貞貞のAIレーダー · MiniMax H3 Image · 2026-11-21 夕刊
今号の 7 件の新バージョン:強く推奨 1 · 推奨 1 · 注目 3 · 収録のみ 2
編集者按語 今号では H3 Image の新バージョン 7 件をレビューし、S 評価が 1 件、A 評価が 1 件、B 評価が 3 件、C 評価が 2 件で、除外はありません。初推しは AusBoss のキャラクター設定図ワークフローです。人物写真を1枚読み込むだけで、正面、斜め45度、横、背面の4方向ビューを一度に描き出し、全身の補完、頭部アップの追加、表情行の追加も可能です。DC Vast Expanse は Krea 2 から移植された大規模シーン向けスタイル LoRA で、A 評価です。AIKSK の3つのワークフロー(6 ステップ 4K テキスト生成画像、スケルトンによるポーズ指定、16 画像参照編集)は基盤モデルが Flux.1 D と表記されていますが、H3 Image 用であることを確認済みです。ただし、サンプルが少なく依存関係が重いため、B / C 評価としました。
強く推奨(1)
【S】MiniMax H3 Image Character Sheet | 16 MP Turnaround From One Photo · v1.1
ワークフロー · 新モデル · 作者 AusBoss · 公開 11-21 11:10 · ダウンロード 154
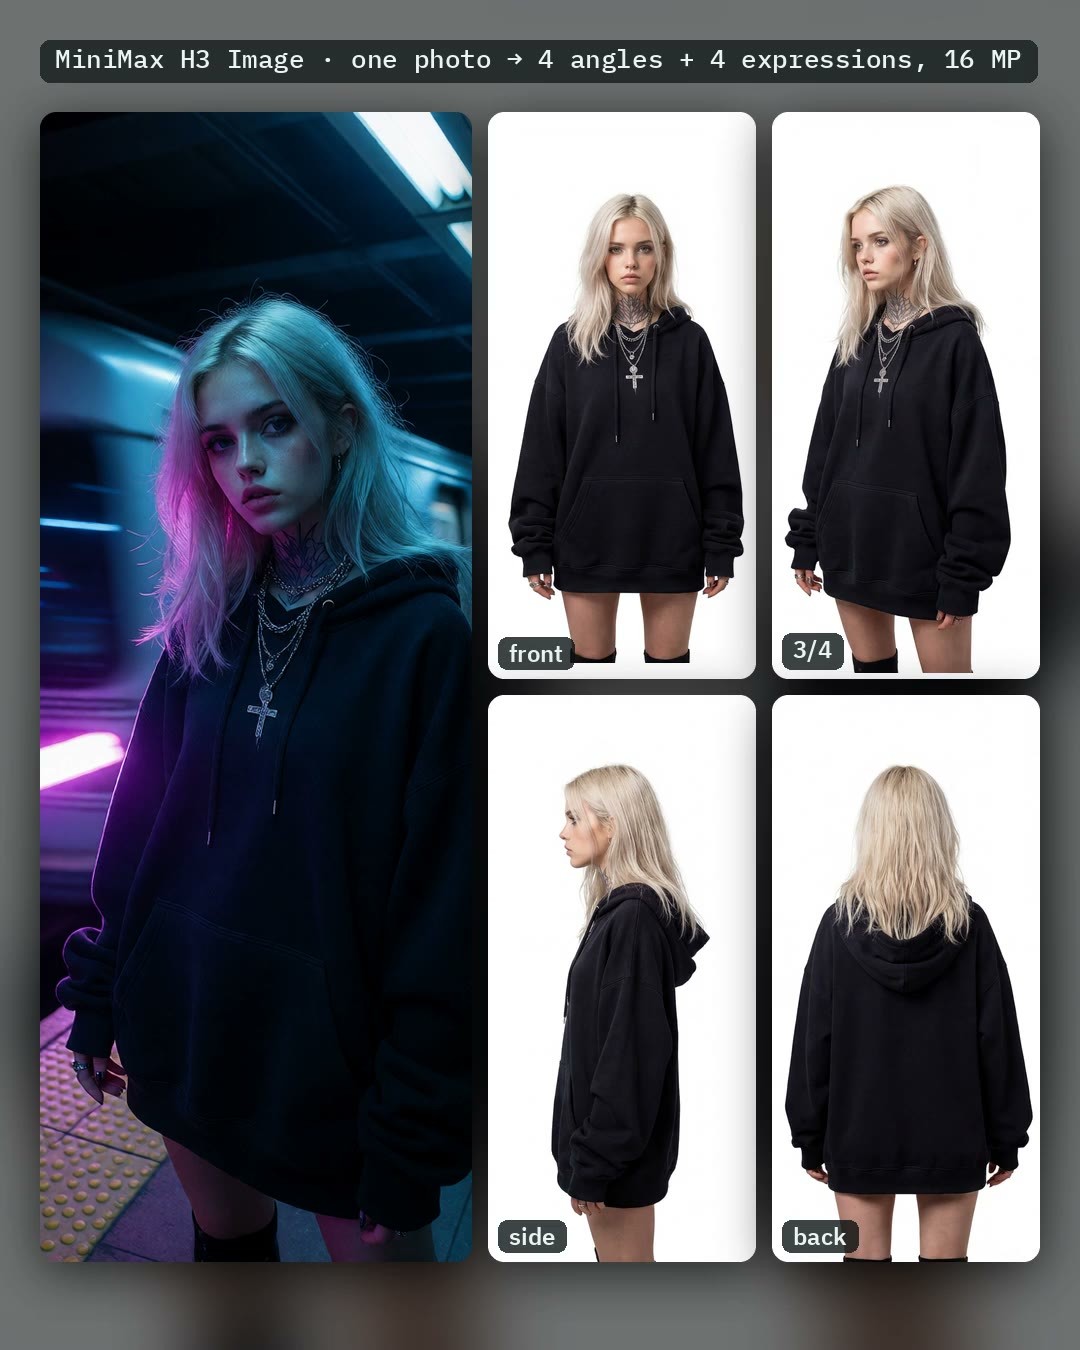
AusBoss の ComfyUI ワークフローです。人物写真を1枚読み込むと、H3 Image が同一人物の正面、斜め45度、横、背面の4方向ビュー設定図を一度に描き出します。最大 16 MP(5504 × 3040)で、アップスケールは不要です。
1枚の写真から多角度のセット設定図を作成でき、スイッチや依存ファイルも明確に記述されているため、今号の初推しです。
画像
推奨理由
- 新ツール:同作者は以前 H3 ビデオモデルでキャラクター設定図を作成していましたが、このバージョンでは H3 Image 画像モデルに変更されました。作者によると、出力は約 5 MP から 16 MP に向上し、処理時間は約半減したとのことです。キャラクターデザイン、一貫性のあるキャラクター参照画像、後続の LoRA / ビデオ用マルチアングル素材の準備に役立ちます
- スイッチ完備:Head to toe で半身写真から靴まで全身を補完;Save each view too で4つのビューを個別に保存;Your photo on the left で元写真を左側に配置;Close-ups under the sheet で再実行し、頭部アップを4つ並べた行を追加(全体画像は 5504 × 4416 になり、4種類の表情に変更することも可能)
- 1 本のサンプル動画と 2 枚のサンプル画像を添付;無料ダウンロード;公開後約 10 時間で 154 回のダウンロード、12 件の「いいね」(注目度を示すのみ)
使い方
- まず ComfyUI 0.45.0 以上または最新バージョン、AusBoss nodes 2.26.5 以上または最新バージョン(Registry 審査通過前は nightly 版をインストール)をインストール;人物がはっきり写った写真を1枚読み込んで直接 Run;背景と「写真に写っていない部分」(例:blue jeans and white sneakers)は任意で入力可能、背景を空欄にすると純白になります
- Size で 4 / 8 / 16 MP を選択(作者によると 16 MP で約 25 秒、4 MP で約 11 秒);Body で Short / Regular / Tall を選択してビュー内の人物の身長を調整;VRAM で High(int8、32 GB カード)または Low(w4a8、24 GB カード)を選択
- Fast では akhaliq の pDMD LoRA を使用してデフォルトの 6 ステップの代わりに 2 ステップで実行;Grain cleanup は Off / Light / Medium / Strong の4段階があり、デフォルトは Off;他の H3 Image LoRA は LoRA Loader に接続
リスクと制限
- 参入障壁が高い:初回実行には約 38 GB のモデルをロードする必要があります(メインモデル int8 版 21.0 GB または w4a8 版 12.5 GB、テキストエンコーダー 15.7 GB、VAE 1.2 GB、Fast では別途 1.96 GB の pDMD LoRA が必要);作者が提示した処理時間はすべて RTX 5090 での測定で、Fast では1枚あたり約 14 秒です
- 背面や補完された脚部はモデルの推測によるもので、実行ごとに異なる可能性があります;作者は写真でのみテストしており、ぼやけた写真からはぼやけた画像が生成されると述べています;ビューを分割する際、2つのビューが重なると互いに影響し合うことがあります
- ワークフローのライセンスはサイト内でのレンタルのみを含みます;ベースモデルは別途 MiniMax-H3-Image コミュニティライセンスの制約を受け、作者は商用利用前にライセンスを確認するよう注意を促しています
推奨(1)
【A】DC Vast Expanse · v1.0 [MinimaxH3Image]
LoRA · 移植 · 作者 dkpc69 · 公開 11-21 20:17 · ダウンロード 15
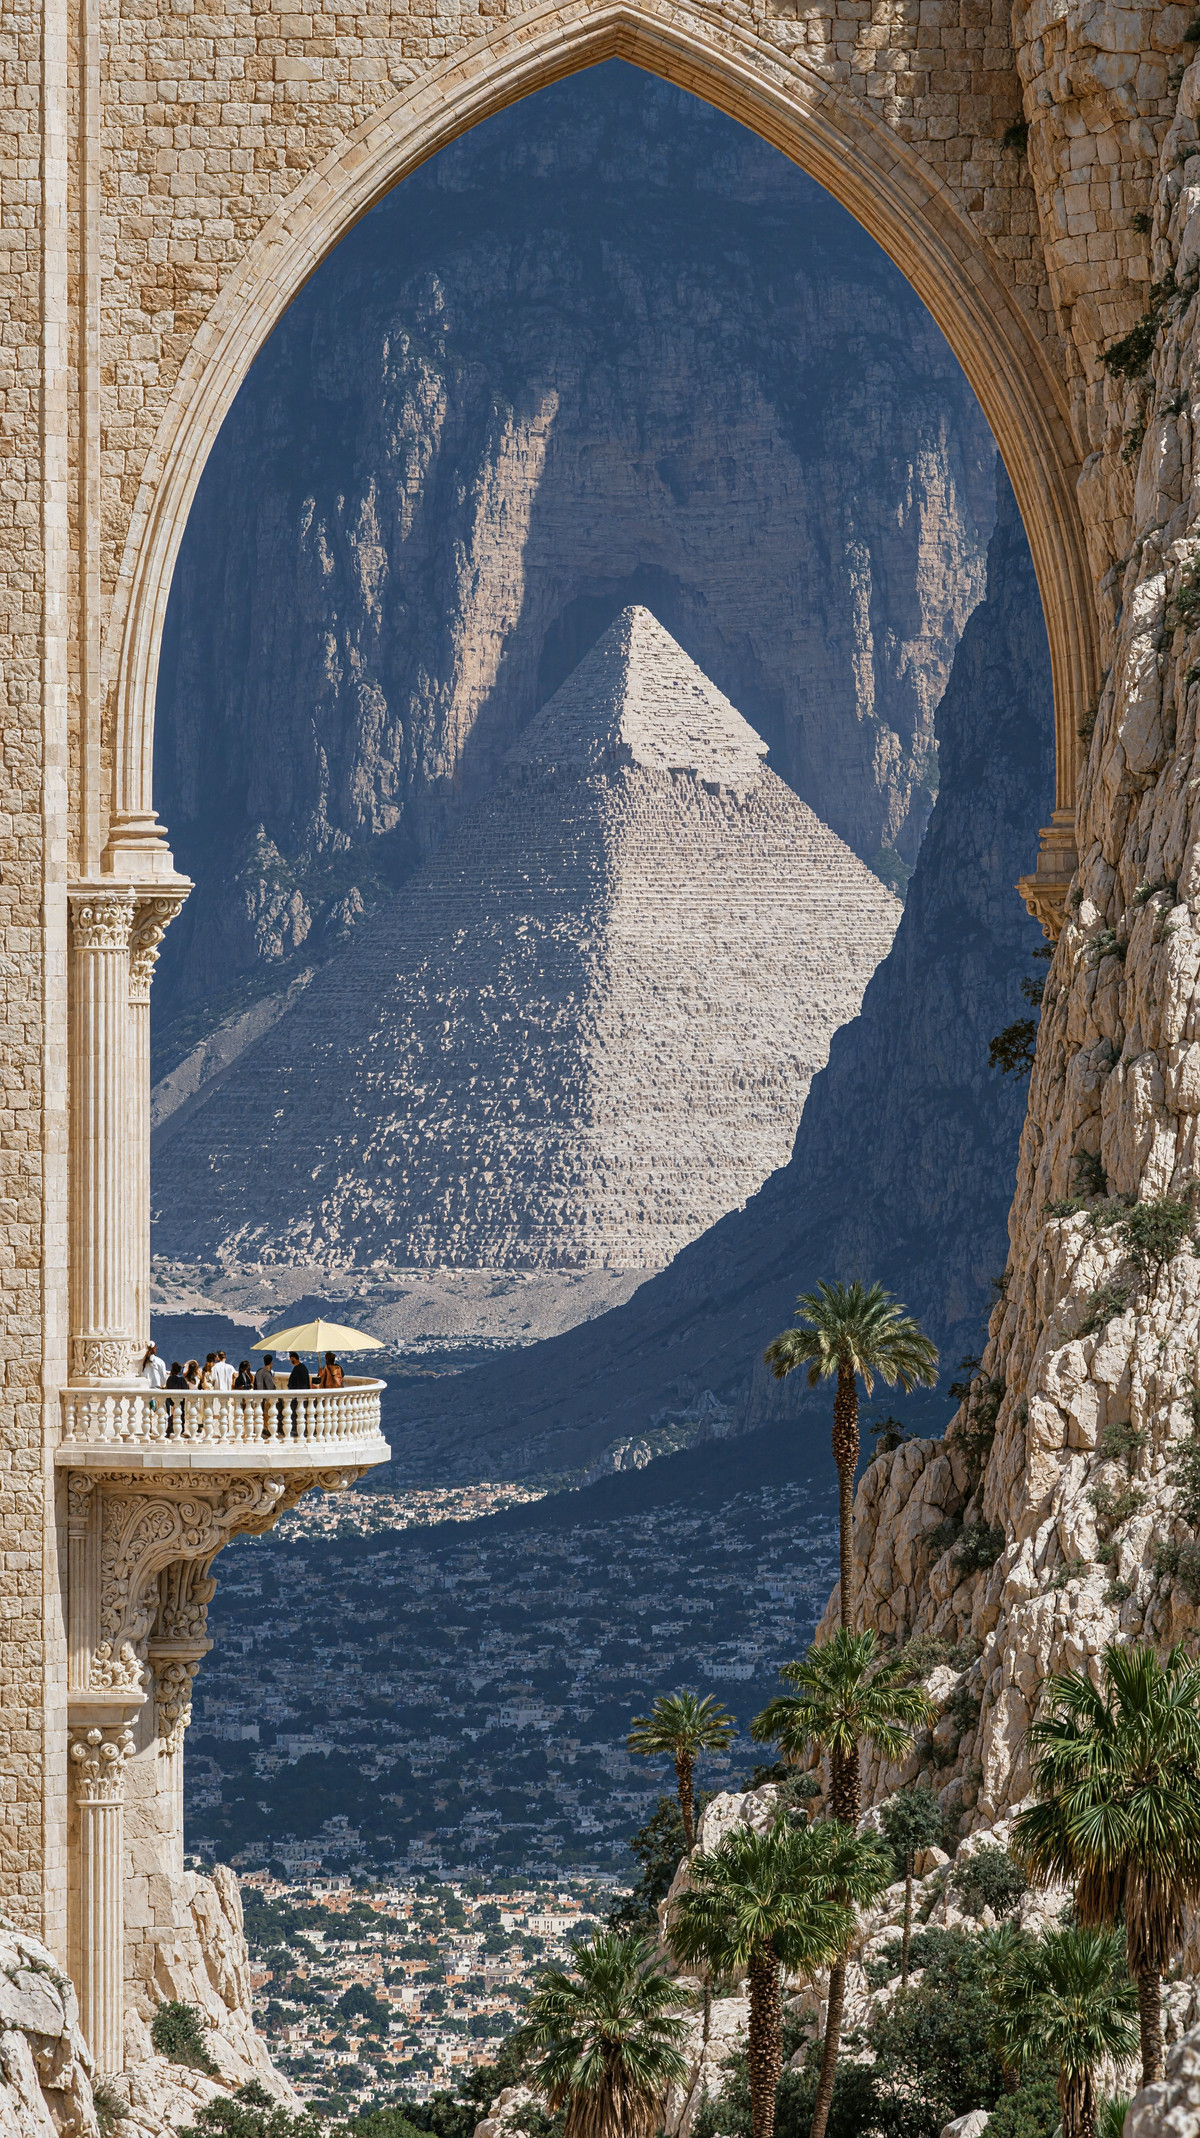
大規模シーン向けスタイル LoRA:強いコントラスト、壮大なスケール感、強い光と影を特徴とし、作者によるとポートレートやファッションスタイルの写真にも適しています。Krea 2 版から H3 Image へ移植されました。
画像
推奨理由
- 移植:以前は Krea 2(Krea2Raw)版があり、448 枚の Midjourney moodboard 画像で訓練されました;H3 Image 版は同じデータセットを使用し、1536 と 2048 の解像度でのみ訓練され、10,000 ステップ、Rank32 で、ファイル名に GPT4.1 によるタグ付けが示されています
- トリガーワードが明確で、15 枚の可視サンプルを添付;作者によると、サンプル画像にはすべて ComfyUI ワークフローが埋め込まれており、ドラッグ&ドロップして再現できます
- モデルページ全体で 2418 回のダウンロード、273 件の「いいね」(注目度を示すのみ);このバージョンは公開後約 1 時間で 15 回のダウンロード、6 件の「いいね」
使い方
- プロンプトにトリガーワード DCVSTEXP.(句点を含む)を記述;作者は 4K で出力し、解像度は高いほど良いと推奨しています
- 強度のデフォルト値は作者から提示されていません;遠景の顔に問題が生じた場合は 0.7–0.8 に下げ、効果が強すぎる場合は少し下げてベースモデルに任せることも可能です;ステップ数やサンプラーは作者から提示されていないため、サンプル画像に埋め込まれたワークフローを参照してください
リスクと制限
- 作者自身が H3 Image 版では遠景の顔が非常に悪いと述べており、1024 解像度で訓練されなかったことが原因ではないかと疑っています
- 訓練データは Midjourney で生成された画像で、スタイルは2人の X / Instagram クリエイターに近いです;5 件のセンシティブなサンプルは非表示になっています
- 作者は、他の生成サイトへ融合または転載する際に、自身の Civitai ホームページを明記するよう要求しています
トリガーワード:DCVSTEXP.
注目(3)
【B】MiniMax H3 Image: Dual Pose Director - Manual VNCCS Skeleton Posing (ComfyUI) · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-21 10:05 · ダウンロード 23
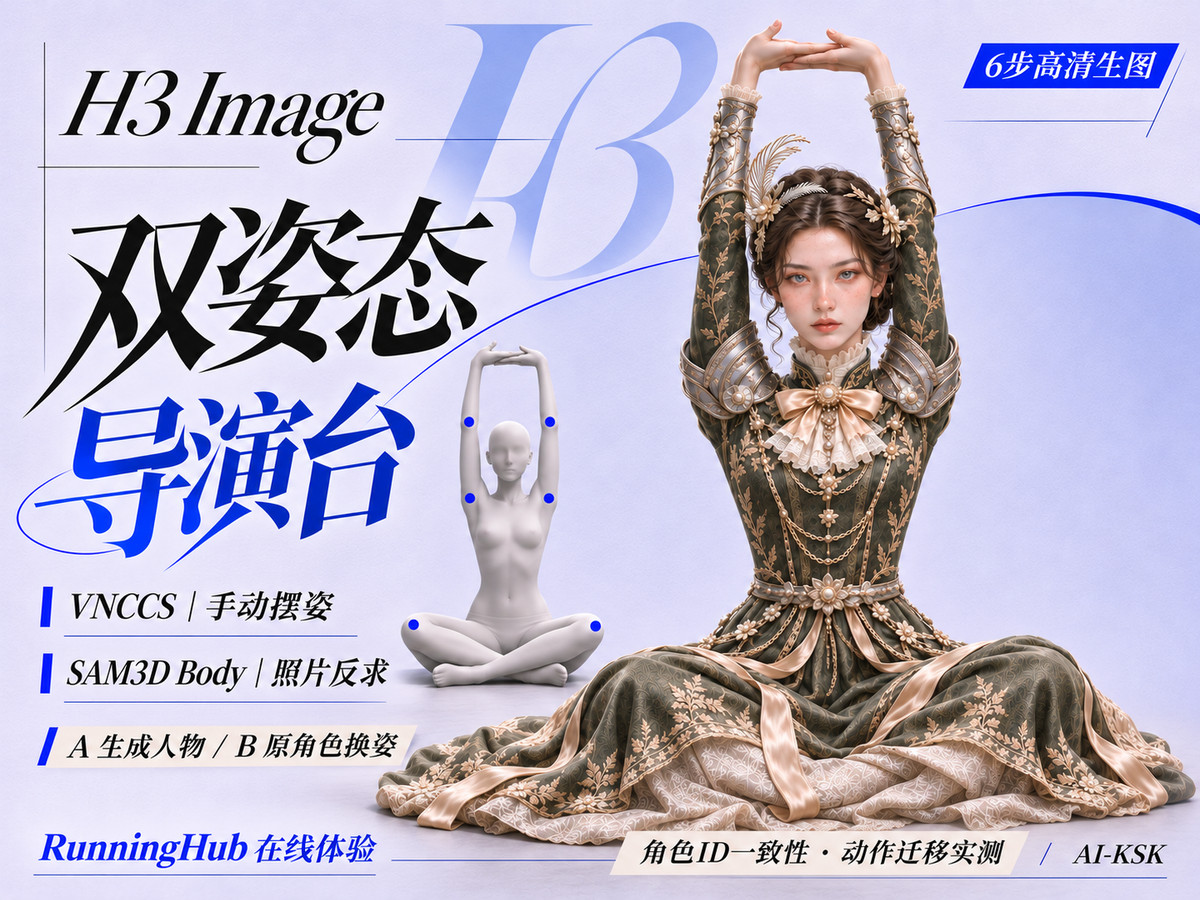
AIKSK の H3 Image 手動ポーズ指定 ComfyUI ワークフローです。VNCCS 3D スケルトンで手動にポーズを設定し条件として使用すると同時に、1枚の参照画像で人物のアイデンティティを保持し、6 ステップで高解像度画像を出力します。
画像
推奨理由
- 新ワークフロー(新ウェイトではない):ベースモデルは誤って Flux.1 D と表記されていますが、名称、説明、依存ファイル名はすべて H3 Image であり、このセクションに分類されます
- 動作の精密な制御が必要なキャラクター出力に対応:スケルトンでポーズを指定し、参照画像で人物を指定;これはプログラムの A ブランチで、B ブランチ(SAM3D による写真からのポーズ逆推定)はオンライン体験のみで、ダウンロード可能な JSON はありません
- 1 枚の可視サンプルを添付;作者は限界を明記しています:極端なポーズではアイデンティティが漂移する可能性があり、6 ステップでは複数回の実行が必要になる場合があります
使い方
- VNCCS スケルトン関連ノードをインストールし、JSON を読み込み;minimax_h3_image_pruned_int8_convrot、minimax_h3_image_vae_fp16、qwen3.5_9b_w4a8_gptq、qwen3vl_32b_minimax_h3_int8_convrot の4ファイルを各自でダウンロード
- スケルトンを設定し、人物参照画像を接続した後、6 ステップで実行;CFG や VRAM 要件は作者から提示されていません
リスクと制限
- 元のワークフローに埋め込まれていたモーションキャプチャ画像はライセンスが不明なため削除され、プレースホルダーに置き換えられており、各自で補う必要があります
- ライセンスにより、あらゆる商用利用や派生が禁止されています;オンライン体験リンクには作者の招待コードが含まれています
- VNCCS ノードと 32B ビジュアル言語エンコーダーに依存していますが、具体的なノードバージョンは作者によって記載されていません
【B】Epic Seven Sprites · Sprites v2.0 MiniMax Img
LoRA · 移植 · 作者 iPiKo · 公開 11-21 15:25 · ダウンロード 22
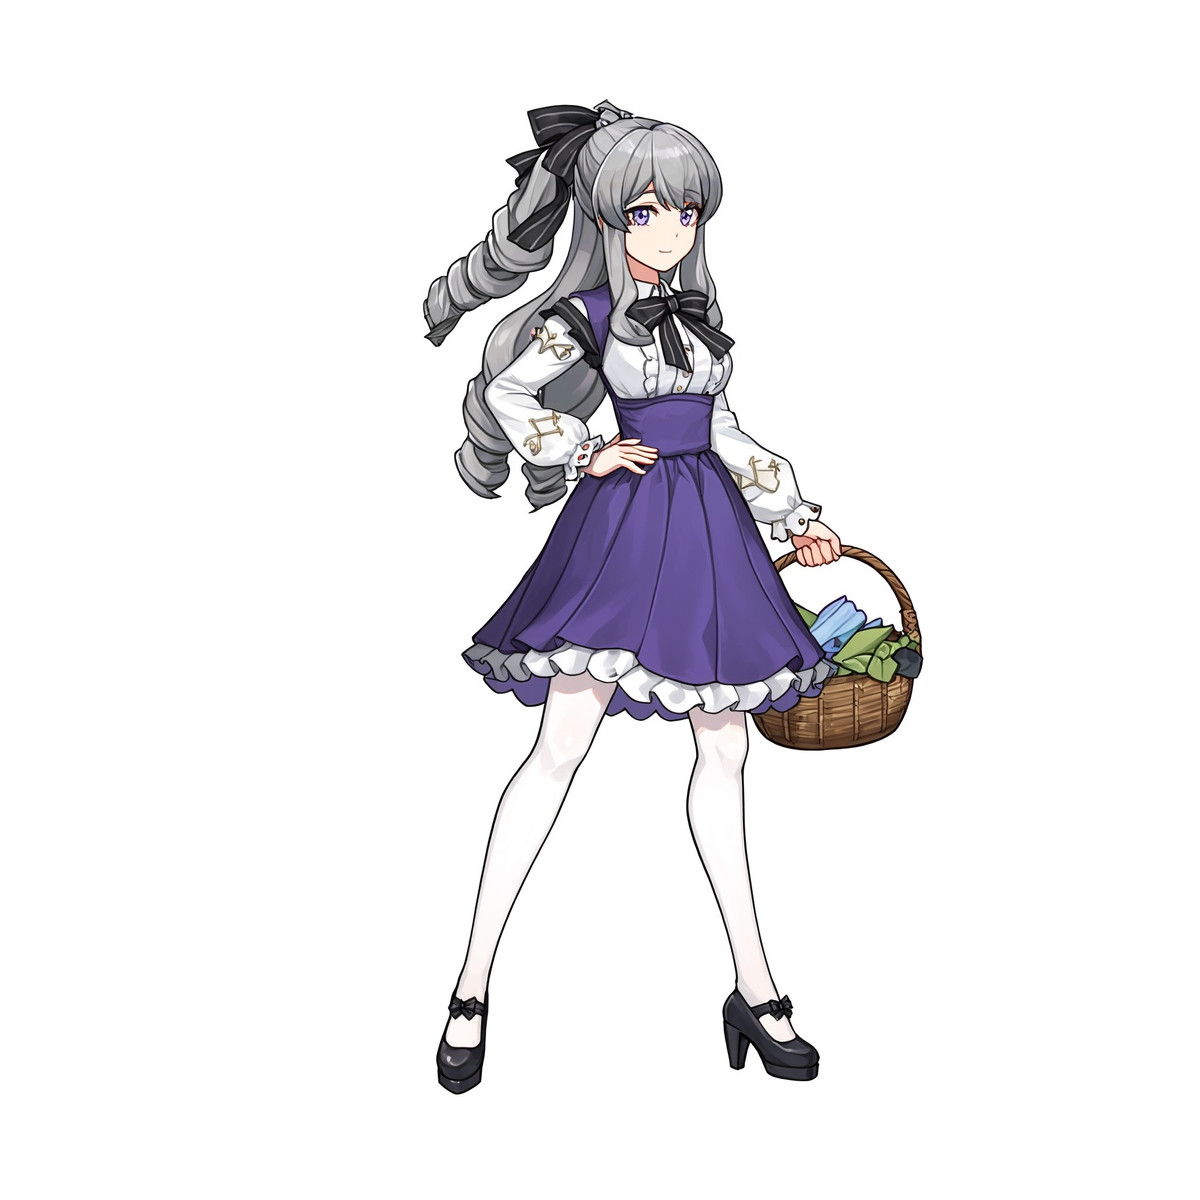
モバイルゲーム『第七史诗』のバトル立ち絵スタイルを再現する LoRA です:クリーンな輪郭線、全身、ゲーム内の待機ポーズ、白背景;V2 シリーズの H3 Image 版です。
画像
推奨理由
- 移植:V2 の同ページにはすでに Illustrious、Anima、Krea 2 版があり、305 枚の白背景女性ヒーロー立ち絵で訓練されました;H3 Image 版のファイル名には base と第 10 エポックが示されていますが、モデルカードにはこのバージョンと他のバージョンとの差異は記載されていません
- ゲームアートや 2D キャラクター立ち絵向け:横方向はクラシックなバトルアングルで、斜め45度はより多くの衣装を披露できます
- 1 枚の可視サンプルを添付;モデルページ全体で 844 回のダウンロード、130 件の「いいね」(注目度を示すのみ)
使い方
- モデルカードには V2 各版のトリガーワードは e7battlesprite と記載されています(この版の API にはトリガーワードが登録されていません);H3 Image には個別のプロンプト記法がないため、Krea 2 の自然言語記法を参照できます:まず「A full-body game sprite in the e7battlesprite style shows a female hero standing in side view against a plain white background.」と記述し、その後キャラクターを説明します
- 作者は正方形キャンバスを使用し、全身白背景を要求しています;強度やステップ数は作者から提示されていません
リスクと制限
- トリガーワードが未登録であり、H3 Image 版のパラメータやプロンプトルールはモデルカードに記載されていません
- 女性ヒーローのみで訓練されており、男性やモンスターのデザインは作者によると実験的性質です
- 商業ゲームのアートスタイルを模倣しているため、商用利用前に原作の著作権に注意してください
【B】MiniMax H3-Image: 16-image reference edit at 4K (ComfyUI) · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-21 18:42 · ダウンロード 16
AIKSK の H3 Image マルチリファレンス画像編集 ComfyUI ワークフロー:1回の編集で最大 16 枚のリファレンス画像を条件として、キャラクターや製品の一連の画像を異なる角度でも一貫性を保ち、4K 出力、6 ステップ。
参考画像
推奨理由
- 新ワークフロー(新ウェイトではない):ベースモデルは Flux.1 D と誤記されているが、名称、説明、タグはすべて H3 Image であり、このセクションに分類
- キャラクター/製品多角度の一貫性ある画像生成に対応;48 個のノード、作者は1〜2枚の画像の場合は単一画像ブランチへの変更を推奨
- 説明が簡潔:依存ファイル名は記載されておらず、確認できるサンプルもなし
使い方
- JSON を読み込み、リファレンス画像(最大 16 枚)を接続して 6 ステップ実行し、4K を出力;ウェイトは同梱されておらず、具体的なファイルはモデルカードに記載されていない
- CFG、VRAM要件は作者により提供されていない;作者はメモリと処理時間がリファレンス画像の枚数に応じて増加すると述べている
リスクと制限
- サンプルはすべてセンシティブレベル(1 個は非表示)であり、効果のプレビューは不可
- ライセンスにより商用利用および派生物の作成は一切禁止;オンライン体験リンクには作者の招待コードが含まれる
- 依存するノードとモデルは各自で確認が必要
- カードの参考画像は AI 生成のイメージ図であり、モデルの実際の出力結果ではない;作者は公開された一般レベルのサンプルを持っていない
収録のみ(2)
- [H3 image]pwni style · v1.0 — LoRA:pwni style と名付けられた実験的なアニメスタイル LoRA。H3 Image pruned int8 バージョンで訓練された最初のテスト版であり、具体的なスタイルについてはモデルカードに記載されていない。
- Text to image: MiniMax H3-Image 4K in 6 steps (ComfyUI) · v1.0 — ワークフロー:AIKSK の H3 Image ベーシックなテキストから画像生成 ComfyUI ワークフロー:6つのノード、プロンプト入力、6 ステップサンプリング、ネイティブ 4K(約 16.8 MP)で画像を出力。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-21 08:31 → 11-21 21:01(北京時間)。推奨理由は編集者によるレビュー済み;ダウンロード数は注目度を表すに過ぎない。