Радар AI от Чжэньчжэнь · MiniMax H3 Image · Вечерний выпуск 2026-11-21
В этом выпуске 7 новых версий: настоятельно рекомендуется 1 · рекомендуется 1 · стоит обратить внимание 3 · включено в обзор 2
Примечание редактора В этом выпуске рассмотрено 7 новых версий H3 Image: 1 категории S, 1 категории A, 3 категории B и 2 категории C, исключений нет. Рекомендуем рабочий процесс создания листов персонажей от AusBoss: загрузите одно фото человека, и система за один проход создаст четыре вида (фронтальный, три четверти, профильный и вид сзади), с возможностью дополнить изображение до полного роста, добавить крупные планы головы или ряды с выражениями лица. LoRA стиля масштабных сцен DC Vast Expanse, портированная с Krea 2, отнесена к категории A; три рабочих процесса от AIKSK (генерация текста в изображение за 6 шагов при 4K, позиционирование по скелету, редактирование с опорой на 16 изображения) используют базовую модель, обозначенную как Flux.1 D. Подтверждено, что они предназначены для H3 Image, но из-за малого количества примеров и высокой зависимости от внешних компонентов отнесены к категориям B / C.
Настоятельно рекомендуется (1)
[S] MiniMax H3 Image Character Sheet | 16 МП Поворотный вид с одного фото · v1.1
Рабочий процесс · Новая модель · Автор AusBoss · Опубликовано 11-21 11:10 · Загрузок 154
Рабочий процесс ComfyUI от AusBoss: загрузите одно фото человека, и H3 Image за один проход создаст лист с четырьмя видами одного и того же человека (фронтальный, три четверти, профильный и вид сзади) с разрешением до 16 МП (5504 × 3040), без необходимости последующего увеличения.
Создание полного набора многоугловых референсов из одного фото, с четко описанными настройками и зависимостями — главный выбор этого выпуска.
Иллюстрации
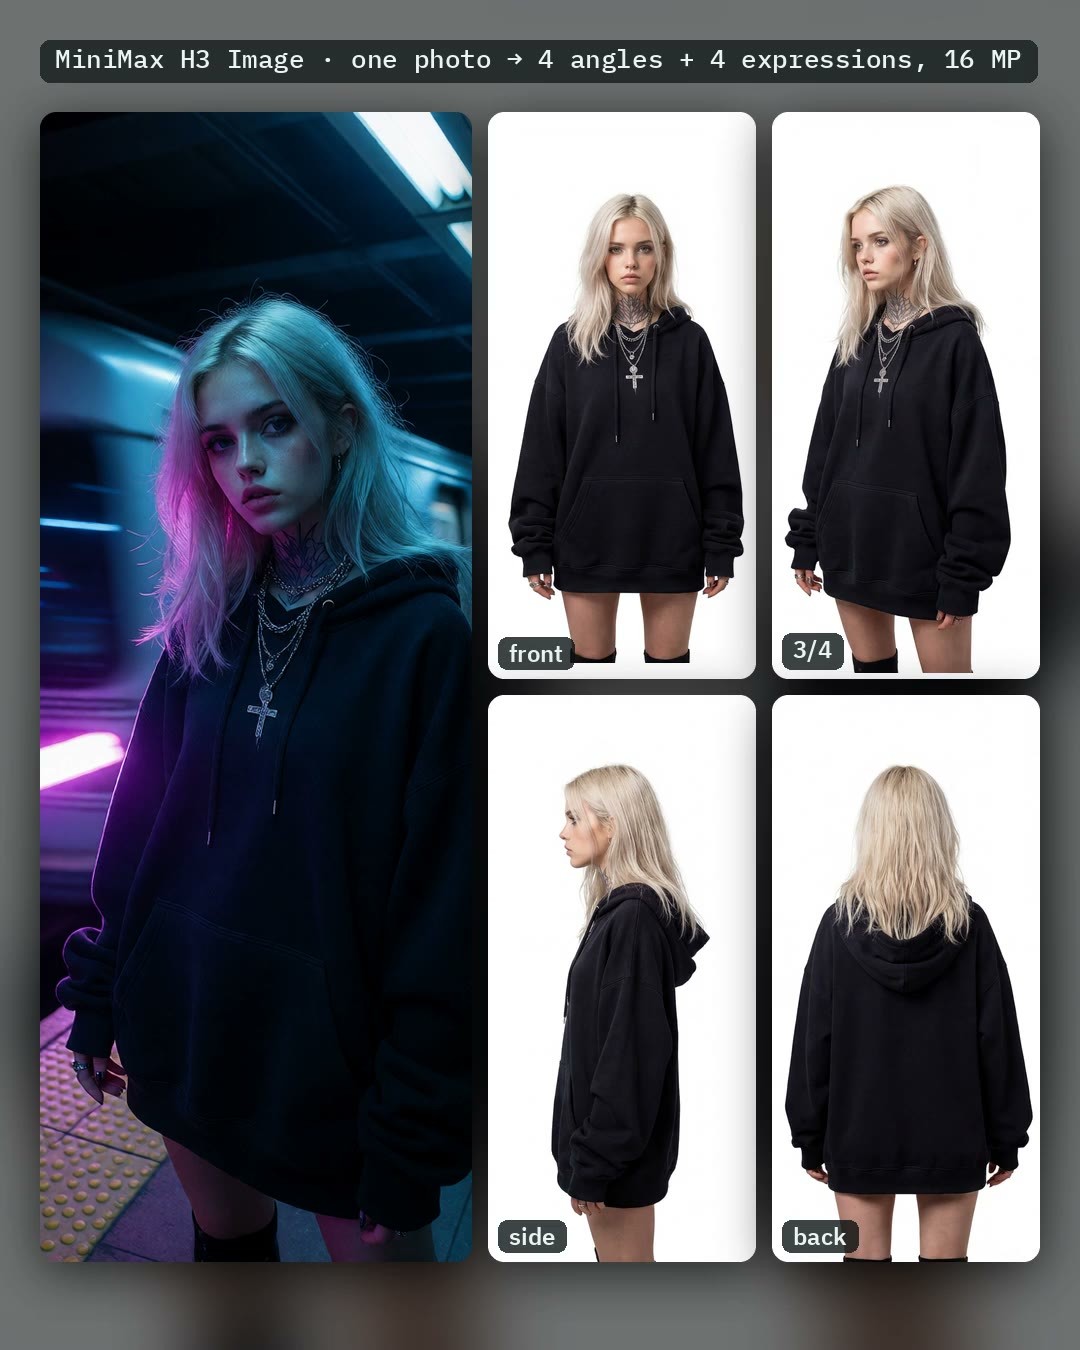
Причины рекомендации
- Новый инструмент: ранее тот же автор создавал листы персонажей с помощью видеомодели H3, в этой версии используется модель изображений H3 Image. По словам автора, разрешение вывода увеличилось с примерно 5 МП до 16 МП, а время обработки сократилось примерно вдвое. Подходит для дизайна персонажей, создания согласованных референсов и подготовки многоугловых материалов для последующих LoRA / видео.
- Полный набор настроек: опция Head to toe дополняет изображение до полного роста (до обуви) при загрузке фото по пояс; Save each view too сохраняет каждый из четырех видов отдельным файлом; Your photo on the left размещает исходное фото слева; Close-ups under the sheet запускает дополнительный проход для добавления ряда из четырех крупных планов головы (общее разрешение становится 5504 × 4416), также можно заменить на четыре различных выражения лица.
- Приложено 1 примеров видео и 2 примеров изображений; бесплатная загрузка; за примерно 10 часов после публикации зафиксировано 154 загрузок и 12 лайков (только как показатель популярности).
Как использовать
- Сначала установите ComfyUI версии 0.45.0 или новее, а также узлы AusBoss версии 2.26.5 или новее (до одобрения в Registry используйте ночную сборку). Загрузите четкое фото человека и нажмите Run. Фон и «части, не попавшие в кадр» (например, blue jeans and white sneakers) можно указать опционально; если оставить поле фона пустым, он будет чисто белым.
- В поле Size выберите 4 / 8 / 16 МП (по словам автора, 16 МП занимает около 25 секунд, а 4 МП — около 11 секунд); в поле Body выберите Short / Regular / Tall для управления ростом персонажа на видах; в поле VRAM выберите High (int8, для карт с 32 ГБ) или Low (w4a8, для карт с 24 ГБ).
- Режим Fast использует LoRA pDMD от akhaliq для генерации за 2 шагов вместо стандартных 6; опция Grain cleanup имеет четыре уровня: Off / Light / Medium / Strong (по умолчанию выключена); другие LoRA для H3 Image подключаются через LoRA Loader.
Риски и ограничения
- Высокий порог входа: при первом запуске загружается около 38 ГБ моделей (основная модель в версии int8 занимает 21.0 ГБ или в версии w4a8 — 12.5 ГБ, текстовый энкодер — 15.7 ГБ, VAE — 1.2 ГБ; для режима Fast дополнительно требуется LoRA pDMD объемом 1.96 ГБ). Все указанные автором времена получены на RTX 5090, в режиме Fast генерация занимает около 14 секунд на изображение.
- Вид сзади и дополненные части тела (ноги, ступни) генерируются моделью на основе предположений и могут различаться при каждом запуске; автор отмечает, что тестировал только на фотографиях, и «мягкие» фото дают «мягкие» результаты; при разделении на отдельные виды, если два вида соприкасаются, элементы могут частично перетекать друг в друга.
- Лицензия рабочего процесса разрешает только использование на платформе; базовая модель подчиняется лицензии сообщества MiniMax-H3-Image, автор напоминает внимательно изучить условия перед коммерческим использованием.
Рекомендуется (1)
[A] DC Vast Expanse · v1.0 [MinimaxH3Image]
LoRA · Порт · Автор dkpc69 · Опубликовано 11-21 20:17 · Загрузок 15
LoRA в стиле масштабных сцен: высокий контраст, ощущение грандиозного масштаба, мощная игра света и тени. По словам автора, также подходит для портретов и фэшн-фотографий. Портирована с версии Krea 2 для H3 Image.
Иллюстрации
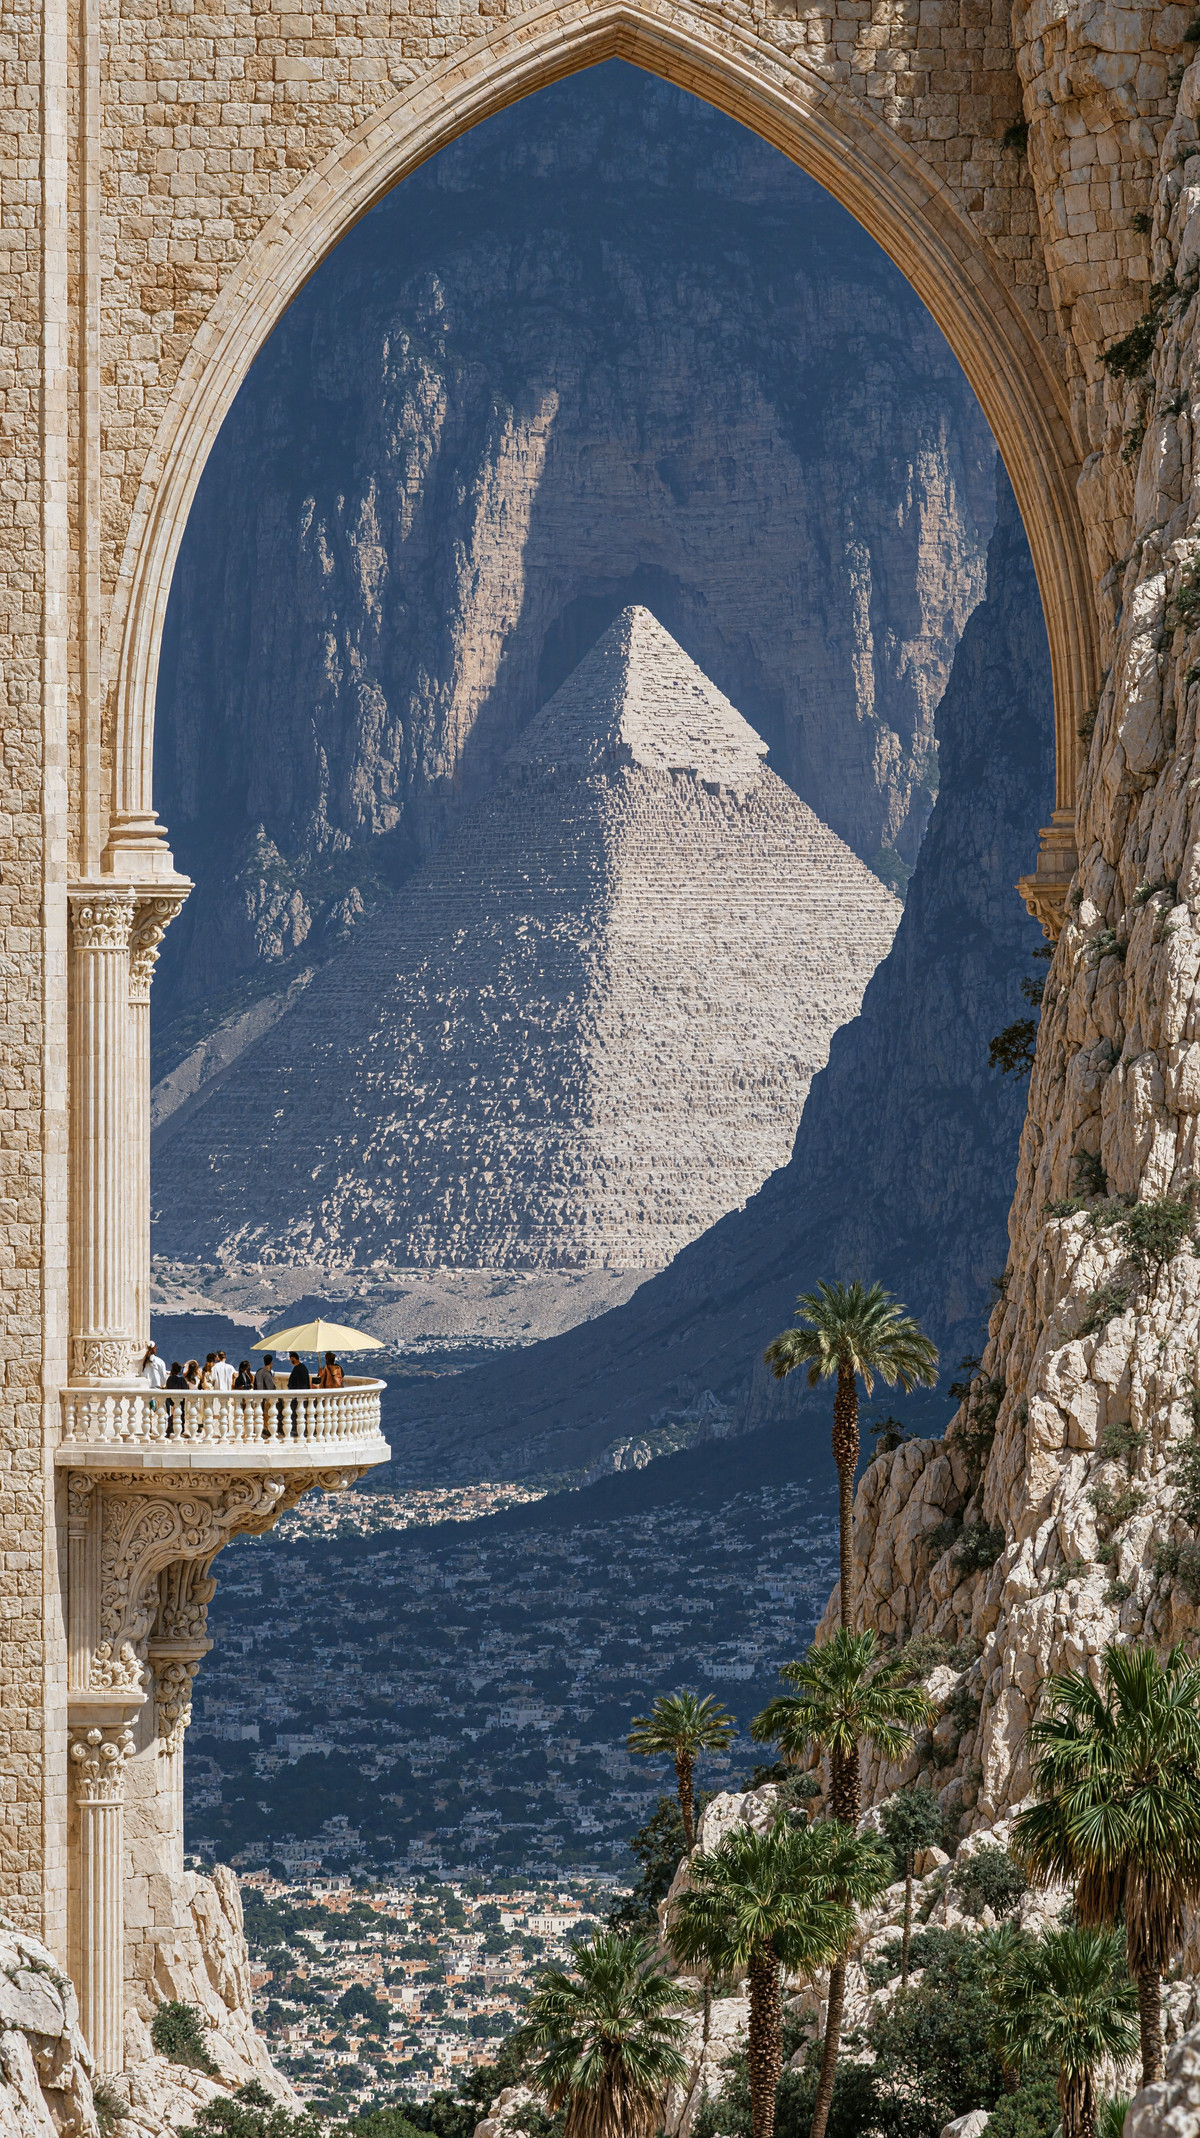
Причины рекомендации
- Порт: ранее существовала версия для Krea 2 (Krea2Raw), обученная на 448 изображениях из мудборда Midjourney. Версия для H3 Image обучена на том же наборе данных, но только при разрешениях 1536 и 2048, за 10,000 шагов, с Rank32. В имени файла указано, что разметка выполнена GPT4.1.
- Четко определены триггерные слова, приложено 15 видимых примеров. Автор утверждает, что все примеры содержат встроенные рабочие процессы ComfyUI, которые можно просто перетащить для воспроизведения.
- Всего на странице модели зафиксировано 2418 загрузок и 273 лайков (только как показатель популярности); за примерно 1 часов после публикации этой версии зафиксировано 15 загрузок и 6 лайков.
Как использовать
- В промпт необходимо включить триггер DCVSTEXP. (с точкой). Автор рекомендует генерировать изображения при разрешении 4K, чем выше разрешение, тем лучше.
- Автор не указал рекомендуемую силу воздействия; если лица на дальних планах искажаются, снизьте значение до 0.7–0.8, также можно немного снизить силу, чтобы базовая модель взяла на себя часть работы. Количество шагов и сэмплер не указаны, ориентируйтесь на встроенные рабочие процессы в примерах.
Риски и ограничения
- Автор сам отмечает, что лица на дальних планах в версии для H3 Image получаются плохо, предполагая, что это связано с отсутствием обучения при разрешении 1024.
- Обучающий набор состоит из изображений, сгенерированных Midjourney, стиль близок к работам двух авторов из X / Instagram; 5 примеров с чувствительным содержанием скрыты.
- Автор требует указывать ссылку на его страницу Civitai при смешивании моделей или перепубликации на других генеративных платформах.
Триггерные слова: DCVSTEXP.
Стоит обратить внимание (3)
[B] MiniMax H3 Image: Dual Pose Director - Manual VNCCS Skeleton Posing (ComfyUI) · v1.0
Рабочий процесс · Новая модель · Автор AIKSK · Опубликовано 11-21 10:05 · Загрузок 23
Рабочий процесс ComfyUI от AIKSK для ручного позиционирования в H3 Image: использует скелет VNCCS 3D для ручного задания позы в качестве условия, одновременно применяя одно референсное изображение для сохранения идентичности персонажа, генерируя высококачественное изображение за 6 шагов.
Иллюстрации
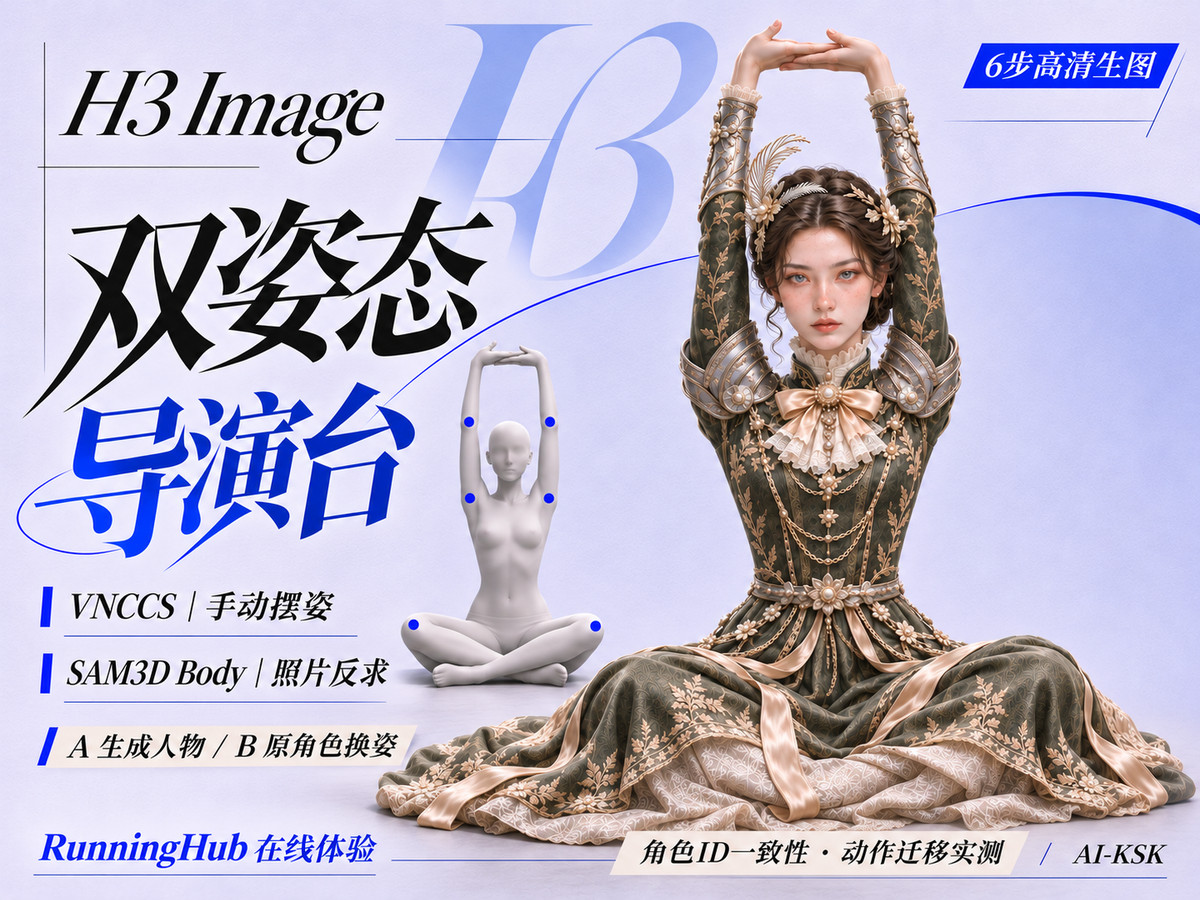
Причины рекомендации
- Новый рабочий процесс (не новые веса): базовая модель ошибочно обозначена как Flux.1 D, однако название, описание и имена зависимых файлов указывают на H3 Image, поэтому отнесен к этому разделу.
- Подходит для генерации персонажей, требующих точного контроля позы: скелет задает позу, референс сохраняет идентичность. Это ветка A программы; ветка B (восстановление позы из фото через SAM3D) доступна только в онлайн-демо, без возможности скачать JSON.
- Приложено 1 видимых примеров; автор указывает на ограничения: при экстремальных позах идентичность может «дрейфовать», а для достижения результата за 6 шагов может потребоваться несколько попыток.
Как использовать
- Установите узлы, связанные со скелетом VNCCS, загрузите JSON. Самостоятельно скачайте четыре файла: minimax_h3_image_pruned_int8_convrot, minimax_h3_image_vae_fp16, qwen3.5_9b_w4a8_gptq, qwen3vl_32b_minimax_h3_int8_convrot.
- Настройте скелет, подключите референсное изображение персонажа и запустите генерацию за 6 шагов. Значения CFG и требования к видеопамяти автором не указаны.
Риски и ограничения
- Встроенные в исходный рабочий процесс изображения захвата движения были удалены из-за неясности лицензий и заменены плейсхолдерами, которые нужно заполнить самостоятельно.
- Лицензия запрещает любое коммерческое использование и создание производных работ; ссылка на онлайн-демо содержит пригласительный код автора.
- Зависит от узлов VNCCS и визуального языкового энкодера размером 32B, конкретные версии узлов автором не указаны.
[B] Epic Seven Sprites · Sprites v2.0 MiniMax Img
LoRA · Порт · Автор iPiKo · Опубликовано 11-21 15:25 · Загрузок 22
LoRA, воссоздающая стиль боевых спрайтов из мобильной игры «Epic Seven»: чистые контуры, полный рост, игровые позы ожидания, белый фон. Версия для H3 Image из серии V2.
Иллюстрации
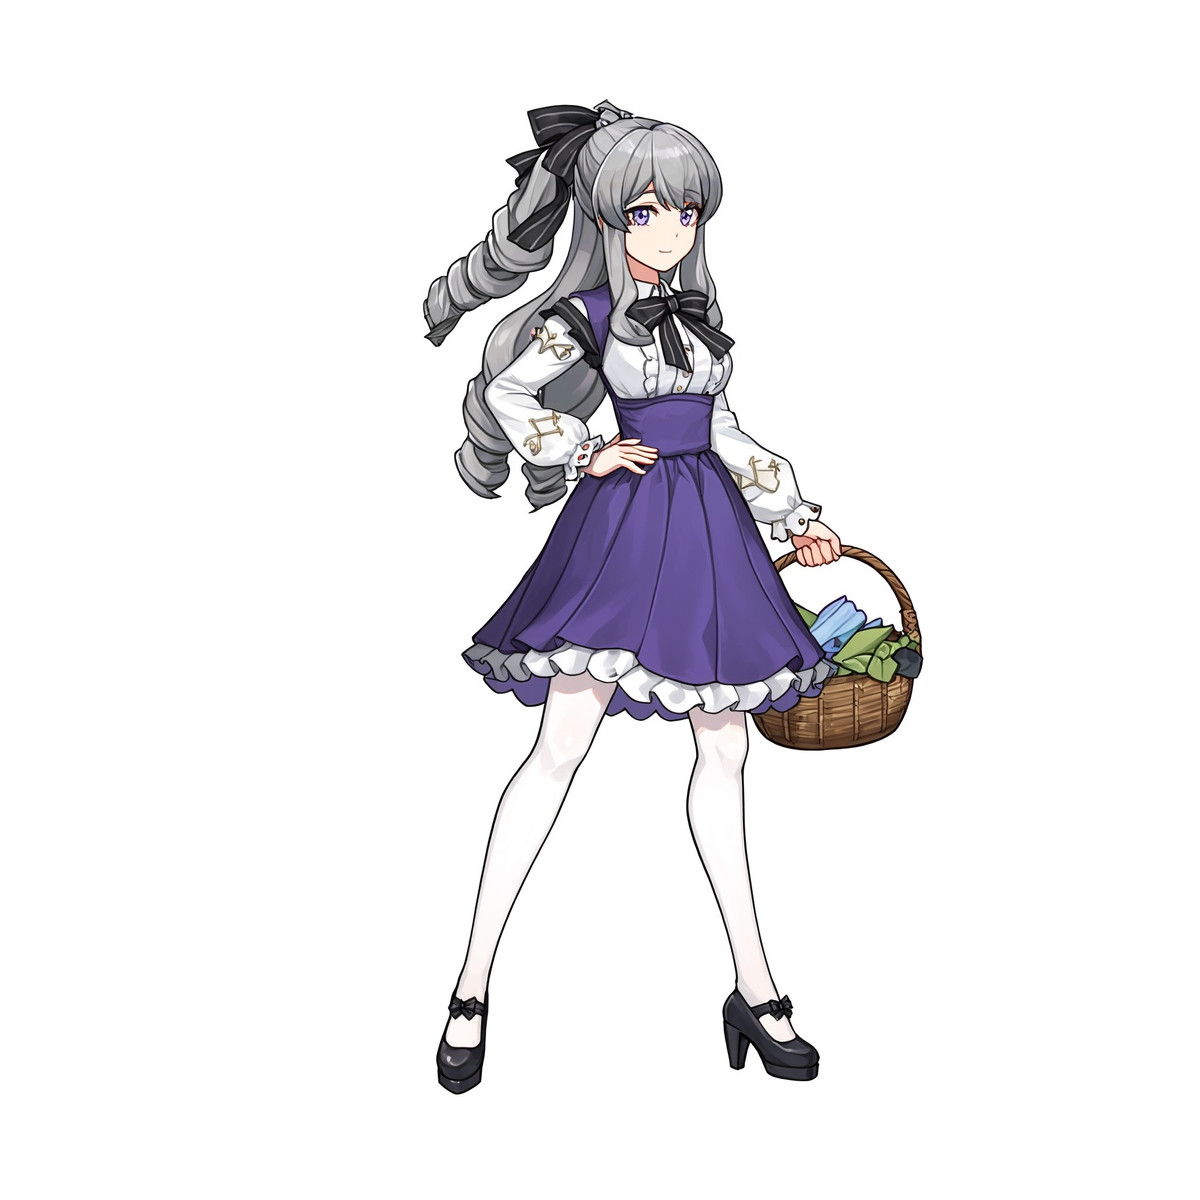
Причины рекомендации
- Портирование: на странице V2 уже есть версии Illustrious, Anima и Krea 2, обученные на 305 изображениях героинь на белом фоне; версия H3 Image имеет в имени файла пометку base и относится к 10-му раунду, при этом в карточке модели не указано, чем эта версия отличается от других
- Для игровой графики и 2D персонажных иллюстраций: вид сбоку — классический боевой ракурс, а три четверти сбоку позволяют лучше показать одежду
- Приложено 1 видимых примеров; всего страница модели имеет 844 скачиваний и 130 лайков (это лишь показатель популярности)
Как использовать
- В карточке модели указано, что триггер для всех версий V2 — e7battlesprite (для этой версии триггер в API не зарегистрирован). Для H3 Image нет отдельных правил написания промптов, можно ориентироваться на стиль естественного языка для Krea 2: сначала напишите «A full-body game sprite in the e7battlesprite style shows a female hero standing in side view against a plain white background.», а затем опишите персонажа.
- Автор рекомендует использовать квадратный холст и требовать полный рост на белом фоне; сила воздействия и количество шагов не указаны.
Риски и ограничения
- Триггер не зарегистрирован, параметры и правила промптов для версии H3 Image в карточке модели не описаны.
- Обучение проводилось только на женских героях; по словам автора, дизайн мужских персонажей и монстров носит экспериментальный характер.
- Стиль имитирует коммерческую игровую графику, перед коммерческим использованием обратите внимание на авторские права оригинала.
[B] MiniMax H3-Image: 16-image reference edit at 4K (ComfyUI) · v1.0
Рабочий процесс · Новая модель · Автор AIKSK · Опубликовано 11-21 18:42 · Загрузок 16
Рабочий процесс ComfyUI для редактирования с несколькими референсными изображениями H3 Image от AIKSK: одно редактирование использует до 16 референсных изображений для обеспечения консистентности персонажа или продукта под разными углами, вывод в разрешении 4K, 6 шагов.
Иллюстрация
Почему стоит обратить внимание
- Новый рабочий процесс (не новые веса): базовая модель ошибочно указана как Flux.1 D, но название, описание и теги относятся к H3 Image, поэтому включен в этот раздел
- Предназначен для генерации изображений персонажей или продуктов с сохранением консистентности под разными углами; 48 узлов, автор рекомендует использовать ветку для одного изображения, если есть только одна-две картинки
- Описание очень краткое: не перечислены имена файлов зависимостей, нет видимых примеров
Как использовать
- Загрузите JSON, подключите референсные изображения (до 16 шт.) и выполните 6 шагов для получения результата в 4K; веса не прилагаются, конкретные файлы автор не указал в карточке модели
- Значения CFG и требования к видеопамяти автором не указаны; автор отмечает, что потребление памяти и время выполнения растут с увеличением количества референсных изображений
Риски и ограничения
- Все примеры имеют рейтинг чувствительности (1 скрыто), невозможно предпросмотреть результат
- Лицензия запрещает любое коммерческое использование и создание производных работ; ссылка на онлайн-демо содержит код приглашения автора
- Зависимые узлы и модели необходимо проверять самостоятельно
- Иллюстрация на карточке — это сгенерированная ИИ схема, а не реальный результат работы модели; у автора нет публичных примеров с обычным рейтингом
Только для справки (2)
- [H3 image]pwni style · v1.0 — LoRA: экспериментальная аниме-стилизация LoRA под названием pwni style, первая тестовая версия, обученная на версии H3 Image pruned int8; конкретный стиль в карточке модели не описан.
- Text to image: MiniMax H3-Image 4K in 6 steps (ComfyUI) · v1.0 — Рабочий процесс: базовый рабочий процесс ComfyUI для генерации изображений по тексту H3 Image от AIKSK: шесть узлов, ввод промпта, сэмплирование за 6 шагов, нативный вывод в 4K (около 16.8 МП).
Данные: публичный API Civitai (базовая модель MiniMax H3), период отбора 11-21 08:31 → 11-21 21:01 (пекинское время). Рекомендации проверены редакторами; количество загрузок отражает только уровень интереса.