진진의 AI 레이더 · MiniMax H3 Image · 2026-11-21 저녁 브리핑
이번 호의 7개 신규 버전: 강력 추천 1 · 추천 1 · 주목할 만함 3 · 단순 수록 2
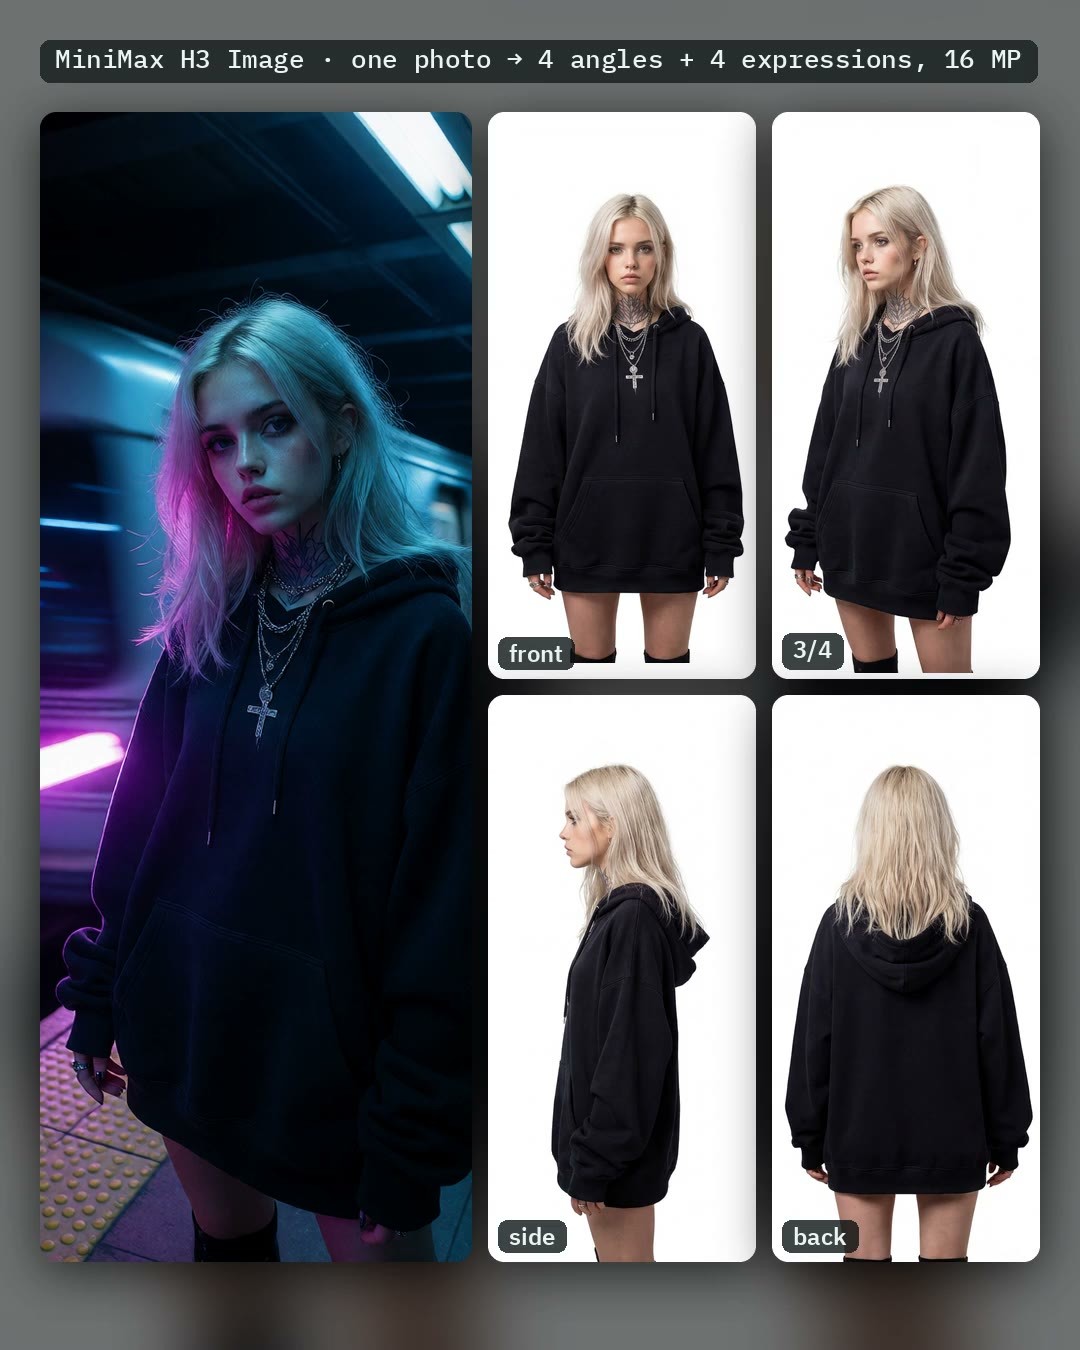
편집자 주 이번 호에서는 H3 Image의 새로운 버전 7개를 검토했습니다. S급 1개, A급 1개, B급 3개, C급 2개이며, 제외된 항목은 없습니다. 첫 추천은 AusBoss의 캐릭터 설정 시트 워크플로우입니다: 인물 사진 한 장을 불러오면 정면, 3/4 측면, 측면, 후면의 4가지 뷰를 한 번에 그려주며, 전신 완성, 머리 클로즈업 추가, 표정 라인 추가가 가능합니다. DC Vast Expanse는 Krea 2에서 이식된 대규모 장면 스타일 LoRA로 A급으로 분류했습니다. AIKSK의 세 가지 워크플로우(6 단계 4K 텍스트-이미지 생성, 스켈레톤을 이용한 포즈 지정, 16 이미지 참조 편집)의 기본 모델은 Flux.1 D로 표기되어 있으나, H3 Image용임을 확인했으나 예제가 적고 의존성이 무거워 B / C급으로 분류했습니다.
강력 추천 (1)
【S】MiniMax H3 Image Character Sheet | 16 MP 한 장의 사진으로 360도 회전 뷰 생성 · v1.1
워크플로우 · 신규 모델 · 저자 AusBoss · 게시일 11-21 11:10 · 다운로드 수 154
AusBoss의 ComfyUI 워크플로우: 인물 사진 한 장을 불러오면 H3 Image가 동일 인물의 정면, 3/4 측면, 측면, 후면의 4가지 뷰 설정 시트를 한 번에 생성하며, 최대 16 MP(5504 × 3040) 해상도로 업스케일링 없이 사용할 수 있습니다.
사진 한 장으로 다양한 각도의 설정 시트 세트를 생성하며, 스위치와 의존성 파일이 명확히 기술되어 있어 이번 호의 첫 추천입니다.
예시 이미지
추천 이유
- 새로운 도구: 같은 저자가 이전에 H3 비디오 모델로 캐릭터 설정 시트를 만든 적이 있으나, 이번 버전은 H3 Image 이미지 모델로 변경되었습니다. 저자는 출력 해상도가 약 5 MP에서 16 MP로 향상되고 처리 시간이 약 절반으로 줄었다고 주장합니다. 캐릭터 디자인, 일관성 있는 캐릭터 참조 이미지 생성, 이후 LoRA / 비디오 제작을 위한 다각도 소재 준비에 유용합니다
- 스위치 완비: Head to toe 옵션으로 반신 사진에서 신발까지 전신을 완성할 수 있습니다. Save each view too 옵션으로 네 가지 뷰를 각각 개별 이미지로 저장할 수 있습니다. Your photo on the left 옵션으로 원본 사진을 왼쪽에 배치할 수 있습니다. Close-ups under the sheet 옵션으로 한 번 더 실행하여 머리 클로즈업 4개를 한 줄로 추가할 수 있으며(전체 이미지가 5504 × 4416로 변경됨), 4가지 표정으로 대체할 수도 있습니다
- 예제 비디오 1개 + 예제 이미지 2개 포함; 무료 다운로드; 게시 후 약 10시간 만에 다운로드 154회, 좋아요 12개(관심도 참고용)
사용 방법
- 먼저 ComfyUI 0.45.0 이상 또는 최신 버전, AusBoss nodes 2.26.5 이상 또는 최신 버전을 설치하세요(Registry 심사 통과 전에는 nightly 버전을 설치). 인물 사진 한 장을 선명하게 불러와 Run을 실행하면 됩니다. 배경과 '사진에 찍히지 않은 부분'(예: blue jeans and white sneakers)은 선택적으로 입력할 수 있으며, 배경을 비워두면 흰색이 됩니다
- Size에서 4 / 8 / 16 MP를 선택하세요(저자 주장에 따르면 16 MP는 약 25초, 4 MP는 약 11초 소요). Body에서 Short / Regular / Tall을 선택하여 뷰 내 인물의 키를 조절할 수 있습니다. VRAM에서 High(int8, 32 GB 카드) 또는 Low(w4a8, 24 GB 카드)를 선택하세요
- Fast 옵션은 akhaliq의 pDMD LoRA를 사용하여 기본 6 단계 대신 2 단계로 실행합니다. Grain cleanup은 Off / Light / Medium / Strong의 4단계가 있으며 기본값은 Off입니다. 다른 H3 Image LoRA는 LoRA Loader에 연결하세요
리스크 및 제한 사항
- 진입 장벽이 높음: 첫 실행 시 약 38 GB의 모델을 로드해야 합니다(메인 모델 int8 버전 21.0 GB 또는 w4a8 버전 12.5 GB, 텍스트 인코더 15.7 GB, VAE 1.2 GB, Fast 옵션은 추가로 1.96 GB의 pDMD LoRA 필요). 저자가 제시한 처리 시간은 모두 RTX 5090 기준이며, Fast 옵션으로 약 14초당 1장 생성됩니다
- 후면 뷰와 완성된 다리/발 부분은 모델이 추론한 결과로, 실행마다 다를 수 있습니다. 저자는 사진으로만 테스트했으며, 흐릿한 사진은 흐릿한 결과물을 생성한다고 주장합니다. 단일 뷰로 분리할 경우 두 뷰가 겹치면 서로 약간의 영향을 미칠 수 있습니다
- 워크플로우 라이선스는 사이트 내 대여만 포함합니다. 기본 모델은 MiniMax-H3-Image 커뮤니티 라이선스의 제약을 받으며, 저자는 상업적 사용 전 라이선스를 반드시 확인하라고 조언합니다
추천 (1)
【A】DC Vast Expanse · v1.0 [MinimaxH3Image]
LoRA · 이식 · 저자 dkpc69 · 게시일 11-21 20:17 · 다운로드 수 15
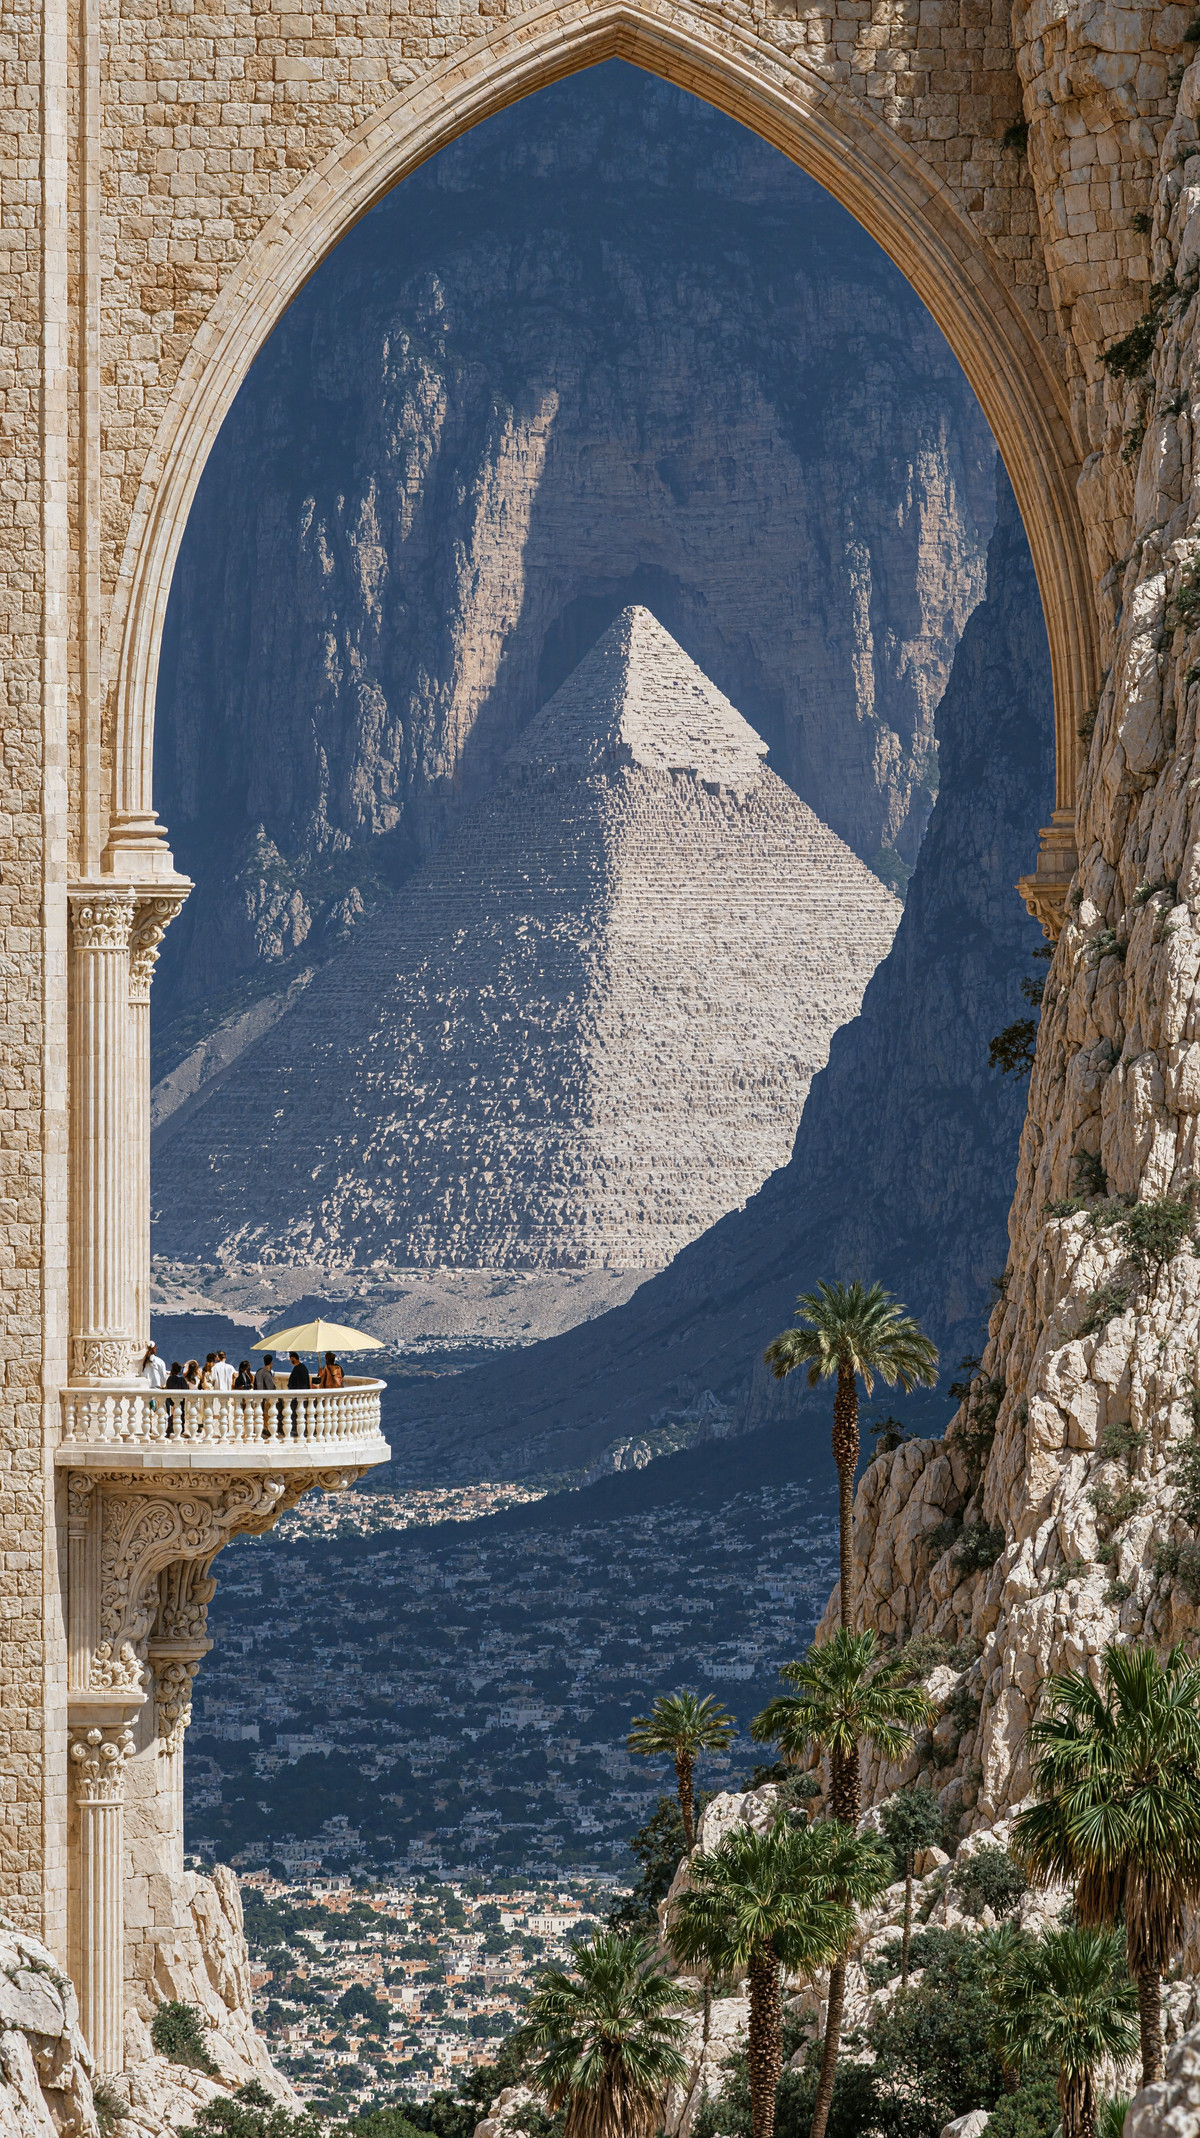
대규모 장면 스타일 LoRA: 강한 대비, 웅장한 스케일감, 강한 명암을 특징으로 하며, 저자는 인물 및 패션 스타일 사진에도 적합하다고 주장합니다. Krea 2 버전에서 H3 Image로 이식되었습니다.
예시 이미지
추천 이유
- 이식: 이전에 Krea 2(Krea2Raw) 버전이 있었으며, 448장의 Midjourney 무드보드 이미지로 학습되었습니다. H3 Image 버전은 동일한 데이터셋을 사용하되 1536 및 2048 해상도에서만 학습되었으며, 10,000 단계, Rank32로 학습되었고, 파일명에 GPT4.1 태깅이 명시되어 있습니다
- 트리거 워드가 명확하며, 가시적인 예제 이미지 15장이 포함되어 있습니다. 저자는 예제 이미지에 ComfyUI 워크플로우가 내장되어 있어 드래그하여 그대로 재현할 수 있다고 주장합니다
- 전체 모델 페이지 다운로드 수 2418회, 좋아요 273개(관심도 참고용); 이 버전은 게시 후 약 1시간 만에 다운로드 15회, 좋아요 6개
사용 방법
- 프롬프트에 트리거 워드 DCVSTEXP.(마침표 포함)를 입력하세요. 저자는 4K 해상도로 생성하고, 해상도는 높을수록 좋다고 권장합니다
- 강도에 대한 기본값은 저자가 제시하지 않았습니다. 원경의 얼굴에 문제가 발생할 경우 0.7–0.8으로 낮추세요. 효과가 너무 강할 경우에도 강도를 약간 낮춰 기본 모델이 주도하도록 할 수 있습니다. 단계 수와 샘플러는 저자가 제시하지 않았으므로, 예제 이미지에 내장된 워크플로우를 참고하세요
리스크 및 제한 사항
- 저자 스스로 H3 Image 버전의 원경 얼굴 품질이 매우 나쁘다고 언급했으며, 1024 해상도로 학습하지 않았기 때문이라고 추정합니다
- 학습 데이터셋은 Midjourney 생성 이미지이며, 스타일은 두 명의 X / Instagram 크리에이터와 유사합니다. 5개의 민감도 등급 예제는 숨겨져 있습니다
- 저자는 다른 생성 사이트로 융합하거나 공유할 때 자신의 Civitai 홈 페이지를 명시할 것을 요구합니다
트리거 워드: DCVSTEXP.
주목할 만함 (3)
【B】MiniMax H3 Image: Dual Pose Director - Manual VNCCS Skeleton Posing (ComfyUI) · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-21 10:05 · 다운로드 수 23
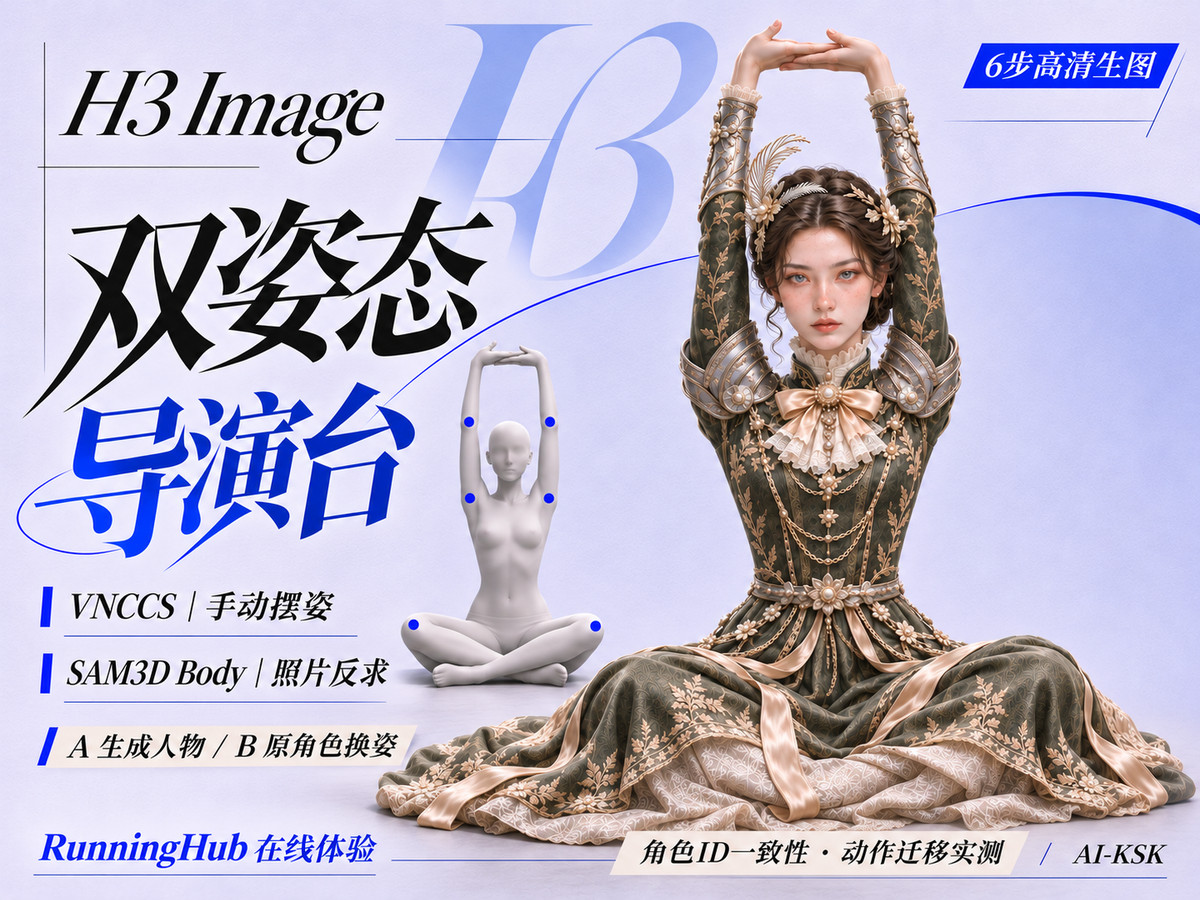
AIKSK의 H3 Image 수동 포즈 지정 ComfyUI 워크플로우: VNCCS 3D 스켈레톤을 사용하여 수동으로 포즈를 지정하고 조건으로 사용하며, 동시에 참조 이미지 한 장을 사용하여 인물 신원을 유지하고, 6 단계로 고해상도 이미지를 생성합니다.
예시 이미지
추천 이유
- 새로운 워크플로우(새로운 가중치가 아님): 기본 모델이 Flux.1 D로 잘못 표기되었으나, 이름, 설명, 의존성 파일명은 모두 H3 Image이므로 이 섹션에 포함됩니다
- 정확한 동작 제어가 필요한 캐릭터 이미지 생성에 유용: 스켈레톤으로 포즈를 지정하고 참조 이미지로 인물을 지정합니다. 이는 프로그램의 A 분기이며, B 분기(SAM3D를 사용하여 사진에서 포즈를 역추적)는 온라인 체험만 가능하고 다운로드 가능한 JSON이 없습니다
- 가시적인 예제 이미지 1장 포함; 저자는 한계를 명시했습니다: 극단적인 포즈에서는 신원이 변형될 수 있으며, 6 단계에서는 여러 번 실행해야 할 수 있습니다
사용 방법
- VNCCS 스켈레톤 관련 노드를 설치하고 JSON을 불러오세요. minimax_h3_image_pruned_int8_convrot, minimax_h3_image_vae_fp16, qwen3.5_9b_w4a8_gptq, qwen3vl_32b_minimax_h3_int8_convrot의 4개 파일을 직접 다운로드하세요
- 스켈레톤을 배치하고 인물 참조 이미지를 연결한 후 6 단계로 실행하세요. CFG 및 VRAM 요구 사항은 저자가 제시하지 않았습니다
리스크 및 제한 사항
- 원본 워크플로우에 내장된 모션 캡처 이미지가 라이선스 불명으로 인해 제거되고 플레이스홀더로 대체되었으므로, 직접 채워 넣어야 합니다
- 라이선스는 어떠한 상업적 사용 및 파생 작업도 허용하지 않습니다. 온라인 체험 링크에는 저자의 초대 코드가 포함되어 있습니다
- VNCCS 노드와 32B 비전 언어 인코더에 의존하며, 구체적인 노드 버전은 저자가 명시하지 않았습니다
【B】Epic Seven Sprites · Sprites v2.0 MiniMax Img
LoRA · 이식 · 저자 iPiKo · 게시일 11-21 15:25 · 다운로드 수 22
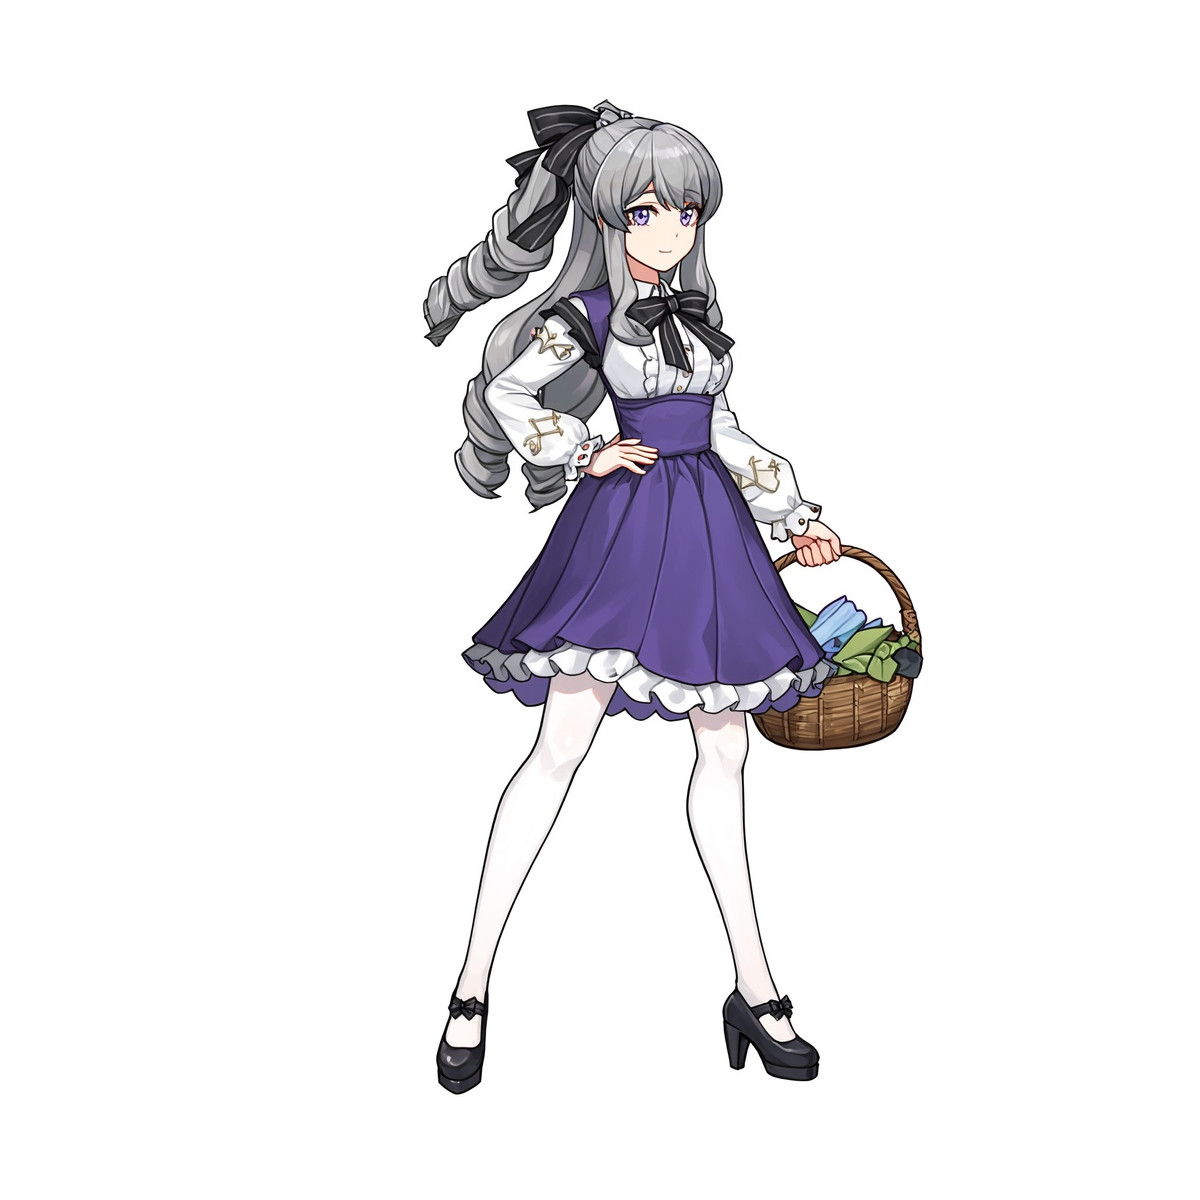
모바일 게임 '세븐나이츠'의 전투 일러스트 스타일을 재현하는 LoRA: 깔끔한 윤곽선, 전신, 게임 내 대기 포즈, 흰색 배경; V2 시리즈의 H3 Image 버전입니다.
예시 이미지
추천 이유
- 이식: V2 동일 페이지에는 이미 Illustrious, Anima, Krea 2 버전이 있으며, 305장의 흰색 배경 여성 영웅 일러스트로 학습되었습니다. H3 Image 버전의 파일명에는 base, 에폭 10이 명시되어 있으나, 모델 카드에는 이 버전과 다른 버전의 차이점이 기술되어 있지 않습니다
- 게임 아트 및 2D 캐릭터 일러스트에 유용: 측면은 전형적인 전투 각도이며, 3/4 측면은 의상을 더 잘 보여줍니다
- 가시적인 예제 이미지 1장 포함; 전체 모델 페이지 다운로드 수 844회, 좋아요 130개(관심도 참고용)
사용 방법
- 모델 카드에는 V2 각 버전의 트리거 워드가 모두 e7battlesprite라고 적혀 있습니다(이 버전의 API에는 트리거 워드가 등록되지 않음). H3 Image에는 별도의 프롬프트 작성법이 없으므로, Krea 2의 자연어 작성법을 참고할 수 있습니다: 먼저 “A full-body game sprite in the e7battlesprite style shows a female hero standing in side view against a plain white background.”라고 작성한 후 캐릭터를 설명하세요
- 저자는 정사각형 캔버스를 사용하고 전신 흰색 배경을 요구할 것을 권장합니다. 강도와 단계 수는 저자가 제시하지 않았습니다
리스크 및 제한 사항
- 트리거 워드가 등록되지 않았으며, H3 Image 버전의 파라미터 및 프롬프트 규칙이 모델 카드에 기술되어 있지 않습니다
- 여성 영웅만으로 학습되었으며, 남성 및 몬스터 디자인은 저자가 실험적이라고 주장합니다
- 상업용 게임 아트 스타일을 모방하므로, 상업적 사용 전 원작의 저작권을 주의하세요
【B】MiniMax H3-Image: 16-image reference edit at 4K (ComfyUI) · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시 11-21 18:42 · 다운로드 16
AIKSK의 H3 Image 다중 참조 이미지 편집 ComfyUI 워크플로우: 한 번의 편집에서 최대 16장의 참조 이미지를 조건으로 사용하여 캐릭터나 제품 세트 이미지가 다양한 각도에서도 일관성을 유지하도록 하며, 4K 출력, 6 스텝을 지원합니다.
예시 이미지
추천 이유
- 신규 워크플로우(신규 가중치 아님): 기본 모델이 Flux.1 D로 잘못 표기되었으나, 이름, 설명, 태그 모두 H3 Image이므로 이 섹션에 포함됨
- 캐릭터/제품의 다각도 일관성 있는 이미지 생성 지원; 48개의 노드, 저자는 1~2장의 이미지만 사용할 경우 단일 이미지 분기를 사용하도록 권장
- 설명이 매우 짧음: 의존성 파일 목록이 없고, 눈에 보이는 예시도 없음
사용 방법
- JSON을 불러오고 참조 이미지(최대 16장)를 연결한 후 6 스텝을 실행하여 4K 해상도로 출력; 가중치 파일은 동봉되지 않으며, 구체적인 파일명은 모델 카드에 명시되지 않음
- CFG 및 VRAM 요구 사항은 저자가 제공하지 않음; 저자는 참조 이미지 수가 증가함에 따라 메모리 사용량과 처리 시간이 증가한다고 언급
리스크 및 제한 사항
- 모든 예시가 민감한 등급(1개는 숨겨짐)이므로 효과를 미리 볼 수 없음
- 라이선스로 인해 어떠한 상업적 사용이나 파생 작업도 허용되지 않음; 온라인 체험 링크에는 저자의 초대 코드가 포함됨
- 의존하는 노드와 모델은 사용자가 직접 확인해야 함
- 카드의 예시 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아님; 저자는 일반 등급의 공개 예시를 제공하지 않음
참고용만 수록 (2)
- [H3 image]pwni style · v1.0 — LoRA: pwni style이라는 이름의 실험적 애니메이션 스타일 LoRA로, H3 Image pruned int8 버전에서 학습된 첫 테스트 버전이며, 구체적인 스타일 특징은 모델 카드에 명시되지 않음.
- Text to image: MiniMax H3-Image 4K in 6 steps (ComfyUI) · v1.0 — 워크플로우: AIKSK의 H3 Image 기본 텍스트-이미지 생성 ComfyUI 워크플로우: 6개의 노드로 구성되며, 프롬프트 입력, 6 스텝 샘플링, 네이티브 4K(약 16.8 MP) 이미지 생성.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-21 08:31 → 11-21 21:01(베이징 시간). 추천 이유는 편집자 검수를 거쳤으며, 다운로드 수는 단지 관심도를 나타냅니다.