Radar AI của Trinh Trinh · MiniMax H3 Image · Bản tin buổi tối 2026-11-21
Kỳ này có 7 phiên bản mới:强烈推荐 1 · 推荐 1 · 可关注 3 · 仅收录 2
Lời bình của biên tập viên Kỳ này đã xem xét 7 phiên bản mới của H3 Image, gồm 1 xếp hạng S, 1 xếp hạng A, 3 xếp hạng B, 2 xếp hạng C, không có loại trừ. Ưu tiên hàng đầu là quy trình làm việc tạo bảng nhân vật của AusBoss: tải lên một bức ảnh chân dung, vẽ ra bốn góc nhìn (chính diện, ba phần tư, bên hông, phía sau) trong một lần, có thể bổ sung toàn thân, thêm cận cảnh đầu hoặc hàng biểu cảm. DC Vast Expanse là LoRA phong cảnh quy mô lớn được chuyển đổi từ Krea 2, xếp hạng A; ba quy trình làm việc của AIKSK (6 bước tạo ảnh từ văn bản 4K, định tư thế bằng khung xương, chỉnh sửa tham chiếu 16 ảnh) có mô hình cơ sở được đánh dấu là Flux.1 D, xác nhận là dành cho H3 Image, nhưng ít ví dụ và phụ thuộc nặng, xếp hạng B / C.
强烈推荐 (1)
【S】MiniMax H3 Image Character Sheet | 16 MP Turnaround Từ Một Bức Ảnh · v1.1
Quy trình làm việc · Mô hình mới · Tác giả AusBoss · Phát hành 11-21 11:10 · Tải xuống 154
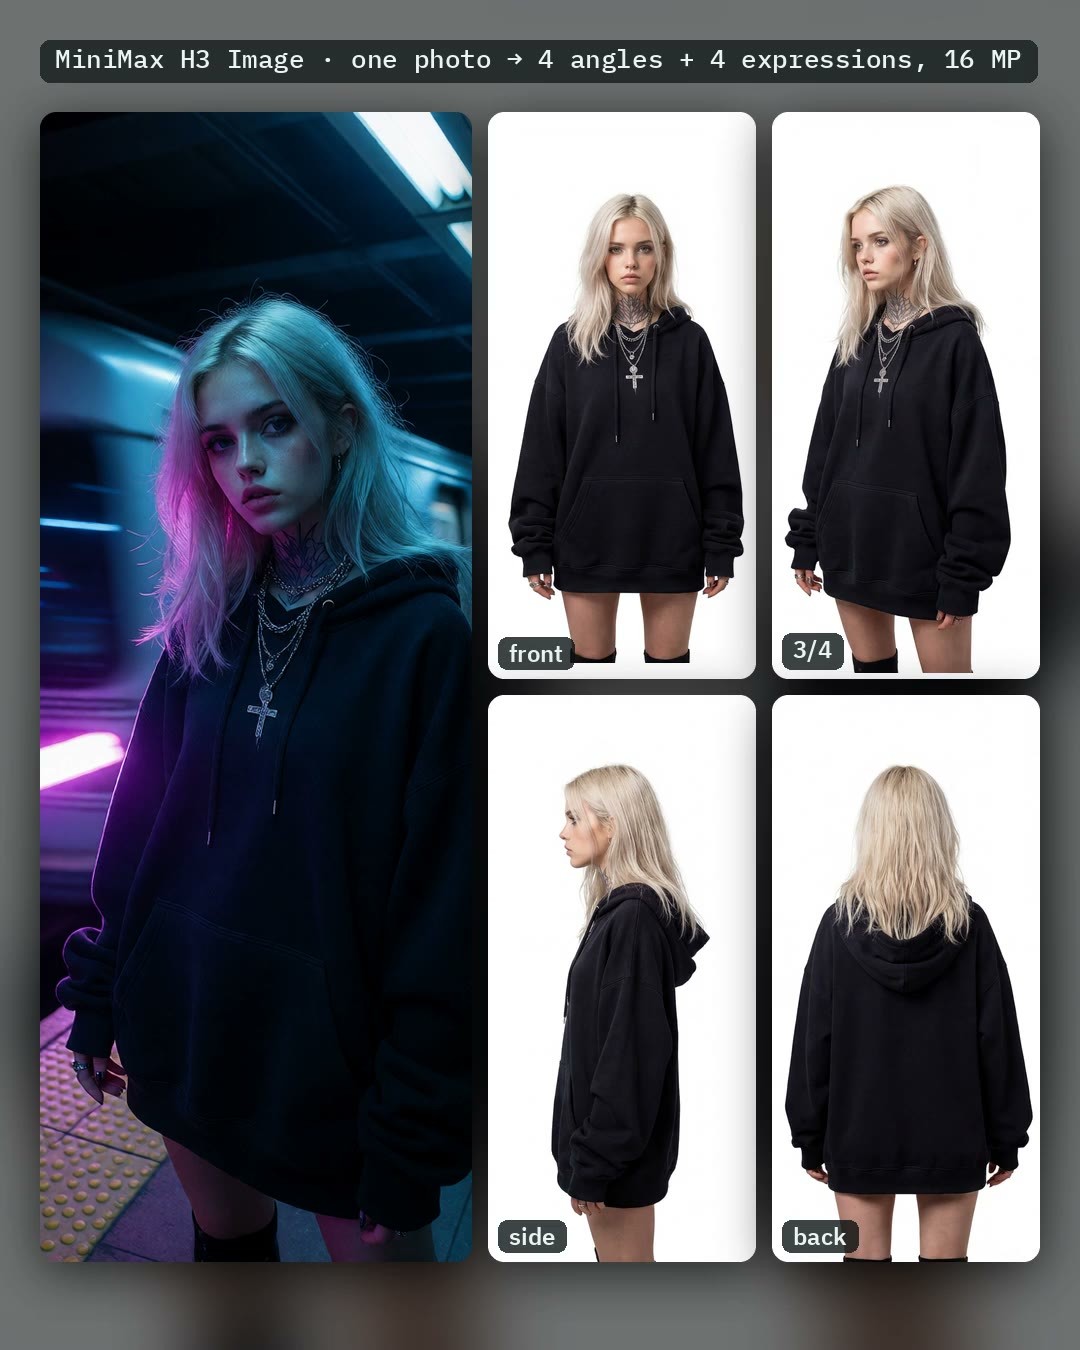
Quy trình làm việc ComfyUI của AusBoss: tải lên một bức ảnh chân dung, H3 Image vẽ ra bảng nhân vật với bốn góc nhìn (chính diện, ba phần tư, bên hông, phía sau) của cùng một người trong một lần, tối đa 16 MP (5504 × 3040), không cần phóng to thêm.
Tạo ra một bộ bảng nhân vật đa góc nhìn từ một bức ảnh, các công tắc và tệp phụ thuộc đều được ghi rõ, ưu tiên hàng đầu kỳ này.
Hình minh họa
Lý do đề xuất
- Công cụ mới: Tác giả trước đây đã sử dụng mô hình video H3 để tạo bảng nhân vật, phiên bản này chuyển sang mô hình hình ảnh H3 Image, tác giả cho biết đầu ra tăng từ khoảng 5 MP lên 16 MP, thời gian xử lý giảm khoảng một nửa; phục vụ thiết kế nhân vật, ảnh tham chiếu nhân vật nhất quán, chuẩn bị tài liệu đa góc nhìn cho LoRA / video sau này
- Đủ công tắc: Head to toe bổ sung toàn thân từ ảnh nửa người xuống đến giày; Save each view too lưu mỗi góc nhìn thành một ảnh riêng; Your photo on the left ghép ảnh gốc vào bên trái; Close-ups under the sheet chạy thêm một lần để thêm một hàng gồm bốn cận cảnh đầu (toàn bộ ảnh trở thành 5504 × 4416), cũng có thể thay bằng bốn biểu cảm
- Kèm theo 1 đoạn video mẫu + 2 ảnh mẫu; tải xuống miễn phí; phát hành khoảng 10 giờ với 154 lượt tải xuống, 12 lượt thích (chỉ cho biết mức độ quan tâm)
Cách sử dụng
- Trước tiên cài đặt ComfyUI 0.45.0 hoặc cập nhật, AusBoss nodes 2.26.5 hoặc cập nhật (cài phiên bản nightly trước khi được phê duyệt trên Registry); tải lên một bức ảnh chân dung rõ ràng và chạy trực tiếp, nền và "các phần không chụp trong ảnh" (ví dụ: blue jeans and white sneakers) là tùy chọn, để trống nền sẽ là màu trắng tinh
- Chọn Size là 4 / 8 / 16 MP (tác giả cho biết 16 MP mất khoảng 25 giây, 4 MP mất khoảng 11 giây); chọn Body là Short / Regular / Tall để kiểm soát chiều cao của nhân vật trong các góc nhìn; chọn VRAM là High (int8, card 32 GB) hoặc Low (w4a8, card 24 GB)
- Fast sử dụng LoRA pDMD của akhaliq để chạy 2 bước thay vì 6 bước mặc định; Grain cleanup có bốn mức Off / Light / Medium / Strong, mặc định là tắt; các LoRA H3 Image khác được nối vào LoRA Loader
Rủi ro và hạn chế
- Ngưỡng cao: Lần chạy đầu tiên cần tải khoảng 38 GB mô hình (mô hình chính phiên bản int8 21.0 GB hoặc phiên bản w4a8 12.5 GB, bộ mã hóa văn bản 15.7 GB, VAE 1.2 GB, Fast cần thêm LoRA pDMD 1.96 GB); thời gian xử lý do tác giả cung cấp đều từ RTX 5090, Fast mất khoảng 14 giây mỗi ảnh
- Phía sau và chân tay được bổ sung là do mô hình suy đoán, có thể khác nhau sau mỗi lần chạy; tác giả cho biết chỉ kiểm tra bằng ảnh, ảnh mờ sẽ cho ra ảnh mờ; khi tách thành các góc nhìn đơn lẻ, nếu hai góc nhìn dính nhau sẽ lẫn một chút vào nhau
- Giấy phép quy trình làm việc chỉ bao gồm cho thuê trên trang web; mô hình cơ sở chịu ràng buộc của giấy phép cộng đồng MiniMax-H3-Image, tác giả nhắc nhở đọc kỹ trước khi sử dụng thương mại
推荐 (1)
【A】DC Vast Expanse · v1.0 [MinimaxH3Image]
LoRA · Chuyển đổi · Tác giả dkpc69 · Phát hành 11-21 20:17 · Tải xuống 15
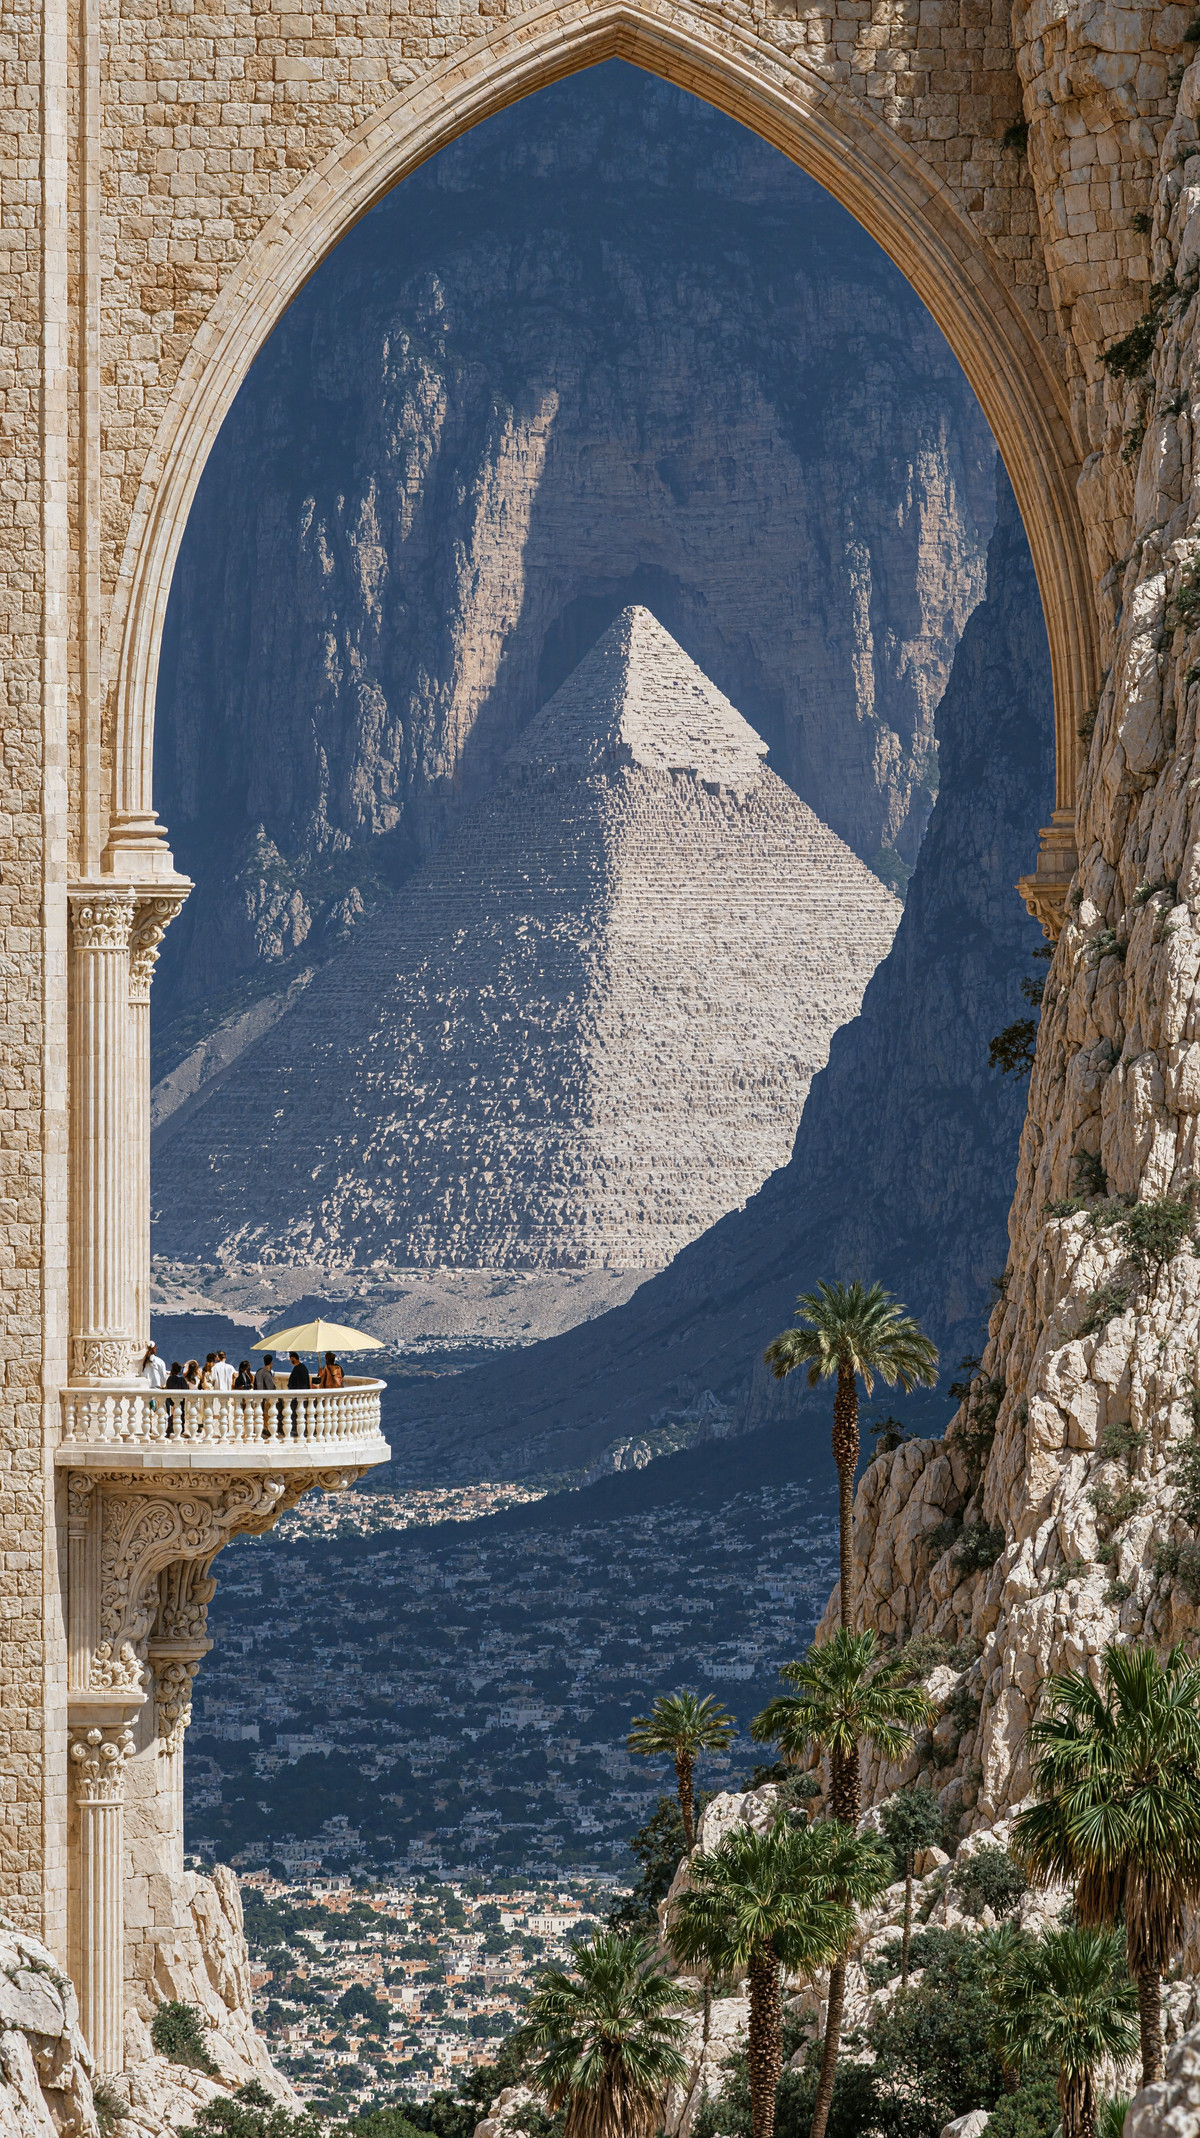
LoRA phong cảnh quy mô lớn: tương phản mạnh, cảm giác quy mô hùng vĩ, ánh sáng và bóng đổ mạnh, tác giả cho biết cũng phù hợp với ảnh chân dung và phong cách thời trang; chuyển đổi từ phiên bản Krea 2 sang H3 Image.
Hình minh họa
Lý do đề xuất
- Chuyển đổi: Trước đây có phiên bản Krea 2 (Krea2Raw), được huấn luyện bằng 448 ảnh moodboard Midjourney; phiên bản H3 Image sử dụng cùng bộ dữ liệu, chỉ huấn luyện ở độ phân giải 1536 và 2048, 10,000 bước, Rank32, tên tệp đánh dấu GPT4.1 tagging
- Từ khóa kích hoạt rõ ràng, kèm theo 15 ảnh ví dụ có thể xem; tác giả cho biết các ảnh ví dụ đều nhúng quy trình làm việc ComfyUI, có thể kéo trực tiếp vào để tái tạo theo
- Toàn bộ trang mô hình có 2418 lượt tải xuống, 273 lượt thích (chỉ cho biết mức độ quan tâm); phiên bản này phát hành khoảng 1 giờ với 15 lượt tải xuống, 6 lượt thích
Cách sử dụng
- Viết từ khóa kích hoạt DCVSTEXP. (bao gồm dấu chấm) vào prompt, tác giả đề xuất xuất ảnh ở 4K, độ phân giải càng cao càng tốt
- Tác giả không cung cấp giá trị mặc định cho cường độ; nếu khuôn mặt ở xa gặp vấn đề, giảm xuống 0.7–0.8, nếu hiệu ứng quá mạnh cũng có thể giảm nhẹ để mô hình cơ sở tiếp quản; tác giả không cung cấp số bước và bộ lấy mẫu, có thể tham khảo quy trình làm việc nhúng trong ảnh ví dụ
Rủi ro và hạn chế
- Tác giả tự nói rằng phiên bản H3 Image có khuôn mặt ở xa rất kém, nghi ngờ là do không huấn luyện ở độ phân giải 1024
- Bộ dữ liệu huấn luyện là ảnh do Midjourney tạo ra, phong cách gần với hai nhà sáng tạo X / Instagram; 5 ví dụ nhạy cảm đã bị ẩn
- Tác giả yêu cầu ghi rõ trang chủ Civitai của họ khi pha trộn hoặc chuyển tiếp sang các trang tạo sinh khác
Từ khóa kích hoạt: DCVSTEXP.
可关注 (3)
【B】MiniMax H3 Image: Dual Pose Director - Manual VNCCS Skeleton Posing (ComfyUI) · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-21 10:05 · Tải xuống 23
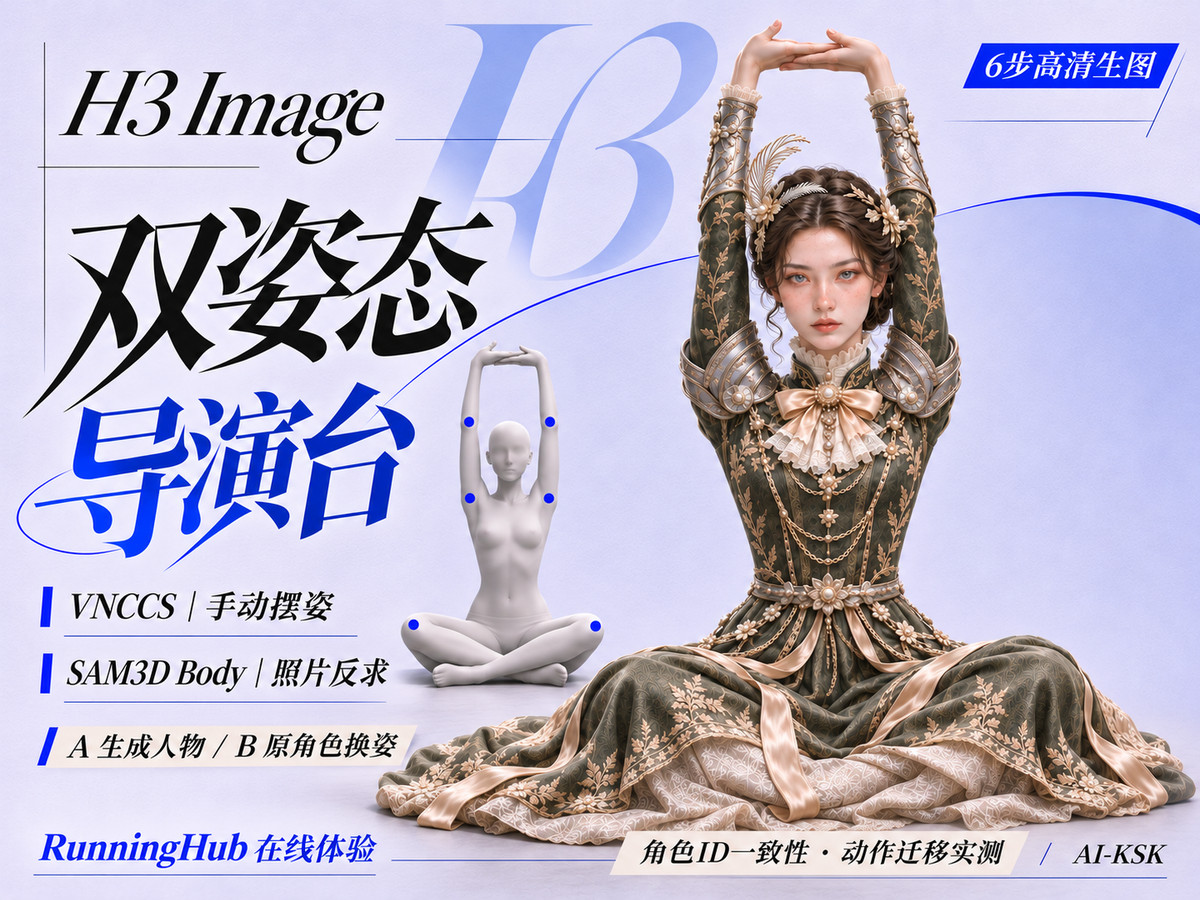
Quy trình làm việc ComfyUI tạo tư thế thủ công H3 Image của AIKSK: sử dụng khung xương VNCCS 3D để đặt tư thế thủ công làm điều kiện, đồng thời sử dụng một ảnh tham chiếu để giữ danh tính nhân vật, xuất ảnh độ phân giải cao trong 6 bước.
Hình minh họa
Lý do đề xuất
- Quy trình làm việc mới (không phải trọng số mới): Mô hình cơ sở bị đánh dấu nhầm là Flux.1 D, nhưng tên, mô tả, tên tệp phụ thuộc đều là H3 Image, được xếp vào mục này
- Phục vụ xuất ảnh nhân vật cần kiểm soát động tác chính xác: khung xương định tư thế, ảnh tham chiếu định nhân vật; đây là nhánh A của chương trình, nhánh B (SAM3D suy ngược tư thế từ ảnh) chỉ có trải nghiệm trực tuyến, không có JSON có thể tải xuống
- Kèm theo 1 ảnh ví dụ có thể xem; tác giả ghi rõ hạn chế: danh tính sẽ trôi dạt ở các tư thế cực đoan, 6 bước có thể cần chạy nhiều lần
Cách sử dụng
- Cài đặt các nút liên quan đến khung xương VNCCS, tải lên JSON; tự tải xuống bốn tệp minimax_h3_image_pruned_int8_convrot, minimax_h3_image_vae_fp16, qwen3.5_9b_w4a8_gptq, qwen3vl_32b_minimax_h3_int8_convrot
- Đặt khung xương, kết nối ảnh tham chiếu nhân vật rồi chạy 6 bước; tác giả không cung cấp CFG và yêu cầu VRAM
Rủi ro và hạn chế
- Ảnh động tác nhúng trong quy trình làm việc gốc đã bị gỡ bỏ do giấy phép không rõ ràng, được thay thế bằng trình giữ chỗ, cần tự bổ sung
- Giấy phép không cho phép bất kỳ mục đích thương mại và phái sinh nào; liên kết trải nghiệm trực tuyến kèm mã mời của tác giả
- Phụ thuộc vào các nút VNCCS và bộ mã hóa ngôn ngữ thị giác 32B, tác giả không ghi phiên bản nút cụ thể
【B】Epic Seven Sprites · Sprites v2.0 MiniMax Img
LoRA · Chuyển đổi · Tác giả iPiKo · Phát hành 11-21 15:25 · Tải xuống 22
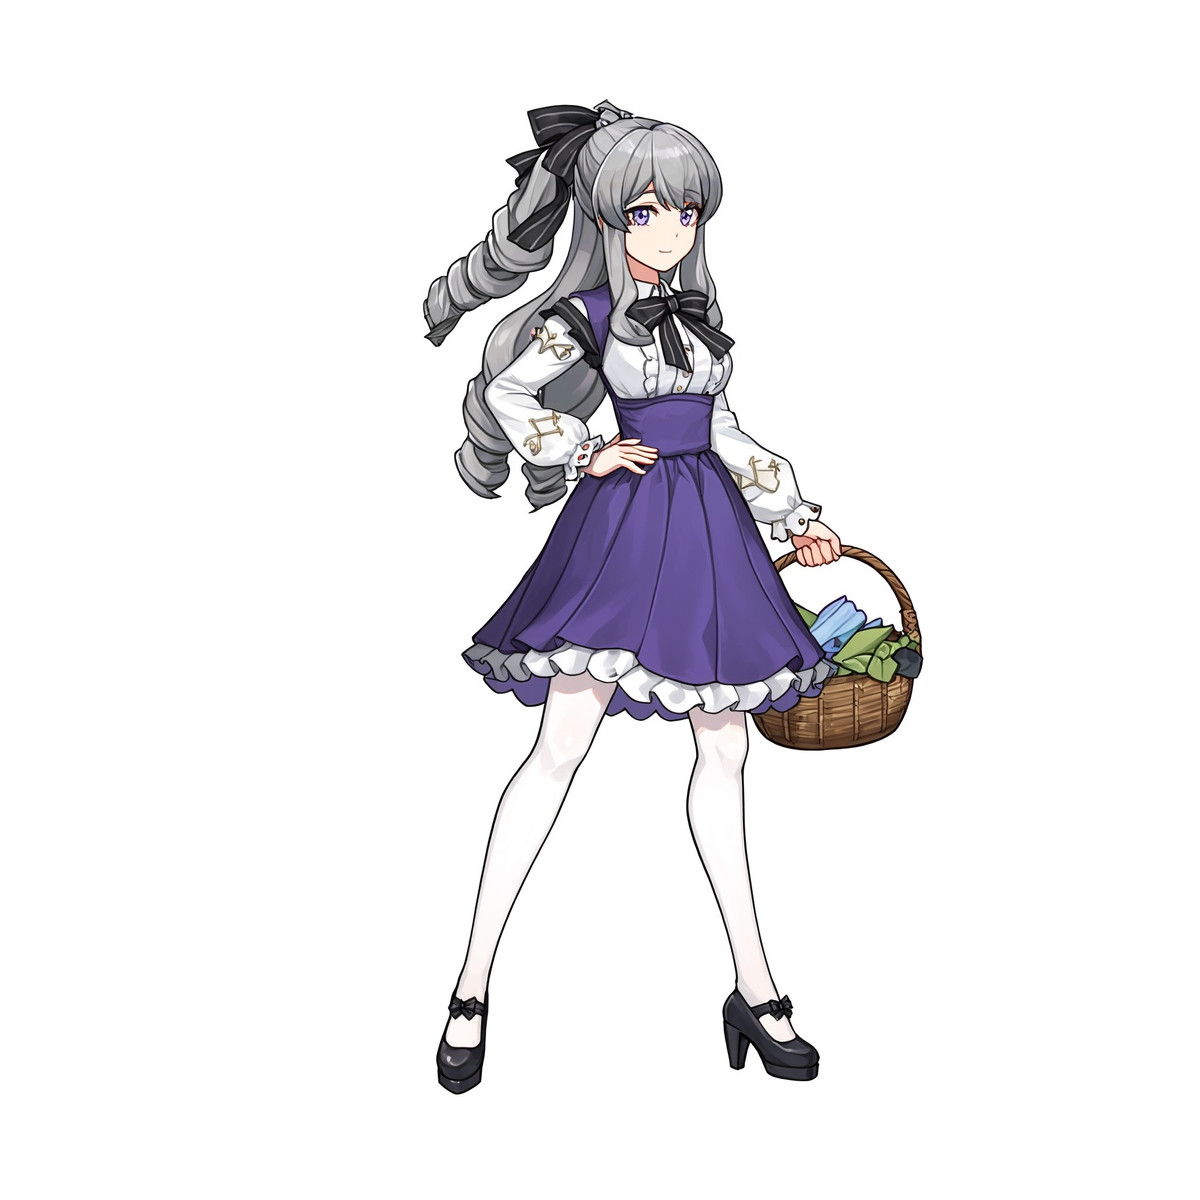
LoRA tái tạo phong cách vẽ chiến đấu của trò chơi di động "Epic Seven": đường viền sạch sẽ, toàn thân, tư thế chờ trong trò chơi, nền trắng; phiên bản H3 Image của loạt V2.
Hình minh họa
Lý do đề xuất
- Chuyển đổi: Trang V2 đã có các phiên bản Illustrious, Anima, Krea 2, được huấn luyện bằng 305 ảnh vẽ anh hùng nữ nền trắng; phiên bản H3 Image có tên tệp đánh dấu base, vòng thứ 10, thẻ mô hình không ghi sự khác biệt giữa phiên bản này và các phiên bản khác
- Phục vụ nghệ thuật trò chơi và vẽ nhân vật 2D: góc nhìn bên hông là góc chiến đấu cổ điển, góc ba phần tư có thể hiển thị nhiều trang phục hơn
- Kèm theo 1 ảnh ví dụ có thể xem; toàn bộ trang mô hình có 844 lượt tải xuống, 130 lượt thích (chỉ cho biết mức độ quan tâm)
Cách sử dụng
- Thẻ mô hình ghi rằng từ khóa kích hoạt của các phiên bản V2 đều là e7battlesprite (phiên bản này chưa đăng ký từ khóa kích hoạt trên API); H3 Image không có cách viết prompt riêng, có thể tham khảo cách viết ngôn ngữ tự nhiên của Krea 2: trước tiên viết “A full-body game sprite in the e7battlesprite style shows a female hero standing in side view against a plain white background.” sau đó mô tả nhân vật
- Tác giả đề xuất sử dụng khung hình vuông, yêu cầu toàn thân nền trắng; tác giả không cung cấp cường độ và số bước
Rủi ro và hạn chế
- Chưa đăng ký từ khóa kích hoạt, các tham số và quy tắc prompt của phiên bản H3 Image đều không được ghi trong thẻ mô hình
- Chỉ huấn luyện bằng anh hùng nữ, tác giả cho biết thiết kế nam giới và quái vật mang tính thử nghiệm
- Bắt chước phong cách nghệ thuật trò chơi thương mại, chú ý bản quyền tác phẩm gốc trước khi sử dụng thương mại
【B】MiniMax H3-Image: Chỉnh sửa tham chiếu 16 ảnh ở 4K (ComfyUI) · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-21 18:42 · Tải xuống 16
Quy trình làm việc ComfyUI chỉnh sửa đa ảnh tham chiếu H3 Image của AIKSK: một lần chỉnh sửa có thể sử dụng tối đa 16 ảnh tham chiếu làm điều kiện, giúp duy trì sự nhất quán cho nhân vật hoặc bộ ảnh sản phẩm ở các góc độ khác nhau, đầu ra 4K, 6 bước.
Hình minh họa
Lý do đề xuất
- Quy trình làm việc mới (không phải trọng số mới): mô hình cơ sở bị gắn nhãn nhầm là Flux.1 D, nhưng tên, mô tả và thẻ đều là H3 Image, nên được xếp vào mục này
- Phục vụ việc tạo ảnh nhất quán đa góc độ cho nhân vật / sản phẩm; 48 nút, tác giả lưu ý rằng nếu chỉ có một hoặc hai ảnh thì nên chuyển sang nhánh xử lý ảnh đơn
- Mô tả rất ngắn: không liệt kê tên tệp phụ thuộc, không có ví dụ hiển thị
Cách sử dụng
- Tải JSON, kết nối các ảnh tham chiếu (tối đa 16 ảnh) rồi chạy 6 bước để xuất ảnh 4K; trọng số không đi kèm, tác giả không liệt kê các tệp cụ thể trong thẻ mô hình
- Tác giả không cung cấp thông tin về CFG và yêu cầu VRAM; tác giả cho biết bộ nhớ và thời gian xử lý tăng theo số lượng ảnh tham chiếu
Rủi ro và hạn chế
- Tất cả ví dụ đều ở mức độ nhạy cảm (1 ví dụ đã bị ẩn), không thể xem trước hiệu quả
- Giấy phép không cho phép bất kỳ mục đích thương mại hay phái sinh nào; liên kết trải nghiệm trực tuyến kèm mã mời của tác giả
- Cần tự kiểm tra các nút và mô hình phụ thuộc
- Hình ảnh minh họa trên thẻ là hình minh họa do AI tạo, không phải hiệu quả thực tế của mô hình; tác giả không có ví dụ công khai ở mức độ bình thường
Chỉ liệt kê (2)
- [H3 image]pwni style · v1.0 — LoRA: LoRA phong cách anime thử nghiệm có tên pwni style, phiên bản thử nghiệm đầu tiên được huấn luyện trên phiên bản H3 Image pruned int8, thẻ mô hình không ghi rõ phong cách cụ thể là gì.
- Text to image: MiniMax H3-Image 4K trong 6 bước (ComfyUI) · v1.0 — Quy trình làm việc: Quy trình làm việc ComfyUI tạo ảnh từ văn bản cơ bản H3 Image của AIKSK: sáu nút, nhập lời nhắc, lấy mẫu 6 bước, xuất ảnh 4K gốc (khoảng 16.8 MP).
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ thu thập từ 11-21 08:31 → 11-21 21:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.