Radar IA de Zhenzhen · MiniMax H3 · Édition du soir 2026-11-02
Cette édition compte 23 nouvelles versions : fortement recommandé 1 · recommandé 2 · à suivre 9 · inclus uniquement 11
Note de l'éditeur Cette édition examine 23 nouvelles versions de H3. Première recommandation : le curseur de quantité KinetiX : sans mot-clé de déclenchement, il contrôle la quantité d'objets à l'écran (épées volantes, flèches, talismans, etc.) via l'intensité positive/négative du LoRA, avec des paliers d'intensité et des exemples de prompts complets. Le pack de nœuds open source H3MD Director génère des vidéos longues de 2 à 3 minutes en une seule exécution, et le workflow de fiche de personnage v1.1 ajoute des gros plans de tête et des lignes d'expressions, tous deux notés A. AIKSK a publié 14 workflows : les 7 avec des paramètres clairs (multi-références, rendu haute définition, quatre-en-un première/dernière image) sont notés B, les 7 quasi-doublons, avec seulement des statistiques de nœuds ou des contradictions dans les paramètres de tâche, sont notés C ; deux LoRAs de personnages fictifs ont des descriptions trop légères et sont dégradés en C.
Fortement recommandé (1)
【S】KinetiX Instance Quantity Density Slider · v1.0
LoRA · Nouveau modèle · Auteur make676767 · Publié le 11-02 14:59 · Téléchargements 77
Un LoRA de type curseur pour contrôler « la quantité d'objets volants/invocations à l'écran » : les valeurs positives augmentent les épées volantes, flèches, shurikens, talismans, etc., de quelques unités à un véritable déluge, tandis que les valeurs négatives verrouillent l'image sur un seul sujet principal, éliminant les copies superflues.
Maintien du S : le contrôle de la quantité est difficile à réaliser précisément avec les prompts de H3, mais les paliers d'intensité et les exemples de prompts sont complets et applicables directement ; le point de pénalité vient du fait que les exemples visibles n'indiquent pas l'intensité utilisée.
Illustration
Raisons de la recommandation
- Nouveau modèle : sert les grandes scènes difficiles à contrôler en termes de quantité dans la génération vidéo texte-à-vidéo, comme « mille épées en vol, pluie de flèches, tempête d'armes cachées », et peut aussi inverser l'effet en utilisant des valeurs négatives pour supprimer les ailiers, les doubles et les images fantômes générés aléatoirement par le modèle de base
- L'auteur fournit des paliers d'intensité complets : de +0.5 à +1.0, une arme se divise en 5 à 10 unités ; de +1.2 à +2.0, c'est le palier de formation ordonnée recommandé par l'auteur ; de +3.0 à +5.0, c'est le déluge ; de -2.0 à -4.0, cela verrouille un seul sujet principal. Il inclut également 4 prompts de scène bilingues chinois-anglais prêts à copier (+2.5, +3.0, -2.5, +2.5)
- Gratuit, la licence permet la vente ; 6 heures après la publication, 77 téléchargements et 10 likes (indiquant uniquement le niveau d'attention)
Comment l'utiliser
- Aucun mot-clé de déclenchement nécessaire, le contrôle se fait purement via l'intensité du LoRA (strength_model) ; commencez par +1.2 à +2.0, augmentez au-delà de +3.0 pour un effet de déluge, et utilisez -2.0 à -4.0 pour « un seul sujet »
- Dans le prompt, précisez toujours le type d'objet (flying swords, arrows, paper talismans, etc.), vous pouvez utiliser directement les 4 prompts de scène fournis par l'auteur ; le nombre de pas, le CFG et l'échantillonneur ne sont pas spécifiés par l'auteur
Risques et limitations
- Les exemples visibles ne contiennent que 2 vidéos sans prompts ni intensité associés, ce qui ne permet pas de voir les différences réelles entre les paliers ; 4 exemples de niveau sensible sont masqués
- L'auteur n'a pas indiqué les données d'entraînement ni la méthode d'entraînement ; les effets secondaires potentiels de la valeur négative « verrouillage d'un seul sujet » sur les groupes de personnages ne sont pas expliqués ; cette entrée n'a pas visionné les vidéos ni exécuté le modèle
Recommandé (2)
【A】MiniMax H3 Character Sheet | Turnaround From One Photo · v1.1
Workflow · Mise à jour de version · Auteur AusBoss · Publié le 11-02 13:21 · Téléchargements 237
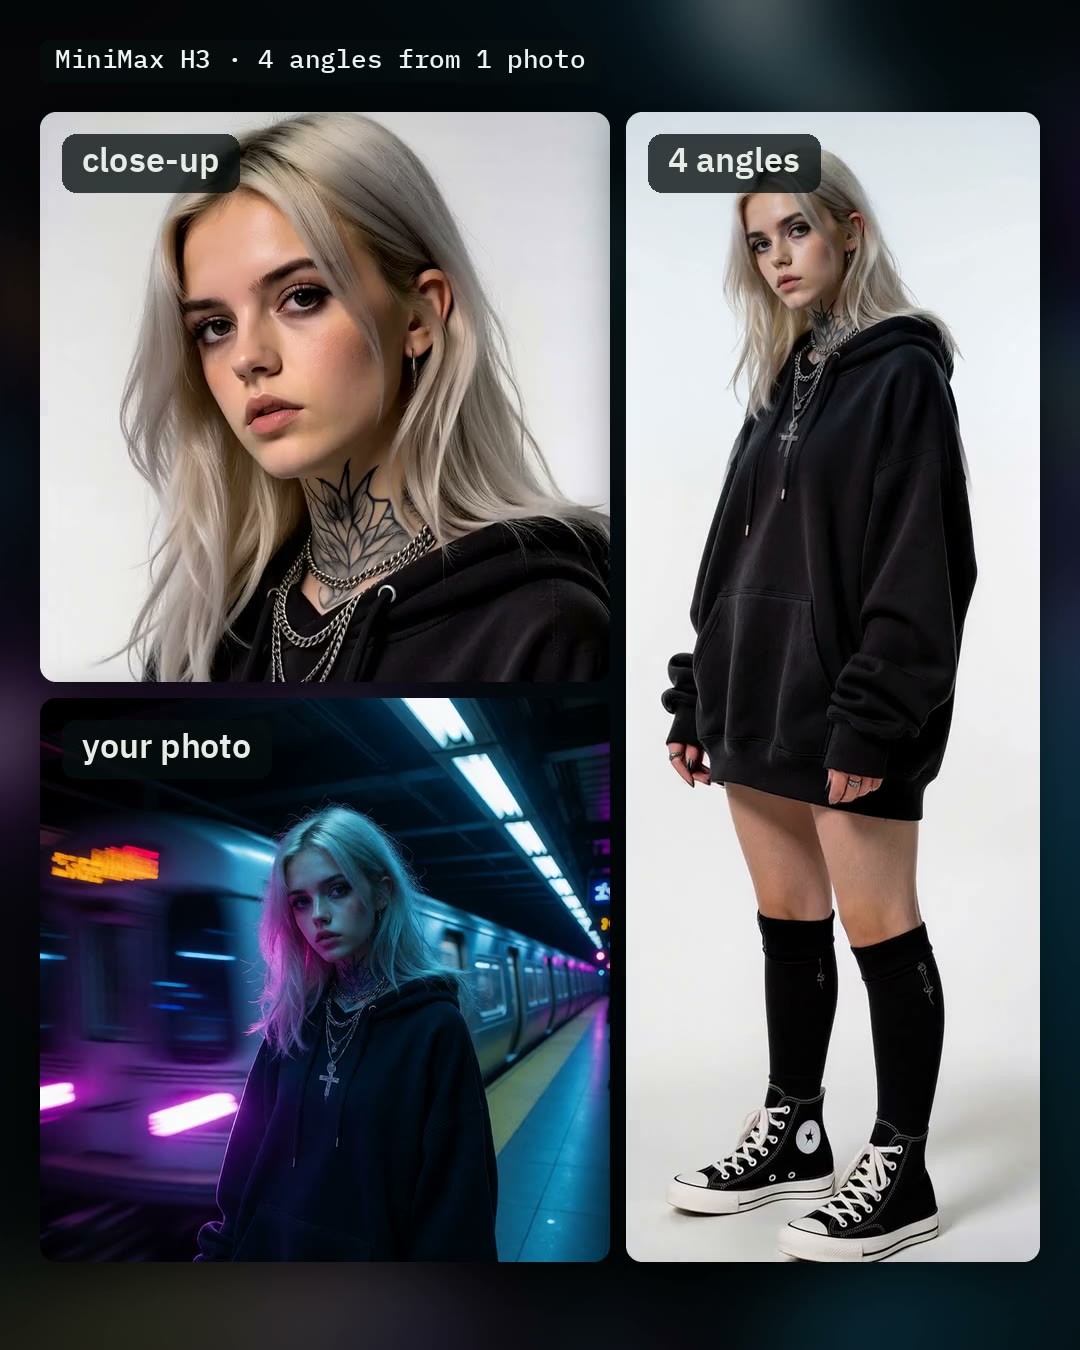
Une photo de personne entre dans ComfyUI, H3 génère une fiche de personnage avec quatre vues (face, trois-quarts, profil, dos) de la même personne (image statique) ; la v1.1 ajoute des lignes optionnelles de gros plans de tête, des lignes d'expressions et une retouche faciale.
Maintien du A : les nouveaux interrupteurs sont des modifications concrètes, désactivés par défaut sans affecter les usages anciens, les exemples et les dépendances sont clairement écrits ; pas de promotion au S car il s'agit d'une petite mise à jour incrémentale, et la taille du modèle ainsi que les restrictions géographiques de licence constituent des barrières pratiques.
Illustration
Raisons de la recommandation
- Mise à jour de version : trois nouveaux interrupteurs ajoutés, tous désactivés à l'ouverture du fichier, la sortie est identique à la v1.0 lorsqu'ils sont tous désactivés — « Close-ups under the sheet » ajoute une ligne de quatre gros plans de tête sous la fiche de personnage (H3 effectue une passe supplémentaire, environ 70 secondes de plus) ; « Expressions instead of head turns » remplace cette ligne par quatre expressions, modifiables individuellement dans les quatre cadres ; « Redraw the faces » fait passer H3 une seconde fois sur la partie supérieure pour rendre les petits visages plus nets (environ 75 secondes de plus)
- Sert à créer des références multi-angles cohérentes à partir de photos réelles, puis à les utiliser comme images de référence pour la génération vidéo de H3 ; les fonctionnalités existantes sont conservées : arrière-plan personnalisable, possibilité de compléter les parties non photographiées (l'auteur indique que « blue jeans and white sneakers » peut compléter un buste en corps entier), l'interrupteur Fast utilise 10 pas au lieu de 18, et l'Upscale 2x utilise SeedVR2 pour agrandir à 6144 × 3072
- Gratuit, la licence permet la vente ; 1 vidéos + 5 images d'exemple ; cette version a 237 téléchargements, le modèle cumule 1842 téléchargements et 128 likes (indiquant uniquement le niveau d'attention)
Comment l'utiliser
- Importez minimaxH3CharacterSheet_v11.json, nécessite ComfyUI 0.30.0 ou supérieur et AusBoss nodes 2.15.0 ou supérieur (recherchez AusBoss dans ComfyUI-Manager, mettez à jour si déjà installé) ; la première exécution charge environ 42 GB de modèles
- Le modèle de diffusion utilise la version Ref2VA de H3 (pas FL2VA), nécessite également l'encodeur de texte Qwen3-VL de H3 et le VAE vidéo ; l'Upscale 2x nécessite SeedVR2 ; consultez la fiche du modèle pour les noms de fichiers et les répertoires spécifiques
- Chargez une photo nette d'une personne, remplissez optionnellement l'arrière-plan et les « parties non photographiées » ; activez les nouveaux interrupteurs selon les besoins, la sortie par défaut est une fiche de quatre vues de 3072 × 1536
Risques et limitations
- La sortie est une fiche de personnage statique, pas une vidéo ; l'auteur précise avoir testé uniquement avec des photos, la vue de dos est devinée par H3 à partir de la photo, la carnation peut s'éclaircir sous une lumière colorée forte
- L'entrée est une photo réelle, utiliser la photo d'autrui pour créer une fiche de personnage nécessite son autorisation, cela implique le droit à l'image
- La fiche du modèle indique que la licence communautaire de H3 ne couvre pas l'Union européenne, le Royaume-Uni, la Corée du Sud et les États-Unis ; le volume total des fichiers du modèle est important ; cette entrée n'a pas exécuté le modèle
【A】H3MD Director – 2–3 min long videos with MiniMax H3 (ComfyUI) · v0.1.1
Workflow · Nouveau modèle · Auteur 1113800942188 · Publié le 11-02 15:06 · Téléchargements 65
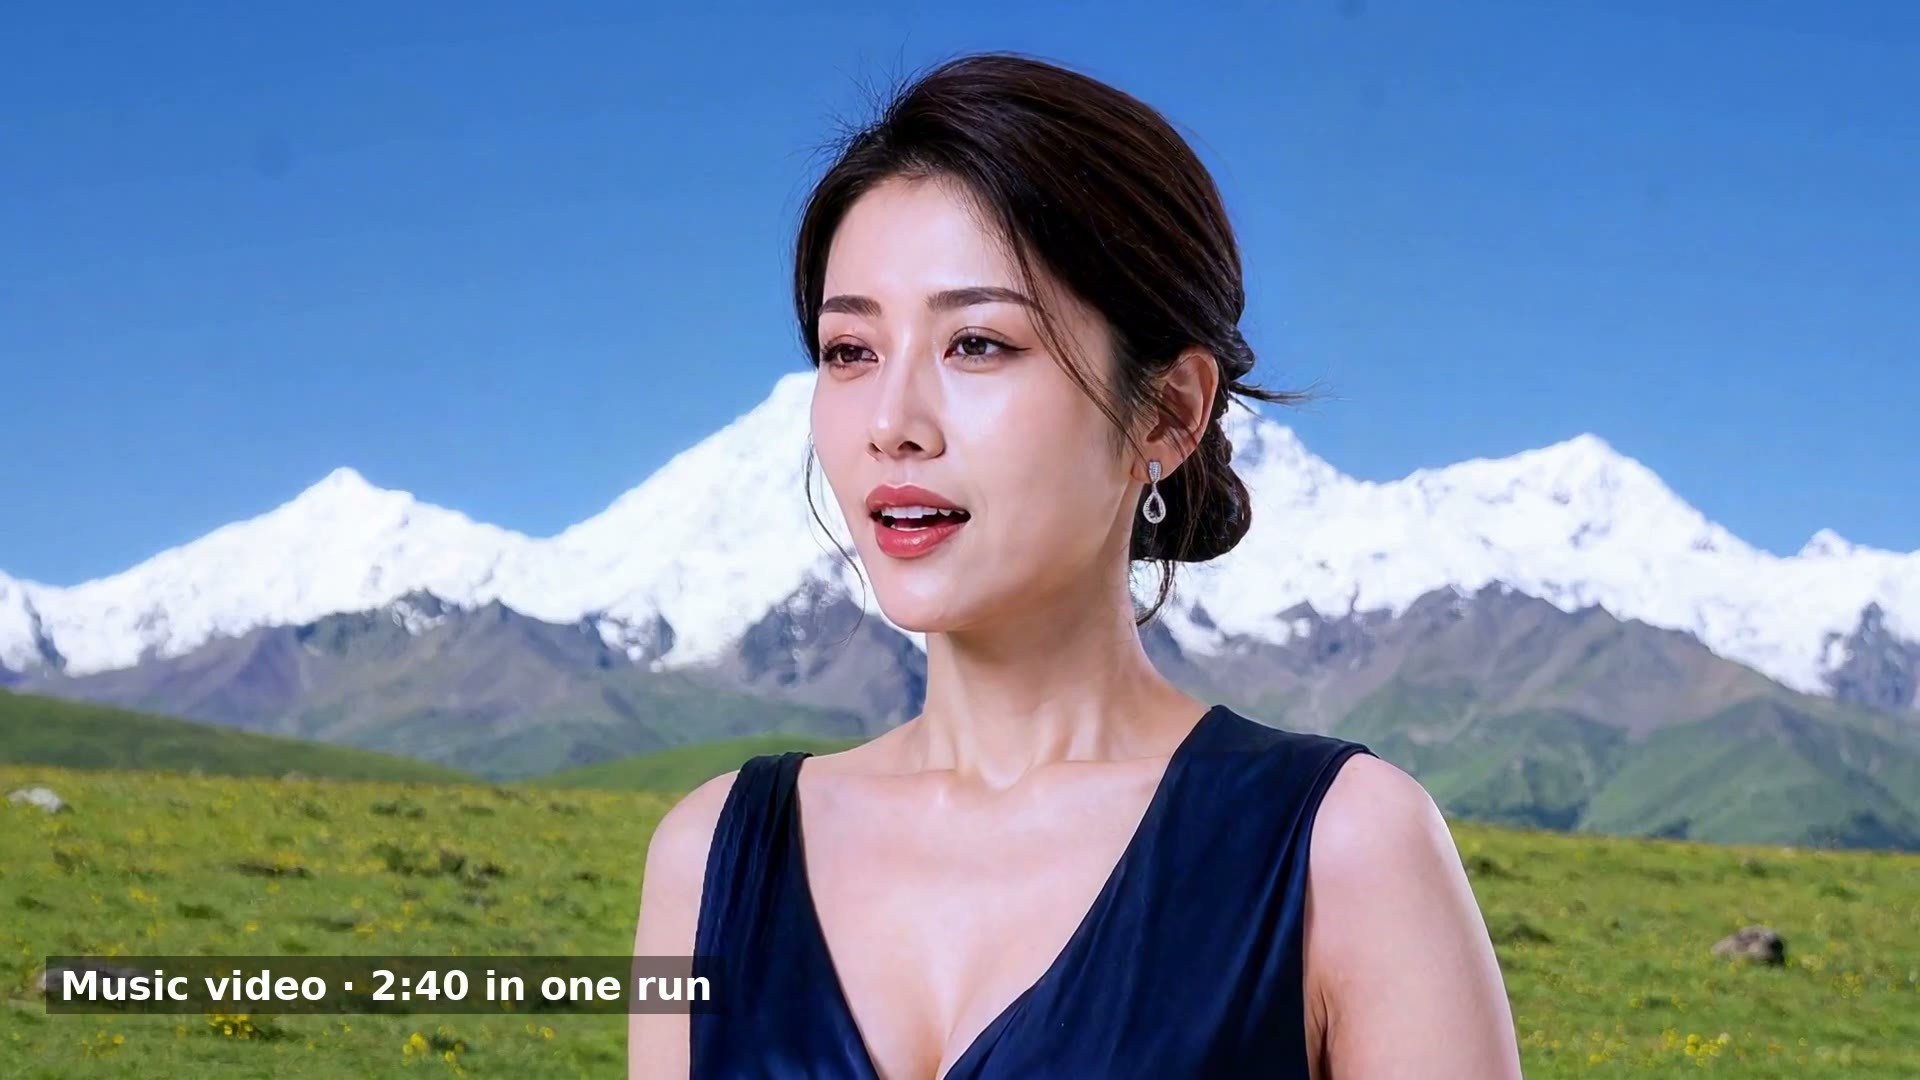
Pack de nœuds ComfyUI open source + workflow d'exemple : une seule exécution génère des vidéos longues de 2 à 3 minutes avec H3, pouvant être un plan-séquence continu ou une séquence multi-plans planifiée par storyboard.
Maintien du A : pousse H3 de segments uniques de 10–15 secondes à l'échelle de la minute, avec possibilité de réparation segment par segment, l'usage et l'installation sont clairs ; pas de promotion au S car c'est la première version, il y a beaucoup de dépendances, les exigences de calcul ne sont pas indiquées, et l'auteur de ce rapport est mentionné dans les remerciements, donc traitement prudent.
Illustration
Raisons de la recommandation
- Nouveau modèle : sert les vidéos longues, les courts-métrages multi-plans et les clips musicaux ; les plans-séquences s'appuient sur une chevauchement latent des 1.6 dernières secondes de chaque segment pour la continuité, les coupes franches peuvent recommencer avec leurs propres images de référence, les statistiques de couleur/contraste sont ramenées au premier segment pour supprimer la dérive
- Inclut un panneau de direction (durée, prompt, image de référence, verrouillage audio par plan), transfert d'action via profondeur + SAM3, clips musicaux avec synchronisation labiale et génération vidéo texte-à-vidéo ; l'auteur indique que les vidéos longues en 1080P, avec des segments uniques de 15 s, peuvent atteindre 2K, avec des options pour faible VRAM/traitement par blocs
- Gratuit, open source AGPL-3.0 ; le README GitHub détaille l'installation, les dépendances, la réexécution par segments et la reprise sur interruption ; 6 heures après la publication, 65 téléchargements (indiquant uniquement le niveau d'attention)
Comment l'utiliser
- Recherchez « H3MD Director » dans ComfyUI-Manager ou clonez le dépôt GitHub dans custom_nodes, ComfyUI nécessite la version 0.43 ou supérieure (support natif H3) ; glissez H3MD Director.json du zip dans ComfyUI, installez les nœuds manquants via Install Missing Custom Nodes, téléchargez les modèles selon les liens Model links du workflow
- Le README recommande de ne lancer d'abord que le premier segment (réglez stop_after sur 1 dans le nœud Loop) pour vérifier l'image et la vitesse, puis activez resume_from_cache pour lancer la vidéo complète ; si un segment est défectueux, entrez son numéro dans rerun_segments pour ne relancer que ceux-ci
- Le README recommande d'utiliser la spécification de prompt h3md-prompt de l'auteur pour chaque plan ; dépend également des packs de nœuds ComfyUI-ClipProj, ComfyUI-VFI (interpolation d'images), KJNodes, rgthree, etc., un modèle d'agrandissement latent appris est optionnel
Risques et limitations
- v0.1.1 est la première version publique, l'auteur n'a pas fourni le temps d'exécution ni les besoins en VRAM pour des vidéos complètes de 2–3 minutes ; 3 exemples de niveau sensible sont masqués, les visibles sont 2 vidéos en 1080p
- Licence AGPL-3.0, toute modification redistribuée doit être open source ; le lien RunningHub dans la fiche du modèle est un lien de parrainage de l'auteur
- La liste des remerciements de l'auteur inclut T8 (l'auteur de ce rapport), cette évaluation ne se base que sur la fiche et le README ; cette entrée n'a pas visionné les vidéos ni exécuté le modèle
À suivre (9)
【B】MiniMax H3 Ref2VA - Multi-Reference Video Generation · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 17:05 · Téléchargements 20
Workflow de génération vidéo multi-références H3 d'AIKSK : cinq images de référence sont connectées simultanément aux conditions Ref2VA, échantillonnage à basse résolution d'abord, agrandissement latent 3D appris par facteur 2, puis raffinement à faible bruit, sortie vidéo avec audio généré par H3.
Illustration
【B】Singularity-V2-x-10Eros-Max · PRISM-DMAD-PDMD
Modèle de base / Checkpoint · Mise à jour de version · Auteur 0l1v1aR0551 · Publié le 11-02 15:46 · Téléchargements 521
Nouvelle version du modèle de base fusionné H3 Ref2VA : fusionne les versions Turbo de 8 pas de Singularity v2 et de 10Eros-Max via l'algorithme PRISM écrit par l'auteur, l'auteur indique que cette version produit une texture de peau réaliste en 8 pas sans LoRA Turbo.
Illustration
【B】MiniMax H3 LightX2V 4 étapes Vidéo-à-Vidéo · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 12:28 · Téléchargements 25
Version LightX2V avec image de référence parmi les trois solutions d'accélération H3 d'AIKSK : générer une vidéo à partir d'une image de référence, LoRA turbo Ref2V en 4 étapes combiné à un échantillonnage Euler simple en 4 étapes en une seule passe ; le titre indique Vidéo-à-Vidéo, mais il n'y a pas d'entrée vidéo source dans l'image.
Image d'illustration
【B】MiniMax H3 Repaint HD Vidéo en Deux Étapes · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 17:04 · Téléchargements 9
Workflow de re-rendu haute définition vidéo H3 d'AIKSK : lit une vidéo existante, injecte ses variables latentes comme base, effectue un agrandissement latent 2x en espace latent 3D appris et une reconstruction conditionnée haute résolution, puis affine avec des étapes courtes à faible bruit, et verrouille enfin l'audio original.
Image d'illustration
【B】MiniMax H3 PDD 8 étapes Vidéo-à-Vidéo avec Référence · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 12:25 · Téléchargements 23
Version avec image de référence de la solution PDD parmi les trois solutions d'accélération H3 : générer une vidéo à partir d'une image de référence, le nœud de configuration PDD prend en charge le modèle, l'échantillonneur et les sigmas, avec des poids d'accélération Ref2VA spécifiques en 8 étapes ; le titre indique Vidéo-à-Vidéo, mais il n'y a pas d'entrée vidéo source en réalité.
Image d'illustration
【B】MiniMax H3 Workflow Arts Martiaux (Multi-Images Clés) · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 15:11 · Téléchargements 17
Workflow d'arts martiaux H3 d'AIKSK (version multi-images clés) : superpose quatre LoRAs pour la texture cinématographique réaliste, le mouvement de caméra, la physique spatiale des arts martiaux et les actions d'arts martiaux FL2VA, combinés à un LoRA turbo en 8 étapes pour générer des scènes de combat, et inclut une partie multi-images clés.
Image d'illustration
【B】Minimax.. simple · v5
Workflow · Mise à jour de version · Auteur sy0ww4bb1984 · Publié le 11-02 13:57 · Téléchargements 36
Un grand workflow tout-en-un H3 : générer une vidéo à partir de plusieurs images de référence et d'un audio de référence, prolonger la vidéo en continuant par lots de frames pour obtenir une vidéo plus longue, puis agrandir par lots ; v5 corrige principalement le flux en suivant les modifications de la nouvelle version de ComfyUI.
Image d'illustration
【B】MiniMax H3 LightX2V 4 Étapes Vidéo Première-Dernière Image · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 12:27 · Téléchargements 27
Version première-dernière image de la solution LightX2V en 4 étapes : générer une vidéo à partir de deux images (première et dernière image), LoRA turbo FL2V en 4 étapes combiné à un échantillonnage Euler simple en 4 étapes en une seule passe.
Image d'illustration
【B】MiniMax H3 FL2VA - Vidéo Texte, Première et Dernière Image · v1.0
Workflow · Nouveau modèle · Auteur AIKSK · Publié le 11-02 17:03 · Téléchargements 9
Workflow quatre-en-un H3 d'AIKSK pour texte, première image, dernière image et première-dernière image : les entrées première et dernière image sont toutes deux optionnelles, la tâche change selon le nombre d'images connectées, utilisant un échantillonnage en deux passes (génération basse résolution, agrandissement latent 2x en espace latent 3D, affinage à faible bruit).
Image d'illustration
Inclus uniquement (11)
- MiniMax H3 Workflow Arts Martiaux · v1.0 — Workflow : Workflow d'arts martiaux H3 d'AIKSK (version standard) : superpose les mêmes quatre LoRAs pour la texture cinématographique réaliste, le mouvement de caméra, la physique spatiale des arts martiaux et les actions d'arts martiaux FL2VA, ainsi qu'un LoRA turbo en 8 étapes, mais sans la partie multi-images clés.
- MiniMax H3 H25 Hybride - Construction Multi-Référence en 8 Étapes · v1.0 — Workflow : Workflow H3 multi-références en 8 étapes d'AIKSK (H25 Hybride) : la fiche indique seulement 47 nœuds, une intensité de LoRA turbo de 1.0, l'échantillonnage utilise des nœuds personnalisés, les entrées et les paramètres ne sont pas spécifiés.
- Michaela Gobielle · v1.0 H3 — LoRA : Version H3 du LoRA de personnage pour Michaela Gobeille, un personnage féminin adulte fictif original de l'auteur, utilisant le mot-clé d'activation mikalora pour générer ce personnage dans les vidéos.
- MiniMax H3 FL2VA - Première/Dernière Image avec Chronologie d'Images Clés · v1.0 — Workflow : Workflow H3 d'AIKSK avec première/dernière image et chronologie d'images clés : le nom de fichier indique « FL2VA première/dernière image + contrôle de chronologie d'images clés + réparation de mouvement Motion Lab », la fiche ne donne que 80 nœuds, sans LoRA, l'échantillonnage utilise des nœuds personnalisés.
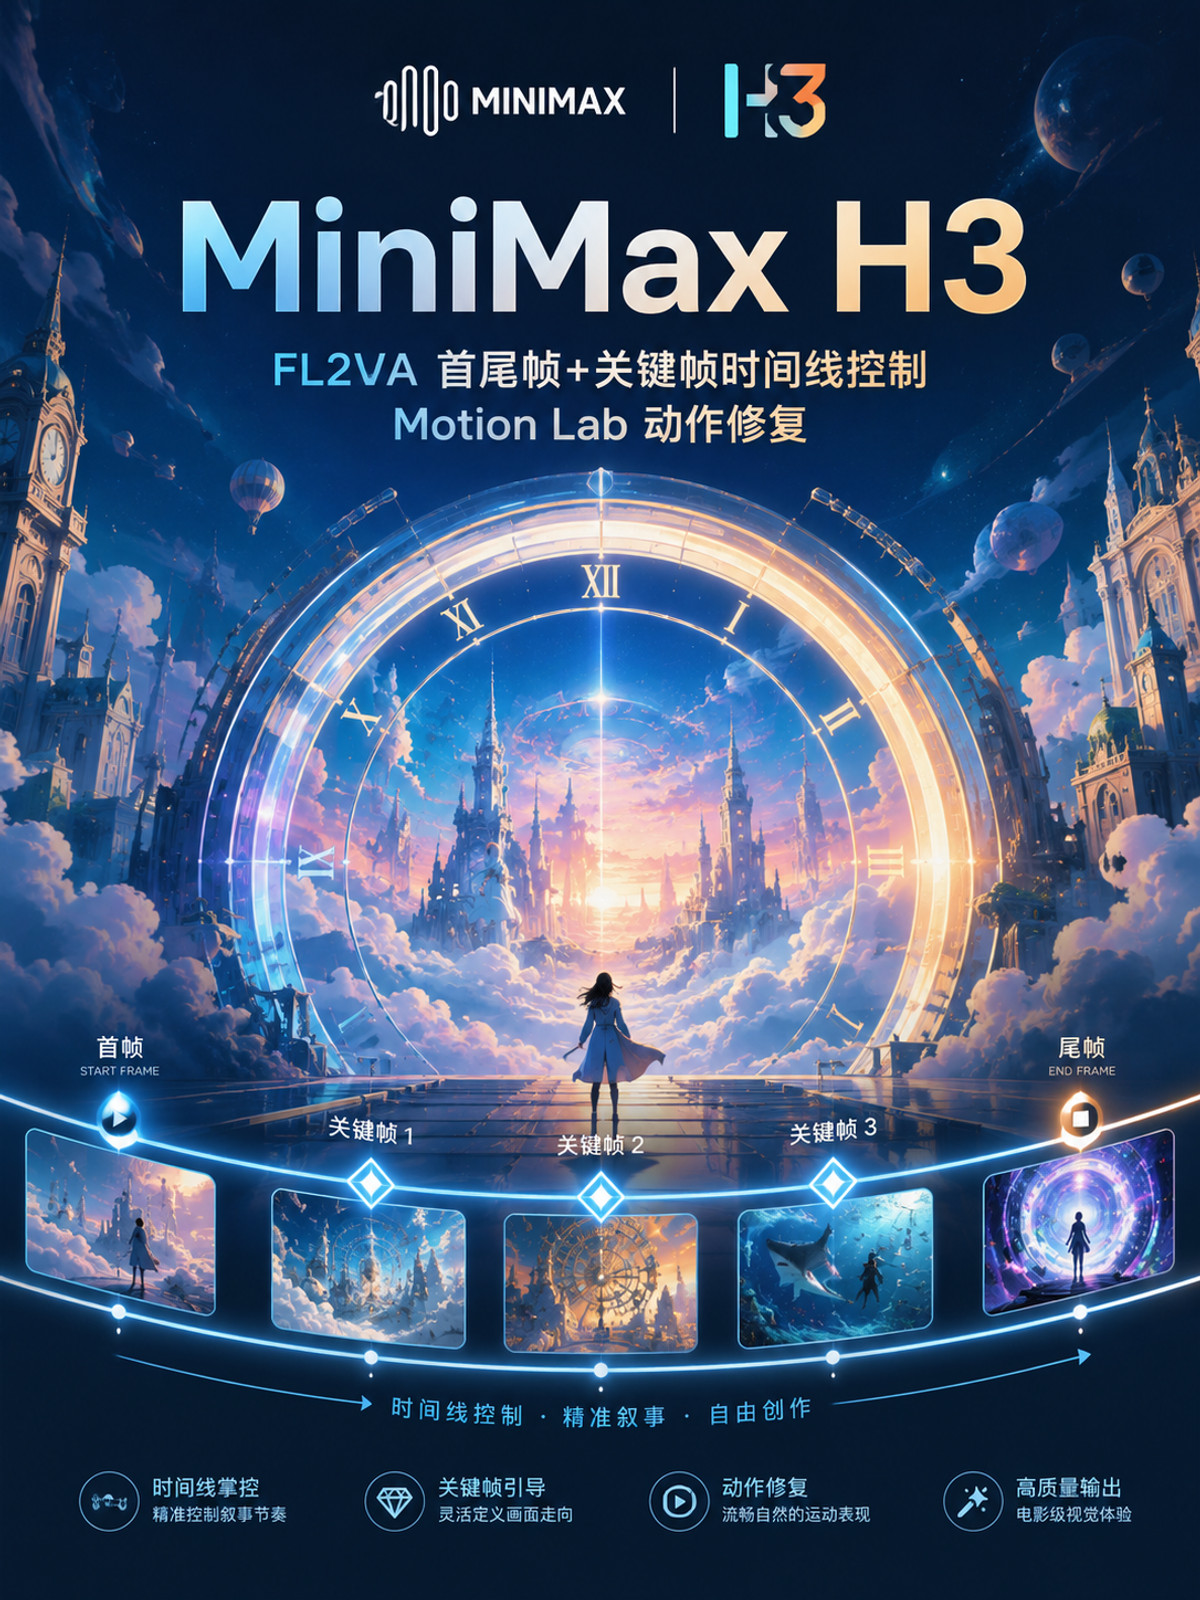
- MiniMax H3 OpenVDN DMD8 Référence-à-Vidéo · v1.0 — Workflow : Version avec image de référence de la solution OpenVDN DMD8 : générer une vidéo à partir d'une image de référence, le plan d'exécution vdn-minimax-h3 (stage_dmd_8nfe) d'OpenVDN fournit le modèle, l'échantillonneur et les sigmas, sortie en une seule passe, sans étape d'agrandissement finale.
- MiniMax H3 OpenVDN DMD8 Vidéo Première-Dernière Image · v1.0 — Workflow : Version première-dernière image de la solution OpenVDN DMD8 : générer une vidéo à partir de deux images (première et dernière image), le plan d'exécution VDN fournit l'échantillonnage, sortie en une seule passe ; le modèle de base sélectionné est FL2VA, mais la tâche conditionnelle reste Ref2VA.
- MiniMax H3 PDD 8 étapes Vidéo Première-Dernière Image · v1.0 — Workflow : Version première-dernière image de la solution PDD en 8 étapes : deux images (première et dernière image) sont connectées, le nœud de configuration PDD prend en charge l'échantillonnage, combiné à des poids d'accélération FL2VA en 8 étapes ; mais la tâche conditionnelle est toujours écrite comme génération vidéo à partir de la première image.
- Lara WhiteMoon · MiniMaxH3 — LoRA : Version H3 du LoRA de personnage pour le personnage fictif Lara WhiteMoon, utilisé pour générer ce personnage féminin au style astrologue steampunk dans les vidéos.
- MiniMax H3 Ref2VA - Multi-Référence avec Points de Scénario d'Images Clés · v1.0 — Workflow : Workflow H3 d'AIKSK avec multi-références et contrôle de scénario par images clés : le nom de fichier indique « Ref2VA multi-référence + contrôle de scénario par images clés + mouvement Motion Lab », la fiche ne donne que 87 nœuds, sans LoRA, l'échantillonnage utilise des nœuds personnalisés.
- HIROYUKI IMAISHI - Kill La Kill, Gurren Lagann, FLCL - Minimax H3 · v1.0 — LoRA : LoRA de style H3 imitant le style d'animation de Hiroyuki Imaishi (Kill la Kill, Gurren Lagann, FLCL).
- BigAss 🍑🔥 [ MOSS / Krea2 / SD] · Minimax v1.0 — LoRA : Version H3 du LoRA de concept de morphologie : utilise le mot-clé d'activation BigAss pour rendre les hanches des personnages plus volumineuses.
Données : API publique Civitai (modèle de base MiniMax H3), fenêtre d'inclusion du 11-02 10:15 au 11-02 21:01 (heure de Pékin). Les recommandations ont été revues par la rédaction ; le nombre de téléchargements reflète uniquement l'intérêt.