정정의 AI 레이더 · MiniMax H3 · 2026-11-02 저녁 뉴스
이번 호 23개 신규 버전: 강력 추천 1 · 추천 2 · 주목할 만함 9 · 단순 수록 11
편집자 주 이번 호에서는 23개의 H3 신규 버전을 검토했습니다. 최초 추천은 KinetiX 수량 슬라이더입니다: 트리거 워드 없이 LoRA의 양/음 강도로 비행검, 화살, 부적 등 화면 내 소품의 수량을 제어하며, 강도 단계와 예시 프롬프트가 완비되어 있습니다. H3MD Director 오픈소스 노드 팩은 한 번에 2–3분 길이의 영상을 생성하고, 캐릭터 시트 워크플로우 v1.1는 헤드 클로즈업과 표정 행을 추가했으며, 모두 A등급입니다. AIKSK가 다시 14개의 워크플로우를 공개했습니다: 다중 참조 이미지, 고화질 리렌더링, 4-in-1 첫/마지막 프레임 등 파라미터가 명확히 기재된 7개는 B등급으로 지정했으며, 유사 중복이거나 노드 통계만 있거나 태스크 설정이 모순되는 7개는 C등급입니다. 두 개의 가상 인물 LoRA는 설명이 빈약하여 C등급으로 하향 조정했습니다.
강력 추천 (1)
【S】KinetiX Instance Quantity Density Slider · v1.0
LoRA · 신규 모델 · 작가 make676767 · 공개일 11-02 14:59 · 다운로드 수 77
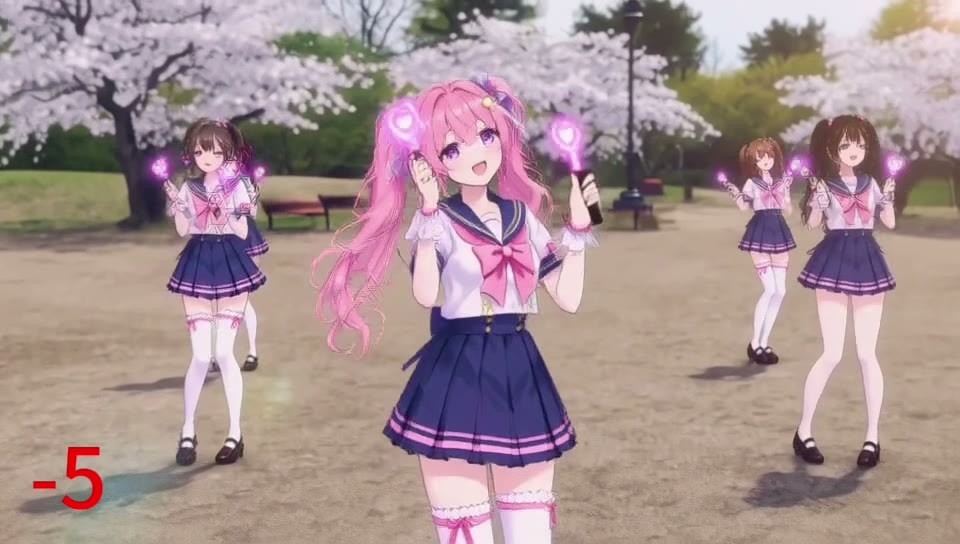
‘화면 내 비행 소품/소환물 수량’을 제어하는 슬라이더형 LoRA입니다: 양의 값은 비행검, 화살, 수리검, 부적 등을 몇 개에서 화면 가득한 탄막 수준으로 늘리고, 음의 값은 화면을 단일 주체로 고정하여 불필요한 복제물을 제거합니다.
S등급 유지: 수량 제어는 H3 프롬프트로는 정밀하게 구현하기 어려운 부분이며, 강도 단계와 예시 프롬프트가 완비되어 있어 그대로 따라 할 수 있습니다. 감점 요인은 공개된 예시에 강도가 표기되지 않았다는 점입니다.
이미지
추천 이유
- 신규 모델: 텍스트-비디오 생성에서 ‘만검 일제 발사, 화살 비, 암기 폭풍’처럼 수량 제어가 어려운 대규모 장면에 유용하며, 반대로 음의 값을 사용하여 기본 모델이 무작위로 생성하는 조력자, 분신, 잔상을 제거할 수도 있습니다
- 작가가 완전한 강도 단계를 제공했습니다: +0.5 ~ +1.0은 무기 하나를 5~10개로 나누고, +1.2 ~ +2.0은 작가가 추천하는 정연한 대열 단계이며, +3.0 ~ +5.0는 화면 가득한 탄막, -2.0 ~ -4.0은 단일 주체 고정입니다. 또한 바로 복사하여 사용할 수 있는 한/영 이중 언어 시나리오 프롬프트 4개(+2.5, +3.0, -2.5, +2.5)가 첨부되어 있습니다
- 무료이며, 라이선스상 판매가 허용됩니다. 공개 후 6시간 만에 다운로드 77회, 좋아요 10개를 기록했습니다(관심도만 반영)
사용 방법
- 트리거 워드 불필요, 순수하게 LoRA 강도(strength_model)로 제어합니다. 먼저 +1.2 ~ +2.0을 사용하고, 화면 가득한 효과를 원하면 +3.0 이상으로 올리고, ‘하나만’ 남기려면 -2.0 ~ -4.0을 사용합니다
- 프롬프트에는 여전히 어떤 소품인지(flying swords, arrows, paper talismans 등)를 명확히 기재해야 하며, 작가가 제공한 4개의 시나리오 프롬프트를 그대로 적용할 수 있습니다. 스텝 수, CFG, 샘플러는 작가가 명시하지 않았습니다
리스크 및 제한 사항
- 공개된 예시는 영상 2개뿐이며 프롬프트와 강도가 첨부되지 않아 각 단계의 실제 차이를 파악하기 어렵습니다. 또한 민감도 등급이 지정된 예시 4개는 숨겨져 있습니다
- 작가가 학습 데이터와 학습 방식을 기재하지 않았습니다. 음의 값 ‘단일 주체 고정’이 인물 군상에 부작용을 일으킬지 여부는 명시되지 않았습니다. 본 항목은 영상을 보거나 실행해 보지 않았습니다
추천 (2)
【A】MiniMax H3 Character Sheet | Turnaround From One Photo · v1.1
워크플로우 · 버전 업데이트 · 작가 AusBoss · 공개일 11-02 13:21 · 다운로드 수 237
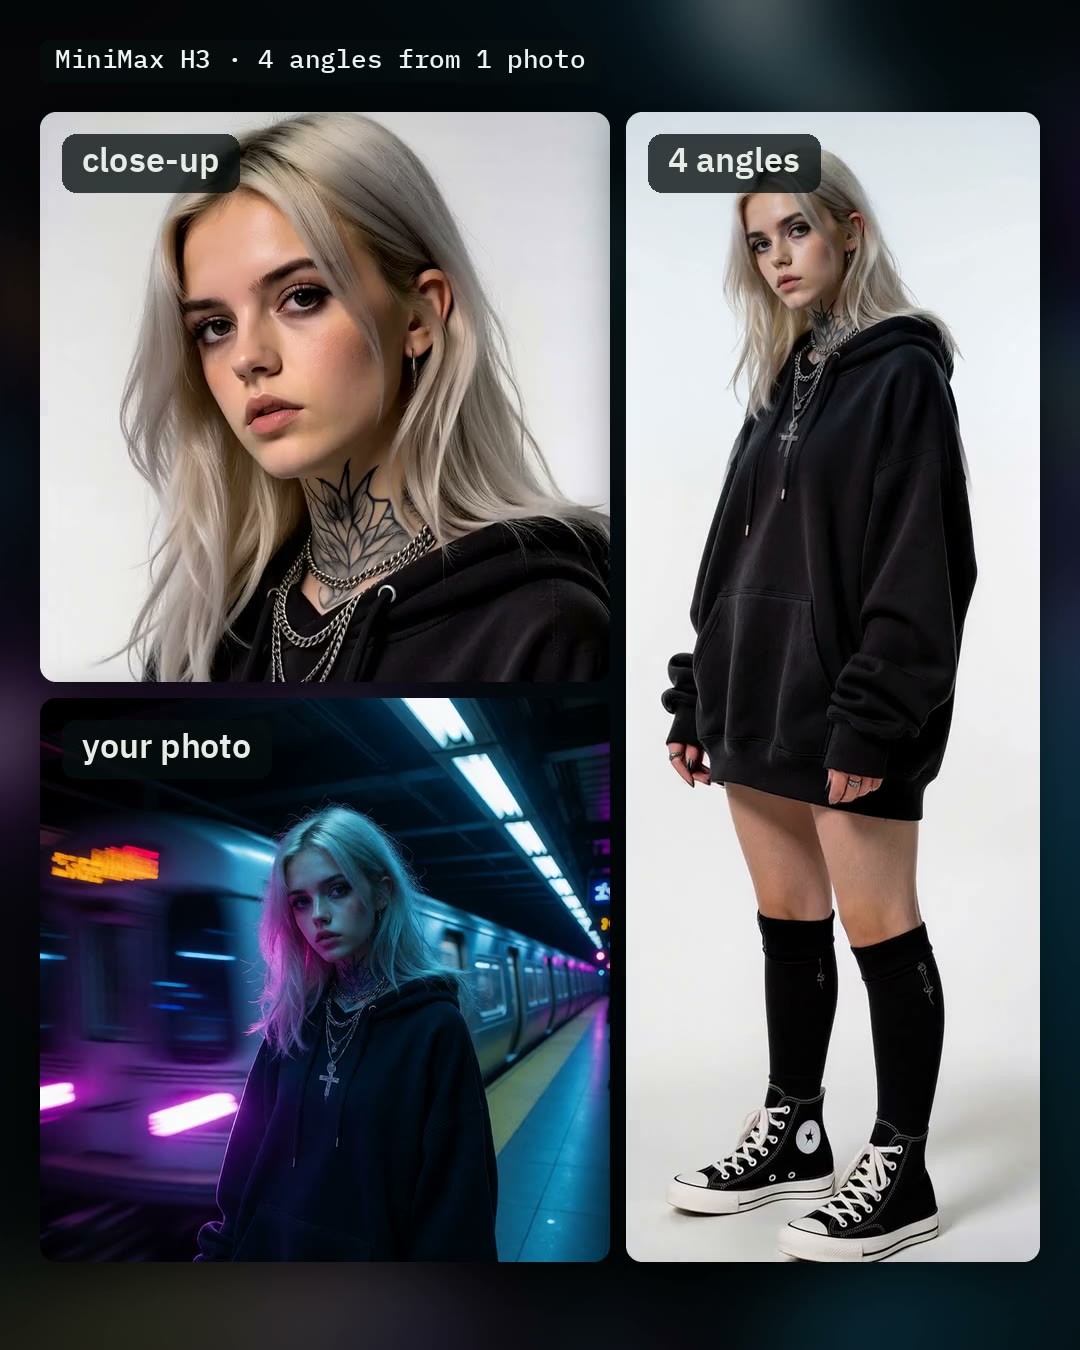
인물 사진 한 장을 ComfyUI에 입력하면, H3가 동일 인물의 정면, 4분의 3 측면, 측면, 후면의 4방향 시트(정적 이미지)를 생성합니다. v1.1에서는 선택 가능한 헤드 클로즈업 행, 표정 행 및 얼굴 리터칭 기능이 추가되었습니다.
A등급 유지: 새로운 스위치 변경 사항이 구체적이고 기본값이 꺼져 있어 기존 사용 방식에 영향을 주지 않으며, 예시와 의존성이 명확히 기재되어 있습니다. S등급으로 상향하지 않은 이유는 소폭의 증분 업데이트이기 때문이며, 모델 용량과 라이선스 지역 제한이 실질적인 진입 장벽이기 때문입니다.
이미지
추천 이유
- 버전 업데이트: 세 가지 새로운 스위치가 추가되었으며, 파일 열기 시 모두 꺼져 있고 모두 꺼진 상태에서는 v1.0과 동일한 출력을 생성합니다. ‘Close-ups under the sheet’은 시트 하단에 네 개의 헤드 클로즈업 행을 추가하며(H3를 한 번 더 실행하여 약 70초 소요), ‘Expressions instead of head turns’는 이 행을 네 가지 표정으로 대체하고 네 개의 상자에 직접 내용을 작성할 수 있습니다. ‘Redraw the faces’는 H3가 상단 부분을 다시 처리하여 작은 얼굴을 더 깔끔하게 만듭니다(약 75초 소요)
- 실제 인물 사진으로 캐릭터 일관성을 유지하는 다중 뷰 참조 이미지를 생성하고, 이를 H3의 참조 이미지 기반 비디오 생성에 사용하는 용도에 적합합니다. 기존 기능은 유지됩니다: 배경 작성 가능, 사진에 찍히지 않은 부분 보완 가능(작가는 ‘blue jeans and white sneakers’를 작성하면 흉상을 전신으로 보완할 수 있다고 언급), Fast 스위치는 10스텝으로 18스텝을 대체하며, Upscale 2x는 SeedVR2를 사용하여 6144 × 3072로 확대합니다
- 무료이며, 라이선스상 판매가 허용됩니다. 영상 1개 + 예시 이미지 5장 제공; 본 버전 다운로드 수 237회, 전체 모델 누적 다운로드 수 1842회, 좋아요 128개(관심도만 반영)
사용 방법
- minimaxH3CharacterSheet_v11.json을 가져와야 하며, ComfyUI 0.30.0 이상 및 AusBoss nodes 2.15.0 이상이 필요합니다(ComfyUI-Manager에서 AusBoss 검색, 이미 설치된 경우 업데이트 필요); 첫 실행 시 약 42GB의 모델이 로드됩니다
- 확산 모델은 H3의 Ref2VA 버전을 사용하며(FL2VA가 아님), 추가로 H3의 Qwen3-VL 텍스트 인코더와 비디오 VAE가 필요합니다. Upscale 2x는 추가로 SeedVR2이 필요하며, 구체적인 파일명과 디렉터리는 모델 카드를 참조하세요
- 선명한 인물 사진 한 장을 로드하고, 배경과 ‘사진에 찍히지 않은 부분’을 선택적으로 입력합니다. 새로운 스위치는 필요에 따라 켜며, 기본 출력은 3072 × 1536 크기의 4방향 시트 한 장입니다
리스크 및 제한 사항
- 출력은 정적 시트 이미지이며 비디오가 아닙니다. 작가는 사진으로만 테스트했다고 명시했으며, 후면은 H3가 사진을 바탕으로 추정한 것으로 강한 컬러 조명 하에서는 피부색이 옅어질 수 있습니다
- 입력은 실제 인물 사진이므로, 타인의 사진으로 시트를 만들 경우 본인 동의를 얻어야 하며 초상권 문제가 발생할 수 있습니다
- 모델 카드에는 H3 커뮤니티 라이선스의 적용 지역에 EU, 영국, 한국, 미국이 포함되지 않는다고 명시되어 있습니다. 모델 파일의 총 용량이 크며, 본 항목은 실행해 보지 않았습니다
【A】H3MD Director – 2–3 min long videos with MiniMax H3 (ComfyUI) · v0.1.1
워크플로우 · 신규 모델 · 작가 1113800942188 · 공개일 11-02 15:06 · 다운로드 수 65
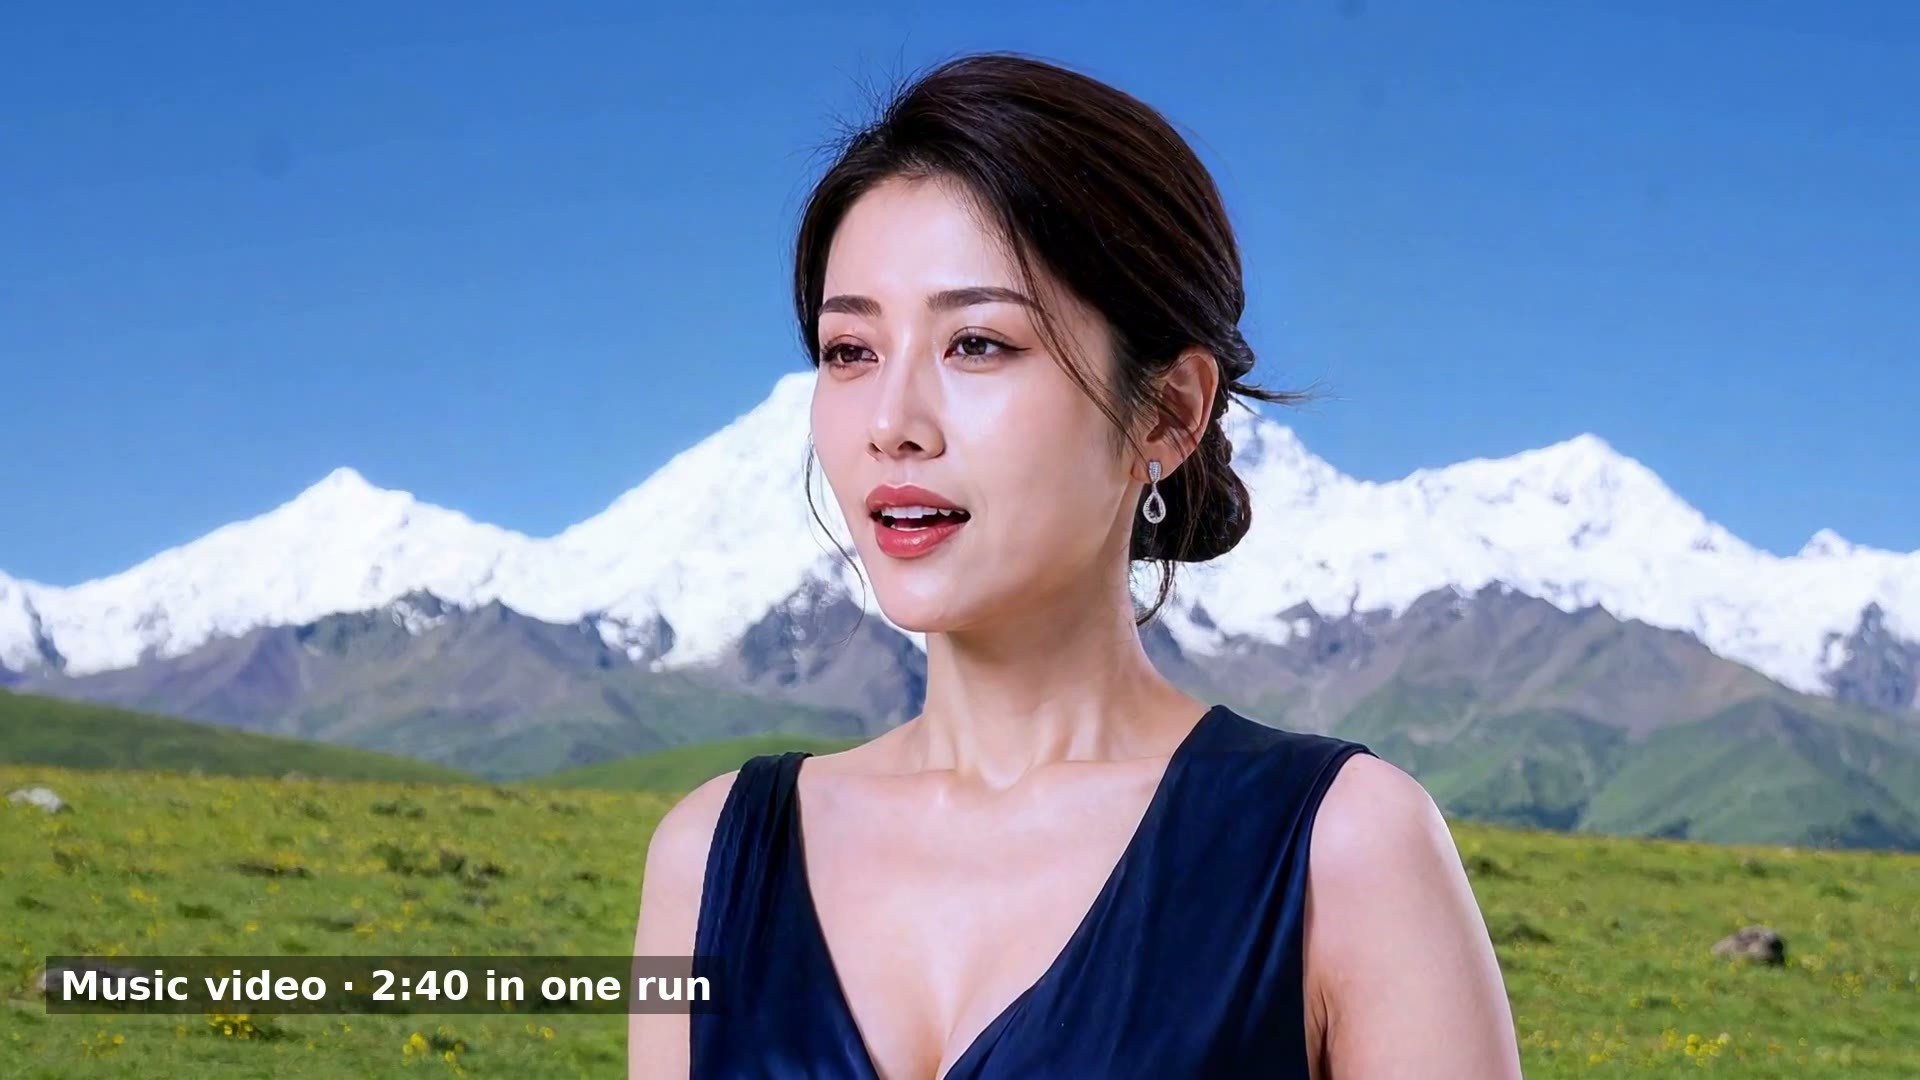
오픈소스 ComfyUI 노드 팩 + 예시 워크플로우: 한 번의 실행으로 H3를 사용하여 2–3분 길이의 장편 영상을 생성합니다. 하나의 연속 롱 테이크이거나, 스토리보드 계획에 따른 다중 컷 시퀀스일 수 있습니다.
A등급 유지: H3의 단일 세그먼트 10–15초를 분 단위로 확장하고 세그먼트별 복원까지 가능하게 하여 용도와 설치 방법이 명확합니다. S등급으로 상향하지 않은 이유는 첫 버전이고, 의존성이 많으며, 컴퓨팅 파워 요구 사항이 명시되지 않았고, 본 보고서의 작가와 감사 인연이 있어 보수적으로 처리했기 때문입니다.
이미지
추천 이유
- 신규 모델: 장편 영상, 다중 컷 단편 및 뮤직비디오에 적합합니다. 롱 테이크는 각 세그먼트가 이전 세그먼트의 마지막 1.6초 잠공간(latent space) 중첩을 통해 연속 작성되며, 하드 컷은 각각의 참조 이미지로 새로 시작할 수 있고, 색상/대비 통계를 첫 번째 세그먼트 기준으로 맞춰 드리프트를 억제합니다
- 디렉터 패널(컷별 길이, 프롬프트, 참조 이미지, 오디오 고정), 깊이 + SAM3 동작 전이, 립싱크 뮤직비디오 및 텍스트-비디오 생성 기능이 포함됩니다. 작가는 장편 영상 1080P, 단일 세그먼트 15초에서 2K까지 지원되며 저 VRAM/청킹 옵션을 제공한다고 언급했습니다
- 무료이며, AGPL-3.0 오픈소스입니다. GitHub README에 설치, 의존성, 세그먼트 재실행 및 체크포인트 재개 방법이 기재되어 있습니다. 공개 후 6시간 만에 다운로드 65회를 기록했습니다(관심도만 반영)
사용 방법
- ComfyUI-Manager에서 ‘H3MD Director’를 검색하거나 GitHub 저장소를 custom_nodes에 클론하세요. ComfyUI는 0.43 이상이어야 합니다(네이티브 H3 지원). zip 파일 내의 H3MD Director.json을 ComfyUI로 드래그하고, 누락된 노드 팩은 Install Missing Custom Nodes를 통해 설치하며, 모델은 워크플로우 내 Model links 설명에 따라 다운로드하세요
- README에서는 먼저 첫 번째 세그먼트만 실행하여(Loop 노드의 stop_after를 1로 설정) 화면과 속도를 확인한 후, resume_from_cache를 켜서 전체 영상을 실행할 것을 권장합니다. 특정 세그먼트가 손상된 경우 rerun_segments에 해당 번호를 입력하여 그 부분만 재실행하세요
- README에서는 각 컷을 작성할 때 작가의 h3md-prompt 프롬프트 규격을 사용할 것을 권장합니다. 또한 ComfyUI-ClipProj, ComfyUI-VFI(프레임 보간), KJNodes, rgthree 등의 노드 팩에 의존하며, 학습된 잠공간 확대 모델은 선택 사항입니다
리스크 및 제한 사항
- v0.1.1는 첫 공개 버전으로, 작가는 전체 2–3분 영상의 소요 시간과 VRAM 요구 사항을 제공하지 않았습니다. 민감도 등급이 지정된 예시 3개는 숨겨져 있으며, 공개된 것은 2개의 1080p 영상입니다
- AGPL-3.0 라이선스로, 수정 후 재배포 시 오픈소스화해야 합니다. 모델 카드의 RunningHub 링크는 작가의 초대 링크입니다
- 작가의 감사 명단에 T8(본 보고서 작가)이 포함되어 있으며, 본 항목의 평가는 카드 내용과 README에만 근거합니다. 본 항목은 영상을 보거나 실행해 보지 않았습니다
주목할 만함 (9)
【B】MiniMax H3 Ref2VA - Multi-Reference Video Generation · v1.0
워크플로우 · 신규 모델 · 작가 AIKSK · 공개일 11-02 17:05 · 다운로드 수 20
AIKSK의 H3 다중 참조 이미지 기반 영상 생성 워크플로우: 5장의 참조 이미지를 Ref2VA 조건에 동시에 연결한 후, 저해상도 샘플링을 수행하고 학습 기반 3D 잠재 공간에서 2배 업스케일링을 진행하며, 이후 저노이즈 정밀 보정을 거쳐 H3 생성 오디오가 포함된 영상을 출력합니다.
이미지
【B】Singularity-V2-x-10Eros-Max · PRISM-DMAD-PDMD
기본 모델 / Checkpoint · 버전 업데이트 · 작가 0l1v1aR0551 · 공개일 11-02 15:46 · 다운로드 수 521
H3 Ref2VA 병합 기본 모델의 최신 버전입니다: Singularity v2과 10Eros-Max의 8스텝 Turbo 버전을 작가가 직접 작성한 PRISM 알고리즘으로 병합했으며, 작가는 이 버전에서는 Turbo LoRA 없이도 8스텝으로 사실적인 피부 질감을 생성할 수 있다고 언급했습니다.
이미지
【B】MiniMax H3 LightX2V 4단계 Video-to-Video · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 12:28 · 다운로드 25
AIKSK의 3가지 H3 가속 솔루션 중 LightX2V 참조 이미지 버전: 참조 이미지 한 장으로 영상을 생성하며, Ref2V turbo 4단계 LoRA와 simple 4단계 Euler 단일 구간 샘플링을 조합합니다. 제목은 Video-to-Video로 되어 있지만, 이미지에는 원본 영상 입력이 없습니다.
예시 이미지
【B】MiniMax H3 2단계 HD Video Repaint · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 17:04 · 다운로드 9
AIKSK의 H3 영상 고화질 재렌더링 워크플로우: 기존 영상을 읽어 들여 잠재 변수(latent)를 기반으로 주입하고, 학습된 3D 잠재 공간 2배 업스케일링 및 고해상도 조건 재구성 후 저노이즈 짧은 단계로 정밀 보정하며, 마지막에 원본 오디오를 고정합니다.
예시 이미지
【B】MiniMax H3 PDD 8단계 Video-to-Video with Reference · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 12:25 · 다운로드 23
3가지 H3 가속 솔루션 중 PDD 참조 이미지 버전: 참조 이미지 한 장으로 영상을 생성하며, PDD 설정 노드가 모델, 샘플러 및 sigma를 제어하고, 전용 Ref2VA 8단계 가속 가중치를 사용합니다. 제목은 Video-to-Video로 되어 있지만, 실제로는 원본 영상 입력이 없습니다.
예시 이미지
【B】MiniMax H3 무술 워크플로우 (다중 키프레임) · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 15:11 · 다운로드 17
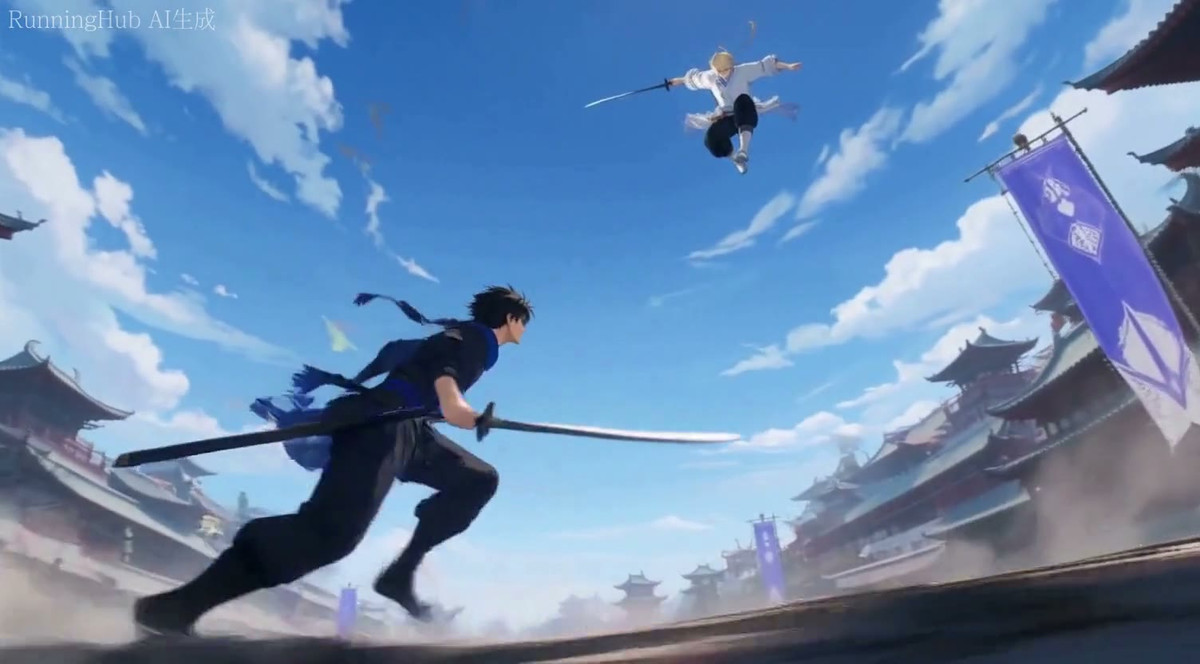
AIKSK의 H3 무술 액션 워크플로우(다중 키프레임 버전): 사실적인 영화 질감, 카메라 워크, 무술 공간 물리, 무술 동작 FL2VA 네 가지 LoRA를 겹쳐 적용하고, 8단계 turbo LoRA로 격투 장면을 생성하며, 다중 키프레임 기능을 포함합니다.
예시 이미지
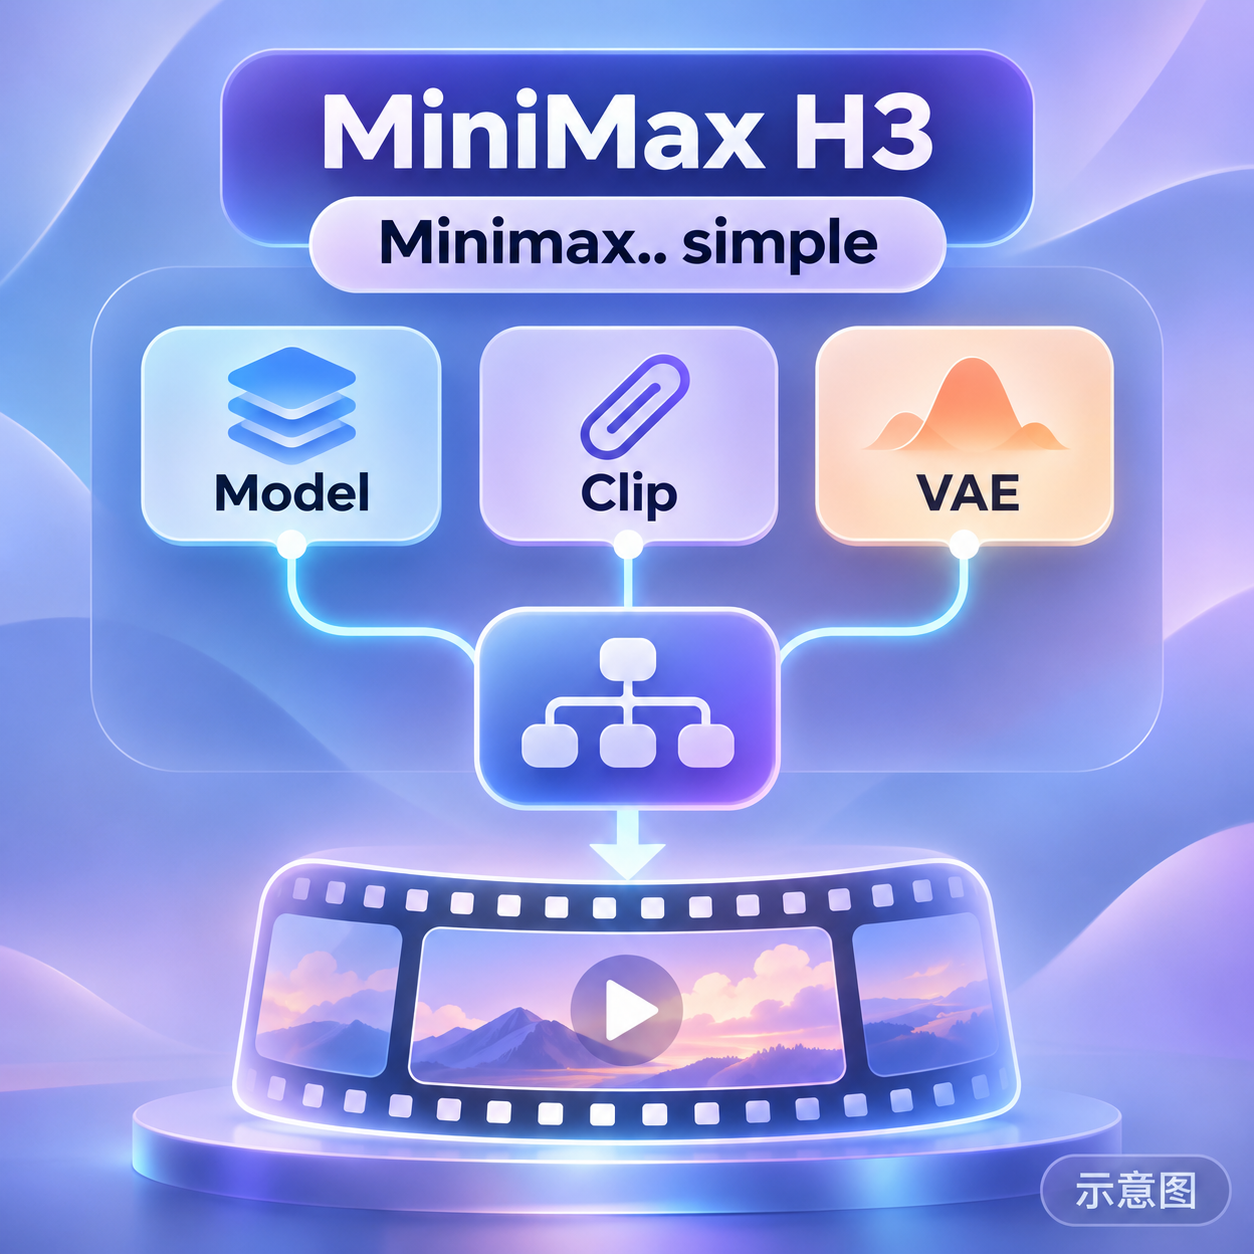
【B】Minimax.. simple · v5
워크플로우 · 버전 업데이트 · 작성자 sy0ww4bb1984 · 게시일 11-02 13:57 · 다운로드 36
대형 H3 올인원 워크플로우: 여러 참조 이미지 + 참조 오디오로 영상을 생성하고, 프레임 수 단위로 배치하여 더 긴 영상으로 연속 생성한 후, 배치로 업스케일링합니다. v5은 주로 새로운 ComfyUI 변경 사항에 맞춰 프로세스를 수정한 버전입니다.
예시 이미지
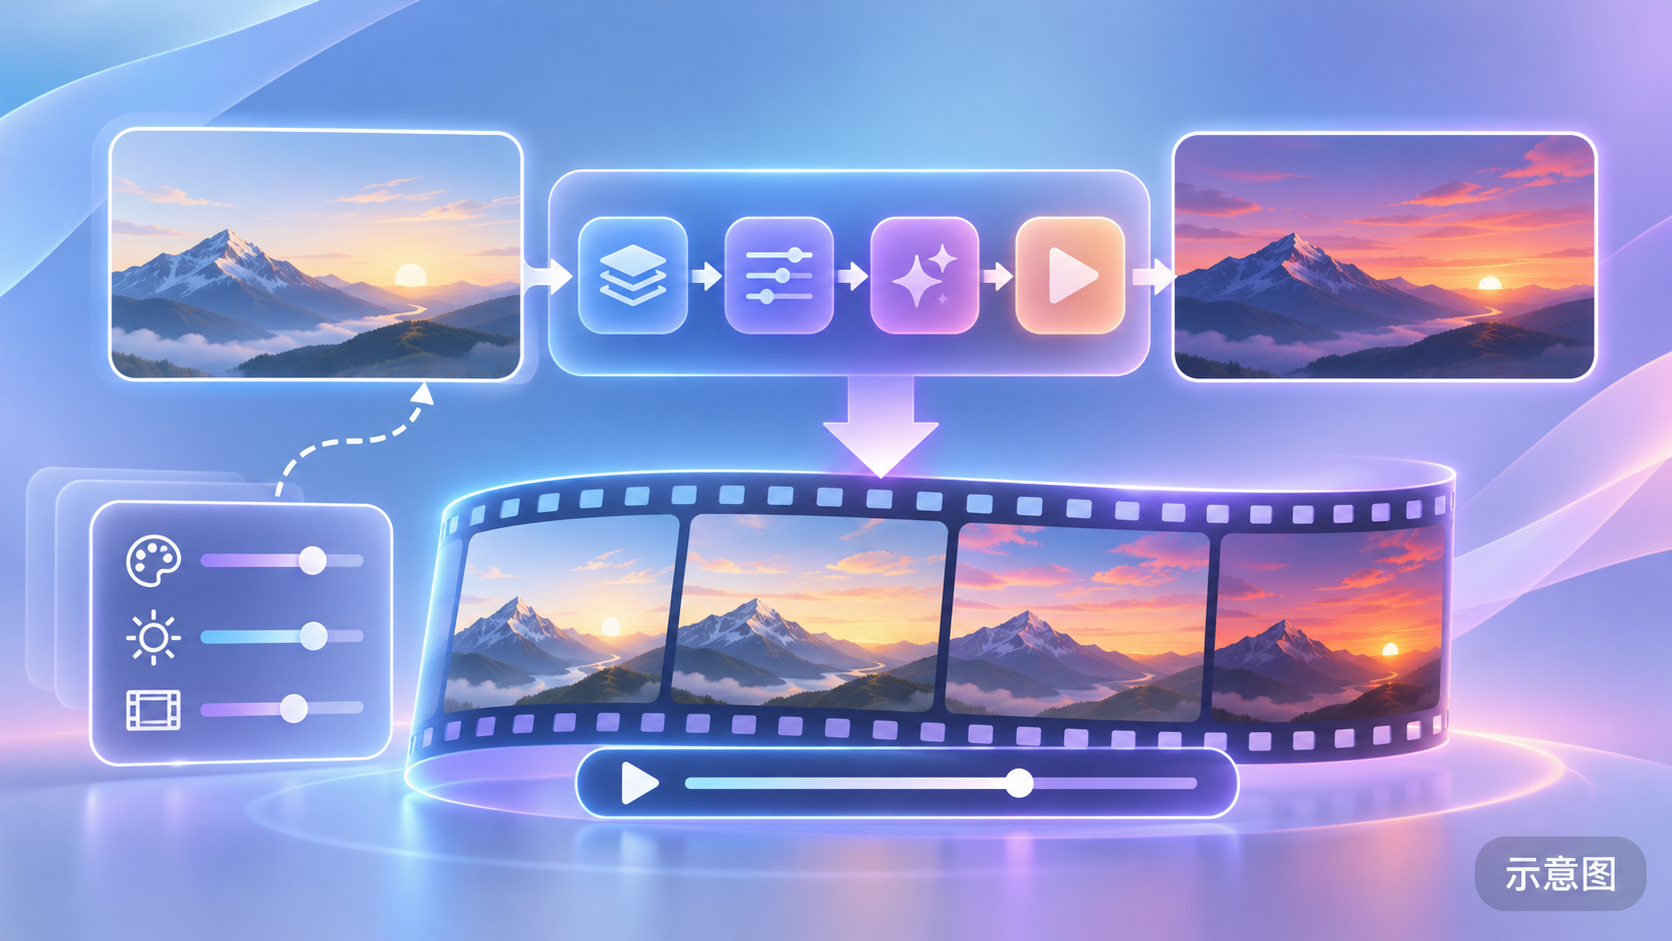
【B】MiniMax H3 LightX2V 4단계 First-Last Frame Video · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 12:27 · 다운로드 27
LightX2V 4단계 솔루션의 첫/마지막 프레임 버전: 첫 프레임과 마지막 프레임 두 장의 이미지로 영상을 생성하며, FL2V turbo 4단계 LoRA와 simple 4단계 Euler 단일 구간 샘플링을 조합합니다.
예시 이미지
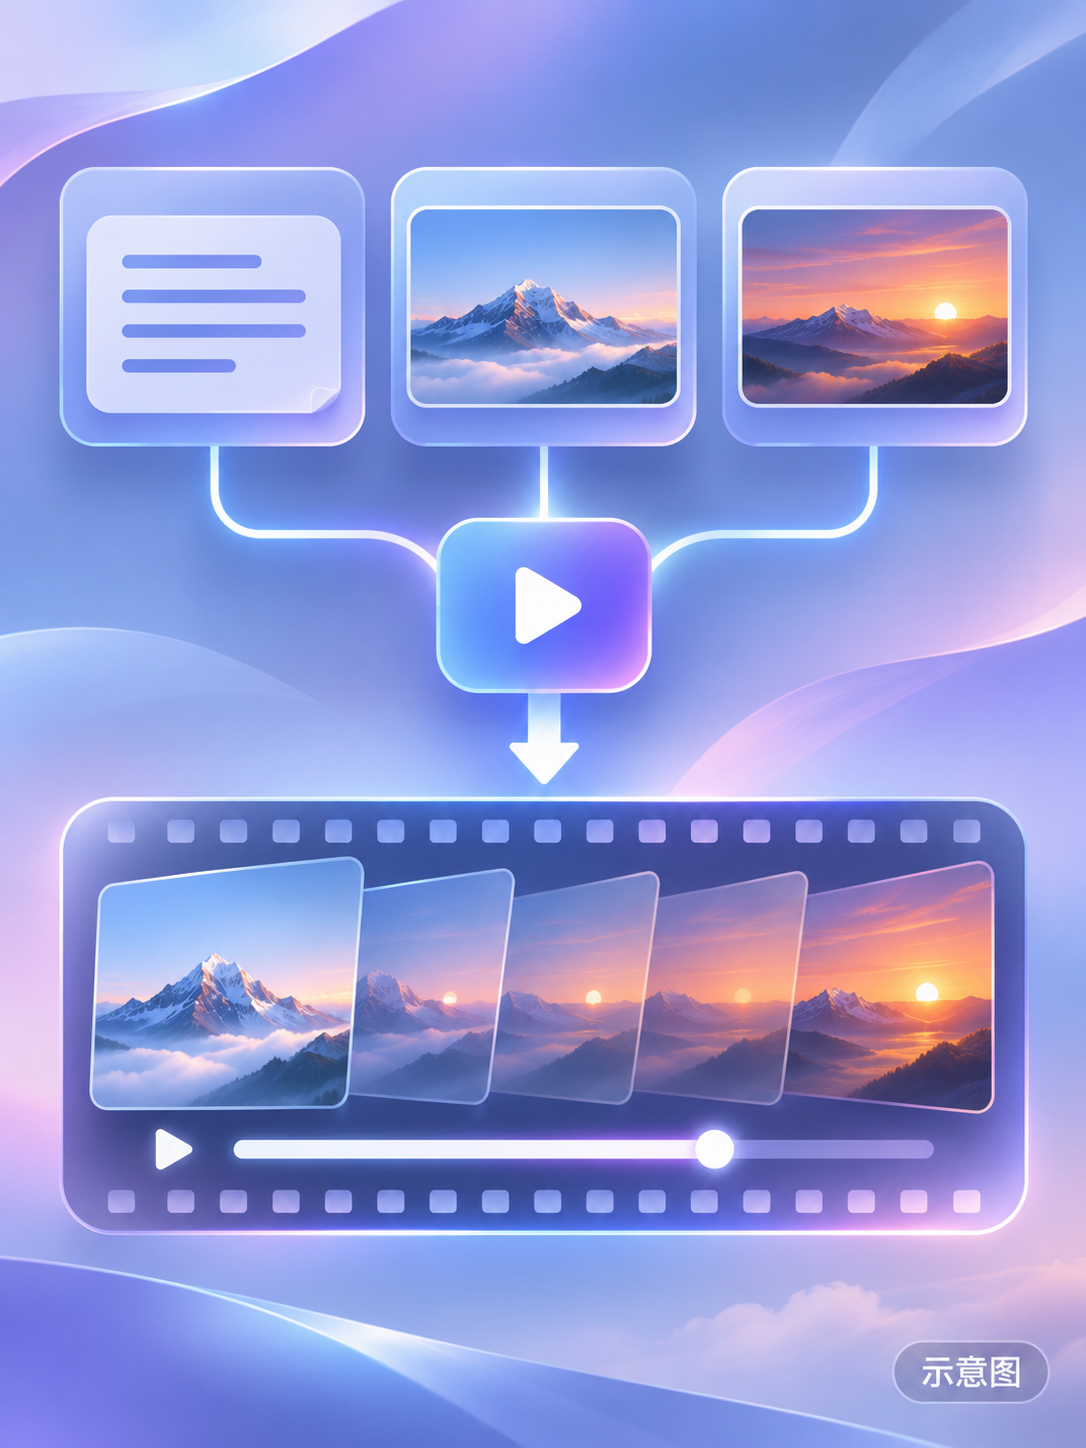
【B】MiniMax H3 FL2VA - Text, First and Last Frame Video · v1.0
워크플로우 · 신규 모델 · 작성자 AIKSK · 게시일 11-02 17:03 · 다운로드 9
AIKSK의 H3 텍스트 생성 / 첫 프레임 / 마지막 프레임 / 첫 및 마지막 프레임 4-in-1 워크플로우: 첫 및 마지막 프레임 입력은 모두 선택 사항이며, 입력된 이미지 수에 따라 작업을 전환하고, 2단계 샘플링(저해상도 생성, 3D 잠재 공간 2배 업스케일링, 저노이즈 정밀 보정)을 수행합니다.
예시 이미지
참고 자료만 수록 (11)
- MiniMax H3 무술 워크플로우 · v1.0 — 워크플로우: AIKSK의 H3 무술 액션 워크플로우(일반 버전): 다중 키프레임 버전과 동일하게 사실적인 영화 질감, 카메라 워크, 무술 공간 물리, 무술 동작 FL2VA 네 가지 LoRA와 8단계 turbo LoRA를 겹쳐 적용하지만, 다중 키프레임 기능은 없습니다.
- MiniMax H3 H25 Hybrid - Multi-Reference 8단계 Build · v1.0 — 워크플로우: AIKSK의 H3 다중 참조 이미지 8단계 워크플로우(H25 Hybrid): 카드에는 47개 노드, turbo LoRA 강도 1.0 하나만 명시되어 있으며, 샘플링은 사용자 정의 노드를 사용하지만 입력 및 파라미터는 명시되지 않았습니다.
- Michaela Gobielle · v1.0 H3 — LoRA: 작가의 오리지널 가상 성인 여성 캐릭터 Michaela Gobeille의 캐릭터 LoRA의 H3 버전으로, 트리거 워드 mikalora를 사용하여 영상에서 이 캐릭터를 생성합니다.
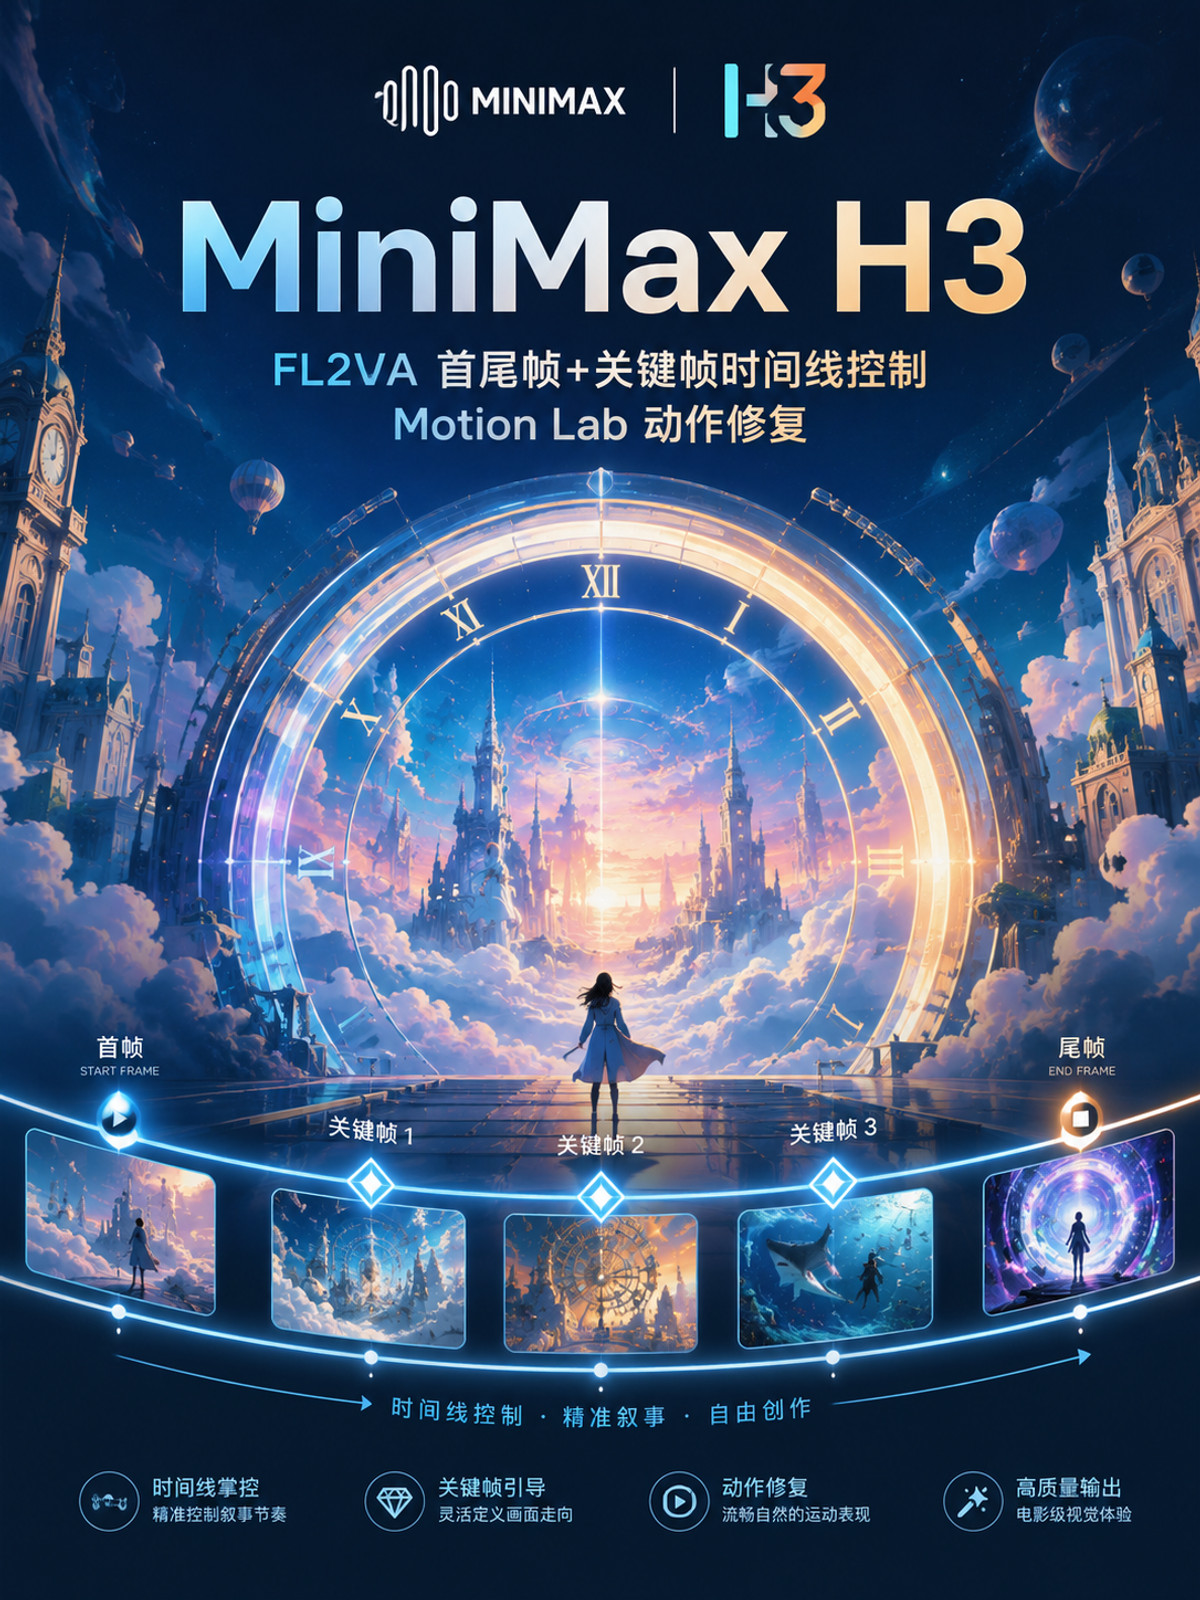
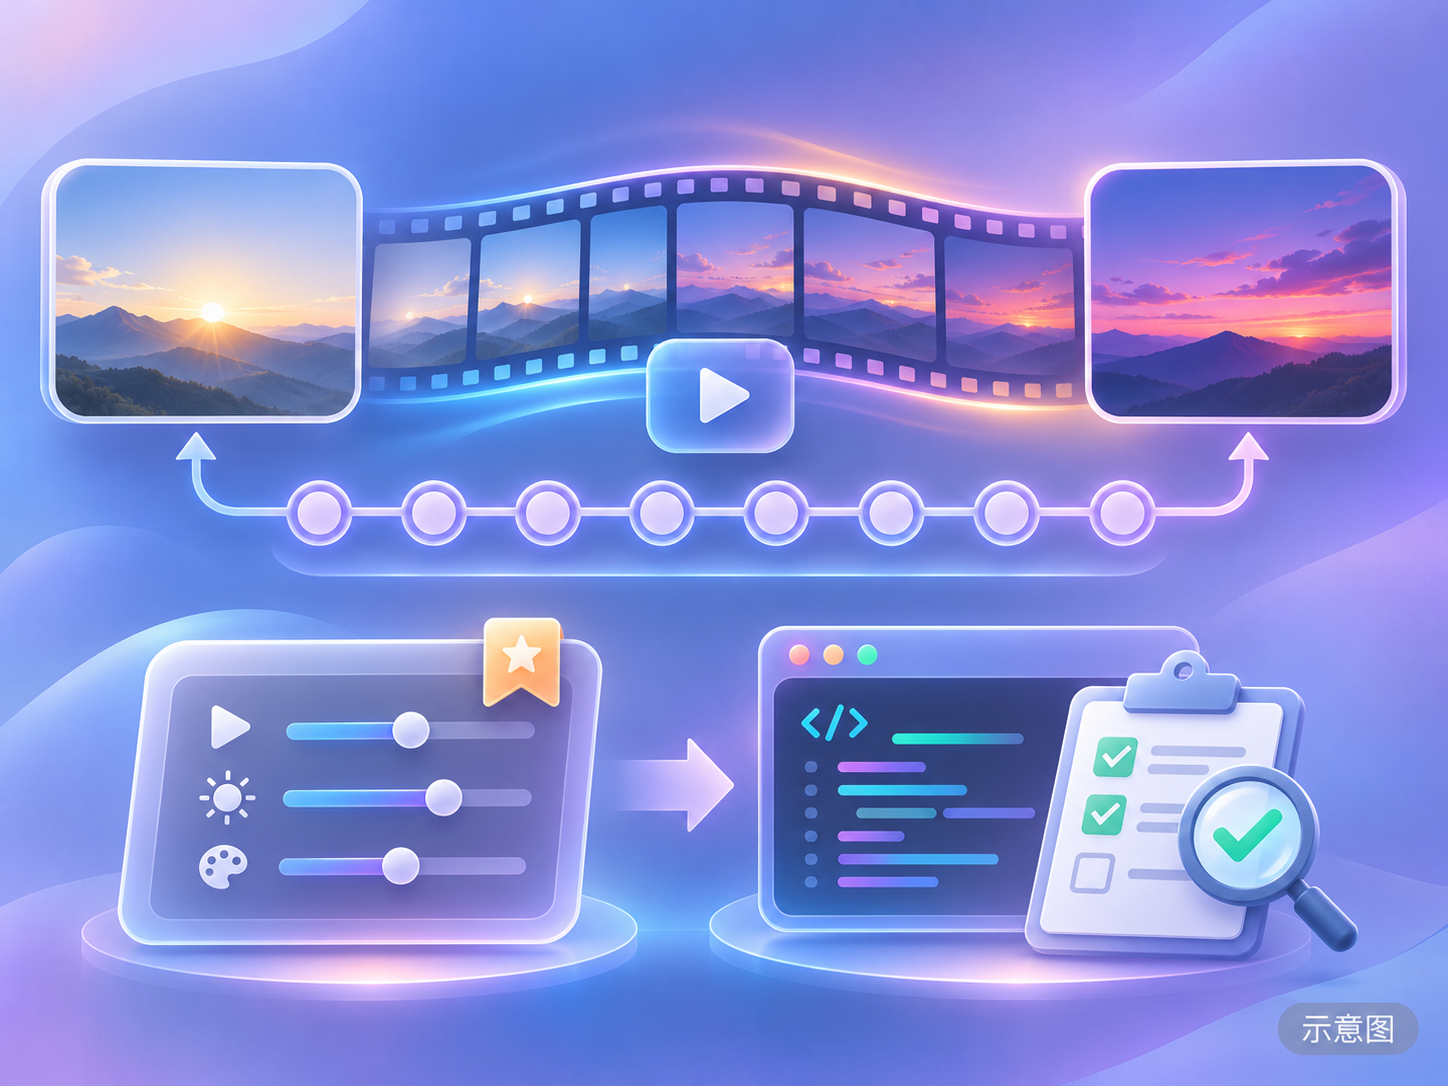
- MiniMax H3 FL2VA - First/Last Frame with Keyframe Timeline · v1.0 — 워크플로우: AIKSK의 H3 첫/마지막 프레임 + 키프레임 타임라인 워크플로우: 파일명은 “FL2VA 첫/마지막 프레임 + 키프레임 타임라인 제어 + Motion Lab 동작 복원”으로 되어 있지만, 카드에는 80개 노드만 제공되며 LoRA는 포함되지 않고 샘플링은 사용자 정의 노드를 사용합니다.
- MiniMax H3 OpenVDN DMD8 Reference-to-Video · v1.0 — 워크플로우: OpenVDN DMD8 솔루션의 참조 이미지 버전: 참조 이미지 한 장으로 영상을 생성하며, OpenVDN의 vdn-minimax-h3(stage_dmd_8nfe) 실행 계획이 모델, 샘플러 및 sigma를 지정하고, 단일 구간 출력으로 업스케일링 후처리 단계가 없습니다.
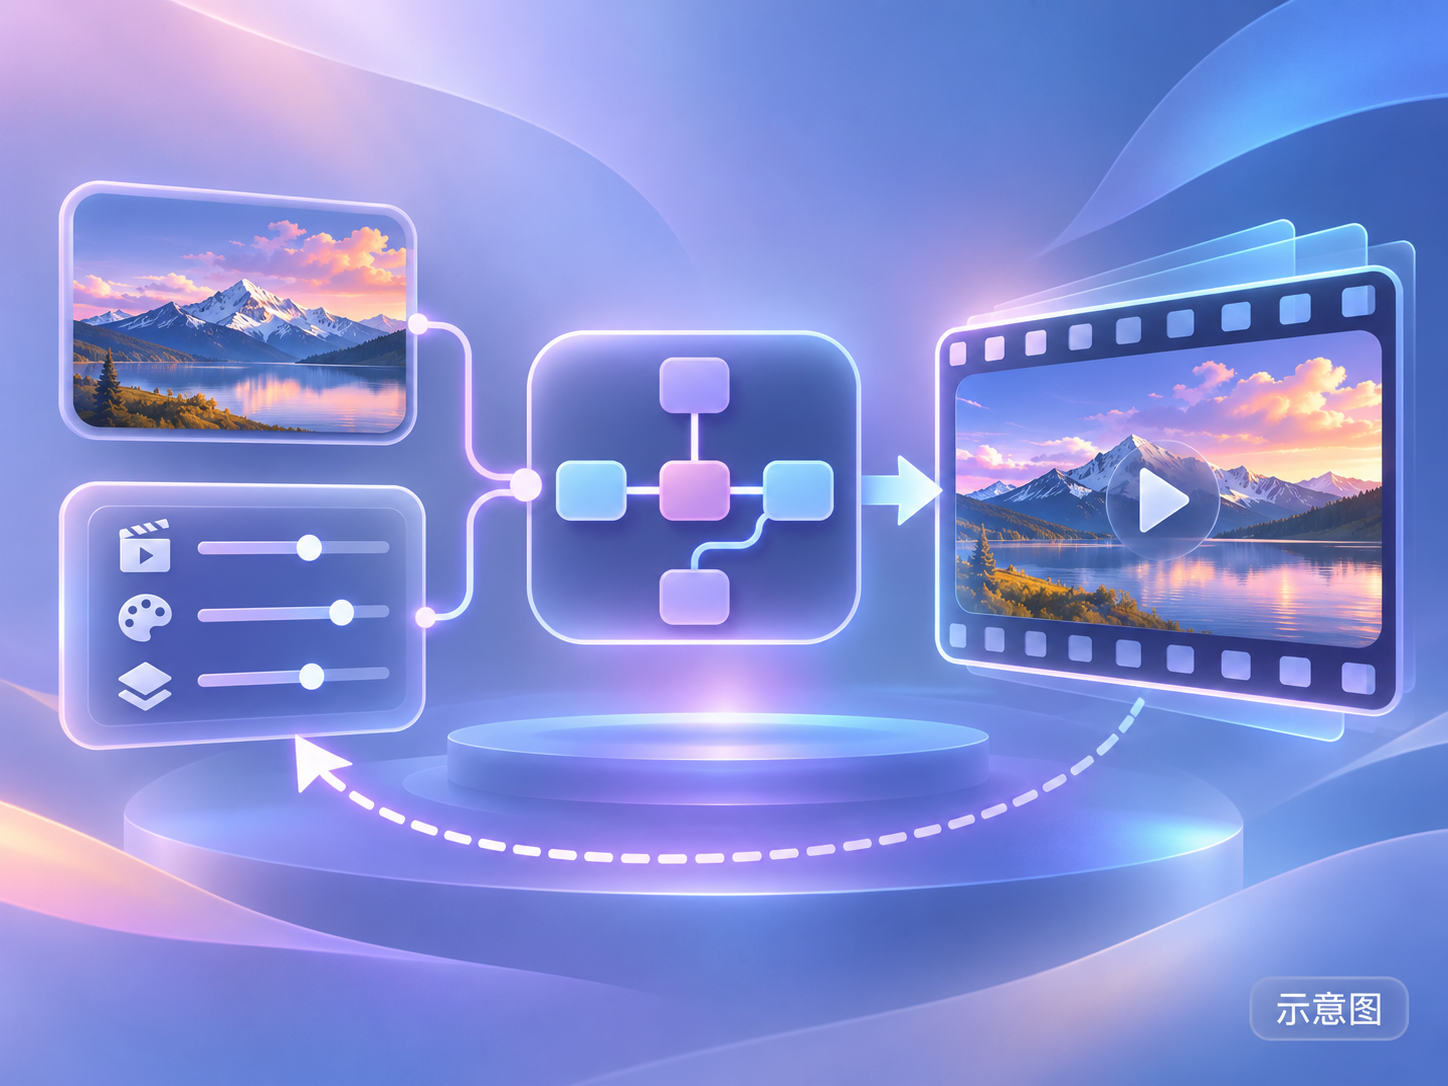
- MiniMax H3 OpenVDN DMD8 First-Last Frame Video · v1.0 — 워크플로우: OpenVDN DMD8 솔루션의 첫/마지막 프레임 버전: 첫 프레임과 마지막 프레임 두 장의 이미지로 영상을 생성하며, VDN 실행 계획이 샘플링을 지정하고 단일 구간 출력합니다. 기본 모델은 FL2VA로 선택되었지만, 조건 작업은 여전히 Ref2VA로 설정되어 있습니다.
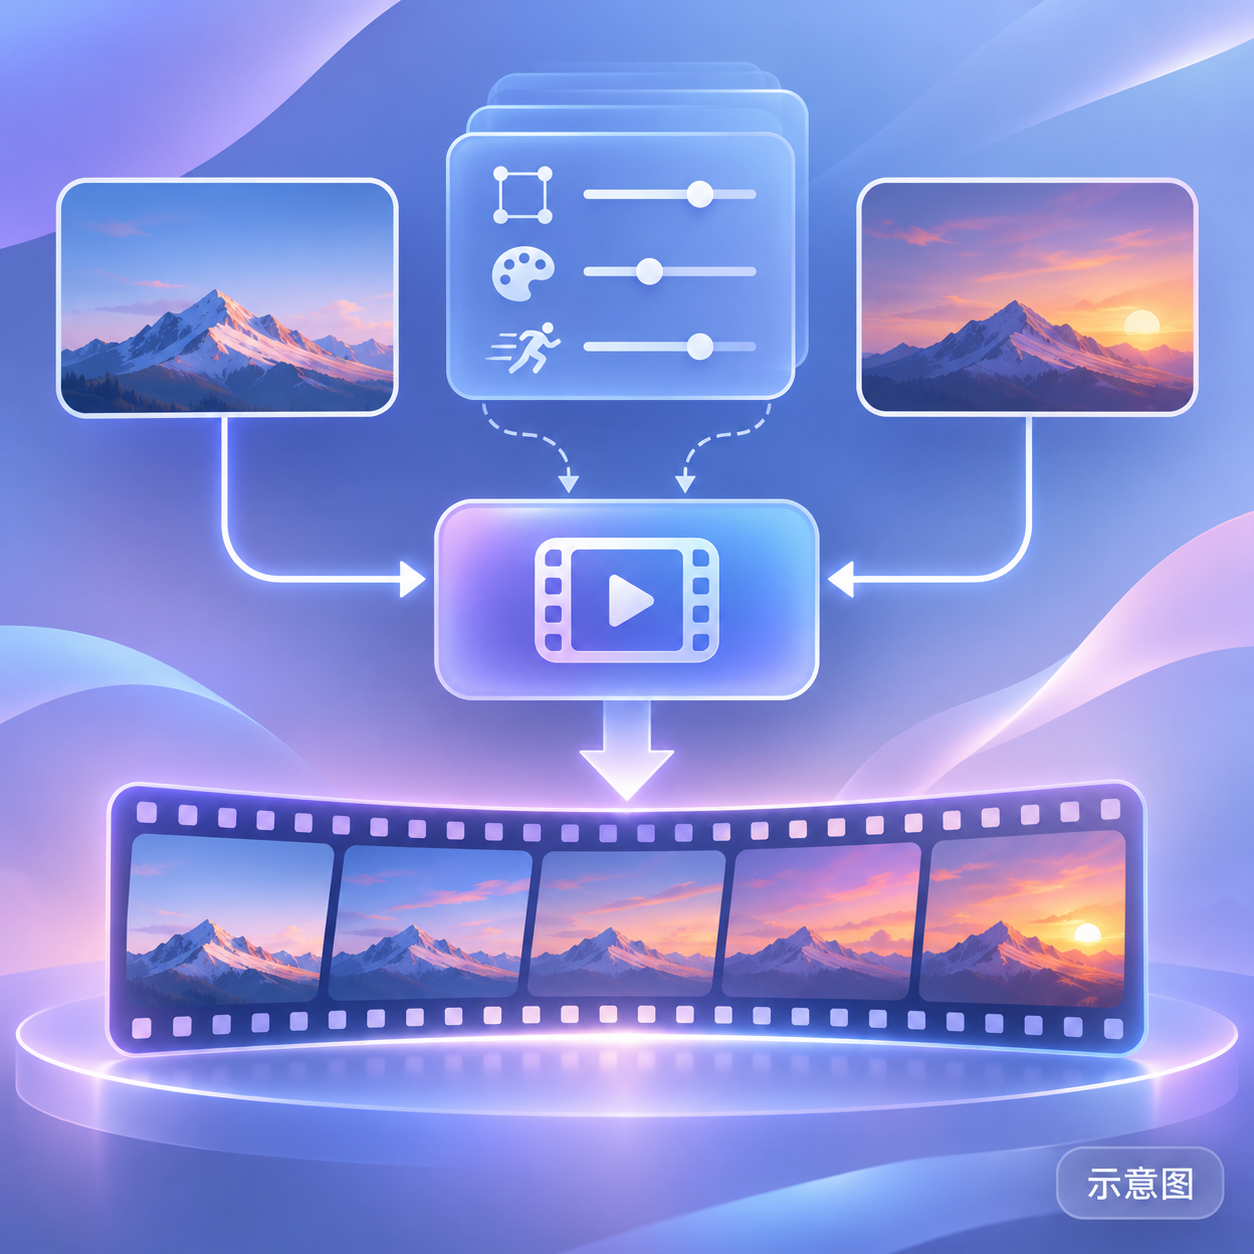
- MiniMax H3 PDD 8단계 First-Last Frame Video · v1.0 — 워크플로우: PDD 8단계 솔루션의 첫/마지막 프레임 버전: 첫 프레임과 마지막 프레임 두 장의 이미지를 연결하고, PDD 설정 노드가 샘플링을 제어하며, FL2VA 8단계 가속 가중치를 사용합니다. 그러나 조건 작업은 여전히 첫 프레임 이미지 기반 영상 생성으로 설정되어 있습니다.
- Lara WhiteMoon · MiniMaxH3 — LoRA: 가상 캐릭터 Lara WhiteMoon의 캐릭터 LoRA의 H3 버전으로, 영상에서 스팀펑크 점성술사 스타일의 여성 캐릭터를 생성하는 데 사용됩니다.
- MiniMax H3 Ref2VA - Multi-Reference with Keyframe Story Beats · v1.0 — 워크플로우: AIKSK의 H3 다중 참조 이미지 + 키프레임 스토리 제어 워크플로우: 파일명은 “Ref2VA 다중 참조 + 키프레임 스토리 제어 + Motion Lab 동작”으로 되어 있지만, 카드에는 87개 노드만 제공되며 LoRA는 포함되지 않고 샘플링은 사용자 정의 노드를 사용합니다.
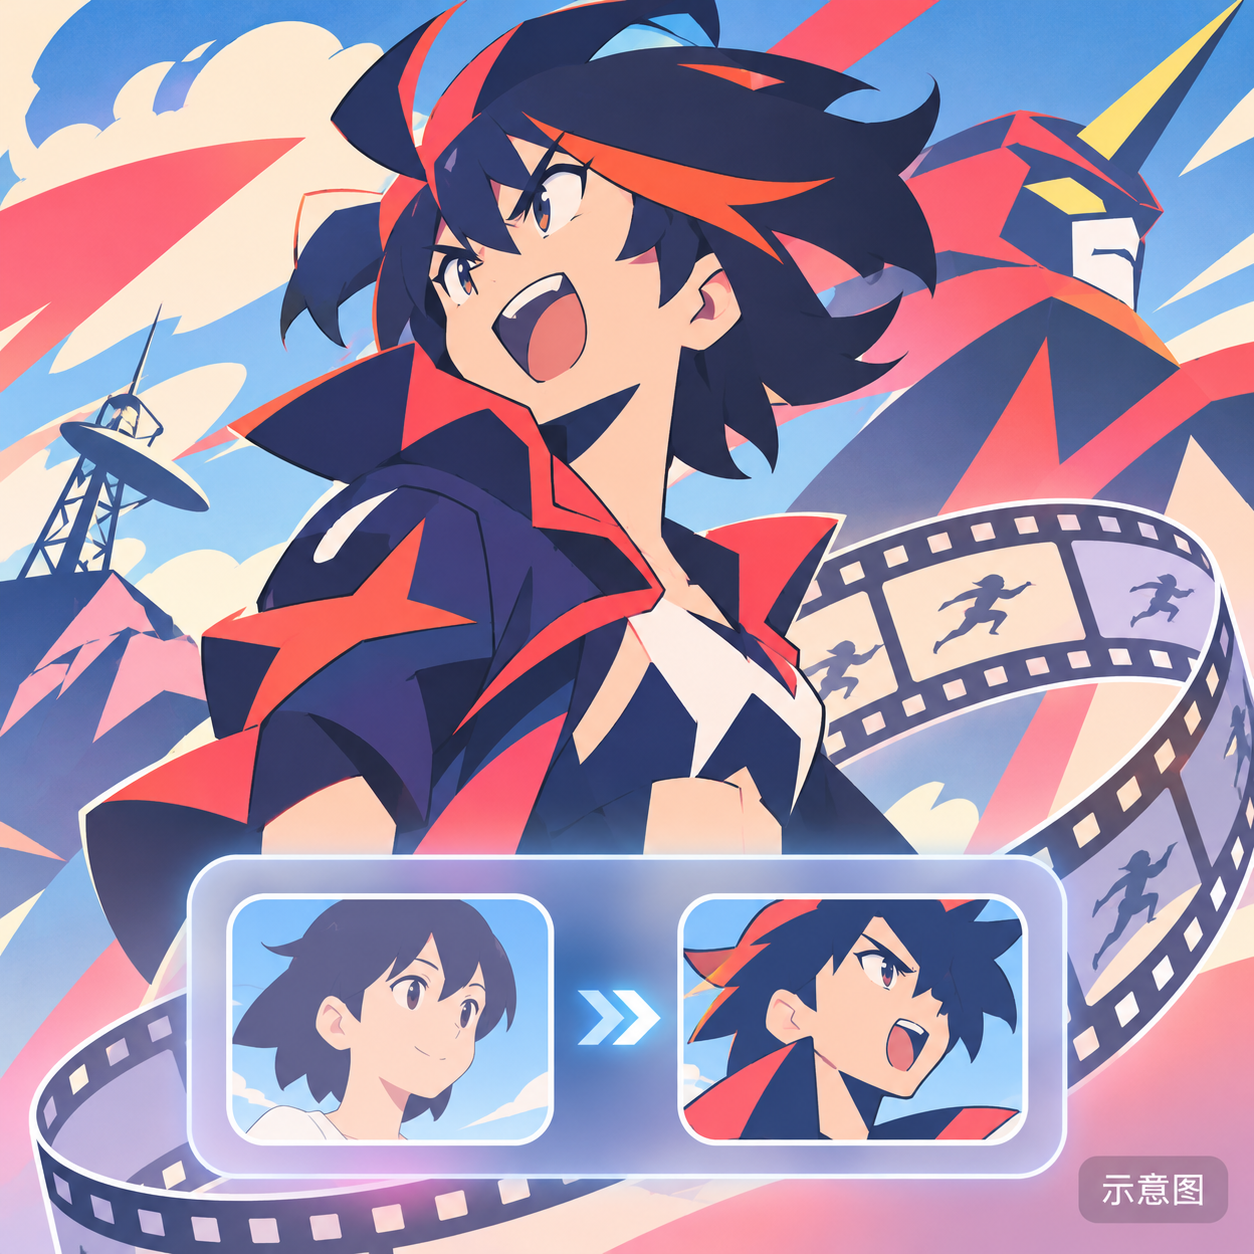
- HIROYUKI IMAISHI - Kill La Kill, Gurren Lagann, FLCL - Minimax H3 · v1.0 — LoRA: 이마ishi Hiroyuki(《킬라킬》, 《천원돌파 그렌라간》, 《FLCL》)의 애니메이션 스타일을 모방한 H3 스타일 LoRA입니다.
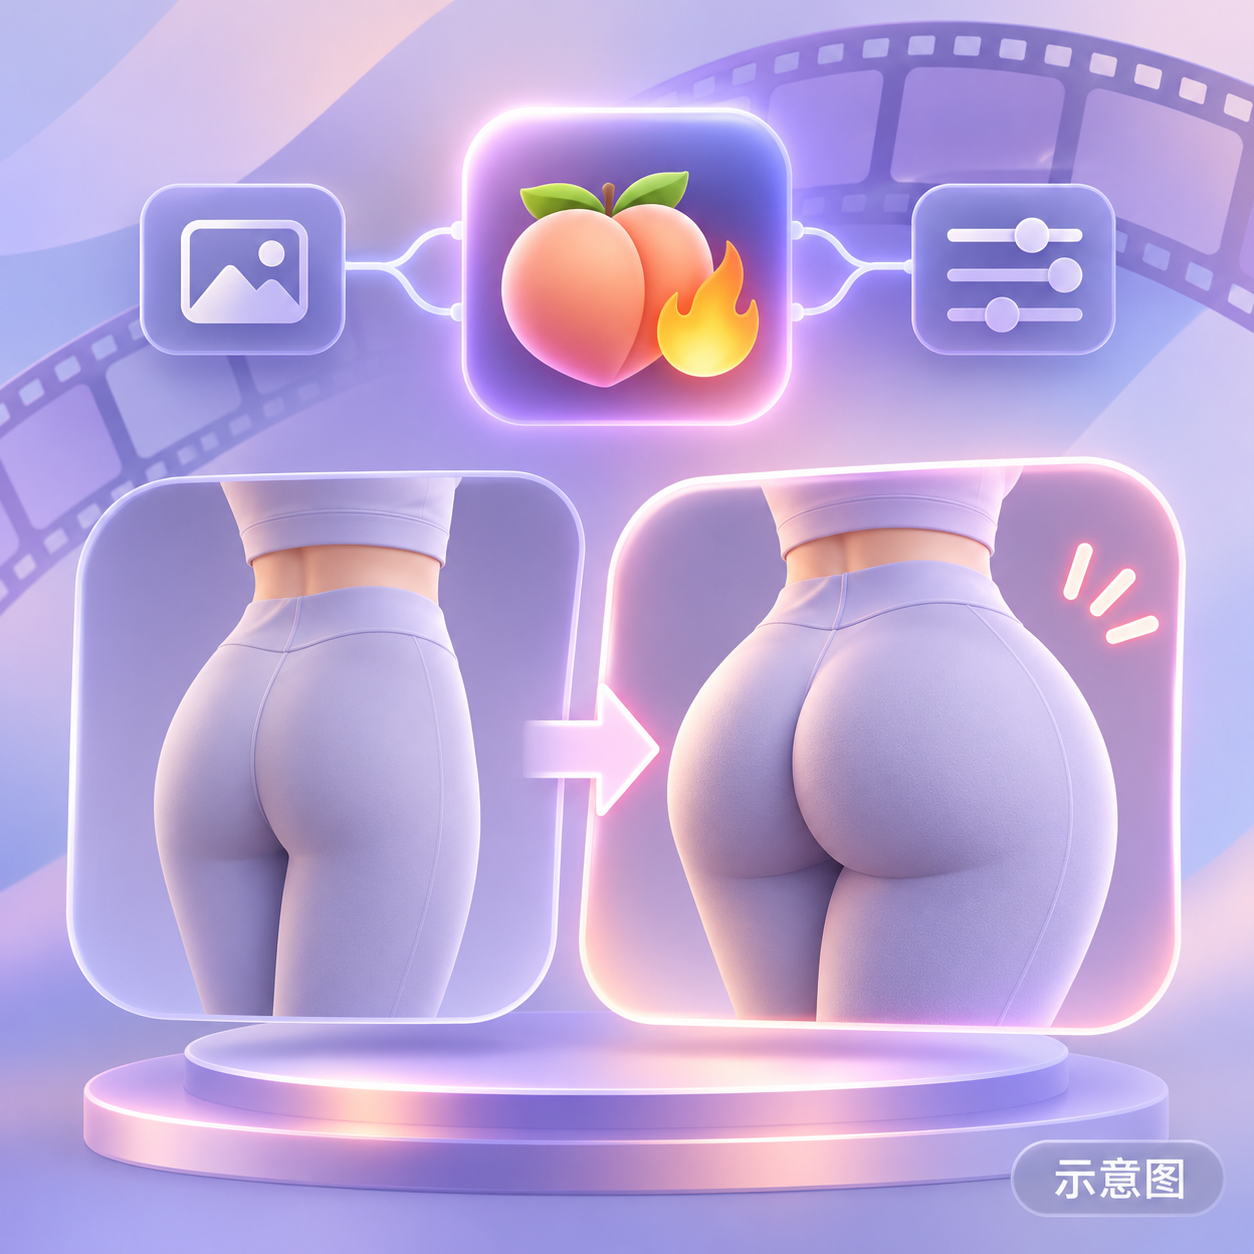
- BigAss 🍑🔥 [ MOSS / Krea2 / SD] · Minimax v1.0 — LoRA: 체형 컨셉 LoRA의 H3 버전: 트리거 워드 BigAss를 사용하여 캐릭터의 엉덩이를 더 풍만하게 만듭니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-02 10:15 → 11-02 21:01(베이징 시간). 추천 이유는 편집 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.