貞貞のAIレーダー · MiniMax H3 · 2026-11-02 夕刊
今号 23 個の新バージョン:強く推奨 1 · 推奨 2 · 注目すべき 9 · 収録のみ 11
編集者按語 今号では 23 個の H3 新バージョンをレビューしました。初推しは KinetiX の数量スライダーです:トリガーワードを使わず、LoRA の正負強度で飛剣、矢、符呪などの同画面内のプロップ数を制御します。強度レベルとサンプルプロンプトも完備しています。H3MD Director のオープンソースノードパッケージは一度の実行で 2〜3 分の長尺動画を生成し、キャラクター設定図ワークフロー v1.1 は頭部クローズアップと表情行を追加しており、いずれも A ランクです。AIKSK はさらに 14 個のワークフローを公開しました:複数参照画像、高解像度再レンダリング、四合一の最初と最後のフレームなどパラメータが明確に記述されている 7 個は B ランク、ほぼ重複しているものやノード統計のみでタスク設定に矛盾がある 7 個は C ランクです。2 つの架空人物 LoRA は説明が薄いため C ランクに降格しました。
強く推奨(1)
【S】KinetiX Instance Quantity Density Slider · v1.0
LoRA · 新モデル · 作者 make676767 · 公開 11-02 14:59 · ダウンロード数 77
「同画面内の飛行プロップ/召喚物の数量」を制御するスライダー LoRA です。正の値では飛剣、矢、手裏剣、符呪などを数個から弾幕のような大量へと増やし、負の値では画面を単一の主体に固定し、余分な複製体を除去します。
S ランク維持:数量制御は H3 のプロンプトでは正確に行うのが難しいため、強度レベルとサンプルプロンプトが完備しており再現可能です。減点理由は、公開されているサンプルに強度が記載されていないことです。
画像
推奨理由
- 新モデル:テキストから動画への生成において、「万剣斉発、矢の雨、暗器の嵐」のような数量制御が難しい大規模シーンをサポートします。また、負の値を用いてベースモデルがランダムに生成する僚機、分身、残像を抑制することも可能です。
- 作者は完全な強度レベルを提供しています:+0.5 〜 +1.0 で武器 1 本が 5〜10 枚に分かれ、+1.2 〜 +2.0 は作者推奨の整然とした陣形レベル、+3.0 〜 +5.0 は弾幕のような大量表示、-2.0 〜 -4.0 で単一主体に固定します。さらに中英バイリンガルのそのままコピー可能なシーンプロンプト 4 条(+2.5、+3.0、-2.5、+2.5)が付属しています。
- 無料で、ライセンスは販売を許可しています。公開後 6 時間でダウンロード数 77 回、いいね数 10 件(注目度のみを示す)
使い方
- トリガーワードは不要で、純粋に LoRA の強度(strength_model)で制御します。まず +1.2 〜 +2.0 を使用し、弾幕のような効果を求める場合は +3.0 以上に上げ、「単一のみ」を求める場合は -2.0 〜 -4.0 を使用します。
- プロンプト内では依然としてプロップの種類(flying swords、arrows、paper talismans など)を明確に記述し、作者提供の 4 条のシーンプロンプトをそのまま適用できます。ステップ数、CFG、サンプラーについては作者から指定がありません。
リスクと制限
- 公開されているサンプルは動画 2 本のみで、プロンプトや強度が添付されていないため、各レベルの実際の差異を確認できません。また、センシティブレベルのサンプル 4 件は非表示になっています。
- 作者は訓練データと訓練方法を記載していません。負の値による「単一主体固定」が人物群像に対して副作用があるかどうかは説明されていません。本項目では動画を確認しておらず、実行も行っていません。
推奨(2)
【A】MiniMax H3 Character Sheet | Turnaround From One Photo · v1.1
ワークフロー · バージョン更新 · 作者 AusBoss · 公開 11-02 13:21 · ダウンロード数 237
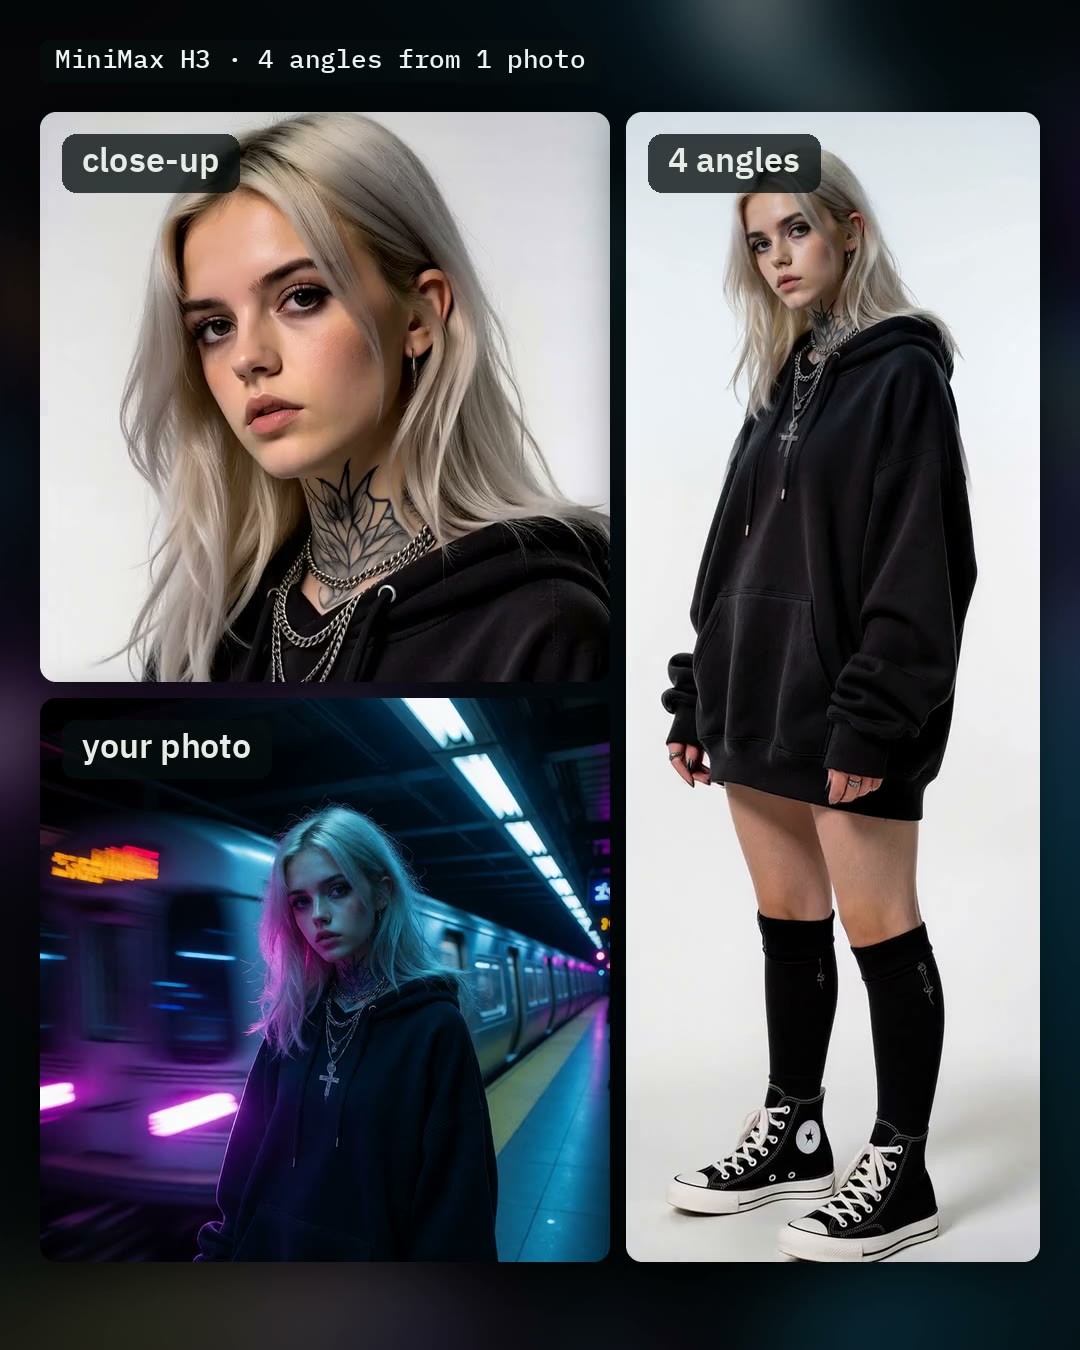
人物写真を ComfyUI に取り込み、H3 が同一人物の正面、斜め横、真横、背面の四方向ビュー設定図(静止画)を描画します。v1.1 では、任意で頭部クローズアップ行、表情行、顔面再描画が追加されました。
A ランク維持:新しいスイッチの変更点は具体的であり、デフォルトではオフのため既存の使用方法に影響しません。サンプルと依存関係も明確に記載されています。S ランクに昇格しなかった理由は、これが小幅な増分であること、およびモデルサイズとライセンス地域制限が実際のハードルとなるためです。
画像
推奨理由
- バージョン更新:3 つのスイッチが追加され、ファイルを開いた際はすべてオフです。すべてオフの場合、出力は v1.0 と同じになります。「Close-ups under the sheet」をオンにすると設定図の下に頭部クローズアップ 4 枚の行が追加されます(H3 をもう一度実行するため、約 70 秒増加)。「Expressions instead of head turns」をオンにするとその行が 4 つの表情に置き換わり、各ボックス内のテキストは自由に書き換え可能です。「Redraw the faces」をオンにすると H3 が上半分を再処理し、小さな顔をよりクリーンにします(約 75 秒増加)。
- 実在の人物写真からキャラクターの一貫性のある多視点参照を作成し、それを H3 の参照画像からの動画生成に使用することをサポートします。既存機能は保持されています:背景の記述が可能で、写真に写っていない部分を補完できます(作者によれば「blue jeans and white sneakers」と記述することで胸像を全身に補完可能)。Fast スイッチでは 10 ステップで 18 ステップを代替し、Upscale 2x では SeedVR2 を使用して 6144 × 3072 に拡大します。
- 無料で、ライセンスは販売を許可しています。動画 1 本 + サンプル画像 5 枚。本バージョンのダウンロード数は 237 回、モデル全体の累計ダウンロード数は 1842 回、いいね数は 128 件(注目度のみを示す)。
使い方
- minimaxH3CharacterSheet_v11.json をインポートします。ComfyUI 0.30.0 以上と AusBoss nodes 2.15.0 以上が必要です(ComfyUI-Manager で AusBoss を検索し、インストール済みの場合は先に更新してください)。初回実行時には約 42 GB のモデルが読み込まれます。
- 拡散モデルには H3 の Ref2VA バージョンを使用します(FL2VA ではありません)。さらに H3 の Qwen3-VL テキストエンコーダと動画 VAE が必要です。Upscale 2x には SeedVR2 が別途必要です。具体的なファイル名とディレクトリはモデルカードを参照してください。
- 人物が鮮明な写真を 1 枚読み込み、任意で背景と「写真に写っていない部分」を入力します。新しいスイッチは必要に応じてオンにし、デフォルトでは 3072 × 1536 の四方向ビュー画像 1 枚を出力します。
リスクと制限
- 出力は静止画の設定図であり動画ではありません。作者は写真でのみテストしたと明記しており、背面は H3 が写真から推測したものです。強い色光の下では肌色が薄くなる可能性があります。
- 入力は実在の人物写真です。他人の写真で設定図を作成する場合は本人の許可が必要であり、肖像権に関わります。
- モデルカードには H3 コミュニティライセンスの適用地域に EU、英国、韓国、米国が含まれないと明記されています。モデルファイルの合計サイズは大きいです。本項目では実行を行っていません。
【A】H3MD Director – 2–3 min long videos with MiniMax H3 (ComfyUI) · v0.1.1
ワークフロー · 新モデル · 作者 1113800942188 · 公開 11-02 15:06 · ダウンロード数 65
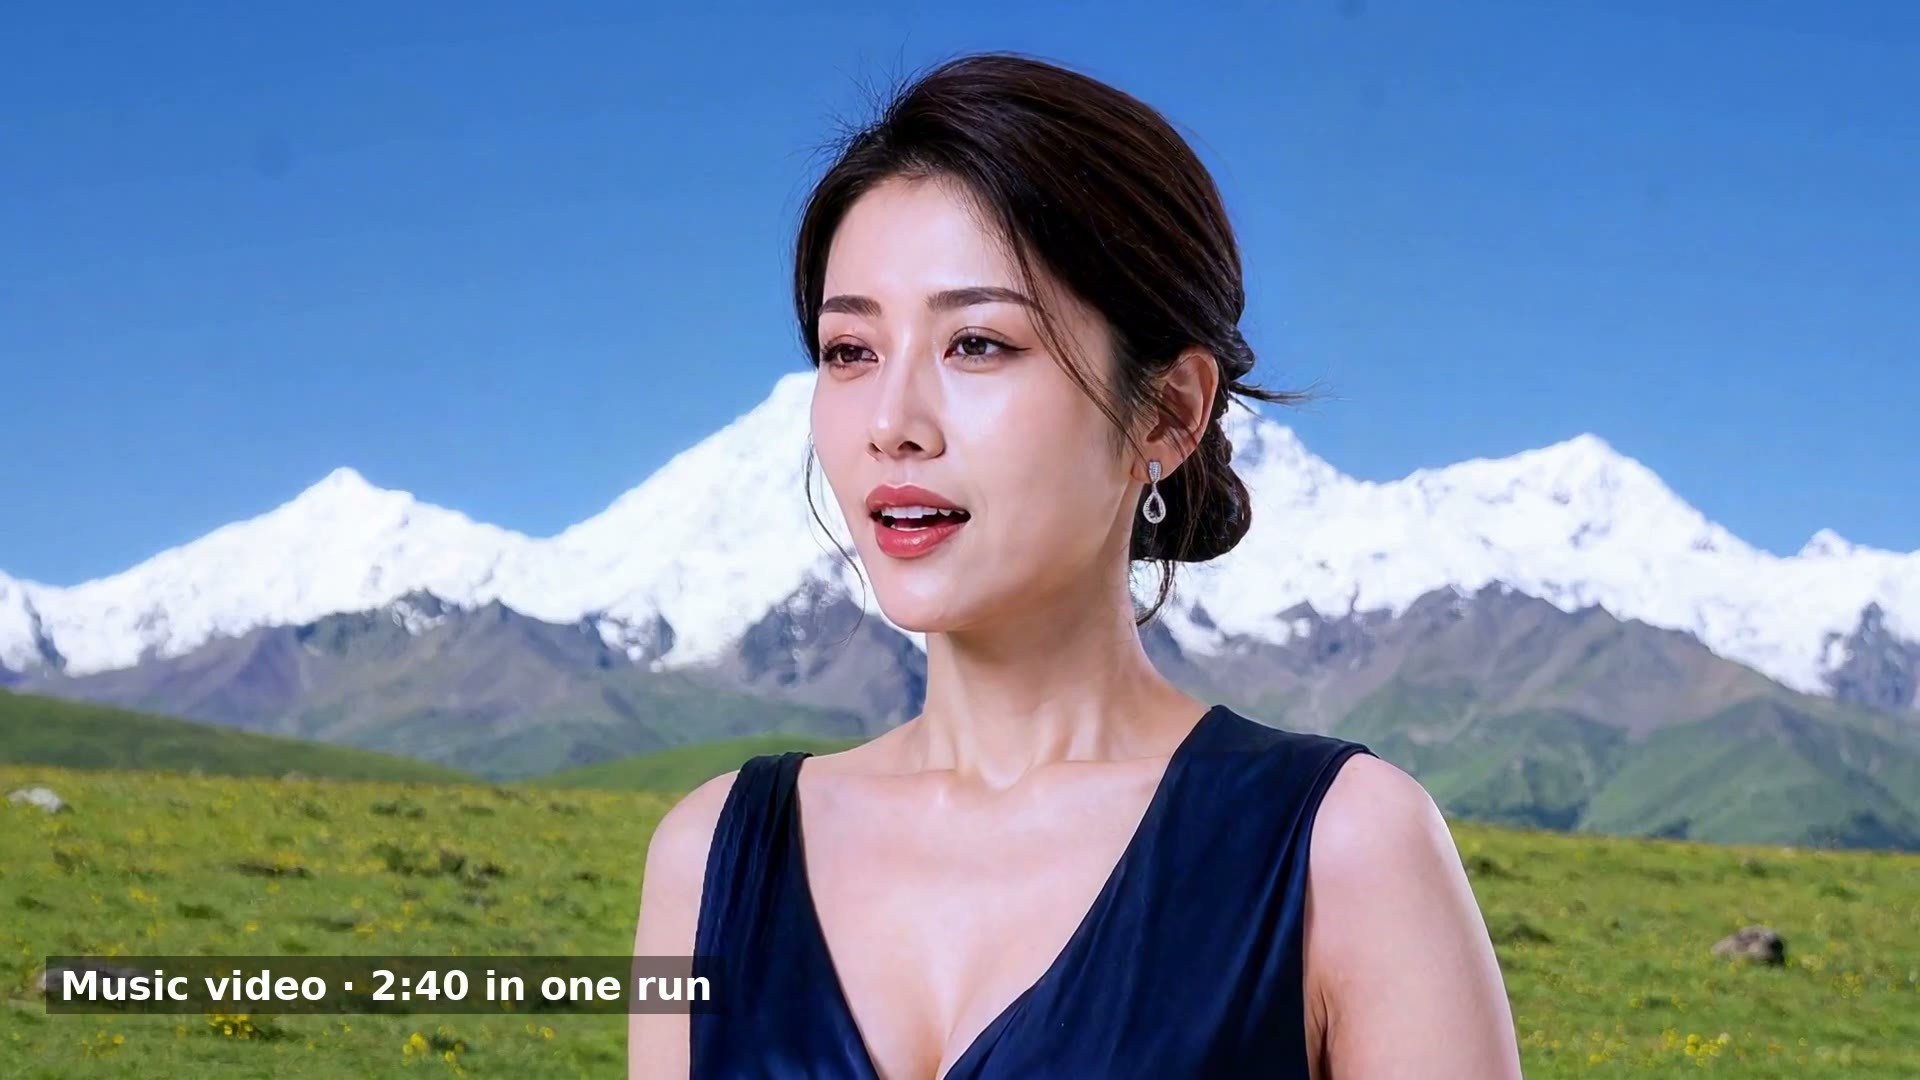
オープンソースの ComfyUI ノードパッケージ + サンプルワークフロー:一度の実行で H3 を用いて 2〜3 分の長尺動画を生成します。連続したロングショットでも、ストーリーボード計画に基づくマルチショットシーケンスでも可能です。
A ランク維持:H3 の単一セグメント 10〜15 秒を分単位まで拡張し、さらにセグメントごとの修復も可能です。用途とインストール方法は明確です。S ランクに昇格しなかった理由は、初版であること、依存関係が多いこと、計算リソース要件が記載されていないこと、および本レポートの作者と謝辞関係にあるため保守的に評価したからです。
画像
推奨理由
- 新モデル:長尺動画、マルチショット短編映画、ミュージックビデオをサポートします。ロングショットは各セグメントが前のセグメントの最後の 1.6 秒分の潜在空間重複を用いて継続生成され、ハードカットのショットではそれぞれの参照画像で再開できます。色/コントラスト統計を最初のセグメントに引き戻すことでドリフトを抑制します。
- ディレクターパネル(ショットごとの長さ、プロンプト、参照画像、音声ロックの設定)、深度 + SAM3 によるモーション転送、リップシンクミュージックビデオ、テキストから動画への生成が付属しています。作者によれば、長尺動画は 1080P、単一セグメント 15 秒で最大 2K まで対応可能であり、低 VRAM/チャンクオプションも備わっています。
- 無料で、AGPL-3.0 オープンソースです。GitHub README にインストール、依存関係、セグメント再実行、チェックポイントからの再開方法が記載されています。公開後 6 時間でダウンロード数 65 回(注目度のみを示す)。
使い方
- ComfyUI-Manager で「H3MD Director」を検索するか、GitHub リポジトリを custom_nodes にクローンします。ComfyUI は 0.43 以上が必要です(ネイティブ H3 サポート)。zip ファイル内の H3MD Director.json を ComfyUI にドラッグし、不足しているノードパッケージは Install Missing Custom Nodes で補完します。モデルはワークフロー内の Model links の説明に従ってダウンロードしてください。
- README では、まず最初のセグメントのみを実行して(Loop ノードの stop_after を 1 に設定)画面と速度を確認し、その後 resume_from_cache をオンにして全体を実行することを推奨しています。特定のセグメントが破損した場合は、rerun_segments に対応するセグメント番号を入力してその部分のみを再実行します。
- README では、各ショットのプロンプト作成に作者の h3md-prompt プロンプト仕様を使用することを推奨しています。さらに ComfyUI-ClipProj、ComfyUI-VFI(フレーム補間)、KJNodes、rgthree などのノードパッケージに依存しており、学習型潜在空間拡大モデルはオプションです。
リスクと制限
- v0.1.1 は最初の公開版であり、作者は 2〜3 分の動画全体の所要時間と VRAM 要件を提供していません。センシティブレベルのサンプル 3 件は非表示で、確認できるのは 1080p の動画 2 本です。
- AGPL-3.0 ライセンスであり、変更して再配布する場合はオープンソースにする必要があります。モデルカード内の RunningHub リンクは作者の招待リンクです。
- 作者の謝辞リストに T8(本レポートの作者)が含まれています。本項目の評価はカード面と README のみに基づいています。本項目では動画を確認しておらず、実行も行っていません。
注目すべき(9)
【B】MiniMax H3 Ref2VA - Multi-Reference Video Generation · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 17:05 · ダウンロード数 20
AIKSK の H3 マルチ参照画像からの動画生成ワークフローです。5 枚の参照画像を同時に Ref2VA 条件に接続し、まず低解像度でサンプリングを行い、学習型 3D 潜在空間拡大で 2 倍にした後、低ノイズでリファインします。出力には H3 生成音声が動画に含まれます。
画像
【B】Singularity-V2-x-10Eros-Max · PRISM-DMAD-PDMD
ベースモデル / Checkpoint · バージョン更新 · 作者 0l1v1aR0551 · 公開 11-02 15:46 · ダウンロード数 521
H3 Ref2VA マージベースモデルの新しいバージョンです。Singularity v2 と 10Eros-Max の 8 ステップ Turbo バージョンを、作者が独自に作成した PRISM アルゴリズムでマージしています。作者によれば、このバージョンでは Turbo LoRA を追加しなくても 8 ステップでリアルな肌質感を生成できます。
画像
【B】MiniMax H3 LightX2V 4-Step Video-to-Video · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 12:28 · ダウンロード 25
AIKSKによる3つのH3高速化ソリューションのうち、LightX2Vの参考画像版です。1枚の参考画像から動画を生成し、Ref2V turbo 4 ステップ LoRA と simple 4 ステップ Euler の単一セグメントサンプリングを組み合わせています。タイトルは Video-to-Video となっていますが、画像にはソース動画の入力がありません。
画像
【B】MiniMax H3 Two-Stage HD Video Repaint · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 17:04 · ダウンロード 9
AIKSKによるH3動画の高解像度再レンダリングワークフローです。既存の動画を読み込み、その潜在変数を基盤として注入し、学習型 3D 潜在空間 2 倍アップスケールと高解像度条件付き再構成を経て、低ノイズ・短ステップでの精修を行います。最後に元の音声に戻します。
画像
【B】MiniMax H3 PDD 8-step Video-to-Video with Reference · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 12:25 · ダウンロード 23
3つのH3高速化ソリューションのうち、PDDの参考画像版です。1枚の参考画像から動画を生成し、PDD設定ノードがモデル、サンプラー、sigmaを制御します。専用の Ref2VA 8 ステップ高速化重みを使用します。タイトルは Video-to-Video となっていますが、実際にはソース動画の入力はありません。
画像
【B】MiniMax H3 Martial Arts Workflow (Multi-Keyframe) · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 15:11 · ダウンロード 17
AIKSKによるH3武術アクションワークフロー(マルチキーフレーム版)です。リアルな映画質感、カメラワーク、武術空間物理、武術アクション FL2VA の4つのLoRAを重ね合わせ、8 ステップ turbo LoRA を組み合わせて戦闘シーンを生成します。マルチキーフレーム機能も含まれています。
画像
【B】Minimax.. simple · v5
ワークフロー · バージョン更新 · 作者 sy0ww4bb1984 · 公開 11-02 13:57 · ダウンロード 36
大規模なH3オールインワンワークフローです。複数の参考画像と参考音声から動画を生成し、フレーム数ごとにバッチ処理して長い動画へ連続生成し、さらにバッチ処理でアップスケールします。v5は主に新しいComfyUIの変更に合わせてフローを修正したものです。
画像
【B】MiniMax H3 LightX2V 4 Steps First-Last Frame Video · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 12:27 · ダウンロード 27
LightX2V 4 ステップソリューションの最初と最後のフレーム版です。最初のフレームと最後のフレームの2枚の画像から動画を生成し、FL2V turbo 4 ステップ LoRA と simple 4 ステップ Euler の単一セグメントサンプリングを組み合わせています。
画像
【B】MiniMax H3 FL2VA - Text, First and Last Frame Video · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 17:03 · ダウンロード 9
AIKSKによるH3のテキスト生成 / 最初のフレーム / 最後のフレーム / 最初と最後のフレームの4-in-1ワークフローです。最初と最後のフレームの入力はどちらもオプションで、接続する画像の数に応じてタスクを切り替えます。2セグメントサンプリング(低解像度生成、3D 潜在空間 2 倍アップスケール、低ノイズ精修)を実行します。
画像
収録のみ(11)
- MiniMax H3 Martial Arts Workflow · v1.0 — ワークフロー:AIKSKによるH3武術アクションワークフロー(通常版):マルチキーフレーム版と同様に、リアルな映画質感、カメラワーク、武術空間物理、武術アクション FL2VA の4つのLoRAと 8 ステップ turbo LoRA を重ね合わせていますが、マルチキーフレーム機能はありません。
- MiniMax H3 H25 Hybrid - Multi-Reference 8-Step Build · v1.0 — ワークフロー:AIKSKによるH3マルチ参考画像 8 ステップワークフロー(H25 Hybrid):カードには 47 個のノード、1つの turbo LoRA 強度 1.0、カスタムノードでのサンプリングのみが記載されており、入力とパラメータは記載されていません。
- Michaela Gobielle · v1.0 H3 — LoRA:作者によるオリジナルの架空の成人女性キャラクター Michaela Gobeille のキャラクターLoRAのH3版です。トリガーワード mikalora を使用して動画内でこのキャラクターを生成します。
- MiniMax H3 FL2VA - First/Last Frame with Keyframe Timeline · v1.0 — ワークフロー:AIKSKによるH3の最初と最後のフレームにキーフレームタイムラインを追加したワークフローです。ファイル名には「FL2VA 最初と最後のフレーム + キーフレームタイムライン制御 + Motion Lab アクション修復」と記載されていますが、カードには 80 個のノード、LoRAなし、カスタムノードでのサンプリングのみが示されています。
- MiniMax H3 OpenVDN DMD8 Reference-to-Video · v1.0 — ワークフロー:OpenVDN DMD8ソリューションの参考画像版です。1枚の参考画像から動画を生成し、OpenVDNの vdn-minimax-h3(stage_dmd_8nfe)実行計画がモデル、サンプラー、sigmaを指定します。単一セグメント出力で、アップスケールの後段はありません。
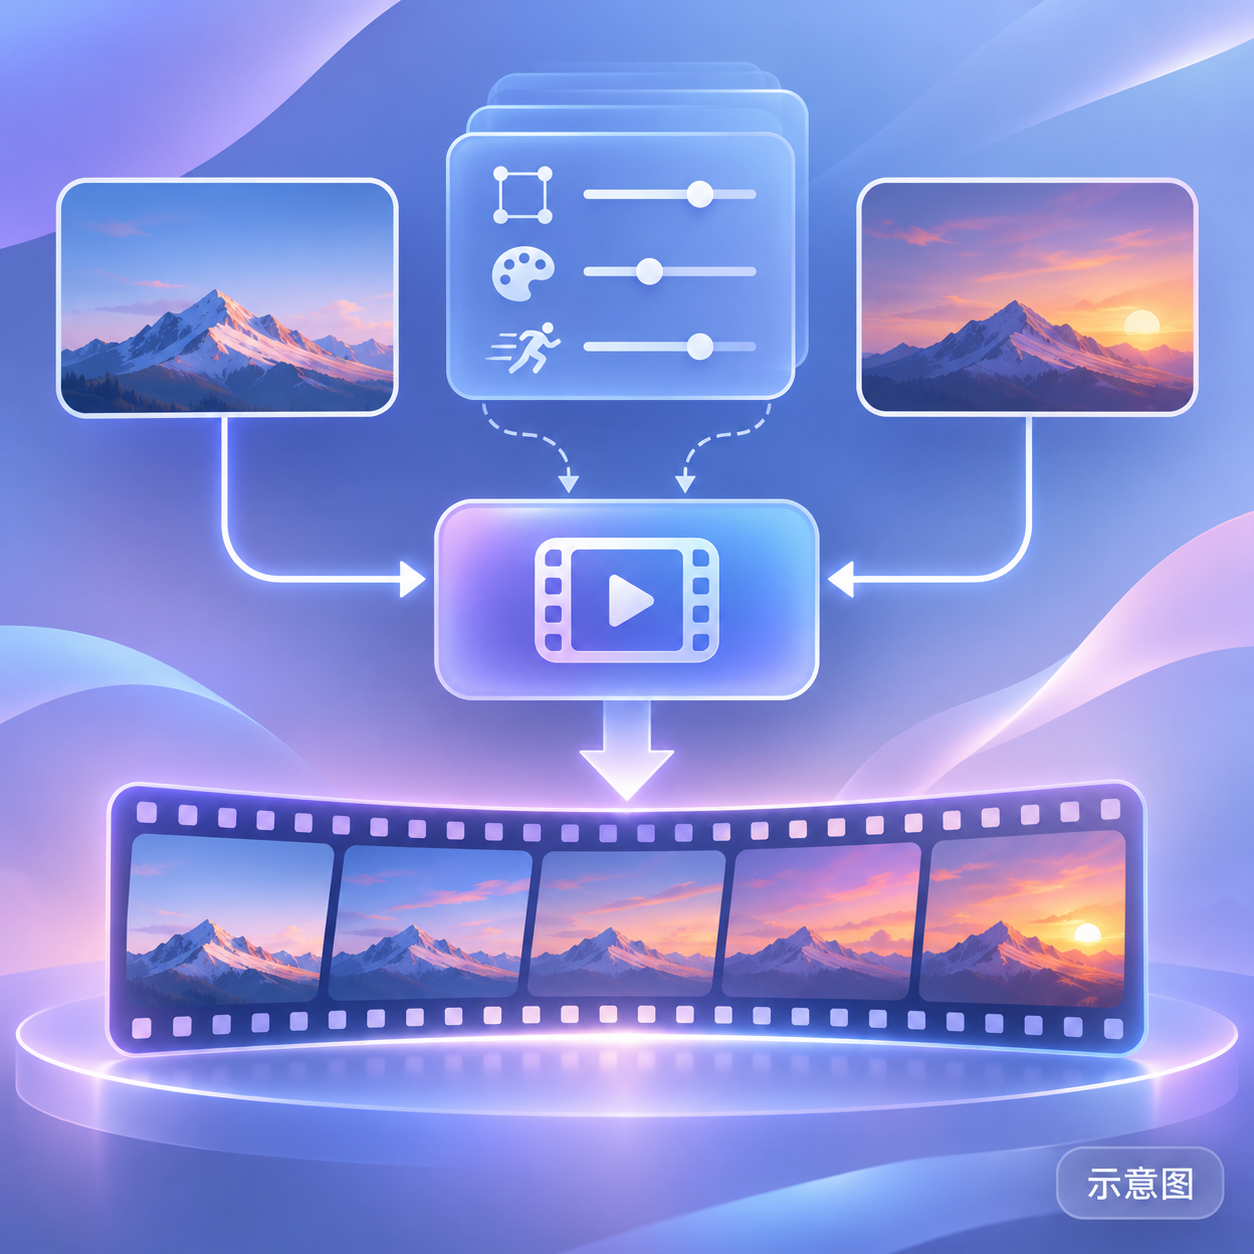
- MiniMax H3 OpenVDN DMD8 First-Last Frame Video · v1.0 — ワークフロー:OpenVDN DMD8ソリューションの最初と最後のフレーム版です。最初のフレームと最後のフレームの2枚の画像から動画を生成し、VDN実行計画がサンプリングを指定します。単一セグメント出力です。ベースモデルには FL2VA が選択されていますが、条件付きタスクは依然として Ref2VA となっています。
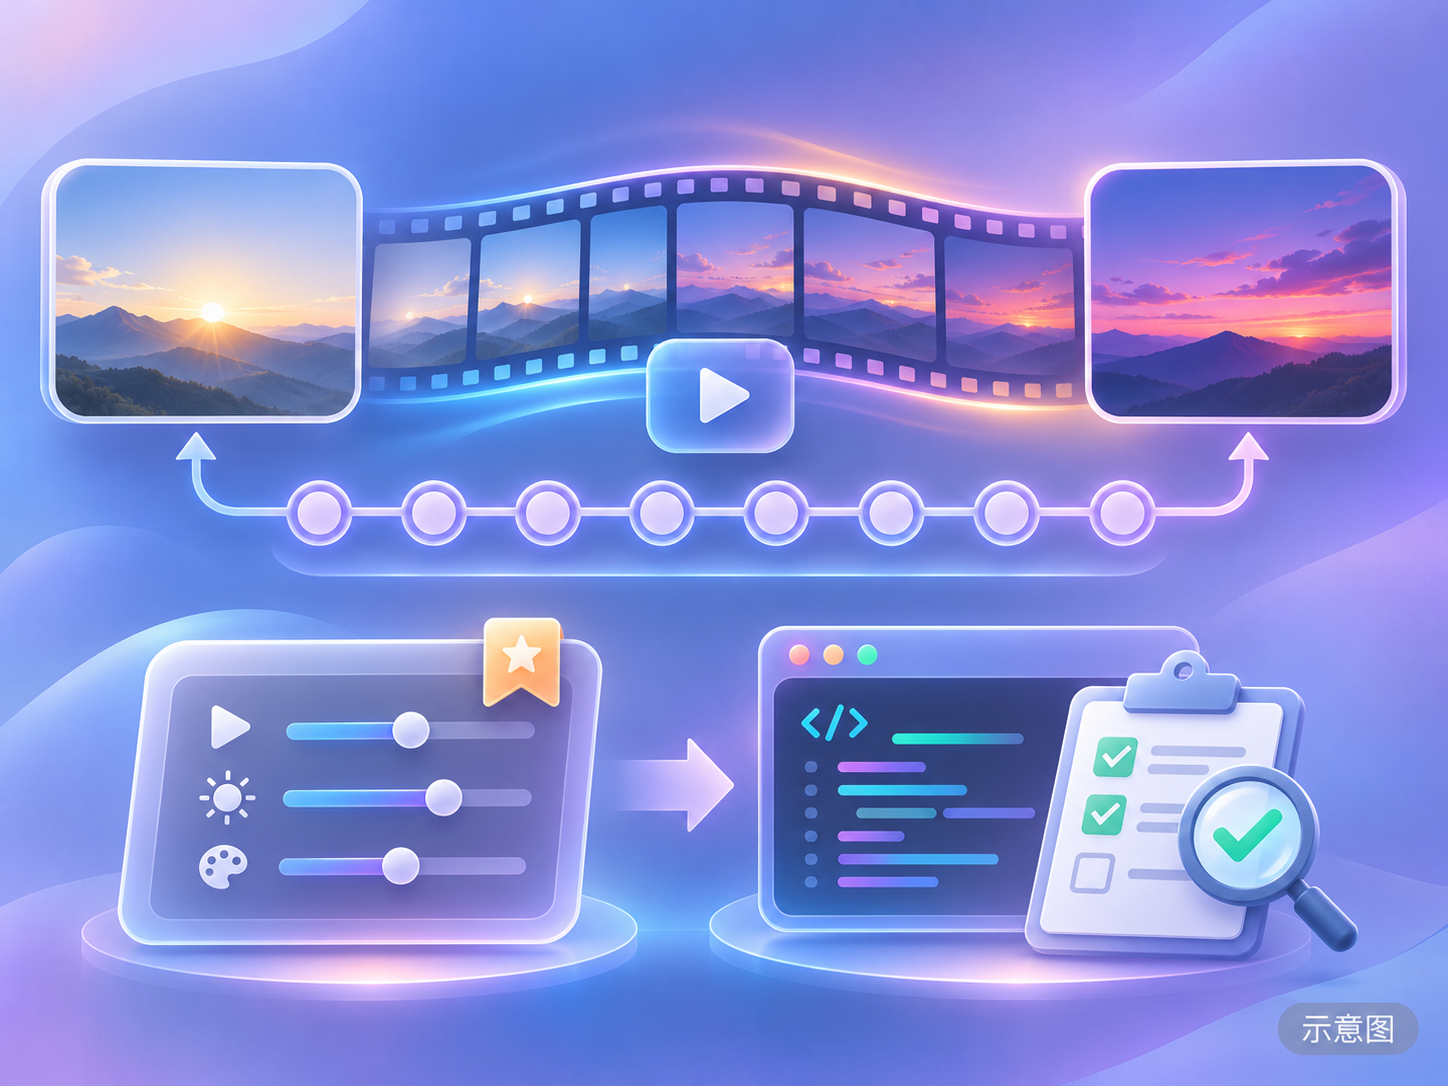
- MiniMax H3 PDD 8-step First-Last Frame Video · v1.0 — ワークフロー:PDD 8 ステップソリューションの最初と最後のフレーム版です。最初のフレームと最後のフレームの2枚の画像を接続し、PDD設定ノードがサンプリングを制御します。FL2VA 8 ステップ高速化重みを組み合わせていますが、条件付きタスクは依然として最初のフレーム画像からの動画生成として記載されています。
- Lara WhiteMoon · MiniMaxH3 — LoRA:架空のキャラクター Lara WhiteMoon のキャラクターLoRAのH3版です。動画内でこのスチームパンク占星術師風の女性キャラクターを生成するために使用します。
- MiniMax H3 Ref2VA - Multi-Reference with Keyframe Story Beats · v1.0 — ワークフロー:AIKSKによるH3のマルチ参考画像にキーフレームによるストーリー制御を追加したワークフローです。ファイル名には「Ref2VA マルチ参考 + キーフレームストーリー制御 + Motion Lab アクション」と記載されていますが、カードには 87 個のノード、LoRAなし、カスタムノードでのサンプリングのみが示されています。
- HIROYUKI IMAISHI - Kill La Kill, Gurren Lagann, FLCL - Minimax H3 · v1.0 — LoRA:今石洋之(『キルラキル』『天元突破グレンラガン』『FLCL』)のアニメ画風を模倣したH3スタイルLoRAです。
- BigAss 🍑🔥 [ MOSS / Krea2 / SD] · Minimax v1.0 — LoRA:体型概念LoRAのH3版です。トリガーワード BigAss を使用して、キャラクターの臀部をより豊かにします。
データ:Civitai公開API(ベースモデル MiniMax H3)、収録期間 11-02 10:15 → 11-02 21:01(北京時間)。推薦理由は編集者による審査済みです。ダウンロード数は注目度を表すに過ぎません。