Radar AI của Trinh Trinh · MiniMax H3 · Bản tin tối 2026-11-02
Kỳ này có 23 phiên bản mới: Đề xuất mạnh mẽ 1 · Đề xuất 2 · Đáng chú ý 9 · Chỉ ghi nhận 11
Lời bình của biên tập viên Kỳ này đã xem xét 23 phiên bản mới của H3. Đề xuất hàng đầu là thanh trượt số lượng KinetiX: không cần từ khóa kích hoạt, điều khiển số lượng các đạo cụ trên màn hình như kiếm bay, mũi tên, bùa chú thông qua cường độ dương/âm của LoRA, với các mức cường độ và câu lệnh mẫu đầy đủ. Gói nút mã nguồn mở H3MD Director tạo video dài 2–3 phút trong một lần chạy, quy trình làm việc hình ảnh nhân vật v1.1 thêm cận cảnh đầu và dòng biểu cảm, cả hai đều đạt điểm A. AIKSK lại phát hành 14 quy trình làm việc: 7 quy trình có tham số rõ ràng như đa ảnh tham chiếu, kết xuất lại độ phân giải cao, khung đầu/cuối 4 trong 1 được xếp hạng B; 7 quy trình trùng lặp gần giống, chỉ có thống kê nút hoặc mâu thuẫn trong cài đặt tác vụ được xếp hạng C; hai mô tả LoRA nhân vật hư cấu quá sơ sài, bị hạ xuống C.
Đề xuất mạnh mẽ (1)
【S】KinetiX Instance Quantity Density Slider · v1.0
LoRA · Mô hình mới · Tác giả make676767 · Phát hành 11-02 14:59 · Tải xuống 77
Một LoRA dạng thanh trượt để kiểm soát “số lượng đạo cụ bay/triệu hồi trên màn hình”: giá trị dương tăng số lượng kiếm bay, mũi tên, phi tiêu, bùa chú từ vài món lên thành mưa đạn khắp màn hình, giá trị âm khóa khung hình lại chỉ còn một chủ thể duy nhất, loại bỏ các bản sao thừa.
Giữ nguyên S: Kiểm soát số lượng là điều rất khó thực hiện chính xác bằng câu lệnh trong H3, các mức cường độ và câu lệnh mẫu đầy đủ, có thể áp dụng ngay; điểm trừ là các ví dụ hiển thị không ghi rõ mức cường độ.
Hình minh họa
Lý do đề xuất
- Mô hình mới: Phục vụ các cảnh lớn khó kiểm soát số lượng trong văn sinh video như “vạn kiếm đồng phát, mưa tên, bão ám khí”, cũng có thể dùng giá trị âm để ngược lại loại bỏ các máy bay không người lái, bản sao và bóng mờ do mô hình cơ sở tự sinh ra
- Tác giả cung cấp các mức cường độ hoàn chỉnh: +0.5 ~ +1.0 chia một vũ khí thành 5~10 viên, +1.2 ~ +2.0 là mức đội hình vuông vắn được tác giả khuyên dùng, +3.0 ~ +5.0 là mưa đạn khắp màn hình, -2.0 ~ -4.0 khóa một chủ thể duy nhất; kèm theo 4 câu lệnh cảnh song ngữ Trung-Anh có thể sao chép trực tiếp (+2.5, +3.0, -2.5, +2.5)
- Miễn phí, giấy phép cho phép bán; phát hành 6 giờ có 77 lượt tải xuống, 10 lượt thích (chỉ phản ánh mức độ quan tâm)
Cách sử dụng
- Không cần từ khóa kích hoạt, chỉ dựa vào cường độ LoRA (strength_model) để điều khiển; bắt đầu với +1.2 ~ +2.0, muốn hiệu ứng khắp màn hình thì tăng lên trên +3.0, muốn “chỉ có một” thì dùng -2.0 ~ -4.0
- Trong câu lệnh vẫn cần ghi rõ loại đạo cụ (flying swords, arrows, paper talismans, v.v.), có thể áp dụng trực tiếp 4 câu lệnh cảnh do tác giả cung cấp; tác giả không cung cấp số bước, CFG, bộ lấy mẫu
Rủi ro và hạn chế
- Các ví dụ hiển thị chỉ có 2 đoạn video và không kèm câu lệnh và cường độ, không thể thấy sự khác biệt thực tế giữa các mức; ngoài ra có 4 ví dụ cấp độ nhạy cảm đã bị ẩn
- Tác giả không ghi dữ liệu huấn luyện và phương pháp huấn luyện; chưa nói rõ giá trị âm “khóa một chủ thể” có tác dụng phụ gì với cảnh nhiều người hay không; mục này chưa xem video, chưa chạy thử
Đề xuất (2)
【A】MiniMax H3 Character Sheet | Turnaround From One Photo · v1.1
Quy trình làm việc · Cập nhật phiên bản · Tác giả AusBoss · Phát hành 11-02 13:21 · Tải xuống 237
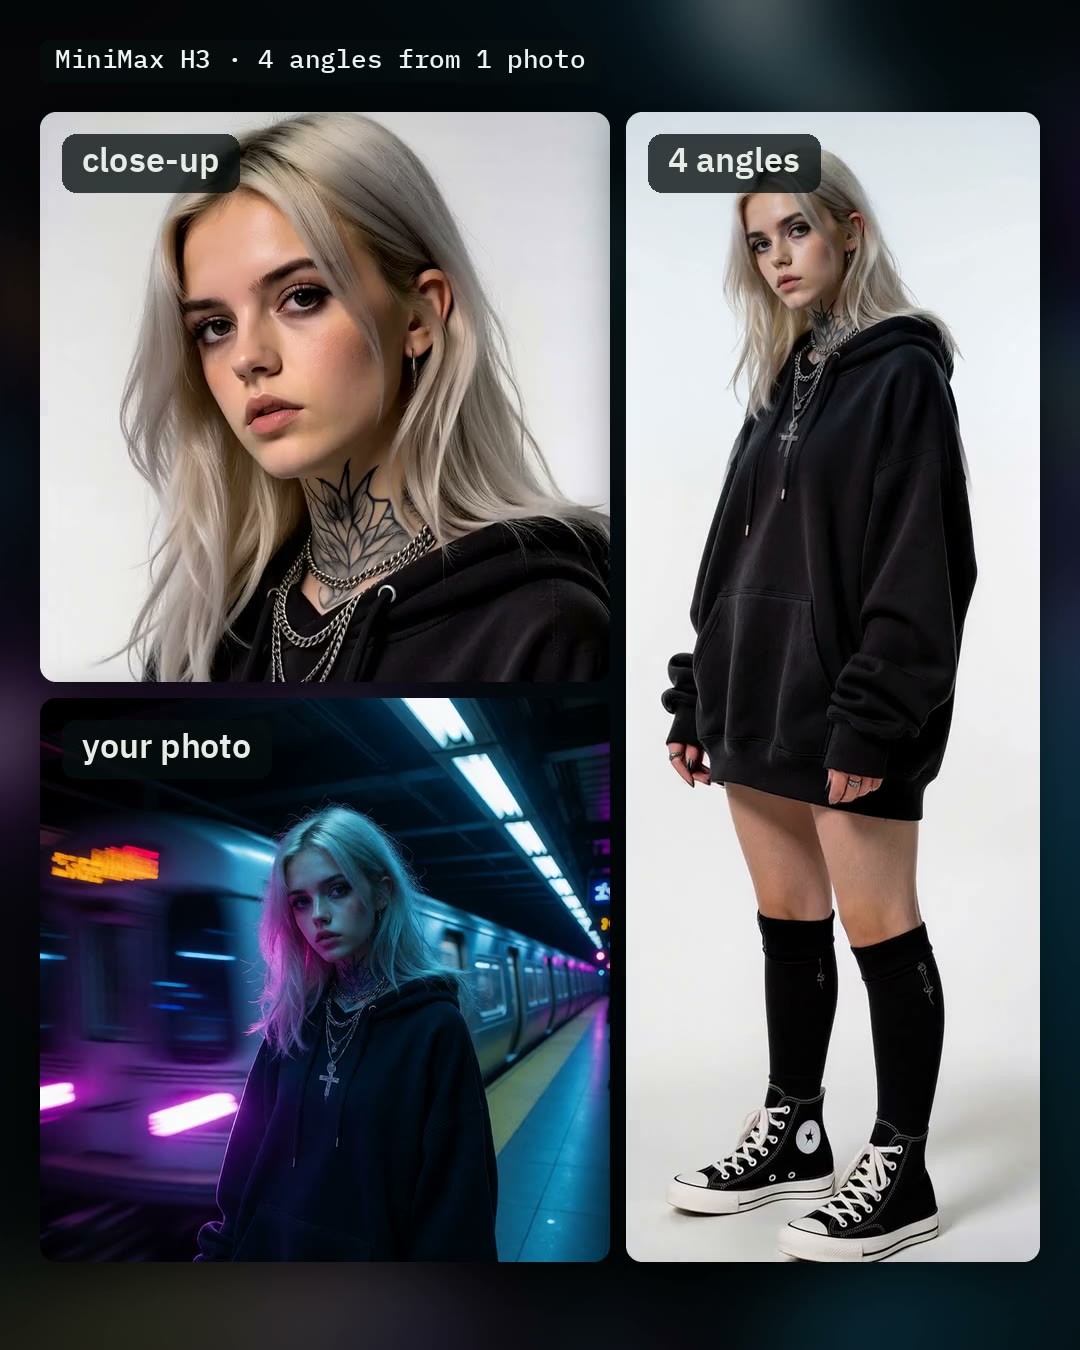
Đưa một bức ảnh chân dung vào ComfyUI, H3 vẽ ra hình ảnh thiết kế nhân vật gồm bốn góc nhìn: chính diện, ba phần tư, bên cạnh và phía sau của cùng một người (ảnh tĩnh); v1.1 thêm dòng cận cảnh đầu tùy chọn, dòng biểu cảm và tính năng vẽ lại khuôn mặt.
Giữ nguyên A: Các công tắc mới thay đổi cụ thể, mặc định tắt nên không ảnh hưởng cách dùng cũ, ví dụ và phụ thuộc được ghi rõ; không nâng lên S vì đây là bản cập nhật nhỏ, và kích thước mô hình cùng hạn chế khu vực giấy phép là rào cản thực tế.
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản: Thêm ba công tắc, khi mở tệp đều ở trạng thái tắt, khi tất cả tắt thì đầu ra giống hệt v1.0 — “Close-ups under the sheet” thêm một dòng gồm bốn cận cảnh đầu bên dưới hình thiết kế (H3 chạy thêm một vòng, mất thêm khoảng 70 giây); “Expressions instead of head turns” thay dòng đó bằng bốn biểu cảm, có thể tự viết lại trong bốn khung; “Redraw the faces” để H3 chạy lại phần trên, giúp khuôn mặt nhỏ sạch hơn (mất thêm khoảng 75 giây)
- Phục vụ việc tạo tham chiếu đa góc nhìn nhất quán cho nhân vật từ ảnh thật, sau đó dùng làm ảnh tham chiếu để sinh video bằng H3; giữ nguyên các tính năng cũ: có thể ghi nền, có thể bổ sung các phần chưa chụp trong ảnh (tác giả cho biết ghi “blue jeans and white sneakers” có thể biến ảnh bán thân thành toàn thân), công tắc Fast dùng 10 bước thay vì 18 bước, Upscale 2x dùng SeedVR2 để phóng to lên 6144 × 3072
- Miễn phí, giấy phép cho phép bán; 1 đoạn video + 5 ảnh mẫu; phiên bản này có 237 lượt tải xuống, toàn bộ mô hình tích lũy 1842 lượt tải, 128 lượt thích (chỉ phản ánh mức độ quan tâm)
Cách sử dụng
- Nhập minimaxH3CharacterSheet_v11.json, yêu cầu ComfyUI phiên bản 0.30.0 trở lên và AusBoss nodes phiên bản 2.15.0 trở lên (tìm AusBoss trong ComfyUI-Manager, nếu đã cài thì cập nhật trước); lần chạy đầu tiên tải khoảng 42 GB mô hình
- Mô hình khuếch tán dùng phiên bản Ref2VA của H3 (không phải FL2VA), ngoài ra cần bộ mã hóa văn bản Qwen3-VL và VAE video của H3; Upscale 2x cần thêm SeedVR2; tên tệp và thư mục cụ thể xem trong thẻ mô hình
- Tải lên một bức ảnh chân dung rõ nét, tùy chọn ghi nền và “các phần chưa chụp trong ảnh”; bật các công tắc mới khi cần, đầu ra mặc định là một ảnh bốn góc nhìn kích thước 3072 × 1536
Rủi ro và hạn chế
- Đầu ra là ảnh thiết kế tĩnh chứ không phải video; tác giả ghi rõ chỉ thử nghiệm với ảnh, góc nhìn phía sau do H3 suy đoán từ ảnh, dưới ánh sáng màu mạnh da có thể bị nhạt đi
- Đầu vào là ảnh người thật, việc dùng ảnh người khác để làm hình thiết kế cần sự đồng ý của người đó, liên quan đến quyền hình ảnh
- Thẻ mô hình ghi rõ giấy phép cộng đồng H3 không áp dụng cho EU, Anh, Hàn Quốc và Mỹ; tổng dung lượng tệp mô hình lớn; mục này chưa chạy thử
【A】H3MD Director – 2–3 min long videos with MiniMax H3 (ComfyUI) · v0.1.1
Quy trình làm việc · Mô hình mới · Tác giả 1113800942188 · Phát hành 11-02 15:06 · Tải xuống 65
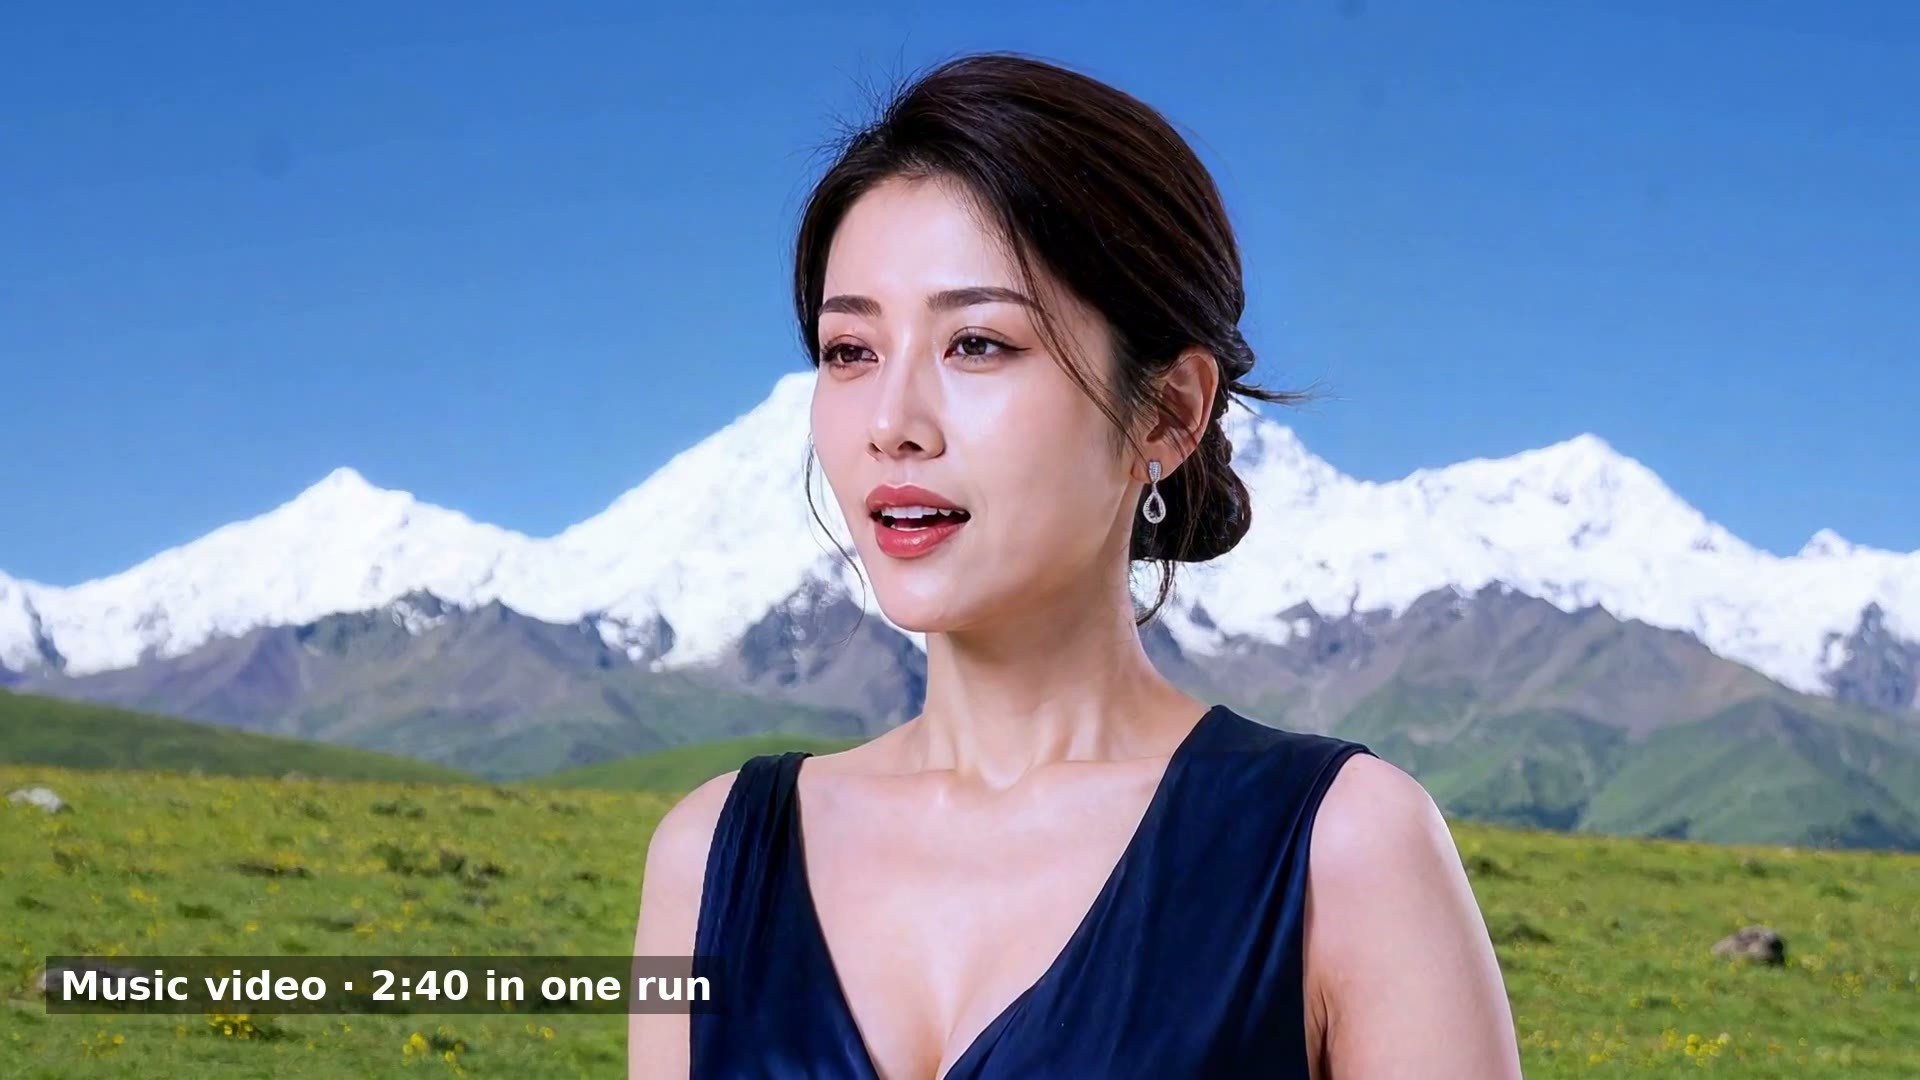
Gói nút mã nguồn mở ComfyUI + quy trình làm việc mẫu: một lần chạy tạo video dài 2–3 phút bằng H3, có thể là một cảnh quay dài liên tục hoặc một chuỗi nhiều cảnh quay được lập kế hoạch theo storyboard.
Giữ nguyên A: Đẩy đoạn đơn 10–15 giây của H3 lên cấp độ phút, còn có thể sửa chữa từng đoạn, mục đích và cách cài đặt đều rõ ràng; không nâng lên S vì đây là phiên bản đầu tiên, nhiều phụ thuộc, không ghi rõ yêu cầu phần cứng, và tác giả bài báo này có mối quan hệ được cảm ơn, nên xử lý thận trọng.
Hình minh họa
Lý do đề xuất
- Mô hình mới: Phục vụ video dài, phim ngắn nhiều cảnh và video âm nhạc; cảnh quay dài dựa vào việc tiếp tục viết từ không gian tiềm ẩn chồng lấp 1.6 giây cuối của đoạn trước, cảnh cắt cứng có thể bắt đầu lại với ảnh tham chiếu riêng, kéo thống kê màu/sự tương phản về đoạn đầu tiên để hạn chế sự trôi dạt
- Kèm theo bảng điều khiển đạo diễn (ghi thời lượng, câu lệnh, ảnh tham chiếu, khóa âm thanh cho từng cảnh), chuyển động từ độ sâu + SAM3, video âm nhạc khớp khẩu hình và văn sinh video; tác giả cho biết video dài 1080P, đoạn đơn 15 s có thể đạt 2K, kèm tùy chọn VRAM thấp/phân khối
- Miễn phí, mã nguồn mở AGPL-3.0; README trên GitHub ghi rõ cài đặt, phụ thuộc, chạy lại từng đoạn và tiếp tục từ điểm dừng; phát hành 6 giờ có 65 lượt tải xuống (chỉ phản ánh mức độ quan tâm)
Cách sử dụng
- Tìm “H3MD Director” trong ComfyUI-Manager hoặc clone kho GitHub vào custom_nodes, ComfyUI cần phiên bản 0.43 trở lên (hỗ trợ H3 gốc); kéo tệp H3MD Director.json từ zip vào ComfyUI, dùng Install Missing Custom Nodes để bổ sung các gói nút còn thiếu, tải mô hình theo hướng dẫn Model links trong quy trình làm việc
- README khuyên nên chỉ chạy đoạn đầu tiên trước (đặt stop_after của nút Loop thành 1) để xác nhận hình ảnh và tốc độ, sau đó bật resume_from_cache để chạy toàn bộ; nếu một đoạn bị lỗi, điền số đoạn vào rerun_segments để chỉ chạy lại những đoạn đó
- README khuyên dùng chuẩn câu lệnh h3md-prompt của tác giả để viết cho mỗi cảnh; còn phụ thuộc vào các gói nút ComfyUI-ClipProj, ComfyUI-VFI (chèn khung hình), KJNodes, rgthree, v.v., mô hình phóng to không gian tiềm ẩn học được là tùy chọn
Rủi ro và hạn chế
- v0.1.1 là phiên bản công khai đầu tiên, tác giả không cung cấp thời gian và yêu cầu VRAM cho video dài 2–3 phút; 3 ví dụ cấp độ nhạy cảm đã bị ẩn, hiển thị là 2 đoạn video 1080p
- Giấy phép AGPL-3.0, nếu sửa đổi và phát hành lại phải mã nguồn mở; liên kết RunningHub trong thẻ mô hình là liên kết mời của tác giả
- Danh sách cảm ơn của tác giả có T8 (tác giả bài báo này), xếp hạng mục này chỉ dựa trên thẻ mô hình và README; mục này chưa xem video, chưa chạy thử
Đáng chú ý (9)
【B】MiniMax H3 Ref2VA - Multi-Reference Video Generation · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 17:05 · Tải xuống 20
Quy trình tạo video từ nhiều ảnh tham chiếu của AIKSK với H3: năm ảnh tham chiếu được đưa đồng thời vào điều kiện Ref2VA, trước tiên lấy mẫu ở độ phân giải thấp, sau đó khuếch đại không gian tiềm ẩn 2 lần bằng bộ giải mã học sâu (learned decoder) trong không gian tiềm ẩn của 3, rồi tinh chỉnh với nhiễu thấp, xuất ra video kèm âm thanh do H3 tạo.
Hình minh họa
【B】Singularity-V2-x-10Eros-Max · PRISM-DMAD-PDMD
Mô hình cơ sở / Checkpoint · Cập nhật phiên bản · Tác giả 0l1v1aR0551 · Phát hành 11-02 15:46 · Tải xuống 521
Phiên bản mới của mô hình cơ sở hợp nhất H3 Ref2VA: hợp nhất phiên bản Turbo 8 bước của Singularity v2 và 10Eros-Max bằng thuật toán PRISM do tác giả tự viết, tác giả cho biết phiên bản này có thể tạo kết cấu da chân thực trong 8 bước mà không cần thêm LoRA Turbo.
Hình minh họa
【B】MiniMax H3 LightX2V 4-Step Video-to-Video · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 12:28 · Tải xuống 25
Phiên bản tham khảo hình ảnh LightX2V trong ba giải pháp tăng tốc H3 của AIKSK: tạo video từ một hình ảnh tham khảo, LoRA turbo Ref2V 4 bước kết hợp với lấy mẫu một giai đoạn Euler đơn giản 4 bước; tiêu đề ghi là Video-to-Video, nhưng không có đầu vào video nguồn trong hình.
Hình minh họa
【B】MiniMax H3 Two-Stage HD Video Repaint · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 17:04 · Tải xuống 9
Quy trình làm việc kết xuất lại video độ phân giải cao H3 của AIKSK: đọc một video hiện có, tiêm các biến tiềm ẩn của nó làm nền, sau khi phóng đại không gian tiềm ẩn 3D 2 lần bằng phương pháp học được và tái tạo có điều kiện độ phân giải cao, sẽ tinh chỉnh ngắn với nhiễu thấp, cuối cùng khóa lại âm thanh gốc.
Hình minh họa
【B】MiniMax H3 PDD 8-step Video-to-Video with Reference · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 12:25 · Tải xuống 23
Phiên bản tham khảo hình ảnh PDD trong ba giải pháp tăng tốc H3: tạo video từ một hình ảnh tham khảo, nút cài đặt PDD tiếp quản mô hình, bộ lấy mẫu và sigma, kết hợp với trọng số tăng tốc Ref2VA 8 bước chuyên dụng; tiêu đề ghi là Video-to-Video, nhưng thực tế không có đầu vào video nguồn.
Hình minh họa
【B】MiniMax H3 Martial Arts Workflow (Multi-Keyframe) · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 15:11 · Tải xuống 17
Quy trình làm việc hành động võ thuật H3 của AIKSK (phiên bản đa khung hình chính): chồng bốn LoRA gồm chất lượng điện ảnh thực tế, chuyển động máy quay, vật lý không gian võ thuật và động tác võ thuật FL2VA, kết hợp với LoRA turbo 8 bước để tạo các cảnh chiến đấu, và có phần đa khung hình chính.
Hình minh họa
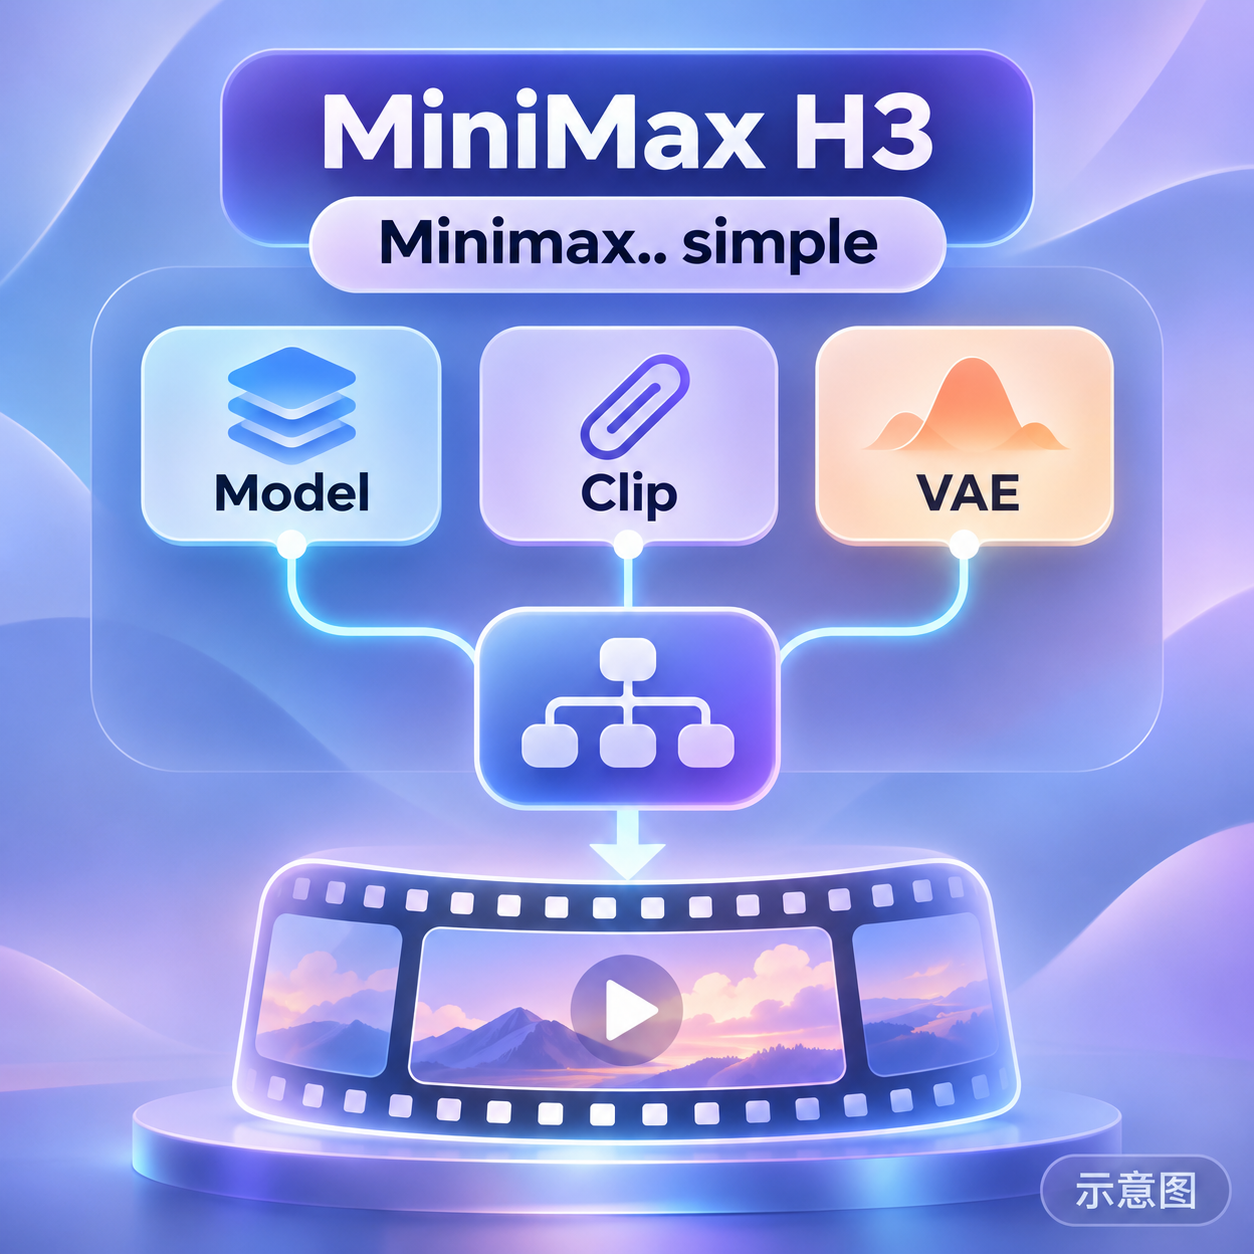
【B】Minimax.. simple · v5
Quy trình làm việc · Cập nhật phiên bản · Tác giả sy0ww4bb1984 · Phát hành 11-02 13:57 · Tải xuống 36
Một quy trình làm việc tích hợp H3 quy mô lớn: tạo video từ nhiều hình ảnh tham khảo + âm thanh tham khảo, tiếp tục viết dài hơn theo từng lô khung hình, sau đó phóng to theo lô; v5 chủ yếu là sửa quy trình để theo kịp các thay đổi của phiên bản ComfyUI mới.
Hình minh họa
【B】MiniMax H3 LightX2V 4 Steps First-Last Frame Video · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 12:27 · Tải xuống 27
Phiên bản khung hình đầu và cuối của giải pháp LightX2V 4 bước: tạo video từ hai hình ảnh khung hình đầu và khung hình cuối, LoRA turbo FL2V 4 bước kết hợp với lấy mẫu một giai đoạn Euler đơn giản 4 bước.
Hình minh họa
【B】MiniMax H3 FL2VA - Text, First and Last Frame Video · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AIKSK · Phát hành 11-02 17:03 · Tải xuống 9
Quy trình làm việc tích hợp bốn trong một H3 của AIKSK cho văn bản / khung hình đầu / khung hình cuối / khung hình đầu và cuối: đầu vào khung hình đầu và cuối đều có thể chọn, chuyển đổi tác vụ dựa trên số lượng hình ảnh được kết nối, sử dụng lấy mẫu hai giai đoạn (tạo độ phân giải thấp, phóng đại không gian tiềm ẩn 3D 2 lần, tinh chỉnh nhiễu thấp).
Hình minh họa
Chỉ liệt kê (11)
- MiniMax H3 Martial Arts Workflow · v1.0 — Quy trình làm việc: Quy trình làm việc hành động võ thuật H3 của AIKSK (phiên bản thường): giống với phiên bản đa khung hình chính, chồng bốn LoRA gồm chất lượng điện ảnh thực tế, chuyển động máy quay, vật lý không gian võ thuật và động tác võ thuật FL2VA cùng với LoRA turbo 8 bước, không có phần đa khung hình chính.
- MiniMax H3 H25 Hybrid - Multi-Reference 8-Step Build · v1.0 — Quy trình làm việc: Quy trình làm việc H3 8 bước đa tham khảo của AIKSK (H25 Hybrid): thẻ chỉ ghi 47 nút, một LoRA turbo với cường độ 1.0, lấy mẫu sử dụng nút tùy chỉnh, đầu vào và tham số không được ghi rõ.
- Michaela Gobielle · v1.0 H3 — LoRA: Phiên bản H3 của LoRA nhân vật cho nhân vật nữ trưởng thành hư cấu do tác giả sáng tạo Michaela Gobeille, sử dụng từ khóa kích hoạt mikalora để tạo ra nhân vật này trong video.
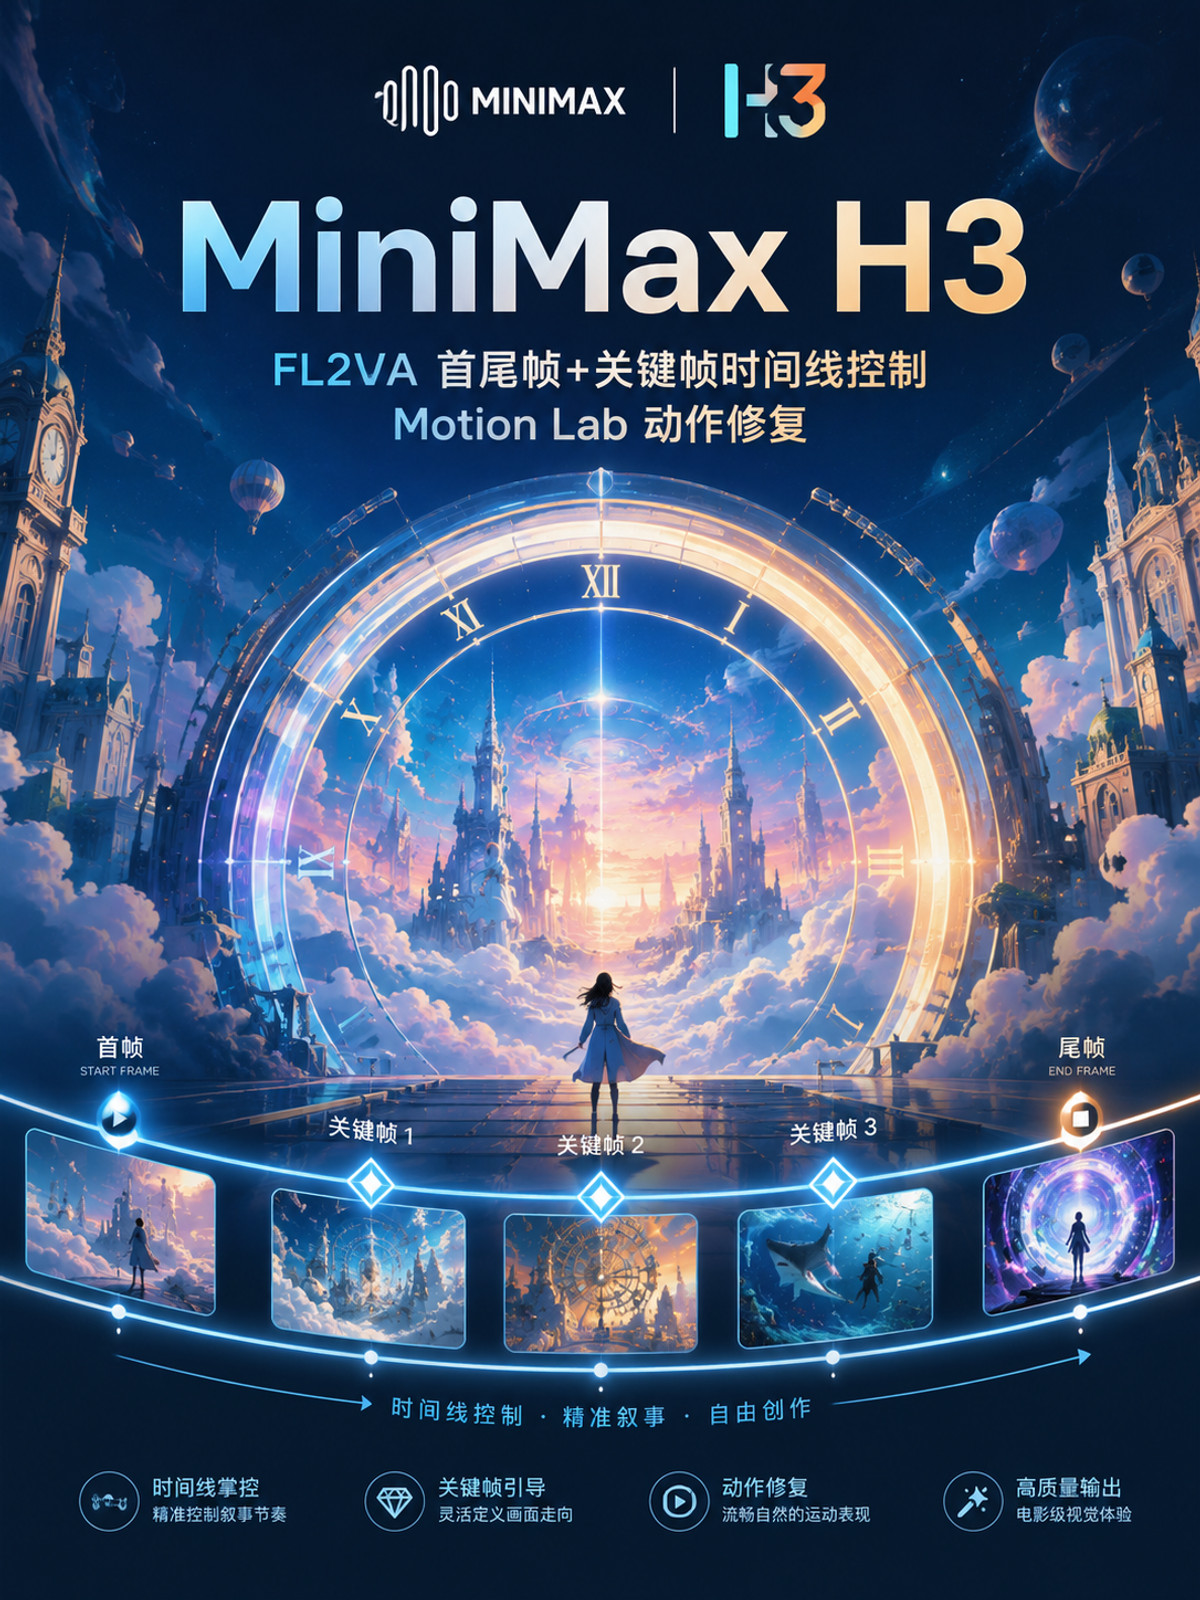
- MiniMax H3 FL2VA - First/Last Frame with Keyframe Timeline · v1.0 — Quy trình làm việc: Quy trình làm việc H3 khung hình đầu/cuối cộng với dòng thời gian khung hình chính của AIKSK: tên tệp ghi “FL2VA khung hình đầu/cuối + kiểm soát dòng thời gian khung hình chính + sửa chữa chuyển động Motion Lab”, thẻ chỉ cung cấp 80 nút, không bao gồm LoRA, lấy mẫu sử dụng nút tùy chỉnh.
- MiniMax H3 OpenVDN DMD8 Reference-to-Video · v1.0 — Quy trình làm việc: Phiên bản tham khảo hình ảnh của giải pháp OpenVDN DMD8: tạo video từ một hình ảnh tham khảo, kế hoạch thực thi của vdn-minimax-h3 (stage_dmd_8nfe) của OpenVDN cung cấp mô hình, bộ lấy mẫu và sigma, đầu ra một giai đoạn, không có phần đuôi phóng to.
- MiniMax H3 OpenVDN DMD8 First-Last Frame Video · v1.0 — Quy trình làm việc: Phiên bản khung hình đầu và cuối của giải pháp OpenVDN DMD8: tạo video từ hai hình ảnh khung hình đầu và khung hình cuối, kế hoạch thực thi VDN cung cấp lấy mẫu, đầu ra một giai đoạn; mô hình cơ sở chọn FL2VA, nhưng tác vụ có điều kiện vẫn là Ref2VA.
- MiniMax H3 PDD 8-step First-Last Frame Video · v1.0 — Quy trình làm việc: Phiên bản khung hình đầu và cuối của giải pháp PDD 8 bước: kết nối hai hình ảnh khung hình đầu và khung hình cuối, nút cài đặt PDD tiếp quản lấy mẫu, kết hợp với trọng số tăng tốc FL2VA 8 bước; nhưng tác vụ có điều kiện vẫn được ghi là tạo video từ hình ảnh khung hình đầu.
- Lara WhiteMoon · MiniMaxH3 — LoRA: Phiên bản H3 của LoRA nhân vật cho nhân vật hư cấu Lara WhiteMoon, dùng để tạo ra nhân vật nữ với tạo hình nhà chiêm tinh học phong cách steampunk trong video.
- MiniMax H3 Ref2VA - Multi-Reference with Keyframe Story Beats · v1.0 — Quy trình làm việc: Quy trình làm việc H3 đa tham khảo cộng với kiểm soát nhịp câu chuyện bằng khung hình chính của AIKSK: tên tệp ghi “Ref2VA đa tham khảo + kiểm soát nhịp câu chuyện bằng khung hình chính + chuyển động Motion Lab”, thẻ chỉ cung cấp 87 nút, không bao gồm LoRA, lấy mẫu sử dụng nút tùy chỉnh.
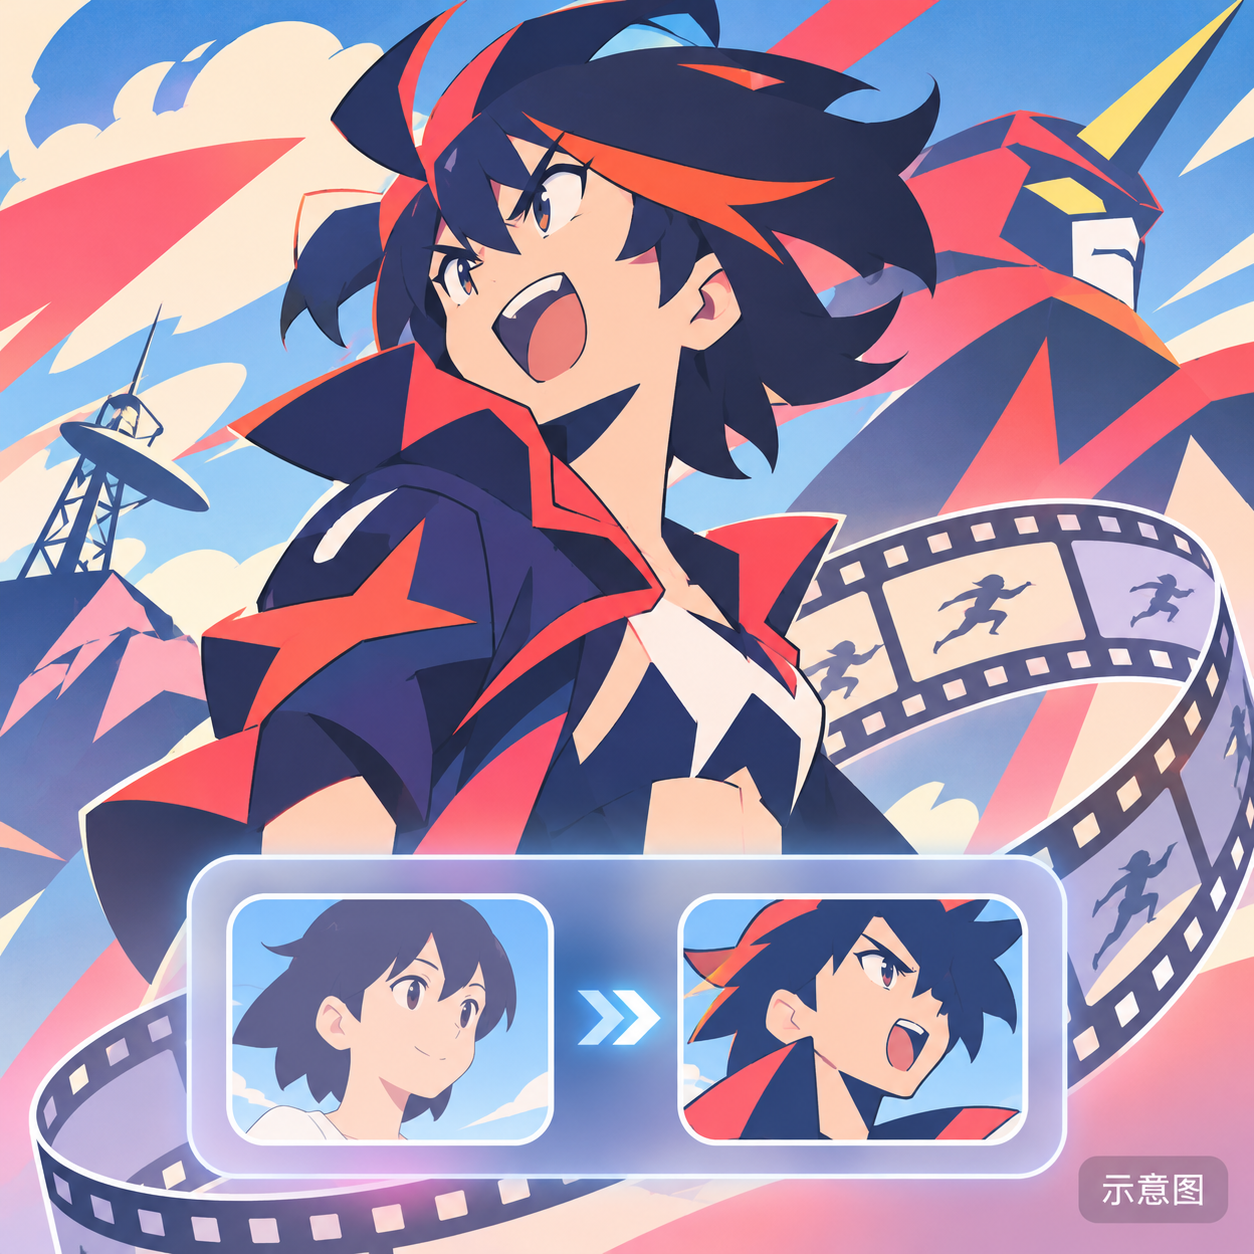
- HIROYUKI IMAISHI - Kill La Kill, Gurren Lagann, FLCL - Minimax H3 · v1.0 — LoRA: LoRA phong cách H3 bắt chước phong cách vẽ hoạt hình của Hiroyuki Imaishi (Kill La Kill, Gurren Lagann, FLCL).
- BigAss 🍑🔥 [ MOSS / Krea2 / SD] · Minimax v1.0 — LoRA: Phiên bản H3 của LoRA khái niệm cơ thể: sử dụng từ khóa kích hoạt BigAss để làm cho mông nhân vật đầy đặn hơn.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ thu thập 11-02 10:15 → 11-02 21:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.