Radar IA de Zhenzhen · MiniMax H3 · Briefing matinal du 2026-11-21
Cette édition présente 14 nouvelles versions : fortement recommandé 0 · recommandé 1 · à suivre 5 · inclus uniquement 8
Note de l'éditeur Cette édition examine 14 nouvelles versions de H3, avec 1 notées A, 5 notées B et 8 notées C, sans exclusions. Première recommandation : Story Creator, qui génère une vidéo narrative complète en un seul passage à partir d'un script de storyboard préformaté ; Qwen Image 2.1 produit les images fixes, H3 génère scène par scène des plans avec dialogues, et YuE2 compose la musique, le tout en utilisant uniquement les nœuds principaux. Simply Advanced v1.7 ajoute l'inpainting vidéo localisé, mais ne propose que des exemples en capture d'écran, ce qui abaisse sa note à B ; Stable_Yogi propose dans le même lot 4 workflows, 3 LoRAs de clonage vocal en anglais et les versions d'essai gratuites de deux packs payants, classés B / C.
Recommandations (1)
【A】Story Creator 12GB — du script à une vidéo narrative complète : images fixes Qwen Image 2.1 + scènes MiniMax H3 avec voix + musique YuE2 · v1.4.0
Workflow · Nouveau modèle · Auteur The_frizzy1 · Publié le 11-21 01:00 · Téléchargements 19
Un workflow ComfyUI qui génère directement une vidéo narrative complète à partir d'un script de storyboard : Qwen Image 2.1 Turbo produit les images fixes pour chaque scène, MiniMax H3 transforme chaque image fixe en plan animé avec dialogues et effets sonores, YuE2 génère la musique, et une voix off unifiée est ajoutée.
La difficulté réside dans le temps de calcul plutôt que dans la mémoire vidéo : commencez par tester une ou deux scènes avec le script court fourni pour vérifier la cohérence du personnage principal et la synchronisation labiale des dialogues avant de lancer l'ensemble.
Illustrations
Raisons de la recommandation
- Conçu pour les « vidéos narratives longues générées par IA » : à partir d'un script préformaté, le système produit une vidéo finale où le même personnage principal apparaît dans toutes les scènes, chaque scène est animée, les personnages parlent, et il y a une voix off ainsi que de la musique ; la partie vidéo est entièrement réalisée par H3, ce qui justifie son inclusion dans cette section (le même élément apparaît également dans la section Qwen 2.1)
- Méthode pour assurer la cohérence du personnage principal : Qwen Image 2.1 génère d'abord une image du personnage, et chaque image fixe de scène est une édition de celle-ci ; H3 utilise le modèle de base FL2VA avec un LoRA turbo de 8 étapes pour générer scène par scène, la durée étant déterminée automatiquement selon le volume des dialogues ; la voix off est générée séparément via H3 en ne conservant que l'audio, garantissant une voix off cohérente sur toute la vidéo
- Utilise uniquement les nœuds principaux de ComfyUI (boucle Start Loop / End Loop), sans installer de nœuds personnalisés ; l'auteur indique avoir réussi à le faire tourner sur une RTX 3060 12 GB + 32 GB de RAM, et liste les liens de téléchargement et les répertoires de stockage pour chacun des 9 fichiers de modèle
- L'auteur mentionne également les limites : l'encodeur de texte intégré de 8B paramètres pour la génération automatique de storyboards donne de mauvais résultats et est désactivé par défaut ; seule la cohérence du personnage principal est garantie, tandis que les personnages secondaires doivent être décrits intégralement à chaque réplique
- Exemples visibles : 2 vidéos + 6 images ; le workflow lui-même est sous licence MIT
Utilisation
- ComfyUI version 0.39 ou supérieure ; téléchargez les trois fichiers de Qwen Image 2.1 selon la fiche du modèle (Turbo int8, encodeur de texte Qwen3-VL 8B, VAE), les cinq fichiers de H3 (modèle de base fl2va pruned int8, LoRA turbo fl2v 8step, encodeur de texte Qwen3-VL 32B, VAE vidéo, VAE audio) et le fichier YuE2
- Format du script : la première ligne commence par WORLD: pour définir le style visuel global ; chaque ligne suivante commence par [caméra/mouvement], puis décrit l'image (lieu, apparence complète de chaque personnage, action) ; après || se trouve la voix off hors champ, et après || Nom: se trouve la réplique prononcée par ce personnage à l'écran ; [continue] permet d'enchaîner la fin de la scène avec l'image de la scène suivante plutôt que par une coupe franche
- La durée de chaque scène est automatiquement comprise entre 3 et 9 secondes ; l'auteur recommande d'utiliser un outil de chat LLM pour rédiger le script selon le fichier HOW_TO_WRITE_A_SCRIPT.md fourni, plutôt que d'utiliser la fonction d'écriture automatique intégrée au workflow
- Le workflow complet est également disponible sur le GitHub de l'auteur et sur son miroir Hugging Face
Risques et limitations
- L'auteur précise que v1.4.0 ne comporte pas de notes de mise à jour et qu'il est difficile de savoir ce qui a changé ; les données de temps d'exécution affichées sur la page proviennent des versions v1.0 et v1.2
- Très lent : selon l'auteur, une vidéo finale de 1 minutes prend environ 43 minutes à générer, une vidéo de 3 minute prend environ 2 heures, et une vidéo de 5 minutes (58 scènes) prend environ 3 heure 35 minutes ; une histoire de 5 minutes nécessite une nuit entière de calcul
- Au-delà d'environ 30 scènes, il faut diviser le traitement en deux parties puis les assembler dans un logiciel de montage (la mémoire augmente d'environ 0.6 GB par scène) ; l'audio est généré séparément pour chaque scène, ce qui nécessite une normalisation du volume en post-production
- Les plans en sur-l'épaule et les personnages partiellement coupés par le cadre sont sujets aux erreurs (le personnage principal apparaît deux fois, ou deux personnages fusionnent)
- Conflit de licences : le workflow est sous licence MIT, mais Qwen Image 2.1 (licence Qwen Research) et YuE2 (CC-BY-NC-4.0) sont non commerciaux, et H3 possède sa propre licence communautaire ; la case « usage commercial autorisé » sur Civitai ne couvre pas les licences de ces modèles
- Dans les métadonnées, le modèle de base est indiqué comme « Other » ; les fichiers de modèle totalisent plusieurs dizaines de Go, et certains exemples sont masqués (5 au total)
À suivre (5)
【B】Simply Advanced - MiniMax H3 · v1.7
Workflow · Mise à jour de version · Auteur altoiddealer · Publié le 11-21 05:47 · Téléchargements 29
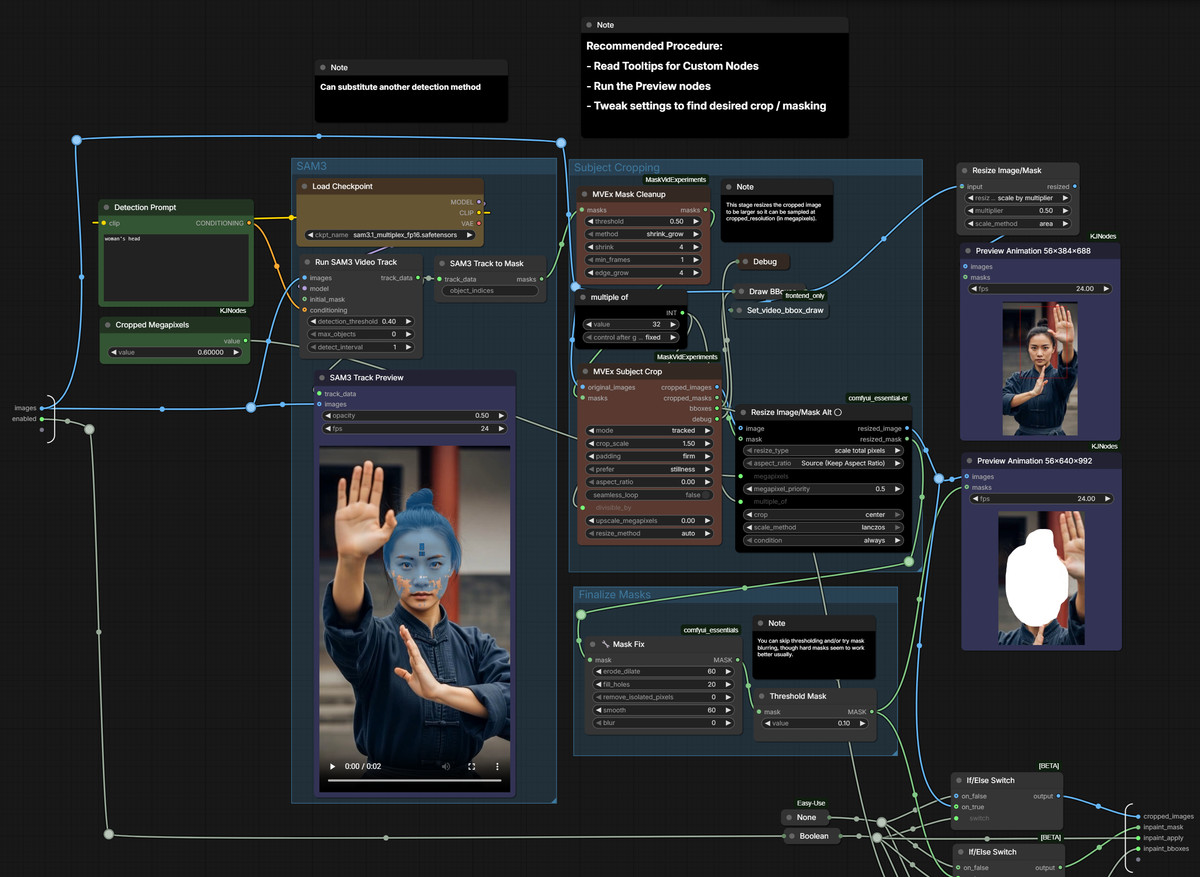
Version v1.7 du workflow H3 multi-entrées intégré Simply Advanced : ajout d'une option d'inpainting vidéo localisé, qui régénère uniquement la zone suivie/masquée dans la vidéo originale.
Pour les utilisateurs déjà familiers avec ce workflow, cette version ajoute principalement l'inpainting localisé ; les débutants peuvent désactiver l'amélioration par LLM et le repainting, en utilisant uniquement les parties référence/guidage. (L'éditeur a abaissé la note à B : les nouvelles fonctionnalités de cette version ne sont illustrées que par 1 captures d'écran, sans exemples vidéo permettant d'évaluer la qualité du repainting.)
Illustrations
Raisons de la recommandation
- Mise à jour de version : v1.7 ajoute l'inpainting vidéo ; en activant l'option sur Video 1 et avec une configuration simple, il est possible de ne repainter que les zones suivies par le masque ; les étapes de recadrage, de masquage et de réintégration sont gérées par le nœud MaskVidExperiments
- Outil en lui-même : accepte jusqu'à 6 images, 2 vidéos et 3 pistes audio, chaque élément pouvant être configuré comme référence (reference), guidage (guide) ou les deux ; inclut l'upscaling latent / la génération en deux étapes et une gestion par étapes des LoRAs
- Extension fluide : permet de continuer à partir de la fin de la vidéo d'entrée (Continuation), de générer jusqu'au début de la vidéo d'entrée (Convergence), ou de combiner les deux pour insérer une séquence entre deux vidéos
- Intègre le pipeline de prompts Ref2VA en 4 étapes de l'auteur (expansion → analyse de référence → blueprint créatif → compilation en structure de prompt H3) et l'amélioration de prompts FL2VA en 1 étapes, le mode étant déterminé automatiquement selon la présence d'images dans Image 1 / Image 2
- Le modèle a été téléchargé 1281 fois au total, gratuit
Utilisation
- Nœuds obligatoires : ComfyUI-Easy-Use, ComfyUI-KJNodes, et le nœud comfyui_essential-er de l'auteur ; pour utiliser l'inpainting vidéo localisé de cette version, installez également MaskVidExperiments
- Nœuds optionnels : Load Video de VideoHelperSuite, MiniMax H3 RefMods, nœuds d'accélération Spectrum, etc.
- Chargez simply-advanced_minimax_h3_v1.7.json, activez l'option Inpainting sur Video 1 et configurez le suivi du masque ; les paramètres d'échantillonnage tels que le nombre d'étapes et l'intensité sont définis par défaut dans le workflow, l'auteur ne les ayant pas précisés dans la fiche du modèle
Risques et limitations
- La fiche complète du modèle exige une version de comfyui-frontend inférieure à v1.50.5 (le nœud Custom Combo dans le sous-graphe ne fonctionne plus avec les nouvelles versions du frontend), ce qui oblige les utilisateurs ayant installé un nouveau frontend à revenir en arrière
- Les exemples visibles se limitent à 1 captures d'écran (1 autres étant masquées), sans exemples vidéo, rendant impossible l'évaluation de la qualité du repainting
- Nombreuses dépendances de nœuds ; l'amélioration des prompts par LLM nécessite un LLM externe configuré séparément ; il s'agit d'un JSON de workflow, pas de nouveaux poids de modèle
【B】MiniMax H3 Fused Turbo : trois workflows de démarrage (texte, image, référence) · v1
Workflow · Nouveau modèle · Auteur Stable_Yogi · Publié le 11-21 01:50 · Téléchargements 57
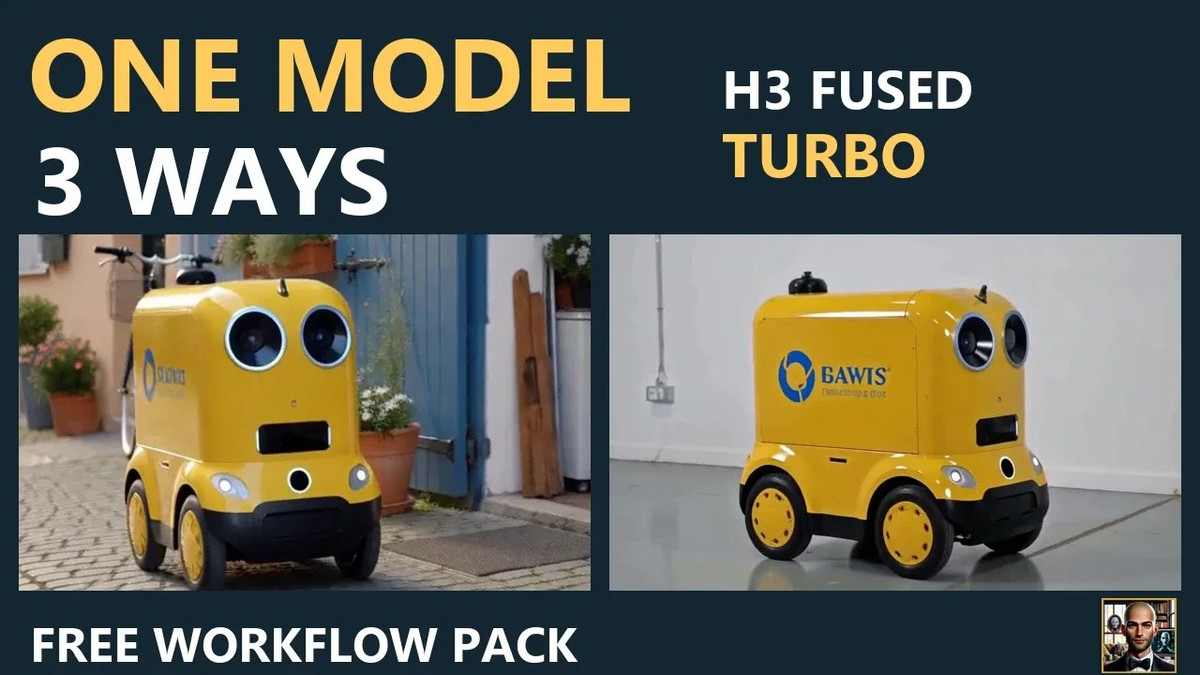
Pack de workflows de démarrage créé par Stable_Yogi pour le modèle d'accélération fusionné tiers MiniMax H3 Fused Turbo : trois approches initiales, à savoir texte-vers-vidéo, image-vers-vidéo (en utilisant votre image comme première frame) et référence-vers-vidéo (en utilisant une image comme référence pour filmer un autre plan).
Illustrations
Raisons de la recommandation
- L'auteur a publié le même jour 4 workflows H3, dont ce pack de démarrage : un seul modèle, trois points de départ, avec au total 4 graphes testés (accompagnés d'une version en 8 étapes pour comparaison), des exemples d'images et un fichier QUICKSTART.md
- Faibles dépendances : utilise uniquement les nœuds principaux MiniMax H3 de ComfyUI ; l'archive contient également une version .api.json permettant des appels via API
- Inclut une vidéo explicative sur la chaîne YouTube de l'auteur, gratuit
Utilisation
- Téléchargez le fichier minimax-h3-fused-turbo-int8-convrot de MATLOWAI depuis Hugging Face et placez-le dans models/diffusion_models, puis téléchargez l'encodeur de texte ainsi que les VAE vidéo et audio depuis Comfy-Org/MiniMax-H3
- Décompressez l'archive, glissez un fichier .json dans ComfyUI, sélectionnez les fichiers de modèle dans le chargeur, et laissez le type du chargeur CLIP sur minimax ; lors des tests, exécutez un seul graphe à la fois
- Le nombre d'étapes par défaut pour Fused Turbo n'est pas indiqué par l'auteur dans la fiche du modèle ; consultez les valeurs par défaut dans le workflow ou comparez avec la version en 8 étapes
Risques et limitations
- Fused Turbo est un modèle fusionné tiers, non officiel ; l'auteur ne précise pas la différence de qualité par rapport aux LoRAs d'accélération officiels
- Les exemples se limitent à 3 images, sans vidéos
- L'auteur indique avoir testé sur ComfyUI 0.32 ; la licence autorise uniquement l'utilisation du contenu généré, mais interdit la distribution de versions modifiées ; le tutoriel détaillé est hébergé sur un portail externe à l'auteur
【B】MiniMax H3 Second Pass : workflow de réparation de mouvement · v1.0
Workflow · Nouveau modèle · Auteur Stable_Yogi · Publié le 11-21 01:50 · Téléchargements 79
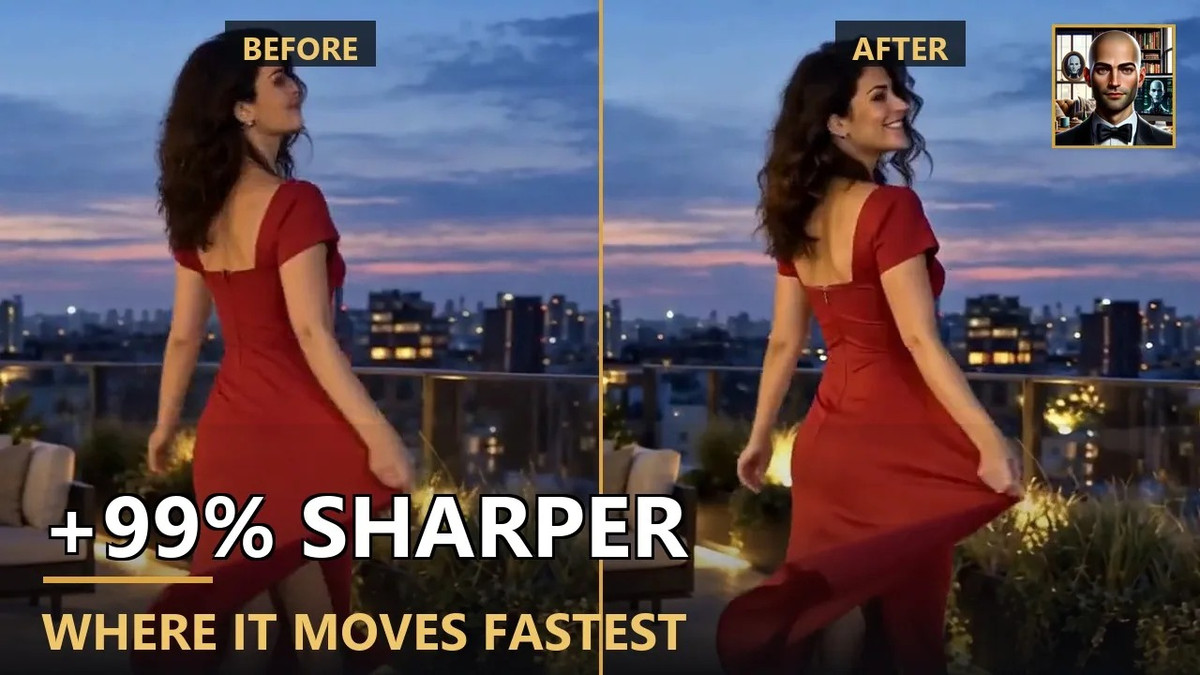
Un workflow vidéo-vers-vidéo qui renvoie un clip H3 déjà généré dans le modèle pour une seconde passe, afin de corriger les mouvements et améliorer la netteté, tout en sauvegardant l'original et le résultat de la seconde passe pour comparaison.
Idéal pour tester sur vos propres clips aux mouvements flous : le workflow sauvegarde automatiquement les deux versions côte à côte.
Illustrations
Raisons de la recommandation
- Post-traitement des clips de service H3 : l'auteur affirme qu'après une seconde passe, toutes les parties de l'image sont plus nettes, avec une amélioration de 99% pour les parties ayant le mouvement le plus rapide (mesuré sur les 124 images totales, métrique spécifique non précisée par l'auteur)
- Génération de deux vidéos en une seule fois (rendu standard + seconde passe), permettant une comparaison directe avant/après
- Contrairement au pack d'initiation du même auteur, celui-ci utilise le modèle de base officiel FL2VA pruned int8 avec l'adaptateur LightX2V 4 étapes ; l'archive contient des images d'exemple, gratuit
Comment utiliser
- Installer ComfyUI-MAINodes v1.1.3 ou supérieur (via Manager ou git clone)
- Modèles : minimax_h3_fl2va_pruned_int8_convrot (19.5 Go), encodeur de texte qwen3vl_32b_minimax_h3_nvfp4_awq (14.6 Go), minimax_h3_video_vae_fp16 (4.9 Go), VAE audio (sans lui, pas de son), ainsi que l'adaptateur LightX2V 4 étapes à placer dans models/loras
- Après décompression, placez les images d'exemple dans ComfyUI/input, vérifiez les chemins des 5 chargeurs, lancez une exécution et comparez les deux vidéos générées ; les paramètres tels que l'intensité de débruitage pour la seconde passe ne sont pas fournis par l'auteur
Risques et limitations
- La méthode de mesure de « l'amélioration de 99% » n'est pas publiée, il faut donc se fier uniquement aux affirmations de l'auteur
- Seules 1 images sont visibles en exemple, sans vidéos comparatives avant/après
- L'adaptateur LightX2V 4 étapes n'a ni nom de fichier spécifique ni lien fourni ; la licence autorise uniquement l'utilisation du contenu généré
【B】MiniMax H3 Location Sheet : la même pièce dans chaque plan · v1.0
Workflow · Nouveau modèle · Auteur Stable_Yogi · Publié le 11-21 01:50 · Téléchargements 75
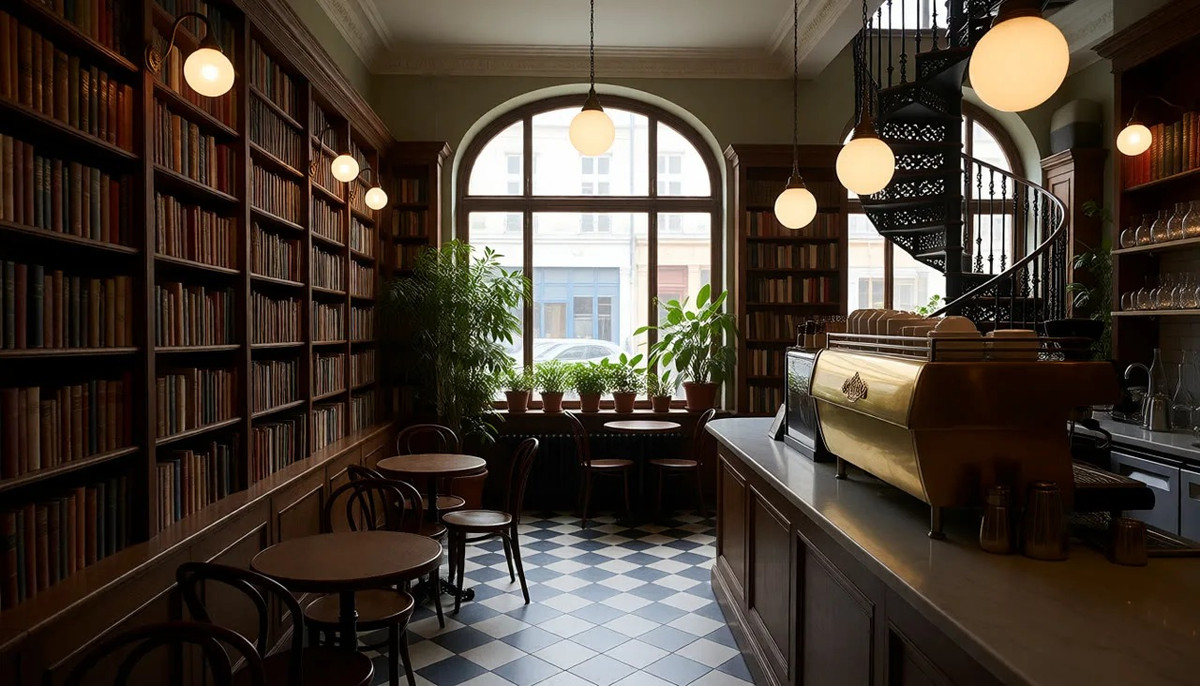
Un workflow en trois étapes pour maintenir la cohérence d'une même pièce sous différents angles de caméra : Krea 2 génère une pièce vide, FLUX.2 Klein 9B génère trois autres vues de la même pièce, puis H3 utilise ces références pour générer des plans de 5 secondes avec son.
Illustration
Raisons de la recommandation
- Sert la cohérence des décors : dans les courts-métrages multi-plans, la disposition de la pièce a tendance à changer lors des changements d'angle ; ici, une « fiche de décor » (une vue principale + trois nouvelles vues) est créée au préalable pour servir de référence à H3, l'auteur affirmant que la pièce reste cohérente lors des mouvements de caméra
- Les trois groupes de nœuds sont disposés de gauche à droite, utilisant uniquement les nœuds essentiels ; parmi les 4 workflows publiés par le même auteur ce jour-là, c'est le seul qui chaîne trois familles de modèles
- Inclut une vidéo explicative sur la chaîne YouTube de l'auteur, gratuit
Comment utiliser
- Modèles : un modèle Krea 2 (l'auteur utilise son propre Muse Krea2 V3.5) avec son encodeur de texte et son VAE ; FLUX.2 Klein 9B avec son encodeur de texte et son VAE ; MiniMax H3 Fused Turbo avec l'encodeur de texte et le VAE de H3
- Lancez d'abord tel quel pour voir la pièce d'exemple ; lors du passage à votre propre décor, modifiez d'abord les prompts du Groupe 1, en décrivant clairement chaque gros objet et sa position, et ajoutez "Empty, no people."
- Modifiez les trois prompts de vue du Groupe 2 pour correspondre à votre pièce et exigez des changements d'angle importants ; dans les prompts de caméra, indiquez quelle partie de la pièce correspond à chaque image, puis décrivez un mouvement de caméra et une action qui se produit
Risques et limitations
- Forte dépendance : nécessite le téléchargement et le chargement simultanés de trois jeux de modèles ; l'occupation de la VRAM et du disque n'est pas indiquée par l'auteur
- L'exemple ne contient que 3 image, sans vidéo, il est donc impossible de juger de la cohérence visuelle depuis la page
- L'archive est très petite (uniquement le workflow), la licence autorise uniquement l'utilisation du contenu généré ; le tutoriel détaillé se trouve sur le portail externe de l'auteur
【B】The Daily Grind - Workflow Minimax H3 · v1.1
Workflow · Mise à jour de version · Auteur darkroast175696 · Publié le 11-20 23:00 · Téléchargements 43
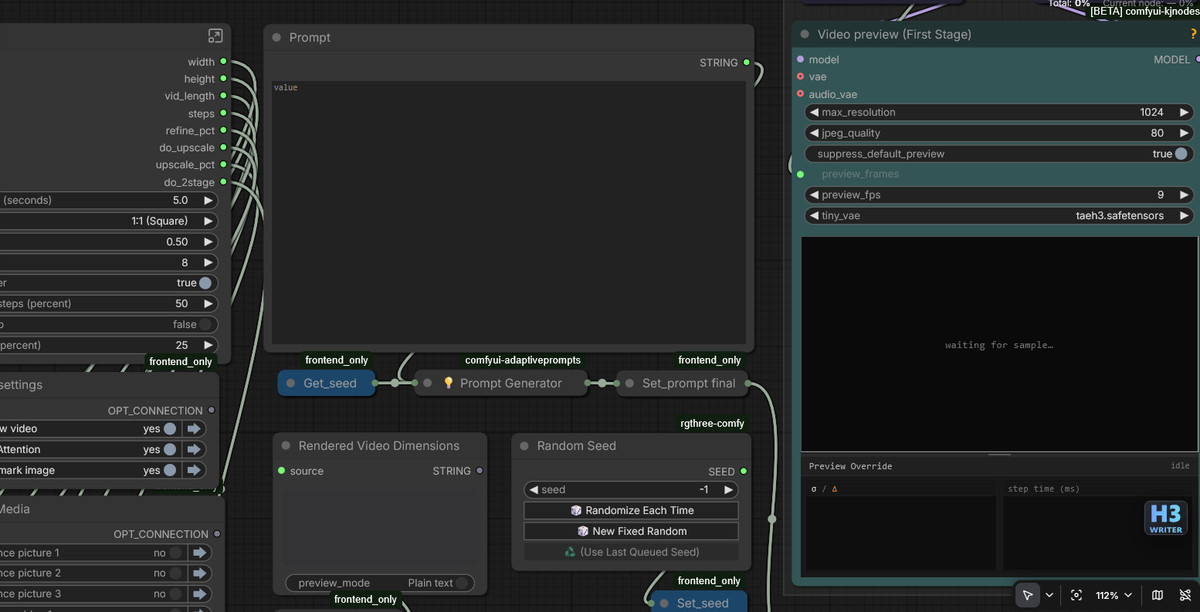
Un workflow v1.1 qui regroupe plusieurs tâches H3 courantes de l'auteur (texte-vers-vidéo, référence-vers-vidéo, etc.) dans un seul modèle, avec une option de rendu en deux étapes : chargement séparé des LoRA d'action et des LoRA de style/détails à différentes étapes.
Illustration
Raisons de la recommandation
- Rendu en deux étapes (concept similaire au double stade de Wan 2.2) : l'auteur explique que lorsque les LoRA d'action deviennent flous en haute résolution et que les LoRA de style endommagent la piste audio, ils peuvent être appliqués à leurs étapes respectives ; des recettes pour différents scénarios sont incluses dans le workflow
- Les paramètres courants sont regroupés dans une seule zone visuelle, sans avoir à entrer dans des sous-graphes pour modifier les paramètres ; passer du mode texte-vers-vidéo au mode référence-vers-vidéo ne nécessite pas de changer de modèle ; les informations de reproduction comme la graine et les prompts sont facilement accessibles
- Mise à jour de version : remplacement du nœud d'affichage des prompts, le texte n'est plus perdu lors du chargement depuis d'anciens workflows intégrés aux vidéos ; les fonctionnalités optionnelles sont désactivées par défaut pour réduire le nombre de nœuds personnalisés obligatoires ; les chargeurs LoRA sont vides par défaut et ne pré-sélectionnent plus les LoRA propres à l'auteur
Comment utiliser
- Après décompression, chargez le workflow ; les nœuds rouges appartiennent soit à des groupes désactivés par un interrupteur disponible, soit sont des nœuds obligatoires à installer
- Il est actuellement nécessaire d'activer Video Preview dans le panneau de paramètres sous les réglages de taille/durée, sinon le workflow ne s'exécutera pas (problème connu par l'auteur, qui promet une correction rapide)
- Téléchargez les modèles et LoRA selon la liste recommandée par l'auteur ; consultez les instructions dans le workflow pour le nombre d'étapes et l'intensité
Risques et limitations
- Les paramètres par défaut contiennent une erreur connue, nécessitant l'activation manuelle de Video Preview pour fonctionner
- Il n'y a que 4 captures d'écran du workflow, sans exemples vidéo
- Le nom du fichier de l'archive a été changé en h3-daily-driver ; il s'agit d'un JSON de workflow, pas de nouveaux poids
Inclus uniquement (8)
- Ochaco Uraraka Voice (Eng) - My Hero Academia - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA : un LoRA H3 entraîné uniquement sur la voix (clonage de timbre/voix) : entraîné sur des extraits du doublage anglais d'Ochaco Uraraka dans My Hero Academia, permettant aux personnages des vidéos générées de parler avec sa voix anglaise.
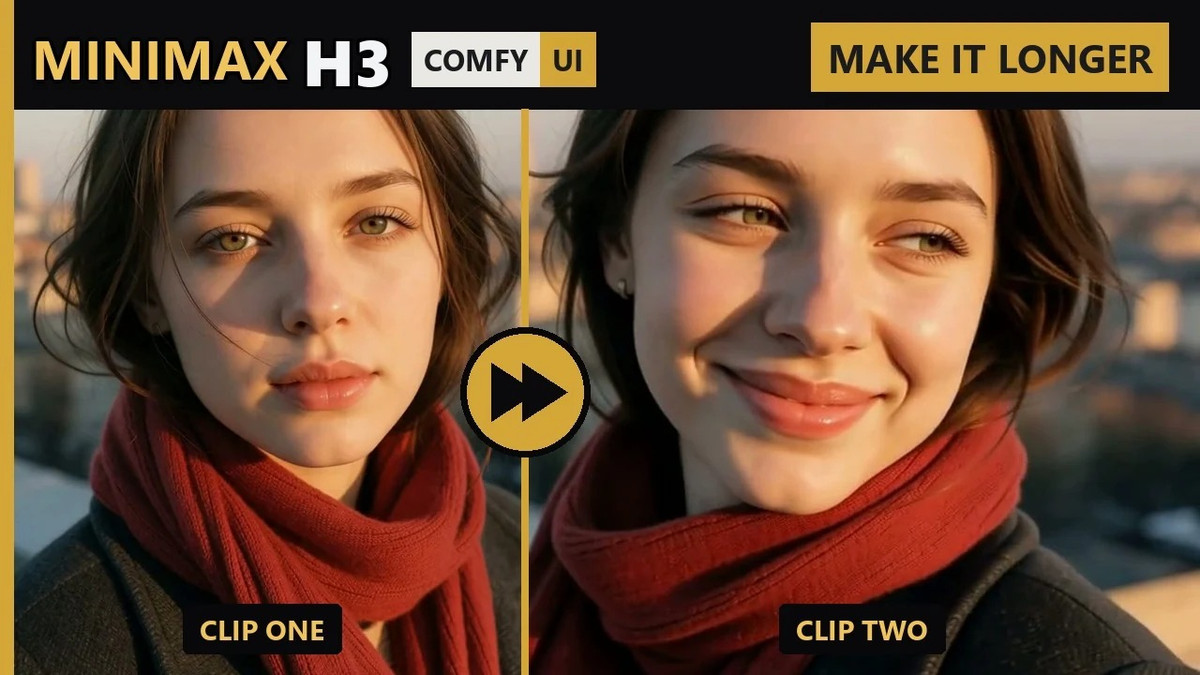
- MiniMax H3 Chain Clips : rendre plus long qu'un seul clip · v1.1 — Workflow : un workflow de base pour la continuation, générant le second segment à partir de la dernière image du premier clip H3, puis assemblant les images et les sons des deux segments.
- HyperFlow H3 Flash — Vidéo rapide avec son en 4–8 étapes (ComfyUI) · v1.1 — Workflow : version d'essai gratuite v1.1 du pack de workflow payant HyperFlow H3 Flash : des préréglages rapides de brouillon texte-vers-vidéo pour le modèle H3 compressé, générant un court métrage avec piste audio stéréo en 4 étapes.
- Maelle Voice (Eng) - Clair Obscur: Expedition 33 - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA : un LoRA H3 entraîné uniquement sur la voix (clonage de timbre/voix) : entraîné sur des extraits du doublage anglais de Maelle dans Clair Obscur: Expedition 33, pour donner aux personnages des vidéos générées sa voix.
- FastH3 Omni Lip-Sync — Portrait + ligne vocale vers vidéo parlante (ComfyUI) · v1.1 — Workflow : version d'essai gratuite v1.1 du pack de workflow payant FastH3 Omni Lip-Sync : entrez un portrait et une ligne vocale pour générer une vidéo parlante avec synchronisation labiale de 5 secondes.
- MiniMax H3 Split Prompts · v1.0 — Workflow : deux workflows qui divisent les prompts H3 en plusieurs champs d'entrée séparés pour faciliter la modification par segments : Ref2V (référence-vers-vidéo) v1.0 et FL2V (première/dernière image) v1.1.
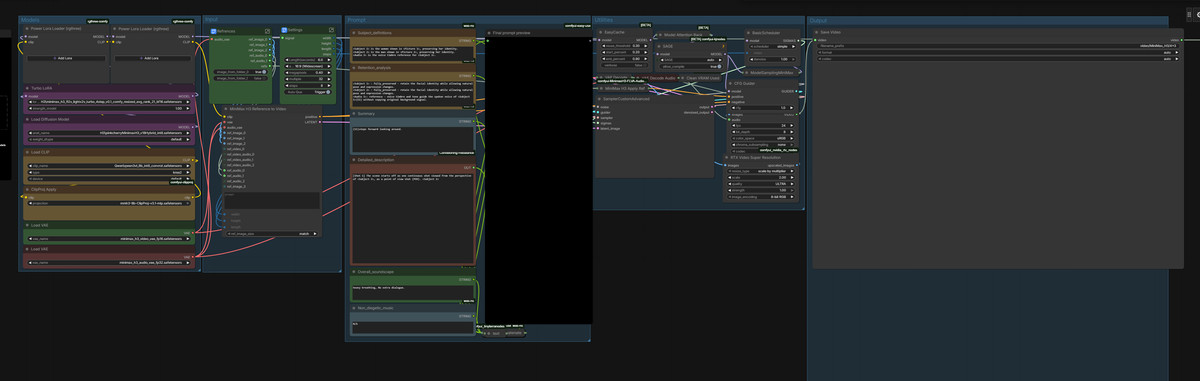
- Zelda Voice (Eng) - Breath of the Wild/Tears of the Kingdom - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA : un LoRA H3 entraîné uniquement sur la voix (clonage de timbre/voix) : entraîné sur des extraits du doublage anglais de Zelda dans The Legend of Zelda: Breath of the Wild / Tears of the Kingdom.
- Gonzo Muppet · v1.0 — LoRA : un LoRA H3 pour le personnage Gonzo des Muppets, divisé en deux fichiers (image et son), la fiche du modèle ne contenant que le nom.
Données : API publique de Civitai (modèle de base MiniMax H3), fenêtre d'inclusion du 11-20 20:31 au 11-21 09:01 (heure de Pékin). Les raisons de recommandation ont été revues par la rédaction ; le nombre de téléchargements reflète uniquement l'intérêt porté.