Zhenzhen의 AI 레이더 · MiniMax H3 · 2026-11-21 모닝 브리핑
이번 호 14개의 신규 버전: 강력 추천 0 · 추천 1 · 주목할 만함 5 · 단순 수록 8
편집자 주 이번 호에서는 H3의 새로운 버전 14개를 검토하여 A등급 1개, B등급 5개, C등급 8개로 분류했으며 제외된 항목은 없습니다. 최초 추천은 Story Creator입니다: 형식에 맞게 작성된 스토리보드 대본으로 한 번에 전체 스토리 영상을 생성하며, Qwen Image 2.1로 정지 이미지를 만들고 H3로 대사 포함 장면을 장면별로 생성한 뒤 YuE2로 배경음악을 입히며 핵심 노드만 사용합니다. Simply Advanced v1.7는 영상 부분 리페인팅 기능이 추가되었으나 스크린샷 예시만 있어 B등급으로 하향 조정했으며, Stable_Yogi의 동일 배치 내 워크플로우 4개, 영어 음성 클로닝 LoRA 3개 및 유료 팩 2종의 무료 체험판은 B/C등급으로 분류했습니다.
추천 (1)
【A】Story Creator 12GB — 대본에서 대사 포함 음성 및 YuE2 음악이 포함된 전체 스토리 영상으로: Qwen Image 2.1 정지 이미지 + MiniMax H3 장면 · v1.4.0
워크플로우 · 신규 모델 · 저자 The_frizzy1 · 게시일 11-21 01:00 · 다운로드 수 19
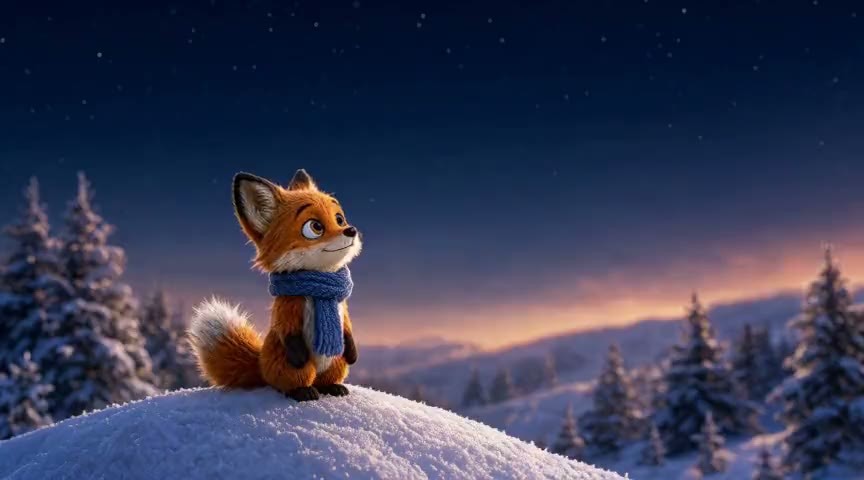
스토리보드 대본에서 바로 전체 스토리 영상을 생성하는 ComfyUI 워크플로우입니다: Qwen Image 2.1 Turbo가 각 장면의 정지 이미지를 생성하고, MiniMax H3가 각 정지 이미지를 대사와 효과음이 포함된 장면으로 변환하며, YuE2이 배경음악을 생성한 후 일관된 내레이션 음성을 추가합니다.
진입 장벽은 VRAM이 아닌 시간입니다: 먼저 동봉된 짧은 대본으로 한두 장면을 실행하여 주인공의 일관성과 대사 입모양을 확인한 후 전체를 실행하세요.
이미지
추천 이유
- '장편 AI 스토리 영상'을 위한 서비스: 형식에 맞게 작성된 대본을 입력하면 동일한 주인공이 모든 장면에 등장하고, 각 장면이 움직이며, 캐릭터가 말을 하고, 내레이션과 배경음악이 포함된 완성 영상을 출력합니다. 영상 부분은 모두 H3로 처리되므로 이 섹션에 정상적으로 수록되었습니다(동일 항목은 Qwen 2.1 섹션에도 포함됨)
- 주인공 일관성 유지 방법: Qwen Image 2.1가 먼저 캐릭터 이미지를 생성하고, 각 장면의 정지 이미지는 이를 편집하여 만듭니다. H3는 FL2VA 기본 모델에 8단계 터보 LoRA를 사용하여 장면별로 생성하며, 길이는 대사 양에 따라 자동으로 결정됩니다. 내레이션은 H3를 별도로 실행하여 음성만 추출함으로써 전체 영상에서 동일한 내레이션 음성을 보장합니다
- ComfyUI 핵심 노드(Start Loop / End Loop 루프)만 사용하며 커스텀 노드는 설치하지 않습니다. 저자는 RTX 3060 12 GB + 32 GB 메모리 환경에서 실행이 가능하다고 언급했으며, 9개 모델 파일의 다운로드 주소와 저장 경로를 하나씩 나열했습니다
- 저자는 작동하지 않는 부분도 명시했습니다: 내장된 8B 텍스트 인코더를 사용한 자동 스토리보드 작성은 효과가 낮아 기본값으로 비활성화되어 있습니다. 주인공만 일관성이 유지되며, 조연은 매 문장마다 완전히 묘사해야 합니다
- 2개의 영상 + 6장의 이미지 예시를 확인할 수 있으며, 워크플로우 자체는 MIT 라이선스입니다
사용 방법
- ComfyUI 0.39 이상 필요. 모델 카드에 따라 Qwen Image 2.1의 3개 파일(Turbo int8, Qwen3-VL 8B 텍스트 인코더, VAE), H3의 5개 파일(fl2va pruned int8 기본 모델, fl2v turbo 8step LoRA, Qwen3-VL 32B 텍스트 인코더, 영상 VAE, 오디오 VAE) 및 YuE2의 1개 파일을 다운로드하세요
- 대본 형식: 첫 줄은 WORLD:로 전체 아트 스타일을 지정합니다. 각 줄은 먼저 [카메라 위치/움직임]을 작성하고, 그 다음 화면(장소, 각 캐릭터의 완전한 외모, 동작)을 작성합니다. || 뒤는 내레이션이며, || 이름: 뒤는 해당 캐릭터가 화면에서 말하는 대사입니다. [continue]를 사용하면 현재 장면의 끝이 다음 장면으로 하드 컷 없이 자연스럽게 이어집니다
- 각 장면의 길이는 자동으로 3–9초 사이로 설정됩니다. 저자는 워크플로우 내장 자동 작성 기능 대신 동봉된 HOW_TO_WRITE_A_SCRIPT.md를 사용하여 대형 언어 모델 채팅 도구로 대본을 작성할 것을 권장합니다
- 전체 워크플로우는 저자의 GitHub 및 Hugging Face 미러에도 있습니다
리스크 및 제한 사항
- 저자는 v1.4.0에 업데이트 노트가 없어 변경 사항을 명확히 알 수 없다고 명시했습니다. 페이지의 소요 시간 데이터는 v1.0 및 v1.2 기준입니다
- 매우 느립니다: 저자가 제시한 소요 시간은 1분 분량의 완성 영상 약 43분, 3분 분량 약 2시간, 5분(58장면) 분량 약 3시간 35분이며, 5분 분량의 스토리는 하룻밤이 걸립니다
- 약 30장면을 초과하면 두 부분으로 나누어 실행한 후 편집 소프트웨어에서 이어 붙여야 합니다(각 장면마다 메모리가 약 0.6 GB 증가). 각 장면의 소리는 별도로 생성되므로 볼륨 불일치는 후반 작업에서 통일해야 합니다
- 오버 더 숄더 샷이나 화면 프레임에 잘린 캐릭터는 오류가 발생하기 쉽습니다(주인공이 두 번 나타나거나 두 캐릭터가 붙어 보임)
- 라이선스 충돌: 워크플로우는 MIT이지만 Qwen Image 2.1(Qwen Research Licence)와 YuE2(CC-BY-NC-4.0)는 모두 비상업용이며, H3에는 별도의 커뮤니티 라이선스가 있습니다. Civitai 페이지에서 선택된 상업적 사용 가능 여부는 이러한 모델의 라이선스를 덮어쓸 수 없습니다
- 데이터에서 기본 모델은 Other로 표기되어 있습니다. 모델 파일 총 용량은 수십 GB에 달하며 일부 예시는 숨겨져 있습니다(5개)
주목할 만함 (5)
【B】Simply Advanced - MiniMax H3 · v1.7
워크플로우 · 버전 업데이트 · 저자 altoiddealer · 게시일 11-21 05:47 · 다운로드 수 29
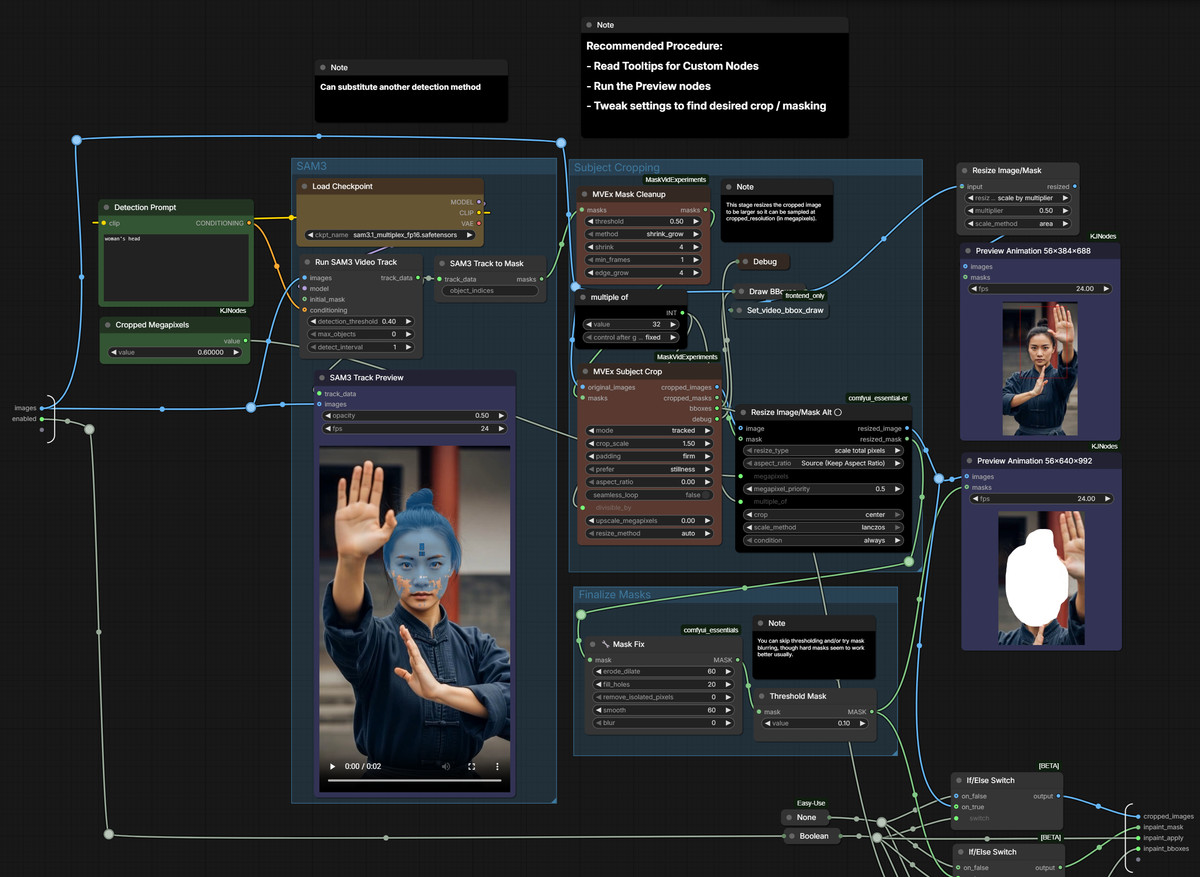
다중 입력 통합 H3 워크플로우인 Simply Advanced의 v1.7입니다: 영상 부분 리페인팅 스위치가 추가되어 원본 영상 내에서 추적/마스크 처리된 영역에서만 재생성합니다.
이미 이 워크플로우를 사용 중인 경우, 이번 버전은 주로 부분 리페인팅 기능이 추가되었습니다. 초보자는 LLM 강화 및 리페인팅 기능을 끄고 참고/가이드 부분만 먼저 사용해 보세요. (편집자 B등급 하향: 이번 버전의 신규 기능은 스크린샷 1장만 있어 리페인팅 효과를 판단할 영상 예시가 없습니다.)
이미지
추천 이유
- 버전 업데이트: v1.7에 Video Inpainting이 추가되어 입력된 Video 1의 스위치를 켜고 간단히 설정하면 추적 마스크 영역만 리페인팅할 수 있습니다. 자르기, 마스크 생성, 붙여넣기 3단계는 MaskVidExperiments 노드가 처리합니다
- 도구 자체: 최대 이미지 6장, 영상 2개, 오디오 3개를 연결할 수 있으며 각각을 참고(reference), 가이드(guide) 또는 둘 다로 설정할 수 있습니다. 잠재 공간 업스케일링 / 2단계 생성 및 단계별 LoRA 관리 기능을 제공합니다
- 원활한 연장: 입력 영상의 끝에서 이어 쓰기(Continuation), 입력 영상의 시작 부분으로 생성(Convergence)하거나 두 가지를 조합하여 두 영상 사이를 채울 수 있습니다
- 저자의 4단계 Ref2VA 프롬프트 파이프라인(확장 → 참고 분석 → 창의적 블루프린트 → H3 프롬프트 구조로 컴파일)과 1단계 FL2VA 프롬프트 강화가 내장되어 있으며, 모드는 Image 1 / Image 2에 이미지가 있는지 여부에 따라 자동으로 판단됩니다
- 모델 누적 다운로드 수 1281회, 무료
사용 방법
- 필수 설치 노드: ComfyUI-Easy-Use, ComfyUI-KJNodes, 저자의 comfyui_essential-er. 이번 버전의 영상 부분 리페인팅을 사용하려면 MaskVidExperiments를 추가로 설치하세요
- 선택적 노드: VideoHelperSuite의 Load Video, MiniMax H3 RefMods, Spectrum 가속 노드 등
- simply-advanced_minimax_h3_v1.7.json을 불러온 후 Video 1에서 Inpainting 스위치를 켜고 마스크 추적을 설정하세요. 단계 수, 강도 등 샘플링 매개변수는 워크플로우 내 기본값을 참조하며 저자는 모델 카드에 명시하지 않았습니다
리스크 및 제한 사항
- 전체 모델 카드는 comfyui-frontend 버전을 v1.50.5 미만으로 요구합니다(서브그래프 내의 Custom Combo 노드가 새로운 프론트엔드에서 오류가 발생). 새로운 프론트엔드를 설치한 사용자는 다운그레이드가 필요합니다
- 확인 가능한 예시는 스크린샷 1장뿐이며(추가로 1개가 숨겨져 있음), 영상 예시가 없어 리페인팅 효과를 판단할 수 없습니다
- 의존성 노드가 많으며, LLM 프롬프트 강화를 위해 별도의 LLM 설정이 필요합니다. 워크플로우 JSON이며 새로운 가중치가 아닙니다
【B】MiniMax H3 Fused Turbo: 3가지 시작 워크플로우(텍스트, 이미지, 참고) · v1
워크플로우 · 신규 모델 · 저자 Stable_Yogi · 게시일 11-21 01:50 · 다운로드 수 57
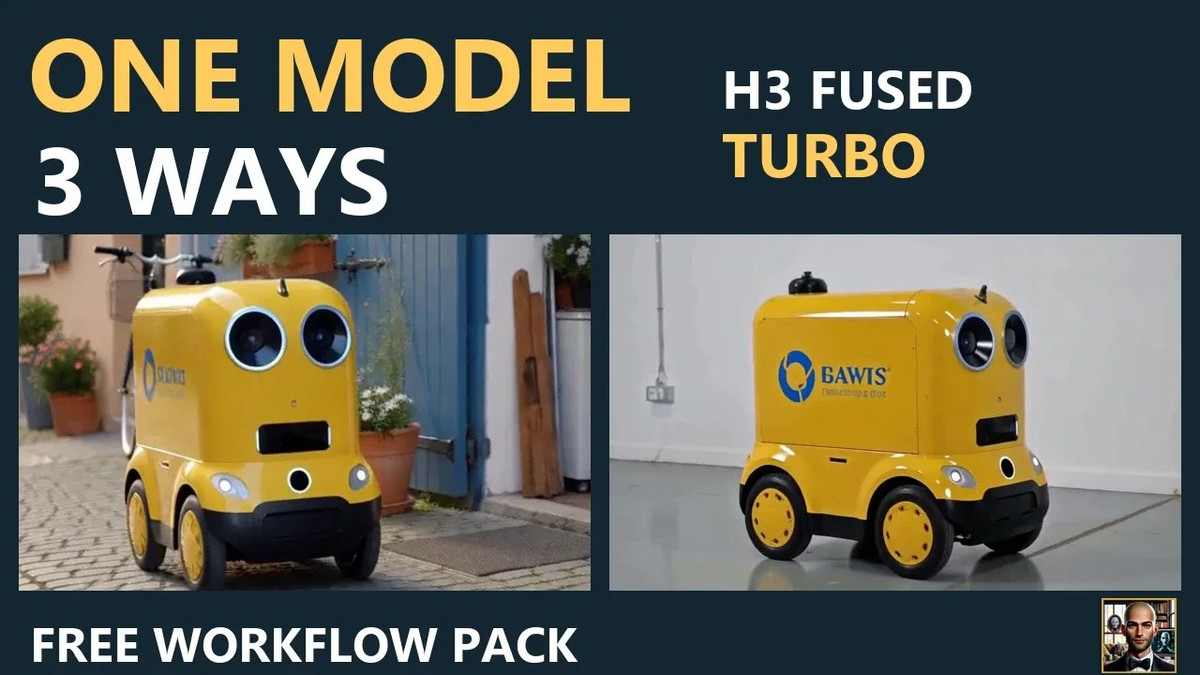
Stable_Yogi가 서드파티 융합 가속 모델인 MiniMax H3 Fused Turbo용으로 제작한 입문 워크플로우 패키지입니다: 텍스트에서 영상 생성, 이미지에서 영상 생성(사용자의 이미지를 첫 프레임으로 사용), 참고 이미지에서 영상 생성(이미지를 참고하여 다른 장면을 촬영)의 3가지 시작 방식을 제공합니다.
이미지
추천 이유
- 동일 저자가 당일 함께 공개한 H3 워크플로우 4개 중 이 항목은 입문 패키지입니다: 하나의 모델로 3가지 시작 방식, 총 4개의 테스트된 이미지(비교용으로 8단계 버전 1개 포함), 예시 이미지 및 QUICKSTART.md 제공
- 의존성이 적음: ComfyUI 핵심 MiniMax H3 노드만 사용. 압축 파일에는 API 호출용 .api.json 버전이 포함되어 있습니다
- 저자의 YouTube 설명 영상 제공, 무료
사용 방법
- Hugging Face에서 MATLOWAI의 minimax-h3-fused-turbo-int8-convrot를 models/diffusion_models에 다운로드하고, Comfy-Org/MiniMax-H3에서 텍스트 인코더 및 영상/오디오 VAE를 다운로드하세요
- 압축을 푼 후 .json 파일 하나를 ComfyUI로 드래그하여 로더에서 모델 파일을 선택하고, CLIP 로더 유형은 minimax로 유지하세요. 테스트 시에는 한 번에 하나의 이미지만 실행하세요
- Fused Turbo의 기본 단계 수는 저자가 모델 카드에 명시하지 않았으므로 워크플로우 내 기본값을 참조하거나 8단계 버전과 비교하세요
리스크 및 제한 사항
- Fused Turbo는 서드파티 융합 모델로 공식 가중치가 아니며, 공식 가속 LoRA와의 화질 차이에 대해 저자는 언급하지 않았습니다
- 예시는 이미지 3장뿐이며 영상은 없습니다
- 저자는 ComfyUI 0.32에서 테스트했다고 밝혔습니다. 라이선스는 생성된 콘텐츠의 사용만 허용하며 수정된 버전의 배포는 허용하지 않습니다. 상세 튜토리얼은 저자의 외부 포털에 있습니다
【B】MiniMax H3 Second Pass: 모션 복구 워크플로우 · v1.0
워크플로우 · 신규 모델 · 저자 Stable_Yogi · 게시일 11-21 01:50 · 다운로드 수 79
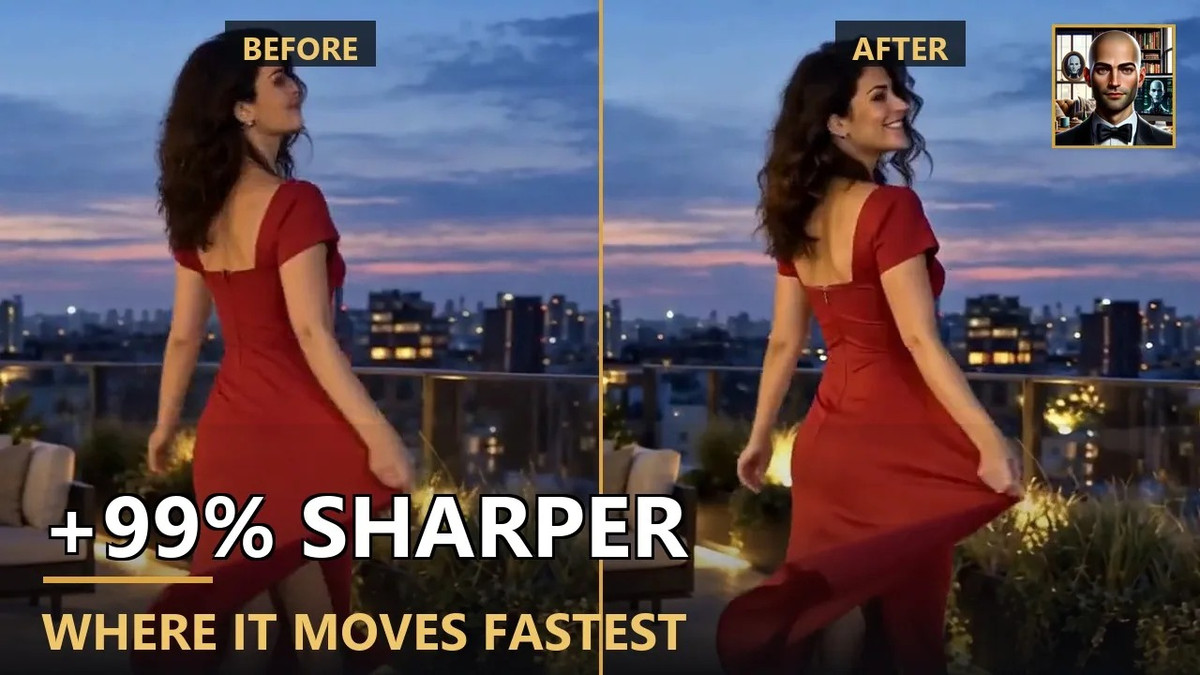
이미 생성된 H3 클립을 모델에 다시 보내 두 번째 패스를 실행하여 모션과 선명도를 복구하는 영상에서 영상으로의 워크플로우이며, 원본과 두 번째 패스 결과를 모두 저장하여 비교할 수 있습니다.
모션이 흐릿한 자신의 영상을 테스트하기에 적합합니다: 워크플로우 자체가 두 버전을 나란히 저장합니다.
이미지
추천 이유
- H3 클립의 후처리 서비스: 저자는 두 번째 패스 후 화면의 모든 부분이 더 선명해졌으며, 가장 빠르게 움직이는 부분의 품질이 99% 향상되었다고 주장합니다(전체 124 프레임에서 측정되었으며, 구체적인 지표는 저자가 명시하지 않음)
- 한 번에 두 개의 비디오 생성(일반 렌더링 + 두 번째 패스)하여 직접 전후 비교 수행
- 같은 저자의 입문용 팩과 달리, 이 팩은 공식 FL2VA pruned int8 기본 모델과 LightX2V 4 스텝 어댑터를 사용함; 압축 파일에 예제 이미지가 포함되어 있으며 무료임
사용 방법
- ComfyUI-MAINodes v1.1.3 이상 설치(Manager 또는 git clone 사용)
- 모델: minimax_h3_fl2va_pruned_int8_convrot(19.5 GB), qwen3vl_32b_minimax_h3_nvfp4_awq 텍스트 인코더(14.6 GB), minimax_h3_video_vae_fp16(4.9 GB), 오디오 VAE(누락 시 소리 없음), 그리고 models/loras 폴더에 LightX2V 4 스텝 어댑터 추가
- 압축 해제 후 예제 이미지를 ComfyUI/input에 넣고, 5개의 로더 경로를 확인한 뒤 한 번 실행하여 출력된 두 개의 비디오를 비교함; 두 번째 패스의 디노이징 강도 등 파라미터는 저자가 제공하지 않음
리스크 및 제한 사항
- '향상 99%'의 측정 방법은 공개되지 않았으므로, 저자의 주장으로만 간주해야 함
- 공개된 예제는 1장의 이미지뿐이며, 전후 비교 비디오는 없음
- LightX2V 4 스텝 어댑터의 구체적인 파일 이름과 링크가 제공되지 않음; 라이선스는 생성된 콘텐츠의 사용만 허용함
【B】MiniMax H3 Location Sheet: 모든 샷에서 동일한 방 · v1.0
워크플로우 · 신규 모델 · 저자 Stable_Yogi · 게시일 11-21 01:50 · 다운로드 수 75
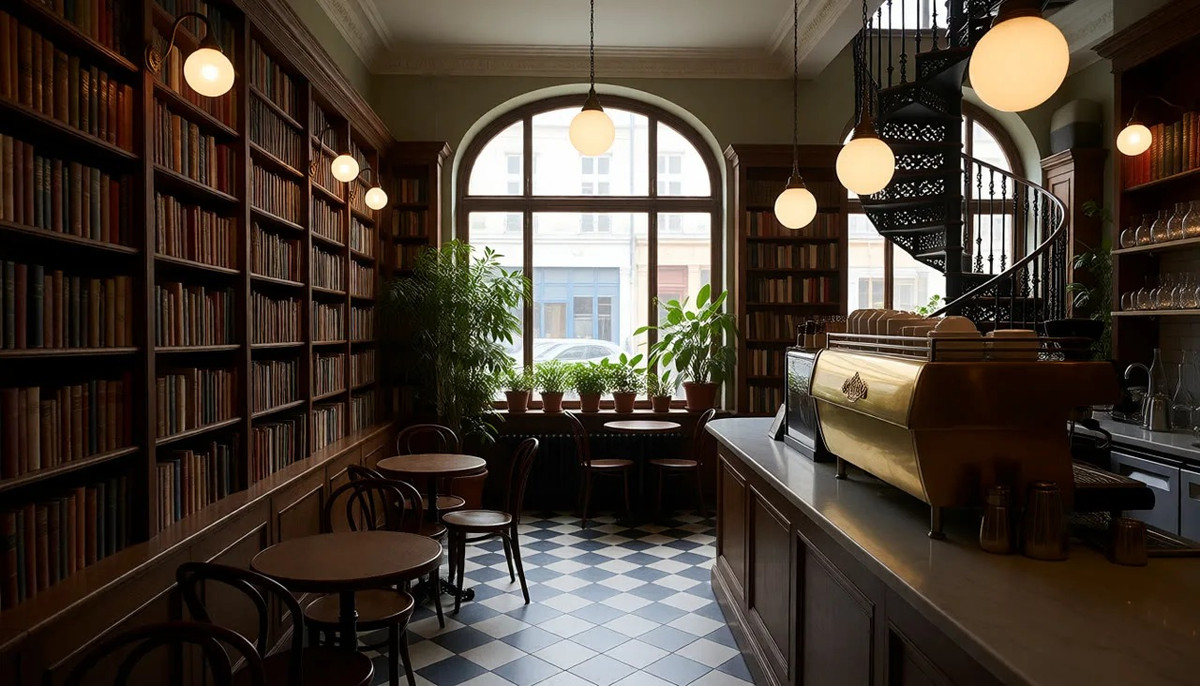
동일한 방이 서로 다른 카메라 각도의 샷에서도 일관성을 유지하도록 하는 3단계 워크플로우: Krea 2로 빈 방을 생성하고, FLUX.2 Klein 9B로 같은 방의 다른 세 가지 관점을 생성한 후, H3에 전달하여 소리가 포함된 5초 샷을 생성함.
예시 이미지
추천 이유
- 장면 일관성 지원: 다중 샷 단편 영상에서 카메라 각도를 변경할 때 방의 레이아웃이 변하기 쉬운데, 이 워크플로우는 먼저 '장면 설정 시트'(주 관점 1개 + 새로운 관점 3개)를 만들어 H3의 참조로 사용하며, 저자는 카메라가 회전할 때 방이 유지된다고 주장함
- 세 그룹의 노드가 왼쪽에서 오른쪽으로 배열되어 있으며 핵심 노드만 사용함; 같은 저자가 같은 날 공개한 4개의 워크플로우 중 세 가지 모델 패밀리를 연결해야 하는 유일한 워크플로우임
- 저자의 YouTube 설명 영상이 첨부되어 있으며 무료임
사용 방법
- 모델: Krea 2 모델 하나(저자는 자신의 Muse Krea2 V3.5를 사용함) 및 해당 텍스트 인코더와 VAE; FLUX.2 Klein 9B 및 해당 텍스트 인코더와 VAE; MiniMax H3 Fused Turbo 및 H3 텍스트 인코더와 VAE
- 먼저 예제 방으로 그대로 실행해 봄; 자신의 장면으로 변경할 때는 Group 1 프롬프트를 수정하여 각 큰 물건과 위치를 명확히 기재하고 "Empty, no people."을 추가함
- Group 2의 세 가지 관점 프롬프트를 자신의 방에 맞게 변경하고 큰 각도 변화를 요구함; 샷 프롬프트에서는 각 이미지가 방의 어느 부분을 나타내는지 설명하고, 카메라 움직임과 발생하는 사건 하나를 기재함
리스크 및 제한 사항
- 의존성이 무거움: 세 가지 모델 세트를 동시에 다운로드하고 로드해야 하며, VRAM 및 디스크 사용량은 저자가 명시하지 않음
- 예제는 3장의 이미지뿐이며 비디오가 없어, 페이지에서 일관성 효과를 판단할 수 없음
- 압축 파일이 매우 작음(워크플로우만 포함); 라이선스는 생성된 콘텐츠의 사용만 허용하며, 상세 튜토리얼은 저자의 외부 포털에 있음
【B】The Daily Grind - Minimax H3 Workflow · v1.1
워크플로우 · 버전 업데이트 · 저자 darkroast175696 · 게시일 11-20 23:00 · 다운로드 수 43
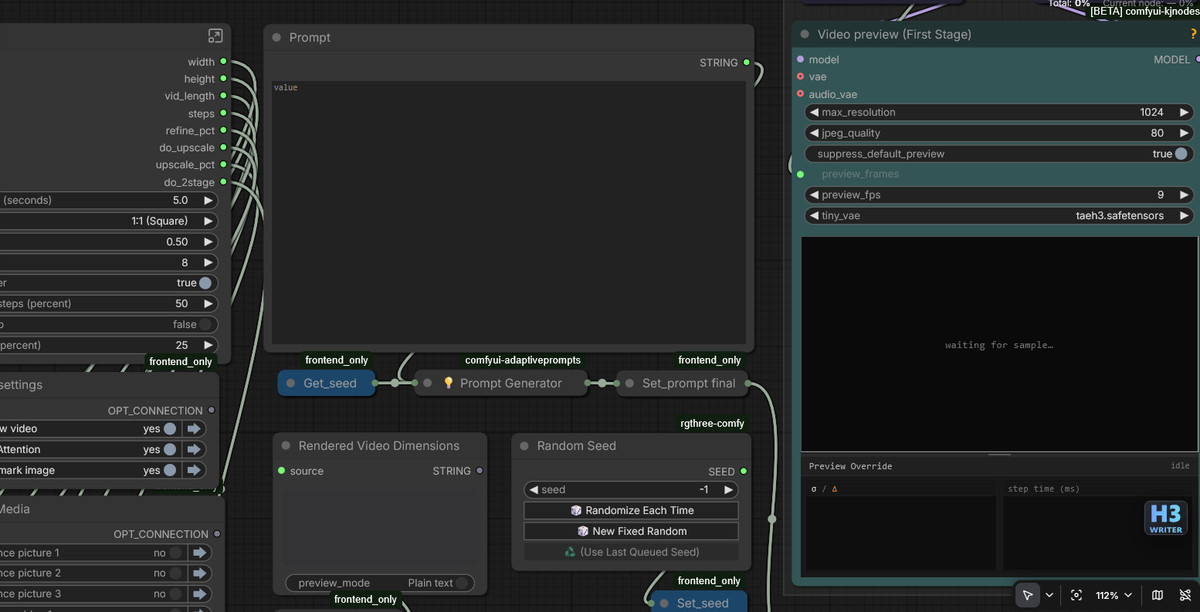
저자가 자주 사용하는 여러 H3 작업(텍스트-비디오, 참조-비디오 등)을 하나의 템플릿으로 통합한 워크플로우 v1.1으로, 2단계 렌더링을 선택적으로 사용 가능: 서로 다른 단계에서 동작 LoRA와 스타일/디테일 LoRA를 각각 로드함.
예시 이미지
추천 이유
- 2단계 렌더링(Wan 2.2의 2단계 방식과 유사한 개념): 저자는 동작 LoRA가 고해상도에서 흐려지거나 스타일 LoRA가 오디오 트랙을 망칠 경우, 각 LoRA가 효과적으로 작동하는 단계에 배치할 수 있다고 주장함; 워크플로우에는 다양한 시나리오에 대한 레시피 설명이 첨부되어 있음
- 일반적인 설정이 하나의 화면 영역에 집중되어 있어 서브그래프에 들어가 파라미터를 수정할 필요가 없음; 텍스트-비디오 / 참조-비디오 전환 시 템플릿을 변경할 필요가 없음; 시드, 프롬프트 등 재현 정보가 쉽게 추출됨
- 버전 업데이트: 프롬프트 표시 노드가 변경되어, 이전 비디오에 내장된 워크플로우를 로드할 때 텍스트가 더 이상 손실되지 않음; 선택적 기능은 필수 커스텀 노드 설치를 줄이기 위해 기본적으로 비활성화됨; LoRA 로더는 기본적으로 비워져 있으며 저자의 LoRA를 더 이상 사전 선택하지 않음
사용 방법
- 압축 해제 후 워크플로우를 로드함; 빨간색 노드는 사용 가능한 스위치가 꺼진 그룹에 속하거나, 반드시 설치해야 하는 노드임
- 현재는 크기 / 길이 설정 아래에 있는 설정 패널에서 Video Preview를 먼저 활성화해야 워크플로우가 실행됨(저자가 인지한 문제이며, 조속히 수정할 것이라고 밝힘)
- 모델과 LoRA는 저자의 추천 목록에 따라 직접 다운로드함; 스텝 수, 강도는 워크플로우 내 설명을 참조함
리스크 및 제한 사항
- 기본 설정에 알려진 오류가 있어, Video Preview를 수동으로 활성화해야 실행 가능함
- 워크플로우 스크린샷 4장만 있으며, 비디오 예제는 없음
- 압축 파일 이름이 h3-daily-driver로 변경됨; 워크플로우 JSON 파일이며 새로운 가중치가 아님
참고용만 수록 (8)
- 오차코 우라라카 목소리(영어) - 히어로 아카데미아 - 오디오 전용 [Minimax H3] (의뢰) · Minimax H3 v1.0 — LoRA: 음성만 학습한 H3 LoRA(음색/보이스 클로닝): 《히어로 아카데미아》의 히다카 이즈쿠(우라라카 오차코) 영어 더빙 클립으로 학습하여, 생성된 영상 속 캐릭터가 그녀의 영어 목소리로 말하게 합니다.
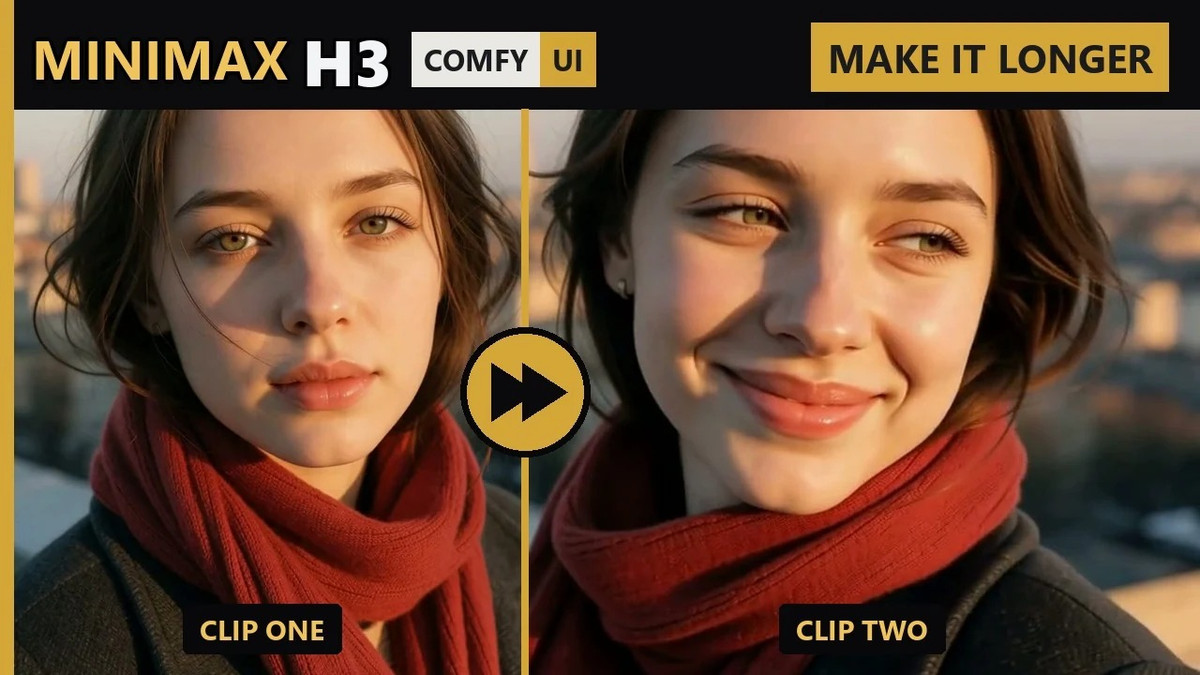
- MiniMax H3 체인 클립: 하나의 클립보다 길게 만들기 · v1.1 — 워크플로우: 첫 번째 H3 클립의 마지막 프레임을 사용하여 두 번째 클립을 생성하고, 두 클립의 영상과 소리를 결합하는 기본 연속 생성 워크플로우입니다.
- HyperFlow H3 Flash — ComfyUI에서 4–8 단계로 소리가 포함된 빠른 영상 생성 · v1.1 — 워크플로우: 유료 워크플로우 패키지 HyperFlow H3 Flash의 무료 체험판 v1.1입니다. 압축된 H3 모델을 위한 텍스트-투-비디오 빠른 초안 프리셋으로, 4 단계 만에 스테레오 오디오 트랙이 포함된 짧은 영상을 생성합니다.
- 마엘 목소리(영어) - Clair Obscur: Expedition 33 - 오디오 전용 [Minimax H3] (의뢰) · Minimax H3 v1.0 — LoRA: 음성만 학습한 H3 LoRA(음색/보이스 클로닝): 《Clair Obscur: Expedition 33》의 마엘(Maelle) 영어 더빙 클립으로 학습하여, 생성된 영상 속 캐릭터에 그녀의 목소리를 입힙니다.
- FastH3 Omni 립싱크 — ComfyUI에서 초상화 + 음성 라인으로 말하는 영상 생성 · v1.1 — 워크플로우: 유료 워크플로우 패키지 FastH3 Omni Lip-Sync의 무료 체험판 v1.1입니다. 초상화 이미지와 음성 클립을 입력하면 5초 길이의 립싱크가 적용된 말하는 인물 영상을 생성합니다.
- MiniMax H3 프롬프트 분할 · v1.0 — 워크플로우: H3 프롬프트를 여러 개의 별도 입력 필드로 분리하여 부분 수정을 쉽게 할 수 있는 두 가지 워크플로우입니다: Ref2V(참조 기반 비디오 생성) v1.0 및 FL2V(첫 프레임/마지막 프레임) v1.1.
- 젤다 목소리(영어) - 브레스 오브 더 와일드 / 티어스 오브 더 킹덤 - 오디오 전용 [Minimax H3] (의뢰) · Minimax H3 v1.0 — LoRA: 음성만 학습한 H3 LoRA(음색/보이스 클로닝): 《젤다의 전설: 브레스 오브 더 와일드 / 티어스 오브 더 킹덤》의 젤다 영어 더빙 클립으로 학습했습니다.
- 곤조 마펫 · v1.0 — LoRA: 마펫 쇼 캐릭터 곤조(Gonzo)의 H3 LoRA로, 영상과 음성 두 개의 파일로 구성되어 있으며 모델 카드에는 이름만 기재되어 있습니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수록 기간 11-20 20:31 → 11-21 09:01(베이징 시간). 추천 이유는 편집 검수를 거쳤으며, 다운로드 수는 관심도를 나타낼 뿐임.