Radar AI của Trinh Trinh · MiniMax H3 · Bản tin buổi sáng 2026-11-21
Kỳ này có 14 phiên bản mới: Rất khuyến nghị 0 · Khuyến nghị 1 · Đáng chú ý 5 · Chỉ ghi nhận 8
Lời bình của biên tập viên Kỳ này đã xem xét 14 phiên bản mới của H3, gồm 1 hạng A, 5 hạng B, 8 hạng C, không có loại trừ. Ưu tiên giới thiệu Story Creator: từ kịch bản phân cảnh được viết theo định dạng, xuất ra toàn bộ video câu chuyện chỉ trong một lần chạy; Qwen Image 2.1 tạo ảnh tĩnh, H3 sinh từng cảnh quay có lời thoại, YuE2 tạo nhạc nền, chỉ sử dụng các node cốt lõi. Simply Advanced v1.7 bổ sung tính năng vẽ lại cục bộ video, nhưng chỉ có ví dụ dạng ảnh chụp màn hình nên bị hạ xuống hạng B; Stable_Yogi cùng đợt ra mắt 4 workflow, 3 LoRA nhân bản giọng nói tiếng Anh và phiên bản dùng thử miễn phí của hai gói trả phí được xếp vào hạng B / C.
Khuyến nghị (1)
【A】Story Creator 12GB — từ kịch bản đến video câu chuyện hoàn chỉnh: Ảnh tĩnh Qwen Image 2.1 + các cảnh quay MiniMax H3 có giọng nói + nhạc YuE2 · v1.4.0
Workflow · Mô hình mới · Tác giả The_frizzy1 · Phát hành 11-21 01:00 · Lượt tải 19
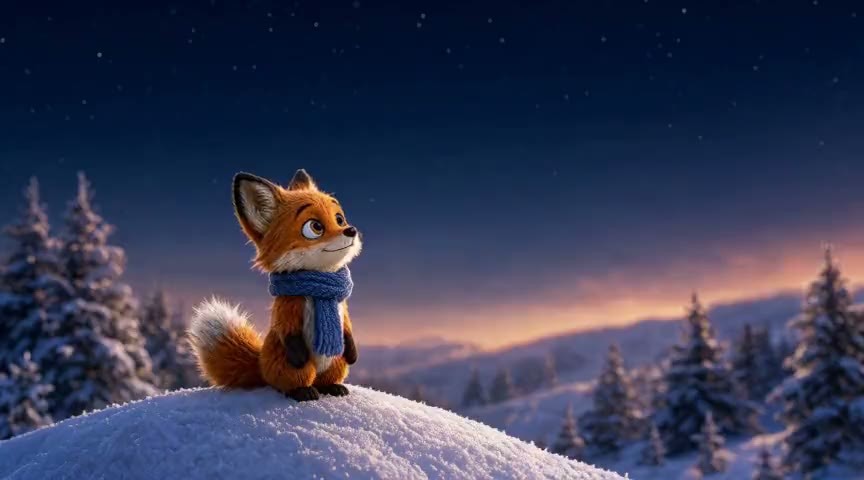
Workflow ComfyUI xuất ra toàn bộ video câu chuyện trực tiếp từ một kịch bản phân cảnh: Qwen Image 2.1 Turbo tạo ảnh tĩnh cho từng cảnh, MiniMax H3 biến mỗi ảnh tĩnh thành một cảnh quay có lời thoại và hiệu ứng âm thanh, YuE2 sinh nhạc nền, cùng với một giọng đọc tường thuật thống nhất.
Rào cản nằm ở thời gian chứ không phải bộ nhớ VRAM: hãy chạy thử một hoặc hai cảnh bằng kịch bản ngắn đi kèm trước, xác nhận sự nhất quán của nhân vật chính và khớp khẩu hình lời thoại rồi mới chạy toàn bộ bài.
Hình ảnh minh họa
Lý do khuyến nghị
- Phục vụ cho "video câu chuyện AI dài tập": đầu vào là một kịch bản được viết theo định dạng, đầu ra là thành phẩm có cùng nhân vật chính xuyên suốt các cảnh, mỗi cảnh đều chuyển động, nhân vật mở miệng nói, có lời tường thuật và nhạc nền; phần video hoàn toàn do H3 thực hiện, nên vẫn được ghi nhận bình thường trong chuyên mục này (cùng một bài viết cũng xuất hiện trong chuyên mục Qwen 2.1)
- Cách thức đảm bảo sự nhất quán của nhân vật chính: Qwen Image 2.1 trước tiên tạo ra một ảnh nhân vật, mỗi ảnh tĩnh cho từng cảnh đều là bản chỉnh sửa từ ảnh đó; H3 sử dụng mô hình cơ sở FL2VA cộng với LoRA turbo 8 bước để sinh từng cảnh, thời lượng tự động xác định dựa trên số lượng lời thoại; phần tường thuật được chạy riêng một lần qua H3 chỉ lấy âm thanh, đảm bảo toàn bộ phim có cùng một giọng đọc tường thuật
- Chỉ sử dụng các node cốt lõi của ComfyUI (vòng lặp Start Loop / End Loop), không cài đặt node tùy chỉnh; tác giả tuyên bố đã chạy thành công trên RTX 3060 12 GB + bộ nhớ RAM 32 GB, danh sách địa chỉ tải xuống và thư mục lưu trữ cho từng tệp trong số 9 tệp mô hình được liệt kê chi tiết
- Tác giả cũng đã viết rõ những điểm chưa ổn: bộ mã hóa văn bản 8B tích hợp sẵn tự động viết kịch bản phân cảnh cho hiệu quả kém, nên đã tắt theo mặc định; chỉ có nhân vật chính là giữ được sự nhất quán, còn các nhân vật phụ cần mô tả đầy đủ trong từng câu thoại
- Có thể xem 2 đoạn video + 6 ảnh minh họa, bản thân workflow được cấp phép MIT
Cách sử dụng
- ComfyUI phiên bản 0.39 trở lên; tải xuống ba tệp Qwen Image 2.1 (Turbo int8, bộ mã hóa văn bản Qwen3-VL 8B, VAE), năm tệp H3 (mô hình cơ sở fl2va pruned int8, LoRA turbo 8 bước cho fl2v, bộ mã hóa văn bản Qwen3-VL 32B, VAE video, VAE âm thanh) và một tệp YuE2 theo thẻ mô hình
- Định dạng kịch bản: dòng đầu tiên là WORLD: xác định phong cách nghệ thuật tổng thể; mỗi dòng bắt đầu bằng [góc máy/chuyển động camera], tiếp theo là mô tả cảnh (địa điểm, ngoại hình đầy đủ của từng nhân vật, hành động); sau || là lời tường thuật ngoài khung hình, sau || Tên: là lời thoại mà nhân vật đó nói trong cảnh; [continue] cho phép kết thúc cảnh này nối liền với hình ảnh của cảnh tiếp theo thay vì cắt cứng
- Thời lượng mỗi cảnh tự động nằm trong khoảng 3–9 giây; tác giả khuyên nên sử dụng công cụ trò chuyện mô hình ngôn ngữ lớn để viết kịch bản theo tệp HOW_TO_WRITE_A_SCRIPT.md đi kèm, không nên dùng tính năng tự động viết có sẵn trong workflow
- Workflow hoàn chỉnh cũng có trên GitHub của tác giả và bản sao lưu trên Hugging Face
Rủi ro và hạn chế
- Tác giả ghi rõ v1.4.0 không có ghi chú cập nhật, không nói rõ đã thay đổi những gì; dữ liệu thời gian trên trang được lấy từ v1.0 và v1.2
- Rất chậm: thời gian xử lý do tác giả cung cấp là 1 phút để tạo video hoàn chỉnh mất khoảng 43 phút, 3 phút mất khoảng 2 giờ, 5 phút (58 cảnh) mất khoảng 3 giờ 35 phút, một câu chuyện dài 5 phút cần chạy qua đêm
- Nếu vượt quá khoảng 30 cảnh, cần chia thành hai phần để chạy rồi ghép lại trong phần mềm chỉnh sửa (bộ nhớ tăng thêm khoảng 0.6 GB mỗi cảnh); âm thanh của mỗi cảnh được tạo riêng biệt, độ lớn âm lượng không đồng nhất cần được chuẩn hóa trong giai đoạn hậu kỳ
- Các cảnh quay qua vai và các nhân vật bị cắt bởi khung hình dễ gặp lỗi (nhân vật chính xuất hiện hai lần, hai nhân vật dính liền vào nhau)
- Xung đột giấy phép: quy trình làm việc theo giấy phép MIT, nhưng Qwen Image 2.1 (Giấy phép Nghiên cứu Qwen) và YuE2 (CC-BY-NC-4.0) đều không cho phép sử dụng thương mại, H3 có giấy phép cộng đồng riêng; việc đánh dấu cho phép sử dụng thương mại trên trang Civitai không thể ghi đè các giấy phép của những mô hình này
- Trong dữ liệu, mô hình cơ sở được đánh dấu là Other; tổng dung lượng tệp mô hình lên tới hàng chục GB, một số ví dụ bị ẩn (5 cái)
Đáng chú ý (5)
【B】Simply Advanced - MiniMax H3 · v1.7
Workflow · Cập nhật phiên bản · Tác giả altoiddealer · Phát hành 11-21 05:47 · Lượt tải 29
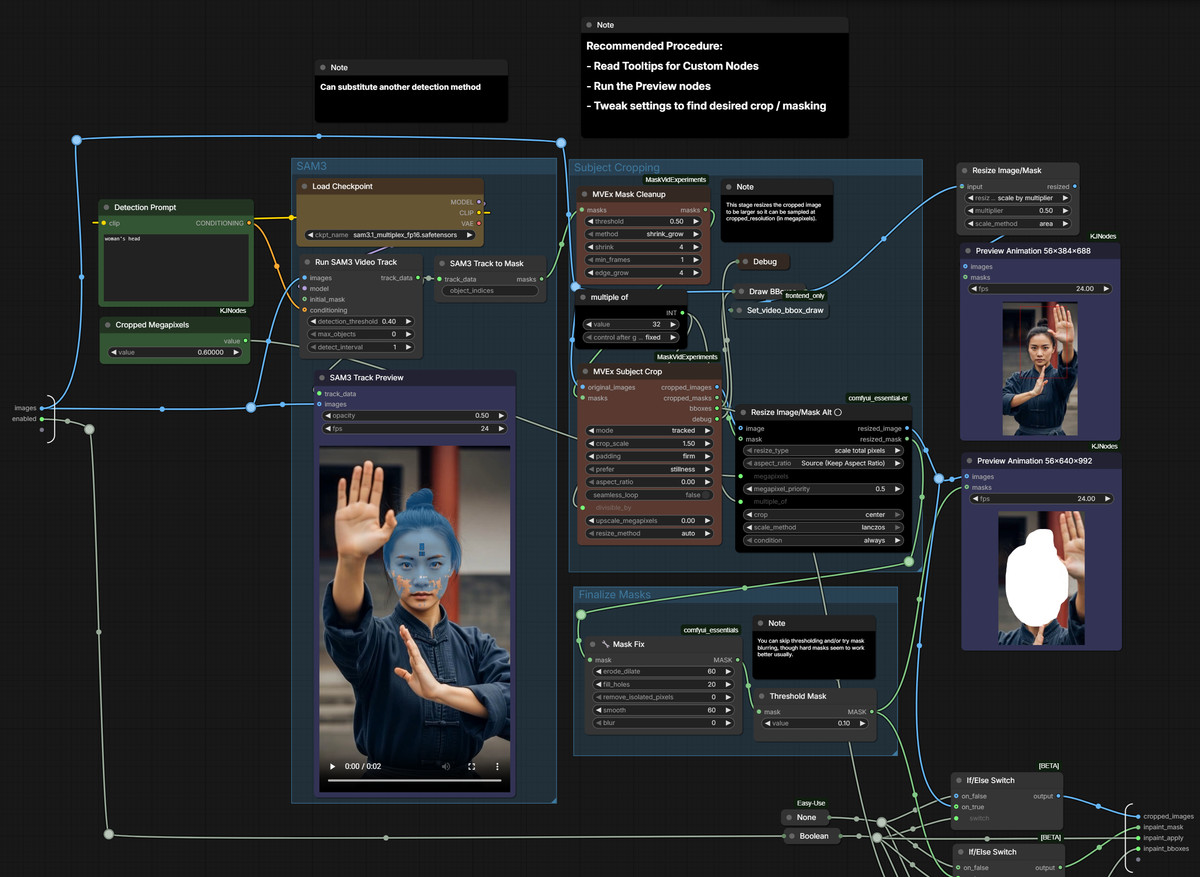
Phiên bản v1.7 của Simply Advanced, một workflow H3 tích hợp đa đầu vào: bổ sung công tắc vẽ lại cục bộ video, chỉ tái tạo trong khu vực được theo dõi/che mặt nạ trên video gốc.
Đối với những người đã sử dụng bộ workflow này, phiên bản này chủ yếu thêm tính năng vẽ lại cục bộ; người mới có thể tắt tính năng tăng cường LLM và vẽ lại trước, chỉ sử dụng phần tham khảo/hướng dẫn. (Biên tập viên hạ xuống hạng B: các tính năng mới của phiên bản này chỉ có 1 ảnh chụp màn hình, không có ví dụ video để đánh giá hiệu quả vẽ lại.)
Hình ảnh minh họa
Lý do khuyến nghị
- Cập nhật phiên bản: v1.7 bổ sung tính năng Video Inpainting, chỉ cần bật công tắc và cấu hình đơn giản cho Video đầu vào 1 là có thể chỉ vẽ lại các vùng được theo dõi bởi mặt nạ; ba bước cắt, tạo mặt nạ và ghép lại được xử lý bởi nút MaskVidExperiments
- Công cụ: hỗ trợ tối đa 6 hình ảnh, 2 đoạn video và 3 đoạn âm thanh, mỗi mục đều có thể được đặt làm tham chiếu (reference), hướng dẫn (guide) hoặc cả hai; tích hợp phóng đại không gian tiềm ẩn / sinh hai giai đoạn và quản lý LoRA theo giai đoạn
- Kéo dài liền mạch: có thể tiếp tục từ cuối video đầu vào (Continuation), sinh ra phần đầu video đầu vào (Convergence), hoặc kết hợp cả hai để chèn một đoạn giữa hai video
- Tích hợp sẵn quy trình nhắc lệnh Ref2VA gồm 4 bước của tác giả (mở rộng → phân tích tham chiếu → bản thiết kế sáng tạo → biên dịch thành cấu trúc nhắc lệnh H3) và tính năng tăng cường nhắc lệnh FL2VA gồm 1 bước, chế độ được tự động xác định dựa trên việc có hình ảnh trong Image 1 / Image 2 hay không
- Tổng số lượt tải mô hình: 1281, miễn phí
Cách sử dụng
- Node bắt buộc cài đặt: ComfyUI-Easy-Use, ComfyUI-KJNodes, comfyui_essential-er của tác giả; để sử dụng tính năng vẽ lại cục bộ video của phiên bản này, cần cài thêm MaskVidExperiments
- Node tùy chọn: Load Video của VideoHelperSuite, MiniMax H3 RefMods, node tăng tốc Spectrum, v.v.
- Tải tệp simply-advanced_minimax_h3_v1.7.json, bật công tắc Inpainting trên Video 1 và thiết lập theo dõi mặt nạ; các tham số lấy mẫu như số bước, cường độ, v.v. hãy xem giá trị mặc định trong workflow, tác giả không ghi rõ trên thẻ mô hình
Rủi ro và hạn chế
- Thẻ mô hình đầy đủ yêu cầu phiên bản comfyui-frontend thấp hơn v1.50.5 (node Custom Combo trong subgraph sẽ bị hỏng trên frontend mới), những người cài frontend mới cần phải quay về phiên bản cũ
- Ví dụ có thể xem chỉ gồm 1 ảnh chụp màn hình (ngoài ra 1 cái bị ẩn), không có ví dụ video, nên không thể đánh giá hiệu quả vẽ lại
- Phụ thuộc vào nhiều node, tính năng tăng cường nhắc lệnh LLM còn cần cấu hình thêm LLM; đây là JSON workflow, không phải trọng số mới
【B】MiniMax H3 Fused Turbo: ba workflow khởi đầu (văn bản, hình ảnh, tham khảo) · v1
Workflow · Mô hình mới · Tác giả Stable_Yogi · Phát hành 11-21 01:50 · Lượt tải 57
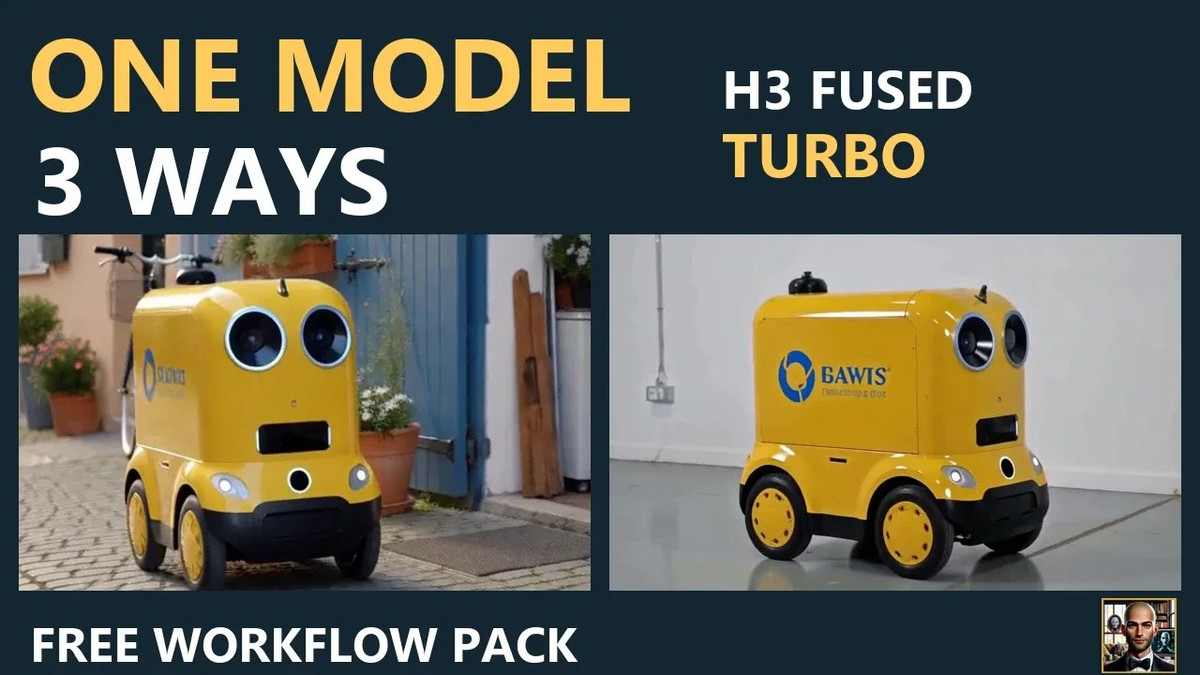
Gói workflow khởi đầu do Stable_Yogi tạo ra cho mô hình tăng tốc hợp nhất của bên thứ ba MiniMax H3 Fused Turbo: ba cách bắt đầu gồm văn bản sang video, hình ảnh sang video (dùng ảnh của bạn làm khung hình đầu tiên), và tham khảo sang video (dùng ảnh làm tham khảo để quay một cảnh khác).
Hình ảnh minh họa
Lý do khuyến nghị
- Cùng tác giả đã phát hành đồng thời 4 workflow H3 trong ngày hôm đó, đây là gói khởi đầu: một mô hình, ba cách bắt đầu, tổng cộng 4 ảnh đã được kiểm thử (kèm theo một phiên bản 8 bước để so sánh), có ảnh ví dụ và tệp QUICKSTART.md
- Ít phụ thuộc: chỉ sử dụng các node MiniMax H3 cốt lõi của ComfyUI; trong gói nén còn có phiên bản .api.json để gọi qua API
- Kèm theo video hướng dẫn trên YouTube của tác giả, miễn phí
Cách sử dụng
- Tải xuống tệp minimax-h3-fused-turbo-int8-convrot của MATLOWAI từ Hugging Face và đặt vào thư mục models/diffusion_models, sau đó tải bộ mã hóa văn bản cùng VAE video và âm thanh từ Comfy-Org/MiniMax-H3
- Sau khi giải nén, kéo một tệp .json vào ComfyUI, chọn các tệp mô hình trong trình tải, giữ nguyên loại trình tải CLIP là minimax; khi kiểm thử, chỉ chạy từng ảnh một lần
- Số bước mặc định của Fused Turbo không được tác giả ghi trên thẻ mô hình, hãy xem giá trị mặc định trong workflow hoặc so sánh với phiên bản 8 bước
Rủi ro và hạn chế
- Fused Turbo là mô hình hợp nhất của bên thứ ba, không phải trọng số chính thức, tác giả không giải thích sự khác biệt về chất lượng hình ảnh so với LoRA tăng tốc chính thức
- Ví dụ chỉ có 3 ảnh, không có video
- Tác giả tuyên bố đã kiểm thử trên ComfyUI 0.32; giấy phép chỉ cho phép sử dụng nội dung được tạo ra, không cho phép phân phối phiên bản chỉnh sửa; hướng dẫn chi tiết nằm trên cổng thông tin bên ngoài trang web của tác giả
【B】MiniMax H3 Second Pass: workflow sửa chữa chuyển động · v1.0
Workflow · Mô hình mới · Tác giả Stable_Yogi · Phát hành 11-21 01:50 · Lượt tải 79
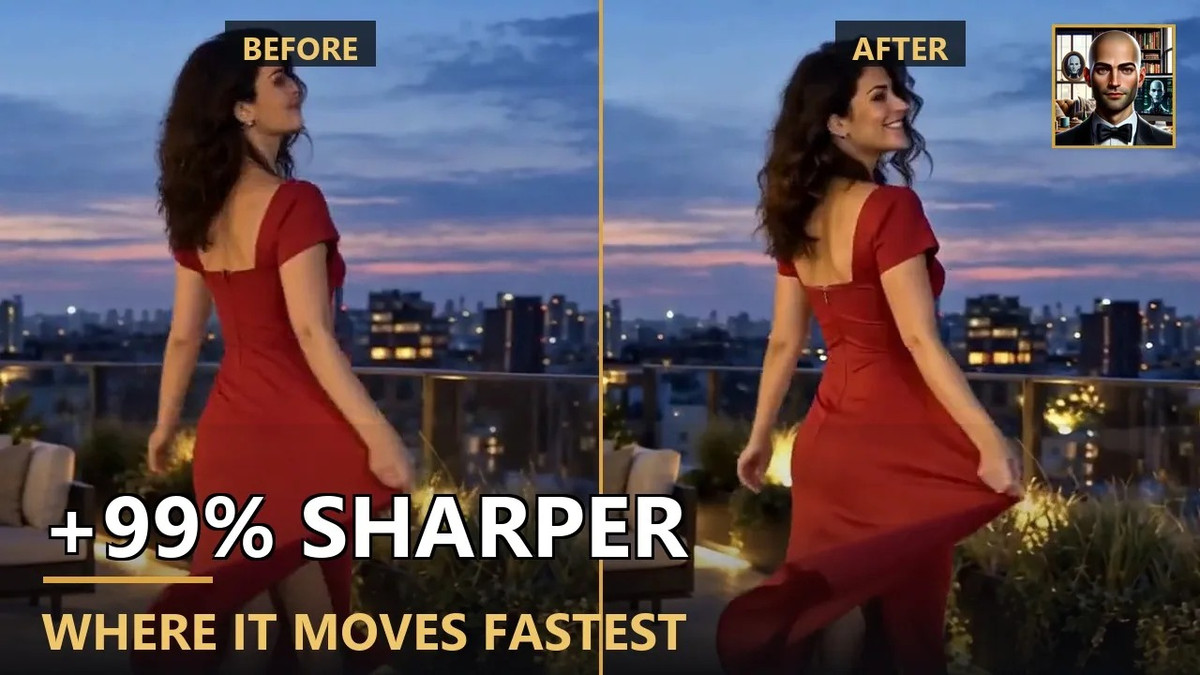
Một workflow video sang video, đưa các đoạn H3 đã được tạo ra quay lại mô hình để chạy lần thứ hai, sửa chữa chuyển động và độ rõ nét, đồng thời lưu cả bản gốc và kết quả lần hai để dễ dàng so sánh.
Phù hợp để thử nghiệm với những đoạn phim có chuyển động mờ nhòe của riêng bạn: bản thân workflow sẽ lưu song song hai phiên bản.
Hình ảnh minh họa
Lý do khuyến nghị
- Xử lý hậu kỳ cho các đoạn video H3: Tác giả cho biết sau lần xử lý thứ hai, mọi phần của hình ảnh đều rõ nét hơn, với phần chuyển động nhanh nhất được cải thiện 99% (đo trên toàn bộ 124 khung hình, tác giả không nêu rõ chỉ số cụ thể)
- Xuất ra hai đoạn video cùng lúc (kết xuất thường + lần xử lý thứ hai) để so sánh trực tiếp trước và sau
- Khác với gói nhập môn của cùng tác giả, gói này sử dụng mô hình cơ sở FL2VA pruned int8 chính thức cộng với bộ thích ứng LightX2V 4 bước; tệp nén kèm theo hình ảnh mẫu, miễn phí
Cách sử dụng
- Cài đặt ComfyUI-MAINodes phiên bản v1.1.3 trở lên (thông qua Manager hoặc git clone)
- Mô hình: minimax_h3_fl2va_pruned_int8_convrot (19.5 GB), bộ mã hóa văn bản qwen3vl_32b_minimax_h3_nvfp4_awq (14.6 GB), minimax_h3_video_vae_fp16 (4.9 GB), VAE âm thanh (nếu thiếu sẽ không có tiếng), cùng với bộ thích ứng LightX2V 4 bước đặt trong thư mục models/loras
- Sau khi giải nén, hãy đặt các hình ảnh mẫu vào ComfyUI/input, kiểm tra đường dẫn của 5 trình tải mô hình, chạy một lần và so sánh hai đoạn video đầu ra; tác giả không cung cấp các tham số như cường độ khử nhiễu cho lần xử lý thứ hai
Rủi ro và hạn chế
- Phương pháp đo lường "cải thiện 99%" không được công khai, chỉ có thể coi là tuyên bố của tác giả
- Chỉ có 1 hình ảnh mẫu hiển thị, không có video so sánh trước và sau
- Bộ thích ứng LightX2V 4 bước không cung cấp tên tệp cụ thể và liên kết; giấy phép chỉ cho phép sử dụng nội dung được tạo ra
【B】MiniMax H3 Location Sheet: cùng một căn phòng trong mọi cảnh quay · v1.0
Quy trình làm việc · Mô hình mới · Tác giả Stable_Yogi · Phát hành 11-21 01:50 · Lượt tải 75
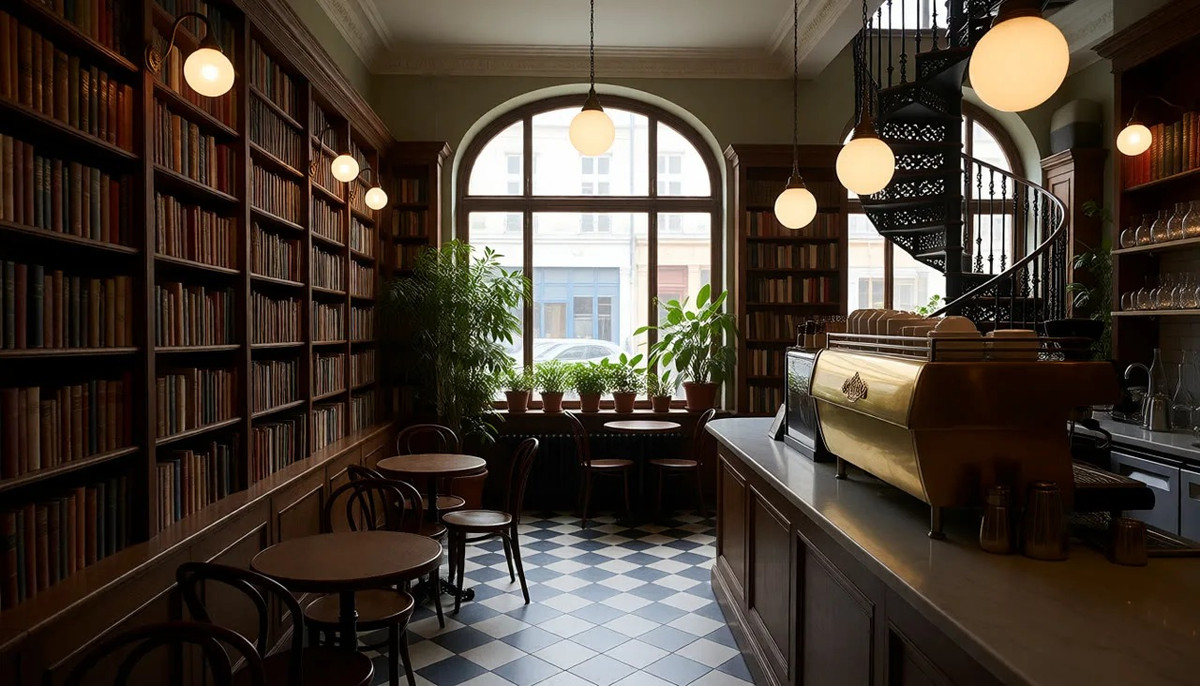
Quy trình làm việc ba giai đoạn giúp duy trì sự nhất quán của cùng một căn phòng qua các góc máy khác nhau: Krea 2 tạo ra căn phòng trống, FLUX.2 Klein 9B tạo ra ba góc nhìn khác nhau của cùng căn phòng đó, sau đó chuyển sang H3 để tham khảo và tạo ra cảnh quay dài 5 giây có âm thanh.
Hình ảnh minh họa
Lý do đề xuất
- Phục vụ tính nhất quán của bối cảnh: Trong các phim ngắn nhiều cảnh, bố cục căn phòng dễ bị thay đổi khi đổi góc máy; ở đây, trước tiên tạo một "bảng thiết lập bối cảnh" (một góc nhìn chính + ba góc nhìn mới) rồi cung cấp cho H3 làm tài liệu tham khảo, tác giả cho biết căn phòng có thể được duy trì khi xoay camera
- Ba nhóm nút được sắp xếp từ trái sang phải, chỉ sử dụng các nút cốt lõi; trong số 4 quy trình làm việc của cùng tác giả trong ngày hôm đó, đây là quy trình duy nhất cần kết nối ba dòng mô hình
- Kèm theo video giải thích trên YouTube của tác giả, miễn phí
Cách sử dụng
- Mô hình: một mô hình Krea 2 (tác giả sử dụng Muse Krea2 V3.5 của riêng mình) cùng bộ mã hóa văn bản và VAE của nó; FLUX.2 Klein 9B cùng bộ mã hóa văn bản và VAE của nó; MiniMax H3 Fused Turbo cùng bộ mã hóa văn bản và VAE của H3
- Trước tiên hãy chạy nguyên trạng để xem căn phòng mẫu; khi thay đổi sang bối cảnh của bạn, hãy sửa lời nhắc trong Group 1 trước, mô tả rõ từng vật thể lớn và vị trí của chúng, đồng thời thêm "Empty, no people."
- Sửa ba lời nhắc góc nhìn trong Group 2 thành căn phòng của bạn và yêu cầu thay đổi góc độ lớn; trong lời nhắc camera, hãy giải thích mỗi hình ảnh tương ứng với phần nào của căn phòng, sau đó viết một động tác máy quay và một sự kiện xảy ra
Rủi ro và hạn chế
- Phụ thuộc nặng: Cần tải xuống và nạp đồng thời ba bộ mô hình, tác giả không ghi rõ mức tiêu thụ VRAM và dung lượng ổ cứng
- Chỉ có 3 hình ảnh mẫu, không có video, hiệu quả nhất quán không thể đánh giá từ trang web
- Tệp nén rất nhỏ (chỉ chứa quy trình làm việc), giấy phép chỉ cho phép sử dụng nội dung được tạo ra; hướng dẫn chi tiết nằm trên cổng thông tin bên ngoài của tác giả
【B】The Daily Grind - Minimax H3 Workflow · v1.1
Quy trình làm việc · Cập nhật phiên bản · Tác giả darkroast175696 · Phát hành 11-20 23:00 · Lượt tải 43
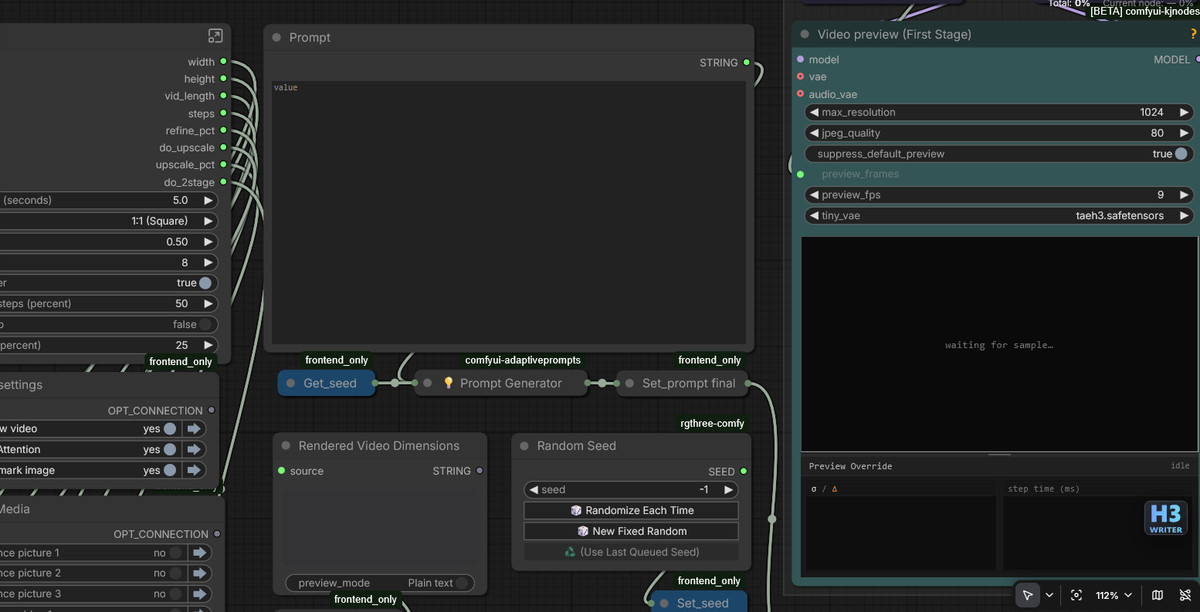
Quy trình làm việc v1.1 kết hợp nhiều tác vụ H3 thường dùng của tác giả (văn bản sang video, tham khảo sang video, v.v.) vào một mẫu duy nhất, hỗ trợ tùy chọn kết xuất hai giai đoạn: nạp riêng biệt LoRA chuyển động và LoRA phong cách/chi tiết ở các giai đoạn khác nhau.
Hình ảnh minh họa
Lý do đề xuất
- Kết xuất hai giai đoạn (tương tự cách tiếp cận hai giai đoạn của Wan 2.2): Tác giả cho biết khi LoRA chuyển động bị mờ ở độ phân giải cao hoặc LoRA phong cách làm hỏng âm thanh, có thể đặt chúng vào các giai đoạn mà chúng phát huy tác dụng; quy trình làm việc kèm theo hướng dẫn công thức cho các kịch bản khác nhau
- Các thiết lập thường dùng được tập trung trong một khu vực màn hình, không cần đi vào đồ thị con để thay đổi tham số; chuyển đổi giữa văn bản sang video / tham khảo sang video không cần đổi mẫu; thông tin tái tạo như seed và lời nhắc dễ dàng truy xuất
- Cập nhật phiên bản: Thay đổi nút hiển thị lời nhắc, văn bản không còn bị mất khi tải từ quy trình làm việc nhúng trong video cũ; các tính năng tùy chọn mặc định tắt để giảm số lượng nút tùy chỉnh bắt buộc cài đặt; bộ nạp LoRA mặc định trống, không còn tự động chọn trước LoRA của tác giả
Cách sử dụng
- Sau khi giải nén, hãy tải quy trình làm việc; các nút màu đỏ hoặc thuộc về nhóm bị tắt bởi công tắc khả dụng, hoặc là các nút bắt buộc phải cài đặt
- Hiện tại, bạn phải bật Video Preview trong bảng thiết lập bên dưới phần cài đặt kích thước / thời lượng trước, nếu không quy trình làm việc sẽ không chạy được (tác giả đã biết vấn đề này và cho biết sẽ sớm khắc phục)
- Tự tải xuống mô hình và LoRA theo danh sách khuyến nghị của tác giả; số bước và cường độ xem hướng dẫn trong quy trình làm việc
Rủi ro và hạn chế
- Thiết lập mặc định có lỗi đã biết, cần bật thủ công Video Preview để chạy
- Chỉ có 4 ảnh chụp màn hình quy trình làm việc, không có ví dụ video
- Tên tệp nén đã được đổi thành h3-daily-driver; đây là JSON của quy trình làm việc, không phải trọng số mới
Chỉ liệt kê (8)
- Ochaco Uraraka Voice (Eng) - My Hero Academia - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA: LoRA H3 chỉ huấn luyện âm thanh (nhân bản giọng nói/âm sắc): Huấn luyện bằng các đoạn lồng tiếng Anh của Ochaco Uraraka trong "My Hero Academia", để nhân vật trong video được tạo ra nói với giọng Anh của cô ấy.
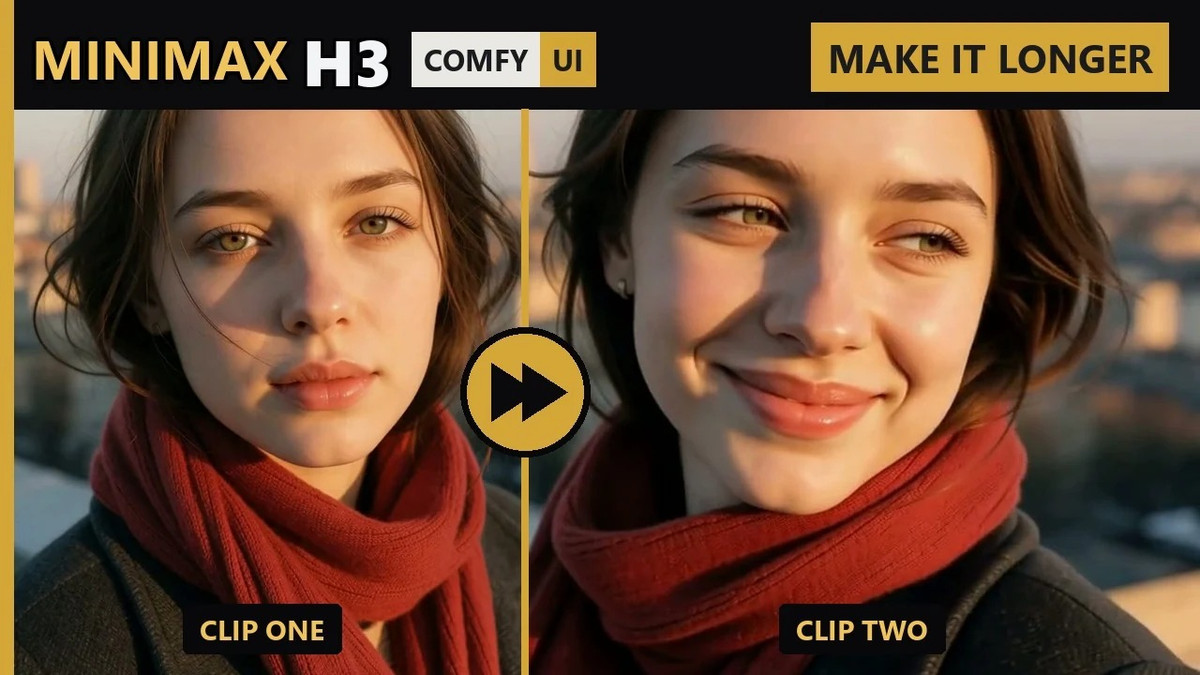
- MiniMax H3 Chain Clips: make it longer than one clip · v1.1 — Quy trình làm việc: Quy trình làm việc cơ bản để nối tiếp, sử dụng khung hình cuối cùng của đoạn video H3 đầu tiên để tạo ra đoạn thứ hai, sau đó ghép cả hai phần hình ảnh và âm thanh lại với nhau.
- HyperFlow H3 Flash — Fast Video with Sound in 4–8 Steps (ComfyUI) · v1.1 — Quy trình làm việc: Phiên bản dùng thử miễn phí v1.1 của gói quy trình làm việc trả phí HyperFlow H3 Flash:预设 nhanh cho văn bản sang video dành cho mô hình H3 đã nén, tạo ra các đoạn phim ngắn có âm thanh nổi trong 4 bước.
- Maelle Voice (Eng) - Clair Obscur: Expedition 33 - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA: LoRA H3 chỉ huấn luyện âm thanh (nhân bản giọng nói/âm sắc): Huấn luyện bằng các đoạn lồng tiếng Anh của Maelle trong "Clair Obscur: Expedition 33", để cung cấp giọng nói của cô ấy cho nhân vật trong video được tạo ra.
- FastH3 Omni Lip-Sync — Portrait + Voice Line to Talking Video (ComfyUI) · v1.1 — Quy trình làm việc: Phiên bản dùng thử miễn phí v1.1 của gói quy trình làm việc trả phí FastH3 Omni Lip-Sync: Nhập một ảnh chân dung và một đoạn thoại, tạo ra video đầu người đang nói khớp khẩu hình trong 5 giây.
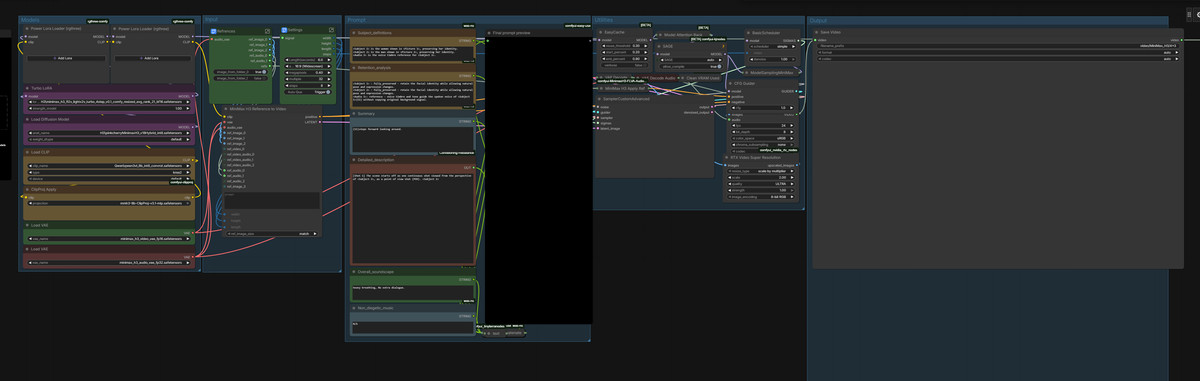
- MiniMax H3 Split Prompts · v1.0 — Quy trình làm việc: Hai quy trình làm việc chia lời nhắc H3 thành nhiều ô nhập riêng biệt để dễ dàng chỉnh sửa theo đoạn: Ref2V (tham khảo sang video) v1.0 và FL2V (khung đầu/cuối) v1.1.
- Zelda Voice (Eng) - Breath of the Wild/Tears of the Kingdom - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA: LoRA H3 chỉ huấn luyện âm thanh (nhân bản giọng nói/âm sắc): Huấn luyện bằng các đoạn lồng tiếng Anh của Zelda trong "The Legend of Zelda: Breath of the Wild / Tears of the Kingdom".
- Gonzo Muppet · v1.0 — LoRA: LoRA H3 cho nhân vật Gonzo trong The Muppet Show, chia thành hai tệp hình ảnh và âm thanh, thẻ mô hình chỉ có tên.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ thu thập từ 11-20 20:31 → 11-21 09:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải chỉ phản ánh mức độ quan tâm.