貞貞のAIレーダー · MiniMax H3 · 2026-11-21 モーニングレポート
今号の 14 個の新バージョン:強く推奨 0 · 推奨 1 · 注目 5 · 収録のみ 8
編集者によるコメント 今号では 14 個の H3 新バージョンをレビューし、A評価が 1 個、B評価が 5 個、C評価が 8 個で、除外はありません。注目作は Story Creator です:フォーマットに沿って作成した絵コンテスクリプトから、一度の処理で完全なストーリー動画を出力します。Qwen Image 2.1 で静止画を生成し、H3 でセリフ付きのショットをシーンごとに生成、YuE2 で音楽を付与し、コアノードのみを使用しています。Simply Advanced v1.7 では動画の部分再描画(インペインティング)が追加されましたが、スクリーンショットの例しかないため B評価に下げました。Stable_Yogi の同梱 4 個のワークフロー、3 個の英語音声クローン LoRA、および有料パッケージ2種の無料トライアル版は B / C評価として記載しています。
推奨(1)
【A】Story Creator 12GB — スクリプトから完全なストーリー動画へ:Qwen Image 2.1 の静止画 + MiniMax H3 の音声付きシーン + YuE2 の音楽 · v1.4.0
ワークフロー · 新モデル · 作者 The_frizzy1 · 公開 11-21 01:00 · ダウンロード数 19
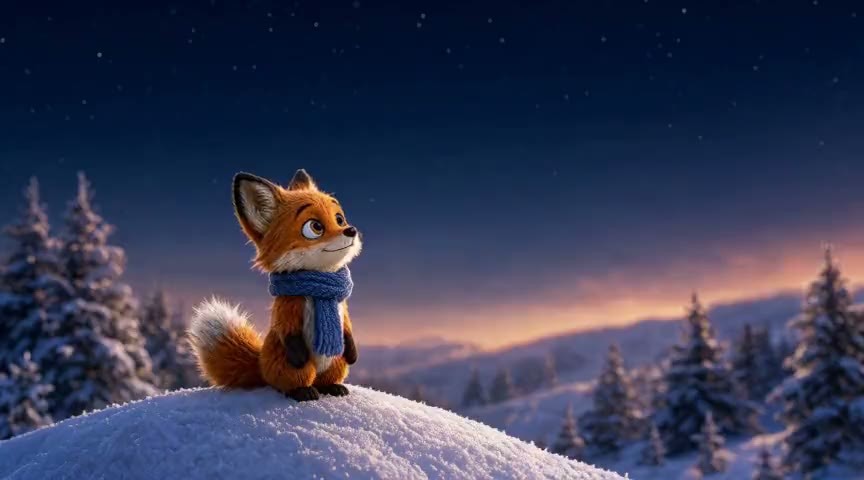
絵コンテスクリプトから直接完全なストーリー動画を出力する ComfyUI ワークフローです。Qwen Image 2.1 Turbo で各シーンの静止画を生成し、MiniMax H3 がその静止画をセリフと効果音付きのショットに変換、YuE2 が音楽を生成し、さらに統一されたナレーションボイスを追加します。
障壁はVRAMではなく時間です:まず同梱の短いスクリプトで1〜2シーンを実行し、主人公の一貫性とセリフの口元が確認できてから、全体を実行してください。
画像
推奨理由
- 「長編AIストーリー動画」向け:フォーマットに沿ったスクリプトを入力すると、同一の主人公が各シーンに登場し、動きがあり、キャラクターが話し、ナレーションと音楽が付いた完成版を出力します。動画部分はすべて H3 で処理されるため、このセクションで通常通り収録しています(同じ項目は Qwen 2.1 セクションにも掲載されています)
- 主人公の一貫性確保の方法:Qwen Image 2.1 でまずキャラクター画像を1枚生成し、各シーンの静止画はその編集として作成します。H3 は FL2VA ベースモデルに 8 ステップの turbo LoRA を適用してシーンごとに生成し、長さはセリフの量に応じて自動決定されます。ナレーションは H3 を別途実行して音声のみを取得し、全編で同じナレーションボイスを保証します
- ComfyUI のコアノードのみ使用(Start Loop / End Loop ループ)、カスタムノードのインストール不要。作者によれば RTX 3060 12 GB + 32 GB メモリで動作確認済みで、9 個のモデルファイルのダウンロード先と保存ディレクトリが個別にリストされています
- 作者は機能しない点も明記しています:内蔵の 8B テキストエンコーダーによる自動絵コンテ作成は効果が低く、デフォルトで無効化されています。一貫性が保てるのは主人公のみで、脇役は各セリフごとに完全な外見記述が必要です
- 2 本の動画 + 6 枚の画像サンプルが確認可能で、ワークフロー自体は MIT ライセンスです
使い方
- ComfyUI バージョン 0.39 以上。モデルカードに従い Qwen Image 2.1 の3ファイル(Turbo int8、Qwen3-VL 8B テキストエンコーダー、VAE)、H3 の5ファイル(fl2va pruned int8 ベースモデル、fl2v turbo 8step LoRA、Qwen3-VL 32B テキストエンコーダー、動画VAE、音声VAE)、および YuE2 の1ファイルをダウンロードしてください
- スクリプト形式:最初の行 WORLD: で全体の画風を指定。各行は [カメラ位置/動き] を最初に書き、次に画面内容(場所、各キャラクターの完全な外見、動作)を記述します。|| の後はナレーション、|| 名前: の後はそのキャラクターが画面内で話すセリフです。[continue] は次のシーンへのハードカットではなく、前のシーンの終わりから連続して接続するために使用します
- 各シーンの長さは 3〜9 秒の間で自動決定されます。作者はワークフロー内蔵の自動作成機能を使わず、同梱の HOW_TO_WRITE_A_SCRIPT.md に従ってLLMチャットツールでスクリプトを作成することを推奨しています
- 完全なワークフローは作者の GitHub と Hugging Face ミラーでも入手可能です
リスクと制限
- 作者は v1.4.0 には更新説明がなく、変更点が不明確だと明記しています。ページ上の処理時間データは v1.0 と v1.2 のものです
- 非常に遅い:作者が示す処理時間は、1 分の完成動画で約 43 分、3 分で約 2 時間、5 分(58 シーン)で約 3 時間 35 分かかります。5 分のストーリーには一晩かかる場合があります
- 30 シーンを超えると、半分に分けて実行し、編集ソフトで結合する必要があります(シーンごとにメモリが約 0.6 GB 増加)。各シーンの音声は個別に生成されるため、音量の不一致はポストプロダクションで統一する必要があります
- オーバー・ザ・ショルダーショットやフレームで切れたキャラクターでエラーが発生しやすいです(主人公が2回表示される、2人のキャラクターが融合するなど)
- ライセンスの競合:ワークフローは MIT ですが、Qwen Image 2.1(Qwen Research Licence)と YuE2(CC-BY-NC-4.0)は非商用であり、H3 には別のコミュニティライセンスがあります。Civitai ページでチェックされている商用利用可は、これらのモデルのライセンスを上書きできません
- データではベースモデルが Other と表記されています。モデルファイルの合計サイズは数十 GB に達し、一部のサンプルは非表示です(5 個)
注目(5)
【B】Simply Advanced - MiniMax H3 · v1.7
ワークフロー · バージョン更新 · 作者 altoiddealer · 公開 11-21 05:47 · ダウンロード数 29
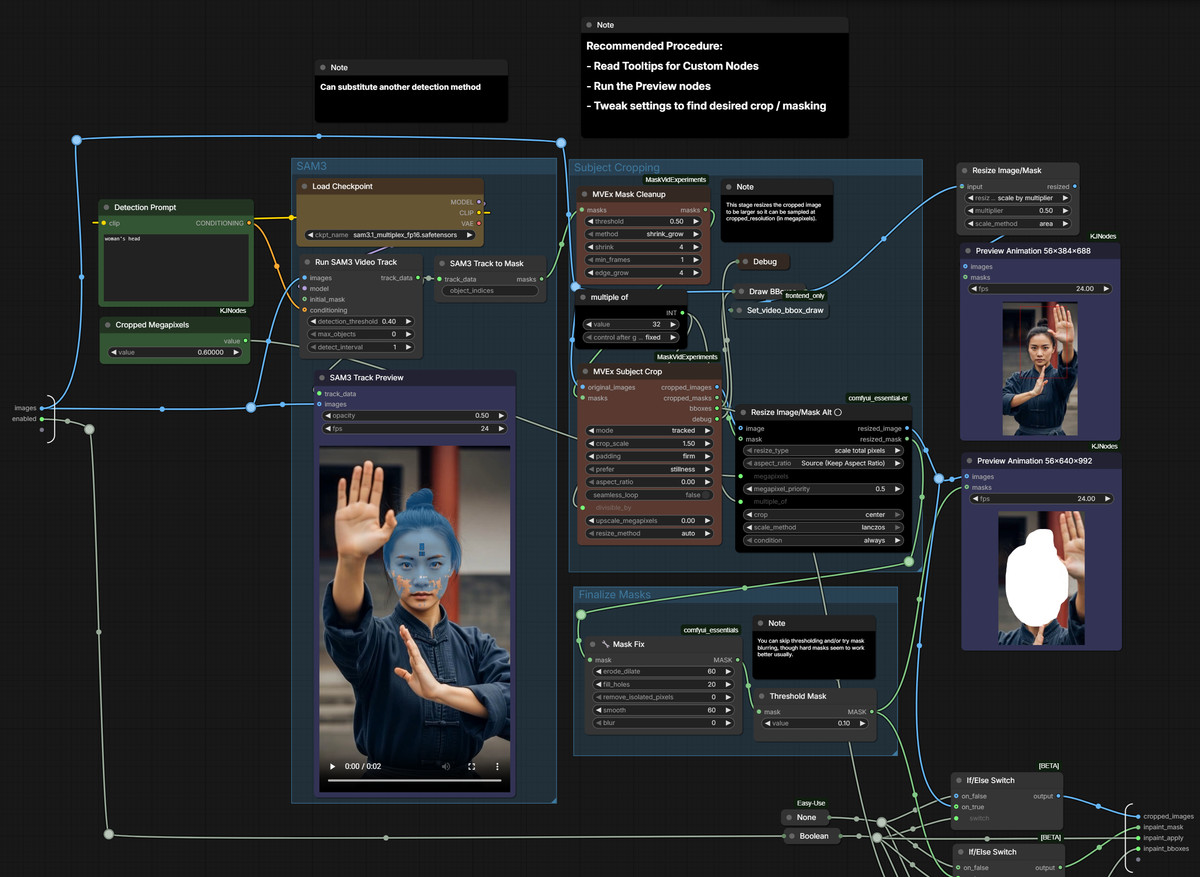
複数入力統合型 H3 ワークフロー Simply Advanced の v1.7 です。動画の部分再描画(インペインティング)スイッチが追加され、元の動画内でトラッキング/マスクされた領域のみを再生成します。
このワークフローを既に使用している場合、このバージョンでは主に部分再描画機能が追加されました。初心者はまず LLM 強化と再描画をオフにし、リファレンス/ガイド機能のみを使用してください。(編集者による B評価への格下げ理由:本バージョンの新機能には 1 枚のスクリーンショットしかなく、再描画効果を判断できる動画サンプルがありません。)
画像
推奨理由
- バージョン更新:v1.7 で Video Inpainting が追加されました。入力された Video 1 でスイッチをオンにし、簡単な設定を行うだけで、トラッキングマスクされた領域のみを再描画できます。トリミング、マスク作成、貼り戻しの3ステップは MaskVidExperiments ノードが処理します
- ツール自体:最大 6 枚の画像、2 本の動画、3 本の音声を入力可能で、それぞれをリファレンス(reference)、ガイド(guide)、またはその両方に設定できます。潜在空間アップスケール / 2段階生成と段階的 LoRA 管理機能を備えています
- シームレスな延長:入力動画の末尾から続きを生成(Continuation)、入力動画の先頭に生成して接続(Convergence)、またはその組み合わせで2本の動画の間を補完できます
- 作者の 4 ステップ Ref2VA プロンプトパイプライン(拡張 → リファレンス分析 → クリエイティブブループリント → H3 プロンプト構造へのコンパイル)と 1 ステップ FL2VA プロンプト強化が内蔵されており、モードは Image 1 / Image 2 に画像があるかどうかで自動判断されます
- モデルの累計ダウンロード数は 1281 回で、無料です
使い方
- 必須ノード:ComfyUI-Easy-Use、ComfyUI-KJNodes、作者の comfyui_essential-er。本バージョンの動画部分再描画を使用するには、MaskVidExperiments もインストールしてください
- オプションノード:VideoHelperSuite の Load Video、MiniMax H3 RefMods、Spectrum 高速化ノードなど
- simply-advanced_minimax_h3_v1.7.json を読み込み、Video 1 で Inpainting スイッチをオンにしてマスクトラッキングを設定します。ステップ数、強度などのサンプリングパラメータはワークフロー内のデフォルト値を確認してください(作者はモデルカードに記載していません)
リスクと制限
- 完全なモデルカードでは comfyui-frontend のバージョンが v1.50.5 未満であることが要求されています(サブグラフ内の Custom Combo ノードは新しいフロントエンドで動作不良を起こすため)、新しいフロントエンドをインストールしているユーザーはロールバックが必要です
- 確認できるサンプルは 1 枚のスクリーンショットのみです(さらに 1 個が非表示)。動画サンプルがなく、再描画効果を判断できません
- 依存ノードが多く、LLM プロンプト強化には別途 LLM の設定が必要です。ワークフロー JSON であり、新しい重みファイルではありません
【B】MiniMax H3 Fused Turbo: 3つのスターターワークフロー(テキスト、画像、リファレンス) · v1
ワークフロー · 新モデル · 作者 Stable_Yogi · 公開 11-21 01:50 · ダウンロード数 57
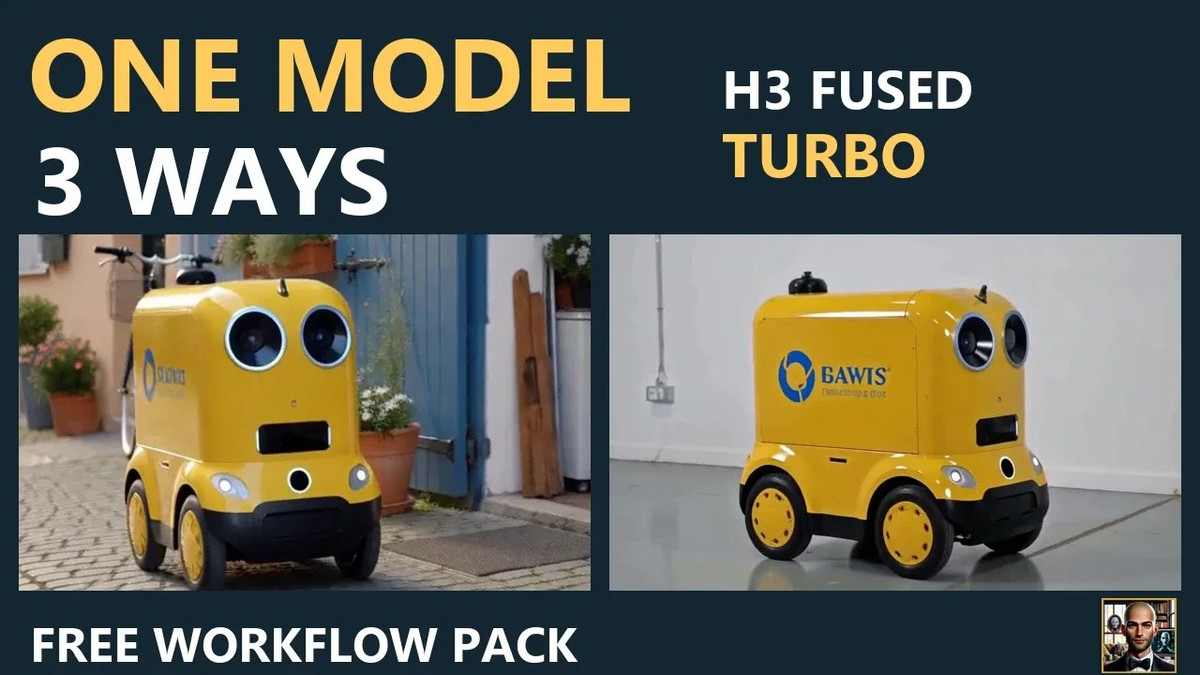
Stable_Yogi がサードパーティ製融合高速化モデル MiniMax H3 Fused Turbo 向けに作成した入門ワークフローパッケージです。テキストから動画、画像から動画(あなたの画像を最初のフレームとして使用)、リファレンスから動画(画像をリファレンスとして別のショットを撮影)の3つの開始方法を提供します。
画像
推奨理由
- 同作者は同日に 4 個の H3 ワークフローを公開しました。これはその入門パッケージです:1つのモデルで3つの開始方法、テスト済みの画像計 4 枚(比較用に 8 ステップ版も付属)、サンプル画像と QUICKSTART.md を同梱
- 依存関係が少ない:ComfyUI コアの MiniMax H3 ノードのみを使用。圧縮ファイルには API 呼び出し用の .api.json バージョンも含まれています
- 作者の YouTube 解説動画が付属しており、無料です
使い方
- Hugging Face から MATLOWAI の minimax-h3-fused-turbo-int8-convrot を models/diffusion_models にダウンロードし、Comfy-Org/MiniMax-H3 からテキストエンコーダーと動画・音声 VAE をダウンロードしてください
- 解凍後、.json ファイルを ComfyUI にドラッグ&ドロップし、ローダーでモデルファイルを選択します。CLIP ローダーのタイプは minimax のままにしてください。テスト時は一度に1つの画像のみを実行してください
- Fused Turbo のデフォルトステップ数は作者がモデルカードに記載していないため、ワークフロー内のデフォルト値を確認するか、8 ステップ版と比較してください
リスクと制限
- Fused Turbo はサードパーティ製の融合モデルであり、公式の重みではありません。画質と公式高速化 LoRA の違いについて作者は説明していません
- サンプルは 3 枚の画像のみで、動画はありません
- 作者は ComfyUI 0.32 でテストしたと述べています。ライセンスは生成コンテンツの使用のみを許可し、修正版の配布は許可されていません。詳細なチュートリアルは作者の外部ポータルにあります
【B】MiniMax H3 Second Pass: 動作修復ワークフロー · v1.0
ワークフロー · 新モデル · 作者 Stable_Yogi · 公開 11-21 01:50 · ダウンロード数 79
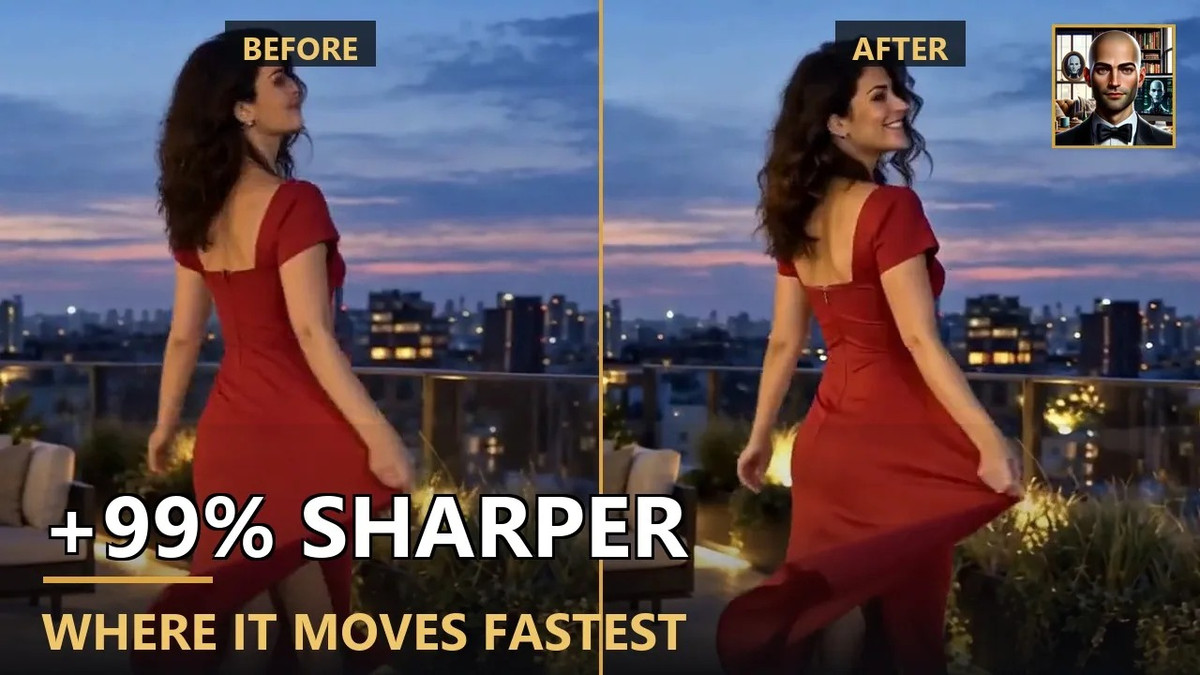
既に生成された H3 クリップをモデルに戻して2回目の処理を行い、動作と鮮明度を修復する動画から動画へのワークフローです。元の動画と2回目の結果を同時に保存し、比較しやすくします。
自分で作成した動作がぼやけた動画を試すのに適しています:ワークフロー自体が2つのバージョンを並べて保存するためです。
画像
推奨理由
- H3 動画の後処理サービス:著者によると、2回目の処理後は画面の各部分がより鮮明になり、動きが最も速い部分では 99% の向上が確認された(全 124 フレームで測定、具体的な指標は著者により不明)
- 1回の処理で2本の動画(通常レンダリング + 2回目処理)を出力し、直接前後比較が可能
- 同著者の入門パッケージとは異なり、こちらは公式の FL2VA pruned int8 ベースモデルと LightX2V 4 ステップアダプターを使用。圧縮ファイルにはサンプル画像が含まれており、無料
使い方
- ComfyUI-MAINodes v1.1.3 以上をインストール(Manager または git clone)
- モデル:minimax_h3_fl2va_pruned_int8_convrot(19.5 GB)、qwen3vl_32b_minimax_h3_nvfp4_awq テキストエンコーダー(14.6 GB)、minimax_h3_video_vae_fp16(4.9 GB)、音声 VAE(欠如時は音声なし)、さらに LightX2V 4 ステップアダプターを models/loras に配置
- 解凍後、サンプル画像を ComfyUI/input に置き、5 個のローダーパスを確認して1回実行し、出力された2本の動画を比較。2回目処理のノイズ除去強度などのパラメータは著者により提供されていない
リスクと制限
- 「99% の向上」の測定方法は公開されておらず、著者の主張として受け取るしかない
- 公開されているサンプルは 1 枚の画像のみで、前後比較動画はない
- LightX2V 4 ステップアダプターの具体的なファイル名やリンクは提供されていない。ライセンスは生成コンテンツの使用のみを許可
【B】MiniMax H3 ロケーションシート:全ショットで同じ部屋 · v1.0
ワークフロー · 新モデル · 著者 Stable_Yogi · 公開 11-21 01:50 · ダウンロード 75
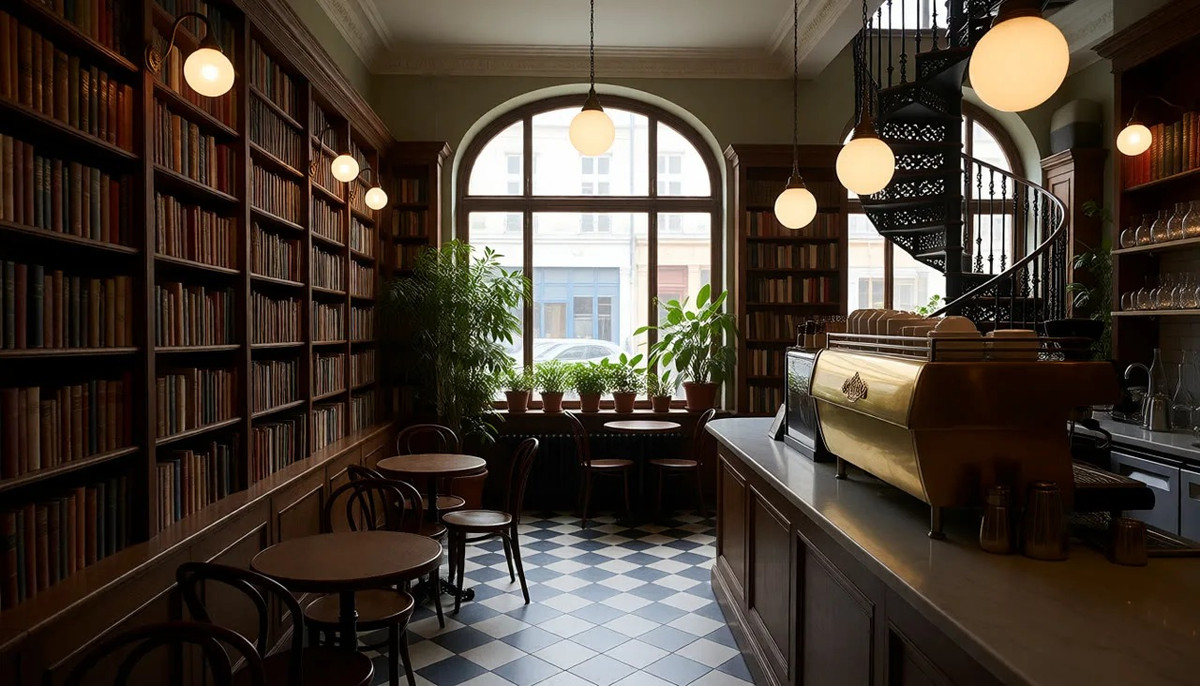
異なるカメラアングルのショット間で同じ部屋の整合性を保つための3段階ワークフロー:Krea 2 で空の部屋を生成し、FLUX.2 Klein 9B で同じ部屋の他の3つの視点の画像を生成、その後 H3 に渡して音声付きの 5 秒のショットを参照生成する。
画像
推奨理由
- シーン整合性への貢献:マルチショットの短編動画ではカメラアングル変更時に部屋のレイアウトが崩れやすいが、ここではまず「シーン設定シート」(1つの主視点 + 3つの新視点)を作成し、それを H3 の参照として使用することで、著者によるとカメラ回転時でも部屋を維持できる
- 3つのノードグループが左から右へ並び、コアノードのみを使用。同著者が同日公開した 4 個のワークフローの中で、3つのモデルファミリーを直列に接続する唯一のもの
- 著者の YouTube 解説動画が付属しており、無料
使い方
- モデル:Krea 2 モデル1つ(著者は自身の Muse Krea2 V3.5 を使用)とそのテキストエンコーダーおよび VAE;FLUX.2 Klein 9B とそのテキストエンコーダーおよび VAE;MiniMax H3 Fused Turbo と H3 テキストエンコーダーおよび VAE
- まずそのまま実行してサンプルの部屋を確認。自身のシーンに変更する際は、まず Group 1 のプロンプトを修正し、大きなオブジェクトとその位置を明確に記述し、"Empty, no people." を追加する
- Group 2 の3つの視点プロンプトを自身の部屋に変更し、大きな角度の変化を要求。カメラプロンプトでは各画像が部屋のどの部分に対応するかを説明し、カメラワークと発生する事象を1つ記述する
リスクと制限
- 依存関係が重い:3セットのモデルを同時にダウンロードおよびロードする必要があり、VRAM とディスク使用量については著者により記載されていない
- サンプルは 3 枚の画像のみで動画はなく、整合性の効果はページからは判断できない
- 圧縮ファイルは小さい(ワークフローのみ)。ライセンスは生成コンテンツの使用のみを許可。詳細なチュートリアルは著者の外部ポータルにある
【B】The Daily Grind - Minimax H3 ワークフロー · v1.1
ワークフロー · バージョン更新 · 著者 darkroast175696 · 公開 11-20 23:00 · ダウンロード 43
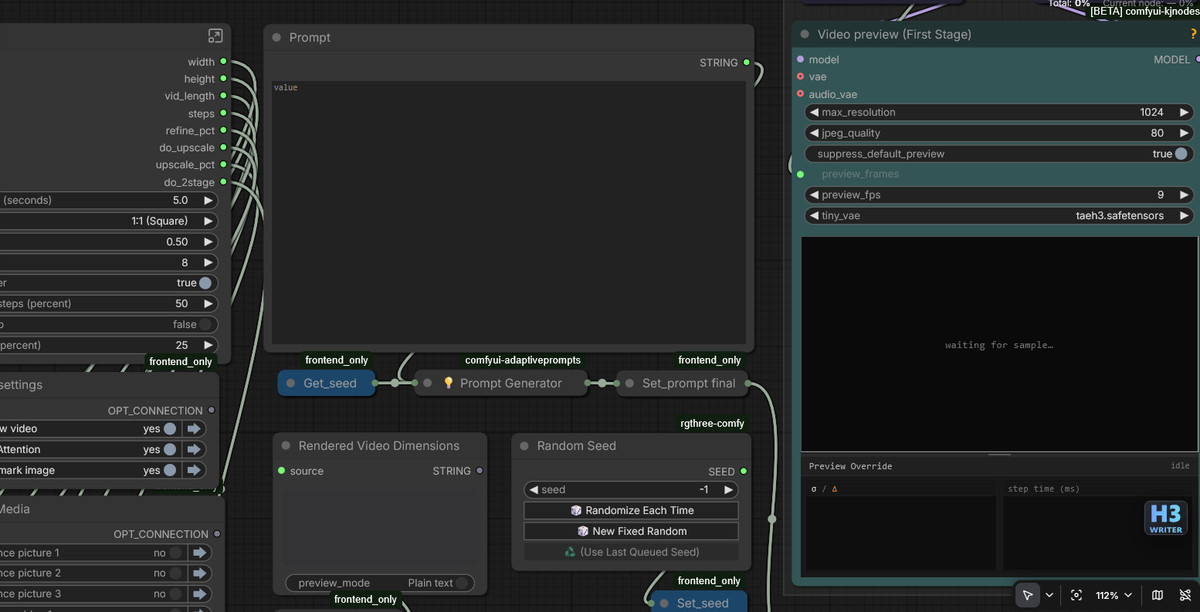
著者がよく使用する複数の H3 タスク(テキストから動画、参照から動画など)を1つのテンプレートに統合したワークフロー v1.1。2段階レンダリングを選択可能:異なる段階でアクション LoRA とスタイル/ディテール LoRA をそれぞれロードする。
画像
推奨理由
- 2段階レンダリング(Wan 2.2 の2段階アプローチに類似):著者によると、アクション LoRA が高分解能でぼやけたり、スタイル LoRA が音声トラックを破損させたりする場合、それらをそれぞれ有効な段階に分離できる。ワークフローには異なるシナリオ向けのレシピ説明が付属
- 一般的な設定が1つの画面領域に集約されており、サブグラフに入ってパラメータを変更する必要がない。テキストから動画 / 参照から動画の切り替えでテンプレートを変更する必要がない。シード、プロンプトなどの再現情報が取得しやすい
- バージョン更新:プロンプト表示ノードを変更し、古い動画に埋め込まれたワークフローから読み込む際にテキストが失われなくなった。オプション機能は必須カスタムノードを減らすためデフォルトで無効。LoRA ローダーはデフォルトでクリアされ、著者自身の LoRA が事前選択されなくなった
使い方
- 解凍後ワークフローを読み込む。赤いノードは、有効なスイッチで無効化されたグループに属するか、インストール必須のノードである
- 現在、サイズ / 長さ設定下の設定パネルで Video Preview を有効にする必要がある。これを行わないとワークフローが実行できない(著者既知の問題で、早急に修正予定と述べている)
- モデルと LoRA は著者の推奨リストに従って各自でダウンロード。ステップ数、強度はワークフロー内の説明を参照
リスクと制限
- デフォルト設定に既知のエラーがあり、Video Preview を手動で有効にしないと実行できない
- ワークフローのスクリーンショットが 4 枚あるだけで、動画サンプルはない
- 圧縮ファイル名は h3-daily-driver に変更済み。ワークフロー JSON であり、新しい重みではない
のみ収録(8)
- Ochaco Uraraka Voice (Eng) - My Hero Academia - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA:音声のみを学習した H3 LoRA(音色/音声クローン):『僕のヒーローアカデミア』麗日お茶子の英語吹き替え音声断片で学習し、生成動画内のキャラクターに彼女の英語声で話させる。
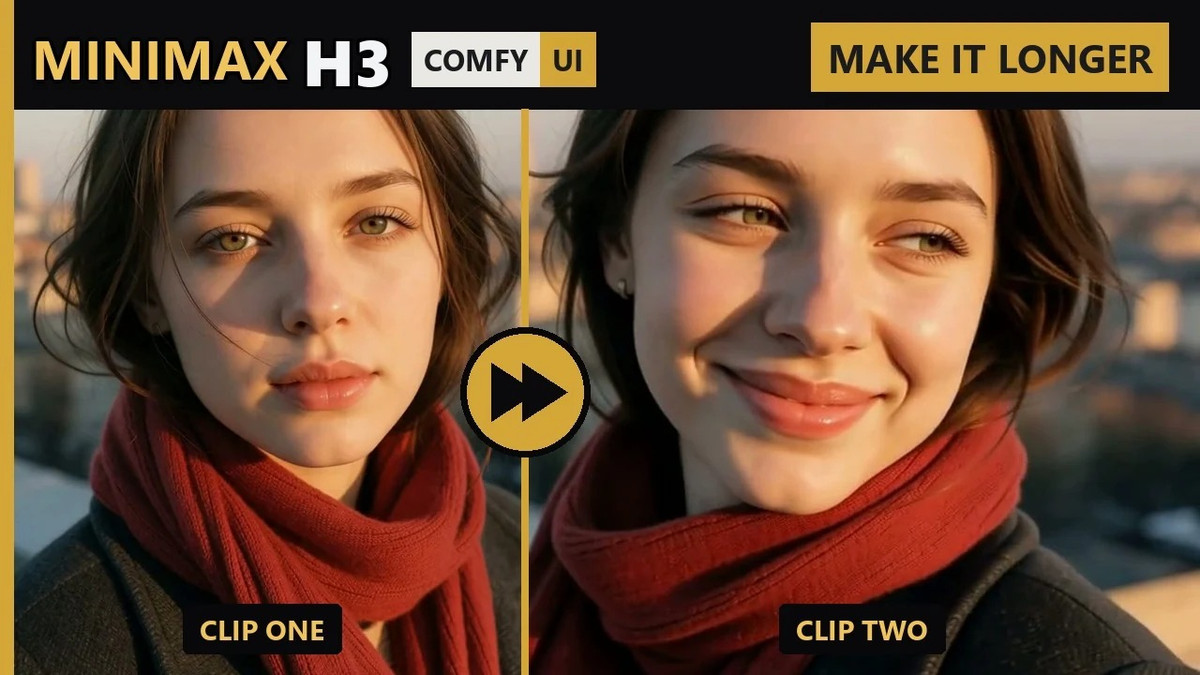
- MiniMax H3 Chain Clips: make it longer than one clip · v1.1 — ワークフロー:最初の H3 クリップの最終フレームから2番目のクリップを生成し、両方の映像と音声を結合する基本的な続き作成ワークフロー。
- HyperFlow H3 Flash — Fast Video with Sound in 4–8 Steps (ComfyUI) · v1.1 — ワークフロー:有料ワークフローパック HyperFlow H3 Flash の無料トライアル版 v1.1:圧縮版 H3 モデル向けのテキストから動画への高速ドラフトプリセットで、4 ステップでステレオ音声トラック付きの短編動画を生成。
- Maelle Voice (Eng) - Clair Obscur: Expedition 33 - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA:音声のみを学習した H3 LoRA(音色/音声クローン):『Clair Obscur: Expedition 33』の Maelle の英語吹き替え音声断片で学習し、生成動画内のキャラクターに彼女の声を割り当てる。
- FastH3 Omni Lip-Sync — Portrait + Voice Line to Talking Video (ComfyUI) · v1.1 — ワークフロー:有料ワークフローパック FastH3 Omni Lip-Sync の無料トライアル版 v1.1:ポートレート画像と音声ラインを入力し、5 秒間のリップシンク付き会話動画(アバター)を生成。
- MiniMax H3 Split Prompts · v1.0 — ワークフロー:H3 プロンプトを複数の別々の入力欄に分割し、セグメントごとの編集を容易にする2つのワークフロー:Ref2V(参照から動画生成)v1.0 と FL2V(最初と最後のフレーム)v1.1。
- Zelda Voice (Eng) - Breath of the Wild/Tears of the Kingdom - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA:音声のみを学習した H3 LoRA(音色/音声クローン):『ゼルダの伝説 ブレス オブ ザ ワイルド / ティアーズ オブ ザ キングダム』のゼルダの英語吹き替え音声断片で学習。
- Gonzo Muppet · v1.0 — LoRA:マペットショーのキャラクター Gonzo の H3 LoRA。映像と音声の2つのファイルで構成され、モデルカードには名前のみが記載されている。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-20 20:31 → 11-21 09:01(北京時間)。推奨理由は編集者による審査済み。ダウンロード数は注目度を示すのみ。