贞贞的AI雷达 · MiniMax H3 · 2026-11-21 晨报
本期 14 个新版本:强烈推荐 0 · 推荐 1 · 可关注 5 · 仅收录 8
编辑按语 本期审阅 14 个 H3 新版本,1 个 A、5 个 B、8 个 C,无排除。首推 Story Creator:按格式写好的分镜脚本一次出整条故事视频,Qwen Image 2.1 出静帧、H3 逐场生成带对白的镜头、YuE2 配乐,只用核心节点。Simply Advanced v1.7 新增视频局部重绘,但只有截图示例,降为 B;Stable_Yogi 同批 4 个工作流、3 个英文声音克隆 LoRA 和两个付费包的免费试用版列 B / C。
推荐(1)
【A】Story Creator 12GB — script to a full story video: Qwen Image 2.1 stills + MiniMax H3 scenes with voices + YuE2 music · v1.4.0
工作流 · 新模型 · 作者 The_frizzy1 · 发布 11-21 01:00 · 下载 19
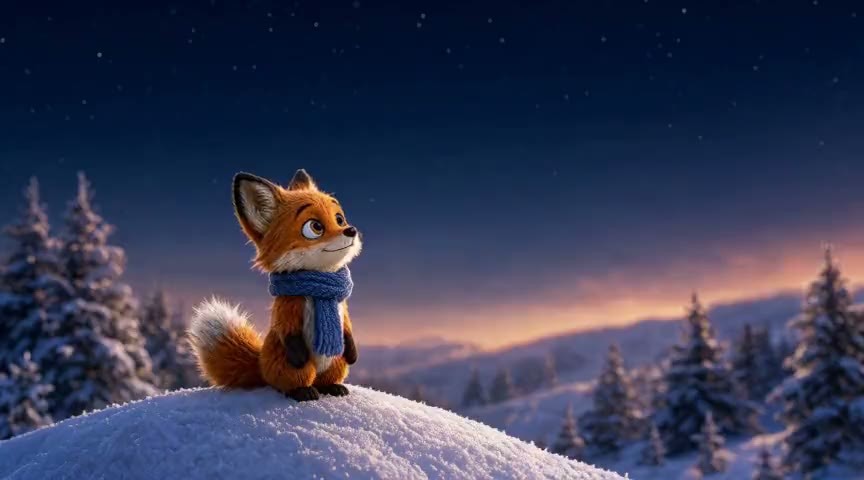
从一份分镜脚本直接出整条故事视频的 ComfyUI 工作流:Qwen Image 2.1 Turbo 出每场静帧,MiniMax H3 把每张静帧变成带对白和音效的镜头,YuE2 生成配乐,再加统一的旁白声线。
门槛在时间而不在显存:先用附带的短脚本跑一两场,确认主角一致和对白口型后再跑整篇。
配图
推荐理由
- 服务“长篇 AI 故事视频”:输入一份按格式写好的脚本,输出同一主角贯穿各场、每场都在动、角色开口说话、有旁白和配乐的成片;视频部分全由 H3 完成,所以在本板块照常收录(同一条也出现在 Qwen 2.1 板块)
- 主角一致的做法:Qwen Image 2.1 先生成一张角色图,每场静帧都是对它的编辑;H3 用 FL2VA 底模加 8 步 turbo LoRA 逐场生成,时长按台词多少自动定;旁白单独跑一遍 H3 只取声音,保证全片同一个旁白声线
- 只用 ComfyUI 核心节点(Start Loop / End Loop 循环),不装自定义节点;作者称在 RTX 3060 12 GB + 32 GB 内存上跑通,9 个模型文件的下载地址和存放目录逐一列出
- 作者把不行的地方也写了:内置的 8B 文本编码器自动写分镜效果差、已默认关闭;只有主角能保持一致,配角要每句都完整描述
- 2 段视频 + 6 张图示例可见,工作流本身 MIT 许可
怎么用
- ComfyUI 0.39 以上;按模型卡下载 Qwen Image 2.1 三个文件(Turbo int8、Qwen3-VL 8B 文本编码器、VAE)、H3 五个文件(fl2va pruned int8 底模、fl2v turbo 8step LoRA、Qwen3-VL 32B 文本编码器、视频 VAE、音频 VAE)和 YuE2 一个文件
- 脚本格式:首行 WORLD: 定整体画风;每行先写 [机位/运镜],再写画面(地点、每个角色的完整外观、动作);|| 后面是画外旁白,|| 名字: 后面是该角色在画面里说的台词;[continue] 让本场结尾接到下一场的画面而不是硬切
- 每场时长自动在 3–9 秒之间;作者建议用大语言模型聊天工具按附带的 HOW_TO_WRITE_A_SCRIPT.md 写脚本,不要用工作流内置的自动写作
- 完整工作流也在作者的 GitHub 和抱脸镜像上
风险与限制
- 作者写明 v1.4.0 没有更新说明、说不清改了什么;页面上的耗时数据来自 v1.0 和 v1.2
- 很慢:作者给的耗时是 1 分钟成片约 43 分钟、3 分钟约 2 小时、5 分钟(58 场)约 3 小时 35 分钟,5 分钟故事要跑一整夜
- 超过约 30 场要分两半跑再在剪辑软件里拼接(每场内存涨约 0.6 GB);每场声音分别生成,响度不一致要后期统一
- 过肩镜头和被画框切掉的角色容易出错(主角出现两次、两个角色粘在一起)
- 许可冲突:工作流是 MIT,但 Qwen Image 2.1(Qwen Research Licence)和 YuE2(CC-BY-NC-4.0)都是非商用,H3 另有社区许可;Civitai 页面勾选的可商用不能覆盖这些模型的许可
- 数据里基模标为 Other;模型文件合计数十 GB,部分示例被隐藏(5 个)
可关注(5)
【B】Simply Advanced - MiniMax H3 · v1.7
工作流 · 版本更新 · 作者 altoiddealer · 发布 11-21 05:47 · 下载 29
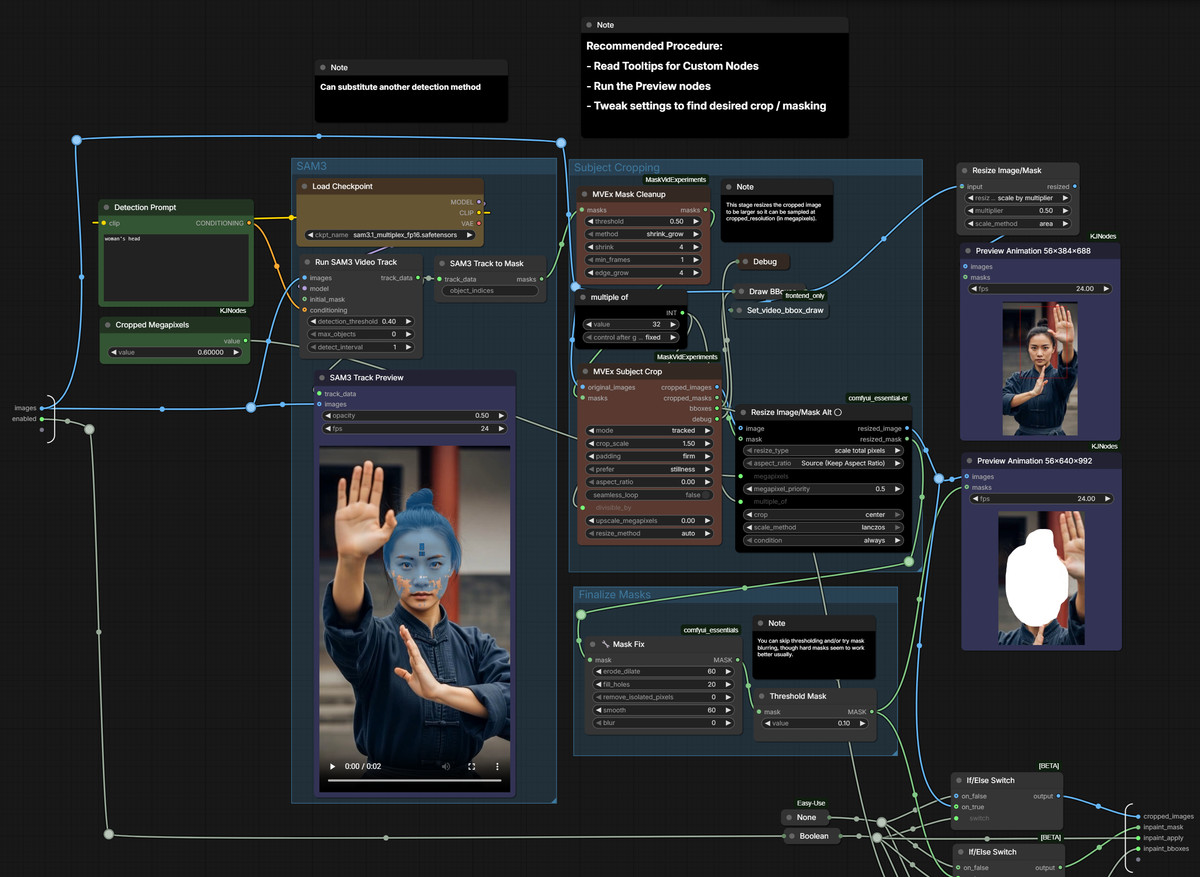
多输入一体化 H3 工作流 Simply Advanced 的 v1.7:新增视频局部重绘开关,只在原视频里被跟踪/遮罩的区域内重新生成。
已在用这套工作流的人,这一版主要多了局部重绘;新手可先关掉 LLM 增强和重绘,只用参考/引导部分。(编辑降为 B:本版新功能只有 1 张截图,没有视频示例可判断重绘效果。)
配图
推荐理由
- 版本更新:v1.7 新增 Video Inpainting,对输入的 Video 1 打开开关、简单配置后即可只重绘被跟踪遮罩的区域;裁切、遮罩、贴回三步交给 MaskVidExperiments 节点完成
- 工具本身:最多接 6 张图、2 段视频、3 段音频,每一项都能设成参考(reference)、引导(guide)或两者兼用;带潜空间放大 / 两段式生成和分阶段 LoRA 管理
- 无缝延长:可从输入视频的结尾续写(Continuation)、生成到输入视频的开头(Convergence),或两者组合在两段视频之间补一段
- 内置作者的 4 步 Ref2VA 提示词流水线(扩写 → 参考分析 → 创意蓝图 → 编译成 H3 提示词结构)和 1 步 FL2VA 提示词增强,模式按 Image 1 / Image 2 是否有图自动判断
- 模型累计下载 1281 次,免费
怎么用
- 必装节点:ComfyUI-Easy-Use、ComfyUI-KJNodes、作者的 comfyui_essential-er;要用本版的视频局部重绘,再装 MaskVidExperiments
- 可选节点:VideoHelperSuite 的 Load Video、MiniMax H3 RefMods、Spectrum 加速节点等
- 载入 simply-advanced_minimax_h3_v1.7.json,在 Video 1 上打开 Inpainting 开关并设置遮罩跟踪;步数、强度等采样参数看工作流内默认值,作者未在模型卡写
风险与限制
- 完整模型卡要求 comfyui-frontend 版本低于 v1.50.5(子图里的 Custom Combo 节点在新版前端会坏),装新前端的人需要回退
- 可见示例只有 1 张截图(另 1 个被隐藏),没有视频示例,重绘效果无从判断
- 依赖节点较多,LLM 提示词增强还需另配 LLM;工作流 JSON,不是新权重
【B】MiniMax H3 Fused Turbo: three starter workflows (text, image, reference) · v1
工作流 · 新模型 · 作者 Stable_Yogi · 发布 11-21 01:50 · 下载 57
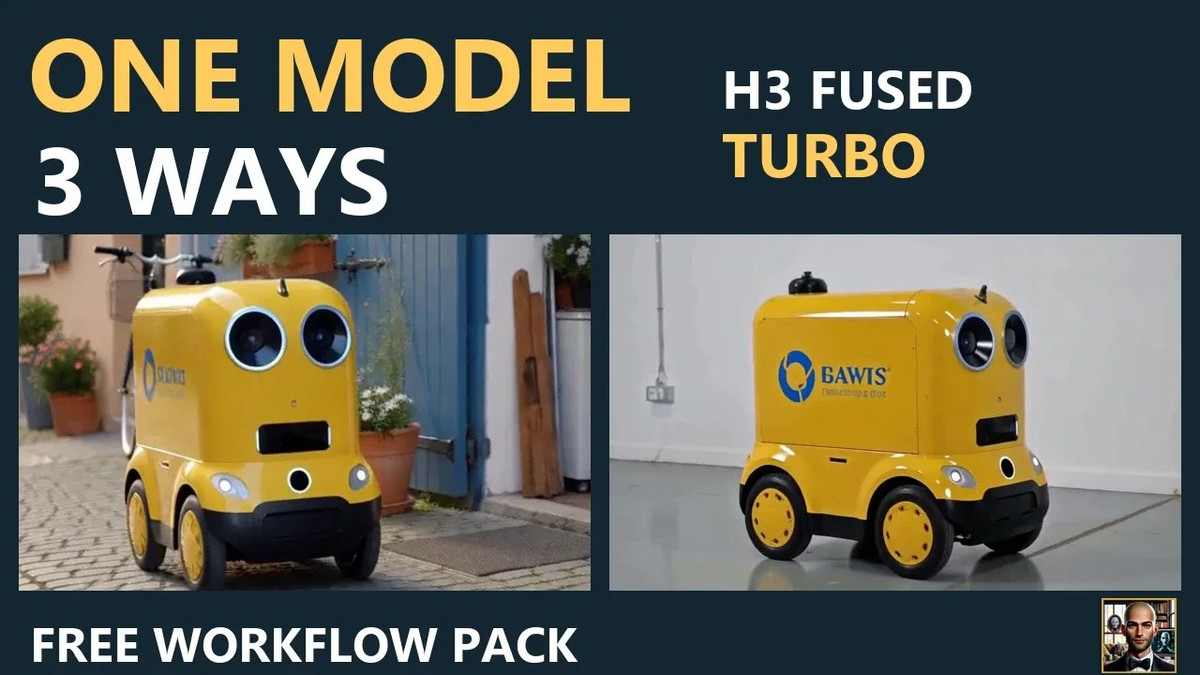
Stable_Yogi 给第三方融合加速模型 MiniMax H3 Fused Turbo 做的入门工作流包:文生视频、图生视频(以你的图作首帧)、参考生视频(把图当参考拍另一个镜头)三种起手方式。
配图
推荐理由
- 同作者当天一起发了 4 个 H3 工作流,这个是入门包:一个模型、三种开局,共 4 个测试过的图(另附一个 8 步版本做对比),带示例图片和 QUICKSTART.md
- 依赖少:只用 ComfyUI 核心 MiniMax H3 节点;压缩包里另有 .api.json 版本可走 API 调用
- 附作者 YouTube 讲解视频,免费
怎么用
- 从抱脸下载 MATLOWAI 的 minimax-h3-fused-turbo-int8-convrot 放到 models/diffusion_models,再从 Comfy-Org/MiniMax-H3 下载文本编码器和视频、音频 VAE
- 解压后把一个 .json 拖进 ComfyUI,在加载器里选好模型文件,CLIP 加载器类型保持 minimax;测试时一次只跑一个图
- Fused Turbo 默认步数作者在模型卡未写,看工作流内默认值或与 8 步版本对比
风险与限制
- Fused Turbo 是第三方融合模型,不是官方权重,画质与官方加速 LoRA 的差别作者未说明
- 示例只有 3 张图片,没有视频
- 作者称在 ComfyUI 0.32 上测试;许可只允许使用生成内容,不允许分发修改版;详细教程放在作者站外门户
【B】MiniMax H3 Second Pass: motion repair workflow · v1.0
工作流 · 新模型 · 作者 Stable_Yogi · 发布 11-21 01:50 · 下载 79
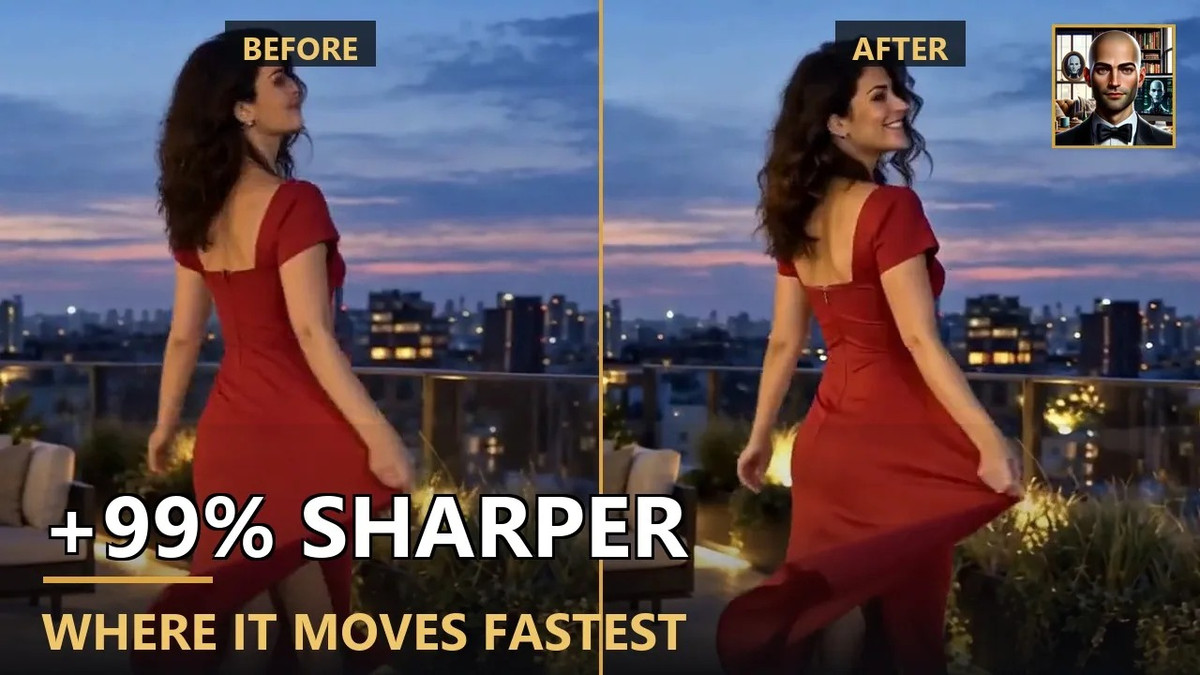
把已经生成好的 H3 片段再送回模型跑第二遍、修动作和清晰度的视频到视频工作流,同时保存原片和第二遍结果方便对比。
适合拿自己一段动作糊的片子试:工作流本身就会并排保存两版。
配图
推荐理由
- 服务 H3 成片的后处理:作者称第二遍后画面各部分都更清晰,运动最快的部分提升 99%(在全部 124 帧上测得,具体指标作者未说明)
- 一次出两段视频(普通渲染 + 第二遍),直接做前后对照
- 与同作者的入门包不同,这个用的是官方 FL2VA pruned int8 底模加 LightX2V 4 步适配器;压缩包附示例图片,免费
怎么用
- 安装 ComfyUI-MAINodes v1.1.3 以上(Manager 或 git clone)
- 模型:minimax_h3_fl2va_pruned_int8_convrot(19.5 GB)、qwen3vl_32b_minimax_h3_nvfp4_awq 文本编码器(14.6 GB)、minimax_h3_video_vae_fp16(4.9 GB)、音频 VAE(缺了没有声音),外加 LightX2V 4 步适配器放 models/loras
- 解压后把示例图片放进 ComfyUI/input,检查 5 个加载器路径,运行一次,比较输出的两段视频;第二遍的去噪强度等参数作者未给
风险与限制
- “提升 99%”的衡量方法没有公开,只能当作者称
- 可见示例只有 1 张图,没有前后对比视频
- LightX2V 4 步适配器没给具体文件名和链接;许可只允许使用生成内容
【B】MiniMax H3 Location Sheet: the same room in every shot · v1.0
工作流 · 新模型 · 作者 Stable_Yogi · 发布 11-21 01:50 · 下载 75
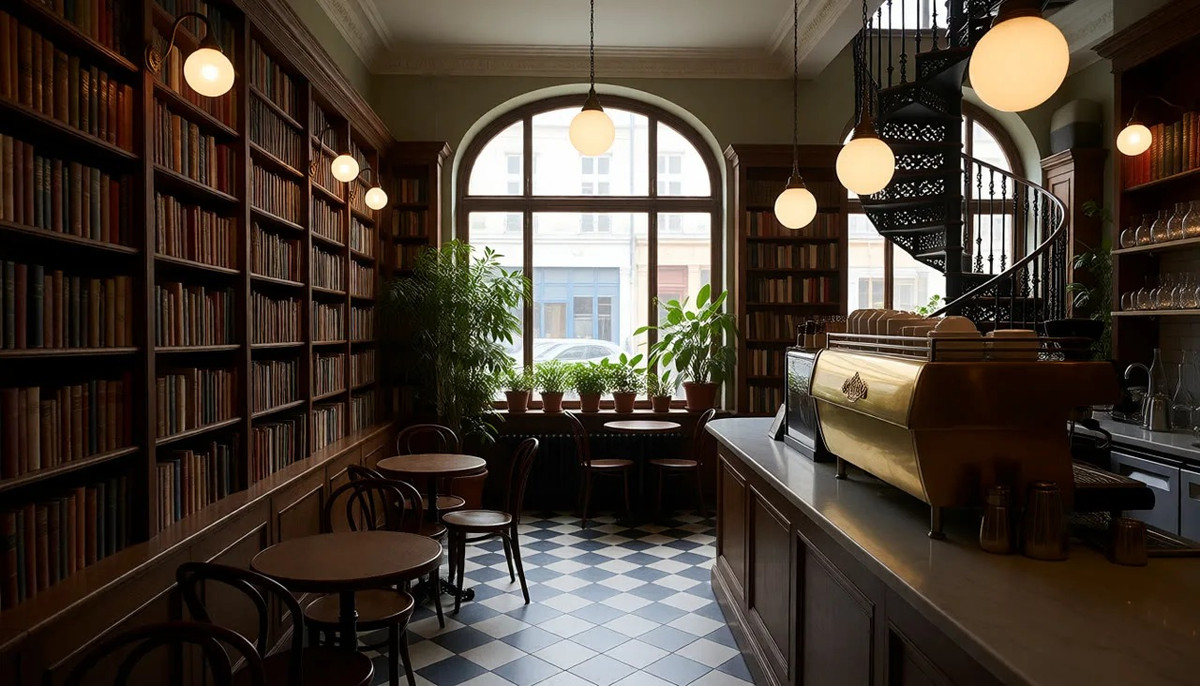
让同一个房间在不同机位镜头里保持一致的三段式工作流:Krea 2 生成空房间,FLUX.2 Klein 9B 生成同一房间的另外三个视角,再交给 H3 参考生成带声音的 5 秒镜头。
配图
推荐理由
- 服务场景一致性:多镜头短片里换机位时房间布局容易变,这里先做一张“场景设定表”(一个主视角 + 三个新视角)再给 H3 当参考,作者称镜头转动时房间能保持
- 三组节点从左到右排列,只用核心节点;同作者当天的 4 个工作流里,这是唯一要串三个模型家族的
- 附作者 YouTube 讲解视频,免费
怎么用
- 模型:一个 Krea 2 模型(作者用自己的 Muse Krea2 V3.5)及其文本编码器和 VAE;FLUX.2 Klein 9B 及其文本编码器和 VAE;MiniMax H3 Fused Turbo 及 H3 文本编码器和 VAE
- 先原样运行一次看示例房间;换成自己的场景时先改 Group 1 提示词,写清每件大物件和位置,并加 "Empty, no people."
- Group 2 三条视角提示词改成你的房间并要求大角度变化;镜头提示词里说明每张图对应房间哪一块,再写一个运镜和一件发生的事
风险与限制
- 依赖重:要同时下载并加载三套模型,显存和硬盘占用作者未写
- 示例只有 3 张图片,没有视频,一致性效果无法从页面判断
- 压缩包很小(仅工作流),许可只允许使用生成内容;详细教程在作者站外门户
【B】The Daily Grind - Minimax H3 Workflow · v1.1
工作流 · 版本更新 · 作者 darkroast175696 · 发布 11-20 23:00 · 下载 43
把作者常用的几种 H3 任务(文生、参考生等)合进一个模板的工作流 v1.1,可选两段式渲染:在不同阶段分别加载动作 LoRA 和风格/细节 LoRA。
配图
推荐理由
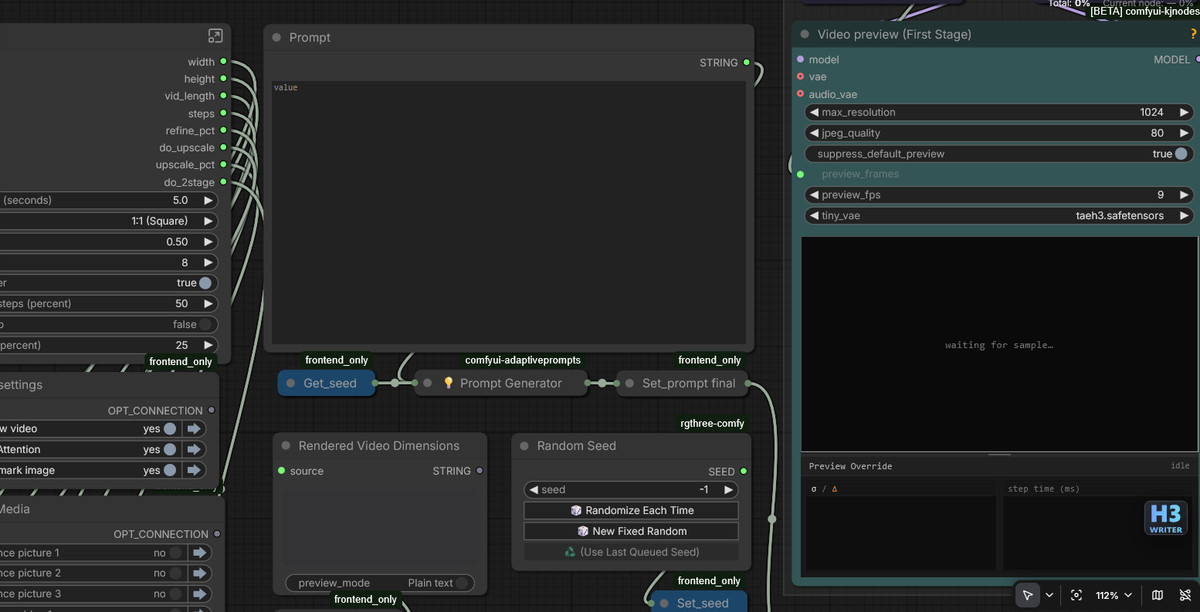
- 两段式渲染(思路类似 Wan 2.2 的双阶段):作者称动作 LoRA 在高分辨率下发糊、风格 LoRA 把音轨弄坏时,可把它们放到各自起作用的阶段;工作流里附了不同场景的配方说明
- 常用设置集中在一个画面区域,不用进子图改参数;切换文生 / 参考生不用换模板;种子、提示词等复现信息容易取到
- 版本更新:换了提示词显示节点,从旧视频内嵌工作流载入时文字不再丢;可选功能默认关闭以减少必装自定义节点;LoRA 加载器默认清空,不再预选作者自己的 LoRA
怎么用
- 解压后载入工作流;红色节点要么属于可用开关关闭的组,要么是必须安装的节点
- 当前必须先在尺寸 / 时长设置下方的设置面板里打开 Video Preview,否则工作流跑不起来(作者已知问题,称会尽快修复)
- 模型和 LoRA 按作者推荐清单自行下载;步数、强度看工作流内的说明
风险与限制
- 默认设置有已知错误,需手动开启 Video Preview 才能运行
- 只有 4 张工作流截图,没有视频示例
- 压缩包文件名已改为 h3-daily-driver;工作流 JSON,不是新权重
仅收录(8)
- Ochaco Uraraka Voice (Eng) - My Hero Academia - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA:只训练声音的 H3 LoRA(音色/声音克隆):用《我的英雄学院》丽日御茶子的英文配音片段训练,让生成视频里的角色用她的英文声线说话。
- MiniMax H3 Chain Clips: make it longer than one clip · v1.1 — 工作流:用第一段 H3 片段的最后一帧生成第二段,再把两段画面和声音拼在一起的基础续写工作流。
- HyperFlow H3 Flash — Fast Video with Sound in 4–8 Steps (ComfyUI) · v1.1 — 工作流:付费工作流包 HyperFlow H3 Flash 的免费试用版 v1.1:给压缩版 H3 模型用的文生视频快速草稿预设,4 步出带立体声音轨的短片。
- Maelle Voice (Eng) - Clair Obscur: Expedition 33 - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA:只训练声音的 H3 LoRA(音色/声音克隆):用《光与影:33号远征队》Maelle 的英文配音片段训练,给生成视频里的角色配她的声线。
- FastH3 Omni Lip-Sync — Portrait + Voice Line to Talking Video (ComfyUI) · v1.1 — 工作流:付费工作流包 FastH3 Omni Lip-Sync 的免费试用版 v1.1:输入一张肖像和一段语音,生成 5 秒对口型的说话头像视频。
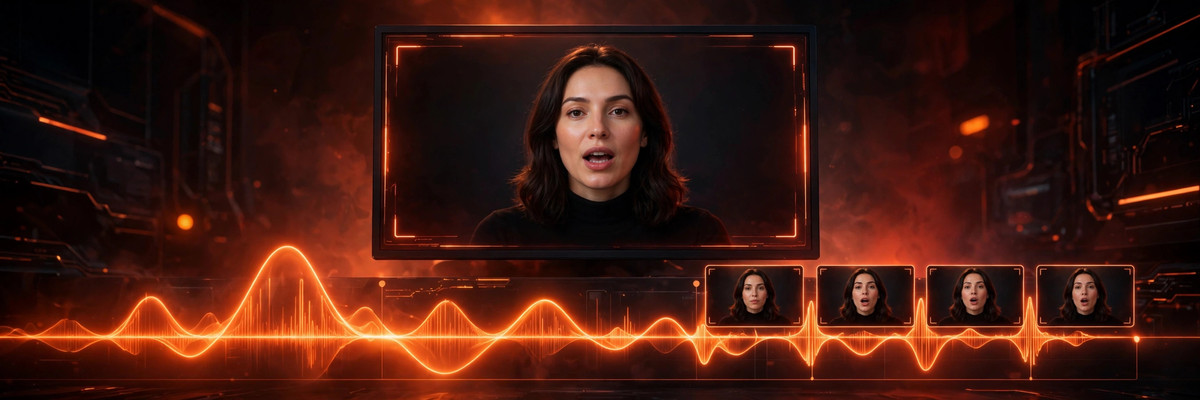
- MiniMax H3 Split Prompts · v1.0 — 工作流:把 H3 提示词拆成几个分开输入框、方便分段修改的两个工作流:Ref2V(参考生视频)v1.0 和 FL2V(首尾帧)v1.1。
- Zelda Voice (Eng) - Breath of the Wild/Tears of the Kingdom - Audio Only [Minimax H3] (Commission) · Minimax H3 v1.0 — LoRA:只训练声音的 H3 LoRA(音色/声音克隆):用《塞尔达传说:旷野之息 / 王国之泪》塞尔达的英文配音片段训练。
- Gonzo Muppet · v1.0 — LoRA:布偶秀角色 Gonzo 的 H3 LoRA,分画面和声音两个文件,模型卡只有名字。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-20 20:31 → 11-21 09:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。