Radar IA de Zhenzhen · MiniMax H3 · Bulletin du matin 2026-11-06
Cette édition : 17 nouvelles versions : fortement recommandé 2 · recommandé 3 · à suivre 5 · inclus uniquement 7
Note de l'éditeur Cette édition examine 17 nouvelles versions de H3. La recommandation principale est le LoRA de style celuloïd INBT : il unifie le style d'animation par défaut, souvent inconstant, de H3 en un style celuloïd avec contours à l'encre et aplats de couleurs, en fournissant les mots-clés de déclenchement, les poids, la structure des prompts et les paramètres d'échantillonnage, accompagnés de 6 vidéos d'exemple ; Better Hair élimine l'aspect crépu et fragmenté des cheveux dans H3, également classé S. Les autres points forts sont le flux de travail de génération d'images à partir de références Pika H3 Flex, Seed Hunter v3 et un processus de longs plans en segments assemblés fonctionnant sur une carte graphique de 12 Go (les exemples sont masqués, la note A est attribuée sur la base de la documentation). Les mises à jour de Minimax.. simple v5.1 et Lonecat V9.0 sont mineures ou leurs descriptions sont dispersées, Easy MH3 manque de liste de dépendances, ils sont donc rétrogradés en B ; six LoRAs de personnages standard n'ont pas de paramètres, et la plupart n'ont pas d'exemples visibles, ils sont donc rétrogradés en C.
Fortement recommandé (2)
【S】INBT Cel Style - MiniMax H3 · H3 V1
LoRA · Nouveau modèle · Auteur AriaMaiven · Publié le 11-06 05:49 · Téléchargements 54
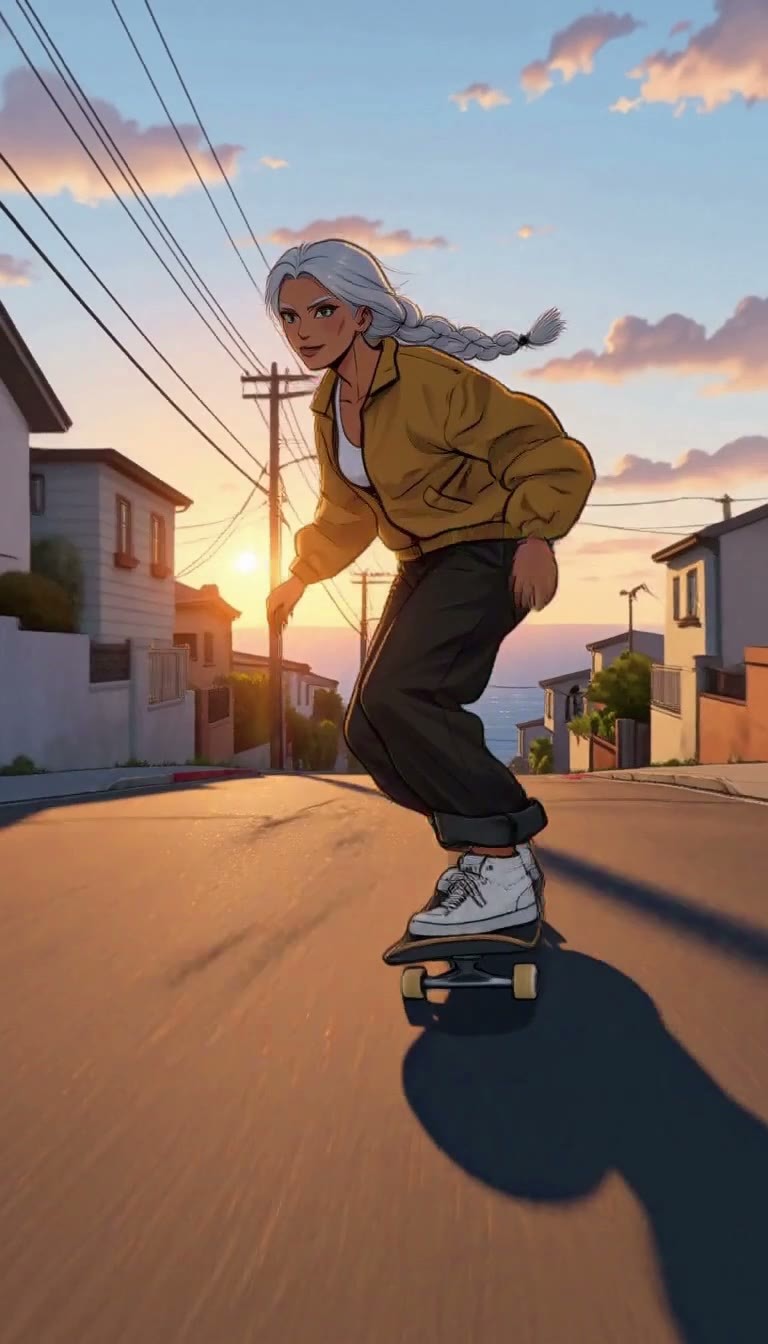
Un LoRA de style d'animation celuloïd : contours à l'encre solides, aplats de couleurs, palette de couleurs néon sous la pluie nocturne, il unifie le style d'animation par défaut de H3, qui oscille entre le cartoon américain et le manhwa, en un seul style. L'auteur affirme que le style reste constant lors des mouvements de caméra, des dialogues et des chants des personnages.
Il est rare qu'un LoRA de style précise clairement la division des tâches du prompt : « ne décrivez pas la technique de dessin, décrivez les personnages ». Suivez simplement son modèle de première phrase pour reproduire le résultat.
Illustration
Raisons de la recommandation
- Idéal pour les courts métrages d'animation 2D, les clips vidéo et les scènes de dialogue générés par texte-à-vidéo : l'auteur affirme que le style est maintenu dans les plans à deux personnages, la synchronisation labiale des dialogues et des chants, les rues désertes, les crépuscules et les lumières néon.
- Le style lui-même n'impose pas d'apparence fixe ; qui que vous décriviez dans le prompt sera dessiné, permettant d'intégrer vos propres personnages dans ce style.
- L'utilisation est entièrement documentée : mots-clés de déclenchement, poids, modèle de première phrase du prompt, échantillonneur, planificateur, nombre de pas, résolution, durée et modèle de base d'entraînement sont tous fournis ; accompagné de 6 vidéos d'exemple.
- Téléchargement gratuit, la licence permet l'utilisation commerciale des images générées (attribution du style requise).
Comment l'utiliser
- Chargez inbt_h3_v1.safetensors, poids 0.8 ; écrivez selon le format de prompt officiel de H3, placez le style dans la première phrase : [Shot 1] 2D-animated in the inbtsint style, a medium shot at eye level...
- Ne décrivez plus les lignes, les ombres, l'anime, etc. (le mot-clé de déclenchement s'en charge) ; décrivez entièrement la coiffure, les yeux, la couleur de peau, les tatouages et les vêtements de chaque personnage.
- Environnement de test de l'auteur : texte-à-vidéo MiniMax H3 FL2VA pruned int8 ConvRot dans ComfyUI, 20 pas, res_multistep + simple, 768x1344 ou 1344x768, 5 secondes ; le modèle de base d'entraînement est FL2VA pruned.
Risques et limitations
- Lorsque le poids est augmenté à 1.0, les lignes deviennent plus lourdes et des marques non demandées apparaissent sur le visage (croix sur le front, rayures sur les tempes), c'est pourquoi l'auteur recommande 0.8.
- Le texte d'arrière-plan devient des glyphes illisibles ; l'auteur précise que c'est un problème inhérent à H3, sans lien avec le LoRA.
- La redistribution est interdite, ainsi que l'utilisation des images générées pour entraîner d'autres modèles (accord préalable de l'auteur requis) ; 1 exemples de niveau sensible sont masqués ; cet article n'a pas été testé.
Mots-clés de déclenchement : inbtsint
【S】Minimax H3: t2va (T2V) – Polyhedron: Better Hair · v1.0
LoRA · Nouveau modèle · Auteur Polyhedron_AI · Publié le 11-06 01:41 · Téléchargements 197
Un LoRA pour corriger les cheveux dans H3 : l'auteur explique que les cheveux générés par H3 présentent souvent une texture crépue et fragmentée, semblable à des craquelures ; ce LoRA ajuste la structure globale des mèches pour éliminer cet effet ; l'auteur le décrit comme « meilleur » plutôt que « parfait ».
Vous pouvez effectuer une comparaison sur trois niveaux 0 / 0.6 / 0.7 avec le même prompt et la même graine pour vérifier si le crépu des cheveux est réduit.
Illustration
Raisons de la recommandation
- Résout les problèmes de texture des cheveux des personnages dans la génération texte-à-vidéo (le nom du modèle indique t2va), il s'agit d'un LoRA de correction générale qui peut être utilisé conjointement avec des LoRAs de personnages ou de style.
- Les mots-clés de déclenchement et l'intensité sont fournis : ha8ir, intensité 0.6–0.7 ; l'auteur a également enregistré des termes de description de texture capillaire tels que perfect hair, thick hair, airy volume, natural waves.
- Accompagné de 3 vidéos d'exemple ; téléchargement gratuit ; 197 téléchargements en 7 heures après la publication, l'une des attentions les plus élevées de cette édition.
Comment l'utiliser
- Chargez polyhedron_minimax_h3_image_lora__hair_ha8ir.safetensors, intensité 0.6–0.7, écrivez ha8ir dans le prompt, vous pouvez ajouter des descriptions telles que thick hair, natural waves, soft flyaways.
- L'utilisation seule est la plus stable ; le nombre de pas et le CFG ne sont pas fournis par l'auteur, les quatre flux de travail associés de l'auteur sont sur son Patreon, l'empilement de LoRAs peut être combiné avec le nœud ComfyUI-PolyhedronLoRAStack de l'auteur sur GitHub.
Risques et limitations
- L'auteur précise explicitement que la situation devient complexe lors de l'empilement de plusieurs LoRAs, sans garantie de résultat.
- La licence n'autorise pas l'utilisation commerciale ; le nom de fichier contient image_lora, les matériaux d'entraînement pourraient être des images plutôt que des vidéos, l'auteur ne le précise pas ; 1 exemples de niveau sensible sont masqués ; cet article n'a pas été testé.
Mots-clés de déclenchement : ha8ir、perfect hair、thick hair、airy volume、natural waves、soft flyaways、hair subsurface scattering
Recommandé (3)
【A】Pika H3 Flex Reference Workflow | Direct Movie Scenes With Sound From Your Pictures | 6 Steps | ComfyUI · v1.0
Flux de travail · Nouveau modèle · Auteur TheLocalLab · Publié le 11-06 00:34 · Téléchargements 63
Un flux de travail ComfyUI : utilisez 1–3 de vos propres images comme références pour générer localement, en 6 étapes, des courts métrages avec mouvements de caméra, dialogues, effets sonores et musique de fond via Pika H3 Flex (un adaptateur de référence basé sur les poids ouverts de H3 par Pika Labs), avec une porte d'accélération VSA et un interrupteur optionnel Semantic Bridge.
Illustration
Raisons de la recommandation
- Idéal pour la génération vidéo à partir de références (Ref2VA) et la génération vidéo à partir de la première image : chaque image de référence forme un groupe, ou vous pouvez passer au mode First Frame pour démarrer à partir d'une seule image ; sortie vidéo avec audio, avec une sortie agrandie 2x RTX.
- Enchaîne le modèle principal H3 Ref2VA int8, l'encodeur de texte qwen3vl 32b, les VAE vidéo/audio, l'adaptateur pika_h3_flex_ref2va, la porte d'accélération fasth3_vsa_gate, Semantic Bridge, ainsi que les nœuds Ref2VA VSA, Semantic Bridge, Memory Cleanup, RTX, KJNodes, rgthree, VideoHelperSuite ; les notes dans l'image listent les liens de chaque modèle.
- Les paramètres sont prédéfinis : échantillonneur lcm, six sigmas manuels de Pika, CFG 1, intensité de l'adaptateur 1, sparsité de la porte 0.75 ; l'auteur a fourni les temps d'exécution sur une RTX A4500 (20 Go) : un clip de 0.6 MP (1056x608) de 5 secondes avec échantillonnage 1:43, 2:11 avec la porte d'accélération désactivée.
- Fournit des conseils pour la rédaction des prompts : un lieu et une petite histoire complète par segment, décrivez les positions selon l'emplacement dans l'image, indiquez la position de la caméra pour chaque plan, exprimez les relations de cause à effet, définissez chaque référence séparément lors de l'utilisation de plusieurs images de référence.
Comment l'utiliser
- Téléchargez Pika-H3-Flex-References-SemanticBridge.json, téléchargez les modèles selon les notes dans l'image et placez-les dans les répertoires diffusion_models / text_encoders / vae / loras et le nouveau répertoire models/semantic_bridge, installez les nœuds manquants via ComfyUI Manager.
- Conservez les paramètres prédéfinis, laissez le nœud de nettoyage de mémoire activé ; testez d'abord les prompts avec de courts clips. L'auteur de Semantic Bridge a constaté lors de tests de sitcoms que l'image est meilleure avec l'activation et le son meilleur avec la désactivation, essayez les deux.
Risques et limitations
- Dépendances lourdes : l'auteur estime que les modèles totalisent environ 48 Go, nécessitant PyTorch version CUDA 13 (cu130), un pilote NVIDIA 580 ou supérieur et une version récente de ComfyUI (testée par l'auteur 0.44.0).
- Seuil de mémoire vidéo : une carte de 20 Go sature la mémoire avec 0.8 MP 15 secondes, trois images de référence 1344x768 15 secondes nécessitent une carte de 24 Go ; 16 / 12 Go sont simulés par l'auteur en limitant la mémoire sur une carte de 20 Go, le pic pour un clip de 15 secondes est d'environ 17 Go, il est recommandé de commencer par de courts clips.
- L'auteur de Semantic Bridge a classé les flux de travail de référence comme non pris en charge dans v1 et a averti que la synchronisation labiale de l'audio de référence pose problème ; Pika H3 Flex et H3 suivent la licence communautaire MiniMax H3, lisez la licence avant toute utilisation commerciale.
- Seuls 1 vidéos d'exemple visibles sont disponibles, 3 exemples de niveau sensible sont masqués ; cet article n'a pas été testé.
【A】Minimax H3 SEED HUNTER - Latent Upscaler, Seamless Video Continuation, Dialogue Gen Tool, Speedups, Ref Mods · v3.0
Flux de travail · Mise à jour de version · Auteur foxydits · Publié le 11-06 07:57 · Téléchargements 55
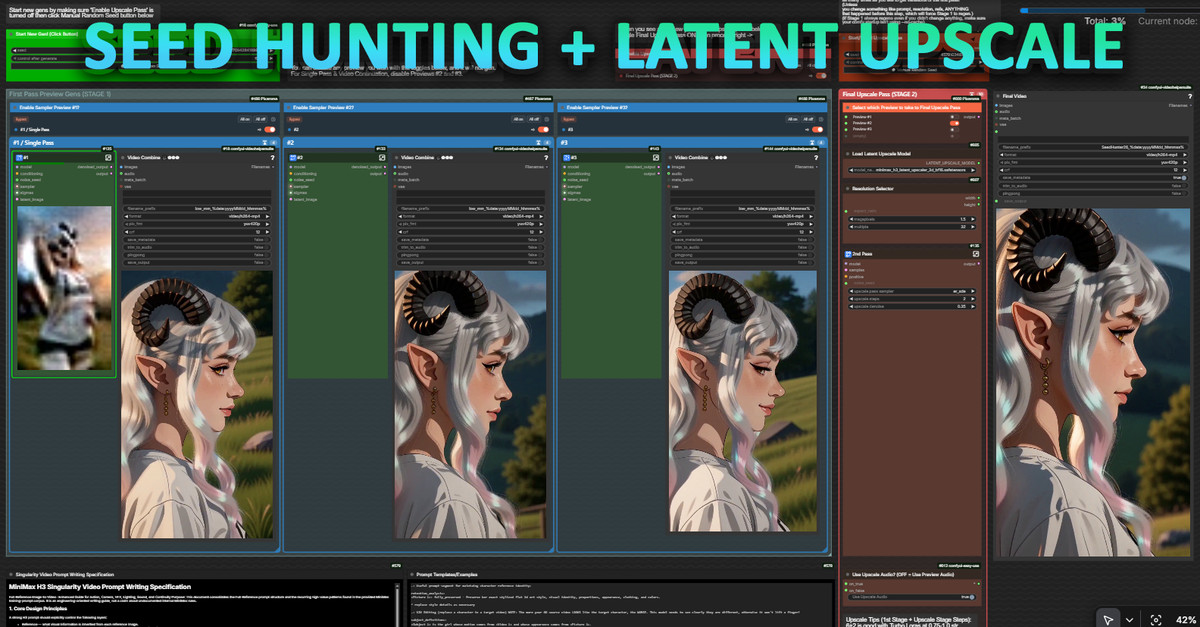
Seed Hunter v3.0 : un flux de travail de « chasse aux graines » qui génère d'abord 3 aperçus basse résolution, permet de sélectionner la graine satisfaisante, puis l'agrandit pour la finalisation ; cette version utilise l'agrandisseur latent intégré de ComfyUI et ajoute des options telles que l'extraction d'images, l'extraction d'images animées et un éditeur de prompts double.
Illustration
Raisons de la recommandation
- Mise à jour de la version : Utilisation du Latent Upscaler intégré à ComfyUI 0.44 (créé par Kijai, l'auteur affirme qu'il est plus rapide et résout les erreurs OOM dues aux pics de mémoire vidéo), il faut donc impérativement passer à 0.44
- Nouveautés : Sauvegarde séparée des premières / dernières images dans output/saved_frames/ ; extraction d'images pour Anime Cadence, rendant le rythme des animations 2D 2 plus proche de l'animation traditionnelle ; possibilité d'utiliser l'audio de la prévisualisation pour la sortie finale ; un second éditeur de prompts permet de rédiger le suivant pendant l'exécution ; les prompts sont automatiquement sauvegardés dans output/prompts/
- Le flux de travail couvre la continuité sans couture, l'audio personnalisé, l'interpolation d'images à 24 FPS vers 48-60, ainsi que des outils pour les dialogues / le clonage vocal ; la page du modèle totalise 39146 téléchargements, 1111 likes et 307 commentaires, témoignant d'un fort intérêt
Comment l'utiliser
- Mettez à jour ComfyUI vers 0.44, puis importez FoxFurEssence H3 Seed Hunter v3.json ; téléchargez le fichier minimax_h3_latent_upscaler spécifié par l'auteur et placez-le dans le dossier latent_upscale_models
- Nœuds : Anime Cadence, Pixaroma, Prompt IDE, MiniMaxH3-PromptBuilder, RefMods, etc., la plupart disponibles via Comfy Registry ; pour accélérer, vous pouvez configurer le LoRA turbo Silveroxide Dareties recommandé par l'auteur et le VAE vidéo int8 de Kijai
Risques et limitations
- La documentation d'utilisation v3.0 est marquée « à venir » par l'auteur, les guides actuels concernent la v2.5 ; il y a beaucoup de nœuds dépendants, il faut les vérifier un par un
- Il n'y a que 2 exemples d'images visibles, 5 exemples à niveau sensible sont masqués, aucun vidéo visible ; cette entrée n'a pas été exécutée
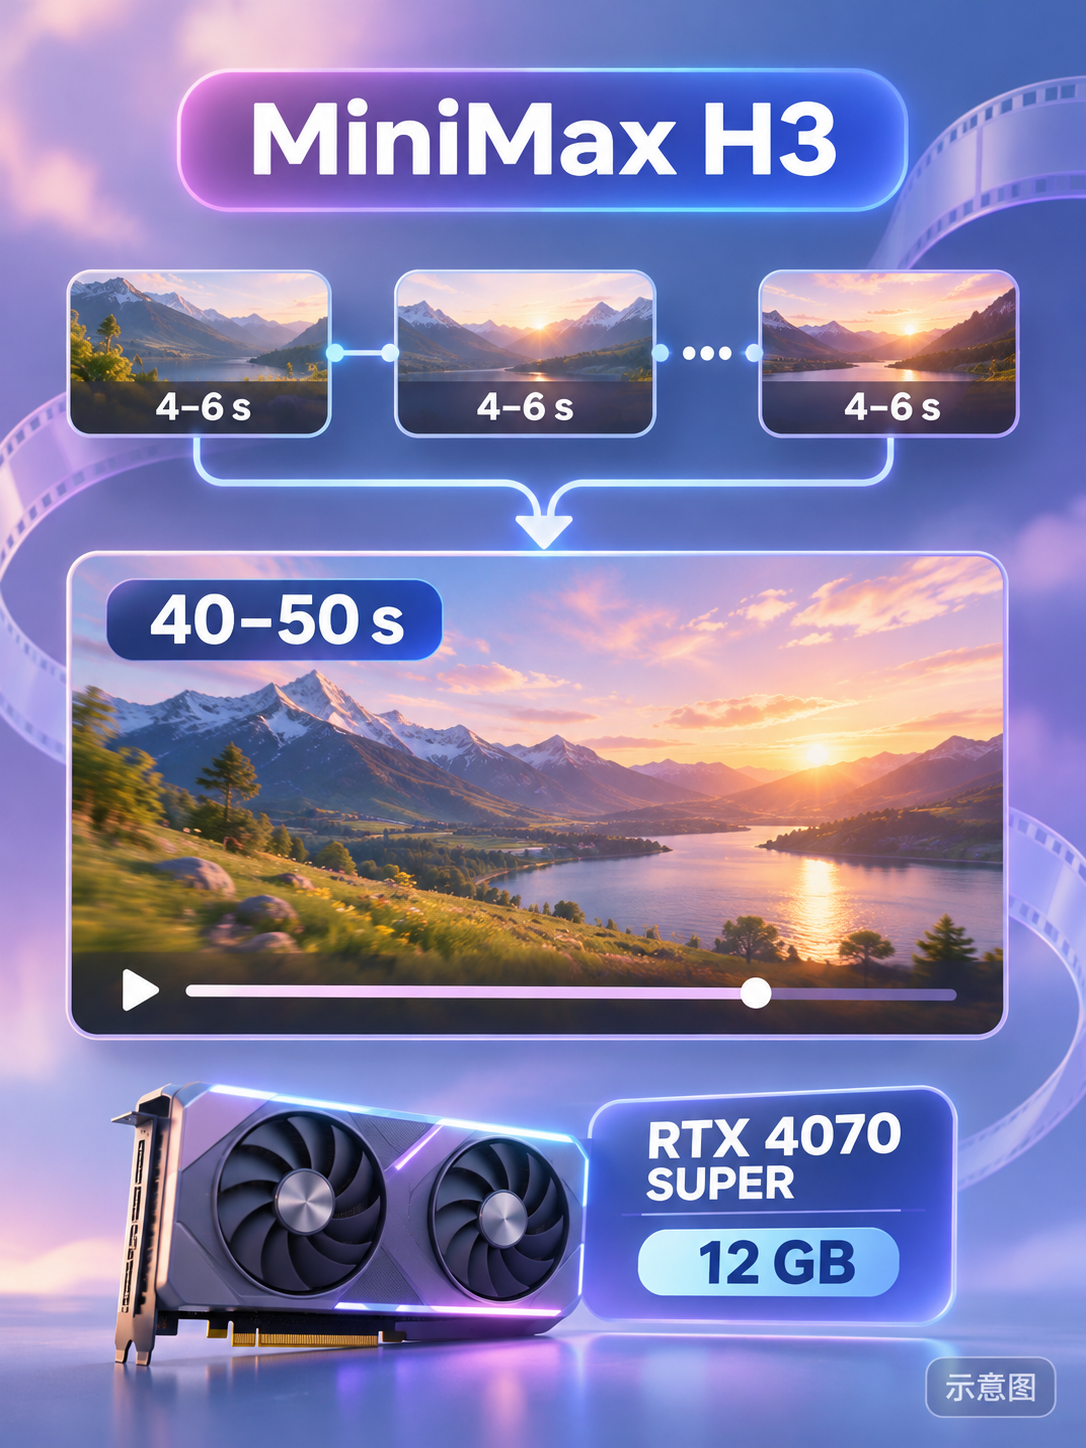
【A】MiniMax H3 plan-séquence : une prise de 40-50 s issue de segments chaînés (12 Go) · v1 (12 Go testés)
Flux de travail · Nouveau modèle · Auteur semenovsas776 · Publié le 11-06 04:32 · Téléchargements 55
Un ensemble de flux de travail et de scripts permettant d'enchaîner des segments H3 de 4-6 secondes en un plan-séquence continu de 40-50 secondes, réalisé par l'auteur sur une RTX 4070 SUPER 12 Go ; l'auteur affirme que les visages, les vêtements et les couleurs restent cohérents jusqu'à la fin, sans coutures visibles.
La solution de plan-séquence la plus complète de cette édition : le flux de travail, la planification des prompts et les scripts de contrôle qualité sont fournis ensemble, idéal pour ceux qui souhaitent réaliser une scène de dialogue en un seul plan ; lisez d'abord l'article avant de vous lancer.
Illustration
Raisons de la recommandation
- Résolution du problème des vidéos longues avec H3 (durée limitée par segment et transitions saccadées lors de la concaténation) : chaque segment est prolongé à partir de la fin de l'espace latent du segment précédent (mode de continuation de FeiHou Easy H3, 22+22 images), à partir du 2e segment, le mode de référence est utilisé avec une image de référence du visage et une image d'ouverture, et le texte de chaque segment répète la description complète des vêtements et décrit les accessoires selon leur état
- Contenu complet de l'archive : workflows d'interface utilisateur pour le 1e segment et le Nième segment (incluant les instructions de configuration), diagrammes de format API correspondants, prompts système pour la planification (à coller dans n'importe quel assistant de chat pour générer le texte de chaque segment), plan de découpage pour la scène du café, ainsi que des scripts pour la vérification du plan, l'exécution en lot de chaînes via l'API ComfyUI, la détection des coutures et des images figées, la similarité faciale et la grille de revue vidéo
- L'auteur indique les temps de traitement : 4070 SUPER + 96 Go de mémoire, environ 1.5 minutes pour le 1e segment, puis 2.5-3.5 minutes par segment supplémentaire ; la méthode complète est détaillée dans un autre article (civitai.com/articles/38141)
Comment l'utiliser
- Nécessite ComfyUI + FeiHou Easy H3, FeiHou Toolbox, KJNodes, le modèle MiniMax H3 Remix v0.8, l'encodeur de texte et le VAE de Comfy-Org/MiniMax-H3, ainsi qu'un amplificateur latent H3 ; ReActor n'est nécessaire que pour le changement de visage sur la première image
- Utilisez d'abord un prompt de planification pour faire rédiger les textes de chaque segment par l'assistant de chat, exécutez le 1e segment, puis continuez à écrire segment par segment avec le flux de travail du Nième segment, ou utilisez le script fourni pour exécuter automatiquement toute la chaîne via l'API
Risques et limitations
- Les deux vidéos d'exemple (versions réalistes et manga de la même scène de café) sont masquées car classées sensibles, on ne peut donc pas voir l'effet réel des coutures ; le niveau est donné par la documentation
- Le modèle principal utilisé est MiniMax H3 Remix v0.8 et non les poids officiels ; l'auteur n'a pas précisé si la continuité fonctionne de la même manière avec d'autres modèles ; cette entrée n'a pas été exécutée
- L'illustration de la carte est un schéma généré par IA, ce ne sont pas les résultats réels du modèle ; l'auteur ne propose pas d'exemples publics à niveau normal
À suivre (5)
【B】Minimax.. simple · v5.1
Flux de travail · Mise à jour de version · Auteur sy0ww4bb1984 · Publié le 11-06 03:10 · Téléchargements 35
La v5.1 du grand flux de travail « Minimax.. simple » pour la génération vidéo à partir d'images de référence + extension par segments + mise à l'échelle : ajout d'options de référence vidéo, instructions pour le remplacement de personne dans la vidéo (video to video replace), passthrough pour la mise à l'échelle, et réintégration de kitchen attention.
Illustration
Raisons de la recommandation
- Mise à jour de version : par rapport à v5, ajout d'entrées de référence vidéo et d'instructions pour le remplacement vid2vid ; l'auteur indique sur la page que v5.1 nécessitait temporairement une référence vidéo pour produire des résultats, corrigé dans 5.11 (le fichier téléchargé s'appelle minimaxv5.11.zip)
- Le flux complet enchaîne la génération vidéo à partir d'images de référence (multi-images, références audio multiples), l'extension par lots selon le nombre d'images avec synchronisation audio, trois types de mise à l'échelle (RTX / latent / redimensionnement), chaque lot pouvant changer de LoRA, prompt, graine et référence ; la page du modèle totalise 2860 téléchargements
- L'auteur liste les sources des LoRAs de distillation et de mise à l'échelle associés : MiniMax-H3-experimental de Kijai, les loras de Comfy-Org, Pika-H3-Flex-Turbo-LoRA
Comment l'utiliser
- Téléchargez et décompressez minimaxv5.11.zip pour l'importer dans ComfyUI ; conseils de paramètres de l'auteur : intensité du LoRA 0.4-1.0, les segments sont définis par nombre d'images et non en secondes, maximum 300 images à 1MP par lot, sigma optionnel Beta57 8 / 6 / 4 étapes
- Pour la mise à l'échelle, il est recommandé d'utiliser un facteur de 2x (l'auteur affirme que les facteurs non entiers étirent l'image) ; pour les nœuds de mémoire, il faut garder les latents audio et vidéo séparés activés et hors des groupes
Risques et limitations
- Les notes de mise à jour sont dispersées : v5.1 et 5.11 sont mélangées, ce qu'est kitchen attention et comment connecter la référence vidéo ne sont pas détaillés
- L'auteur se décrit comme ayant un seul ordinateur de milieu de gamme, difficile de tester entièrement ce grand flux ; les mises à jour de ComfyUI le cassent souvent ; il faut vérifier soi-même les nœuds et modèles dépendants
- Il n'y a que 1 exemples d'images visibles, 4 exemples à niveau sensible sont masqués, aucun vidéo visible ; cette entrée n'a pas été exécutée
【B】Lonecat’s MiniMax H3 FL2VA/ REF2VA | Flux de travail vidéo faible VRAM avec optimiseurs Low VRAM, Upscaler et Post-Production · V9.0 Plus rapide et meilleur
Flux de travail · Mise à jour de version · Auteur lonecatone23 · Publié le 11-06 08:04 · Téléchargements 14
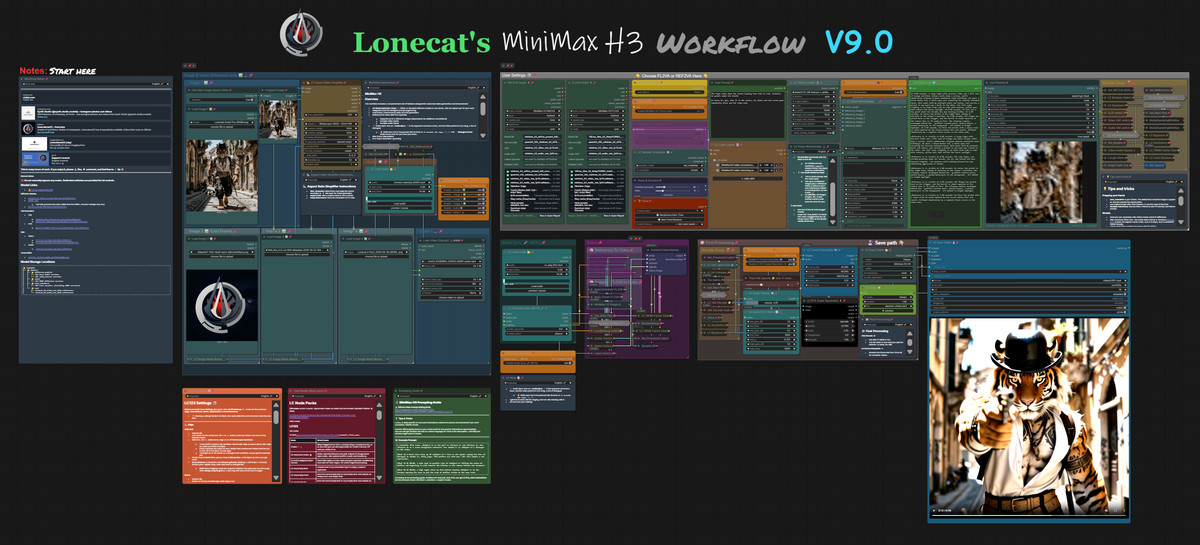
Le grand flux de travail V9.0 de Lonecat pour la génération vidéo à partir d'images premières/dernières (H3) ou d'images de référence : le seul changement explicitement mentionné est la suppression d'Ultimate Upscale, remplacé par une méthode de mise à l'échelle testée par l'auteur lors du développement d'un autre flux de travail.
Illustration
Raisons de la recommandation
- Mise à jour de version : l'auteur affirme avoir testé de nombreuses méthodes de mise à l'échelle et constaté que les pratiques courantes étaient souvent problématiques, il a donc supprimé Ultimate Upscale ; l'auteur dit que le résultat est meilleur, mais la méthode exacte est détaillée dans un lien externe, non développée sur la page du modèle
- Le flux prend en charge les images premières/dernières (FLF2V) et les images de référence (REF2V, jusqu'à 4 images de référence), les entrées vidéo et audio, l'outil LC Vision créé par l'auteur pour générer des prompts à partir d'images, l'interpolation RIFE, la super-résolution RTX, ainsi que les modèles GGUF ; les notes dans l'image sont en chinois
- Gratuit ; la page du modèle totalise 5301 téléchargements et 207 likes
Comment l'utiliser
- Importez MiniMax H3 Ver 9.0 (1).json ; l'auteur vient de mettre à jour son propre pack de nœuds, en cas d'erreur, téléchargez-le manuellement depuis le GitHub de l'auteur (lonecatone23)
- L'auteur précise qu'il s'agit d'un flux de travail avancé, non destiné aux débutants ; les novices peuvent utiliser un autre flux simplifié de l'auteur. Le nombre d'étapes et les exigences en mémoire vidéo ne sont pas donnés par l'auteur
Risques et limitations
- La note de mise à jour tient en une phrase, les détails de la méthode de mise à l'échelle sont dans un lien externe, impossible à vérifier sur la page du modèle
- Dépend de plusieurs packs de nœuds créés par l'auteur ; il n'y a que 1 exemples d'images visibles, 2 exemples à niveau sensible sont masqués ; cette entrée n'a pas été exécutée
【B】Easy MH3 (génération vidéo + mise à l'échelle par découpage + 60 FPS) · v1.0
Flux de travail · Nouveau modèle · Auteur Crimson009 · Publié le 11-05 23:15 · Téléchargements 67
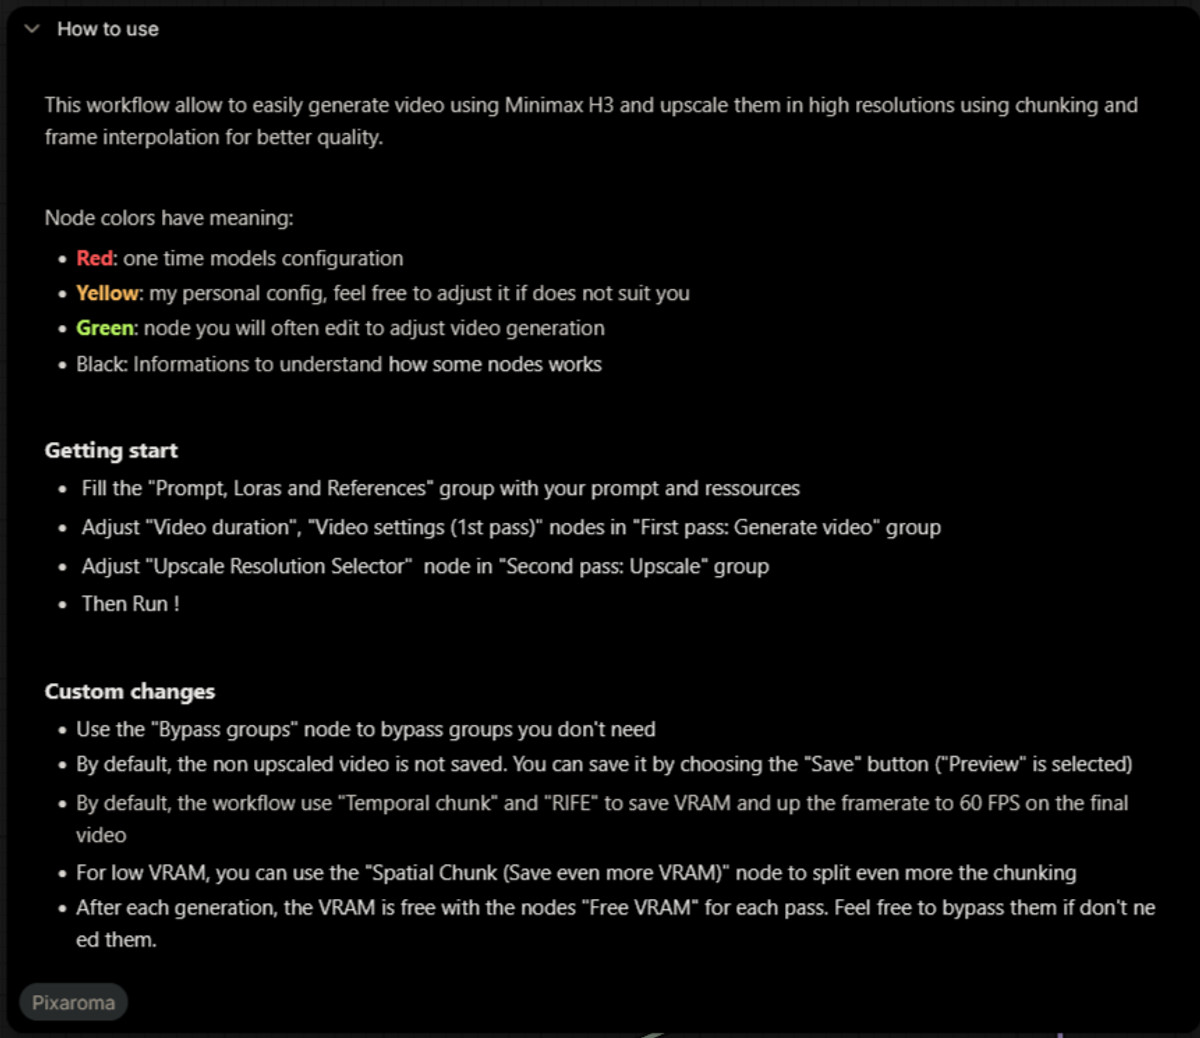
Un flux de travail H3 en deux passes : la première génère la vidéo, la seconde met à l'échelle vers une haute résolution via un découpage temporel (Temporal chunk), puis interpole les images avec RIFE pour atteindre 60 FPS, mettant l'accent sur l'économie de mémoire vidéo et la simplicité d'utilisation.
Illustration
Raisons de la recommandation
- Sert les scénarios où l'on souhaite des vidéos haute résolution et haute fréquence d'images avec une mémoire vidéo limitée : découpage temporel par défaut + RIFE, si la mémoire est encore plus basse, on peut utiliser le découpage spatial (Spatial Chunk) pour diviser davantage, un nœud Free VRAM libère la mémoire à la fin de chaque passe
- Les nœuds sont colorés selon leur usage : rouge pour la configuration des modèles unique, jaune pour les paramètres personnels de l'auteur, vert pour les paramètres de génération fréquemment modifiés, noir pour les explications
- Les étapes sont clairement écrites : remplissez le groupe « Prompt, Loras and References », ajustez la durée vidéo et les paramètres de la première passe, puis choisissez la résolution de mise à l'échelle avant d'exécuter ; désactivez les groupes inutiles avec le nœud « Bypass groups »
Comment l'utiliser
- Importez Easy_MMH3_2pass_chunked_RIFE_upscale_V1.json et remplissez selon l'ordre ci-dessus ; les vidéos non mises à l'échelle sont prévisualisées par défaut sans être sauvegardées, changez Preview en Save si nécessaire
- Les modèles, nœuds, nombre d'étapes et mémoire vidéo requis ne sont pas donnés par l'auteur
Risques et limitations
- Les modèles dépendants et les nœuds personnalisés ne sont pas listés, il faut importer pour voir ce qui manque
- Il n'y a que 1 exemples d'images visibles, 2 exemples à niveau sensible sont masqués, aucun vidéo visible, l'effet de mise à l'échelle ne peut être vérifié ; cette entrée n'a pas été exécutée
【B】Prophetero Test Bench + Take Compare GLOBAL · v0.4
Flux de travail · Nouveau modèle · Auteur Prophetero · Publié le 11-05 22:09 · Téléchargements 19
Un outil de test et de comparaison intégré à ComfyUI (Test Bench + Take Compare, version bêta publique) : exécutez d'abord des essais courts avec une ligne de base sans LoRA et plusieurs combinaisons de LoRAs dans le même flux de travail, comparez côte à côte les images, les mouvements et l'audio sur la même page, puis convertissez en un clic les paramètres sélectionnés en un rendu complet ou exportez le flux de travail.
Illustration
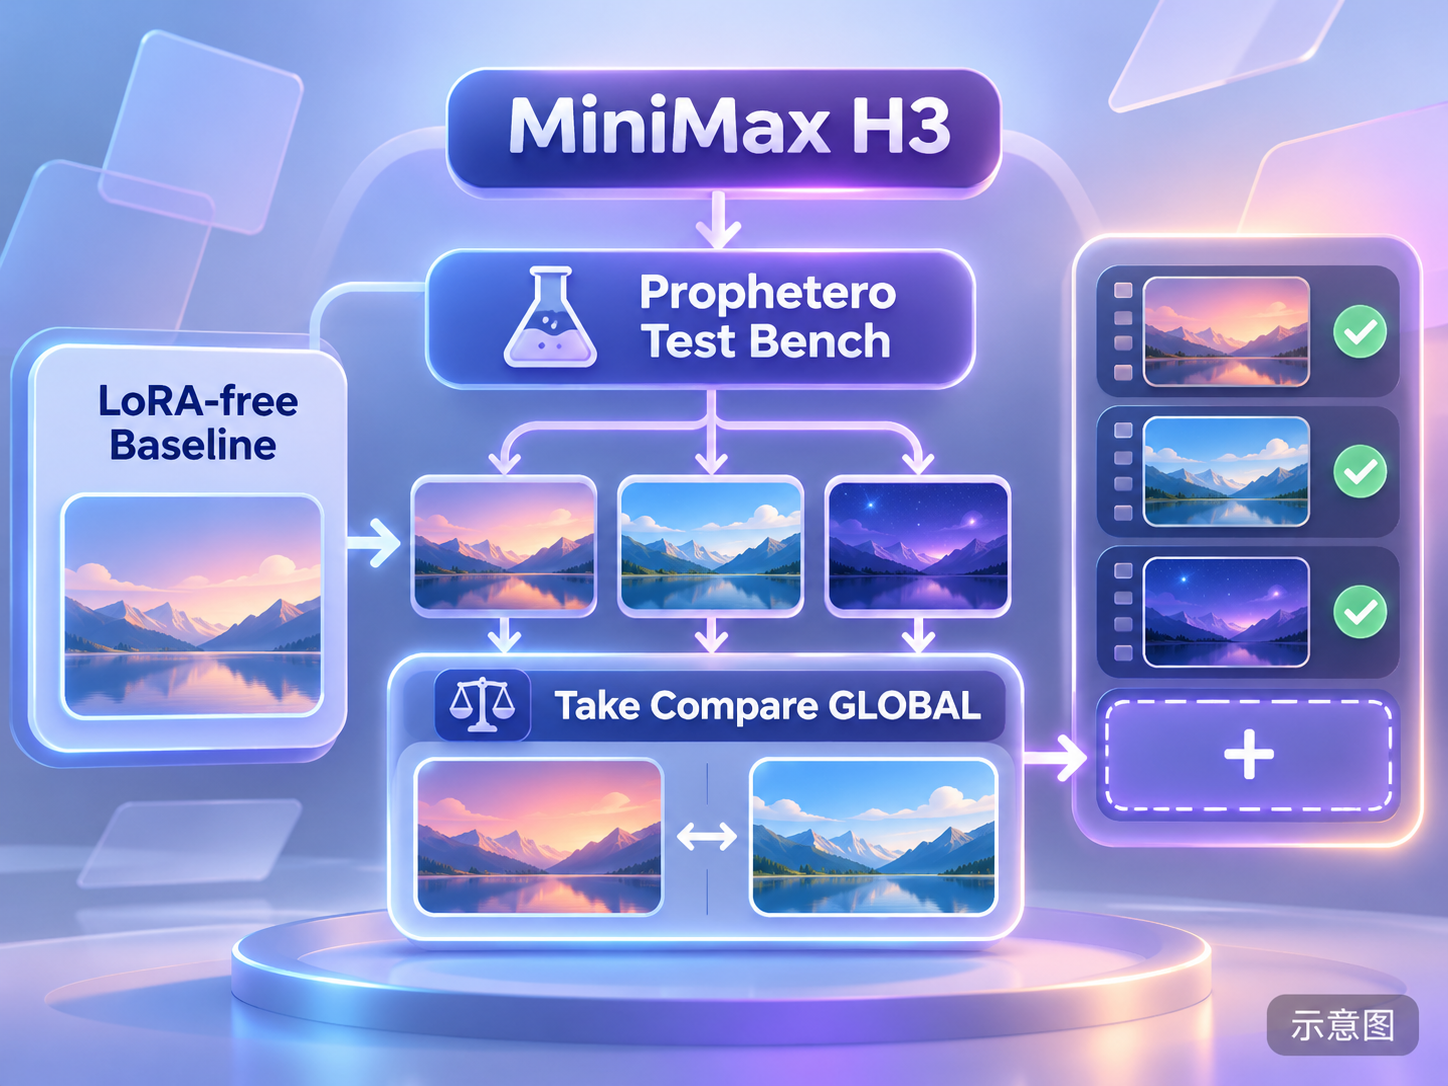
Raisons de la recommandation
- Résout les problèmes de flux de travail liés à l'ajustement des combinaisons de LoRAs, comme changer constamment d'onglet et oublier les paramètres : chaque carte d'échantillon permet de rechercher des LoRAs, de définir individuellement leur activation et leur intensité, et affiche les paramètres sauvegardés ; il peut identifier les contrôles de durée H3 / LTX pour raccourcir automatiquement les essais, les essais terminés ne sont pas relancés lors de l'ajout d'une nouvelle expérience
- Take Compare permet de comparer jusqu'à quatre segments simultanément, avec support pour le défilement image par image, le décalage temporel, le zoom synchronisé, les marqueurs de notes, et une vitesse de lecture de 0.25x à 2x ; il permet de visualiser les formes d'onde mono / stéréo des pistes audio originales ainsi que les niveaux de crête / RMS
- Prend en charge Power Lora Loader (rgthree), LoraLoader, LoraLoaderModelOnly, les nœuds de sortie prennent en charge SaveVideo et VHS_VideoCombine ; l'interface est disponible en huit langues
Comment l'utiliser
- Décompressez l'ensemble du ZIP, arrêtez le backend, exécutez START_HERE.cmd et sélectionnez le backend ComfyUI réellement utilisé, redémarrez SwarmUI / ComfyUI et rafraîchissez le navigateur ; ouvrez un workflow fonctionnel produisant des images correctes, faites un clic droit sur la toile vierge et sélectionnez Prophetero · Test Bench + Take Compare
- Limites de comparaison : une seule séquence de 0.5–120 secondes, 1–60 FPS, maximum 8 MP et 2 GiB
Risques et limitations
- Version bêta publique, l'auteur précise que l'inférence était simulée lors des tests, la compatibilité avec tous les modèles réels et nœuds personnalisés n'est pas garantie ; un essai court réussi ne garantit pas le succès d'un rendu complet
- Ce n'est pas un JSON de workflow standard, mais un paquet de plugin incluant des scripts d'installation Windows ; il faut examiner les fichiers du paquet avant l'installation ; la licence interdit la vente de ce logiciel
- Il n'y a que 1 exemples sensibles qui sont masqués, aucun exemple visible ; cette entrée n'a pas été exécutée
- L'image de la carte est un schéma généré par IA, ce ne sont pas les résultats réels du modèle ; l'auteur ne propose pas d'exemples publics non sensibles
【B】H3 : Texture authentique et jeu d'acteur primé, niveau maître. · v1.0
LoRA · Nouveau modèle · Auteur TuTu_1018 · Publié le 11-05 21:29 · Téléchargements : 254
LoRA « Texture réaliste et jeu d'acteur primé » : l'auteur affirme qu'il renforce les détails faciaux des personnages, les micro-expressions, les changements de regard et l'expression émotionnelle, rendant les personnages dans les dialogues, les scènes émotionnelles et les scènes narratives plus crédibles comme s'ils jouaient la comédie plutôt que d'exécuter des actions mécaniques.
Image illustrative
Raisons de la recommandation
- Sert aux scènes de dialogue et aux gros plans émotionnels pour personnages réalistes, en génération vidéo texte-vers-vidéo ou image-vers-vidéo, l'orientation est la qualité du jeu d'acteur plutôt qu'un personnage ou un style graphique spécifique
- Environ une demi-journée après la publication : 254 téléchargements et 21 likes, c'est la version la plus téléchargée de cette période, mais cela indique uniquement le niveau d'intérêt
- L'auteur a publié un workflow en ligne portant le même nom sur RunningHub (le lien contient un code d'invitation)
Utilisation
- Charger H3lora.safetensors pour un rendu réaliste digne d'un acteur primé ; les mots-clés de déclenchement ne sont pas enregistrés par l'auteur, et l'intensité ainsi que le nombre de pas ne sont pas indiqués par l'auteur
Risques et limitations
- La fiche du modèle ne contient que des descriptions promotionnelles, sans informations d'entraînement, paramètres ni comparaisons ; le seul exemple est sensible et masqué, on ne peut donc pas voir les effets réels du jeu d'acteur
- Les instructions sont répétées deux fois, principalement pour rediriger vers une plateforme externe ; cette entrée n'a pas été exécutée
- L'image de la carte est un schéma généré par IA, ce ne sont pas les résultats réels du modèle ; l'auteur ne propose pas d'exemples publics non sensibles
Inclus uniquement (7)
- Bonnie Rabbit · v1.0 H3 — LoRA : Version H3 du LoRA de personnage pour Bonnie Rabbit, une fille aux oreilles de lapin créée par l'auteur (propriétaire d'une ferme de carottes dans la campagne néo-zélandaise), mot-clé de déclenchement bonnielora.
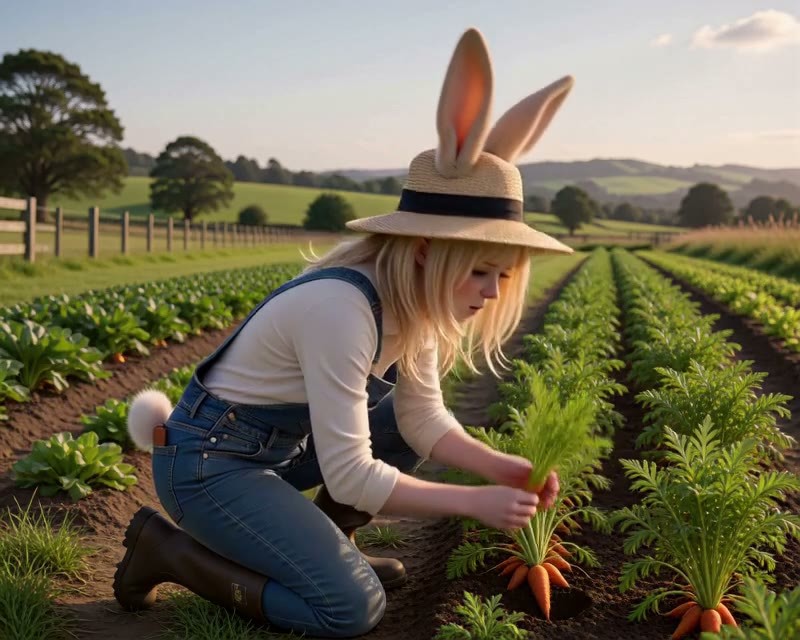
- Nevaeh Belwyn · MiniMaxH3 — LoRA : Version H3 du LoRA de personnage pour Nevaeh Belwyn, un personnage féminin fictif (archiviste de manuscrits anciens à Bruges, vêtue de laine vintage et de dentelle antique), l'auteur précise qu'il ne s'agit pas d'une personne réelle.
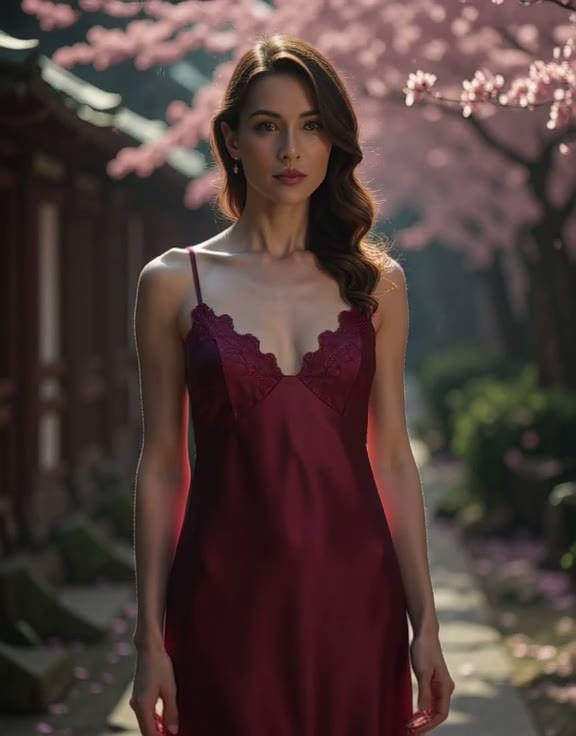
- Looney Red Riding Hood :: MMH3 Character · v1.0 — LoRA : LoRA de personnage pour une version conte sombre du Petit Chaperon rouge (sourire maniaque montrant les dents, cheveux blonds, cape rouge usée), entraîné avec le design de personnage et les images de style de l'artiste @phatestronaught, destiné à la génération vidéo texte-vers-vidéo.
- Sam Bramblepot · v1.0 H3 — LoRA : Version H3 du LoRA de personnage pour Sam Bramblepot, un jardinier nain créé par l'auteur, mot-clé de déclenchement samlora.
- Nox · v1.0 H3 — LoRA : Version H3 du LoRA de personnage pour Nox, un personnage féminin « ombre vivante » créé par l'auteur (peau noire absorbant la lumière, yeux argentés), mot-clé de déclenchement noxlora.
- Flat Lindsay · v1.0 H3 — LoRA : Version H3 du LoRA pour Flat Lindsay, un personnage créé par l'auteur : une fille « en papier », qui ressemble à une illustration avec contours vue de face, disparaît presque vue de profil, mais vit normalement dans le monde tridimensionnel.
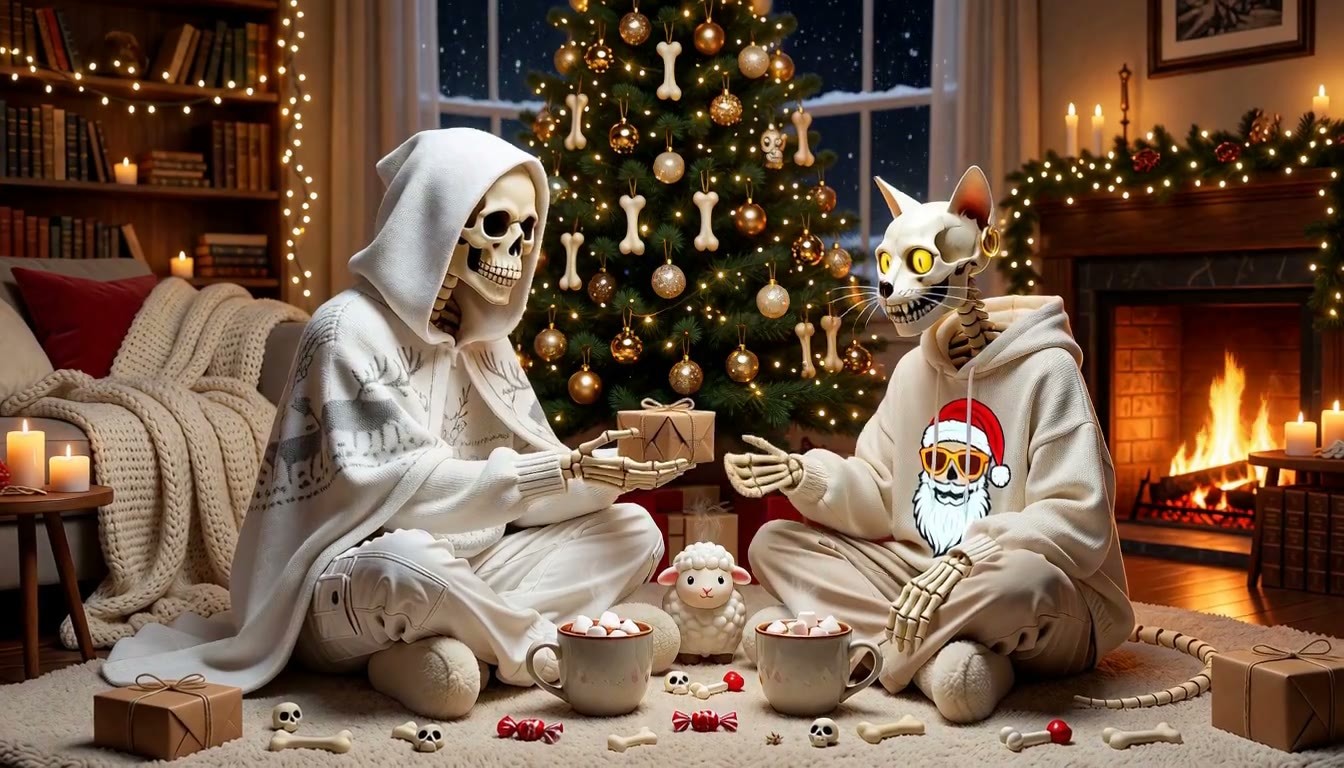
- 🎄LORU & RIBS : CHRISTMAS BONE DANCE · v1 — LoRA : LoRA de deux personnages sur le thème de Noël : Loru, la Faucheuse à capuche blanche, et son chat squelette Ribs buvant du chocolat chaud près de la cheminée, patinant sur la glace et échangeant des cadeaux ; l'auteur affirme qu'il excelle dans les textures de tricot, la structure osseuse et les effets lumineux magiques.
Données : API publique Civitai (modèle de base MiniMax H3), période d'inclusion du 11-05 20:31 au 11-06 09:01 (heure de Pékin). Les raisons de recommandation ont été revues par la rédaction ; le nombre de téléchargements indique uniquement le niveau d'intérêt.