정정(貞貞)의 AI 레이더 · MiniMax H3 · 2026-11-06 모닝 브리프
이번 호 17개 신규 버전: 강력 추천 2 · 추천 3 · 주목할 만함 5 · 단순 수록 7
편집자 주 이번 호에서는 17개의 H3 신규 버전을 검토했습니다. 최우선 추천은 INBT 셀 애니메이션 스타일 LoRA입니다. H3의 기본 애니메이션 스타일이 일관되지 않은 문제를 먹선 윤곽과 평면 음영 처리의 셀 애니메이션 스타일로 통일했으며, 트리거 워드, 가중치, 프롬프트 구조 및 샘플링 설정을 모두 명시하고 6개의 예시 영상을 첨부했습니다. Better Hair는 H3의 머리카락이 거칠고 부서지는 느낌을 제거하며, 역시 S등급입니다. 기타 하이라이트로는 Pika H3 Flex 참조 이미지 기반 영상 생성 워크플로우, Seed Hunter v3, 그리고 12GB 그래픽 카드로 실행 가능한 분할 결합 롱샷 프로세스(예시는 비공개이며 문서 기준으로 A등급 평가)가 있습니다. Minimax.. simple v5.1와 Lonecat V9.0는 업데이트 폭이 작거나 설명이 산발적이며, Easy MH3는 의존성 목록이 누락되어 B등급으로 강등되었습니다. 여섯 개의 일반 캐릭터 LoRA는 파라미터가 없고, 대부분 시각적 예시가 없어 C등급으로 강등되었습니다.
강력 추천 (2)
【S】INBT Cel Style - MiniMax H3 · H3 V1
LoRA · 신규 모델 · 작성자 AriaMaiven · 게시일 11-06 05:49 · 다운로드 수 54
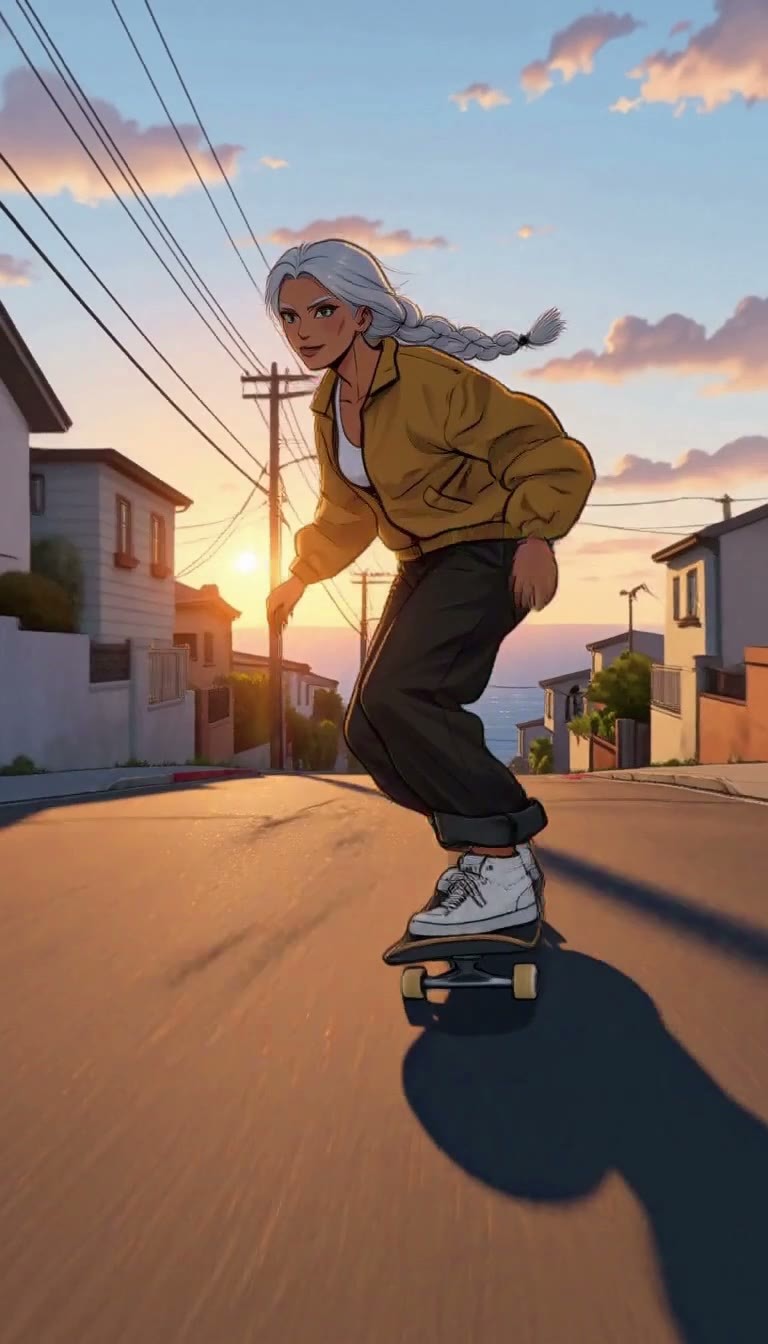
하나의 셀 애니메이션 스타일 LoRA입니다. 단단한 먹선 윤곽, 평면 음영, 비 오는 밤의 네온 색감을 통해 H3가 기본적으로 미국식 만화와 한국 웹툰 스타일 사이에서 흔들리는 애니메이션 스타일을 하나로 통일합니다. 작성자에 따르면 카메라 움직임, 캐릭터의 대화 및 노래 중에도 스타일이 유지됩니다.
스타일 LoRA에서는 드물게 '그림 기법을 설명하지 말고 캐릭터를 설명하라'는 프롬프트 분담 원칙을 명시했습니다. 작성자가 제시한 첫 문장 템플릿을 따르면 쉽게 재현할 수 있습니다.
이미지
추천 이유
- 텍스트-투-비디오(Text-to-Video)에서의 2D 애니메이션 단편, MV, 대화 장면 지원: 작성자에 따르면 한 컷에 두 사람, 대화 및 노래 입모양 동기화, 사람이 없는 거리, 황혼 및 네온 조명에서도 스타일이 유지됩니다.
- 스타일 자체에는 고정된 외모가 없으므로, 프롬프트에 지정한 대로 그려지며 자신의 캐릭터를 이 스타일에 적용할 수 있습니다.
- 사용법이 완벽하게 문서화되어 있습니다: 트리거 워드, 가중치, 프롬프트 첫 문장 템플릿, 샘플러, 스케줄러, 스텝 수, 해상도, 길이 및 학습 기반 모델이 모두 제공됩니다. 6개의 예시 영상이 첨부되어 있습니다.
- 무료 다운로드 가능하며, 라이선스는 상업적 이미지 생성을 허용합니다(스타일 출처 표기 필요).
사용 방법
- inbt_h3_v1.safetensors를 로드하고 가중치를 0.8로 설정합니다. 공식 H3 프롬프트 형식을 따르며, 첫 문장에 스타일을 배치합니다: [Shot 1] 2D-animated in the inbtsint style, a medium shot at eye level...
- 선, 음영, anime 등 그림 기법을 추가로 설명하지 마세요(트리거 워드가 이미 담당합니다). 각 캐릭터의 헤어스타일, 눈, 피부색, 문신, 의상을 모두 상세히 작성해야 합니다.
- 작성자 테스트 환경: ComfyUI에서 MiniMax H3 FL2VA pruned int8 ConvRot 텍스트-투-비디오, 20 스텝, res_multistep + simple, 768x1344 또는 1344x768, 5초; 학습 기반 모델은 FL2VA pruned입니다.
리스크 및 제한 사항
- 가중치를 1.0까지 올리면 선이 두꺼워지고 얼굴에 요청하지 않은 표시(이마의 십자, 관자놀이의 긁힘)가 그려집니다. 작성자는 이 때문에 0.8을 권장합니다.
- 배경 텍스트가 깨진 글자로 변할 수 있으며, 작성자는 이는 LoRA가 아닌 H3 자체의 문제라고 설명합니다.
- 재배포가 금지되며, 이 LoRA로 생성된 이미지를 다른 모델 학습에 사용하는 것도 금지됩니다(사전 동의 필요). 1개의 민감 등급 예시는 비공개 상태입니다. 본 항목은 실행되지 않았습니다.
트리거 워드: inbtsint
【S】Minimax H3: t2va (T2V) – Polyhedron: Better Hair · v1.0
LoRA · 신규 모델 · 작성자 Polyhedron_AI · 게시일 11-06 01:41 · 다운로드 수 197
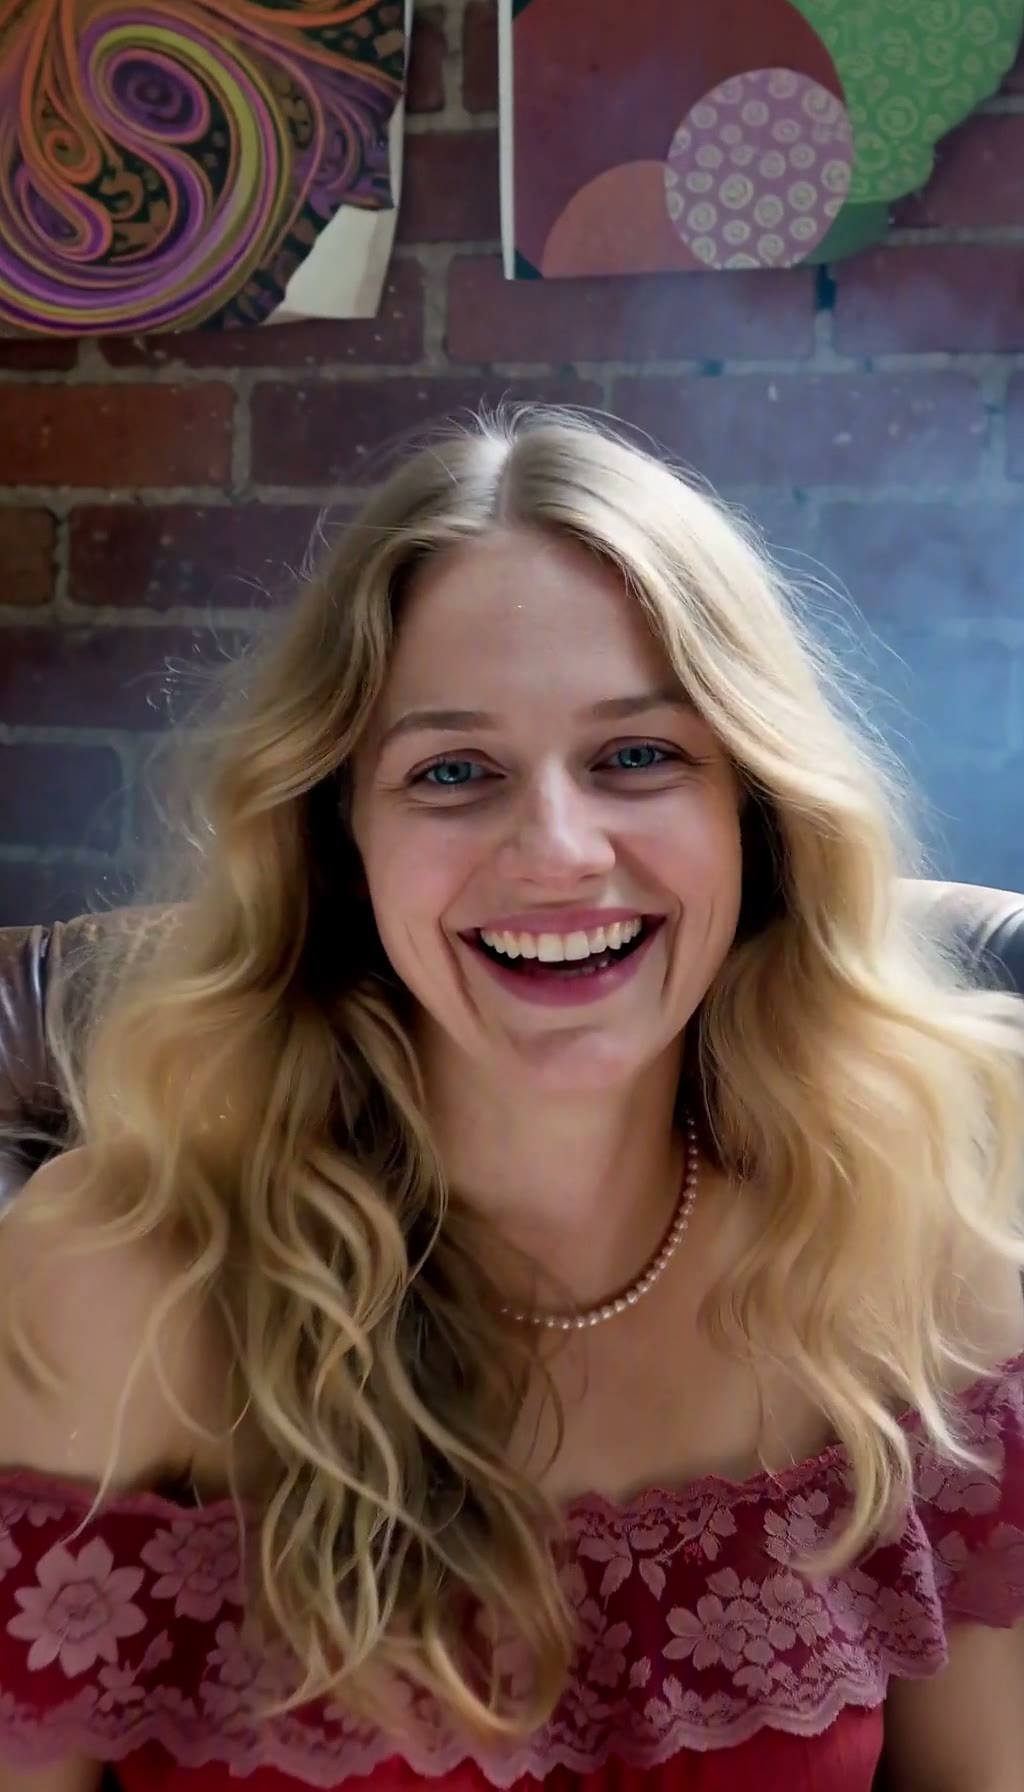
H3의 머리카락을 수정하는 LoRA입니다. 작성자에 따르면 H3가 생성하는 머리카락에는 종종 거칠고 바스라지는 듯한 질감이 있는데, 이 LoRA는 전체적인 모발 구조를 조정하여 이러한 느낌을 제거합니다. 작성자는 스스로 '더 나은(better)' 상태이지 '완벽한(perfect)' 상태는 아니라고 말합니다.
동일한 프롬프트와 시드로 0 / 0.6 / 0.7 세 단계의 비교 테스트를 수행하여 모발의 거친 정도가 감소했는지 확인할 수 있습니다.
이미지
추천 이유
- 텍스트-투-비디오(모델명에 t2va 표기)에서 인물의 머리카락 질감 문제를 해결하는 범용 수정형 LoRA로, 캐릭터 및 스타일 LoRA와 함께 사용할 수 있습니다.
- 트리거 워드와 강도가 명시되어 있습니다: ha8ir, 강도 0.6–0.7; 작성자는 perfect hair, thick hair, airy volume, natural waves 등 모발 질감 설명 단어를 추가로 등록했습니다.
- 3개의 예시 영상이 첨부되어 있으며 무료 다운로드 가능합니다. 게시 후 7시간 만에 197회 다운로드되어 이번 호에서 가장 높은 관심도 중 하나를 기록했습니다.
사용 방법
- polyhedron_minimax_h3_image_lora__hair_ha8ir.safetensors를 로드하고 강도를 0.6–0.7로 설정하며, 프롬프트에 ha8ir를 작성합니다. thick hair, natural waves, soft flyaways 등의 설명을 추가할 수 있습니다.
- 단독 사용이 가장 안정적입니다. 스텝 수와 CFG는 작성자가 제공하지 않았으며, 작성자의 네 가지 호환 워크플로우는 Patreon에 있습니다. LoRA 중첩 시 작성자의 GitHub에 있는 ComfyUI-PolyhedronLoRAStack 노드를 활용할 수 있습니다.
리스크 및 제한 사항
- 작성자는 여러 LoRA를 동시에 중첩할 경우 상황이 복잡해지며 효과가 보장되지 않는다고 명시했습니다.
- 라이선스는 상업적 사용을 허용하지 않습니다. 파일명에 image_lora가 포함되어 있어 학습 소재가 영상 대신 이미지일 가능성이 있으나 작성자는 이를 명시하지 않았습니다. 1개의 민감 등급 예시는 비공개 상태입니다. 본 항목은 실행되지 않았습니다.
트리거 워드: ha8ir、perfect hair、thick hair、airy volume、natural waves、soft flyaways、hair subsurface scattering
추천 (3)
【A】Pika H3 Flex Reference Workflow | Direct Movie Scenes With Sound From Your Pictures | 6 Steps | ComfyUI · v1.0
워크플로우 · 신규 모델 · 작성자 TheLocalLab · 게시일 11-06 00:34 · 다운로드 수 63
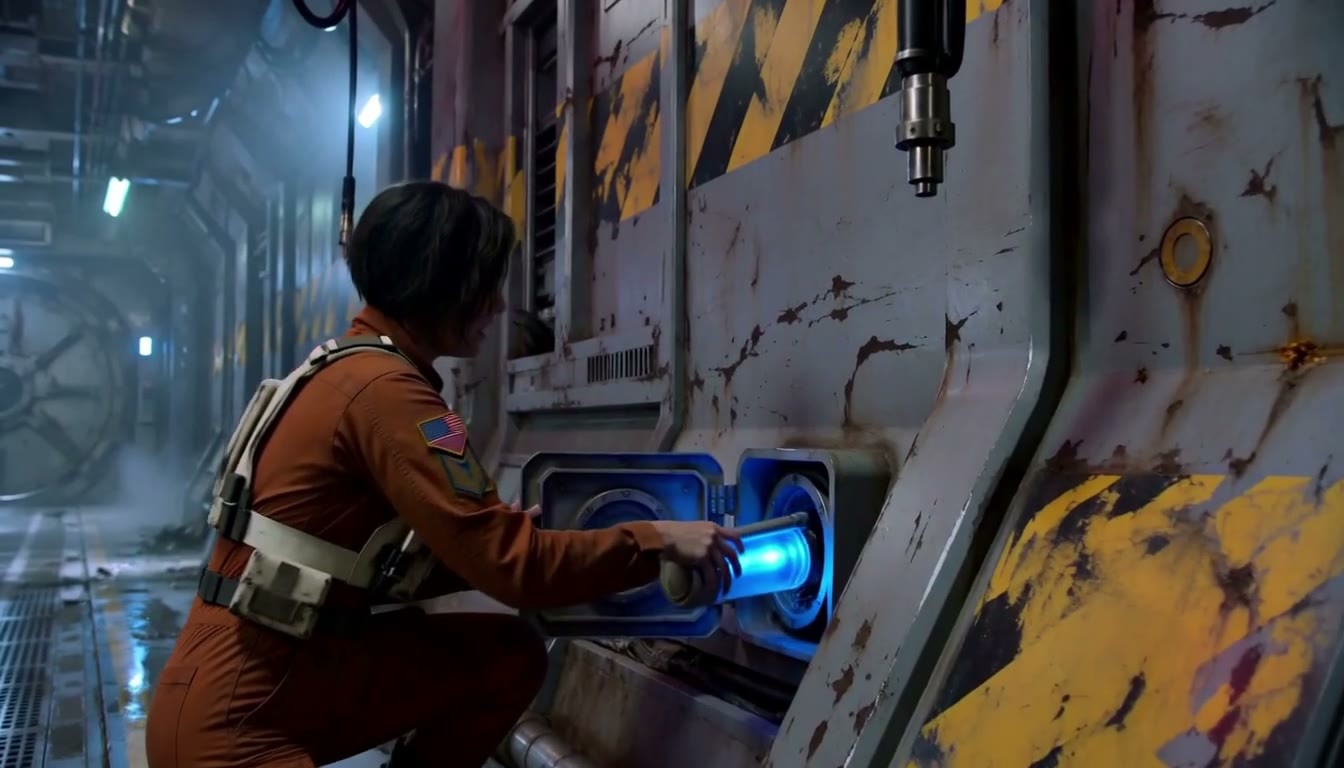
하나의 ComfyUI 워크플로우입니다. 1–3장의 사용자 이미지를 참조로 사용하여, 로컬에서 Pika H3 Flex(Pika Labs가 H3 오픈 웨이트 기반 참조 이미지 어댑터)를 통해 카메라 움직임, 대화, 효과음 및 배경음악이 포함된 단편 영상을 6단계로 생성합니다. VSA 가속 게이트와 선택적 Semantic Bridge 스위치가 추가되었습니다.
이미지
추천 이유
- 참조 이미지 기반 영상 생성(Ref2VA) 및 첫 프레임 기반 영상 생성 지원: 각 참조 이미지당 하나의 그룹을 형성하며, First Frame Mode로 전환하여 단일 이미지에서 시작할 수도 있습니다. 오디오가 포함된 영상을 출력하며, 추가로 2x RTX 업스케일링 출력이 가능합니다.
- H3 Ref2VA int8 주 모델, qwen3vl 32b 텍스트 인코더, 영상/오디오 VAE, pika_h3_flex_ref2va 어댑터, fasth3_vsa_gate 가속 게이트, Semantic Bridge, 그리고 Ref2VA VSA, Semantic Bridge, Memory Cleanup, RTX, KJNodes, rgthree, VideoHelperSuite 노드들을 연결했습니다. 이미지 내 주석에 각 모델의 링크가 나열되어 있습니다.
- 파라미터가 사전 설정되어 있습니다: lcm 샘플러, Pika의 6개 수동 sigma, CFG 1, 어댑터 강도 1, 게이트 희소성 0.75; 작성자는 RTX A4500(20 GB)에서의 소요 시간을 제시했습니다: 0.6 MP(1056x608) 5초 클립 샘플링 1:43, 가속 게이트 비활성화 시 2:11.
- 프롬프트 작성 팁이 첨부되어 있습니다: 각 단락은 하나의 장소와 완전한 작은 이야기로 구성, 화면 위치에 따른 방향 명시, 각 컷의 카메라 위치 명시, 인과 관계 서술, 여러 참조 이미지 사용 시 각각의 정의.
사용 방법
- Pika-H3-Flex-References-SemanticBridge.json을 다운로드하고, 이미지 내 주석에 따라 모델을 다운로드하여 diffusion_models / text_encoders / vae / loras 및 새로 생성한 models/semantic_bridge 디렉터리에 배치합니다. 누락된 노드는 ComfyUI Manager로 설치합니다.
- 사전 설정된 파라미터를 유지하고, 메모리 정리 노드를 활성화 상태로 둡니다. 먼저 짧은 클립으로 프롬프트를 테스트하세요. Semantic Bridge의 경우 작성자는 시트콤 테스트에서 활성화 시 화면이 더 좋고 비활성화 시 소리가 더 좋다고 발견했으며, 두 경우 모두 시도해 보기를 권장합니다.
리스크 및 제한 사항
- 의존성이 무겁습니다: 작성자 통계에 따르면 모델 합계 약 48 GB이며, CUDA 13(cu130) 버전의 PyTorch, 580 이상의 NVIDIA 드라이버 및 최신 ComfyUI(작성자 테스트 버전 0.44.0)가 필요합니다.
- VRAM 요구 사항: 20 GB 카드에서 0.8 MP 15초는 VRAM이 초과되며, 참조 이미지 3장 사용 시 1344x768 15초는 24 GB 카드가 필요합니다. 16 / 12 GB는 작성자가 20 GB 카드에서 VRAM을 제한하여 시뮬레이션한 값으로, 15초 클립의 피크는 약 17 GB입니다. 짧은 클립부터 시작하는 것을 권장합니다.
- Semantic Bridge의 작성자는 v1에서 참조 이미지 워크플로우를 지원되지 않는 항목으로 분류했으며, 참조 오디오의 입모양 동기화 문제를 경고했습니다. Pika H3 Flex와 H3는 MiniMax H3 커뮤니티 라이선스를 따르므로, 상업적 사용 전 라이선스를 확인해야 합니다.
- 공개된 예시 영상은 1개뿐이며, 추가로 3개의 민감 등급 예시가 비공개 상태입니다. 본 항목은 실행되지 않았습니다.
【A】Minimax H3 SEED HUNTER - Latent Upscaler, Seamless Video Continuation, Dialogue Gen Tool, Speedups, Ref Mods · v3.0
워크플로우 · 버전 업데이트 · 작성자 foxydits · 게시일 11-06 07:57 · 다운로드 수 55
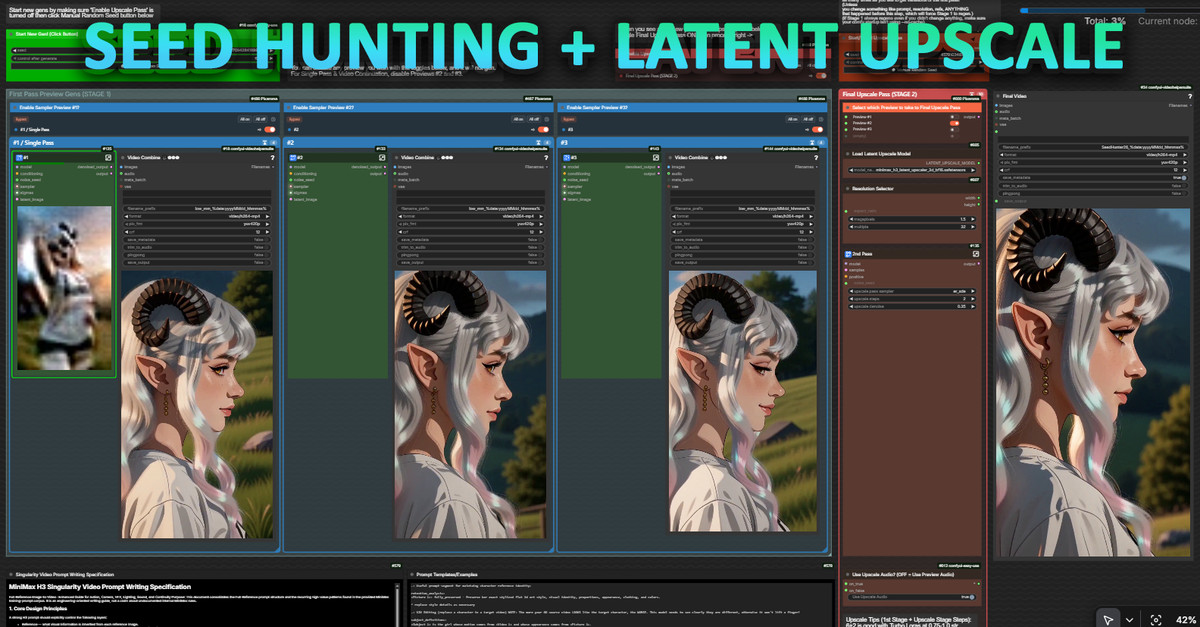
Seed Hunter v3.0: 먼저 저해상도 미리보기 3개를 생성하여 마음에 드는 시드를 선택한 후 업스케일링하여 최종본을 만드는 '시드 헌팅' 워크플로우입니다. 이 버전은 ComfyUI 내장 latent 업스케일러를 사용하며, 프레임 추출, 애니메이션 프레임 추출, 이중 프롬프트 편집기 등의 옵션이 추가되었습니다.
이미지
추천 이유
- 버전 업데이트: Kijai가 제작하고 ComfyUI 0.44에 내장된 Latent Upscaler로 변경했습니다(저자는 더 빠르며 VRAM 스파이크로 인한 OOM 문제를 해결했다고 주장합니다). 따라서 0.44로 업그레이드해야 합니다
- 신규 기능: 첫/마지막 프레임을 output/saved_frames/에 별도 저장; Anime Cadence 애니메이션 프레임 추출로 2D 애니메이션의 동작 리듬을 전통 애니메이션처럼 만듦; 최종 출력 시 미리보기 영상의 오디오를 사용할 수 있음; 두 번째 프롬프트 편집기로 실행 중 다음 프롬프트를 작성할 수 있음; 프롬프트가 자동으로 output/prompts/에 저장됨
- 워크플로우 자체는 매끄러운 연속 생성, 사용자 지정 오디오, 24 FPS에서 48-60로의 프레임 보간, 대화/음성 클론 도구를 포함합니다. 전체 모델 페이지는 누적 39146회 다운로드, 1111개 좋아요, 307개 댓글을 기록하며 높은 관심을 받고 있습니다
사용 방법
- ComfyUI를 0.44로 업그레이드한 후 FoxFurEssence H3 Seed Hunter v3.json을 가져오세요. 저자가 지정한 minimax_h3_latent_upscaler를 다운로드하여 latent_upscale_models 디렉토리에 넣으세요
- 노드: Anime Cadence, Pixaroma, Prompt IDE, MiniMaxH3-PromptBuilder, RefMods 등 대부분은 Comfy Registry에서 설치할 수 있습니다. 가속을 위해 저자가 추천하는 Silveroxide Dareties turbo LoRA와 Kijai의 int8 비디오 VAE를 구성할 수 있습니다
위험 및 제한 사항
- v3.0 사용 설명서는 저자가 '출시 예정'이라고 표기했으며, 기존 가이드는 v2.5용입니다. 의존 노드가 많으므로 하나씩 확인해야 합니다
- 보이는 이미지 예시는 2장뿐이며, 5개의 민감 등급 예시는 숨겨져 있고 보이는 영상은 없습니다. 이 항목은 실행되지 않았습니다
【A】MiniMax H3 롱 테이크: 연결된 세그먼트로 만든 40-50초 단일 샷 (12 GB) · v1 (12 GB 테스트됨)
워크플로우 · 신규 모델 · 저자 semenovsas776 · 게시일 11-06 04:32 · 다운로드 수 55
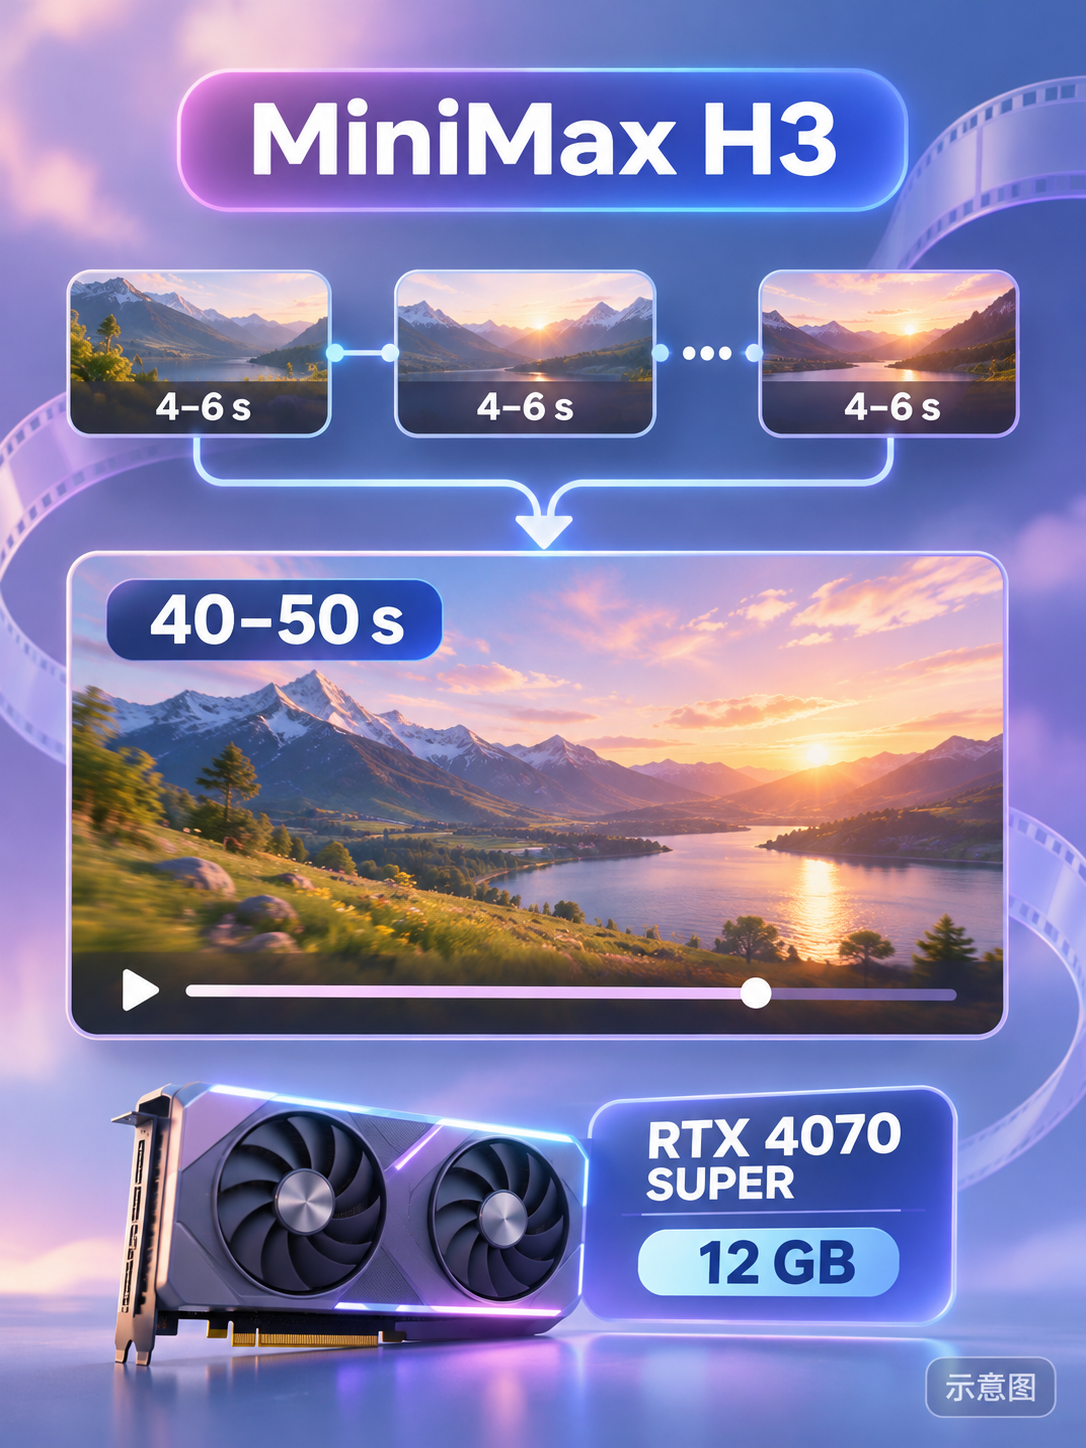
4-6초 길이의 H3 클립들을 40-50초 연속 롱 테이크로 연결하는 워크플로우 + 스크립트 패키지입니다. 저자는 RTX 4070 SUPER 12 GB에서 완료했으며, 얼굴, 의상, 색상이 마지막까지 유지되고 이음새가 보이지 않는다고 주장합니다.
이번 호에서 가장 완성도 높은 롱 테이크 솔루션: 워크플로우, 프롬프트 계획 및 품질 검사 스크립트가 함께 제공됩니다. 원테이크 대화 장면을 만들고자 하는 사람은 먼저 기사를 읽고 시작하는 것이 좋습니다.
이미지
추천 이유
- H3의 단일 세그먼트 길이 제한과 연결 시 점프 현상이 발생하는 긴 비디오 문제를 해결합니다: 각 세그먼트는 이전 세그먼트의 latent 끝부분에서 연속 생성됩니다(FeiHou Easy H3의 연속 모드, 22+22 프레임). 2번째 세그먼트부터는 참조 모드를 사용하여 얼굴 참조 이미지와 오프닝 이미지를 포함하며, 각 세그먼트의 텍스트에는 전체 의상을 반복하고 상태에 따라 소품을 설명합니다
- 압축 파일 내용이 풍부합니다: 1번째 세그먼트와 N번째 세그먼트의 UI 워크플로우(설정 설명 포함), 해당 API 형식 이미지, 계획용 시스템 프롬프트(임의의 채팅 어시스턴트에 붙여넣어 각 세그먼트 텍스트 생성), 카페 장면의 스토리보드 계획, 그리고 계획 검사, ComfyUI API를 통한 체인 일괄 실행, 이음새/프레임 멈춤 감지, 얼굴 유사도, 리뷰 시트 등의 스크립트가 포함됩니다
- 저자는 소요 시간을 제시했습니다: 4070 SUPER + 96 GB 메모리 기준, 1번째 세그먼트는 약 1.5분, 이후 각 세그먼트는 2.5-3.5분입니다. 전체 방법은 별도 기사(civitai.com/articles/38141)에 있습니다
사용 방법
- ComfyUI + FeiHou Easy H3, FeiHou Toolbox, KJNodes, MiniMax H3 Remix v0.8 모델, Comfy-Org/MiniMax-H3의 텍스트 인코더 및 VAE, 그리고 H3 latent 업스케일러가 필요합니다. ReActor는 첫 번째 프레임에서 얼굴을 교체할 때만 필요합니다
- 먼저 계획 프롬프트를 사용하여 채팅 어시스턴트가 각 세그먼트 텍스트를 작성하게 한 후, 1번째 세그먼트를 실행하고, N번째 세그먼트 워크플로우를 사용하여 세그먼트별로 연속 생성하거나, 포함된 스크립트를 통해 API로 전체 체인을 자동으로 실행하세요
위험 및 제한 사항
- 두 개의 예시 영상(동일한 카페 장면의 사실적 버전과 만화 버전) 모두 민감 등급으로 숨겨져 있어 실제 이음새 효과를 볼 수 없으며, 등급은 문서에 따라 결정됩니다
- 주 모델은 공식 가중치가 아닌 MiniMax H3 Remix v0.8을 사용하며, 모델을 교체한 후에도 동일한 연결이 가능한지 저자는 명시하지 않았습니다. 이 항목은 실행되지 않았습니다
- 카드 이미지는 AI 생성 개념도이며 모델의 실제 효과가 아닙니다. 저자는 공개된 일반 등급 예시가 없습니다
주목할 만한 항목 (5)
【B】Minimax.. simple · v5.1
워크플로우 · 버전 업데이트 · 저자 sy0ww4bb1984 · 게시일 11-06 03:10 · 다운로드 수 35
'Minimax.. simple' 대형 참조 이미지에서 비디오 생성 + 세그먼트 연장 + 업스케일링 워크플로우의 v5.1 버전입니다: 비디오 참조 옵션, 비디오에서 인물 교체(video to video replace) 작업 설명, 업스케일링용 패스스루(passthrough)가 추가되었으며 kitchen attention이 다시 추가되었습니다.
이미지
추천 이유
- 버전 업데이트: v5 대비 비디오 참조 입력과 vid2vid 교체 설명이 추가되었습니다. 저자는 페이지에서 v5.1가 한동안 비디오 참조가 없으면 출력이 불가능했다고 언급했으며, 이후의 5.11 버전에서 수정되었습니다(다운로드 파일명은 minimaxv5.11.zip)
- 전체 프로세스는 참조 이미지에서 비디오 생성(다중 이미지, 다중 오디오 참조), 프레임 수 기준 배치 연장 및 오디오 동기화, RTX/latent/resize 세 가지 업스케일링을 연결하며, 각 배치마다 LoRA, 프롬프트, 시드 및 참조를 변경할 수 있습니다. 모델 페이지는 누적 2860회 다운로드를 기록했습니다
- 저자는 관련 증류 및 업스케일링 LoRA 출처를 나열했습니다: Kijai의 MiniMax-H3-experimental, Comfy-Org의 loras, Pika-H3-Flex-Turbo-LoRA
사용 방법
- minimaxv5.11.zip을 다운로드하여 압축을 풀고 ComfyUI에 가져오세요. 저자의 파라미터 팁: LoRA 강도 0.4-1.0, 클립은 초 단위가 아닌 프레임 수로 설정, 단일 배치 최대 300 frames at 1MP, 선택적으로 Beta57 8 / 6 / 4 단계 sigma 사용
- 업스케일링은 2배 배율을 사용하는 것이 좋습니다(저자는 정수 배율이 아니면 화면이 늘어날 수 있다고 주장합니다). 메모리 노드는 독립적인 오디오/비디오 latent을 켜둔 상태로 그룹 밖에 배치해야 합니다
위험 및 제한 사항
- 업데이트 설명이 산발적입니다: v5.1와 5.11이 혼재되어 있으며, kitchen attention이 무엇인지, 비디오 참조를 어떻게 연결하는지 자세히 설명되지 않았습니다
- 저자는 중급 컴퓨터 한 대만 소유하고 있어 이 대형 워크플로우를 완전히 테스트하기 어렵다고 주장하며, ComfyUI 업데이트가 자주 문제를 일으킨다고 합니다. 의존 노드와 모델은 직접 확인해야 합니다
- 보이는 이미지 예시는 1장뿐이며, 4개의 민감 등급 예시는 숨겨져 있고 보이는 영상은 없습니다. 이 항목은 실행되지 않았습니다
【B】Lonecat의 MiniMax H3 FL2VA/ REF2VA | Low VRAM Optimizers, Upscaler, & Post Production을 포함한 저 VRAM 비디오 워크플로우 · V9.0 더 빠르고 더 좋음
워크플로우 · 버전 업데이트 · 저자 lonecatone23 · 게시일 11-06 08:04 · 다운로드 수 14
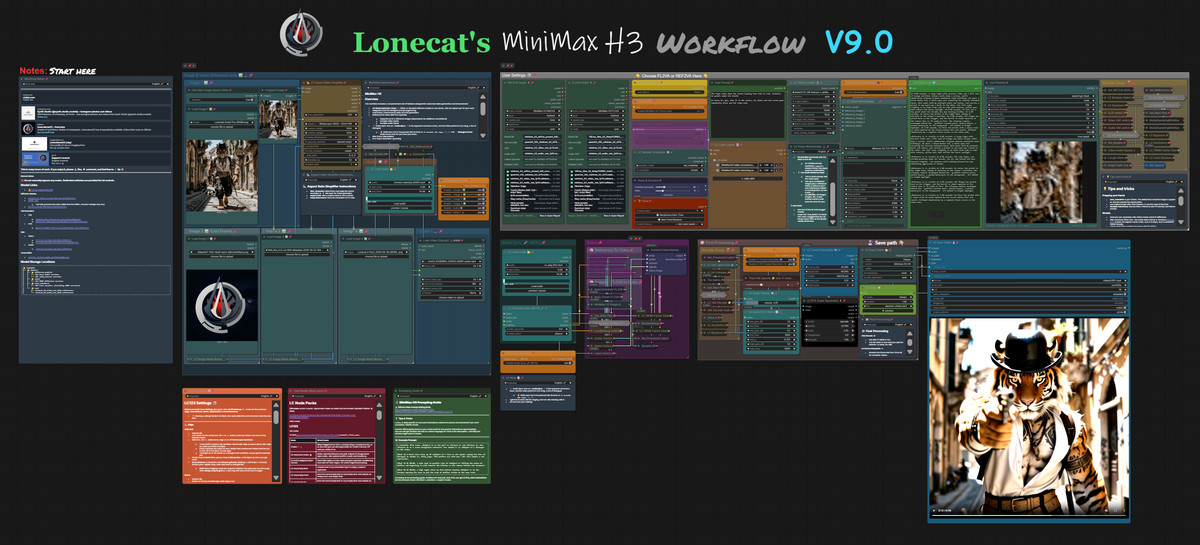
Lonecat의 H3 첫/마지막 프레임 / 참조 이미지에서 비디오 생성 대형 워크플로우 V9.0입니다: 명시된 유일한 변경 사항은 Ultimate Upscale을 제거하고 저자가 다른 워크플로우를 만들 때 테스트한 업스케일링 방법으로 대체한 것입니다.
이미지
추천 이유
- 버전 업데이트: 저자는 많은 업스케일링 방법을 테스트한 후 대부분의 사용법에는 문제가 있음을 발견했다고 주장하며, Ultimate Upscale을 제거했습니다. 저자는 최종 결과가 더 좋다고 주장하지만, 구체적으로 어떤 방법으로 대체했는지는 외부 링크에 있으며 모델 페이지에는 자세히 설명되어 있지 않습니다
- 워크플로우 자체는 첫/마지막 프레임(FLF2V)과 참조 이미지(REF2V, 최대 4장의 참조 이미지), 비디오 및 오디오 입력, 저자가 제작한 LC Vision 이미지 기반 프롬프트 작성, RIFE 프레임 보간, RTX 초해상도, 그리고 GGUF 모델을 지원합니다. 이미지 내 메모에는 중국어가 포함되어 있습니다
- 무료입니다. 전체 모델 페이지는 누적 5301회 다운로드, 207개 좋아요를 기록했습니다
사용 방법
- MiniMax H3 Ver 9.0 (1).json을 가져오세요. 저자는 자신의 노드 패키지를 방금 업데이트했으며, 오류가 발생하면 저자의 GitHub(lonecatone23)에서 수동으로 다운로드하세요
- 저자는 이것이 초보자를 위한 것이 아닌 고급 워크플로우라고 설명합니다. 초보자는 저자의 다른 간소화된 워크플로우를 사용할 수 있습니다. 단계 수와 VRAM 요구 사항은 저자가 제공하지 않았습니다
위험 및 제한 사항
- 업데이트 설명은 한 문장뿐이며, 업스케일링 방법의 세부 사항은 외부 링크에 있어 모델 페이지에서 확인할 수 없습니다
- 저자의 여러 노드 패키지에 의존합니다. 보이는 이미지 예시는 1장뿐이며, 2개의 민감 등급 예시는 숨겨져 있습니다. 이 항목은 실행되지 않았습니다
【B】Easy MH3 (청킹을 사용한 비디오 생성 + 업스케일링 + 60 FPS) · v1.0
워크플로우 · 신규 모델 · 저자 Crimson009 · 게시일 11-05 23:15 · 다운로드 수 67
2단계 H3 워크플로우입니다: 1단계에서 비디오를 생성하고, 2단계에서 시간 청킹(Temporal chunk)을 사용하여 고해상도로 업스케일링한 후 RIFE로 60 FPS까지 프레임 보간을 수행합니다. VRAM 절약과 쉬운 사용성을 강조합니다.
이미지
추천 이유
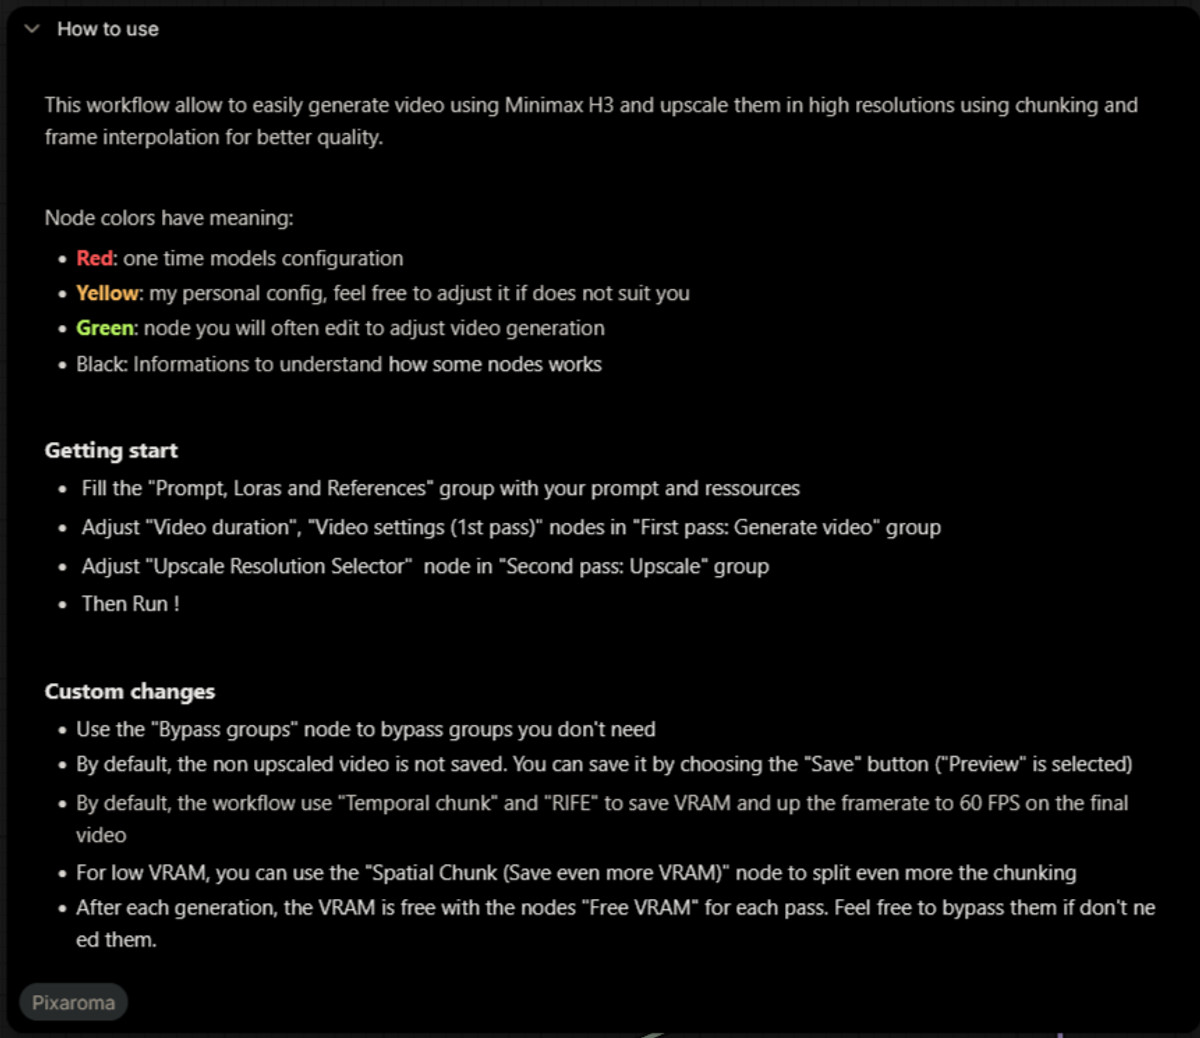
- 고해상도, 고프레임 영상 결과물을 원하지만 VRAM이 제한적인 상황에 적합합니다: 기본 시간 청킹 + RIFE를 사용하며, VRAM이 더 낮을 경우 Spatial Chunk 공간 청킹으로 더 잘게 나눌 수 있습니다. 각 단계가 끝날 때 Free VRAM 노드가 VRAM을 해제합니다
- 노드는 용도에 따라 색상으로 구분됩니다: 빨간색은 일회성 모델 구성, 노란색은 저자의 개인 설정, 초록색은 자주 변경하는 생성 파라미터, 검은색은 설명입니다
- 작업 단계가 명확히 기술되어 있습니다: 'Prompt, Loras and References' 그룹을 입력하고, 비디오 길이와 1단계 설정을 조정한 후, 업스케일링 해상도를 선택하여 실행하세요. 불필요한 그룹은 'Bypass groups' 노드로 비활성화하세요
사용 방법
- Easy_MMH3_2pass_chunked_RIFE_upscale_V1.json을 가져와 위 순서대로 입력하세요. 업스케일링되지 않은 비디오는 기본적으로 미리보기만 하고 저장하지 않으며, 필요 시 Preview를 Save로 변경하세요
- 필요한 모델, 노드, 단계 수 및 VRAM은 저자가 제공하지 않았습니다
위험 및 제한 사항
- 의존 모델과 커스텀 노드가 나열되어 있지 않아, 가져온 후 무엇이 누락되었는지 확인해야 합니다
- 보이는 이미지 예시는 1장뿐이며, 2개의 민감 등급 예시는 숨겨져 있고 보이는 영상은 없으며, 업스케일링 효과를 확인할 수 없습니다. 이 항목은 실행되지 않았습니다
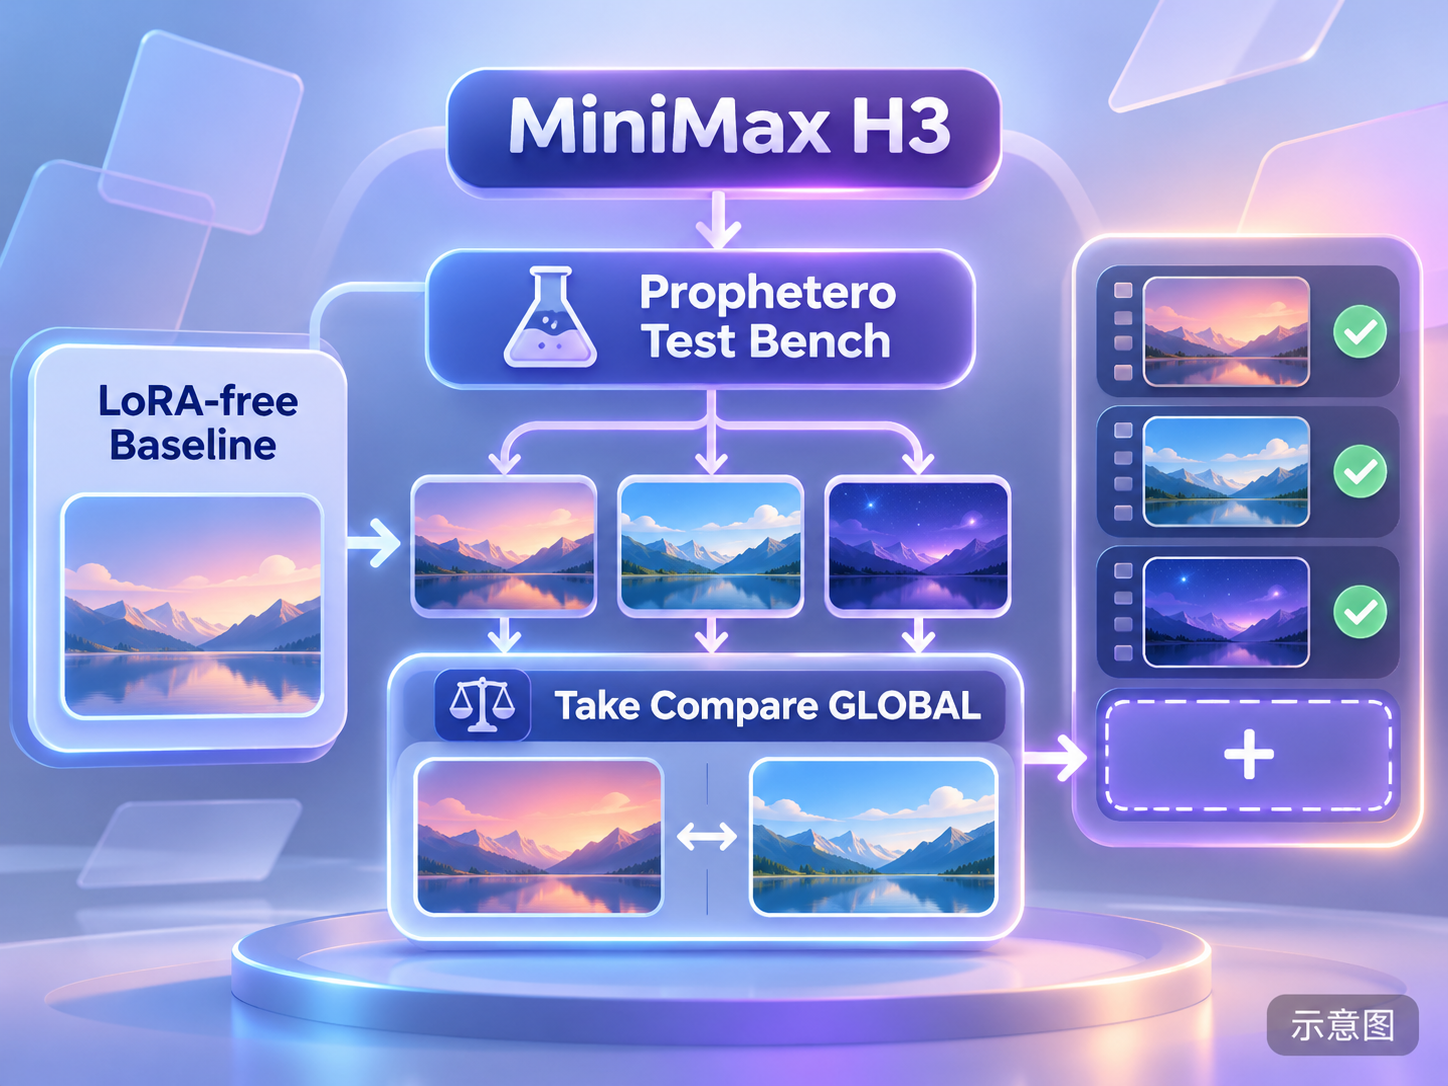
【B】Prophetero Test Bench + Take Compare GLOBAL · v0.4
워크플로우 · 신규 모델 · 저자 Prophetero · 게시일 11-05 22:09 · 다운로드 수 19
ComfyUI에 내장된 테스트 및 비교 도구(Test Bench + Take Compare, 베타 버전)입니다: 동일한 워크플로우로 LoRA가 없는 기준선과 여러 LoRA 조합의 짧은 클립을 먼저 실행하여 화면, 동작, 오디오를 같은 페이지에서 나란히 비교한 후, 선택한 설정을 전체 길이 렌더링으로 변환하거나 워크플로우를 내보낼 수 있습니다.
이미지
추천 이유
- LoRA 조합을 조정할 때 탭을 반복적으로 전환하고 파라미터를 기억하지 못하는 워크플로우 문제를 해결합니다: 각 샘플 카드에서 LoRA를 검색하고 개별 스위치와 강도를 설정하며 저장된 설정을 표시할 수 있습니다. H3 / LTX 길이 컨트롤을 인식하여 테스트 실행을 자동으로 단축하며, 완료된 테스트 실행은 새로운 실험 추가 시 다시 실행되지 않습니다
- Take Compare는 최대 4개의 클립을 동시에 비교할 수 있으며, 프레임별 보기, 시간 오프셋, 연동 확대/축소, 메모 마크업, 0.25x–2x 재생 속도를 지원합니다. 원본 오디오 트랙의 모노/스테레오 파형과 피크/RMS 레벨을 볼 수 있습니다
- Power Lora Loader(rgthree), LoraLoader, LoraLoaderModelOnly를 지원하며, 출력 노드는 SaveVideo와 VHS_VideoCombine을 지원합니다. 인터페이스는 8개 언어를 제공합니다
사용 방법
- 전체 ZIP 파일을 압축 해제하고, 백엔드를 중지한 후 START_HERE.cmd를 실행하여 실제로 사용하는 ComfyUI 백엔드를 선택하세요. SwarmUI / ComfyUI를 재시작하고 브라우저를 새로고침합니다. 정상적으로 출력이 생성되는 워크플로우를 열고, 빈 캔버스에서 마우스 우클릭하여 Prophetero · Test Bench + Take Compare를 선택합니다.
- 비교 제한: 단일 세그먼트 0.5–120초, 1–60 FPS, 최대 8 MP 및 2 GiB
리스크 및 제한 사항
- 베타 버전으로, 저자는 테스트 시 추론이 시뮬레이션된 것이며 모든 실제 모델 및 커스텀 노드와의 호환성을 보장하지 않는다고 명시했습니다. 짧은 테스트 실행이 성공했다고 해서 전체 길이 렌더링이 성공한다는 보장은 없습니다.
- 일반적인 워크플로우 JSON이 아니라 Windows 설치 스크립트가 포함된 플러그인 패키지이므로, 설치 전 패키지 내 파일을 먼저 확인해야 합니다. 라이선스상 소프트웨어 판매가 금지되어 있습니다.
- 민감 등급의 예시 1개만 존재하며 모두 숨겨져 있어 공개된 예시가 없습니다. 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다. 저자는 공개된 일반 등급의 예시를 제공하지 않았습니다.
【B】H3: Authentic texture and award-winning, master-class acting. · v1.0
LoRA · 신규 모델 · 저자 TuTu_1018 · 게시일 11-05 21:29 · 다운로드 수 254
“리얼한 질감, 명품 연기” LoRA: 저자는 인물의 얼굴 디테일, 미세 표정, 눈빛 변화 및 감정 표현을 강화하여 대화 장면, 감정 연기 및 드라마 장면에서 인물이 기계적인 동작이 아닌 실제 연기를 하는 것처럼 보이게 한다고 주장합니다.
이미지
추천 이유
- 리얼한 인물의 대화 장면, 감정 클로즈업 등 텍스트-투-비디오 / 이미지-투-비디오 용도로, 특정 캐릭터나 스타일이 아닌 연기 질감에 초점을 맞춘 방향입니다.
- 게시 후 약 반나절 만에 254회 다운로드, 21개의 좋아요를 기록하여 이번 호에서 다운로드 수가 가장 많았으나, 이는 단지 관심도를 나타냅니다.
- 저자는 RunningHub에 동일한 이름의 온라인 워크플로우를 게시했습니다(링크에 초대 코드가 포함됨).
사용 방법
- H3리얼한 질감 명품 연기 lora.safetensors를 로드하세요. 트리거 워드는 저자가 등록하지 않았으며, 강도 및 스텝 수에 대한 정보도 저자가 제공하지 않았습니다.
리스크 및 제한 사항
- 모델 카드에는 홍보성 설명만 있고 학습 정보, 파라미터 및 비교 데이터가 없습니다. 유일한 예시는 민감 등급으로 숨겨져 있어 실제 연기 효과를 확인할 수 없습니다.
- 설명이 두 번 반복되어 있으며, 주로 외부 플랫폼으로 유도하는 내용입니다. 이 항목은 실행되지 않았습니다.
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다. 저자는 공개된 일반 등급의 예시를 제공하지 않았습니다.
목록에만 포함 (7)
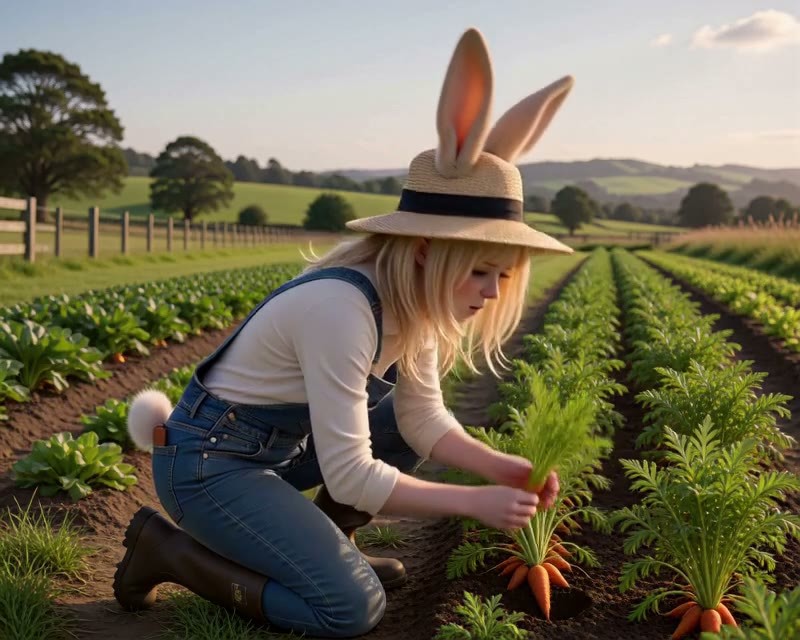
- Bonnie Rabbit · v1.0 H3 — LoRA: 저자의 오리지널 토끼 귀 소녀 캐릭터 Bonnie Rabbit(뉴질랜드 시골의 당근 농장주)의 H3 버전 캐릭터 LoRA입니다. 트리거 워드는 bonnielora입니다.
- Nevaeh Belwyn · MiniMaxH3 — LoRA: 허구의 여성 캐릭터 Nevaeh Belwyn(브뤼헤의 고서 아키비스트, 빈티지 울과 앤티크 레이스 의상)의 H3 버전 캐릭터 LoRA입니다. 저자는 실존 인물이 아니라고 명시했습니다.
- Looney Red Riding Hood :: MMH3 Character · v1.0 — LoRA: 다크 동화 버전의 빨간 망토 캐릭터 LoRA(이를 드러내고 광소하는 모습, 금발, 낡은 빨간 망토)로, 아티스트 @phatestronaught의 캐릭터 디자인 및 스타일 이미지로 학습되었으며 텍스트-투-비디오 용도입니다.
- Sam Bramblepot · v1.0 H3 — LoRA: 저자의 오리지널 난쟁이 정원사 캐릭터 Sam Bramblepot의 H3 버전 캐릭터 LoRA입니다. 트리거 워드는 samlora입니다.
- Nox · v1.0 H3 — LoRA: 저자의 오리지널 “살아있는 그림자” 여성 캐릭터 Nox(빛을 삼킬 정도로 검은 피부, 은색 눈)의 H3 버전 캐릭터 LoRA입니다. 트리거 워드는 noxlora입니다.
- Flat Lindsay · v1.0 H3 — LoRA: 저자의 오리지널 캐릭터 Flat Lindsay의 H3 버전 LoRA입니다. “종이 인형” 소녀로, 정면에서는 윤곽선 일러스트처럼 보이지만 옆으로 돌리면 거의 사라지며, 3D 세계에서 정상적으로 생활합니다.
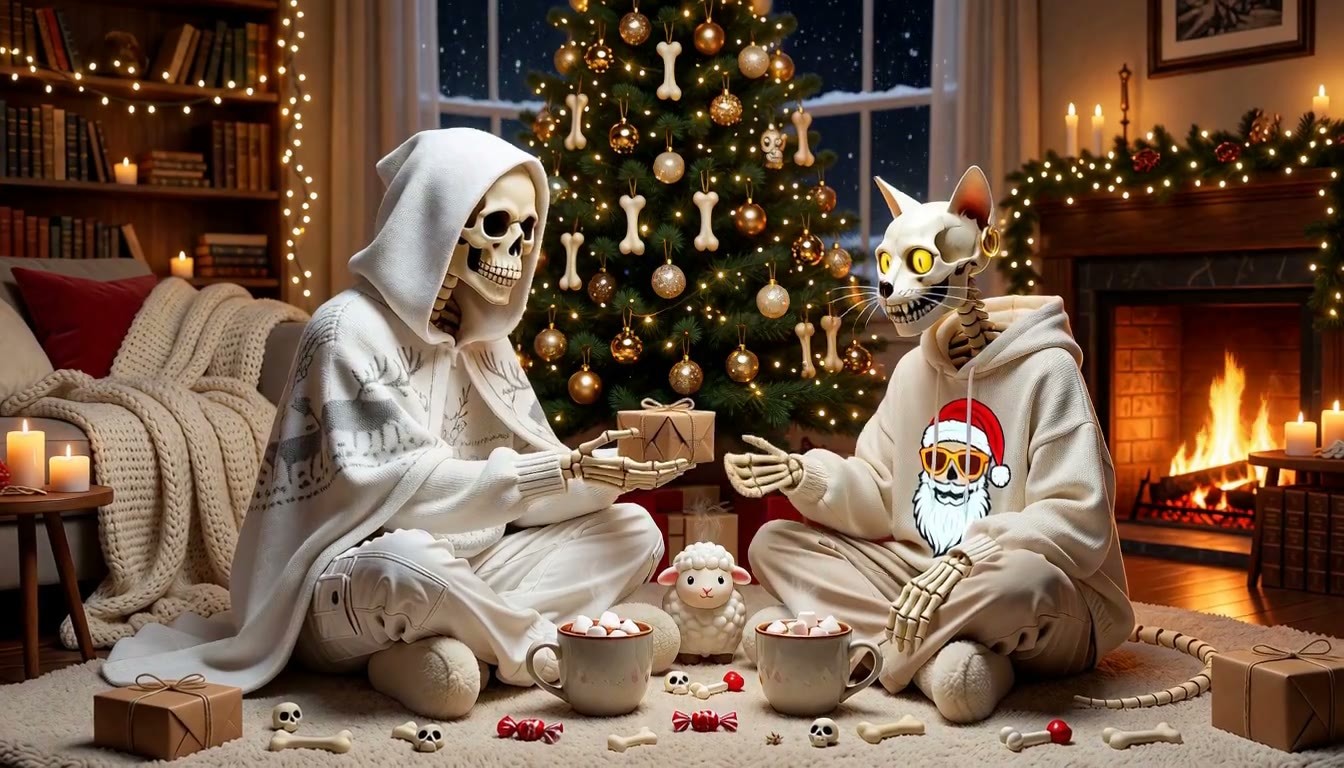
- 🎄LORU & RIBS: CHRISTMAS BONE DANCE · v1 — LoRA: 크리스마스 테마의 듀얼 캐릭터 LoRA로, 흰 후드를 쓴死神 Loru와 그의 해골 고양이 Ribs가 벽난로 옆에서 핫코코어를 마치고, 얼음 위에서 스케이트를 타며, 선물을 교환하는 장면입니다. 저자는 니트 의상의 질감, 뼈 구조 및 마법 광효과의 표현에 강점이 있다고 주장합니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-05 20:31 → 11-06 09:01(베이징 시간). 추천 이유는 편집 검수를 거쳤으며, 다운로드 수는 단지 관심도를 나타냅니다.