贞贞的AI雷达 · MiniMax H3 · 2026-11-06 晨报
本期 17 个新版本:强烈推荐 2 · 推荐 3 · 可关注 5 · 仅收录 7
编辑按语 本期审阅 17 个 H3 新版本。首推 INBT 赛璐璐画风 LoRA:把 H3 默认摇摆不定的动画画风统一成墨线勾边、平涂阴影的赛璐璐风,触发词、权重、提示词结构和采样设置都写全,附 6 段示例视频;Better Hair 去掉 H3 头发的毛躁碎裂感,同为 S。其他亮点是 Pika H3 Flex 参考图出片工作流、Seed Hunter v3 和一套 12 GB 显卡可跑的分段拼接长镜头流程(示例被隐藏,凭文档定 A)。Minimax.. simple v5.1、Lonecat V9.0 的更新幅度小或说明零散,Easy MH3 缺依赖清单,降为 B;六个常规角色 LoRA 没有参数、多数无可见示例,降为 C。
强烈推荐(2)
【S】INBT Cel Style - MiniMax H3 · H3 V1
LoRA · 新模型 · 作者 AriaMaiven · 发布 11-06 05:49 · 下载 54
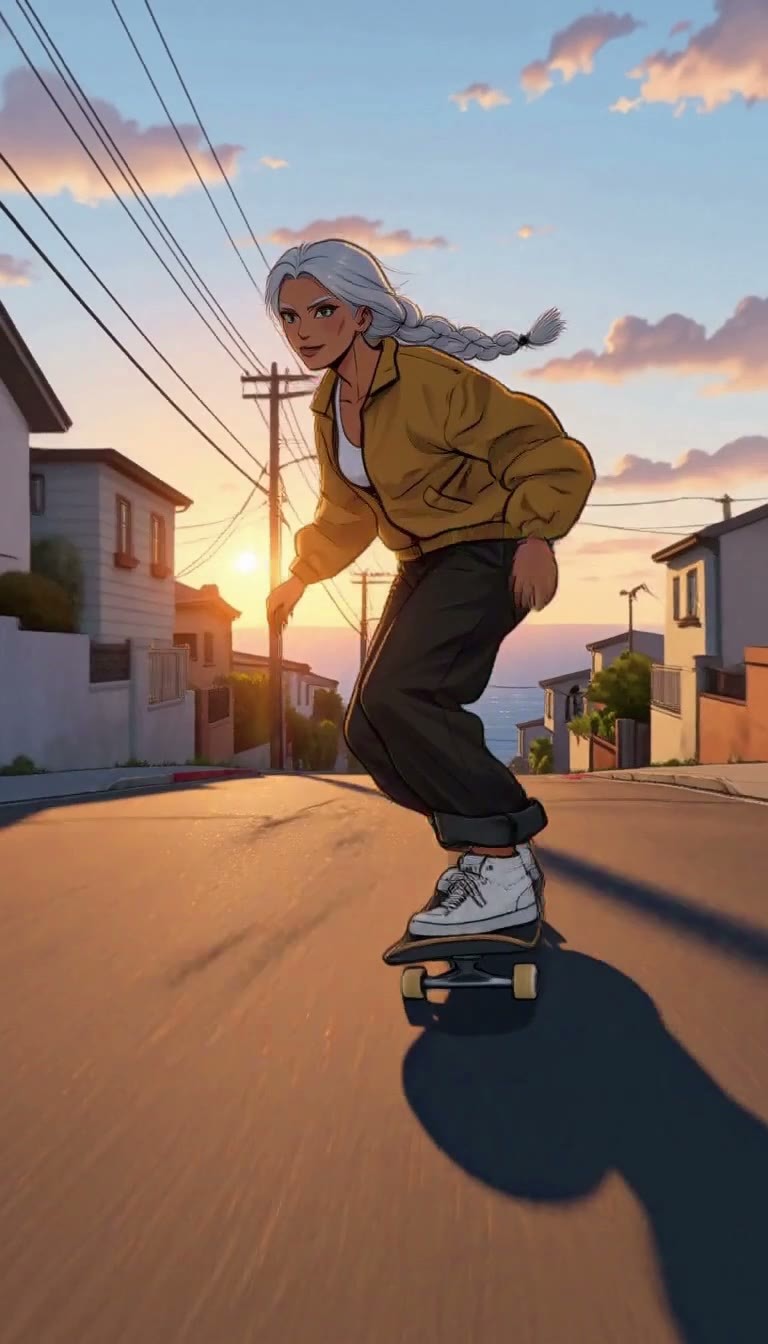
一条赛璐璐动画画风 LoRA:坚实的墨线勾边、平涂阴影、雨夜霓虹的配色,把 H3 默认在美式卡通和韩漫之间摇摆的动画画风统一成一种,作者称镜头运动和角色说话、唱歌时画风保持不变。
画风 LoRA 里少见地写明了“不要描述画法、要描述角色”的提示词分工,照它的首句模板写即可复现。
配图
推荐理由
- 服务文生视频里的 2D 动画短片、MV、对白戏:作者称一镜两人、对白和唱歌口型同步、无人空街、黄昏和霓虹光都能保持画风
- 画风本身不带固定长相,提示词写谁就画谁,可以把自己的角色套进这个画风
- 用法写得完整:触发词、权重、提示词首句模板、采样器、调度器、步数、分辨率、时长和训练底模都给了;附 6 段示例视频
- 免费下载,许可允许商用出图(需署名画风)
怎么用
- 加载 inbt_h3_v1.safetensors,权重 0.8;按官方 H3 提示词格式写,第一句放风格:[Shot 1] 2D-animated in the inbtsint style, a medium shot at eye level...
- 不要再描述线条、阴影、anime 等画法(触发词已负责);每个角色的发型、眼睛、肤色、纹身、服装都要写全
- 作者测试环境:ComfyUI 里 MiniMax H3 FL2VA pruned int8 ConvRot 文生视频,20 步,res_multistep + simple,768x1344 或 1344x768,5 秒;训练底模是 FL2VA pruned
风险与限制
- 权重拉到 1.0 时线条变重,并会在脸上画出没要求的记号(额头十字、太阳穴划痕),作者因此建议 0.8
- 背景文字会变成乱码字形,作者说明这是 H3 本身的问题,与 LoRA 无关
- 禁止转载,也禁止用它的出图训练其他模型(需先征得作者同意);1 个敏感级示例已隐藏;本条未运行
触发词:inbtsint
【S】Minimax H3: t2va (T2V) – Polyhedron: Better Hair · v1.0
LoRA · 新模型 · 作者 Polyhedron_AI · 发布 11-06 01:41 · 下载 197
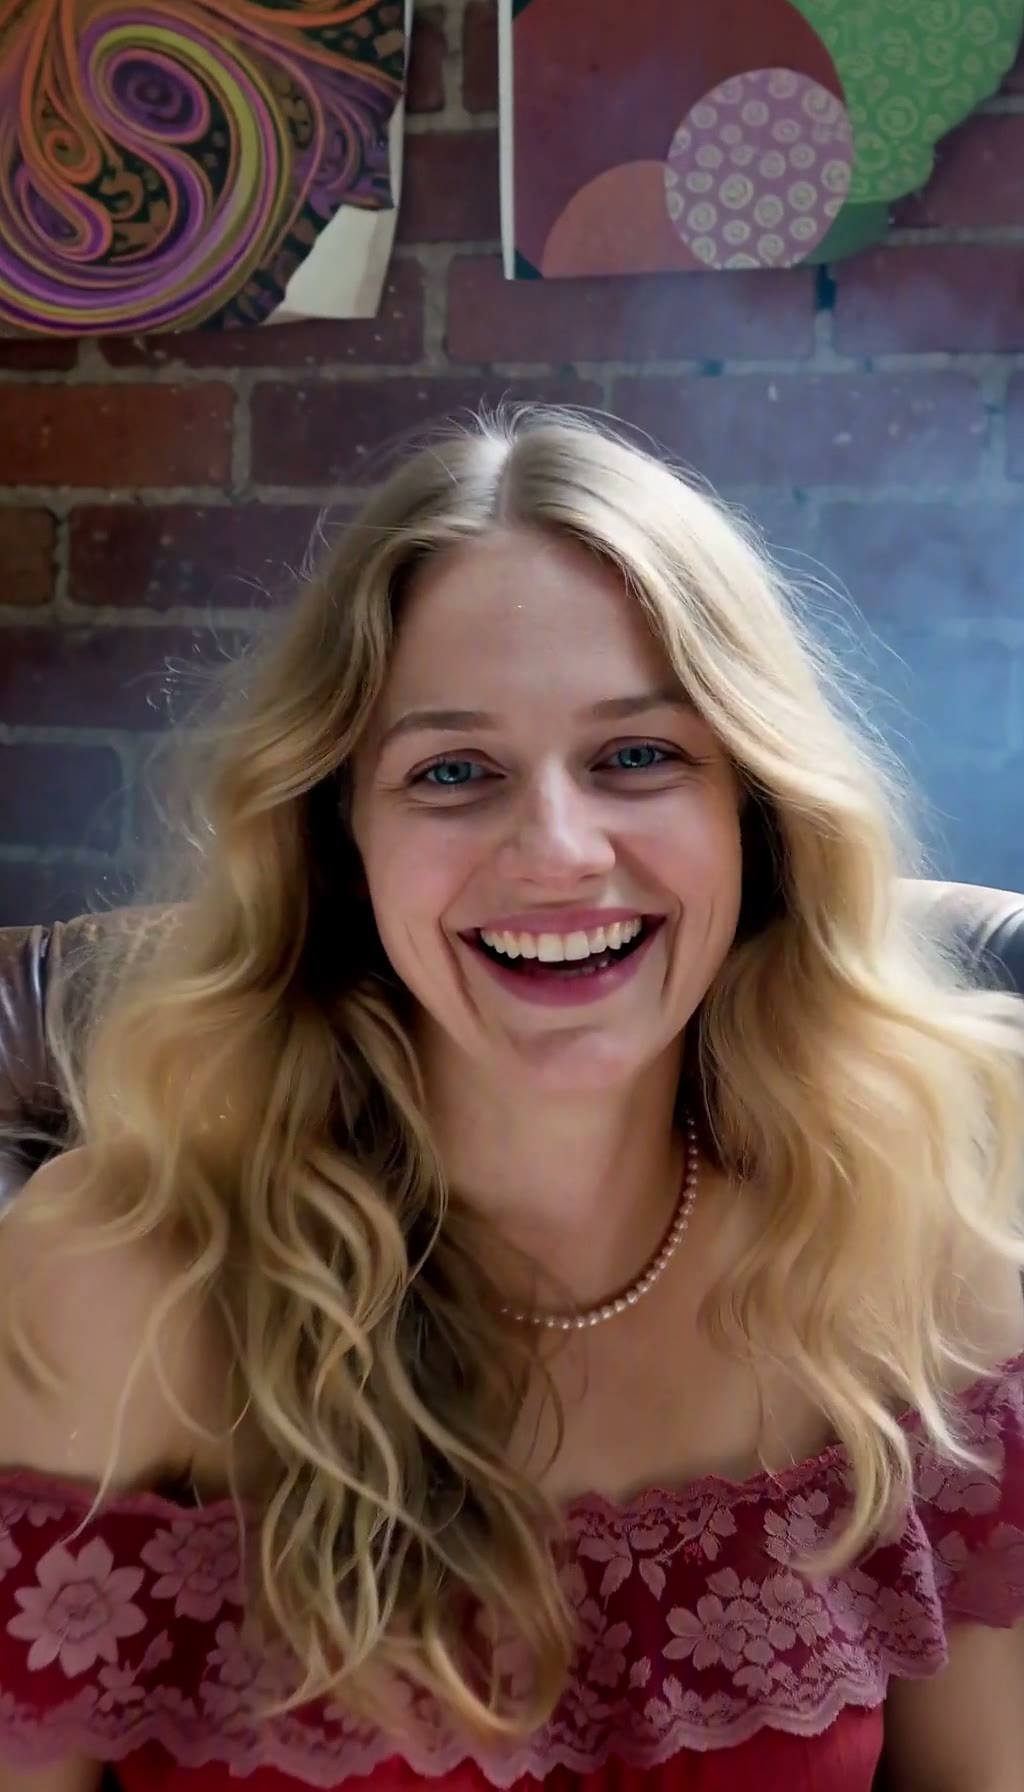
修 H3 头发的 LoRA:作者说 H3 生成的头发常有毛躁、噼啪碎裂似的纹理,这条 LoRA 调整整体发丝结构把这种感觉去掉;作者自己说是“更好”而不是“完美”。
可以拿同一提示词、同一种子做 0 / 0.6 / 0.7 三档对照,看发丝毛躁是否减少。
配图
推荐理由
- 服务文生视频(模型名标 t2va)里人物头发的质感问题,属于通用修复型 LoRA,可以和角色、风格 LoRA 一起用
- 触发词和强度都给了:ha8ir,强度 0.6–0.7;作者另登记了 perfect hair、thick hair、airy volume、natural waves 等发质描述词
- 附 3 段示例视频;免费下载;发布 7 小时 197 次下载,关注度是本期最高之一
怎么用
- 加载 polyhedron_minimax_h3_image_lora__hair_ha8ir.safetensors,强度 0.6–0.7,提示词写 ha8ir,可再加 thick hair、natural waves、soft flyaways 等描述
- 单独使用最稳;步数、CFG 作者未给,作者的四个配套工作流在其 Patreon 上,叠加 LoRA 可配合作者在 GitHub 的 ComfyUI-PolyhedronLoRAStack 节点
风险与限制
- 作者明说同时叠多个 LoRA 时情况会变复杂,效果不保证
- 许可不允许商用;文件名带 image_lora,训练素材可能是图片而非视频,作者未说明;1 个敏感级示例已隐藏;本条未运行
触发词:ha8ir、perfect hair、thick hair、airy volume、natural waves、soft flyaways、hair subsurface scattering
推荐(3)
【A】Pika H3 Flex Reference Workflow | Direct Movie Scenes With Sound From Your Pictures | 6 Steps | ComfyUI · v1.0
工作流 · 新模型 · 作者 TheLocalLab · 发布 11-06 00:34 · 下载 63
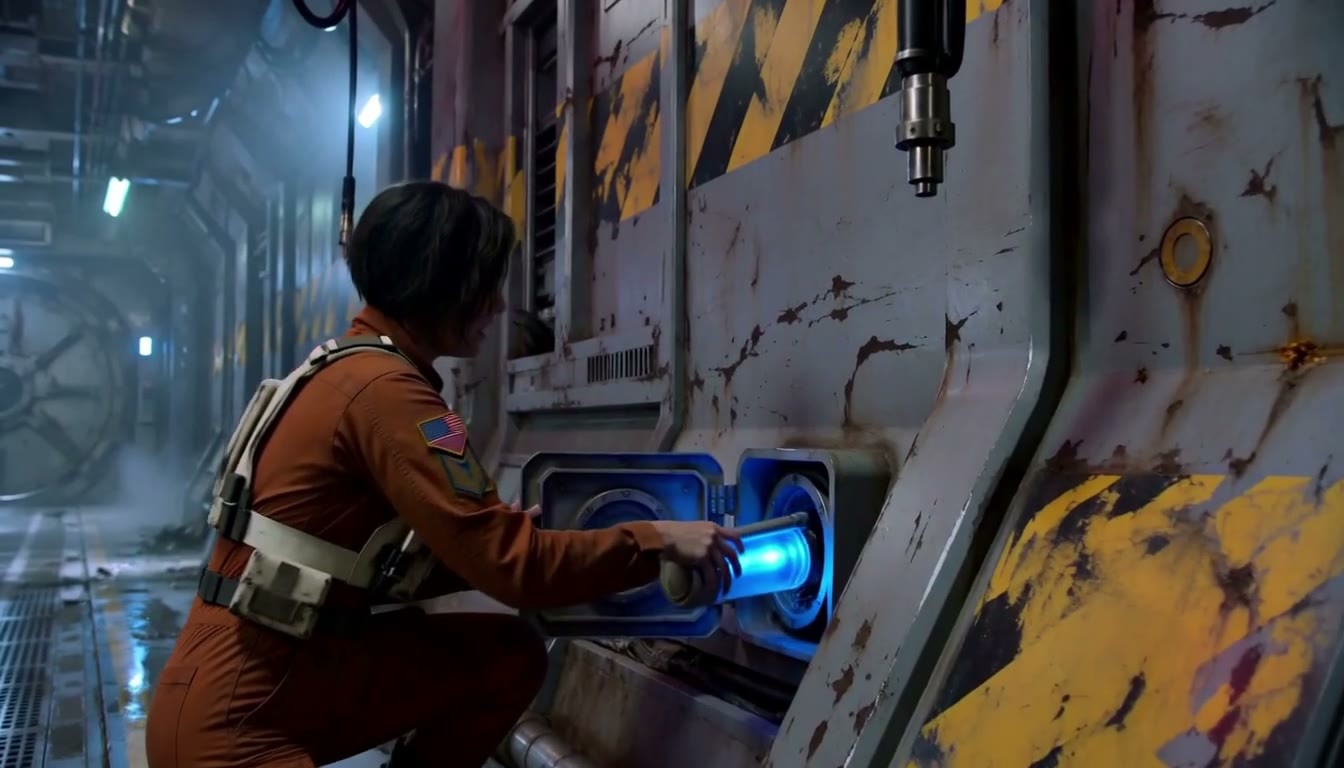
一个 ComfyUI 工作流:用 1–3 张自己的图片作参考,在本地用 Pika H3 Flex(Pika Labs 基于 H3 开放权重的参考图适配器)6 步出带镜头运动、对白、音效和配乐的短片,加了 VSA 加速门和可选的 Semantic Bridge 开关。
配图
推荐理由
- 服务参考图生视频(Ref2VA)和首帧生视频:每张参考图一个分组,也可切到 First Frame Mode 从一张图起步;输出带音频的视频,另有 2x RTX 放大输出
- 串了 H3 Ref2VA int8 主模型、qwen3vl 32b 文本编码器、视频 / 音频 VAE、pika_h3_flex_ref2va 适配器、fasth3_vsa_gate 加速门、Semantic Bridge,以及 Ref2VA VSA、Semantic Bridge、Memory Cleanup、RTX、KJNodes、rgthree、VideoHelperSuite 节点,图内备注列了每个模型链接
- 参数已预设:lcm 采样器、Pika 的六个手动 sigma、CFG 1、适配器强度 1、gate sparsity 0.75;作者给了 RTX A4500(20 GB)上的耗时:0.6 MP(1056x608)5 秒片段采样 1:43,关掉加速门 2:11
- 附提示词写法建议:每段一个地点一个完整小故事、按画面位置写方位、每个镜头写机位、把因果写出来、多参考图时各自定义
怎么用
- 下载 Pika-H3-Flex-References-SemanticBridge.json,按图内备注下载模型并放到 diffusion_models / text_encoders / vae / loras 和新建的 models/semantic_bridge 目录,缺的节点用 ComfyUI Manager 补装
- 保持预设参数,记忆清理节点保持开启;先跑短片段测试提示词。Semantic Bridge 作者在情景喜剧测试里发现开着画面更好、关着声音更好,两种都试
风险与限制
- 依赖很重:作者统计模型合计约 48 GB,要求 CUDA 13(cu130)版 PyTorch、580 以上 NVIDIA 驱动和较新的 ComfyUI(作者测试 0.44.0)
- 显存门槛:20 GB 卡上 0.8 MP 15 秒会爆显存,三张参考图 1344x768 15 秒要 24 GB 卡;16 / 12 GB 是作者在 20 GB 卡上限制显存模拟的,15 秒片段峰值约 17 GB,建议从短片段开始
- Semantic Bridge 的作者在 v1 里把参考图工作流列为不支持,并提醒参考音频口型同步有问题;Pika H3 Flex 与 H3 走 MiniMax H3 社区许可,商用前要读许可
- 只有 1 段可见示例视频,另有 3 个敏感级示例隐藏;本条未运行
【A】Minimax H3 SEED HUNTER - Latent Upscaler, Seamless Video Continuation, Dialogue Gen Tool, Speedups, Ref Mods · v3.0
工作流 · 版本更新 · 作者 foxydits · 发布 11-06 07:57 · 下载 55
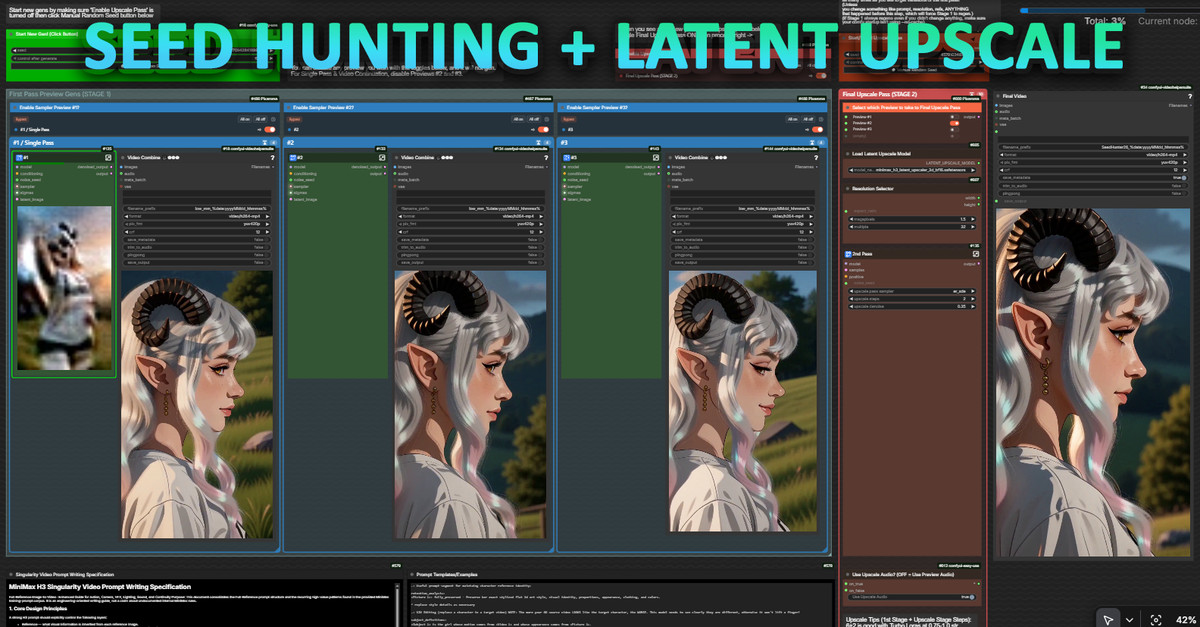
Seed Hunter v3.0:先一次出 3 个低分辨率预览、挑中满意的种子再放大定稿的“抽种子”工作流,这一版换用 ComfyUI 内置的 latent 放大器,并加了帧提取、动画抽帧、双提示词编辑器等选项。
配图
推荐理由
- 版本更新:改用 Kijai 做的、ComfyUI 0.44 内置的 Latent Upscaler(作者称更快并解决了显存尖峰导致的 OOM),因此必须升级到 0.44
- 新增:首 / 尾帧另存到 output/saved_frames/;Anime Cadence 动画抽帧,让 2D 动画的动作节奏更像传统动画;最终输出可改用预览片的音频;第二个提示词编辑器可边跑边写下一条;提示词自动存到 output/prompts/
- 流程本身覆盖无缝续写、自定义音频、24 FPS 插帧到 48-60、对白 / 声音克隆工具;整个模型页累计 39146 次下载、1111 赞、307 条评论,关注度高
怎么用
- 升级 ComfyUI 到 0.44 后导入 FoxFurEssence H3 Seed Hunter v3.json;下载作者指定的 minimax_h3_latent_upscaler 放进 latent_upscale_models 目录
- 节点:Anime Cadence、Pixaroma、Prompt IDE、MiniMaxH3-PromptBuilder、RefMods 等,多数在 Comfy Registry 可装;加速可配作者推荐的 Silveroxide Dareties turbo LoRA 和 Kijai 的 int8 视频 VAE
风险与限制
- v3.0 使用说明作者标注“即将发布”,现有指南是 v2.5 的;依赖节点多,需逐个核对
- 只有 2 张可见图片示例,5 个敏感级示例隐藏,没有可见视频;本条未运行
【A】MiniMax H3 long take: one 40-50 s shot from chained segments (12 GB) · v1 (12 GB tested)
工作流 · 新模型 · 作者 semenovsas776 · 发布 11-06 04:32 · 下载 55
一套把 4-6 秒的 H3 片段串成 40-50 秒连续长镜头的工作流 + 脚本包,作者在 RTX 4070 SUPER 12 GB 上完成;作者称脸、服装和色彩能保持到最后,接缝看不出来。
本期最完整的长镜头方案:工作流、提示词规划和质检脚本一起给,适合想做一镜到底对话戏的人先读文章再上手。
配图
推荐理由
- 解决 H3 单段时长有限、拼接易跳变的长视频问题:每段从上一段的 latent 尾部续写(FeiHou Easy H3 的接续模式,22+22 帧),第 2 段起用参考模式带上人脸参考图和开场图,每段文本重复完整服装并按状态描述道具
- 压缩包内容齐:第 1 段和第 N 段的 UI 工作流(内含设置说明)、对应的 API 格式图、规划用系统提示词(贴进任意聊天助手生成各段文本)和咖啡馆场景的分镜计划,以及计划检查、通过 ComfyUI API 批量跑链、接缝 / 卡帧检测、人脸相似度、审片表等脚本
- 作者给了耗时:4070 SUPER + 96 GB 内存,第 1 段约 1.5 分钟,之后每段 2.5-3.5 分钟;完整方法另有文章(civitai.com/articles/38141)
怎么用
- 需要 ComfyUI + FeiHou Easy H3、FeiHou Toolbox、KJNodes,MiniMax H3 Remix v0.8 模型,Comfy-Org/MiniMax-H3 的文本编码器和 VAE,以及 H3 latent 放大器;只有在第一帧换脸时才需要 ReActor
- 先用规划提示词让聊天助手写出各段文本,跑第 1 段,再用第 N 段工作流逐段续写,或用附带脚本通过 API 自动跑整条链
风险与限制
- 两段示例视频(同一咖啡馆场景的写实版和漫画版)都被标为敏感级隐藏,看不到实际接缝效果,等级凭文档给出
- 主模型用的是 MiniMax H3 Remix v0.8 而非官方权重,换模型后能否同样衔接作者未说明;本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
可关注(5)
【B】Minimax.. simple · v5.1
工作流 · 版本更新 · 作者 sy0ww4bb1984 · 发布 11-06 03:10 · 下载 35
“Minimax.. simple”大型参考图生视频 + 分段延长 + 放大工作流的 v5.1:新增视频参考选项、视频换人(video to video replace)的操作说明、放大用的直通(passthrough),并重新加回 kitchen attention。
配图
推荐理由
- 版本更新:相比 v5 加了视频参考输入和 vid2vid 替换说明;作者在页面上说 v5.1 一度必须有视频参考才能出片,随后的 5.11 已修复(下载文件名为 minimaxv5.11.zip)
- 整个流程串了参考图生视频(多图、多段音频参考)、按帧数分批延长并同步音频、RTX / latent / resize 三种放大,每批可换 LoRA、提示词、种子和参考;模型页累计 2860 次下载
- 作者列了配套的蒸馏和放大 LoRA 来源:Kijai 的 MiniMax-H3-experimental、Comfy-Org 的 loras、Pika-H3-Flex-Turbo-LoRA
怎么用
- 下载 minimaxv5.11.zip 解压导入 ComfyUI;作者参数提示:LoRA 强度 0.4-1.0,片段按帧数而非秒数设定,单批最多 300 frames at 1MP,可选 Beta57 8 / 6 / 4 步 sigma
- 放大建议用 2x 倍率(作者称非整倍数会拉伸画面);记忆节点需要把独立的音视频 latent 保持开启并放在分组外
风险与限制
- 更新说明零散:v5.1 与 5.11 混写在一起,kitchen attention 是什么、视频参考怎么接没有展开
- 作者自称只有一台中端电脑、很难测全这个大流程,ComfyUI 更新经常弄坏它;依赖的节点和模型需自行核对
- 只有 1 张可见图片示例,4 个敏感级示例隐藏,没有可见视频;本条未运行
【B】Lonecat’s MiniMax H3 FL2VA/ REF2VA | 低显存视频工作流 w/ Low VRAM Optimizers, Upscaler, & Post Production · V9.0 Faster & Better
工作流 · 版本更新 · 作者 lonecatone23 · 发布 11-06 08:04 · 下载 14
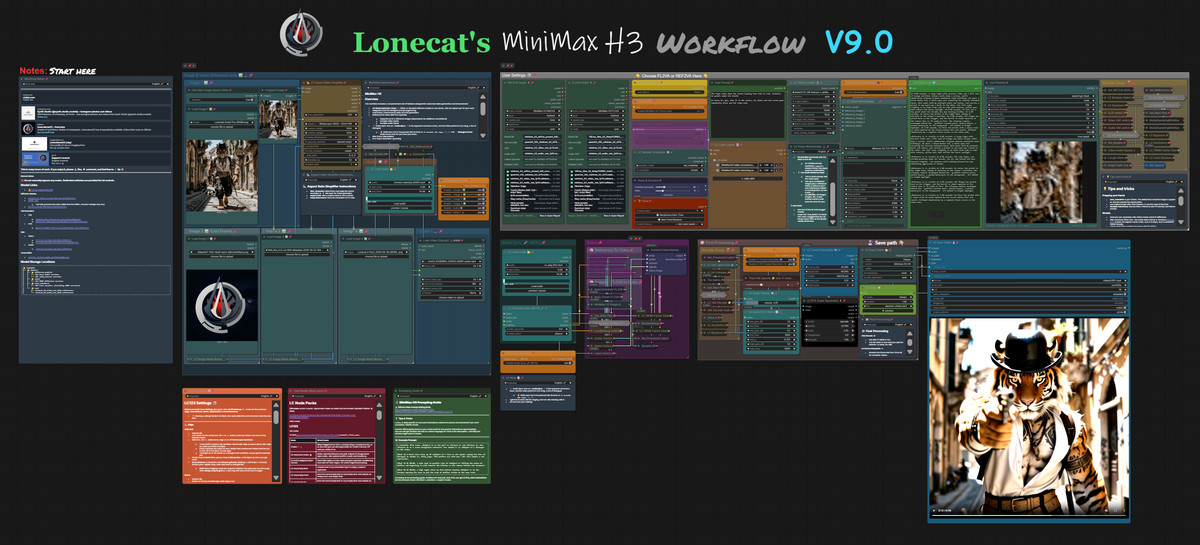
Lonecat 的 H3 首尾帧 / 参考图生视频大工作流 V9.0:唯一写明的改动是去掉 Ultimate Upscale,换成作者在做另一个工作流时测出的放大方法。
配图
推荐理由
- 版本更新:作者称测了很多放大方法后发现大家的做法多数有问题,于是移除 Ultimate Upscale,作者称成品更好,但具体换成什么方法写在外链里,模型页没有展开
- 流程本身支持首尾帧(FLF2V)和参考图(REF2V,最多 4 张参考图)、视频和音频输入、作者自制的 LC Vision 看图写提示词、RIFE 插帧、RTX 超分,以及 GGUF 模型;图内备注有中文
- 免费;整个模型页累计 5301 次下载、207 赞
怎么用
- 导入 MiniMax H3 Ver 9.0 (1).json;作者刚更新了自己的节点包,报错时从作者 GitHub(lonecatone23)手动下载
- 作者说明这是进阶工作流,不面向新手;新手可用作者另一个简化版工作流。步数、显存要求作者未给
风险与限制
- 更新说明只有一句,放大方法的细节在站外链接,模型页无法核对
- 依赖作者自己的多个节点包;只有 1 张可见图片示例,2 个敏感级示例隐藏;本条未运行
【B】Easy MH3 (video generation + upscale using chunking + 60 FPS) · v1.0
工作流 · 新模型 · 作者 Crimson009 · 发布 11-05 23:15 · 下载 67
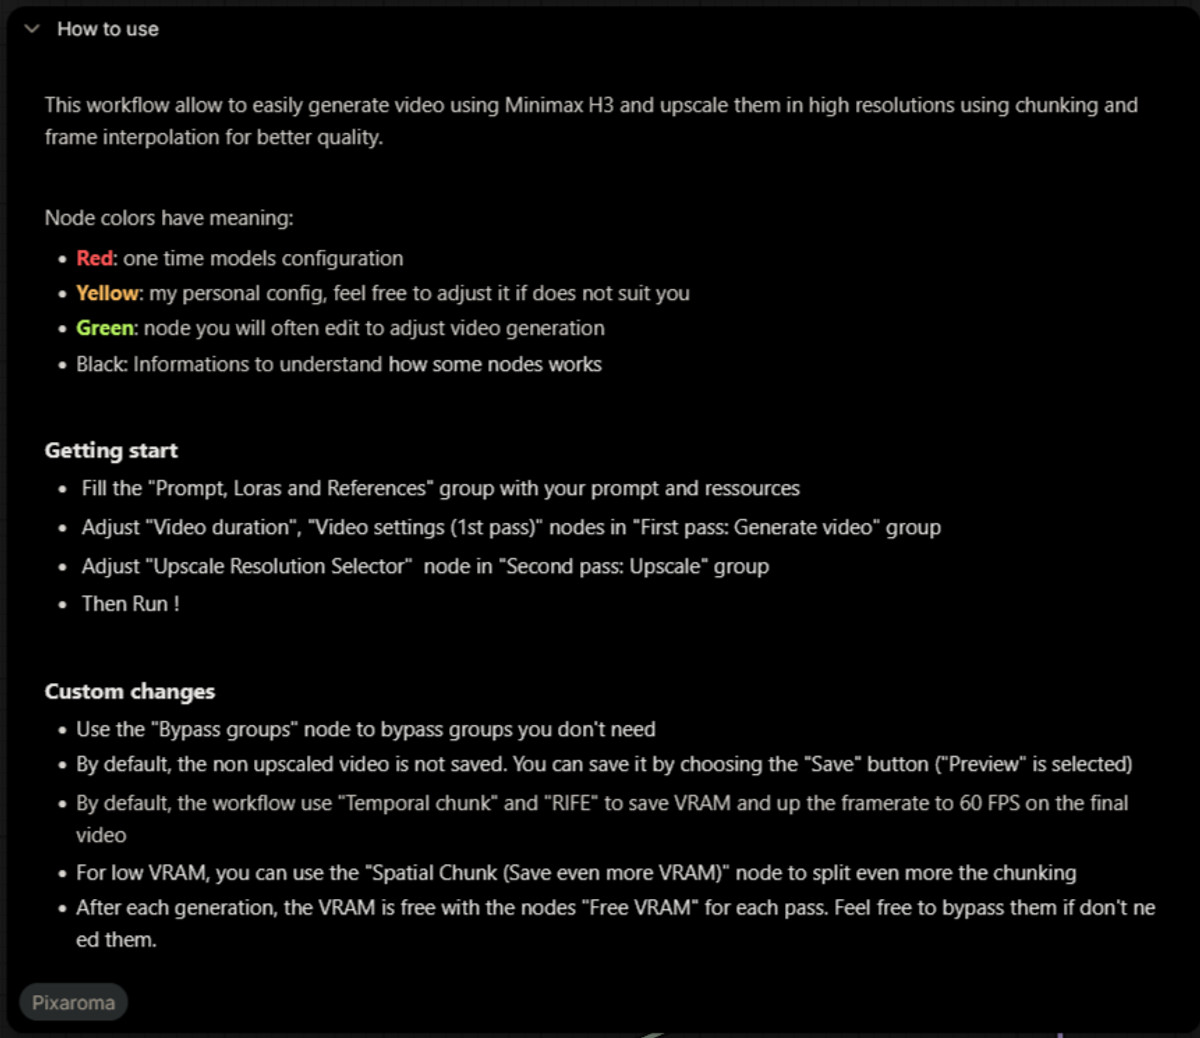
一个两遍式的 H3 工作流:第一遍生成视频,第二遍用时间分块(Temporal chunk)放大到高分辨率,再用 RIFE 插帧到 60 FPS,主打省显存、上手简单。
配图
推荐理由
- 服务想要高分辨率、高帧率成片但显存有限的场景:默认时间分块 + RIFE,显存更低时可改用 Spatial Chunk 空间分块进一步切小,每遍结束有 Free VRAM 节点释放显存
- 节点按颜色区分用途:红色是一次性模型配置,黄色是作者个人设置,绿色是常改的生成参数,黑色是说明
- 操作步骤写清楚:填“Prompt, Loras and References”组,调视频时长和第一遍设置,再选放大分辨率后运行;不需要的组用“Bypass groups”节点关掉
怎么用
- 导入 Easy_MMH3_2pass_chunked_RIFE_upscale_V1.json,按上面顺序填写;未放大的视频默认只预览不保存,需要时把 Preview 改成 Save
- 需要哪些模型、节点、步数和显存作者未给
风险与限制
- 没有列出依赖的模型和自定义节点,只能导入后看缺什么
- 只有 1 张可见图片示例,2 个敏感级示例隐藏,没有可见视频,放大效果无法核对;本条未运行
【B】Prophetero Test Bench + Take Compare GLOBAL · v0.4
工作流 · 新模型 · 作者 Prophetero · 发布 11-05 22:09 · 下载 19
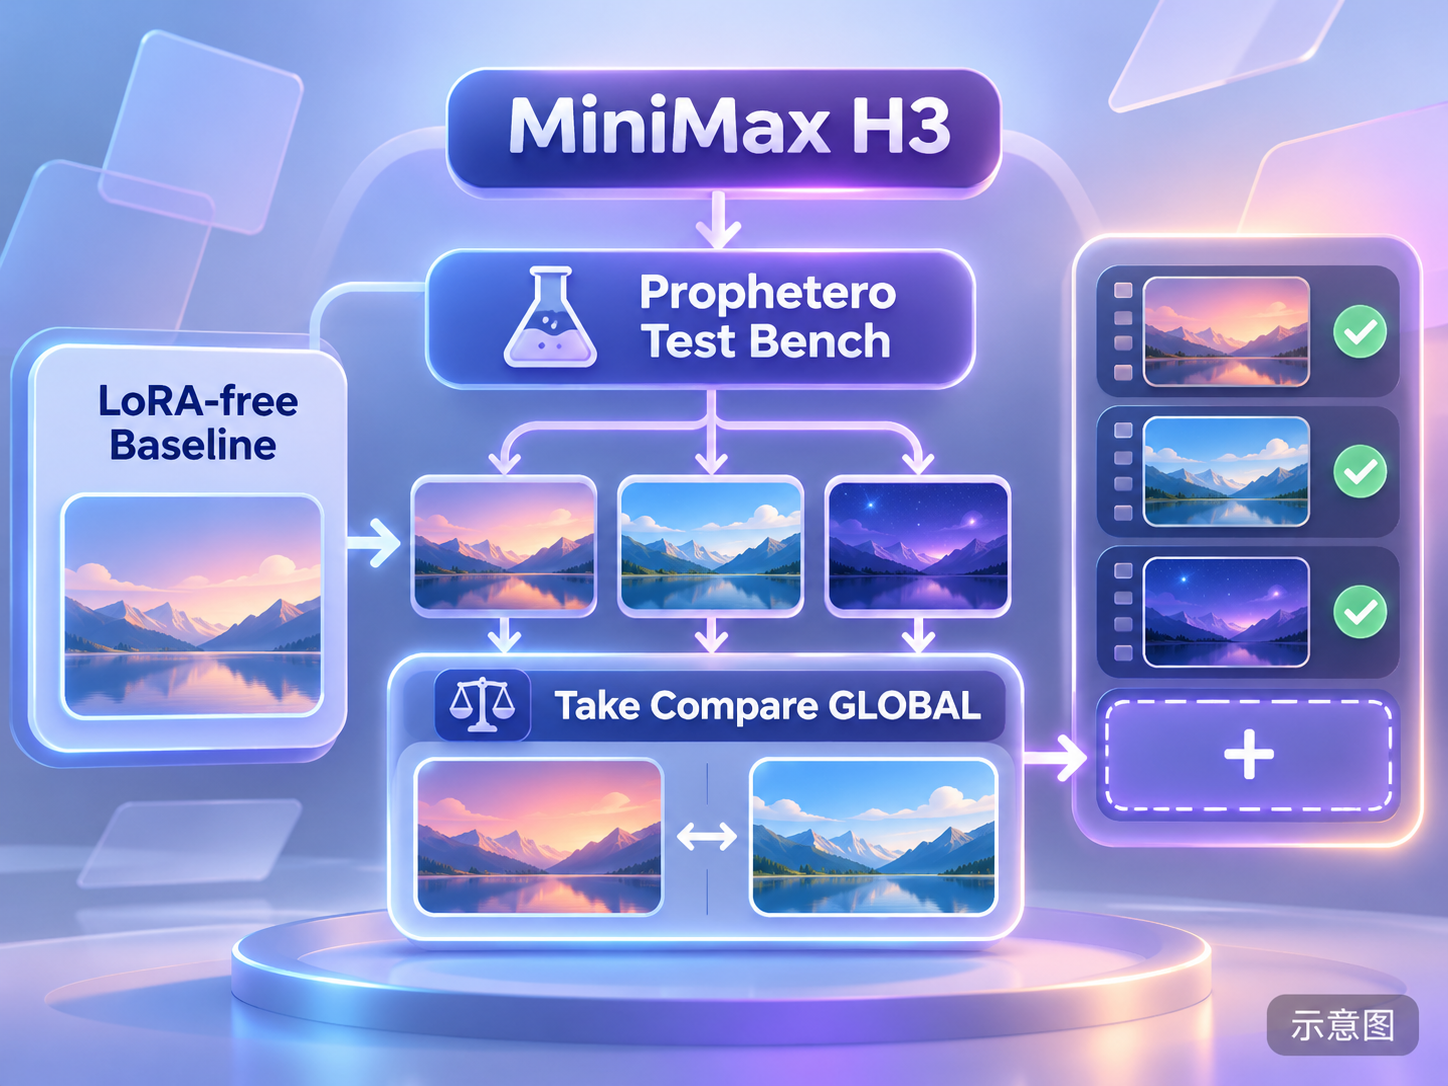
一个装进 ComfyUI 的测试与对比工具(Test Bench + Take Compare,公测版):同一工作流先跑无 LoRA 基线和多组 LoRA 组合的短片试跑,在同一页并排对比画面、动作和音频,再把选中那组设置一键转成全长渲染或导出工作流。
配图
推荐理由
- 解决调 LoRA 组合时反复切标签页、记不住参数的流程问题:每张样本卡可搜索 LoRA、单独设开关和强度并显示保存的设置;能识别 H3 / LTX 时长控件自动缩短试跑,已完成的试跑新增实验时不会重跑
- Take Compare 最多同时比四段,支持逐帧、时间偏移、联动缩放、备注标记、0.25x–2x 播放速度;可看原始音轨的单 / 双声道波形和峰值 / RMS 电平
- 支持 Power Lora Loader(rgthree)、LoraLoader、LoraLoaderModelOnly,输出节点支持 SaveVideo 和 VHS_VideoCombine;界面有八种语言
怎么用
- 解压整个 ZIP,停掉后端,运行 START_HERE.cmd 并选择实际使用的 ComfyUI 后端,重启 SwarmUI / ComfyUI 并刷新浏览器;打开能正常出片的工作流,在空白画布右键选 Prophetero · Test Bench + Take Compare
- 对比限制:单段 0.5–120 秒、1–60 FPS、最多 8 MP 和 2 GiB
风险与限制
- 公测版,作者说明测试时推理是模拟的,不保证兼容所有真实模型和自定义节点;短试跑成功不代表全长渲染能成功
- 不是普通工作流 JSON,而是带 Windows 安装脚本的插件包,安装前应先看包内文件;许可禁止出售该软件
- 只有 1 个敏感级示例且已隐藏,没有可见示例;本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【B】H3: Authentic texture and award-winning, master-class acting. · v1.0
LoRA · 新模型 · 作者 TuTu_1018 · 发布 11-05 21:29 · 下载 254
“真实质感影帝演技”LoRA:作者称强化人物面部细节、微表情、眼神变化和情绪表达,让对话、情绪戏和文戏里的人物更像在演戏而不是机械动作。
配图
推荐理由
- 服务写实人物的对白戏、情绪特写这类文生视频 / 图生视频,方向是表演质感而不是某个角色或画风
- 发布约半天 254 次下载、21 赞,是本期下载最多的版本,但只说明关注度
- 作者在 RunningHub 上放了同名在线工作流(链接带邀请码)
怎么用
- 加载 H3真实质感影帝表演lora.safetensors;触发词作者未登记,强度、步数作者未给
风险与限制
- 模型卡只有宣传性描述,没有训练信息、参数和对比;唯一的示例为敏感级已隐藏,看不到实际表演效果
- 说明重复了两遍,主要是引流到站外平台;本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
仅收录(7)
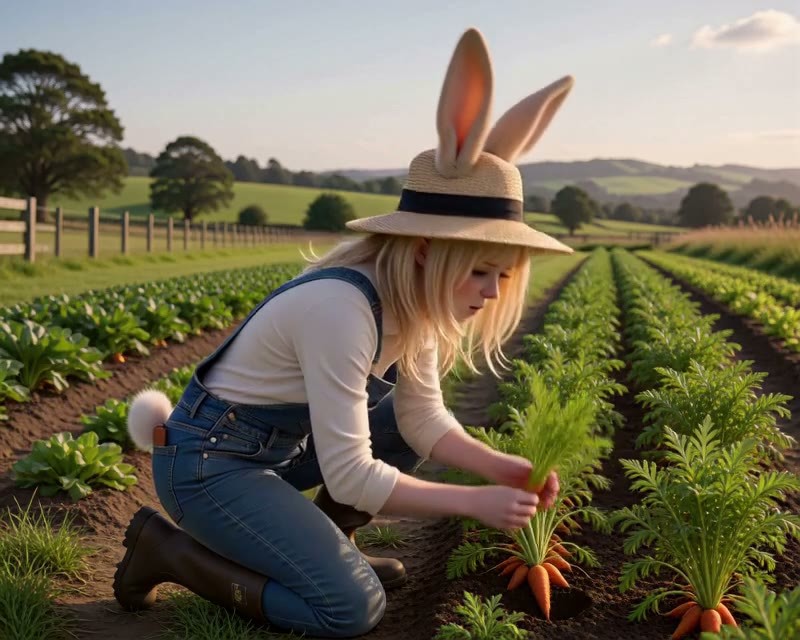
- Bonnie Rabbit · v1.0 H3 — LoRA:作者原创的兔耳女孩角色 Bonnie Rabbit(新西兰乡下的胡萝卜农场主)的 H3 版角色 LoRA,触发词 bonnielora。
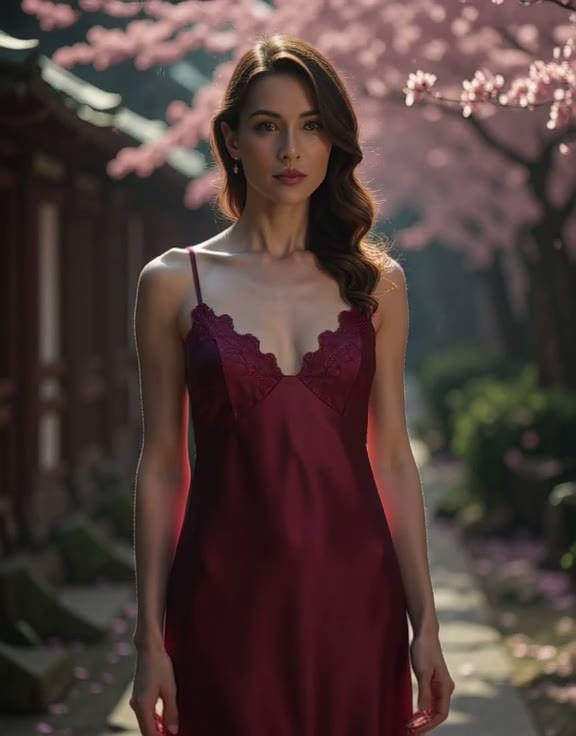
- Nevaeh Belwyn · MiniMaxH3 — LoRA:虚构女性角色 Nevaeh Belwyn(布鲁日的古籍档案员,复古羊毛与古董蕾丝装扮)的 H3 版角色 LoRA,作者称不是真人。
- Looney Red Riding Hood :: MMH3 Character · v1.0 — LoRA:黑暗童话版小红帽角色 LoRA(龇牙狂笑、金发、破旧红斗篷),用画师 @phatestronaught 的角色设计和画风图训练,面向文生视频。
- Sam Bramblepot · v1.0 H3 — LoRA:作者原创的侏儒园丁角色 Sam Bramblepot 的 H3 版角色 LoRA,触发词 samlora。
- Nox · v1.0 H3 — LoRA:作者原创的“活影子”女性角色 Nox(皮肤黑到吞光、银色眼睛)的 H3 版角色 LoRA,触发词 noxlora。
- Flat Lindsay · v1.0 H3 — LoRA:作者原创角色 Flat Lindsay 的 H3 版 LoRA:一个“纸片人”女孩,正面看像描边插画,侧过身几乎消失,却在三维世界里正常生活。
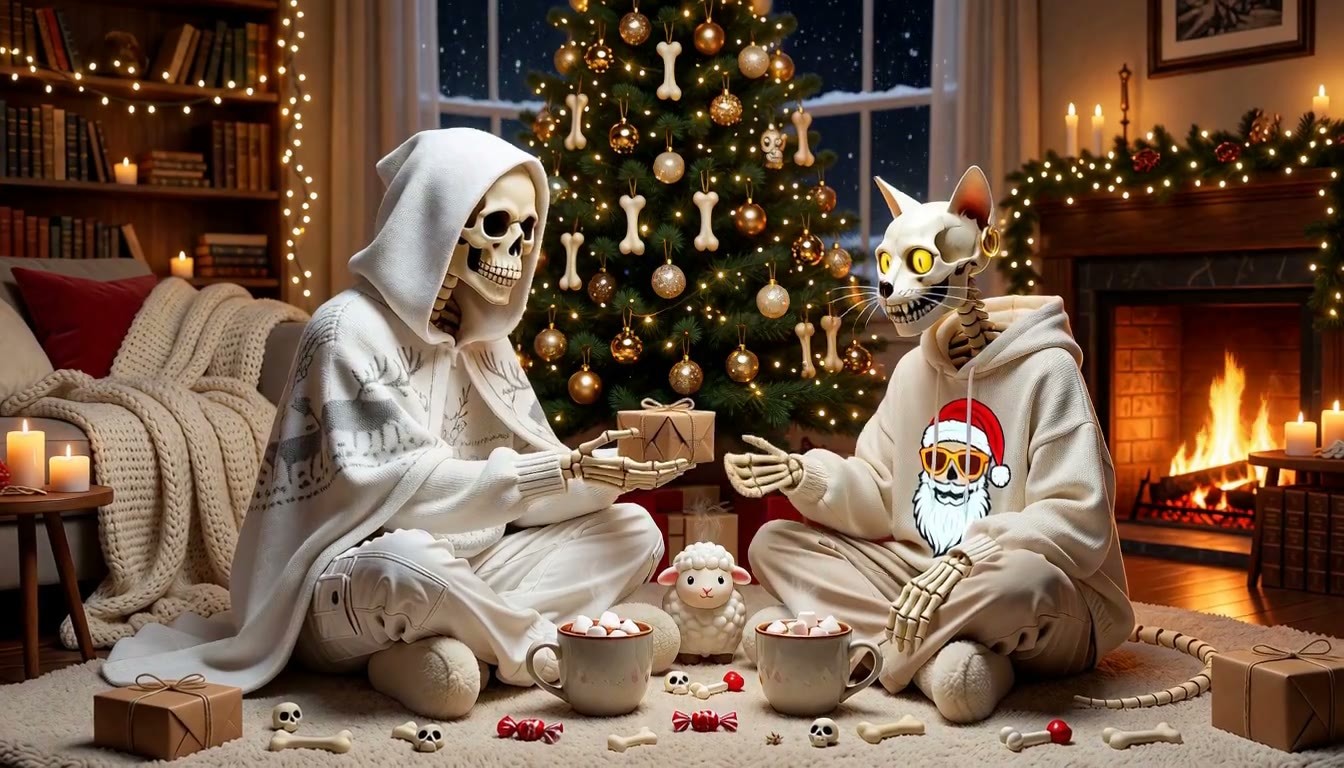
- 🎄LORU & RIBS: CHRISTMAS BONE DANCE · v1 — LoRA:圣诞主题的双角色 LoRA:白兜帽死神 Loru 和它的骷髅猫 Ribs 在壁炉旁喝热可可、冰上滑冰、交换礼物,作者称擅长针织衣物质感、骨骼结构和魔法光效。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-05 20:31 → 11-06 09:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。