Radar AI của Trinh Trinh · MiniMax H3 · Bản tin buổi sáng 2026-11-06
Kỳ này có 17 phiên bản mới: Đề xuất mạnh mẽ 2 · Đề xuất 3 · Đáng chú ý 5 · Chỉ ghi nhận 7
Lời bình của biên tập viên Kỳ này đã xem xét 17 phiên bản mới của H3. Đề xuất hàng đầu là LoRA phong cách hoạt hình Cel của INBT: thống nhất phong cách hoạt hình thường dao động không ổn định của H3 thành phong cách Cel với đường viền mực và bóng đổ phẳng, bao gồm đầy đủ từ khóa kích hoạt, trọng số, cấu trúc prompt và cài đặt lấy mẫu, kèm theo 6 đoạn video mẫu; Better Hair loại bỏ cảm giác tóc rối và vỡ vụn của H3, cũng được xếp hạng S. Các điểm nổi bật khác bao gồm quy trình làm việc tạo video từ ảnh tham khảo của Pika H3 Flex, Seed Hunter v3 và một quy trình ghép nối dài cảnh quay có thể chạy trên card đồ họa 12 GB (ví dụ bị ẩn, xếp hạng A dựa trên tài liệu). Các bản cập nhật của Minimax.. simple v5.1 và Lonecat V9.0 có phạm vi nhỏ hoặc mô tả rời rạc, Easy MH3 thiếu danh sách phụ thuộc, bị hạ xuống hạng B; sáu LoRA nhân vật thông thường không có tham số, hầu hết không có ví dụ hiển thị, bị hạ xuống hạng C.
Đề xuất mạnh mẽ (2)
【S】INBT Cel Style - MiniMax H3 · H3 V1
LoRA · Mô hình mới · Tác giả AriaMaiven · Phát hành 11-06 05:49 · Tải xuống 54
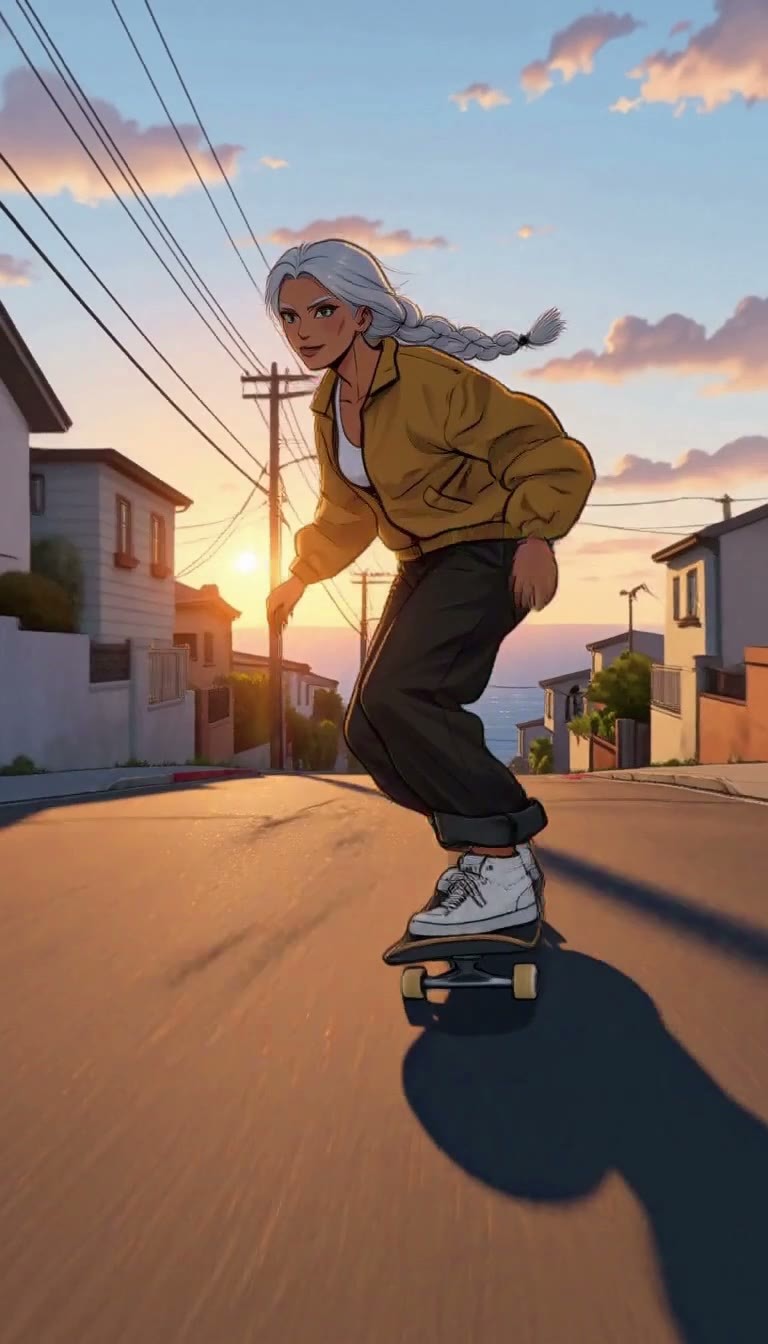
Một LoRA phong cách hoạt hình Cel: đường viền mực chắc chắn, bóng đổ phẳng, bảng màu neon trong đêm mưa, thống nhất phong cách hoạt hình của H3 vốn thường dao động giữa hoạt hình Mỹ và truyện tranh Hàn Quốc thành một phong cách duy nhất, tác giả cho biết phong cách giữ nguyên khi máy quay di chuyển và khi nhân vật nói chuyện hoặc hát.
Hiếm thấy trong các LoRA phong cách, mô tả này ghi rõ sự phân công prompt là "không mô tả kỹ thuật vẽ, mà mô tả nhân vật", chỉ cần viết theo mẫu câu đầu tiên của nó là có thể tái tạo.
Hình ảnh minh họa
Lý do đề xuất
- Dịch vụ tạo video từ văn bản cho các phim ngắn hoạt hình 2D, MV và cảnh đối thoại: tác giả cho biết khả năng duy trì phong cách vẽ khi thể hiện hai nhân vật trong một cảnh quay, đồng bộ khẩu hình khi đối thoại và hát, cảnh đường phố vắng người, cũng như bối cảnh hoàng hôn và ánh đèn neon
- Phong cách vẽ không có khuôn mặt cố định, viết tên ai vào prompt thì vẽ người đó, có thể áp dụng phong cách này cho nhân vật của riêng bạn
- Hướng dẫn sử dụng được trình bày đầy đủ: cung cấp từ khóa kích hoạt, trọng số, mẫu câu mở đầu cho prompt, bộ lấy mẫu (sampler), bộ lập lịch (scheduler), số bước, độ phân giải, thời lượng và mô hình nền tảng để huấn luyện; kèm theo 6 đoạn video mẫu
- Tải xuống miễn phí, giấy phép cho phép sử dụng hình ảnh cho mục đích thương mại (yêu cầu ghi công phong cách vẽ)
Cách sử dụng
- Tải inbt_h3_v1.safetensors, trọng số 0.8; viết theo định dạng prompt H3 chính thức, đặt phong cách ở câu đầu tiên: [Shot 1] 2D-animated in the inbtsint style, a medium shot at eye level...
- Không mô tả thêm các kỹ thuật vẽ như đường nét, bóng đổ, anime, v.v. (từ khóa kích hoạt đã đảm nhiệm); cần viết đầy đủ kiểu tóc, mắt, màu da, hình xăm, trang phục của từng nhân vật
- Môi trường thử nghiệm của tác giả: Tạo video từ văn bản bằng MiniMax H3 FL2VA pruned int8 ConvRot trong ComfyUI, 20 bước, res_multistep + simple, 768x1344 hoặc 1344x768, 5 giây; mô hình cơ sở huấn luyện là FL2VA pruned
Rủi ro và hạn chế
- Khi tăng trọng số lên 1.0, đường nét trở nên đậm hơn và vẽ các ký hiệu không yêu cầu trên mặt (dấu thập tự trên trán, vết xước ở thái dương), tác giả vì vậy khuyên dùng 0.8
- Văn bản trong nền sẽ biến thành các ký tự vô nghĩa, tác giả giải thích đây là vấn đề của chính H3, không liên quan đến LoRA
- Cấm sao chép, cũng cấm sử dụng hình ảnh tạo ra từ nó để huấn luyện các mô hình khác (cần sự đồng ý của tác giả trước); 1 ví dụ cấp độ nhạy cảm đã bị ẩn; mục này chưa được chạy thử
Từ khóa kích hoạt: inbtsint
【S】Minimax H3: t2va (T2V) – Polyhedron: Better Hair · v1.0
LoRA · Mô hình mới · Tác giả Polyhedron_AI · Phát hành 11-06 01:41 · Tải xuống 197
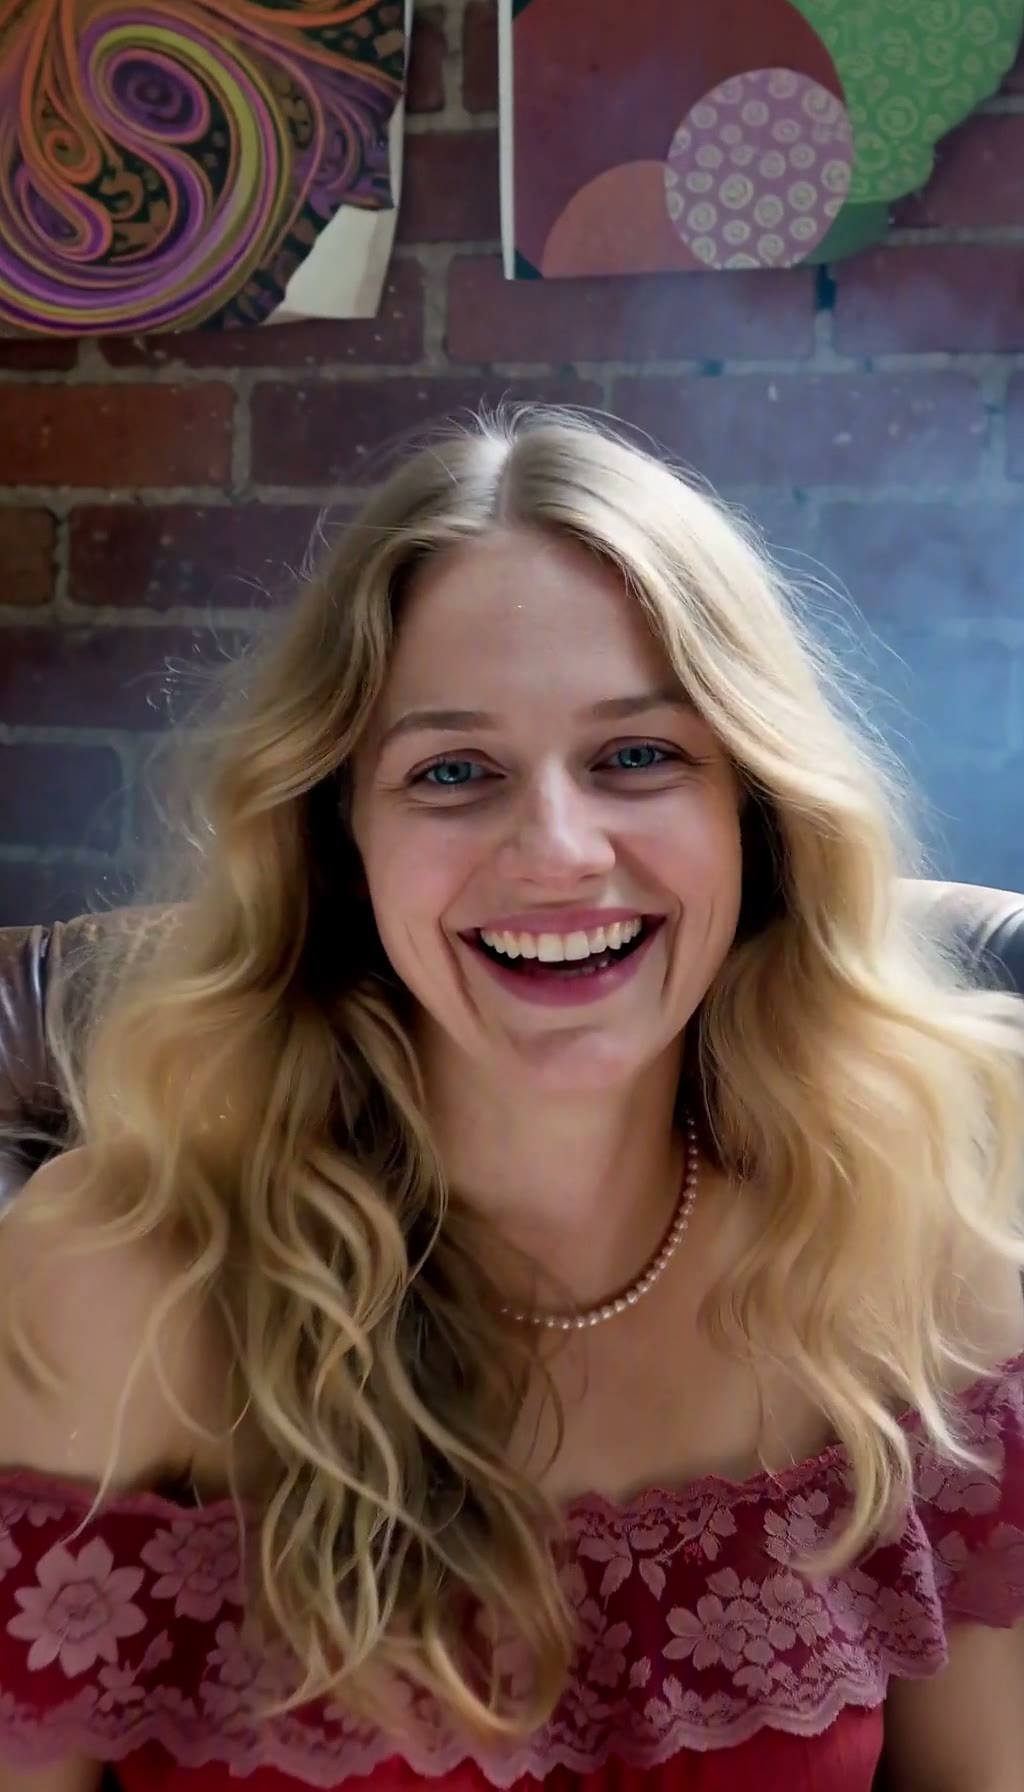
LoRA sửa tóc cho H3: tác giả nói rằng tóc do H3 tạo ra thường có kết cấu rối và vỡ vụn như tiếng nổ lách tách, LoRA này điều chỉnh cấu trúc sợi tóc tổng thể để loại bỏ cảm giác đó; tác giả tự nhận là "tốt hơn" chứ không phải "hoàn hảo".
Có thể dùng cùng một prompt, cùng một seed để so sánh ba mức 0 / 0.6 / 0.7, xem liệu độ rối của sợi tóc có giảm không.
Hình ảnh minh họa
Lý do đề xuất
- Phục vụ vấn đề chất lượng tóc nhân vật trong tạo video từ văn bản (tên mô hình ghi là t2va), thuộc loại LoRA sửa lỗi chung, có thể dùng cùng với LoRA nhân vật và phong cách
- Đã cung cấp từ khóa kích hoạt và cường độ: ha8ir, cường độ 0.6–0.7; tác giả cũng đăng ký các từ mô tả chất tóc như perfect hair, thick hair, airy volume, natural waves
- Kèm theo 3 đoạn video mẫu; tải xuống miễn phí; phát hành 7 giờ với 197 lượt tải xuống, mức độ quan tâm thuộc nhóm cao nhất kỳ này
Cách sử dụng
- Tải polyhedron_minimax_h3_image_lora__hair_ha8ir.safetensors, cường độ 0.6–0.7, viết ha8ir trong prompt, có thể thêm các mô tả như thick hair, natural waves, soft flyaways
- Ổn định nhất khi sử dụng riêng lẻ; tác giả không cung cấp số bước, CFG, bốn quy trình làm việc đi kèm của tác giả nằm trên Patreon, có thể kết hợp với nút ComfyUI-PolyhedronLoRAStack của tác giả trên GitHub khi chồng nhiều LoRA
Rủi ro và hạn chế
- Tác giả nói rõ rằng khi chồng nhiều LoRA cùng lúc, tình hình sẽ trở nên phức tạp, hiệu quả không được đảm bảo
- Giấy phép không cho phép sử dụng thương mại; tên tệp chứa image_lora, dữ liệu huấn luyện có thể là hình ảnh thay vì video, tác giả không giải thích; 1 ví dụ cấp độ nhạy cảm đã bị ẩn; mục này chưa được chạy thử
Từ khóa kích hoạt: ha8ir, perfect hair, thick hair, airy volume, natural waves, soft flyaways, hair subsurface scattering
Đề xuất (3)
【A】Pika H3 Flex Reference Workflow | Direct Movie Scenes With Sound From Your Pictures | 6 Steps | ComfyUI · v1.0
Quy trình làm việc · Mô hình mới · Tác giả TheLocalLab · Phát hành 11-06 00:34 · Tải xuống 63
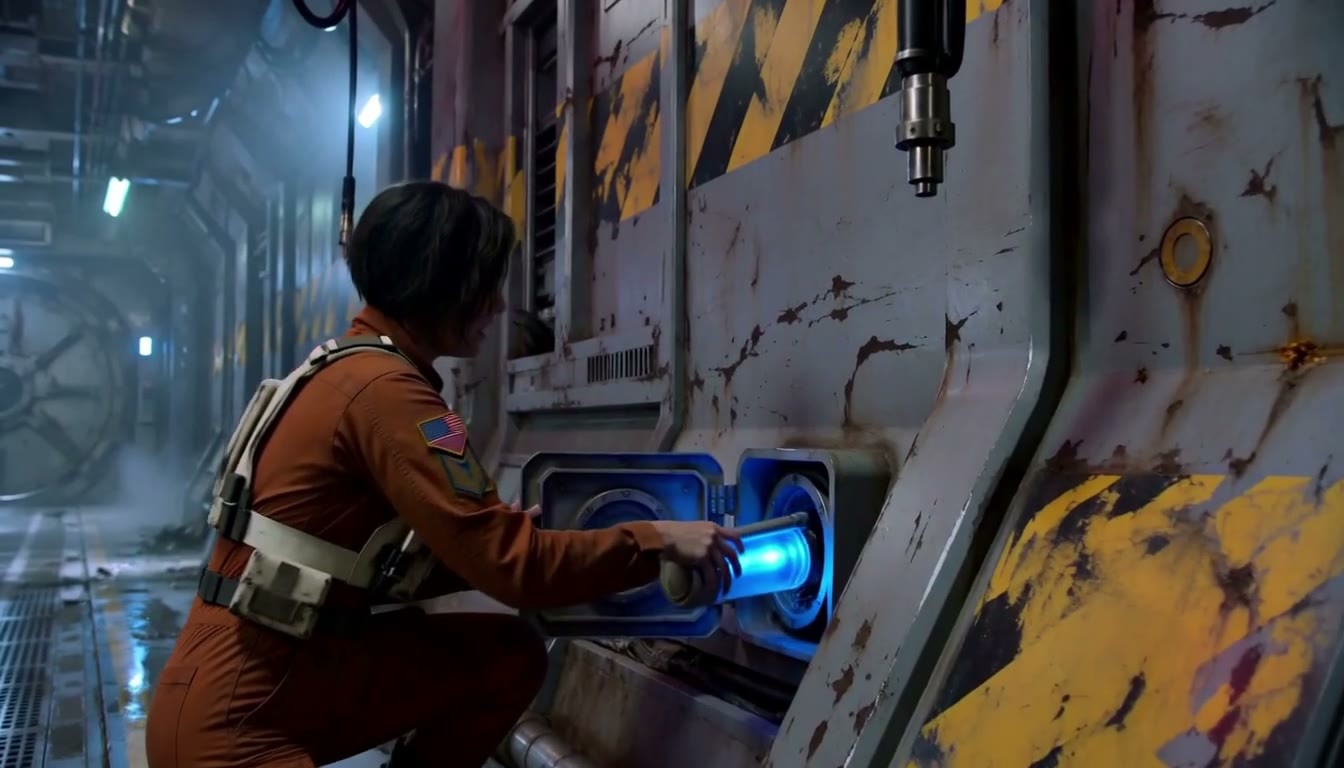
Một quy trình làm việc ComfyUI: sử dụng 1–3 hình ảnh của riêng bạn làm tham khảo, tạo video ngắn có chuyển động máy quay, đối thoại, hiệu ứng âm thanh và nhạc nền trong 6 bước bằng Pika H3 Flex (bộ thích ứng ảnh tham khảo dựa trên trọng số mở của H3 do Pika Labs phát triển) cục bộ, đã thêm cổng tăng tốc VSA và công tắc Semantic Bridge tùy chọn.
Hình ảnh minh họa
Lý do đề xuất
- Phục vụ tạo video từ ảnh tham khảo (Ref2VA) và tạo video từ khung hình đầu tiên: mỗi ảnh tham khảo là một nhóm, cũng có thể chuyển sang First Frame Mode để bắt đầu từ một hình ảnh; đầu ra là video có âm thanh, ngoài ra còn có đầu ra phóng to bằng RTX 2x
- Kết nối mô hình chính H3 Ref2VA int8, bộ mã hóa văn bản qwen3vl 32b, VAE video / âm thanh, bộ thích ứng pika_h3_flex_ref2va, cổng tăng tốc fasth3_vsa_gate, Semantic Bridge, cùng với các nút Ref2VA VSA, Semantic Bridge, Memory Cleanup, RTX, KJNodes, rgthree, VideoHelperSuite, ghi chú trong hình liệt kê liên kết của từng mô hình
- Tham số đã được đặt trước: bộ lấy mẫu lcm, sáu sigma thủ công của Pika, CFG 1, cường độ bộ thích ứng 1, độ thưa của cổng 0.75; tác giả cung cấp thời gian xử lý trên RTX A4500 (20 GB): đoạn 0.6 MP (1056x608) 5 giây lấy mẫu 1:43, tắt cổng tăng tốc 2:11
- Kèm theo gợi ý viết prompt: mỗi đoạn một địa điểm và một câu chuyện hoàn chỉnh, viết phương vị theo vị trí trên màn hình, viết vị trí máy quay cho mỗi cảnh quay, viết rõ nguyên nhân và kết quả, định nghĩa riêng khi có nhiều ảnh tham khảo
Cách sử dụng
- Tải Pika-H3-Flex-References-SemanticBridge.json, tải các mô hình theo ghi chú trong hình và đặt vào các thư mục diffusion_models / text_encoders / vae / loras và thư mục models/semantic_bridge mới tạo, cài đặt bổ sung các nút còn thiếu bằng ComfyUI Manager
- Giữ nguyên các tham số đặt trước, giữ nút dọn dẹp bộ nhớ ở trạng thái bật; chạy thử các đoạn ngắn trước để kiểm tra prompt. Tác giả Semantic Bridge phát hiện trong thử nghiệm phim hài kịch rằng bật thì hình ảnh tốt hơn, tắt thì âm thanh tốt hơn, hãy thử cả hai
Rủi ro và hạn chế
- Phụ thuộc nặng nề: tác giả thống kê tổng dung lượng mô hình khoảng 48 GB, yêu cầu PyTorch phiên bản CUDA 13 (cu130), driver NVIDIA từ 580 trở lên và ComfyUI phiên bản mới hơn (tác giả thử nghiệm 0.44.0)
- Ngưỡng VRAM: trên card 20 GB, đoạn 0.8 MP 15 giây sẽ tràn VRAM, ba ảnh tham khảo 1344x768 15 giây cần card 24 GB; 16 / 12 GB là do tác giả mô phỏng giới hạn VRAM trên card 20 GB, đoạn 15 giây đạt đỉnh khoảng 17 GB, khuyên bắt đầu từ các đoạn ngắn
- Tác giả của Semantic Bridge trong v1 đã liệt kê quy trình làm việc ảnh tham khảo là không được hỗ trợ, và nhắc nhở rằng đồng bộ khẩu hình với âm thanh tham khảo có vấn đề; Pika H3 Flex và H3 tuân theo giấy phép cộng đồng MiniMax H3, cần đọc kỹ giấy phép trước khi sử dụng thương mại
- Chỉ có 1 đoạn video mẫu khả kiến, ngoài ra 3 ví dụ cấp độ nhạy cảm bị ẩn; mục này chưa được chạy thử
【A】Minimax H3 SEED HUNTER - Latent Upscaler, Seamless Video Continuation, Dialogue Gen Tool, Speedups, Ref Mods · v3.0
Quy trình làm việc · Cập nhật phiên bản · Tác giả foxydits · Phát hành 11-06 07:57 · Tải xuống 55
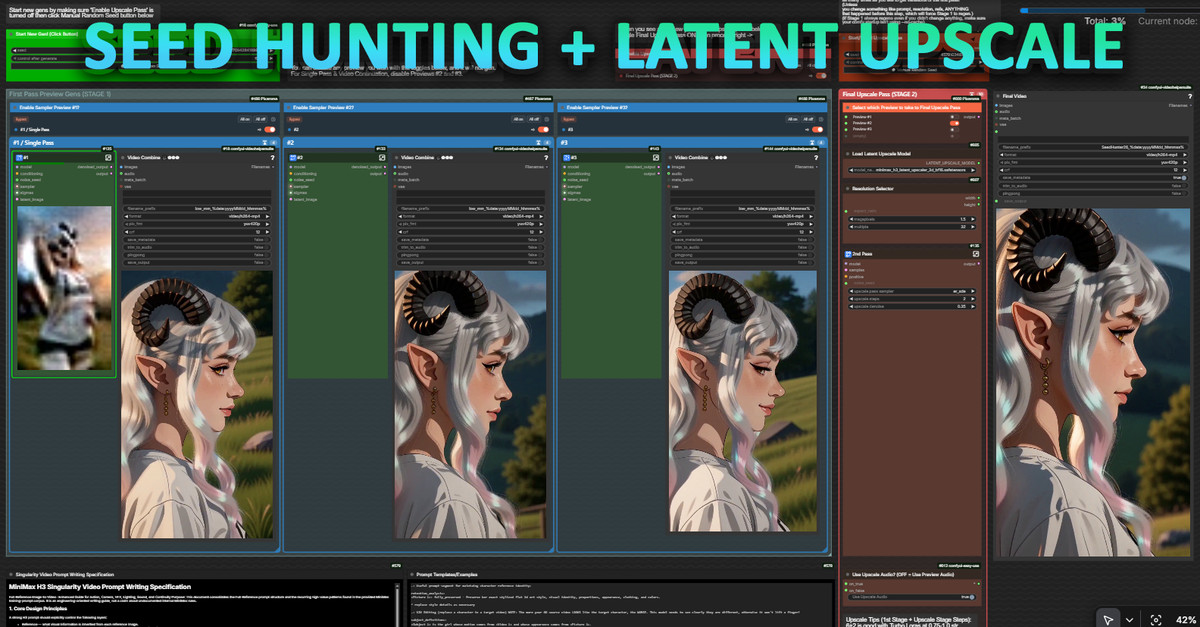
Seed Hunter v3.0: quy trình làm việc "săn seed" tạo ra 3 bản xem trước độ phân giải thấp cùng lúc, chọn seed ưng ý rồi phóng to để hoàn thiện, phiên bản này chuyển sang sử dụng bộ phóng to latent tích hợp của ComfyUI, và thêm các tùy chọn như trích xuất khung hình, trích xuất khung hình hoạt hình, trình chỉnh sửa prompt kép, v.v.
Hình ảnh minh họa
Lý do đề xuất
- Cập nhật phiên bản: Chuyển sang sử dụng Latent Upscaler do Kijai phát triển, tích hợp sẵn trong ComfyUI 0.44 (tác giả cho biết nhanh hơn và giải quyết được lỗi OOM do đỉnh VRAM), do đó bắt buộc phải nâng cấp lên 0.44
- Mới: Lưu khung hình đầu/cuối vào thư mục output/saved_frames/; Trích khung hình hoạt hình Anime Cadence, giúp nhịp độ chuyển động của hoạt hình 2D giống với hoạt hình truyền thống hơn; Đầu ra cuối cùng có thể sử dụng âm thanh từ bản xem trước; Trình chỉnh sửa prompt thứ hai cho phép viết prompt tiếp theo trong khi đang chạy; Prompt tự động được lưu vào output/prompts/
- Quy trình bao gồm viết tiếp liền mạch, âm thanh tùy chỉnh, nội suy khung hình từ 24 FPS lên 48-60, công cụ hội thoại/nhân bản giọng nói; Trang mô hình tích lũy 39146 lượt tải xuống, 1111 lượt thích, 307 bình luận, mức độ quan tâm cao
Cách sử dụng
- Nâng cấp ComfyUI lên 0.44 rồi nhập FoxFurEssence H3 Seed Hunter v3.json; Tải minimax_h3_latent_upscaler do tác giả chỉ định và đặt vào thư mục latent_upscale_models
- Các node: Anime Cadence, Pixaroma, Prompt IDE, MiniMaxH3-PromptBuilder, RefMods, v.v., hầu hết có thể cài đặt từ Comfy Registry; Để tăng tốc, có thể cấu hình LoRA turbo Silveroxide Dareties do tác giả đề xuất và VAE video int8 của Kijai
Rủi ro và hạn chế
- Hướng dẫn sử dụng v3.0 được tác giả đánh dấu là "sắp ra mắt", hướng dẫn hiện tại là của v2.5; phụ thuộc vào nhiều node, cần kiểm tra từng cái một
- Chỉ có 2 ví dụ hình ảnh hiển thị được, 5 ví dụ ở mức độ nhạy cảm bị ẩn, không có video hiển thị; mục này chưa được chạy thử
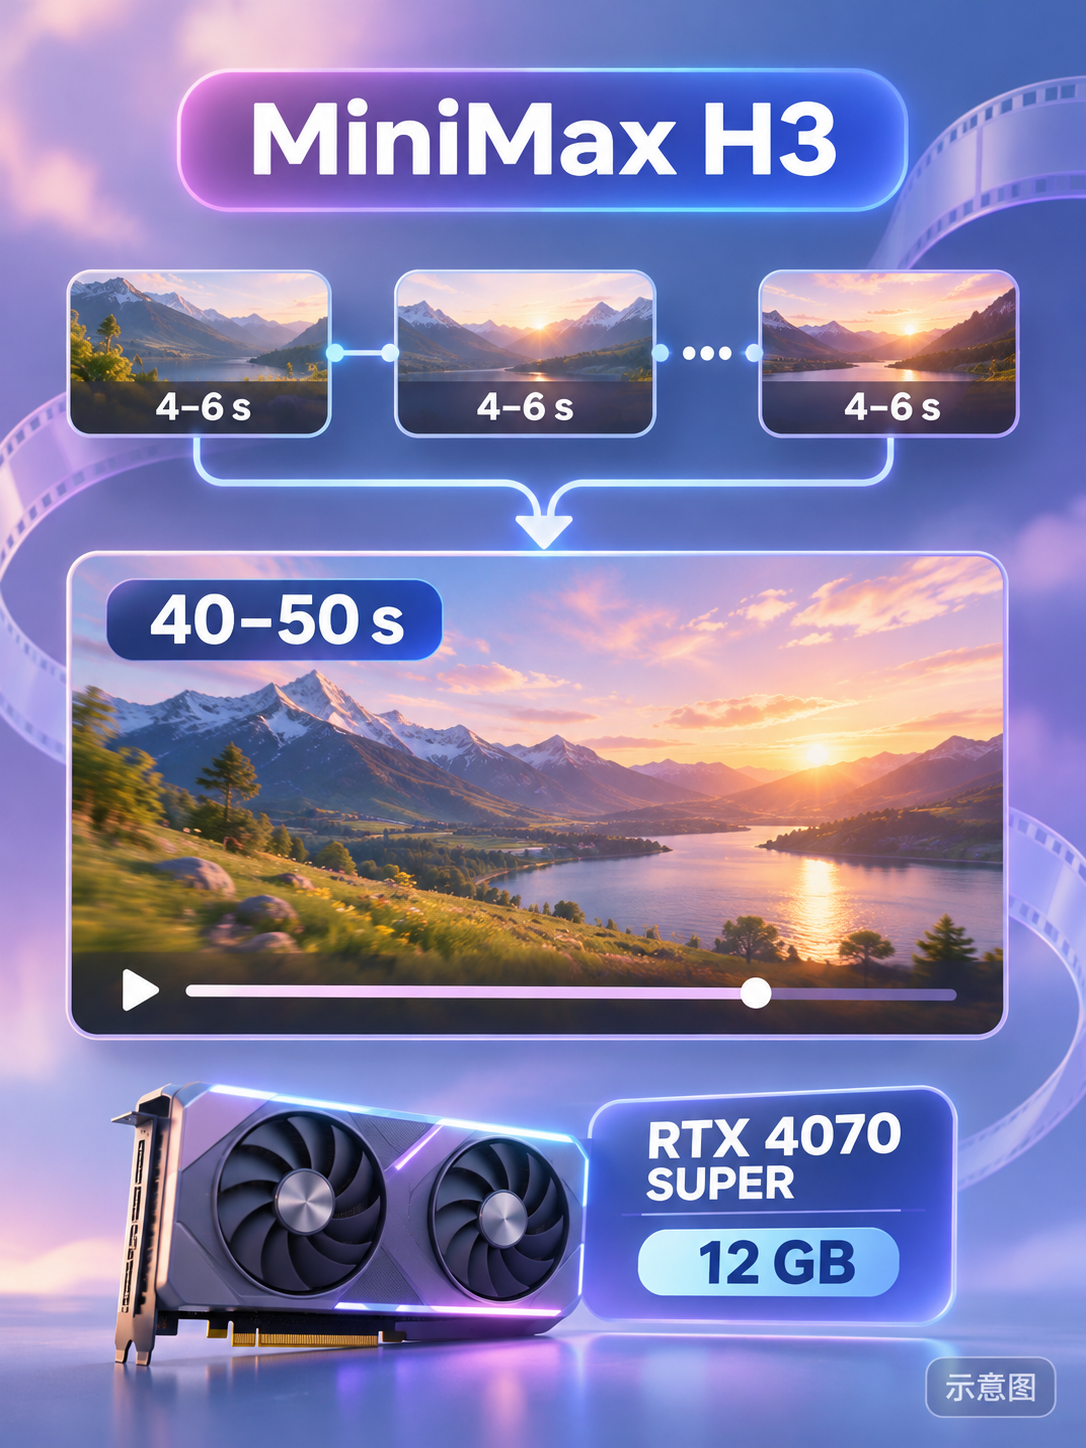
【A】MiniMax H3 long take: một cảnh quay 40-50 giây từ các phân đoạn nối tiếp (12 GB) · v1 (12 GB đã kiểm thử)
Quy trình làm việc · Mô hình mới · Tác giả semenovsas776 · Phát hành 11-06 04:32 · Tải xuống 55
Một bộ quy trình làm việc + gói script để nối các phân đoạn H3 dài 4-6 giây thành một cảnh quay dài liên tục 40-50 giây, tác giả hoàn thành trên RTX 4070 SUPER 12 GB; tác giả cho biết khuôn mặt, trang phục và màu sắc được duy trì đến cuối cùng, không nhìn thấy mối nối.
Giải pháp cảnh quay dài hoàn chỉnh nhất trong kỳ này: cung cấp cùng lúc quy trình làm việc, kế hoạch prompt và script kiểm tra chất lượng, phù hợp cho những ai muốn làm cảnh đối thoại một cú máy (one-shot) nên đọc bài viết trước khi bắt tay vào làm.
Hình minh họa
Lý do đề xuất
- Giải quyết vấn đề video dài khi H3 có giới hạn thời lượng cho mỗi phân đoạn và dễ bị nhảy hình khi ghép nối: mỗi phân đoạn được viết tiếp từ phần đuôi latent của phân đoạn trước (chế độ nối tiếp của FeiHou Easy H3, 22+22 khung hình), từ phân đoạn thứ 2 sử dụng chế độ tham chiếu kèm theo ảnh tham chiếu khuôn mặt và ảnh mở đầu, văn bản của mỗi phân đoạn lặp lại đầy đủ mô tả trang phục và mô tả đạo cụ theo trạng thái
- Nội dung gói nén đầy đủ: quy trình làm việc UI cho phân đoạn thứ 1 và phân đoạn thứ N (kèm hướng dẫn thiết lập), sơ đồ định dạng API tương ứng, prompt hệ thống dùng để lập kế hoạch (dán vào bất kỳ trợ lý trò chuyện nào để tạo văn bản cho từng phân đoạn) và kế hoạch phân cảnh cho bối cảnh quán cà phê, cùng với các script kiểm tra kế hoạch, chạy chuỗi tự động qua API ComfyUI, phát hiện mối nối/khung hình bị kẹt, độ tương đồng khuôn mặt, bảng đánh giá phim, v.v.
- Tác giả cung cấp thời gian xử lý: RTX 4070 SUPER + 96 GB RAM, phân đoạn thứ 1 mất khoảng 1.5 phút, các phân đoạn sau mất 2.5-3.5 phút/phân đoạn; phương pháp đầy đủ có trong một bài viết khác (civitai.com/articles/38141)
Cách sử dụng
- Cần có ComfyUI + FeiHou Easy H3, FeiHou Toolbox, KJNodes, mô hình MiniMax H3 Remix v0.8, bộ mã hóa văn bản và VAE từ Comfy-Org/MiniMax-H3, cùng với bộ khuếch đại latent H3; chỉ cần ReActor nếu đổi khuôn mặt ở khung hình đầu tiên
- Trước tiên dùng prompt lập kế hoạch để trợ lý trò chuyện viết văn bản cho từng phân đoạn, chạy phân đoạn thứ 1, sau đó dùng quy trình làm việc phân đoạn thứ N để viết tiếp từng phân đoạn, hoặc dùng script đi kèm để tự động chạy toàn bộ chuỗi qua API
Rủi ro và hạn chế
- Hai video ví dụ (phiên bản thực tế và phiên bản truyện tranh của cùng một bối cảnh quán cà phê) đều bị đánh dấu ở mức độ nhạy cảm và bị ẩn, không thể xem hiệu quả mối nối thực tế, mức độ được đưa ra dựa trên tài liệu
- Mô hình chính sử dụng MiniMax H3 Remix v0.8 thay vì trọng số chính thức, tác giả không nêu rõ liệu việc nối tiếp có hoạt động tương tự khi đổi mô hình hay không; mục này chưa được chạy thử
- Hình minh họa trên thẻ là hình minh họa do AI tạo, không phải hiệu quả thực tế của mô hình; tác giả không có ví dụ công khai ở mức độ bình thường
Có thể theo dõi (5)
【B】Minimax.. simple · v5.1
Quy trình làm việc · Cập nhật phiên bản · Tác giả sy0ww4bb1984 · Phát hành 11-06 03:10 · Tải xuống 35
Phiên bản v5.1 của quy trình làm việc lớn "Minimax.. simple" gồm tạo video từ ảnh tham chiếu + kéo dài theo phân đoạn + khuếch đại: thêm tùy chọn tham chiếu video, hướng dẫn thao tác thay thế người trong video (video to video replace), passthrough (đi thẳng) cho việc khuếch đại, và thêm lại kitchen attention.
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản: so với v5, đã thêm đầu vào tham chiếu video và hướng dẫn thay thế vid2vid; tác giả nói trên trang rằng v5.1 ban đầu bắt buộc phải có tham chiếu video mới tạo được video, bản 5.11 sau đó đã khắc phục (tên tệp tải xuống là minimaxv5.11.zip)
- Toàn bộ quy trình kết nối tạo video từ ảnh tham chiếu (nhiều ảnh, tham chiếu nhiều đoạn âm thanh), kéo dài theo lô dựa trên số khung hình và đồng bộ âm thanh, ba loại khuếch đại RTX / latent / resize, mỗi lô có thể đổi LoRA, prompt, seed và tham chiếu; trang mô hình tích lũy 2860 lượt tải xuống
- Tác giả liệt kê nguồn LoRA chưng cất và khuếch đại đi kèm: MiniMax-H3-experimental của Kijai, loras của Comfy-Org, Pika-H3-Flex-Turbo-LoRA
Cách sử dụng
- Tải minimaxv5.11.zip, giải nén và nhập vào ComfyUI; gợi ý tham số của tác giả: cường độ LoRA 0.4-1.0, phân đoạn được đặt theo số khung hình thay vì giây, tối đa 300 khung hình ở 1MP mỗi lô, tùy chọn sigma Beta57 8 / 6 / 4 bước
- Khuyến nghị khuếch đại với tỷ lệ 2x (tác giả cho biết nếu không phải bội số nguyên sẽ làm giãn hình ảnh); các node bộ nhớ cần giữ bật riêng biệt latent video/âm thanh và đặt ngoài nhóm
Rủi ro và hạn chế
- Ghi chú cập nhật rời rạc: v5.1 và 5.11 được viết lẫn lộn, không giải thích chi tiết kitchen attention là gì, cách kết nối tham chiếu video
- Tác giả tự nhận chỉ có một máy tính tầm trung, rất khó kiểm thử toàn bộ quy trình lớn này; các bản cập nhật ComfyUI thường xuyên làm hỏng nó; cần tự kiểm tra các node và mô hình phụ thuộc
- Chỉ có 1 ví dụ hình ảnh hiển thị được, 4 ví dụ ở mức độ nhạy cảm bị ẩn, không có video hiển thị; mục này chưa được chạy thử
【B】Lonecat’s MiniMax H3 FL2VA/ REF2VA | Quy trình làm việc video VRAM thấp w/ Bộ tối ưu Low VRAM, Upscaler, & Hậu kỳ · V9.0 Nhanh hơn & Tốt hơn
Quy trình làm việc · Cập nhật phiên bản · Tác giả lonecatone23 · Phát hành 11-06 08:04 · Tải xuống 14
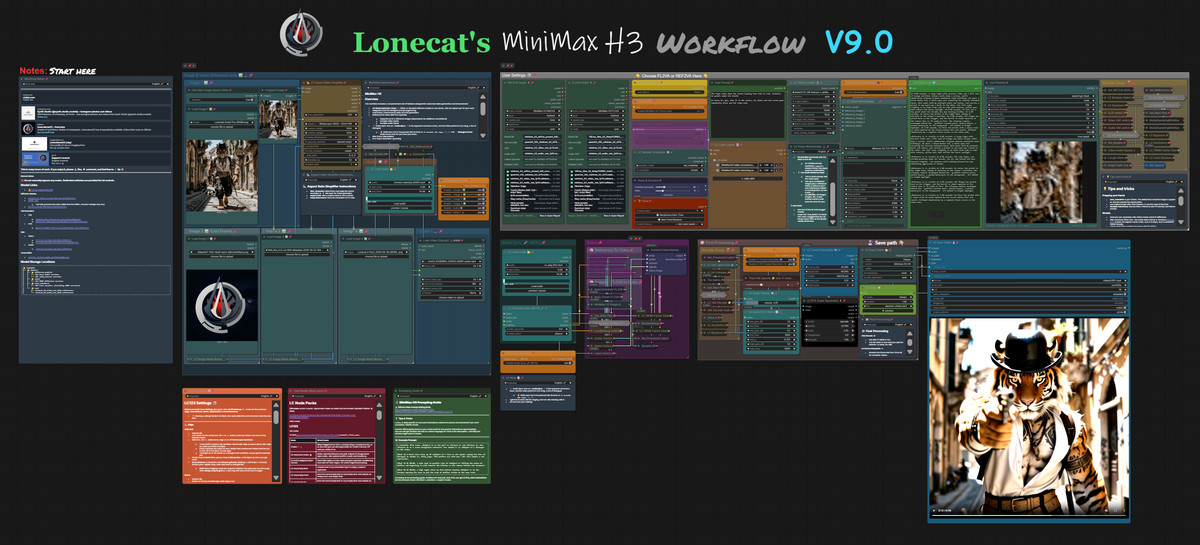
Quy trình làm việc lớn H3 khung hình đầu/cuối / tạo video từ ảnh tham chiếu của Lonecat V9.0: thay đổi duy nhất được ghi rõ là loại bỏ Ultimate Upscale, thay bằng phương pháp khuếch đại mà tác giả đã kiểm thử khi làm một quy trình làm việc khác.
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản: tác giả cho biết sau khi kiểm thử nhiều phương pháp khuếch đại thì phát hiện cách làm của đa số mọi người đều có vấn đề, vì vậy đã loại bỏ Ultimate Upscale, tác giả cho biết thành phẩm tốt hơn, nhưng phương pháp cụ thể được thay thế được viết trong liên kết ngoài, trang mô hình không trình bày chi tiết
- Bản thân quy trình hỗ trợ khung hình đầu/cuối (FLF2V) và ảnh tham chiếu (REF2V, tối đa 4 ảnh tham chiếu), đầu vào video và âm thanh, LC Vision tự tạo của tác giả để xem ảnh và viết prompt, nội suy khung hình RIFE, siêu phân giải RTX, cũng như mô hình GGUF; ghi chú trong hình có tiếng Trung
- Miễn phí; trang mô hình tích lũy 5301 lượt tải xuống, 207 lượt thích
Cách sử dụng
- Nhập MiniMax H3 Ver 9.0 (1).json; tác giả vừa cập nhật gói node của mình, nếu báo lỗi hãy tải thủ công từ GitHub của tác giả (lonecatone23)
- Tác giả giải thích đây là quy trình làm việc nâng cao, không dành cho người mới bắt đầu; người mới có thể dùng quy trình làm việc đơn giản hóa khác của tác giả. Tác giả không cung cấp số bước và yêu cầu VRAM
Rủi ro và hạn chế
- Ghi chú cập nhật chỉ có một câu, chi tiết phương pháp khuếch đại nằm ở liên kết ngoài trang, không thể kiểm tra trên trang mô hình
- Phụ thuộc vào nhiều gói node của riêng tác giả; chỉ có 1 ví dụ hình ảnh hiển thị được, 2 ví dụ ở mức độ nhạy cảm bị ẩn; mục này chưa được chạy thử
【B】Easy MH3 (tạo video + khuếch đại sử dụng chia lô + 60 FPS) · v1.0
Quy trình làm việc · Mô hình mới · Tác giả Crimson009 · Phát hành 11-05 23:15 · Tải xuống 67
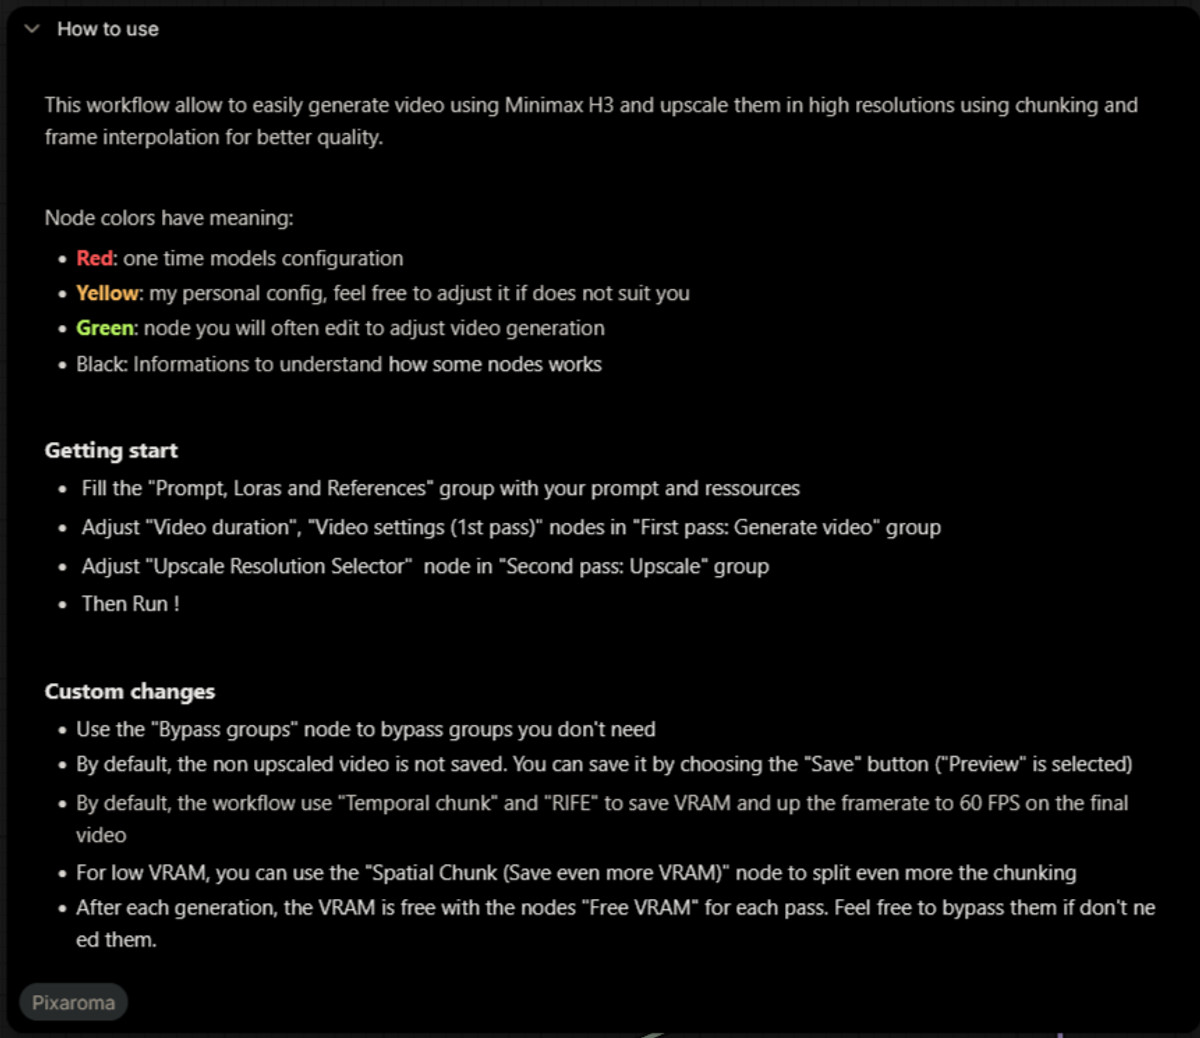
Một quy trình làm việc H3 hai lượt: lượt đầu tiên tạo video, lượt thứ hai khuếch đại lên độ phân giải cao bằng cách chia lô theo thời gian (Temporal chunk), sau đó nội suy khung hình bằng RIFE lên 60 FPS, tập trung vào tiết kiệm VRAM và dễ sử dụng.
Hình minh họa
Lý do đề xuất
- Phục vụ các tình huống muốn có thành phẩm độ phân giải cao, tốc độ khung hình cao nhưng VRAM hạn chế: mặc định là chia lô theo thời gian + RIFE, khi VRAM thấp hơn có thể chuyển sang Spatial Chunk (chia lô không gian) để cắt nhỏ hơn nữa, cuối mỗi lượt có node Free VRAM để giải phóng VRAM
- Các node được phân biệt mục đích bằng màu sắc: màu đỏ là cấu hình mô hình một lần, màu vàng là cài đặt cá nhân của tác giả, màu xanh lá là các tham số sinh thường xuyên thay đổi, màu đen là mô tả
- Các bước thao tác được viết rõ ràng: điền vào nhóm "Prompt, Loras and References", điều chỉnh thời lượng video và cài đặt lượt đầu tiên, sau đó chọn độ phân giải khuếch đại rồi chạy; các nhóm không cần thiết có thể tắt bằng node "Bypass groups"
Cách sử dụng
- Nhập Easy_MMH3_2pass_chunked_RIFE_upscale_V1.json, điền theo thứ tự trên; video chưa khuếch đại mặc định chỉ xem trước không lưu, khi cần hãy đổi Preview thành Save
- Tác giả không cung cấp thông tin về mô hình, node, số bước và VRAM cần thiết
Rủi ro và hạn chế
- Không liệt kê các mô hình và node tùy chỉnh phụ thuộc, chỉ có thể nhập vào rồi xem thiếu gì
- Chỉ có 1 ví dụ hình ảnh hiển thị được, 2 ví dụ ở mức độ nhạy cảm bị ẩn, không có video hiển thị, không thể kiểm tra hiệu quả khuếch đại; mục này chưa được chạy thử
【B】Prophetero Test Bench + Take Compare GLOBAL · v0.4
Quy trình làm việc · Mô hình mới · Tác giả Prophetero · Phát hành 11-05 22:09 · Tải xuống 19
Một công cụ thử nghiệm và so sánh (Test Bench + Take Compare, phiên bản beta công khai) được tích hợp vào ComfyUI: chạy thử các đoạn video ngắn với đường cơ sở không LoRA và nhiều tổ hợp LoRA trên cùng một quy trình làm việc, so sánh hình ảnh, chuyển động và âm thanh song song trên cùng một trang, sau đó chuyển đổi cài đặt của nhóm được chọn sang kết xuất toàn bộ độ dài hoặc xuất quy trình làm việc chỉ bằng một cú nhấp chuột.
Hình minh họa
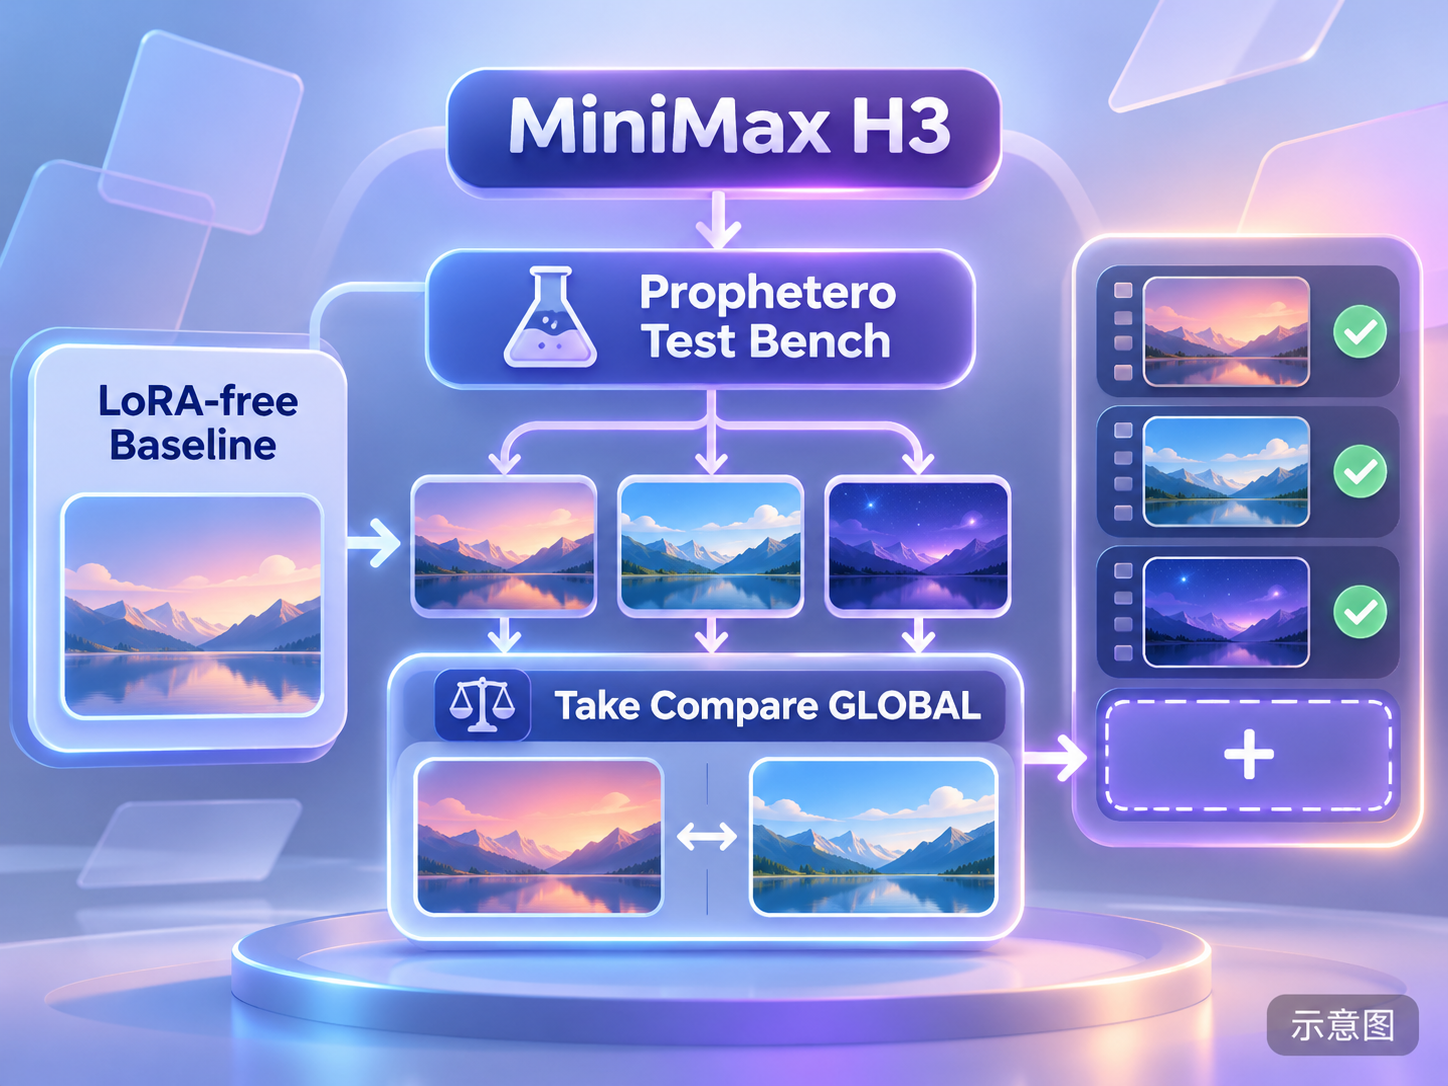
Lý do đề xuất
- Giải quyết vấn đề quy trình khi điều chỉnh tổ hợp LoRA phải chuyển đổi tab liên tục và không nhớ được tham số: mỗi thẻ mẫu có thể tìm kiếm LoRA, đặt công tắc và cường độ riêng lẻ và hiển thị cài đặt đã lưu; có thể nhận diện điều khiển thời lượng H3 / LTX để tự động rút ngắn thời gian chạy thử, các lần chạy thử đã hoàn thành sẽ không chạy lại khi thêm thí nghiệm mới
- Take Compare hỗ trợ so sánh tối đa bốn đoạn cùng lúc, hỗ trợ từng khung hình, dịch chuyển thời gian, thu phóng liên kết, đánh dấu ghi chú, tốc độ phát 0.25x–2x; có thể xem dạng sóng đơn/kênh đôi và mức đỉnh/RMS của âm thanh gốc
- Hỗ trợ Power Lora Loader (rgthree), LoraLoader, LoraLoaderModelOnly, các node đầu ra hỗ trợ SaveVideo và VHS_VideoCombine; giao diện có tám ngôn ngữ
Cách sử dụng
- Giải nén toàn bộ tệp ZIP, dừng backend, chạy START_HERE.cmd và chọn backend ComfyUI thực tế đang sử dụng, khởi động lại SwarmUI / ComfyUI và làm mới trình duyệt; mở workflow có thể xuất video bình thường, nhấp chuột phải vào vùng canvas trống và chọn Prophetero · Test Bench + Take Compare
- Giới hạn so sánh: mỗi đoạn 0.5–120 giây, 1–60 FPS, tối đa 8 MP và 2 GiB
Rủi ro và hạn chế
- Phiên bản thử nghiệm công khai, tác giả cho biết suy luận trong quá trình thử nghiệm là mô phỏng, không đảm bảo tương thích với tất cả các mô hình thực tế và nút tùy chỉnh; chạy thử ngắn thành công không có nghĩa là kết xuất toàn bộ sẽ thành công
- Không phải là JSON workflow thông thường, mà là gói plugin kèm theo script cài đặt Windows, nên xem xét các tệp trong gói trước khi cài đặt; giấy phép cấm bán phần mềm này
- Chỉ có 1 ví dụ ở mức nhạy cảm và đã bị ẩn, không có ví dụ nào hiển thị; mục này chưa được chạy
- Hình ảnh trên thẻ là hình minh họa do AI tạo, không phải hiệu ứng thực tế của mô hình; tác giả không có ví dụ công khai ở mức thông thường
【B】H3: Kết cấu chân thực và diễn xuất đạt giải thưởng, đẳng cấp bậc thầy. · v1.0
LoRA · Mô hình mới · Tác giả TuTu_1018 · Phát hành 11-05 21:29 · Tải xuống 254
LoRA “Kết cấu chân thực, diễn xuất như diễn viên đoạt giải”: tác giả cho biết mô hình tăng cường chi tiết khuôn mặt, biểu cảm vi mô, thay đổi ánh mắt và biểu đạt cảm xúc, khiến các nhân vật trong các cảnh đối thoại, cảnh cảm xúc và cảnh kịch tính trông giống như đang diễn xuất thực sự thay vì các hành động máy móc.
Hình minh họa
Lý do đề xuất
- Phục vụ các cảnh đối thoại, cận cảnh cảm xúc của nhân vật tả thực trong các tác phẩm văn sinh video / ảnh sinh video, hướng tới chất lượng diễn xuất thay vì một nhân vật hoặc phong cách vẽ cụ thể nào
- Phát hành khoảng nửa ngày đã có 254 lượt tải xuống, 21 lượt thích, là phiên bản có nhiều lượt tải nhất trong kỳ này, nhưng điều này chỉ cho thấy mức độ quan tâm
- Tác giả đã đăng một workflow trực tuyến cùng tên trên RunningHub (liên kết kèm mã mời)
Cách sử dụng
- Tải H3lora.safetensors diễn xuất chân thực như diễn viên điện ảnh; từ khóa kích hoạt không được tác giả đăng ký, cường độ và số bước không được tác giả cung cấp
Rủi ro và hạn chế
- Thẻ mô hình chỉ có mô tả mang tính quảng cáo, không có thông tin huấn luyện, tham số và so sánh; ví dụ duy nhất ở mức nhạy cảm đã bị ẩn, không thể thấy hiệu ứng diễn xuất thực tế
- Mô tả bị lặp lại hai lần, chủ yếu nhằm dẫn dắt người dùng đến các nền tảng bên ngoài; mục này chưa được chạy
- Hình ảnh trên thẻ là hình minh họa do AI tạo, không phải hiệu ứng thực tế của mô hình; tác giả không có ví dụ công khai ở mức thông thường
Chỉ ghi nhận (7)
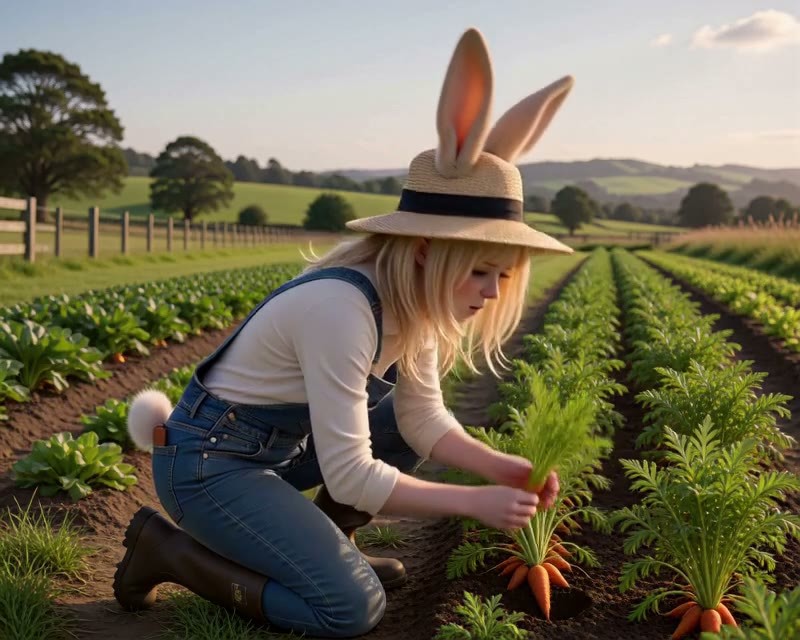
- Bonnie Rabbit · v1.0 H3 — LoRA: LoRA nhân vật phiên bản H3 của Bonnie Rabbit, một cô gái tai thỏ do tác giả tự sáng tạo (chủ trang trại cà rốt ở vùng nông thôn New Zealand), từ khóa kích hoạt là bonnielora.
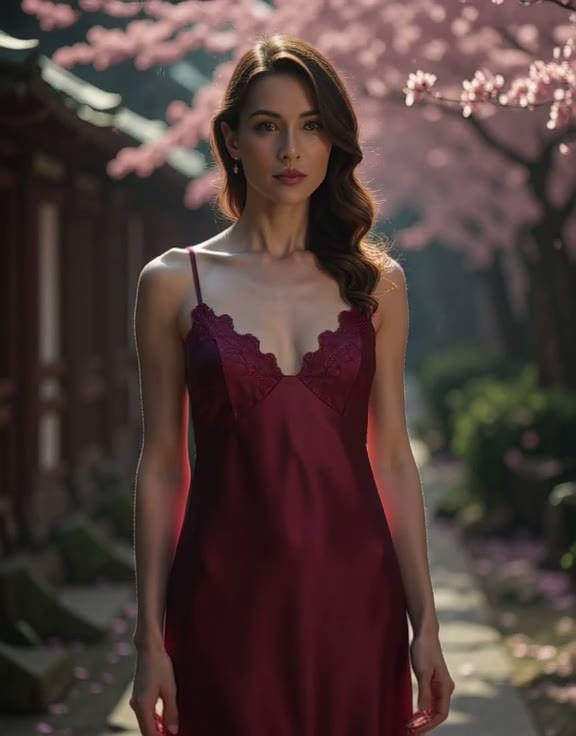
- Nevaeh Belwyn · MiniMaxH3 — LoRA: LoRA nhân vật phiên bản H3 của Nevaeh Belwyn, một nhân vật nữ hư cấu (nhân viên lưu trữ sách cổ ở Bruges, mặc trang phục len cổ điển và ren cổ), tác giả khẳng định đây không phải là người thật.
- Looney Red Riding Hood :: MMH3 Character · v1.0 — LoRA: LoRA nhân vật Cô bé quàng khăn đỏ phiên bản truyện cổ tích đen tối (cười nhe răng, tóc vàng, áo choàng đỏ rách rưới), được huấn luyện bằng thiết kế nhân vật và phong cách vẽ của họa sĩ @phatestronaught, dành cho việc tạo video từ văn bản.
- Sam Bramblepot · v1.0 H3 — LoRA: LoRA nhân vật phiên bản H3 của Sam Bramblepot, một người làm vườn lùn do tác giả tự sáng tạo, từ khóa kích hoạt là samlora.
- Nox · v1.0 H3 — LoRA: LoRA nhân vật phiên bản H3 của Nox, một nhân vật nữ "bóng sống" do tác giả tự sáng tạo (da đen đến mức nuốt ánh sáng, mắt bạc), từ khóa kích hoạt là noxlora.
- Flat Lindsay · v1.0 H3 — LoRA: LoRA phiên bản H3 của nhân vật Flat Lindsay do tác giả tự sáng tạo: một cô gái "phẳng như giấy", nhìn chính diện giống tranh minh họa có viền, nhưng khi nghiêng người thì gần như biến mất, dù vẫn sống bình thường trong thế giới ba chiều.
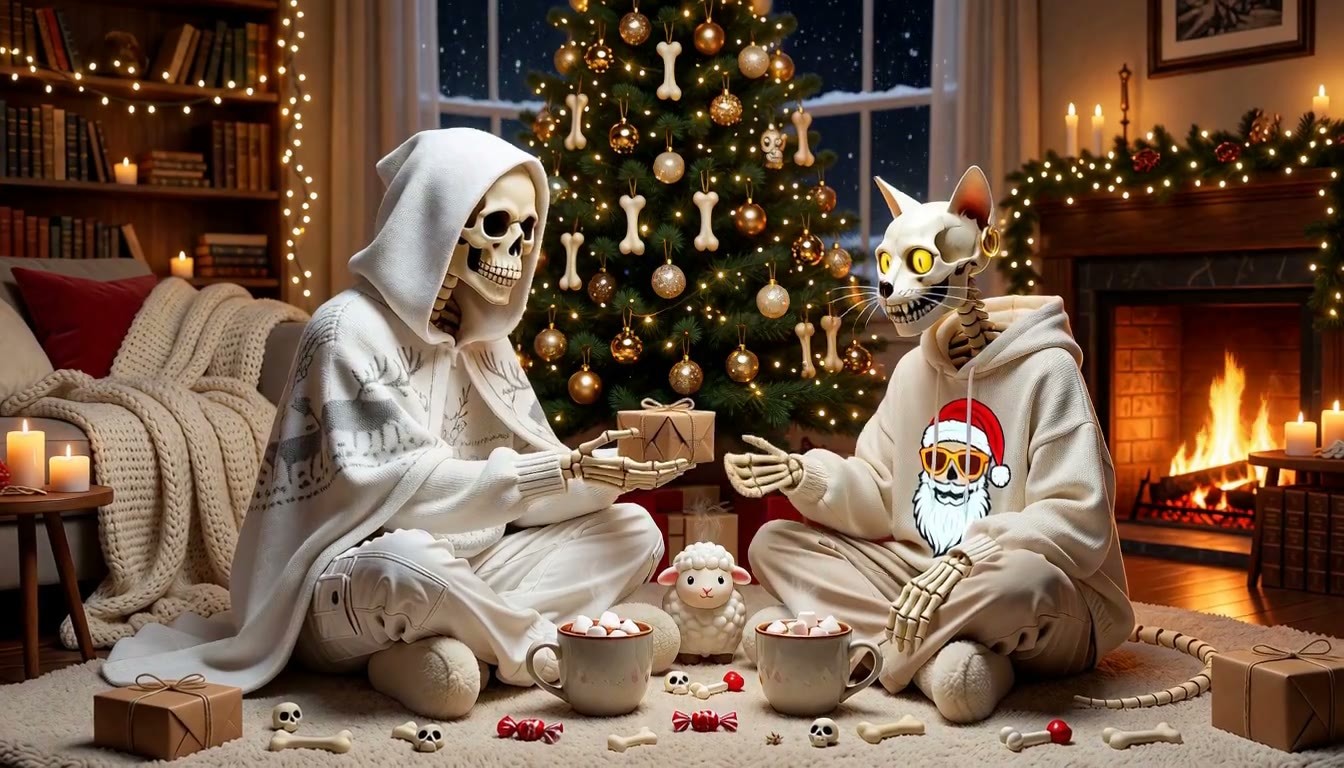
- 🎄LORU & RIBS: CHRISTMAS BONE DANCE · v1 — LoRA: LoRA hai nhân vật chủ đề Giáng sinh: Thần chết Loru đội mũ trùm đầu trắng và chú mèo xương Ribs của nó uống cacao nóng bên lò sưởi, trượt băng trên sân băng và trao đổi quà tặng, tác giả cho biết LoRA này nổi bật về kết cấu vải dệt kim, cấu trúc xương và hiệu ứng ánh sáng ma thuật.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ ghi nhận từ 11-05 20:31 → 11-06 09:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.