Радар AI от Чжэньчжэнь · MiniMax H3 · Утренний обзор 2026-11-06
В этом выпуске 17 новых версий: настоятельно рекомендуется 2 · рекомендуется 3 · стоит обратить внимание 5 · только для сведения 7
Примечание редактора В этом выпуске рассмотрено 17 новых версий H3. Главная рекомендация — LoRA в стиле аниме-сели INBT: она приводит непостоянный анимационный стиль H3 по умолчанию к единому стилю с четкими контурными линиями и плоским затенением. Полностью описаны триггерные слова, веса, структура промптов и настройки сэмплирования; приложено 6 примеров видео. Better Hair устраняет эффект пушистости и ломкости волос в H3, также получает оценку S. Другие интересные материалы: рабочий процесс генерации видео по референсным изображениям Pika H3 Flex, Seed Hunter v3 и методика создания длинных кадров путем склейки сегментов, работающая на видеокартах с 12 ГБ памяти (примеры скрыты, оценка A основана на документации). Обновления Minimax.. simple v5.1 и Lonecat V9.0 незначительны или описаны фрагментарно, в Easy MH3 отсутствует список зависимостей, поэтому им присвоена оценка B; шесть стандартных LoRA персонажей не имеют параметров и в большинстве случаев не имеют видимых примеров, поэтому им присвоена оценка C.
Настоятельно рекомендуется (2)
【S】INBT Cel Style - MiniMax H3 · H3 V1
LoRA · Новая модель · Автор AriaMaiven · Опубликовано 11-06 05:49 · Загрузок 54
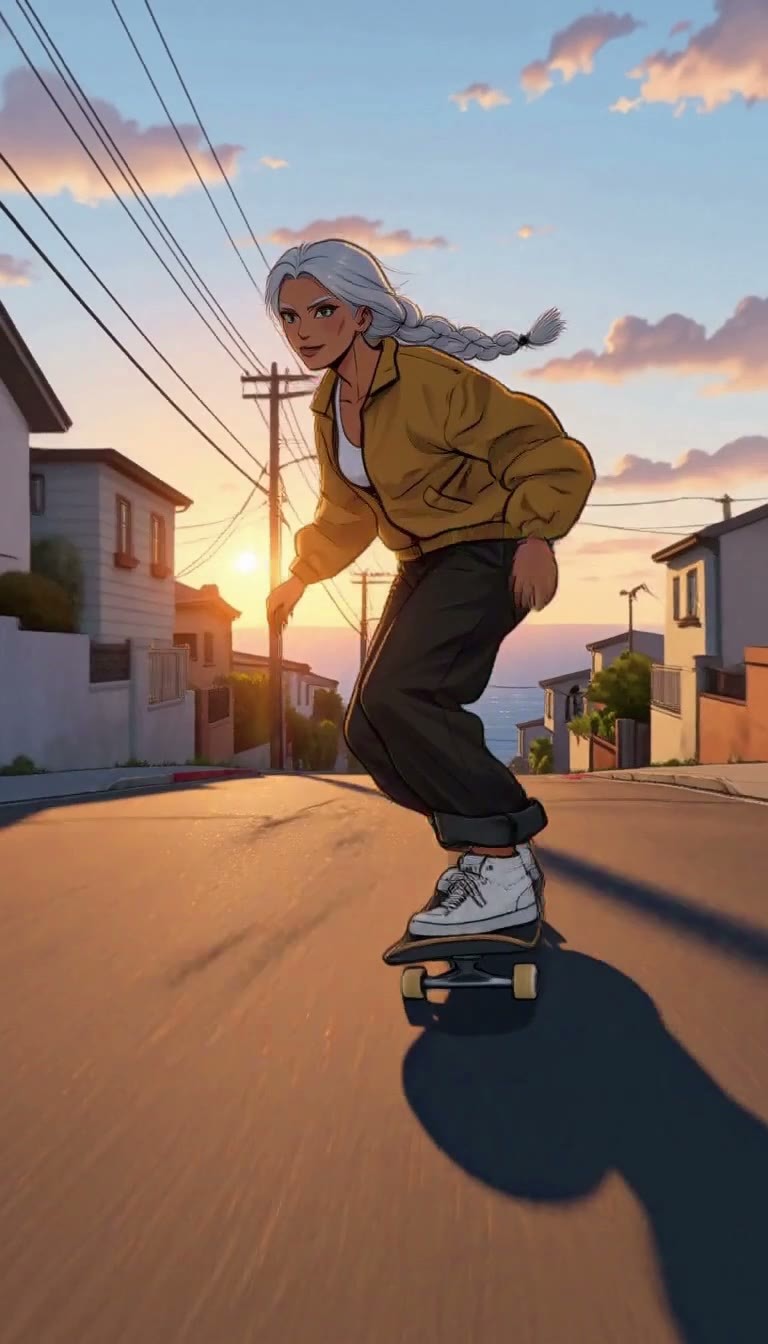
LoRA в стиле аниме-сели: четкие контурные линии, плоское затенение, цветовая гамма неоновых ночных дождей. Она приводит анимационный стиль H3, который по умолчанию колеблется между американской мультипликацией и корейской манхвой, к единому виду. Автор утверждает, что стиль сохраняется неизменным при движении камеры, а также когда персонажи говорят или поют.
В LoRA стиля редко встречается четкое разделение ролей в промптах: «не описывайте технику рисования, описывайте персонажей». Достаточно следовать шаблону первой фразы, чтобы воспроизвести результат.
Иллюстрации
Причины рекомендации
- В сервисе генерации видео из текста для 2D анимационных короткометражек, музыкальных клипов и диалоговых сцен: автор утверждает, что стиль сохраняется при съёмке двух персонажей в одном кадре, синхронизации губ с диалогами и пением, пустых улицах без людей, а также в сценах с закатом и неоновым освещением
- Сам стиль не имеет фиксированной внешности: нарисует того, кто указан в промпте, так что можно интегрировать своих персонажей в этот стиль
- Инструкция по использованию составлена подробно: указаны триггерные слова, веса, шаблон первой строки промпта, сэмплер, планировщик, количество шагов, разрешение, длительность и базовая модель обучения; приложены 6 примеров видео
- Бесплатное скачивание, лицензия разрешает коммерческое использование изображений (с обязательным указанием авторства стиля)
Как использовать
- Загрузите inbt_h3_v1.safetensors, вес 0.8; пишите промпты в официальном формате H3, начиная с описания стиля: [Shot 1] 2D-animated in the inbtsint style, a medium shot at eye level...
- Не описывайте линии, тени, anime и другие технические аспекты рисования (за них отвечает триггерное слово); подробно опишите прическу, глаза, цвет кожи, татуировки и одежду каждого персонажа
- Тестовая среда автора: текстово-видеогенерация MiniMax H3 FL2VA pruned int8 ConvRot в ComfyUI, 20 шагов, res_multistep + simple, разрешение 768x1344 или 1344x768, длительность 5 секунд; базовая модель обучения — FL2VA pruned
Риски и ограничения
- При увеличении веса до 1.0 линии становятся толще, и на лице появляются не запрошенные знаки (крест на лбу, царапины на висках), поэтому автор рекомендует вес 0.8
- Текст на фоне превращается в нечитаемые глифы; автор поясняет, что это проблема самого H3, не связанная с LoRA
- Запрещено перепубликовать, а также запрещено использовать сгенерированные изображения для обучения других моделей (требуется предварительное согласие автора); 1 примеров чувствительного уровня скрыты; данный пункт не был протестирован
Триггерные слова: inbtsint
【S】Minimax H3: t2va (T2V) – Polyhedron: Better Hair · v1.0
LoRA · Новая модель · Автор Polyhedron_AI · Опубликовано 11-06 01:41 · Загрузок 197
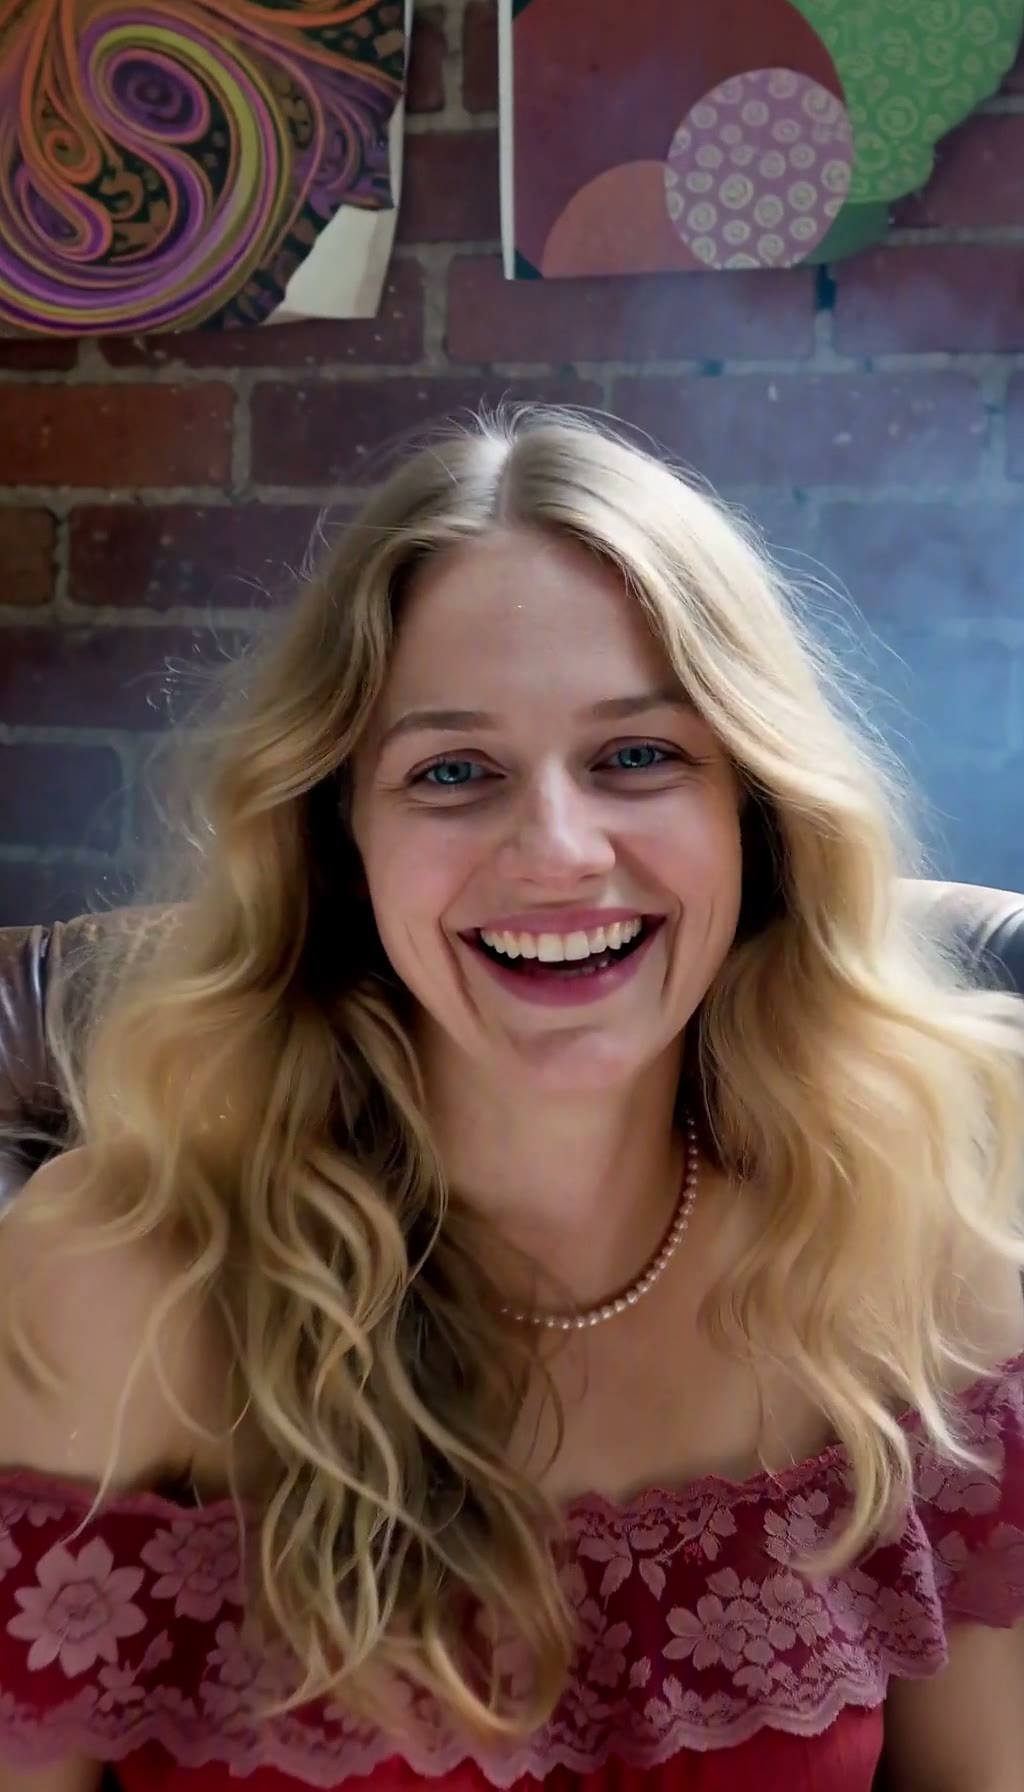
LoRA для исправления волос в H3: автор отмечает, что генерируемые H3 волосы часто имеют пушистую, трескающуюся текстуру. Эта LoRA корректирует общую структуру прядей, устраняя этот эффект; сам автор характеризует результат как «лучше», а не «идеально».
Можно провести сравнение при одинаковом промпте и одном и том же сиде с тремя уровнями интенсивности: 0 / 0.6 / 0.7, чтобы проверить, уменьшается ли пушистость волос.
Иллюстрации
Причины рекомендации
- Решает проблему качества волос персонажей в текстово-видеогенерации (в названии модели указано t2va); это универсальная корректирующая LoRA, которую можно использовать вместе с LoRA персонажей и стилей
- Указаны триггерные слова и интенсивность: ha8ir, интенсивность 0.6–0.7; автор также зарегистрировал описательные слова для качества волос, такие как perfect hair, thick hair, airy volume, natural waves
- Приложено 3 примеров видео; бесплатное скачивание; за 7 часов после публикации было 197 загрузок, что является одним из самых высоких показателей интереса в этом выпуске
Как использовать
- Загрузите polyhedron_minimax_h3_image_lora__hair_ha8ir.safetensors, интенсивность 0.6–0.7, в промпте укажите ha8ir, можно добавить описания thick hair, natural waves, soft flyaways и другие
- Наиболее стабильно работает при отдельном использовании; количество шагов и CFG автором не указаны, четыре сопутствующих рабочих процесса автора находятся на его Patreon; для наложения LoRA можно использовать узел ComfyUI-PolyhedronLoRAStack автора на GitHub
Риски и ограничения
- Автор прямо указывает, что при одновременном наложении нескольких LoRA ситуация усложняется, и результат не гарантирован
- Лицензия не разрешает коммерческое использование; в имени файла присутствует image_lora, что может означать, что обучающие материалы были изображениями, а не видео, но автор это не уточнил; 1 примеров чувствительного уровня скрыты; данный пункт не был протестирован
Триггерные слова: ha8ir, perfect hair, thick hair, airy volume, natural waves, soft flyaways, hair subsurface scattering
Рекомендуется (3)
【A】Pika H3 Flex Reference Workflow | Direct Movie Scenes With Sound From Your Pictures | 6 Steps | ComfyUI · v1.0
Рабочий процесс · Новая модель · Автор TheLocalLab · Опубликовано 11-06 00:34 · Загрузок 63
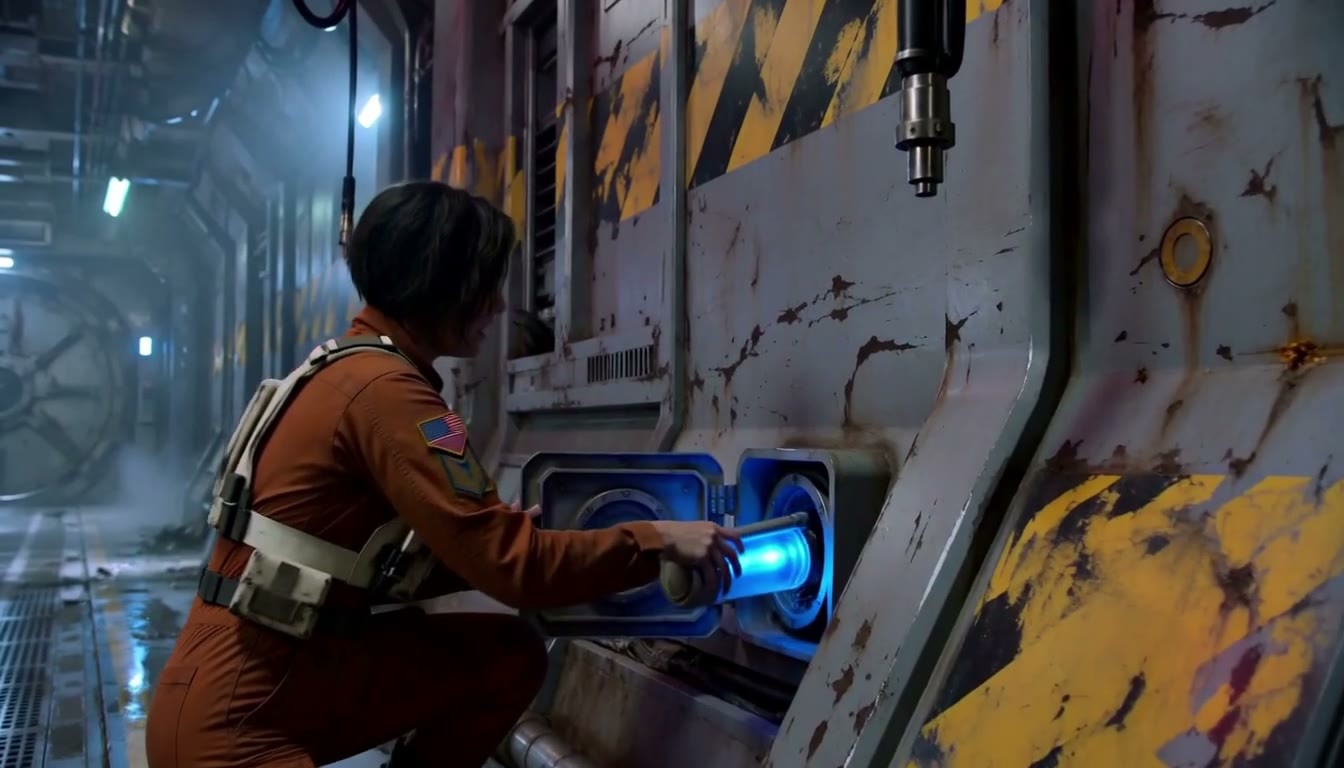
Рабочий процесс ComfyUI: используя 1–3 своих изображений в качестве референсов, локально с помощью Pika H3 Flex (адаптер референсных изображений Pika Labs на основе открытых весов H3) за 6 шага создаются короткие видеоролики с движением камеры, диалогами, звуковыми эффектами и музыкой. Добавлены ускоритель VSA и опциональный переключатель Semantic Bridge.
Иллюстрации
Причины рекомендации
- Подходит для генерации видео по референсным изображениям (Ref2VA) и генерации видео по первому кадру: каждое референсное изображение группируется отдельно, также можно переключиться в режим First Frame Mode для старта с одного изображения; на выходе получается видео со звуком, дополнительно доступен апскейл с помощью 2x RTX
- Связаны основная модель H3 Ref2VA int8, текстовый энкодер qwen3vl 32b, видео/аудио VAE, адаптер pika_h3_flex_ref2va, ускоритель fasth3_vsa_gate, Semantic Bridge, а также узлы Ref2VA VSA, Semantic Bridge, Memory Cleanup, RTX, KJNodes, rgthree, VideoHelperSuite; в примечаниях на схеме указаны ссылки на каждую модель
- Параметры предустановлены: сэмплер lcm, шесть ручных сигм Pika, CFG 1, интенсивность адаптера 1, разреженность gate 0.75; автор приводит время выполнения на RTX A4500 (20 ГБ): фрагмент 0.6 МП (1056x608) длительностью 5 секунд требует 1:43 шагов сэмплирования, без ускорителя — 2:11
- Приложены рекомендации по написанию промптов: одна локация и одна законченная история на сегмент, описание расположения объектов относительно кадра, указание положения камеры для каждого кадра, описание причинно-следственных связей, индивидуальное определение для каждого референса при использовании нескольких изображений
Как использовать
- Скачайте Pika-H3-Flex-References-SemanticBridge.json, скачайте модели согласно примечаниям на схеме и поместите их в директории diffusion_models / text_encoders / vae / loras и созданную директорию models/semantic_bridge, недостающие узлы установите через ComfyUI Manager
- Сохраняйте предустановленные параметры, держите узел очистки памяти включенным; сначала тестируйте промпты на коротких фрагментах. Автор Semantic Bridge обнаружил, что в тестах с ситкомами при включенном Semantic Bridge картинка лучше, а при выключенном — звук лучше; попробуйте оба варианта
Риски и ограничения
- Тяжелые зависимости: по подсчетам автора, общий объем моделей составляет около 48 ГБ, требуется PyTorch версии CUDA 13 (cu130), драйвер NVIDIA версии 580 или выше и относительно новая версия ComfyUI (автор тестировал на 0.44.0)
- Требования к видеопамяти: на карте с 20 ГБ памяти фрагмент 0.8 МП длительностью 15 секунд вызывает переполнение памяти, три референсных изображения при разрешении 1344x768 и длительности 15 секунд требуют карты с 24 ГБ памяти; варианты 16 / 12 ГБ были смоделированы автором путем ограничения памяти на карте с 20 ГБ, пиковое потребление для фрагмента длительностью 15 секунд составляет около 17 ГБ, рекомендуется начинать с коротких фрагментов
- Автор Semantic Bridge в версии v1 указал рабочие процессы с референсными изображениями как неподдерживаемые и предупредил о проблемах с синхронизацией губ при использовании референсного аудио; Pika H3 Flex и H3 распространяются по лицензии сообщества MiniMax H3, перед коммерческим использованием необходимо прочитать лицензию
- Доступно только 1 видимых примеров видео, еще 3 примеров чувствительного уровня скрыты; данный пункт не был протестирован
【A】Minimax H3 SEED HUNTER - Latent Upscaler, Seamless Video Continuation, Dialogue Gen Tool, Speedups, Ref Mods · v3.0
Рабочий процесс · Обновление версии · Автор foxydits · Опубликовано 11-06 07:57 · Загрузок 55
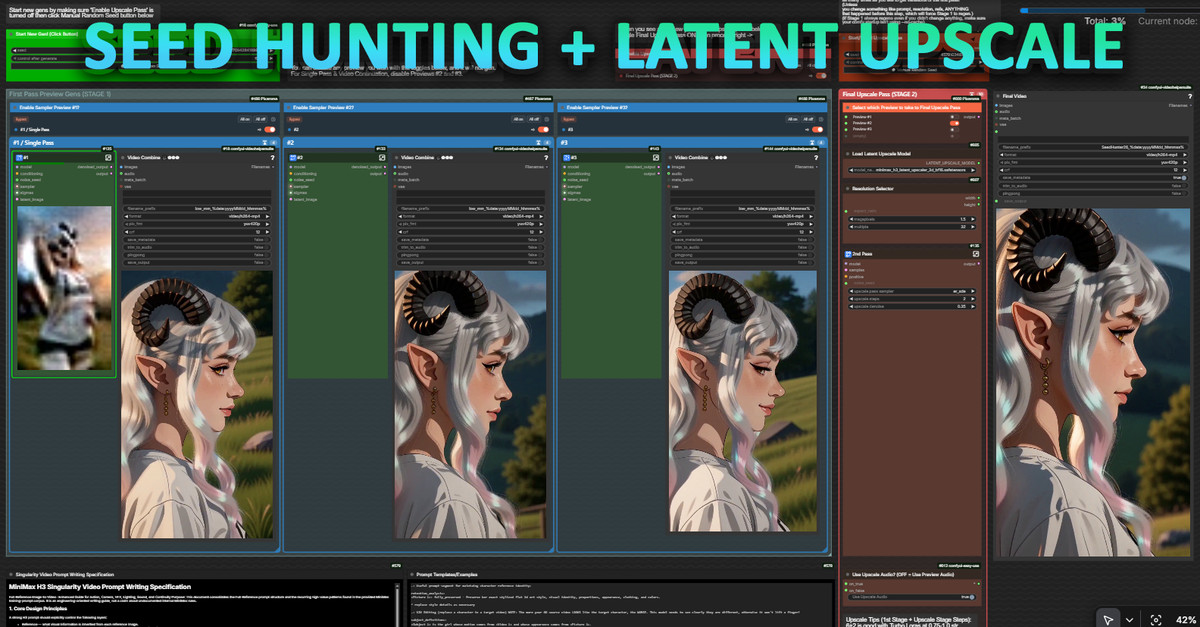
Seed Hunter v3.0: рабочий процесс «поиска сида», который сначала генерирует 3 превью низкого разрешения, а затем увеличивает выбранный удачный сид до финального качества. В этой версии используется встроенный латентный апскейлер ComfyUI, добавлены извлечение кадров, выборка анимационных кадров, редактор двойных промптов и другие опции.
Иллюстрации
Причины рекомендации
- Обновление версии: переход на встроенный в ComfyUI 0.44 Latent Upscaler от Kijai (автор утверждает, что он работает быстрее и решает проблему OOM из-за пиковых нагрузок на видеопамять), поэтому необходимо обновиться до 0.44
- Новое: сохранение первой/последней кадры в output/saved_frames/; извлечение кадров анимации Anime Cadence, чтобы ритм движений в 2D-анимации 2D напоминал традиционную анимацию; возможность использовать аудио из превью для финального вывода; второй редактор промптов позволяет писать следующий промпт во время выполнения; автоматическое сохранение промптов в output/prompts/
- Сам процесс охватывает бесшовное продолжение генерации, пользовательское аудио, интерполяцию кадров с 24 FPS до 48-60, инструменты для диалогов/клонирования голоса; всего на странице модели накопилось 39146 загрузок, 1111 лайков и 307 комментариев, что свидетельствует о высоком интересе
Как использовать
- После обновления ComfyUI до 0.44 импортируйте FoxFurEssence H3 Seed Hunter v3.json; скачайте указанный автором minimax_h3_latent_upscaler и поместите его в каталог latent_upscale_models
- Узлы: Anime Cadence, Pixaroma, Prompt IDE, MiniMaxH3-PromptBuilder, RefMods и другие, большинство из которых можно установить через Comfy Registry; для ускорения можно настроить рекомендуемые автором turbo LoRA Silveroxide Dareties и видео VAE int8 от Kijai
Риски и ограничения
- В описании v3.0 автор пометил «скоро будет выпущено», существующие руководства относятся к v2.5; много зависимых узлов, которые нужно проверять по одному
- Доступно только 2 видимых примеров изображений, 5 примеров с чувствительным контентом скрыты, видимых видео нет; данный пункт не был протестирован
【A】Длинный кадр MiniMax H3: один 40-50-секундный дубль из цепочки сегментов (12 ГБ) · v1 (протестировано на 12 ГБ)
Рабочий процесс · Новая модель · Автор semenovsas776 · Опубликовано 11-06 04:32 · Загрузок 55
Рабочий процесс и пакет скриптов, которые склеивают 4-6-секундные сегменты H3 в непрерывный длинный кадр длительностью 40-50 секунд; автор выполнил это на RTX 4070 SUPER с 12 ГБ видеопамяти; автор утверждает, что лица, одежда и цвета сохраняются до конца, а стыки незаметны.
Самая полная схема для длинных кадров в этом выпуске: вместе с рабочим процессом предоставляются планирование промптов и скрипты контроля качества, что идеально подходит для тех, кто хочет снять диалоговую сцену одним дублем — сначала прочитайте статью, затем приступайте к работе.
Иллюстрации
Причины рекомендовать
- Решает проблему ограниченной длительности одного сегмента H3 и скачков при склейке длинных видео: каждый сегмент продолжает генерацию от хвоста латентного представления предыдущего (режим продолжения FeiHou Easy H3, 22+22 кадров), начиная с 2-го сегмента используется режим с опорным изображением лица и стартовым кадром, в тексте каждого сегмента полностью повторяется описание одежды и описываются предметы в зависимости от состояния
- Архив содержит всё необходимое: UI-рабочие процессы для 1-го и N-го сегментов (с инструкциями по настройке), соответствующие схемы в формате API, системные промпты для планирования (вставьте в любой чат-ассистент для генерации текстов сегментов) и план раскадровки для сцены в кафе, а также скрипты проверки плана, пакетного запуска цепочки через API ComfyUI, обнаружения стыков/зависаний, проверки сходства лиц и таблицы просмотра
- Автор указал время выполнения: на RTX 4070 SUPER + 96 ГБ ОЗУ 1-й сегмент занимает около 1.5 минут, каждый последующий — 2.5-3.5 минут; полный метод описан в отдельной статье (civitai.com/articles/38141)
Как использовать
- Требуется ComfyUI + FeiHou Easy H3, FeiHou Toolbox, KJNodes, модель MiniMax H3 Remix v0.8, текстовый энкодер и VAE от Comfy-Org/MiniMax-H3, а также усилитель латентного представления H3; ReActor нужен только при замене лица на первом кадре
- Сначала используйте промпт для планирования, чтобы чат-ассистент написал тексты для всех сегментов, запустите 1-й сегмент, затем продолжайте генерацию сегментов за сегментом с помощью рабочего процесса для N-го сегмента или используйте прилагаемые скрипты для автоматического запуска всей цепочки через API
Риски и ограничения
- Оба примера видео (реалистичная и комикс-версии одной и той же сцены в кафе) помечены как чувствительный контент и скрыты, поэтому реальный эффект стыков не виден, уровень чувствительности указан в документации
- Основная модель — MiniMax H3 Remix v0.8, а не официальные веса; автор не уточняет, будет ли стыковка работать так же хорошо при смене модели; данный пункт не был протестирован
- Иллюстрация на карточке — это сгенерированная ИИ схема, а не реальный результат работы модели; у автора нет публичных примеров с обычным рейтингом
Стоит обратить внимание (5)
【B】Minimax.. simple · v5.1
Рабочий процесс · Обновление версии · Автор sy0ww4bb1984 · Опубликовано 11-06 03:10 · Загрузок 35
Версия v5.1 крупного рабочего процесса «Minimax.. simple» для генерации видео из опорных изображений + сегментированного удлинения + апскейлинга: добавлены опции видео-референса, инструкции по замене человека в видео (video to video replace), сквозной режим (passthrough) для апскейлинга, а также снова добавлено kitchen attention.
Иллюстрации
Причины рекомендовать
- Обновление версии: по сравнению с v5 добавлены входные данные видео-референса и инструкции по замене vid2vid; автор на странице отметил, что в v5.1 для генерации видео был обязателен видео-референс, но это было исправлено в версии 5.11 (имя файла загрузки: minimaxv5.11.zip)
- Весь процесс объединяет генерацию видео из опорных изображений (несколько изображений, несколько аудио-референсов), пакетное удлинение по количеству кадров с синхронизацией аудио, три типа апскейлинга (RTX / latent / resize), возможность менять LoRA, промпты, сиды и референсы в каждой партии; всего на странице модели накопилось 2860 загрузок
- Автор перечислил источники дистиллированных и апскейл-LoRA: MiniMax-H3-experimental от Kijai, loras от Comfy-Org, Pika-H3-Flex-Turbo-LoRA
Как использовать
- Скачайте и распакуйте minimaxv5.11.zip, импортируйте в ComfyUI; подсказки по параметрам от автора: сила LoRA 0.4-1.0, сегменты задаются по количеству кадров, а не по секундам, максимум 300 кадров при 1MP в одной партии, опционально доступны шаги sigma Beta57 8 / 6 / 4
- Для апскейлинга рекомендуется использовать коэффициент 2x (автор утверждает, что нецелые коэффициенты растягивают изображение); для узлов памяти необходимо держать независимые латентные представления аудио и видео включенными и расположенными вне групп
Риски и ограничения
- Примечания к обновлению разрозненны: v5.1 и 5.11 описаны вперемешку, что такое kitchen attention и как подключить видео-референс, не раскрыто
- Автор признается, что у него только один компьютер среднего уровня, и ему сложно протестировать весь этот большой процесс, обновления ComfyUI часто его ломают; зависимые узлы и модели нужно проверять самостоятельно
- Доступно только 1 видимых примеров изображений, 4 примеров с чувствительным контентом скрыты, видимых видео нет; данный пункт не был протестирован
【B】Lonecat’s MiniMax H3 FL2VA/ REF2VA | Рабочий процесс для видео с низким VRAM с оптимизаторами Low VRAM, апскейлером и пост-обработкой · V9.0 Быстрее и лучше
Рабочий процесс · Обновление версии · Автор lonecatone23 · Опубликовано 11-06 08:04 · Загрузок 14
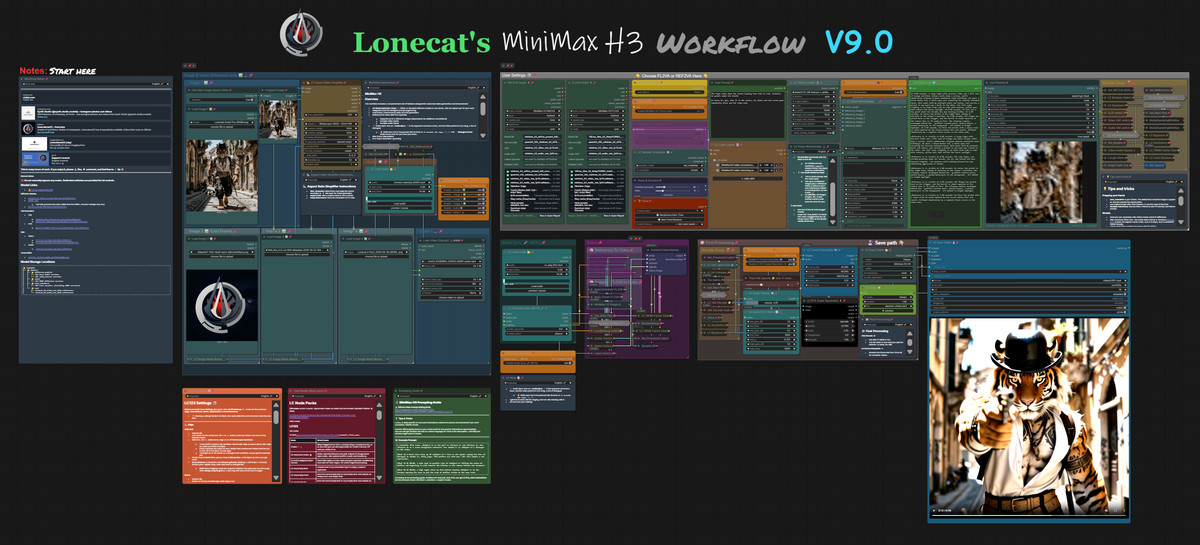
Крупный рабочий процесс Lonecat для генерации видео из первой/последней кадры / опорных изображений H3 версии V9.0: единственное явно указанное изменение — удаление Ultimate Upscale и замена его методом апскейлинга, который автор протестировал при создании другого рабочего процесса.
Иллюстрации
Причины рекомендовать
- Обновление версии: автор утверждает, что после тестирования многих методов апскейлинга обнаружил, что большинство подходов других людей имеют проблемы, поэтому он удалил Ultimate Upscale; автор говорит, что результат стал лучше, но конкретный метод описан во внешней ссылке и не раскрыт на странице модели
- Сам процесс поддерживает первую/последнюю кадры (FLF2V) и опорные изображения (REF2V, до 4 опорных изображений), ввод видео и аудио, собственный инструмент автора LC Vision для написания промптов по изображениям, интерполяцию кадров RIFE, суперразрешение RTX, а также модели GGUF; примечания на изображении на китайском языке
- Бесплатно; всего на странице модели накопилось 5301 загрузок и 207 лайков
Как использовать
- Импортируйте MiniMax H3 Ver 9.0 (1).json; автор только что обновил свой пакет узлов, при ошибках скачивайте вручную с GitHub автора (lonecatone23)
- Автор отмечает, что это продвинутый рабочий процесс, не предназначенный для новичков; новичкам можно использовать другой упрощенный рабочий процесс автора. Количество шагов и требования к видеопамяти автор не указал
Риски и ограничения
- Примечание к обновлению состоит всего из одной фразы, детали метода апскейлинга находятся во внешней ссылке, на странице модели их проверить нельзя
- Зависит от нескольких пакетов узлов самого автора; доступно только 1 видимых примеров изображений, 2 примеров с чувствительным контентом скрыты; данный пункт не был протестирован
【B】Easy MH3 (генерация видео + апскейл с использованием чанкинга + 60 FPS) · v1.0
Рабочий процесс · Новая модель · Автор Crimson009 · Опубликовано 11-05 23:15 · Загрузок 67
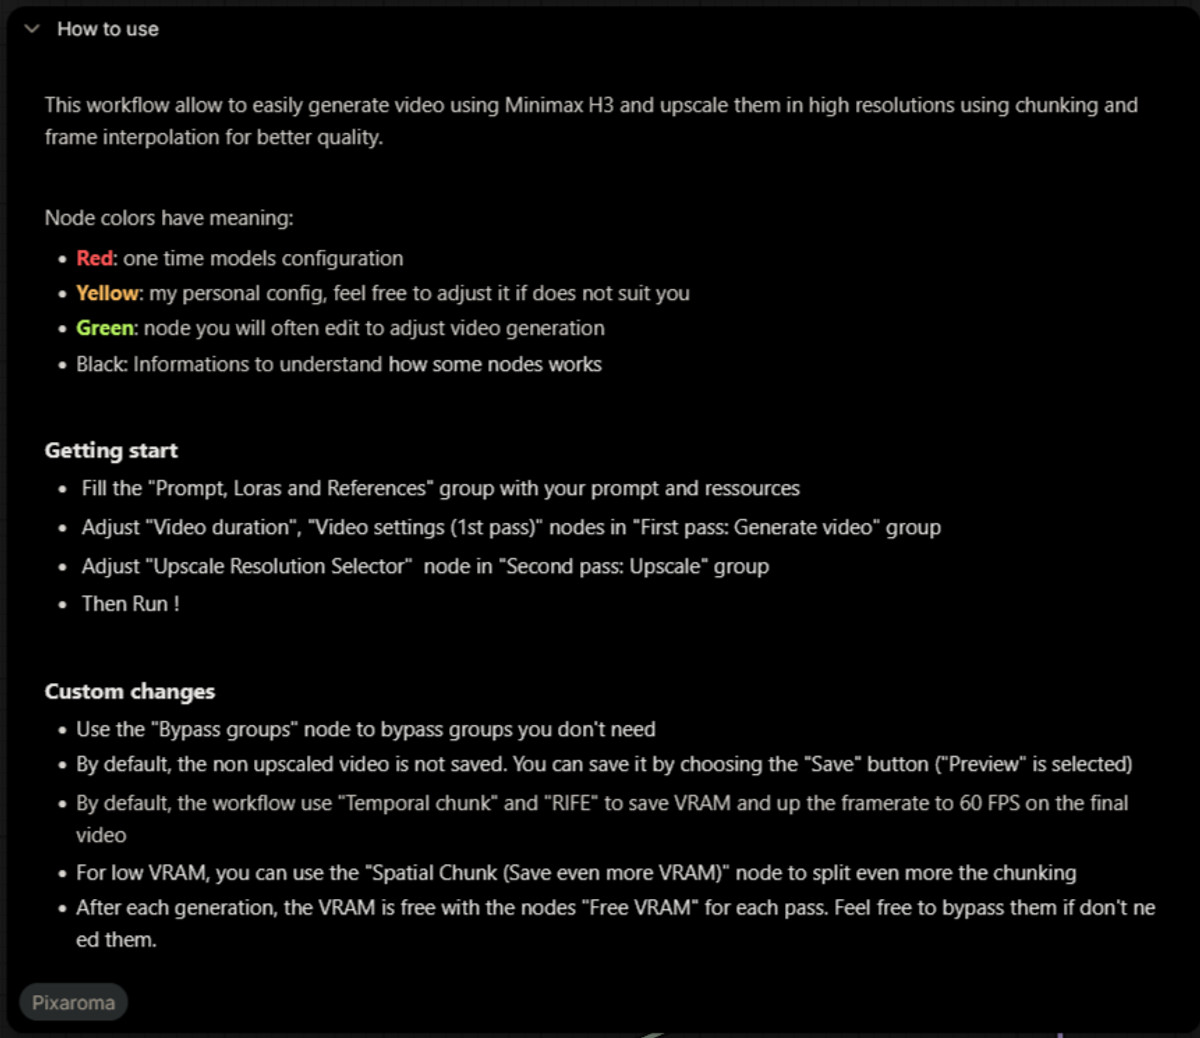
Двухпроходный рабочий процесс H3: первый проход генерирует видео, второй проход использует временное разбиение на блоки (Temporal chunk) для апскейлинга до высокого разрешения, затем интерполирует кадры до 60 FPS с помощью RIFE; основной упор сделан на экономию видеопамяти и простоту использования.
Иллюстрации
Причины рекомендовать
- Подходит для сценариев, где нужны видео в высоком разрешении и с высокой частотой кадров, но видеопамять ограничена: по умолчанию используется временное разбиение на блоки + RIFE, при еще меньшей видеопамяти можно использовать пространственное разбиение (Spatial Chunk) для дальнейшего уменьшения блоков, в конце каждого прохода узел Free VRAM освобождает видеопамять
- Узлы различаются по цвету в зависимости от назначения: красные — одноразовая настройка моделей, желтые — личные настройки автора, зеленые — часто изменяемые параметры генерации, черные — пояснения
- Пошаговые инструкции написаны четко: заполните группу «Prompt, Loras and References», настройте длительность видео и параметры первого прохода, затем выберите разрешение апскейла и запустите; ненужные группы отключаются узлом «Bypass groups»
Как использовать
- Импортируйте Easy_MMH3_2pass_chunked_RIFE_upscale_V1.json и заполните поля в указанном порядке; неапскейленные видео по умолчанию только предпросматриваются, но не сохраняются, при необходимости измените Preview на Save
- Автор не указал, какие модели, узлы, количество шагов и объем видеопамяти требуются
Риски и ограничения
- Список зависимых моделей и пользовательских узлов отсутствует, можно только импортировать и смотреть, чего не хватает
- Доступно только 1 видимых примеров изображений, 2 примеров с чувствительным контентом скрыты, видимых видео нет, эффект апскейла проверить невозможно; данный пункт не был протестирован
【B】Prophetero Test Bench + Take Compare GLOBAL · v0.4
Рабочий процесс · Новая модель · Автор Prophetero · Опубликовано 11-05 22:09 · Загрузок 19
Инструмент для тестирования и сравнения (Test Bench + Take Compare, бета-версия), встроенный в ComfyUI: в одном рабочем процессе сначала выполняются короткие пробные прогоны базовой версии без LoRA и нескольких комбинаций LoRA, затем изображения, движение и аудио сравниваются бок о бок на одной странице, после чего настройки выбранной комбинации можно одним нажатием преобразовать в рендеринг полной длины или экспортировать рабочий процесс.
Иллюстрации
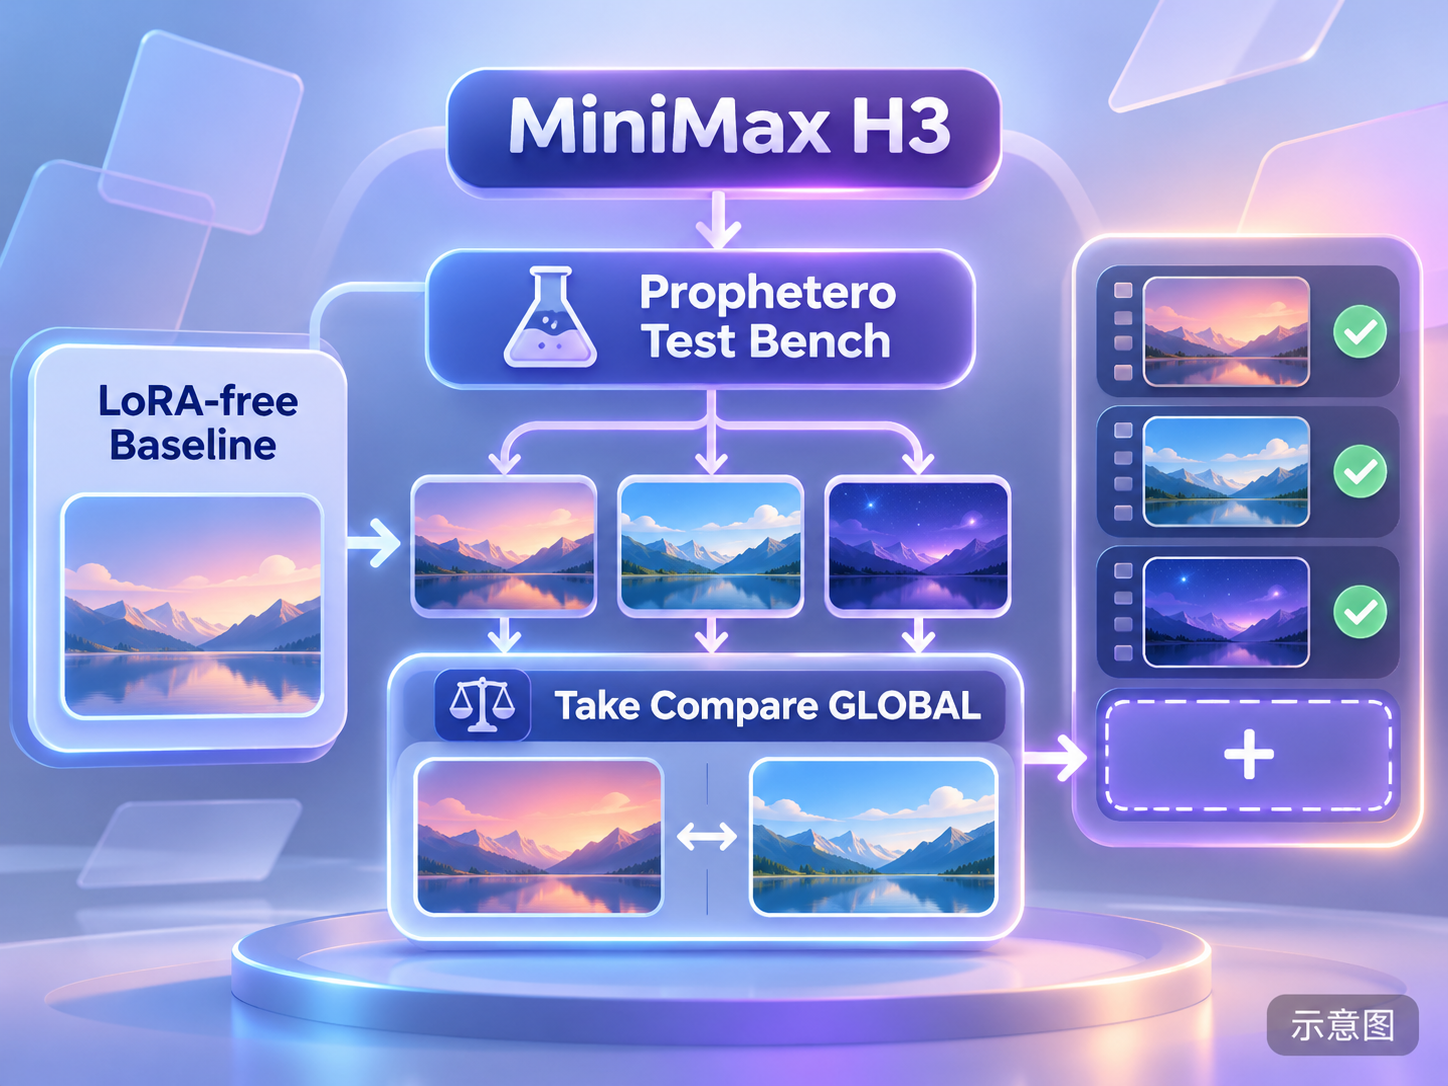
Причины рекомендовать
- Решает проблему рабочего процесса при настройке комбинаций LoRA, когда приходится постоянно переключать вкладки и запоминать параметры: на каждой карточке образца можно искать LoRA, отдельно включать/выключать их и настраивать силу, сохраненные настройки отображаются; инструмент распознает элементы управления длительностью H3 / LTX и автоматически сокращает пробные прогоны, завершенные прогоны не перезапускаются при добавлении новых экспериментов
- Take Compare позволяет одновременно сравнивать до четырех видео, поддерживает покадровый просмотр, временной сдвиг, синхронное масштабирование, заметки и маркеры, скорость воспроизведения от 0.25x до 2x; можно просматривать моно/стерео-волны исходной аудиодорожки и уровни пиков / RMS
- Поддерживает Power Lora Loader (rgthree), LoraLoader, LoraLoaderModelOnly, выходные узлы поддерживают SaveVideo и VHS_VideoCombine; интерфейс доступен на восьми языках
Как использовать
- Распакуйте весь ZIP-архив, остановите бэкенд, запустите START_HERE.cmd и выберите фактический используемый бэкенд ComfyUI, перезапустите SwarmUI / ComfyUI и обновите браузер; откройте рабочий процесс, который корректно генерирует результат, щелкните правой кнопкой мыши на пустом холсте и выберите Prophetero · Test Bench + Take Compare
- Ограничения сравнения: длительность одного сегмента 0.5–120 сек., 1–60 FPS, максимум 8 МП и 2 ГиБ
Риски и ограничения
- Публичная бета-версия, автор указывает, что при тестировании инференс был симулированным, совместимость со всеми реальными моделями и пользовательскими узлами не гарантируется; успешный короткий пробный запуск не означает, что рендеринг полной длины будет успешным
- Это не обычный JSON рабочего процесса, а пакет плагина со скриптами установки для Windows; перед установкой следует изучить файлы внутри пакета; лицензия запрещает продажу данного программного обеспечения
- Доступно только 1 примеров чувствительного уровня, и они скрыты, видимых примеров нет; данный пункт не был запущен
- Изображение на карточке является сгенерированной ИИ схематической иллюстрацией, а не фактическим результатом работы модели; у автора нет публичных примеров обычного уровня
【B】H3: Authentic texture and award-winning, master-class acting. · v1.0
LoRA · Новая модель · Автор TuTu_1018 · Опубликовано 11-05 21:29 · Загрузок 254
LoRA «Реалистичная текстура и актерская игра уровня оскароносного мастера»: автор утверждает, что она усиливает детали лица персонажей, микровыражения, изменения взгляда и эмоциональную выразительность, делая персонажей в диалогах, эмоциональных сценах и драматических эпизодах более похожими на живых актеров, а не на механические движения.
Иллюстрация
Причины рекомендации
- Подходит для текстово-видео / изображение-в-видео с реалистичными персонажами в диалогах и эмоциональных крупных планах, фокус на качестве актерской игры, а не на конкретном персонаже или стиле рисунка
- Примерно за полдня после публикации было 254 загрузок и 21 лайков, это самая загружаемая версия в этом выпуске, но это лишь показатель уровня интереса
- Автор разместил одноименный онлайн-рабочий процесс на RunningHub (ссылка содержит пригласительный код)
Как использовать
- Загрузите lora.safetensors H3 с реалистичной текстурой и актёрской игрой уровня «оскароносного» исполнителя; триггерные слова не указаны автором, параметры интенсивности и количество шагов также не заданы автором
Риски и ограничения
- Карточка модели содержит только рекламные описания, без информации об обучении, параметров и сравнений; единственный пример относится к чувствительному уровню и скрыт, фактический эффект актерской игры недоступен для просмотра
- Описание продублировано дважды, в основном для перенаправления на внешнюю платформу; данный пункт не был запущен
- Изображение на карточке является сгенерированной ИИ схематической иллюстрацией, а не фактическим результатом работы модели; у автора нет публичных примеров обычного уровня
Только для архива (7)
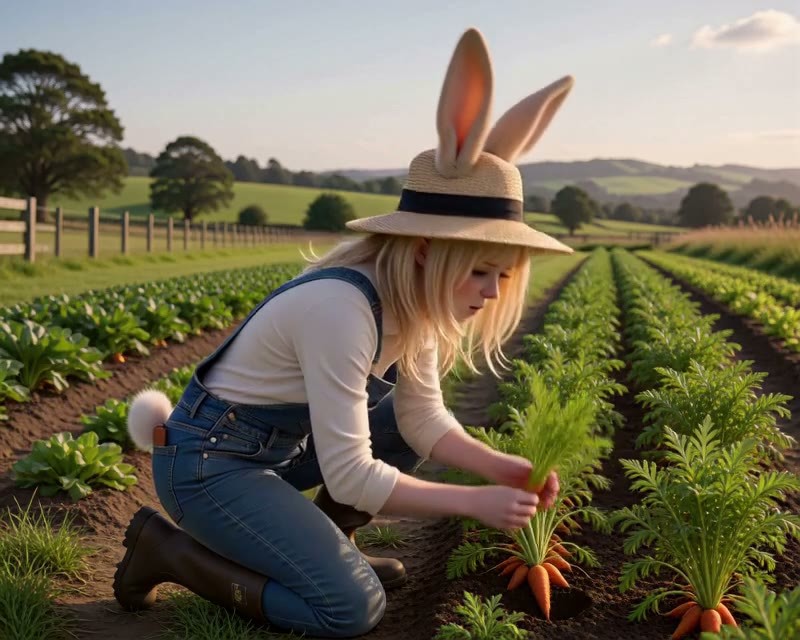
- Bonnie Rabbit · v1.0 H3 — LoRA: LoRA персонажа H3 для оригинального персонажа автора Bonnie Rabbit (владелица морковной фермы в сельской местности Новой Зеландии) с кроличьими ушами, триггерное слово bonnielora.
- Nevaeh Belwyn · MiniMaxH3 — LoRA: LoRA персонажа H3 для вымышленного женского персонажа Nevaeh Belwyn (архивариус старинных книг в Брюгге, одетая в винтажную шерсть и античное кружево), автор утверждает, что это не реальный человек.
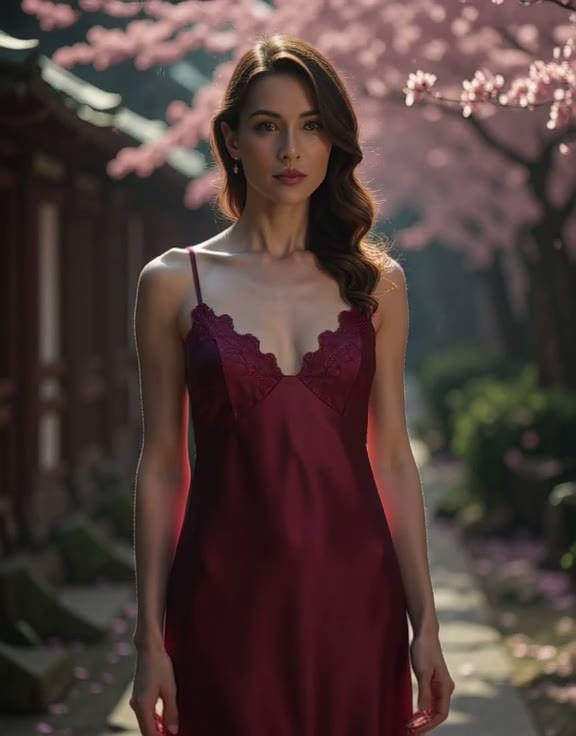
- Looney Red Riding Hood :: MMH3 Character · v1.0 — LoRA: LoRA персонажа «Красная Шапочка» в стиле мрачной сказки (оскаленная улыбка, светлые волосы, потрепанный красный плащ), обученная на дизайне персонажа и референсах стиля художника @phatestronaught, ориентирована на генерацию видео из текста.
- Sam Bramblepot · v1.0 H3 — LoRA: LoRA персонажа H3 для оригинального персонажа автора Sam Bramblepot, карлика-садовника, триггерное слово samlora.
- Nox · v1.0 H3 — LoRA: LoRA персонажа H3 для оригинального женского персонажа автора Nox («живая тень» с кожей, поглощающей свет, и серебряными глазами), триггерное слово noxlora.
- Flat Lindsay · v1.0 H3 — LoRA: LoRA H3 для оригинального персонажа автора Flat Lindsay: девушка-«бумажная фигурка», которая спереди выглядит как иллюстрация с контуром, почти исчезает при повороте в профиль, но нормально живет в трехмерном мире.
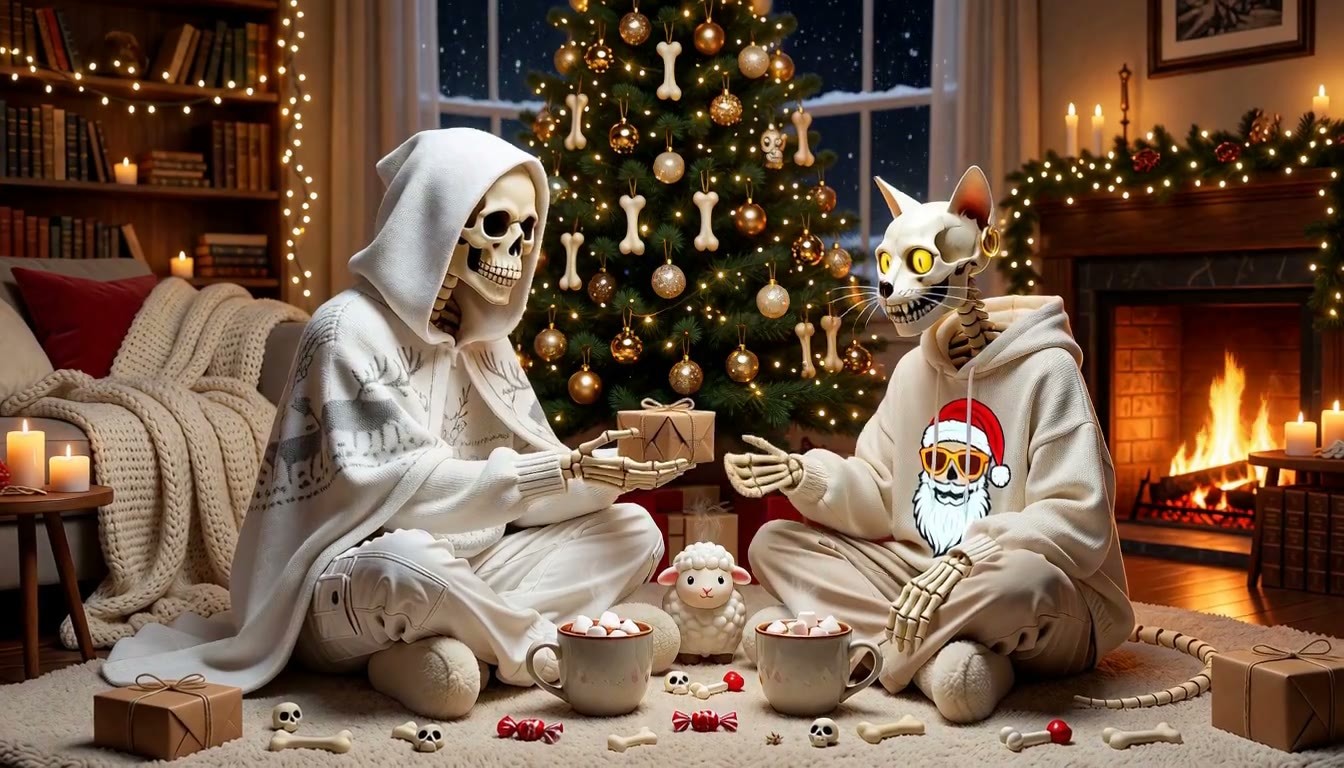
- 🎄LORU & RIBS: CHRISTMAS BONE DANCE · v1 — LoRA: Рождественская LoRA с двумя персонажами: белый капюшонный жнец Loru и его скелет-кот Ribs пьют горячее какао у камина, катаются на льду и обмениваются подарками; автор утверждает, что модель хорошо справляется с текстурой вязаных изделий, структурой костей и магическими световыми эффектами.
Данные: публичный API Civitai (базовая модель MiniMax H3), окно отбора 11-05 20:31 → 11-06 09:01 (пекинское время). Причины рекомендации проверены редакторами; количество загрузок отражает только уровень интереса.