貞貞のAIレーダー · MiniMax H3 · 2026-11-06 朝刊
今号の 17 件の新バージョン:強く推奨 2 · 推奨 3 · 注目 5 · 収録のみ 7
編集者按語 今号では 17 件の H3 新バージョンをレビューしました。初推しは INBT セル画風 LoRA:H3 のデフォルトで揺れ動くアニメ画風を、墨線による輪郭描画とフラットな影付けのセル画風に統一します。トリガーワード、重み、プロンプト構造、サンプリング設定をすべて記載し、6 本のサンプル動画を添付しています。Better Hair は H3 の髪のゴワつきや砕けた質感を除去し、こちらも S 評価です。その他の注目点は、Pika H3 Flex の参考画像からの出力ワークフロー、Seed Hunter v3、そして 12 GB の GPU で動作する分割結合による長尺ショット処理フロー(サンプルは非公開、ドキュメントに基づき A 評価)です。Minimax.. simple v5.1 と Lonecat V9.0 は更新幅が小さいか説明が散漫であり、Easy MH3 は依存関係リストが欠けているため B 評価に下げました。6 件の一般的なキャラクター LoRA はパラメータがなく、多くは目に見えるサンプルがないため C 評価に下げました。
強く推奨(2)
【S】INBT Cel Style - MiniMax H3 · H3 V1
LoRA · 新モデル · 作者 AriaMaiven · 公開 11-06 05:49 · ダウンロード 54
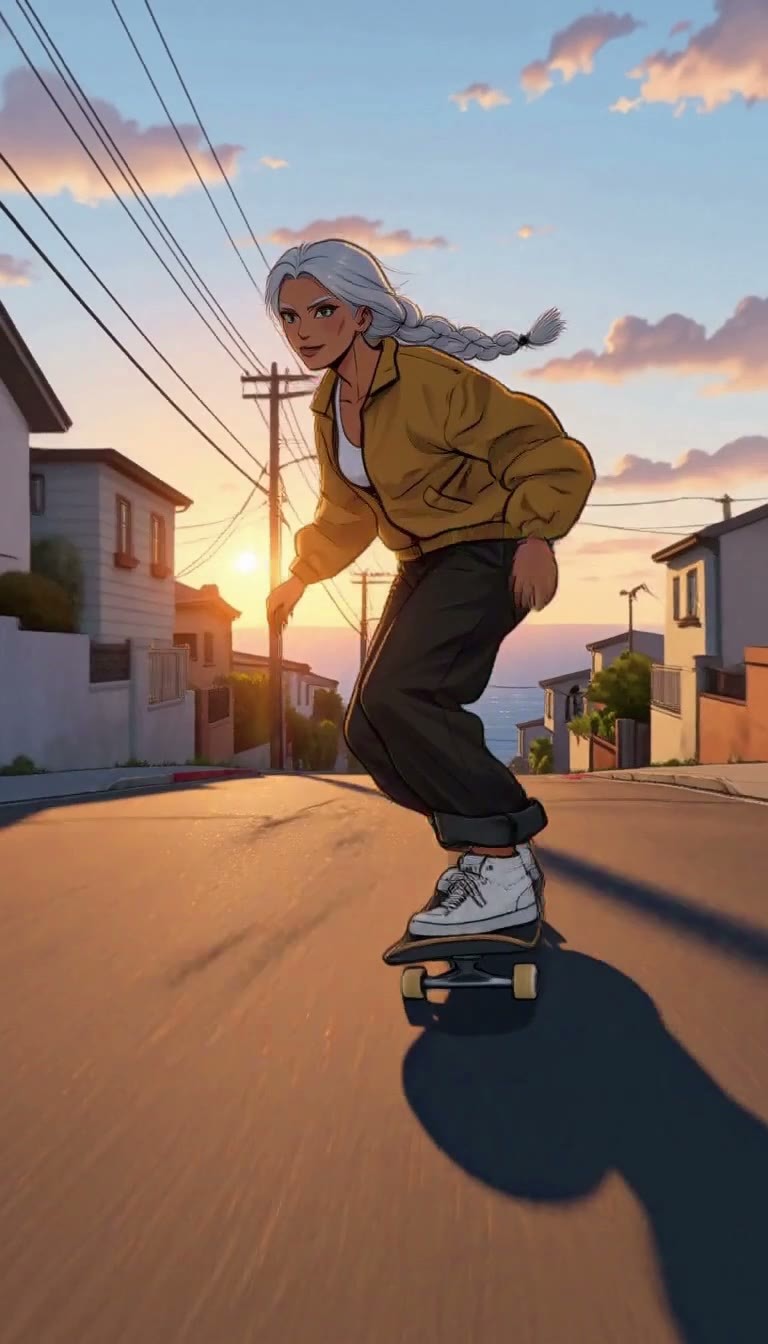
セル画アニメ画風の LoRA:確かな墨線による輪郭描画、フラットな影付け、雨夜のネオンカラーを特徴とし、H3 のデフォルトでアメリカンカートゥーンと韓国漫画の間で揺れ動くアニメ画風を一種類に統一します。作者によれば、カメラワークやキャラクターの会話・歌唱時でも画風は変わらないとのことです。
画風 LoRA では珍しく、「描き方を説明せず、キャラクターを説明する」というプロンプトの役割分担が明記されており、その最初のテンプレートに従って記述すれば再現可能です。
画像
推奨理由
- テキストから動画生成における 2D アニメーション短編、MV、会話シーンに対応:作者によれば、ワンカットで二人、会話と歌唱のリップシンク、無人の空街、夕暮れやネオン光でも画風を維持できる
- 画風自体に固定された顔立ちはなく、プロンプトに書いた人物を描くため、自分のキャラクターをこの画風に適用できる
- 使い方が完全に記載されている:トリガーワード、重み、プロンプトの最初のテンプレート、サンプラー、スケジューラー、ステップ数、解像度、長さ、学習ベースモデルがすべて提供されている。6 本のサンプル動画を添付
- 無料ダウンロード、商用利用許可あり(画風のクレジットが必要)
使い方
- inbt_h3_v1.safetensors を読み込み、重み 0.8。公式の H3 プロンプト形式に従い、最初の文にスタイルを記述:[Shot 1] 2D-animated in the inbtsint style, a medium shot at eye level...
- 線、影、anime などの描き方をこれ以上説明しないこと(トリガーワードが担当している)。各キャラクターの髪型、目、肌色、タトゥー、服装をすべて詳細に記述する
- 作者のテスト環境:ComfyUI 内の MiniMax H3 FL2VA pruned int8 ConvRot テキストから動画生成、20 ステップ、res_multistep + simple、768x1344 または 1344x768、5 秒。学習ベースモデルは FL2VA pruned
リスクと制限
- 重みを 1.0 に上げると線が太くなり、要求していない記号(額の十字、こめかみの傷)が顔に描かれるため、作者は 0.8 を推奨している
- 背景の文字が文字化けするが、作者はこれは H3 自体の問題であり、LoRA とは無関係だと説明している
- 転載禁止、またこの LoRA の出力画像を用いて他のモデルを学習させることも禁止(事前に作者の同意が必要)。1 件のセンシティブなサンプルは非公開。本項目は未実行
トリガーワード:inbtsint
【S】Minimax H3: t2va (T2V) – Polyhedron: Better Hair · v1.0
LoRA · 新モデル · 作者 Polyhedron_AI · 公開 11-06 01:41 · ダウンロード 197
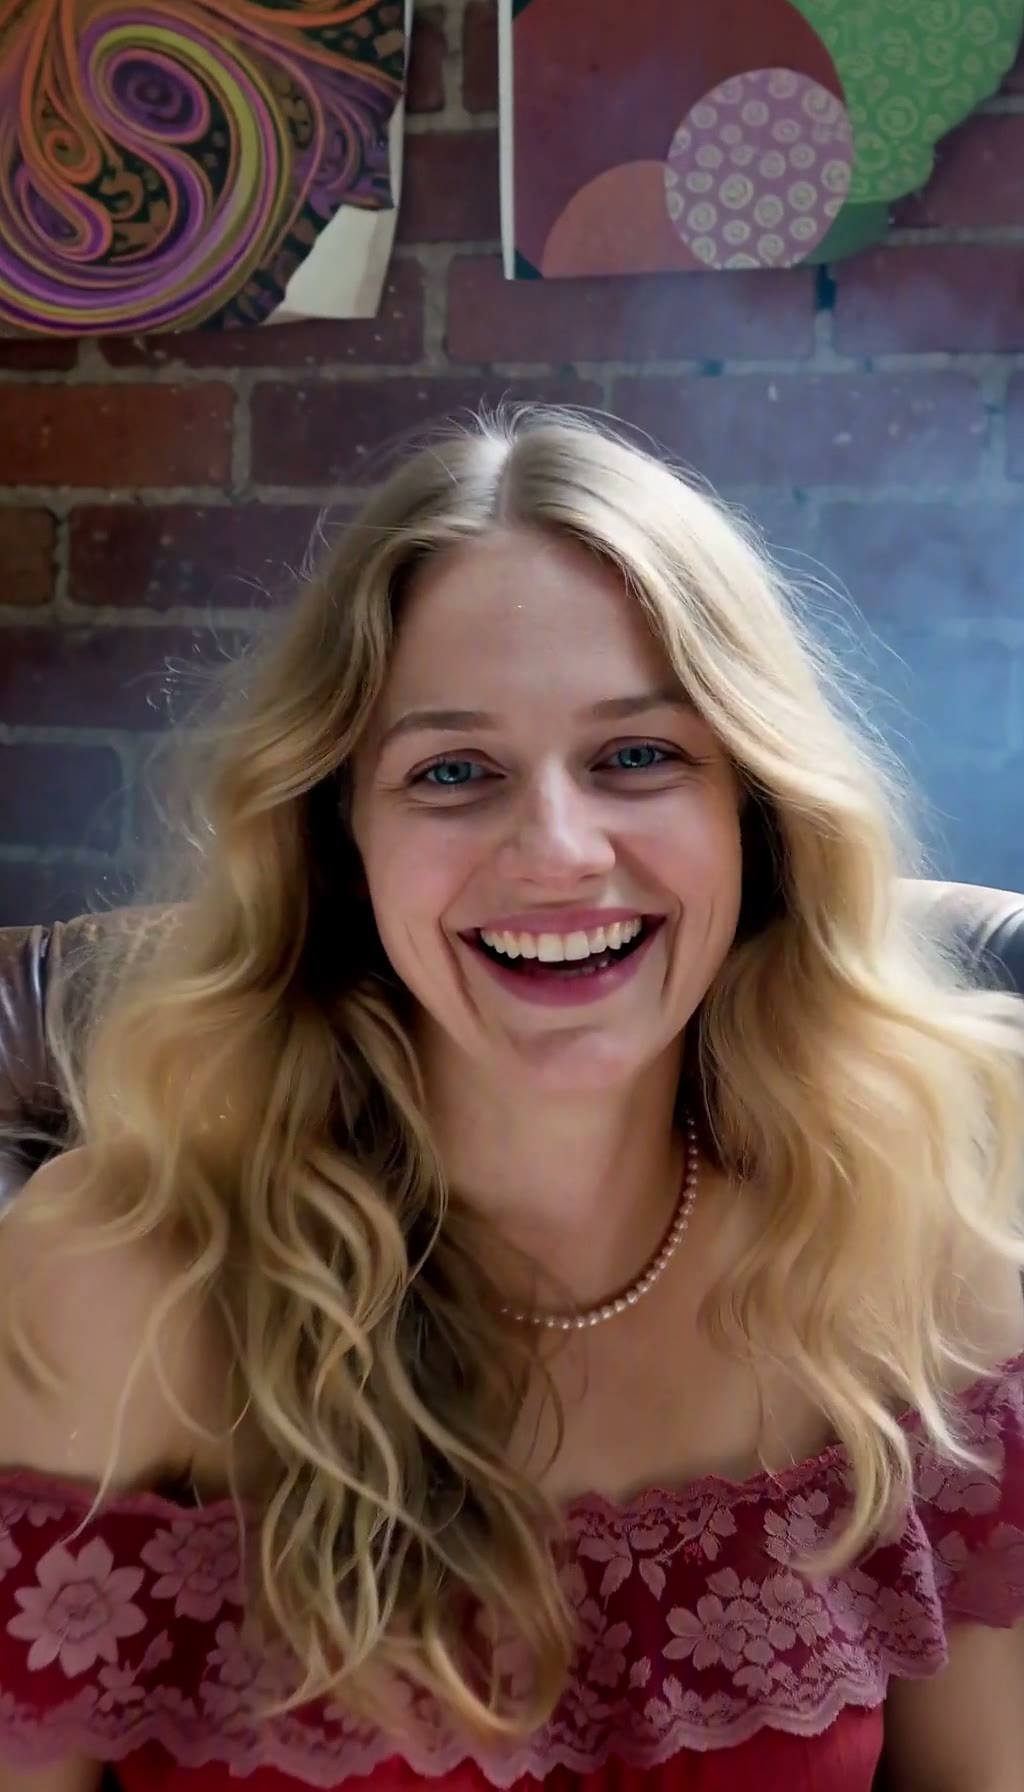
H3 の髪を修正する LoRA:作者によれば、H3 が生成する髪にはよくゴワつきやパチパチと砕けたような質感が見られるが、この LoRA は髪全体の構造を調整してその感覚を除去する。作者自身は「完璧」ではなく「より良い」と述べている。
同じプロンプト、同じシードで 0 / 0.6 / 0.7 の 3 段階で比較し、髪のゴワつきが減少しているか確認できる。
画像
推奨理由
- テキストから動画生成(モデル名に t2va と記載)における人物の髪の質感問題に対応する汎用修正型 LoRA で、キャラクターやスタイル LoRA と併用可能
- トリガーワードと強度が提供されている:ha8ir、強度 0.6–0.7。作者は additionally perfect hair、thick hair、airy volume、natural waves などの髪質記述ワードも登録している
- 3 本のサンプル動画を添付。無料ダウンロード。公開 7 時間で 197 回のダウンロードがあり、注目度は今号で最高クラス
使い方
- polyhedron_minimax_h3_image_lora__hair_ha8ir.safetensors を読み込み、強度 0.6–0.7、プロンプトに ha8ir と記述。thick hair、natural waves、soft flyaways などの記述を追加可能
- 単独使用が最も安定。ステップ数、CFG は作者が提供していない。作者の 4 つの関連ワークフローは Patreon 上にあり、LoRA の重ね掛けは作者の GitHub にある ComfyUI-PolyhedronLoRAStack ノードと連携可能
リスクと制限
- 作者は複数の LoRA を同時に重ねると状況が複雑になり、効果が保証されないと明言している
- ライセンスは商用利用を許可していない。ファイル名に image_lora とあり、学習素材は動画ではなく画像である可能性があるが、作者は説明していない。1 件のセンシティブなサンプルは非公開。本項目は未実行
トリガーワード:ha8ir、perfect hair、thick hair、airy volume、natural waves、soft flyaways、hair subsurface scattering
推奨(3)
【A】Pika H3 Flex Reference Workflow | Direct Movie Scenes With Sound From Your Pictures | 6 Steps | ComfyUI · v1.0
ワークフロー · 新モデル · 作者 TheLocalLab · 公開 11-06 00:34 · ダウンロード 63
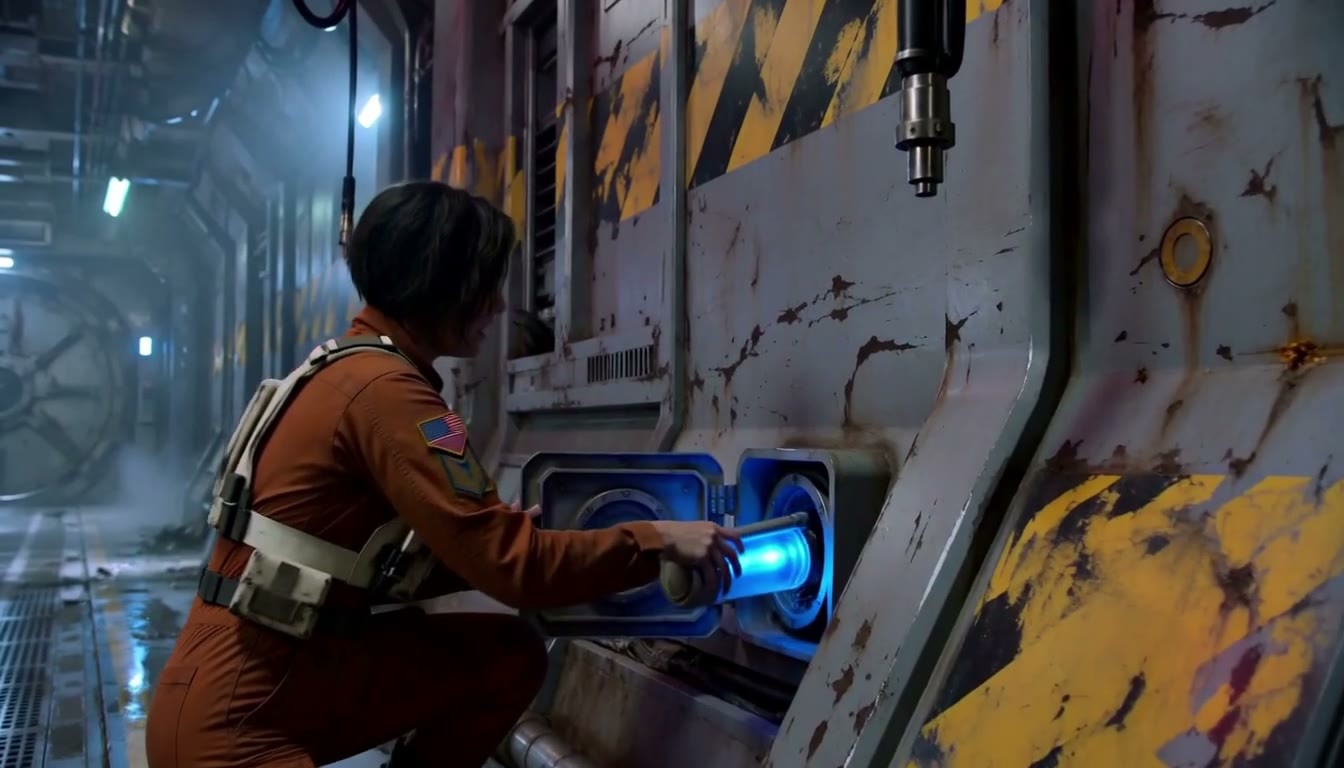
ComfyUI ワークフロー:自分の画像 1–3 枚を参考画像として使用し、ローカルで Pika H3 Flex(Pika Labs が H3 のオープンウェイトを基にした参考画像アダプター)を用いて、カメラワーク、会話、効果音、BGM 付きの短編動画を 6 ステップで生成します。VSA 加速ゲートとオプションの Semantic Bridge スイッチが追加されています。
画像
推奨理由
- 参考画像から動画生成(Ref2VA)と最初のフレームから動画生成に対応:各参考画像ごとにグループ化され、First Frame Mode に切り替えて 1 枚の画像から開始することも可能。音声付き動画を出力し、さらに 2x RTX アップスケール出力もある
- H3 Ref2VA int8 メインモデル、qwen3vl 32b テキストエンコーダー、動画 / 音声 VAE、pika_h3_flex_ref2va アダプター、fasth3_vsa_gate 加速ゲート、Semantic Bridge、および Ref2VA VSA、Semantic Bridge、Memory Cleanup、RTX、KJNodes、rgthree、VideoHelperSuite ノードを連携させている。図内のメモに各モデルのリンクが記載されている
- パラメータはプリセット済み:lcm サンプラー、Pika の 6 つの手動 sigma、CFG 1、アダプター強度 1、ゲートスパース性 0.75。作者は RTX A4500(20 GB)での所要時間を提供:0.6 MP(1056x608)5 秒のクリップでサンプリング 1:43、加速ゲートをオフにすると 2:11
- プロンプト作成のアドバイス付き:各セクションごとに 1 つの場所と完全な小さな物語、画面の位置に応じた方位の記述、各ショットごとにカメラポジションの記述、因果関係の明示、複数の参考画像の場合は各自の定義
使い方
- Pika-H3-Flex-References-SemanticBridge.json をダウンロードし、図内のメモに従ってモデルをダウンロードして diffusion_models / text_encoders / vae / loras および新規作成した models/semantic_bridge ディレクトリに配置。不足しているノードは ComfyUI Manager で補完インストールする
- プリセットパラメータを維持し、メモリクリーンアップノードはオンにしておく。まず短いクリップでプロンプトをテストする。Semantic Bridge について、作者はシットコムテストでオンにすると画質が良く、オフにすると音質が良いと発見したため、両方を試すこと
リスクと制限
- 依存関係が重い:作者の統計ではモデル合計で約 48 GB、CUDA 13(cu130)版 PyTorch、580 以上の NVIDIA ドライバー、および比較的新しい ComfyUI(作者のテストは 0.44.0)が必要
- VRAM の閾値:20 GB カードでは 0.8 MP 15 秒で VRAM が溢れる。3 枚の参考画像で 1344x768 15 秒には 24 GB カードが必要。16 / 12 GB は作者が 20 GB カードで VRAM を制限してシミュレーションしたもので、15 秒のクリップでピーク時約 17 GB。短いクリップから始めることを推奨
- Semantic Bridge の作者は v1 で参考画像ワークフローを非対応としており、参考音声のリップシンクに問題があることを警告している。Pika H3 Flex と H3 は MiniMax H3 コミュニティライセンスに従うため、商用利用前にライセンスを確認すること
- 目に見えるサンプル動画は 1 本のみで、さらに 3 件のセンシティブなサンプルが非公開。本項目は未実行
【A】Minimax H3 SEED HUNTER - Latent Upscaler, Seamless Video Continuation, Dialogue Gen Tool, Speedups, Ref Mods · v3.0
ワークフロー · バージョン更新 · 作者 foxydits · 公開 11-06 07:57 · ダウンロード 55
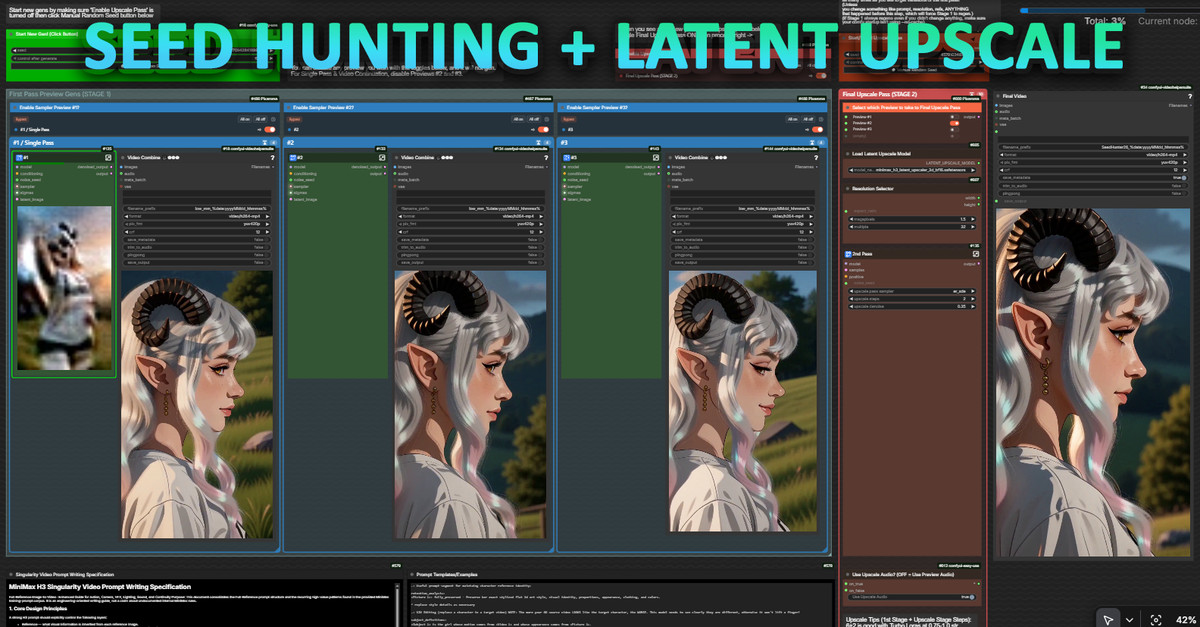
Seed Hunter v3.0:まず一度に 3 個の低解像度プレビューを生成し、気に入ったシードを選んでからアップスケールして確定する「シード抽選」ワークフロー。このバージョンでは ComfyUI 内蔵の latent アップスケーラーを採用し、フレーム抽出、アニメーションフレーム抽出、デュアルプロンプトエディターなどのオプションを追加しました。
画像
推奨理由
- バージョン更新:Kijai が作成し、ComfyUI 0.44 に内蔵されている Latent Upscaler に変更(作者はより高速で、VRAM スパイクによる OOM を解決したと主張)。そのため 0.44 へのアップグレードが必須
- 新規追加:最初のフレーム/最後のフレームを output/saved_frames/ に別保存;Anime Cadence によるアニメーションフレーム抽出で、2D アニメーションの動作リズムを従来のアニメーションに近づける;最終出力でプレビュー動画の音声を使用可能に;2 番目のプロンプトエディタで実行中に次のプロンプトを記述可能;プロンプトを output/prompts/ に自動保存
- ワークフロー自体はシームレスな継続生成、カスタム音声、24 FPS から 48-60 へのフレーム補間、対話/音声クローンツールをカバー;モデルページ累計で 39146 回のダウンロード、1111 のいいね、307 件のコメントがあり、注目度が高い
使い方
- ComfyUI を 0.44 にアップグレード後、FoxFurEssence H3 Seed Hunter v3.json をインポート;作者が指定した minimax_h3_latent_upscaler をダウンロードし、latent_upscale_models ディレクトリに配置
- ノード:Anime Cadence、Pixaroma、Prompt IDE、MiniMaxH3-PromptBuilder、RefMods など、多くは Comfy Registry からインストール可能;高速化には作者推奨の Silveroxide Dareties turbo LoRA と Kijai の int8 ビデオ VAE を設定可能
リスクと制限
- v3.0 の使用説明は作者により「近日公開」と記載されており、既存のガイドは v2.5 用;依存ノードが多いため、個別に確認が必要
- 表示可能な画像サンプルは 2 枚のみ、5 件のセンシティブレベルのサンプルは非表示、表示可能な動画なし;本項目は未実行
【A】MiniMax H3 ロングテイク:チェーンされたセグメントからの 40-50 秒ショット(12 GB) · v1(12 GB でテスト済み)
ワークフロー · 新モデル · 作者 semenovsas776 · 公開 11-06 04:32 · ダウンロード 55
4-6 秒の H3 クリップを 40-50 秒の連続ロングテイクに繋げるワークフロー + スクリプトパック。作者は RTX 4070 SUPER 12 GB で完了;顔、衣装、色彩が最後まで維持され、継ぎ目は目立たないと作者は主張。
今号で最も完全なロングテイクソリューション:ワークフロー、プロンプト計画、品質チェックスクリプトが一式提供されており、ワンカットの対話シーンを制作したい人は、まず記事を読んでから着手するのが適しています。
画像
推奨理由
- H3 の単一セグメントの長さ制限と、継ぎ目での変動が生じやすい長尺動画の問題を解決:各セグメントは前のセグメントの latent の末尾から継続生成(FeiHou Easy H3 の接続モード、22+22 フレーム)、第 2 セグメント以降は参照モードで顔参照画像と開始画像を使用、各セグメントのテキストには完全な衣装を繰り返し、状態に応じて小道具を記述
- 圧縮パッケージの内容が充実:第 1 セグメントと第 N セグメントの UI ワークフロー(設定説明を含む)、対応する API 形式図、計画用システムプロンプト(任意のチャットアシスタントに貼り付けて各セグメントのテキストを生成)、カフェシーンの絵コンテ計画、および計画チェック、ComfyUI API 経由でのチェーン一括実行、継ぎ目/フレームスタック検出、顔類似度、レビュー表などのスクリプト
- 作者が所要時間を提示:4070 SUPER + 96 GB メモリ、第 1 セグメントは約 1.5 分、以降の各セグメントは 2.5-3.5 分;完全な方法は別記事(civitai.com/articles/38141)に記載
使い方
- ComfyUI + FeiHou Easy H3、FeiHou Toolbox、KJNodes、MiniMax H3 Remix v0.8 モデル、Comfy-Org/MiniMax-H3 のテキストエンコーダと VAE、および H3 latent アップスケーラーが必要;最初のフレームで顔交換する場合のみ ReActor が必要
- まず計画プロンプトでチャットアシスタントに各セグメントのテキストを書かせ、第 1 セグメントを実行し、その後第 N セグメントワークフローでセグメントごとに継続生成するか、添付スクリプトを使って API 経由でチェーン全体を自動実行
リスクと制限
- 2 つのサンプル動画(同じカフェシーンのリアル版と漫画版)はどちらもセンシティブレベルとして非表示になっており、実際の継ぎ目の効果を確認できず、レベルはドキュメントに基づいて判断
- メインモデルは公式重みではなく MiniMax H3 Remix v0.8 を使用しており、モデル変更後に同様に接続できるかは作者が説明していない;本項目は未実行
- カードの画像は AI 生成の概念図であり、モデルの実際の効果ではない;作者は公開のノーマルレベルのサンプルを持っていない
注目すべき項目(5)
【B】Minimax.. simple · v5.1
ワークフロー · バージョン更新 · 作者 sy0ww4bb1984 · 公開 11-06 03:10 · ダウンロード 35
「Minimax.. simple」大規模参照画像から動画へ + セグメント延長 + アップスケールワークフローの v5.1:動画参照オプション、動画から動画への人物置換(video to video replace)の操作説明、アップスケール用のパススルー(passthrough)を追加し、kitchen attention を再度追加。
画像
推奨理由
- バージョン更新:v5 と比較して動画参照入力と vid2vid 置換の説明を追加;作者はページ上で v5.1 では動画参照がないと出力できなかったが、その後の 5.11 で修正されたと述べている(ダウンロードファイル名は minimaxv5.11.zip)
- フロー全体は参照画像から動画へ(複数画像、複数音声参照)、フレーム数ベースのバッチ延長と音声同期、RTX / latent / resize の 3 種類のアップスケールを連携、バッチごとに LoRA、プロンプト、シード、参照を変更可能;モデルページ累計で 2860 回のダウンロード
- 作者は対応する蒸留およびアップスケール LoRA のソースを列挙:Kijai の MiniMax-H3-experimental、Comfy-Org の loras、Pika-H3-Flex-Turbo-LoRA
使い方
- minimaxv5.11.zip をダウンロードして解凍し、ComfyUI にインポート;作者のパラメータヒント:LoRA 強度 0.4-1.0、クリップは秒数ではなくフレーム数で設定、1 バッチあたり最大 300 frames at 1MP、オプションで Beta57 8 / 6 / 4 ステップ sigma
- アップスケールには 2 倍率を推奨(作者は整数倍以外では画面が引き伸ばされると主張);メモリノードでは独立した音声/動画 latent を有効にし、グループ外に配置する必要がある
リスクと制限
- 更新説明が散発的:v5.1 と 5.11 が混在して記載されており、kitchen attention とは何か、動画参照をどう接続するかは展開されていない
- 作者は中程度のスペックの PC しか持っておらず、この大規模フローの全テストが困難であると自称;ComfyUI の更新で頻繁に破損する;依存ノードとモデルは各自で確認が必要
- 表示可能な画像サンプルは 1 枚のみ、4 件のセンシティブレベルのサンプルは非表示、表示可能な動画なし;本項目は未実行
【B】Lonecat’s MiniMax H3 FL2VA/ REF2VA | 低 VRAM ビデオワークフロー w/ Low VRAM Optimizers, Upscaler, & Post Production · V9.0 Faster & Better
ワークフロー · バージョン更新 · 作者 lonecatone23 · 公開 11-06 08:04 · ダウンロード 14
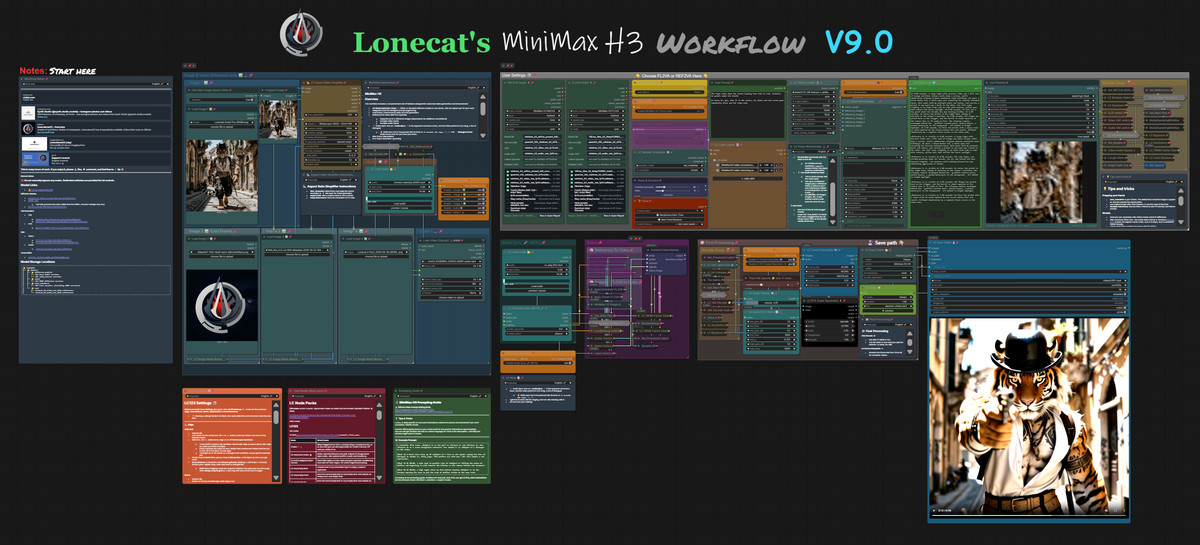
Lonecat の H3 最初/最後のフレーム / 参照画像から動画への大規模ワークフロー V9.0:明記された唯一の変更点は Ultimate Upscale を削除し、作者が別のワークフロー作成時にテストしたアップスケール方法に置き換えたこと。
画像
推奨理由
- バージョン更新:作者は多くのアップスケール方法をテストした結果、多くの人のやり方に問題が多いと発見し、Ultimate Upscale を削除;作者は最終的な品質が向上したと主張するが、具体的な置き換え方法は外部リンクに記載されており、モデルページでは展開されていない
- フロー自体は最初/最後のフレーム(FLF2V)と参照画像(REF2V、最大 4 枚の参照画像)、動画および音声入力、作者自作の LC Vision による画像を見てのプロンプト作成、RIFE フレーム補間、RTX 超解像、および GGUF モデルをサポート;画像内の備考には中国語あり
- 無料;モデルページ累計で 5301 回のダウンロード、207 のいいね
使い方
- MiniMax H3 Ver 9.0 (1).json をインポート;作者は自身のノードパックを最近更新しており、エラーが発生した場合は作者の GitHub(lonecatone23)から手動でダウンロード
- 作者はこれは上級者向けワークフローであり、初心者向けではないと説明;初心者は作者の別の簡略化されたワークフローを使用可能。ステップ数、VRAM 要件は作者が提示していない
リスクと制限
- 更新説明は一文のみで、アップスケール方法の詳細は外部リンクにあり、モデルページでは確認できない
- 作者自身の複数のノードパックに依存;表示可能な画像サンプルは 1 枚のみ、2 件のセンシティブレベルのサンプルは非表示;本項目は未実行
【B】Easy MH3 (video generation + upscale using chunking + 60 FPS) · v1.0
ワークフロー · 新モデル · 作者 Crimson009 · 公開 11-05 23:15 · ダウンロード 67
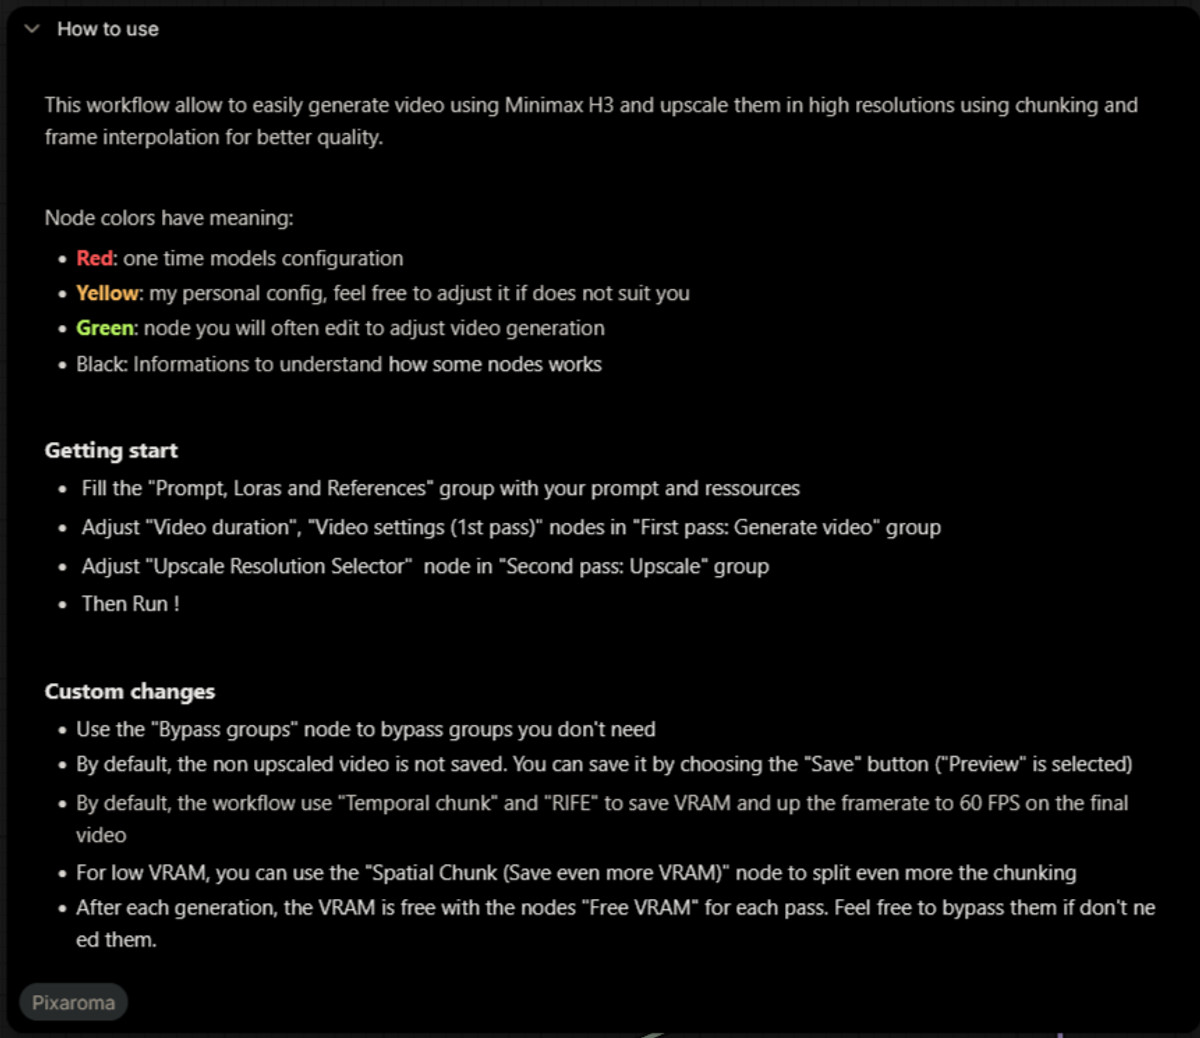
2 パス式の H3 ワークフロー:第 1 パスで動画を生成し、第 2 パスで時間チャンク(Temporal chunk)を使用して高解像度にアップスケールし、さらに RIFE で 60 FPS にフレーム補間。VRAM 節約と使いやすさを重視。
画像
推奨理由
- 高解像度・高フレームレートの最終動画が必要だが VRAM が限られているシナリオに対応:デフォルトで時間チャンク + RIFE、VRAM がさらに低い場合は Spatial Chunk(空間チャンク)に切り替えてさらに細分化、各パス終了時に Free VRAM ノードで VRAM を解放
- ノードは色で用途を区別:赤は一度きりのモデル設定、黄色は作者個人の設定、緑は頻繁に変更する生成パラメータ、黒は説明
- 操作手順が明確:「Prompt, Loras and References」グループに入力、動画長と第 1 パスの設定を調整、アップスケール解像度を選択して実行;不要なグループは「Bypass groups」ノードで無効化
使い方
- Easy_MMH3_2pass_chunked_RIFE_upscale_V1.json をインポートし、上記の順序で入力;アップスケール前の動画はデフォルトでプレビューのみで保存されず、必要に応じて Preview を Save に変更
- 必要なモデル、ノード、ステップ数、VRAM は作者が提示していない
リスクと制限
- 依存するモデルとカスタムノードがリストアップされておらず、インポート後に不足分を確認するしかない
- 表示可能な画像サンプルは 1 枚のみ、2 件のセンシティブレベルのサンプルは非表示、表示可能な動画なし、アップスケール効果は確認不可;本項目は未実行
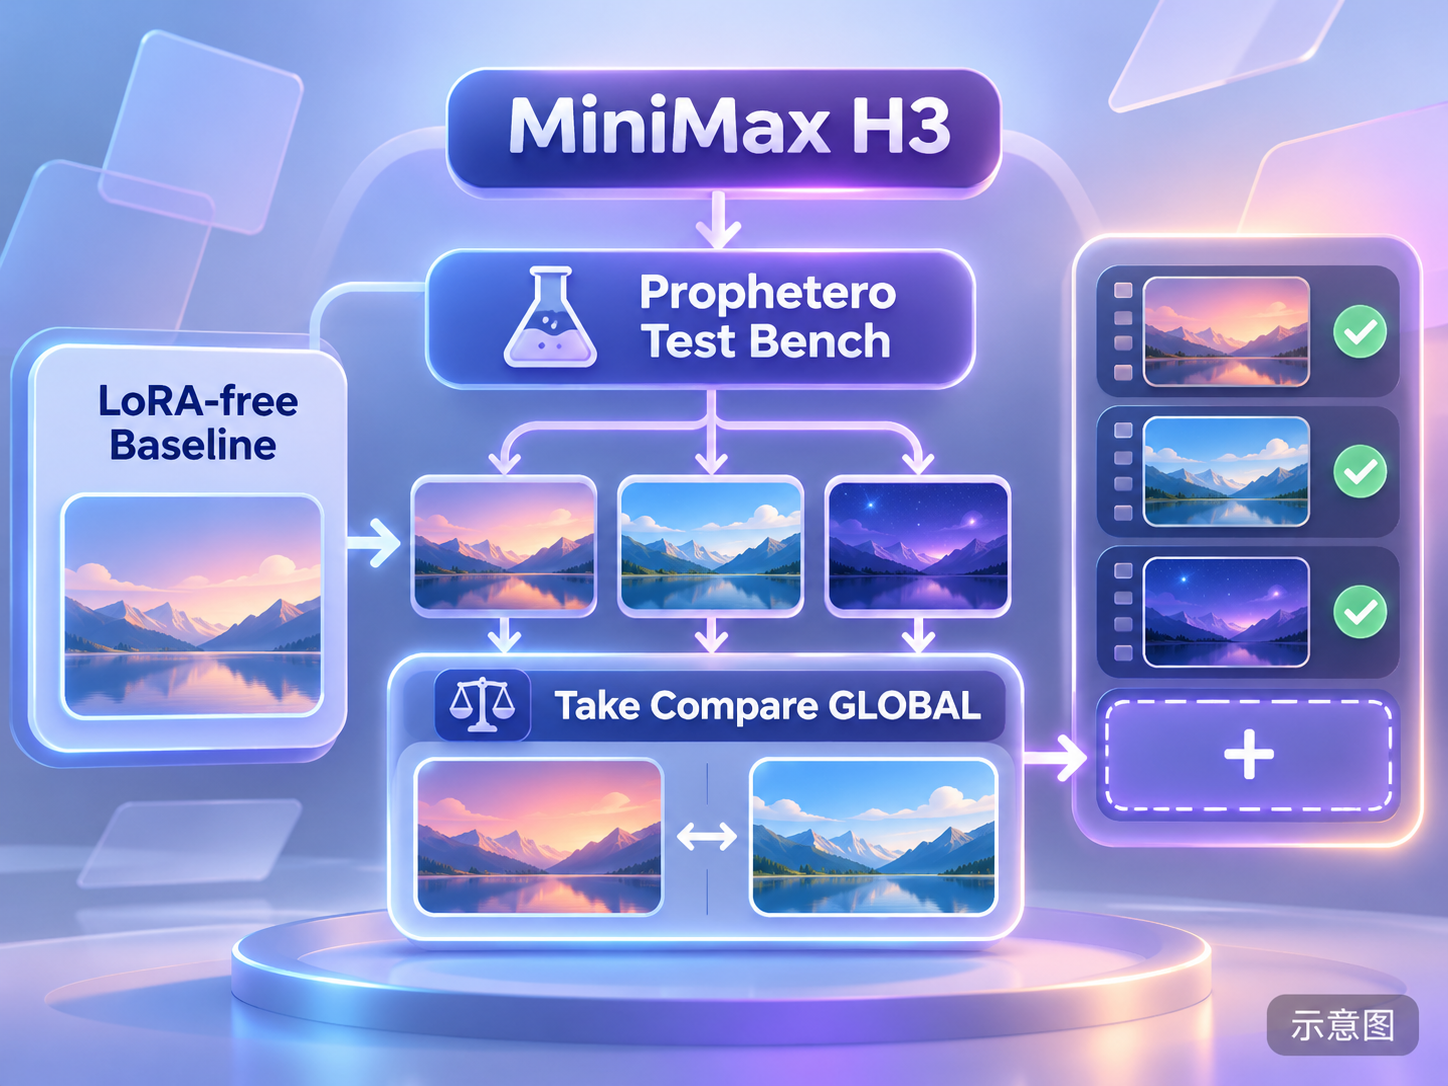
【B】Prophetero Test Bench + Take Compare GLOBAL · v0.4
ワークフロー · 新モデル · 作者 Prophetero · 公開 11-05 22:09 · ダウンロード 19
ComfyUI に組み込まれたテストと比較ツール(Test Bench + Take Compare、パブリックベータ版):同一ワークフローで LoRA なしのベースラインと複数の LoRA 組み合わせの短尺試走を実行し、同一ページで映像、動作、音声を並べて比較し、選択した設定をワンクリックでフルレンダリングに変換またはワークフローとしてエクスポート。
画像
推奨理由
- LoRA 組み合わせの調整時にタブを頻繁に切り替え、パラメータを覚えきれないというフローの問題を解決:各サンプルカードで LoRA を検索、個別にスイッチと強度を設定し、保存された設定を表示;H3 / LTX の長さコントロールを認識して試走を自動的に短縮、完了済みの試走は新しい実験を追加しても再実行されない
- Take Compare は最大 4 本の動画を同時に比較可能、フレーム単位、時間オフセット、連動ズーム、メモマーカー、0.25x–2x の再生速度をサポート;元音源のモノ/ステレオ波形とピーク/RMS レベルを確認可能
- Power Lora Loader(rgthree)、LoraLoader、LoraLoaderModelOnly をサポート、出力ノードは SaveVideo と VHS_VideoCombine をサポート;インターフェースは 8 言語に対応
使い方
- ZIP全体を展開し、バックエンドを停止してSTART_HERE.cmdを実行し、実際に使用しているComfyUIバックエンドを選択します。SwarmUI / ComfyUIを再起動し、ブラウザを更新します。正常に出力できるワークフローを開き、空白のキャンバス上で右クリックして「Prophetero · Test Bench + Take Compare」を選択します
- 比較制限:1セグメントあたり 0.5–120 秒、1–60 FPS、最大 8 MP および 2 GiB
リスクと制限
- ベータ版であり、作者はテスト時の推論はシミュレーションであると説明しています。すべての実モデルやカスタムノードとの互換性は保証されません。短いテスト実行が成功しても、フルレンダリングが成功するとは限りません
- 通常のワークフローJSONではなく、Windowsインストールスクリプトを含むプラグインパッケージです。インストール前にパッケージ内のファイルを確認してください。ライセンスにより本ソフトウェアの販売は禁止されています
- 敏感なレベルのサンプルが 1 件あり、これらは非表示にされています。表示可能なサンプルはありません。本項目は実行されていません
- カードの画像はAI生成の概念図であり、モデルの実際の出力結果ではありません。作者は公開された通常レベルのサンプルを持っていません
【B】H3: Authentic texture and award-winning, master-class acting. · v1.0
LoRA · 新モデル · 作者 TuTu_1018 · 公開 11-05 21:29 · ダウンロード数 254
「リアルな質感とアカデミー賞級の演技」LoRA:作者は、人物の顔のディテール、微細な表情、視線の変化、感情表現を強化し、会話シーン、感情シーン、ドラマシーンにおいて、人物が機械的な動きではなく、まるで演技をしているかのように見えるようにすると述べています。
画像
推奨理由
- リアルな人物の会話シーンや感情のクローズアップなど、テキストから動画へ(文生视频)/ 画像から動画へ(图生视频)の用途に対応します。方向性は特定のキャラクターや画風ではなく、演技の質感にあります
- 公開から約半日で 254 回のダウンロード、21 件の「いいね」を獲得し、今期最もダウンロードされたバージョンですが、これは注目度を示すに過ぎません
- 作者はRunningHub上で同名のオンラインワークフローを公開しています(リンクには招待コードが含まれています)
使い方
- H3リアルな質感とアカデミー賞級の演技lora.safetensorsを読み込みます。トリガーワードは作者によって登録されておらず、強度やステップ数も作者によって提供されていません
リスクと制限
- モデルカードには宣伝的な記述のみがあり、学習情報、パラメータ、比較データがありません。唯一のサンプルは敏感なレベルであり非表示のため、実際の演技効果を確認できません
- 説明が2回繰り返されており、主に外部プラットフォームへの誘導を目的としています。本項目は実行されていません
- カードの画像はAI生成の概念図であり、モデルの実際の出力結果ではありません。作者は公開された通常レベルのサンプルを持っていません
収録のみ(7)
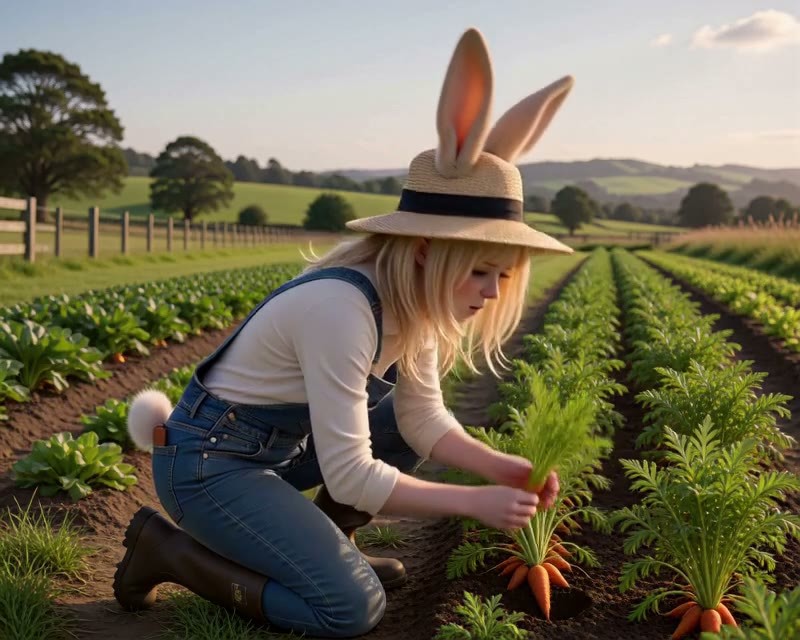
- Bonnie Rabbit · v1.0 H3 — LoRA:作者によるオリジナルのウサギ耳の女の子キャラクター「Bonnie Rabbit」(ニュージーランドの田舎にあるニンジン農場の経営者)のH3版キャラクターLoRA。トリガーワードはbonnielora。
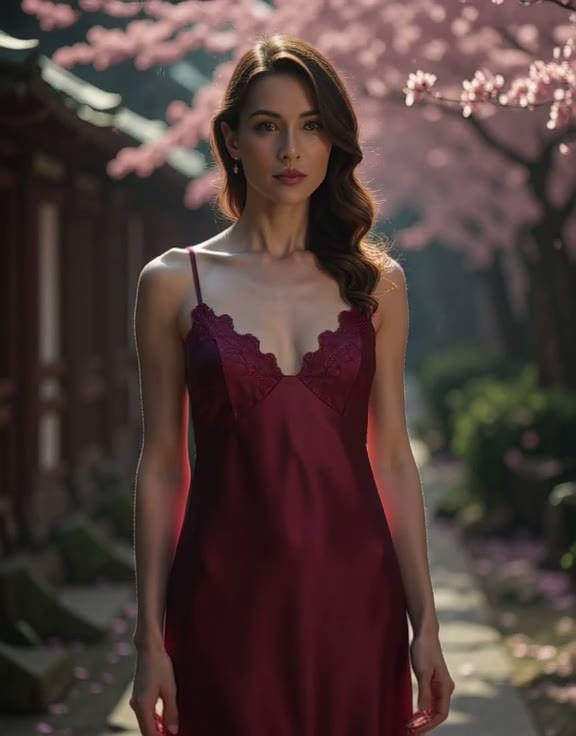
- Nevaeh Belwyn · MiniMaxH3 — LoRA:架空の女性キャラクター「Nevaeh Belwyn」(ブルージュの古文書アーキビストで、レトロなウールとアンティークレースの衣装を着用)のH3版キャラクターLoRA。作者は実在の人物ではないと述べています。
- Looney Red Riding Hood :: MMH3 Character · v1.0 — LoRA:ダークファンタジー版の赤ずきんちゃんキャラクターLoRA(歯を剥き出しにして狂ったように笑い、金髪、ボロボロの赤いマント)。イラストレーター@phatestronaughtのキャラクターデザインと画風画像で学習されており、テキストから動画への生成向けです。
- Sam Bramblepot · v1.0 H3 — LoRA:作者によるオリジナルのドワーフ庭師キャラクター「Sam Bramblepot」のH3版キャラクターLoRA。トリガーワードはsamlora。
- Nox · v1.0 H3 — LoRA:作者によるオリジナルの「生きた影」女性キャラクター「Nox」(光を飲み込むほど黒い肌、銀色の目)のH3版キャラクターLoRA。トリガーワードはnoxlora。
- Flat Lindsay · v1.0 H3 — LoRA:作者によるオリジナルキャラクター「Flat Lindsay」のH3版LoRA:「紙のような」女の子で、正面から見ると輪郭線のあるイラストのように見えますが、横を向くとほぼ消えてしまい、3Dの世界で普通に生活しています。
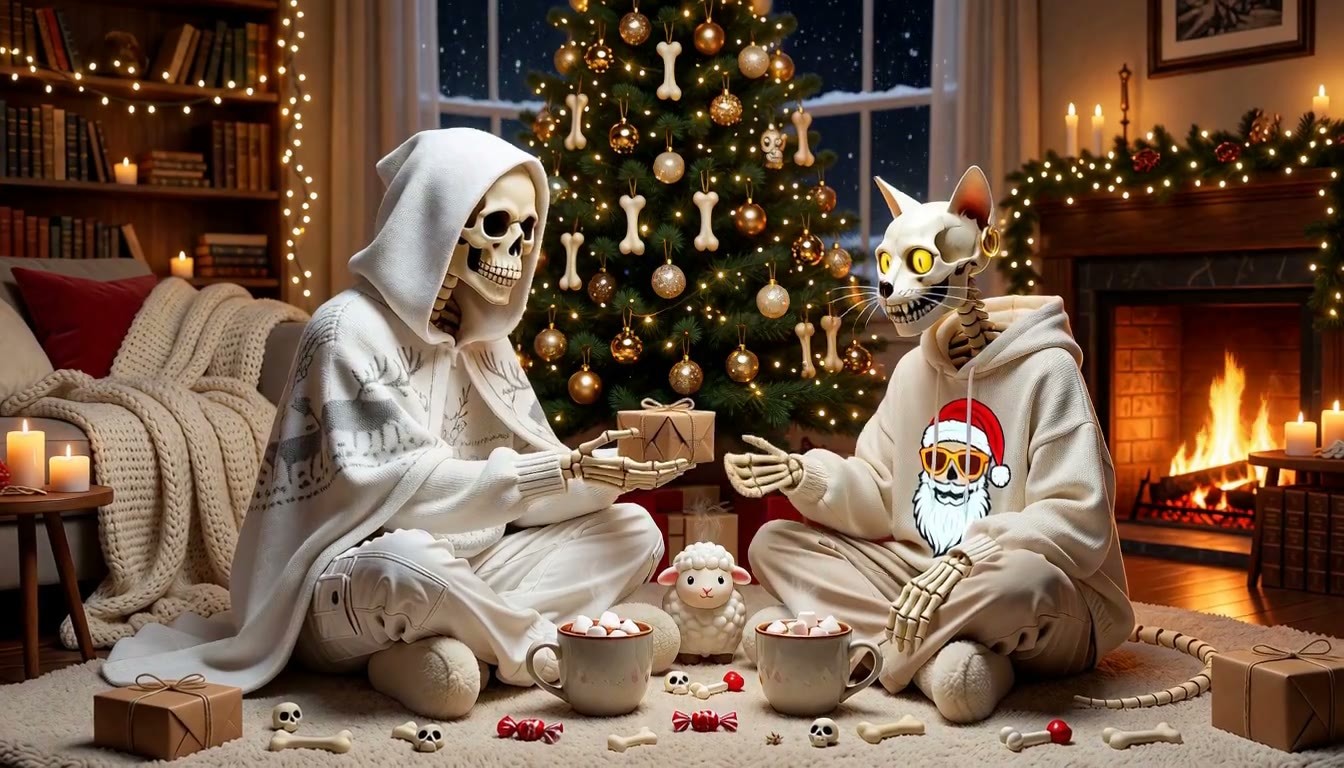
- 🎄LORU & RIBS: CHRISTMAS BONE DANCE · v1 — LoRA:クリスマステーマの2キャラクターLoRA:白いフードを被った死神Loruとそのスケルトン猫Ribsが、暖炉のそばでホットココアを飲んだり、氷上でスケートをしたり、プレゼントを交換したりします。作者はニット素材の質感、骨格構造、魔法の光のエフェクトに優れていると述べています。
データ:Civitai公開API(基盤モデル MiniMax H3)、収録期間 11-05 20:31 → 11-06 09:01(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は注目度を示すに過ぎません。