Radar IA de Zhenzhen · MiniMax H3 · Bulletin du matin 2026-11-11
Cette édition compte 23 nouvelles versions : Recommandation forte 2 · Recommandé 3 · À suivre 9 · Inclus uniquement 9
Note de l'éditeur Cette édition examine 23 nouvelles versions de H3, dont 2 classées S, 3 A, 9 B et 9 C. La recommandation principale est le workflow de génération d'images à partir de texte et d'édition d'images H3 Image par AusBoss : générez une image de 16 MP avec une seule phrase ou modifiez des images en langage courant, avec la possibilité d'ajouter jusqu'à sept images de référence. Le mode Fast utilise pDMD pour réduire les étapes de 6 à 2. Notez que près de la moitié des entrées de cette édition sont des versions image de H3 intégrées dans ComfyUI via 11-10, produisant uniquement des images et non des vidéos. Côté vidéo, le LoRA « Friend's POV » (style photo prise par un ami avec son téléphone) est également classé S, tandis que les LoRAs pour la vue à la première personne de lunettes intelligentes et le style graphique de Frieren : Le Magicien d'Épices sont classés A. Les quantifications INT8 / INT4 mal documentées du pack H3 Image sont rétrogradées en B / C, les LoRAs de voix off sont rétrogradés en B pour des raisons de droits d'auteur, et les 5 LoRAs de personnages originaux portés en masse par MisterMR manquent de mots-clés déclencheurs et d'exemples, ils sont donc classés C.
Recommandation forte (2)
【S】MiniMax H3 Image Generate + Edit | 16 MP, 8 Images · v1.0
Workflow · Nouveau modèle · Auteur AusBoss · Publié le 11-11 08:31 · Téléchargements 140
Workflow ComfyUI de génération d'images à partir de texte et d'édition pour MiniMax H3 Image (la version image de H3) : générez des images de 16 MP avec une seule phrase, ou modifiez des images en langage courant. Lors de l'édition, vous pouvez ajouter jusqu'à sept images de référence et spécifier ce qui doit être extrait de chacune.
Premier workflow à lier génération, édition, référence multi-images et mise à l'échelle après le lancement de H3 Image, avec un numéro de version de test indiqué. Idéal comme modèle de départ pour H3 Image.
Illustration
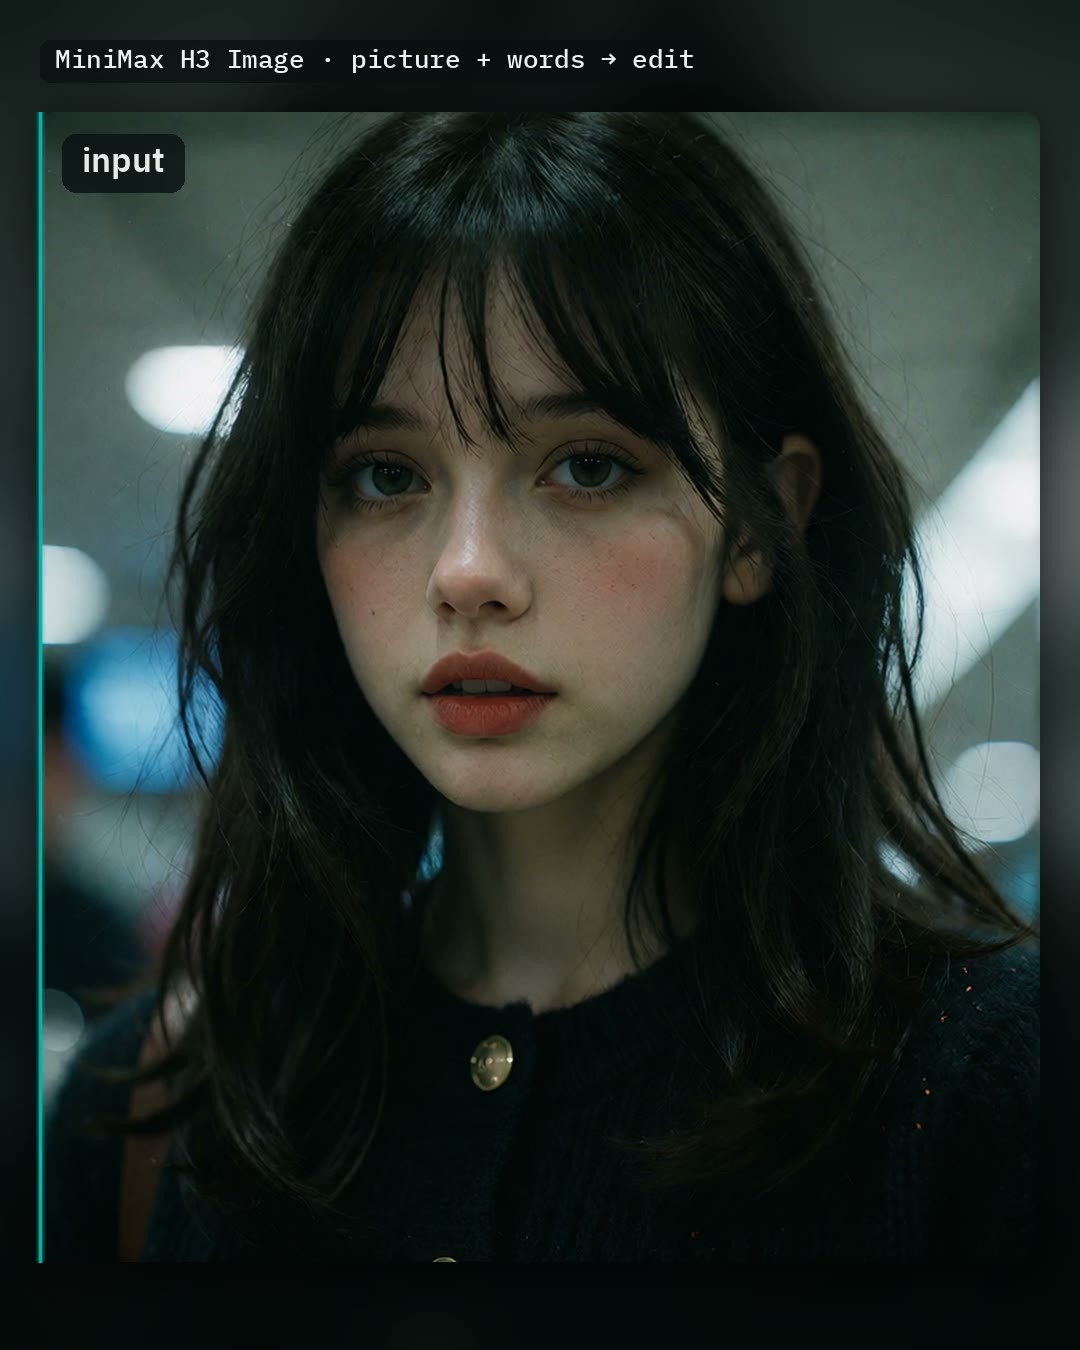
Raisons de la recommandation
- Nouveau modèle (workflow, pas de nouveaux poids) ; sert à la génération d'images à partir de texte, à l'édition par instruction et à la composition multi-références pour H3 Image, par exemple « mettre la veste de l'image 2 sur la personne de l'image 1 »
- L'auteur précise l'environnement de test (branche master de ComfyUI commit ede4e5f + nœuds AusBoss 2.22.0, testé sur deux niveaux de VRAM) et liste individuellement les fichiers de modèles requis, leurs répertoires d'installation et leur taille : le mode High VRAM utilise le modèle de base int8 ConvRot (21.0 Go), le mode Low VRAM utilise w4a8 (12.5 Go), avec un encodeur de texte Qwen3-VL 32B nvfp4 et un VAE H3 Image partagés
- Options complètes : Auto prompt utilise un petit modèle pour étendre quelques mots en une description longue ; Size bascule entre 4 MP / 16 MP ; Fast utilise un LoRA pDMD de 2 étapes pour réduire les étapes de 6 à 2 ; SeedVR2 optionnel permet de doubler la résolution des résultats en 4 MP
- L'auteur indique qu'une nouvelle image de 16 MP prend environ 22 secondes et une modification d'image de 16 MP environ 35 secondes sur une RTX 5090 ; 1 vidéos et 6 images d'exemple visibles
Utilisation
- Mettez d'abord à jour ComfyUI vers une version postérieure à 0.44.0 et les nœuds AusBoss vers 2.22.0, glissez-déposez le workflow et lancez-le directement ; il inclut par défaut un prompt complet
- Pour générer vos propres images : écrivez une description longue complète, ou activez Auto prompt et écrivez seulement quelques mots ; pour l'édition : activez Edit a picture, chargez l'image et décrivez la modification (par ex. « Make it snow. ») ; connectez les images de référence de picture 2 à picture 8 dans l'ordre, et mentionnez « picture 2 » dans le prompt
- Placez le texte devant apparaître dans l'image entre guillemets ; désactivez Auto prompt si votre prompt est déjà très complet (l'auteur note que les mains deviennent erratiques lors de la réécriture du prompt initial) ; n'activez pas Fast pour créer des affiches ou des couvertures
Risques et limitations
- Dépend du nouveau support de H3 Image (intégré à ComfyUI via 11-10) et des nœuds propres à AusBoss ; les anciennes versions de ComfyUI ne fonctionnent pas ; le téléchargement complet des modèles (modèle de base + encodeur de texte 32B + modèle d'extension optionnel, LoRA d'accélération, SeedVR2) est très volumineux
- Licence communautaire MiniMax-H3-Image : selon le résumé fait par l'auteur de la quantification Comfy, elle ne couvre pas l'UE, le Royaume-Uni, la Corée du Sud et les États-Unis ; les productions ne peuvent pas être utilisées pour améliorer d'autres modèles IA ; une autorisation supplémentaire est requise si le revenu annuel dépasse 100 000 USD ou si vous proposez un service hébergé
- Il s'agit du modèle image de H3, il ne produit pas de vidéos ; les chiffres de temps sont ceux indiqués par l'auteur
【S】Friend's POV - MiniMax H3 · H3 V1
LoRA · Nouveau modèle · Auteur AriaMaiven · Publié le 11-11 09:15 · Téléchargements 86
LoRA de style vidéo « photo prise par un ami avec son téléphone » : cadrage large, sujet repoussé sur le bord du cadre, éclairage plat typique d'un smartphone, et l'image tremble dès que la personne qui filme sourit.
Fait partie de la série « Point de vue amateur » avec le Smart Glasses POV du même auteur ; la syntaxe des paramètres est identique.
Illustration
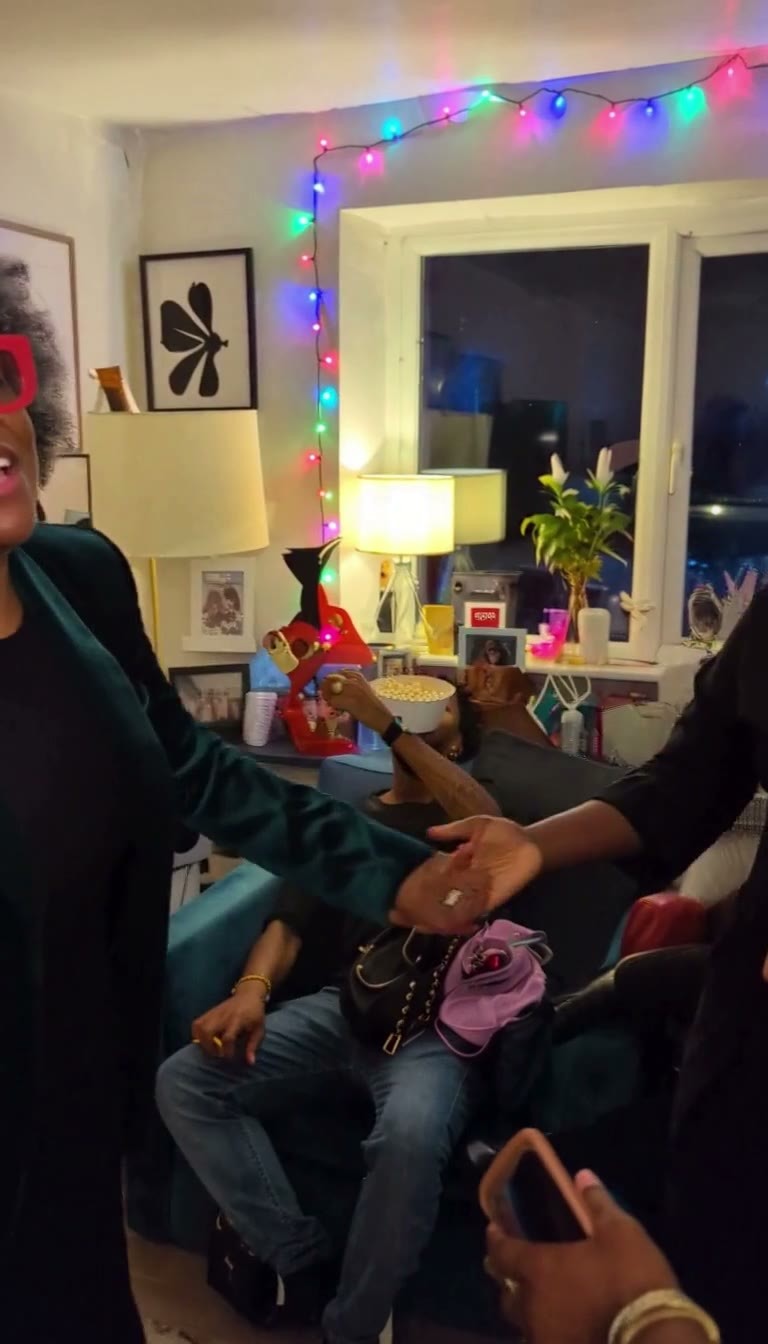
Raisons de la recommandation
- Nouveau modèle ; sert aux vidéos de vie quotidienne en gros plan avec des personnages, comme les fêtes, les rues nocturnes ou les allées de supermarché, où l'on recherche une « vidéo dans le téléphone d'un ami » plutôt qu'un rendu cinématographique
- L'auteur fournit un mode d'emploi complet : mot-clé déclencheur celsint, intensité 0.65 pour les visages en gros plan (visage stable, effet smartphone conservé), jusqu'à 0.8 si la personne est loin, de dos ou hors champ (style plus marqué, mais les visages proches peuvent se déformer)
- La rédaction des prompts est précise : placez le style dans la première phrase du prompt H3 ; ne mentionnez pas téléphone, caméra à main, tremblement, exposition ou grain, car le mot-clé déclencheur s'en charge ; décrivez plutôt ce que fait l'ami filmé (courir derrière, être tiré par le poignet, bousculé par un invité) pour un tremblement plus réaliste
- Configuration de test de l'auteur : MiniMax H3 FL2VA pruned int8 ConvRot texte-vers-vidéo, 20 étapes, res_multistep + simple, 768x1344, 5 secondes ; 2 vidéos d'exemple visibles
Utilisation
- Mot-clé déclencheur celsint ; intensité de 0.65 (visages en gros plan) à 0.8 (plans éloignés ou sans visage) ; écrivez dans la première phrase du prompt [Shot 1] Live-action in the celsint style, a medium shot at chest height...
- Utilisez-le seul, ne le superposez pas à d'autres LoRAs de corps ou de mouvement ; l'auteur a testé en texte-vers-vidéo avec 20 étapes, res_multistep, simple et 768x1344
Risques et limitations
- Utilisation commerciale autorisée mais l'origine du style doit être citée ; la republication ou l'utilisation des productions pour entraîner d'autres modèles nécessite l'autorisation préalable de l'auteur
- 1 exemples sont masqués ; seul le texte-vers-vidéo a été testé, les performances en image-vers-vidéo / Ref2VA ne sont pas précisées par l'auteur
Mot-clé déclencheur : celsint
Recommandé (3)
【A】Minimax H3 Image Quants - comfy-native - fp8_scaled / nvfp4 / GGUF Q6 / Q4 / Q3 / Q2_mix · v1.0
Modèle de base / Checkpoint · Nouveau modèle · Auteur Thasmodius · Publié le 11-11 07:19 · Téléchargements 47
Pack de précisions complémentaires pour le modèle de base H3 Image : quantifications mixtes fp8 scaled, NVFP4 et GGUF Q6_K / Q4_K / Q3_K / Q2_K non disponibles dans le dépôt officiel Comfy, contenant uniquement le modèle de diffusion.
Illustration
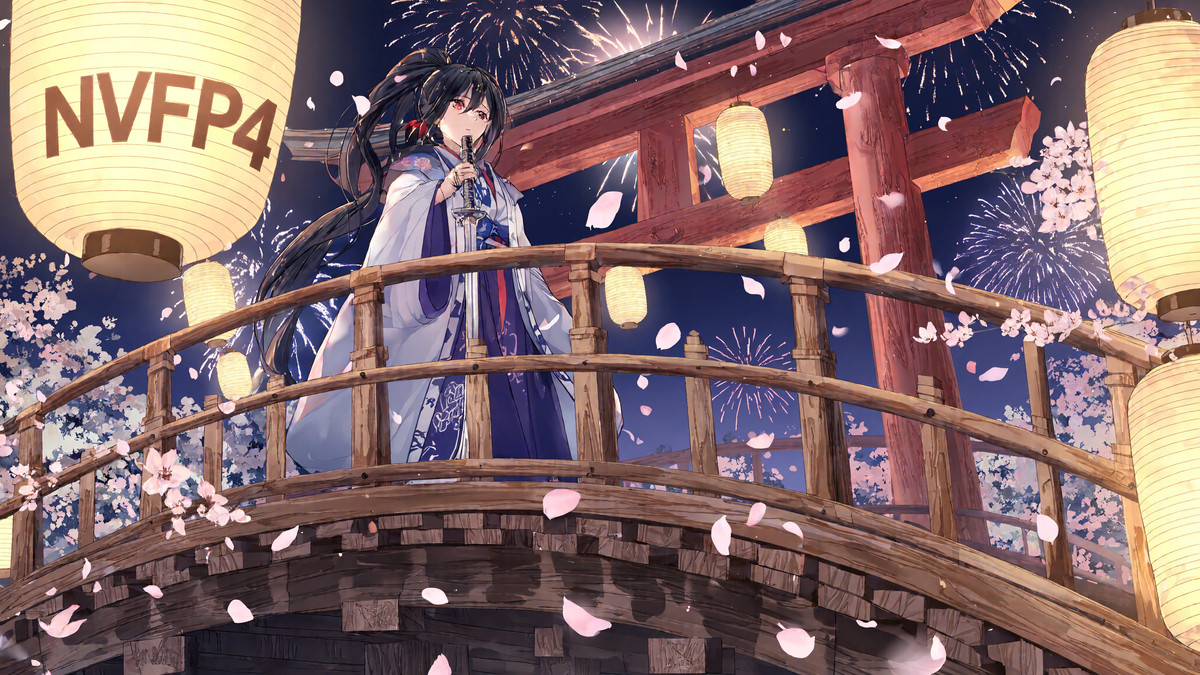
Raisons de la recommandation
- Nouveau modèle (poids quantifiés) ; sert aux utilisateurs souhaitant exécuter la génération et l'édition d'images H3 Image sur RTX 40 / 50 ou toute autre carte graphique, mais manquant de VRAM pour charger le bf16 officiel
- Les usages de chaque variante sont clairs : fp8 scaled (21.0 Go) pour RTX 40 / 50 ; NVFP4 (12.5 Go) fonctionne nativement uniquement sur RTX 50 et est le plus rapide (l'auteur indique environ 2048x2048 à 3.4 steps/s sur une RTX PRO 6000, contre environ 2.1 steps/s pour fp8) ; GGUF Q6_K (17.5 Go), Q4_K (12.5 Go) et Q3_K (10.0 Go) fonctionnent sur n'importe quelle carte graphique ; Q2_K mix (9.25 Go) est une variante expérimentale, l'auteur note un adoucissement visuel notable
- L'auteur précise que la portée de la quantification est identique aux int8 / w4a8 officiels de Comfy (mêmes 200 couches transformer, représentant 95.8% des poids), le reste conservant le bf16 officiel inchangé, et fournit une page de comparaison sur HF ; 8 images d'exemple visibles
Utilisation
- Nécessite ComfyUI 0.44 ou plus récent ; ouvrez le modèle « MiniMax H3 Image » intégré à ComfyUI et sélectionnez le fichier dans Load Diffusion Model ; conservez les paramètres du modèle : 6 étapes, euler, simple, cfg 1
- L'encodeur de texte qwen3vl_32b_minimax_h3_nvfp4_awq (ou int8 convrot) et le VAE doivent être récupérés depuis le dépôt MiniMax-H3-Image de Comfy-Org
- Pour GGUF, remplacez le nœud de chargement par Unet Loader (GGUF) et appliquez d'abord un correctif à ComfyUI-GGUF (exécutez le script de patch fourni par l'auteur, ou ajoutez manuellement "minimax_h3" dans IMG_ARCH_LIST de loader.py), sinon vous obtiendrez une erreur Unexpected architecture type
- L'auteur indique que le modèle fonctionne mieux entre 4 et 20 MP, avec des résultats médiocres en basse résolution ; utilisez des prompts anglais longs et détaillés
Risques et limitations
- Licence communautaire MiniMax-H3-Image : l'auteur précise dans le texte original que la licence ne couvre pas l'Union européenne, le Royaume-Uni, la Corée du Sud et les États-Unis ; le modèle et ses productions ne peuvent pas être utilisés pour améliorer d'autres modèles d'IA ; un revenu annuel supérieur à 100 000 USD ou l'offre d'un service hébergé nécessite une autorisation écrite préalable de MiniMax ; les produits commerciaux doivent mentionner MiniMax-H3-Image
- Les dépendances GGUF ne sont pas encore fusionnées dans les correctifs amont ; 2 exemples sont masqués ; il s'agit d'un modèle d'image, il ne génère pas de vidéo
【A】Smart Glasses POV - MiniMax H3 · H3 V1
LoRA · Nouveau modèle · Auteur AriaMaiven · Publié le 11-11 09:15 · Téléchargements 122
LoRA au style vidéo à la première personne des lunettes intelligentes : grand-angle sans distorsion, mouvements de tête suivant le regard vers les mains, et les mains du porteur entrant dans le cadre par le bas.
Illustration
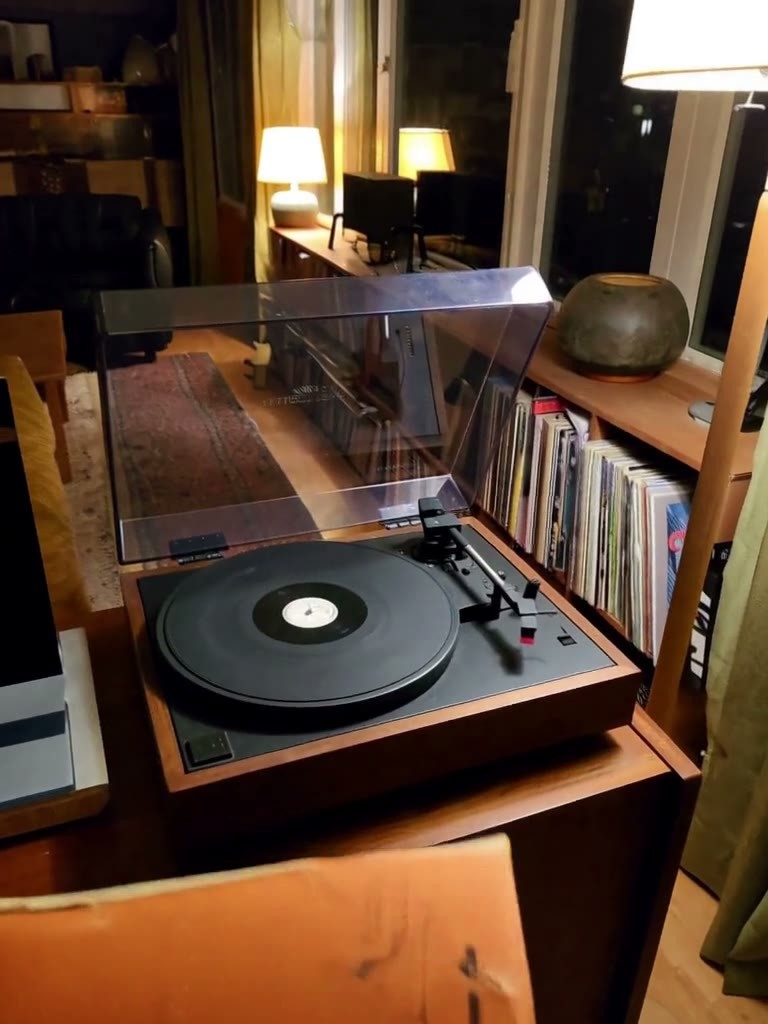
Raisons de la recommandation
- Nouveau modèle ; destiné aux vidéos quotidiennes à la première personne « vue depuis les yeux » telles que cuisiner, faire du vélo, prendre un livre sur une étagère ou ouvrir la porte pour accueillir un chien
- L'intensité est clairement définie : 0.6 est recommandé ; 0.8 offre un style plus fort mais les mains ne suivent plus la description ; 1.0 est excessif
- L'auteur rappelle qu'il faut toujours décrire les mains en détail (teint de peau, bagues, montre, ongles, manches, écrire "no tattoos" si pas de tatouages), car le LoRA complète les parties non décrites ; la configuration de test de l'auteur est FL2VA pruned int8 ConvRot pour la génération vidéo à partir de texte, 20 étapes, res_multistep + simple, 768x1024, 5 secondes
Comment l'utiliser
- Mot-clé de déclenchement povsint, intensité 0.6 ; commencez la première phrase du prompt par [Shot 1] Live-action in the povsint style, an eye-level shot...
- N'écrivez pas glasses, POV, first person, fisheye, le mot-clé de déclenchement s'en charge ; utilisez-le seul, sans superposer de LoRA de corps ou d'action
Risques et limitations
- L'auteur admet que les mains peuvent parfois être un ton plus claires, et que de petits tatouages apparaissent parfois sur les poignets ; vérifiez avant la publication
- Seuls 1 exemples vidéo visibles (4 sont masqués) ; la republication ou l'utilisation de ses productions pour entraîner d'autres modèles nécessite l'autorisation préalable de l'auteur
Mot-clé de déclenchement : povsint
【A】Frieren Anime H3 Style Lora · v1.0
LoRA · Nouveau modèle · Auteur tazmannner379 · Publié le 11-10 21:24 · Téléchargements 259
LoRA vidéo au style de l'anime « Frieren » : reproduit le style graphique de l'anime, avec certaines voix de personnages et la bande originale.
Illustration
Raisons de la recommandation
- Nouveau modèle ; destiné aux courts métrages de fans de Frieren, à la génération vidéo à partir de texte ou d'image en style anime, et aux créations où les personnages parlent
- Données d'entraînement précisées : 672 extraits d'épisodes avec audio + 721 captures d'écran ; l'auteur a publié sur Hugging Face un rapport d'entraînement, un guide de prompts, ainsi que des fiches de personnages et des références audio pour 27 personnages
- Fournit 3 points de contrôle d'entraînement (3150 / 3900 / 4200 étapes), le fichier principal étant celui de 4200 étapes ; 6 exemples vidéo visibles, environ 16 heures après la publication, 259 téléchargements, 36 likes
Comment l'utiliser
- Commencez le prompt par les mots-clés de déclenchement 2d anime style, Frieren style,
- L'auteur recommande sur sa page HF le point de contrôle de 4200 étapes, intensité 1.0 ; entraîné sur un modèle de base FL2VA, il peut aussi être utilisé sur un modèle de base Ref2VA avec des fiches de personnages comme images de référence
- Pour une reproduction stable d'un personnage, suivez les conseils de l'auteur en combinant les images de référence et les références audio de la page HF
Risques et limitations
- Entraîné sur des images de l'anime officiel et des voix de personnages (l'auteur déclare sur HF ne pas détenir les droits, usage éducatif uniquement) ; vérifiez les droits avant toute publication ou utilisation commerciale
- Les étapes, CFG et échantillonneur ne sont pas indiqués sur la page Civitai, consultez le guide sur HF ; 6 exemples sont masqués
Mots-clés de déclenchement : 2d anime style, Frieren style
À suivre (9)
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT8
Modèle de base / Checkpoint · Nouveau modèle · Auteur tsolful · Publié le 11-11 07:17 · Téléchargements 67
Version quantifiée INT8 ConvRot (W8A8) du modèle de base H3 Image, 19.54 Go, recommandée par l'auteur comme choix par défaut parmi les trois niveaux de quantification.
Illustration
【B】Yukari Takeba Voice - Persona 3 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · Nouveau modèle · Auteur OneMoreLurker · Publié le 11-11 12:04 · Téléchargements 20
LoRA de doublage de personnage purement audio : entraîné sur les voix japonaises de Yukari Takeba dans « Persona 3 Reload », permettant à H3 de générer des répliques avec la voix de ce personnage.
Illustration
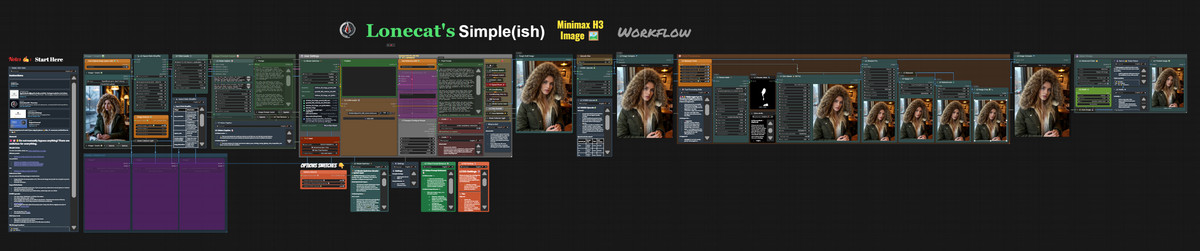
【B】Lonecat’s Simple Speed Boost 🚀 Workflows | 简易加速工作流 (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple Minimax Image 🖼️
Workflow · Mise à jour de version · Auteur lonecatone23 · Publié le 11-11 11:45 · Téléchargements 10
Version H3 Image (Simple Minimax Image) ajoutée à la collection de workflows simples de Lonecat : un workflow annoté de génération d'images à partir de références avec H3 Image, l'auteur ayant ajouté un nœud skin master pour améliorer la texture de la peau.
Illustration
【B】MInimax H3 Studio, Pixel Upscale Optimized for NVIDIA ONLY · v3.0
Workflow · Mise à jour de version · Auteur hRUSTIN474 · Publié le 11-11 04:50 · Téléchargements 57
Workflow vidéo H3 Studio v3.0 : trois branches (texte vers vidéo, image vers vidéo, image de référence vers vidéo) avec génération automatique de prompts, enchaînement de scènes multiples, puis super-résolution et post-traitement HDR spécifiques à NVIDIA après la génération.
Illustration
【B】MiniMaxH3 Lipsync / TLF2VA · Nova.3
Workflow · Mise à jour de version · Auteur Rvage · Publié le 11-11 00:44 · Téléchargements 50
Workflow Nova.3 de synchronisation labiale / vidéo multi-scènes pour H3 : utilise une image de personnage + un enregistrement audio existant pour créer des vidéos de chant ou de parole avec synchronisation labiale, ou utilise la génération native H3 texte vers vidéo / image vers vidéo / première et dernière image, avec rendu par segments de scène, permettant d'interrompre et de reprendre, ou de relancer depuis un segment donné.
Illustration
【B】H3 Image w/ Pose Studio + Other Advanced Features [FoxFurEssence] · v1.0
Workflow · Nouveau modèle · Auteur foxydits · Publié le 11-11 08:56 · Téléchargements 159
Workflow multifonction H3 Image : génération d'images à partir de texte / d'images / jusqu'à 9 images de référence, avec Pose Studio intégré pour la pose (activable/désactivable), et possibilité d'extraire une image d'une vidéo comme référence.
Illustration
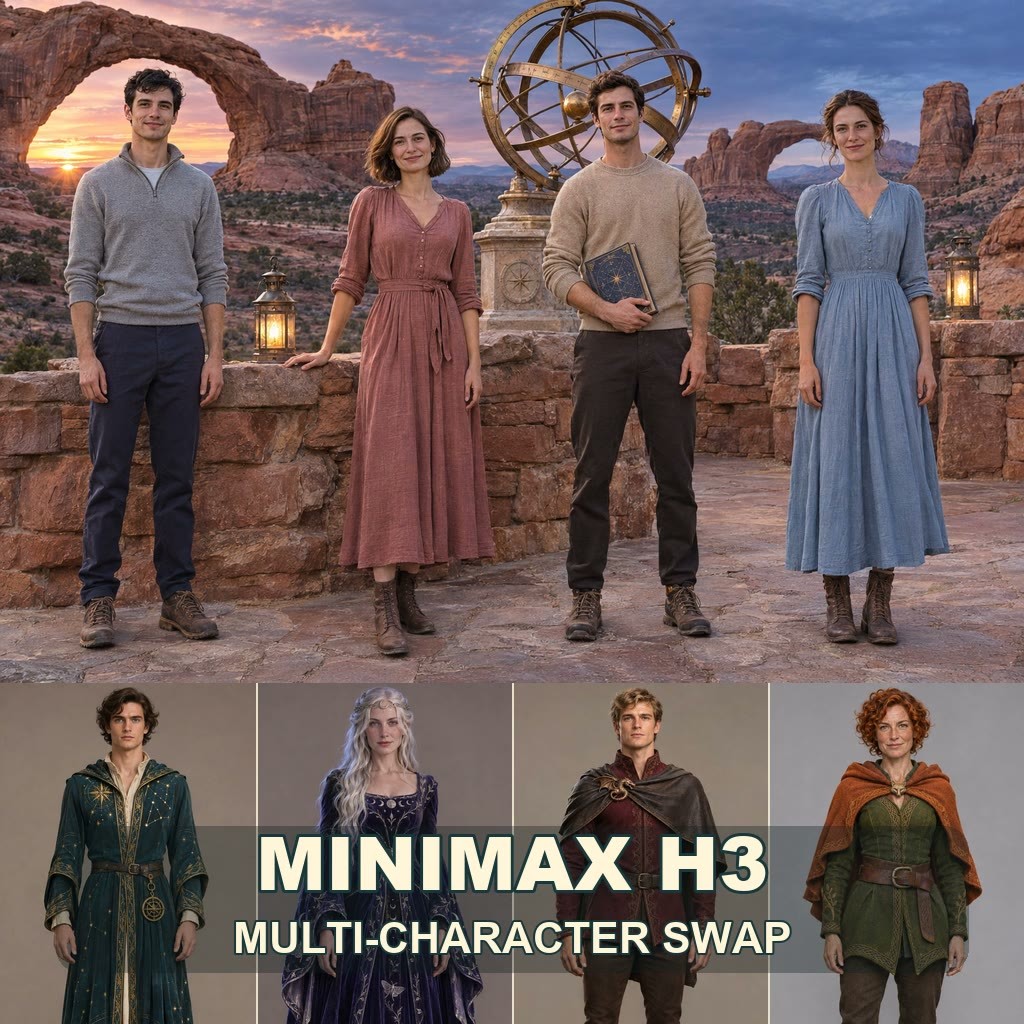
【B】MiniMax H3 Multi-Character Swap in Images | ComfyUI · v1.0
Workflow · Nouveau modèle · Auteur BearGhasemian · Publié le 11-11 11:04 · Téléchargements 7
Workflow de remplacement de personnages sur une image statique utilisant le nœud d'image de référence du modèle vidéo H3 : fournit une image de référence par personnage pour remplacer les 1–4 personnes d'une image par les personnages spécifiés.
Illustration
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT6
Modèle de base / Checkpoint · Mise à jour de version · Auteur tsolful · Publié le 11-11 07:30 · Téléchargements 7
Version quantifiée INT6 (W6A8) de H3 Image sur la même page, 15.61 Go, intermédiaire entre INT8 et INT4, ce niveau n'étant pas disponible dans le dépôt officiel Comfy.
Illustration
【B】MiniMax H3 60-Second Seamless Video Workflow For 12GB GPUs @ 35-Min Gen Times · v1.2
Workflow · Nouveau modèle · Auteur vortis23 · Publié le 11-11 12:46 · Téléchargements 3
Workflow vidéo longue durée H3 v1.2 fonctionnant sur des cartes graphiques de 12 Go : utilise le nœud H3 Motion Director pour segmenter selon la ligne temporelle, l'auteur affirmant qu'il génère en environ 35 minutes un plan-séquence continu d'environ une minute.
Illustration
Inclus uniquement (9)
- (prevent melting faces)MiniMax H3-Image base workflow · base workflow — Flux de travail : flux de travail de génération d'images de base H3 Image intitulé « prevent melting faces », la description sur la page du modèle ne contient qu'un point.
- Aliyah Belwyn · MiniMaxH3 — LoRA : LoRA de personnage pour le personnage fictif original de l'auteur, Aliyah Belwyn (harpetiste de Bruges), porté de la version Anima / ZImageTurbo vers H3.
- Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT4 — Modèle de base / Checkpoint : version quantifiée H3 Image INT4 (W4A8 GPTQ) de la même page, 12.77 Go, la plus petite des trois options, elle économise uniquement la mémoire vidéo sans accélérer les performances.
- MiniMax-H3-Image · v1.0 — Flux de travail : flux de travail de génération d'images intitulé MiniMax-H3-Image, la description ne contient que le titre et « v1 ».
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — Flux de travail : flux de travail simple adaptant le flux de génération d'images de Qwen 2.1 à H3 Image, dont le nom mentionne un amplificateur de prompt plus rapide.
- Esmae Belwyn · MiniMaxH3 — LoRA : LoRA de personnage pour le personnage fictif original de l'auteur, Esmae Belwyn (fleuriste au bord des canaux de Bruges), porté de la version MOSS Image vers H3.
- Faye Belwyn · MiniMaxH3 — LoRA : LoRA de personnage pour le personnage fictif original de l'auteur, Faye Belwyn (restauratrice de tissus anciens à Bruges), porté des versions Krea 2 / ZImageTurbo / MOSS Image vers H3.
- Anaya Von Vergin · MiniMaxH3 — LoRA : LoRA de personnage pour le personnage fictif original de l'auteur, Anaya Von Vergin (conservatrice de musée issue d'Oxford), porté de plusieurs versions SDXL, Flux, Anima et MOSS Image vers H3.
- Ruth Belwyn · MiniMaxH3 — LoRA : LoRA de personnage pour le personnage fictif original de l'auteur, Ruth Belwyn (relieuse de livres à Bruges), version H3 publiée simultanément avec la version Krea 2.
Données : API publique de Civitai (modèle de base MiniMax H3), période de collecte du 11-10 20:31 au 11-11 13:03 (heure de Pékin). Les recommandations ont été vérifiées par la rédaction ; le nombre de téléchargements reflète uniquement le niveau d'intérêt.