Radar AI của Trinh Trinh · MiniMax H3 · Bản tin buổi sáng 2026-11-11
Kỳ này có 23 phiên bản mới: Đề xuất mạnh mẽ 2 · Đề xuất 3 · Đáng chú ý 9 · Chỉ ghi nhận 9
Lời bình của biên tập viên Kỳ này đã xem xét 23 phiên bản mới của H3, gồm 2 mục S, 3 mục A, 9 mục B và 9 mục C. Đề xuất hàng đầu là quy trình làm việc tạo ảnh từ văn bản và chỉnh sửa ảnh H3 Image của AusBoss: tạo ảnh 16 MP chỉ với một câu mô tả hoặc chỉnh sửa ảnh bằng ngôn ngữ đời thường, có thể kết nối thêm bảy ảnh tham khảo; chế độ Fast sử dụng pDMD để giảm số bước từ 6 xuống 2 bước; lưu ý rằng khoảng một nửa số mục trong kỳ này là phiên bản hình ảnh H3 được tích hợp vào ComfyUI 11-10, chỉ tạo ảnh chứ không tạo video. Về mặt video, cùng xếp hạng S là LoRA phong cách “quay bằng điện thoại của bạn bè” Friend’s POV, còn LoRA góc nhìn thứ nhất từ kính thông minh và LoRA phong cách vẽ của “Frieren: Pháp sư tiễn táng” được xếp hạng A. Các gói lượng hóa H3 Image có mô tả không rõ ràng về INT8 / INT4 bị hạ xuống hạng B / C, LoRA giọng lồng tiếng bị hạ xuống hạng B do vấn đề bản quyền, và 5 LoRA nhân vật gốc do MisterMR chuyển đổi hàng loạt thiếu từ kích hoạt và ví dụ minh họa, nên được xếp hạng C.
Đề xuất mạnh mẽ (2)
【S】MiniMax H3 Image Generate + Edit | 16 MP, 8 Ảnh · v1.0
Quy trình làm việc · Mô hình mới · Tác giả AusBoss · Phát hành 11-11 08:31 · Tải xuống 140
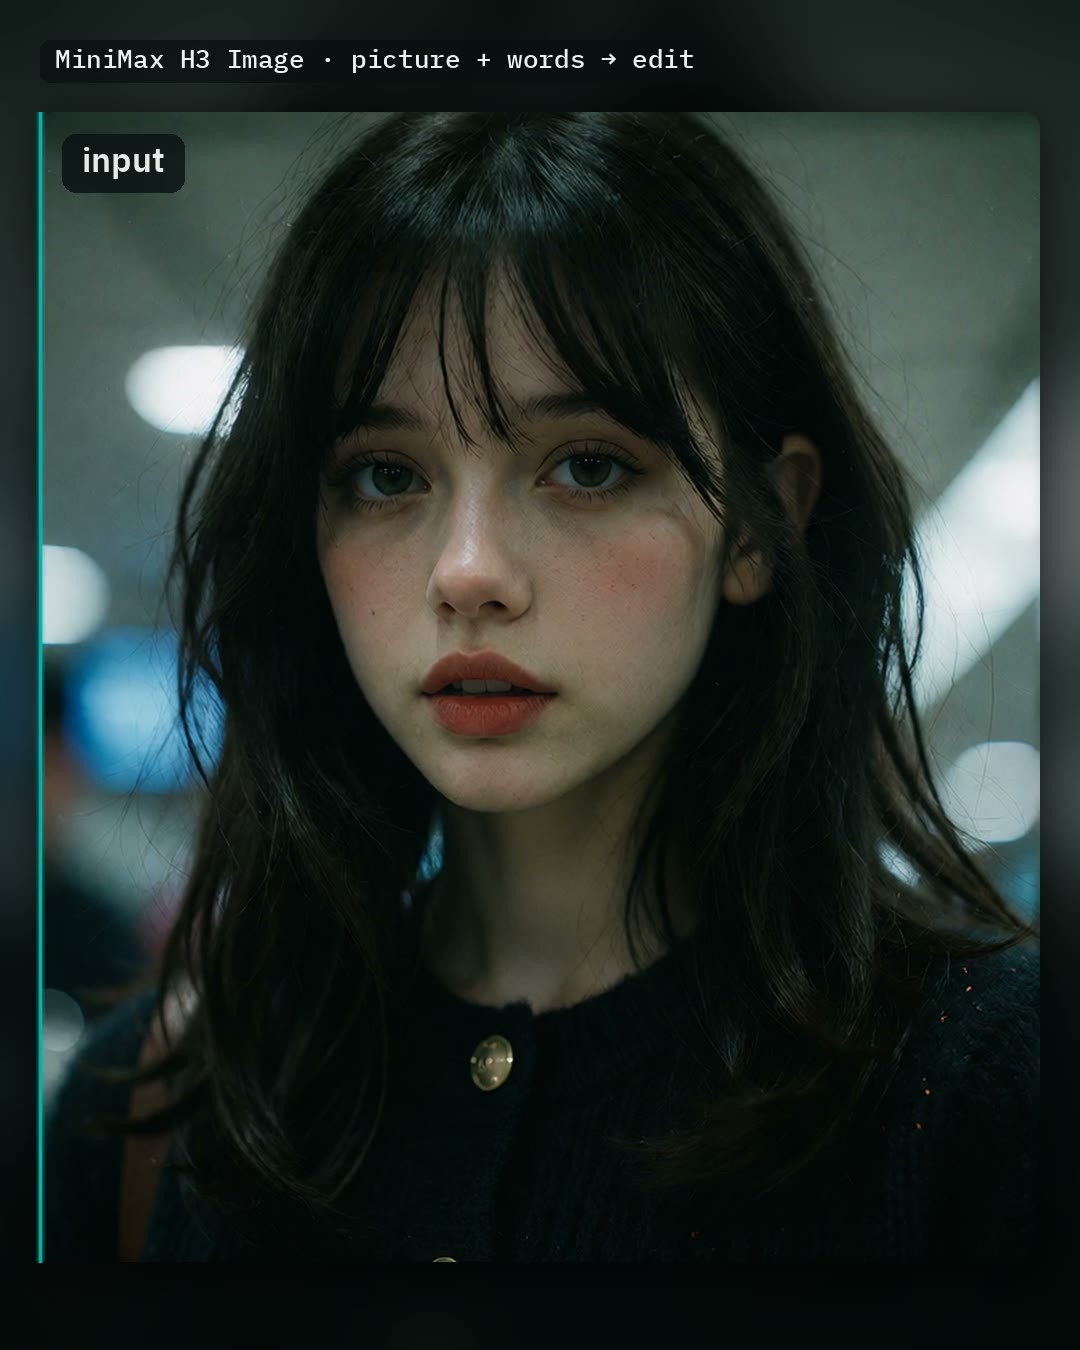
Quy trình làm việc tạo ảnh từ văn bản và chỉnh sửa ảnh trên ComfyUI cho MiniMax H3 Image (phiên bản hình ảnh của H3): tạo ảnh 16 MP chỉ với một câu mô tả, hoặc chỉnh sửa ảnh bằng ngôn ngữ đời thường, khi chỉnh sửa có thể kết nối thêm tối đa bảy ảnh tham khảo và chỉ định rõ nội dung cần lấy từ mỗi ảnh.
Sau khi H3 Image ra mắt, đây là quy trình làm việc đầu tiên kết nối liền mạch các bước tạo ảnh, chỉnh sửa ảnh, tham khảo nhiều ảnh và phóng to, đồng thời có ghi rõ phiên bản thử nghiệm, rất phù hợp làm mẫu khởi đầu cho H3 Image.
Hình minh họa
Lý do đề xuất
- Mô hình mới (dưới dạng quy trình làm việc, không phải trọng số mới); phục vụ việc tạo ảnh từ văn bản, chỉnh sửa ảnh theo lệnh và tổng hợp tham khảo nhiều ảnh cho H3 Image, ví dụ như “mặc chiếc áo khoác trong ảnh 2 cho người trong ảnh 1”
- Tác giả ghi rõ môi trường thử nghiệm (nhánh master của ComfyUI commit ede4e5f + nút AusBoss 2.22.0, đã chạy thử trên cả hai mức VRAM), đồng thời liệt kê chi tiết từng tệp mô hình cần thiết, thư mục lưu trữ và dung lượng: High VRAM sử dụng mô hình cơ sở int8 ConvRot (21.0 GB), Low VRAM sử dụng w4a8 (12.5 GB), dùng chung bộ mã hóa văn bản Qwen3-VL 32B nvfp4 và VAE của H3 Image
- Đầy đủ các công tắc điều chỉnh: Auto prompt sử dụng mô hình nhỏ để mở rộng vài từ thành mô tả dài; Size chuyển đổi giữa 4 MP / 16 MP; Fast sử dụng LoRA pDMD 2 bước để giảm số bước từ 6 xuống 2 bước; tùy chọn sử dụng SeedVR2 để phóng to gấp đôi kết quả 4 MP
- Tác giả cho biết trên RTX 5090, việc tạo mới một ảnh 16 MP mất khoảng 22 giây, chỉnh sửa ảnh 16 MP mất khoảng 35 giây; kèm theo 1 đoạn video + 6 ảnh ví dụ minh họa
Cách sử dụng
- Trước tiên cập nhật ComfyUI lên phiên bản sau 0.44.0 và cập nhật nút AusBoss lên 2.22.0, kéo thả quy trình làm việc vào và nhấn Run trực tiếp, mặc định đã kèm theo một lời nhắc đầy đủ
- Tự tạo ảnh: viết mô tả dài đầy đủ, hoặc bật Auto prompt và chỉ viết vài từ; chỉnh sửa ảnh: bật Edit a picture, tải ảnh lên và viết nội dung cần thay đổi (ví dụ “Make it snow.”); kết nối các ảnh tham khảo lần lượt từ picture 2 đến picture 8, và gọi tên cụ thể “picture 2” trong lời nhắc
- Văn bản cần xuất hiện trong khung hình hãy đặt trong dấu ngoặc kép; khi lời nhắc đã đủ chi tiết thì tắt Auto prompt (tác giả cho biết khi viết lại lời nhắc mở đầu, bàn tay thường bị biến dạng); khi làm áp phích hoặc bìa sách thì không bật chế độ Fast
Rủi ro và hạn chế
- Phụ thuộc vào hỗ trợ mới của H3 Image (mới được tích hợp vào ComfyUI từ 11-10) và các nút tùy chỉnh của AusBoss, nên không thể chạy trên các phiên bản ComfyUI cũ; dung lượng tải xuống của toàn bộ bộ mô hình (mô hình cơ sở + bộ mã hóa văn bản 32B + mô hình mở rộng tùy chọn, LoRA tăng tốc, SeedVR2) là rất lớn
- Giấy phép cộng đồng MiniMax-H3-Image: theo lời kể lại của tác giả lượng hóa Comfy, giấy phép không bao gồm EU, Vương quốc Anh, Hàn Quốc, Mỹ, sản phẩm đầu ra không được dùng để cải thiện các mô hình AI khác, nếu doanh thu hàng năm vượt quá 100 vạn đô la hoặc cung cấp dịch vụ lưu trữ thì cần được cấp phép riêng
- Đây là mô hình hình ảnh của H3, không tạo video; các con số về thời gian xử lý là do tác giả cung cấp
【S】Friend's POV - MiniMax H3 · H3 V1
LoRA · Mô hình mới · Tác giả AriaMaiven · Phát hành 11-11 09:15 · Tải xuống 86
LoRA phong cách video “quay bằng điện thoại của bạn bè”: bố cục rộng, chủ thể bị đẩy ra rìa khung hình, ánh sáng phẳng từ điện thoại, và khung hình sẽ rung lắc khi người quay cười.
Cùng tác giả với Smart Glasses POV, thuộc cùng một loạt “góc nhìn quay phim nghiệp dư”, cách viết tham số nhất quán.
Hình minh họa
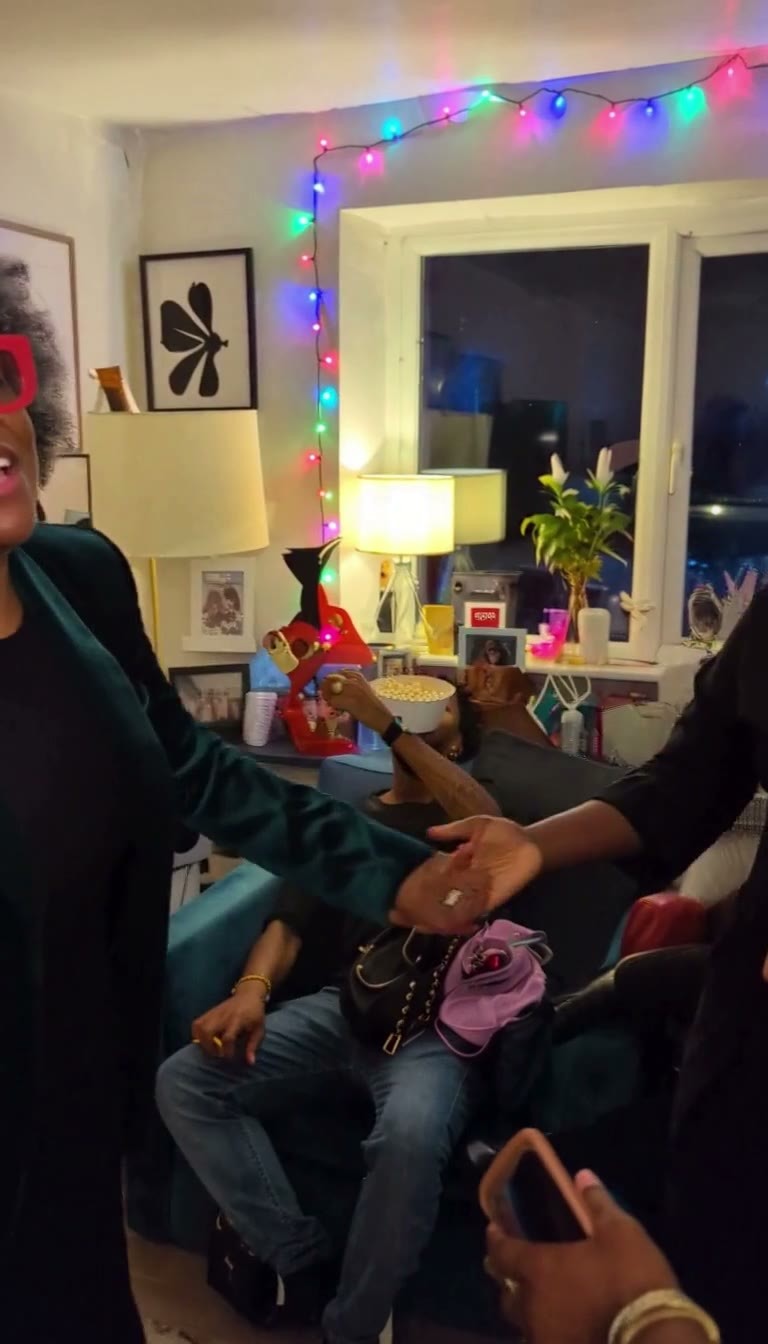
Lý do đề xuất
- Mô hình mới; phục vụ các video đời thường cận cảnh có nhân vật như tiệc tùng, phố đêm, lối đi siêu thị, hướng đến cảm giác “video trong điện thoại của bạn bè” thay vì phong cách điện ảnh
- Tác giả cung cấp hướng dẫn sử dụng đầy đủ: từ kích hoạt celsint, với khuôn mặt cận cảnh dùng cường độ 0.65 (giữ ổn định khuôn mặt, vẫn giữ cảm giác điện thoại), khi người ở xa, quay lưng hoặc không xuất hiện trong khung hình có thể tăng lên 0.8 (phong cách mạnh hơn, nhưng khuôn mặt cận cảnh sẽ bị biến dạng)
- Cách viết lời nhắc được hướng dẫn cụ thể: đặt phong cách ở câu đầu tiên trong lời nhắc H3; không viết các từ như điện thoại, cầm tay, rung lắc, phơi sáng, hạt nhiễu, vì những yếu tố này do từ kích hoạt đảm nhiệm; thay vào đó hãy mô tả “người bạn được quay đang làm gì” (chạy phía sau, bị kéo cổ tay, bị khách va vào), rung lắc sẽ trông chân thực hơn
- Cấu hình thử nghiệm của tác giả: MiniMax H3 FL2VA pruned int8 ConvRot tạo video từ văn bản, 20 bước, res_multistep + simple, 768x1344, 5 giây; kèm theo 2 đoạn video ví dụ minh họa
Cách sử dụng
- Từ kích hoạt celsint; cường độ từ 0.65 (khuôn mặt cận cảnh) đến 0.8 (cảnh xa hoặc không có khuôn mặt); câu đầu tiên trong lời nhắc viết dạng [Shot 1] Live-action in the celsint style, a medium shot at chest height...
- Sử dụng độc lập, không kết hợp với các LoRA về cơ thể người hoặc chuyển động khác; tác giả thử nghiệm ở chế độ tạo video từ văn bản với 20 bước, res_multistep, simple, 768x1344
Rủi ro và hạn chế
- Có thể sử dụng cho mục đích thương mại nhưng cần ghi rõ nguồn gốc phong cách; khi đăng tải lại hoặc sử dụng sản phẩm đầu ra để huấn luyện các mô hình khác, phải xin phép tác giả trước
- 1 ví dụ đã bị ẩn; chỉ thử nghiệm chế độ tạo video từ văn bản, tác giả chưa đề cập đến hiệu suất trong chế độ tạo video từ ảnh / Ref2VA
Từ kích hoạt: celsint
Đề xuất (3)
【A】Minimax H3 Image Quants - comfy-native - fp8_scaled / nvfp4 / GGUF Q6 / Q4 / Q3 / Q2_mix · v1.0
Mô hình cơ sở / Checkpoint · Mô hình mới · Tác giả Thasmodius · Phát hành 11-11 07:19 · Tải xuống 47
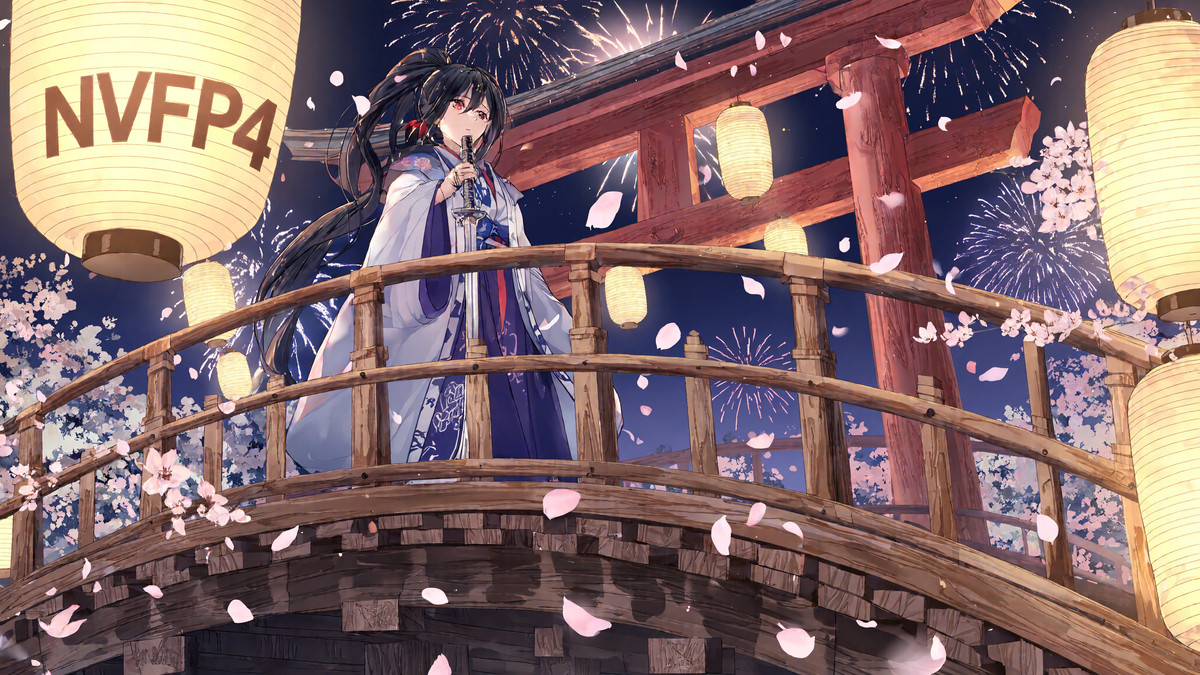
Gói bổ sung độ chính xác cho mô hình cơ sở H3 Image: bao gồm các phiên bản lượng hóa hỗn hợp fp8 scaled, NVFP4 và GGUF Q6_K / Q4_K / Q3_K / Q2_K mà kho lưu trữ chính thức của Comfy chưa có, chỉ chứa mô hình khuếch tán.
Hình minh họa
Lý do đề xuất
- Mô hình mới (trọng số lượng hóa); phục vụ người dùng muốn chạy tạo ảnh từ văn bản và chỉnh sửa ảnh H3 Image trên RTX 40 / 50 hoặc bất kỳ card đồ họa nào nhưng VRAM không đủ để chứa phiên bản bf16 chính thức
- Mục đích của từng phiên bản được ghi rõ: fp8 scaled 21.0 GB dành cho RTX 40 / 50; NVFP4 12.5 GB chỉ chạy gốc trên RTX 50 và nhanh nhất (tác giả cho biết trên RTX PRO 6000 đạt khoảng 2048x2048 3.4 steps/s, fp8 khoảng 2.1 steps/s); GGUF Q6_K 17.5 GB, Q4_K 12.5 GB, Q3_K 10.0 GB chạy trên bất kỳ card đồ họa nào; Q2_K mix 9.25 GB là phiên bản thử nghiệm, tác giả cho biết hình ảnh rõ ràng bị mờ hơn
- Tác giả giải thích phạm vi lượng hóa giống với int8 / w4a8 chính thức của Comfy (cùng 200 lớp transformer, chiếm 95.8% trọng số), phần còn lại giữ nguyên bf16 chính thức, đồng thời cung cấp trang so sánh trên HF; kèm theo 8 ảnh ví dụ minh họa
Cách sử dụng
- Yêu cầu ComfyUI phiên bản 0.44 trở lên; mở mẫu “MiniMax H3 Image” tích hợp sẵn trong ComfyUI, chọn tệp trong Load Diffusion Model; giữ nguyên cài đặt mẫu với 6 bước, euler, simple, cfg 1
- Bộ mã hóa văn bản qwen3vl_32b_minimax_h3_nvfp4_awq (hoặc int8 convrot) và VAE được lấy từ kho lưu trữ MiniMax-H3-Image của Comfy-Org
- Đối với GGUF, cần thay đổi nút tải thành Unet Loader (GGUF), và trước tiên phải vá ComfyUI-GGUF (chạy tệp vá do tác giả cung cấp, hoặc thêm thủ công "minimax_h3" vào IMG_ARCH_LIST trong loader.py), nếu không sẽ báo lỗi Unexpected architecture type
- Tác giả cho biết mô hình hoạt động tốt nhất trong khoảng 4–20 MP, hiệu suất kém ở độ phân giải thấp, cần sử dụng lời nhắc tiếng Anh dài và chi tiết
Rủi ro và hạn chế
- Giấy phép cộng đồng MiniMax-H3-Image: Tác giả ghi rõ trong bài gốc rằng giấy phép không áp dụng cho EU, Vương quốc Anh, Hàn Quốc, Mỹ; mô hình và đầu ra không được dùng để cải thiện các mô hình AI khác; nếu doanh thu hàng năm vượt quá 100 nghìn đô la hoặc cung cấp dịch vụ lưu trữ (hosting), cần có sự cho phép bằng văn bản từ MiniMax; sản phẩm thương mại phải ghi rõ MiniMax-H3-Image
- Các phụ thuộc GGUF chưa được hợp nhất vào bản gốc (upstream); 2 ví dụ bị ẩn; đây là mô hình hình ảnh, không tạo video
【A】Góc nhìn kính thông minh - MiniMax H3 · H3 V1
LoRA · Mô hình mới · Tác giả AriaMaiven · Phát hành 11-11 09:15 · Tải xuống 122
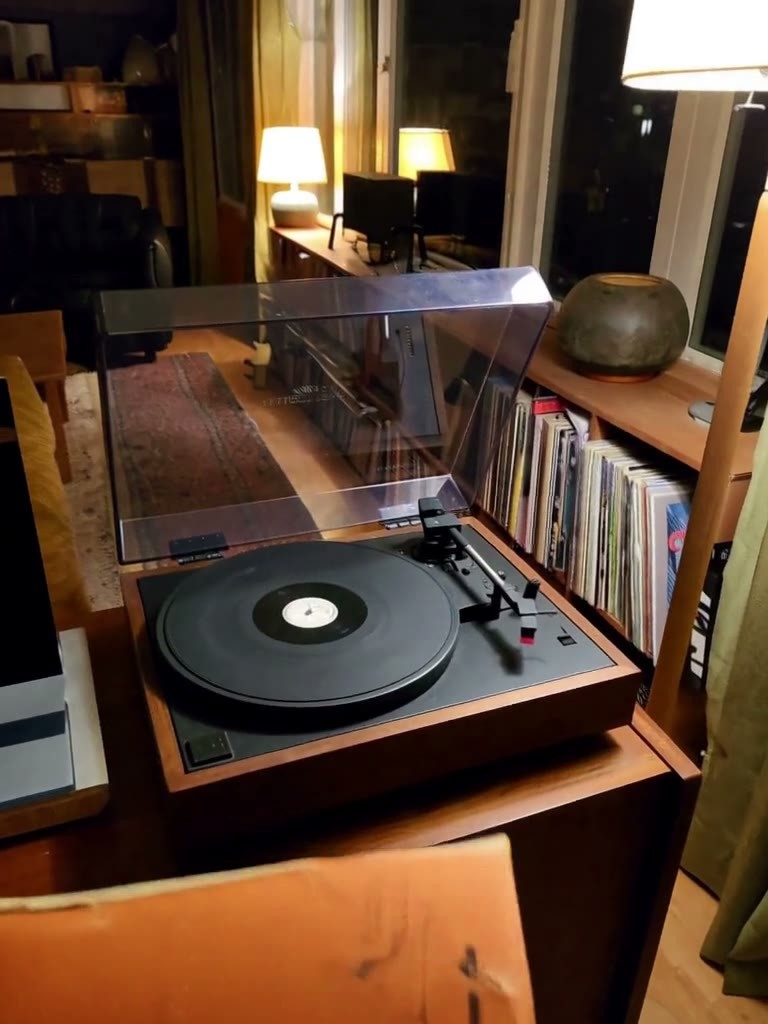
LoRA phong cách video góc nhìn thứ nhất từ kính thông minh: góc rộng không biến dạng, chuyển động đầu khi cúi xuống nhìn tay, và hai bàn tay của người đeo đưa vào từ phía dưới khung hình.
Hình minh họa
Lý do đề xuất
- Mô hình mới; phục vụ các video góc nhìn thứ nhất đời thường kiểu "nhìn từ sau đôi mắt" như nấu ăn, đạp xe, lấy sách từ kệ, mở cửa đón chó
- Cường độ được ghi rõ: 0.6 là mức khuyến nghị; 0.8 có phong cách mạnh hơn nhưng tay không còn tuân theo mô tả; 1.0 là quá mức
- Tác giả nhắc nhở phải mô tả đầy đủ đôi tay mỗi lần (màu da, nhẫn, đồng hồ, móng tay, tay áo, nếu không có hình xăm thì ghi "no tattoos"), những phần không được mô tả LoRA sẽ tự động bổ sung; cấu hình thử nghiệm của tác giả là FL2VA pruned int8 ConvRot cho văn bản thành video, 20 bước, res_multistep + simple, 768x1024, 5 giây
Cách sử dụng
- Từ khóa kích hoạt (trigger word) povsint, cường độ 0.6; câu đầu tiên trong prompt viết [Shot 1] Live-action in the povsint style, an eye-level shot...
- Không viết glasses, POV, first person, fisheye, vì từ khóa kích hoạt đã đảm nhận; sử dụng riêng lẻ, không kết hợp với LoRA về cơ thể người hoặc chuyển động
Rủi ro và hạn chế
- Tác giả tự nhận rằng đôi tay đôi khi trắng hơn một tông, thỉnh thoảng có hình xăm nhỏ xuất hiện trên cổ tay, cần kiểm tra trước khi công bố
- Chỉ có 1 đoạn video mẫu hiển thị (4 đoạn bị ẩn); việc sao chép hoặc sử dụng đầu ra để huấn luyện các mô hình khác cần sự cho phép của tác giả
Từ khóa kích hoạt: povsint
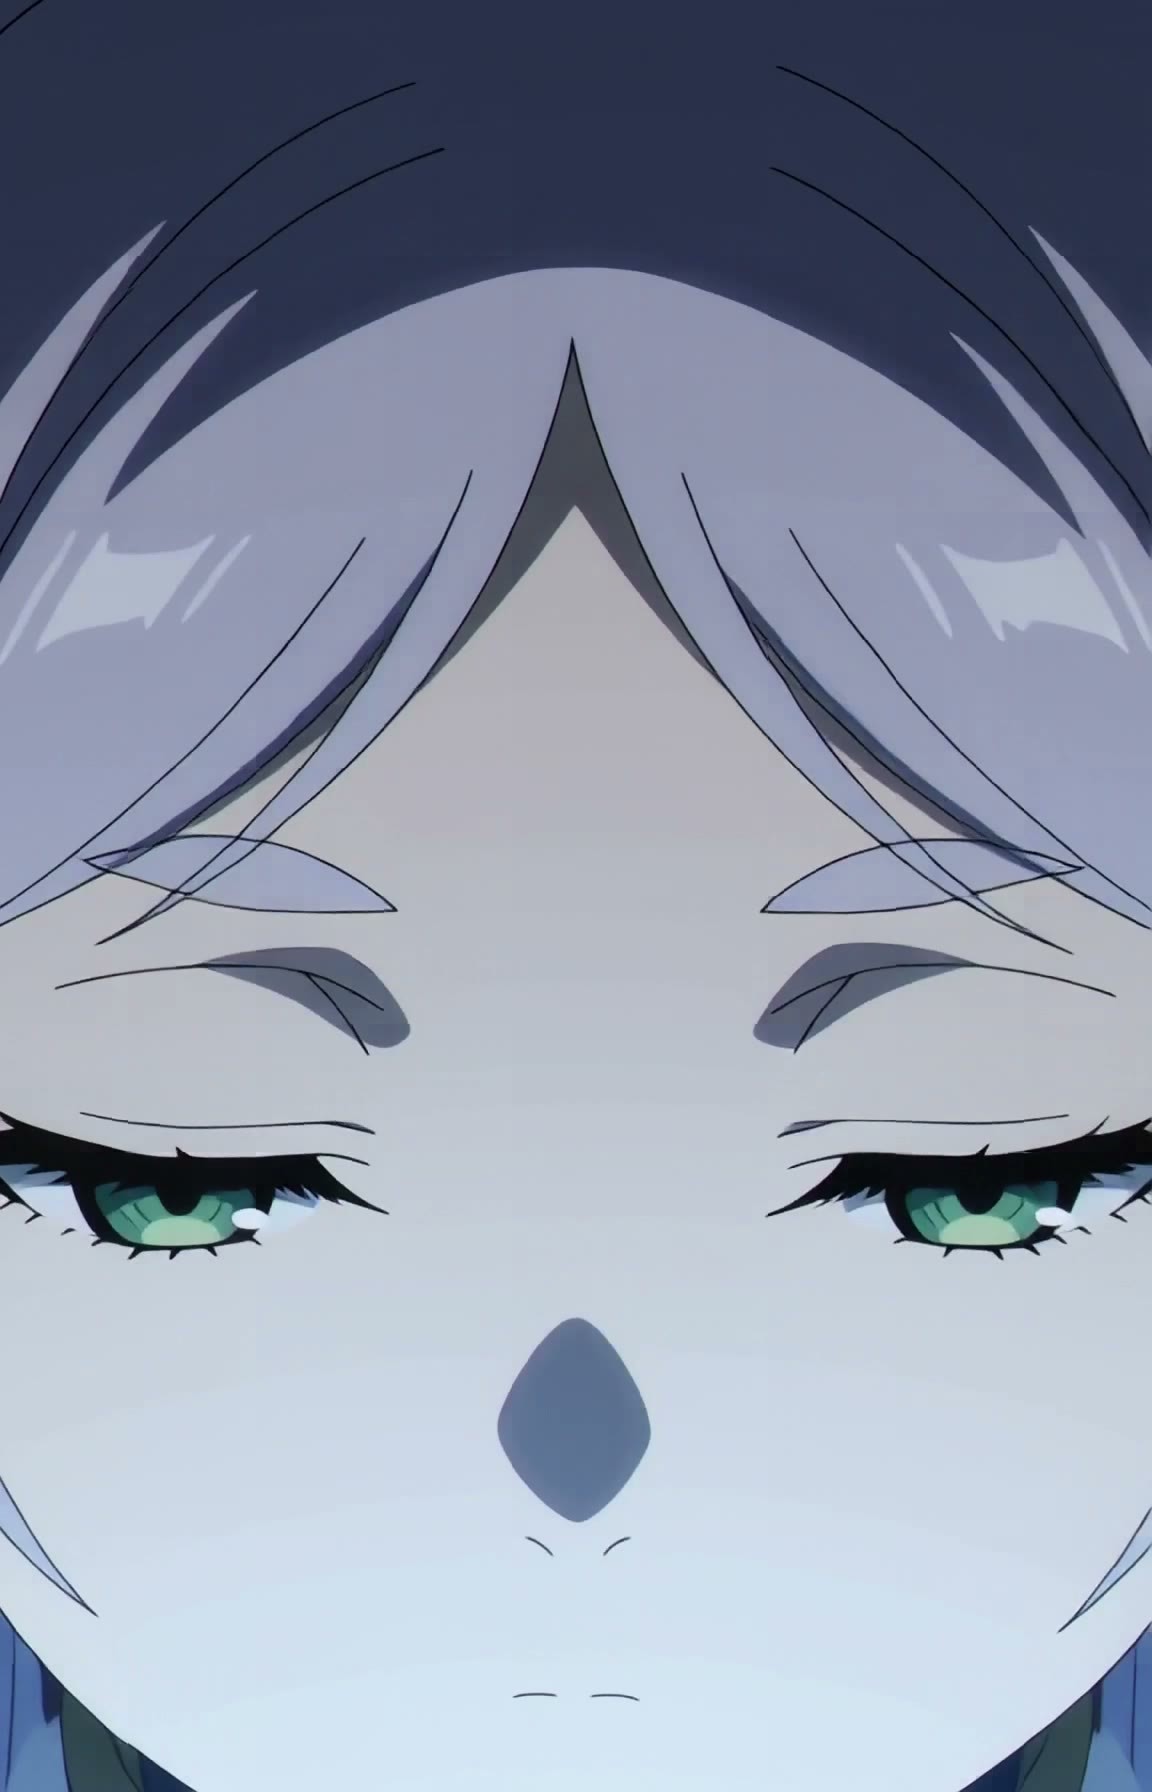
【A】Phong cách anime Frieren H3 Style Lora · v1.0
LoRA · Mô hình mới · Tác giả tazmannner379 · Phát hành 11-10 21:24 · Tải xuống 259
LoRA video phong cách anime "Frieren: Beyond Journey's End": tái hiện phong cách vẽ của bộ anime này, kèm theo một phần giọng nói nhân vật và nhạc nền.
Hình minh họa
Lý do đề xuất
- Mô hình mới; phục vụ những ai muốn làm phim ngắn fan-made về Frieren, video từ văn bản/hình ảnh sang video phong cách anime, và cần nhân vật lên tiếng
- Dữ liệu huấn luyện được ghi rõ: 672 đoạn phim có âm thanh + 721 ảnh chụp màn hình; tác giả đã đăng báo cáo huấn luyện, hướng dẫn prompt, cùng với ảnh thiết kế nhân vật và tham chiếu giọng nói của 27 nhân vật trên Hugging Face
- Cung cấp 3 điểm kiểm tra (checkpoint) theo số bước huấn luyện (3150 / 3900 / 4200 bước), tệp chính là phiên bản 4200 bước; 6 đoạn video mẫu hiển thị, sau khi phát hành khoảng 16 giờ đã có 259 lượt tải và 36 lượt thích
Cách sử dụng
- Bắt đầu prompt bằng từ khóa kích hoạt 2d anime style, Frieren style,
- Trang HF của tác giả khuyến nghị điểm kiểm tra 4200 bước, cường độ 1.0; được huấn luyện trên mô hình cơ sở FL2VA, cũng có thể dùng trên mô hình cơ sở Ref2VA kết hợp với ảnh thiết kế nhân vật làm ảnh tham chiếu
- Để tái hiện ổn định một nhân vật cụ thể, hãy kết hợp ảnh tham chiếu nhân vật và tham chiếu giọng nói từ trang HF theo khuyến nghị của tác giả
Rủi ro và hạn chế
- Được huấn luyện bằng hình ảnh từ anime chính thức và lồng tiếng nhân vật (tác giả tự nhận trên trang HF rằng không sở hữu bản quyền, chỉ dành cho mục đích học tập), hãy xác nhận quyền sở hữu trước khi công khai hoặc sử dụng thương mại
- Số bước, CFG, bộ lấy mẫu không được ghi trên trang Civitai, hãy xem hướng dẫn trên HF; 6 ví dụ bị ẩn
Từ khóa kích hoạt: 2d anime style, Frieren style
Đáng chú ý (9)
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT8
Mô hình cơ sở / Checkpoint · Mô hình mới · Tác giả tsolful · Phát hành 11-11 07:17 · Tải xuống 67
Phiên bản lượng tử hóa INT8 ConvRot (W8A8) của mô hình cơ sở H3 Image, dung lượng 19.54 GB, tác giả khuyến nghị chọn làm mặc định trong ba mức lượng tử hóa.
Hình minh họa
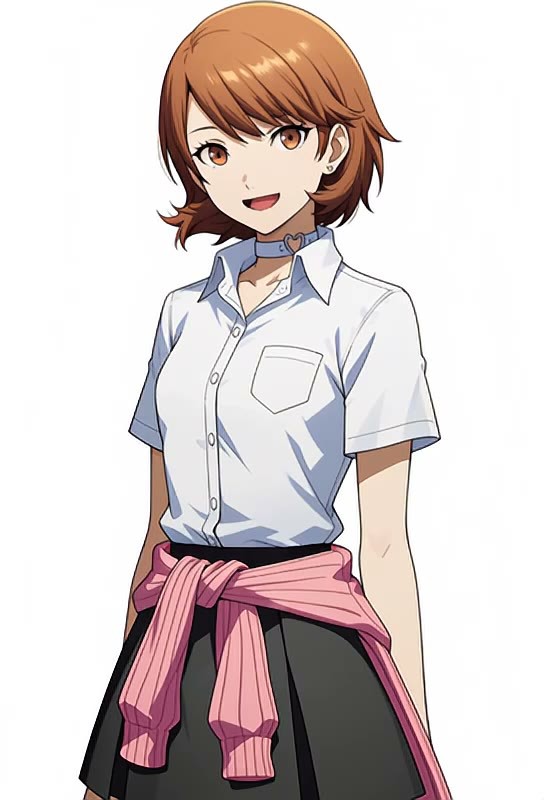
【B】Giọng nói Yukari Takeba - Persona 3 - Chỉ âm thanh [Minimax H3] · Minimax H3 v1.0
LoRA · Mô hình mới · Tác giả OneMoreLurker · Phát hành 11-11 12:04 · Tải xuống 20
LoRA lồng tiếng nhân vật chỉ âm thanh: được huấn luyện bằng giọng nói tiếng Nhật của Yukari Takeba từ "Persona 3 Reload", giúp H3 tạo ra lời thoại với chất giọng của nhân vật này.
Hình minh họa
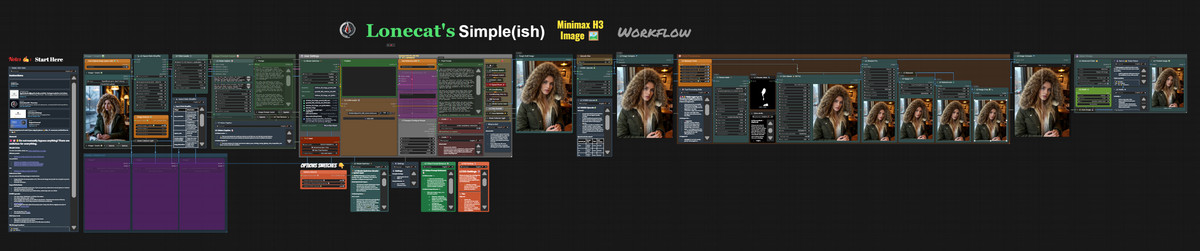
【B】Quy trình tăng tốc đơn giản của Lonecat 🚀 | Simple Speed Boost Workflows (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple Minimax Image 🖼️
Quy trình làm việc · Cập nhật phiên bản · Tác giả lonecatone23 · Phát hành 11-11 11:45 · Tải xuống 10
Phiên bản H3 Image (Simple Minimax Image) mới được thêm vào bộ sưu tập quy trình làm việc đơn giản của Lonecat: một quy trình tạo ảnh từ ảnh tham chiếu H3 Image có chú thích, tác giả đã thêm nút skin master để cải thiện kết cấu da.
Hình minh họa
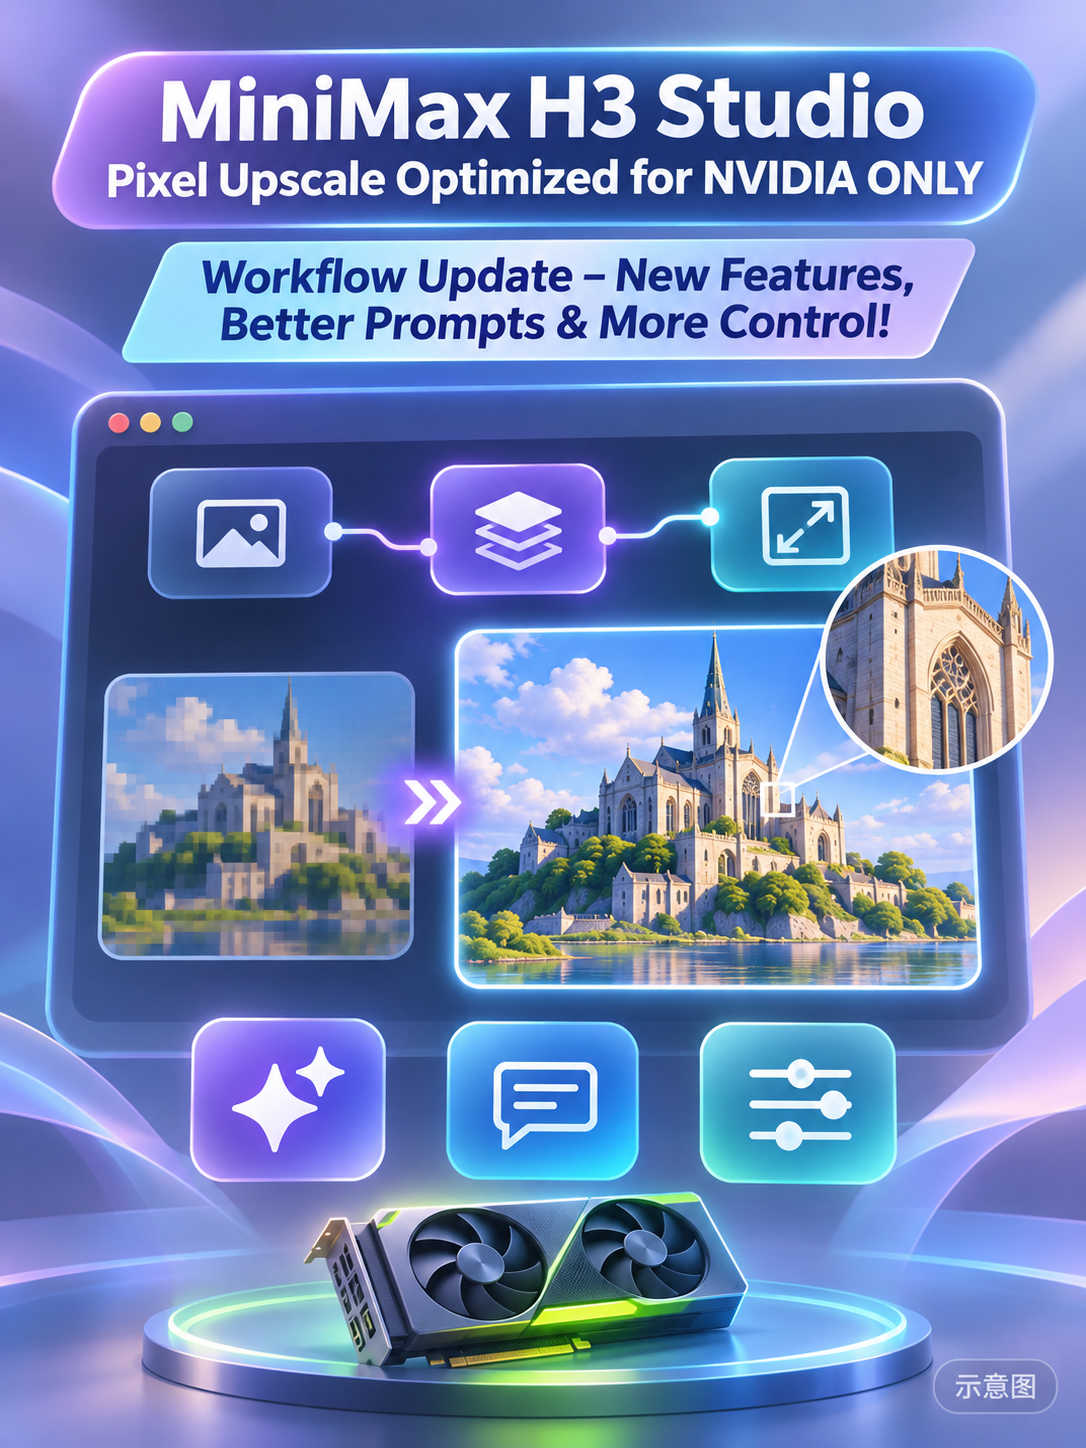
【B】MInimax H3 Studio, Pixel Upscale tối ưu hóa chỉ dành cho NVIDIA · v3.0
Quy trình làm việc · Cập nhật phiên bản · Tác giả hRUSTIN474 · Phát hành 11-11 04:50 · Tải xuống 57
Quy trình làm việc video H3 Studio v3.0: ba nhánh văn bản sang video / hình ảnh sang video / ảnh tham chiếu sang video kèm tự động viết prompt, nối tiếp nhiều cảnh, sau khi xuất video sẽ xử lý hậu kỳ siêu phân giải và HDR dành riêng cho NVIDIA.
Hình minh họa
【B】MiniMaxH3 Khớp môi / TLF2VA · Nova.3
Quy trình làm việc · Cập nhật phiên bản · Tác giả Rvage · Phát hành 11-11 00:44 · Tải xuống 50
Quy trình làm việc video khớp môi / đa cảnh H3 Nova.3: sử dụng ảnh nhân vật + bản thu âm có sẵn để tạo video khớp môi khi hát, nói chuyện, hoặc sử dụng tính năng văn bản/hình ảnh sang video, khung đầu/cuối gốc của H3, kết xuất theo từng cảnh, có thể tạm dừng và tiếp tục hoặc làm lại từ một cảnh cụ thể.
Hình minh họa
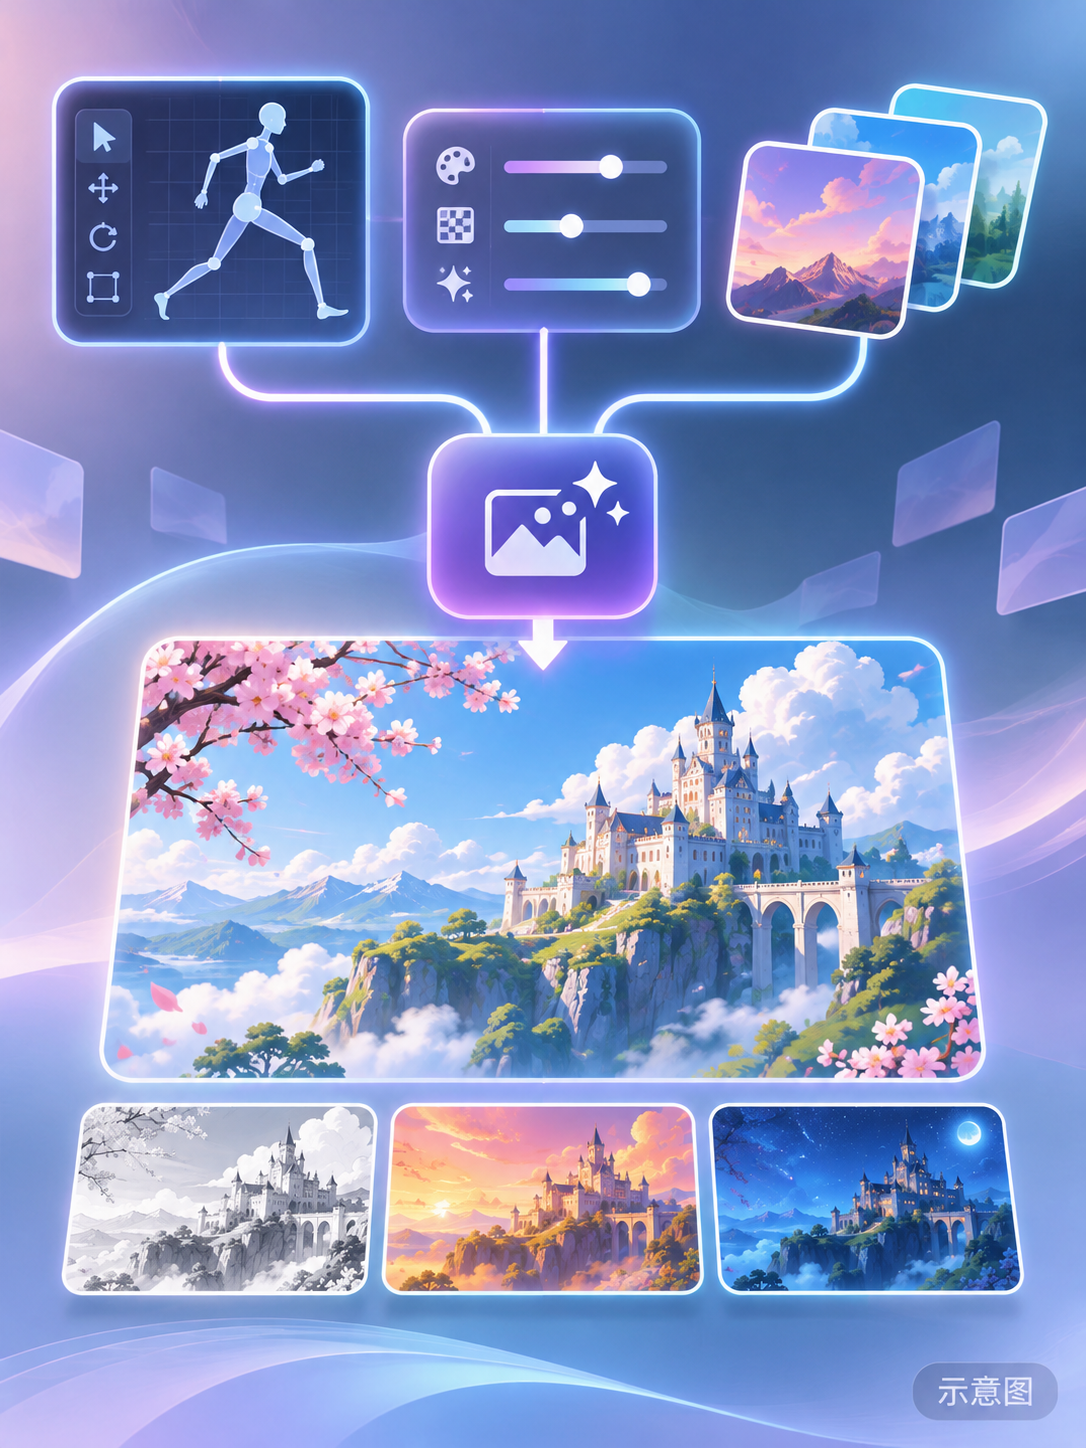
【B】H3 Image kèm Pose Studio + Các tính năng nâng cao khác [FoxFurEssence] · v1.0
Quy trình làm việc · Mô hình mới · Tác giả foxydits · Phát hành 11-11 08:56 · Tải xuống 159
Quy trình làm việc đa năng H3 Image: văn bản sang hình ảnh / hình ảnh sang hình ảnh / tạo ảnh từ tối đa 9 ảnh tham chiếu, tích hợp Pose Studio có thể bật/tắt để tạo dáng, đồng thời có thể cắt một khung hình từ video làm ảnh tham chiếu.
Hình minh họa
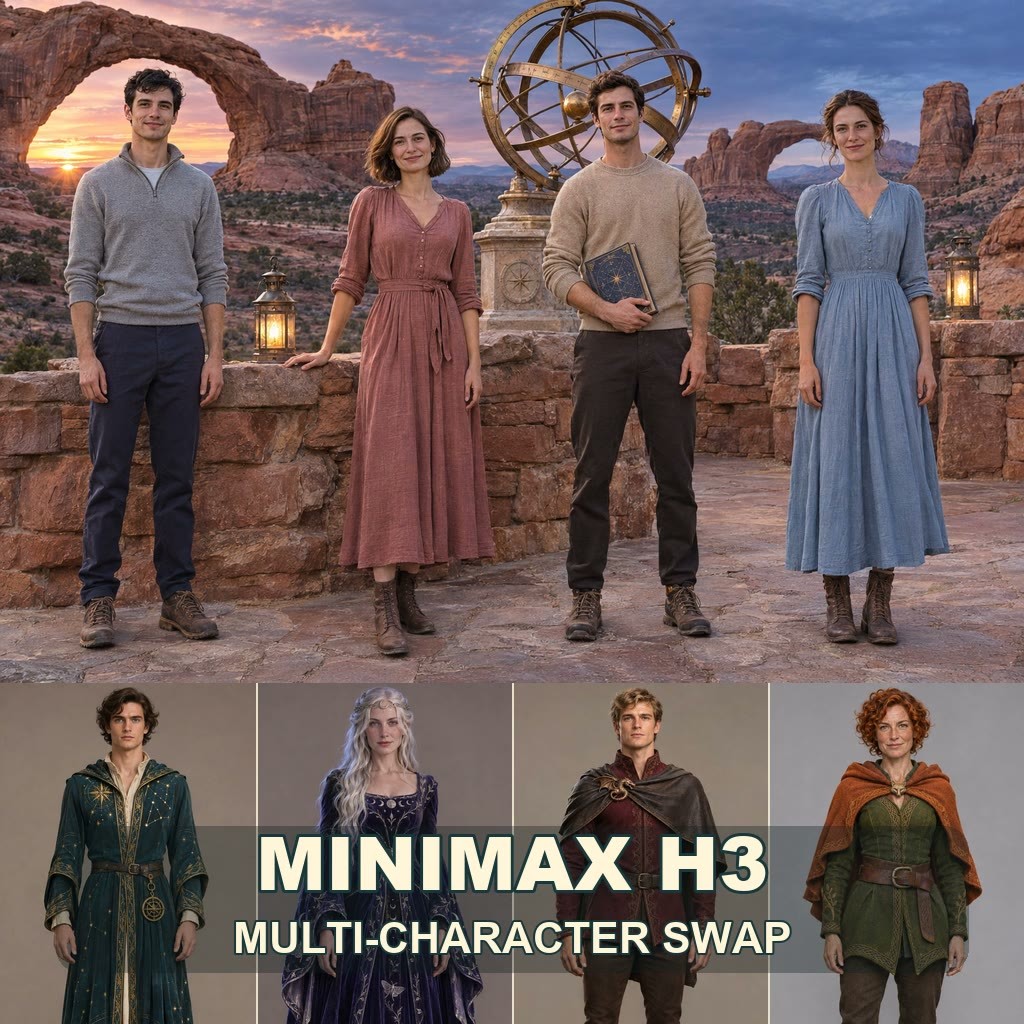
【B】Hoán đổi nhiều nhân vật trong hình ảnh MiniMax H3 | ComfyUI · v1.0
Quy trình làm việc · Mô hình mới · Tác giả BearGhasemian · Phát hành 11-11 11:04 · Tải xuống 7
Quy trình làm việc hoán đổi nhân vật cho ảnh tĩnh đơn khung sử dụng nút ảnh tham chiếu của mô hình video H3: cung cấp một ảnh tham chiếu cho mỗi nhân vật, thay thế 1–4 người trong một bức ảnh bằng các nhân vật chỉ định.
Hình minh họa
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT6
Mô hình cơ sở / Checkpoint · Cập nhật phiên bản · Tác giả tsolful · Phát hành 11-11 07:30 · Tải xuống 7
Phiên bản lượng tử hóa INT6 (W6A8) của H3 Image trên cùng trang, dung lượng 15.61 GB, nằm giữa INT8 và INT4, kho lưu trữ chính thức của Comfy không có mức này.
Hình minh họa
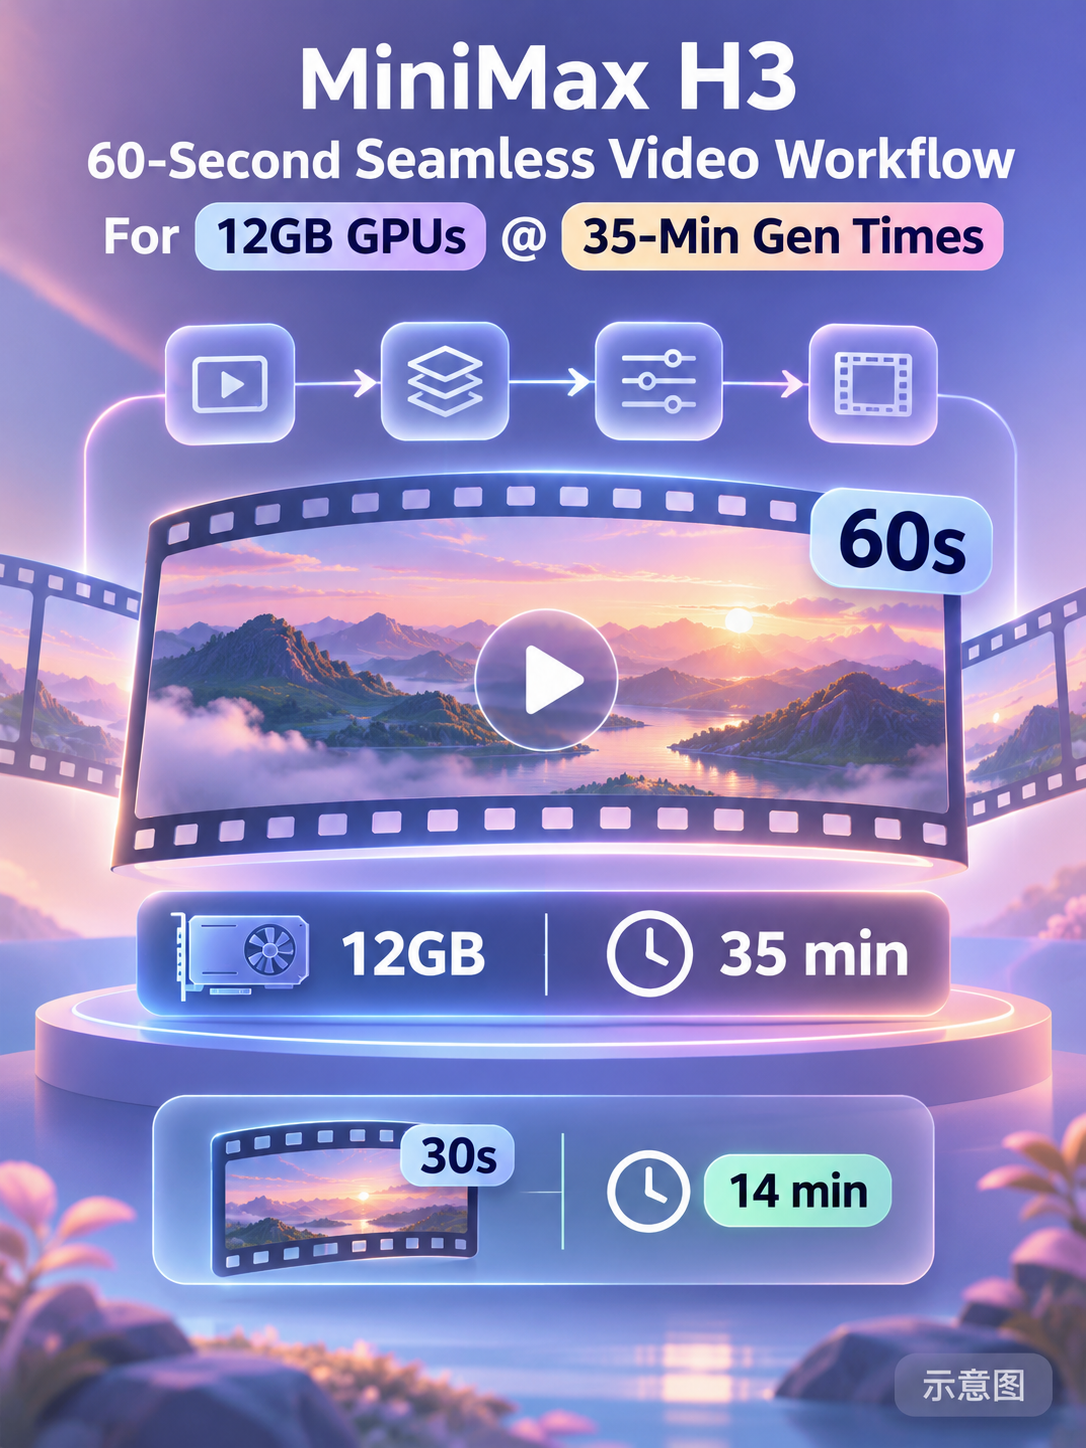
【B】Quy trình làm việc video liền mạch 60 giây MiniMax H3 cho GPU 12GB @ Thời gian tạo 35 phút · v1.2
Quy trình làm việc · Mô hình mới · Tác giả vortis23 · Phát hành 11-11 12:46 · Tải xuống 3
Quy trình làm việc video dài H3 v1.2 có thể chạy trên card đồ họa 12GB: sử dụng nút H3 Motion Director để phân đoạn theo dòng thời gian, tác giả cho biết mất khoảng 35 phút để tạo ra một cảnh quay liên tục dài tối đa khoảng một phút.
Hình minh họa
Chỉ liệt kê (9)
- (ngăn khuôn mặt bị tan chảy) MiniMax H3-Image quy trình cơ bản · quy trình cơ bản — Quy trình: Quy trình tạo ảnh cơ bản H3 Image có tên “ngăn khuôn mặt bị tan chảy”, mô tả trên trang mô hình chỉ gồm một dấu chấm.
- Aliyah Belwyn · MiniMaxH3 — LoRA: LoRA nhân vật Aliyah Belwyn (người chơi đàn hạc ở Bruges) do tác giả tự sáng tạo, được chuyển từ phiên bản Anima / ZImageTurbo sang H3.
- Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT4 — Mô hình gốc / Checkpoint: Phiên bản lượng tử hóa H3 Image INT4 (W4A8 GPTQ) cùng trang, dung lượng 12.77 GB, nhỏ nhất trong ba phiên bản, chỉ tiết kiệm VRAM chứ không tăng tốc độ.
- MiniMax-H3-Image · v1.0 — Quy trình: Quy trình tạo ảnh có tên MiniMax-H3-Image, mô tả chỉ gồm tiêu đề và “v1”.
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — Quy trình: Quy trình đơn giản điều chỉnh quy trình tạo ảnh của Qwen 2.1 để sử dụng trên H3 Image, tên gọi cho biết có bộ mở rộng prompt nhanh hơn.
- Esmae Belwyn · MiniMaxH3 — LoRA: LoRA nhân vật Esmae Belwyn (người cắm hoa bên kênh đào Bruges) do tác giả tự sáng tạo, được chuyển từ phiên bản MOSS Image sang H3.
- Faye Belwyn · MiniMaxH3 — LoRA: LoRA nhân vật Faye Belwyn (người phục chế vải cổ ở Bruges) do tác giả tự sáng tạo, được chuyển từ các phiên bản Krea 2 / ZImageTurbo / MOSS Image sang H3.
- Anaya Von Vergin · MiniMaxH3 — LoRA: LoRA nhân vật Anaya Von Vergin (người phụ trách bảo tàng xuất thân từ Oxford) do tác giả tự sáng tạo, được chuyển từ nhiều phiên bản như SDXL, Flux, Anima, MOSS Image sang H3.
- Ruth Belwyn · MiniMaxH3 — LoRA: LoRA nhân vật Ruth Belwyn (người đóng sách ở Bruges) do tác giả tự sáng tạo, phiên bản H3 được đăng tải cùng lúc với phiên bản Krea 2.
Dữ liệu: API công khai của Civitai (mô hình gốc MiniMax H3), khoảng thời gian thu thập 11-10 20:31 → 11-11 13:03 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.