정정(貞貞)의 AI 레이더 · MiniMax H3 · 2026-11-11 모닝 브리프
이번 호의 23개 신규 버전: 강력 추천 2 · 추천 3 · 주목할 만함 9 · 단순 등재 9
편집자 주 이번 호에서는 H3의 새로운 버전 23개를 검토했으며, S등급 2개, A등급 3개, B등급 9개, C등급 9개로 분류했습니다. 최우선 추천은 AusBoss의 H3 Image 텍스트-이미지 생성 + 이미지 편집 워크플로우입니다: 한 문장으로 16 MP 이미지를 생성하거나 쉬운 말로 이미지를 편집할 수 있으며, 최대 7장의 참고 이미지를 추가할 수 있습니다. Fast 모드에서는 pDMD를 사용하여 6 스텝을 2 스텝으로 줄입니다. 이번 호의 약 절반이 H3의 이미지 버전이 11-10에 ComfyUI로 통합된 항목이며, 영상은 생성하지 않고 이미지만 생성한다는 점에 유의하세요. 영상 부문에서 S등급으로 함께 등재된 것은 '친구 핸드폰으로 찍은 스냅' 스타일의 LoRA Friend's POV이며, 스마트 안경 1인칭 시점 LoRA와 『장송의 프리렌』 아트 스타일 LoRA는 A등급으로 분류되었습니다. H3 Image 양자화 패키지에서 설명이 불명확한 INT8 / INT4는 B / C등급으로 하향 조정되었으며, 더빙 음성 LoRA는 저작권 문제로 B등급으로 하향 조정되었고, MisterMR이 대량으로 이식한 5개의 오리지널 캐릭터 LoRA는 트리거 워드와 예시가 부족하여 C등급으로 분류되었습니다.
강력 추천 (2)
【S】MiniMax H3 Image Generate + Edit | 16 MP, 8 Pictures · v1.0
워크플로우 · 신규 모델 · 저자 AusBoss · 게시일 11-11 08:31 · 다운로드 수 140
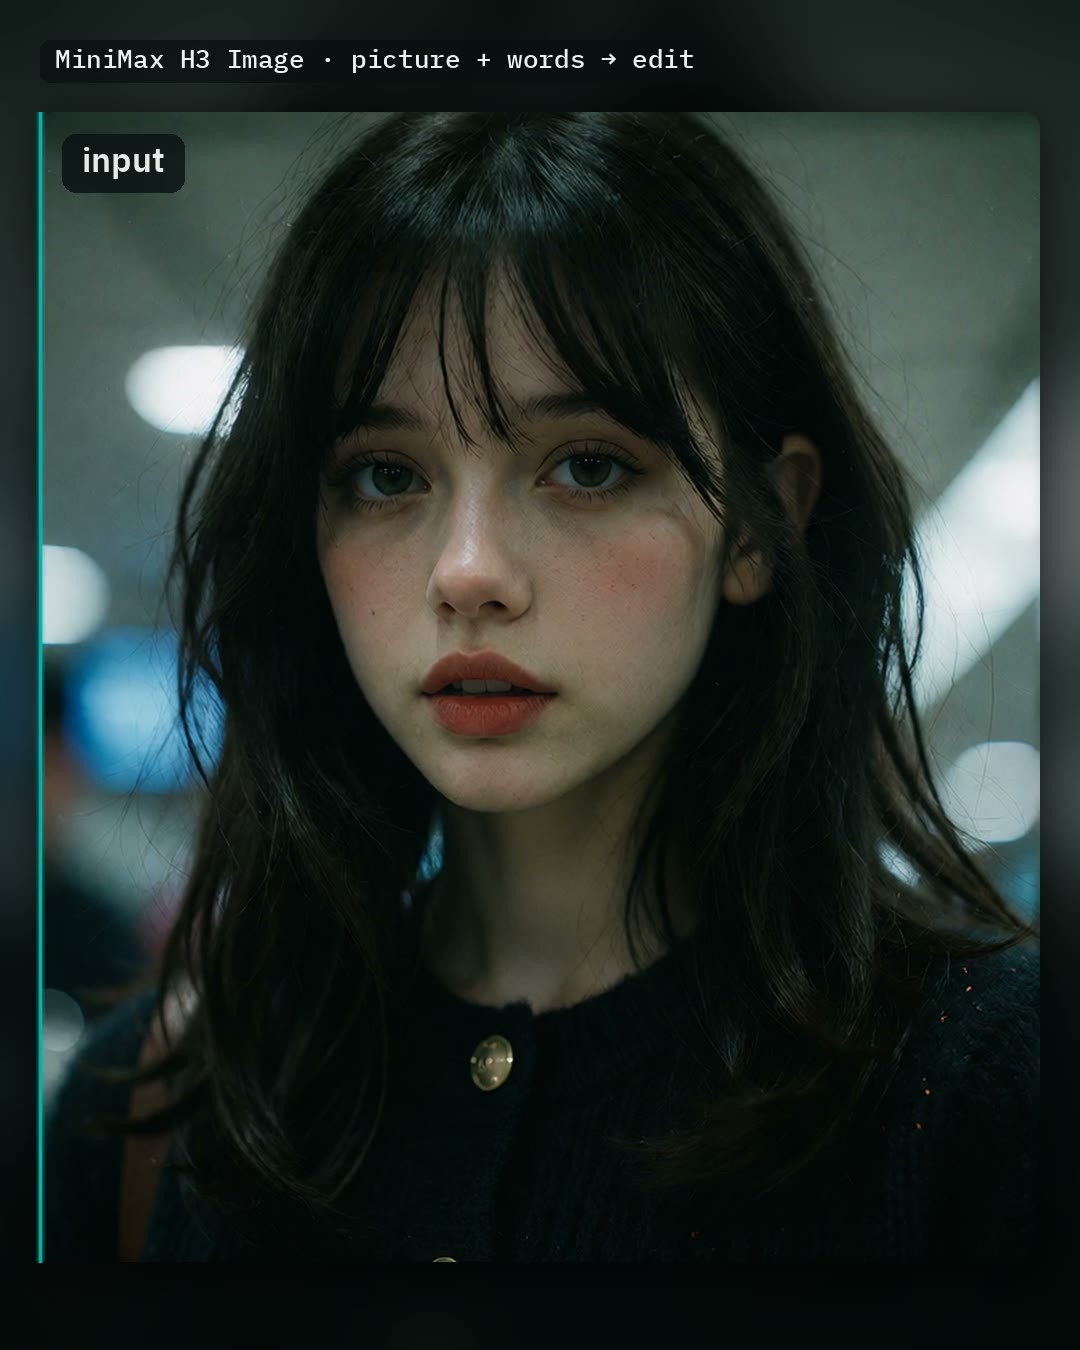
MiniMax H3 Image(H3의 이미지 버전)의 ComfyUI 텍스트-이미지 생성 + 이미지 편집 워크플로우: 한 문장으로 16 MP 이미지를 생성하거나, 쉬운 말로 이미지를 편집할 수 있으며, 편집 시 최대 7장의 참고 이미지를 추가하여 각 이미지에서 무엇을 가져올지 지정할 수 있습니다.
H3 Image 출시 후 생성, 편집, 다중 이미지 참고 및 업스케일링을 하나로 연결하고 테스트 버전 번호까지 명시한 최초의 워크플로우로, H3 Image의 시작 템플릿으로 적합합니다.
예시 이미지
추천 이유
- 신규 모델(워크플로우이며, 새로운 가중치가 아님); H3 Image의 텍스트-이미지 생성, 지시 기반 이미지 편집 및 다중 이미지 참고 합성을 지원하며, 예를 들어 '이미지 2의 재킷을 이미지 1의 인물에게 입혀줘'와 같은 작업이 가능합니다
- 저자는 테스트 환경(ComfyUI master 브랜치 커밋 ede4e5f + AusBoss nodes 2.22.0, 두 가지 VRAM 설정에서 모두 실행 확인)을 명시하고, 필요한 모델 파일, 배치 디렉터리 및 크기를 하나씩 나열했습니다: High VRAM은 int8 ConvRot 기본 모델(21.0 GB)을 사용하며, Low VRAM은 w4a8(12.5 GB)을 사용합니다. 공통으로 Qwen3-VL 32B nvfp4 텍스트 인코더와 H3 Image VAE를 사용합니다
- 스위치가 완비되어 있습니다: Auto prompt는 소형 모델을 사용하여 몇 단어를 긴 설명으로 확장합니다; Size는 4 MP / 16 MP 사이에서 전환됩니다; Fast는 pDMD 2 스텝 LoRA를 사용하여 6 스텝을 2 스텝으로 줄입니다; 선택적으로 SeedVR2를 사용하여 4 MP 결과를 2배로 업스케일링할 수 있습니다
- 저자에 따르면 RTX 5090에서 새로운 16 MP 이미지는 약 22초, 16 MP 이미지 편집은 약 35이 소요됩니다; 1개의 비디오 + 6개의 확인 가능한 예시 이미지
사용 방법
- 먼저 ComfyUI를 0.44.0 이후 버전으로 업데이트하고, AusBoss nodes를 2.22.0으로 업데이트한 후, 워크플로우를 드래그하여 직접 Run하면 기본으로 완전한 프롬프트가 포함됩니다
- 직접 이미지 생성: 완전한 긴 설명을 작성하거나, Auto prompt를 켜고 몇 단어만 작성합니다; 이미지 편집: Edit a picture를 켜고 이미지를 불러온 후 변경 사항을 작성합니다(예: 'Make it snow.'). 참고 이미지는 picture 2부터 picture 8까지 순서대로 연결하고, 프롬프트에서 'picture 2'라고 명시적으로 지정합니다
- 화면에 표시될 텍스트는 따옴표 안에 넣습니다; 프롬프트가 이미 완전할 경우 Auto prompt를 끄십시오(저자는 시작 프롬프트를 재작성할 때 손이 어지러워진다고 언급했습니다); 포스터나 표지를 만들 때는 Fast를 켜지 마십시오
리스크 및 제한 사항
- H3 Image의 새로운 지원(11-10에 ComfyUI로 통합됨)과 AusBoss의 자체 노드에 의존하므로, 구버전 ComfyUI에서는 실행할 수 없습니다; 전체 모델 세트(기본 모델 + 32B 텍스트 인코더 + 선택적 확장 모델, 가속 LoRA, SeedVR2)의 다운로드 용량이 매우 큽니다
- MiniMax-H3-Image 커뮤니티 라이선스: Comfy 양자화 저자의 전언에 따르면, EU, 영국, 한국, 미국은 적용되지 않으며, 산출물은 다른 AI 모델 개선에 사용할 수 없고, 연매출이 100만 달러를 초과하거나 호스팅 서비스를 제공할 경우 별도의 허가가 필요합니다
- 이는 H3의 이미지 모델로, 영상은 생성하지 않습니다; 소요 시간 수치는 저자의 주장입니다
【S】Friend's POV - MiniMax H3 · H3 V1
LoRA · 신규 모델 · 저자 AriaMaiven · 게시일 11-11 09:15 · 다운로드 수 86
'친구가 핸드폰으로 찍은 스냅' 스타일의 영상 LoRA: 구도가 넓고, 피사체가 화면 가장자리로 밀려나며, 핸드폰의 평평한 조명, 촬영자가 웃으면 화면이 함께 흔들리는 특징이 있습니다.
같은 저자의 Smart Glasses POV와 함께 '아마추어 촬영 시점' 시리즈를 구성하며, 파라미터 작성 방식이 동일합니다.
예시 이미지
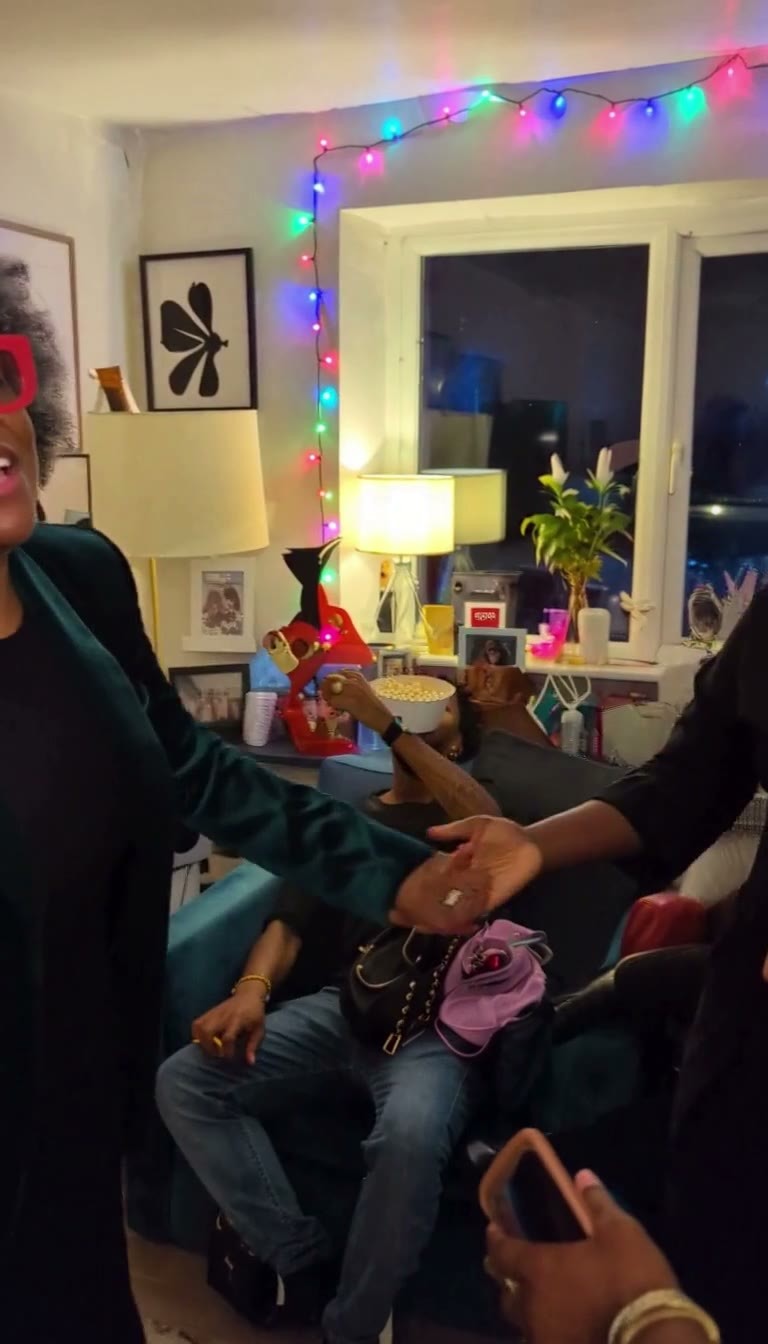
추천 이유
- 신규 모델; 파티, 밤거리, 슈퍼마켓 통로 등 인물이 있는 근거리 생활 영상을 대상으로 하며, 영화 같은 느낌보다는 '친구 핸드폰 속의 영상'을 원할 때 적합합니다
- 저자는 완전한 사용법을 제공했습니다: 트리거 워드 celsint, 근거리 얼굴은 강도 0.65(얼굴 안정성 유지, 핸드폰 느낌 보존), 인물이 멀리 있거나 등을 돌리거나 화면에 없을 경우 0.8까지 높일 수 있습니다(스타일이 더 강해지지만, 근거리 얼굴은 변형될 수 있음)
- 프롬프트 작성법이 구체적입니다: 스타일은 H3 프롬프트의 첫 문장에 배치합니다; 핸드폰, 핸드헬드, 흔들림, 노출, 그레인 등은 작성하지 마십시오. 이들은 트리거 워드가 담당합니다; 대신 '촬영된 친구가 무엇을 하고 있는지'(뒤에서 달리기, 손목을 잡힘, 손님에게 부딪힘 등)를 설명하면 흔들림이 더 자연스러워집니다
- 저자의 테스트 설정: MiniMax H3 FL2VA pruned int8 ConvRot 텍스트-비디오 생성, 20 스텝, res_multistep + simple, 768x1344, 5초; 2개의 확인 가능한 예시 비디오
사용 방법
- 트리거 워드 celsint; 강도 0.65(근거리 얼굴) ~ 0.8(원거리 또는 얼굴 없음); 프롬프트 첫 문장에 [Shot 1] Live-action in the celsint style, a medium shot at chest height...라고 작성합니다
- 단독으로 사용하며, 다른 인물 또는 동작 LoRA와 겹치지 마십시오; 저자의 테스트는 텍스트-비디오 생성 20 스텝, res_multistep, simple, 768x1344이었습니다
리스크 및 제한 사항
- 상업적 사용이 가능하지만 스타일의 출처를 명시해야 합니다;转载或 해당 산출물을 다른 모델 학습에 사용하려면 저자의 허가를 먼저 받아야 합니다
- 1개의 예시가 숨겨져 있습니다; 텍스트-비디오 생성만 테스트되었으며, 이미지-비디오 생성 / Ref2VA에서의 성능은 저자가 명시하지 않았습니다
트리거 워드: celsint
추천 (3)
【A】Minimax H3 Image Quants - comfy-native - fp8_scaled / nvfp4 / GGUF Q6 / Q4 / Q3 / Q2_mix · v1.0
기본 모델 / 체크포인트 · 신규 모델 · 저자 Thasmodius · 게시일 11-11 07:19 · 다운로드 수 47
H3 Image 기본 모델의 보조 정밀도 패키지: Comfy 공식 저장소에 없는 fp8 scaled, NVFP4 및 GGUF Q6_K / Q4_K / Q3_K / Q2_K 혼합 양자화이며, 확산 모델만 포함됩니다.
예시 이미지
추천 이유
- 신규 모델(양자화 가중치); RTX 40 / 50 또는 임의의 그래픽 카드에서 H3 Image 텍스트-이미지 생성 및 편집을 실행하고 싶지만 공식 bf16를 담을 VRAM이 부족한 사용자를 대상으로 합니다
- 각 등급의 용도가 명확히 작성되어 있습니다: fp8 scaled 21.0 GB는 RTX 40 / 50용; NVFP4 12.5 GB는 RTX 50에서만 네이티브로 실행되며 가장 빠릅니다(저자에 따르면 RTX PRO 6000에서 2048x2048는 약 3.4 steps/s, fp8는 약 2.1 steps/s); GGUF Q6_K 17.5 GB, Q4_K 12.5 GB, Q3_K 10.0 GB는 임의의 그래픽 카드용; Q2_K mix 9.25 GB는 실험적 등급으로, 저자는 화면이 눈에 띄게 흐려진다고 언급했습니다
- 저자는 양자화 범위가 Comfy 공식 int8 / w4a8와 동일하다고 설명합니다(동일한 200개의 transformer 레이어, 가중치의 95.8% 차지), 나머지는 공식 bf16로 유지되며, HF에 비교 페이지를 제공했습니다; 8개의 확인 가능한 예시 이미지
사용 방법
- ComfyUI 0.44 이상 버전이 필요합니다; ComfyUI 기본 제공 'MiniMax H3 Image' 템플릿을 열고, Load Diffusion Model에서 파일을 선택합니다; 템플릿 설정을 6 스텝, euler, simple, cfg 1로 유지하십시오
- 텍스트 인코더 qwen3vl_32b_minimax_h3_nvfp4_awq(또는 int8 convrot)와 VAE는 Comfy-Org의 MiniMax-H3-Image 저장소에서 가져오십시오
- GGUF의 경우 로딩 노드를 Unet Loader (GGUF)로 변경하고, 먼저 ComfyUI-GGUF에 패치를 적용해야 합니다(저자가 제공한 patch 스크립트를 실행하거나, loader.py의 IMG_ARCH_LIST에 "minimax_h3"를 수동으로 추가). 그렇지 않으면 Unexpected architecture type 오류가 발생합니다
- 저자는 모델이 4–20 MP 사이에서 가장 좋은 효과를 낸다고 주장하며, 저해상도에서는 성능이 떨어지고, 길고 상세한 영어 프롬프트를 사용해야 합니다
리스크 및 제한 사항
- MiniMax-H3-Image 커뮤니티 라이선스: 원문에는 라이선스가 EU, 영국, 한국, 미국을 포함하지 않는다고 명시되어 있습니다. 모델 및 출력물은 다른 AI 모델을 개선하는 데 사용할 수 없습니다. 연 매출이 100만 달러를 초과하거나 호스팅 서비스를 제공하는 경우 MiniMax의 서면 허가를 먼저 받아야 합니다. 상업용 제품에는 MiniMax-H3-Image를 표기해야 합니다.
- GGUF는 아직 상류(upstream)에 병합되지 않은 패치에 의존합니다. 2개의 예시가 숨겨져 있습니다. 이는 이미지 모델이므로 영상을 생성하지 않습니다.
【A】스마트 안경 POV - MiniMax H3 · H3 V1
LoRA · 신규 모델 · 작성자 AriaMaiven · 게시일 11-11 09:15 · 다운로드 수 122
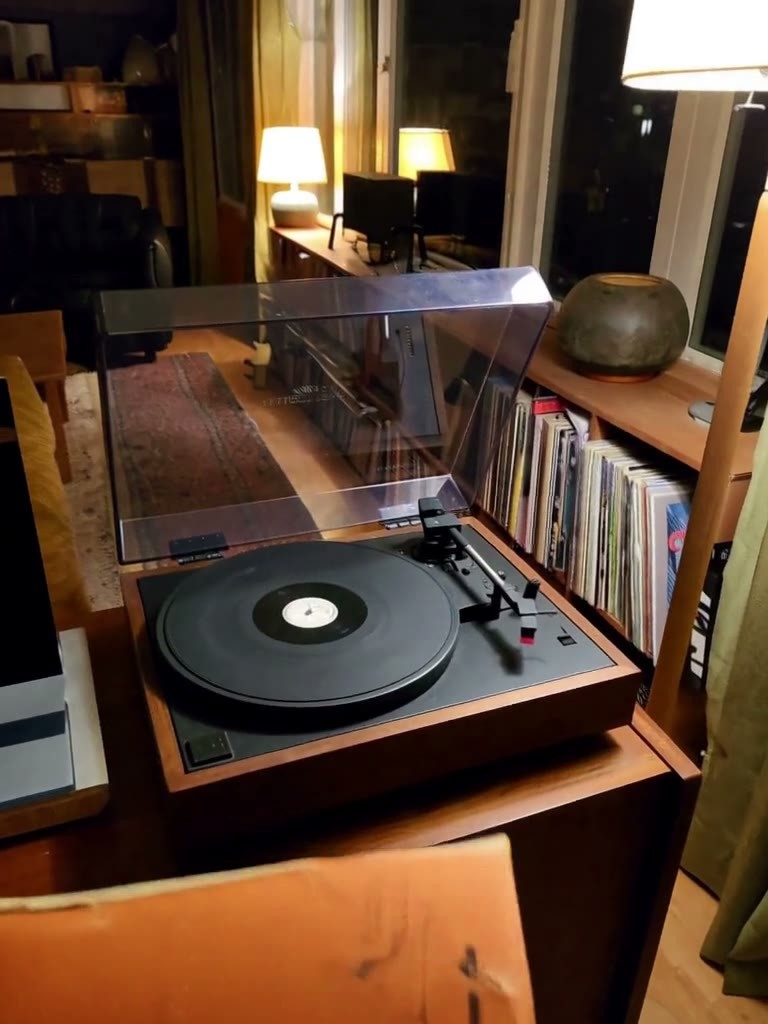
스마트 안경 1인칭 영상 스타일 LoRA: 왜곡 없는 광각, 고개를 숙여 손을 볼 때 따라오는 머리 흔들림, 착용자의 양손이 화면 아래에서 들어오는 효과를 재현합니다.
예시 이미지
추천 이유
- 신규 모델; 요리, 자전거 타기, 책장에서 책 꺼내기, 문을 열어 개를 맞이하기 등 '눈 뒤에서 보는' 일상적인 1인칭 영상에 적합합니다.
- 강도 설정이 명확합니다: 0.6을 권장하며, 0.8은 스타일이 더 강하지만 손이 프롬프트 지시를 따르지 않게 되고, 1.0은 과도합니다.
- 작성자는 매번 손을 완전히 묘사해야 한다고 조언합니다(피부색, 반지, 시계, 손톱, 소매 포함. 문신이 없다면 "no tattoos"라고 명시). 묘사하지 않은 부분은 LoRA가 자동으로 채웁니다. 작성자의 테스트 설정은 FL2VA pruned int8 ConvRot 텍스트-투-비디오이며, 20 스텝, res_multistep + simple 샘플러, 해상도 768x1024, 길이 5초입니다.
사용법
- 트리거 워드는 povsint이며 강도는 0.6을 사용합니다. 프롬프트 첫 문장은 [Shot 1] Live-action in the povsint style, an eye-level shot... 형태로 작성합니다.
- glasses, POV, first person, fisheye 같은 단어는 트리거 워드가 담당하므로 별도로 작성하지 않습니다. 단독으로 사용하며 인물이나 동작 LoRA와 겹쳐 사용하지 않습니다.
리스크 및 제한 사항
- 작성자 스스로 손이 가끔 한 단계 더 하얗게 나오거나, 간혹 손목에 작은 문신이 나타날 수 있어 게시 전 확인이 필요하다고 언급했습니다.
- 1개의 예시 영상만 공개되어 있으며(4개는 숨겨져 있음), 재사용하거나 해당 출력물로 다른 모델을 학습시키려면 작성자의 허가를 먼저 받아야 합니다.
트리거 워드: povsint
【A】프렌렌 애니메이션 H3 스타일 LoRA · v1.0
LoRA · 신규 모델 · 작성자 tazmannner379 · 게시일 11-10 21:24 · 다운로드 수 259
『장송의 프리렌』 애니메이션 스타일 영상 LoRA: 해당 애니메이션의 그림체를 재현하며 일부 캐릭터의 목소리와 배경음악까지 포함합니다.
예시 이미지
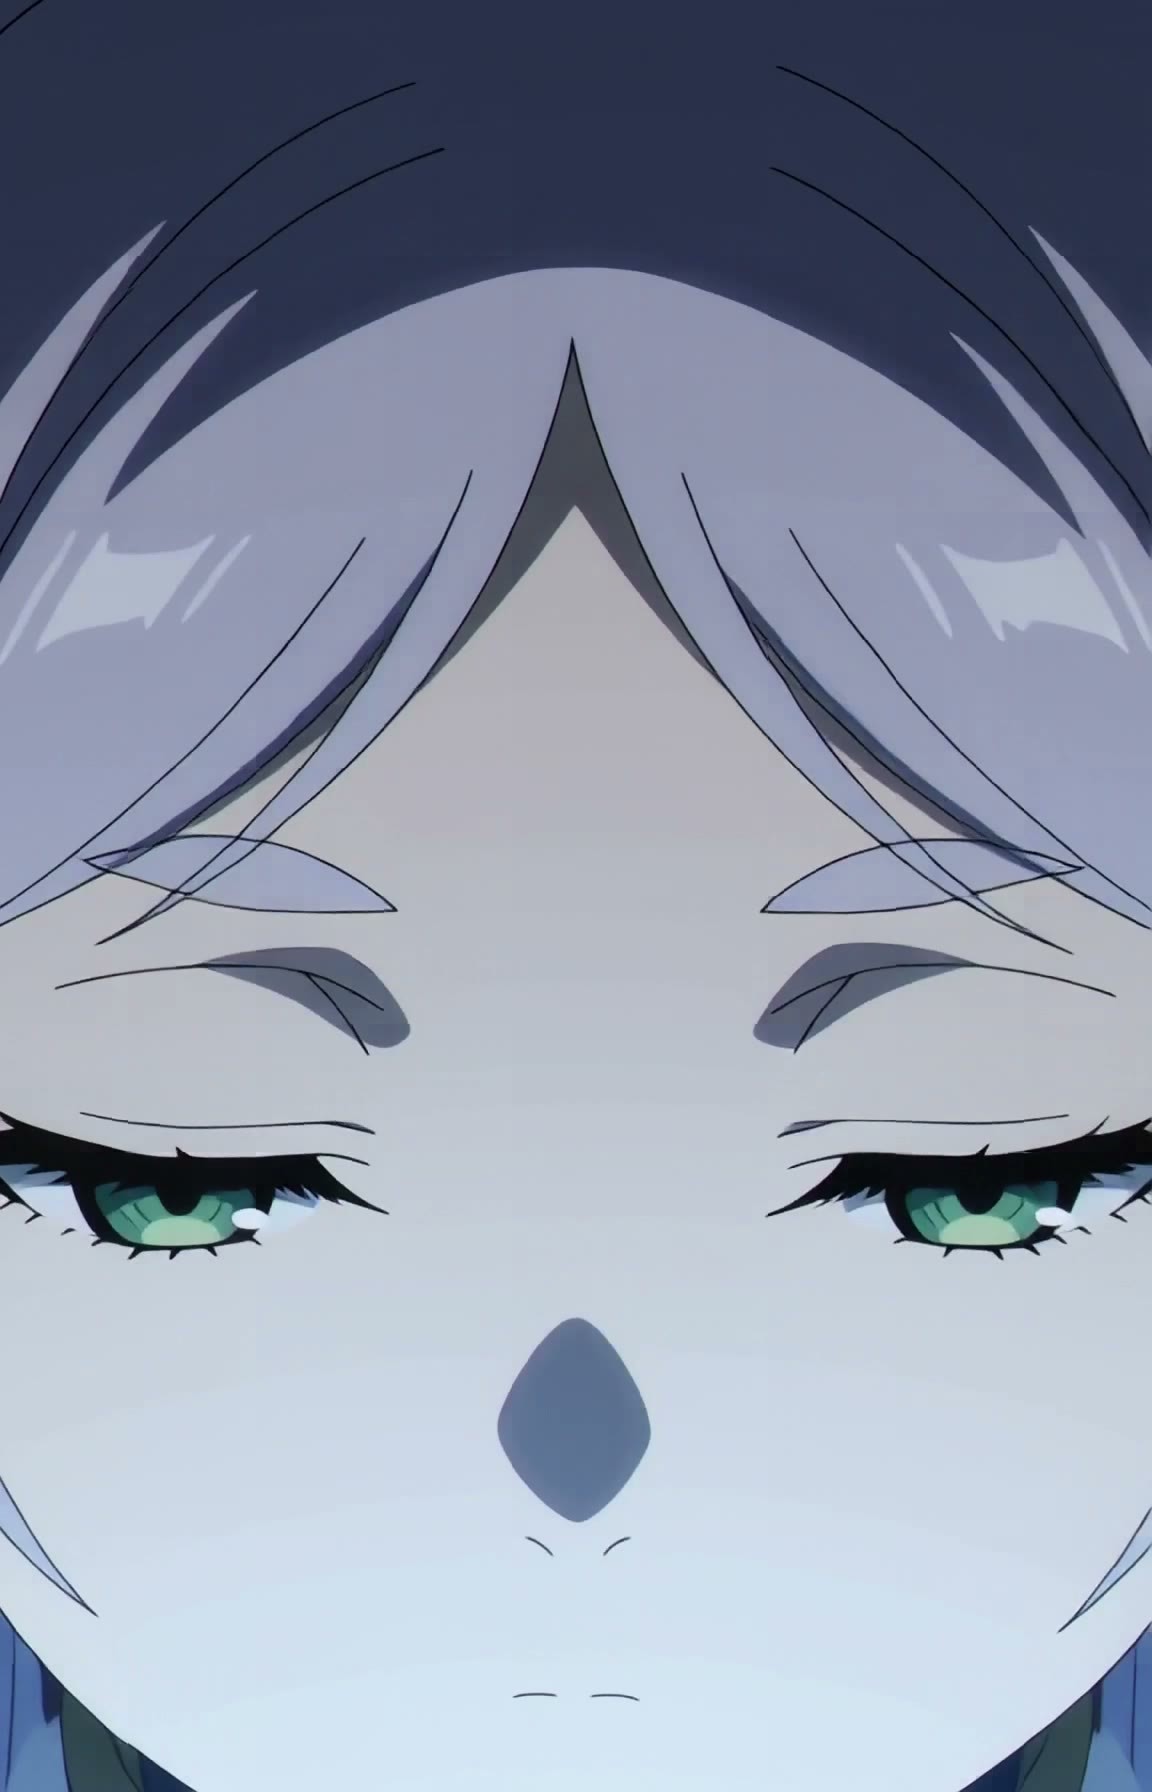
추천 이유
- 신규 모델; 프리렌 팬메이드 단편 영상, 애니메이션 스타일의 텍스트-투-비디오 / 이미지-투-비디오를 제작하면서 캐릭터가 말을 하는 장면을 원하는 창작자에게 적합합니다.
- 학습 데이터 명시: 오디오가 포함된 에피소드 클립 672개 + 스크린샷 721장. 작성자는 Hugging Face에 학습 보고서, 프롬프트 가이드라인, 그리고 27개 캐릭터의 캐릭터 설정 이미지와 음성 참조 파일을 게시했습니다.
- 3개의 학습 스텝 체크포인트를 제공합니다(3150 / 3900 / 4200 스텝). 메인 파일은 4200 스텝입니다. 공개된 예시 영상은 6개이며, 게시 후 약 16시간 만에 다운로드 수 259회, 좋아요 36개를 기록했습니다.
사용법
- 프롬프트 시작 부분에 트리거 워드 2d anime style, Frieren style,을 작성합니다.
- 작성자의 HF 페이지에서는 4200 스텝 체크포인트와 강도 1.0을 권장합니다. FL2VA 기반 모델로 학습되었으며, Ref2VA 기반 모델에서 캐릭터 설정 이미지를 참조 이미지로 사용하여 사용할 수도 있습니다.
- 특정 캐릭터를 안정적으로 재현하려면 작성자의 조언에 따라 HF 페이지의 캐릭터 참조 이미지와 음성 참조 파일을 함께 사용하십시오.
리스크 및 제한 사항
- 정품 애니메이션 화면과 캐릭터 더빙으로 학습되었습니다(작성자는 HF 페이지에서 저작권을 소유하지 않으며 학습 목적이라고 밝힘). 공개하거나 상업적으로 사용하기 전에 권리를 확인하십시오.
- 스텝 수, CFG, 샘플러는 Civitai 페이지에 명시되어 있지 않으므로 HF 가이드를 참조해야 합니다. 6개의 예시가 숨겨져 있습니다.
트리거 워드: 2d anime style, Frieren style
주목할 만한 항목 (9)
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT8
베이스 모델 / 체크포인트 · 신규 모델 · 작성자 tsolful · 게시일 11-11 07:17 · 다운로드 수 67
H3 Image 베이스 모델의 INT8 ConvRot(W8A8) 양자화 버전으로, 용량은 19.54GB입니다. 작성자는 세 가지 양자화 옵션 중 기본 선택지로 추천합니다.
예시 이미지
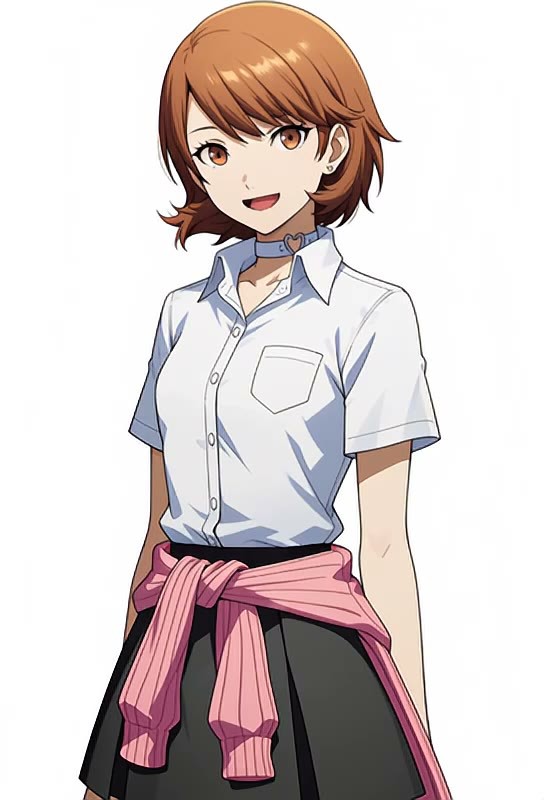
【B】타케바 유카리 목소리 - 페르소나 3 - 오디오 전용 [Minimax H3] · Minimax H3 v1.0
LoRA · 신규 모델 · 작성자 OneMoreLurker · 게시일 11-11 12:04 · 다운로드 수 20
순수 오디오 캐릭터 음성 LoRA: 『페르소나 3 리로드』의 타케바 유카리 일본어 음성을 학습하여 H3가 해당 캐릭터의 목소리로 대사를 생성하도록 합니다.
예시 이미지
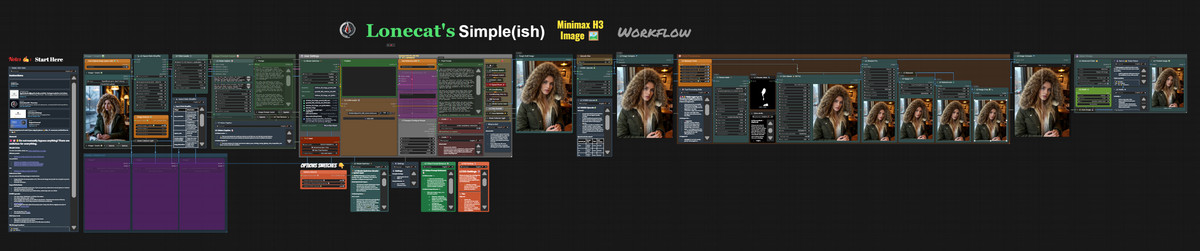
【B】Lonecat의 간단한 속도 부스트 🚀 워크플로우 | 简易加速工作流 (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple Minimax Image 🖼️
워크플로우 · 버전 업데이트 · 작성자 lonecatone23 · 게시일 11-11 11:45 · 다운로드 수 10
Lonecat의 간단한 워크플로우 모음에 새로 추가된 H3 Image 버전(Simple Minimax Image)입니다: 주석이 달린 H3 Image 참조 이미지 생성 워크플로우로, 작성자가 피부 질감을 개선하기 위해 skin master 노드를 추가했습니다.
예시 이미지
【B】MInimax H3 Studio, NVIDIA 전용 픽셀 업스케일 최적화 · v3.0
워크플로우 · 버전 업데이트 · 작성자 hRUSTIN474 · 게시일 11-11 04:50 · 다운로드 수 57
H3 Studio 영상 워크플로우 v3.0: 텍스트-투-비디오 / 이미지-투-비디오 / 참조 이미지-투-비디오 세 가지 분기와 자동 프롬프트 작성 기능을 포함하며, 여러 장면의 연속성을 유지하고 최종 출력 후 NVIDIA 전용 업스케일링 및 HDR 후처리를 수행합니다.
예시 이미지
【B】MiniMaxH3 립싱크 / TLF2VA · Nova.3
워크플로우 · 버전 업데이트 · 작성자 Rvage · 게시일 11-11 00:44 · 다운로드 수 50
H3 립싱크 / 다중 장면 영상 워크플로우 Nova.3: 캐릭터 이미지와 기존 녹음 파일을 사용하여 노래하거나 말하는 립싱크 영상을 만들거나, 네이티브 H3 텍스트-투-비디오 / 이미지-투-비디오 / 첫 및 마지막 프레임 방식을 사용합니다. 장면을 나누어 렌더링하며 중단 후 재개하거나 특정 장면부터 다시 생성할 수 있습니다.
예시 이미지
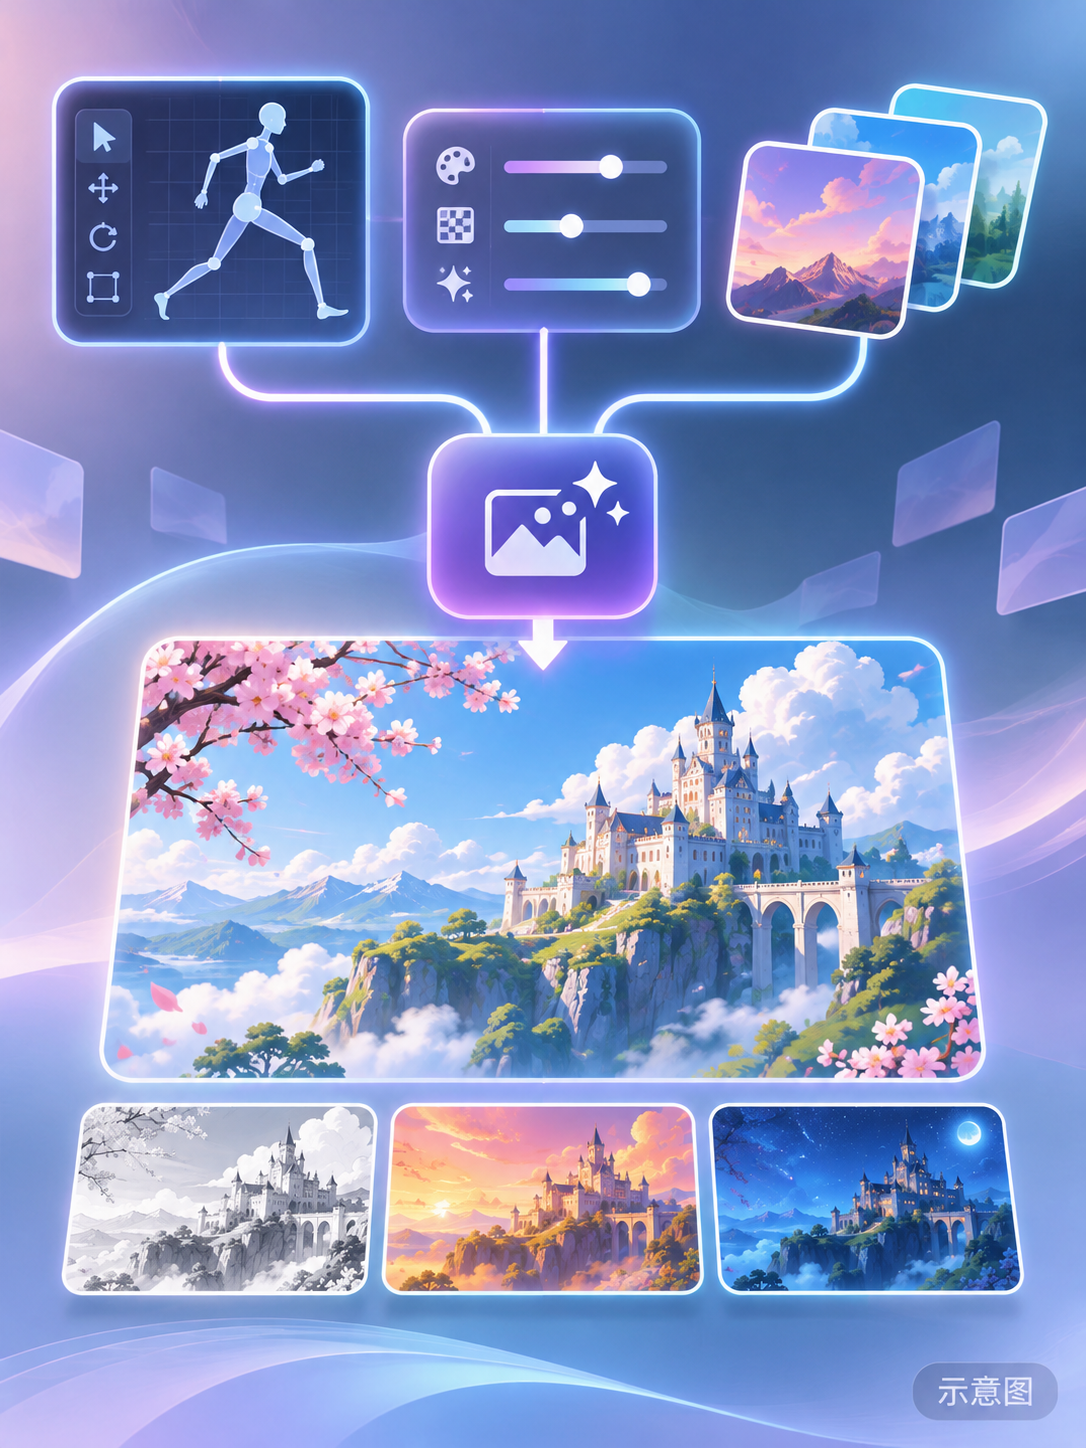
【B】H3 Image w/ 포즈 스튜디오 + 기타 고급 기능 [FoxFurEssence] · v1.0
워크플로우 · 신규 모델 · 작성자 foxydits · 게시일 11-11 08:56 · 다운로드 수 159
H3 Image 다기능 워크플로우: 텍스트-투-이미지 / 이미지-투-이미지 / 최대 9장의 참조 이미지를 활용한 생성을 지원하며, 내장된 포즈 스튜디오(Pose Studio)를 통해 자세를 지정할 수 있고(켜고 끄기 가능), 영상에서 프레임을 추출해 참조 이미지로 사용할 수도 있습니다.
예시 이미지
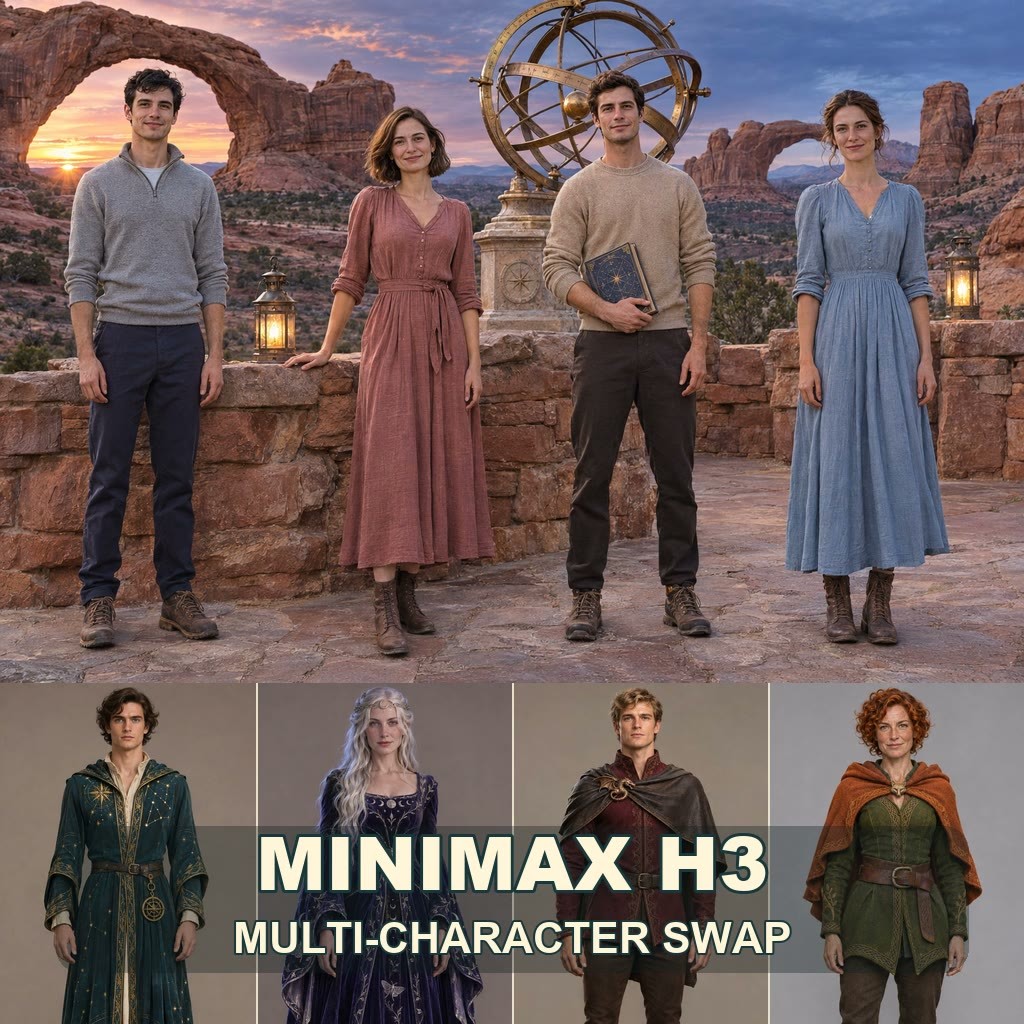
【B】MiniMax H3 이미지 내 다중 캐릭터 교체 | ComfyUI · v1.0
워크플로우 · 신규 모델 · 작성자 BearGhasemian · 게시일 11-11 11:04 · 다운로드 수 7
H3 영상 모델의 참조 이미지 노드를 사용하여 단일 정지 프레임에서 캐릭터를 교체하는 워크플로우입니다: 각 캐릭터마다 참조 이미지를 하나씩 제공하여, 한 장의 이미지 안에 있는 1~4명의 사람을 지정된 캐릭터로 바꿉니다.
예시 이미지
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT6
베이스 모델 / 체크포인트 · 버전 업데이트 · 작성자 tsolful · 게시일 11-11 07:30 · 다운로드 수 7
동일 페이지의 H3 Image INT6(W6A8) 양자화 버전으로, 용량은 15.61GB입니다. INT8과 INT4 사이의 성능을 가지며, Comfy 공식 저장소에는 이 단계가 없습니다.
예시 이미지
【B】MiniMax H3 60초 연속 영상 워크플로우, 12GB GPU용 @ 생성 시간 35분 · v1.2
워크플로우 · 신규 모델 · 작성자 vortis23 · 게시일 11-11 12:46 · 다운로드 수 3
12GB 그래픽 카드에서 실행 가능한 H3 장편 영상 워크플로우 v1.2: H3 Motion Director 노드를 사용하여 타임라인에 따라 분할하며, 작성자는 약 35분 만에 최대 1분 길이의 연속 추적 촬영 영상을 생성할 수 있다고 주장합니다.
예시 이미지
참고용만 수록 (9)
- (얼굴 녹는 현상 방지) MiniMax H3-Image 기본 워크플로 · 기본 워크플로 — 워크플로: '얼굴 녹는 현상 방지'라는 이름의 H3 Image 기본 이미지 생성 워크플로이며, 모델 페이지 설명에는 마침표 하나만 있습니다.
- Aliyah Belwyn · MiniMaxH3 — LoRA: 저자의 오리지널 가상 캐릭터인 Aliyah Belwyn(브뤼헤의 하프 연주자)을 위한 캐릭터 LoRA로, Anima / ZImageTurbo 버전에서 H3으로 이식되었습니다.
- Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT4 — 기본 모델 / 체크포인트: 동일 페이지의 H3 Image INT4(W4A8 GPTQ) 양자화 버전으로, 용량은 12.77 GB이며 세 가지 옵션 중 가장 작고 VRAM만 절약되며 속도는 빨라지지 않습니다.
- MiniMax-H3-Image · v1.0 — 워크플로: MiniMax-H3-Image라는 이름의 이미지 생성 워크플로이며, 설명에는 제목과 'v1'만 포함되어 있습니다.
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — 워크플로: Qwen 2.1의 이미지 생성 워크플로를 H3 Image용으로 수정한 간단한 워크플로이며, 이름에는 더 빠른 프롬프트 업샘플러가 포함됨이 명시되어 있습니다.
- Esmae Belwyn · MiniMaxH3 — LoRA: 저자의 오리지널 가상 캐릭터인 Esmae Belwyn(브뤼헤 운하가의 플로리스트)을 위한 캐릭터 LoRA로, MOSS Image 버전에서 H3으로 이식되었습니다.
- Faye Belwyn · MiniMaxH3 — LoRA: 저자의 오리지널 가상 캐릭터인 Faye Belwyn(브뤼헤의 고직물 복원사)을 위한 캐릭터 LoRA로, Krea 2 / ZImageTurbo / MOSS Image 버전에서 H3으로 이식되었습니다.
- Anaya Von Vergin · MiniMaxH3 — LoRA: 저자의 오리지널 가상 캐릭터인 Anaya Von Vergin(옥스퍼드 출신의 박물관 큐레이터)을 위한 캐릭터 LoRA로, SDXL, Flux, Anima, MOSS Image 등 여러 버전에서 H3으로 이식되었습니다.
- Ruth Belwyn · MiniMaxH3 — LoRA: 저자의 오리지널 가상 캐릭터인 Ruth Belwyn(브뤼헤의 제본사)을 위한 캐릭터 LoRA로, Krea 2 버전과 동시에 등록된 H3 버전입니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-10 20:31 → 11-11 13:03(베이징 시간). 추천 이유는 편집자 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.