贞贞的AI雷达 · MiniMax H3 · 2026-11-11 晨报
本期 23 个新版本:强烈推荐 2 · 推荐 3 · 可关注 9 · 仅收录 9
编辑按语 本期审阅 23 个 H3 新版本,2 个 S、3 个 A、9 个 B、9 个 C。首推 AusBoss 的 H3 Image 文生图 + 改图工作流:一句话出 16 MP 图或用大白话改图,可再接七张参考图,Fast 档用 pDMD 把 6 步降到 2 步;注意本期约一半条目是 11-10 进 ComfyUI 的 H3 图像版,只出图不出视频。视频方面同列 S 的是“朋友手机随手拍”风格 LoRA Friend’s POV,智能眼镜第一人称 LoRA 和《葬送的芙莉莲》画风 LoRA 列 A。H3 Image 量化包里说明不清的 INT8 / INT4 降为 B / C,配音声线 LoRA 因版权问题降为 B,MisterMR 批量移植的 5 个原创角色 LoRA 缺触发词和示例,列 C。
强烈推荐(2)
【S】MiniMax H3 Image Generate + Edit | 16 MP, 8 Pictures · v1.0
工作流 · 新模型 · 作者 AusBoss · 发布 11-11 08:31 · 下载 140
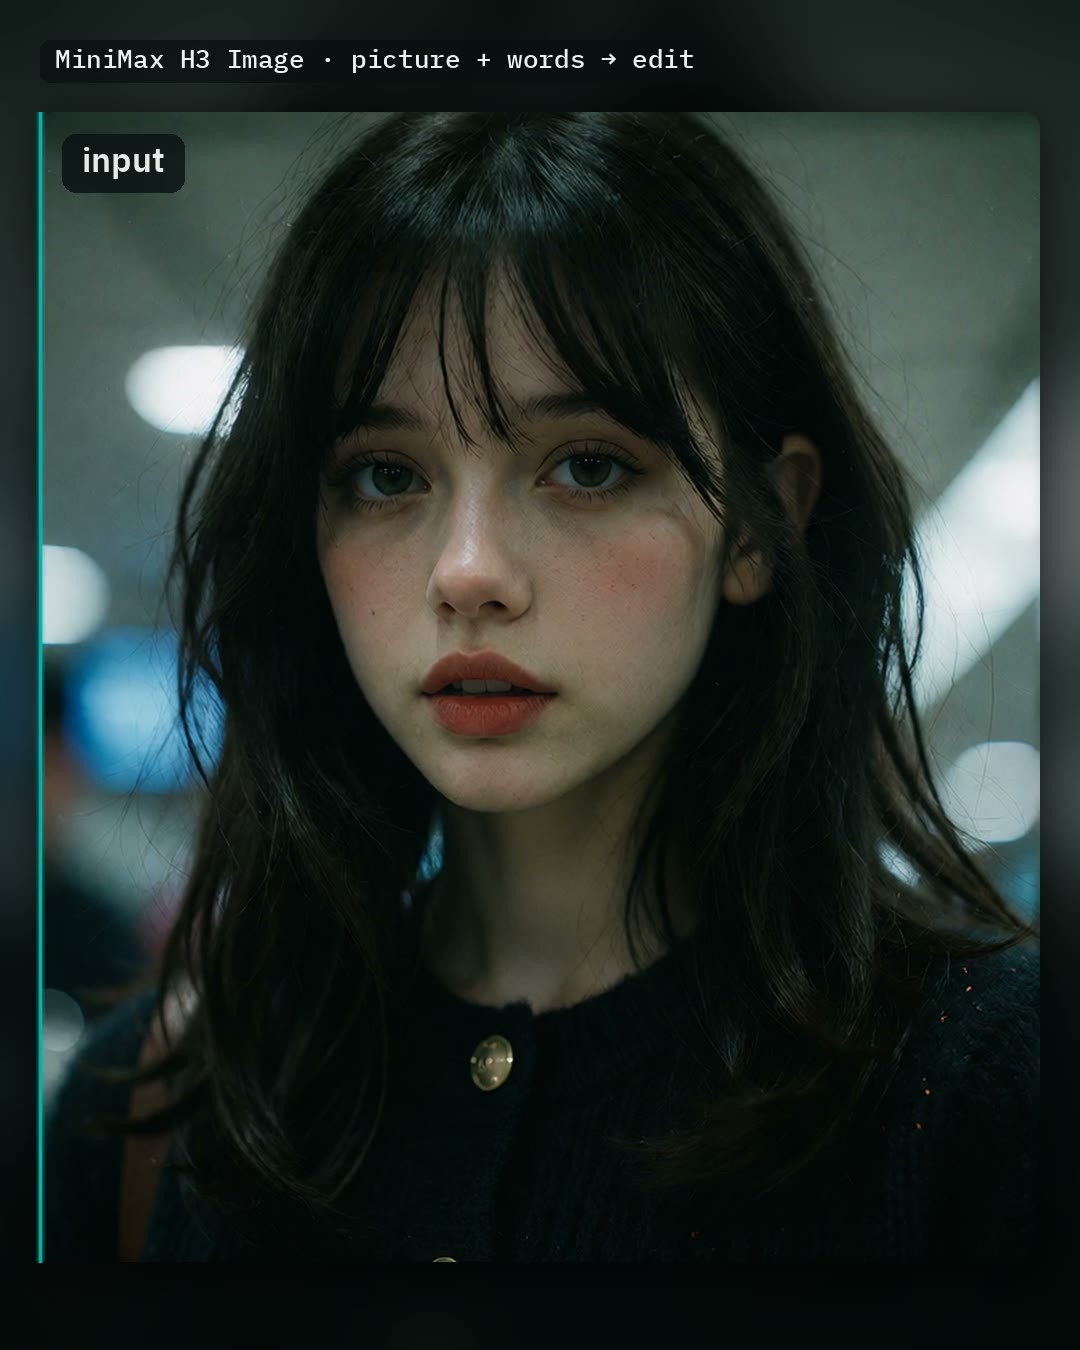
MiniMax H3 Image(H3 的图像版)的 ComfyUI 文生图 + 改图工作流:一句话生成 16 MP 图片,或用大白话改图,改图时可再接最多七张参考图并指定从每张取什么。
H3 Image 上线后第一份把生成、改图、多图参考和放大串在一起、还标了测试版本号的工作流,适合作为 H3 Image 的起步模板。
配图
推荐理由
- 新模型(工作流,不是新权重);服务 H3 Image 的文生图、指令改图和多图参考合成,例如“把图 2 的夹克穿到图 1 的人身上”
- 作者写明测试环境(ComfyUI master 分支 commit ede4e5f + AusBoss nodes 2.22.0,两档显存都跑过),并逐个列出所需模型文件、放置目录和大小:High VRAM 用 int8 ConvRot 底模(21.0 GB),Low VRAM 用 w4a8(12.5 GB),共用 Qwen3-VL 32B nvfp4 文本编码器和 H3 Image VAE
- 开关齐全:Auto prompt 用小模型把几个词扩写成长描述;Size 在 4 MP / 16 MP 间切换;Fast 用 pDMD 2 步 LoRA 把 6 步降到 2 步;可选 SeedVR2 把 4 MP 结果放大两倍
- 作者称 RTX 5090 上新出一张 16 MP 约 22 秒、16 MP 改图约 35 秒;1 段视频 + 6 张可见示例图
怎么用
- 先把 ComfyUI 更新到 0.44.0 之后的版本、AusBoss nodes 更新到 2.22.0,拖入工作流直接 Run,默认带一条完整提示词
- 自己出图:写完整长描述,或打开 Auto prompt 只写几个词;改图:打开 Edit a picture,载入图片写改动(如“Make it snow.”);参考图从 picture 2 依次接到 picture 8,并在提示词里点名“picture 2”
- 要出现在画面里的文字放进引号;提示词已经很完整时关掉 Auto prompt(作者称改写开场提示词时手部会乱);做海报、封面时不要开 Fast
风险与限制
- 依赖 H3 Image 新支持(11-10 才进 ComfyUI)和 AusBoss 自家节点,旧版 ComfyUI 跑不了;全套模型(底模 + 32B 文本编码器 + 可选扩写模型、加速 LoRA、SeedVR2)下载量很大
- MiniMax-H3-Image 社区许可:按 Comfy 量化作者转述,不覆盖欧盟、英国、韩国、美国,产出不得用于改进其他 AI 模型,年收入超过 100 万美元或做托管服务需另行授权
- 这是 H3 的图像模型,不出视频;耗时数字为作者称
【S】Friend's POV - MiniMax H3 · H3 V1
LoRA · 新模型 · 作者 AriaMaiven · 发布 11-11 09:15 · 下载 86
“朋友用手机随手拍”的视频风格 LoRA:构图偏宽、主体被挤到画面边上、手机平光、拍的人一笑画面就跟着晃。
和同作者的 Smart Glasses POV 是一套“素人拍摄视角”系列,参数写法一致。
配图
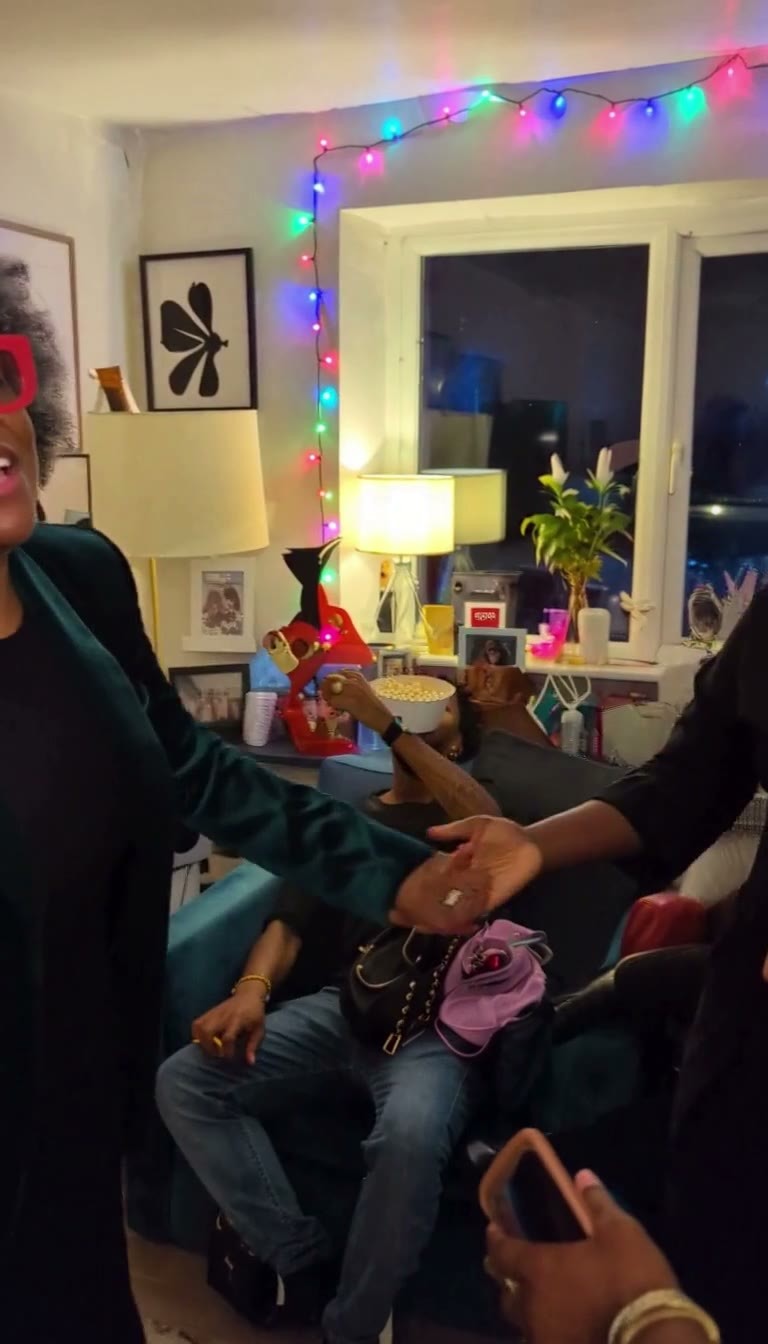
推荐理由
- 新模型;服务派对、夜街、超市过道这类有人物的近景生活视频,要的是“朋友手机里的视频”而不是电影感
- 作者给了完整用法:触发词 celsint,近景人脸用强度 0.65(脸稳、手机感保留),人远、背对或不在画面里可加到 0.8(风格更强,但近脸会走样)
- 提示词写法讲得具体:风格放在 H3 提示词第一句;不要写手机、手持、抖动、曝光、颗粒,这些由触发词负责;改为描述“拍的朋友在做什么”(跑在后面、被拽手腕、被客人撞到),晃动会更像真的
- 作者测试配置:MiniMax H3 FL2VA pruned int8 ConvRot 文生视频,20 步、res_multistep + simple、768x1344、5 秒;2 段可见示例视频
怎么用
- 触发词 celsint;强度 0.65(近景人脸)~0.8(远景或无脸);提示词第一句写 [Shot 1] Live-action in the celsint style, a medium shot at chest height...
- 单独使用,不要叠其他人体或动作 LoRA;作者测试为文生视频 20 步、res_multistep、simple、768x1344
风险与限制
- 可用于商用但需注明风格出处;转载或用其产出训练其他模型须先获作者许可
- 1 个示例被隐藏;只测了文生视频,图生视频 / Ref2VA 下的表现作者未说明
触发词:celsint
推荐(3)
【A】Minimax H3 Image Quants - comfy-native - fp8_scaled / nvfp4 / GGUF Q6 / Q4 / Q3 / Q2_mix · v1.0
底模 / Checkpoint · 新模型 · 作者 Thasmodius · 发布 11-11 07:19 · 下载 47
H3 Image 底模的补充精度包:Comfy 官方仓库没有的 fp8 scaled、NVFP4 和 GGUF Q6_K / Q4_K / Q3_K / Q2_K 混合量化,只含扩散模型。
配图
推荐理由
- 新模型(量化权重);服务想在 RTX 40 / 50 或任意显卡上跑 H3 Image 文生图、改图但显存不够放官方 bf16 的用户
- 各档用途写清:fp8 scaled 21.0 GB 给 RTX 40 / 50;NVFP4 12.5 GB 只在 RTX 50 原生跑、最快(作者称 RTX PRO 6000 上 2048x2048 约 3.4 steps/s,fp8 约 2.1 steps/s);GGUF Q6_K 17.5 GB、Q4_K 12.5 GB、Q3_K 10.0 GB 任意显卡;Q2_K mix 9.25 GB 为实验档,作者称画面明显变软
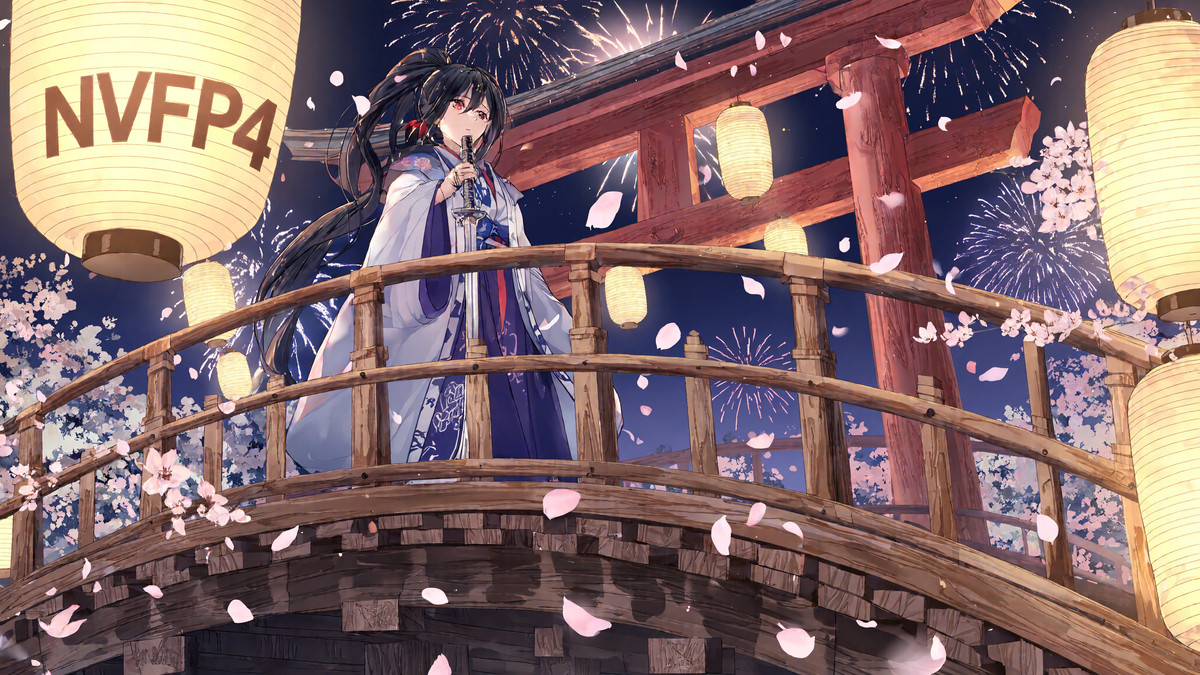
- 作者说明量化范围与 Comfy 官方 int8 / w4a8 相同(同样 200 个 transformer 层,占权重 95.8%),其余保持官方 bf16 不变,并给了 HF 上的对比页;8 张可见示例图
怎么用
- 需要 ComfyUI 0.44 或更新;打开 ComfyUI 自带的 “MiniMax H3 Image” 模板,在 Load Diffusion Model 里选文件;保持模板设置 6 步、euler、simple、cfg 1
- 文本编码器 qwen3vl_32b_minimax_h3_nvfp4_awq(或 int8 convrot)和 VAE 从 Comfy-Org 的 MiniMax-H3-Image 仓库取
- GGUF 要把加载节点换成 Unet Loader (GGUF),并先给 ComfyUI-GGUF 打补丁(运行作者给的 patch 脚本,或手动在 loader.py 的 IMG_ARCH_LIST 里加 "minimax_h3"),否则报 Unexpected architecture type
- 作者称模型在 4–20 MP 之间效果最好,低分辨率差,要用长而详细的英文提示词
风险与限制
- MiniMax-H3-Image 社区许可:作者原文写明授权不覆盖欧盟、英国、韩国、美国;模型及产出不得用于改进其他 AI 模型;年收入超过 100 万美元或做托管服务需先获 MiniMax 书面许可;商用产品须标注 MiniMax-H3-Image
- GGUF 依赖尚未合并进上游的补丁;2 个示例被隐藏;这是图像模型,不出视频
【A】Smart Glasses POV - MiniMax H3 · H3 V1
LoRA · 新模型 · 作者 AriaMaiven · 发布 11-11 09:15 · 下载 122
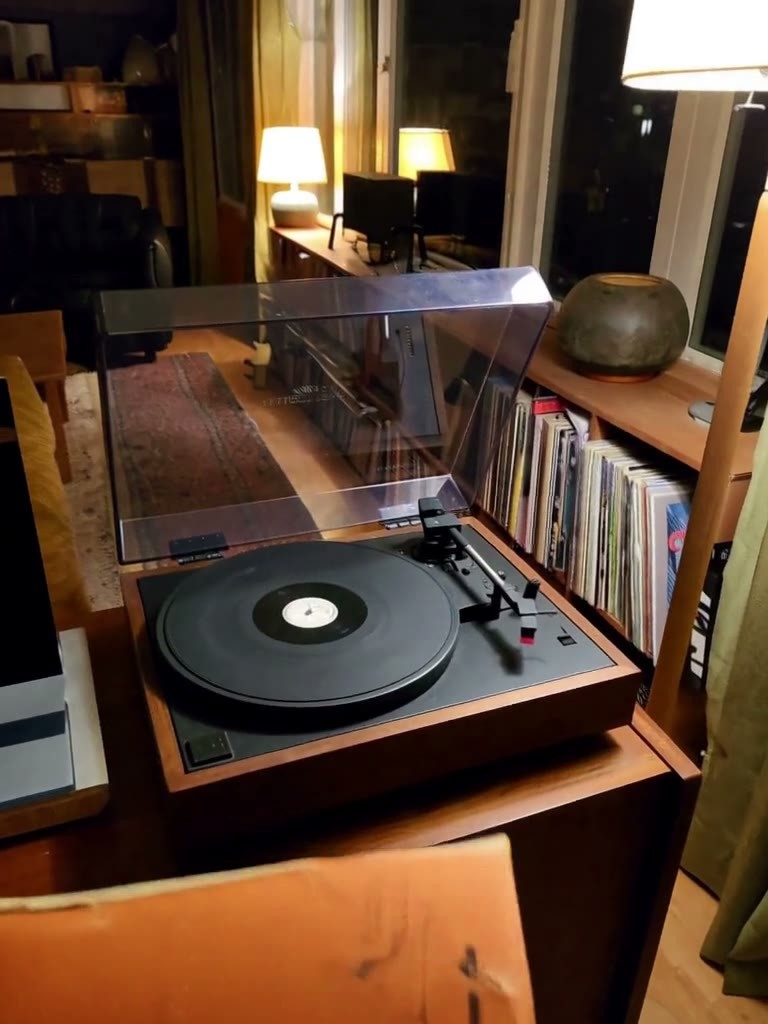
智能眼镜第一人称视频风格 LoRA:不变形的广角、跟着低头看手的头部晃动、佩戴者自己的双手从画面下方伸进来。
配图
推荐理由
- 新模型;服务做饭、骑车、从书架抽书、开门迎狗这类“从眼睛后面看”的日常第一人称视频
- 强度写得清楚:0.6 为推荐;0.8 风格更强但手不再听描述;1.0 过头
- 作者提醒每次都要把手写完整(肤色、戒指、手表、指甲、袖子,不要纹身就写 "no tattoos"),没写的部分 LoRA 会自己补;作者测试配置为 FL2VA pruned int8 ConvRot 文生视频,20 步、res_multistep + simple、768x1024、5 秒
怎么用
- 触发词 povsint,强度 0.6;提示词第一句写 [Shot 1] Live-action in the povsint style, an eye-level shot...
- 不要写 glasses、POV、first person、fisheye,由触发词负责;单独使用,不叠人体或动作 LoRA
风险与限制
- 作者自己说手有时会偏白一档,偶尔手腕上会冒出小纹身,发布前要检查
- 只有 1 段可见示例视频(4 个被隐藏);转载或用其产出训练其他模型须先获作者许可
触发词:povsint
【A】Frieren Anime H3 Style Lora · v1.0
LoRA · 新模型 · 作者 tazmannner379 · 发布 11-10 21:24 · 下载 259
《葬送的芙莉莲》动画风格视频 LoRA:复现该动画的画风,并带上部分角色声线和配乐。
配图
推荐理由
- 新模型;服务想做芙莉莲同人短片、动画风格文生视频 / 图生视频,且要角色开口说话的创作
- 训练数据写明:672 段带音频的剧集片段 + 721 张截图;作者在 Hugging Face 放了训练报告、提示词指南,以及 27 个角色的角色设定图和声音参考
- 提供 3 个训练步数的检查点(3150 / 3900 / 4200 步),主文件是 4200 步;6 段可见示例视频,发布约 16 小时 259 次下载、36 赞
怎么用
- 提示词开头写触发词 2d anime style, Frieren style,
- 作者 HF 页推荐 4200 步检查点、强度 1.0;用 FL2VA 底模训练,也可在 Ref2VA 底模上配角色设定图做参考图
- 要稳定还原某个角色,按作者建议搭配 HF 页的角色参考图和声音参考
风险与限制
- 用正版动画画面和角色配音训练(作者在 HF 页自称不拥有版权、仅供学习),公开或商用前确认权利
- 步数、CFG、采样器在 Civitai 页没写,要去 HF 看指南;6 个示例被隐藏
触发词:2d anime style、Frieren style
可关注(9)
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT8
底模 / Checkpoint · 新模型 · 作者 tsolful · 发布 11-11 07:17 · 下载 67
H3 Image 底模的 INT8 ConvRot(W8A8)量化版,19.54 GB,作者推荐作为三档量化里的默认选择。
配图
【B】Yukari Takeba Voice - Persona 3 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · 新模型 · 作者 OneMoreLurker · 发布 11-11 12:04 · 下载 20
纯音频角色配音 LoRA:用《女神异闻录 3 Reload》岳羽由加莉的日语语音训练,让 H3 生成这个角色声线的台词。
配图
【B】Lonecat’s Simple Speed Boost 🚀 Workflows | 简易加速工作流 (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple Minimax Image 🖼️
工作流 · 版本更新 · 作者 lonecatone23 · 发布 11-11 11:45 · 下载 10
Lonecat 简易工作流合集新增的 H3 Image 版(Simple Minimax Image):一份带注释的 H3 Image 参考出图工作流,作者加了 skin master 节点改善皮肤质感。
配图
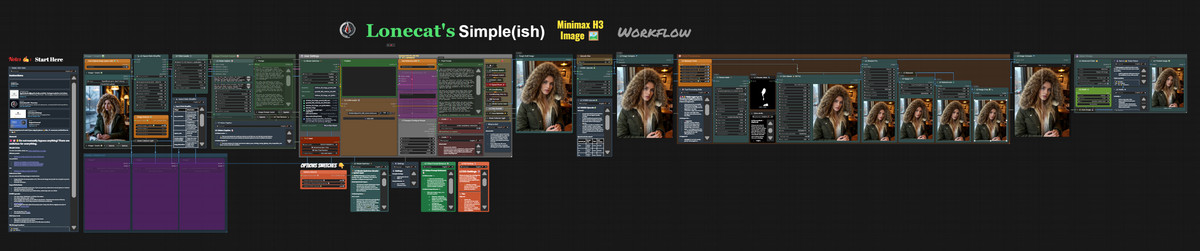
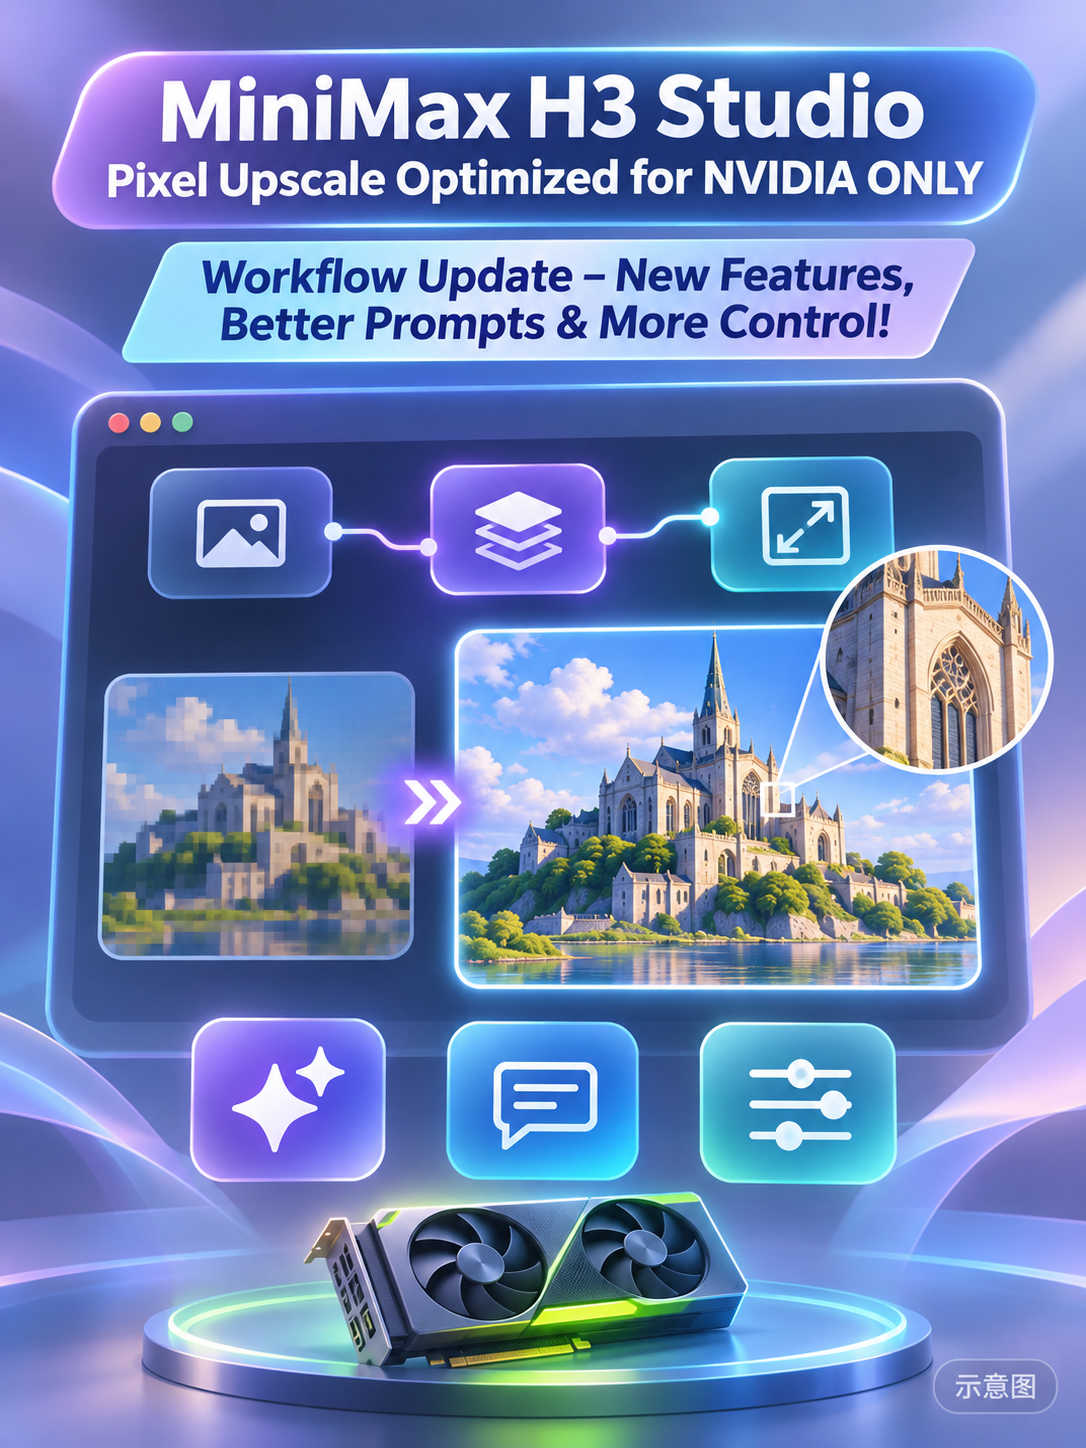
【B】MInimax H3 Studio, Pixel Upscale Optimized for NVIDIA ONLY · v3.0
工作流 · 版本更新 · 作者 hRUSTIN474 · 发布 11-11 04:50 · 下载 57
H3 Studio 视频工作流 v3.0:文生 / 图生 / 参考图生视频三条分支加自动写提示词,多场景续接,出片后走 NVIDIA 专用的超分和 HDR 后期。
配图
【B】MiniMaxH3 Lipsync / TLF2VA · Nova.3
工作流 · 版本更新 · 作者 Rvage · 发布 11-11 00:44 · 下载 50
H3 对口型 / 多场景视频工作流 Nova.3:用角色图 + 现成录音做唱歌、说话的对口型视频,或走原生 H3 文生 / 图生 / 首尾帧,按场景分段渲染,可中断续跑或从某段起重做。
配图
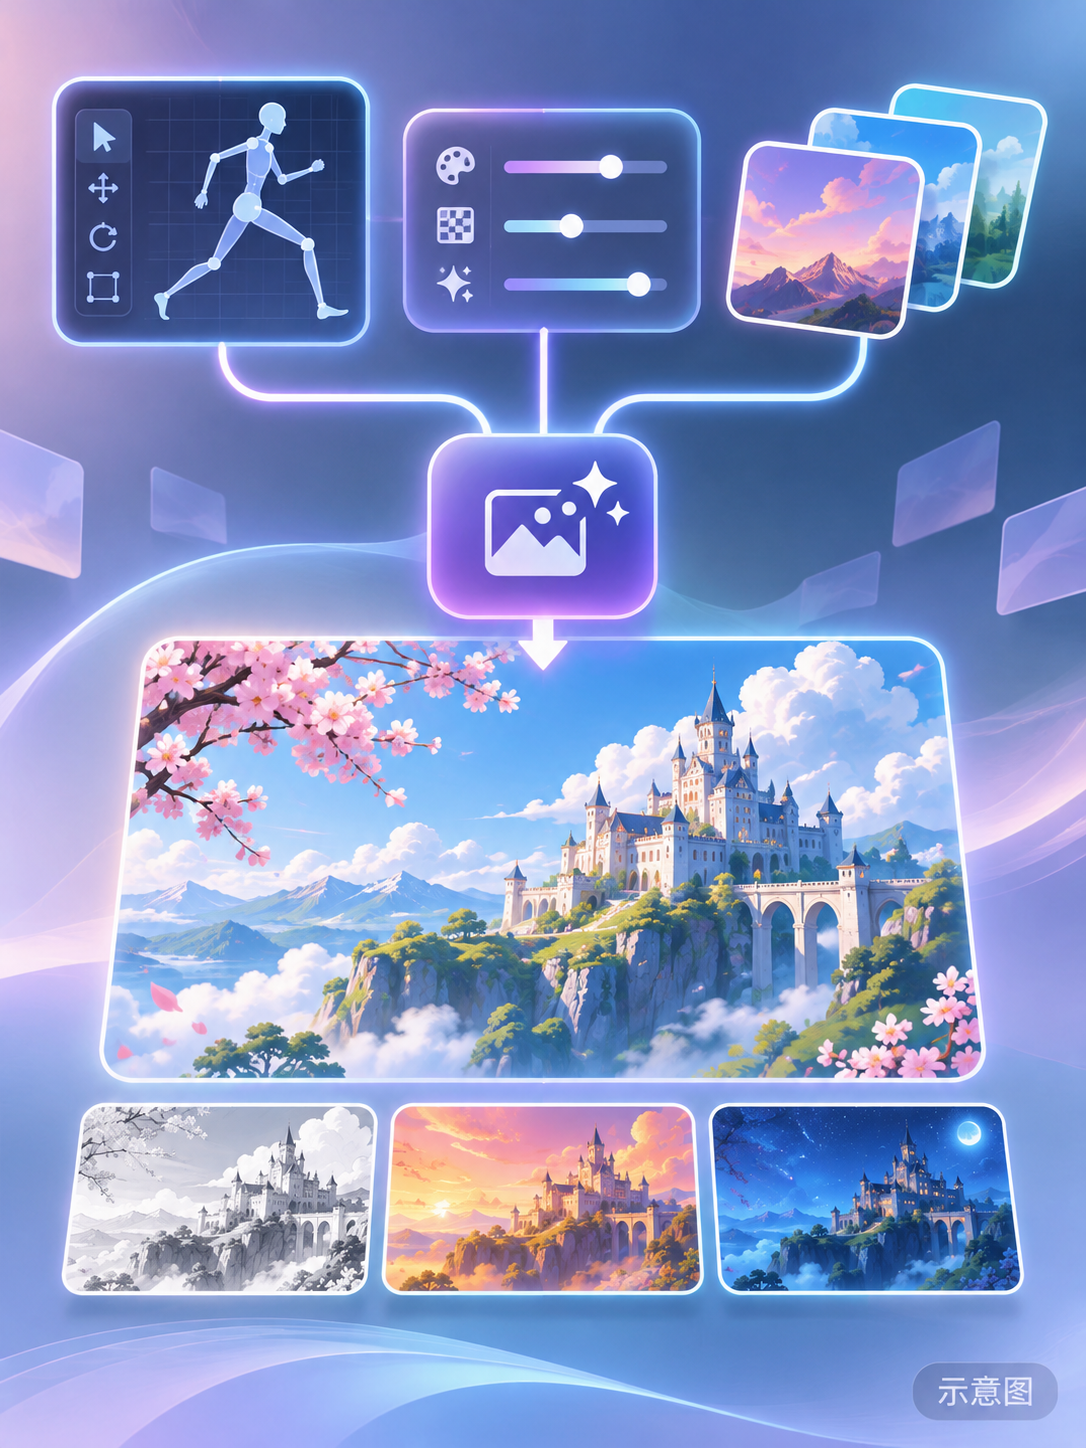
【B】H3 Image w/ Pose Studio + Other Advanced Features [FoxFurEssence] · v1.0
工作流 · 新模型 · 作者 foxydits · 发布 11-11 08:56 · 下载 159
H3 Image 多功能工作流:文生图 / 图生图 / 最多 9 张参考图生成,内置可开关的 Pose Studio 摆姿势,还能从视频里截一帧当参考图。
配图
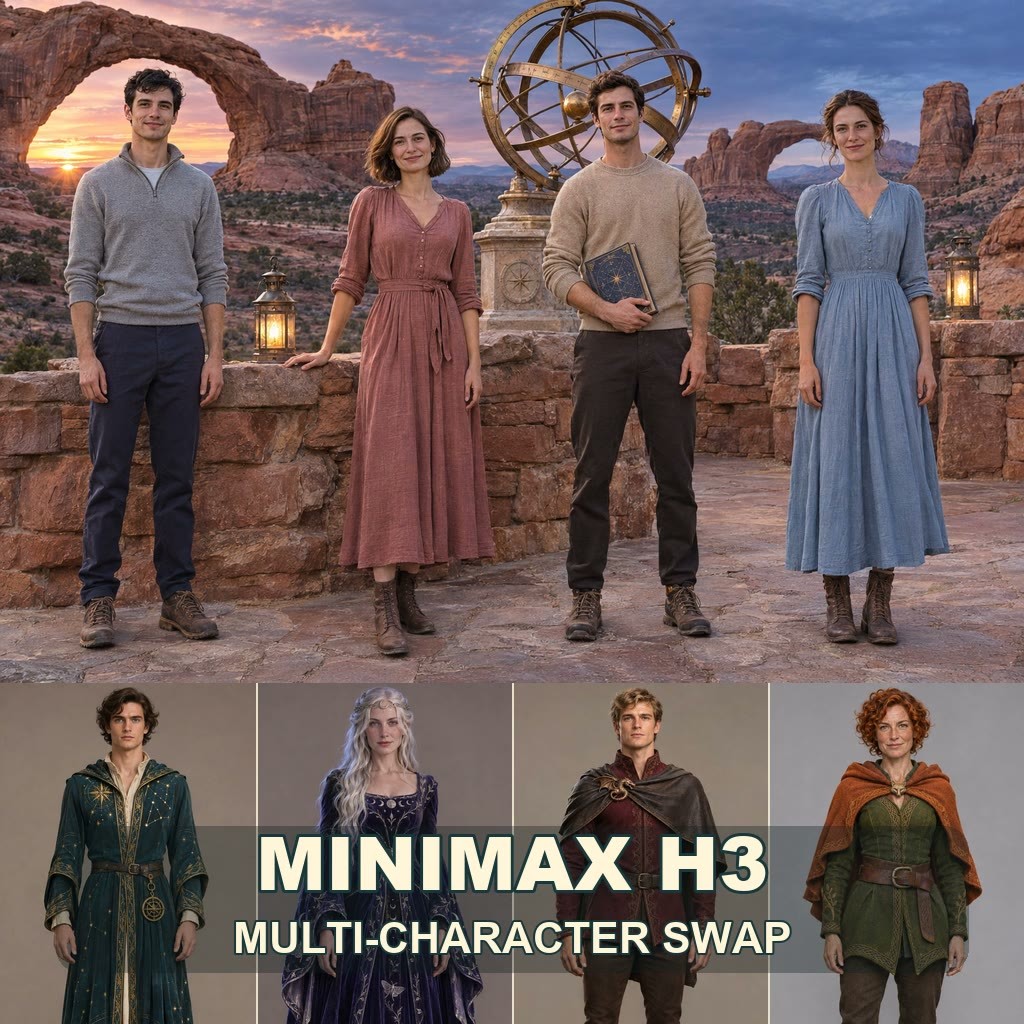
【B】MiniMax H3 Multi-Character Swap in Images | ComfyUI · v1.0
工作流 · 新模型 · 作者 BearGhasemian · 发布 11-11 11:04 · 下载 7
用 H3 视频模型的参考图节点做单帧静图的换人工作流:给每个角色一张参考图,把一张图里的 1–4 个人换成指定角色。
配图
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT6
底模 / Checkpoint · 版本更新 · 作者 tsolful · 发布 11-11 07:30 · 下载 7
同页的 H3 Image INT6(W6A8)量化版,15.61 GB,介于 INT8 和 INT4 之间,Comfy 官方仓库没有这一档。
配图
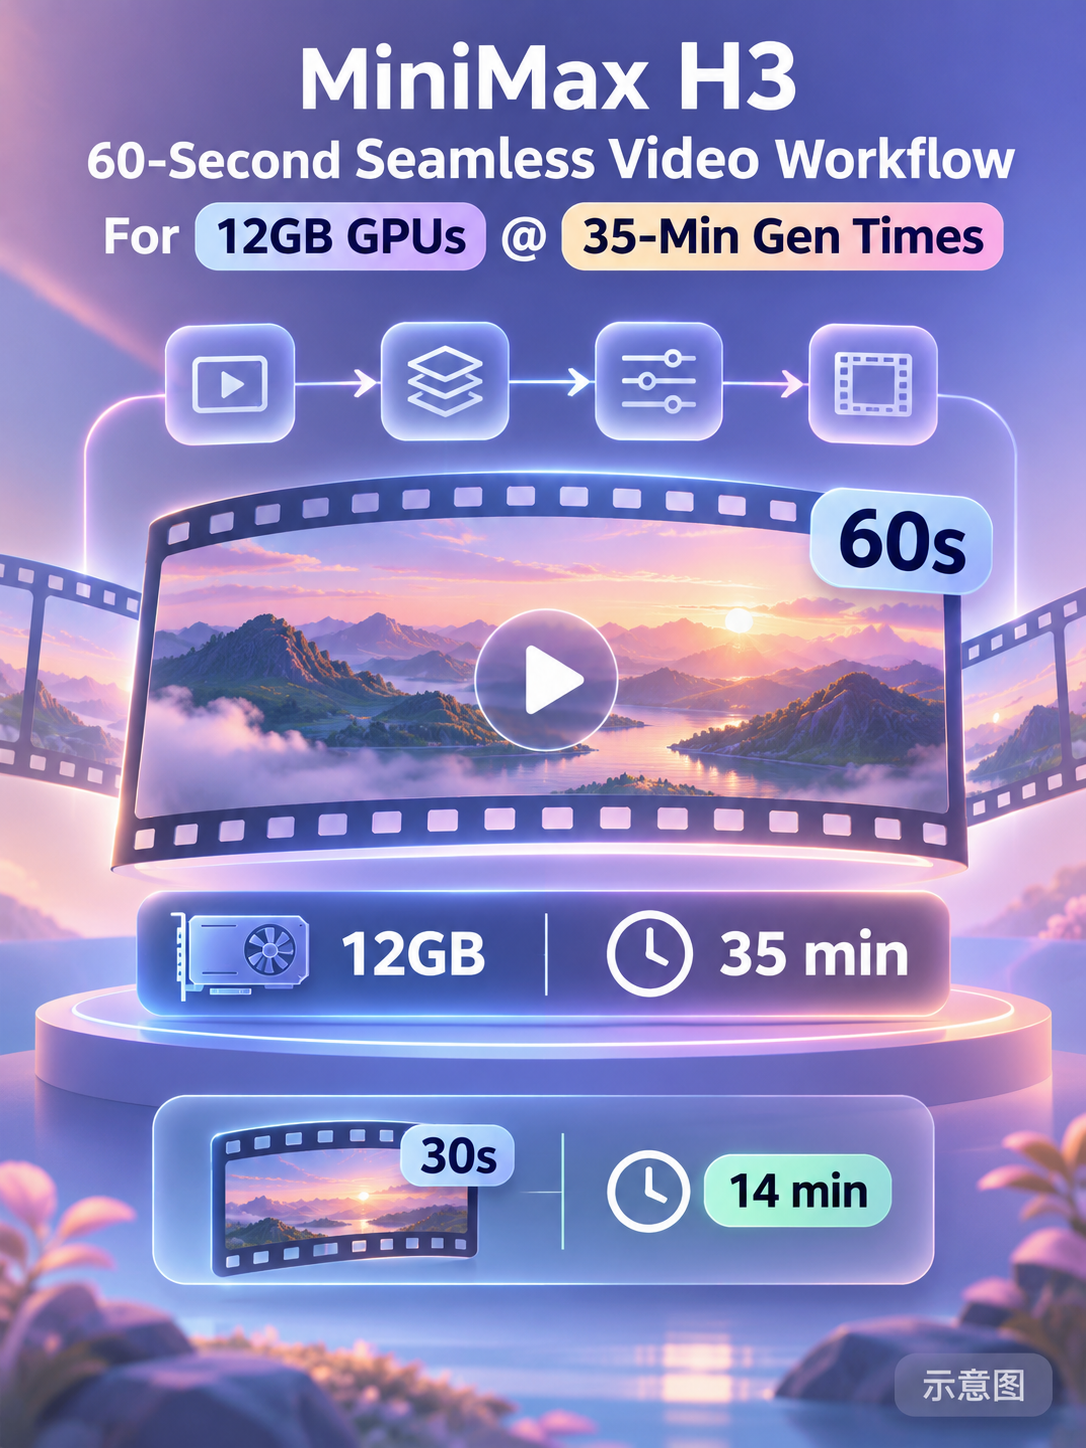
【B】MiniMax H3 60-Second Seamless Video Workflow For 12GB GPUs @ 35-Min Gen Times · v1.2
工作流 · 新模型 · 作者 vortis23 · 发布 11-11 12:46 · 下载 3
12GB 显卡可跑的 H3 长视频工作流 v1.2:借助 H3 Motion Director 节点按时间线分段,作者称约 35 分钟生成最长约一分钟的连续跟拍镜头。
配图
仅收录(9)
- (prevent melting faces)MiniMax H3-Image base workflow · base workflow — 工作流:名为“防止人脸融化”的 H3 Image 基础出图工作流,模型页说明只有一个句号。
- Aliyah Belwyn · MiniMaxH3 — LoRA:作者原创虚构角色 Aliyah Belwyn(布鲁日的竖琴演奏家)的角色 LoRA,从 Anima / ZImageTurbo 版移植到 H3。
- Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT4 — 底模 / Checkpoint:同页的 H3 Image INT4(W4A8 GPTQ)量化版,12.77 GB,三档里最小,只省显存不提速。
- MiniMax-H3-Image · v1.0 — 工作流:名为 MiniMax-H3-Image 的出图工作流,说明只有标题和“v1”。
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — 工作流:把 Qwen 2.1 的出图工作流改到 H3 Image 上用的简单工作流,名称称带更快的提示词扩写。
- Esmae Belwyn · MiniMaxH3 — LoRA:作者原创虚构角色 Esmae Belwyn(布鲁日运河边的花艺师)的角色 LoRA,从 MOSS Image 版移植到 H3。
- Faye Belwyn · MiniMaxH3 — LoRA:作者原创虚构角色 Faye Belwyn(布鲁日的古织物修复师)的角色 LoRA,从 Krea 2 / ZImageTurbo / MOSS Image 版移植到 H3。
- Anaya Von Vergin · MiniMaxH3 — LoRA:作者原创虚构角色 Anaya Von Vergin(牛津出身的博物馆策展人)的角色 LoRA,从 SDXL、Flux、Anima、MOSS Image 等多个版本移植到 H3。
- Ruth Belwyn · MiniMaxH3 — LoRA:作者原创虚构角色 Ruth Belwyn(布鲁日的装帧师)的角色 LoRA,与 Krea 2 版同时上架的 H3 版。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-10 20:31 → 11-11 13:03(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。