貞貞のAIレーダー · MiniMax H3 · 2026-11-11 朝刊
今号は 23 個の新バージョン:強く推奨 2 · 推奨 3 · 注目すべきもの 9 · 収録のみ 9
編集者によるコメント 今号では 23 個の H3 新バージョンをレビューし、S評価が 2 個、A評価が 3 個、B評価が 9 個、C評価が 9 個でした。初回特集は AusBoss の H3 Image テキスト生成画像 + 編集ワークフローです:一文で 16 MP の画像を生成したり、平易な言葉で画像を編集したりでき、さらに7枚の参考画像を追加できます。Fast モードでは pDMD を使用して 6 ステップを 2 ステップに短縮します。今号の約半数のエントリは 11-10 で ComfyUI に導入された H3 画像版であり、動画ではなく画像のみを出力する点にご注意ください。動画関連では、「友人のスマホで撮ったような」スタイルの LoRA Friend’s POV が S評価にランクインし、スマートグラスの一人称視点 LoRA と『葬送のフリーレン』画風 LoRA は A評価です。H3 Image の量子化パッケージにおいて説明が不明確な INT8 / INT4 は B / C に格下げされ、声優ボイス LoRA は著作権の問題で B に格下げされました。MisterMR が一括移植した 5 個のオリジナルキャラクター LoRA はトリガーワードとサンプルが欠けているため、C評価です。
強く推奨(2)
【S】MiniMax H3 Image Generate + Edit | 16 MP, 8 枚の画像 · v1.0
ワークフロー · 新モデル · 作者 AusBoss · 公開日 11-11 08:31 · ダウンロード数 140
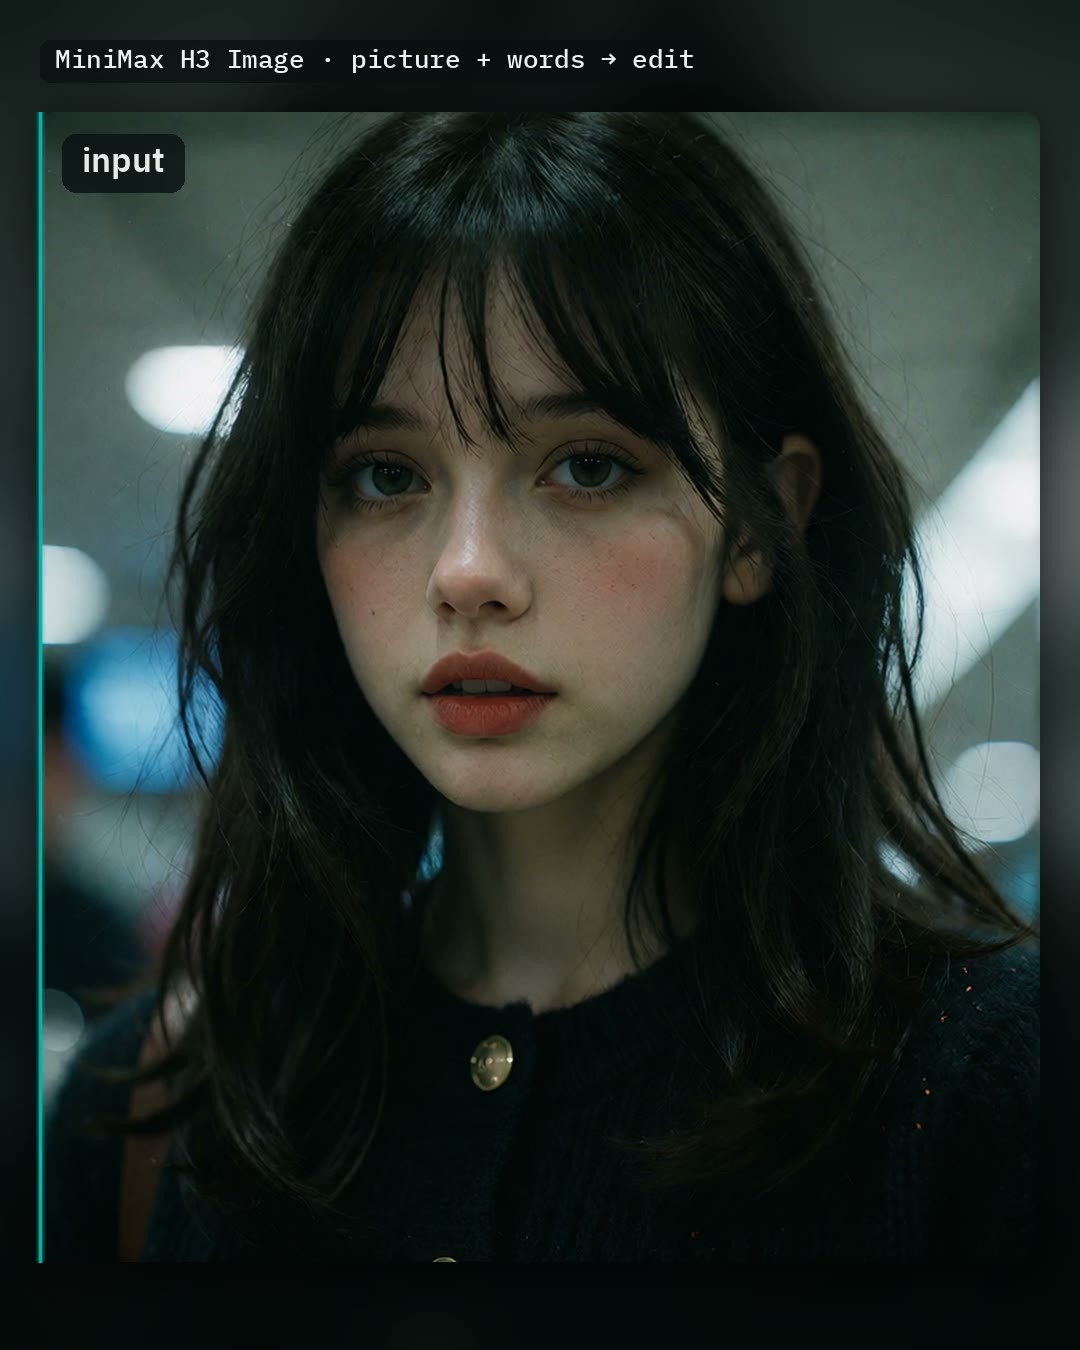
MiniMax H3 Image(H3 の画像版)の ComfyUI テキスト生成画像 + 編集ワークフロー:一文で 16 MP の画像を生成したり、平易な言葉で画像を編集したりでき、編集時には最大7枚の参考画像を追加し、各画像から何を抽出するかを指定できます。
H3 Image のリリース後、生成、編集、複数画像参照、アップスケールを統合し、テストバージョン番号まで明記した初のワークフローです。H3 Image の入門テンプレートとして最適です。
画像
推奨理由
- 新モデル(ワークフローであり、新しい重みではありません);H3 Image のテキスト生成画像、指示による画像編集、複数画像参照合成に対応しています。例えば「画像 2 のジャケットを画像 1 の人物に着せる」といった操作が可能です。
- 作者はテスト環境(ComfyUI master ブランチ commit ede4e5f + AusBoss nodes 2.22.0、両方のVRAM設定で動作確認済み)を明記し、必要なモデルファイル、配置ディレクトリ、サイズを一覧表示しています:High VRAM では int8 ConvRot ベースモデル(21.0 GB)、Low VRAM では w4a8(12.5 GB)を使用し、共通で Qwen3-VL 32B nvfp4 テキストエンコーダーと H3 Image VAE を使用します。
- スイッチが充実しています:Auto prompt は小規模モデルを使用して数語を長い説明に拡張します;Size は 4 MP / 16 MP 間で切り替えます;Fast は pDMD 2 ステップ LoRA を使用して 6 ステップを 2 ステップに短縮します;オプションの SeedVR2 を使用すると、4 MP の結果を2倍にアップスケールできます。
- 作者によると、RTX 5090 では新しい 16 MP 画像の生成に約 22 秒、16 MP 画像の編集に約 35 秒かかります;1 本の動画 + 6 枚の表示可能なサンプル画像があります。
使い方
- まず ComfyUI を 0.44.0 以降のバージョンに更新し、AusBoss nodes を 2.22.0 に更新します。ワークフローをドラッグして直接 Run すると、デフォルトで完全なプロンプトが含まれています。
- 自分で画像を生成する場合:完全な長い説明を書くか、Auto prompt を有効にして数語だけ入力します。編集する場合:Edit a picture を有効にし、画像を読み込んで変更内容(例:「Make it snow.」)を書きます。参考画像は picture 2 から picture 8 まで順に接続し、プロンプト内で「picture 2」と名指しします。
- 画面に表示されるテキストは引用符で囲みます。プロンプトがすでに完全な場合は Auto prompt をオフにします(作者によると、開始プロンプトを書き換えると手が乱れることがあります)。ポスターやカバーを作成する際は Fast を有効にしないでください。
リスクと制限
- H3 Image の新機能サポート(11-10 で ComfyUI に導入)と AusBoss 独自ノードに依存しているため、古いバージョンの ComfyUI では動作しません。フルセットのモデル(ベースモデル + 32B テキストエンコーダー + オプションのプロンプト拡張モデル、高速化 LoRA、SeedVR2)のダウンロードサイズは非常に大きいです。
- MiniMax-H3-Image コミュニティライセンス:Comfy 量子化作者の転述によると、EU、英国、韓国、米国には適用されず、出力を他の AI モデルの改善に使用することはできません。年間収入が 100 万ドルを超える場合やホスティングサービスを行う場合は別途許可が必要です。
- これは H3 の画像モデルであり、動画は生成しません。所要時間の数値は作者による報告です。
【S】Friend's POV - MiniMax H3 · H3 V1
LoRA · 新モデル · 作者 AriaMaiven · 公開日 11-11 09:15 · ダウンロード数 86
「友人がスマホで撮ったような」動画スタイルの LoRA:構図は広め、被写体は画面の端に押しやられ、スマホのフラットな光線、撮影者が笑うと画面も一緒に揺れます。
同じ作者の Smart Glasses POV とは「素人撮影視点」シリーズの一組で、パラメータの書き方は一致しています。
画像
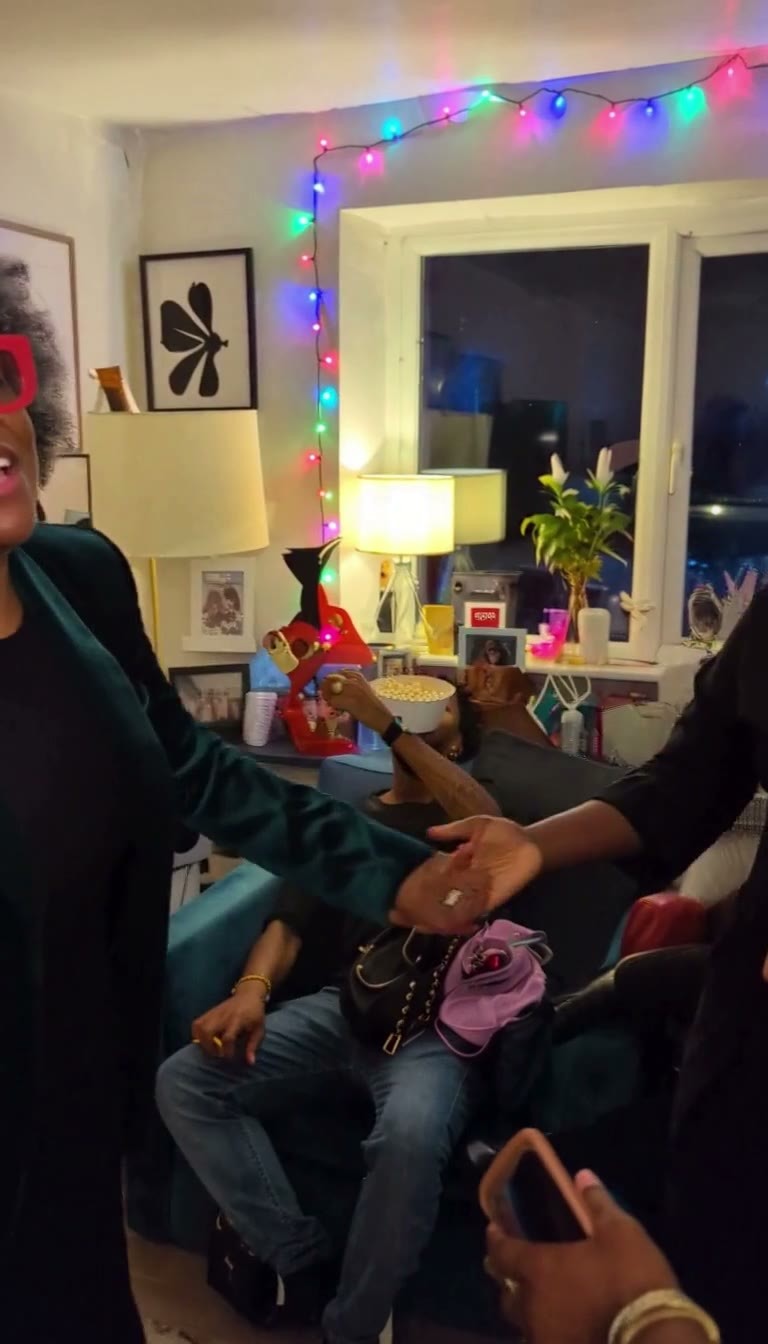
推奨理由
- 新モデル;パーティー、夜の街、スーパーの通路など、人物がいる近景の生活動画を対象としており、「友人のスマホにある動画」のような雰囲気を求めます(映画のような質感ではありません)。
- 作者は完全な使い方を提供しています:トリガーワード celsint、近景の顔には強度 0.65(顔が安定し、スマホ感が保持されます)、人物が遠い、背中を向けている、または画面外の場合は 0.8 に上げることができます(スタイルは強くなりますが、近景の顔は崩れる可能性があります)。
- プロンプトの書き方は具体的です:スタイルは H3 プロンプトの最初の文に置きます;スマホ、手持ち、揺れ、露出、粒子などは書かないでください。これらはトリガーワードが担当します。代わりに「撮影された友人が何をしているか」(後ろを走っている、手首を引かれている、客にぶつかられているなど)を記述すると、揺れがよりリアルになります。
- 作者のテスト設定:MiniMax H3 FL2VA pruned int8 ConvRot テキスト生成動画、20 ステップ、res_multistep + simple、768x1344、5 秒;2 本の表示可能なサンプル動画があります。
使い方
- トリガーワード celsint;強度 0.65(近景の顔)~0.8(遠景または顔なし);プロンプトの最初の文に [Shot 1] Live-action in the celsint style, a medium shot at chest height... と書きます。
- 単独で使用し、他の人体や動作 LoRA と重ねないでください。作者のテストではテキスト生成動画 20 ステップ、res_multistep、simple、768x1344 です。
リスクと制限
- 商用利用は可能ですが、スタイルの出典を明記する必要があります。転載やその出力を他のモデルの訓練に使用するには、事前に作者の許可が必要です。
- 1 個のサンプルは非表示です;テキスト生成動画のみテストされており、画像生成動画 / Ref2VA でのパフォーマンスについては作者から説明がありません。
トリガーワード:celsint
推奨(3)
【A】Minimax H3 Image Quants - comfy-native - fp8_scaled / nvfp4 / GGUF Q6 / Q4 / Q3 / Q2_mix · v1.0
ベースモデル / Checkpoint · 新モデル · 作者 Thasmodius · 公開日 11-11 07:19 · ダウンロード数 47
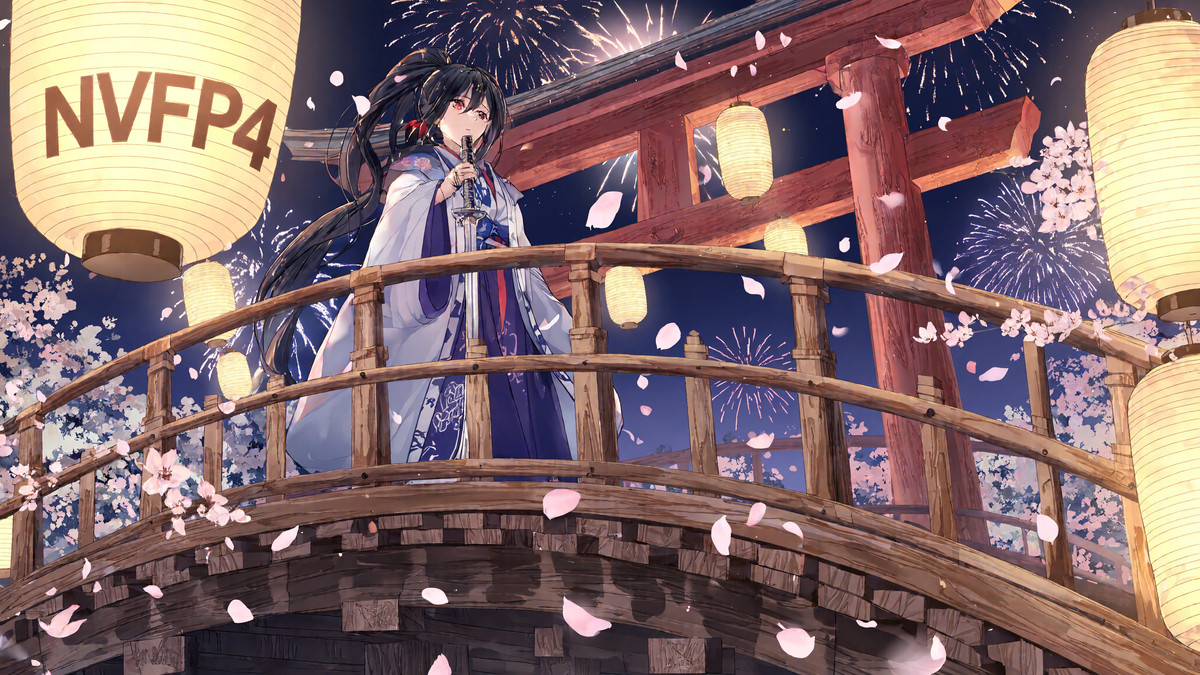
H3 Image ベースモデルの補足精度パッケージ:Comfy 公式リポジトリにはない fp8 scaled、NVFP4、および GGUF Q6_K / Q4_K / Q3_K / Q2_K 混合量子化を含み、拡散モデルのみが含まれます。
画像
推奨理由
- 新モデル(量子化重み);RTX 40 / 50 または任意の GPU で H3 Image のテキスト生成画像や編集を実行したいが、公式 bf16 を収める VRAM が不足しているユーザー向けです。
- 各段階の用途が明確に記述されています:fp8 scaled 21.0 GB は RTX 40 / 50 用;NVFP4 12.5 GB は RTX 50 でネイティブ実行のみ可能で最速(作者によると、RTX PRO 6000 では 2048x2048 で約 3.4 steps/s、fp8 では約 2.1 steps/s);GGUF Q6_K 17.5 GB、Q4_K 12.5 GB、Q3_K 10.0 GB は任意の GPU 用;Q2_K mix 9.25 GB は実験段階で、作者によると画質が明らかにぼやけます。
- 作者は量子化範囲が Comfy 公式の int8 / w4a8 と同じである(同じく 200 個の transformer レイヤー、重みの 95.8% を占める)と説明し、残りは公式 bf16 のまま変更されていません。また、HF 上の比較ページも提供されています;8 枚の表示可能なサンプル画像があります。
使い方
- ComfyUI 0.44 以降が必要です;ComfyUI 標準の「MiniMax H3 Image」テンプレートを開き、Load Diffusion Model でファイルを選択します。テンプレート設定は 6 ステップ、euler、simple、cfg 1 のままにしてください。
- テキストエンコーダー qwen3vl_32b_minimax_h3_nvfp4_awq(または int8 convrot)と VAE は Comfy-Org の MiniMax-H3-Image リポジトリから取得します。
- GGUF を使用する場合は、読み込みノードを Unet Loader (GGUF) に変更し、事前に ComfyUI-GGUF にパッチを適用する必要があります(作者が提供する patch スクリプトを実行するか、手動で loader.py の IMG_ARCH_LIST に "minimax_h3" を追加します)。これを行わないと Unexpected architecture type エラーが発生します。
- 作者によると、モデルは 4–20 MP の間で最も効果的で、低解像度では性能が低下します。長く詳細な英語プロンプトを使用する必要があります。
リスクと制限
- MiniMax-H3-Image コミュニティライセンス:著者の原文では、ライセンスはEU、英国、韓国、米国には適用されないことが明記されています。モデルおよびその出力は、他のAIモデルの改善には使用できません。年間収入が 100 万ドルを超える場合、またはホスティングサービスを行う場合は、事前にMiniMaxの書面による許可が必要です。商用製品には MiniMax-H3-Image と明記する必要があります
- GGUFは上流にマージされていないパッチに依存しています。2 件のサンプルは非表示です。これは画像モデルであり、動画は生成しません
【A】Smart Glasses POV - MiniMax H3 · H3 V1
LoRA · 新モデル · 作者 AriaMaiven · 公開 11-11 09:15 · ダウンロード 122
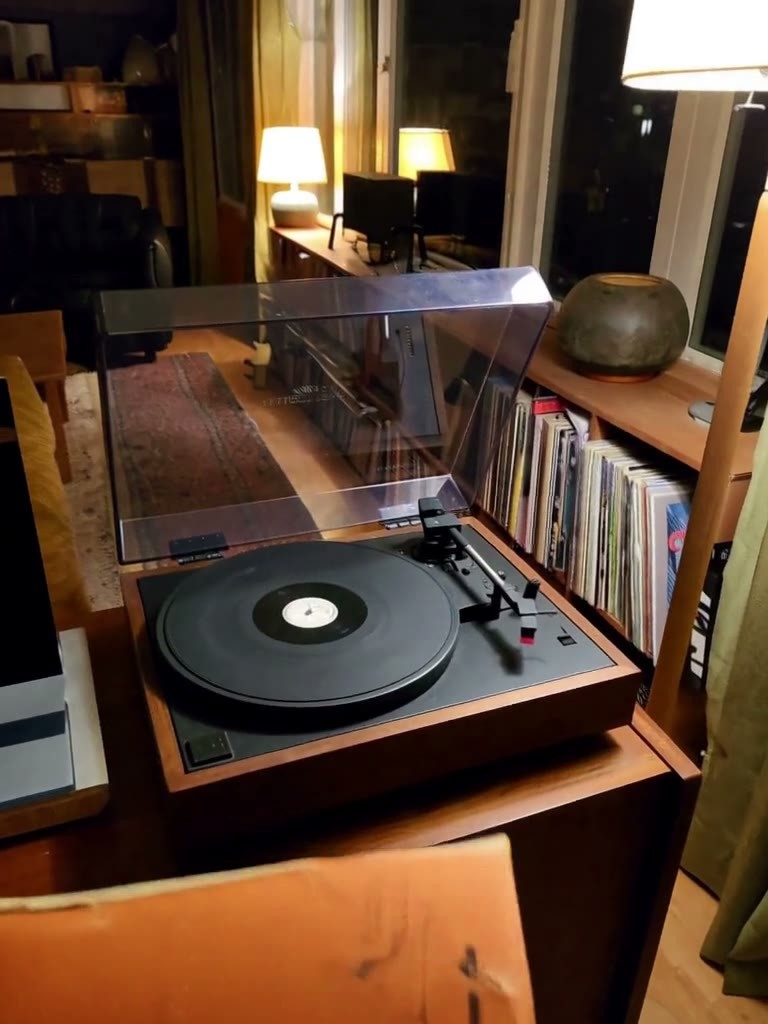
スマートグラスの一人称視点動画スタイルLoRA:歪みのない広角、手元を見る際の頭の揺れ、画面下から伸びる着用者自身の手を再現します。
画像
推奨理由
- 新モデル。料理、自転車、本棚からの本の取り出し、ドアを開けて犬を迎えるといった「目線越し」の日常の一人称視点動画に対応します
- 強度が明確に記述されています:0.6 が推奨。0.8 はスタイルがより強くなりますが、手がプロンプトに従わなくなります。1.0 は過剰です
- 著者は毎回手を完全に記述するよう注意を促しています(肌色、指輪、時計、爪、袖、タトゥーがない場合は "no tattoos" と記述)。記述されていない部分はLoRAが補完します。著者のテスト設定は FL2VA pruned int8 ConvRot によるテキストから動画への生成で、20 ステップ、res_multistep + simple、768x1024、5 秒です
使い方
- トリガーワード povsint、強度 0.6。プロンプトの最初の文に [Shot 1] Live-action in the povsint style, an eye-level shot... と記述します
- glasses、POV、first person、fisheye は記述せず、トリガーワードに任せます。単独で使用し、人体や動作のLoRAとは併用しません
リスクと制限
- 著者自身、手が時々一段階白くなることがあり、稀に手首に小さなタトゥーが現れることがあるため、公開前に確認が必要だと述べています
- 表示されるサンプル動画は 1 件のみです(4 件は非表示)。転載や、その出力を他のモデルの学習に使用するには、事前に著者の許可が必要です
トリガーワード:povsint
【A】Frieren Anime H3 Style Lora · v1.0
LoRA · 新モデル · 作者 tazmannner379 · 公開 11-10 21:24 · ダウンロード 259
『葬送のフリーレン』アニメスタイル動画LoRA:同アニメの画風を再現し、一部のキャラクターの声優とBGMも伴います。
画像
推奨理由
- 新モデル。フリーレンの二次創作短編動画、アニメスタイルのテキストから動画/画像から動画への生成、かつキャラクターが話す創作をしたい方向けです
- 学習データが明記されています:音声付きのエピソードクリップ 672 本 + スクリーンショット 721 枚。著者はHugging Faceに学習レポート、プロンプトガイド、および 27 人のキャラクターのキャラクター設定画と音声参考資料を公開しています
- 3 個の学習ステップ数のチェックポイントを提供しています(3150 / 3900 / 4200 ステップ)。メインファイルは 4200 ステップです。表示されるサンプル動画は 6 件で、公開約 16 時間で 259 回のダウンロード、36 件のいいねを獲得しています
使い方
- プロンプトの冒頭にトリガーワード 2d anime style, Frieren style, と記述します
- 著者のHFページでは 4200 ステップのチェックポイントと強度 1.0 が推奨されています。FL2VAベースモデルで学習されていますが、Ref2VAベースモデル上でキャラクター設定画を参考画像として併用することも可能です
- 特定のキャラクターを安定して再現するには、著者の提案に従い、HFページのキャラクター参考画像と音声参考資料を併用してください
リスクと制限
- 正規のアニメ映像とキャラクターの音声で学習されています(著者はHFページで著作権を所有しておらず、学習目的のみであると自己申告しています)。公開または商用利用前に権利を確認してください
- ステップ数、CFG、サンプラーはCivitaiページに記載されていません。HFのガイドを参照してください。6 件のサンプルは非表示です
トリガーワード:2d anime style、Frieren style
注目(9)
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT8
ベースモデル / Checkpoint · 新モデル · 作者 tsolful · 公開 11-11 07:17 · ダウンロード 67
H3 Image ベースモデルの INT8 ConvRot(W8A8)量子化版です。サイズは 19.54 GB で、著者は3段階の量子化におけるデフォルトの選択肢として推奨しています。
画像
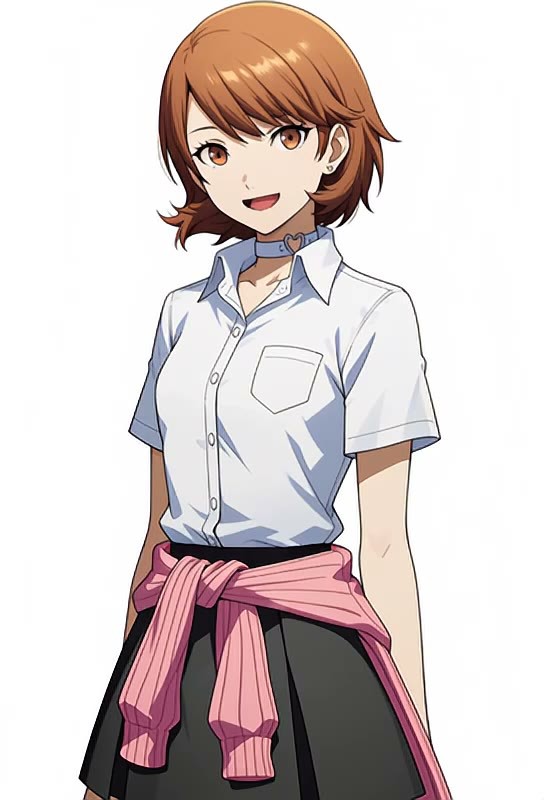
【B】Yukari Takeba Voice - Persona 3 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · 新モデル · 作者 OneMoreLurker · 公開 11-11 12:04 · ダウンロード 20
音声のみキャラクターボイスLoRA:『ペルソナ 3 リロード』の岳羽ゆかりの日本語音声で学習されており、H3 でこのキャラクターの声質の台詞を生成します。
画像
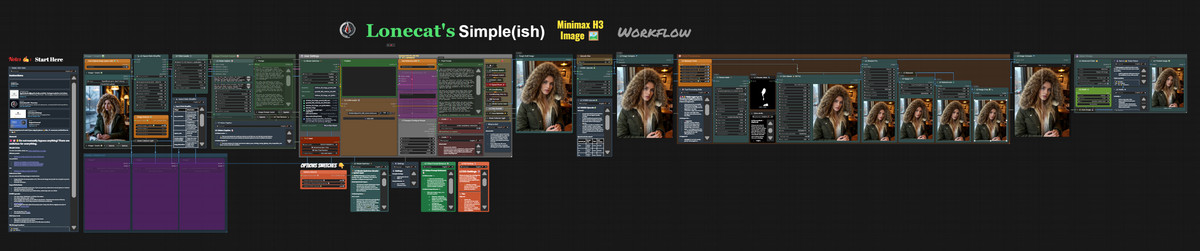
【B】Lonecat’s Simple Speed Boost 🚀 Workflows | 简易加速工作流 (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple Minimax Image 🖼️
ワークフロー · バージョン更新 · 作者 lonecatone23 · 公開 11-11 11:45 · ダウンロード 10
Lonecatの簡易ワークフロー集に追加された H3 Image 版(Simple Minimax Image)です。コメント付きの H3 Image 参考画像生成ワークフローで、著者は肌の質感を改善するために skin master ノードを追加しました。
画像
【B】MInimax H3 Studio, Pixel Upscale Optimized for NVIDIA ONLY · v3.0
ワークフロー · バージョン更新 · 作者 hRUSTIN474 · 公開 11-11 04:50 · ダウンロード 57
H3 Studio 動画ワークフロー v3.0:テキストから動画/画像から動画/参考画像から動画の3つのブランチと自動プロンプト作成、マルチシーン連続生成、出力後のNVIDIA専用アップスケールとHDRポストプロセッシングを含みます。
画像
【B】MiniMaxH3 Lipsync / TLF2VA · Nova.3
ワークフロー · バージョン更新 · 作者 Rvage · 公開 11-11 00:44 · ダウンロード 50
H3 リップシンク/マルチシーン動画ワークフロー Nova.3:キャラクター画像と既存の録音を使用して歌や会話のリップシンク動画を生成するか、ネイティブの H3 テキストから動画/画像から動画/最初と最後のフレームを使用し、シーンごとに分割レンダリングします。中断して再開したり、特定のシーンから再生成したりできます。
画像
【B】H3 Image w/ Pose Studio + Other Advanced Features [FoxFurEssence] · v1.0
ワークフロー · 新モデル · 作者 foxydits · 公開 11-11 08:56 · ダウンロード 159
H3 Image マルチ機能ワークフロー:テキストから画像/画像から画像/最大 9 枚の参考画像からの生成に対応し、オン/オフ可能な Pose Studio によるポーズ指定、動画からのフレーム抽出を参考画像として使用できます。
画像
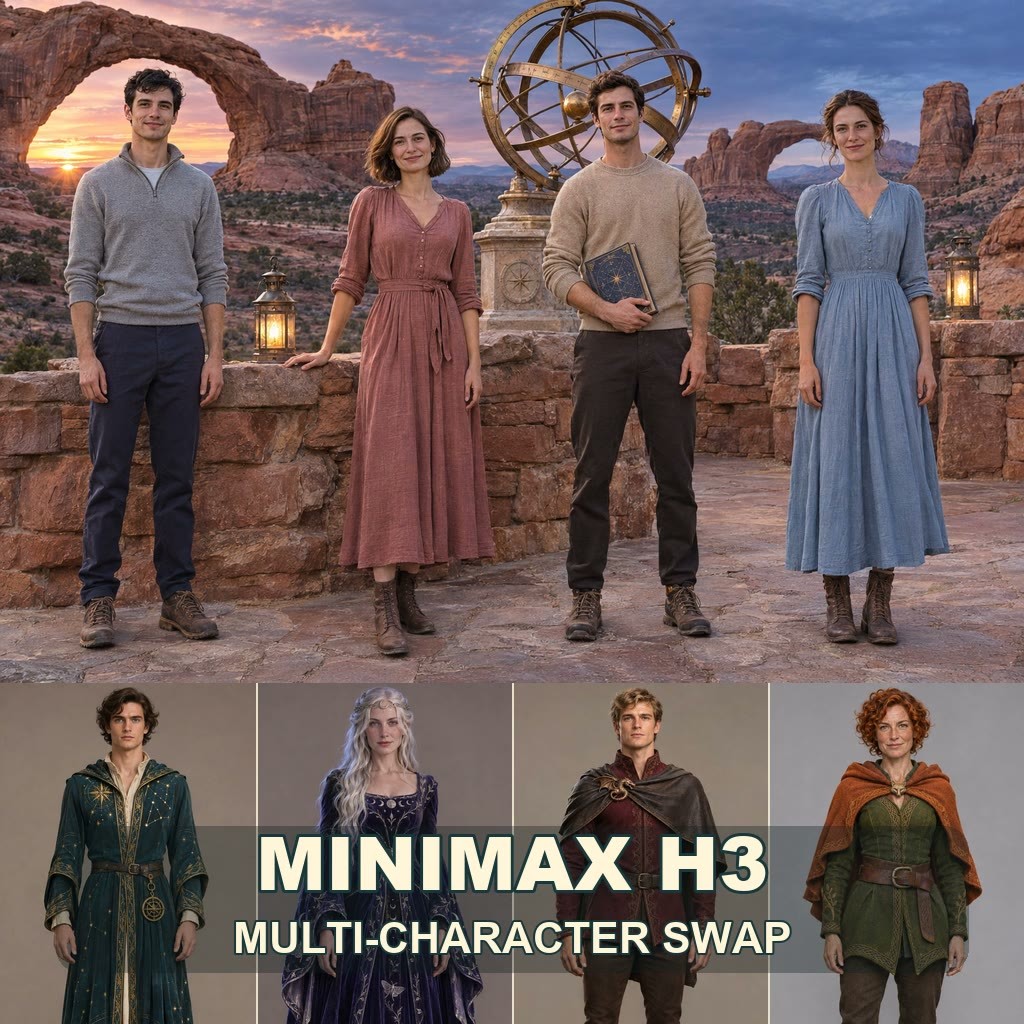
【B】MiniMax H3 Multi-Character Swap in Images | ComfyUI · v1.0
ワークフロー · 新モデル · 作者 BearGhasemian · 公開 11-11 11:04 · ダウンロード 7
H3 動画モデルの参考画像ノードを使用して単フレーム静止画のキャラクター交換を行うワークフローです。各キャラクターに1枚の参考画像を与え、1枚の画像内の 1–4 人を指定されたキャラクターに置き換えます。
画像
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT6
ベースモデル / Checkpoint · バージョン更新 · 作者 tsolful · 公開 11-11 07:30 · ダウンロード 7
同ページの H3 Image INT6(W6A8)量子化版です。サイズは 15.61 GB で、INT8 と INT4 の中間に位置し、Comfy公式リポジトリにはこの段階はありません。
画像
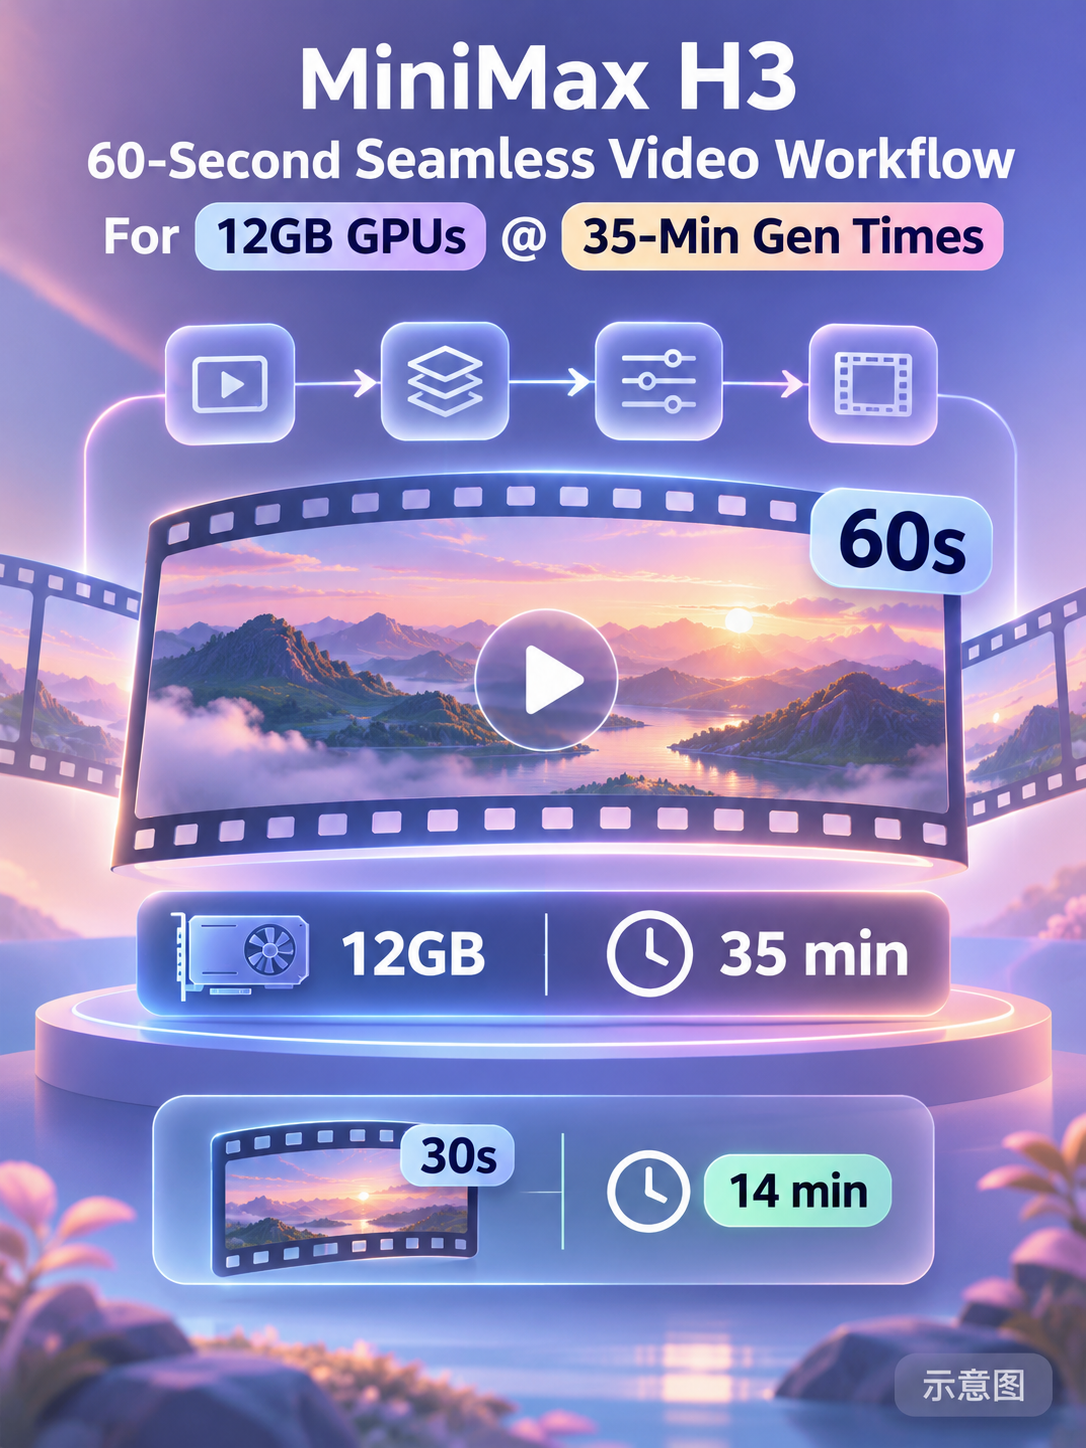
【B】MiniMax H3 60-Second Seamless Video Workflow For 12GB GPUs @ 35-Min Gen Times · v1.2
ワークフロー · 新モデル · 作者 vortis23 · 公開 11-11 12:46 · ダウンロード 3
12GB GPUで動作する H3 長尺動画ワークフロー v1.2:H3 Motion Director ノードを使用してタイムライン上で分割し、著者によれば約 35 分で最長約1分の連続トラッキングショットを生成します。
画像
収録のみ(9)
- (顔の崩壊防止)MiniMax H3-Image ベースワークフロー · ベースワークフロー — ワークフロー:「顔の崩壊防止」と名付けられた H3 Image の基本画像生成ワークフロー。モデルページの説明は句点のみ。
- Aliyah Belwyn · MiniMaxH3 — LoRA:作者によるオリジナルの架空キャラクター Aliyah Belwyn(ブルッヘのハープ奏者)のキャラクター LoRA。Anima / ZImageTurbo 版から H3 へ移植。
- Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT4 — ベースモデル / チェックポイント:同ページの H3 Image INT4(W4A8 GPTQ)量子化版。12.77 GB で、3段階のうち最小サイズ。VRAM の節約のみで速度向上はない。
- MiniMax-H3-Image · v1.0 — ワークフロー:「MiniMax-H3-Image」と名付けられた画像生成ワークフロー。説明はタイトルと「v1」のみ。
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — ワークフロー:Qwen 2.1 の画像生成ワークフローを H3 Image 用に調整したシンプルなワークフロー。名称にはより高速なプロンプト拡張機能が記載されている。
- Esmae Belwyn · MiniMaxH3 — LoRA:作者によるオリジナルの架空キャラクター Esmae Belwyn(ブルッヘ運河沿いのフローリスト)のキャラクター LoRA。MOSS Image 版から H3 へ移植。
- Faye Belwyn · MiniMaxH3 — LoRA:作者によるオリジナルの架空キャラクター Faye Belwyn(ブルッヘの古布修復師)のキャラクター LoRA。Krea 2 / ZImageTurbo / MOSS Image 版から H3 へ移植。
- Anaya Von Vergin · MiniMaxH3 — LoRA:作者によるオリジナルの架空キャラクター Anaya Von Vergin(オックスフォード出身の博物館キュレーター)のキャラクター LoRA。SDXL、Flux、Anima、MOSS Image など複数のバージョンから H3 へ移植。
- Ruth Belwyn · MiniMaxH3 — LoRA:作者によるオリジナルの架空キャラクター Ruth Belwyn(ブルッヘの本製本師)のキャラクター LoRA。Krea 2 版と同時に公開された H3 版。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-10 20:31 → 11-11 13:03(北京時間)。推奨理由は編集者による審査済み。ダウンロード数は注目度を示すに過ぎない。