Радар AI от Чжэньчжэнь · MiniMax H3 · Утренний обзор 2026-11-11
В этом выпуске 23 новых версий: настоятельно рекомендуется 2 · рекомендуется 3 · заслуживает внимания 9 · только для ознакомления 9
Примечание редактора В этом выпуске рассмотрено 23 новых версий H3: 2 категории S, 3 категории A, 9 категории B и 9 категории C. Главная рекомендация — рабочий процесс генерации и редактирования изображений H3 Image от AusBoss: создание изображений разрешением 16 МП одной фразой или редактирование простым языком, с возможностью добавления до семи референсных изображений; в режиме Fast использование pDMD сокращает количество шагов с 6 до 2. Обратите внимание, что примерно половина материалов в этом выпуске — это версии H3 для изображений, интегрированные в ComfyUI 11-10, которые генерируют только изображения, но не видео. Среди видеоматериалов категории S выделяется LoRA в стиле «случайная съемка на телефон друга» Friend’s POV, а LoRA с видом от первого лица через умные очки и LoRA в стиле аниме «Провожающая в последний путь Фрирен» отнесены к категории A. Квантованные пакеты H3 Image с неясными описаниями INT8 / INT4 понижены до категорий B / C, а LoRA с голосовыми характеристиками для озвучки понижены до категории B из-за проблем с авторскими правами; 5 оригинальных LoRA персонажей, портированных MisterMR, лишены триггерных слов и примеров, поэтому отнесены к категории C.
Настоятельно рекомендуется (2)
【S】MiniMax H3 Image Generate + Edit | 16 МП, 8 изображений · v1.0
Рабочий процесс · Новая модель · Автор AusBoss · Опубликовано 11-11 08:31 · Загрузок 140
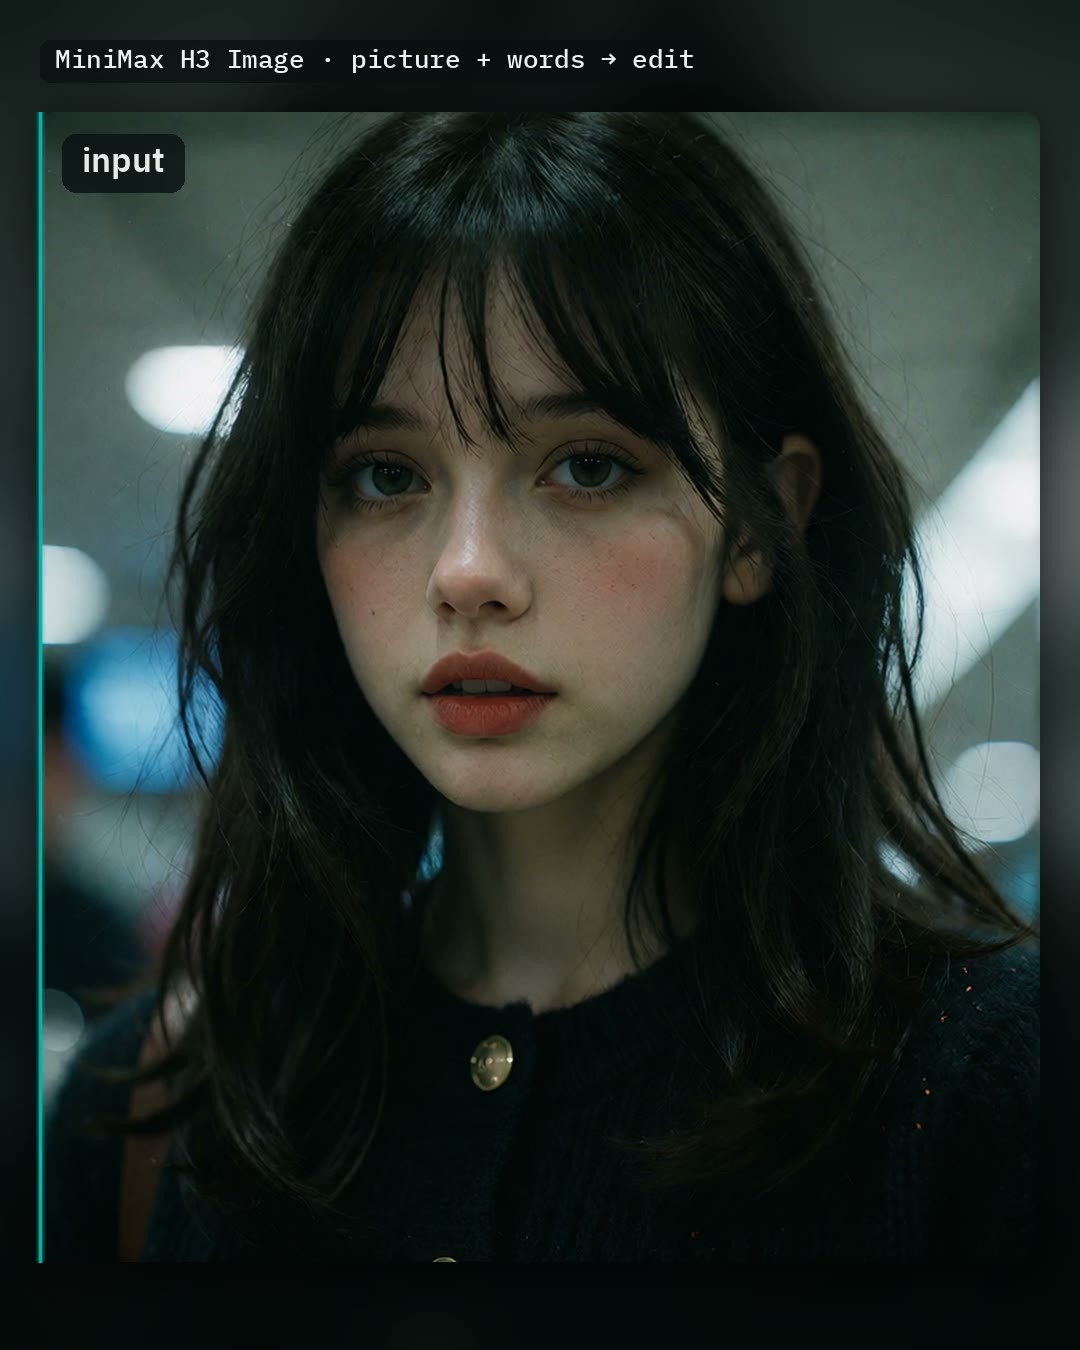
Рабочий процесс ComfyUI для генерации и редактирования изображений MiniMax H3 Image (версия H3 для изображений): создание изображений разрешением 16 МП одной фразой или редактирование простым языком, с возможностью добавления до семи референсных изображений при редактировании и указанием того, что брать с каждого из них.
Первый рабочий процесс после запуска H3 Image, который объединяет генерацию, редактирование, работу с несколькими референсами и апскейлинг, а также содержит номер версии для тестирования. Подходит в качестве стартового шаблона для H3 Image.
Иллюстрации
Причины рекомендации
- Новая модель (рабочий процесс, а не новые веса); обслуживает генерацию изображений по тексту, редактирование по инструкции и композицию с несколькими референсами для H3 Image, например: «надень куртку с изображения 2 на человека с изображения 1»
- Автор указывает тестовую среду (ветка master ComfyUI, коммит ede4e5f + узлы AusBoss 2.22.0, протестировано на двух уровнях видеопамяти) и перечисляет необходимые файлы моделей, директории размещения и их размеры: для High VRAM используется базовая модель int8 ConvRot (21.0 ГБ), для Low VRAM — w4a8 (12.5 ГБ), общий текстовый энкодер Qwen3-VL 32B nvfp4 и VAE H3 Image
- Полный набор переключателей: Auto prompt использует маленькую модель для расширения нескольких слов в длинное описание; Size переключается между 4 МП / 16 МП; Fast использует LoRA pDMD на 2 шагов, сокращая количество шагов с 6 до 2; опциональный SeedVR2 позволяет увеличить результат 4 МП в два раза
- По словам автора, на RTX 5090 генерация одного изображения 16 МП занимает около 22 секунд, а редактирование изображения 16 МП — около 35 секунд; 1 видеороликов + 6 видимых примеров изображений
Как использовать
- Сначала обновите ComfyUI до версии после 0.44.0 и узлы AusBoss до 2.22.0, перетащите рабочий процесс и нажмите Run; по умолчанию включен полный промпт
- Для генерации: напишите полное длинное описание или включите Auto prompt и напишите всего несколько слов; для редактирования: включите Edit a picture, загрузите изображение и опишите изменения (например, «Make it snow.»); референсные изображения подключаются последовательно от picture 2 до picture 8, и в промпте нужно явно указать «picture 2»
- Текст, который должен появиться на изображении, заключайте в кавычки; если промпт уже достаточно полный, отключите Auto prompt (автор отмечает, что при переписывании начального промпта руки могут искажаться); при создании постеров или обложек не включайте режим Fast
Риски и ограничения
- Зависит от новой поддержки H3 Image (интеграция в ComfyUI появилась только в 11-10) и собственных узлов AusBoss; старые версии ComfyUI не поддерживаются; полный набор моделей (базовая модель + текстовый энкодер 32B + опциональная модель расширения, LoRA ускорения, SeedVR2) требует большого объема загрузки
- Лицензия сообщества MiniMax-H3-Image: согласно пересказу автора квантования для Comfy, она не распространяется на ЕС, Великобританию, Южную Корею и США; результаты нельзя использовать для улучшения других ИИ-моделей; при годовом доходе свыше 100 тыс. долларов или предоставлении хостинговых услуг требуется отдельная лицензия
- Это имиджевая модель H3, она не генерирует видео; данные о времени выполнения предоставлены автором
【S】Friend's POV - MiniMax H3 · H3 V1
LoRA · Новая модель · Автор AriaMaiven · Опубликовано 11-11 09:15 · Загрузок 86
LoRA в стиле видео «случайная съемка на телефон друга»: широкий кадр, объект смещен к краю, плоское освещение от телефона, изображение дрожит, когда снимающий смеется.
Вместе с Smart Glasses POV того же автора составляет серию «вид с любительской камеры», параметры описаны единообразно.
Иллюстрации
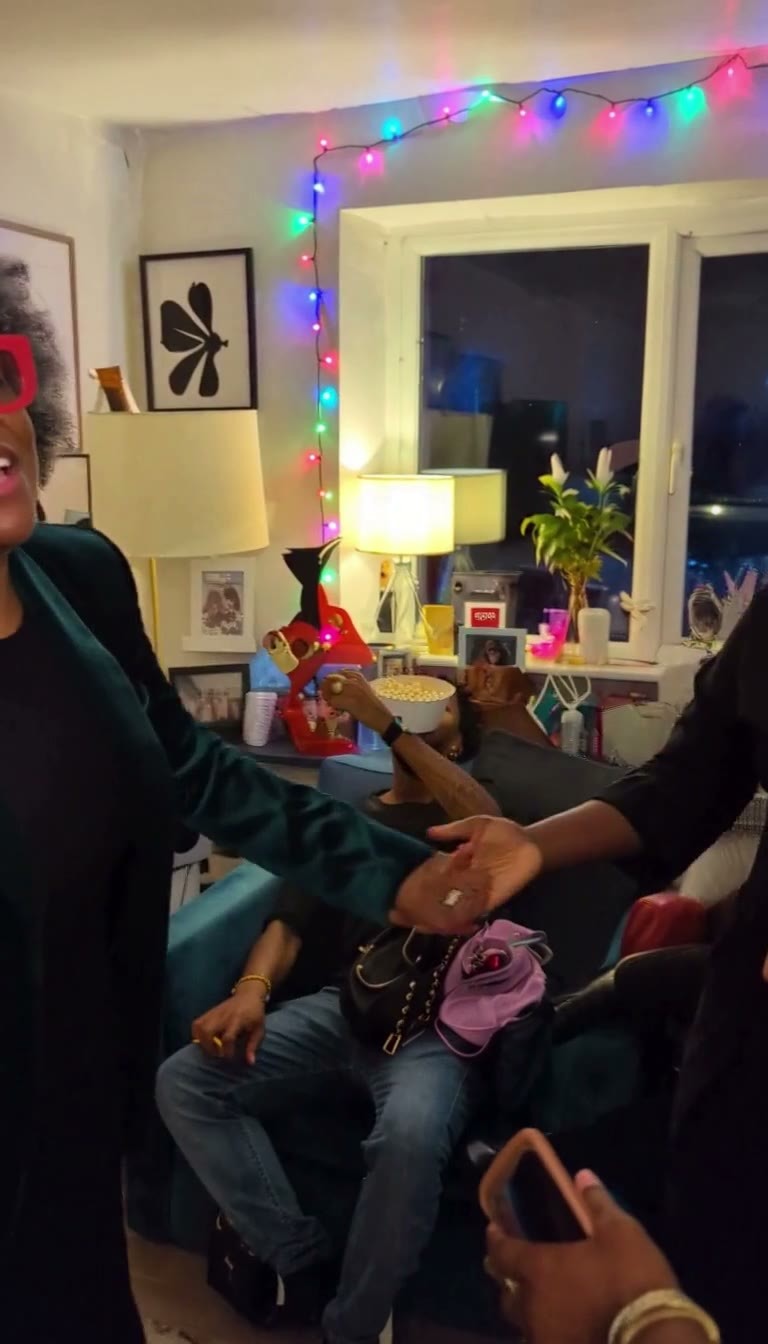
Причины рекомендации
- Новая модель; подходит для крупных планов жизненных сцен с людьми, таких как вечеринки, ночные улицы, проходы в супермаркетах, где нужен эффект «видео с телефона друга», а не кинематографичность
- Автор предоставил полное руководство по использованию: триггерное слово celsint, для крупных планов лиц используйте силу 0.65 (стабильное лицо, сохраняется эффект телефона), для дальних планов, спиной к камере или без лица можно увеличить до 0.8 (стиль выражен сильнее, но крупные планы лиц могут искажаться)
- Конкретные рекомендации по написанию промптов: стиль указывайте в первом предложении промпта H3; не пишите про телефон, ручную камеру, дрожание, экспозицию, зернистость — за это отвечает триггерное слово; вместо этого описывайте, «что делает друг на видео» (бежит сзади, держат за запястье, толкает гость), так движение будет выглядеть реалистичнее
- Тестовая конфигурация автора: MiniMax H3 FL2VA pruned int8 ConvRot для генерации видео из текста, 20 шагов, res_multistep + simple, 768x1344, 5 секунд; 2 видимых примеров видео
Как использовать
- Триггерное слово celsint; сила от 0.65 (крупный план лица) до 0.8 (дальний план или без лица); в первом предложении промпта напишите [Shot 1] Live-action in the celsint style, a medium shot at chest height...
- Используйте отдельно, не комбинируйте с другими LoRA для тел или движений; тестирование автора проводилось для генерации видео из текста с 20 шагами, res_multistep, simple, 768x1344
Риски и ограничения
- Можно использовать в коммерческих целях, но необходимо указывать источник стиля; для репоста или использования результатов для обучения других моделей требуется разрешение автора
- 1 примеров скрыты; протестировано только генерирование видео из текста, поведение при генерации видео из изображения / Ref2VA автором не описано
Триггерное слово: celsint
Рекомендуется (3)
【A】Minimax H3 Image Quants - comfy-native - fp8_scaled / nvfp4 / GGUF Q6 / Q4 / Q3 / Q2_mix · v1.0
Базовая модель / Checkpoint · Новая модель · Автор Thasmodius · Опубликовано 11-11 07:19 · Загрузок 47
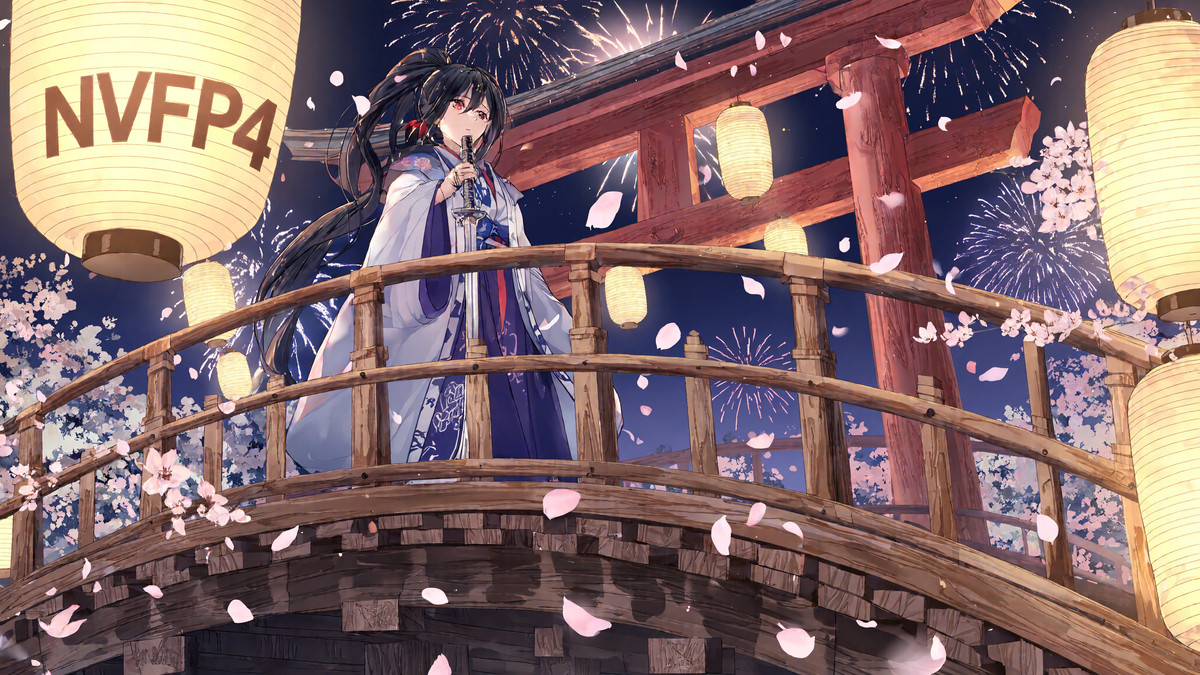
Дополнительный пакет точности для базовой модели H3 Image: квантованные версии fp8 scaled, NVFP4 и смешанные GGUF Q6_K / Q4_K / Q3_K / Q2_K, отсутствующие в официальном репозитории Comfy, содержащие только диффузионную модель.
Иллюстрации
Причины рекомендации
- Новая модель (квантованные веса); подходит для пользователей, которые хотят запускать генерацию и редактирование изображений H3 Image на RTX 40 / 50 или любой другой видеокарте, но не имеют достаточно видеопамяти для официальной версии bf16
- Назначение каждой версии описано четко: fp8 scaled 21.0 ГБ для RTX 40 / 50; NVFP4 12.5 ГБ работает нативно только на RTX 50 и является самой быстрой (по словам автора, на RTX PRO 6000 разрешение 2048x2048 дает около 3.4 шагов/с, а fp8 — около 2.1 шагов/с); GGUF Q6_K 17.5 ГБ, Q4_K 12.5 ГБ, Q3_K 10.0 ГБ для любых видеокарт; Q2_K mix 9.25 ГБ — экспериментальная версия, по словам автора, изображение становится заметно мягче
- Автор поясняет, что диапазон квантования совпадает с официальными int8 / w4a8 от Comfy (те же 200 слоев трансформера, составляющих 95.8% весов), остальная часть остается в официальном bf16, и предоставляет страницу сравнения на HF; 8 видимых примеров изображений
Как использовать
- Требуется ComfyUI 0.44 или новее; откройте встроенный шаблон ComfyUI «MiniMax H3 Image» и выберите файл в узле Load Diffusion Model; сохраните настройки шаблона: 6 шагов, euler, simple, cfg 1
- Текстовый энкодер qwen3vl_32b_minimax_h3_nvfp4_awq (или int8 convrot) и VAE берите из репозитория MiniMax-H3-Image от Comfy-Org
- Для GGUF замените узел загрузки на Unet Loader (GGUF) и предварительно пропатчите ComfyUI-GGUF (запустите скрипт патча от автора или вручную добавьте "minimax_h3" в IMG_ARCH_LIST в loader.py), иначе появится ошибка Unexpected architecture type
- По словам автора, модель лучше всего работает в диапазоне 4–20 МП, на низких разрешениях качество хуже, требуются длинные и подробные промпты на английском языке
Риски и ограничения
- Лицензия сообщества MiniMax-H3-Image: в оригинальном тексте автора указано, что лицензия не распространяется на ЕС, Великобританию, Южную Корею и США; модель и её результаты нельзя использовать для улучшения других ИИ-моделей; если годовой доход превышает 100 тыс. долларов или вы предоставляете хостинг-услуги, необходимо предварительно получить письменное разрешение от MiniMax; в коммерческих продуктах должна быть указана маркировка MiniMax-H3-Image
- Зависимости GGUF еще не объединены с патчами в основной ветке; 2 примеров скрыты; это модель для генерации изображений, она не создает видео
【A】Smart Glasses POV - MiniMax H3 · H3 V1
LoRA · Новая модель · Автор AriaMaiven · Опубликовано 11-11 09:15 · Загрузок 122
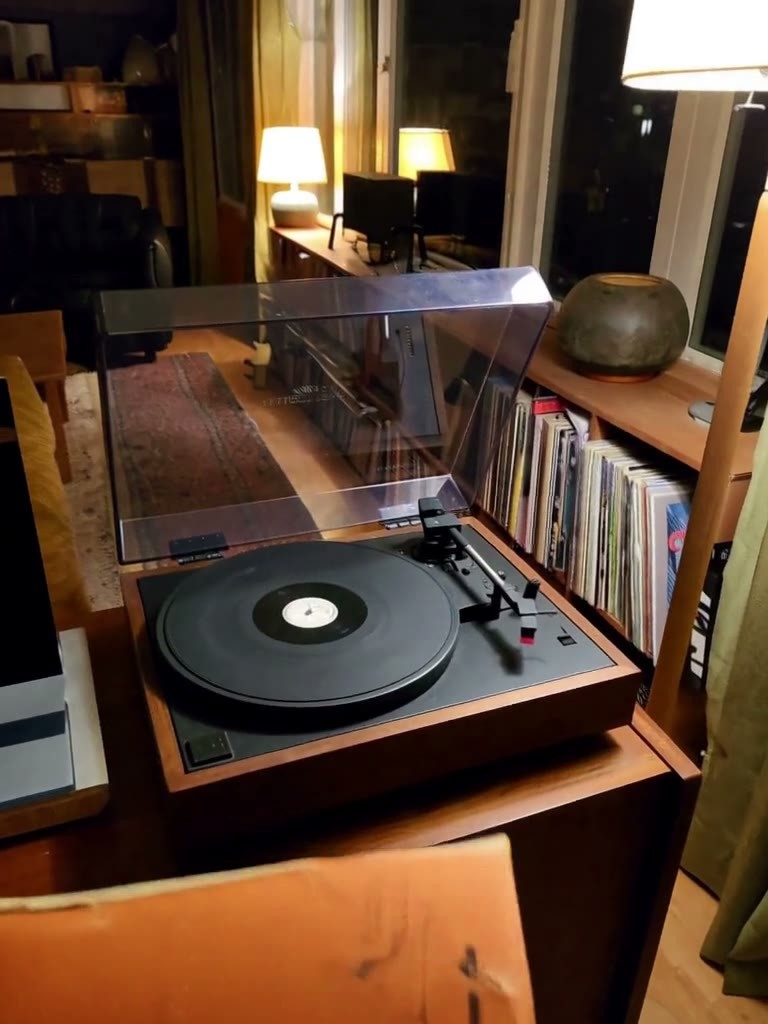
LoRA в стиле видео от первого лица через умные очки: широкий угол без искажений, движение головы при взгляде вниз на руки, собственные руки носителя, входящие в кадр снизу.
Иллюстрации
Причины для рекомендации
- Новая модель; подходит для повседневных видео от первого лица «из-за глаз», таких как приготовление еды, езда на велосипеде, вытаскивание книги с полки или открытие двери навстречу собаке
- Сила воздействия описана четко: 0.6 — рекомендуемое значение; 0.8 дает более сильный стиль, но руки перестают следовать описанию; 1.0 — слишком много
- Автор напоминает, что каждый раз нужно полностью описывать руки (цвет кожи, кольца, часы, ногти, рукава; если татуировок нет, пишите "no tattoos"), так как LoRA сама дополнит неопределенные детали; тестовая конфигурация автора: FL2VA pruned int8 ConvRot для генерации видео из текста, 20 шагов, res_multistep + simple, разрешение 768x1024, длительность 5 секунд
Как использовать
- Триггерное слово povsint, сила 0.6; первое предложение промпта должно начинаться с [Shot 1] Live-action in the povsint style, an eye-level shot...
- Не пишите glasses, POV, first person, fisheye, так как за это отвечает триггерное слово; используйте модель отдельно, не комбинируя с LoRA для тел или действий
Риски и ограничения
- Автор сам отмечает, что руки иногда становятся на тон светлее, а на запястьях иногда появляются маленькие татуировки; проверяйте результат перед публикацией
- Доступно только 1 видимых примеров видео (4 скрыты); для репоста или использования результатов для обучения других моделей необходимо предварительно получить разрешение автора
Триггерные слова: povsint
【A】Frieren Anime H3 Style Lora · v1.0
LoRA · Новая модель · Автор tazmannner379 · Опубликовано 11-10 21:24 · Загрузок 259
LoRA в стиле аниме «Провожающая в последний путь Фрирен»: воспроизводит художественный стиль аниме, включая голоса некоторых персонажей и саундтрек.
Иллюстрации
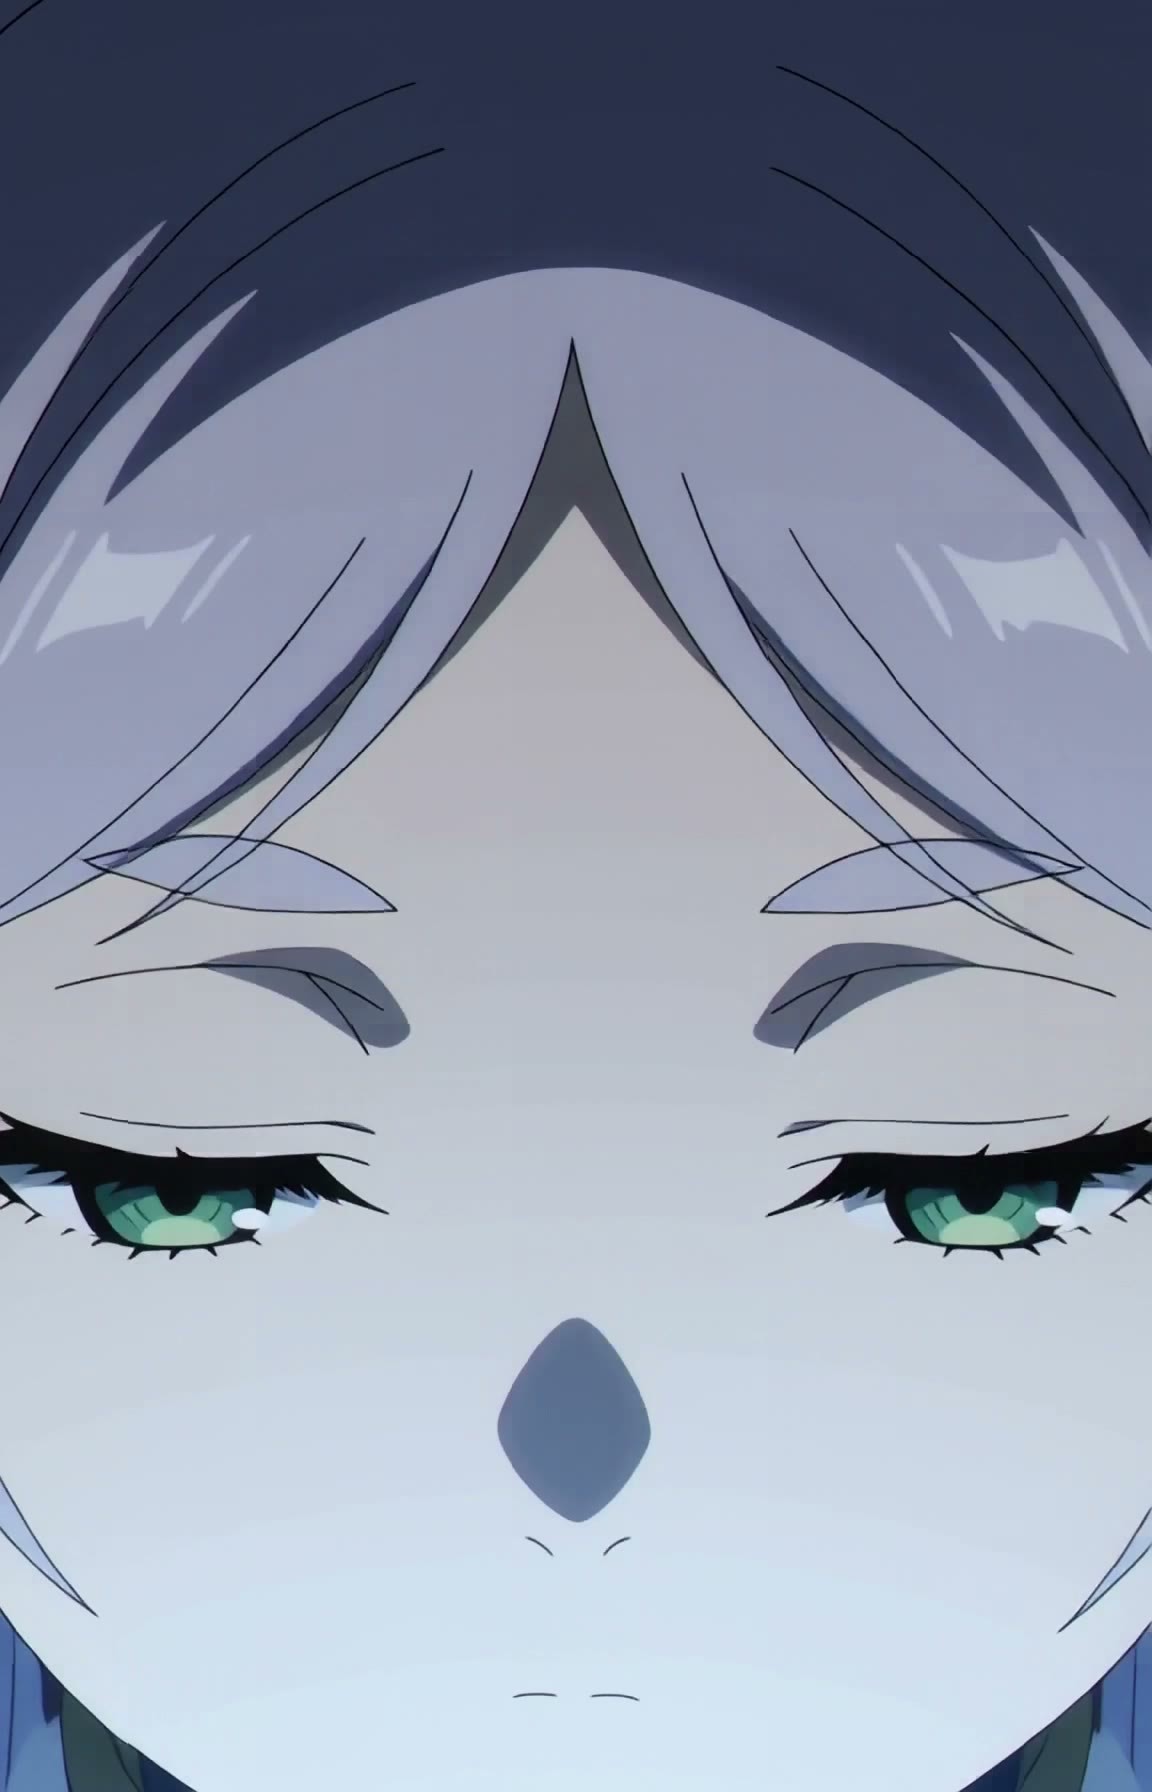
Причины для рекомендации
- Новая модель; подходит для создания фанатских короткометражек о Фрирен, генерации видео из текста или изображений в аниме-стиле, а также для проектов, где персонажи должны говорить
- Данные для обучения указаны явно: 672 фрагментов эпизодов со звуком + 721 скриншотов; автор разместил на Hugging Face отчет об обучении, руководство по промптам, а также дизайн-документы персонажей и аудио-референсы для 27 персонажей
- Предоставлены чекпоинты с 3 количеством шагов обучения (3150 / 3900 / 4200 шагов), основной файл — на 4200 шагов; 6 видимых примеров видео, через 16 часа после публикации — 259 загрузок и 36 лайков
Как использовать
- Начните промпт с триггерных слов 2d anime style, Frieren style,
- На странице автора в HF рекомендуется использовать чекпоинт на 4200 шагов с силой 1.0; обучение проводилось на базе FL2VA, также можно использовать базу Ref2VA с референсными изображениями персонажей
- Для стабильного воспроизведения конкретного персонажа следуйте рекомендациям автора и используйте референсные изображения и аудио-референсы персонажей со страницы в HF
Риски и ограничения
- Обучение проводилось на кадрах из лицензионного аниме и голосах персонажей (автор на странице в HF заявляет, что не владеет авторскими правами и использует материалы только для обучения); проверьте права перед публичным или коммерческим использованием
- Количество шагов, CFG и сэмплер не указаны на странице Civitai, смотрите руководство на HF; 6 примеров скрыты
Триггерные слова: 2d anime style, Frieren style
Стоит обратить внимание (9)
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT8
Базовая модель / Чекпоинт · Новая модель · Автор tsolful · Опубликовано 11-11 07:17 · Загрузок 67
Квантованная версия INT8 ConvRot (W8A8) базовой модели H3 Image, размер 19.54 ГБ, автор рекомендует её как выбор по умолчанию среди трех вариантов квантования.
Иллюстрации
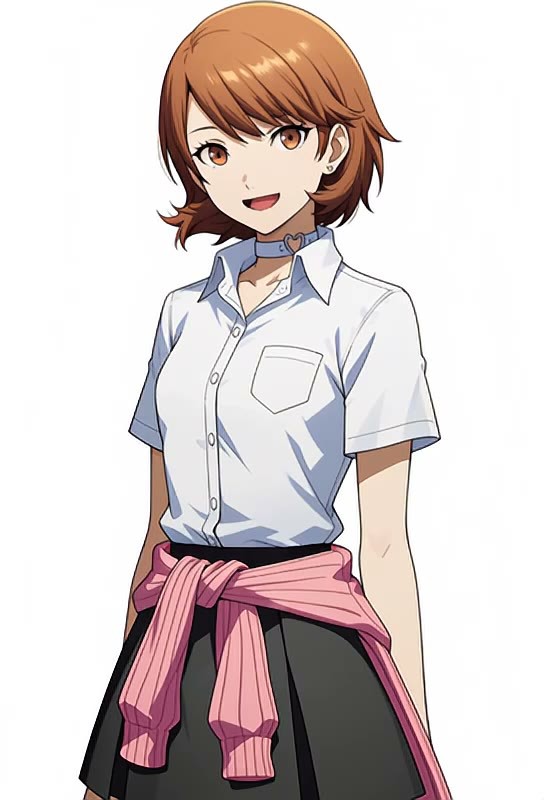
【B】Yukari Takeba Voice - Persona 3 - Audio Only [Minimax H3] · Minimax H3 v1.0
LoRA · Новая модель · Автор OneMoreLurker · Опубликовано 11-11 12:04 · Загрузок 20
LoRA для озвучки персонажа только со звуком: обучена на японской речи Юкари Такэба из игры «Persona 3 Reload», позволяет H3 генерировать реплики с голосом этого персонажа.
Иллюстрации
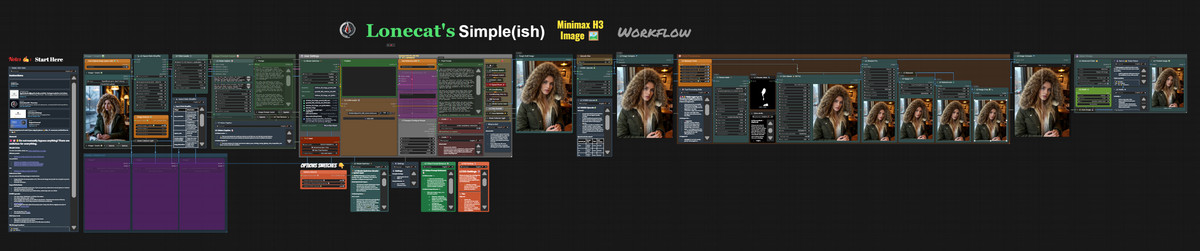
【B】Lonecat’s Simple Speed Boost 🚀 Workflows | 简易加速工作流 (MiniMax H3, Krea 2, Qwen 2.1, ZIT, Klein_9b, Illustrious, Flux, Wan2.2, Qwen Image Edit) · Simple Minimax Image 🖼️
Рабочий процесс · Обновление версии · Автор lonecatone23 · Опубликовано 11-11 11:45 · Загрузок 10
Новая версия H3 Image (Simple Minimax Image) в коллекции простых рабочих процессов Lonecat: документированный рабочий процесс для генерации изображений по референсу с H3 Image, автор добавил узел skin master для улучшения текстуры кожи.
Иллюстрации
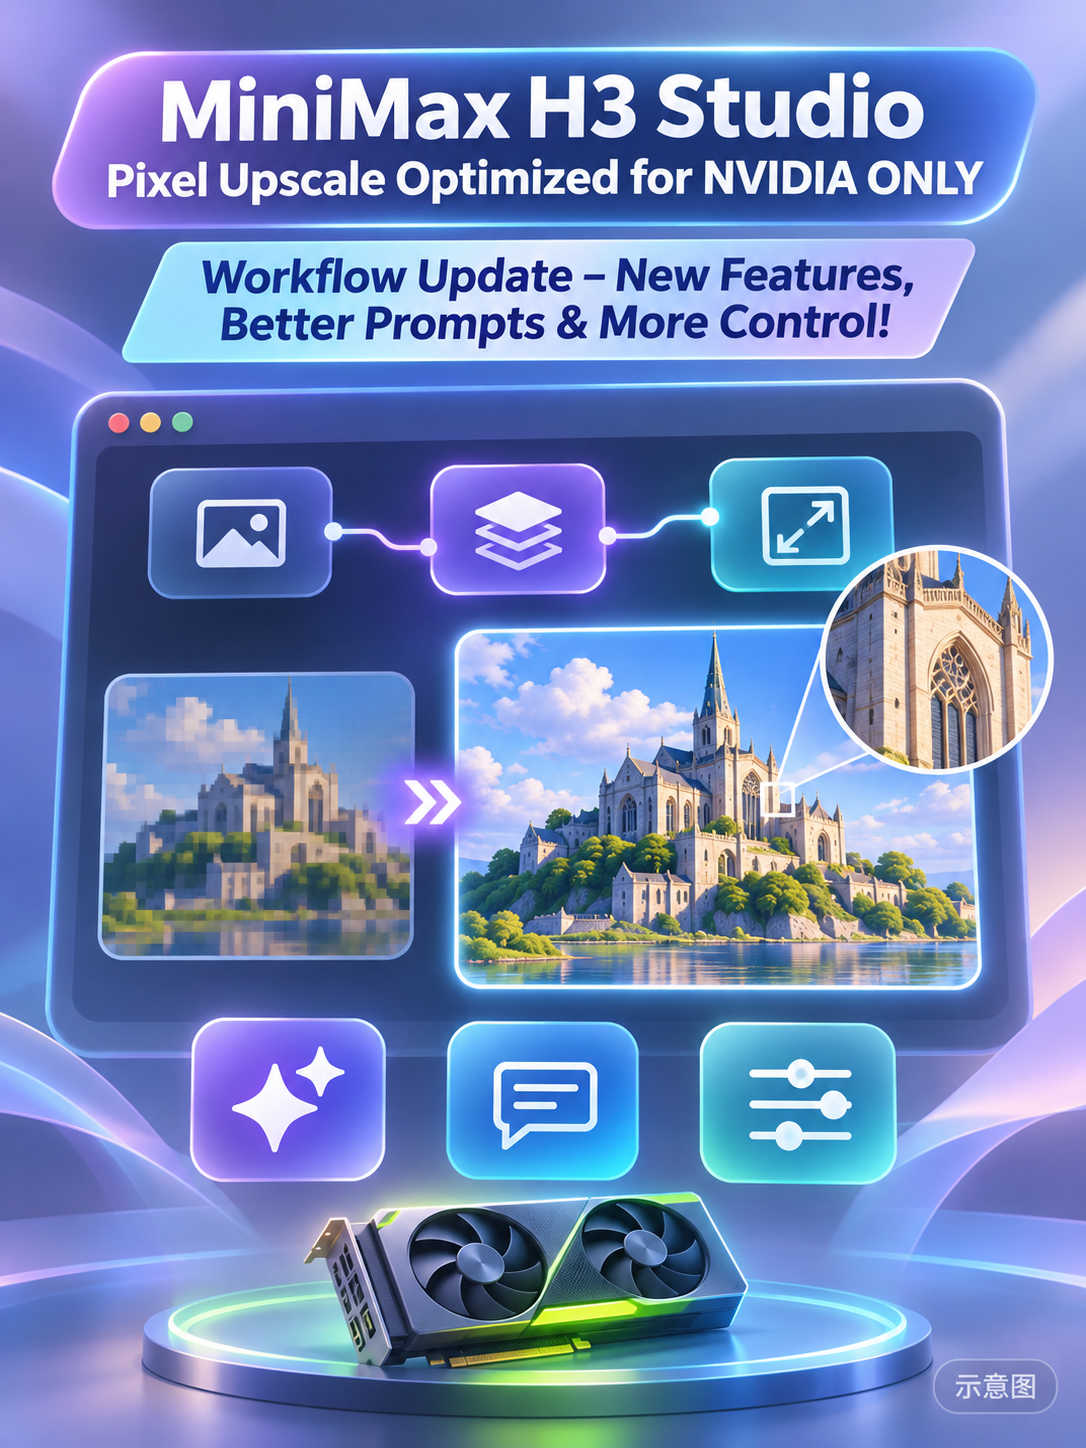
【B】MInimax H3 Studio, Pixel Upscale Optimized for NVIDIA ONLY · v3.0
Рабочий процесс · Обновление версии · Автор hRUSTIN474 · Опубликовано 11-11 04:50 · Загрузок 57
Видеорабочий процесс H3 Studio v3.0: три ветки (текст-в-видео, изображение-в-видео, видео по референсу) с автоматической генерацией промптов, непрерывность между сценами, после создания видео выполняется апскейл и постобработка HDR, оптимизированные специально для NVIDIA.
Иллюстрации
【B】MiniMaxH3 Lipsync / TLF2VA · Nova.3
Рабочий процесс · Обновление версии · Автор Rvage · Опубликовано 11-11 00:44 · Загрузок 50
Рабочий процесс Nova.3 для синхронизации губ / многокадрового видео с H3: создание видео с пением или речью с синхронизацией губ, используя изображение персонажа и готовую аудиозапись, либо использование нативных функций H3 (текст-в-видео, изображение-в-видео, кадры начала и конца) с покомпонентным рендерингом по сценам, возможностью прерывания и продолжения или перезапуска с определенного сегмента.
Иллюстрации
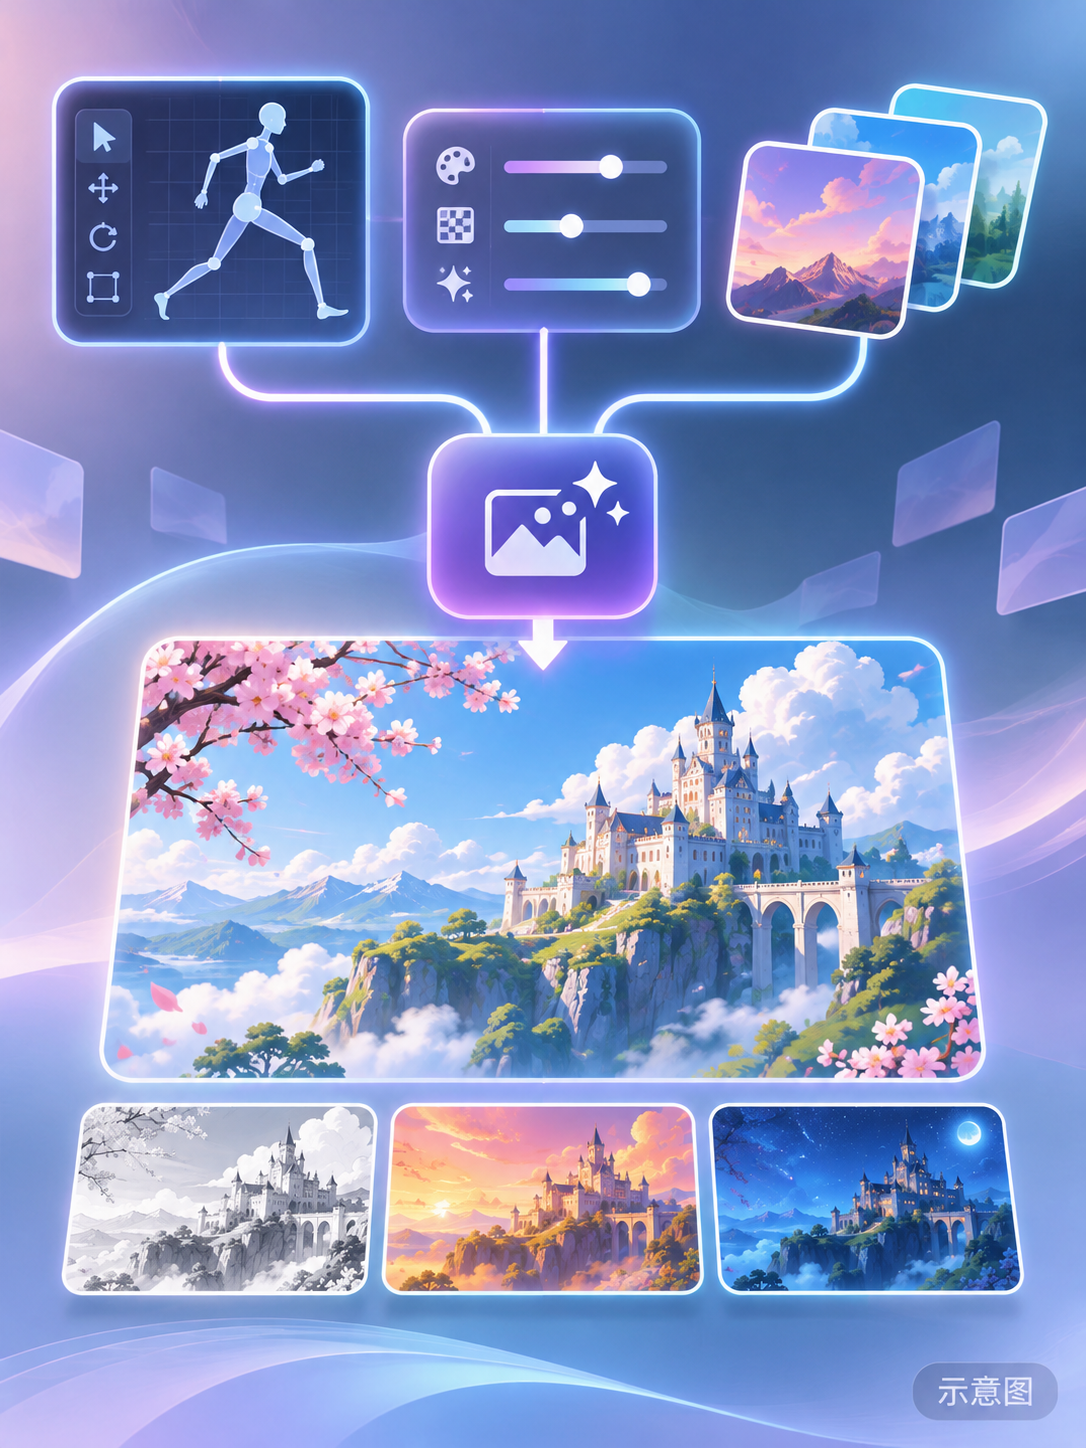
【B】H3 Image w/ Pose Studio + Other Advanced Features [FoxFurEssence] · v1.0
Рабочий процесс · Новая модель · Автор foxydits · Опубликовано 11-11 08:56 · Загрузок 159
Многофункциональный рабочий процесс H3 Image: генерация изображений из текста / изображений / до 9 референсных изображений, встроенный переключаемый Pose Studio для поз, а также возможность извлечения кадра из видео в качестве референса.
Иллюстрации
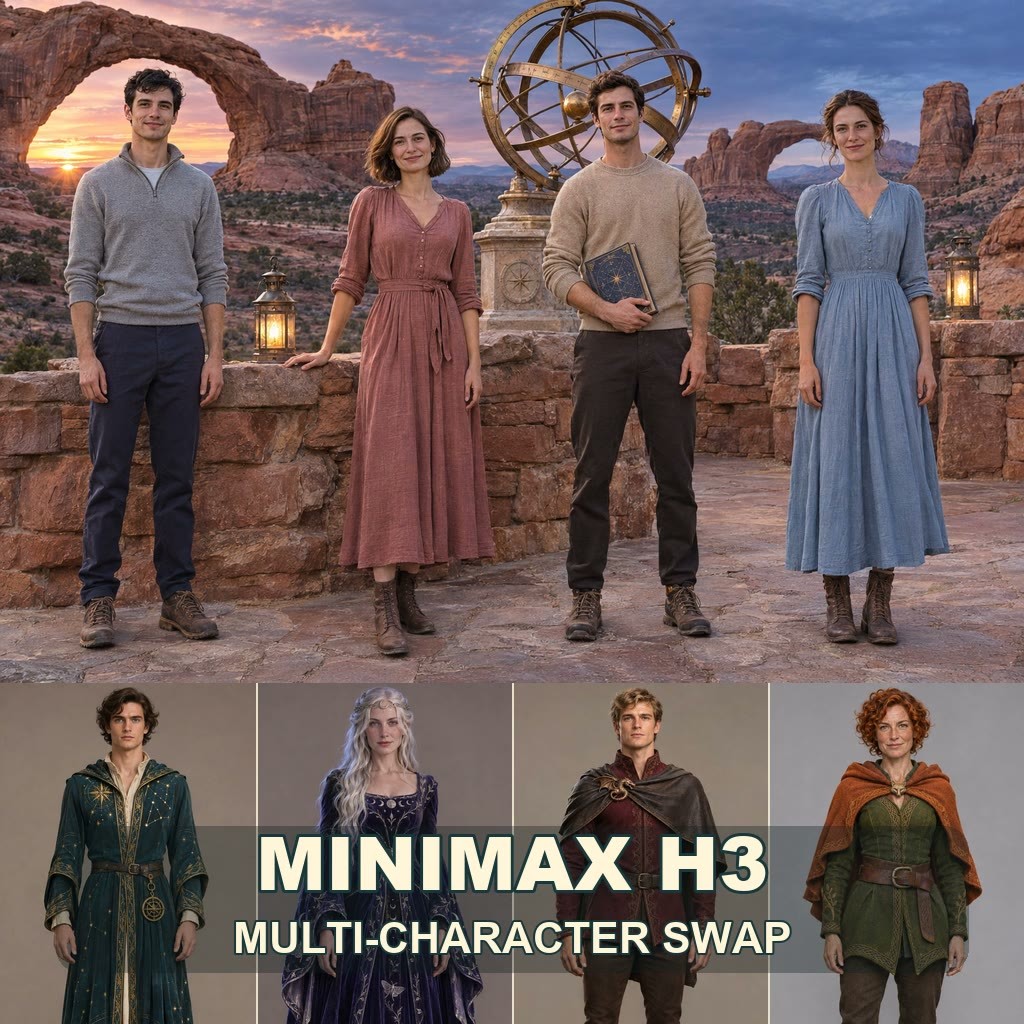
【B】MiniMax H3 Multi-Character Swap in Images | ComfyUI · v1.0
Рабочий процесс · Новая модель · Автор BearGhasemian · Опубликовано 11-11 11:04 · Загрузок 7
Рабочий процесс для замены персонажей на статичном кадре с использованием узла референсных изображений видеомодели H3: предоставьте по одному референсному изображению для каждого персонажа, чтобы заменить 1–4 человек на указанном изображении на заданных персонажей.
Иллюстрации
【B】Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT6
Базовая модель / Чекпоинт · Обновление версии · Автор tsolful · Опубликовано 11-11 07:30 · Загрузок 7
Квантованная версия INT6 (W6A8) H3 Image с той же страницы, размер 15.61 ГБ, занимает промежуточное положение между INT8 и INT4, в официальном репозитории Comfy этот вариант отсутствует.
Иллюстрации
【B】MiniMax H3 60-Second Seamless Video Workflow For 12GB GPUs @ 35-Min Gen Times · v1.2
Рабочий процесс · Новая модель · Автор vortis23 · Опубликовано 11-11 12:46 · Загрузок 3
Рабочий процесс длинных видео H3 v1.2, совместимый с видеокартами 12 ГБ: сегментация по временной шкале с помощью узла H3 Motion Director, по словам автора, генерация непрерывного следящего кадра длительностью до одной минуты занимает примерно 35 минут.
Иллюстрации
Только для архива (9)
- (предотвращение «плавления» лиц) MiniMax H3-Image базовый рабочий процесс · базовый рабочий процесс — Рабочий процесс: базовый рабочий процесс генерации изображений H3 Image под названием «Предотвращение плавления лиц»; в описании на странице модели стоит только точка.
- Aliyah Belwyn · MiniMaxH3 — LoRA: LoRA персонажа Aliyah Belwyn (арфистка из Брюгге), созданного автором; перенесена из версий для Anima / ZImageTurbo в H3.
- Minimax H3 Image INT8/INT6/INT4 · Minimax H3 IMAGE INT4 — Базовая модель / Checkpoint: квантованная версия H3 Image INT4 (W4A8 GPTQ) с той же страницы, размером 12.77 ГБ; самая маленькая из трёх вариантов, экономит только видеопамять, но не ускоряет работу.
- MiniMax-H3-Image · v1.0 — Рабочий процесс: рабочий процесс генерации изображений под названием MiniMax-H3-Image; в описании указаны только заголовок и «v1».
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — Рабочий процесс: простой рабочий процесс, адаптированный для H3 Image на основе рабочего процесса генерации изображений Qwen 2.1; в названии упоминается более быстрый апсемплер промптов.
- Esmae Belwyn · MiniMaxH3 — LoRA: LoRA персонажа Esmae Belwyn (флористка у каналов Брюгге), созданного автором; перенесена из версии для MOSS Image в H3.
- Faye Belwyn · MiniMaxH3 — LoRA: LoRA персонажа Faye Belwyn (реставратор старинных тканей из Брюгге), созданного автором; перенесена из версий для Krea 2 / ZImageTurbo / MOSS Image в H3.
- Anaya Von Vergin · MiniMaxH3 — LoRA: LoRA персонажа Anaya Von Vergin (музейный куратор из Оксфорда), созданного автором; перенесена из множества версий, включая SDXL, Flux, Anima и MOSS Image, в H3.
- Ruth Belwyn · MiniMaxH3 — LoRA: LoRA персонажа Ruth Belwyn (переплётчица из Брюгге), созданного автором; версия для H3, опубликованная одновременно с версией для Krea 2.
Данные: открытый API Civitai (базовая модель MiniMax H3), период сбора 11-10 20:31 → 11-11 13:03 (пекинское время). Рекомендации проверены редакцией; количество загрузок отражает только уровень интереса.