Radar IA de Zhenzhen · MiniMax H3 · 2026-11-14 Le Soir
Cette édition compte 9 nouvelles versions : fortement recommandées 1 · recommandées 3 · à suivre 2 · incluses uniquement 3
Note de l'éditeur Cette édition examine 9 nouvelles versions de H3, avec 1 S, 3 A, 2 B et 3 C. La première recommandation est le troisième curseur d'éclair en chaîne de la suite d'effets spéciaux KinetiX : une valeur positive fait rebondir l'éclair entre plusieurs cibles, tandis qu'une valeur négative le maintient au point d'impact, sans mot-clé déclencheur. Les deux LoRA d'accélération 3–4 étapes de CROWN HyperPDMD (version image-fin/image-début et version référence multi-images avec synchronisation labiale) ont des paramètres complets, passant automatiquement de B à A ; les LoRA audio pour accents féminins sont divisés en un fichier par accent, classés A. Les deux LoRA de personnages originaux n'ont rien de particulier et la plupart des exemples sont masqués, ils sont donc rétrogradés en C ; la requantification de l'encodeur de texte ne constitue pas une nouvelle capacité, elle est classée C.
Fortement recommandées (1)
【S】KinetiX Elemental VFX Suite · Chain Lightning V1.0
LoRA · Mise à jour de version · Auteur make676767 · Publié le 11-14 14:06 · Téléchargements 71
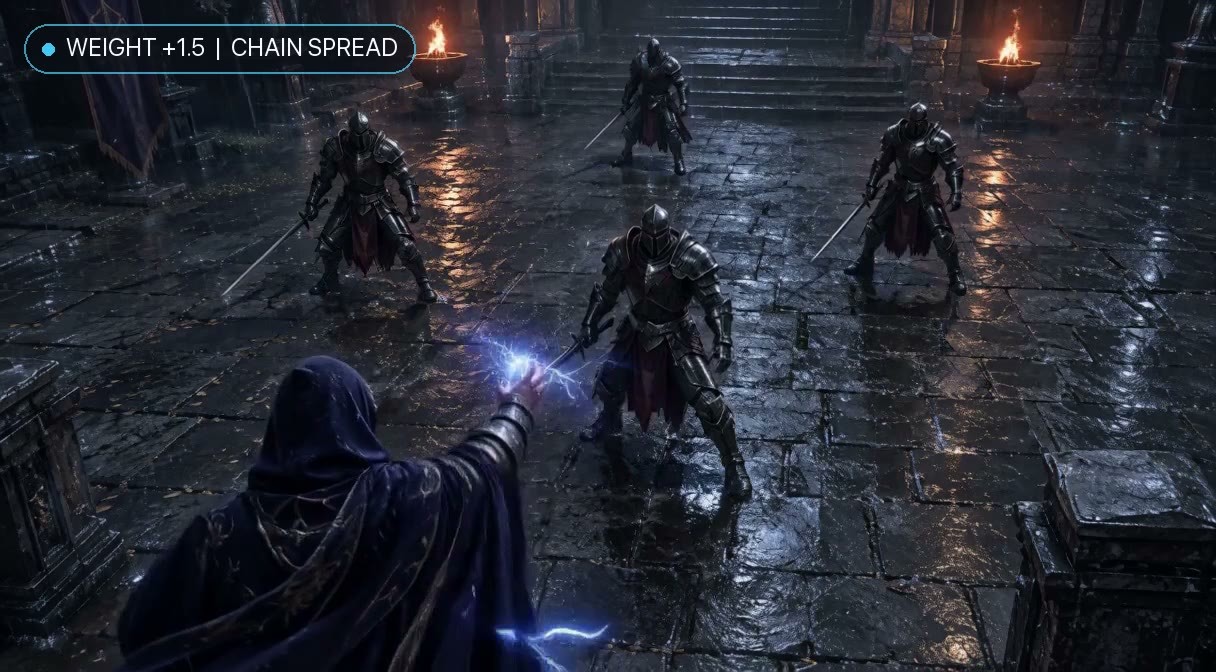
Un LoRA avec un curseur d'éclair en chaîne pouvant être positif ou négatif : une valeur positive fait rebondir l'éclair entre les personnes et objets métalliques à proximité après avoir touché la première cible, tandis qu'une valeur négative maintient le courant au point d'impact sans débordement.
Illustration
Raisons de la recommandation
- Le troisième effet de la série d'effets spéciaux élémentaires KinetiX (les deux premiers étant Fire Spread et Freeze Speed), ce n'est pas une mise à jour d'un ancien effet ; les notes de version constituent l'introduction de cet effet.
- Sert aux plans magiques, de combat et de surcharge scientifique dans la génération vidéo à partir de texte : aucun mot-clé déclencheur nécessaire ; l'auteur affirme que la couleur n'est pas verrouillée, il suffit d'indiquer un éclair cyan, écarlate, violet ou doré dans le prompt pour changer la couleur.
- Faisable en pratique : l'auteur fournit des paliers d'intensité et 4 prompts de scène directement copiables (incluant une comparaison avec une valeur négative unique), ainsi que 4 vidéos d'exemple visibles ; le fichier ne pèse que 7 Mo, la licence autorise les dérivés.
Comment l'utiliser
- Après avoir chargé le LoRA, ajustez strength_model : à partir de +1.0, un enchaînement multi-cibles apparaît, et plus haut, un réseau électrique à grande échelle ; 0 correspond à des étincelles locales normales ; de -1.2 à -5, le courant est verrouillé sur un point unique sans débordement ; aucun mot-clé déclencheur n'est nécessaire.
- Dans le prompt, précisez la première cible touchée, les personnes ou objets métalliques environnants pouvant être enchaînés (soldats, armures, mechas, caisses de marchandises, etc.) et la couleur de l'éclair ; un fichier compressé de ressources de workflow est également fourni.
Risques et limitations
- Le tableau d'intensité de l'auteur est incohérent : la description en anglais indique une zone optimale de +1.0 à +5 et une zone de surcharge de +1.8 à +2.5, avec chevauchement des deux zones ; la description en chinois indique une zone optimale de +1.0 à +1.6 et une zone de surcharge de +1.8 à +5. Il est conseillé d'essayer à partir d'environ +1.
- 3 exemples sont masqués (contenu mixte) ; la version du modèle de base et le nombre d'étapes ne sont pas indiqués par l'auteur dans les instructions (ils pourraient se trouver dans le fichier compressé joint, non vérifié).
Recommandées (3)
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - Ref2VA Multi-Ref & Lip-Sync (3-4 Step r38)
LoRA · Nouveau modèle · Auteur NineCrowns · Publié le 11-14 14:39 · Téléchargements 119
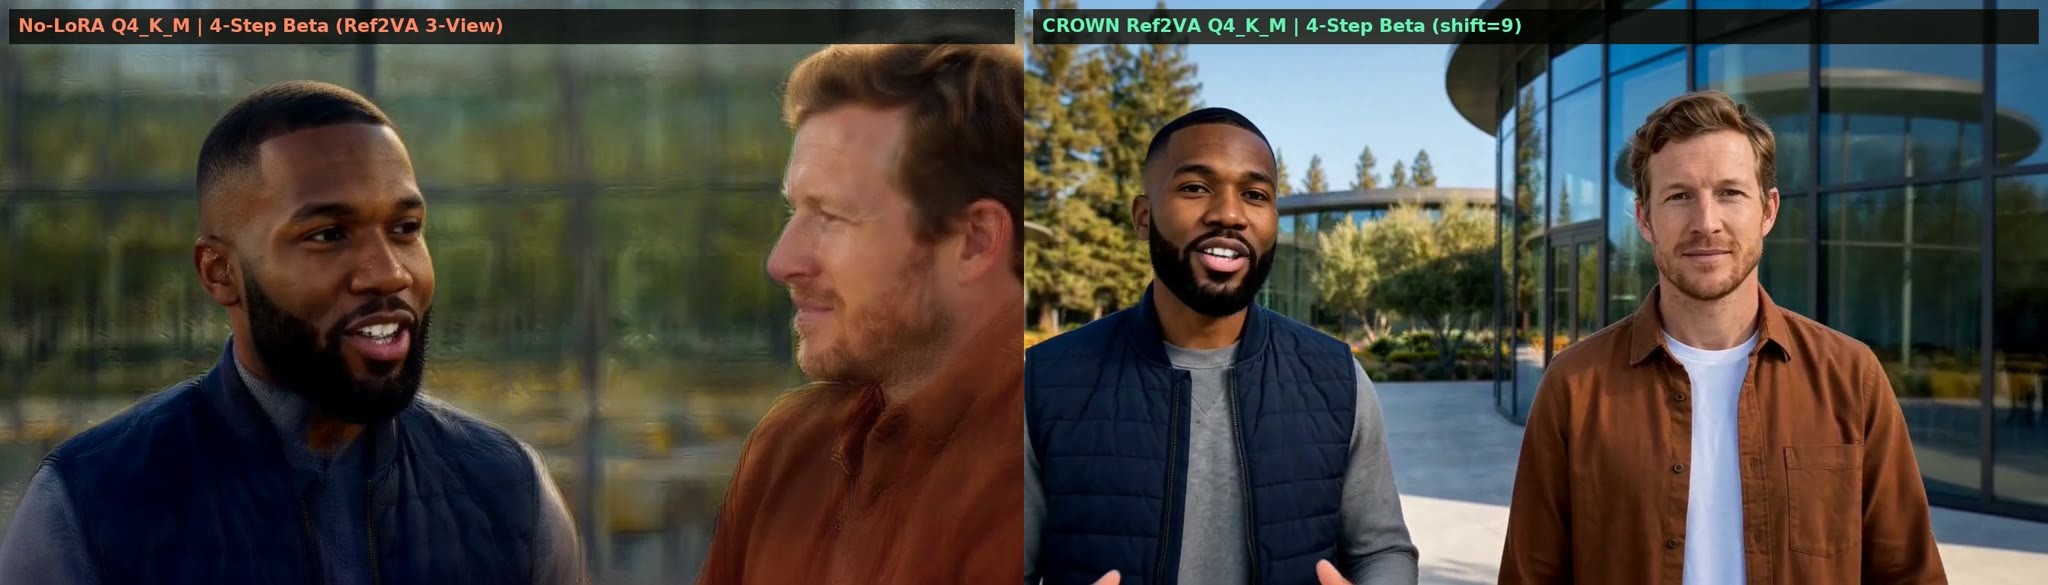
La version Ref2VA du même LoRA d'accélération 3–4 étapes : utilisée pour la référence multi-images de sujets (images sous plusieurs angles du personnage plus une image de scène) et la synchronisation labiale audio, l'auteur affirme une durée maximale de 15 secondes, avec compatibilité pour les modèles de base BF16, INT8 et GGUF Q4.
Illustration
Raisons de la recommandation
- Deux versions du même modèle avec la version FL2VA : cette version est uniquement compatible avec les modèles de base Ref2VA, servant à la génération vidéo à partir d'images de référence et à la synchronisation labiale, sans gestion des images début/fin ; le fichier pèse 340.3 Mo, l'auteur affirme qu'il provient du mélange et de la compression de points de contrôle entraînés sur 2000 étapes.
- Les paramètres sont identiques à ceux de la version FL2VA : intensité 1.0 (0.95 à 1.05), Euler, CFG 1.0, 3 ou 4 étapes ; l'auteur recommande également de définir la taille des images de référence sur max et shift_video sur 9.0 pour améliorer la clarté des scènes avec plusieurs personnages.
- 2 vidéos et 1 images sont visibles ; passage automatique de B à A.
Comment l'utiliser
- Utilisez un modèle de base Ref2VA : si la mémoire vidéo est inférieure à 9 Go, utilisez le GGUF Q4_K_M avec UnetLoaderGGUFAdvanced (définissez patch_dtype sur target), ou pruned int8 convrot ou BF16.
- Intensité du LoRA 1.0, euler + BetaSamplingScheduler, CFG 1.0, 3 ou 4 étapes ; définissez ref_image_size sur max dans MiniMaxH3ReferenceToVideo et shift_video sur 9.0 dans MiniMaxH3SigmaShift.
Risques et limitations
- L'auteur fournit une plage de 9.0 à 12.0 pour shift_video, tandis que shift_audio 3.0 et les paramètres alpha / beta du planificateur Beta 0.6 ne sont indiqués que dans la fiche modèle complète.
- Forte composante promotionnelle : les portraits au niveau des pores, la distillation de 8 B200, etc., sont des affirmations de l'auteur, sans exemples comparatifs sans LoRA.
- La synchronisation labiale et la référence à des photos réelles nécessitent le consentement de la personne concernée, attention aux droits à l'image ; le fichier compressé du workflow est téléversé sous le type "données d'entraînement", le scan de sécurité n'est pas terminé.
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - FL2VA / I2VA / T2VA (3-4 Step r38)
LoRA · Nouveau modèle · Auteur NineCrowns · Publié le 11-14 14:39 · Téléchargements 72
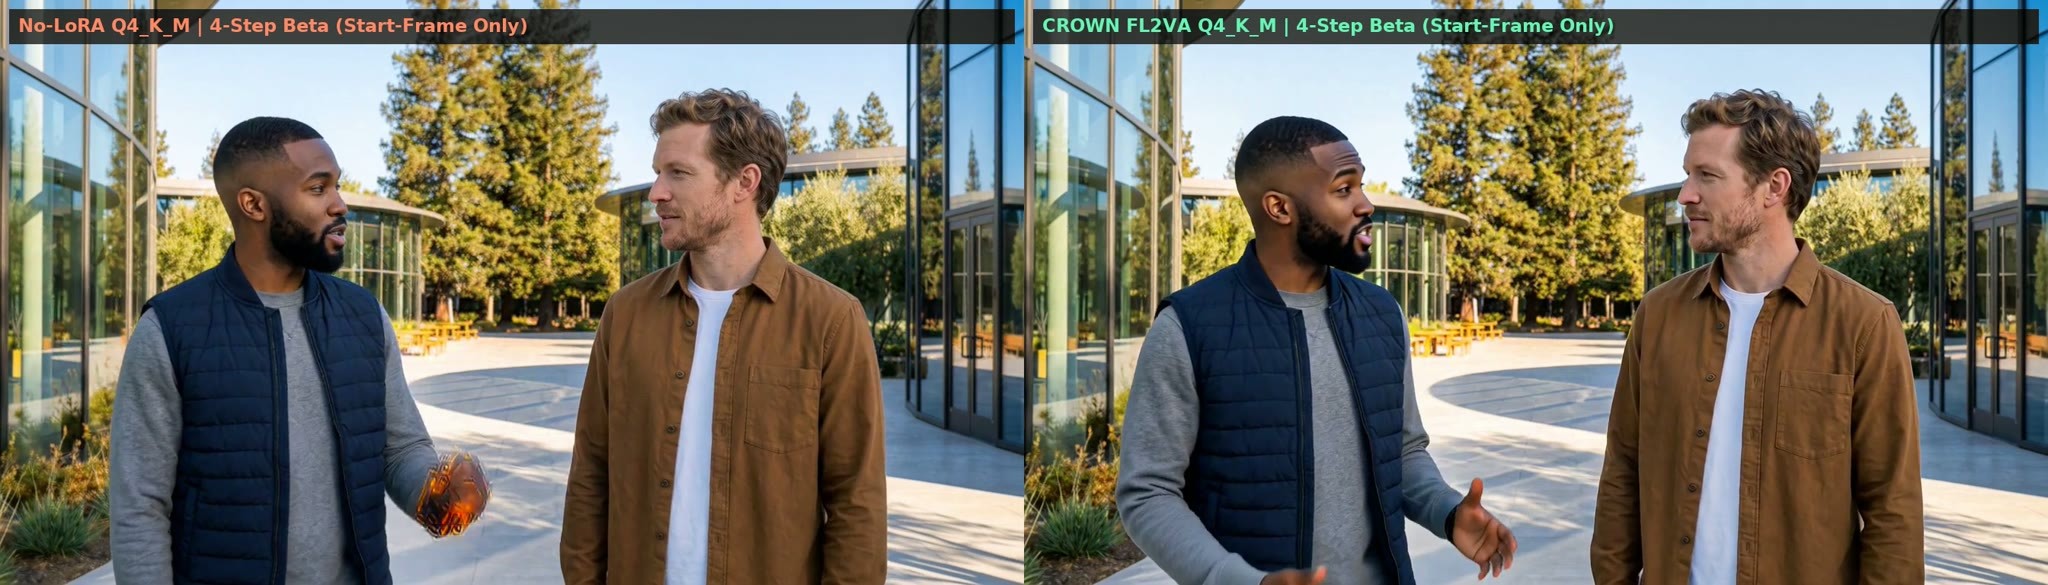
Le LoRA d'accélération 3–4 étapes pour H3 (version FL2VA) : utilisé pour la génération vidéo à partir de texte, la génération vidéo à partir d'une image unique et les images début/fin, l'auteur affirme que le même fichier peut être appliqué aux modèles de base BF16, INT8 et GGUF Q4, réduisant le flou dû à la quantification basse précision.
Illustration
Raisons de la recommandation
- L'une des deux versions du nouveau modèle : cette version est compatible avec les modèles de base FL2VA, couvrant T2V, I2V et les images début/fin, l'auteur affirme une durée maximale de 15 secondes ; l'autre version est uniquement compatible avec Ref2VA (référence multi-images et synchronisation labiale), les deux ne sont pas interchangeables.
- L'auteur affirme que sans LoRA, lors d'une exécution directe en 3–4 étapes, l'image reste fixe pour I2V à partir d'une image unique, les visages deviennent flous pour T2V pur, et des fantômes apparaissent au milieu pour les images début/fin ; ce LoRA utilise la distillation HyperPDMD, perturbant alternativement les modèles de base Q4_K_M, ConvRot INT8 et BF16 pendant l'entraînement.
- Paramètres complets et exemples visibles : intensité 1.0 (0.95 à 1.05), Euler, CFG 1.0, 3 ou 4 étapes ; 3 vidéos et 2 images sont visibles ; le fichier pèse 347 Mo, avec un fichier compressé de workflow ComfyUI joint ; passage automatique de B à A.
Comment l'utiliser
- Utilisez un modèle de base FL2VA : si la mémoire vidéo est inférieure à 9 Go, utilisez le GGUF Q4_K_M avec UnetLoaderGGUFAdvanced (définissez patch_dtype sur target), sinon utilisez pruned int8 convrot ou BF16.
- Intensité du LoRA 1.0 ; SamplerCustomAdvanced + BasicGuider (CFG 1.0) + euler + BetaSamplingScheduler, 3 ou 4 étapes, suivi de MiniMaxH3SigmaShift.
Risques et limitations
- Les paramètres d'échantillonnage s'écartent des normes et sont indiqués dans la seconde moitié de la fiche modèle complète : pour cette version, shift_video 12.0, shift_audio 3.0, les paramètres alpha / beta du planificateur Beta 0.6 ; leur omission peut empêcher d'atteindre l'effet des exemples.
- Forte composante promotionnelle : une amélioration de la clarté de 6.5 à 10 fois, la distillation de 8 B200, la conservation de 99.96% d'énergie sont des affirmations de l'auteur, sans exemples comparatifs sans LoRA ni comparaison avec les LoRA Turbo existants.
- Le fichier compressé du workflow est téléversé sous le type "données d'entraînement", le scan de sécurité n'est pas terminé.
【A】Minimax Female Accents · 1.1
LoRA · Mise à jour de version · Auteur imb101 · Publié le 11-14 10:00 · Téléchargements 173
Un LoRA d'accents féminins agissant uniquement sur l'audio : v1.1 divise les accents précédemment mélangés dans un seul fichier en un LoRA par accent, et ajoute les accents de Liverpool et du Minnesota.
Illustration
Raisons de la recommandation
- Mise à jour de version : l'auteur affirme que l'ancien modèle unique mélangeait plusieurs accents, et qu'en les séparant, les accents sont plus précis ; il y a maintenant 5 fichiers au total : Utah, Atlanta, New Jersey, Liverpool, Minnesota.
- Sert aux vidéos avec dialogues en anglais (génération à partir de texte ou d'image) : l'auteur affirme que les accents intégrés à H3 sont plats, ce groupe de LoRA entraîne uniquement la partie audio sans toucher à la partie vidéo, n'affectant pas l'image.
- L'auteur a publié les données d'entraînement de la première version : 66 segments audio, 22 segments par accent, étiquetés automatiquement avec Qwen ASR.
Comment l'utiliser
- Chargez le fichier correspondant à l'accent souhaité, intensité 0.6–0.8 (l'ancienne version recommandait 0.4–0.5), définissez audio sampling sur 3 ; si des sons de voix cassée (vocal fry) étranges apparaissent, augmentez audio sampling.
- Les prompts sont identiques à ceux de l'ancienne version : après le dialogue, écrivez in a <nom de l'accent> accent, par exemple The woman says <d>[English]…</d> in a atlanta accent.
Risques et limitations
- Après la division, une seule génération ne peut utiliser qu'un seul accent, les dialogues entre deux personnes avec des accents différents ne sont pas possibles.
- L'auteur affirme être encore loin de la précision parfaite, n'étant toujours pas sûr pour l'accent de l'Utah ; uniquement pour les accents féminins ; 1 vidéos d'exemple sont visibles, 4 sont masquées (contenu mixte).
- Chaque fichier d'accent pèse environ 296 Mo ; la licence interdit les dérivés.
À suivre (2)
【B】Tap to Screen — Clip vidéo avec synchronisation labiale MiniMax H3 sur votre propre chanson (chronologie multi-scènes) · v1.3.2
Flux de travail · Mise à jour de version · Auteur koyan0418439 · Publication 11-14 13:56 · Téléchargements 34
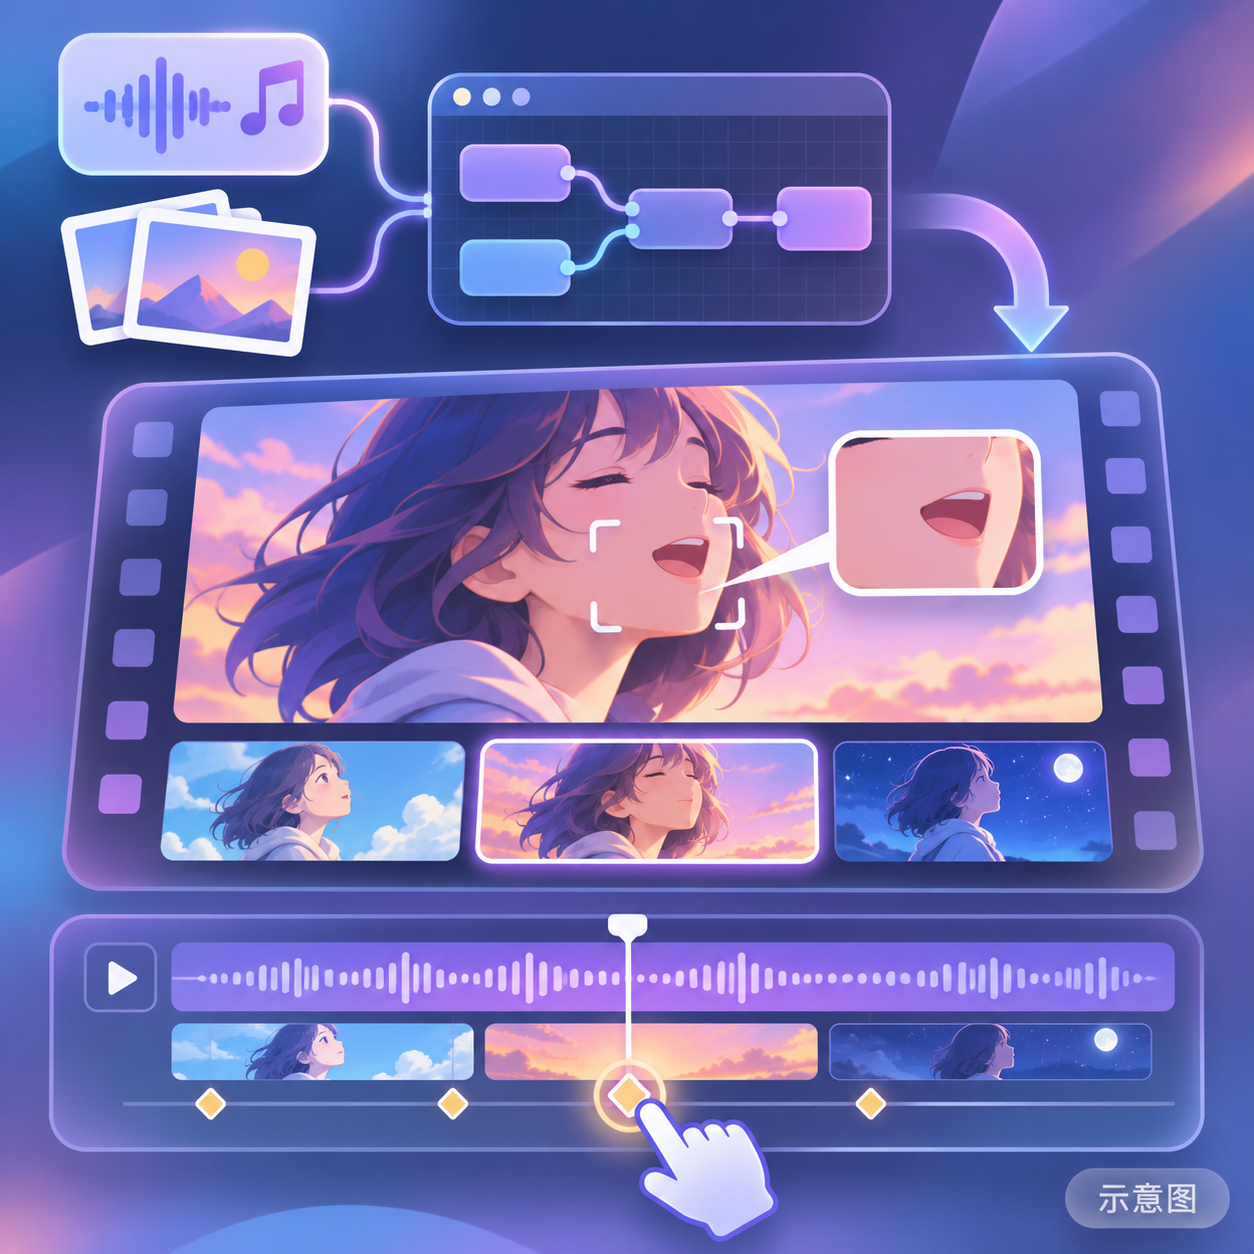
Un flux de travail chronologique pour créer des clips vidéo avec synchronisation labiale multi-scènes à partir de votre propre chanson et d'images ; v1.3.2 ajoute uniquement l'exportation destinée aux logiciels de montage : masters ProRes / FFV1 et segments découpés par scène.
Illustration
Raisons de la recommandation
- Mise à jour de version, la chronologie et la partie génération restent inchangées : le nœud Join from files et le bouton Export en haut de la chronologie ajoutent les formats ProRes 422 HQ, ProRes 4444 (10 bits, audio PCM) et le master sans perte FFV1, encodés une seule fois directement à partir des images originales ; le format par défaut h264 (crf 18) est identique à celui d'avant
- scene_clips sort chaque scène séparément (incluant les images supplémentaires après les points de coupe et la partie correspondante de la chanson), et joint un fichier scenes.csv enregistrant l'heure de début de chaque segment dans la vidéo et la chanson, permettant de réaliser les transitions soi-même dans Resolve ou Premiere
- L'écriture des fichiers est plus stable : horodatage explicite, dossier séparé pour chaque exécution, arrêt anticipé en cas d'espace disque insuffisant, les exécutions échouées ne laissent pas de fichiers incomplets
- L'outil lui-même : appuyez sur C pendant la lecture de la chanson pour couper les scènes, appuyez sur S pour marquer les intervalles chantés, chaque partie de la chanson est envoyée à H3 pour la synchronisation labiale sous forme de <Audio 1>, jusqu'à 4 images de personnages pour maintenir la cohérence visuelle
Comment l'utiliser
- Copiez custom_nodes/ComfyUI-H3Timeline dans le dossier custom_nodes de ComfyUI et redémarrez → Glissez-déposez le flux de travail depuis workflows → Cliquez sur Timeline en bas à gauche du canevas pour charger la chanson et les images → Exécutez ; pour obtenir des masters destinés au montage, sélectionnez l'encodage dans Export en haut de la chronologie et cochez un segment par scène
- Les modèles listés par l'auteur : modèle principal H3 ref2va pruned int8, LoRA turbo 4 étapes pour ref2v, encodeur de texte Qwen3-VL nvfp4, VAE vidéo et audio
Risques et limitations
- Cette version n'apporte aucune amélioration à l'image ou à la synchronisation labiale ; ceux qui n'ont pas besoin de montage externe peuvent continuer à utiliser v1.3.1
- Le seul exemple est masqué, il n'y a pas d'exemple visible
- ProRes 4444 ne prend pas en charge le canal alpha, les images sources restent en 8 bits ; le master FFV1 occupe un espace disque proportionnel à la taille des images originales
- L'illustration de la carte est un schéma généré par IA, ce n'est pas le rendu réel du modèle ; l'auteur ne propose pas d'exemples publics de qualité standard
【B】Score to Screen — Chansons, voix et scènes : un studio de clip vidéo (YuE2 × MiniMax H3) · v9.0
Flux de travail · Mise à jour de version · Auteur koyan0418439 · Publication 11-14 19:06 · Téléchargements 14
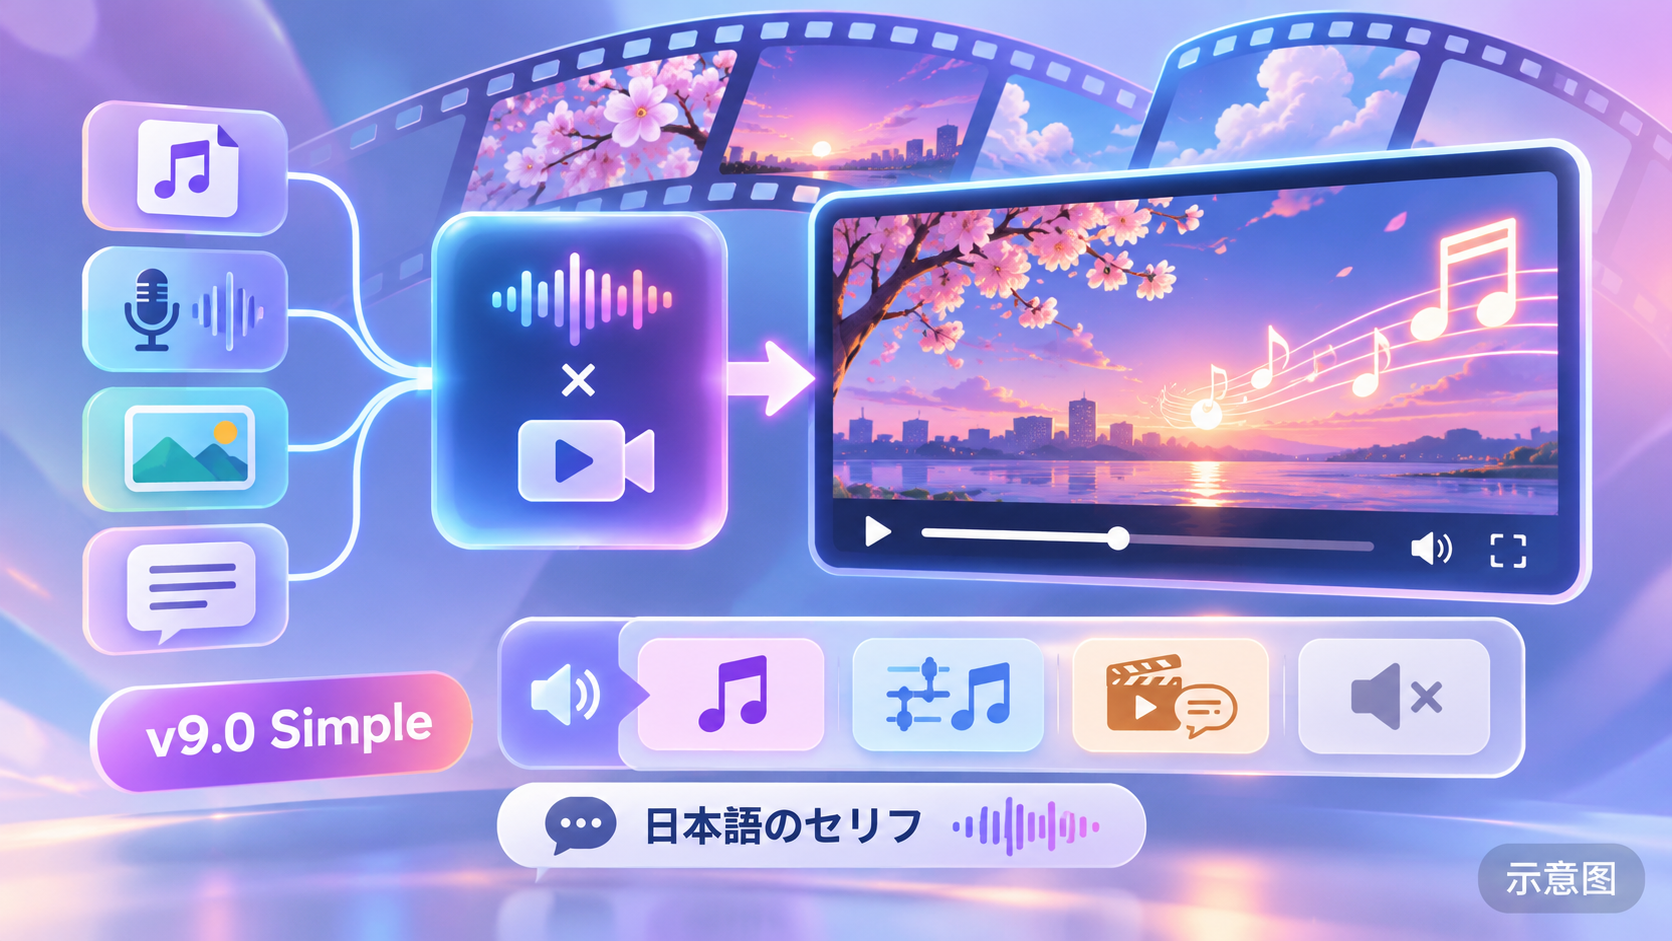
Un flux de travail qui utilise YuE2 pour composer et chanter, et H3 pour générer un clip vidéo multi-scènes avec synchronisation labiale à partir d'une simple invite et de quelques images ; v9.0 permet de choisir le son pour chaque scène individuellement : chanson, dialogue et sons ambiants générés par H3, chanson plus ambiance, ou silence.
Illustration
Raisons de la recommandation
- Mise à jour de version (par rapport à v8.2) : les cadres de scène dans la chronologie ajoutent l'option This scene's sound ; si vous sélectionnez H3's sound, aucune chanson n'est jouée pour cette scène, les répliques entre guillemets sont prononcées telles quelles par le personnage désigné, les autres se taisent ; la chanson continue en arrière-plan et reprend ensuite, la durée totale et les points de coupe restent inchangés, avec un fondu de 0.25 s à l'entrée et à la sortie
- Les dialogues japonais contenant des kanji sont réécrits en hiragana par le LLM intégré au flux de travail avant d'être envoyés à H3 (l'auteur indique que H3 lit mal les kanji) ; ajout du volume global pour la chanson et les sons H3 ; l'option Song + ambience nécessite une exécution supplémentaire uniquement pour le son sur la même scène, ce qui double approximativement le temps de traitement
- L'outil lui-même : un LLM local décompose l'invite en étiquettes de style YuE2, paroles et invites H3 par scène, jusqu'à 64 scènes, les points de coupe tombant sur les mesures musicales, le moteur H3 peut être Standard (20 étapes), Turbo ou FastH3 Omni (8 étapes)
Comment l'utiliser
- Après décompression, copiez les 4 dossiers de custom_nodes dans ComfyUI/custom_nodes, installez également ComfyUI-Video-Saver, et exécutez pip install demucs dans l'environnement Python de ComfyUI, puis rechargez le flux de travail après redémarrage
- Sélectionnez le son pour chaque scène dans la chronologie ; écrivez les dialogues sous forme de phrases entre guillemets avec l'orateur désigné, par exemple The silver-haired woman says: "…" ; la valeur par défaut reste Song, les sons des projets v8.2 restent inchangés
Risques et limitations
- Dépendances lourdes : modèles YuE2, LLM local (téléchargement automatique de llama-server et du modèle par défaut Qwen3-VL 4B lors de la première utilisation), 4 paquets de nœuds personnalisés, Demucs ; la synchronisation avec les percussions nécessite également l'installation de STRUM
- Le seul exemple (vidéo de couverture) est masqué, il n'y a pas d'exemple visible ; l'auteur décrit cela comme un flux de travail expérimental personnel
- L'auteur indique qu'il faut 2000 s pour une scène de 13.8 secondes avec le moteur Standard sur une RTX 5060 Ti 16 GB, et 458 s avec FastH3 Omni NVFP4
- L'illustration de la carte est un schéma généré par IA, ce n'est pas le rendu réel du modèle ; l'auteur ne propose pas d'exemples publics de qualité standard
Inclus uniquement (3)
- Zaynab Von Vergin · MiniMaxH3 — LoRA : LoRA de personnage pour Zaynab Von Vergin, un personnage fictif original (issue d'une famille noble d'Oxford, gérant une boutique de haute couture dans un appartement parisien).
- Faith NordhavenLove · MiniMaxH3 — LoRA : LoRA de personnage pour Faith NordhavenLove, un personnage fictif original (assistante gardienne de phare sur un cap suédois, portant souvent un manteau en laine bleu marine et un bonnet tricoté).
- Qwen for MinimaxH3 & Image (Updated Fast Scaled) · Scaled_Comfy_Quant — Encodeur de texte : une autre version quantifiée de l'encodeur de texte Qwen3-VL 32B utilisé par H3 : précision mixte FP32 / FP16 / INT8, fichier unique de 26.2 GB.
Données : API publique Civitai (modèle de base MiniMax H3), fenêtre d'inclusion du 11-14 08:48 au 11-14 21:01 (heure de Pékin). Les raisons de la recommandation ont été revues par la rédaction ; le nombre de téléchargements reflète uniquement l'intérêt porté.