貞貞のAIレーダー · MiniMax H3 · 2026-11-14 夕刊
今号の 9 個の新バージョン:強く推奨 1 · 推奨 3 · 注目すべき 2 · 収録のみ 3
編集者按 今号では 9 個の H3 新バージョンをレビューしました。S が 1 個、A が 3 個、B が 2 個、C が 3 個です。初推めは KinetiX エフェクトスイートの3番目の連鎖稲妻スライダーです:正の値では稲妻が複数のターゲット間をリレーのように跳ね渡り、負の値ではヒット地点で停止し、トリガーワードは不要です。CROWN HyperPDMD の2つの 3–4 ステップ高速化 LoRA(最初のフレーム/画像から動画生成版と複数画像参照リップシンク版)はパラメータが完備しており、自動 B から A に昇格しました。女性アクセント音声 LoRA は、各アクセントごとに1ファイルに分割され、A に分類されました。2つのオリジナルキャラクター LoRA は特筆すべき点がなく、サンプルの多くが非表示のため、C に降格しました。テキストエンコーダの再量子化は新機能とは見なされないため、C に分類されました。
強く推奨(1)
【S】KinetiX Elemental VFX Suite · Chain Lightning V1.0
LoRA · バージョン更新 · 作者 make676767 · 公開 11-14 14:06 · ダウンロード 71
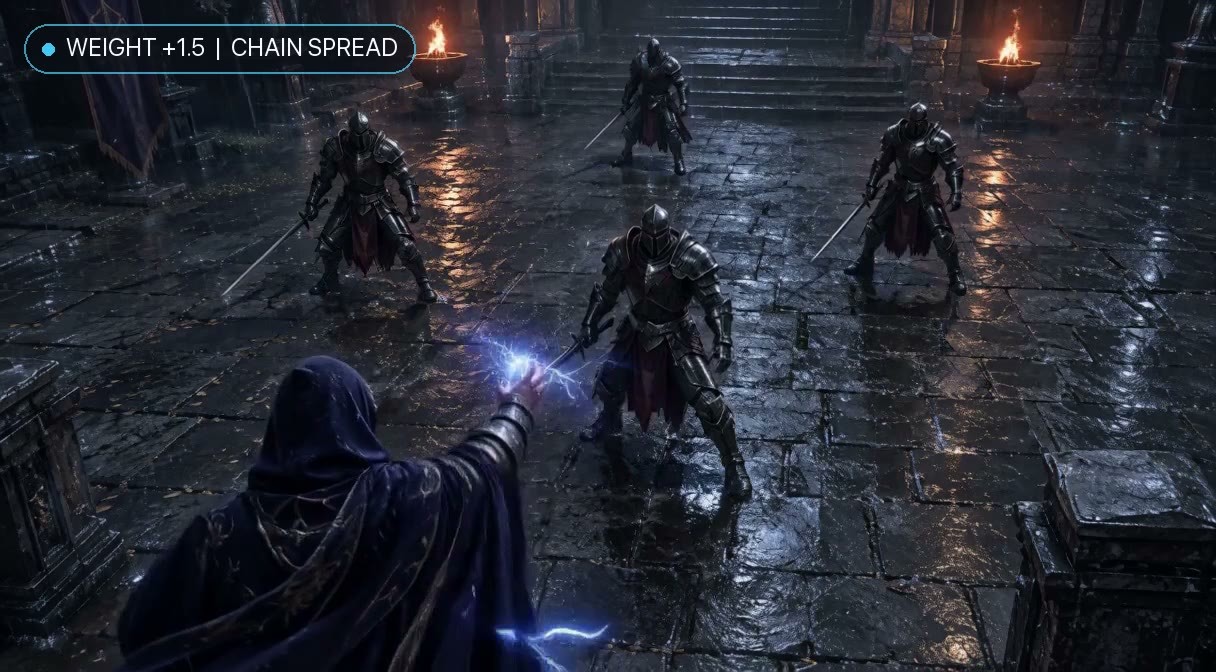
正負両方の値を設定できる連鎖稲妻スライダー LoRA:正の値では、稲妻が最初のターゲットに命中した後、周囲の人物や金属物体の間をリレーのように跳ね渡り、負の値では電流がヒット地点で留まり、外側に漏れ出さないようにします。
画像
推奨理由
- KinetiX 元素エフェクトシリーズの3番目のエフェクト(前2つは Fire Spread と Freeze Speed)であり、既存エフェクトの更新ではありません。バージョン説明は本エフェクトの紹介そのものです
- テキストから動画生成における魔法、戦闘、SF的な過負荷シーンに対応:トリガーワードは不要。作者によれば色は固定されておらず、プロンプトにシアン、スカーレット、パープル、またはゴールドの稲妻と記述すれば色を変更できます
- 再現可能:作者は強度の段階分けと、そのままコピー可能な 4 件のシーン用プロンプト(負の値による単一点の対照を含む)を提供しており、4 本のサンプル動画が確認可能です。ファイルサイズはわずか 7 MB で、ライセンスは派生物の作成を許可しています
使い方
- LoRA を読み込んだ後、strength_model を調整します:+1.0 から複数ターゲットの連鎖が発生し、さらに上げると広範囲の電網になります。0 は通常の局所的な火花です。-1.2 から -5 では単一点に固定され、外側に漏れません。トリガーワードは不要です
- プロンプトには、最初に命中するターゲット、周囲で連鎖可能な人物や金属物体(兵士、鎧、メカ、貨物箱など)、および稲妻の色を明確に記述します。別途、workflow resources の圧縮ファイルが付属しています
リスクと制限
- 作者の強度表に一貫性がありません:英語の説明ではスイートスポットが +1.0 ~ +5、過負荷モードが +1.8 ~ +2.5 と記述されており、両者が重複しています。中国語の説明ではスイートスポットが +1.0 ~ +1.6、+1.8 ~ +5 が過負荷モードとされています。+1 付近から上げて試すことを推奨します
- 3 件のサンプルが非表示です(混合コンテンツ)。ベースモデルのバージョンやステップ数については、作者は説明に明記していません(付属の圧縮ファイル内にある可能性がありますが、未確認です)
推奨(3)
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - Ref2VA Multi-Ref & Lip-Sync (3-4 Step r38)
LoRA · 新モデル · 作者 NineCrowns · 公開 11-14 14:39 · ダウンロード 119
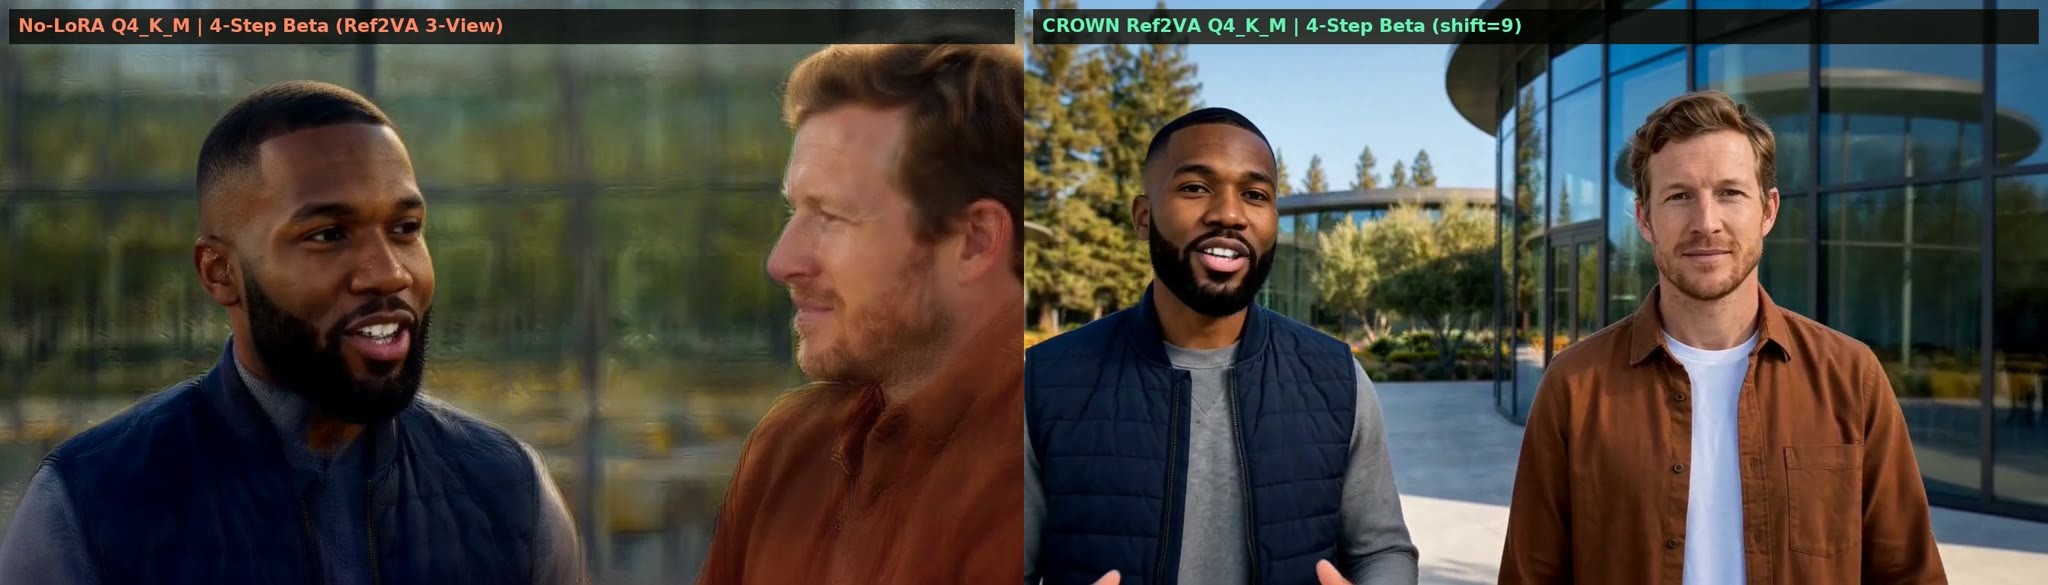
同じ 3–4 ステップ高速化 LoRA の Ref2VA 版です:複数画像による主体参照(キャラクターの多角度画像とシーン画像)および音声によるリップシンクに使用します。作者によれば、最長 15 秒まで対応し、BF16、INT8、GGUF Q4 のベースモデルと互換性があります。
画像
推奨理由
- FL2VA 版と同じモデルの2つのバージョンのうちの1つです:本バージョンは Ref2VA ベースモデル専用で、参照画像からの動画生成とリップシンクに対応し、最初のフレーム/最後のフレームには対応しません。ファイルサイズは 340.3 MB で、作者によれば 2000 ステップで訓練されたチェックポイントを混合・圧縮して作成されました
- パラメータは FL2VA 版と同じです:強度 1.0(0.95 ~ 1.05)、Euler、CFG 1.0、3 または 4 ステップ。作者はさらに、参照画像のサイズを max に設定し、shift_video を 9.0 に設定することで、複数人物の鮮明度を向上させると推奨しています
- 2 本の動画と 1 枚の画像が確認可能です。自動 B から A に昇格しました
使い方
- ベースモデルには Ref2VA を使用します:VRAM が 9 GB 未満の場合は、Q4_K_M の GGUF を UnetLoaderGGUFAdvanced(patch_dtype を target に設定)と組み合わせて使用するか、pruned int8 convrot または BF16 を使用できます
- LoRA の強度は 1.0、euler + BetaSamplingScheduler、CFG 1.0、3 または 4 ステップ。MiniMaxH3ReferenceToVideo の ref_image_size を max に設定し、MiniMaxH3SigmaShift の shift_video を 9.0 に設定します
リスクと制限
- 作者が提示した shift_video は 9.0 ~ 12.0 の範囲ですが、shift_audio 3.0、Beta スケジューラの alpha / beta 0.6 は完全なモデルカードにのみ記載されています
- 宣伝色が強いです:毛穴レベルのポートレート、8 枚の B200 蒸留などはすべて作者の自己申告であり、LoRA なしの対照サンプルがありません
- リップシンクや実在人物の参照には本人の同意が必要であり、肖像権に注意してください。ワークフローの圧縮ファイルは「訓練データ」タイプとしてアップロードされており、セキュリティスキャンは完了していません
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - FL2VA / I2VA / T2VA (3-4 Step r38)
LoRA · 新モデル · 作者 NineCrowns · 公開 11-14 14:39 · ダウンロード 72
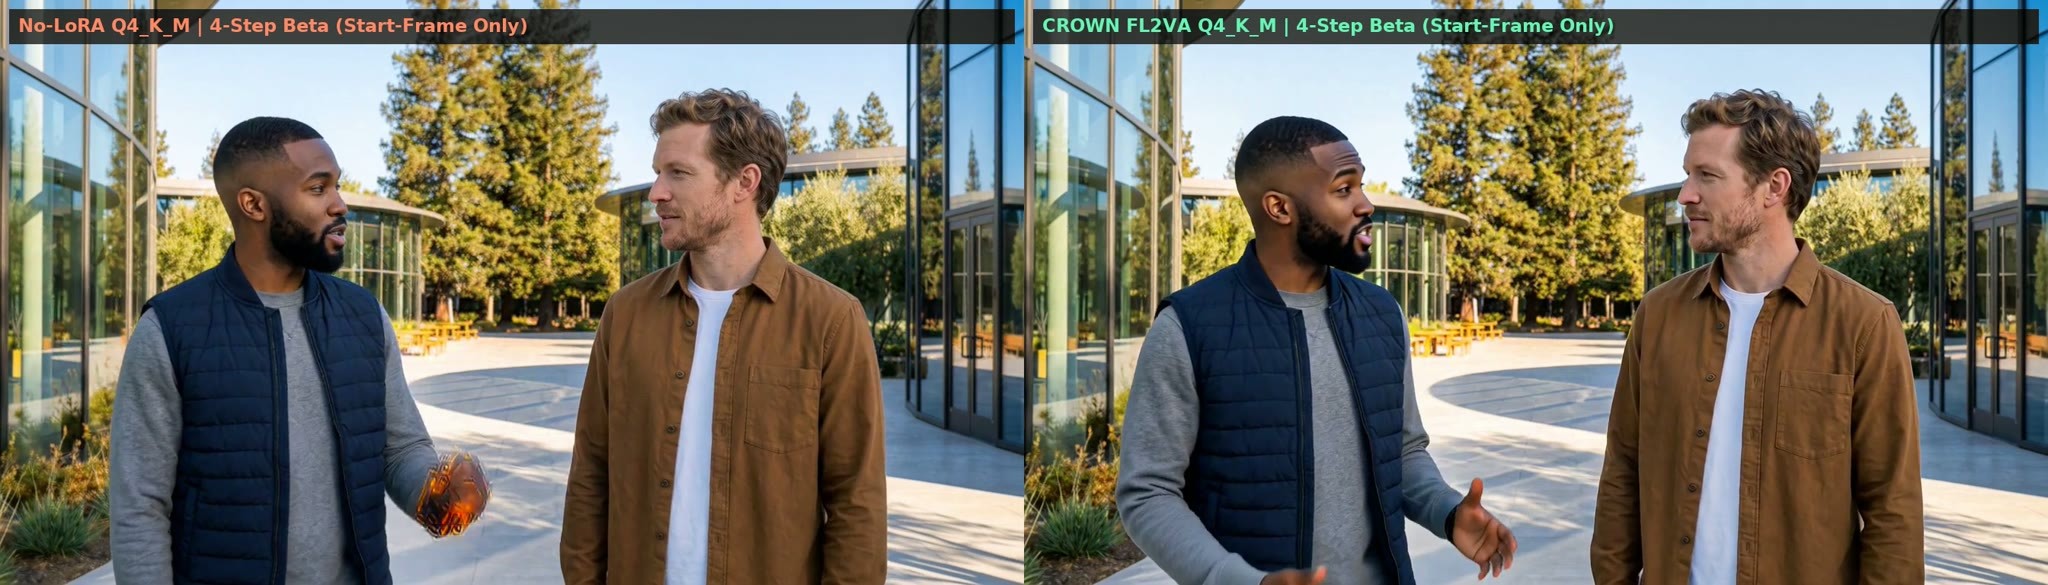
H3 用の 3–4 ステップ高速化 LoRA(FL2VA 版)です:テキストから動画生成、単一画像から動画生成、および最初のフレーム/最後のフレームに対応します。作者によれば、同じファイルを BF16、INT8、GGUF Q4 のベースモデルに適用でき、低ビット量子化によるぼやけを軽減します。
画像
推奨理由
- 新モデルの2つのバージョンのうちの1つです:本バージョンは FL2VA ベースモデルに対応し、T2V、I2V、および最初のフレーム/最後のフレームをカバーします。作者によれば、最長 15 秒まで対応します。もう1つのバージョンは Ref2VA 専用(複数画像参照とリップシンク)であり、両者は互換性がありません
- 作者によれば、LoRA なしで直接 3–4 ステップを実行すると、単一画像の I2V では画面が動かず、純粋な T2V では顔がぼやけ、最初のフレーム/最後のフレームでは中間部分にゴーストが発生します。本 LoRA は HyperPDMD 蒸留を使用し、訓練時に Q4_K_M、ConvRot INT8、BF16 のベースモデルを交互に乱して行います
- パラメータが完備しており、サンプルが確認可能です:強度 1.0(0.95 ~ 1.05)、Euler、CFG 1.0、3 または 4 ステップ。3 本の動画と 2 枚の画像が確認可能です。ファイルサイズは 347 MB で、ComfyUI ワークフローの圧縮ファイルが付属しています。自動 B から A に昇格しました
使い方
- ベースモデルには FL2VA を使用します:VRAM が 9 GB 未満の場合は、Q4_K_M の GGUF を UnetLoaderGGUFAdvanced(patch_dtype を target に設定)と組み合わせて使用し、VRAM が十分な場合は pruned int8 convrot または BF16 を使用します
- LoRA の強度は 1.0。SamplerCustomAdvanced + BasicGuider(CFG 1.0)+ euler + BetaSamplingScheduler、3 または 4 ステップ、その後 MiniMaxH3SigmaShift を接続します
リスクと制限
- サンプリングパラメータが通常と異なり、完全なモデルカードの後半に記載されています:本バージョンでは shift_video 12.0、shift_audio 3.0、Beta スケジューラの alpha / beta 0.6 です。設定漏れがあると、サンプルのような効果が得られない可能性があります
- 宣伝色が強いです:鮮明度 6.5–10 倍向上、8 枚の B200 蒸留、99.96% エネルギー保持などはすべて作者の自己申告であり、LoRA なしの対照サンプルも、既存の Turbo LoRA との比較もありません
- ワークフローの圧縮ファイルは「訓練データ」タイプとしてアップロードされており、セキュリティスキャンは完了していません
【A】Minimax Female Accents · 1.1
LoRA · バージョン更新 · 作者 imb101 · 公開 11-14 10:00 · ダウンロード 173
音声のみに作用する女性アクセント LoRA です:v1.1 では、以前は1つのファイルに混在していたアクセントを、各アクセントごとに1つの LoRA に分割し、さらにリバプールとミネソタのアクセントを追加しました。
画像
推奨理由
- バージョン更新:作者によれば、旧版の単一モデルでは複数のアクセントが混在していましたが、分割によりアクセントがより正確になりました。現在、Utah、Atlanta、New Jersey、Liverpool、Minnesota の計 5 個のファイルがあります
- 英語のセリフを含む動画(テキストから生成/画像から生成のいずれも可)に対応します:作者によれば、H3 標準のアクセントは平坦になりがちですが、この LoRA 群は音声部分のみを訓練し、動画部分には触れないため、画面に影響しません
- 作者は初版の訓練データを公開しています:66 件の音声、各アクセントあたり 22 件で、Qwen ASR により自動タグ付けされました
使い方
- 必要なアクセントに対応するファイルを読み込み、強度を 0.6–0.8(旧版では 0.4–0.5 が推奨)に設定し、audio sampling を 3 に設定します。奇妙な気泡音(vocal fry)が発生した場合は、audio sampling を上げてください
- プロンプトは旧版と同じです:セリフの後に in a <アクセント名> accent と記述します。例:The woman says <d>[English]…</d> in a atlanta accent
リスクと制限
- 分割後は、1回の生成で1つのアクセントのみ使用可能であり、2人が異なるアクセントで会話するシーンは作成できません
- 作者によれば、正確性にはまだ遠く、Utah のアクセントについては確信が持てていません。女性アクセントのみ対応しています。1 本のサンプル動画が確認可能ですが、4 本は非表示です(混合コンテンツ)
- 各アクセントファイルは約 296 MB です。ライセンスは派生物の作成を禁止しています
注目すべき(2)
【B】Tap to Screen — MiniMax H3 リップシンク MV を自分の曲で作成(マルチシーンタイムライン) · v1.3.2
ワークフロー · バージョン更新 · 作者 koyan0418439 · 公開 11-14 13:56 · ダウンロード数 34
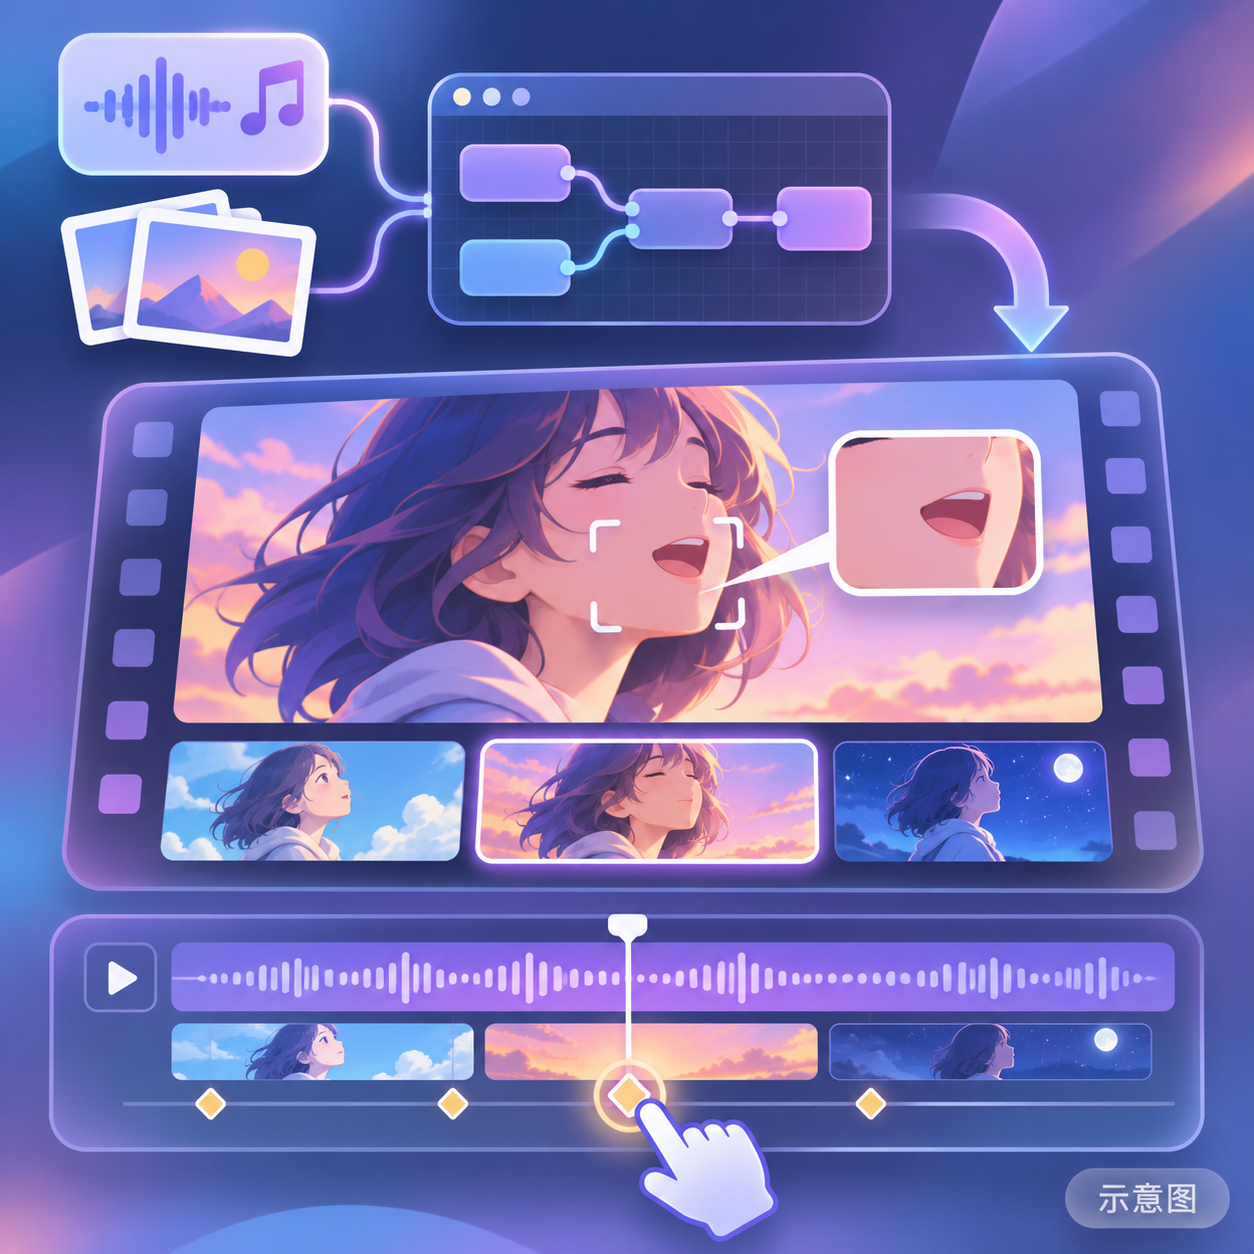
自分の曲と画像を使ってマルチシーンのリップシンク MV タイムラインを作成するワークフロー。v1.3.2 では、編集ソフト向けのエクスポート機能(ProRes / FFV1 マスターおよびシーン別クリップ)のみが追加されました。
参考画像
推奨理由
- バージョン更新ですが、タイムラインと生成部分は変更されていません。Join from files ノードとタイムライン上部の Export ボタンに、ProRes 422 HQ、ProRes 4444(10-bit、PCM 音声)、FFV1 ロスレスマスターが追加され、元のフレームから一度だけエンコードされます。デフォルトの h264(crf 18)は以前と完全に同じです
- scene_clips は各シーンを個別に出力します(カットポイント後の余分なフレームと対応する曲の部分を含み、scenes.csv で各セグメントの動画および曲内の開始時間を記録するため、トランジションは Resolve や Premiere で独自に行えます)
- ファイル書き込みがより安定しました:明示的なタイムスタンプ付き、実行ごとに個別フォルダを作成、ディスク容量不足時は先に停止し、失敗した実行では中途半端なファイルが残らないようになっています
- ツール自体について:曲を配置する際に C キーでシーンを切り替え、S キーで歌唱区間をマークします。各曲セグメントは <Audio 1> として H3 に送られリップシンクを行い、最大 4 枚のキャラクター画像で外見の一貫性を保ちます
使い方
- custom_nodes/ComfyUI-H3Timeline を ComfyUI の custom_nodes にコピーして再起動 → workflows フォルダ内のワークフローをドラッグ&ドロップ → キャンバス左下の Timeline で曲と画像を追加 → Run をクリック。編集用マスターが必要な場合は、タイムライン上部の Export でエンコードを選択し、シーンごとのクリップ出力にチェックを入れます
- 作者が列挙したモデル:H3 ref2va pruned int8 メインモデル、ref2v turbo 4 ステップ LoRA、Qwen3-VL nvfp4 テキストエンコーダ、動画および音声 VAE
リスクと制限
- このバージョンでは映像やリップシンクの品質向上はありません。外部の編集ソフトを使わない場合は v1.3.1 を使い続けても問題ありません
- 唯一のサンプルは非公開で、閲覧可能な例がありません
- ProRes 4444 はアルファチャンネルを含みません。元のフレームは依然として 8-bit です。FFV1 マスターは元のフレームサイズに応じてディスク容量を消費します
- カードの参考画像は AI 生成のイメージ図であり、モデルの実際の出力結果ではありません。作者による公開された通常レベルのサンプルはありません
【B】Score to Screen — Songs, voices and scenes: a music video studio (YuE2 × MiniMax H3) · v9.0
ワークフロー · バージョン更新 · 作者 koyan0418439 · 公開 11-14 19:06 · ダウンロード数 14
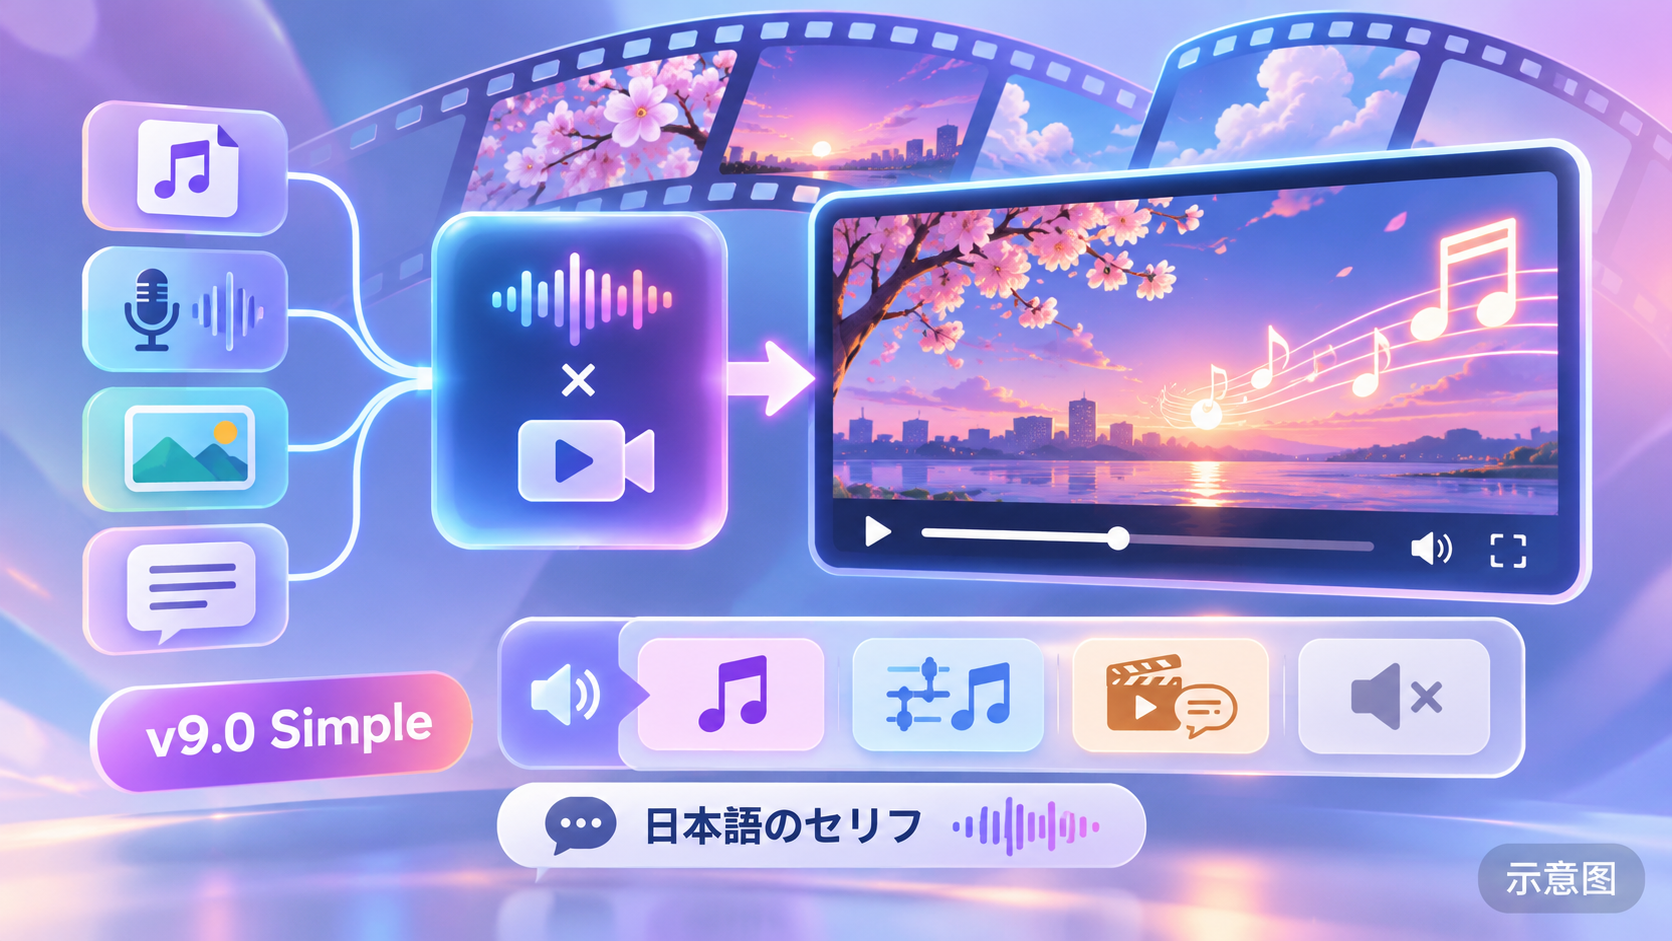
1 つのプロンプトと数枚の画像で、YuE2 が作曲・歌唱し、H3 がリップシンク付きマルチシーン MV を生成するワークフロー。v9.0 では、各シーンごとに音声(曲、H3 生成のセリフと環境音、曲+環境音、または無音)を選択できるようになりました。
参考画像
推奨理由
- バージョン更新(v8.2 比):タイムラインのシーンボックスに「This scene's sound」が追加されました。「H3's sound」を選択すると、そのシーンでは曲を再生せず、引用符内のセリフは指定された人物によって原文のまま話され、他の人物は口を閉じます。曲はバックグラウンドで継続し、その後再接続されるため、総尺とカットポイントは変わりません。フェードイン/アウトはそれぞれ 0.25 秒です
- 日本語のセリフに漢字が含まれる場合、ワークフロー内蔵の LLM がひらがなに書き換えてから H3 に送ります(作者によると、H3 は漢字を誤読するため)。曲と H3 音声の総音量設定が追加されました。「Song + ambience」を選択すると、同じシーンに対して純粋な音声生成を再度実行する必要があるため、処理時間が約 2 倍になります
- ツール自体について:ローカル LLM がプロンプトを YuE2 のスタイルタグ、歌詞、各シーンの H3 プロンプトに分解します。最大 64 シーンまで対応し、カットポイントは小節線に合わせられます。H3 エンジンは Standard(20 ステップ)、Turbo、または FastH3 Omni(8 ステップ)から選択可能です
使い方
- 解凍後、custom_nodes 内の 4 個のフォルダを ComfyUI/custom_nodes にコピーし、ComfyUI-Video-Saver を別途インストールします。さらに ComfyUI の Python 環境で
pip install demucsを実行し、再起動後にワークフローを読み込みます - タイムラインの各シーンで音声タイプを選択します。セリフは「The silver-haired woman says: "…"」のように、話者を明示した引用符付きの文として記述します。デフォルトは依然として「Song」であり、v8.2 プロジェクトの音声設定は変更されません
リスクと制限
- 依存関係が重いです:YuE2 モデル、ローカル LLM(初回実行時に llama-server とデフォルトの Qwen3-VL 4B が自動ダウンロードされます)、4 個のカスタムノードパッケージ、Demucs。ドラムビートとの同期には STRUM の追加インストールが必要です
- 唯一のサンプル(カバー動画)は非公開で、閲覧可能な例がありません。作者はこれを個人的な実験的ワークフローと位置付けています
- 作者は RTX 5060 Ti 16 GB で Standard エンジンを使用し、13.8 秒のシーン生成に 2000 秒かかりました。FastH3 Omni NVFP4 では 458 秒でした
- カードの参考画像は AI 生成のイメージ図であり、モデルの実際の出力結果ではありません。作者による公開された通常レベルのサンプルはありません
収録のみ(3)
- Zaynab Von Vergin · MiniMaxH3 — LoRA:オリジナル架空キャラクター「Zaynab Von Vergin」(オックスフォードの名門出身で、パリのアパートで高級ブティックを経営する)の人物 LoRA。
- Faith NordhavenLove · MiniMaxH3 — LoRA:オリジナル架空キャラクター「Faith NordhavenLove」(スウェーデンの岬にある灯台の看守助手で、常にネイビーブルーのコートとニット帽を着用する)の人物 LoRA。
- Qwen for MinimaxH3 & Image (Updated Fast Scaled) · Scaled_Comfy_Quant — テキストエンコーダ:H3 用の Qwen3-VL 32B テキストエンコーダの別の量子化バージョン:FP32 / FP16 / INT8 の混合精度、単一ファイルで 26.2 GB。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-14 08:48 → 11-14 21:01(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は単に関心の高さを示すものです。