Радар AI от Чжэньчжэнь · MiniMax H3 · Вечерний обзор 2026-11-14
В этом выпуске 9 новых версий: настоятельно рекомендуем 1 · рекомендуем 3 · стоит обратить внимание 2 · только для сведения 3
Примечание редактора В этом выпуске рассмотрено 9 новых версий H3: 1 категории S, 3 категории A, 2 категории B и 3 категории C. Рекомендуем третий ползунок цепной молнии из набора эффектов KinetiX: положительные значения заставляют молнию перескакивать между несколькими целями, отрицательные — останавливают её в точке попадания, триггерные слова не требуются. У двух LoRA-моделей ускорения CROWN HyperPDMD на 3–4 шагов (версии для генерации видео по первому/последнему кадру и для синхронизации губ по нескольким референсным изображениям) параметры указаны полностью, поэтому они автоматически повышены с B до A; аудио-LoRA с женскими акцентами разделена на отдельные файлы для каждого акцента и отнесена к категории A. Две LoRA-модели оригинальных персонажей не имеют особых особенностей, а примеры в основном скрыты, поэтому они понижены до категории C; пере-квантование текстового энкодера не считается новой возможностью и отнесено к категории C.
Настоятельно рекомендуем (1)
【S】KinetiX Elemental VFX Suite · Chain Lightning V1.0
LoRA · Обновление версии · Автор make676767 · Опубликовано 11-14 14:06 · Загрузок 71
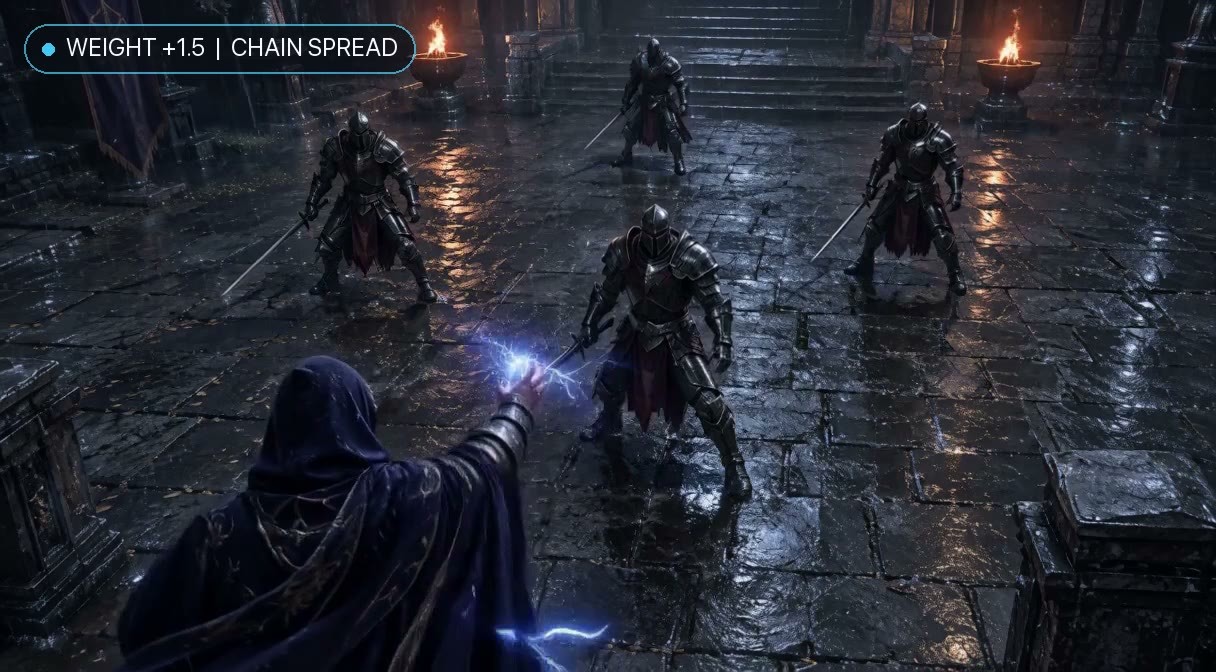
LoRA с ползунком цепной молнии, принимающим положительные и отрицательные значения: положительные значения заставляют молнию после поражения первой цели перескакивать между людьми и металлическими объектами поблизости, отрицательные значения останавливают ток в точке попадания, не позволяя ему распространяться дальше.
Иллюстрация
Причины рекомендации
- Третий эффект в серии элементальных эффектов KinetiX (первыми двумя были Fire Spread и Freeze Speed), а не обновление старых эффектов; описание версии представляет собой введение к этому эффекту
- Подходит для магических, боевых и научно-фантастических сцен с перегрузкой в генерации видео по тексту: триггерные слова не требуются; автор утверждает, что цвет не фиксируется, достаточно указать в промпте молнии голубого, алого, фиолетового или золотого цвета
- Выполнимо: автор предоставил градации интенсивности и 4 готовых к копированию промптов для сцен (включая сравнение с отрицательным значением для одной точки), доступны 4 примеров видео; размер файла составляет всего 7 МБ, лицензия разрешает создание производных работ
Как использовать
- После загрузки LoRA настройте strength_model: при +1.0 появляется цепная реакция на нескольких целях, при более высоких значениях — обширная электрическая сеть; 0 соответствует обычным локальным искрам; от -1.2 до -5 фиксирует эффект в одной точке без распространения; триггерные слова не требуются
- В промпте четко укажите первую пораженную цель, людей или металлические объекты вокруг, которые могут быть связаны (солдаты, доспехи, мехи, ящики и т.д.), а также цвет молнии; дополнительно прилагается архив с ресурсами workflow
Риски и ограничения
- Таблица интенсивности автора противоречива: в английском описании оптимальный диапазон указан как +1.0 ~ +5, а режим перегрузки как +1.8 ~ +2.5, эти диапазоны перекрываются; в китайском описании оптимум составляет +1.0 ~ +1.6, а +1.8 ~ +5 — режим перегрузки, рекомендуется начинать тестирование с значений около +1
- 3 примеров скрыто (смешанный контент); версия базовой модели и количество шагов автором в описании не указаны (возможно, они находятся в прилагаемом архиве, который не был проверен)
Рекомендуем (3)
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - Ref2VA Multi-Ref & Lip-Sync (3-4 Step r38)
LoRA · Новая модель · Автор NineCrowns · Опубликовано 11-14 14:39 · Загрузок 119
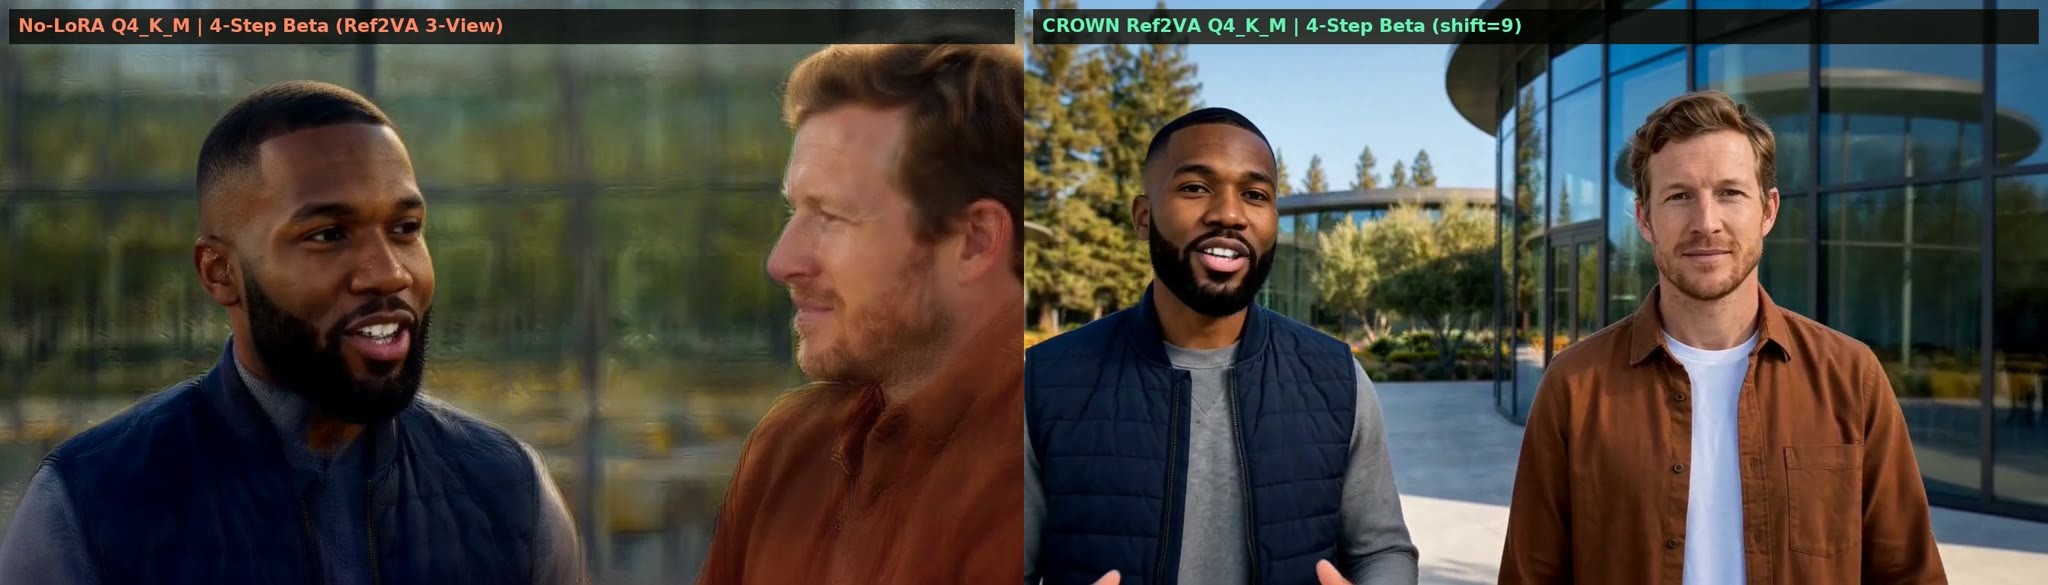
Версия Ref2VA того же набора LoRA-моделей ускорения на 3–4 шагов: предназначена для генерации видео по нескольким референсным изображениям (многоугольные изображения персонажа плюс изображение сцены) и синхронизации губ по аудио, автор утверждает, что максимальная длительность составляет 15 секунд, а также совместимость с базовыми моделями BF16, INT8 и GGUF Q4.
Иллюстрация
Причины рекомендации
- Это одна из двух версий одной и той же модели, что и версия FL2VA: данная версия предназначена только для базовых моделей Ref2VA, служит для генерации видео по референсным изображениям и синхронизации губ, но не для генерации по первому/последнему кадру; размер файла составляет 340.3 МБ, автор утверждает, что он получен путем смешивания и сжатия чекпоинтов, обученных на 2000 шагах
- Параметры идентичны версии FL2VA: интенсивность 1.0 (0.95 ~ 1.05), Euler, CFG 1.0, 3 или 4 шагов; автор дополнительно рекомендует устанавливать размер референсных изображений в max, а shift_video в 9.0 для повышения четкости при наличии нескольких персонажей
- Доступны 2 видео и 1 изображения; автоматическое повышение с B до A
Как использовать
- Используйте базовую модель Ref2VA: если видеопамять меньше 9 ГБ, используйте GGUF Q4_K_M с UnetLoaderGGUFAdvanced (установите patch_dtype в target), также можно использовать pruned int8 convrot или BF16
- Интенсивность LoRA 1.0, euler + BetaSamplingScheduler, CFG 1.0, 3 или 4 шагов; в MiniMaxH3ReferenceToVideo установите ref_image_size в max, в MiniMaxH3SigmaShift установите shift_video в 9.0
Риски и ограничения
- Автор указывает диапазон shift_video от 9.0 до 12.0, а значения shift_audio 3.0 и параметры альфа/бета для планировщика Beta 0.6 приведены только в полной карточке модели
- Много маркетинговых заявлений: «поры на уровне детализации» в портретах, дистилляция с использованием 8 изображений B200 и т.д. — всё это собственные утверждения автора, без контрольных примеров без LoRA
- Для синхронизации губ и использования реальных фотографий людей необходимо получить их согласие, соблюдайте права на изображение; архив с рабочими процессами загружен как «обучающие данные», проверка безопасности не завершена
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - FL2VA / I2VA / T2VA (3-4 Step r38)
LoRA · Новая модель · Автор NineCrowns · Опубликовано 11-14 14:39 · Загрузок 72
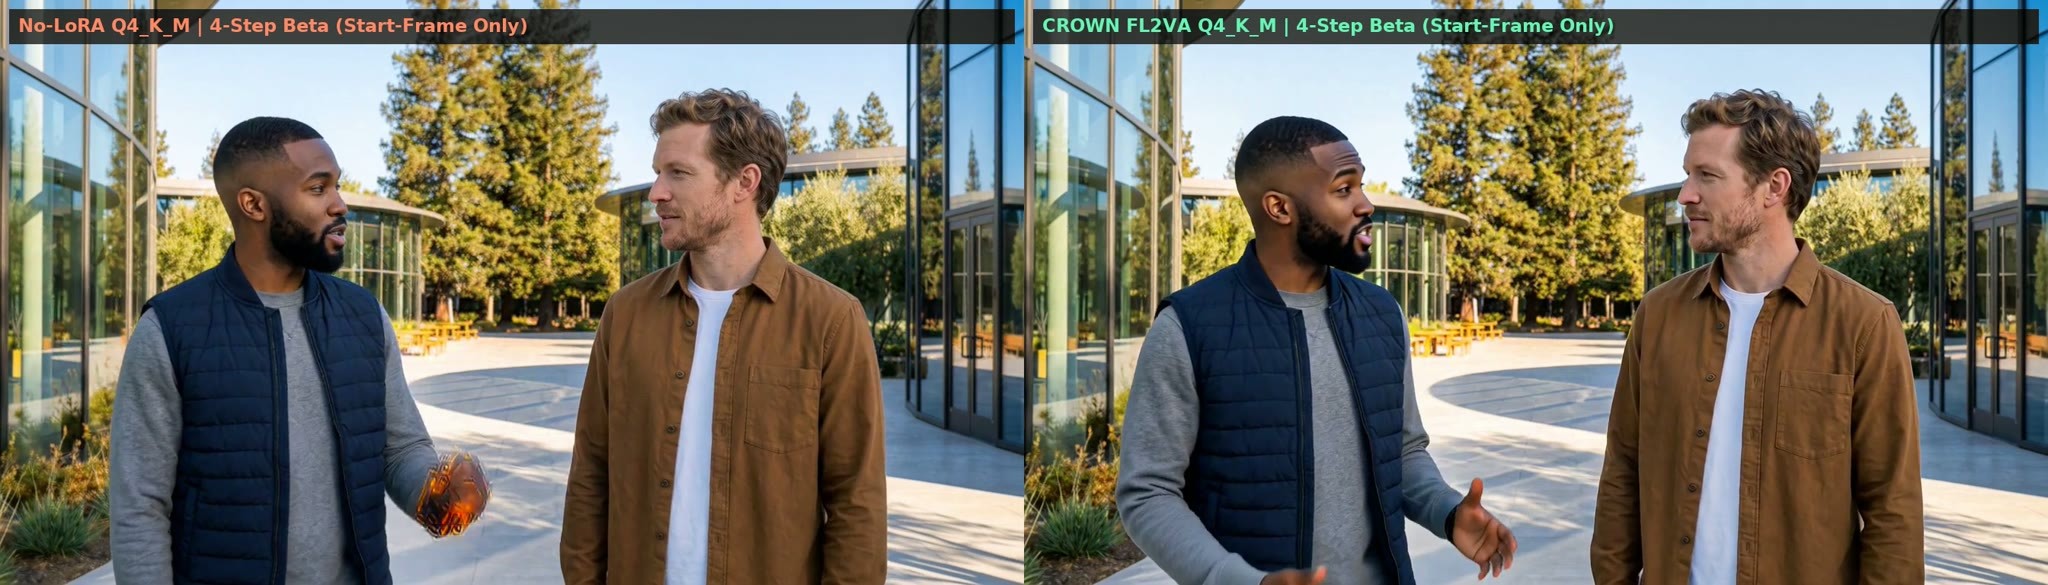
LoRA-модель ускорения на 3–4 шагов для H3 (версия FL2VA): предназначена для генерации видео по тексту, генерации видео по одному изображению и генерации по первому/последнему кадру, автор утверждает, что один и тот же файл можно использовать с базовыми моделями BF16, INT8 и GGUF Q4, а также что он снижает размытость при низобитном квантовании.
Иллюстрация
Причины рекомендации
- Одна из двух версий новой модели: данная версия предназначена для базовых моделей FL2VA, охватывает T2V, I2V и генерацию по первому/последнему кадру, автор утверждает, что максимальная длительность составляет 15 секунд; другая версия предназначена только для Ref2VA (множественные референсы и синхронизация губ), они не взаимозаменяемы
- Автор утверждает, что при запуске на 3–4 шагах без LoRA изображение в I2V по одному изображению не двигается, лица в чистом T2V размываются, а в генерации по первому/последнему кадру появляются артефакты в середине; данная LoRA использует дистилляцию HyperPDMD, во время обучения поочередно возмущались базовые модели Q4_K_M, ConvRot INT8 и BF16
- Параметры указаны, примеры доступны: интенсивность 1.0 (0.95 ~ 1.05), Euler, CFG 1.0, 3 или 4 шагов; доступны 3 видео и 2 изображения; размер файла составляет 347 МБ, прилагается архив с workflow ComfyUI; автоматическое повышение с B до A
Как использовать
- Используйте базовую модель FL2VA: если видеопамять меньше 9 ГБ, используйте GGUF Q4_K_M с UnetLoaderGGUFAdvanced (установите patch_dtype в target), при достаточной видеопамяти используйте pruned int8 convrot или BF16
- Интенсивность LoRA 1.0; SamplerCustomAdvanced + BasicGuider (CFG 1.0) + euler + BetaSamplingScheduler, 3 или 4 шагов, затем подключите MiniMaxH3SigmaShift
Риски и ограничения
- Параметры сэмплирования отклоняются от стандартных и указаны во второй половине полной карточки модели: для данной версии shift_video 12.0, shift_audio 3.0, alpha / beta для планировщика Beta 0.6; пропуск этих настроек может привести к тому, что результат не будет соответствовать примерам
- Много маркетинговых заявлений: повышение четкости в 6.5–10 раз, дистилляция 8 B200, сохранение 99.96% энергии — это утверждения самого автора, примеры без LoRA для сравнения отсутствуют, сравнение с существующими Turbo LoRA не проводилось
- Архив с workflow загружен как тип «данные для обучения», проверка безопасности не завершена
【A】Minimax Female Accents · 1.1
LoRA · Обновление версии · Автор imb101 · Опубликовано 11-14 10:00 · Загрузок 173
LoRA с женскими акцентами, влияющая только на аудио: в v1.1 акценты, ранее смешанные в одном файле, разделены на отдельные LoRA для каждого акцента, добавлены ливерпульский и миннесотский акценты.
Иллюстрация
Причины рекомендации
- Обновление версии: автор утверждает, что старая единая модель смешивала несколько акцентов, после разделения акценты стали точнее; сейчас всего 5 файлов: Utah, Atlanta, New Jersey, Liverpool, Minnesota
- Подходит для видео с английскими диалогами (как по тексту, так и по изображению): автор утверждает, что встроенные акценты H3 звучат плоско, данная группа LoRA обучена только на аудиокомпоненте, не затрагивая видеочасть, поэтому не влияет на изображение
- Автор опубликовал данные обучения первой версии: 66 аудиофрагментов, по 22 фрагментов на каждый акцент, автоматическая разметка выполнена с помощью Qwen ASR
Как использовать
- Загрузите соответствующий файл для нужного акцента, интенсивность 0.6–0.8 (для старой версии рекомендовалось 0.4–0.5), установите audio sampling в 3; если появляются странные булькающие звуки (vocal fry), увеличьте audio sampling
- Промпты такие же, как в старой версии: после реплики напишите in a <название акцента> accent, например, The woman says <d>[English]…</d> in a atlanta accent
Риски и ограничения
- После разделения за одну генерацию можно использовать только один акцент, диалог двух людей с разными акцентами создать невозможно
- Автор утверждает, что до точности еще далеко, уверенность в акценте Utah отсутствует; поддерживаются только женские акценты; доступны 1 примеров видео, 4 скрыты (смешанный контент)
- Размер файла для каждого акцента составляет около 296 МБ; лицензия запрещает создание производных работ
Стоит обратить внимание (2)
【B】Tap to Screen — Синхронизация губ с песней в клипе MiniMax H3 (многокадровый таймлайн) · v1.3.2
Рабочий процесс · Обновление версии · Автор koyan0418439 · Опубликовано 11-14 13:56 · Загрузок 34
Рабочий процесс с таймлайном для создания многокадрового клипа с синхронизацией губ по вашим собственным песням и изображениям; в v1.3.2 добавлен только экспорт для видеоредакторов: мастер-файлы ProRes / FFV1 и нарезанные по сценам фрагменты.
Иллюстрация
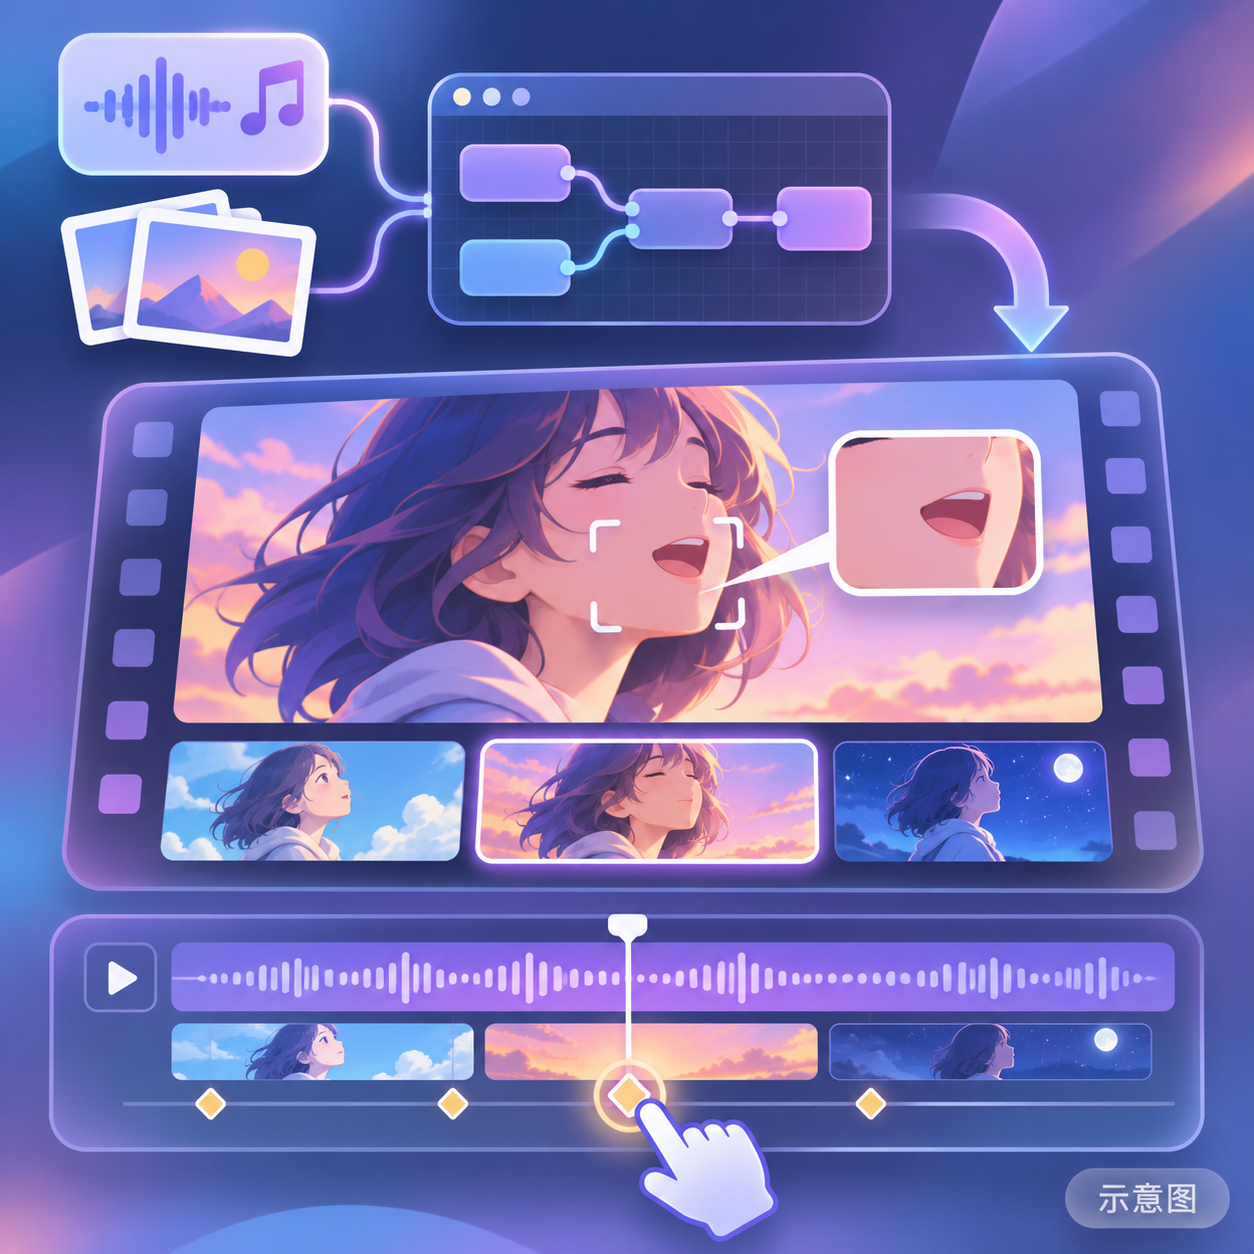
Почему стоит попробовать
- Обновление версии, таймлайн и генерация не изменились: в узле Join from files и кнопке Export в верхней части таймлайна добавлены поддержка ProRes 422 HQ, ProRes 4444 (10-бит, звук PCM) и мастер-файлы FFV1 без потерь, кодируемые напрямую из исходных кадров; стандартный h264 (crf 18) остался прежним
- scene_clips выводит каждую сцену отдельно (включая лишние кадры после точки склейки и соответствующий фрагмент песни) и прилагает файл scenes.csv с указанием времени начала каждой сцены в видео и песне, чтобы переходы можно было делать в Resolve или Premiere
- Более надежная запись файлов: явные временные метки, отдельная папка для каждого запуска, остановка при нехватке места на диске, неудачные запуски не оставляют неполных файлов
- Сам инструмент: при загрузке песни нажмите C для разделения на сцены, S для обозначения поющих участков; каждый фрагмент песни передается в H3 как <Audio 1> для синхронизации губ, до 4 изображений персонажей для сохранения единообразия внешности
Как использовать
- Скопируйте custom_nodes/ComfyUI-H3Timeline в папку custom_nodes ComfyUI и перезапустите → перетащите рабочий процесс из папки workflows → нажмите Timeline в левом нижнем углу холста, чтобы загрузить песни и изображения → Run; для получения мастер-файлов для монтажа выберите кодек в верхней части таймлайна и отметьте опцию «один фрагмент на сцену»
- Модели, указанные автором: основная модель H3 ref2va pruned int8, LoRA ref2v turbo на 4 шагов, текстовый энкодер Qwen3-VL nvfp4, VAE для видео и аудио
Риски и ограничения
- В этой версии нет улучшений в качестве изображения и синхронизации губ; если вам не нужен внешний видеоредактор, можно продолжать использовать v1.3.1
- Единственный пример скрыт, видимых примеров нет
- ProRes 4444 не поддерживает альфа-канал, исходные кадры остаются 8-битными; мастер-файлы FFV1 занимают на диске объем, соответствующий размеру исходных кадров
- Иллюстрация на карточке — это сгенерированная ИИ схема, а не реальный результат работы модели; у автора нет общедоступных примеров обычного уровня
【B】Score to Screen — Песни, голоса и сцены: студия музыкальных клипов (YuE2 × MiniMax H3) · v9.0
Рабочий процесс · Обновление версии · Автор koyan0418439 · Опубликовано 11-14 19:06 · Загрузок 14
Рабочий процесс, создающий многокадровый клип с синхронизацией губ с помощью YuE2 (композиция и вокал) и H3 (генерация видео) по одному промпту и нескольким изображениям; в v9.0 для каждой сцены можно отдельно выбрать звук: песня, диалог и звуки окружения, сгенерированные самим H3, песня с фоновыми шумами или тишина.
Иллюстрация
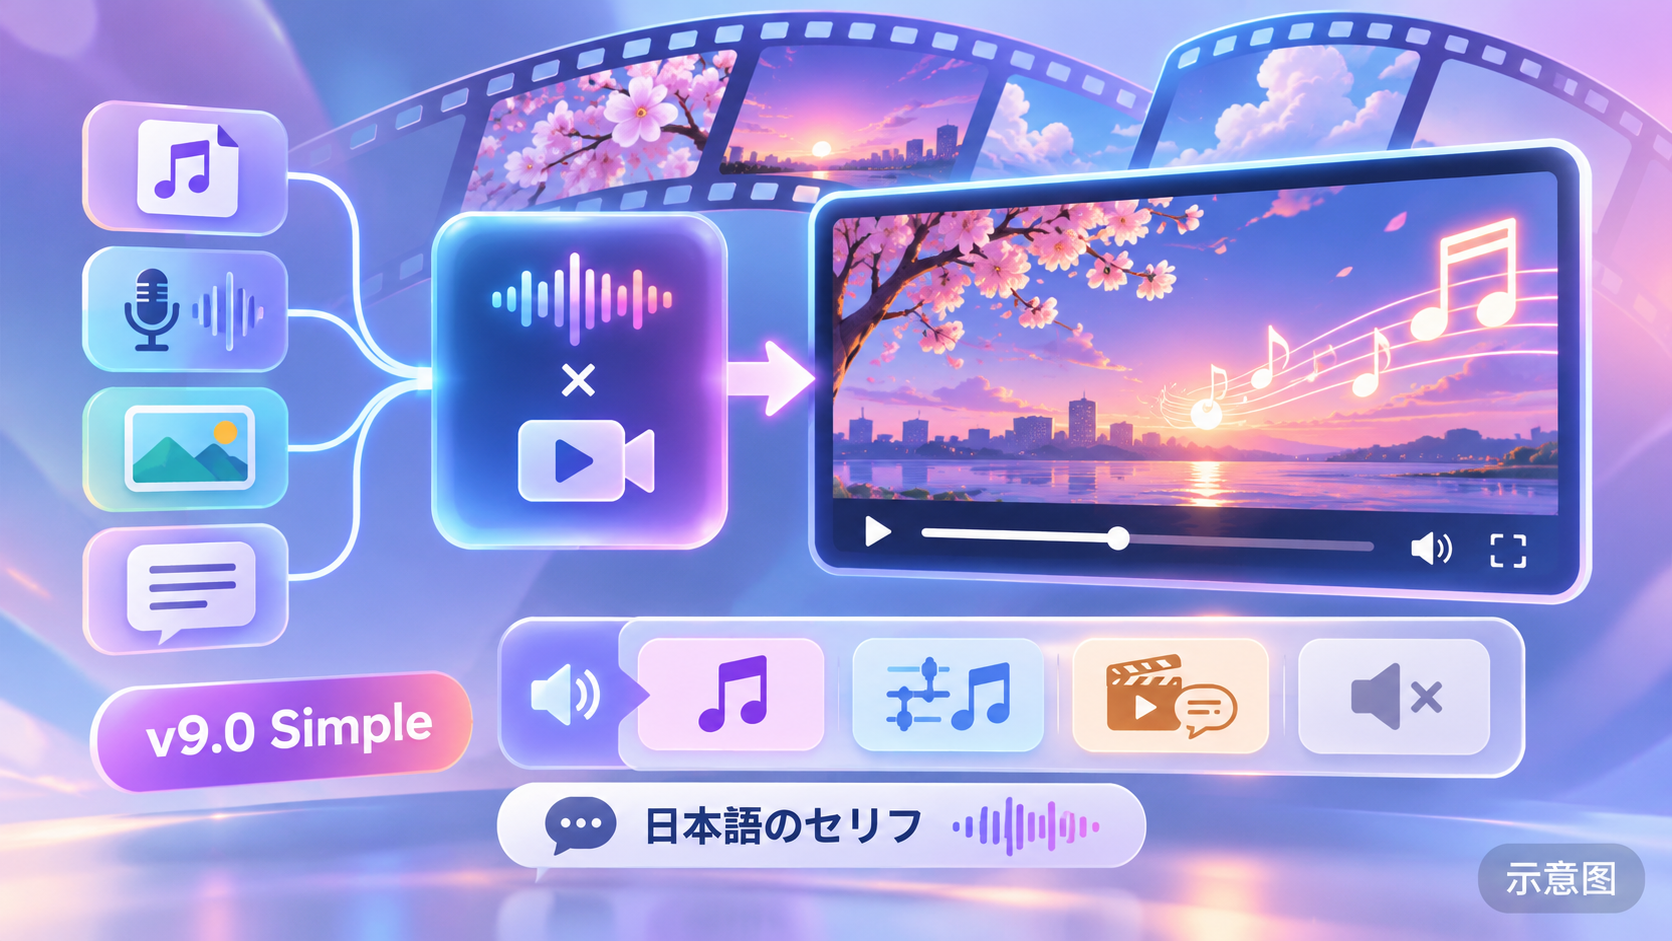
Почему стоит попробовать
- Обновление версии (относительно v8.2): в блоке сцены на таймлайне добавлена опция This scene's sound; при выборе H3's sound в этой сцене песня не играет, реплики в кавычках произносятся указанным персонажем дословно, остальные молчат; песня продолжает звучать на фоне и возобновляется позже, общая длительность и точки склейки не меняются, затухание при входе и выходе составляет 0.25 с
- Японские реплики с иероглифами переписываются встроенным в рабочий процесс LLM в хирагану перед отправкой в H3 (автор утверждает, что H3 неправильно читает иероглифы); добавлена общая громкость для песни и звука H3; режим Song + ambience требует повторного запуска только для звука в той же сцене, что примерно удваивает время обработки
- Сам инструмент: локальный LLM разбивает промпт на стилевые теги для YuE2, текст песни и промпты для H3 по сценам, до 64 сцен, точки склейки привязаны к тактовым линиям, движок H3 можно выбрать Standard (20 шагов), Turbo или FastH3 Omni (8 шагов)
Как использовать
- После распаковки скопируйте 4 папок из custom_nodes в ComfyUI/custom_nodes, дополнительно установите ComfyUI-Video-Saver и выполните pip install demucs в Python-окружении ComfyUI, перезапустите и загрузите рабочий процесс
- Выберите звук для каждой сцены на таймлайне; диалоги оформляются как предложения в кавычках с указанием говорящего, например: The silver-haired woman says: "…"; по умолчанию выбран режим Song, звуковое оформление проектов из v8.2 не меняется
Риски и ограничения
- Высокие требования к зависимостям: модели YuE2, локальный LLM (при первом запуске автоматически скачиваются llama-server и стандартный Qwen3-VL 4B), 4 пакетов пользовательских узлов, Demucs; для синхронизации с ритмом барабанов требуется дополнительная установка STRUM
- Единственный пример (видео на обложке) скрыт, видимых примеров нет; автор называет это экспериментальным рабочим процессом для личного использования
- Автор сообщает, что на RTX 5060 Ti 16 GB создание одной сцены длительностью 13.8 секунд на движке Standard занимает 2000 с, а на FastH3 Omni NVFP4 — 458 с
- Иллюстрация на карточке — это сгенерированная ИИ схема, а не реальный результат работы модели; у автора нет общедоступных примеров обычного уровня
Только для ознакомления (3)
- Zaynab Von Vergin · MiniMaxH3 — LoRA: персонажный LoRA для вымышленного персонажа Zaynab Von Vergin (уроженка оксфордской семьи, управляющая бутиком высокой моды в парижской квартире).
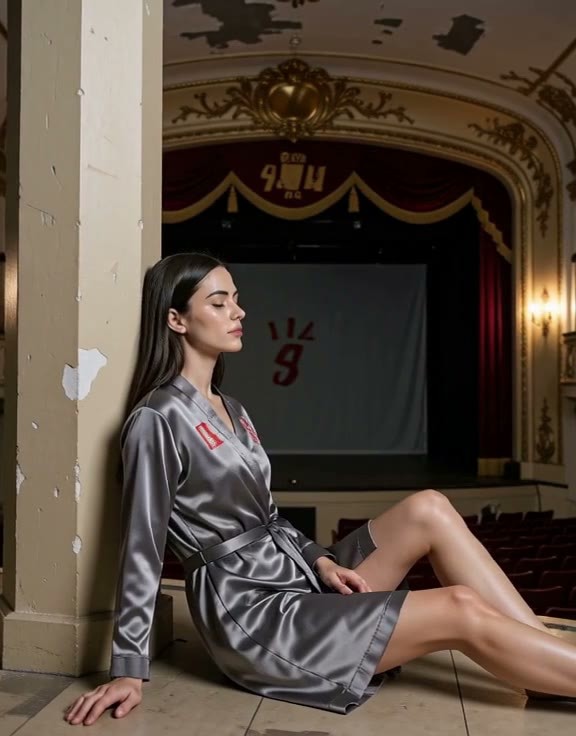
- Faith NordhavenLove · MiniMaxH3 — LoRA: персонажный LoRA для вымышленного персонажа Faith NordhavenLove (помощница смотрителя маяка на шведском мысе, часто носит темно-синее шерстяное пальто и вязаную шапку).
- Qwen for MinimaxH3 & Image (Updated Fast Scaled) · Scaled_Comfy_Quant — Текстовый энкодер: еще одна квантованная версия текстового энкодера Qwen3-VL 32B для H3: смешанная точность FP32 / FP16 / INT8, один файл размером 26.2 ГБ.
Данные: открытый API Civitai (базовая модель MiniMax H3), период отбора 11-14 08:48 → 11-14 21:01 (пекинское время). Рекомендации проверены редакторами; количество загрузок отражает только уровень интереса.