贞贞的AI雷达 · MiniMax H3 · 2026-11-14 晚报
本期 9 个新版本:强烈推荐 1 · 推荐 3 · 可关注 2 · 仅收录 3
编辑按语 本期审阅 9 个 H3 新版本,1 个 S、3 个 A、2 个 B、3 个 C。首推 KinetiX 特效套件的第三条连锁闪电滑杆:正值让闪电在多个目标间接力跳电、负值停在命中点,无需触发词。CROWN HyperPDMD 的两个 3–4 步加速 LoRA(首尾帧/图生视频版和多图参考对口型版)参数给得齐,自动 B 升为 A;女性口音音频 LoRA 拆成每种口音一个文件列 A。两条原创人物 LoRA 没有特别之处、示例大多隐藏,降为 C;文本编码器重新量化不算新能力,列 C。
强烈推荐(1)
【S】KinetiX Elemental VFX Suite · Chain Lightning V1.0
LoRA · 版本更新 · 作者 make676767 · 发布 11-14 14:06 · 下载 71
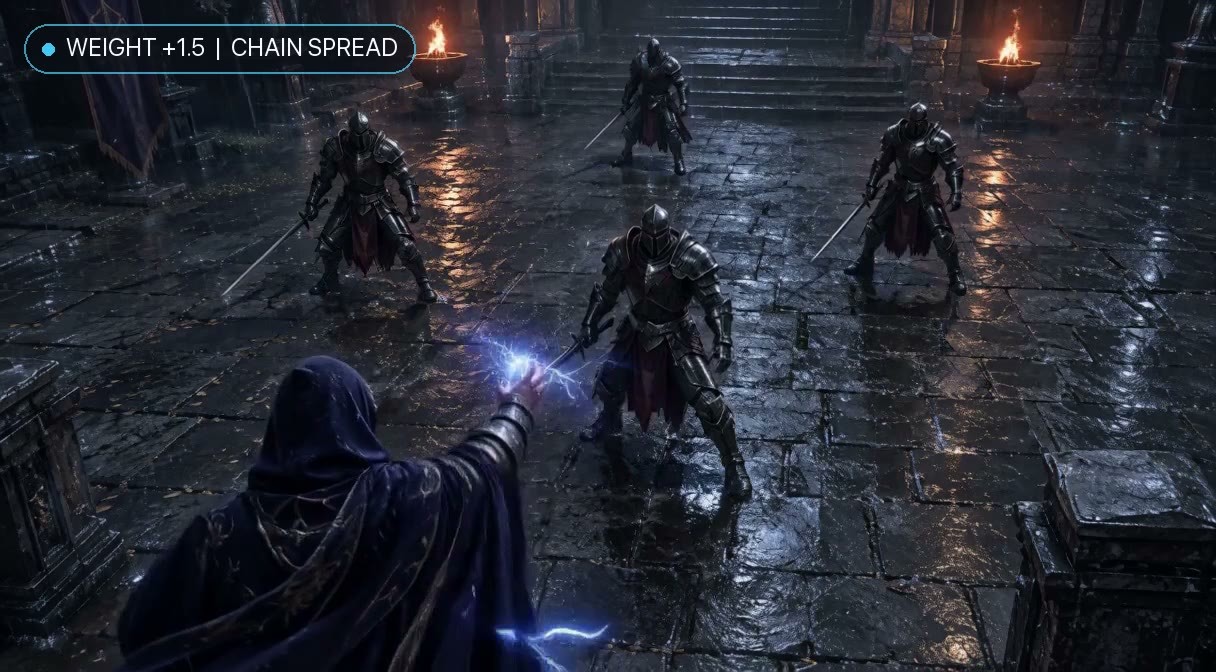
可正可负的连锁闪电滑杆 LoRA:正值让闪电打中第一个目标后在附近的人和金属物之间接力跳电,负值让电流停在命中点不外溢。
配图
推荐理由
- KinetiX 元素特效系列的第三个效果(前两个是 Fire Spread 和 Freeze Speed),不是旧效果的更新;版本说明就是本效果的介绍
- 服务文生视频里的魔法、打斗、科幻过载镜头:无需触发词;作者称不锁颜色,提示词写青色、猩红、紫色或金色闪电即可换色
- 能照做:作者给了强度分档和 4 条可直接复制的场景提示词(含负值单点的对照),4 段示例视频可见;文件只有 7 MB,许可允许衍生
怎么用
- 加载 LoRA 后调 strength_model:+1.0 起出现多目标连锁,再往上是大范围电网;0 为普通局部火花;-1.2 到 -5 锁定单点不外溢;无需触发词
- 提示词写清第一个被击中的目标、周围可被串起来的人或金属物(士兵、铠甲、机甲、货箱等)和闪电颜色;另附一个 workflow resources 压缩包
风险与限制
- 作者的强度表前后不一:英文说明写甜点位 +1.0 ~ +5、过载档 +1.8 ~ +2.5,两档重叠;中文说明是甜点 +1.0 ~ +1.6、+1.8 ~ +5 为过载档,建议从 +1 附近往上试
- 3 个示例被隐藏(混合内容);底模版本、步数作者未在说明里写(可能在附带压缩包里,未打开核对)
推荐(3)
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - Ref2VA Multi-Ref & Lip-Sync (3-4 Step r38)
LoRA · 新模型 · 作者 NineCrowns · 发布 11-14 14:39 · 下载 119
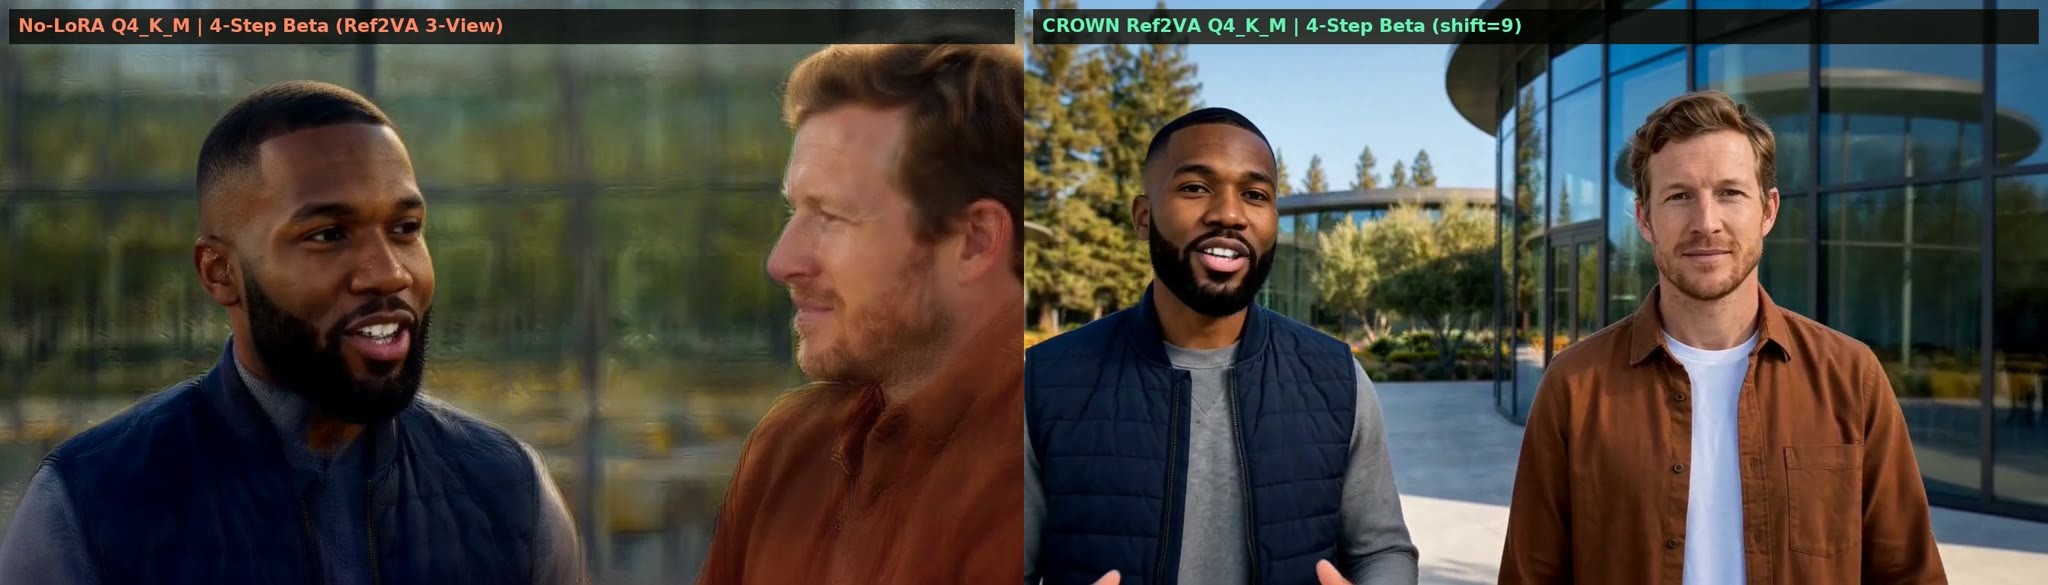
同一套 3–4 步加速 LoRA 的 Ref2VA 版:用于多图主体参考(角色多角度图加场景图)和音频对口型,作者称最长 15 秒,并兼容 BF16、INT8 和 GGUF Q4 底模。
配图
推荐理由
- 与 FL2VA 版是同一模型的两个版本:本版只配 Ref2VA 底模,服务参考图生视频和对口型,不做首尾帧;文件 340.3 MB,作者称由 2000 步训练的检查点混合压缩而来
- 参数与 FL2VA 版相同:强度 1.0(0.95 ~ 1.05)、Euler、CFG 1.0、3 或 4 步;作者另建议参考图尺寸设 max、shift_video 9.0 以提高多人物清晰度
- 2 段视频加 1 张图可见;自动 B 升为 A
怎么用
- 底模用 Ref2VA:显存不到 9 GB 用 Q4_K_M 的 GGUF 配 UnetLoaderGGUFAdvanced(patch_dtype 设 target),也可用 pruned int8 convrot 或 BF16
- LoRA 强度 1.0,euler + BetaSamplingScheduler,CFG 1.0,3 或 4 步;MiniMaxH3ReferenceToVideo 的 ref_image_size 设 max,MiniMaxH3SigmaShift 的 shift_video 设 9.0
风险与限制
- 作者给的 shift_video 是 9.0 ~ 12.0 的范围,shift_audio 3.0、Beta 调度 alpha / beta 0.6 只写在完整模型卡里
- 宣传成分重:毛孔级人像、8 张 B200 蒸馏等都是作者自述,没有不加 LoRA 的对照示例
- 对口型和参考真人照片需取得本人同意,注意肖像权;工作流压缩包以“训练数据”类型上传,安全扫描未完成
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - FL2VA / I2VA / T2VA (3-4 Step r38)
LoRA · 新模型 · 作者 NineCrowns · 发布 11-14 14:39 · 下载 72
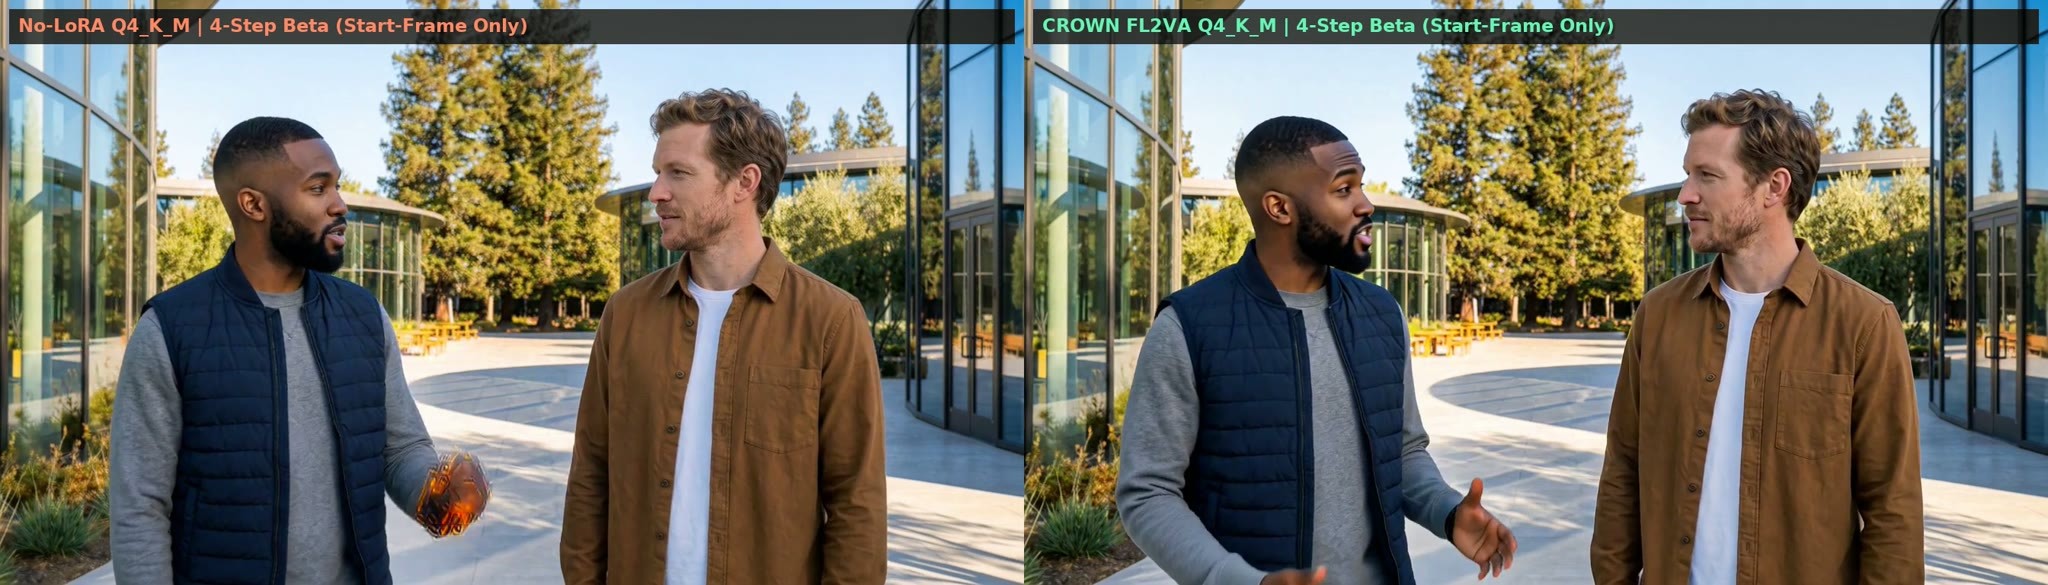
H3 的 3–4 步加速 LoRA(FL2VA 版):用于文生视频、单图生视频和首尾帧,作者称同一文件可挂在 BF16、INT8 和 GGUF Q4 底模上,并减轻低比特量化的发糊。
配图
推荐理由
- 新模型的两个版本之一:本版配 FL2VA 底模,覆盖 T2V、I2V 和首尾帧,作者称最长 15 秒;另一版只配 Ref2VA(多图参考和对口型),两者不能互换
- 作者称不加 LoRA 直接跑 3–4 步时,单图 I2V 画面不动、纯 T2V 人脸糊成一团、首尾帧中段重影;本 LoRA 用 HyperPDMD 蒸馏,训练时轮流扰动 Q4_K_M、ConvRot INT8 和 BF16 底模
- 参数齐、示例可见:强度 1.0(0.95 ~ 1.05)、Euler、CFG 1.0、3 或 4 步;3 段视频加 2 张图可见;文件 347 MB,附 ComfyUI 工作流压缩包;自动 B 升为 A
怎么用
- 底模用 FL2VA:显存不到 9 GB 用 Q4_K_M 的 GGUF 配 UnetLoaderGGUFAdvanced(patch_dtype 设 target),显存充足用 pruned int8 convrot 或 BF16
- LoRA 强度 1.0;SamplerCustomAdvanced + BasicGuider(CFG 1.0)+ euler + BetaSamplingScheduler,3 或 4 步,再接 MiniMaxH3SigmaShift
风险与限制
- 采样参数偏离常规,且写在完整模型卡后半:本版 shift_video 12.0、shift_audio 3.0,Beta 调度 alpha / beta 0.6;漏设可能达不到示例效果
- 宣传成分重:清晰度提高 6.5–10 倍、8 张 B200 蒸馏、保留 99.96% 能量都是作者自述,没有不加 LoRA 的对照示例,也没和现有 Turbo LoRA 比较
- 工作流压缩包以“训练数据”类型上传,安全扫描未完成
【A】Minimax Female Accents · 1.1
LoRA · 版本更新 · 作者 imb101 · 发布 11-14 10:00 · 下载 173
只作用于音频的女性口音 LoRA:v1.1 把原来混在一个文件里的口音拆成每种口音一个 LoRA,并新增利物浦和明尼苏达口音。
配图
推荐理由
- 版本更新:作者称旧版单个模型会把几种口音混在一起,拆开后口音更准;现在共 5 个文件:Utah、Atlanta、New Jersey、Liverpool、Minnesota
- 服务带英文对白的视频(文生 / 图生均可):作者称 H3 自带的口音偏平,这组 LoRA 只训练音频部分、不碰视频部分,不影响画面
- 作者公开了第一版的训练数据:66 段音频、每种口音 22 段,用 Qwen ASR 自动打标
怎么用
- 按需要的口音加载对应文件,强度 0.6–0.8(旧版建议 0.4–0.5),audio sampling 设 3;出现怪异的气泡音(vocal fry)就调高 audio sampling
- 提示词与旧版相同:在台词后写 in a <口音名> accent,如 The woman says <d>[English]…</d> in a atlanta accent
风险与限制
- 拆分后一次生成只能用一种口音,两个人说不同口音的对话做不了
- 作者称离准确还很远,对 Utah 口音仍没把握;只做女性口音;1 段示例视频可见,4 个被隐藏(混合内容)
- 每个口音文件约 296 MB;许可禁止衍生
可关注(2)
【B】Tap to Screen — MiniMax H3 lip-sync MV on your own song (multi-scene timeline) · v1.3.2
工作流 · 版本更新 · 作者 koyan0418439 · 发布 11-14 13:56 · 下载 34
用自己的歌和图片做多场景对口型 MV 的时间轴工作流;v1.3.2 只加了给剪辑软件用的导出:ProRes / FFV1 母版和按场景拆开的片段。
配图
推荐理由
- 版本更新,时间轴和生成部分不变:Join from files 节点和时间轴顶部的 Export 按钮新增 ProRes 422 HQ、ProRes 4444(10-bit、PCM 声音)和 FFV1 无损母版,从原始帧直接编码一次;默认 h264(crf 18)与之前完全相同
- scene_clips 把每个场景单独输出(含切点之后多出的帧和对应那段歌),并附 scenes.csv 记录每段在视频和歌曲里的开始时间,转场可以在 Resolve 或 Premiere 里自己做
- 写文件更稳:带显式时间戳、每次运行单独文件夹、磁盘不够先停,失败的运行不会留下半截文件
- 工具本身:放歌时按 C 切场景、按 S 标出唱歌区间,每段歌作为 <Audio 1> 送给 H3 对口型,最多 4 个角色图保持外貌一致
怎么用
- 把 custom_nodes/ComfyUI-H3Timeline 复制进 ComfyUI 的 custom_nodes 并重启 → 拖入 workflows 里的工作流 → 点画布左下角 Timeline 放歌和图片 → Run;要剪辑母版就在时间轴顶部 Export 选编码并勾选每场景一个片段
- 作者列出的模型:H3 ref2va pruned int8 主模型、ref2v turbo 4 步 LoRA、Qwen3-VL nvfp4 文本编码器、视频和音频 VAE
风险与限制
- 本版对画面和口型没有改进,不需要外部剪辑的人可以继续用 v1.3.1
- 唯一示例被隐藏,没有可见示例
- ProRes 4444 不带 alpha,源帧仍是 8-bit;FFV1 母版按原始帧大小占磁盘
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
【B】Score to Screen — Songs, voices and scenes: a music video studio (YuE2 × MiniMax H3) · v9.0
工作流 · 版本更新 · 作者 koyan0418439 · 发布 11-14 19:06 · 下载 14
一句提示词加几张图,用 YuE2 作曲演唱、H3 生成对口型多场景 MV 的工作流;v9.0 让每个场景单独选声音:歌、H3 自己生成的对白和现场声、歌加环境声,或静音。
配图
推荐理由
- 版本更新(相对 v8.2):时间轴场景框新增 This scene's sound;选 H3's sound 时该场景不放歌,引号里的台词按原文由指定的人说出,其他人闭嘴;歌在背后继续走、后面接上,总长和切点不变,切入切出各淡 0.25 s
- 日文台词含汉字时由工作流自带的 LLM 改写成平假名再送 H3(作者称 H3 会读错汉字);新增歌和 H3 声音的总音量;Song + ambience 要对同一场景再跑一次纯声音,耗时约翻倍
- 工具本身:本地 LLM 把提示词拆成 YuE2 风格标签、歌词和每场景的 H3 提示词,最多 64 个场景、切点落在小节线上,H3 引擎可选 Standard(20 steps)、Turbo 或 FastH3 Omni(8 steps)
怎么用
- 解压后把 custom_nodes 里的 4 个文件夹复制进 ComfyUI/custom_nodes,另装 ComfyUI-Video-Saver,并在 ComfyUI 的 Python 里 pip install demucs,重启后载入工作流
- 在时间轴每个场景选声音;对白写成 The silver-haired woman says: "…" 这样带说话人的引号句;默认仍是 Song,v8.2 的项目声音不变
风险与限制
- 依赖重:YuE2 模型、本地 LLM(首次自动下载 llama-server 和默认 Qwen3-VL 4B)、4 个自定义节点包、Demucs;鼓点同步还要另装 STRUM
- 唯一示例(封面视频)被隐藏,没有可见示例;作者称这是个人实验性工作流
- 作者在 RTX 5060 Ti 16 GB 上用 Standard 引擎做一个 13.8 秒场景要 2000 s,FastH3 Omni NVFP4 要 458 s
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
仅收录(3)
- Zaynab Von Vergin · MiniMaxH3 — LoRA:原创虚构角色 Zaynab Von Vergin(出身牛津世家、在巴黎公寓里经营高级时装店)的人物 LoRA。
- Faith NordhavenLove · MiniMaxH3 — LoRA:原创虚构角色 Faith NordhavenLove(瑞典海岬上的灯塔看守助手,常穿海军蓝呢大衣、戴针织帽)的人物 LoRA。
- Qwen for MinimaxH3 & Image (Updated Fast Scaled) · Scaled_Comfy_Quant — 文本编码器:H3 用的 Qwen3-VL 32B 文本编码器的又一个量化版:FP32 / FP16 / INT8 混合精度,单文件 26.2 GB。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-14 08:48 → 11-14 21:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。