정정(貞貞)의 AI 레이더 · MiniMax H3 · 2026-11-14 저녁 브리핑
이번 호 9개 신규 버전: 강력 추천 1 · 추천 3 · 주목할 만함 2 · 단순 수록 3
편집자 주 이번 호에서는 H3의 신규 버전 9개를 검토했으며, S급 1개, A급 3개, B급 2개, C급 3개로 분류했습니다. 최신 추천은 KinetiX 특수효과 스위트의 세 번째 연쇄 번개 슬라이더입니다. 양수 값은 번개가 여러 대상 사이에서 점프하며 전이되게 하고, 음수 값은 타격 지점에서 멈추게 하며, 트리거 워드가 필요 없습니다. CROWN HyperPDMD의 두 가지 3–4 스텝 가속 LoRA(첫/마지막 프레임 및 이미지-투-비디오 버전과 다중 이미지 참조 립싱크 버전)는 파라미터가 잘 정리되어 있어 자동 B급에서 A급으로 상향 조정했습니다. 여성 억양 오디오 LoRA는 각 억양별로 파일이 분리되어 있어 A급으로 분류했습니다. 두 개의 오리지널 캐릭터 LoRA는 특별함이 없고 예시가 대부분 숨겨져 있어 C급으로 하향 조정했으며, 텍스트 인코더의 재양자화는 새로운 기능으로 간주하지 않아 C급으로 분류했습니다.
강력 추천 (1)
【S】KinetiX Elemental VFX Suite · Chain Lightning V1.0
LoRA · 버전 업데이트 · 작성자 make676767 · 게시일 11-14 14:06 · 다운로드 수 71
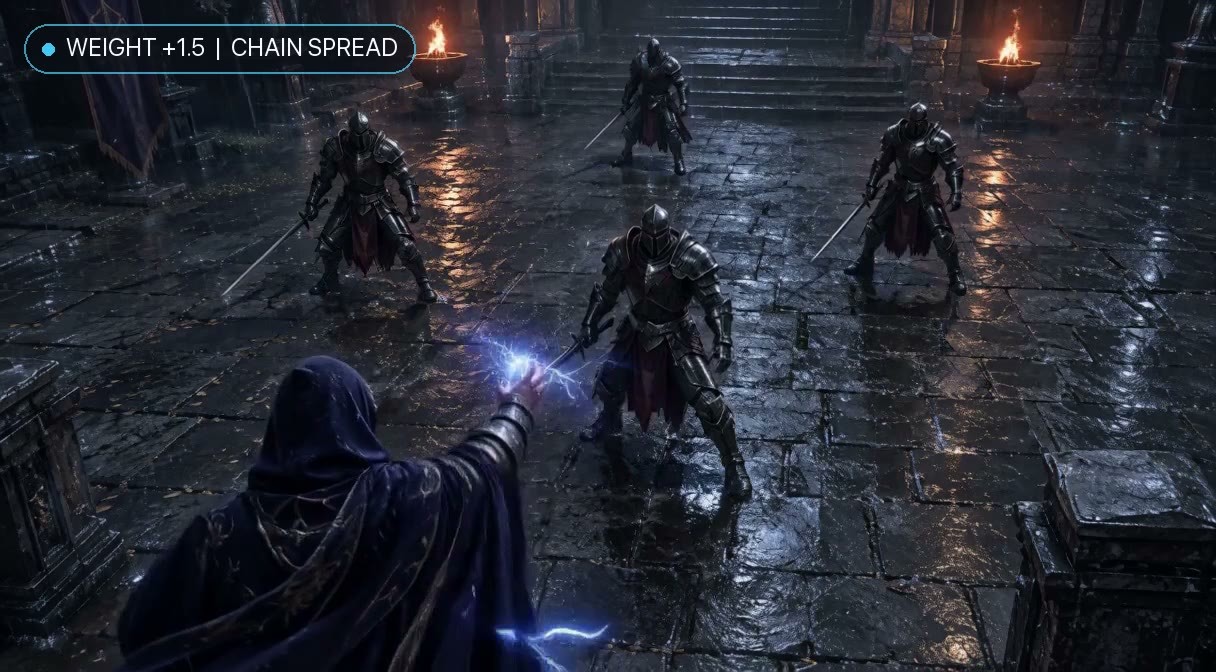
양수 및 음수 값을 모두 지원하는 연쇄 번개 슬라이더 LoRA입니다. 양수 값은 번개가 첫 번째 대상을 타격한 후 주변 사람과 금속 물체 사이에서 점프하며 전이되게 하고, 음수 값은 전류가 타격 지점에서 멈추고 외부로 퍼지지 않게 합니다.
이미지
추천 이유
- KinetiX 원소 특수효과 시리즈의 세 번째 효과(이전 두 가지는 Fire Spread와 Freeze Speed)로, 기존 효과의 업데이트가 아닙니다. 버전 설명이 곧 본 효과의 소개입니다.
- 텍스트-투-비디오의 마법, 전투, SF 과부하 장면에 적합합니다. 트리거 워드가 필요 없으며, 작성자는 색상을 고정하지 않는다고 주장하며 프롬프트에 청색, 진홍색, 보라색 또는 금색 번개를 지정하면 색상을 변경할 수 있습니다.
- 실행 가능: 작성자는 강도 단계와 복사하여 사용할 수 있는 4개의 장면 프롬프트(음수 단일 지점 대조 포함)를 제공하며, 4개의 예시 비디오가 확인 가능합니다. 파일 크기는 7 MB뿐이며, 라이선스는 파생 작업을 허용합니다.
사용법
- LoRA 로드 후 strength_model을 조정합니다. +1.0부터 다중 대상 연쇄가 나타나며, 그 이상은 대규모 전력망이 됩니다. 0은 일반적인 국부적 스파크이며, -1.2에서 -5 사이는 단일 지점에 고정되어 외부로 퍼지지 않습니다. 트리거 워드가 필요 없습니다.
- 프롬프트에 첫 번째로 타격당하는 대상, 주변에서 연결될 수 있는 사람이나 금속 물체(병사, 갑옷, 메카, 화물 상자 등) 및 번개 색상을 명확히 지정합니다. 별도로 workflow resources 압축 파일이 제공됩니다.
리스크 및 제한 사항
- 작성자의 강도 표가 일관되지 않습니다. 영어 설명에는 스위트 스팟이 +1.0 ~ +5, 과부하 단계가 +1.8 ~ +2.5으로 두 단계가 겹치며, 중국어 설명에는 스위트가 +1.0 ~ +1.6, +1.8 ~ +5이 과부하 단계로 되어 있습니다. +1 근처부터 상향 조정하여 테스트하는 것을 권장합니다.
- 3개의 예시가 숨겨져 있습니다(혼합 콘텐츠). 베이스 모델 버전과 스텝 수는 작성자가 설명에 명시하지 않았습니다(동봉된 압축 파일에 있을 수 있으나 확인하지 않았습니다).
추천 (3)
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - Ref2VA Multi-Ref & Lip-Sync (3-4 Step r38)
LoRA · 신규 모델 · 작성자 NineCrowns · 게시일 11-14 14:39 · 다운로드 수 119
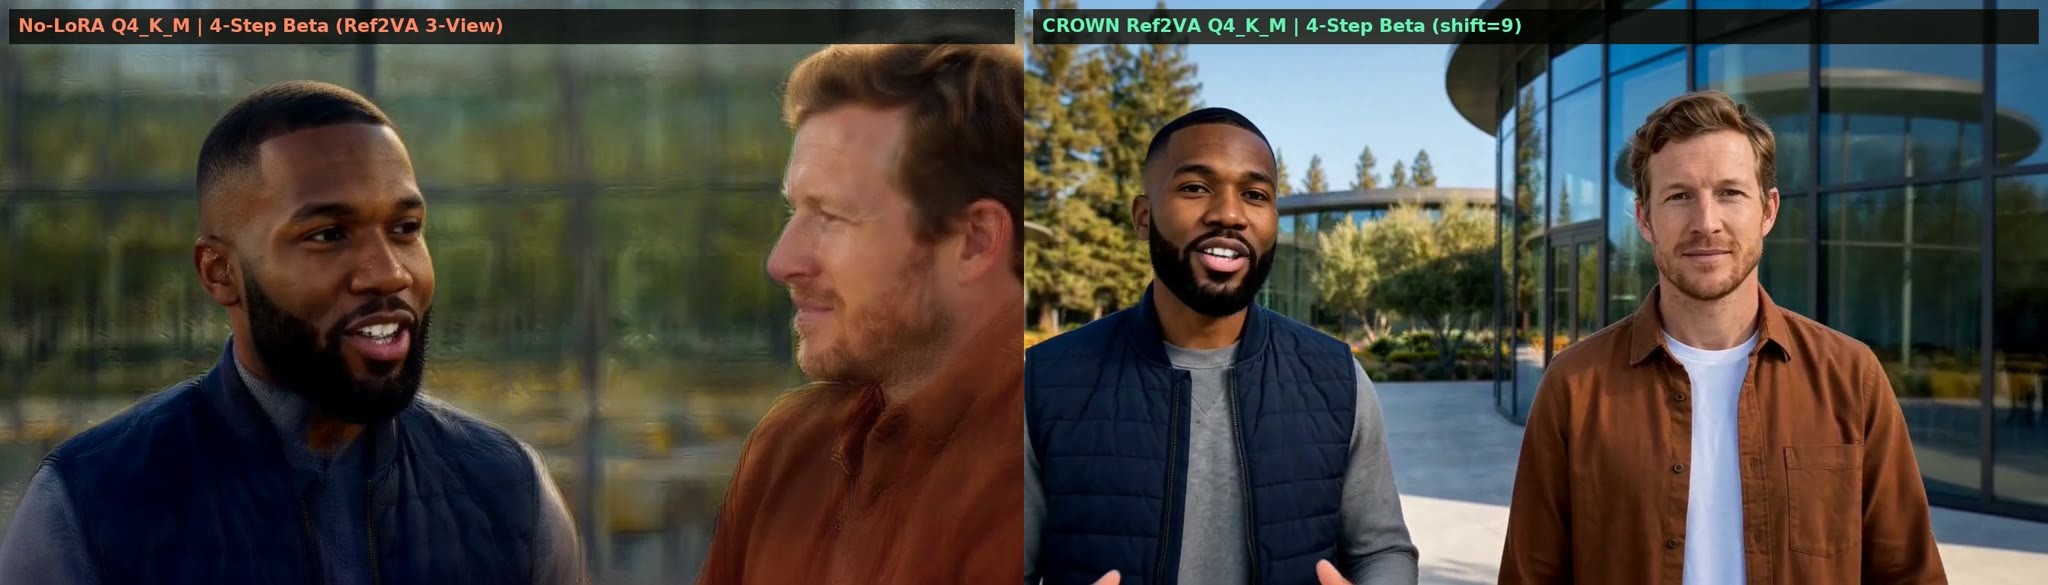
동일한 3–4 스텝 가속 LoRA의 Ref2VA 버전입니다. 다중 이미지 대상 참조(캐릭터의 다각도 이미지 및 장면 이미지)와 오디오 립싱크에 사용되며, 작성자는 최대 15초까지 지원한다고 주장하고 BF16, INT8, GGUF Q4 베이스 모델과 호환됩니다.
이미지
추천 이유
- FL2VA 버전과 동일한 모델의 두 가지 버전 중 하나입니다. 본 버전은 Ref2VA 베이스 모델 전용으로 참조 이미지-투-비디오와 립싱크에 사용되며 첫/마지막 프레임은 지원하지 않습니다. 파일 크기는 340.3 MB이며, 작성자는 2000 스텝으로 학습된 체크포인트를 혼합하여 압축했다고 주장합니다.
- 파라미터는 FL2VA 버전과 동일합니다. 강도 1.0(0.95 ~ 1.05), Euler, CFG 1.0, 3 또는 4 스텝입니다. 작성자는 다중 캐릭터 선명도를 높이기 위해 참조 이미지 크기를 max로 설정하고 shift_video를 9.0로 설정할 것을 추가로 권장합니다.
- 2개의 비디오와 1개의 이미지가 확인 가능합니다. 자동 B급에서 A급으로 상향 조정했습니다.
사용법
- 베이스 모델은 Ref2VA를 사용합니다. VRAM이 9 GB 미만인 경우 Q4_K_M GGUF를 UnetLoaderGGUFAdvanced(patch_dtype을 target으로 설정)와 함께 사용하거나, pruned int8 convrot 또는 BF16를 사용할 수 있습니다.
- LoRA 강도는 1.0, euler + BetaSamplingScheduler, CFG 1.0, 3 또는 4 스텝입니다. MiniMaxH3ReferenceToVideo의 ref_image_size를 max로 설정하고, MiniMaxH3SigmaShift의 shift_video를 9.0로 설정합니다.
리스크 및 제한 사항
- 작성자가 제시한 shift_video는 9.0 ~ 12.0 범위이며, shift_audio 3.0, Beta 스케줄링 alpha / beta 0.6은 전체 모델 카드에만 명시되어 있습니다.
- 홍보 요소가 강합니다. 모공 단위 초상화, 8장의 B200 증류 등은 모두 작성자의 자술이며, LoRA를 적용하지 않은 대조 예시가 없습니다.
- 립싱크와 실제 인물 사진 참조에는 본인 동의가 필요하며 초상권에 유의해야 합니다. 워크플로우 압축 파일은 '학습 데이터' 유형으로 업로드되었으며, 보안 스캔이 완료되지 않았습니다.
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - FL2VA / I2VA / T2VA (3-4 Step r38)
LoRA · 신규 모델 · 작성자 NineCrowns · 게시일 11-14 14:39 · 다운로드 수 72
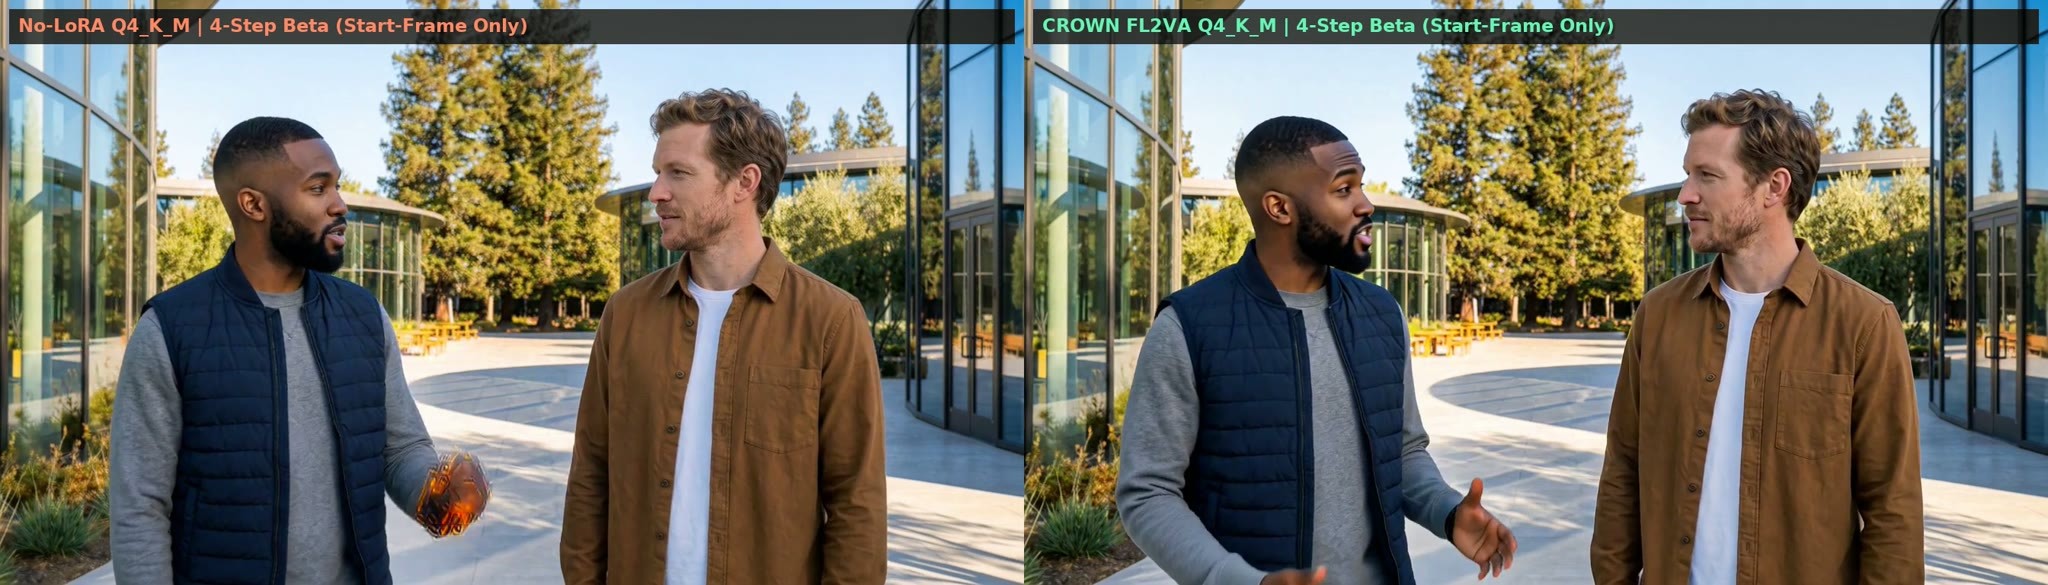
H3용 3–4 스텝 가속 LoRA(FL2VA 버전)입니다. 텍스트-투-비디오, 단일 이미지-투-비디오 및 첫/마지막 프레임에 사용되며, 작성자는 동일한 파일을 BF16, INT8, GGUF Q4 베이스 모델에 적용할 수 있고 저비트 양자화로 인한 흐려짐을 완화한다고 주장합니다.
이미지
추천 이유
- 신규 모델의 두 가지 버전 중 하나입니다. 본 버전은 FL2VA 베이스 모델과 함께 사용되며 T2V, I2V 및 첫/마지막 프레임을 커버합니다. 작성자는 최대 15초까지 지원한다고 주장합니다. 다른 버전은 Ref2VA 전용(다중 이미지 참조 및 립싱크)이며 두 버전은 호환되지 않습니다.
- 작성자는 LoRA 없이 직접 3–4 스텝을 실행할 경우, 단일 이미지 I2V는 화면이 움직이지 않고, 순수 T2V는 얼굴이 뭉개지며, 첫/마지막 프레임은 중간 부분이 잔상처럼 보인다고 주장합니다. 본 LoRA는 HyperPDMD 증류를 사용하며, 학습 시 Q4_K_M, ConvRot INT8, BF16 베이스 모델을 번갈아 가며 교란했습니다.
- 파라미터가 완비되고 예시가 확인 가능합니다. 강도 1.0(0.95 ~ 1.05), Euler, CFG 1.0, 3 또는 4 스텝입니다. 3개의 비디오와 2개의 이미지가 확인 가능합니다. 파일 크기는 347 MB이며 ComfyUI 워크플로우 압축 파일이 포함되어 있습니다. 자동 B급에서 A급으로 상향 조정했습니다.
사용법
- 베이스 모델은 FL2VA를 사용합니다. VRAM이 9 GB 미만인 경우 Q4_K_M GGUF를 UnetLoaderGGUFAdvanced(patch_dtype을 target으로 설정)와 함께 사용하며, VRAM이 충분하면 pruned int8 convrot 또는 BF16를 사용합니다.
- LoRA 강도는 1.0입니다. SamplerCustomAdvanced + BasicGuider(CFG 1.0) + euler + BetaSamplingScheduler를 사용하고, 3 또는 4 스텝을 실행한 후 MiniMaxH3SigmaShift를 연결합니다.
리스크 및 제한 사항
- 샘플링 파라미터가 일반적이지 않으며 전체 모델 카드 후반부에 명시되어 있습니다. 본 버전의 shift_video는 12.0, shift_audio는 3.0, Beta 스케줄링 alpha / beta는 0.6입니다. 설정을 누락하면 예시 효과를 달성하지 못할 수 있습니다.
- 홍보 요소가 강합니다. 선명도 6.5–10배 향상, 8장의 B200 증류, 99.96% 에너지 보존 등은 모두 작성자의 자술이며, LoRA를 적용하지 않은 대조 예시가 없고 기존 Turbo LoRA와의 비교도 없습니다.
- 워크플로우 압축 파일은 '학습 데이터' 유형으로 업로드되었으며, 보안 스캔이 완료되지 않았습니다.
【A】Minimax Female Accents · 1.1
LoRA · 버전 업데이트 · 작성자 imb101 · 게시일 11-14 10:00 · 다운로드 수 173
오디오에만 적용되는 여성 억양 LoRA입니다. v1.1는 기존에 하나의 파일에 섞여 있던 억양들을 각 억양별 LoRA로 분리하고, 리버풀과 미네소타 억양을 추가했습니다.
이미지
추천 이유
- 버전 업데이트: 작성자는 구버전의 단일 모델이 여러 억양을 섞어 사용했다고 주장하며, 분리 후에는 억양이 더 정확해졌다고 합니다. 현재 총 5개의 파일이 있습니다: Utah, Atlanta, New Jersey, Liverpool, Minnesota.
- 영어 대사가 포함된 비디오(텍스트-투-비디오 / 이미지-투-비디오 모두 가능)에 적합합니다. 작성자는 H3 기본 제공 억양이 평평하다고 주장하며, 이 LoRA 세트는 오디오 부분만 학습하고 비디오 부분은 건드리지 않아 화면에 영향을 주지 않습니다.
- 작성자는 첫 번째 버전의 학습 데이터를 공개했습니다. 66개의 오디오 클립, 각 억양당 22개이며 Qwen ASR로 자동 태깅했습니다.
사용법
- 필요한 억양에 해당하는 파일을 로드하고 강도를 0.6–0.8(구버전 권장 0.4–0.5)로 설정하며, audio sampling을 3으로 설정합니다. 이상한 성대 결절음(vocal fry)이 발생하면 audio sampling을 높입니다.
- 프롬프트는 구버전과 동일합니다. 대사 뒤에 in a <억양 이름> accent를 작성합니다. 예: The woman says <d>[English]…</d> in a atlanta accent
리스크 및 제한 사항
- 분리 후에는 한 번의 생성에 하나의 억양만 사용할 수 있어, 두 사람이 서로 다른 억양으로 대화하는 것은 불가능합니다.
- 작성자는 정확도까지 아직 거리가 멀다고 주장하며, Utah 억양에 대해서는 여전히 확신이 없습니다. 여성 억양만 지원됩니다. 1개의 예시 비디오가 확인 가능하며, 4개는 숨겨져 있습니다(혼합 콘텐츠).
- 각 억양 파일은 약 296 MB입니다. 라이선스는 파생 작업을 금지합니다.
주목할 만함 (2)
【B】탭하여 화면으로 — MiniMax H3 립싱크 MV를 내 노래로 만들기 (멀티 씬 타임라인) · v1.3.2
워크플로우 · 버전 업데이트 · 작성자 koyan0418439 · 게시일 11-14 13:56 · 다운로드 수 34
자신의 노래와 이미지를 사용하여 멀티 씬 립싱크 MV를 만드는 타임라인 워크플로우; v1.3.2에서는 편집 소프트웨어용 내보내기 기능만 추가되었습니다: ProRes / FFV1 마스터 파일과 씬별로 분리된 클립입니다.
이미지
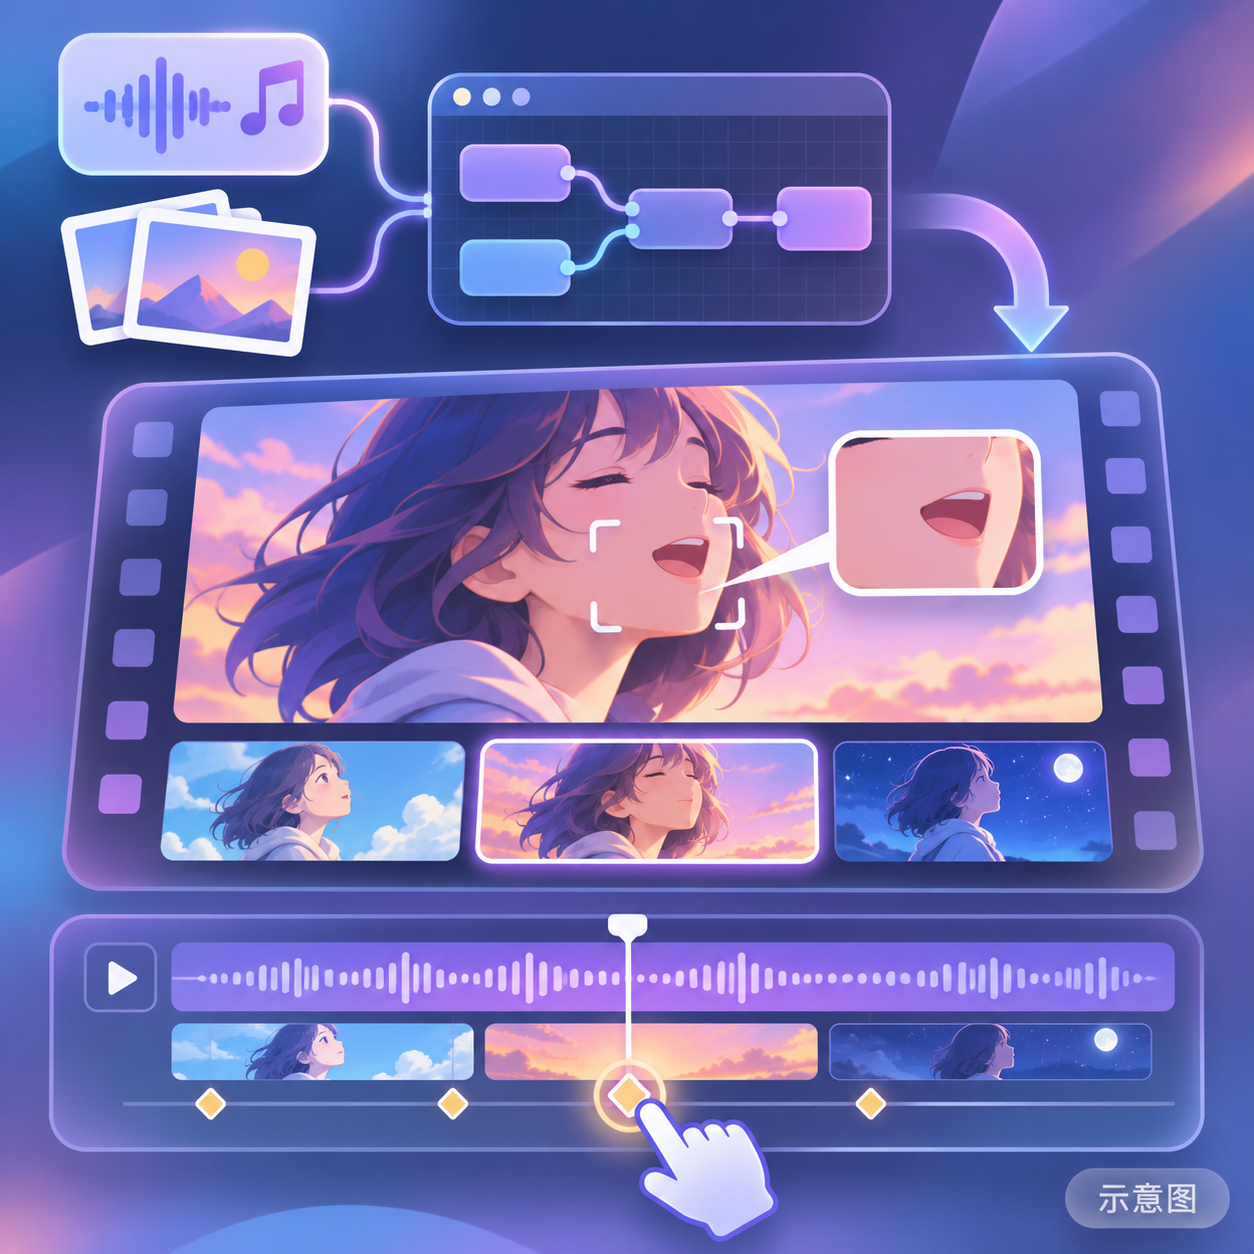
추천 이유
- 버전 업데이트, 타임라인 및 생성 부분은 변경되지 않음: Join from files 노드와 타임라인 상단의 Export 버튼에 ProRes 422 HQ, ProRes 4444 (10-bit, PCM 오디오) 및 FFV1 무손실 마스터가 추가되어 원본 프레임에서 한 번만 인코딩합니다. 기본값인 h264 (crf 18)은 이전과 완전히 동일합니다
- scene_clips는 각 씬을 개별적으로 출력하며(컷 포인트 이후의 추가 프레임과 해당 구간 노래 포함), scenes.csv를 첨부하여 각 구간이 비디오와 노래에서 시작하는 시간을 기록합니다. 트랜지션은 Resolve 또는 Premiere에서 직접 수행할 수 있습니다
- 파일 작성이 더 안정적입니다: 명시적 타임스탬프 포함, 실행마다 별도 폴더 생성, 디스크 공간 부족 시 먼저 중지하며, 실패한 실행은 불완전한 파일을 남기지 않습니다
- 도구 자체: 노래 재생 중 C 키로 씬 전환, S 키로 노래 구간 표시, 각 노래 구간을 <Audio 1>로 H3에 보내 립싱크하며, 최대 4개의 캐릭터 이미지를 사용하여 외모 일관성을 유지합니다
사용 방법
- custom_nodes/ComfyUI-H3Timeline을 ComfyUI의 custom_nodes 폴더에 복사하고 재시작 → workflows 폴더의 워크플로우를 드래그하여 로드 → 캔버스 좌측 하단의 Timeline에서 노래와 이미지 추가 → Run 실행; 편집용 마스터 파일이 필요하면 타임라인 상단의 Export에서 코덱을 선택하고 씬별 클립 생성을 체크하세요
- 작성자가 나열한 모델: H3 ref2va pruned int8 주 모델, ref2v turbo 4 스텝 LoRA, Qwen3-VL nvfp4 텍스트 인코더, 비디오 및 오디오 VAE
리스크 및 제한 사항
- 이 버전은 화면 품질과 립싱크에 개선이 없으므로, 외부 편집이 필요하지 않은 사용자는 v1.3.1를 계속 사용할 수 있습니다
- 유일한 예시가 숨겨져 있어 공개된 예시가 없습니다
- ProRes 4444은 알파 채널을 지원하지 않으며, 원본 프레임은 여전히 8-bit입니다; FFV1 마스터는 원본 프레임 크기에 따라 디스크 공간을 차지합니다
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다; 작성자는 공개된 일반 수준의 예시를 제공하지 않습니다
【B】Score to Screen — 노래, 목소리 및 씬: 뮤직비디오 스튜디오 (YuE2 × MiniMax H3) · v9.0
워크플로우 · 버전 업데이트 · 작성자 koyan0418439 · 게시일 11-14 19:06 · 다운로드 수 14
프롬프트 한 줄과 몇 장의 이미지로 YuE2를 사용하여 작곡 및 노래하고, H3로 멀티 씬 립싱크 MV를 생성하는 워크플로우; v9.0에서는 각 씬마다 소리를 개별적으로 선택할 수 있습니다: 노래, H3이 자체 생성한 대사 및 현장 소리, 노래에 환경음 추가, 또는 무음.
이미지
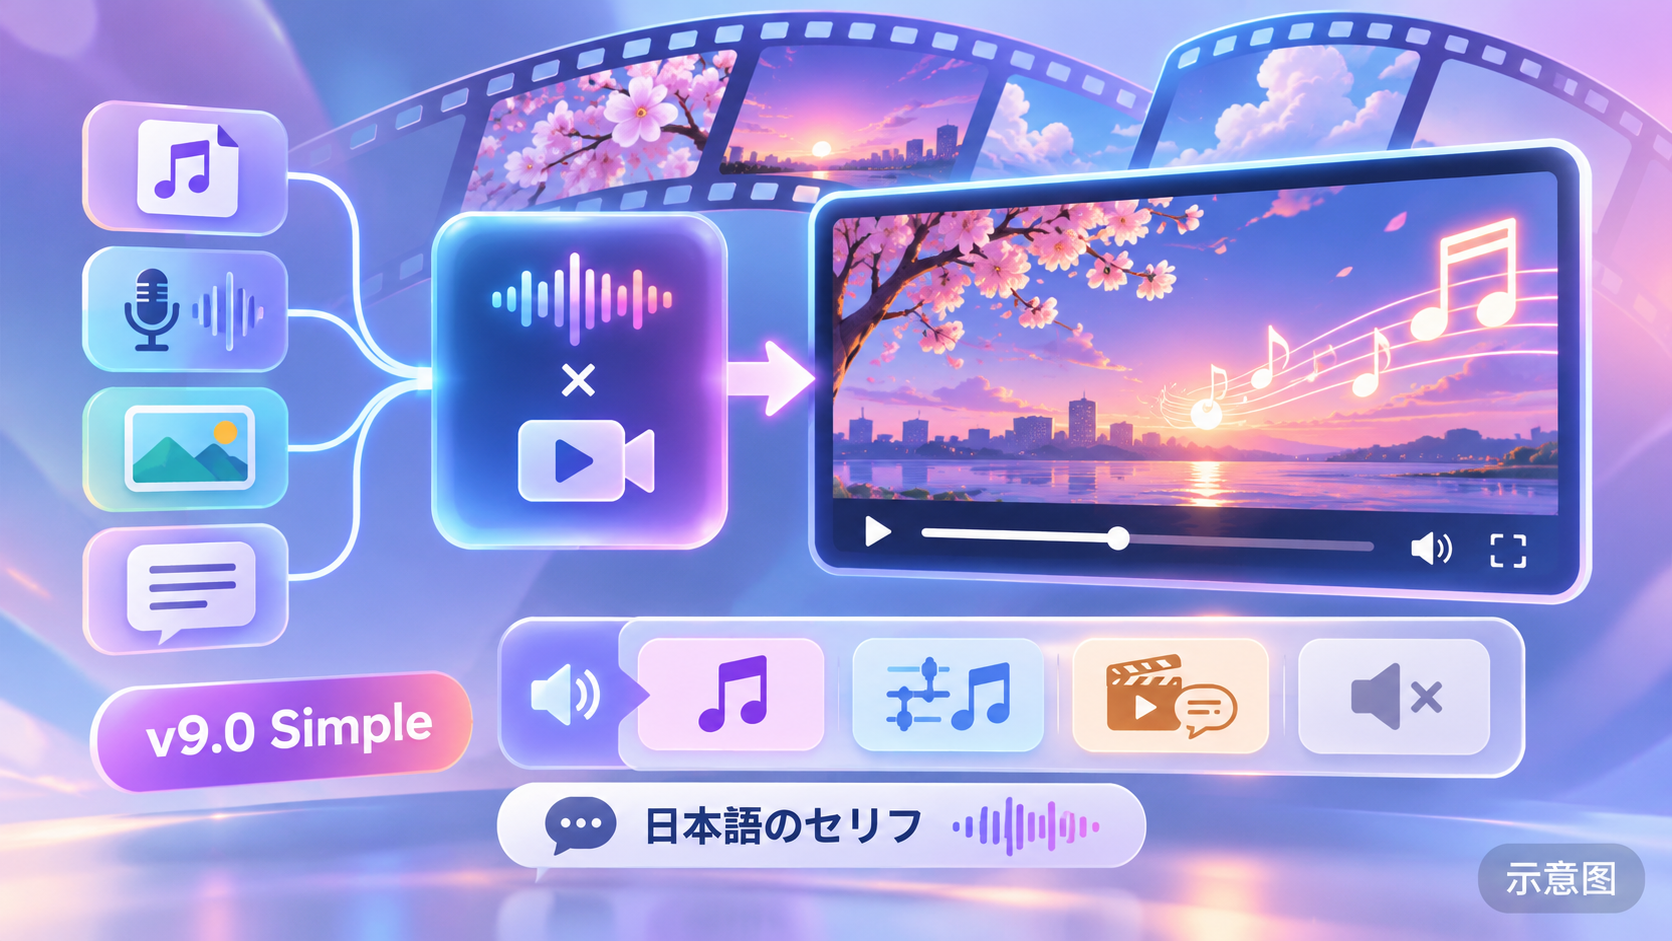
추천 이유
- 버전 업데이트 (v8.2 대비): 타임라인 씬 상자에 'This scene's sound' 옵션이 추가되었습니다; 'H3's sound'를 선택하면 해당 씬에서 노래가 재생되지 않으며, 따옴표 안의 대사는 지정된 인물이 원문 그대로 말하고 다른 인물들은 침묵합니다; 노래는 배경에서 계속 진행되며 나중에 이어지고, 총 길이와 컷 포인트는 변하지 않으며, 인/아웃 페이드는 각각 0.25초입니다
- 일본어 대사에 한자가 포함된 경우 워크플로우에 내장된 LLM이 히라가나로 변환한 후 H3에 전달합니다(작성자는 H3이 한자를 잘못 읽는다고 언급함); 노래와 H3 소리의 총 볼륨 옵션이 추가되었습니다; 'Song + ambience'를 사용하려면 동일한 씬에 대해 순수 소리 생성을 한 번 더 실행해야 하며, 소요 시간이 약 두 배로 증가합니다
- 도구 자체: 로컬 LLM이 프롬프트를 YuE2 스타일 태그, 가사 및 각 씬의 H3 프롬프트로 분해하며, 최대 64개의 씬을 지원하고 컷 포인트는 마디 라인에 맞춰집니다. H3 엔진은 Standard (20 스텝), Turbo 또는 FastH3 Omni (8 스텝) 중 선택 가능합니다
사용 방법
- 압축 해제 후 custom_nodes 폴더의 4개 폴더를 ComfyUI/custom_nodes에 복사하고, ComfyUI-Video-Saver를 별도로 설치하며, ComfyUI의 Python 환경에서 pip install demucs를 실행한 후 재시작하여 워크플로우를 로드하세요
- 타임라인의 각 씬에서 소리를 선택하세요; 대사는 'The silver-haired woman says: "…"'와 같이 화자를 명시한 따옴표 문장으로 작성합니다; 기본값은 여전히 'Song'이며, v8.2 프로젝트의 소리 설정은 변경되지 않습니다
리스크 및 제한 사항
- 의존성이 무겁습니다: YuE2 모델, 로컬 LLM(첫 실행 시 llama-server 및 기본 Qwen3-VL 4B 자동 다운로드), 4개의 커스텀 노드 패키지, Demucs; 비트 동기화를 위해 STRUM을 추가로 설치해야 합니다
- 유일한 예시(커버 비디오)가 숨겨져 있어 공개된 예시가 없습니다; 작성자는 이를 개인 실험용 워크플로우라고 설명합니다
- 작성자는 RTX 5060 Ti 16 GB에서 Standard 엔진으로 13.8초 길이의 씬을 만드는 데 2000초가 소요되며, FastH3 Omni NVFP4는 458초가 소요된다고 보고했습니다
- 카드 이미지는 AI로 생성된 개념도이며 모델의 실제 결과가 아닙니다; 작성자는 공개된 일반 수준의 예시를 제공하지 않습니다
비공개 목록 (3)
- Zaynab Von Vergin · MiniMaxH3 — LoRA: 원본 허구 캐릭터인 Zaynab Von Vergin(옥스퍼드의 명문 가문 출신으로 파리의 아파트에서 고급 부티크를 운영함)의 인물 LoRA입니다.
- Faith NordhavenLove · MiniMaxH3 — LoRA: 원본 허구 캐릭터인 Faith NordhavenLove(스웨덴 해안의 등대지기 보조로, 해군 블루 울 코트를 입고 니트 모자를 쓰는 것이 특징)의 인물 LoRA입니다.
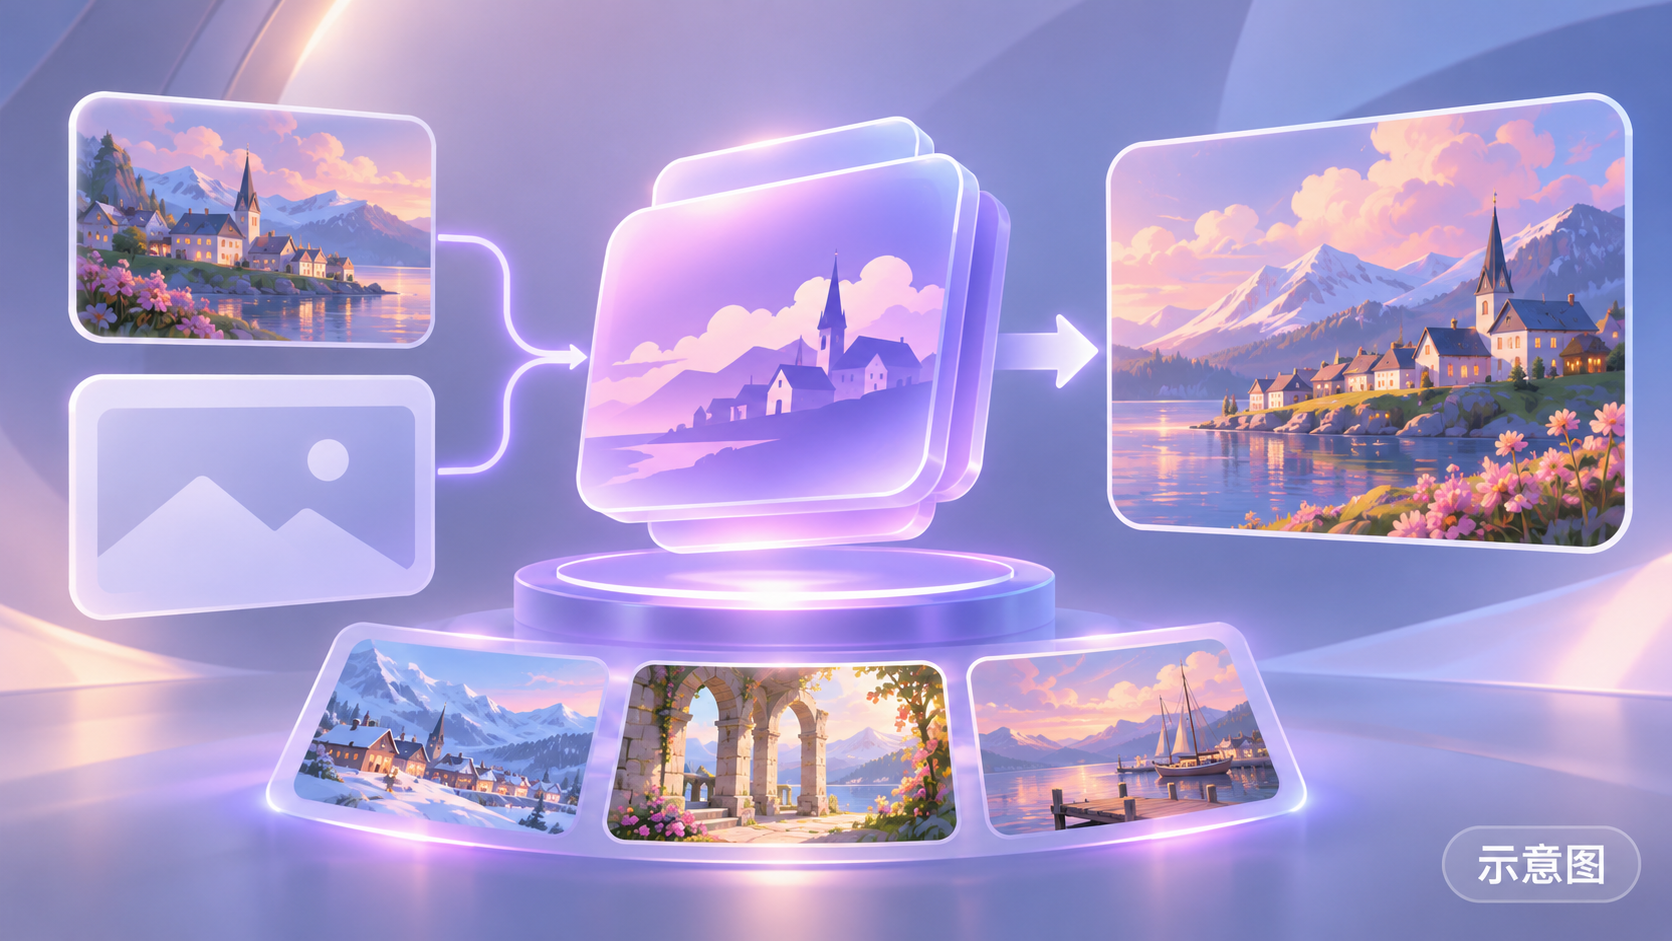
- Qwen for MinimaxH3 & Image (Updated Fast Scaled) · Scaled_Comfy_Quant — 텍스트 인코더: H3용 Qwen3-VL 32B 텍스트 인코더의 또 다른 양자화 버전: FP32 / FP16 / INT8 혼합 정밀도, 단일 파일 26.2 GB.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-14 08:48 → 11-14 21:01(베이징 시간). 추천 이유는 편집 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.