Radar AI của Trinh Trinh · MiniMax H3 · Bản tin tối 2026-11-14
Kỳ này có 9 phiên bản mới:强烈推荐 (Cực kỳ khuyến nghị) 1 · 推荐 (Khuyến nghị) 3 · 可关注 (Đáng chú ý) 2 · 仅收录 (Chỉ ghi nhận) 3
Lời tựa của biên tập viên Kỳ này đã xem xét 9 phiên bản mới của H3, gồm 1 hạng S, 3 hạng A, 2 hạng B, 3 hạng C. Nổi bật nhất là thanh trượt sét liên hoàn thứ ba của bộ hiệu ứng KinetiX: giá trị dương cho phép sét nhảy điện giữa nhiều mục tiêu, giá trị âm giữ sét tại điểm va chạm, không cần từ khóa kích hoạt. Hai LoRA tăng tốc 3–4 bước của CROWN HyperPDMD (phiên bản khung hình đầu/cuối và phiên bản tham chiếu đa hình ảnh khớp khẩu hình) có đầy đủ thông số, tự động nâng từ B lên A; LoRA âm thanh giọng nữ được tách thành từng tệp riêng cho mỗi giọng, xếp hạng A. Hai LoRA nhân vật gốc không có gì đặc biệt, ví dụ phần lớn bị ẩn, hạ xuống hạng C; việc lượng tử hóa lại bộ mã hóa văn bản không được coi là tính năng mới, xếp hạng C.
Cực kỳ khuyến nghị (1)
【S】KinetiX Elemental VFX Suite · Chain Lightning V1.0
LoRA · Cập nhật phiên bản · Tác giả make676767 · Phát hành 11-14 14:06 · Tải xuống 71
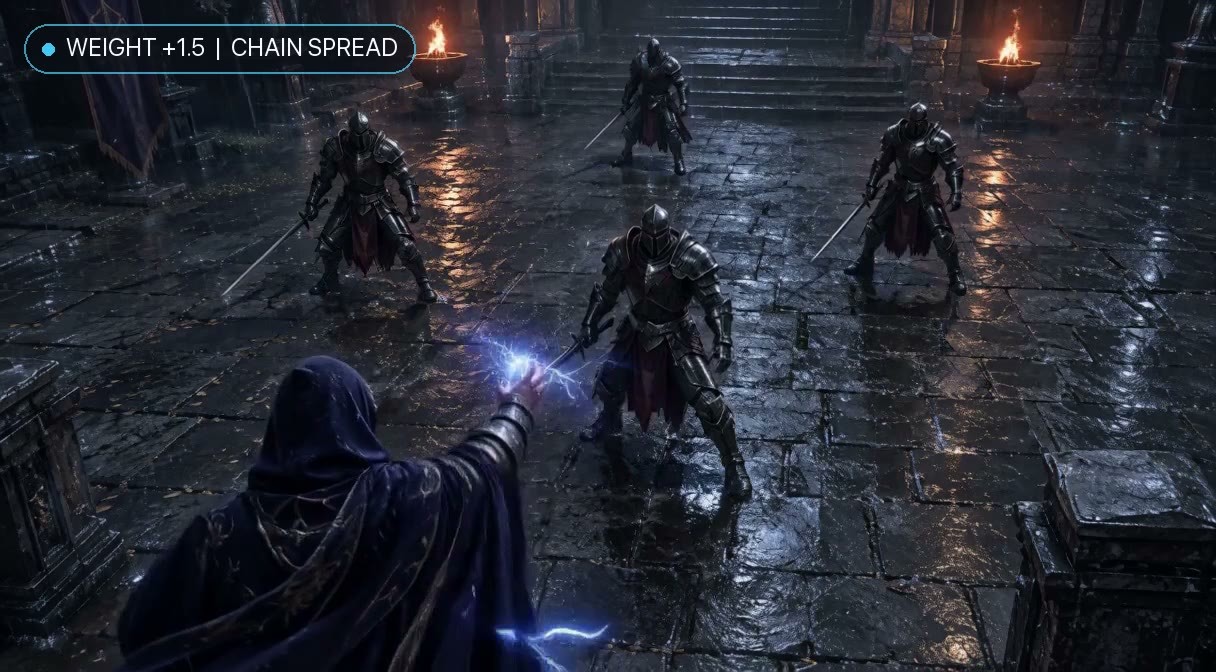
LoRA thanh trượt sét liên hoàn có thể dương hoặc âm: giá trị dương khiến sét sau khi đánh trúng mục tiêu đầu tiên sẽ nhảy điện giữa những người và vật kim loại xung quanh, giá trị âm khiến dòng điện dừng lại tại điểm va chạm mà không lan ra ngoài.
Hình minh họa
Lý do khuyến nghị
- Hiệu ứng thứ ba trong loạt hiệu ứng nguyên tố KinetiX (hai hiệu ứng trước là Fire Spread và Freeze Speed), không phải bản cập nhật của hiệu ứng cũ; mô tả phiên bản chính là giới thiệu về hiệu ứng này
- Phục vụ các cảnh quay ma thuật, chiến đấu, quá tải khoa học viễn tưởng trong video tạo từ văn bản: không cần từ khóa kích hoạt; tác giả tuyên bố không khóa màu, chỉ cần viết sét màu xanh lam, đỏ thẫm, tím hoặc vàng trong prompt để đổi màu
- Có thể thực hiện được: tác giả cung cấp các mức cường độ và 4 prompt cảnh quay có thể sao chép trực tiếp (bao gồm đối chiếu điểm đơn giá trị âm), 4 đoạn video mẫu có thể xem; tệp chỉ nặng 7 MB, giấy phép cho phép phái sinh
Cách sử dụng
- Sau khi tải LoRA, điều chỉnh strength_model: từ +1.0 bắt đầu xuất hiện sét liên hoàn đa mục tiêu, tăng cao hơn nữa là lưới điện quy mô lớn; 0 là tia lửa cục bộ thông thường; từ -1.2 đến -5 khóa điểm đơn không lan ra ngoài; không cần từ khóa kích hoạt
- Trong prompt, hãy mô tả rõ mục tiêu đầu tiên bị đánh trúng, những người hoặc vật kim loại xung quanh có thể bị nối điện (lính, áo giáp, máy móc, thùng hàng, v.v.) và màu sắc của sét; kèm theo một tệp nén tài nguyên quy trình làm việc (workflow resources)
Rủi ro và hạn chế
- Bảng cường độ của tác giả không nhất quán: mô tả tiếng Anh ghi điểm ngọt (sweet spot) là +1.0 ~ +5, mức quá tải là +1.8 ~ +2.5, hai mức này chồng lấn; mô tả tiếng Trung ghi điểm ngọt là +1.0 ~ +1.6, +1.8 ~ +5 là mức quá tải, khuyến nghị thử nghiệm từ khoảng +1 trở lên
- 3 ví dụ bị ẩn (nội dung hỗn hợp); phiên bản mô hình cơ sở, số bước không được tác giả ghi trong mô tả (có thể nằm trong tệp nén kèm theo, chưa mở để kiểm tra)
Khuyến nghị (3)
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - Ref2VA Multi-Ref & Lip-Sync (3-4 Step r38)
LoRA · Mô hình mới · Tác giả NineCrowns · Phát hành 11-14 14:39 · Tải xuống 119
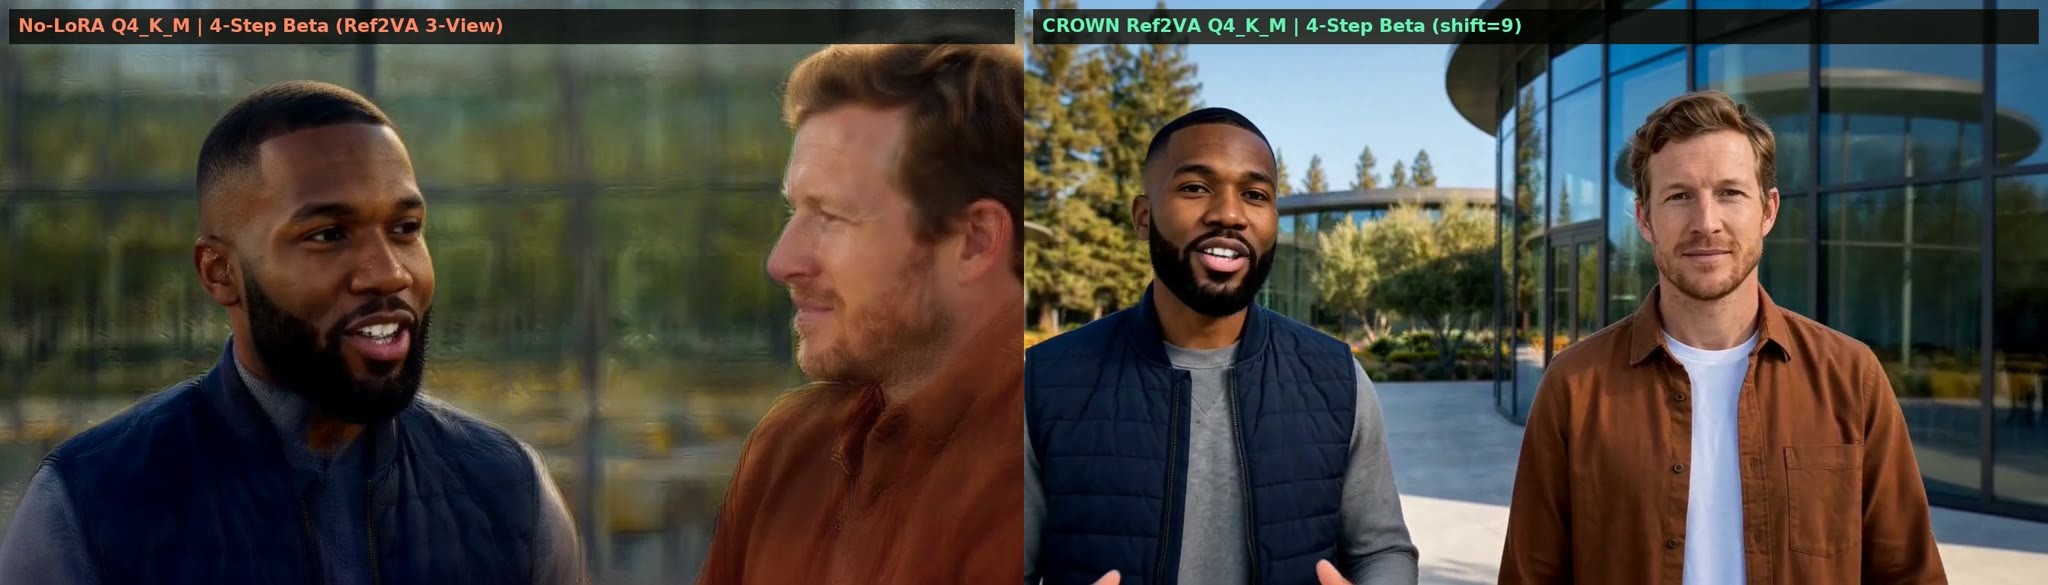
Phiên bản Ref2VA của cùng một bộ LoRA tăng tốc 3–4 bước: dùng cho tham chiếu chủ thể đa hình ảnh (hình ảnh nhân vật từ nhiều góc độ cộng với hình ảnh bối cảnh) và khớp khẩu hình theo âm thanh, tác giả tuyên bố dài nhất 15 giây, và tương thích với các mô hình cơ sở BF16, INT8 và GGUF Q4.
Hình minh họa
Lý do khuyến nghị
- Là hai phiên bản của cùng một mô hình với phiên bản FL2VA: phiên bản này chỉ đi kèm mô hình cơ sở Ref2VA, phục vụ tạo video từ hình ảnh tham chiếu và khớp khẩu hình, không làm khung hình đầu/cuối; tệp nặng 340.3 MB, tác giả tuyên bố được nén và trộn từ các điểm kiểm tra được huấn luyện trong 2000 bước
- Thông số giống phiên bản FL2VA: cường độ 1.0 (0.95 ~ 1.05), Euler, CFG 1.0, 3 hoặc 4 bước; tác giả còn khuyến nghị đặt kích thước hình ảnh tham chiếu là max, shift_video 9.0 để tăng độ rõ nét khi có nhiều nhân vật
- 2 đoạn video cộng với 1 hình ảnh có thể xem; tự động nâng từ B lên A
Cách sử dụng
- Mô hình cơ sở dùng Ref2VA: nếu VRAM dưới 9 GB, dùng GGUF Q4_K_M với UnetLoaderGGUFAdvanced (đặt patch_dtype là target), cũng có thể dùng pruned int8 convrot hoặc BF16
- Cường độ LoRA 1.0, euler + BetaSamplingScheduler, CFG 1.0, 3 hoặc 4 bước; đặt ref_image_size của MiniMaxH3ReferenceToVideo là max, đặt shift_video của MiniMaxH3SigmaShift là 9.0
Rủi ro và hạn chế
- shift_video do tác giả cung cấp là phạm vi từ 9.0 ~ 12.0, shift_audio 3.0, alpha / beta của bộ lập lịch Beta 0.6 chỉ được ghi trong thẻ mô hình đầy đủ
- Yếu tố quảng cáo nặng: chân dung chi tiết đến lỗ chân lông, chưng cất 8 tấm B200 v.v. đều là tự thuật của tác giả, không có ví dụ đối chiếu khi không dùng LoRA
- Khớp khẩu hình và tham chiếu ảnh thật của người cần sự đồng ý của chính chủ, lưu ý quyền hình ảnh; tệp nén quy trình làm việc được tải lên dưới loại "dữ liệu huấn luyện", chưa hoàn thành quét bảo mật
【A】CROWN HyperPDMD-HD 3-4 Step All-in-One Turbo & De-Quantization LoRA | MiniMax H3 (BF16 / INT8 / GGUF Q4) · v1.0 - FL2VA / I2VA / T2VA (3-4 Step r38)
LoRA · Mô hình mới · Tác giả NineCrowns · Phát hành 11-14 14:39 · Tải xuống 72
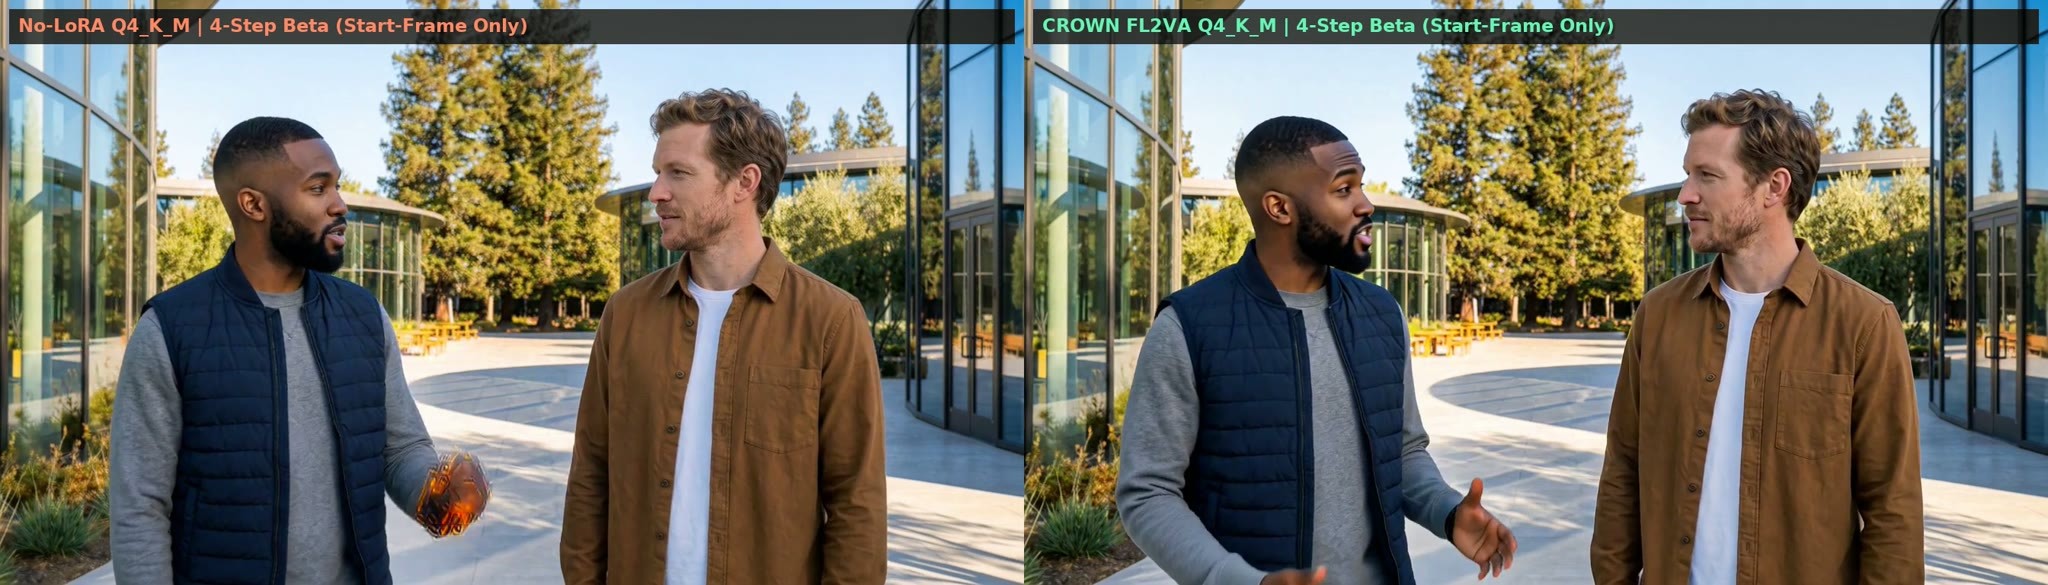
LoRA tăng tốc 3–4 bước cho H3 (phiên bản FL2VA): dùng cho tạo video từ văn bản, tạo video từ một hình ảnh và khung hình đầu/cuối, tác giả tuyên bố cùng một tệp có thể gắn vào các mô hình cơ sở BF16, INT8 và GGUF Q4, đồng thời giảm thiểu hiện tượng mờ nhòe do lượng tử hóa bit thấp.
Hình minh họa
Lý do khuyến nghị
- Một trong hai phiên bản của mô hình mới: phiên bản này đi kèm mô hình cơ sở FL2VA, bao phủ T2V, I2V và khung hình đầu/cuối, tác giả tuyên bố dài nhất 15 giây; phiên bản kia chỉ đi kèm Ref2VA (tham chiếu đa hình ảnh và khớp khẩu hình), hai phiên bản không thể thay thế cho nhau
- Tác giả tuyên bố khi chạy trực tiếp 3–4 bước mà không dùng LoRA, hình ảnh I2V từ một hình ảnh không động, khuôn mặt trong T2V thuần túy bị nhòe thành một khối, khung hình đầu/cuối có bóng ma ở giữa; LoRA này sử dụng chưng cất HyperPDMD, trong quá trình huấn luyện lần lượt làm nhiễu các mô hình cơ sở Q4_K_M, ConvRot INT8 và BF16
- Thông số đầy đủ, ví dụ có thể xem: cường độ 1.0 (0.95 ~ 1.05), Euler, CFG 1.0, 3 hoặc 4 bước; 3 đoạn video cộng với 2 hình ảnh có thể xem; tệp nặng 347 MB, kèm theo tệp nén quy trình làm việc ComfyUI; tự động nâng từ B lên A
Cách sử dụng
- Mô hình cơ sở dùng FL2VA: nếu VRAM dưới 9 GB, dùng GGUF Q4_K_M với UnetLoaderGGUFAdvanced (đặt patch_dtype là target), nếu VRAM đủ dùng pruned int8 convrot hoặc BF16
- Cường độ LoRA 1.0; SamplerCustomAdvanced + BasicGuider (CFG 1.0) + euler + BetaSamplingScheduler, 3 hoặc 4 bước, sau đó nối tiếp MiniMaxH3SigmaShift
Rủi ro và hạn chế
- Thông số lấy mẫu lệch khỏi thông lệ, và được ghi ở nửa sau của thẻ mô hình đầy đủ: phiên bản này shift_video 12.0, shift_audio 3.0, alpha / beta của bộ lập lịch Beta 0.6; nếu bỏ sót có thể không đạt được hiệu quả như ví dụ
- Yếu tố quảng cáo nặng: độ rõ nét tăng 6.5–10 lần, chưng cất 8 tấm B200, giữ lại 99.96% năng lượng đều là tự thuật của tác giả, không có ví dụ đối chiếu khi không dùng LoRA, cũng không so sánh với các LoRA Turbo hiện có
- Tệp nén quy trình làm việc được tải lên dưới loại "dữ liệu huấn luyện", chưa hoàn thành quét bảo mật
【A】Minimax Female Accents · 1.1
LoRA · Cập nhật phiên bản · Tác giả imb101 · Phát hành 11-14 10:00 · Tải xuống 173
LoRA giọng nữ chỉ tác động lên âm thanh: v1.1 tách các giọng vốn trộn lẫn trong một tệp thành mỗi giọng một LoRA, đồng thời thêm giọng Liverpool và Minnesota.
Hình minh họa
Lý do khuyến nghị
- Cập nhật phiên bản: tác giả tuyên bố mô hình đơn lẻ phiên bản cũ sẽ trộn lẫn nhiều giọng, sau khi tách ra giọng sẽ chính xác hơn; hiện tại có tổng cộng 5 tệp: Utah, Atlanta, New Jersey, Liverpool, Minnesota
- Phục vụ video có đối thoại tiếng Anh (tạo từ văn bản / tạo từ hình ảnh đều được): tác giả tuyên bố giọng tích hợp sẵn của H3 khá phẳng, bộ LoRA này chỉ huấn luyện phần âm thanh, không đụng đến phần video, không ảnh hưởng đến hình ảnh
- Tác giả công khai dữ liệu huấn luyện của phiên bản đầu tiên: 66 đoạn âm thanh, mỗi giọng 22 đoạn, được gắn nhãn tự động bằng Qwen ASR
Cách sử dụng
- Tải tệp tương ứng với giọng cần dùng, cường độ 0.6–0.8 (phiên bản cũ khuyến nghị 0.4–0.5), đặt audio sampling là 3; nếu xuất hiện âm thanh lạ kiểu vocal fry (giọng nứt) thì tăng audio sampling
- Prompt giống phiên bản cũ: sau lời thoại viết in a <tên giọng>, ví dụ The woman says <d>[English]…</d> in a atlanta accent
Rủi ro và hạn chế
- Sau khi tách, mỗi lần tạo chỉ có thể dùng một giọng, không thể làm cuộc hội thoại mà hai người nói hai giọng khác nhau
- Tác giả tuyên bố còn xa mới đạt độ chính xác, vẫn chưa chắc chắn về giọng Utah; chỉ làm giọng nữ; 1 đoạn video mẫu có thể xem, 4 cái bị ẩn (nội dung hỗn hợp)
- Mỗi tệp giọng nặng khoảng 296 MB; giấy phép cấm phái sinh
Đáng chú ý (2)
【B】Tap to Screen — MV khớp môi MiniMax H3 trên bài hát của bạn (dòng thời gian đa cảnh) · v1.3.2
Quy trình làm việc · Cập nhật phiên bản · Tác giả koyan0418439 · Phát hành 11-14 13:56 · Tải xuống 34
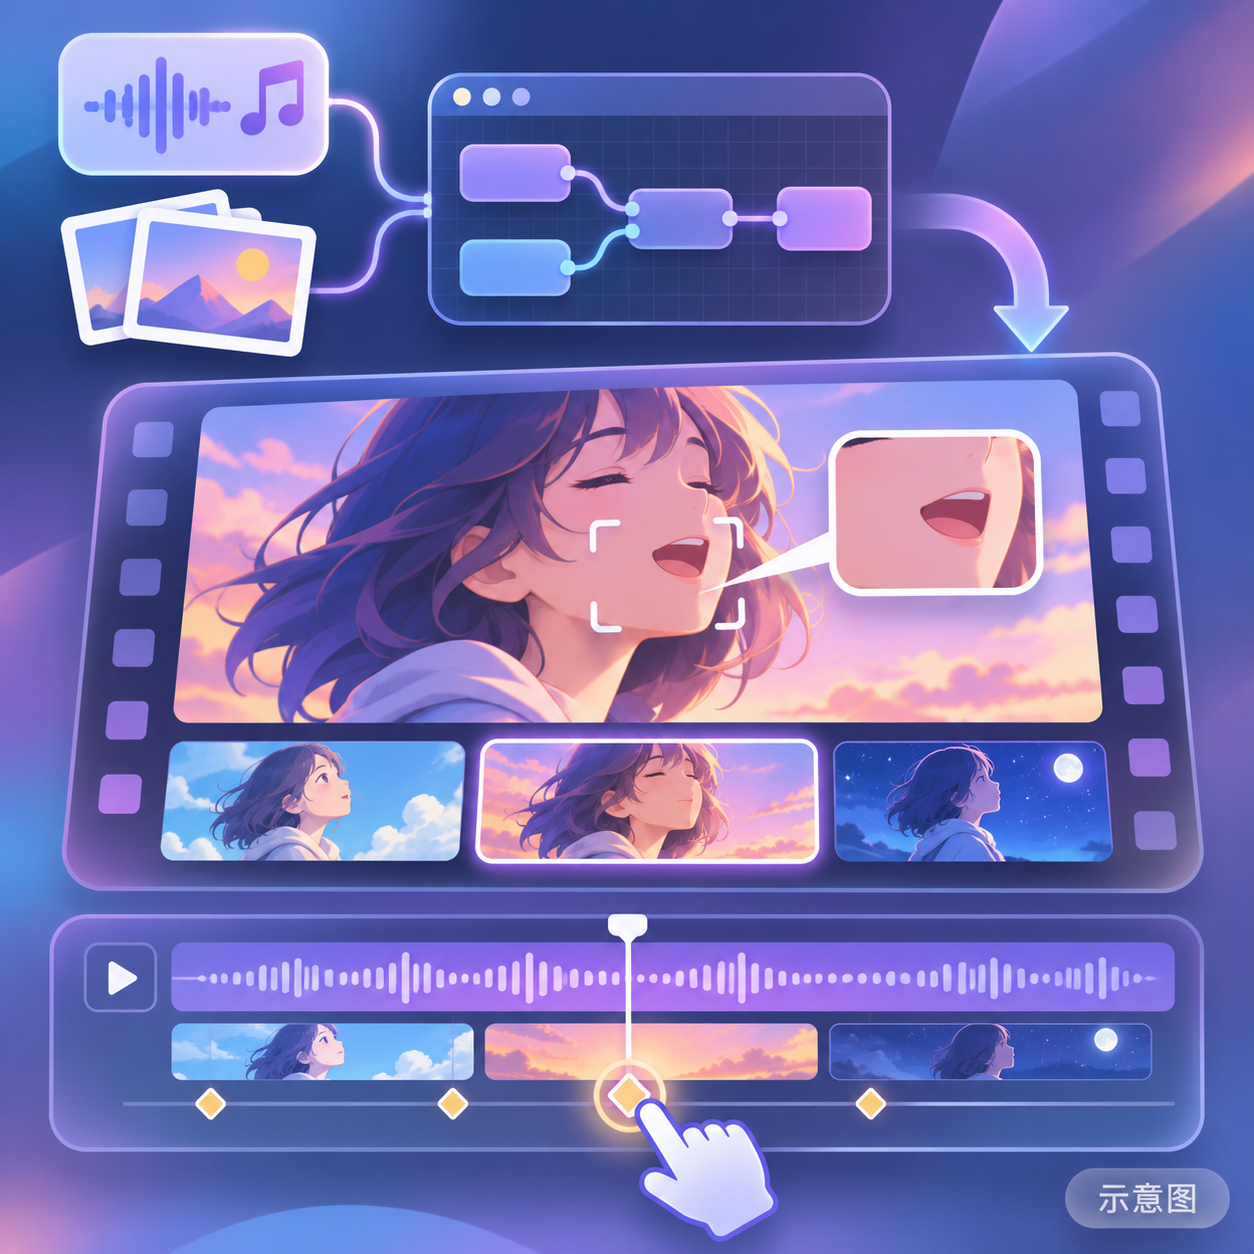
Quy trình làm việc dòng thời gian để tạo MV khớp môi đa cảnh từ bài hát và hình ảnh của riêng bạn; v1.3.2 chỉ bổ sung các định dạng xuất dành cho phần mềm chỉnh sửa video: bản gốc ProRes / FFV1 và các đoạn clip được tách theo từng cảnh.
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản, phần dòng thời gian và sinh nội dung không thay đổi: Nút Join from files và nút Export ở đầu dòng thời gian bổ sung hỗ trợ ProRes 422 HQ, ProRes 4444 (10-bit, âm thanh PCM) và bản gốc FFV1 không mất dữ liệu, mã hóa trực tiếp một lần từ khung hình gốc; mặc định h264 (crf 18) vẫn hoàn toàn giống như trước
- scene_clips xuất riêng từng cảnh (bao gồm các khung hình thừa sau điểm cắt và đoạn nhạc tương ứng), kèm theo tệp scenes.csv ghi lại thời điểm bắt đầu của mỗi đoạn trong video và bài hát, cho phép tự thực hiện chuyển cảnh trong Resolve hoặc Premiere
- Ghi tệp ổn định hơn: có dấu thời gian rõ ràng, thư mục riêng cho mỗi lần chạy, dừng trước nếu không đủ dung lượng ổ đĩa, các lần chạy thất bại sẽ không để lại tệp bị cắt dở
- Về công cụ: nhấn C khi phát nhạc để cắt cảnh, nhấn S để đánh dấu đoạn hát, mỗi đoạn nhạc được gửi đến H3 dưới dạng \u003cAudio 1\u003e để khớp môi, hỗ trợ tối đa 4 ảnh nhân vật để duy trì sự nhất quán về ngoại hình
Cách sử dụng
- Sao chép custom_nodes/ComfyUI-H3Timeline vào thư mục custom_nodes của ComfyUI và khởi động lại → Kéo quy trình làm việc từ thư mục workflows vào → Nhấn Timeline ở góc dưới bên trái của canvas để thêm nhạc và hình ảnh → Run; nếu cần bản gốc để chỉnh sửa, hãy chọn định dạng mã hóa tại nút Export ở đầu dòng thời gian và tích chọn xuất riêng từng cảnh
- Các mô hình được tác giả liệt kê: Mô hình chính H3 ref2va pruned int8, LoRA turbo 4 bước cho ref2v, Bộ mã hóa văn bản Qwen3-VL nvfp4, và VAE cho video và âm thanh
Rủi ro và hạn chế
- Phiên bản này không cải thiện về hình ảnh hay khớp môi, nếu bạn không cần chỉnh sửa bên ngoài thì vẫn có thể tiếp tục dùng v1.3.1
- Ví dụ duy nhất bị ẩn, không có ví dụ nào hiển thị công khai
- ProRes 4444 không hỗ trợ kênh alpha, khung hình nguồn vẫn là 8-bit; bản gốc FFV1 chiếm dung lượng ổ đĩa theo kích thước khung hình gốc
- Hình minh họa trên thẻ là ảnh mô phỏng do AI tạo ra, không phải hiệu ứng thực tế của mô hình; tác giả không có ví dụ công khai ở mức độ thông thường
【B】Score to Screen — Bài hát, giọng nói và cảnh quay: một studio làm video ca nhạc (YuE2 × MiniMax H3) · v9.0
Quy trình làm việc · Cập nhật phiên bản · Tác giả koyan0418439 · Phát hành 11-14 19:06 · Tải xuống 14
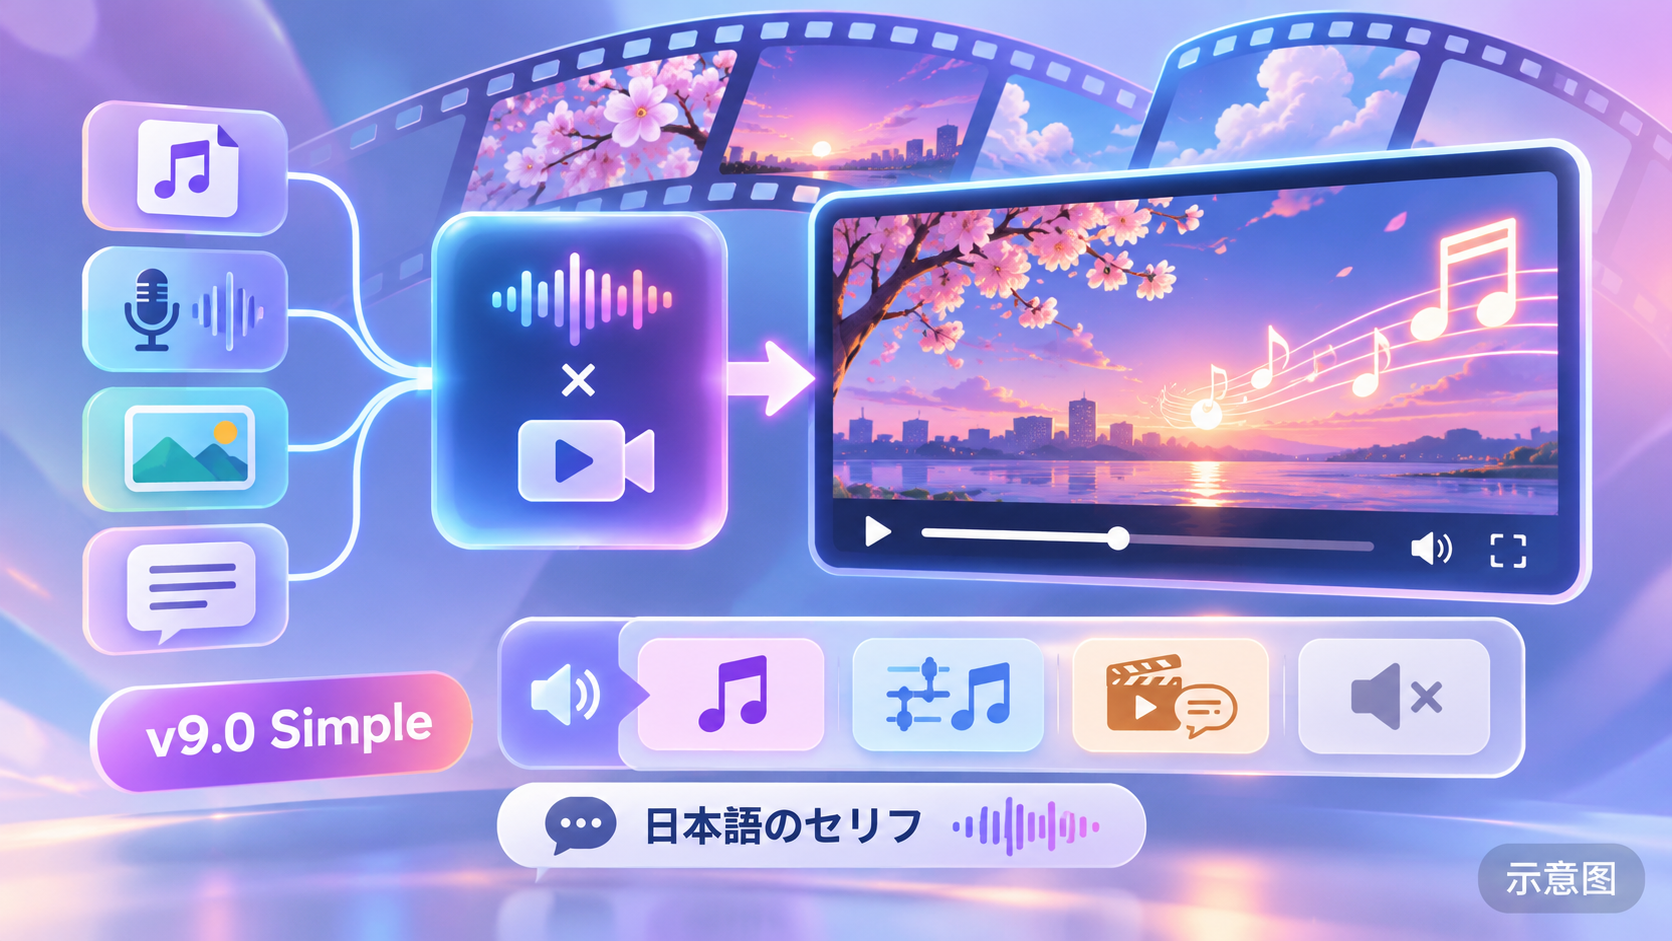
Quy trình làm việc tạo MV khớp môi đa cảnh bằng cách dùng YuE2 để sáng tác và hát, H3 để sinh video, chỉ với một câu lệnh prompt và vài hình ảnh; v9.0 cho phép chọn âm thanh riêng cho từng cảnh: bài hát, thoại và âm thanh hiện trường do H3 tự sinh, bài hát kèm âm thanh môi trường, hoặc tắt tiếng.
Hình minh họa
Lý do đề xuất
- Cập nhật phiên bản (so với v8.2): Khung cảnh trong dòng thời gian bổ sung tùy chọn This scene's sound; khi chọn H3's sound, cảnh đó sẽ không phát bài hát, lời thoại trong dấu ngoặc kép được nói nguyên văn bởi nhân vật chỉ định, những người khác im lặng; bài hát vẫn chạy ngầm phía sau và nối lại sau đó, tổng thời lượng và điểm cắt không đổi, hiệu ứng fade in/out mỗi bên kéo dài 0.25 giây
- Lời thoại tiếng Nhật chứa chữ Hán sẽ được LLM tích hợp trong quy trình làm việc chuyển sang hiragana trước khi gửi cho H3 (tác giả cho biết H3 đọc sai chữ Hán); bổ sung điều chỉnh âm lượng tổng thể cho bài hát và giọng nói của H3; tùy chọn Song + ambience yêu cầu chạy lại riêng phần âm thanh cho cùng một cảnh, thời gian xử lý tăng gấp đôi
- Về công cụ: LLM cục bộ phân tách prompt thành các thẻ phong cách YuE2, lời bài hát và prompt cho H3 của từng cảnh, hỗ trợ tối đa 64 cảnh, điểm cắt nằm trên vạch nhịp, có thể chọn engine H3 là Standard (20 steps), Turbo hoặc FastH3 Omni (8 steps)
Cách sử dụng
- Sau khi giải nén, sao chép 4 thư mục trong custom_nodes vào ComfyUI/custom_nodes, cài thêm ComfyUI-Video-Saver, và chạy pip install demucs trong môi trường Python của ComfyUI, khởi động lại rồi tải quy trình làm việc
- Chọn âm thanh cho từng cảnh trong dòng thời gian; viết lời thoại dưới dạng câu có dấu ngoặc kép kèm tên người nói, ví dụ: The silver-haired woman says: "…"; mặc định vẫn là Song, âm thanh của các dự án v8.2 không thay đổi
Rủi ro và hạn chế
- Phụ thuộc nặng: Mô hình YuE2, LLM cục bộ (tự động tải llama-server và Qwen3-VL 4B mặc định lần đầu), 4 gói node tùy chỉnh, Demucs; đồng bộ nhịp trống còn cần cài thêm STRUM
- Ví dụ duy nhất (video bìa) bị ẩn, không có ví dụ nào hiển thị công khai; tác giả cho biết đây là quy trình làm việc thử nghiệm cá nhân
- Tác giả mất 2000 giây để tạo một cảnh dài 13.8 giây bằng engine Standard trên RTX 5060 Ti 16 GB, và 458 giây với FastH3 Omni NVFP4
- Hình minh họa trên thẻ là ảnh mô phỏng do AI tạo ra, không phải hiệu ứng thực tế của mô hình; tác giả không có ví dụ công khai ở mức độ thông thường
Chỉ liệt kê (3)
- Zaynab Von Vergin · MiniMaxH3 — LoRA: LoRA nhân vật cho Zaynab Von Vergin hư cấu nguyên bản (xuất thân từ gia đình danh giá ở Oxford, điều hành cửa hàng thời trang cao cấp trong căn hộ tại Paris).
- Faith NordhavenLove · MiniMaxH3 — LoRA: LoRA nhân vật cho Faith NordhavenLove hư cấu nguyên bản (trợ lý người gác đèn hải đăng trên mũi đá ở Thụy Điển, thường mặc áo khoác dạ xanh navy và đội mũ len).
- Qwen for MinimaxH3 & Image (Updated Fast Scaled) · Scaled_Comfy_Quant — Bộ mã hóa văn bản: Một phiên bản lượng tử hóa khác của bộ mã hóa văn bản Qwen3-VL 32B dùng cho H3: độ chính xác hỗn hợp FP32 / FP16 / INT8, dung lượng tệp đơn 26.2 GB.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ thu thập từ 11-14 08:48 đến 11-14 21:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.