Radar IA de Zhenzhen · MiniMax H3 Image · Édition du soir 2026-11-16
Cette édition compte 5 nouvelles versions : fortement recommandé 0 · recommandé 3 · à suivre 1 · inclus uniquement 1
Note de l'éditeur Cette édition a examiné 5 nouvelles versions de H3 Image, avec 3 A, 1 B et 1 C. La recommandation principale est le flux de travail d'édition réaliste de voidhunter77 : utiliser l'image originale et un gros plan du visage comme référence pour modifier la scène, la pose et les vêtements tout en préservant les traits du personnage en 16 MP. L'auteur a clairement détaillé la méthode d'échantillonnage et les cas d'échec, mais n'a testé que sur une carte graphique de 96 Go. Le style d'animation plat de rurudo et le LoRA de tenue de camouflage Woodland ont des paramètres ou des mots-clés de déclenchement clairs, classés A ; la version quantifiée GGUF propose deux niveaux, Q4_K_M et Q8_0, ainsi que des flux de travail associés, mais sans exemples visibles, classée B ; le flux de travail « BETTER RESULTS » avec une seule ligne de description est classé C.
Recommandations (3)
【A】MiniMax H3 Image : Flux de travail d'édition réaliste (16 MP, ComfyUI) · v1.0
Flux de travail · Nouveau modèle · Auteur voidhunter77 · Publié le 11-16 17:44 · Téléchargements 55
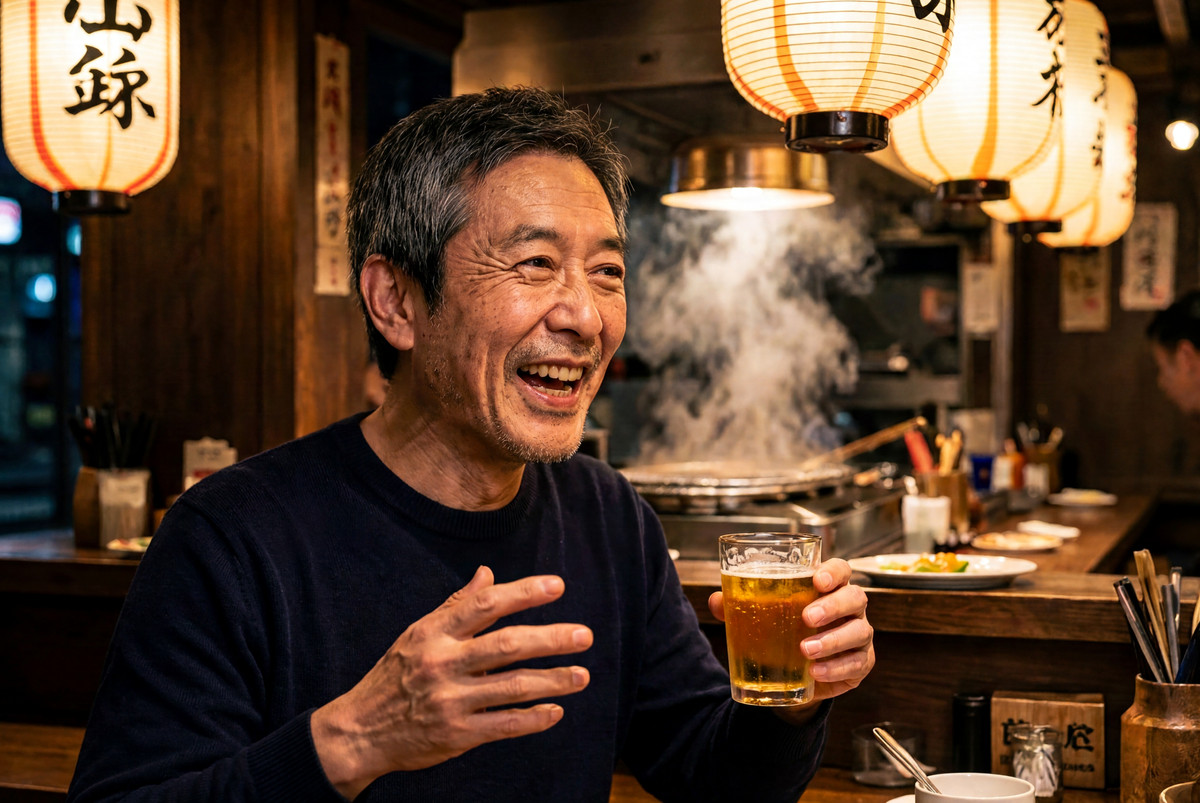
Flux de travail ComfyUI pour la retouche réaliste avec H3 Image : entrez une photo et un gros plan du visage, modifiez la composition, la pose, les vêtements, le lieu et l'éclairage selon le prompt, tout en préservant les traits du personnage original, en générant en 16 MP pour obtenir des détails de peau, de cheveux fins et de texture de tissu.
La fiche complète du modèle comprend également une section sur les expériences d'agrandissement : l'auteur affirme que 16–64 MP conviennent à un usage quotidien, au-delà de quoi les textures fines commencent à apparaître en blocs.
Illustrations
Raisons de la recommandation
- Fournit deux versions équivalentes : une version par défaut utilisant le nœud unique KSampler de H3 Image (comfyui-h3-sampler, GPL-3.0), et une version avec tous les paramètres visibles utilisant des nœuds natifs et RES4LYF ; l'auteur affirme que la composition et le rendu sont cohérents avec la même graine
- L'auteur explique la recette : le modèle est distillé sur une grille de bruit fixe de 6 étapes, utilisant Euler standard pour la phase structurelle, puis remplaçant les deux dernières étapes par res_2s_rkmk2e avec un eta de 0.65 de nouveau bruit pour produire les pores et le grain ; il affirme que dans des tests sur 10 graines, d'autres échantillonneurs dessinaient des objets en double
- Inclut 20 images d'exemple, chacune intégrant le flux de travail pouvant être glissé dans ComfyUI ; gratuit, la licence permet la génération d'images et la vente
Comment l'utiliser
- Placez la photo à modifier dans Picture 1 et un recadrage serré du visage de la même personne (avec un peu de cheveux) dans Picture 2 ; conservez les trois premières et les trois dernières phrases du prompt, ne remplacez que la description de la scène au milieu, et maintenez 16 MP
- Nécessite une version récente de ComfyUI (testée par l'auteur sur 0.45.3), un modèle de diffusion de 21 Go, un encodeur de texte int8 de 27 Go (les cartes Blackwell peuvent utiliser la version NVFP4 de 15.7 Go) et un VAE de 1.2 Go ; la version nœud nécessite un git clone de comfyui-h3-sampler, l'autre version nécessite d'installer RES4LYF via le Manager
Risques et limitations
- L'auteur n'a testé que sur une RTX PRO 6000 de 96 Go, il est inconnu si les cartes graphiques standard peuvent gérer 16 MP ; la page complète de l'auteur mentionne un temps de calcul d'environ trente secondes à une minute par image
- L'auteur affirme que les expressions très fortes (crier, pleurer) déforment le visage au maximum, et que le texte imprimé sur les vêtements a tendance à sembler collé, à avoir des fantômes ou des fautes d'orthographe
【A】[H3 image] style rurudo (るるど) · v0.8
LoRA · Nouveau modèle · Auteur KaleidRuby · Publié le 11-16 09:26 · Téléchargements 53
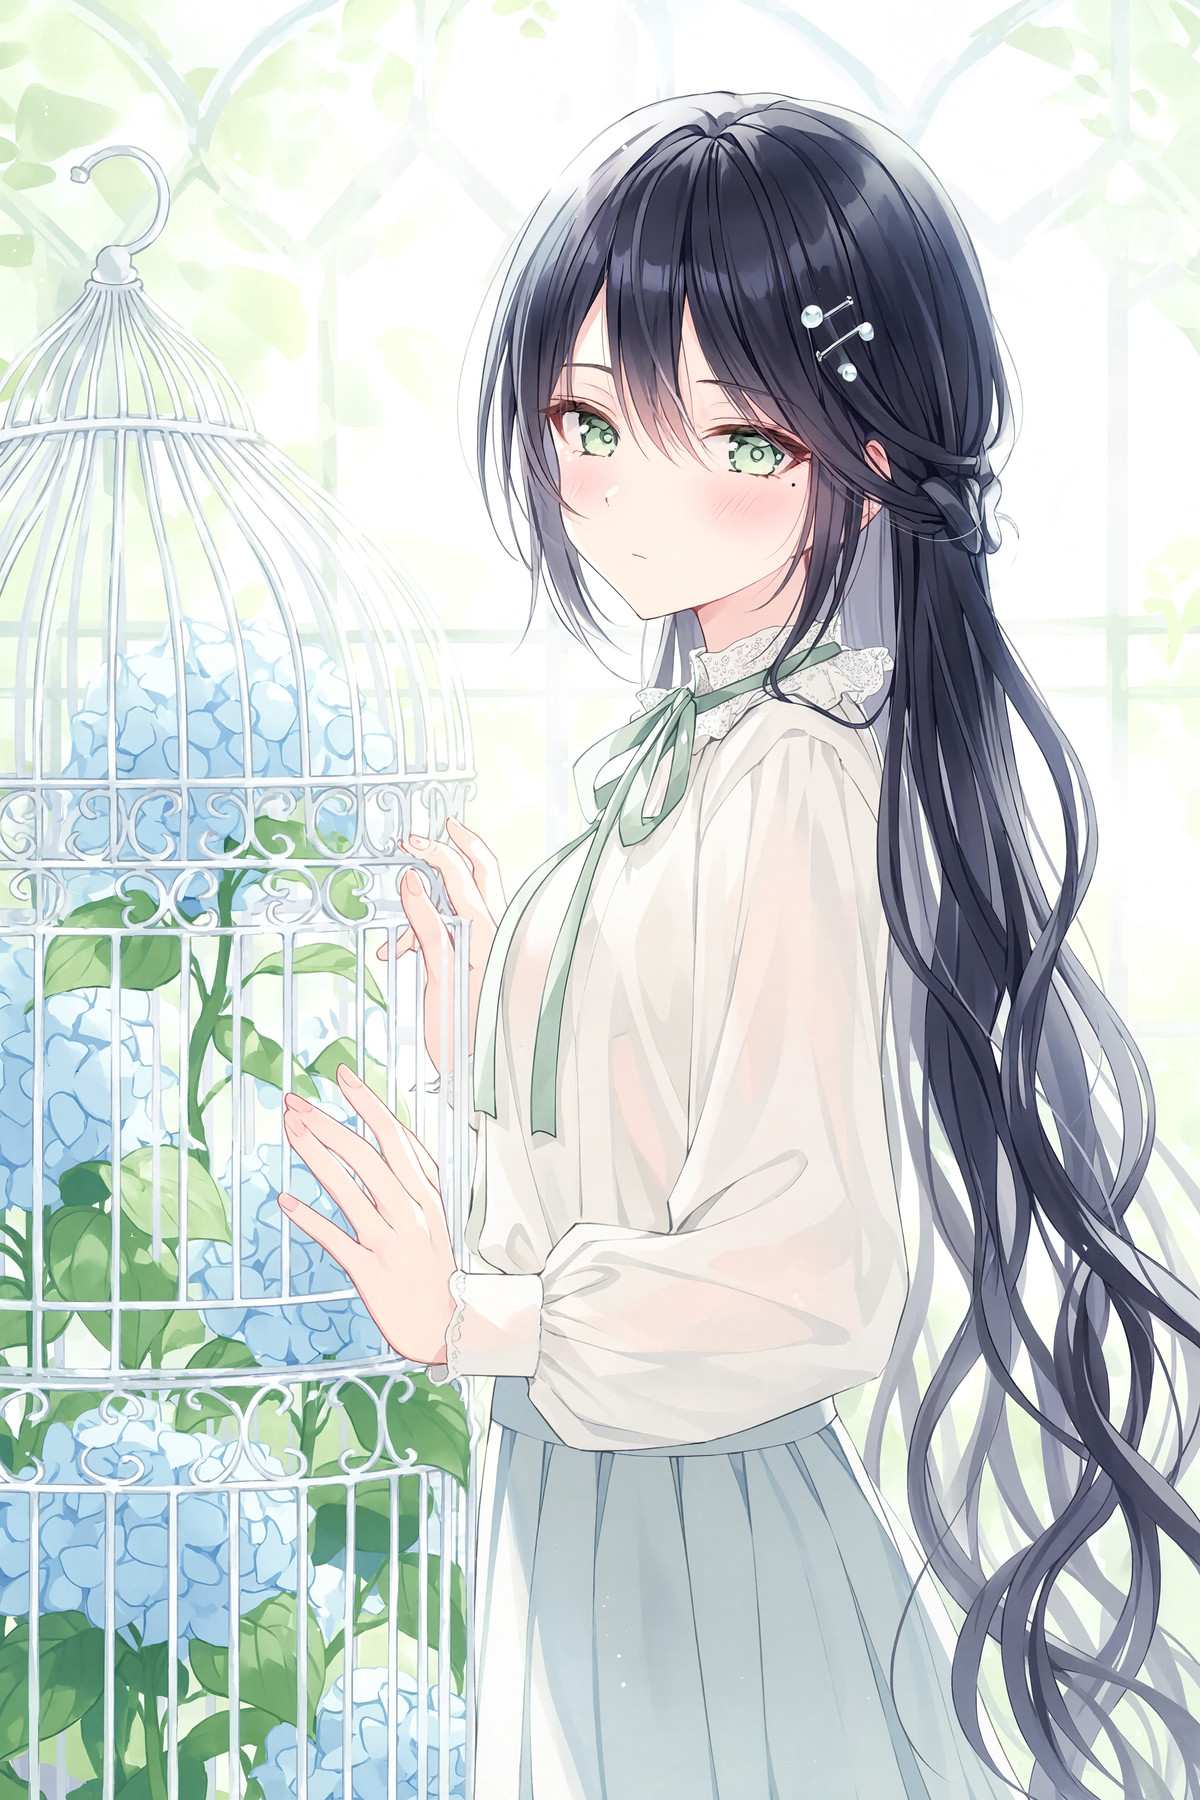
LoRA H3 Image au style de l'illustratrice japonaise rurudo (るるど) : coloration d'animation plate, mot-clé de déclenchement @rurudo, l'auteur précise qu'il est destiné uniquement à H3 Image, pas à la version vidéo.
Illustrations
Raisons de la recommandation
- Paramètres complets : 16MP, cfg=1, step=6, intensité 0.8-1.5
- L'auteur avertit que H3 Image produit des images corrompues lorsque l'intensité totale de tous les LoRA dépasse 2.0, augmenter le nombre d'étapes de 6 à 12 peut atténuer ce problème, utile lors de l'empilement de LoRA
- Inclut 4 exemples visibles ; gratuit, la licence permet la génération d'images et la vente
Comment l'utiliser
- Chargez rurudo_h3_v3.safetensors, écrivez @rurudo dans le prompt ; 16MP, cfg=1, 6 étapes, intensité 0.8-1.5
- Lors de l'empilement avec d'autres LoRA, si l'intensité totale dépasse 2.0, augmentez le nombre d'étapes à 12
Risques et limitations
- Imitation du style personnel d'un artiste vivant, évaluez par vous-même avant toute utilisation commerciale
- Version v0.8, les 4 exemples sont masqués, la description ne fait que quelques lignes
Mots-clés de déclenchement : @rurudo
【A】Woodland Camo BDU, H3 Image (et vidéo ?) · v1.0
LoRA · Nouveau modèle · Auteur andyx1976 · Publié le 11-16 09:05 · Téléchargements 35
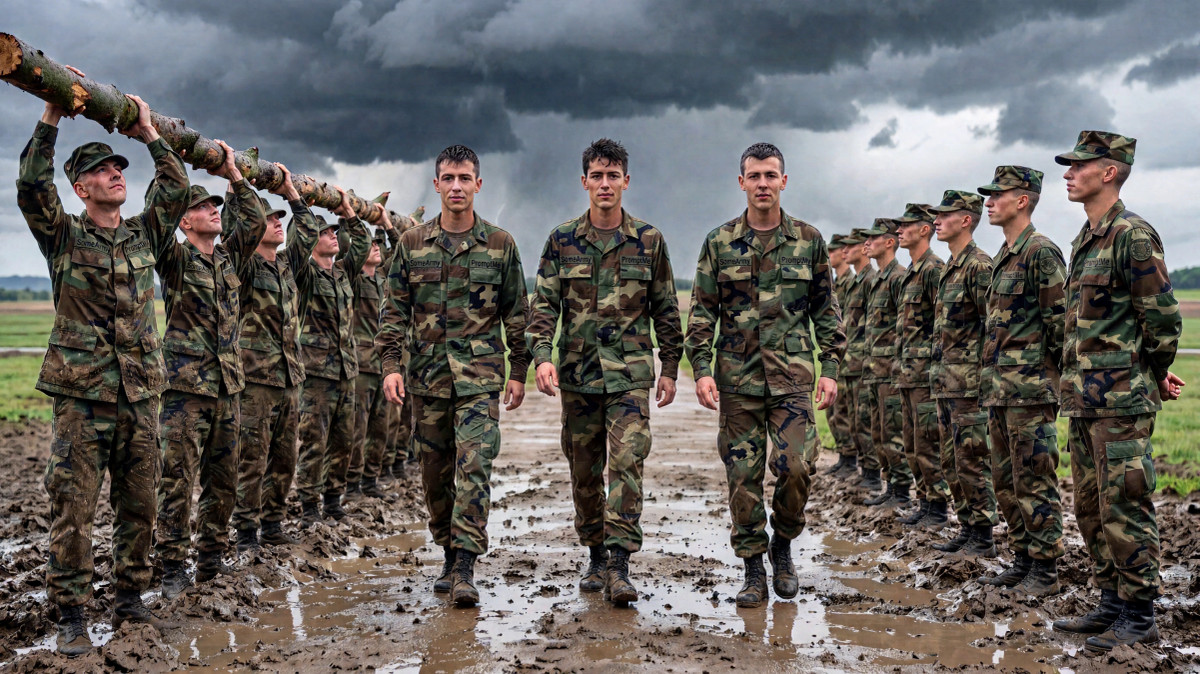
Version H3 Image du LoRA de tenue de camouflage Woodland (BDU) : habille les personnages avec des tenues de combat rétro de l'armée américaine à motif camouflage forêt, mot-clé de déclenchement Woodland Camo BDU.
Illustrations
Raisons de la recommandation
- L'auteur affirme que sans LoRA, H3 dessine des tenues de combat modernes avec poches obliques, ce LoRA sert à corriger vers le style rétro, et nécessite plus explicitement le mot-clé de déclenchement que les versions pour d'autres modèles de base
- L'auteur affirme qu'il fonctionne aussi sur H3 Video, les vidéos d'exemple n'ont pas d'image de départ, les vêtements sont entièrement générés par le LoRA ; sur p-h3, les détails comme les plaques nominatives deviennent désordonnés
- Inclut 6 images et 1 vidéos ; gratuit, la licence permet la génération d'images et la vente ; l'auteur a ajouté des notes d'entraînement : sur H3, un rank 16 est trop faible, un rank 32 est meilleur
Comment l'utiliser
- Écrivez Woodland Camo BDU dans le prompt (l'auteur ne l'a pas enregistré dans la version, mais l'a mentionné dans la description) ; l'auteur mentionne qu'une intensité d'environ 0.8 laisse plus de marge au modèle
- Le nombre d'étapes et le CFG ne sont pas donnés par l'auteur ; l'auteur affirme qu'il peut être utilisé avec des modèles affinés H3 comme 10eros
Risques et limitations
- Les images d'entraînement sont souvent de vieilles photos de faible résolution, l'auteur affirme qu'en 16 MP, les détails sont comblés par le modèle, « n'espérez pas de miracles »
- L'auteur affirme que la complexité et la structure corporelle sont inférieures à celles de modèles comme Krea2
À suivre (1)
【B】Minimax H3 Image - GGUF · v1.0
Modèle de base / Checkpoint · Nouveau modèle · Auteur molbal · Publié le 11-16 17:40 · Téléchargements 21
Conversion quantifiée GGUF du modèle de base H3 Image, offrant deux niveaux Q4_K_M et Q8_0, avec deux flux de travail associés pour la génération de texte à image et l'édition, utilisant le nœud de chargement GGUF maintenu par l'auteur.
Illustrations
Raisons de la recommandation
- Sert les utilisateurs dont la mémoire vidéo est insuffisante pour charger les poids originaux : le fichier Q4_K_M est beaucoup plus petit que Q8_0, permettant de choisir selon la mémoire vidéo disponible
- Fournit simultanément deux flux de travail : minimax-h3-image-gguf.json (texte à image) et minimax-h3-image-edit-gguf.json (édition)
- Gratuit, la licence permet la génération d'images et la vente
Comment l'utiliser
- Installez la branche ComfyUI-GGUF de l'auteur (comfyui-gguf-reboot), utilisez son nœud de chargement pour lire les fichiers gguf et remplacer le modèle de base original, puis importez les flux de travail associés
- L'auteur ne précise pas si l'encodeur de texte et le VAE nécessitent aussi des versions quantifiées, ni le nombre d'étapes ou le CFG
Risques et limitations
- Le seul exemple est masqué, aucune comparaison n'est disponible pour évaluer la perte de qualité due à la quantification
- La description ne fait que deux lignes ; nécessite l'utilisation d'un nœud de chargement GGUF non officiel
- L'illustration de la fiche est un schéma généré par IA, pas le rendu réel du modèle ; l'auteur n'a pas d'exemples publics de niveau standard
Inclus uniquement (1)
- mini max image - Flux de travail BETTER RESULTS - très belle qualité avec un upsampleur de prompt plus rapide · v1.0 — Flux de travail : adaptation du flux de travail de Qwen 2.1 pour H3 Image dans ComfyUI, le nom indique un upsampleur de prompt plus rapide, la description ne fait qu'une seule ligne.
Données : API publique Civitai (modèle de base MiniMax H3), fenêtre d'inclusion du 11-16 08:31 au 11-16 21:01 (heure de Pékin). Les raisons de recommandation ont été revues par les éditeurs ; le nombre de téléchargements reflète uniquement l'attention portée.