貞貞のAIレーダー · MiniMax H3 Image · 2026-11-16 夕刊
今号の 5 件の新バージョン:強く推奨 0 · 推奨 3 · 注目 1 · 収録のみ 1
編集者による按語 今号では H3 Image の新バージョン 5 件をレビューし、A評価が 3 件、B評価が 1 件、C評価が 1 件でした。初推しは voidhunter77 によるリアル編集ワークフローです。元画像と顔のクローズアップを参照画像として使用し、16 MP でシーン、ポーズ、服装を変更しながら人物の顔立ちを保持します。作者はサンプリングの考え方と失敗パターンを明確に記述していますが、96 GB の GPU でのみテストされています。rurudo のフラットアニメ画風と Woodland カモフラージュBDU LoRA は、パラメータやトリガーワードが明確であるため A 評価としました。GGUF 量子化版には Q4_K_M と Q8_0 の2段階と対応ワークフローがありますが、確認可能なサンプルがないため B 評価としました。説明が一文のみの「BETTER RESULTS」ワークフローは C 評価としました。
推奨(3)
【A】MiniMax H3 Image: Realism Edit Workflow (16 MP, ComfyUI) · v1.0
ワークフロー · 新モデル · 作者 voidhunter77 · 公開 11-16 17:44 · ダウンロード数 55
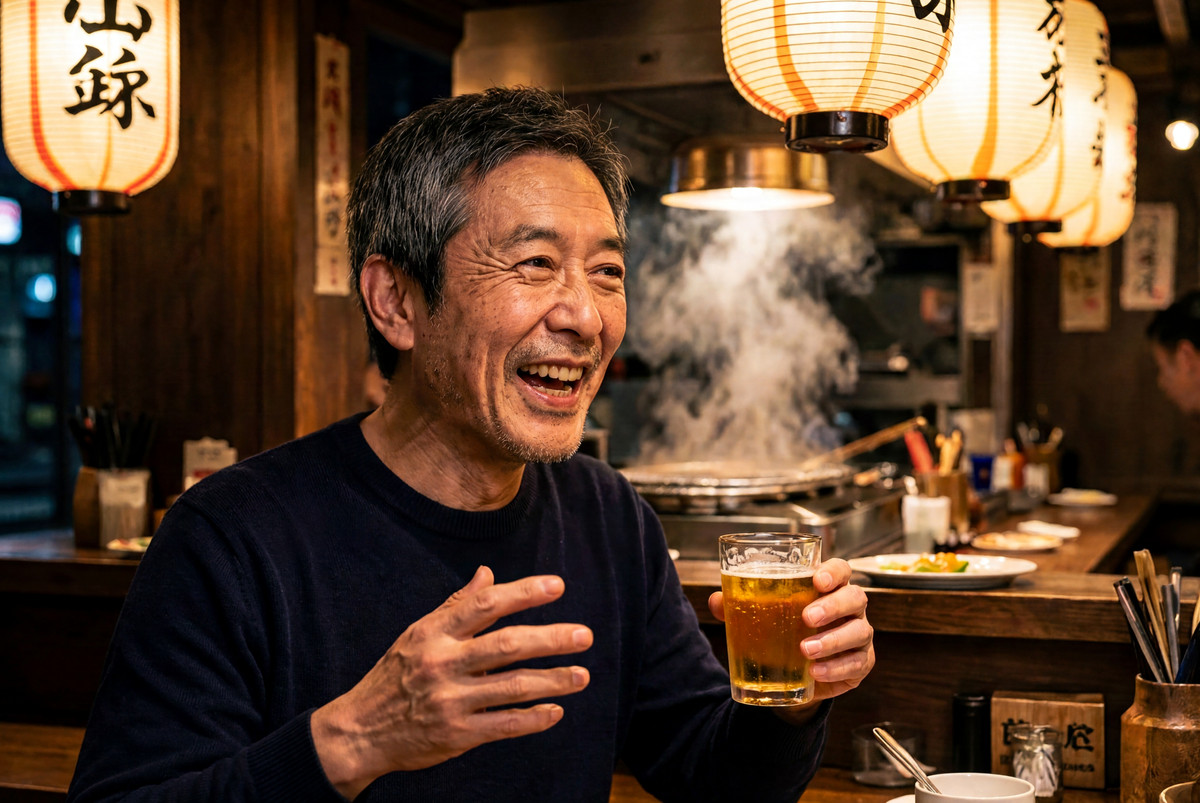
H3 Image 用のリアルな画像編集 ComfyUI ワークフローです。写真1枚と顔のクローズアップ1枚を入力し、プロンプトに従って構図、ポーズ、服装、場所、ライティングを変更しながら、元の人物の顔立ちを保持します。16 MP で出力することで、肌、細かな髪、布地の質感を表現します。
完全なモデルカードにはアップスケーリングの実験セクションもあります。作者は 16–64 MP が日常使用に適しており、それ以上では細かなテクスチャにブロックノイズが発生し始めると述べています。
画像
推奨理由
- 2つの同等バージョンを提供しています。H3 Image KSampler 単一ノード(comfyui-h3-sampler、GPL-3.0)のデフォルトパラメータ版と、ネイティブノードと RES4LYF を組み合わせた全パラメータ可視版です。作者は同じシードで構図と見た目が一致すると述べています。
- 作者はレシピを説明しています。モデルは固定の 6 ステップのノイズグリッド上で蒸留されており、構造段階では通常の Euler を使用し、最後の2ステップでは res_2s_rkmk2e に切り替えて eta 0.65 の新しいノイズを追加することで、毛穴や粒子感を生成します。10 個のシードでのテストでは、他のサンプラーでは重複した物体が描かれると述べています。
- 20 枚のサンプル画像を添付しており、各画像にはワークフローが埋め込まれているため ComfyUI にドラッグ&ドロップできます。無料で、ライセンスでは画像生成と販売が許可されています。
使い方
- Picture 1 に編集したい写真を、Picture 2 に同じ人物の顔のトリミング画像(髪を少し含める)を配置します。プロンプトは最初の3文と最後の3文を保持し、中間のシーン記述のみを置き換えます。16 MP を維持してください。
- 新しい ComfyUI(作者は 0.45.3 でテスト)、拡散モデル 21 GB、int8 テキストエンコーダ 27 GB(Blackwell では 15.7 GB の NVFP4 版が利用可能)、および 1.2 GB の VAE が必要です。ノード版は comfyui-h3-sampler を git clone してインストールし、もう一方のバージョンは Manager から RES4LYF をインストールします。
リスクと制限
- 作者は 96 GB の RTX PRO 6000 でのみテストしており、一般的な GPU で 16 MP が実行可能かどうかは不明です。作者の完全なページには、1枚あたり約30秒から1分かかるという処理時間が記載されています。
- 作者は、強い表情(叫び、泣き)では顔が最も変化しやすく、衣服の印刷文字は貼り付けたように見えたり、二重像になったり、スペルミスが生じやすいと述べています。
【A】[H3 image]rurudo style (るるど) · v0.8
LoRA · 新モデル · 作者 KaleidRuby · 公開 11-16 09:26 · ダウンロード数 53
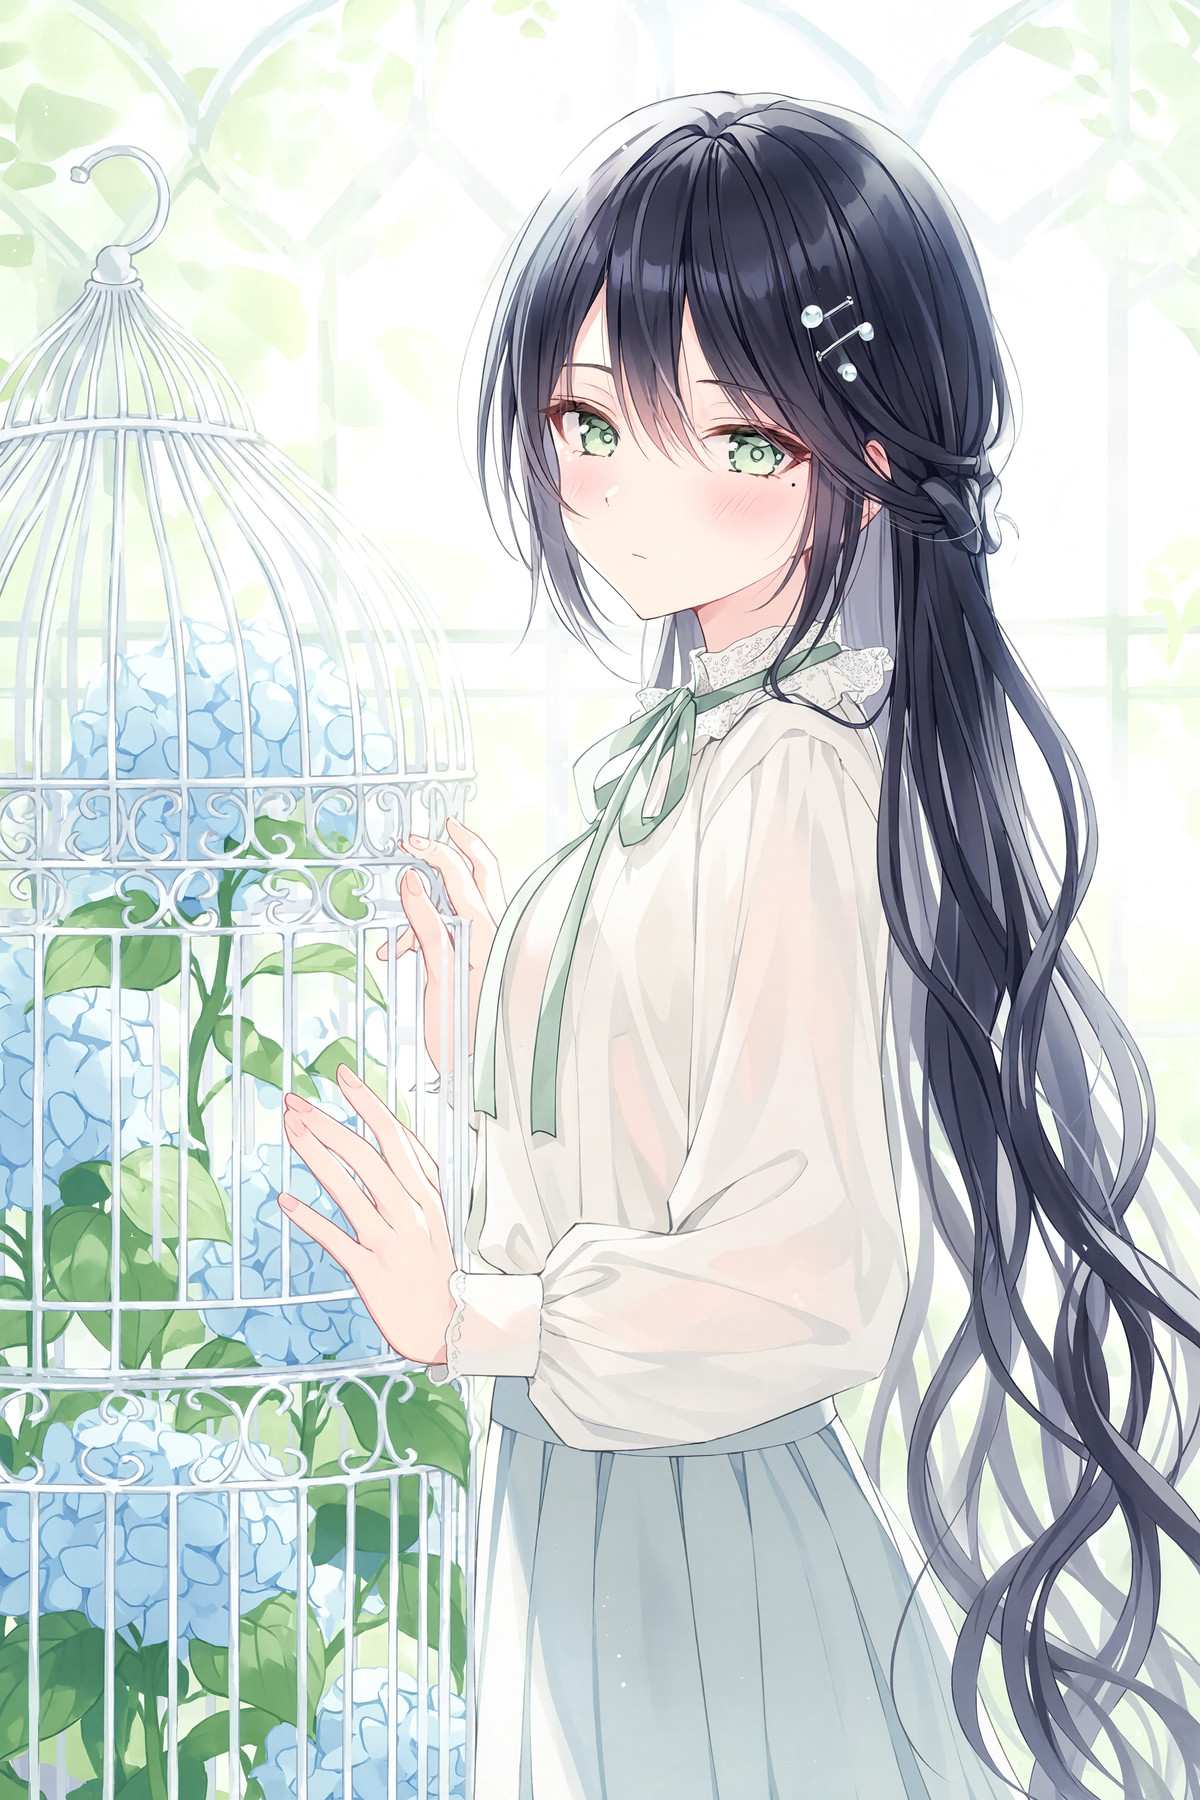
日本のイラストレーター rurudo(るるど)の画風を模倣した H3 Image 用 LoRA です。フラットなアニメ調の彩色で、トリガーワードは @rurudo です。作者は H3 Image 専用であり、ビデオ版ではないことを明記しています。
画像
推奨理由
- パラメータが完全に記載されています:16MP、cfg=1、step=6、強度 0.8-1.5
- 作者は、H3 Image ですべての LoRA の総強度が 2.0 を超えると画像が破綻すると指摘しています。ステップ数を 6 から 12 に増やすことで緩和でき、LoRA を重ねる際に有効です。
- 4 枚の確認可能なサンプルを添付しています。無料で、ライセンスでは画像生成と販売が許可されています。
使い方
- rurudo_h3_v3.safetensors を読み込み、プロンプトに @rurudo を記述します。16MP、cfg=1、6 ステップ、強度 0.8-1.5 を使用します。
- 他の LoRA と併用し、総強度が 2.0 を超える場合は、ステップ数を 12 に増やします。
リスクと制限
- 存命中の画家の個人画風を模倣しているため、商用利用前に自己責任で評価してください。
- バージョン番号は v0.8 で、4 個のサンプルは非表示になっており、説明は数行のみです。
トリガーワード:@rurudo
【A】Woodland Camo BDU, H3 Image (and video?) · v1.0
LoRA · 新モデル · 作者 andyx1976 · 公開 11-16 09:05 · ダウンロード数 35
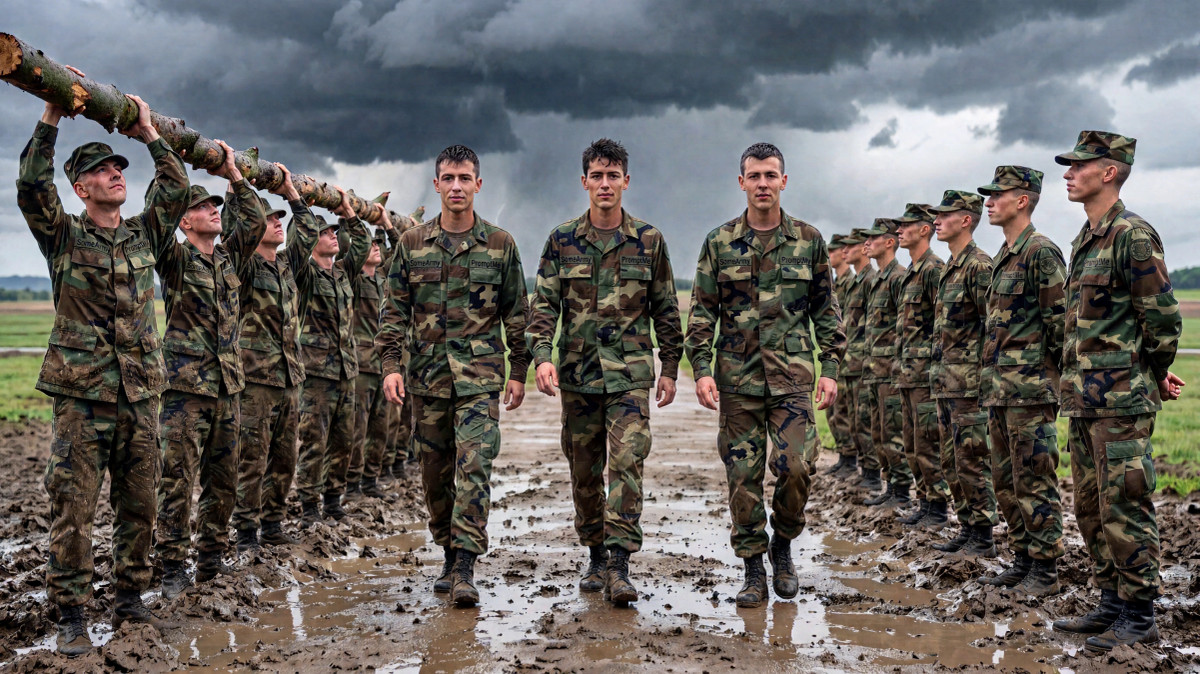
レトロな Woodland カモフラージュBDU(戦闘服)の服装 LoRA の H3 Image 版です。人物に林地カモフラージュ柄のレトロな米軍BDUを着用させます。トリガーワードは Woodland Camo BDU です。
画像
推奨理由
- 作者は、LoRA なしでは H3 が斜めポケット付きの現代的なBDUを描く傾向があり、この LoRA はそれをレトロなスタイルに修正するために使用されると述べています。また、他のベースモデル版よりもトリガーワードの記述が重要だと指摘しています。
- 作者は H3 Video でも使用可能だと述べており、サンプル動画では初期画像がなく、服装は完全に LoRA によって生成されています。p-h3 ではネームプレートなどのディテールが乱れることがあります。
- 6 枚の画像と 1 本の動画を添付しています。無料で、ライセンスでは画像生成と販売が許可されています。作者は訓練の知見も添付しており、H3 では rank 16 は弱く、rank 32 の方が優れていると述べています。
使い方
- プロンプトに Woodland Camo BDU を記述します(作者はバージョン情報には登録せず、説明欄に記載しています)。作者は強度 0.8 程度でモデルに余裕を持たせることを推奨しています。
- ステップ数と CFG は作者によって提供されていません。作者は 10eros などの H3 ファインチューニングモデルと併用可能だと述べています。
リスクと制限
- 訓練画像は解像度の低い古い写真が多く、作者は 16 MP ではディテールをモデルが補完する必要があるため、「奇跡を期待しないでください」と述べています。
- 作者は、複雑さと人体構造は Krea2 などのモデルほど優れていないと述べています。
注目(1)
【B】Minimax H3 Image - GGUF · v1.0
ベースモデル / Checkpoint · 新モデル · 作者 molbal · 公開 11-16 17:40 · ダウンロード数 21
H3 Image ベースモデルの GGUF 量子化変換です。Q4_K_M と Q8_0 の2段階を提供し、テキストから画像生成用と編集用の2つの対応ワークフローを添付しています。作者が独自にメンテナンスしている GGUF 読み込みノードを使用します。
画像
推奨理由
- 元の重みを読み込むための VRAM が不足しているユーザー向けです。Q4_K_M ファイルは Q8_0 よりも大幅に小さく、VRAM に応じて選択できます。
- minimax-h3-image-gguf.json(テキストから画像生成)と minimax-h3-image-edit-gguf.json(編集)の2つのワークフローを提供しています。
- 無料で、ライセンスでは画像生成と販売が許可されています。
使い方
- 作者の ComfyUI-GGUF ブランチ(comfyui-gguf-reboot)をインストールし、その読み込みノードを使用して gguf ファイルを読み込み、元のベースモデルを置き換えます。その後、対応ワークフローをインポートします。
- テキストエンコーダと VAE にも量子化版が必要かどうか、またステップ数と CFG については、作者によって提供されていません。
リスクと制限
- 唯一のサンプルは非表示になっており、量子化による画質劣化に対する比較対照がありません。
- 説明は2行のみです。非公式の GGUF 読み込みノードへの切り替えが必要です。
- カードの画像は AI 生成された概念図であり、モデルの実際の効果ではありません。作者は公開された通常の品質のサンプルを持っていません。
収録のみ(1)
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — ワークフロー:Qwen 2.1 のワークフローを H3 Image 用の ComfyUI ワークフローに変更したものです。名称にはより高速なプロンプト拡張が含まれると記載されていますが、説明は一文のみです。
データ:Civitai 公開 API(ベースモデル MiniMax H3)、収録期間 11-16 08:31 → 11-16 21:01(北京時間)。推奨理由は編集者によるレビュー済みです。ダウンロード数は注目度を表すに過ぎません。