Radar AI của Trinh Trinh · MiniMax H3 Image · Bản tin buổi tối 2026-11-16
Kỳ này có 5 phiên bản mới: Rất khuyến nghị 0 · Khuyến nghị 3 · Đáng chú ý 1 · Chỉ ghi nhận 1
Lời bình của biên tập viên Kỳ này đã xem xét 5 phiên bản mới của H3 Image, gồm 3 hạng A, 1 hạng B và 1 hạng C. Ưu tiên giới thiệu quy trình chỉnh sửa thực tế của voidhunter77: sử dụng ảnh gốc cùng một ảnh cận mặt làm tham chiếu, thay đổi bối cảnh, tư thế và trang phục ở độ phân giải 16 MP trong khi vẫn giữ nguyên ngoại hình nhân vật; tác giả đã mô tả rõ ràng phương pháp lấy mẫu và các trường hợp thất bại, nhưng chỉ thử nghiệm trên card đồ họa 96 GB. LoRA phong cách anime phẳng của rurudo và LoRA trang phục ngụy trang Woodland BDU có tham số hoặc từ khóa kích hoạt rõ ràng, xếp hạng A; phiên bản lượng hóa GGUF có hai mức Q4_K_M, Q8_0 cùng quy trình đi kèm nhưng không có ví dụ trực quan, xếp hạng B; quy trình “BETTER RESULTS” chỉ có một dòng mô tả, xếp hạng C.
Khuyến nghị (3)
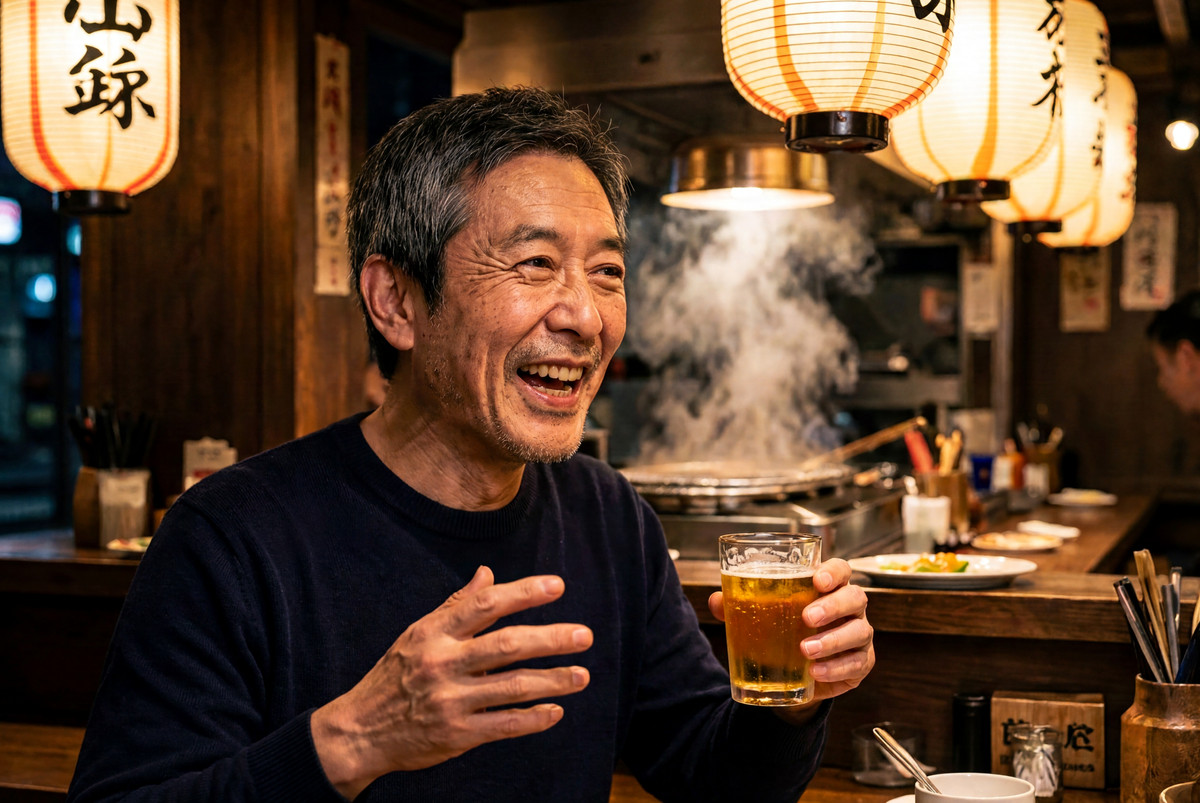
【A】MiniMax H3 Image: Quy trình chỉnh sửa thực tế (16 MP, ComfyUI) · v1.0
Quy trình làm việc · Mô hình mới · Tác giả voidhunter77 · Phát hành 11-16 17:44 · Lượt tải 55
Quy trình ComfyUI chỉnh sửa ảnh thực tế cho H3 Image: nhập vào một bức ảnh và một ảnh cận mặt, thay đổi bố cục, tư thế, trang phục, địa điểm và ánh sáng theo prompt, giữ nguyên ngoại hình nhân vật gốc, xuất ảnh ở độ phân giải 16 MP để đạt được kết cấu da, tóc rối và vải vóc.
Trang mô hình đầy đủ còn có một phần thử nghiệm phóng to: tác giả cho biết mức 16–64 MP phù hợp cho sử dụng hàng ngày, nếu tăng cao hơn nữa các chi tiết nhỏ bắt đầu bị vỡ khối.
Hình ảnh minh họa
Lý do khuyến nghị
- Cung cấp hai phiên bản tương đương: phiên bản tham số mặc định sử dụng nút đơn KSampler của H3 Image (comfyui-h3-sampler, GPL-3.0), và phiên bản hiển thị đầy đủ tham số sử dụng nút gốc kết hợp với RES4LYF; tác giả khẳng định cùng một seed sẽ cho ra bố cục và cảm quan hình ảnh nhất quán
- Tác giả giải thích công thức: mô hình được chưng cất trên lưới nhiễu cố định 6 bước, giai đoạn cấu trúc sử dụng Euler thông thường, hai bước cuối cùng chuyển sang res_2s_rkmk2e và thêm nhiễu mới với eta 0.65 để tạo ra lỗ chân lông và hạt ảnh; tác giả cho biết trong bài kiểm tra với 10 seed, các bộ lấy mẫu khác sẽ vẽ ra các vật thể trùng lặp
- Kèm theo 20 hình ảnh ví dụ, mỗi hình đều nhúng quy trình làm việc có thể kéo thả vào ComfyUI; miễn phí, giấy phép cho phép xuất ảnh và bán hàng
Cách sử dụng
- Đặt ảnh cần chỉnh sửa vào Picture 1, đặt ảnh cắt sát mặt của cùng một người (bao gồm cả tóc) vào Picture 2; trong prompt giữ nguyên ba câu đầu và ba câu cuối, chỉ thay thế mô tả bối cảnh ở giữa, duy trì độ phân giải 16 MP
- Yêu cầu phiên bản ComfyUI mới hơn (tác giả đã thử nghiệm trên 0.45.3), mô hình khuếch tán cần 21 GB, bộ mã hóa văn bản int8 cần 27 GB (dòng Blackwell có thể dùng phiên bản NVFP4 15.7 GB) và VAE cần 1.2 GB; phiên bản nút yêu cầu git clone comfyui-h3-sampler, phiên bản còn lại cài đặt RES4LYF từ Manager
Rủi ro và hạn chế
- Tác giả chỉ thử nghiệm trên RTX PRO 6000 dung lượng 96 GB, chưa rõ các card đồ họa thông thường có chạy được ở độ phân giải 16 MP hay không; trang đầy đủ của tác giả ghi riêng thời gian xử lý khoảng nửa phút đến một phút cho mỗi ảnh
- Tác giả cho biết các biểu cảm cực mạnh (la hét, khóc) sẽ làm biến dạng khuôn mặt nhiều nhất, chữ in trên quần áo dễ bị trông như dán vào, bóng mờ hoặc sai chính tả
【A】[H3 image]phong cách rurudo (るるど) · v0.8
LoRA · Mô hình mới · Tác giả KaleidRuby · Phát hành 11-16 09:26 · Lượt tải 53
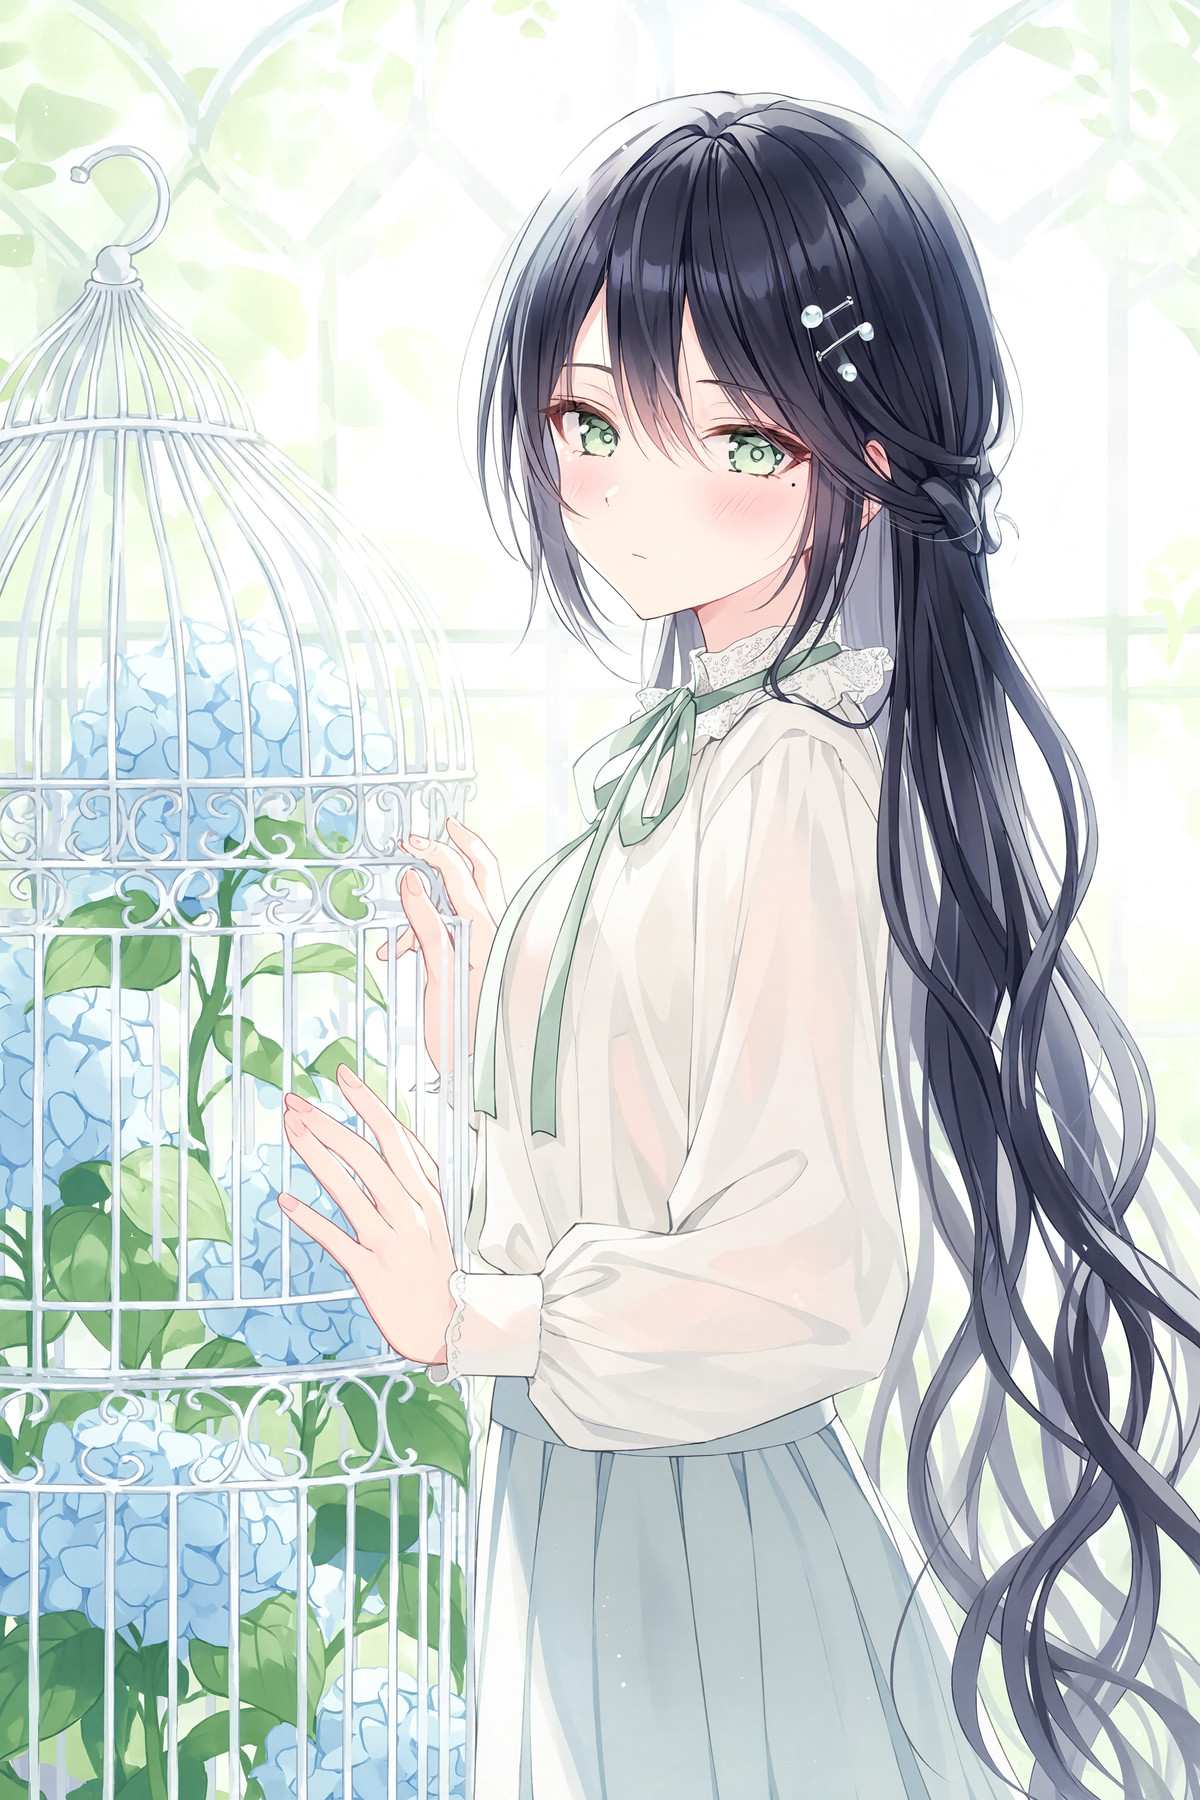
LoRA H3 Image theo phong cách của họa sĩ minh họa Nhật Bản rurudo (るるど): tô màu anime phẳng, từ khóa kích hoạt @rurudo, tác giả lưu ý chỉ dùng cho H3 Image, không phải phiên bản video.
Hình ảnh minh họa
Lý do khuyến nghị
- Cung cấp đầy đủ tham số: 16MP, cfg=1, step=6, cường độ 0.8-1.5
- Tác giả lưu ý rằng H3 Image sẽ tạo ra ảnh lỗi khi tổng cường độ của tất cả các LoRA vượt quá 2.0, việc tăng số bước từ 6 lên 12 có thể giảm thiểu vấn đề này, hữu ích khi kết hợp nhiều LoRA
- Kèm theo 4 hình ảnh ví dụ trực quan; miễn phí, giấy phép cho phép xuất ảnh và bán hàng
Cách sử dụng
- Tải rurudo_h3_v3.safetensors, viết @rurudo trong prompt; 16MP, cfg=1, 6 bước, cường độ 0.8-1.5
- Khi kết hợp với các LoRA khác và tổng cường độ vượt quá 2.0, hãy tăng số bước lên 12
Rủi ro và hạn chế
- Bắt chước phong cách cá nhân của một họa sĩ còn sống, cần tự đánh giá trước khi sử dụng cho mục đích thương mại
- Phiên bản v0.8, 4 hình ảnh ví dụ đã bị ẩn, phần mô tả chỉ có vài dòng
Từ khóa kích hoạt: @rurudo
【A】Quân phục ngụy trang Woodland BDU, H3 Image (và video?) · v1.0
LoRA · Mô hình mới · Tác giả andyx1976 · Phát hành 11-16 09:05 · Lượt tải 35
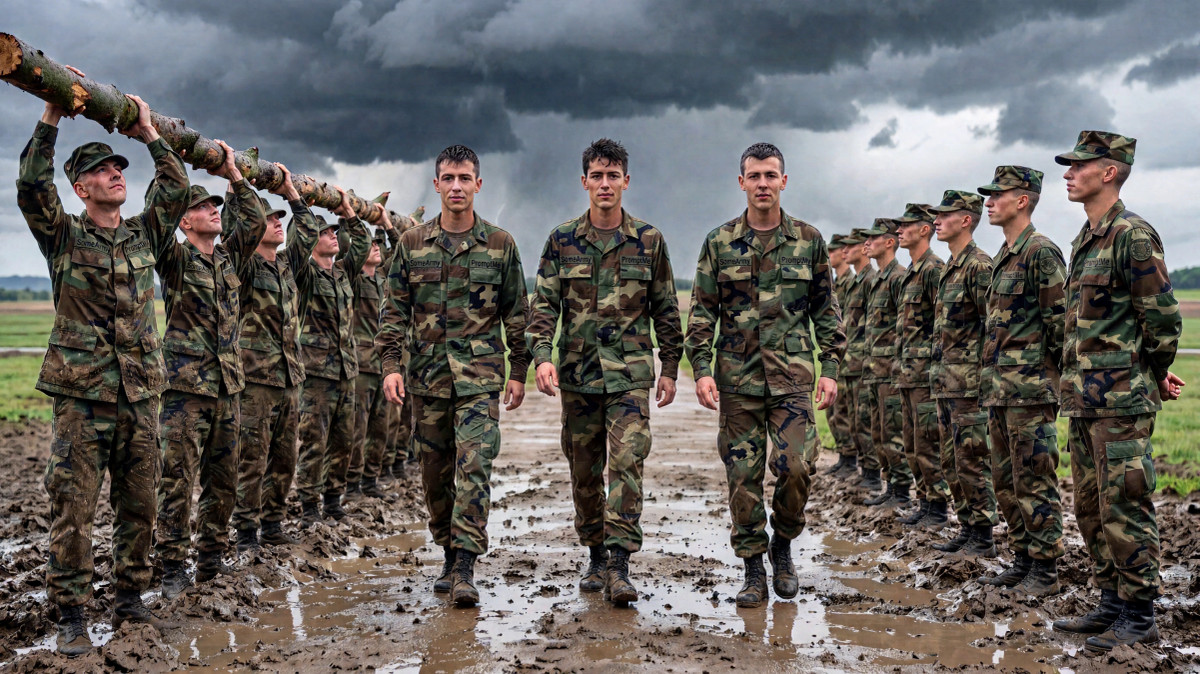
Phiên bản H3 Image của LoRA trang phục quân phục ngụy trang Woodland BDU kiểu cũ: mặc cho nhân vật bộ quân phục cổ điển của quân đội Mỹ với họa tiết ngụy trang rừng, từ khóa kích hoạt là Woodland Camo BDU.
Hình ảnh minh họa
Lý do khuyến nghị
- Tác giả cho biết khi không dùng LoRA, H3 sẽ vẽ thành kiểu quân phục hiện đại với túi chéo, LoRA này được dùng để chỉnh sửa lại thành kiểu cổ điển, và nó đòi hỏi phải viết từ khóa kích hoạt nhiều hơn so với các phiên bản mô hình cơ sở khác
- Tác giả cho biết cũng có thể sử dụng trên H3 Video, video ví dụ không có ảnh khởi đầu, trang phục hoàn toàn do LoRA tạo ra; trên p-h3, các chi tiết như bảng tên sẽ bị lộn xộn
- Kèm theo 6 hình ảnh và 1 đoạn video; miễn phí, giấy phép cho phép xuất ảnh và bán hàng; tác giả kèm theo kinh nghiệm huấn luyện: trên H3, rank 16 quá yếu, rank 32 tốt hơn
Cách sử dụng
- Viết Woodland Camo BDU trong prompt (tác giả không đăng ký trong phiên bản, chỉ ghi trong mô tả); tác giả đề cập rằng cường độ khoảng 0.8 sẽ để lại nhiều không gian hơn cho mô hình
- Tác giả không cung cấp số bước và CFG; tác giả cho biết có thể sử dụng cùng với các mô hình tinh chỉnh H3 như 10eros
Rủi ro và hạn chế
- Ảnh huấn luyện chủ yếu là những bức ảnh cũ có độ phân giải không cao, tác giả cho biết ở mức 16 MP các chi tiết phụ thuộc vào việc mô hình tự bổ sung, “đừng mong đợi điều kỳ diệu”
- Tác giả cho biết độ phức tạp và cấu trúc cơ thể con người kém hơn so với các mô hình như Krea2
Đáng chú ý (1)
【B】Minimax H3 Image - GGUF · v1.0
Mô hình cơ sở / Checkpoint · Mô hình mới · Tác giả molbal · Phát hành 11-16 17:40 · Lượt tải 21
Chuyển đổi lượng hóa GGUF cho mô hình cơ sở H3 Image, cung cấp hai mức Q4_K_M và Q8_0, kèm theo hai quy trình làm việc cho tạo ảnh từ văn bản và chỉnh sửa ảnh, sử dụng nút tải GGUF do chính tác giả duy trì.
Hình ảnh minh họa
Lý do khuyến nghị
- Phục vụ người dùng có VRAM không đủ để tải trọng số gốc: tệp Q4_K_M nhỏ hơn nhiều so với Q8_0, có thể chọn theo dung lượng VRAM
- Đồng thời cung cấp hai quy trình làm việc là minimax-h3-image-gguf.json (tạo ảnh từ văn bản) và minimax-h3-image-edit-gguf.json (chỉnh sửa)
- Miễn phí, giấy phép cho phép xuất ảnh và bán hàng
Cách sử dụng
- Cài đặt nhánh ComfyUI-GGUF của tác giả (comfyui-gguf-reboot), sử dụng nút tải của nó để đọc tệp gguf thay thế mô hình cơ sở gốc, sau đó nhập quy trình làm việc đi kèm
- Tác giả không cung cấp thông tin về việc bộ mã hóa văn bản và VAE có cần phiên bản lượng hóa hay không, cũng như số bước và CFG
Rủi ro và hạn chế
- Hình ảnh ví dụ duy nhất đã bị ẩn, không có sự so sánh nào về mức độ suy giảm chất lượng hình ảnh sau khi lượng hóa
- Phần mô tả chỉ có hai dòng; yêu cầu sử dụng nút tải GGUF không chính thức
- Hình ảnh trên thẻ là hình minh họa do AI tạo ra, không phải hiệu ứng thực tế của mô hình; tác giả không có ví dụ công khai ở mức độ thông thường
Chỉ ghi nhận (1)
- mini max image - quy trình BETTER RESULTS - chất lượng rất tốt với bộ mở rộng prompt nhanh hơn · v1.0 — Quy trình làm việc: chuyển đổi quy trình của Qwen 2.1 thành quy trình ComfyUI cho H3 Image, tên gọi đề cập đến bộ mở rộng prompt nhanh hơn, phần mô tả chỉ có một câu.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MiniMax H3), cửa sổ ghi nhận từ 11-16 08:31 → 11-16 21:01 (giờ Bắc Kinh). Lý do khuyến nghị đã qua xem xét của biên tập viên; số lượt tải chỉ phản ánh mức độ quan tâm.