贞贞的AI雷达 · MiniMax H3 Image · 2026-11-16 晚报
本期 5 个新版本:强烈推荐 0 · 推荐 3 · 可关注 1 · 仅收录 1
编辑按语 本期审阅 5 个 H3 Image 新版本,3 个 A、1 个 B、1 个 C。首推 voidhunter77 的写实编辑工作流:用原图加一张脸部特写做参考,在 16 MP 下改场景、姿势和服装并保留人物长相,作者把采样思路和失败情形都写清楚了,但只在 96 GB 显卡上测过。rurudo 平涂动画画风和 Woodland 迷彩作训服 LoRA 参数或触发词清楚,列 A;GGUF 量化版有 Q4_K_M、Q8_0 两档和配套工作流但没有可见示例,列 B;只有一句说明的“BETTER RESULTS”工作流列 C。
推荐(3)
【A】MiniMax H3 Image: Realism Edit Workflow (16 MP, ComfyUI) · v1.0
工作流 · 新模型 · 作者 voidhunter77 · 发布 11-16 17:44 · 下载 55
H3 Image 的写实改图 ComfyUI 工作流:输入一张照片和一张脸部特写,按提示词换构图、姿势、服装、地点和光线,保留原人物长相,在 16 MP 出图以得到皮肤、碎发和布料纹理。
完整模型卡还有一节放大实验:作者称 16–64 MP 适合日常使用,再往上细纹理开始出块。
配图
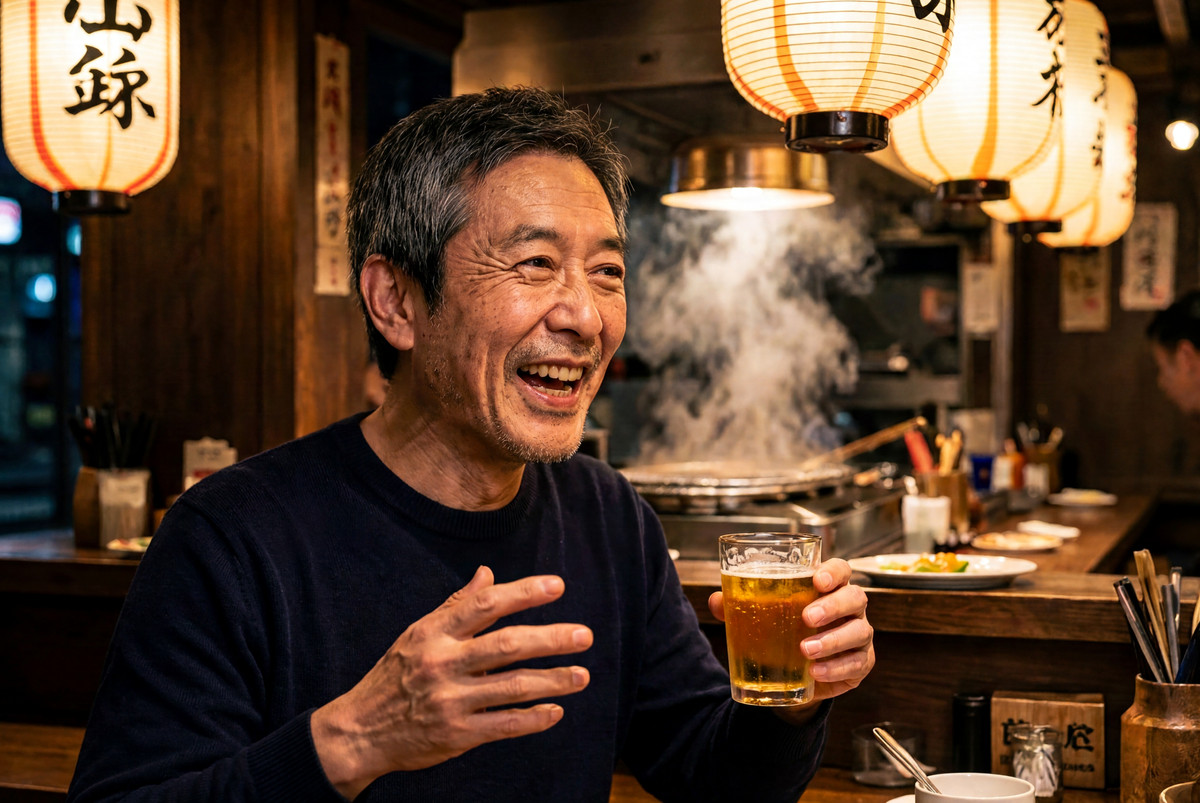
推荐理由
- 提供两个等价版本:用 H3 Image KSampler 单节点(comfyui-h3-sampler,GPL-3.0)的默认参数版,和用原生节点加 RES4LYF 搭的全参数可见版;作者称同一种子构图和观感一致
- 作者解释了配方:模型是在固定 6 步噪声网格上蒸馏的,结构阶段用普通 Euler,最后两步换 res_2s_rkmk2e 并加 eta 0.65 的新噪声来出毛孔和颗粒;称在 10 个种子的测试里其他采样器会画出重复物体
- 附 20 张示例图,每张都嵌了工作流可拖进 ComfyUI;免费,许可允许出图和售卖
怎么用
- Picture 1 放要改的照片,Picture 2 放同一人的脸部紧裁剪(带点头发);提示词保留前三句和后三句,只替换中间的场景描述,保持 16 MP
- 需要较新的 ComfyUI(作者在 0.45.3 测试)、扩散模型 21 GB、int8 文本编码器 27 GB(Blackwell 可用 15.7 GB 的 NVFP4 版)和 1.2 GB 的 VAE;节点版需 git clone comfyui-h3-sampler,另一版从 Manager 装 RES4LYF
风险与限制
- 作者只在 96 GB 的 RTX PRO 6000 上测过,普通显卡能否跑 16 MP 未知;作者完整页面另写了单张约半分钟到一分钟的耗时
- 作者称极强表情(喊叫、哭)会让脸变得最多,衣服上的印刷文字容易像贴上去、重影或拼错
【A】[H3 image]rurudo style (るるど) · v0.8
LoRA · 新模型 · 作者 KaleidRuby · 发布 11-16 09:26 · 下载 53
日本插画师 rurudo(るるど)画风的 H3 Image LoRA:平涂动画上色,触发词 @rurudo,作者注明只用于 H3 Image、不是视频版。
配图
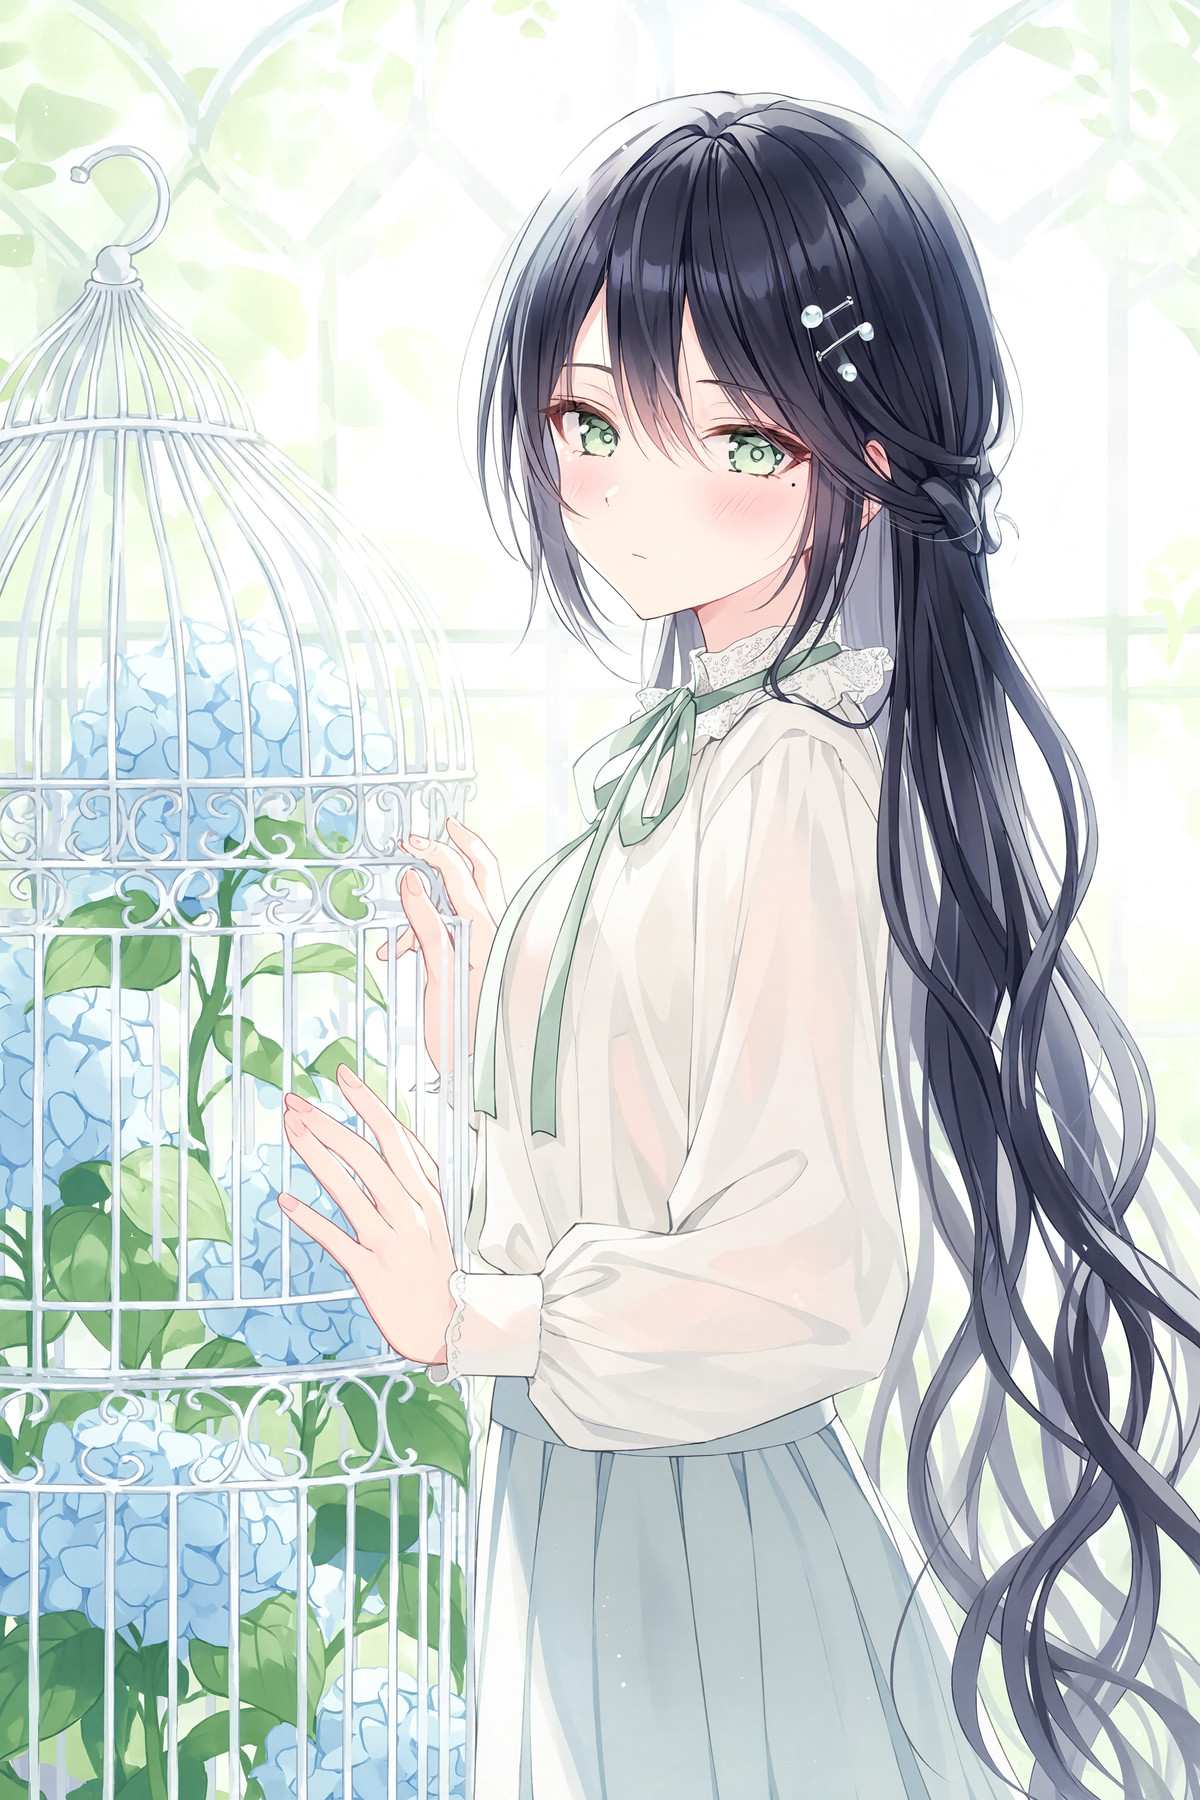
推荐理由
- 参数给全:16MP、cfg=1、step=6,强度 0.8-1.5
- 作者提示 H3 Image 在所有 LoRA 总强度超过 2.0 时会出坏图,把步数从 6 加到 12 可以缓解,叠 LoRA 时有用
- 附 4 张可见示例;免费,许可允许出图和售卖
怎么用
- 加载 rurudo_h3_v3.safetensors,提示词写 @rurudo;16MP、cfg=1、6 步,强度 0.8-1.5
- 与其他 LoRA 叠用、总强度超过 2.0 时把步数加到 12
风险与限制
- 模仿在世画师的个人画风,商用前自行评估
- 版本号 v0.8,4 个示例已隐藏,说明只有几行
触发词:@rurudo
【A】Woodland Camo BDU, H3 Image (and video?) · v1.0
LoRA · 新模型 · 作者 andyx1976 · 发布 11-16 09:05 · 下载 35
老式 Woodland 迷彩作训服(BDU)服装 LoRA 的 H3 Image 版:让人物穿上带林地迷彩的复古美军作训服,触发词 Woodland Camo BDU。
配图
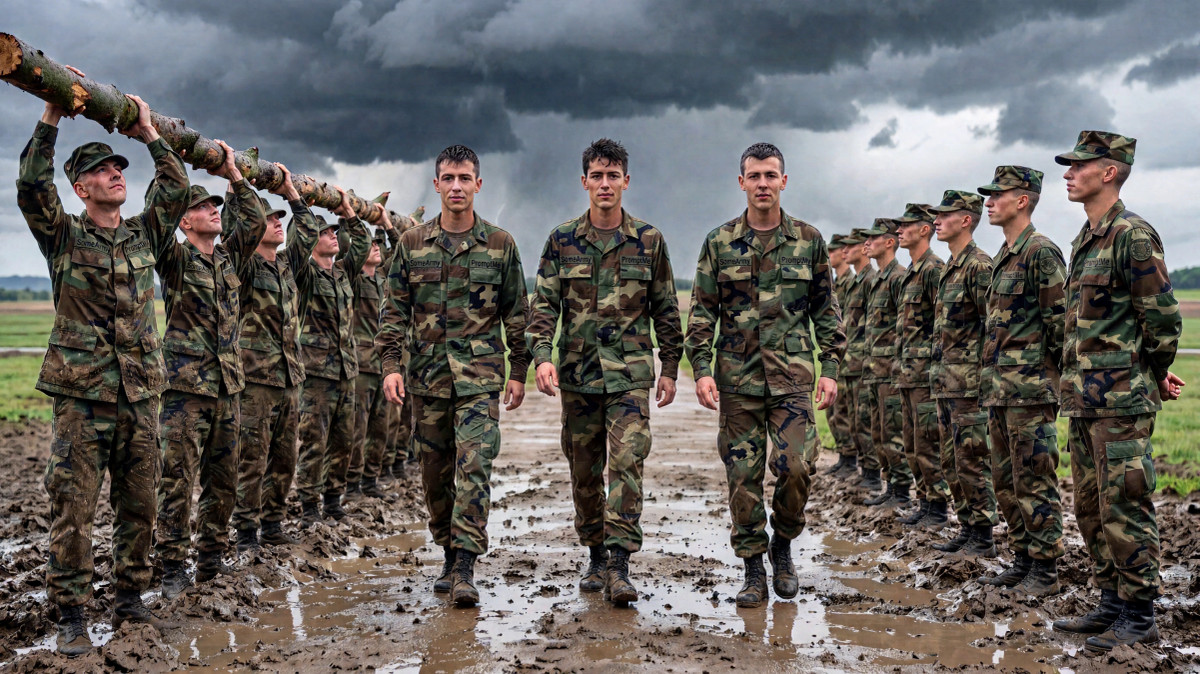
推荐理由
- 作者称不加 LoRA 时 H3 会画成带斜插袋的现代款作训服,这个 LoRA 用来纠正成复古款,而且比其他底模版本更需要写触发词
- 作者称也能在 H3 视频上用,示例视频没有起始图、服装完全由 LoRA 生成;在 p-h3 上铭牌等细节会乱
- 附 6 张图加 1 段视频;免费,许可允许出图和售卖;作者附了训练心得:H3 上 rank 16 太弱,rank 32 更好
怎么用
- 提示词写 Woodland Camo BDU(作者未在版本里登记,写在说明中);作者提到强度 0.8 左右给模型留更多空间
- 步数、CFG 作者未给;作者称可与 10eros 等 H3 微调模型一起用
风险与限制
- 训练图多为分辨率不高的老照片,作者称 16 MP 下细节靠模型补,“别指望奇迹”
- 作者称复杂度和人体结构不如 Krea2 等模型
可关注(1)
【B】Minimax H3 Image - GGUF · v1.0
底模 / Checkpoint · 新模型 · 作者 molbal · 发布 11-16 17:40 · 下载 21
H3 Image 底模的 GGUF 量化转换,提供 Q4_K_M 和 Q8_0 两档,附文生图和编辑两个配套工作流,用作者自己维护的 GGUF 加载节点。
配图
推荐理由
- 服务显存不够加载原版权重的用户:Q4_K_M 文件比 Q8_0 小得多,可以按显存选
- 同时给了 minimax-h3-image-gguf.json(文生图)和 minimax-h3-image-edit-gguf.json(编辑)两个工作流
- 免费,许可允许出图和售卖
怎么用
- 安装作者的 ComfyUI-GGUF 分支(comfyui-gguf-reboot),用其加载节点读取 gguf 文件替换原底模,再导入配套工作流
- 文本编码器、VAE 是否也需量化版,以及步数、CFG,作者未给
风险与限制
- 唯一示例已隐藏,量化后画质损失没有任何对照
- 说明只有两行;需换用非官方的 GGUF 加载节点
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
仅收录(1)
- mini max image - BETTER RESULTS workflow - very nice quality with FASTER prompt upsampler · v1.0 — 工作流:把 Qwen 2.1 的工作流改成 H3 Image 用的 ComfyUI 工作流,名称称带更快的提示词扩写,说明只有一句。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-16 08:31 → 11-16 21:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。