AI-радар Чжэньчжэня · MiniMax H3 Image · Вечерний выпуск 2026-11-16
В этом выпуске 5 новых версий: настоятельно рекомендуется 0 · рекомендуется 3 · заслуживает внимания 1 · только для сведения 1
Примечание редактора В этом выпуске рассмотрено 5 новых версий H3 Image: 3 категории A, 1 категории B и 1 категории C. Главный выбор — рабочий процесс реалистичного редактирования от voidhunter77: использование исходного изображения и крупного плана лица в качестве референса для изменения сцены, позы и одежды при сохранении внешности персонажа на разрешении 16 МП. Автор подробно описал подход к сэмплированию и случаи неудач, но тестирование проводилось только на видеокарте 96 ГБ. LoRA в стиле плоской анимации rurudo и камуфляжной формы Woodland имеют четкие параметры или триггерные слова, поэтому отнесены к категории A; квантованные версии GGUF с двумя уровнями Q4_K_M и Q8_0, а также сопутствующими рабочими процессами, но без видимых примеров, отнесены к категории B; рабочий процесс «BETTER RESULTS» с однострочным описанием отнесен к категории C.
Рекомендации (3)
【A】MiniMax H3 Image: Рабочий процесс реалистичного редактирования (16 МП, ComfyUI) · v1.0
Рабочий процесс · Новая модель · Автор voidhunter77 · Опубликовано 11-16 17:44 · Загрузок 55
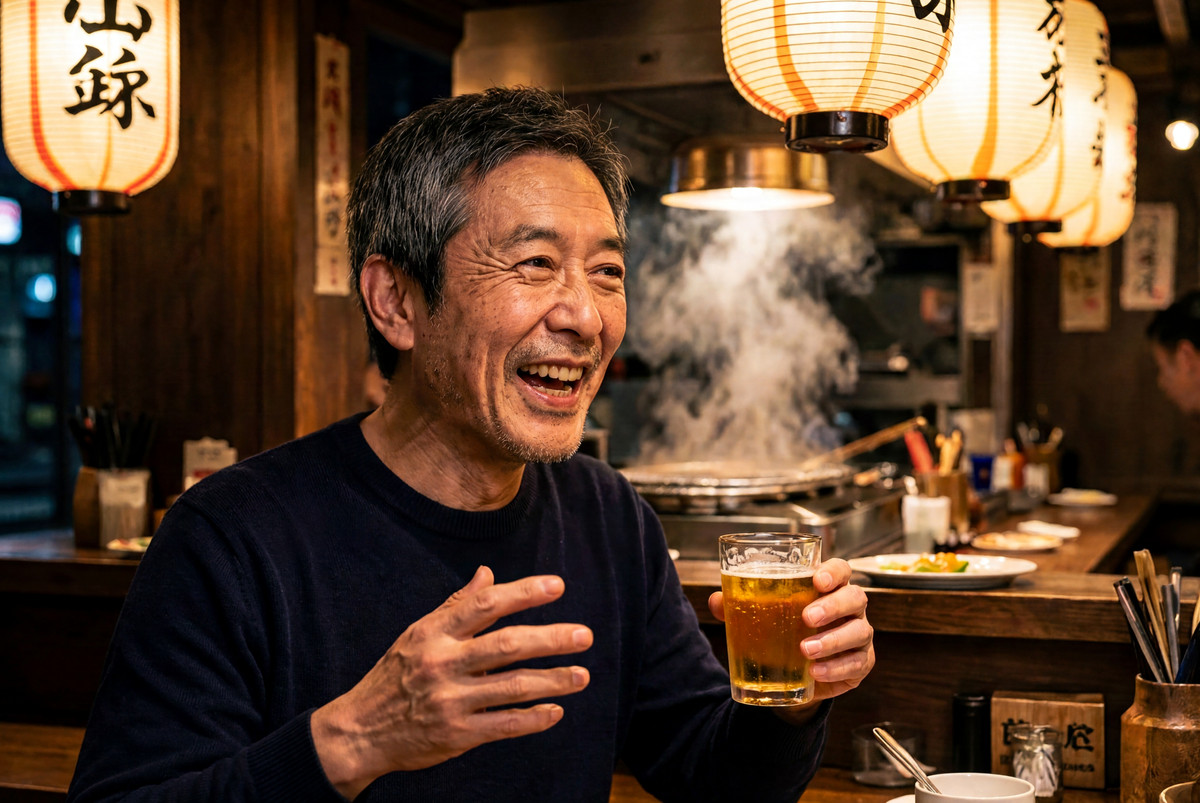
Рабочий процесс ComfyUI для реалистичного редактирования изображений в H3 Image: на вход подается фотография и крупный план лица, а по текстовому описанию меняются композиция, поза, одежда, место и освещение с сохранением оригинальной внешности персонажа. Генерация выполняется при разрешении 16 МП для детализации кожи, отдельных волосков и текстуры ткани.
В полной карточке модели есть раздел об экспериментах с апскейлингом: автор утверждает, что разрешение от 16 до 64 МП подходит для повседневного использования, а при дальнейшем увеличении мелкие текстуры начинают распадаться на блоки.
Иллюстрации
Причины рекомендации
- Предоставлены две эквивалентные версии: версия с параметрами по умолчанию, использующая одноузловой KSampler для H3 Image (comfyui-h3-sampler, лицензия GPL-3.0), и версия с полностью видимыми параметрами, собранная на нативных узлах с RES4LYF; автор утверждает, что при одинаковом seed композиция и визуальное восприятие совпадают
- Автор объяснил рецепт: модель дистиллирована на фиксированной сетке шума из 6 шагов; на структурном этапе используется обычный Euler, а на последних двух шагах переключается на res_2s_rkmk2e с добавлением нового шума eta 0.65 для создания пор и зернистости; по словам автора, в тестах на 10 seed другие сэмплеры рисуют повторяющиеся объекты
- Прилагается 20 примеров изображений, каждое из которых содержит встроенный рабочий процесс, который можно перетащить в ComfyUI; бесплатно, лицензия разрешает генерацию и продажу изображений
Как использовать
- В Picture 1 помещается редактируемое фото, в Picture 2 — плотный кроп лица того же человека (с небольшим количеством волос); в промпте сохраняются первые три и последние три предложения, заменяется только среднее описание сцены, разрешение остается 16 МП
- Требуется относительно новая версия ComfyUI (автор тестировал на 0.45.3), диффузионная модель занимает 21 ГБ, текстовый энкодер int8 — 27 ГБ (для архитектуры Blackwell доступна версия NVFP4 объемом 15.7 ГБ) и VAE — 1.2 ГБ; для узловой версии нужно выполнить git clone comfyui-h3-sampler, для другой версии установить RES4LYF через Manager
Риски и ограничения
- Автор тестировал только на RTX PRO 6000 с памятью 96 ГБ; неизвестно, смогут ли обычные видеокарты работать с разрешением 16 МП; на полной странице автора указано время генерации примерно от полминуты до минуты на одно изображение
- По словам автора, очень сильные эмоции (крик, плач) сильнее всего искажают лицо, а печатный текст на одежде часто выглядит как наклейка, двоится или содержит ошибки
【A】[H3 image]стиль rurudo (るるど) · v0.8
LoRA · Новая модель · Автор KaleidRuby · Опубликовано 11-16 09:26 · Загрузок 53
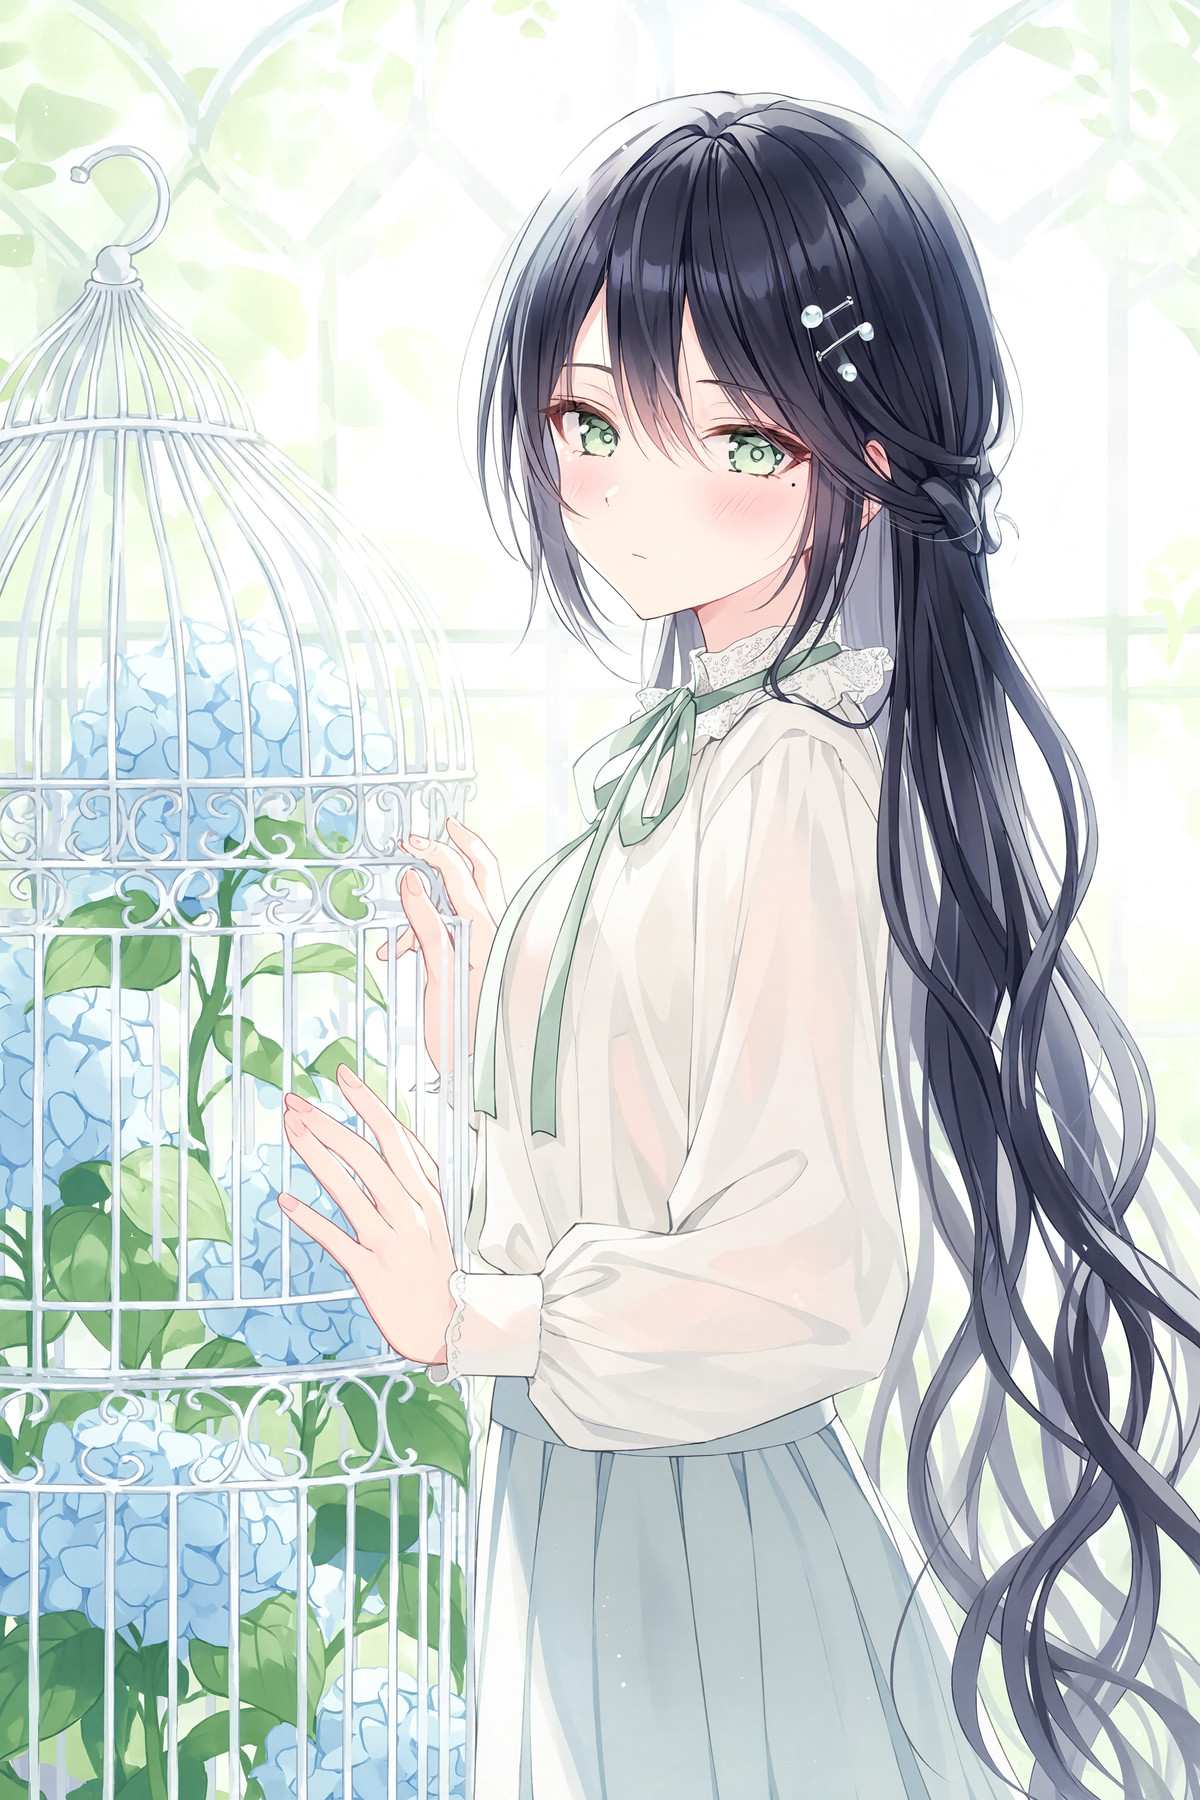
LoRA для H3 Image в стиле японского иллюстратора rurudo (るるдо): плоская анимационная раскраска, триггерное слово @rurudo. Автор уточняет, что модель предназначена только для H3 Image, а не для видеоварианта.
Иллюстрации
Причины рекомендации
- Параметры указаны полностью: 16МП, cfg=1, step=6, сила 0.8-1.5
- Автор предупреждает, что H3 Image выдает некорректные изображения, когда суммарная сила всех LoRA превышает 2.0; увеличение количества шагов с 6 до 12 помогает смягчить проблему, что полезно при наложении нескольких LoRA
- Прилагается 4 видимых примеров; бесплатно, лицензия разрешает генерацию и продажу изображений
Как использовать
- Загрузите rurudo_h3_v3.safetensors, в промпте укажите @rurudo; используйте 16МП, cfg=1, 6 шагов, сила 0.8-1.5
- При комбинировании с другими LoRA и суммарной силе выше 2.0 увеличьте количество шагов до 12
Риски и ограничения
- Имитация личного стиля живущего художника; перед коммерческим использованием оцените риски самостоятельно
- Версия v0.8, 4 примеров скрыты, описание занимает всего несколько строк
Триггерные слова: @rurudo
【A】Камуфляж Woodland BDU, H3 Image (и видео?) · v1.0
LoRA · Новая модель · Автор andyx1976 · Опубликовано 11-16 09:05 · Загрузок 35
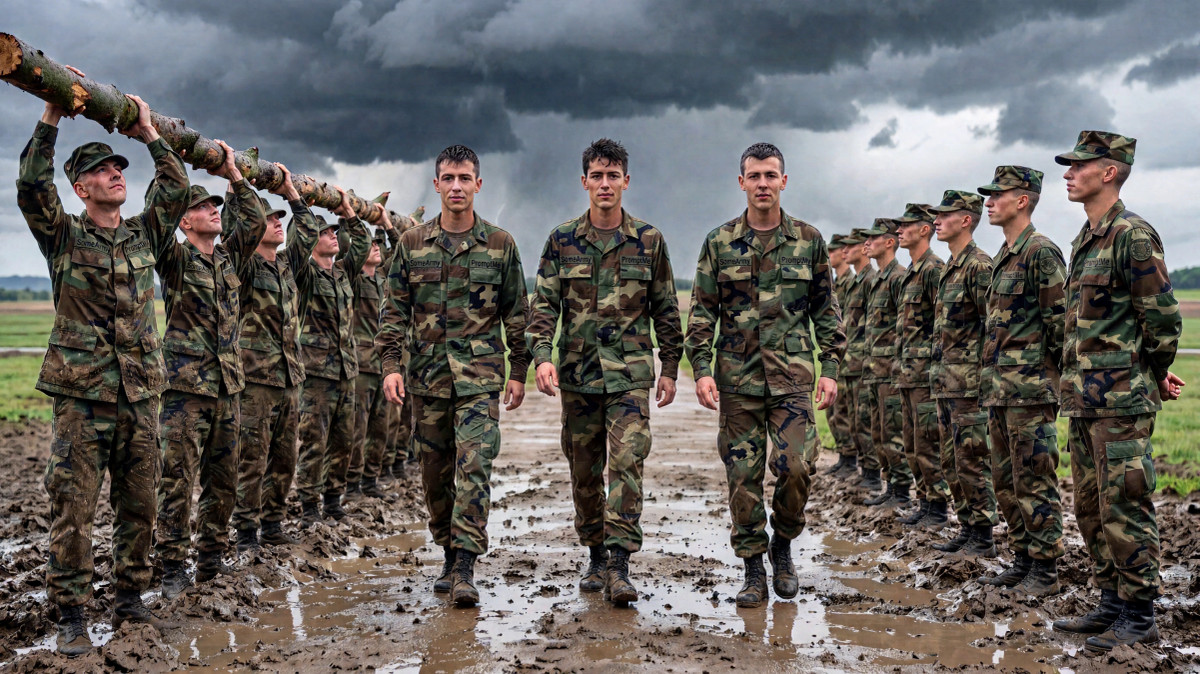
Версия LoRA для одежды в стиле старой камуфляжной формы Woodland (BDU) для H3 Image: одевает персонажа в винтажную американскую военную форму с лесным камуфляжем, триггерное слово Woodland Camo BDU.
Иллюстрации
Причины рекомендации
- По словам автора, без LoRA модель H3 рисует современную форму с диагональными карманами; эта LoRA корректирует стиль на винтажный, и в отличие от версий для других базовых моделей, здесь обязательно нужно прописывать триггерное слово
- Автор утверждает, что LoRA также работает с H3 Video; в примерах видео нет начального изображения, одежда полностью генерируется LoRA; на модели p-h3 детали вроде нашивок искажаются
- Прилагается 6 изображений и 1 видеоролика; бесплатно, лицензия разрешает генерацию и продажу; автор добавил заметки по обучению: для H3 ранг 16 слишком слаб, лучше использовать ранг 32
Как использовать
- В промпте укажите Woodland Camo BDU (автор не зарегистрировал его в версии модели, а написал в описании); автор упоминает, что сила около 0.8 оставляет модели больше пространства для маневра
- Количество шагов и CFG автором не указаны; по словам автора, LoRA можно использовать вместе с дообученными моделями H3, такими как 10eros
Риски и ограничения
- Обучающие изображения — это в основном старые фотографии низкого разрешения; автор утверждает, что детали при разрешении 16 МП дорисовывает модель, «чуда ждать не стоит»
- По словам автора, сложность и анатомическая корректность уступают таким моделям, как Krea2
Заслуживает внимания (1)
【B】Minimax H3 Image - GGUF · v1.0
Базовая модель / Чекпойнт · Новая модель · Автор molbal · Опубликовано 11-16 17:40 · Загрузок 21
GGUF-квантование базовой модели H3 Image, предлагающее два уровня: Q4_K_M и Q8_0, с двумя сопутствующими рабочими процессами для генерации по тексту и редактирования, использующими узел загрузки GGUF, поддерживаемый автором.
Иллюстрации
Причины рекомендации
- Решение для пользователей с недостаточным объемом видеопамяти для загрузки оригинальных весов: файл Q4_K_M значительно меньше, чем Q8_0, что позволяет выбирать вариант в зависимости от доступной памяти
- Предоставлены два рабочих процесса: minimax-h3-image-gguf.json (генерация по тексту) и minimax-h3-image-edit-gguf.json (редактирование)
- Бесплатно, лицензия разрешает генерацию и продажу изображений
Как использовать
- Установите форк ComfyUI-GGUF от автора (comfyui-gguf-reboot), используйте его узел загрузки для чтения файлов gguf вместо оригинальной базовой модели, затем импортируйте сопутствующие рабочие процессы
- Автор не указал, нужны ли квантованные версии для текстового энкодера и VAE, а также рекомендуемые количество шагов и CFG
Риски и ограничения
- Единственный пример скрыт, нет никакого сравнения потерь качества после квантования
- Описание занимает всего две строки; требуется использование неофициального узла загрузки GGUF
- Иллюстрация в карточке — это сгенерированная ИИ схема, а не реальный результат работы модели; у автора нет публичных примеров обычного уровня качества
Только для сведения (1)
- mini max image - рабочий процесс BETTER RESULTS - очень хорошее качество с более быстрым апсемплером промптов · v1.0 — Рабочий процесс: адаптация рабочего процесса Qwen 2.1 для H3 Image в ComfyUI; название обещает более быстрый апсемплер промптов, описание состоит всего из одной фразы.
Данные: открытый API Civitai (базовая модель MiniMax H3), окно отбора 11-16 08:31 → 11-16 21:01 (пекинское время). Причины рекомендации проверены редактором; количество загрузок отражает только уровень интереса.