정정의 AI 레이더 · MiniMax H3 Image · 2026-11-16 저녁 뉴스레터
이번 호 5개의 새로운 버전: 강력 추천 0 · 추천 3 · 주목할 만함 1 · 단순 수록 1
편집자 주 이번 호에서는 H3 Image의 새로운 버전 5개를 검토했으며, A등급 3개, B등급 1개, C등급 1개로 분류했습니다. 가장 먼저 추천하는 것은 voidhunter77의 리얼리즘 편집 워크플로우입니다: 원본 이미지와 얼굴 클로즈업을 참고 자료로 사용하여 16 MP 해상도에서 배경, 포즈, 의상을 변경하면서도 인물의 외모를 유지합니다. 저자는 샘플링 접근 방식과 실패 사례를 명확히 기술했지만, 테스트는 오직 96 GB 그래픽 카드에서만 수행되었습니다. rurudo의 평면 애니메이션 스타일과 Woodland 위장 전투복 LoRA는 파라미터나 트리거 워드가 명확하여 A등급으로 분류했습니다. GGUF 양자화 버전은 Q4_K_M, Q8_0 두 단계와 관련 워크플로우가 제공되지만 시각적인 예시가 없어 B등급으로 분류했습니다. 설명이 한 문장뿐인 'BETTER RESULTS' 워크플로우는 C등급으로 분류했습니다.
추천 (3)
【A】MiniMax H3 Image: 리얼리즘 편집 워크플로우 (16 MP, ComfyUI) · v1.0
워크플로우 · 신규 모델 · 저자 voidhunter77 · 게시일 11-16 17:44 · 다운로드 수 55
H3 Image의 리얼리즘 이미지 편집용 ComfyUI 워크플로우입니다: 사진 한 장과 얼굴 클로즈업 한 장을 입력으로 받아 프롬프트에 따라 구도, 포즈, 의상, 장소, 조명을 변경하되 원본 인물의 외모는 유지합니다. 16 MP 해상도로 출력하여 피부, 잔머리, 천의 질감을 표현합니다.
전체 모델 카드에는 업스케일링 실험 섹션이 하나 더 있습니다: 저자는 16–64 MP가 일상적인 사용에 적합하며, 그 이상으로 올리면 미세한 질감에서 블록 현상이 발생하기 시작한다고 설명합니다.
예시 이미지
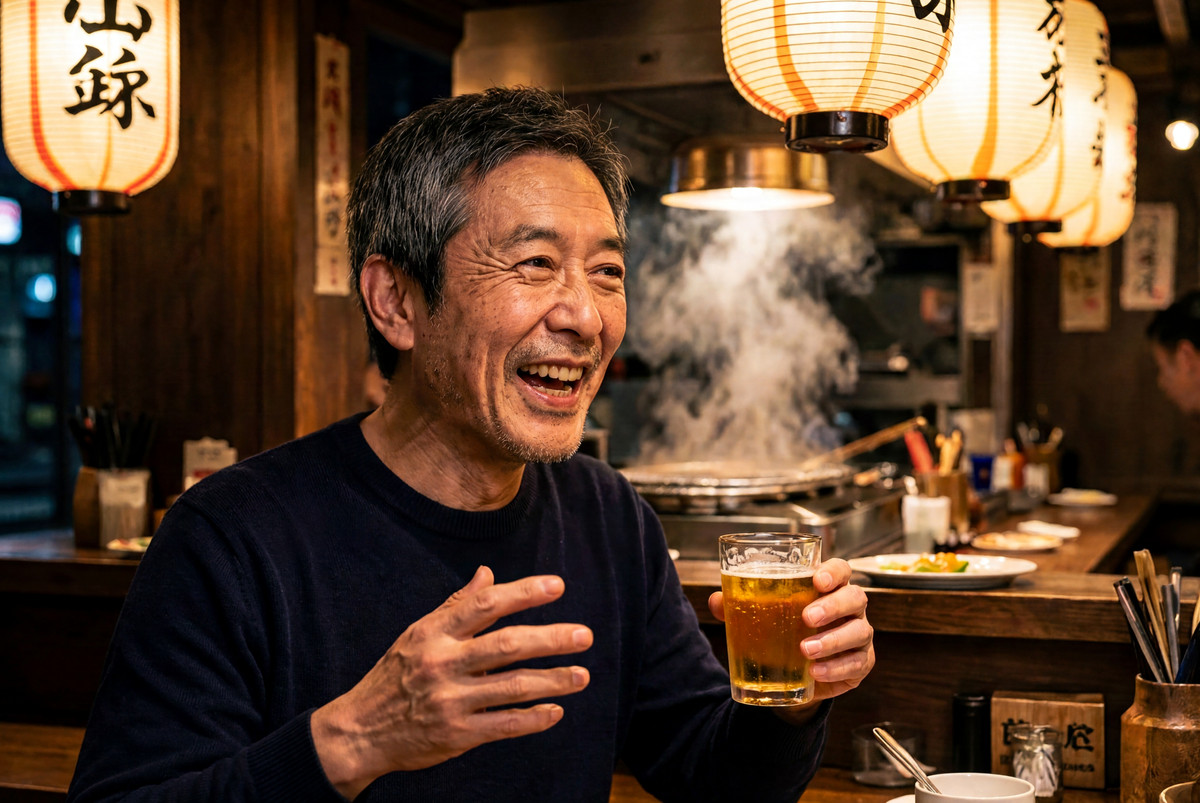
추천 이유
- 두 가지 동등한 버전을 제공합니다: H3 Image KSampler 단일 노드(comfyui-h3-sampler, GPL-3.0)를 사용한 기본 파라미터 버전과 네이티브 노드에 RES4LYF를 추가하여 모든 파라미터를 볼 수 있게 한 버전입니다. 저자는 동일한 시드에서 구도와 시각적 결과가 일치한다고 주장합니다.
- 저자는 레시피를 설명했습니다: 모델은 고정된 6 스텝의 노이즈 그리드에서 증류(distillation)되었으며, 구조 단계에서는 일반적인 Euler 샘플러를 사용하고 마지막 두 스텝에서는 res_2s_rkmk2e로 전환하여 eta 0.65의 새로운 노이즈를 추가함으로써 모공과 입자감을 표현합니다. 저자는 10개의 시드 테스트에서 다른 샘플러들은 중복된 물체를 그리는 경향이 있다고 주장합니다.
- 예시 이미지 20장이 첨부되어 있으며, 각 이미지에 워크플로우가 내장되어 ComfyUI로 드래그하여 불러올 수 있습니다. 무료이며 라이선스는 이미지 생성 및 판매를 허용합니다.
사용 방법
- Picture 1에는 편집할 사진을, Picture 2에는 동일 인물의 얼굴을 타이트하게 크롭한 이미지(머리카락 일부 포함)를 넣습니다. 프롬프트는 앞의 세 문장과 뒤의 세 문장은 유지하고 중간 부분의 배경 설명만 교체하며, 해상도는 16 MP로 유지합니다.
- 비교적 최신 버전의 ComfyUI가 필요하며(저자는 0.45.3에서 테스트), 확산 모델은 21 GB, int8 텍스트 인코더는 27 GB(Blackwell 아키텍처에서는 NVFP4 버전의 15.7 GB 사용 가능), VAE는 1.2 GB가 필요합니다. 노드 버전은 comfyui-h3-sampler를 git clone하여 설치해야 하며, 다른 버전은 Manager를 통해 RES4LYF를 설치합니다.
리스크 및 제한 사항
- 저자는 오직 96 GB의 RTX PRO 6000에서만 테스트했으며, 일반 그래픽 카드에서 16 MP 해상도 실행 가능 여부는 불명확합니다. 저자의 전체 페이지에는 이미지 한 장당 약 30초에서 1분 정도 소요된다는 내용이 별도로 기재되어 있습니다.
- 저자는 매우 강한 표정(고함치기, 울음)이 얼굴 변형을 가장 크게 유발하며, 의상에 인쇄된 텍스트는 붙여 넣은 것처럼 보이거나 이중으로 겹치거나 철자가 틀리기 쉽다고 주장합니다.
【A】[H3 image]rurudo style (루루도) · v0.8
LoRA · 신규 모델 · 저자 KaleidRuby · 게시일 11-16 09:26 · 다운로드 수 53
일본 일러스트레이터 rurudo(루루도)의 화풍을 적용한 H3 Image LoRA입니다: 평면 애니메이션 채색 스타일이며, 트리거 워드는 @rurudo입니다. 저자는 H3 Image 전용이며 비디오 버전이 아님을 명시했습니다.
예시 이미지
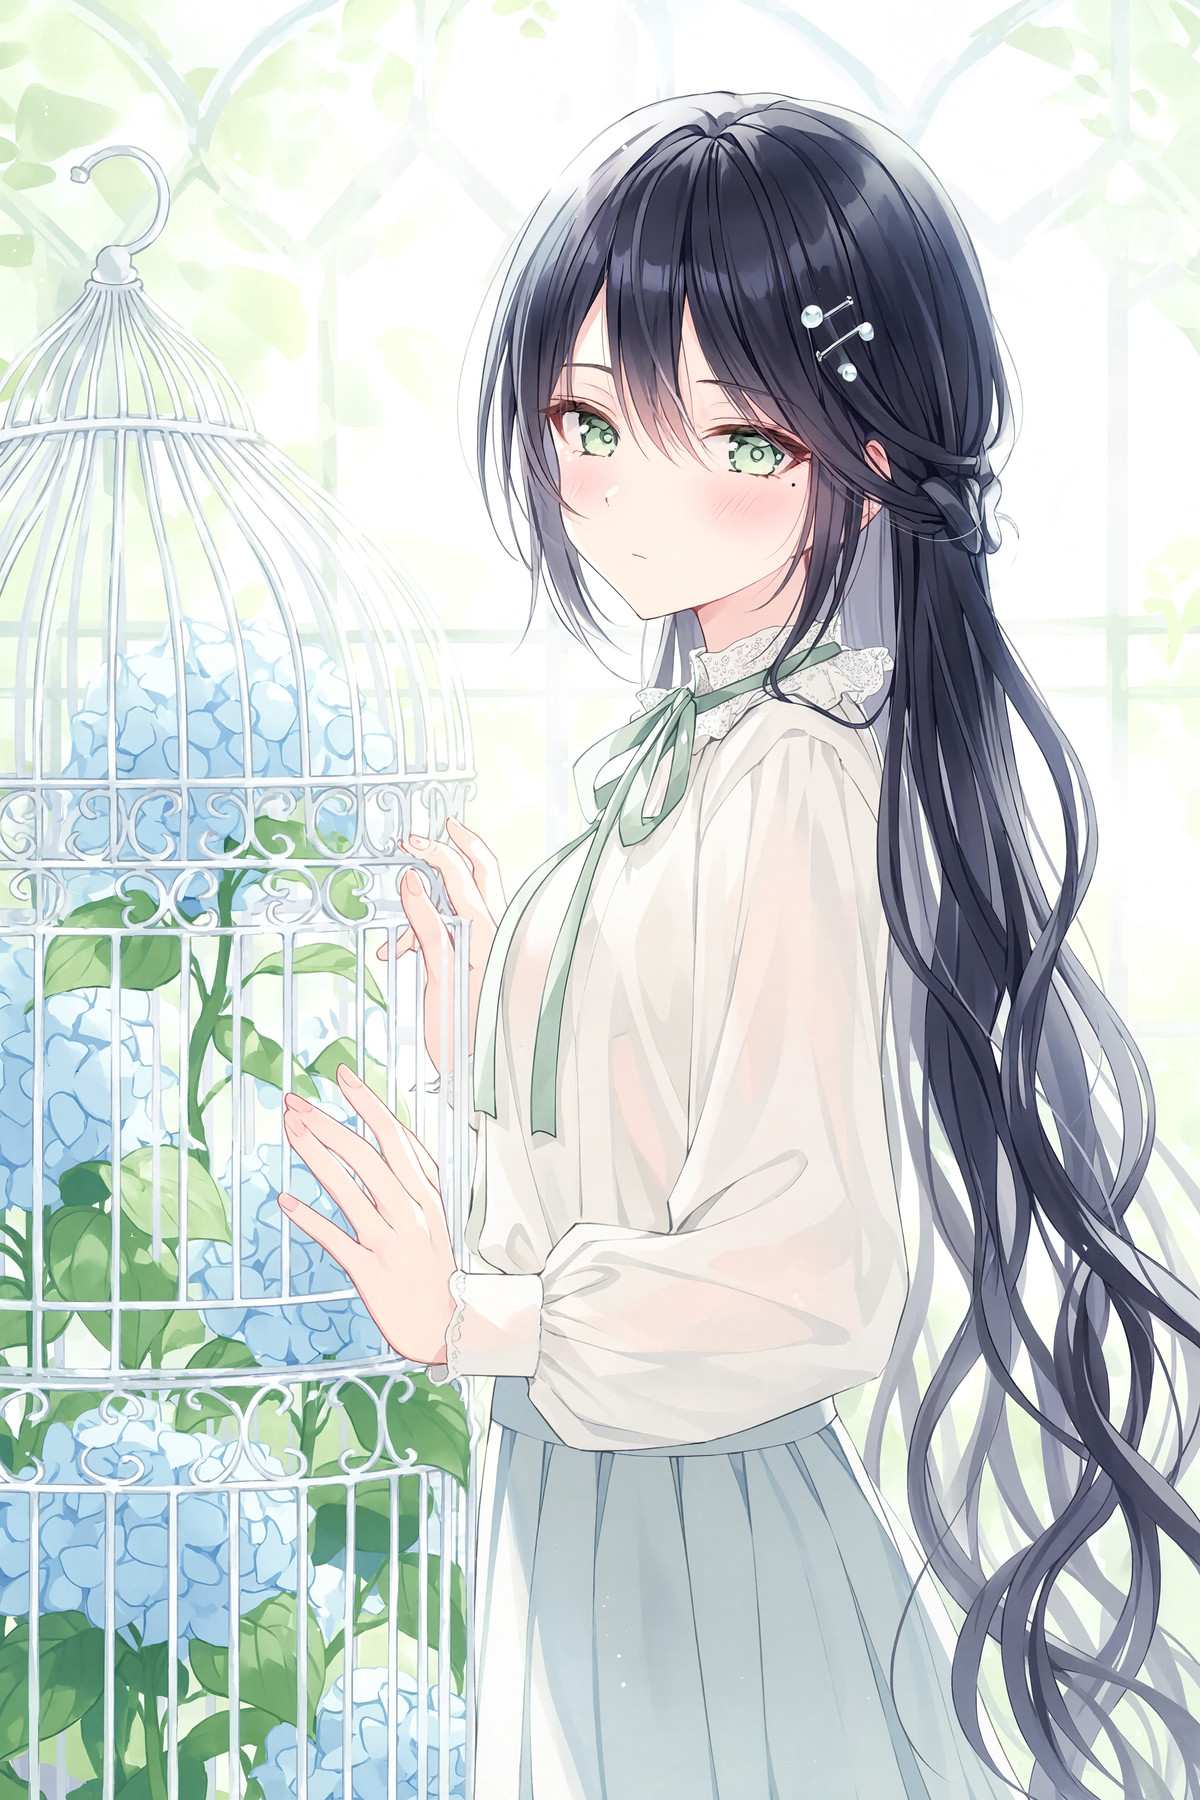
추천 이유
- 파라미터가 모두 명시되어 있습니다: 16MP, cfg=1, step=6, 강도 0.8-1.5.
- 저자는 H3 Image에서 모든 LoRA의 총 강도가 2.0를 초과하면 이미지가 깨진다고 경고하며, 스텝 수를 6에서 12으로 늘리면 완화될 수 있다고 합니다. 이는 LoRA를 겹쳐 사용할 때 유용한 팁입니다.
- 시각적으로 확인할 수 있는 예시 이미지 4장이 첨부되어 있습니다. 무료이며 라이선스는 이미지 생성 및 판매를 허용합니다.
사용 방법
- rurudo_h3_v3.safetensors를 로드하고 프롬프트에 @rurudo를 작성합니다. 설정은 16MP, cfg=1, 스텝 수 6, 강도 0.8-1.5입니다.
- 다른 LoRA와 겹쳐 사용하여 총 강도가 2.0를 초과할 경우 스텝 수를 12으로 늘립니다.
리스크 및 제한 사항
- 생존해 있는 일러스트레이터의 개인 화풍을 모방하는 것이므로, 상업적 사용 전 자체적으로 평가해야 합니다.
- 버전 번호는 v0.8이며, 4개의 예시는 숨겨져 있고 설명은 몇 줄에 불과합니다.
트리거 워드: @rurudo
【A】Woodland Camo BDU, H3 Image (및 비디오?) · v1.0
LoRA · 신규 모델 · 저자 andyx1976 · 게시일 11-16 09:05 · 다운로드 수 35
고전적인 Woodland 위장 전투복(BDU) 의상 LoRA의 H3 Image 버전입니다: 인물에게 숲 위장 무늬가 있는 복고풍 미군 전투복을 입히며, 트리거 워드는 Woodland Camo BDU입니다.
예시 이미지
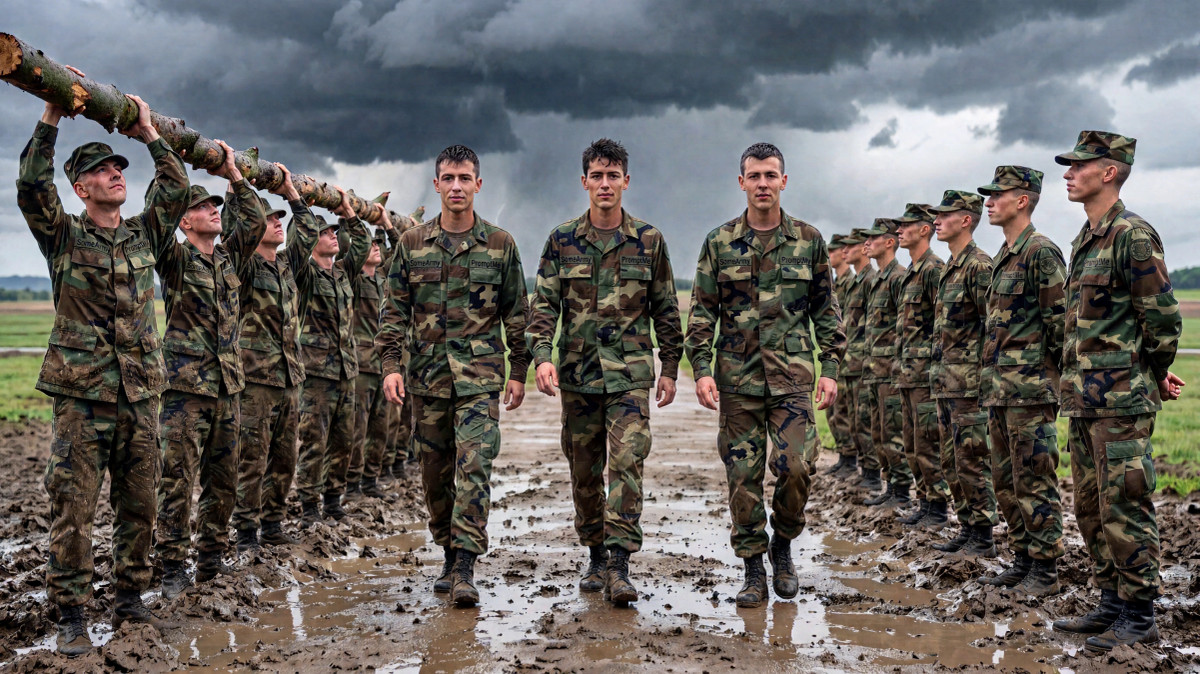
추천 이유
- 저자는 LoRA를 사용하지 않으면 H3이 대각선 주머니가 있는 현대식 전투복으로 그리는 경향이 있으며, 이 LoRA는 이를 복고풍 스타일로 교정하기 위한 것이라고 설명합니다. 또한 다른 기반 모델 버전보다 트리거 워드 작성이 더 중요하다고 합니다.
- 저자는 H3 비디오에서도 사용할 수 있다고 주장하며, 예시 비디오에는 시작 이미지가 없고 의상이 전적으로 LoRA에 의해 생성되었습니다. p-h3에서는 명판 등 세부 사항이 어지러워질 수 있습니다.
- 이미지 6장과 비디오 1개가 첨부되어 있습니다. 무료이며 라이선스는 이미지 생성 및 판매를 허용합니다. 저자는 학습 팁을 덧붙였습니다: H3에서는 rank 16가 너무 약하고, rank 32가 더 좋습니다.
사용 방법
- 프롬프트에 Woodland Camo BDU를 작성합니다(저자는 버전 정보에는 등록하지 않고 설명란에 기재했습니다). 저자는 강도를 0.8 정도로 설정하여 모델에 더 많은 공간을 주는 것이 좋다고 언급했습니다.
- 스텝 수와 CFG는 저자가 제공하지 않았습니다. 저자는 이 LoRA가 10eros 등 H3 미세 조정 모델과 함께 사용할 수 있다고 주장합니다.
리스크 및 제한 사항
- 학습 이미지는 대부분 해상도가 낮은 오래된 사진들이며, 저자는 16 MP에서 세부 사항은 모델이 보완하는 방식이라 "기적을 기대하지 말라"고 합니다.
- 저자는 복잡도와 인체 구조가 Krea2 등 다른 모델들보다 떨어진다고 주장합니다.
주목할 만함 (1)
【B】Minimax H3 Image - GGUF · v1.0
기반 모델 / 체크포인트 · 신규 모델 · 저자 molbal · 게시일 11-16 17:40 · 다운로드 수 21
H3 Image 기반 모델의 GGUF 양자화 변환본입니다. Q4_K_M과 Q8_0 두 단계를 제공하며, 텍스트-이미지 생성 및 편집용 관련 워크플로우가 첨부되어 있고 저자가 직접 유지 관리하는 GGUF 로딩 노드를 사용합니다.
예시 이미지
추천 이유
- 원본 가중치를 로드할 VRAM이 부족한 사용자를 위한 서비스입니다: Q4_K_M 파일은 Q8_0보다 훨씬 작으므로 VRAM 용량에 따라 선택할 수 있습니다.
- minimax-h3-image-gguf.json(텍스트-이미지 생성)과 minimax-h3-image-edit-gguf.json(편집) 두 가지 워크플로우를 동시에 제공합니다.
- 무료이며 라이선스는 이미지 생성 및 판매를 허용합니다.
사용 방법
- 저자의 ComfyUI-GGUF 분기(comfyui-gguf-reboot)를 설치하고, 해당 로딩 노드를 사용하여 gguf 파일을 읽어 원본 기반 모델을 대체한 후 관련 워크플로우를 가져옵니다.
- 텍스트 인코더와 VAE도 양자화 버전이 필요한지 여부, 그리고 스텝 수 및 CFG 설정은 저자가 제공하지 않았습니다.
리스크 및 제한 사항
- 유일한 예시가 숨겨져 있어 양자화 후의 화질 손실에 대한 비교 자료가 전혀 없습니다.
- 설명이 두 줄뿐이며, 비공식적인 GGUF 로딩 노드를 사용해야 합니다.
- 카드에 있는 이미지는 AI로 생성된 개념도일 뿐 모델의 실제 결과가 아닙니다. 저자는 공개적으로 확인할 수 있는 일반 수준의 예시를 제공하지 않았습니다.
단순 수록 (1)
- mini max image - BETTER RESULTS 워크플로우 - 더 빠른 프롬프트 업샘플러로 매우 좋은 품질 · v1.0 — 워크플로우: Qwen 2.1의 워크플로우를 H3 Image용 ComfyUI 워크플로우로 수정한 것입니다. 이름에는 더 빠른 프롬프트 업샘플러가 포함되었음을 시사하지만, 설명은 한 문장뿐입니다.
데이터: Civitai 공개 API(기반 모델 MiniMax H3), 수집 기간 11-16 08:31 → 11-16 21:01(베이징 시간). 추천 이유는 편집자 검수를 거쳤습니다. 다운로드 수는 단지 관심도를 나타냅니다.