Radar IA de Zhenzhen · MOSS Image · 2026-11-10 Édition du soir
Cette édition présente 35 nouvelles versions : fortement recommandé 2 · recommandé 9 · à suivre 10 · inclus uniquement 14
Note de l'éditeur Cette édition a examiné 44 nouvelles versions de MOSS, dont 2 classées S, 9 classées A, 10 classées B et 14 classées C, avec 9 exclusions. La recommandation principale est la version MOSS du LoRA Ad Infinitum, au style de publicité pleine page rétro : elle transforme l'image en cartes de produits, affiches et publicités de magazines d'époque, avec des titres à l'aspect vintage générés entre guillemets ; les mots-clés de déclenchement, l'intensité, le nombre de pas, le CFG et les instructions de mise en page sont tous fournis. Classé également S, le LoRA de contrôle de pose de thedeoxen, qui utilise des squelettes DWPose pour faire adopter la même pose à de nouveaux personnages ; les LoRAs de contrôle Canny, lineart, scribble, depth, normal et segmentation du même auteur sont classés A. D'autres LoRAs classés A incluent des arrière-plans de couloirs FGO, un style de capture d'écran d'animation v2 et des photos réalistes prises à la volée avec un smartphone ; plusieurs LoRAs de personnages ou de styles avec seulement une ou deux lignes de description et les LoRAs de personnages en accès anticipé payant sont classés C. Les 8 instantanés intermédiaires du LoRA de personnage Liangwu ne conservent que la version finale st9000, et la version Krea2 de Ceiling Fisheye Cam est un poids Krea 2 incorrectement étiqueté comme MOSS ; les deux ont été exclus.
Fortement recommandé (2)
【S】Ad Infinitum - Krea 2 · Classic - MOSS
LoRA · Portage · Auteur AriaMaiven · Publié le 11-10 10:48 · Téléchargements 50
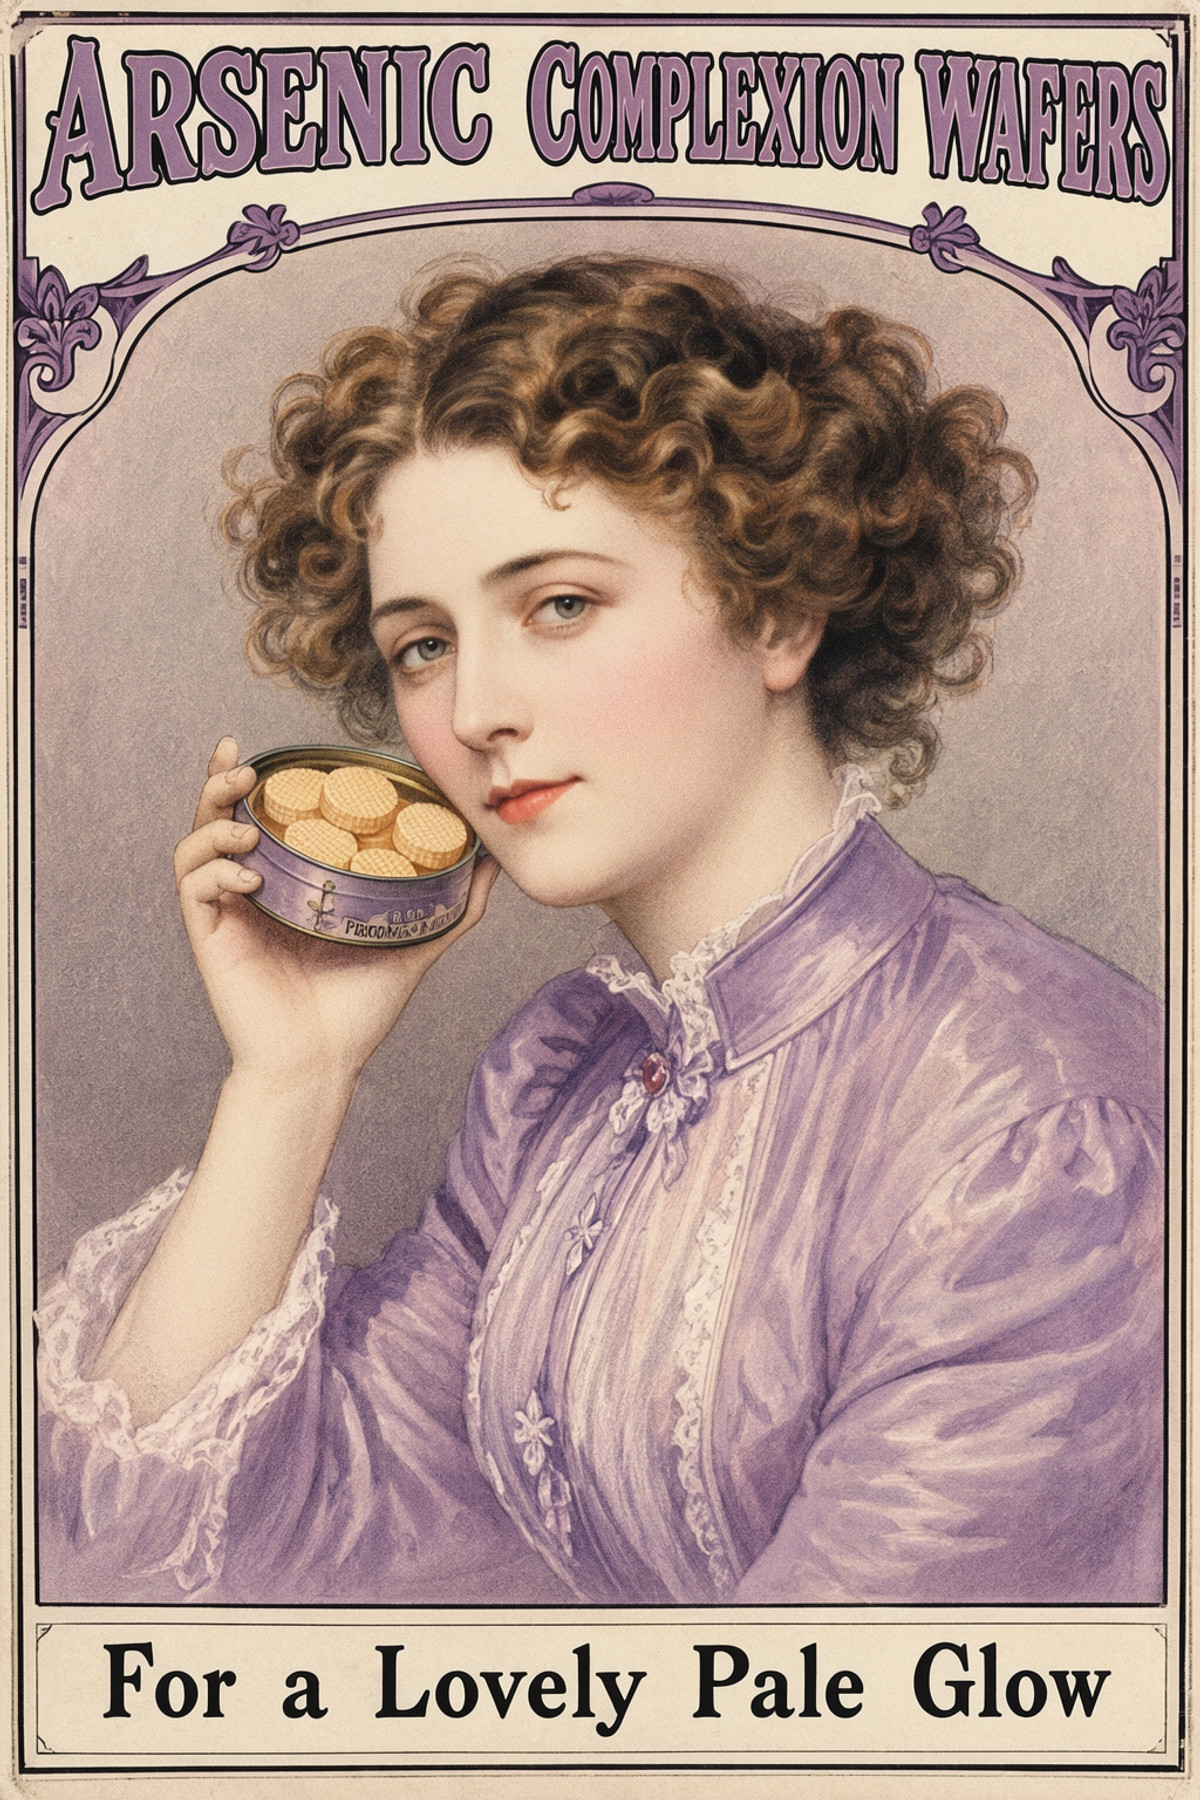
Version MOSS (Classic) du LoRA de style publicité rétro pleine page : transforme l'image en publicités pleine page avec pointillisme, contours à l'encre et papier crème, typiques des cartes de produits, affiches et publicités de magazines des années 1885–1948, et génère des titres en majuscules d'époque selon le prompt.
Recommandation principale de ce groupe : direction unique (publicité pleine page ancienne plutôt qu'un simple filtre rétro), tous les paramètres sont fournis (mots-clés de déclenchement, intensité, pas, CFG, dimensions et mise en page), ce qui rend la mise en œuvre facile.
Illustrations
Raisons de la recommandation
- Portage : la page contient déjà les versions Classic et Future Vintage pour Krea 2, avec un total de 303 téléchargements sur la page du modèle ; la version MOSS est entraînée sur MOSS Base, utilisant le même ensemble de 46 cartes de produits / affiches / publicités de magazines du domaine public (avec le texte original retiré), le mot-clé de déclenchement adnclsk est conservé
- Convient à la génération d'images pour affiches rétro, vieilles publicités, parodies de marques et illustrations éditoriales ; l'auteur fournit des instructions de mise en page : à la fin du prompt, placez chaque texte entre guillemets et indiquez sa position, MOSS l'écrira dans une police majuscule d'époque
- Paramètres complets : intensité de 0.7 à 1.0 ; MOSS Image (SFT), 30 pas, CFG 3, euler / simple, 1024 x 1536 ; l'auteur affirme que sans LoRA, MOSS ne génère que des illustrations numériques modernes
- L'auteur affirme que chaque image de la galerie est accompagnée de prompts et de paramètres ; gratuit, la licence autorise la sortie d'images et la location sur site ; publié il y a environ 10 heures avec 50 téléchargements
Comment l'utiliser
- Commencez le prompt par adnclsk, puis décrivez le sujet et la scène de la publicité ; intensité de 0.7 à 1.0, utilisez 0.7 pour un rendu plus propre si le titre est long
- Pour inclure du texte, ajoutez à la fin : The only words on the page are the headline "…" at the top …, and the line "…" on a cream panel at the bottom, placez chaque phrase entre guillemets et indiquez la position et la couleur
- MOSS Image (SFT), 30 pas, CFG 3, euler / simple, 1024 x 1536 ; même si vous prévoyez de faire la mise en page vous-même en post-production, incluez le titre et le bandeau inférieur dans le prompt, sinon les scènes de trains ou de paysages tendront vers un style peinture à l'huile
- N'ajoutez pas les mots poster, lithograph, vintage ou des termes d'époque, l'auteur affirme que le LoRA intègre déjà l'esthétique d'époque
Risques et limitations
- 5 exemples visibles, 4 autres masqués par la classification ; pas de comparaison avec/sans LoRA utilisant la même graine
- L'ensemble d'entraînement ne contient que 46 images ; l'archive de workflow ComfyUI fournie avec la version Krea 2 n'est pas incluse dans la version MOSS, vous devez la créer vous-même
- La licence exige l'attribution ; l'auteur déclare que la republication ou l'utilisation de ses images générées pour entraîner d'autres modèles nécessite une autorisation préalable
- Cet article n'a pas été testé
Mot-clé de déclenchement : adnclsk
【S】MOSS-Image Pose Control · v1.0
LoRA · Nouveau modèle · Auteur thedeoxen · Publié le 11-10 16:20 · Téléchargements 29
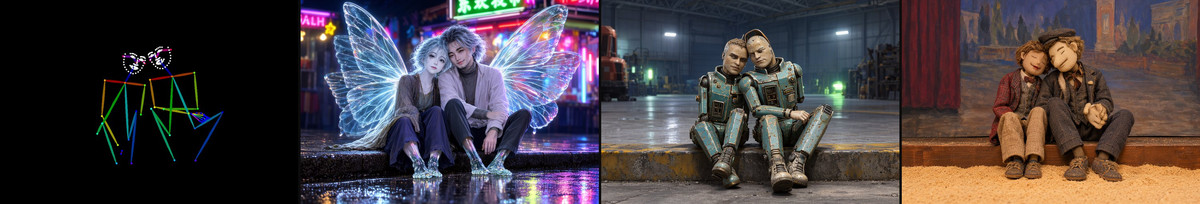
LoRA de contrôle de pose pour MOSS-Image-SFT : en fournissant une image de squelette DWPose colorée sur fond noir, le personnage généré adopte la même pose corporelle, des mains et du visage que le squelette, tandis que l'apparence, les vêtements et la scène sont entièrement déterminés par le prompt.
Le même auteur a publié sept LoRAs de contrôle le même jour, avec la même méthode d'entraînement et les mêmes paramètres d'échantillonnage, la seule différence étant le type d'image de contrôle utilisée ; celui pour la pose est le plus autonome et le workflow le plus complet, servant de représentant pour ce groupe.
Illustrations
Raisons de la recommandation
- Nouvelle capacité : ajoute à MOSS-Image-SFT la capacité de contrôler la pose via un squelette ; l'auteur explique qu'il s'agit d'un LoRA d'édition de type ControlNet, et non d'un adaptateur de concaténation color/depth officiel, il se charge avec un chargeur LoRA standard et l'image de squelette est envoyée comme seule image de référence dans Text Encode MOSS-Image Edit
- Convient aux changements de vêtements/personnages, au transfert de poses de photos vers d'autres personnages, et aux scénarios nécessitant une cohérence des mouvements corporels dans les storyboards et les images clés ; contrairement aux contrôles de contour comme Canny / Lineart du même auteur, il ne verrouille que la position des articulations, pas les contours des vêtements ni l'arrière-plan
- Méthode d'extraction de squelette fournie par l'auteur : DWPose de comfyui_controlnet_aux, avec les options corps, mains et visage activées ; le squelette coloré sur fond noir correspond aux images de contrôle utilisées lors de l'entraînement
- Paramètres et workflow complets : inclut un JSON de workflow ComfyUI (lecture de photo → génération de squelette → encodage → échantillonnage), utilise l'archive de l'étape 4500, intensité 1.0, 30 pas, CFG 4, euler + simple, sans mot-clé de déclenchement
- 3 exemples, chacun étant une mosaïque « squelette + trois prompts différents », permettant de voir directement la même pose avec trois personnages différents ; publié il y a 5 heures avec 29 téléchargements et 3 likes, c'est le plus populaire de ce groupe de LoRAs de contrôle ; gratuit, la licence autorise la sortie d'images et la vente
Comment l'utiliser
- Utilisez MOSS-Image-SFT comme modèle de base : UNet moss_image_sft_int8_convrot, encodeur de texte qwen3.5_9b_w4a8_gptq (type moss_image), VAE flux2-vae_small ; attachez le LoRA à l'UNet avec une intensité de 1.0
- Utilisez DWPose (corps + mains + visage) pour extraire le squelette de la photo de référence, utilisez l'image de squelette colorée sur fond noir comme seule image de référence connectée à Text Encode MOSS-Image Edit ; définissez le format d'édition sur ai-toolkit pour les nœuds d'encodage positif et négatif
- 30 pas, CFG 4, euler + simple ; sans mot-clé de déclenchement, le prompt décrit l'identité du personnage, les vêtements, les matériaux et la scène, sans avoir besoin de décrire chaque articulation individuellement
Risques et limitations
- 4 exemples de niveau sensible sont masqués, soit plus que les 3 visibles
- Pour les membres manquants dans le squelette, l'auteur affirme que le prompt ne peut pas fiabiliser la reconstruction des articulations correspondantes ; le niveau de précision pour les détails fins comme les doigts n'est pas précisé
- Entraîné spécifiquement pour MOSS-Image-SFT (l'auteur utilise un UNet quantifié int8) ; les performances avec MOSS-Image-Base ou d'autres précisions ne sont pas précisées ; l'auteur a étiqueté le modèle de base comme Other
- Dans la fiche modèle complète, l'auteur suggère de réduire l'intensité vers 0.7 si le contrôle est trop rigide, la valeur d'entraînement étant 1.0
- Les images d'exemple n'incluent pas les paramètres de génération ; cet article n'a pas été testé
Recommandé (9)
【A】Anime Screencap Style · v2.0
LoRA · Mise à jour de version · Auteur kanakiy · Publié le 11-10 09:48 · Téléchargements 57
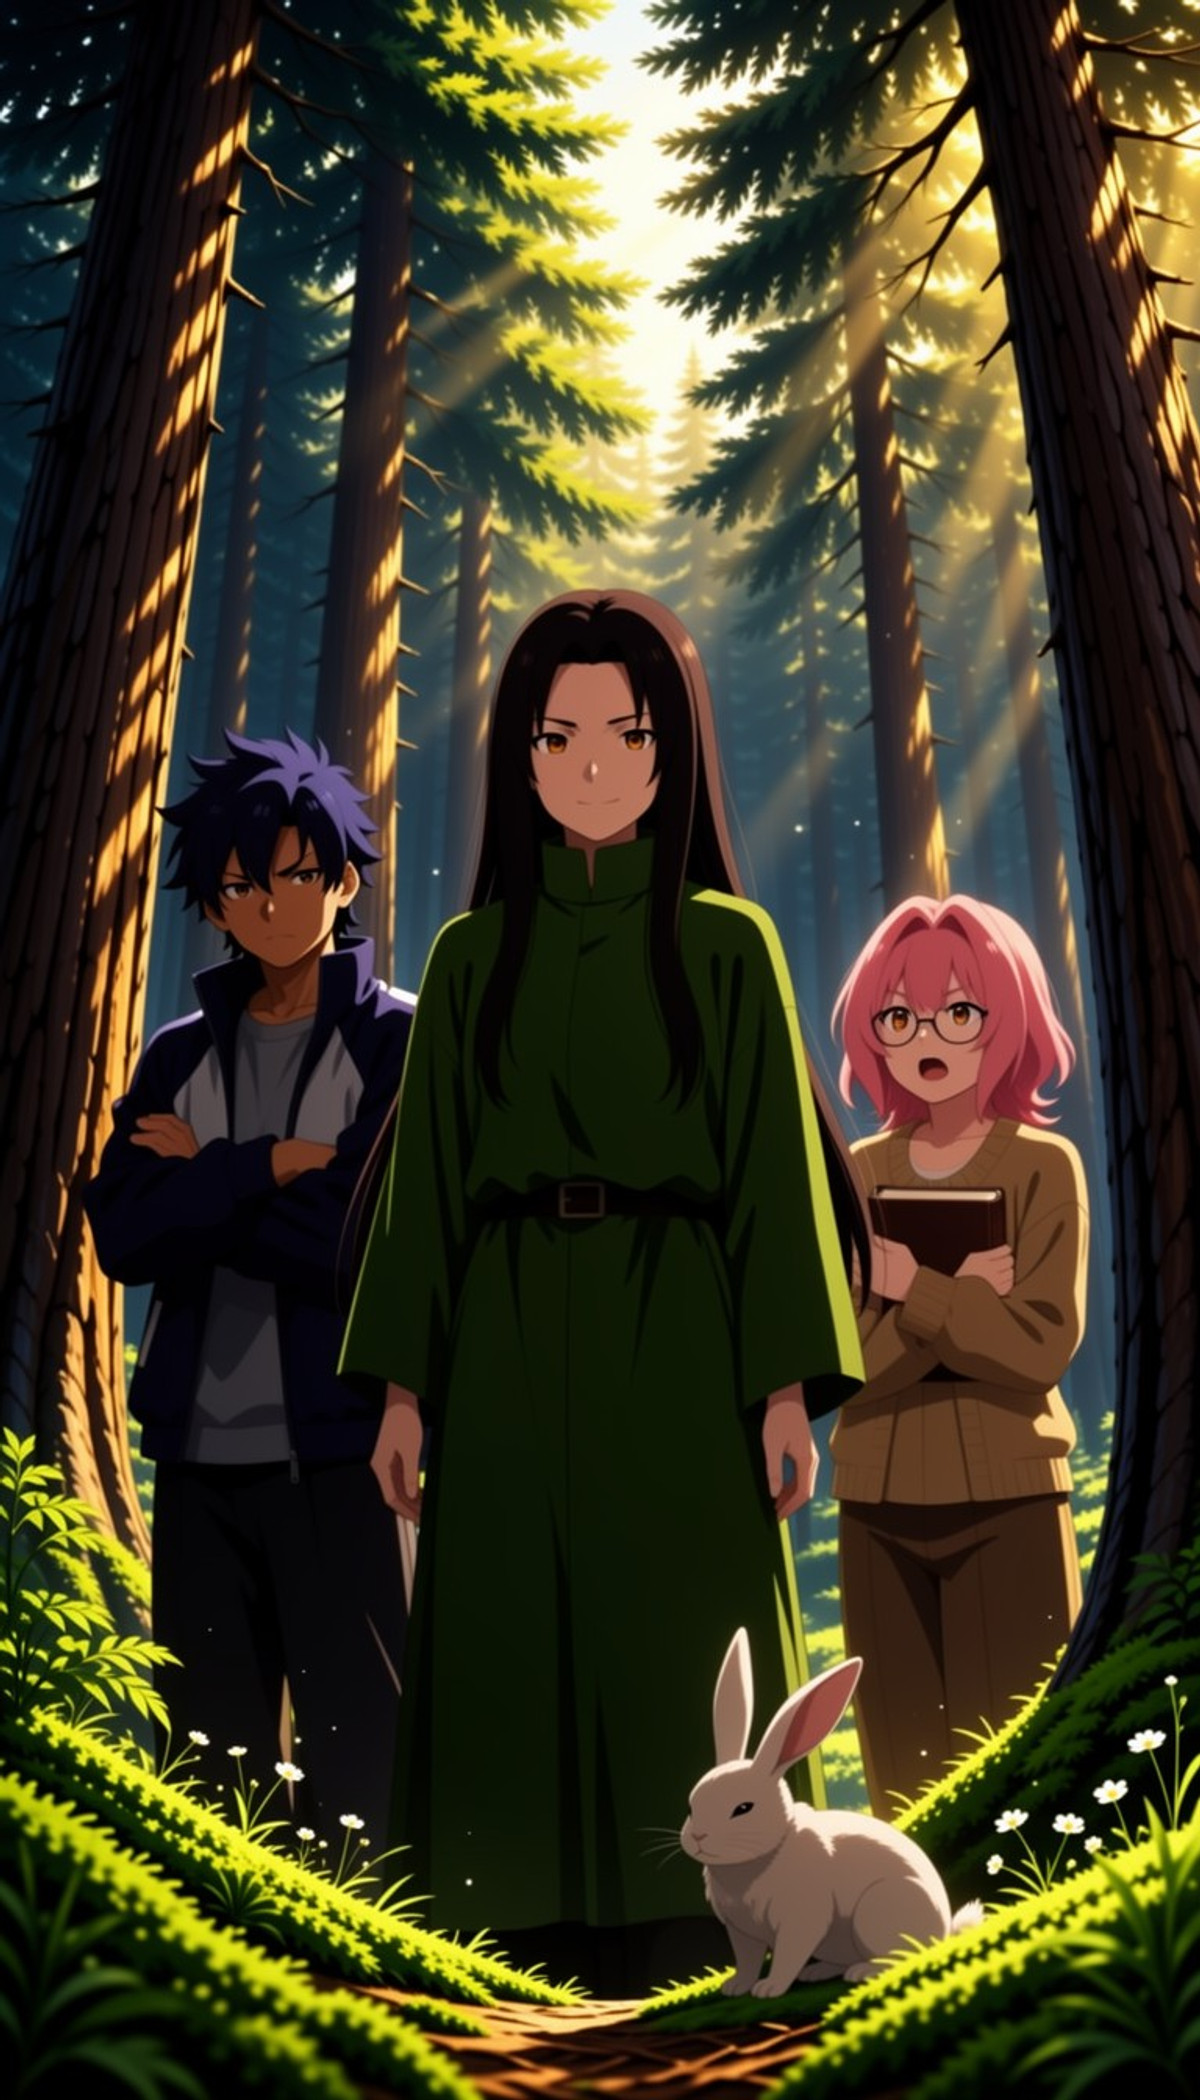
Version v2.0 du LoRA de style capture d'écran d'animation moderne : aplats de couleur cel-shading, ombres douces quasi absentes, lignes épaisses et nettes, couleurs saturées et composition cinématographique large.
Maintien de la note A automatique : l'objectif de style est décrit spécifiquement et il y a beaucoup d'exemples, mais v2 manque d'informations sur l'intensité et les paramètres d'échantillonnage.
Illustrations
Raisons de la recommandation
- Mise à jour de version : l'auteur affirme que v2.0 a amélioré les données d'entraînement en retirant les personnages Tsunade et Seiko Ayase des données de v1.0 (ils restent accessibles par leur nom) ; pour v1.0, une intensité de 0.6–0.8 était recommandée en raison de ces deux personnages
- Convient à la génération d'images avec un « effet capture d'écran d'animation » plutôt que le style anime doux et dégradé courant, l'auteur affirme qu'il est plus plat et plus dur que la plupart des modèles anime
- 17 exemples ; gratuit ; publié il y a environ 11 heures avec 57 téléchargements
Comment l'utiliser
- Chargez simplement le LoRA, sans mot-clé de déclenchement ; pour v1.0, une intensité de 0.6–0.8 est recommandée, l'intensité pour v2.0 n'est pas fournie par l'auteur, vous pouvez commencer par la même plage ; le nombre de pas et le CFG ne sont pas fournis
Risques et limitations
- L'auteur n'a pas écrit de notes de mise à jour (la description de version est vide, les changements proviennent de deux phrases dans la fiche modèle) ; pas de comparaison entre v1 et v2
- La licence n'autorise pas l'usage commercial des images générées, seule la location est permise ; 3 exemples sont masqués par la classification
- Cet article n'a pas été testé
【A】Realistic Photo by Amateur Snapshot · MOSS
LoRA · Nouveau modèle · Auteur 858654128784 · Publié le 11-10 18:02 · Téléchargements 73
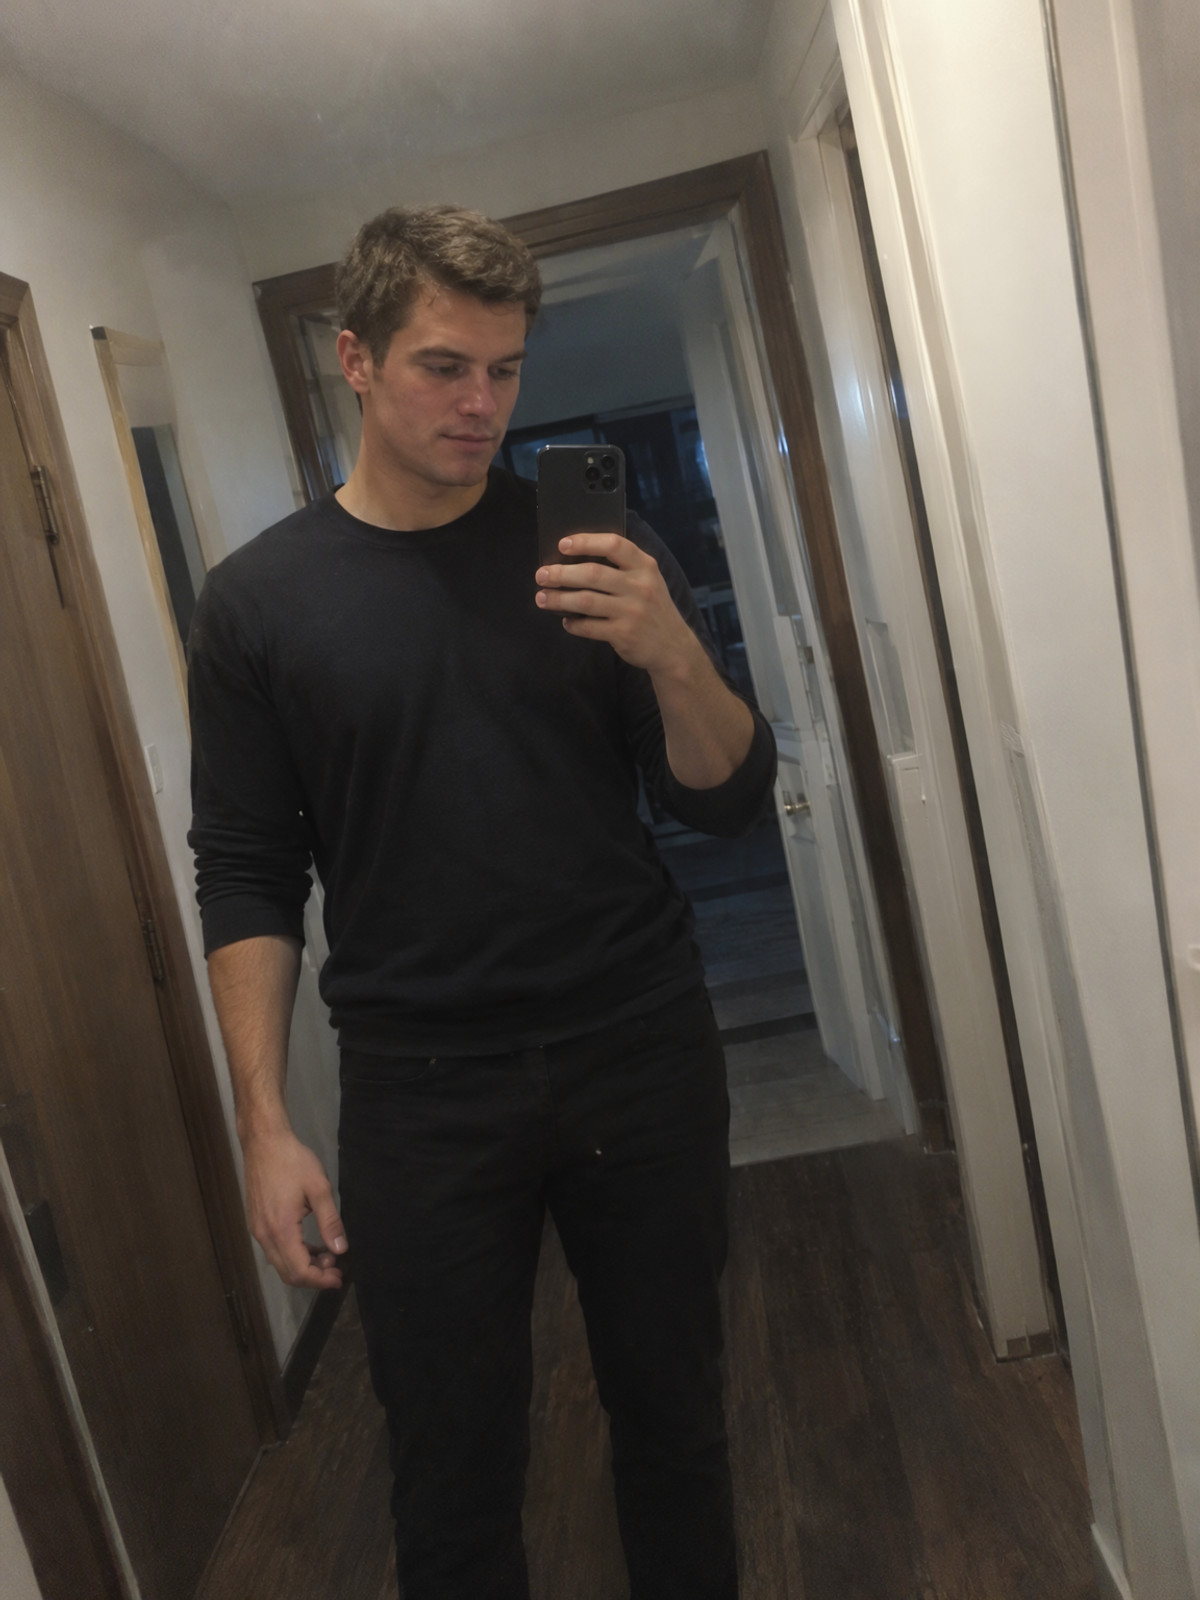
LoRA de photos réalistes au style de photo prise à la volée avec un smartphone : selfies dans le miroir, selfies frontaux, comptoirs de cuisine, ascenseurs, photos d'animaux prises d'en haut, compositions inclinées, éclairage inégal, grain dans les ombres et textures de peau réalistes, éliminant l'aspect studio trop propre typique des images IA.
Maintien de la note A automatique : usage clair, les instructions de prompt sont directement applicables, mais il manque l'intensité et les paramètres d'échantillonnage, et les exemples visibles sont peu nombreux.
Illustrations
Raisons de la recommandation
- Nouveau modèle : uniquement disponible pour MOSS, l'objectif est « les photos prises par des gens ordinaires avec un smartphone » plutôt que des photos réalistes retouchées
- L'auteur fournit des instructions de prompt : commencez par amateur smartphone photo, indiquez le lieu, qui tient le téléphone, d'où vient la lumière ; ajoutez des détails comme « le téléphone bloque la moitié du visage » ou « une tasse à moitié coupée au premier plan » pour plus de réalisme
- Gratuit, la licence autorise la sortie d'images, la location et la vente ; publié il y a environ 3 heures avec 73 téléchargements, c'est l'article avec la croissance de téléchargements la plus rapide de ce groupe
Comment l'utiliser
- Commencez le prompt par amateur smartphone photo, décrivez le lieu, la personne tenant l'appareil et la source de lumière, puis ajoutez des détails de photo à la volée comme des obstructions ou des coupures au premier plan ; sans mot-clé de déclenchement
- L'intensité, le nombre de pas et le CFG ne sont pas fournis par l'auteur
Risques et limitations
- 15 exemples sont masqués par la classification, seuls 5 sont visibles ; la page contient du contenu mixte
- Pas de paramètres fournis, ni de comparaison avec/sans LoRA ; la source des données d'entraînement n'est pas précisée par l'auteur
- Génère des photos de vie quotidienne de personnages très réalistes, veillez à indiquer la génération IA lors de la publication ; cet article n'a pas été testé
【A】Chaldea Corridor: Fate/Grand Order · MOSS-sft01
LoRA · Nouveau modèle · Auteur RHU_AIstudio · Publié le 11-10 19:59 · Téléchargements 10
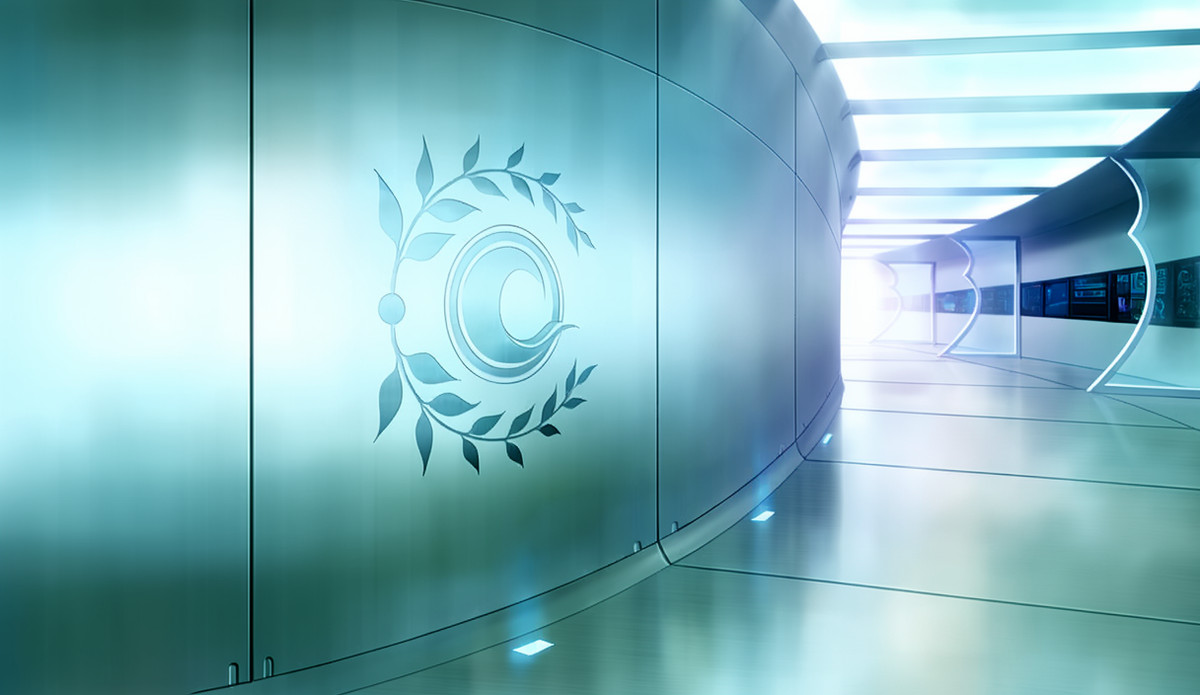
LoRA d'arrière-plan de scène pour le couloir de l'ancien Chaldea de Fate/Grand Order : utilise un mot-clé de déclenchement pour fixer ce couloir, puis des mots d'état pour alterner entre les aspects normal, sombre, endommagé, gelé, etc.
Maintien de la note A automatique : c'est l'article avec la description d'usage la plus claire pour un LoRA de scène, le mot-clé de déclenchement, l'intensité et les mots d'état sont directement copiables, mais il ne couvre qu'un seul lieu et manque de paramètres d'échantillonnage.
Illustration
Raisons de la recommandation
- Nouveau modèle, et l'un des rares LoRA de type scène / arrière-plan de cette édition : il ne se concentre pas sur les personnages, mais reproduit spécifiquement un lieu fixe, servant à l'illustration de fan art, à l'ajout d'arrière-plans pour des illustrations de personnages ou à des images de scènes de style visual novel
- L'auteur précise la source de l'entraînement : 7 images d'arrière-plans issus du jeu, couvrant les états normal / sombre / flou / endommagé / gelé et deux angles de caméra
- Les mots-clés de déclenchement, l'intensité et les termes d'état sont fournis : corridor_(chaldea)_(fate), intensité 1.0 ; bright lighting, dark, dim lighting, damaged, cracked wall, debris, frozen, ice, flooded, close-up correspondant à l'angle montrant le mur avec les armoiries
- 3 exemples visibles, 1 masqués ; gratuit, licence permissive, autorisant la génération d'images, la vente et les œuvres dérivées
Comment l'utiliser
- Écrivez corridor_(chaldea)_(fate) dans le prompt, ajoutez des termes d'état selon les besoins : bright lighting / dark, dim lighting / damaged, cracked wall, debris / frozen, ice, flooded ; ajoutez close-up pour l'angle montrant le mur avec les armoiries ; intensité du LoRA 1.0
- Le nombre de pas, le CFG et l'échantillonneur ne sont pas précisés par l'auteur ; le nom de la version est MOSS-sft01, l'auteur n'indique pas si l'entraînement a été effectué sur la base Base ou SFT
Risques et limitations
- L'ensemble de données d'entraînement ne contient que 7 images, ce qui signifie que les résultats se limitent essentiellement aux différents états de ce couloir et aux deux angles de caméra ; il est inconnu si la structure est conservée lors d'un changement de perspective
- Les matériaux proviennent d'images d'arrière-plan sous copyright du jeu ; bien que la licence soit permissive, il faut tenir compte du copyright de l'œuvre originale avant toute utilisation commerciale
- La fiche du modèle ne contient qu'un seul paragraphe, sans instructions sur l'ajout de personnages ni sur l'utilisation combinée ; cette entrée n'a pas été testée
Mots-clés de déclenchement : corridor_(chaldea)_(fate)
【A】MOSS-Image Scribble Control · v1.0
LoRA · Nouveau modèle · Auteur thedeoxen · Publié le 11-10 16:53 · Téléchargements 23
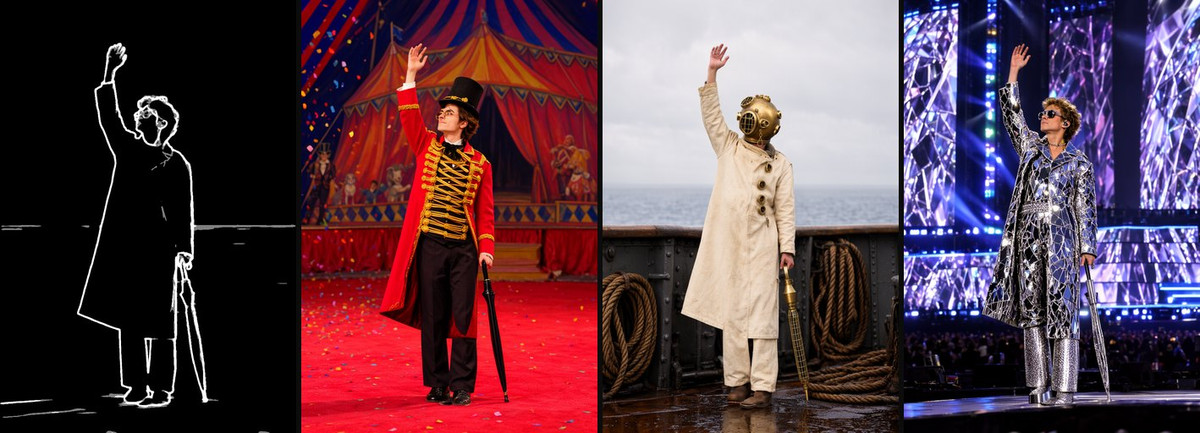
LoRA de contrôle par gribouillage pour MOSS-Image-SFT : fournissez quelques traits blancs épais et doux sur fond noir, il ne suit que les grands mouvements et les volumes, laissant les détails, la texture et le style être librement définis par le prompt.
Illustration
Raisons de la recommandation
- Nouvelle capacité : le niveau de contrôle le plus souple de la série de l'auteur, gérant uniquement les traits principaux et les grandes formes, sans suivre chaque bord fin ; l'auteur suggère de l'utiliser avant le raffinement Canny / Lineart pour des tests de composition rapides
- Sert à l'esquisse initiale, aux traits de storyboard, ou à ne conserver que les grandes formes sur une photo avant de redessiner : l'entrée peut être quelques traits à main levée ou des bords doux extraits d'une photo
- Prétraitement : le workflow utilise HED Soft-Edge Lines avec le mode safe activé ; les gribouillis d'entraînement sont plus épais et plus doux que Canny et les linearts, l'auteur affirme que les bords doux HED sont plus proches des images d'entraînement que les esquisses fines PiDiNet
- Inclut un workflow ComfyUI ; sauvegarde à l'étape 5000, intensité 1.0, 30 pas, CFG 4, euler + simple ; 3 exemples en mosaïque
- Gratuit, la licence autorise la génération d'images et la vente ; 23 téléchargements en 4 heures après la publication
Comment l'utiliser
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), attachez le LoRA à l'UNet, intensité 1.0
- HED Soft-Edge Lines (mode safe) ou quelques traits blancs épais sur fond noir à main levée, comme seule image de référence connectée à Text Encode MOSS-Image Edit, définissez le format d'édition sur ai-toolkit pour les encodages positif et négatif
- 30 pas, CFG 4, euler + simple ; pas de mot-clé de déclenchement ; l'auteur suggère que des traits peu nombreux et affirmés sont préférables aux images de bordures désordonnées, laissant la texture, la couleur et les petits détails au prompt
Risques et limitations
- Le contrôle est souple, les positions des détails ne sont pas verrouillées ; pour les scènes nécessitant des contours précis, il faut utiliser Canny ou Lineart
- Entraîné uniquement pour MOSS-Image-SFT ; le modèle de base est marqué comme Other ; 1 exemples de niveau sensible sont masqués
- La fiche complète du modèle suggère de réduire l'intensité vers 0.7 si le contrôle est trop rigide
- Cette entrée n'a pas été testée
【A】MOSS-Image Normal Control · v1.0
LoRA · Nouveau modèle · Auteur thedeoxen · Publié le 11-10 16:51 · Téléchargements 24
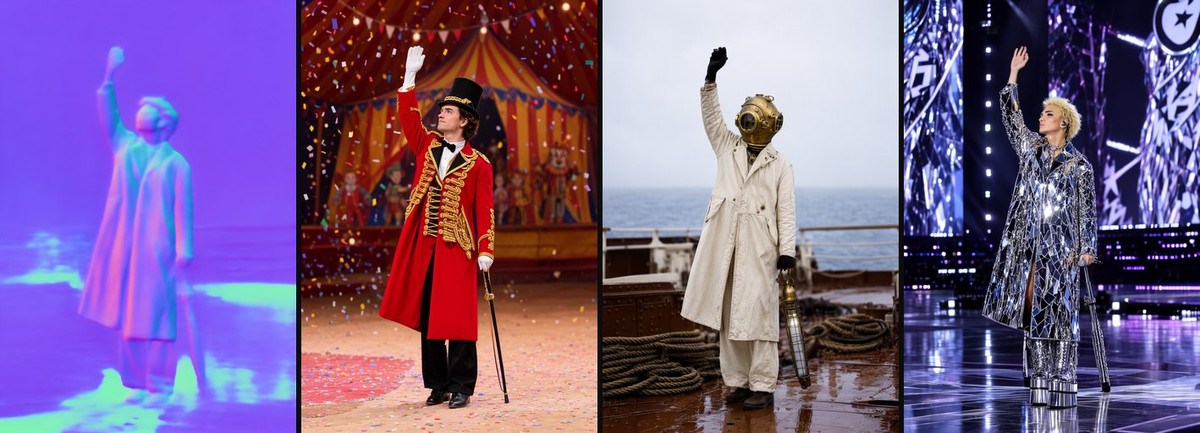
LoRA de contrôle par normales pour MOSS-Image-SFT : fournissez une carte de normales colorée, il préserve le volume et l'orientation des surfaces des objets, ne changeant que les matériaux et la scène.
Illustration
Raisons de la recommandation
- Nouvelle capacité : gère une couche supplémentaire « direction de la surface » par rapport aux cartes de profondeur, laissant le volume et l'orientation inchangés tout en permettant de changer les matériaux ; les utilisations listées par l'auteur incluent le changement de matériaux / le rééclairage de formes fixes et les scènes de photos de produits où le volume de l'objet est fixe
- Sert au changement de matériaux sur des photos de produits, au re-texturing de sculptures ou d'accessoires, et aux scènes où la profondeur est correcte mais où il faut aussi contrôler l'orientation des surfaces ; l'entrée est une photo ou une normale exportée d'un rendu 3D
- Prétraitement : le workflow utilise BAE Normal Map, les images d'entraînement sont des normales d'espace caméra courantes en violet / cyan / vert ; l'auteur rappelle d'utiliser des normales d'espace caméra, pas des cartes de hauteur en niveaux de gris, plus les normales sont lisses, plus le volume est propre, le bruit créant des bosses superflues
- Inclut un workflow ComfyUI ; sauvegarde à l'étape 5000, intensité 1.0, 30 pas, CFG 4, euler + simple ; 3 exemples en mosaïque utilisant la même photo de test que les versions Canny / Lineart
- Gratuit, la licence autorise la génération d'images et la vente
Comment l'utiliser
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), attachez le LoRA à l'UNet, intensité 1.0
- BAE Normal Map génère une carte de normales colorée en espace caméra, comme seule image de référence connectée à Text Encode MOSS-Image Edit, définissez le format d'édition sur ai-toolkit pour les encodages positif et négatif
- 30 pas, CFG 4, euler + simple ; pas de mot-clé de déclenchement, écrivez les matériaux et la scène dans le prompt
Risques et limitations
- L'utilisation est plus étroite que Canny / Depth, apportant une valeur ajoutée par rapport au contrôle de profondeur principalement dans les cas de changement de matériaux et d'éclairage
- Il faut vérifier soi-même si les normales exportées des logiciels 3D sont cohérentes avec les conventions de couleur de BAE, l'auteur ne le précise pas ; entraîné uniquement pour MOSS-Image-SFT ; le modèle de base est marqué comme Other ; 1 exemples de niveau sensible sont masqués
- La fiche complète du modèle suggère de réduire l'intensité vers 0.7 si le contrôle est trop rigide
- Cette entrée n'a pas été testée
【A】MOSS-Image Segmentation Control · v1.0
LoRA · Nouveau modèle · Auteur thedeoxen · Publié le 11-10 16:54 · Téléchargements 25
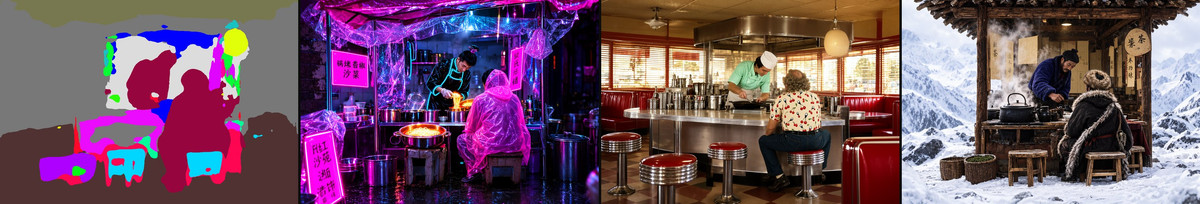
LoRA de contrôle par segmentation sémantique pour MOSS-Image-SFT : fournissez une carte de zones en aplats de couleur, il préserve les limites des zones et la disposition générale, laissant le prompt décider de ce que chaque zone devient.
Illustration
Raisons de la recommandation
- Nouvelle capacité : contrôle par « blocs de zone » plutôt que par lignes ou profondeur, adapté pour diviser d'abord l'image en grandes zones (personnages, meubles, arrière-plan) avant de changer le style de rendu global ; l'auteur affirme que les limites et les volumes principaux sont conservés
- Sert à la composition par blocs de scène, aux dispositions de type script couleur, et à la redéfinition de l'image entière en conservant la position des personnages et des meubles
- Prétraitement : le workflow utilise la segmentation sémantique UniFormer ; les images d'entraînement sont des aplats de couleur couvrant toute la surface, sans grandes zones noires non annotées ; l'auteur rappelle que les couleurs des blocs ne sont que des identifiants de zone et ne deviennent pas les couleurs de l'image finale, les matériaux doivent être écrits dans le prompt, les dégradés et les textures perturbent les zones
- Inclut un workflow ComfyUI ; sauvegarde à l'étape 4500, intensité 1.0, 30 pas, CFG 4, euler + simple
- Gratuit, la licence autorise la génération d'images et la vente ; 25 téléchargements en 4 heures après la publication
Comment l'utiliser
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), attachez le LoRA à l'UNet, intensité 1.0
- UniFormer génère une carte de zones en aplats couvrant toute l'image (ne laissez pas de grandes zones noires), comme seule image de référence connectée à Text Encode MOSS-Image Edit, définissez le format d'édition sur ai-toolkit pour les encodages positif et négatif
- 30 pas, CFG 4, euler + simple ; pas de mot-clé de déclenchement, précisez clairement le sujet et le matériau de chaque zone dans le prompt
Risques et limitations
- L'auteur affirme que les segmenteurs qui laissent l'arrière-plan en noir ne correspondent pas bien à ces poids, il faut faire attention lors du changement de modèle de segmentation
- 2 exemple visible, 1 exemples de niveau sensible sont masqués ; entraîné uniquement pour MOSS-Image-SFT ; le modèle de base est marqué comme Other
- La fiche complète du modèle suggère de réduire l'intensité vers 0.7 si le contrôle est trop rigide
- Cette entrée n'a pas été testée
【A】MOSS-Image Lineart Control · v1.0
LoRA · Nouveau modèle · Auteur thedeoxen · Publié le 11-10 16:37 · Téléchargements 21
LoRA de contrôle par lineart pour MOSS-Image-SFT : fournissez un lineart de fines lignes blanches sur fond noir, il génère selon la structure des lignes, laissant la couleur, les matériaux et le style être définis par le prompt.
Illustration
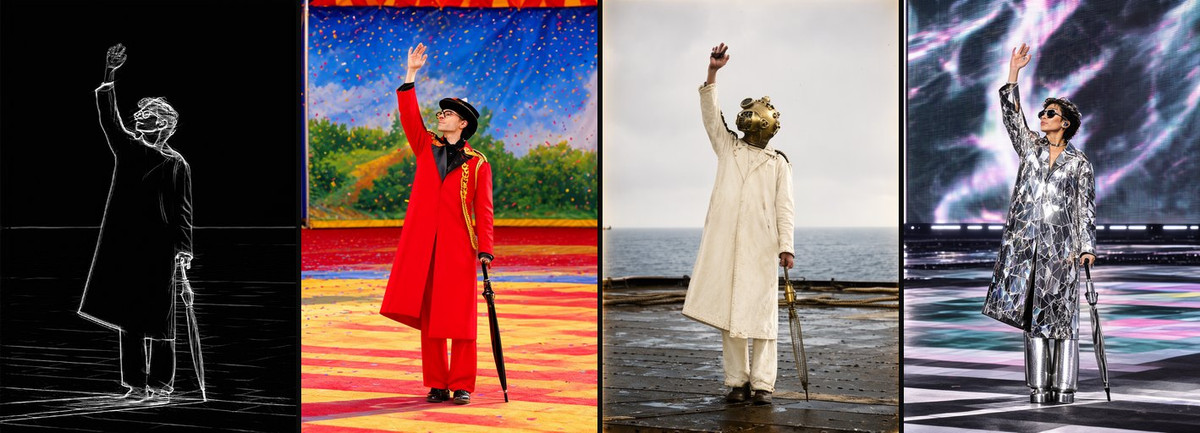
Raisons de la recommandation
- Nouvelle capacité : intermédiaire entre Canny et Scribble — suit les contours nets, mais sans le bruit de points dispersés présent dans les images Canny brutes ; l'utilisation principale listée par l'auteur est la colorisation de linearts
- Sert à la colorisation de linearts, à la génération d'images finales à partir de croquis de conception, et au changement de scène en conservant la structure des lignes d'une photo ; l'auteur affirme que les linearts dessinés à la main et extraits de photos fonctionnent tous deux, à condition que les lignes soient légères et espacées
- Le prétraitement est important : le workflow utilise Realistic Lineart avec l'option coarse activée, l'auteur affirme que cela correspond mieux aux images d'entraînement que le mode lineart fin ; lignes blanches sur fond noir, si vous avez un lineart à lignes noires sur fond blanc, il faut d'abord inverser les couleurs
- Inclut un workflow ComfyUI ; sauvegarde à l'étape 5000, intensité 1.0, 30 pas, CFG 4, euler + simple ; 3 exemples en mosaïque utilisant la même photo de test que la version Canny
- Gratuit, la licence autorise la génération d'images et la vente
Comment l'utiliser
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), attachez le LoRA à l'UNet, intensité 1.0
- Realistic Lineart (coarse activé) génère une image de lignes blanches sur fond noir, comme seule image de référence connectée à Text Encode MOSS-Image Edit, définissez le format d'édition sur ai-toolkit pour les encodages positif et négatif
- 30 pas, CFG 4, euler + simple ; pas de mot-clé de déclenchement, écrivez la couleur, les matériaux et le style artistique dans le prompt
Risques et limitations
- L'auteur affirme que les lignes espacées correspondent mieux à l'entraînement que les croquis denses, le comportement avec des linearts trop denses n'est pas précisé
- Entraîné uniquement pour MOSS-Image-SFT ; le modèle de base est marqué comme Other ; 1 exemples de niveau sensible sont masqués ; ce groupe a le moins de téléchargements (21 fois)
- La fiche complète du modèle suggère de réduire l'intensité vers 0.7 si le contrôle est trop rigide
- Cette entrée n'a pas été testée
【A】MOSS-Image Canny Control · v1.0
LoRA · Nouveau modèle · Auteur thedeoxen · Publié le 11-10 16:29 · Téléchargements 23
LoRA de contrôle par bords Canny pour MOSS-Image-SFT : fournissez une image de bords Canny avec des lignes blanches sur fond noir, il verrouille les contours des objets, la composition et les bords fins, laissant les matériaux, la palette de couleurs et le style être gérés par le prompt.
Illustration
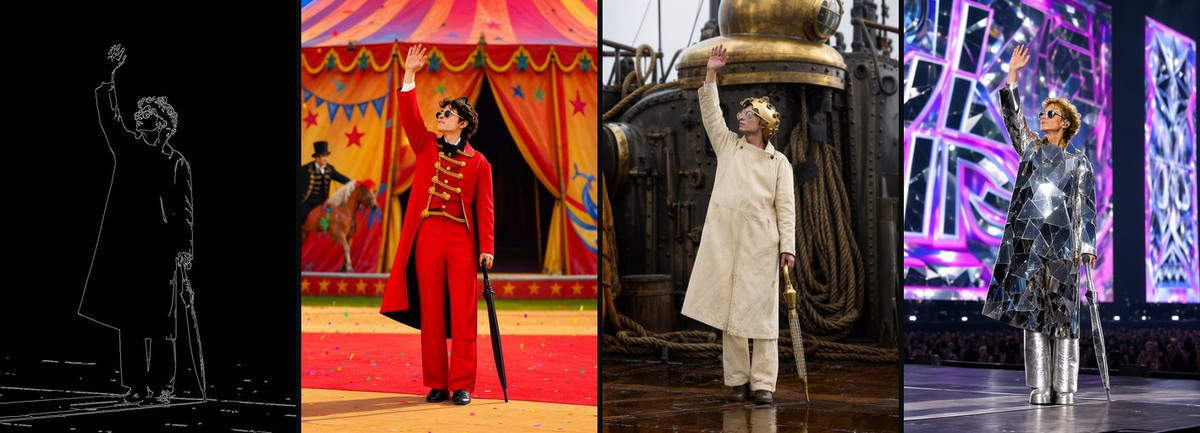
Raisons de la recommandation
- Nouvelle capacité : le plus strict de la série LoRA du même auteur, suivant même les contours les plus fins ; l'auteur le positionne comme « conserver les contours, changer les couleurs et les matériaux », adapté aux études de mise en page où les contours doivent rester fixes
- Sert à la conversion photo en style, au redessin avec changement de matériau sur la même composition, aux brouillons de mise en page : l'entrée est une photo ou une image existante, extraction Canny d'abord puis génération
- Prétraitement spécifié : Canny Edge de comfyui_controlnet_aux, seuils low 100 / high 200 ; l'auteur conseille d'augmenter les seuils pour des contours plus nets si le résultat suit chaque bruit de façon trop rigide
- Workflow ComfyUI inclus ; sauvegarde à l'étape 4500, force 1.0, 30 étapes, CFG 4, euler + simple ; 3 exemples de collages « image de contrôle + trois prompts », utilisant la même photo de test du directeur de cirque que les LoRA Normal / Scribble / Lineart du même auteur, permettant une comparaison horizontale
- Gratuit, licence autorisant la génération d'images et la vente ; 23 téléchargements en 4 heures
Comment l'utiliser
- MOSS-Image-SFT (UNet convrot int8 + encodeur de texte qwen3.5_9b_w4a8_gptq, type moss_image + flux2-vae_small), LoRA attaché à l'UNet, force 1.0
- Prétraitement Canny Edge (low 100 / high 200) produisant des lignes blanches sur fond noir, utilisé comme seule image de référence connectée à Text Encode MOSS-Image Edit, format d'édition défini sur ai-toolkit pour les encodages positif et négatif
- 30 étapes, CFG 4, euler + simple ; pas de mot-clé de déclenchement, le prompt décrit les nouveaux matériaux, couleurs et scènes
Risques et limitations
- Plus l'image Canny est dense, plus l'image est contrainte par les détails de l'original, laissant moins de place à la modification par le prompt ; pour ne conserver que la forme générale, il faut passer aux LoRA Scribble ou Lineart
- Entraîné uniquement pour MOSS-Image-SFT, les autres modèles de base / précisions ne sont pas mentionnés par l'auteur ; le modèle de base est marqué Other ; 1 exemples de niveau sensible sont masqués
- La fiche modèle complète suggère de baisser la force vers 0.7 si le contrôle est trop rigide
- Cet élément n'a pas été testé
【A】MOSS-Image Depth Control · v1.0
LoRA · Nouveau modèle · Auteur thedeoxen · Publié le 11-10 16:25 · Téléchargements 22
LoRA de contrôle de profondeur pour MOSS-Image-SFT : fournir une carte de profondeur en niveaux de gris (blanc proche, noir loin) pour maintenir la distance entre premier et arrière-plan ainsi que la disposition spatiale, laissant le sujet et le style au prompt.
Illustration
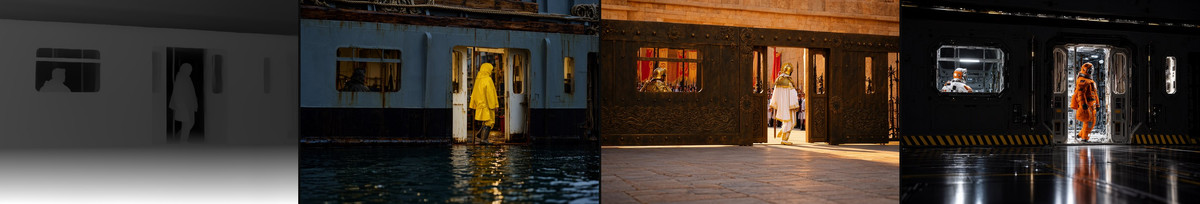
Raison de la recommandation
- Nouvelle capacité : verrouille uniquement « qui est proche, qui est loin » et la profondeur de la caméra, sans verrouiller chaque bord ; l'auteur indique qu'il convient aux cas où « la profondeur de la caméra est plus importante que les contours » ; notez qu'il ne s'agit pas de l'adaptateur officiel MOSS color/depth, mais d'un LoRA d'édition du même auteur
- Sert à la reconstruction de scènes avec changement de style à la même position de caméra, au changement de matériau après séparation du sujet au premier plan et de l'arrière-plan, aux mises en page avec un sujet au premier plan clair comme les produits et l'intérieur
- Prétraitement : le workflow utilise Depth Anything V2 (depth_anything_v2_vitl), blanc au premier plan, noir à l'arrière-plan ; l'auteur avertit spécifiquement de ne pas utiliser une carte de profondeur inversée, sinon elle entrera en conflit avec le LoRA
- Workflow ComfyUI inclus ; sauvegarde à l'étape 5000, force 1.0, 30 étapes, CFG 4, euler + simple ; l'auteur indique que les grandes zones plates de profondeur laissent plus d'espace au prompt pour la texture
- Gratuit, licence autorisant la génération d'images et la vente ; 3 likes
Comment l'utiliser
- MOSS-Image-SFT (UNet convrot int8 + encodeur de texte qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA attaché à l'UNet, force 1.0
- Depth Anything V2 vitl produisant une carte de profondeur en niveaux de gris (blanc proche, noir loin, ne pas inverser), utilisée comme seule image de référence connectée à Text Encode MOSS-Image Edit, format d'édition défini sur ai-toolkit pour les encodages positif et négatif
- 30 étapes, CFG 4, euler + simple ; pas de mot-clé de déclenchement, le prompt décrit le sujet, les matériaux et le style
Risques et limitations
- Seuls 1 collages d'exemples sont visibles, 4 exemples de niveau sensible sont masqués, ce qui en fait l'élément avec le moins de preuves publiques de ce groupe
- L'auteur ne compare pas la supériorité par rapport à l'adaptateur de profondeur officiel ; entraîné uniquement pour MOSS-Image-SFT ; le modèle de base est marqué Other
- La fiche modèle complète suggère de baisser la force vers 0.7 si le contrôle est trop rigide
- Cet élément n'a pas été testé
À suivre (10)
【B】AG: Naberius - Grumpy Niji Boys · MOSS-Image
LoRA · Portage · Auteur Azriaelis · Publié le 11-10 09:10 · Téléchargements 27
Version MOSS de Naberius de la série « Ars Goetia » : un LoRA de style semi-réaliste Niji, principalement des personnages masculins (le titre est Grumpy Niji Boys).
Illustration
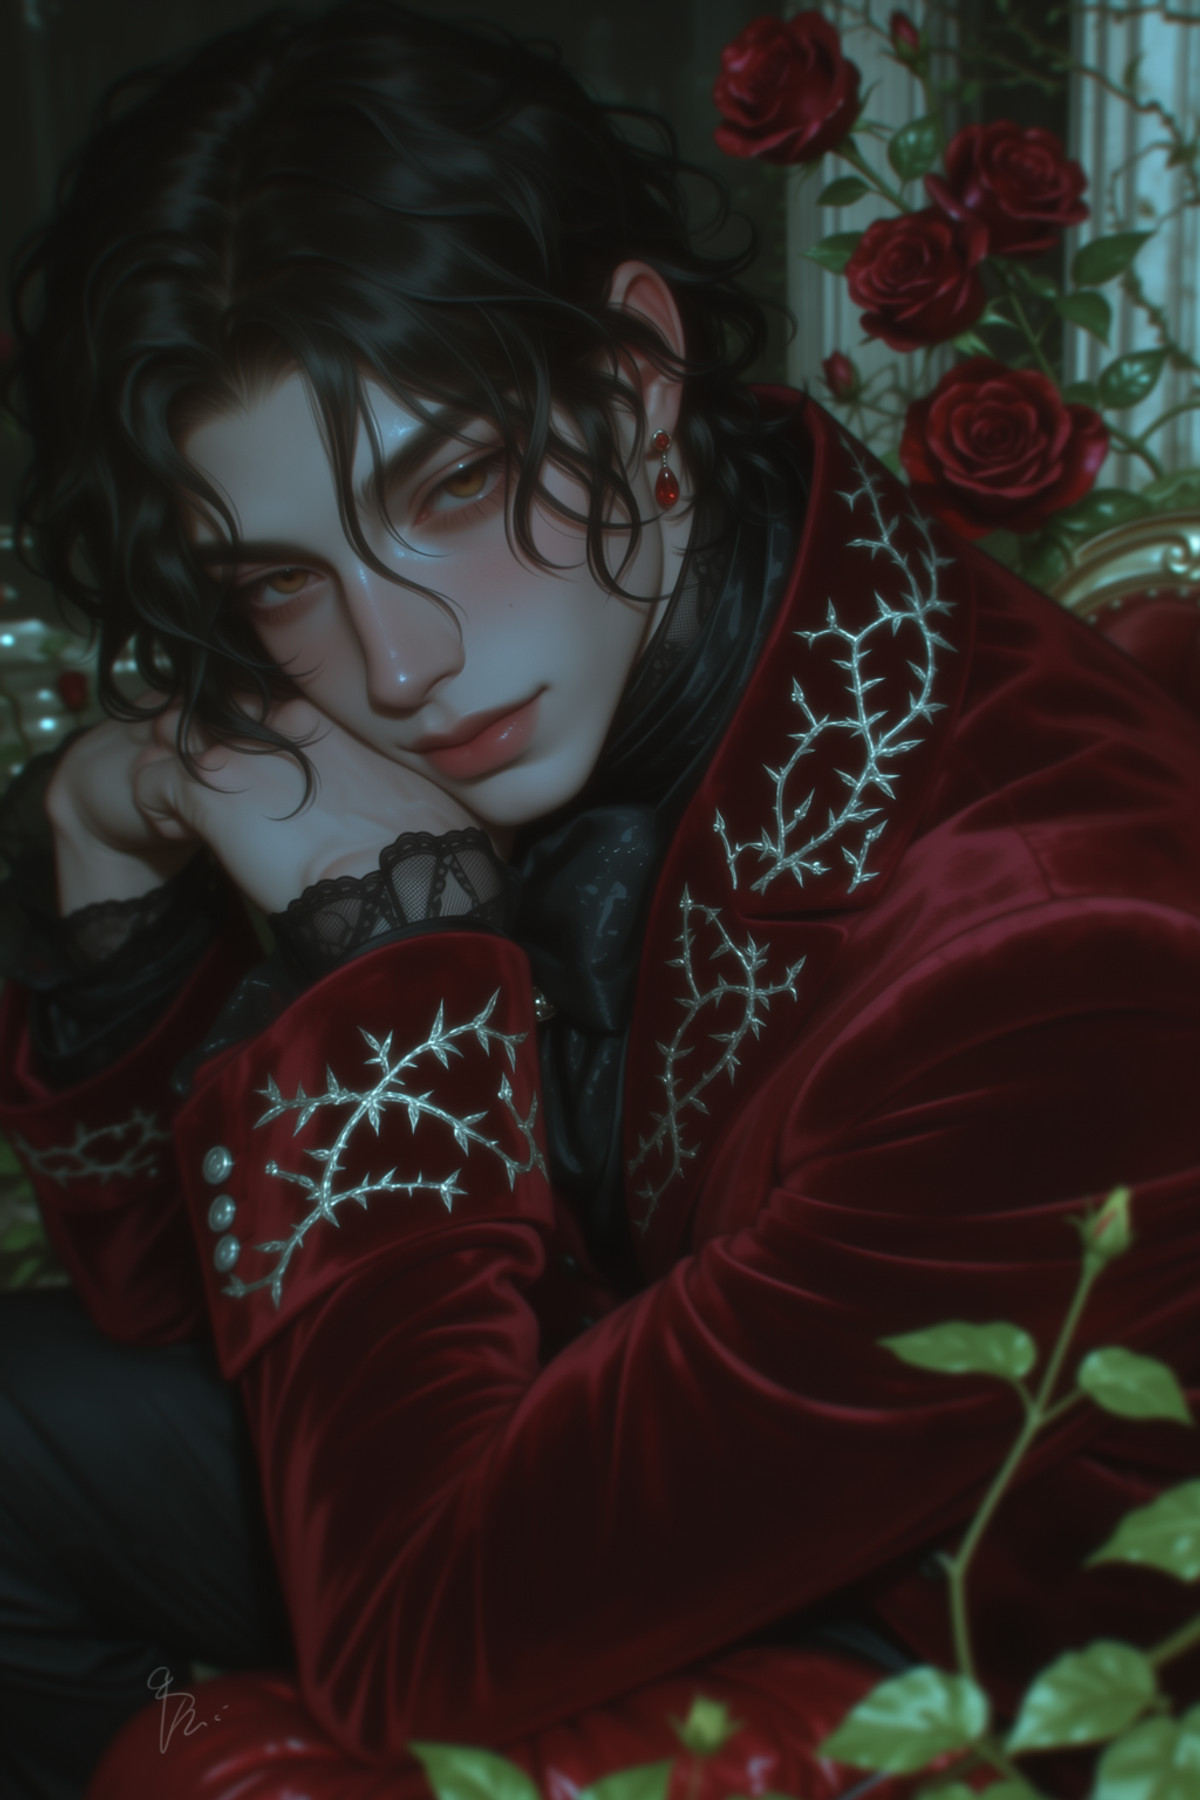
【B】HaDeS MOSS Suite Workflows · Turbo Image to Image v0.1
Workflow · Mise à jour de version · Auteur _HaDeS_ · Publié le 11-10 17:33 · Téléchargements 24
Nouvel élément de la collection de workflows HaDeS MOSS Suite : un workflow ComfyUI d'image à image MOSS avec nœud d'amélioration de prompt et LoRA d'accélération HaDeS (JSON, pas de nouveaux poids).
Illustration
【B】V67 Twins and Mirror · V1 MOSS
LoRA · Portage · Auteur angelomaiota · Publié le 11-10 17:57 · Téléchargements 23
Version MOSS du LoRA jumeaux et miroir : génère des images de jumeaux monozygotes / dizygotes, de reflets dans les miroirs, de reflets dans les flaques d'eau, c'est-à-dire des compositions symétriques ou « une personne, deux corps ».
Illustration
【B】One obsession_MOSS · SFT v1
Modèle de base / Checkpoint · Mise à jour de version · Auteur maxfeifei8 · Publié le 11-10 19:20 · Téléchargements 9 · Payant
Deuxième version SFT v1 du fine-tuning du modèle de base MOSS One obsession : poids complets du modèle de base (deux types, INT8 et BF16), nommé série SFT, la version précédente était BASE v1.
Illustration
【B】V67 Italian Villages · V1 MOSS
LoRA · Portage · Auteur angelomaiota · Publié le 11-10 15:11 · Téléchargements 21
Version MOSS du LoRA paysage de villages italiens : maisons en pierre, ruelles étroites, toits en terre cuite, vues depuis les sommets et lumière dorée, l'auteur indique une fusion de peinture de paysage à la Canaletto et de photographie architecturale réaliste.
Illustration
【B】Chenbin(鬼针草)Style | MOSS Image LoRA · v1.0
LoRA · Nouveau modèle · Auteur NO83 · Publié le 11-10 20:46 · Téléchargements 7
LoRA dédié MOSS imitant le style de l'artiste « Chenbin » (鬼针草) : l'auteur indique que la texture des bas est très bien rendue, les cheveux sont corrects.
Illustration
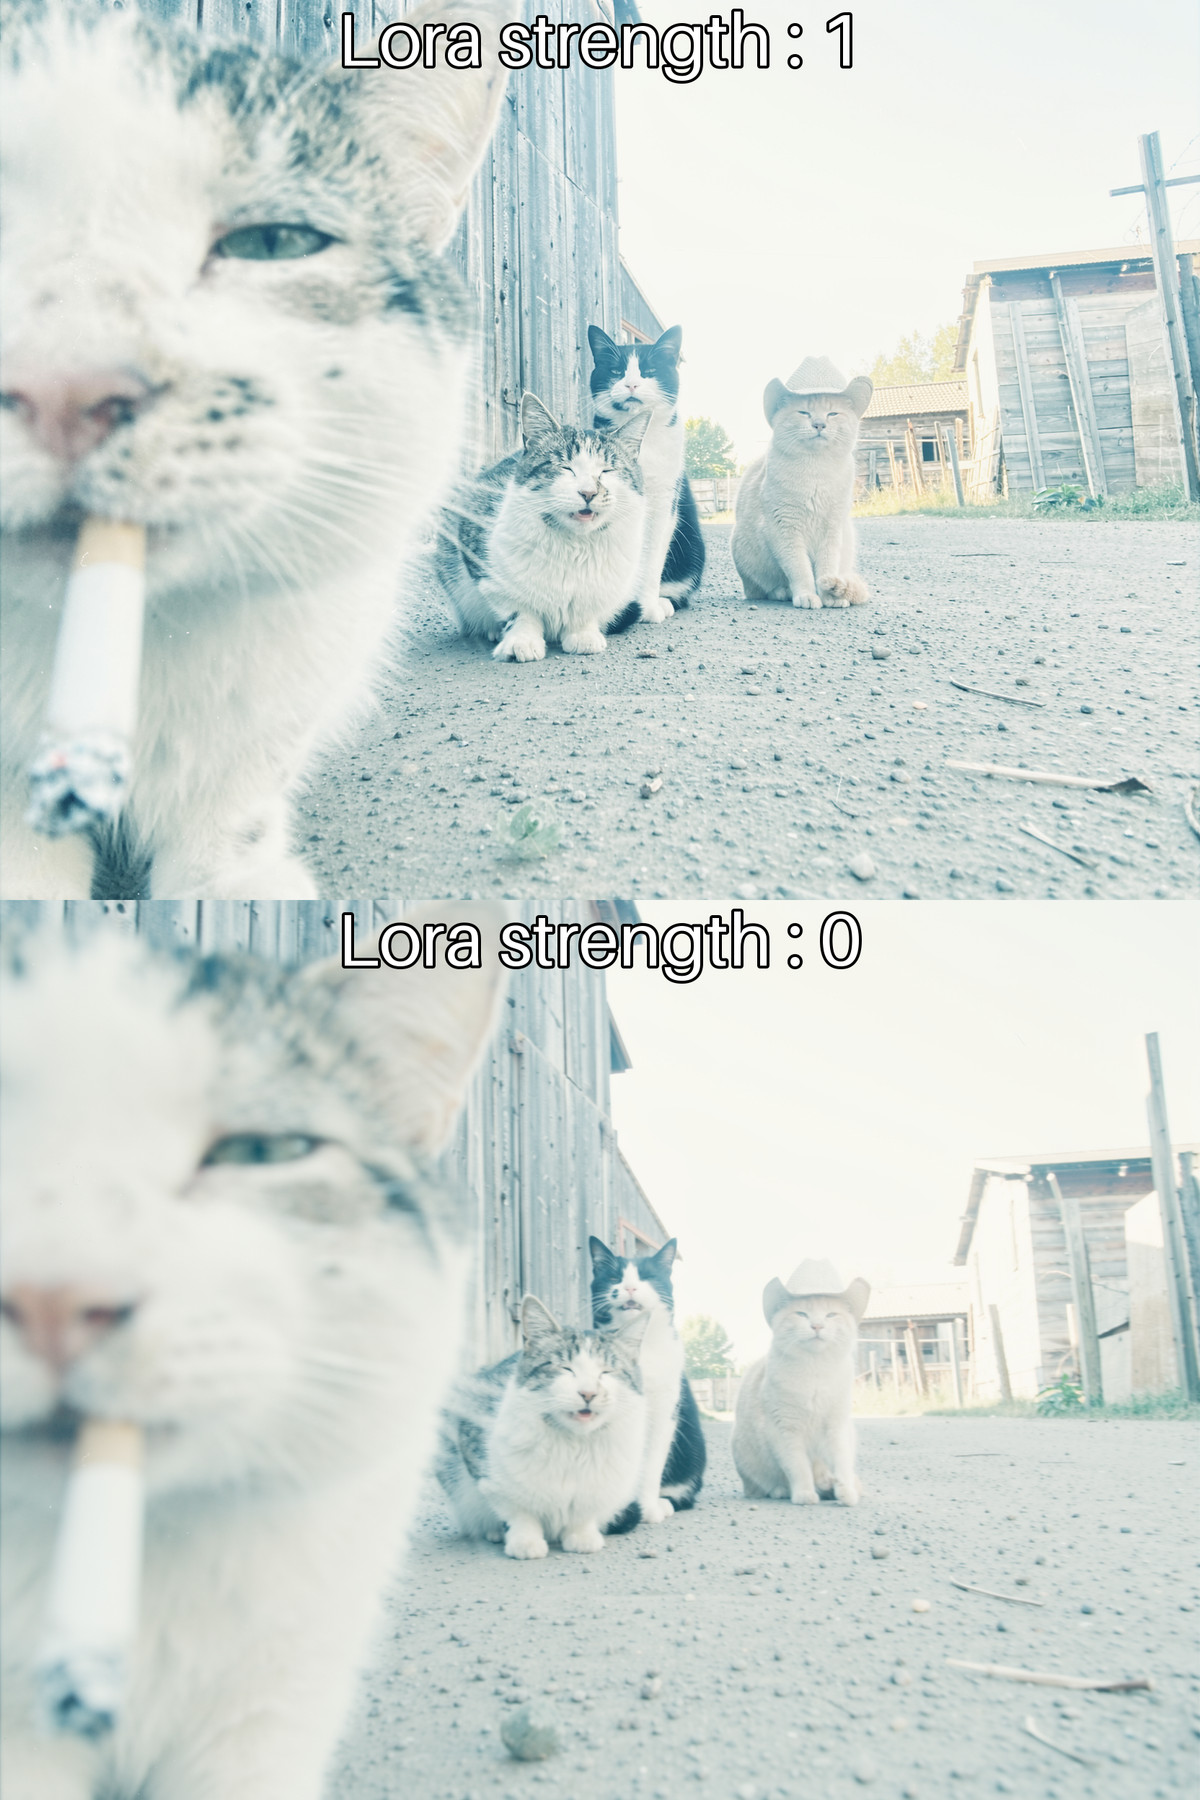
【B】Kromoss slider: blurry to sharp · v1
LoRA · Nouveau modèle · Auteur Generated_Good · Publié le 11-10 18:27 · Téléchargements 61
LoRA curseur de netteté : entraîné sur Kromoss (fine-tuning complet de MOSS-Image-Base), utilise des forces positives et négatives pour ajuster le flou du premier plan et de l'arrière-plan, visant le problème fréquent de flou de Kromoss.
Illustration
【B】釉光细绘 Glazeline style · moss-v1.0
LoRA · Nouveau modèle · Auteur soda_Cookie · Publié le 11-10 20:04 · Téléchargements 12
Le LoRA de style illustration nommé « Glazeline » (Émail finement dessiné) est accompagné, fourni par l'auteur, d'un mot-clé déclencheur, d'un exemple complet de prompt et d'un prompt négatif.
Illustration
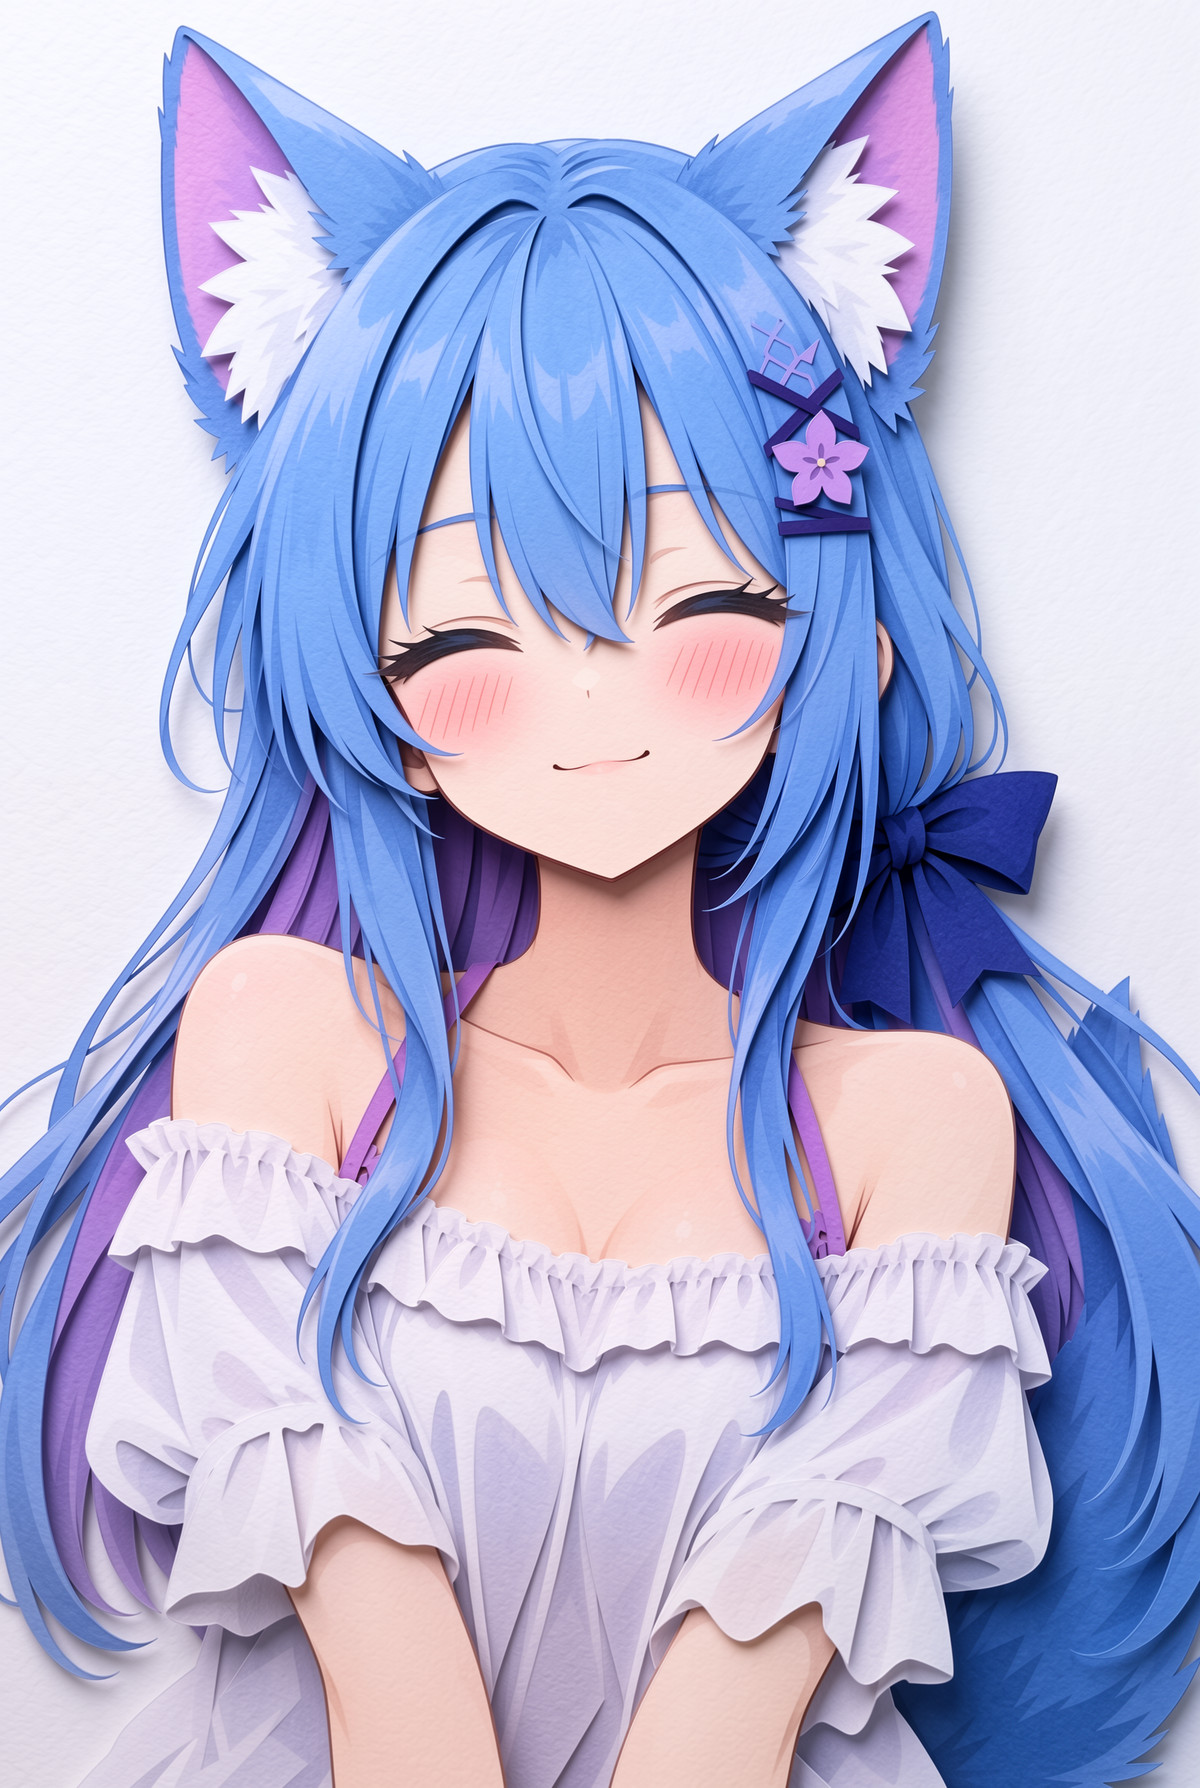
【B】纸雕/纸偶 · v1.0
LoRA · Portage · Auteur YuChuXi · Publié le 11-10 13:54 · Téléchargements 47
Version MOSS du LoRA style papier découpé / marionnettes en papier : transforme l'image en une illustration de papier découpé superposée en couches.
Illustration
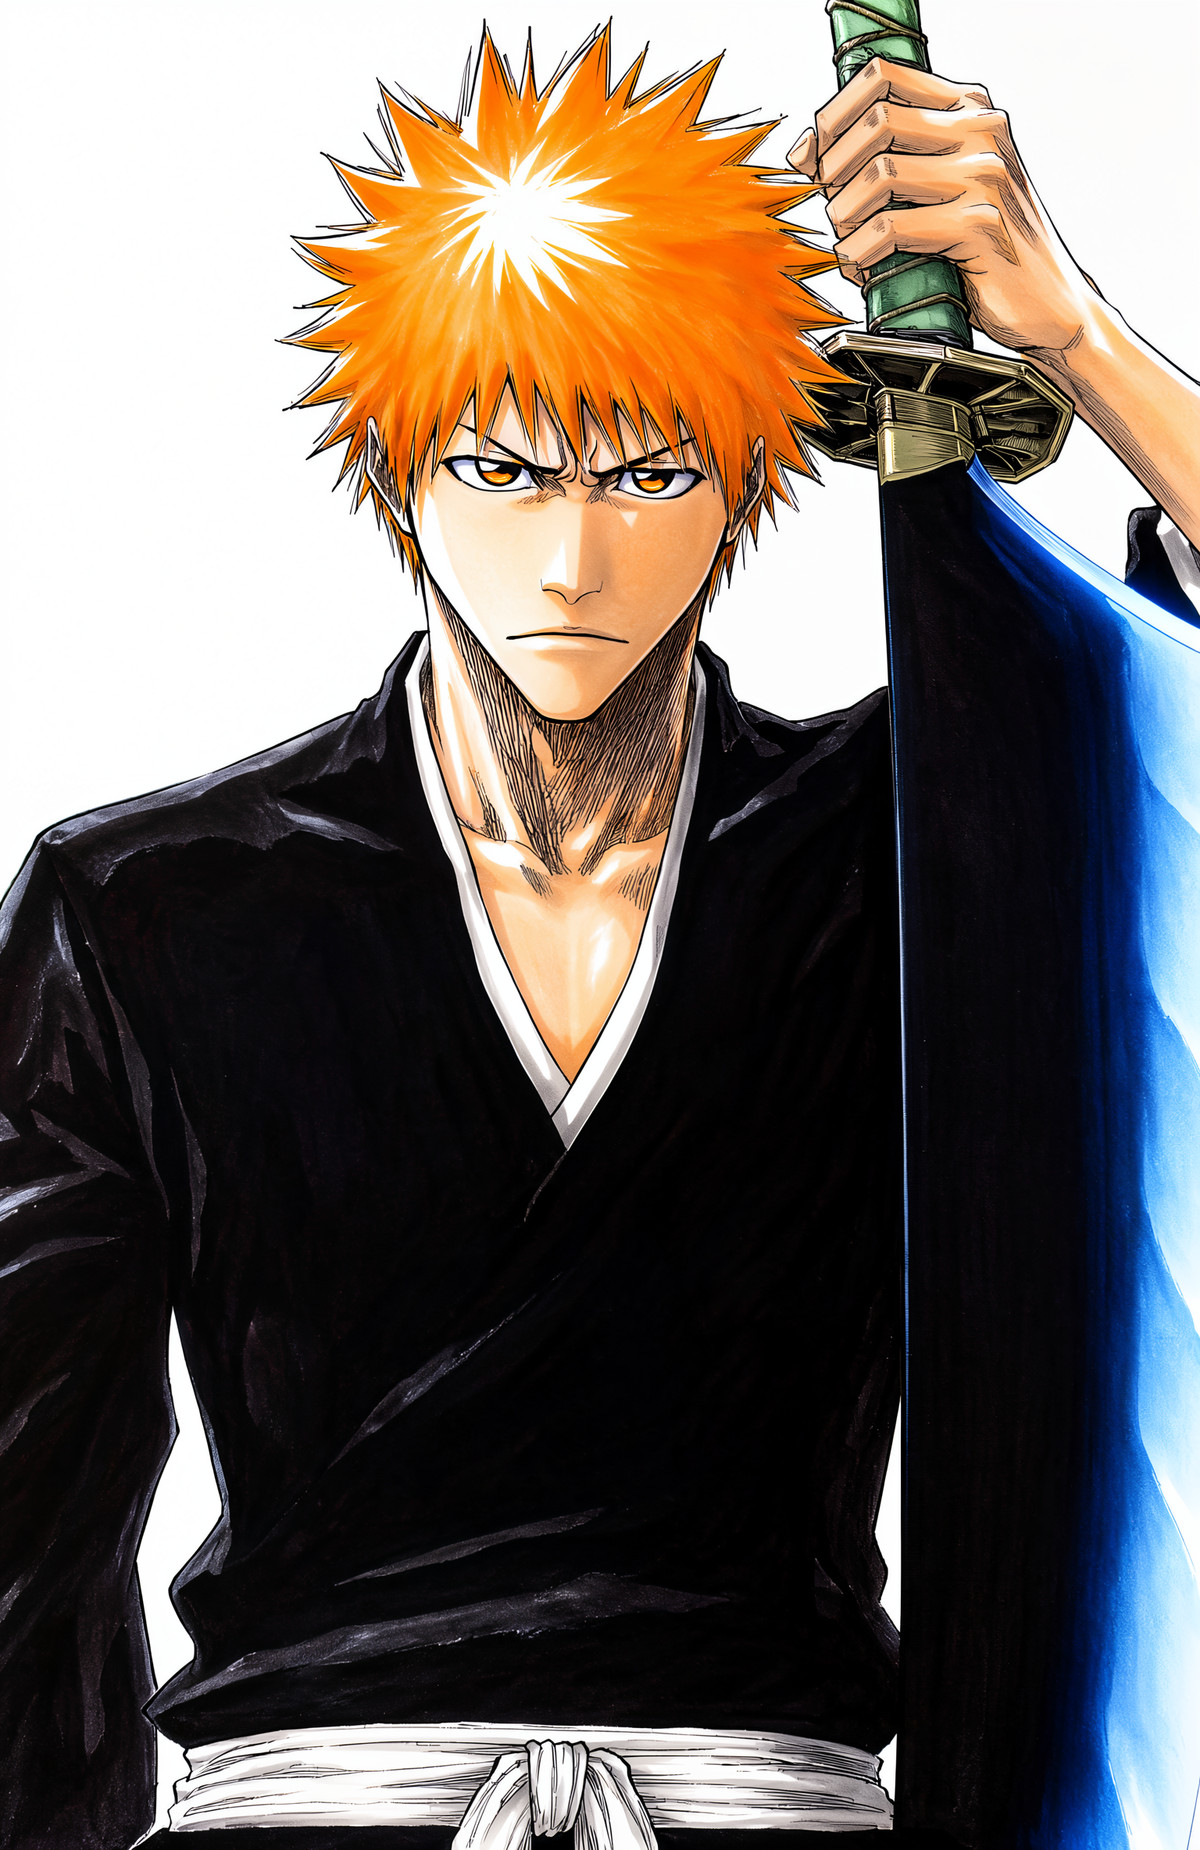
【B】18 in 1,《Bleach》/《死神》,Tite Kubo/久保带人 - Artist Style · MOSS_v1.0
LoRA · Portage · Auteur flyx3 · Publié le 11-10 12:10 · Téléchargements 3 · Payant
Version MOSS du LoRA style de manga de Tite Kubo, auteur de « Bleach » (死神), capable de générer la plupart des personnages de l'œuvre dans le même fichier.
Illustration
Inclus uniquement (14)
- Style MaleBot · Moss v1 — LoRA : version MOSS d'un LoRA de style imitant les couvertures de personnages masculins courants dans les chatbots de personnages (l'auteur mentionne une ressemblance avec le style niji).
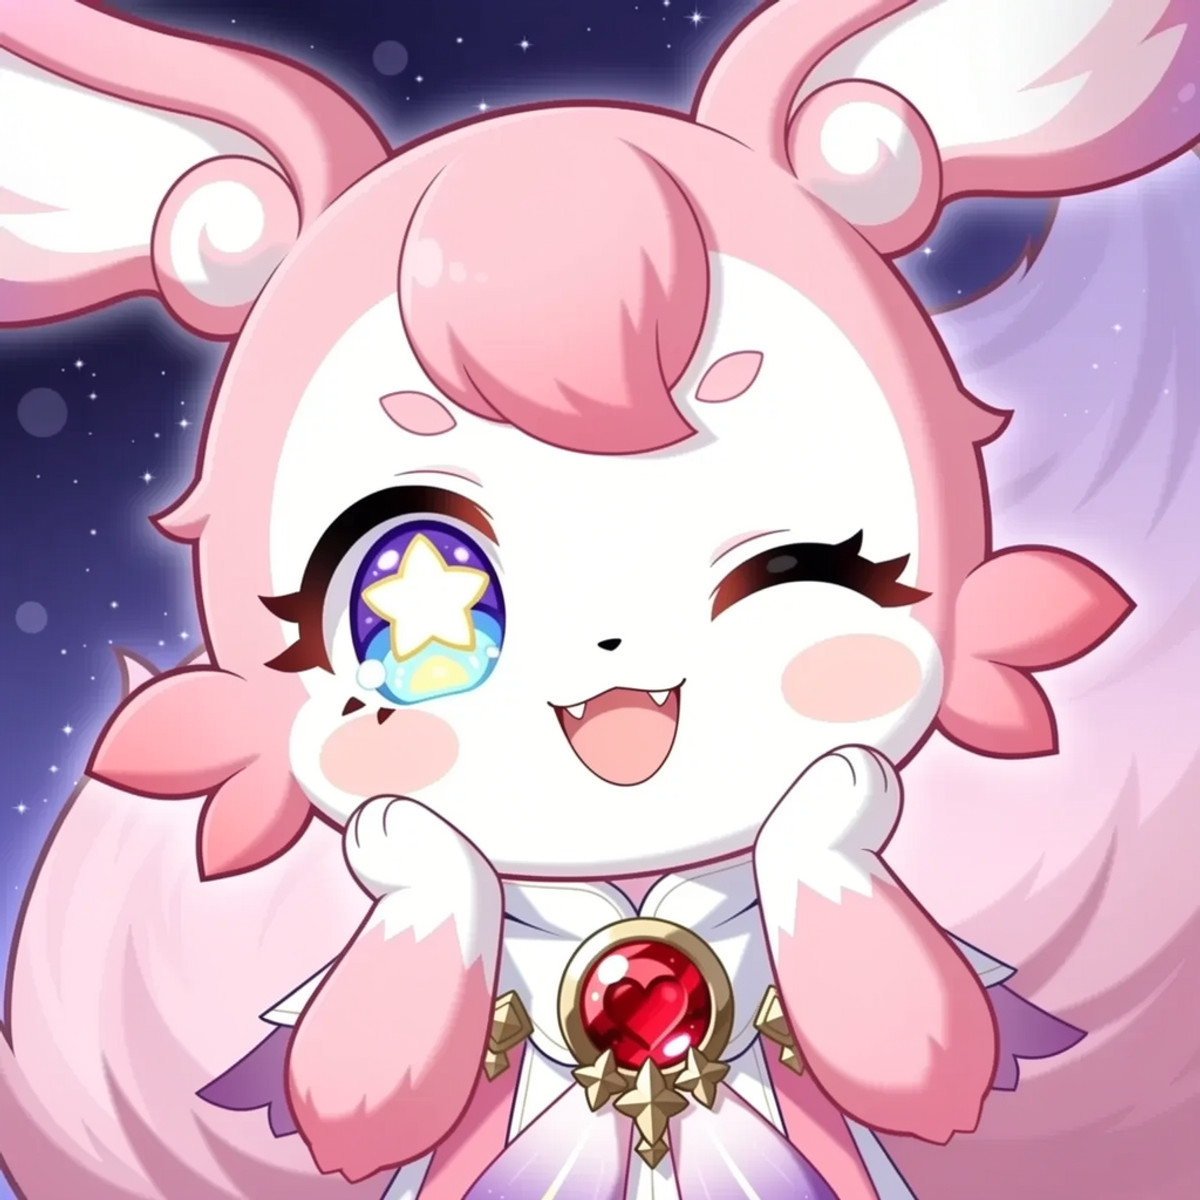
- Mem (Honkai: Star Rail) [Illustrious/pony/moss] · MOSS — LoRA : version MOSS du LoRA de personnage pour « Mem » (une petite créature rose en peluche) du jeu Honkai: Star Rail.
- huashijw/Artiste JW | Style · MOSS(test) — LoRA : version de test MOSS d'un LoRA de style imitant le style de dessin anime féminin mignon de l'artiste « Artiste JW » (huashijw).
- Style Takorin | ILXL & Anima · Moss v0.1 — LoRA : version de test MOSS v0.1 d'un LoRA de style anime de l'artiste Takorin (namako8982).
- Francesca · MossImage — LoRA : version MOSS d'un LoRA de personnage pour Francesca, un personnage fictif de la série MisterMR (avec un concept de « muse » originaire de Toscane).
- xKlara · MOSS Image — LoRA : LoRA de personnage pour xKlara, une femme originale générée par IA (cheveux bruns foncés, traits doux), version MOSS entraînée sur le même ensemble de données que la version Krea 2 sur la même page.
- Echidna - MOSS · Echidna — LoRA : LoRA de personnage pour Echidna du jeu Re:Zero − Starting Life in Another World, l'auteur fournissant une description détaillée de l'apparence et des vêtements, pièce par pièce.
- Frankie NordhavenLove · MossImage — LoRA : LoRA de personnage pour un personnage féminin nordique fictif, utilisé pour générer des images avec un visage cohérent.
- Style jun navigavi · v1.0 — LoRA : LoRA d'illustration anime imitant le style de l'artiste jun navigavi.
- LoRA de style par Ryia | 2 · v1.1 — LoRA : LoRA de style anime entraîné sur les images générées par l'auteur avec NAI v5, cette version étant réentraînée sur Moss-heal.
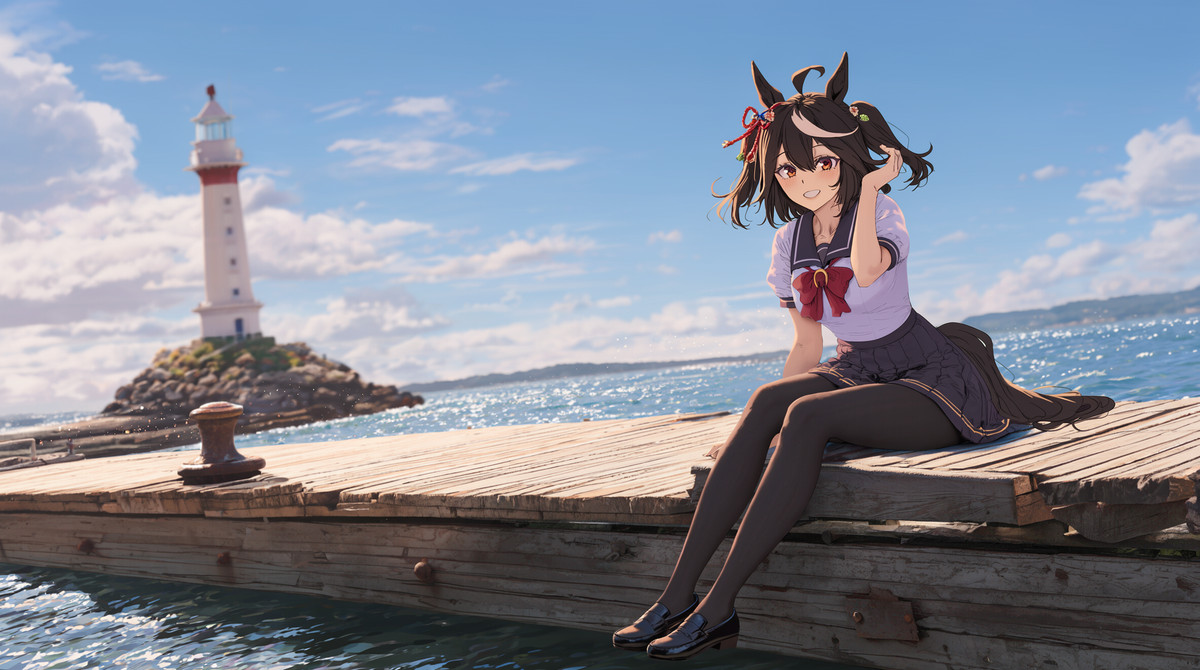
- Liangwu/Ryohka/Suzuya · Runs_1_st9000 — LoRA : LoRA de personnage MOSS-Image-SFT pour le personnage anime « Ryohka / Suzuya », il s'agit de la dernière sauvegarde à l'étape 9000 de la même session d'entraînement ; l'exemple montre une jeune fille aux longs cheveux violets bouclés, aux yeux verts et portant un uniforme marin blanc.
- ૮꒰ ˶• ༝ •˶꒱ა ♡ · v1 — LoRA : LoRA de style que l'auteur décrit comme « animation rétro des années 2000 », avec des exemples d'images carrées.
- Style YD · v1.1 — LoRA : deuxième version d'un LoRA de style nommé YD, la fiche du modèle ne contenant que les mots-clés de déclenchement.
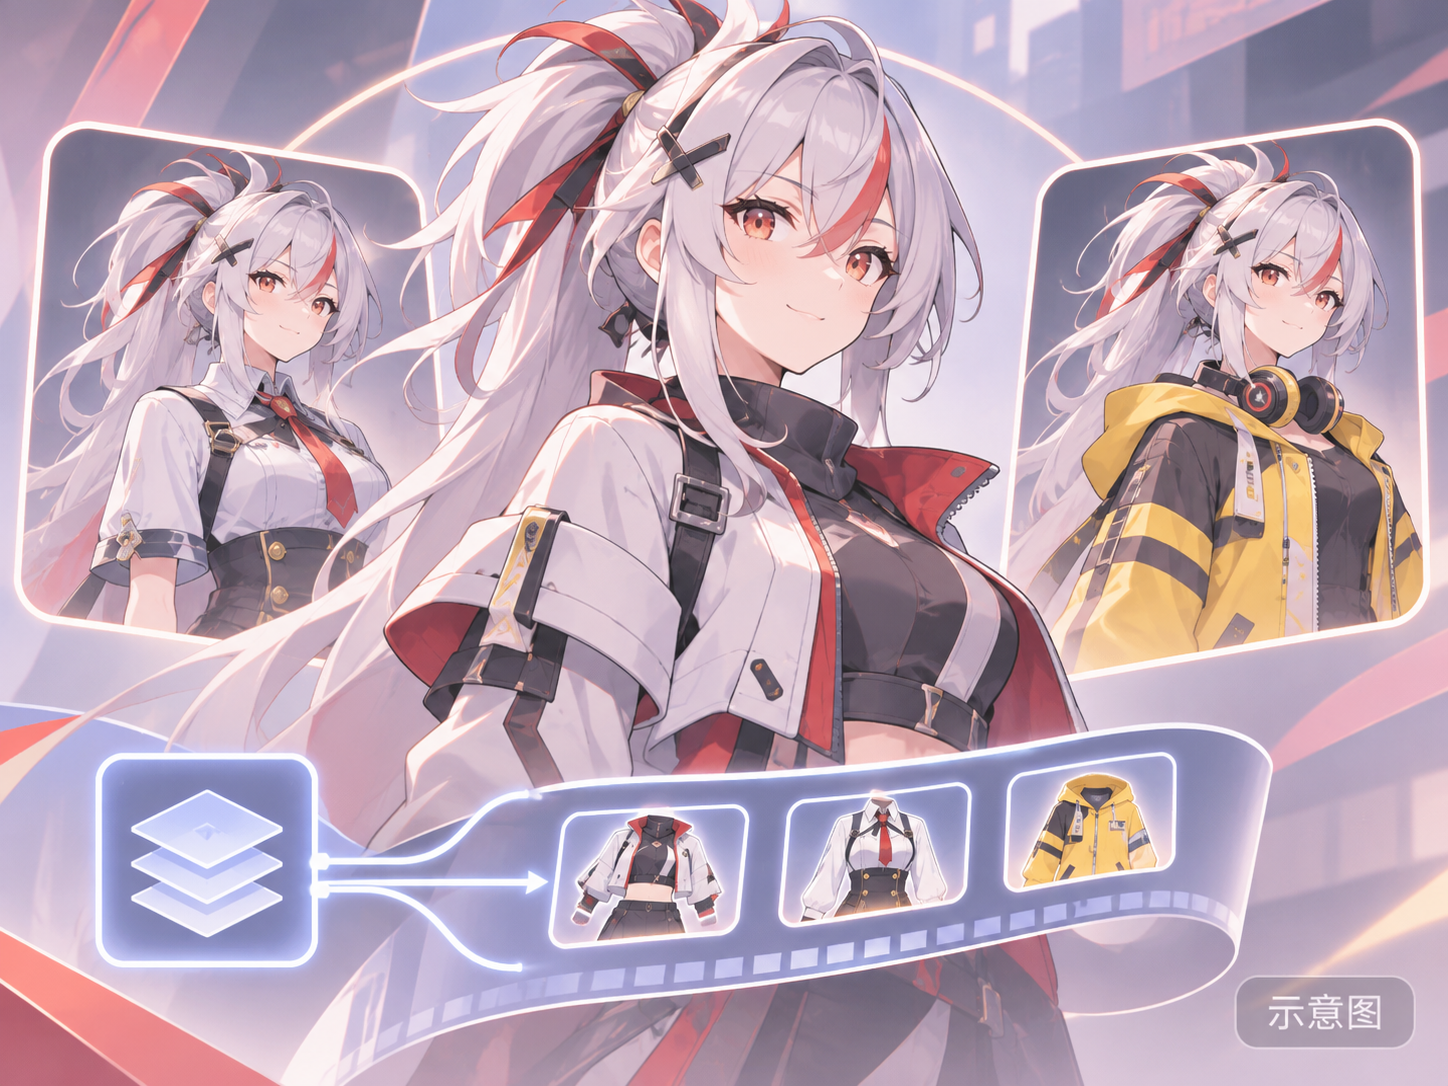
- Phoenix Reffaella フィオニー・レファエラ, Tenues 3 — Zenless Zone Zero ゼンレスゾーンゼロ [Anima+Illustrious+MOSS] · v1.0 MOSS Image — LoRA : version MOSS du LoRA de personnage pour Phoenix, un personnage de la saison 3 de Zenless Zone Zero, un fichier contenant trois tenues.
Données : API publique de Civitai (modèle de base MOSS Image), fenêtre d'inclusion du 11-10 08:31 au 11-10 21:01 (heure de Pékin). Les recommandations ont été vérifiées par la rédaction ; le nombre de téléchargements reflète uniquement le niveau d'attention.