贞贞的AI雷达 · MOSS Image · 2026-11-10 晚报
本期 35 个新版本:强烈推荐 2 · 推荐 9 · 可关注 10 · 仅收录 14
编辑按语 本期审阅 44 个 MOSS 新版本,2 个 S、9 个 A、10 个 B、14 个 C,排除 9 个。首推复古整页广告风格 LoRA Ad Infinitum 的 MOSS 版:把画面做成老式商品卡、海报和杂志广告,能按引号写出年代感标题,触发词、强度、步数、CFG 和排字写法都给全了;同列 S 的是 thedeoxen 的姿势控制 LoRA,喂 DWPose 骨架图让新人物摆出同样姿势,同作者的 Canny、线稿、涂鸦、深度、法线、分割控制 LoRA 列 A。另有 FGO 走廊场景背景、动画截图风 v2、手机随手拍写实照片等列 A;多个只有一两句说明的人物 / 画风 LoRA 和付费抢先体验的角色 LoRA 列 C。凉屋角色 LoRA 的 8 个中间步数快照只保留最终 st9000 版,Ceiling Fisheye Cam 的 Krea2 版是误标成 MOSS 的 Krea 2 权重,均已排除。
强烈推荐(2)
【S】Ad Infinitum - Krea 2 · Classic - MOSS
LoRA · 移植 · 作者 AriaMaiven · 发布 11-10 10:48 · 下载 50
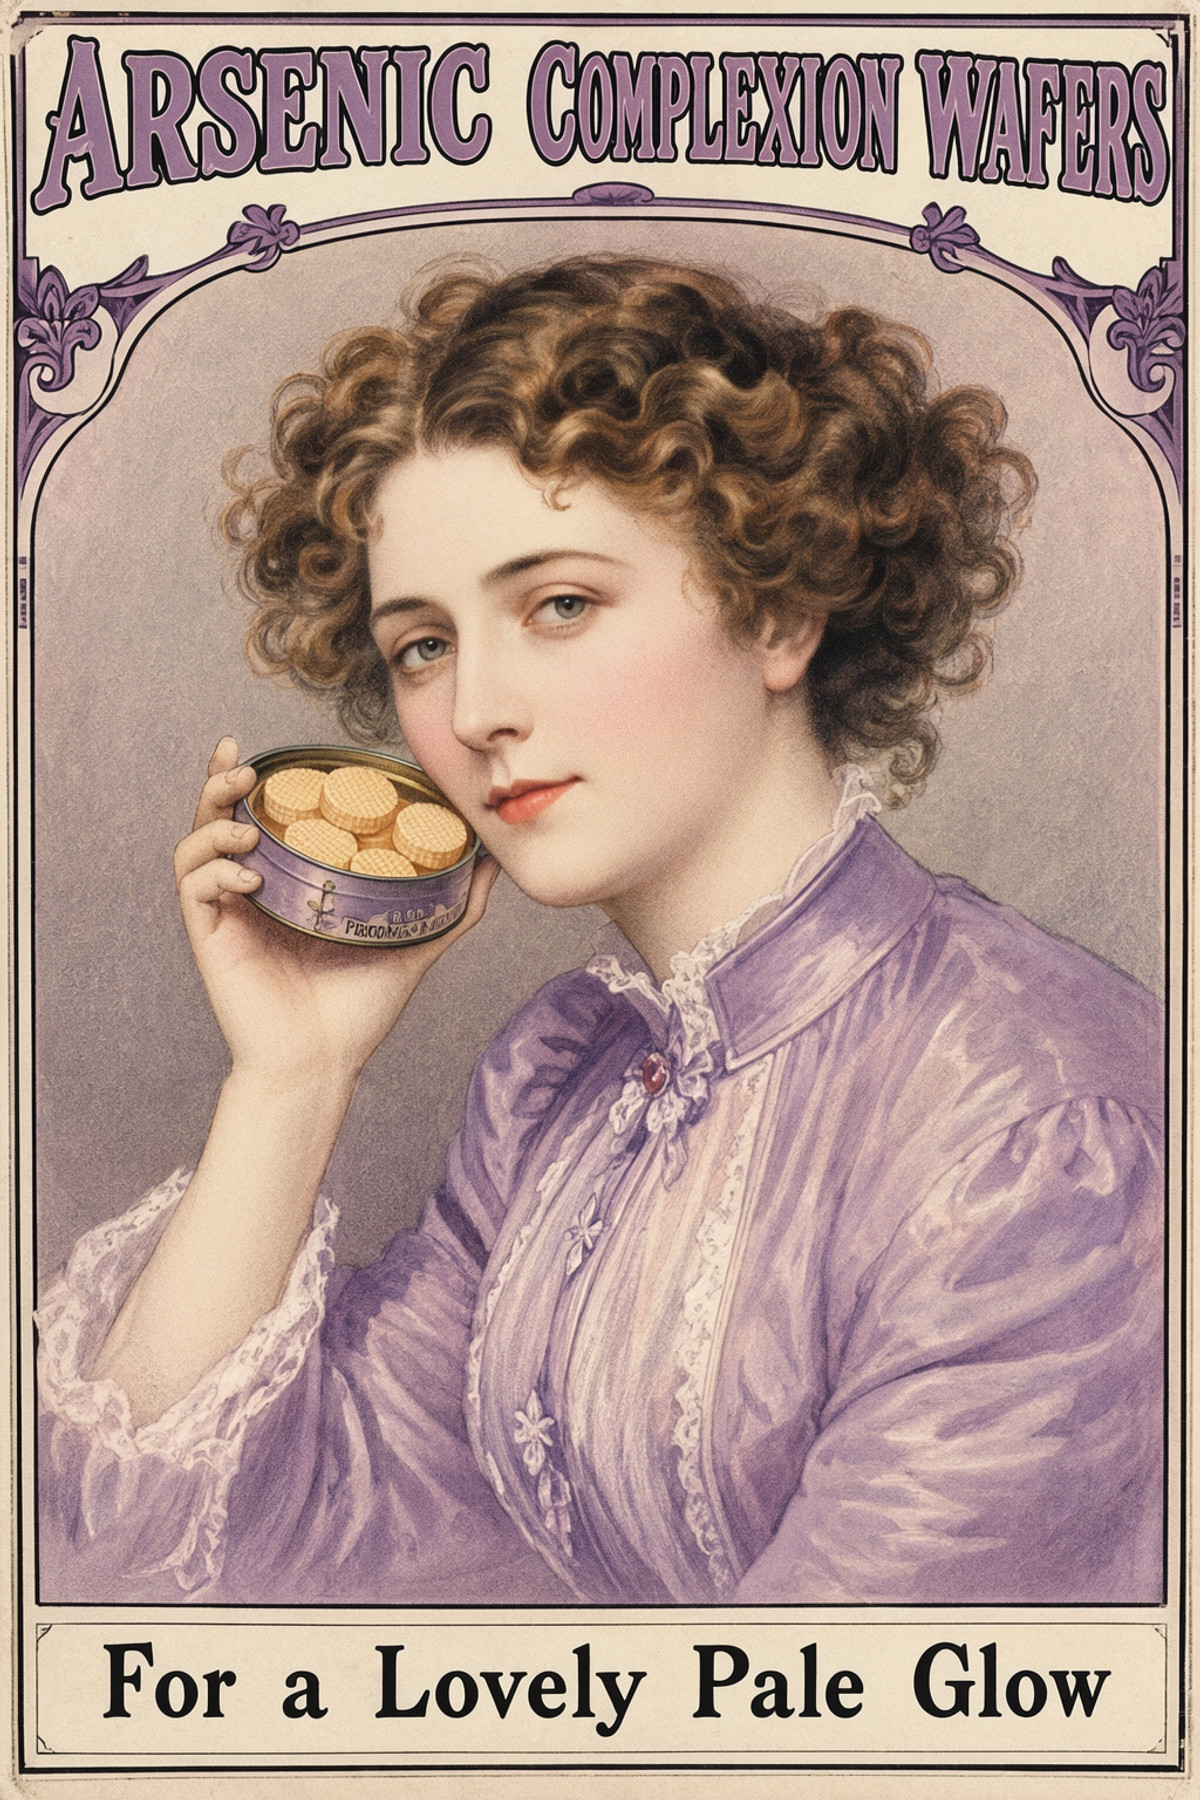
复古广告页风格 LoRA 的 MOSS 版(Classic):把画面做成 1885–1948 年商品卡、海报和杂志广告那种点彩上色、墨线勾边、奶油色纸面的整页广告,并能按提示词写出老式大写标题。
本组首推:方向独特(整页老广告而不只是复古滤镜),触发词、强度、步数、CFG、尺寸和排字写法都给全了,照做门槛低。
配图
推荐理由
- 移植:同页已有 Krea 2 的 Classic 和 Future Vintage 两版,模型页累计 303 次下载;MOSS 版在 MOSS Base 上训练,用的是同一套 46 张公有领域商品卡 / 海报 / 杂志广告(已去掉原有文字),触发词沿用 adnclsk
- 服务复古海报、老广告、品牌恶搞和编辑配图类文生图;作者给了排字写法:提示词结尾把每句文字放进引号并写明位置,MOSS 会用年代感的大写字体写出来
- 参数齐:强度 0.7 到 1.0;MOSS Image (SFT),30 步,CFG 3,euler / simple,1024 x 1536;作者称不加 LoRA 时 MOSS 只会画成现代数字插画
- 作者称图库每张图都带提示词和参数;免费,许可允许出图和站内出租;发布约 10 小时 50 次下载
怎么用
- 提示词第一个词写 adnclsk,再写广告的主体和画面;强度 0.7 到 1.0,标题较长时用 0.7 更干净
- 要文字就在结尾写:The only words on the page are the headline "…" at the top …, and the line "…" on a cream panel at the bottom,每句放引号并写明位置和颜色
- MOSS Image (SFT),30 步,CFG 3,euler / simple,1024 x 1536;即使打算后期自己排字,也要在提示词里给出标题和底栏,否则火车、风景类画面会漂成油画
- 不要再写 poster、lithograph、vintage 或年代词,作者称 LoRA 已经自带年代感
风险与限制
- 可见示例 5 张,另 4 张被分级隐藏;没有加 / 不加 LoRA 的同种子对照
- 训练集只有 46 张;Krea 2 版附带的 ComfyUI 工作流压缩包 MOSS 版没有,要自己搭
- 许可要求署名;作者声明转载或用它的出图训练其他模型须先获许可
- 本条未运行
触发词:adnclsk
【S】MOSS-Image Pose Control · v1.0
LoRA · 新模型 · 作者 thedeoxen · 发布 11-10 16:20 · 下载 29
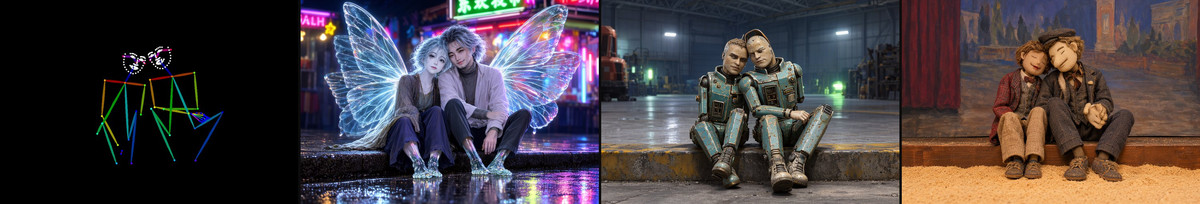
MOSS-Image-SFT 的姿势控制 LoRA:喂一张黑底彩色 DWPose 骨架图,生成的人物按骨架摆出同样的身体、手和脸部姿势,长相、服装和场景全由提示词决定。
同作者同日发了七个控制 LoRA,训练方式和采样参数一样,差别只在吃什么控制图;姿势这条能力最独立、工作流最完整,作为本组代表。
配图
推荐理由
- 新能力:给 MOSS-Image-SFT 补上按骨架控姿势的能力;作者说明它是 ControlNet 式的编辑 LoRA,不是官方的 color/depth 拼接适配器,用普通 LoRA 加载器加载、把骨架图当唯一参考图送进 Text Encode MOSS-Image Edit 即可
- 服务换装换人、把照片里的姿势转给另一个角色、分镜和关键帧里要求身体动作一致的场景;与同作者 Canny / Lineart 这类轮廓控制不同,它只锁关节位置,不锁衣服轮廓和背景
- 作者给的骨架提取方式:comfyui_controlnet_aux 的 DWPose,身体、手、脸三项都打开;黑底彩色骨骼与训练用的控制图一致
- 参数和工作流齐:附 ComfyUI 工作流 JSON(读照片→出骨架→编码→采样),选用第 4500 步存档,强度 1.0,30 步,CFG 4,euler + simple,无触发词
- 示例 3 张,每张是“骨架 + 三个不同提示词”的拼图,可直接看同一姿势换三种人物;发布 5 小时 29 次下载、3 赞,是这组控制 LoRA 里关注度最高的一个;免费,许可允许出图和售卖
怎么用
- 底模用 MOSS-Image-SFT:UNet moss_image_sft_int8_convrot、文本编码器 qwen3.5_9b_w4a8_gptq(类型选 moss_image)、VAE flux2-vae_small;LoRA 挂在 UNet 上,强度 1.0
- 用 DWPose(身体 + 手 + 脸)从参考照片提骨架,黑底彩色骨骼图作为唯一参考图接入 Text Encode MOSS-Image Edit;正负两个编码节点的 edit format 都设 ai-toolkit
- 30 步,CFG 4,euler + simple;无触发词,提示词写人物身份、服装、材质和场景,不必逐个描述关节
风险与限制
- 4 个敏感级示例被隐藏,比可见的 3 张还多
- 骨架里缺失的肢体,作者称提示词无法可靠补出对应关节;手指等细部能跟到什么程度作者未说
- 只针对 MOSS-Image-SFT(作者用的是 int8 量化 UNet)训练;配 MOSS-Image-Base 或其他精度的表现作者未说;作者把基模标成 Other
- 完整模型卡里作者建议控制太僵时把强度往 0.7 降,训练值是 1.0
- 示例图没有附生成参数;本条未运行
推荐(9)
【A】Anime Screencap Style · v2.0
LoRA · 版本更新 · 作者 kanakiy · 发布 11-10 09:48 · 下载 57
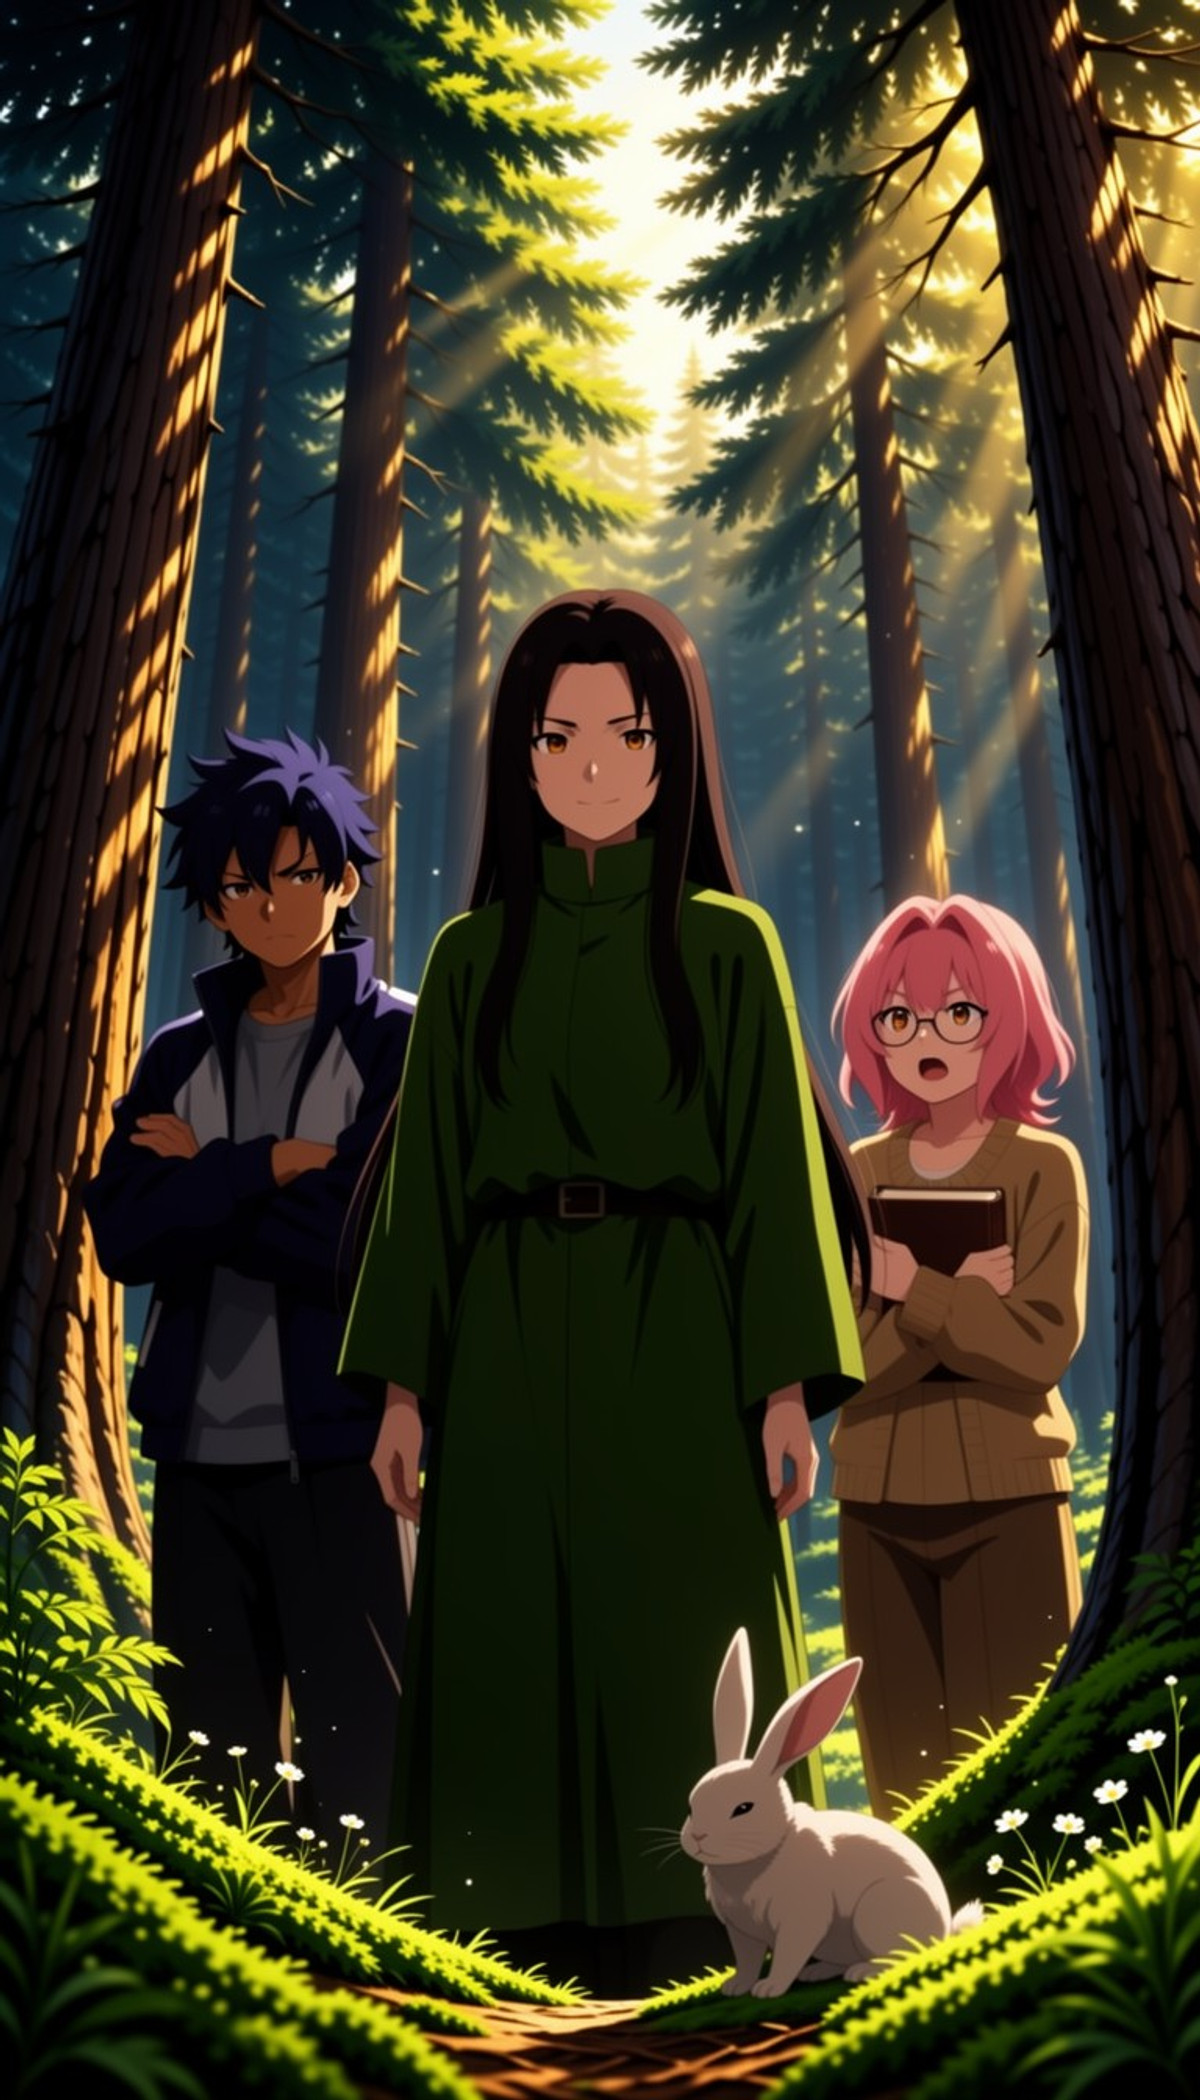
现代动画截图风格 LoRA 的 v2.0:平涂赛璐珞、几乎不带柔和阴影、粗而干净的线条、高饱和色彩和宽银幕式构图。
保持自动 A:风格目标描述得具体、示例多,但 v2 缺强度和采样参数。
配图
推荐理由
- 版本更新:作者称 v2.0 改进了训练数据,去掉了 v1.0 数据里的纲手和绫濑星子(Seiko Ayase)两个角色(仍可用名字主动调出);v1.0 因为这两个角色建议强度 0.6–0.8
- 服务想要“动画截图感”而非常见柔和渐变二次元的文生图,作者称比多数动漫模型更平、更硬朗
- 17 张示例;免费;发布约 11 小时 57 次下载
怎么用
- 加载 LoRA 即可,无触发词;v1.0 建议强度 0.6–0.8,v2.0 强度作者未给,可从同一区间起试;步数、CFG 作者未给
风险与限制
- 作者未写更新说明(版本说明为空,改动来自模型卡两句话);v1 和 v2 没有对照
- 许可不含出图商用,只允许出租;3 张示例被分级隐藏
- 本条未运行
【A】Realistic Photo by Amateur Snapshot · MOSS
LoRA · 新模型 · 作者 858654128784 · 发布 11-10 18:02 · 下载 73
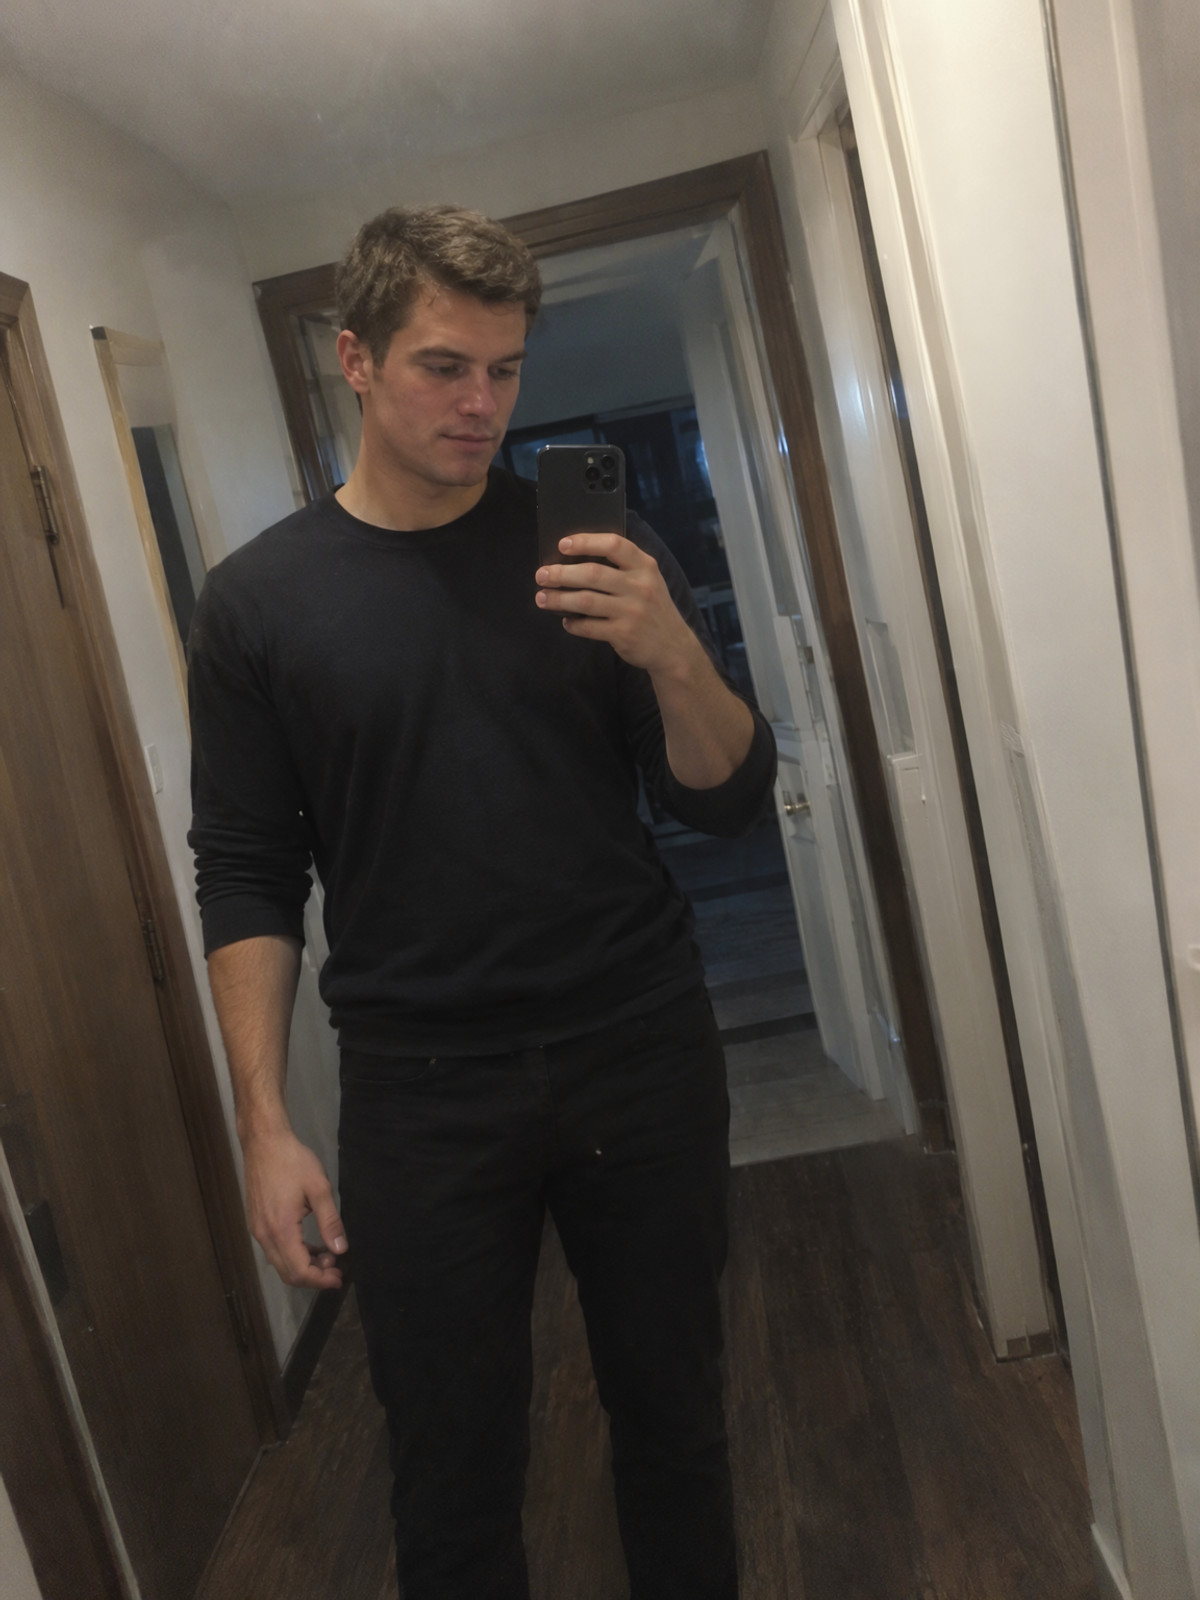
手机随手拍风格的写实照片 LoRA:对镜自拍、前置自拍、厨房桌面、电梯里、俯拍宠物,歪斜构图、光线不均、暗部颗粒和真实皮肤纹理,去掉 AI 图那种过于干净的影棚感。
保持自动 A:用途明确、提示词写法可直接照做,缺强度和采样参数,可见示例偏少。
配图
推荐理由
- 新模型:只有 MOSS 版,目标是“普通人用手机拍的照片”而不是精修写实
- 作者给了提示词写法:以 amateur smartphone photo 开头,写明地点、谁拿着手机、光从哪里来;加“手机挡住半张脸”“前景里被裁掉一半的马克杯”这类细节更像
- 免费,许可允许出图、出租和售卖;发布约 3 小时 73 次下载,是本组下载最快的一条
怎么用
- 提示词以 amateur smartphone photo 开头,写地点、持机人和光源,再加遮挡、前景裁切等随手拍细节;无触发词
- 强度、步数、CFG 作者未给
风险与限制
- 15 张示例被分级隐藏,可见只有 5 张;页面为混合内容
- 没有参数,也没有加 / 不加 LoRA 的对照;训练数据来源作者未说明
- 生成以假乱真的人物生活照,发布时注意标注 AI 生成;本条未运行
【A】Chaldea Corridor: Fate/Grand Order · MOSS-sft01
LoRA · 新模型 · 作者 RHU_AIstudio · 发布 11-10 19:59 · 下载 10
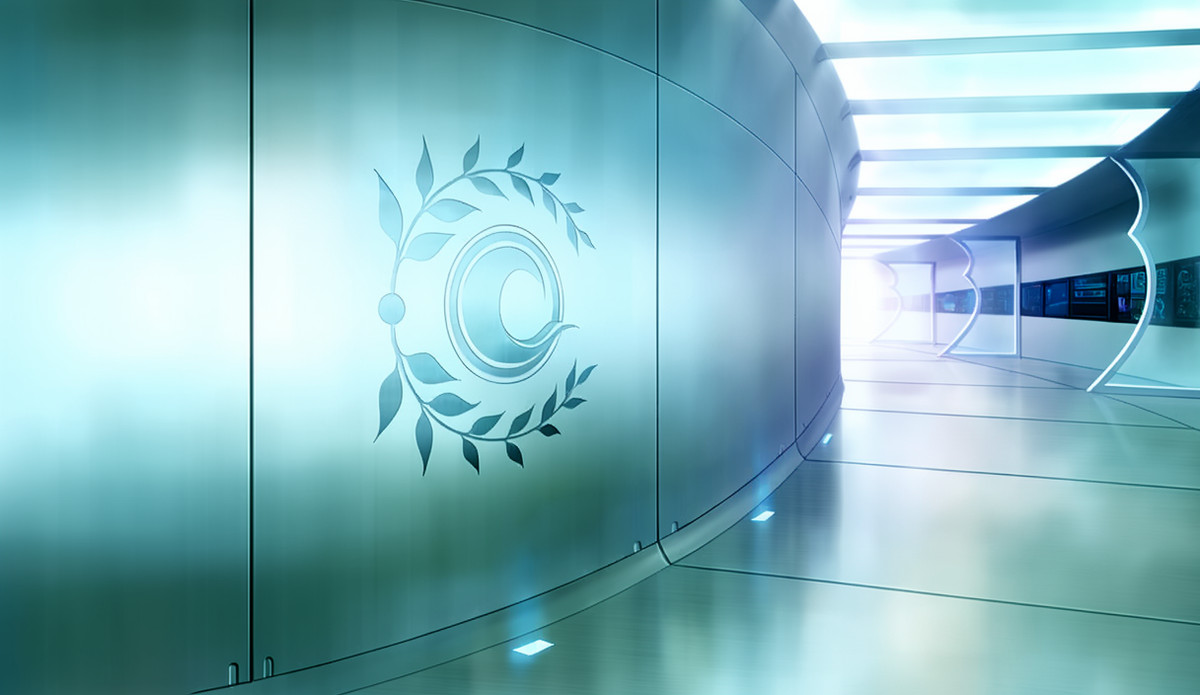
《Fate/Grand Order》旧迦勒底走廊的场景背景 LoRA:用一个触发词固定这条走廊,再用状态词切换正常、昏暗、破损、冰冻等样子。
保持自动 A:场景 LoRA 的用法写得最清楚的一条,触发词、强度和状态词可直接照抄,但只覆盖一个地点、缺采样参数。
配图
推荐理由
- 新模型,而且是本期少见的场景 / 背景类 LoRA:不管人物,专门复现一个固定地点,服务同人插画、角色立绘配背景、视觉小说式场景图
- 作者说明了训练来源:7 张游戏内背景素材,覆盖正常 / 昏暗 / 模糊 / 破损 / 冰冻几种状态和两个机位
- 触发词、强度和状态词都给了:corridor_(chaldea)_(fate),强度 1.0;bright lighting、dark, dim lighting、damaged, cracked wall, debris、frozen, ice, flooded,close-up 对应带纹章墙面的那个机位
- 3 张可见示例,1 张被隐藏;免费,许可宽松,允许出图、售卖和衍生
怎么用
- 提示词写 corridor_(chaldea)_(fate),按需要加状态词:bright lighting / dark, dim lighting / damaged, cracked wall, debris / frozen, ice, flooded;要纹章墙面那个角度加 close-up;LoRA 强度 1.0
- 步数、CFG、采样器作者未给;版本名是 MOSS-sft01,作者没写明是在 Base 还是 SFT 上训练
风险与限制
- 训练集只有 7 张图,能出的基本就是这条走廊的这几种状态和两个机位,换别的视角能否保持结构未知
- 素材来自游戏的版权背景图,许可虽宽松,商用前仍要考虑原作版权
- 模型卡只有一段话,没有加人物时的写法和叠用说明;本条未运行
触发词:corridor_(chaldea)_(fate)
【A】MOSS-Image Scribble Control · v1.0
LoRA · 新模型 · 作者 thedeoxen · 发布 11-10 16:53 · 下载 23
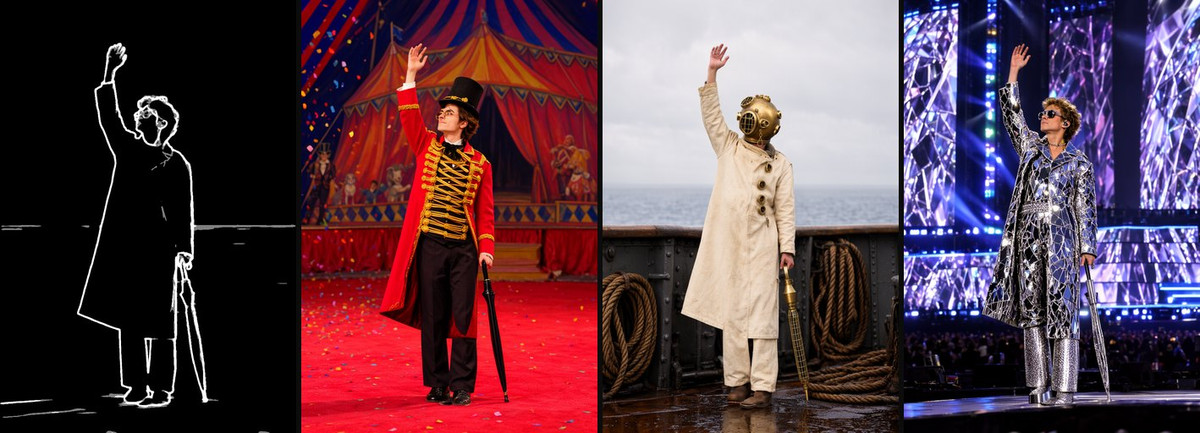
MOSS-Image-SFT 的涂鸦控制 LoRA:喂黑底上几笔粗软的白色笔画,只跟大的笔势和体块,细节、质感和风格由提示词自由发挥。
配图
推荐理由
- 新能力:同作者控制系列里最松的一档,只管主要笔画和大块形体,不追每条细边;作者建议把它用在 Canny / Lineart 精修之前做快速构图测试
- 服务草图起稿、分镜笔画、在照片上只保留大形再重画:输入可以是手绘几笔,也可以是从照片提取的软边
- 预处理:工作流用 HED Soft-Edge Lines 并开 safe mode;训练用的涂鸦比 Canny 和线稿更粗更软,作者称 HED 软边比细的 PiDiNet 草图更接近训练图
- 附 ComfyUI 工作流;第 5000 步存档,强度 1.0,30 步,CFG 4,euler + simple;3 张拼图示例
- 免费,许可允许出图和售卖;发布 4 小时 23 次下载
怎么用
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small),LoRA 挂 UNet,强度 1.0
- HED Soft-Edge Lines(safe mode)或手绘几笔黑底白色粗线,作为唯一参考图接 Text Encode MOSS-Image Edit,正负编码 edit format 都设 ai-toolkit
- 30 步,CFG 4,euler + simple;无触发词;作者建议少而肯定的笔画胜过杂乱的边缘图,质感、颜色和小细节留给提示词
风险与限制
- 控制松,细部位置不会被锁住,需要精确轮廓的场景应换 Canny 或 Lineart
- 只针对 MOSS-Image-SFT 训练;基模标为 Other;1 个敏感级示例被隐藏
- 完整模型卡建议控制太僵时把强度往 0.7 降
- 本条未运行
【A】MOSS-Image Normal Control · v1.0
LoRA · 新模型 · 作者 thedeoxen · 发布 11-10 16:51 · 下载 24
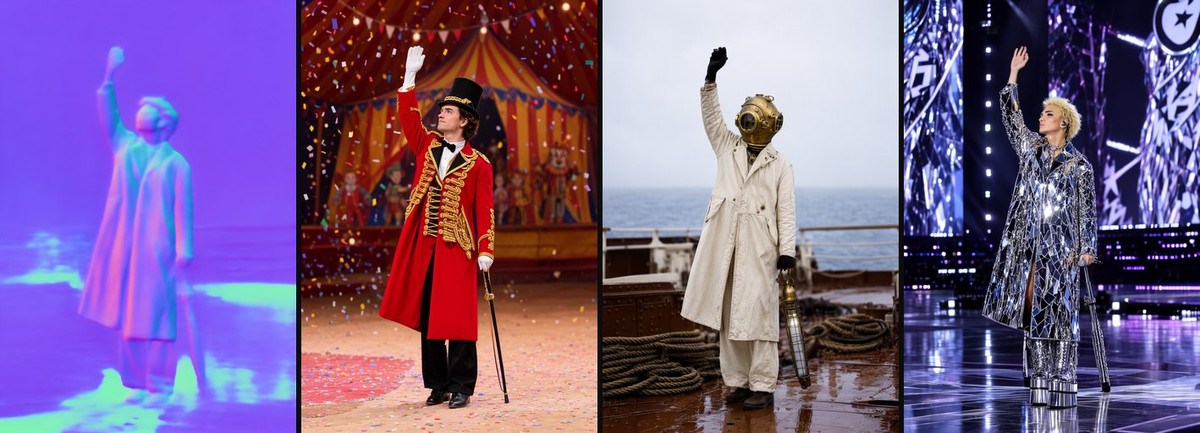
MOSS-Image-SFT 的法线控制 LoRA:喂一张彩色法线图,保住物体的体积和表面朝向,只换材质和场景。
配图
推荐理由
- 新能力:比深度图多管一层“表面朝哪个方向”,体积和朝向不动而材质可换;作者列的用途是给固定形体换材质 / 重新打光、产品图里物体体积固定的场景
- 服务产品图换材质、雕塑或道具重贴图、深度对了但还要控制表面朝向的场景;输入是照片或三维渲染导出的法线
- 预处理:工作流用 BAE Normal Map,训练图是常见的紫 / 青 / 绿相机空间法线;作者提醒要用相机空间法线,不能用灰度高度图,法线越平滑体积越干净、噪点多会长出多余的凸起
- 附 ComfyUI 工作流;第 5000 步存档,强度 1.0,30 步,CFG 4,euler + simple;3 张拼图示例与 Canny / Lineart 版同一测试照
- 免费,许可允许出图和售卖
怎么用
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small),LoRA 挂 UNet,强度 1.0
- BAE Normal Map 出彩色相机空间法线图,作为唯一参考图接 Text Encode MOSS-Image Edit,正负编码 edit format 都设 ai-toolkit
- 30 步,CFG 4,euler + simple;无触发词,提示词写材质和场景
风险与限制
- 用途比 Canny / Depth 窄,主要在换材质、换光的场合才比深度控制多出价值
- 三维软件导出的法线是否与 BAE 的颜色约定一致需自行确认,作者未说明;只针对 MOSS-Image-SFT 训练;基模标为 Other;1 个敏感级示例被隐藏
- 完整模型卡建议控制太僵时把强度往 0.7 降
- 本条未运行
【A】MOSS-Image Segmentation Control · v1.0
LoRA · 新模型 · 作者 thedeoxen · 发布 11-10 16:54 · 下载 25
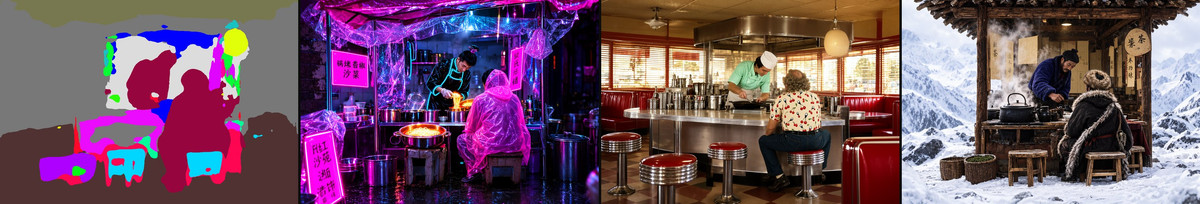
MOSS-Image-SFT 的语义分割控制 LoRA:喂一张平涂色块的区域图,保住各区域的边界和大块布局,每块变成什么由提示词决定。
配图
推荐理由
- 新能力:按“区域块”而不是线条或纵深来控制,适合先把画面分好人、家具、背景几大块,再整体换渲染风格;作者称边界和大块体量会保留
- 服务场景分块构图、色彩脚本式布局、保留人物与家具位置重绘整张图
- 预处理:工作流用 UniFormer 语义分割;训练图是铺满的平涂色块,没有大片黑色未标注区;作者提醒色块颜色只是区域编号,不会变成成图里的颜色,材质要写进提示词,渐变和纹理会打乱区域
- 附 ComfyUI 工作流;第 4500 步存档,强度 1.0,30 步,CFG 4,euler + simple
- 免费,许可允许出图和售卖;发布 4 小时 25 次下载
怎么用
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small),LoRA 挂 UNet,强度 1.0
- UniFormer 出铺满画面的平涂区域图(不要留大片黑底),作为唯一参考图接 Text Encode MOSS-Image Edit,正负编码 edit format 都设 ai-toolkit
- 30 步,CFG 4,euler + simple;无触发词,提示词里写清每个区域的主体和材质
风险与限制
- 作者称会把背景留成黑色的分割器与这份权重不太匹配,换别的分割模型要注意
- 可见示例 2 张,1 个敏感级示例被隐藏;只针对 MOSS-Image-SFT 训练;基模标为 Other
- 完整模型卡建议控制太僵时把强度往 0.7 降
- 本条未运行
【A】MOSS-Image Lineart Control · v1.0
LoRA · 新模型 · 作者 thedeoxen · 发布 11-10 16:37 · 下载 21
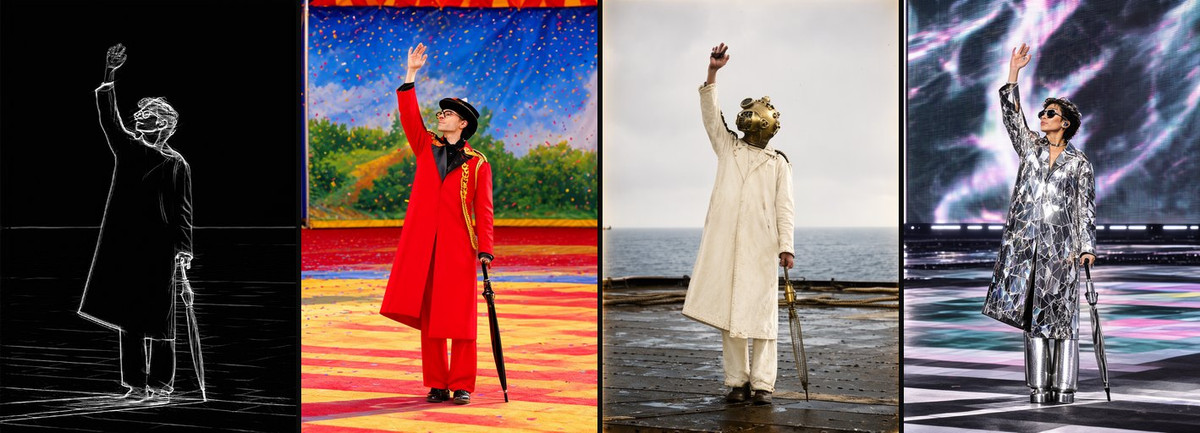
MOSS-Image-SFT 的线稿控制 LoRA:喂黑底白色细线稿,按线条结构生成,上色、材质和风格由提示词决定。
配图
推荐理由
- 新能力:介于 Canny 和 Scribble 之间——跟随干净的轮廓线,但不带原始 Canny 图里的碎点噪声;作者列的用途首先是给线稿上色
- 服务线稿上色、设计草图出成图、照片保留线条结构后换场景;手绘线稿和从照片提取的线稿作者称都能用,前提是线要轻、要稀
- 预处理有讲究:工作流用 Realistic Lineart 并打开 coarse,作者称这比精细线稿模式更接近训练图;白线黑底,若手头是黑线白底的线稿需先反相
- 附 ComfyUI 工作流;第 5000 步存档,强度 1.0,30 步,CFG 4,euler + simple;3 张拼图示例与 Canny 版同一测试照
- 免费,许可允许出图和售卖
怎么用
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small),LoRA 挂 UNet,强度 1.0
- Realistic Lineart(coarse 打开)出黑底白线图,作为唯一参考图接 Text Encode MOSS-Image Edit,正负编码 edit format 都设 ai-toolkit
- 30 步,CFG 4,euler + simple;无触发词,提示词写颜色、材质和画风
风险与限制
- 作者称稀疏线条比密集素描更贴合训练,线稿过密时的表现未说明
- 只针对 MOSS-Image-SFT 训练;基模标为 Other;1 个敏感级示例被隐藏;本组下载最少(21 次)
- 完整模型卡建议控制太僵时把强度往 0.7 降
- 本条未运行
【A】MOSS-Image Canny Control · v1.0
LoRA · 新模型 · 作者 thedeoxen · 发布 11-10 16:29 · 下载 23
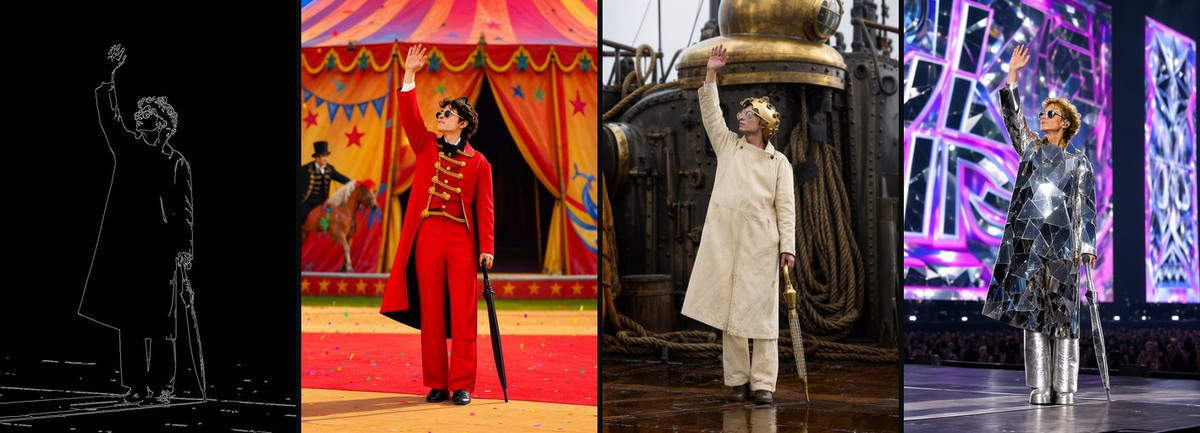
MOSS-Image-SFT 的 Canny 边缘控制 LoRA:喂黑底白线的 Canny 边缘图,锁住物体轮廓、构图和细边,材质、配色和风格交给提示词。
配图
推荐理由
- 新能力:同作者控制 LoRA 系列里约束最紧的一个,连细碎边缘都会跟;作者把它定位为“保留轮廓、换颜色和材质”,适合轮廓必须不动的版式研究
- 服务照片转风格、同构图换材质重绘、版式草案:输入是一张照片或已有画面,先提 Canny 再生成
- 预处理写得具体:comfyui_controlnet_aux 的 Canny Edge,阈值 low 100 / high 200;作者提示若结果死扣每个噪点,就把阈值调高让边缘更干净
- 附 ComfyUI 工作流;第 4500 步存档,强度 1.0,30 步,CFG 4,euler + simple;3 张“控制图 + 三个提示词”拼图示例,与同作者 Normal / Scribble / Lineart 用的是同一张马戏团长测试照,可横向比较
- 免费,许可允许出图和售卖;发布 4 小时 23 次下载
怎么用
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq 文本编码器,类型 moss_image + flux2-vae_small),LoRA 挂 UNet,强度 1.0
- Canny Edge 预处理(low 100 / high 200)出黑底白线图,作为唯一参考图接 Text Encode MOSS-Image Edit,正负编码 edit format 都设 ai-toolkit
- 30 步,CFG 4,euler + simple;无触发词,提示词写新的材质、配色和场景
风险与限制
- Canny 图越密,画面越被原图细节绑住,留给提示词改造的空间越小;想只保大形应换 Scribble 或 Lineart 那两条
- 只针对 MOSS-Image-SFT 训练,其他底模 / 精度作者未说;基模标为 Other;1 个敏感级示例被隐藏
- 完整模型卡建议控制太僵时把强度往 0.7 降
- 本条未运行
【A】MOSS-Image Depth Control · v1.0
LoRA · 新模型 · 作者 thedeoxen · 发布 11-10 16:25 · 下载 22
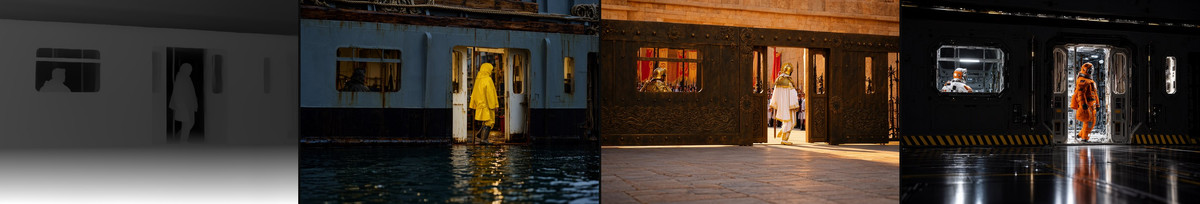
MOSS-Image-SFT 的深度控制 LoRA:喂一张近白远黑的灰度深度图,保持前后景距离和空间布局,主体和风格交给提示词。
配图
推荐理由
- 新能力:只锁“谁近谁远”和机位纵深,不锁每条边,作者称适合“镜头纵深比轮廓更重要”的场合;注意它不是官方的 MOSS color/depth 拼接适配器,而是同作者的编辑式 LoRA
- 服务同机位换风格重建场景、前景主体与背景分离后换材质、产品和室内这类有明确近景主体的版面
- 预处理:工作流用 Depth Anything V2(depth_anything_v2_vitl),近处白、背景落到黑;作者特别提醒不要用反相的深度图,否则会和 LoRA 打架
- 附 ComfyUI 工作流;第 5000 步存档,强度 1.0,30 步,CFG 4,euler + simple;作者称大块平坦的深度区域给提示词留出更多纹理空间
- 免费,许可允许出图和售卖;3 赞
怎么用
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small),LoRA 挂 UNet,强度 1.0
- Depth Anything V2 vitl 出灰度深度图(近白远黑,勿反相),作为唯一参考图接 Text Encode MOSS-Image Edit,正负编码 edit format 都设 ai-toolkit
- 30 步,CFG 4,euler + simple;无触发词,提示词写主体、材质和风格
风险与限制
- 可见示例只有 1 张拼图,另有 4 个敏感级示例被隐藏,是这组里公开证据最少的
- 与官方 depth 拼接适配器相比孰优孰劣作者未说;只针对 MOSS-Image-SFT 训练;基模标为 Other
- 完整模型卡建议控制太僵时把强度往 0.7 降
- 本条未运行
可关注(10)
【B】AG: Naberius - Grumpy Niji Boys · MOSS-Image
LoRA · 移植 · 作者 Azriaelis · 发布 11-10 09:10 · 下载 27
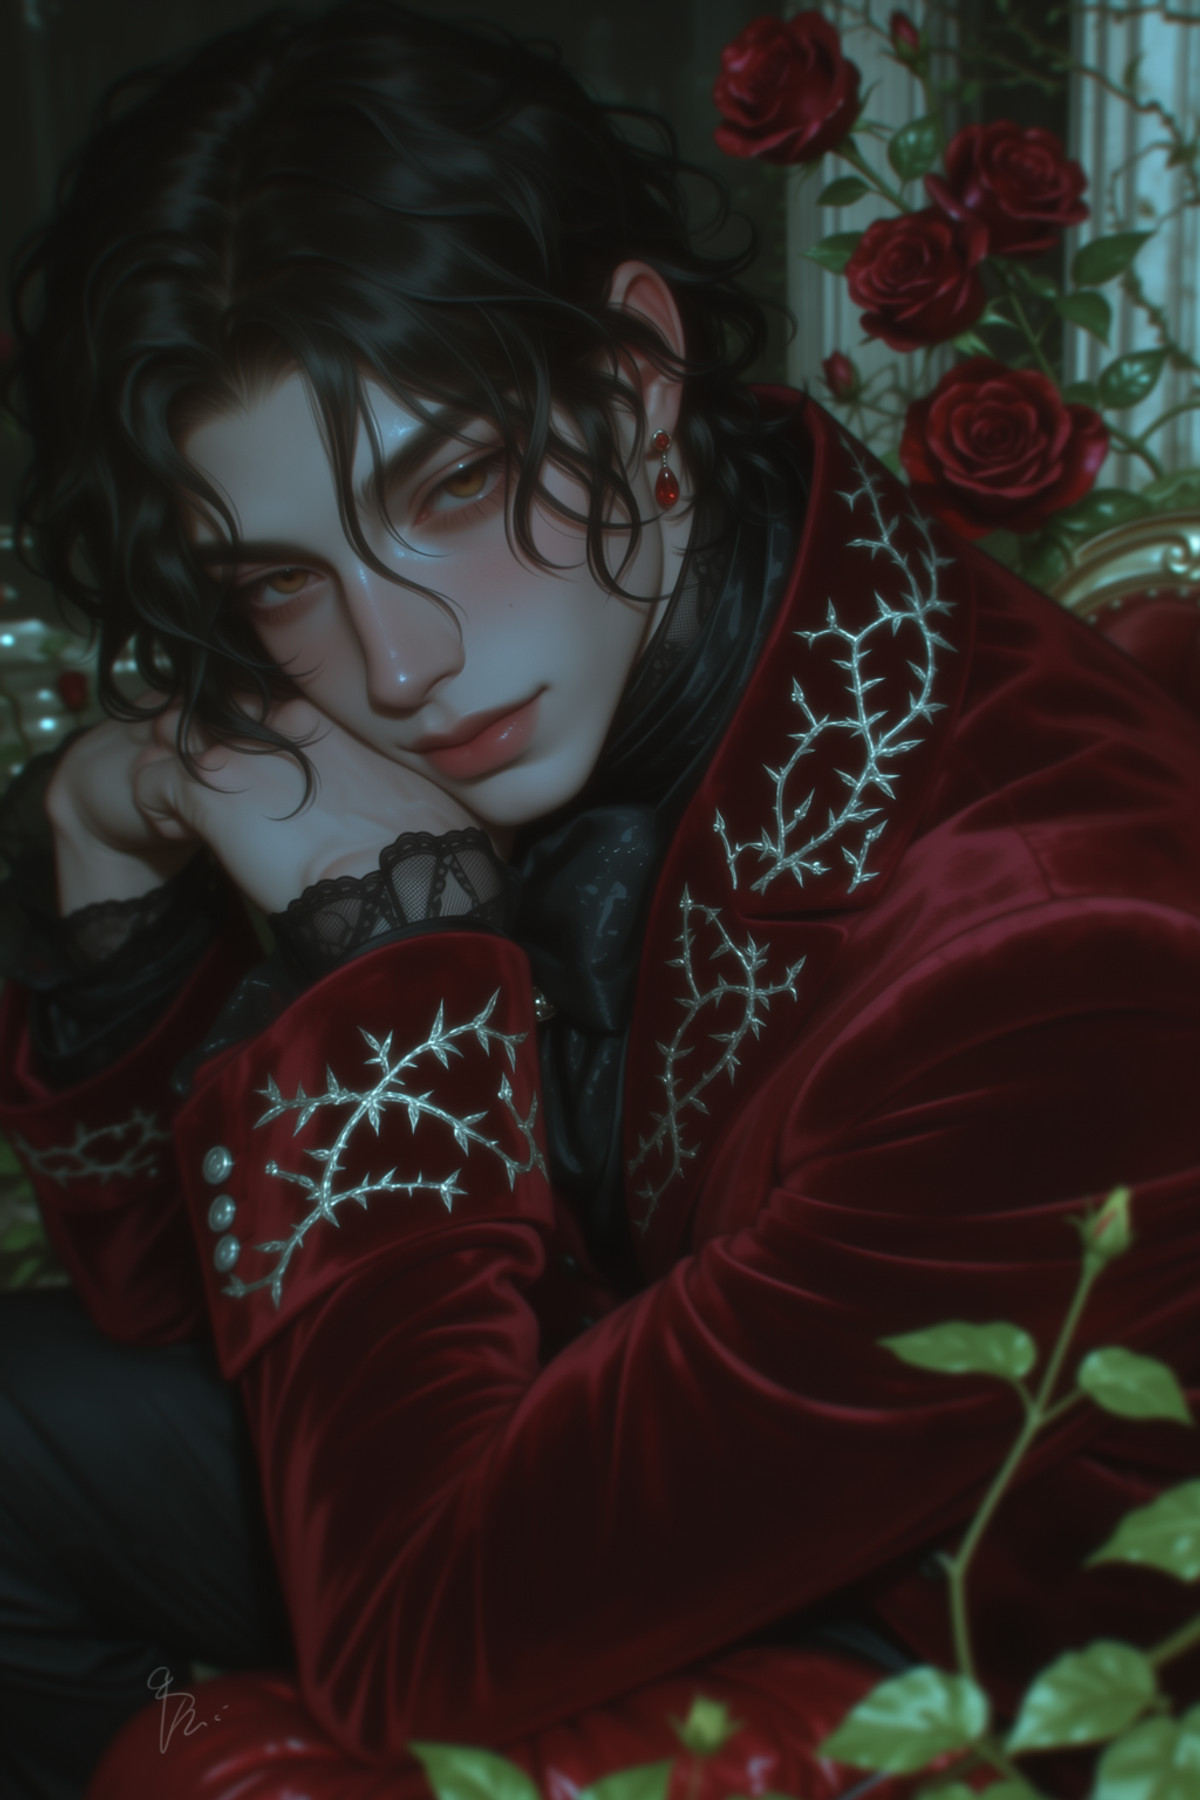
“Ars Goetia”系列里 Naberius 这一条的 MOSS 版:偏 Niji 半写实、男性角色为主的画风 LoRA(标题叫 Grumpy Niji Boys)。
配图
【B】HaDeS MOSS Suite Workflows · Turbo Image to Image v0.1
工作流 · 版本更新 · 作者 _HaDeS_ · 发布 11-10 17:33 · 下载 24
HaDeS MOSS Suite 工作流合集的新一条:带提示词增强节点和 HaDeS 加速 LoRA 的 MOSS 图生图 ComfyUI 工作流(JSON,不是新权重)。
配图
【B】V67 Twins and Mirror · V1 MOSS
LoRA · 移植 · 作者 angelomaiota · 发布 11-10 17:57 · 下载 23
双胞胎与镜像 LoRA 的 MOSS 版:生成同卵 / 异卵双胞胎、镜中倒影、水洼倒影这类“一个人两个身体”或对称构图的画面。
配图
【B】One obsession_MOSS · SFT v1
底模 / Checkpoint · 版本更新 · 作者 maxfeifei8 · 发布 11-10 19:20 · 下载 9 · 付费
MOSS 底模微调 One obsession 的第二个版本 SFT v1:整套底模权重(INT8 和 BF16 两种),按名称是 SFT 系列,前一版是 BASE v1。
配图
【B】V67 Italian Villages · V1 MOSS
LoRA · 移植 · 作者 angelomaiota · 发布 11-10 15:11 · 下载 21
意大利小镇风光 LoRA 的 MOSS 版:石屋、窄巷、陶土屋顶、山顶俯瞰和金色光线,作者称融合了卡纳莱托式风景画和写实建筑摄影。
配图
【B】Chenbin(鬼针草)Style | MOSS Image LoRA · v1.0
LoRA · 新模型 · 作者 NO83 · 发布 11-10 20:46 · 下载 7
仿画师“鬼针草”画风的 MOSS 专用 LoRA:作者称丝袜质感表现很好,头发丝一般。
配图
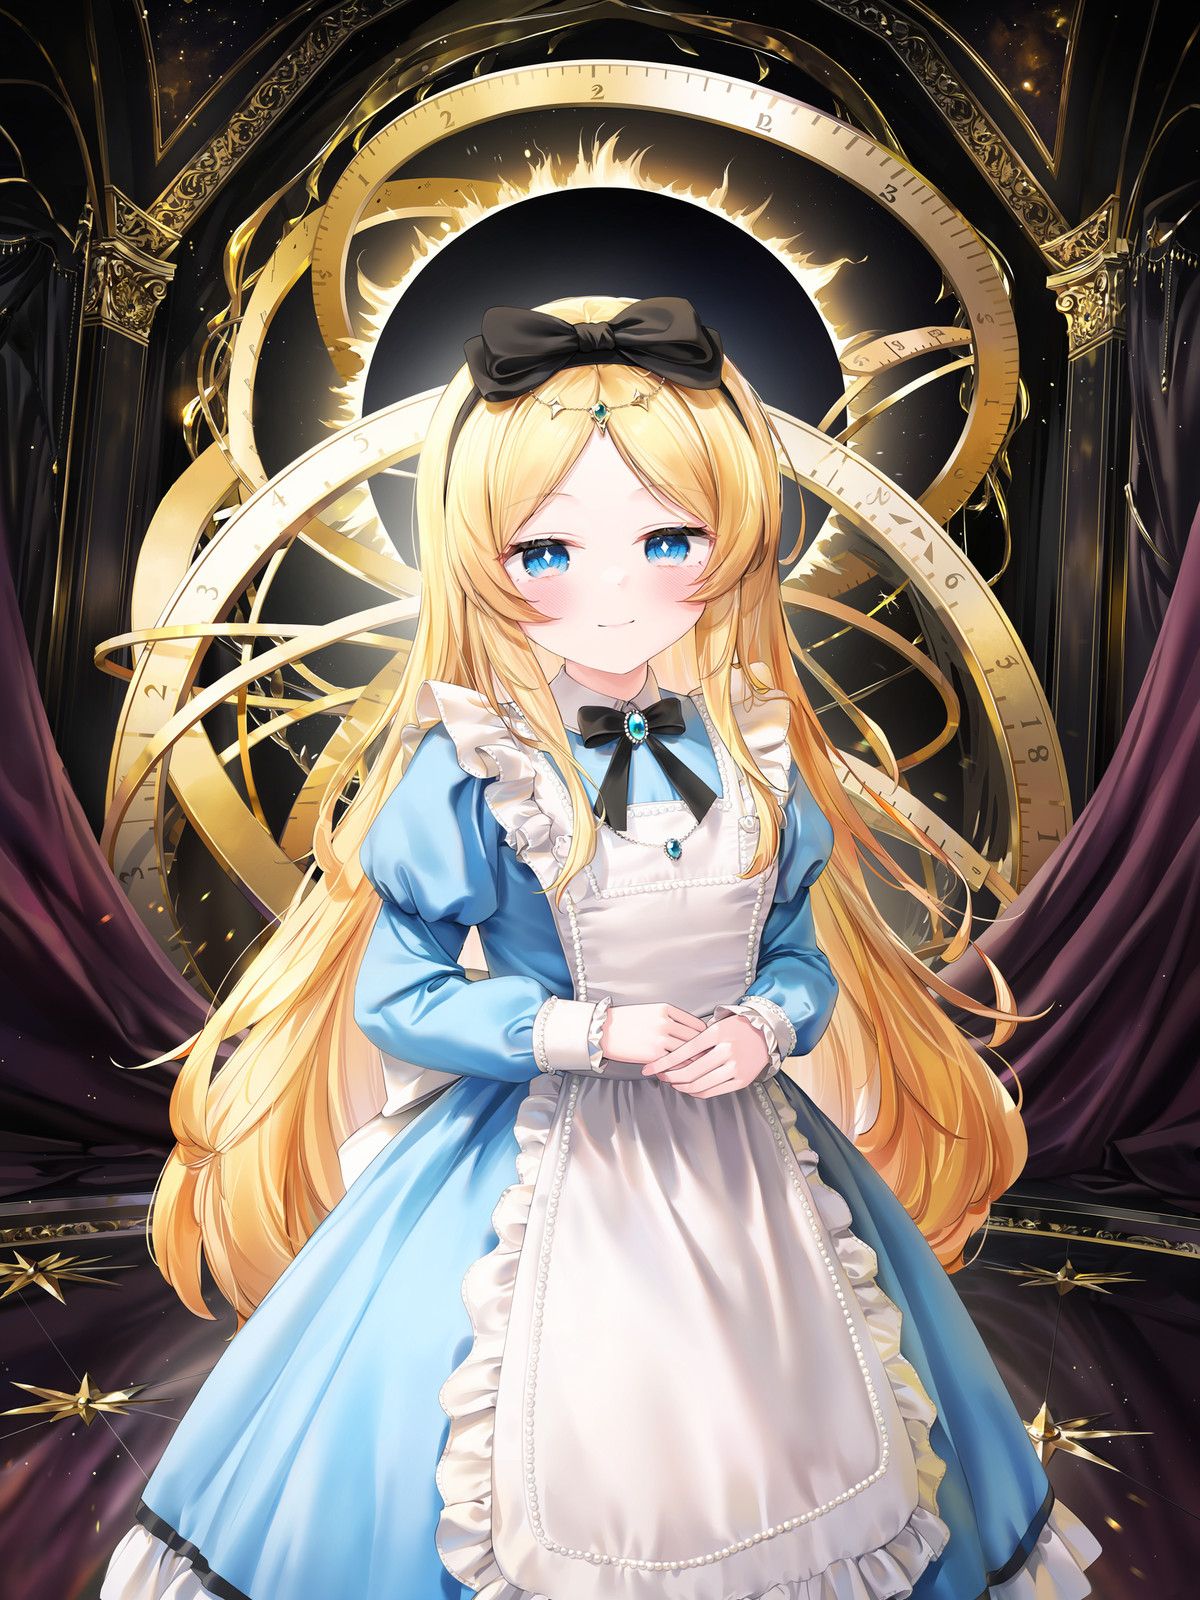
【B】Kromoss slider: blurry to sharp · v1
LoRA · 新模型 · 作者 Generated_Good · 发布 11-10 18:27 · 下载 61
清晰度滑杆 LoRA:在 Kromoss(MOSS-Image-Base 的全量微调)上训练,用正负强度调节前景和背景的虚化程度,针对 Kromoss 常出糊图的问题。
配图
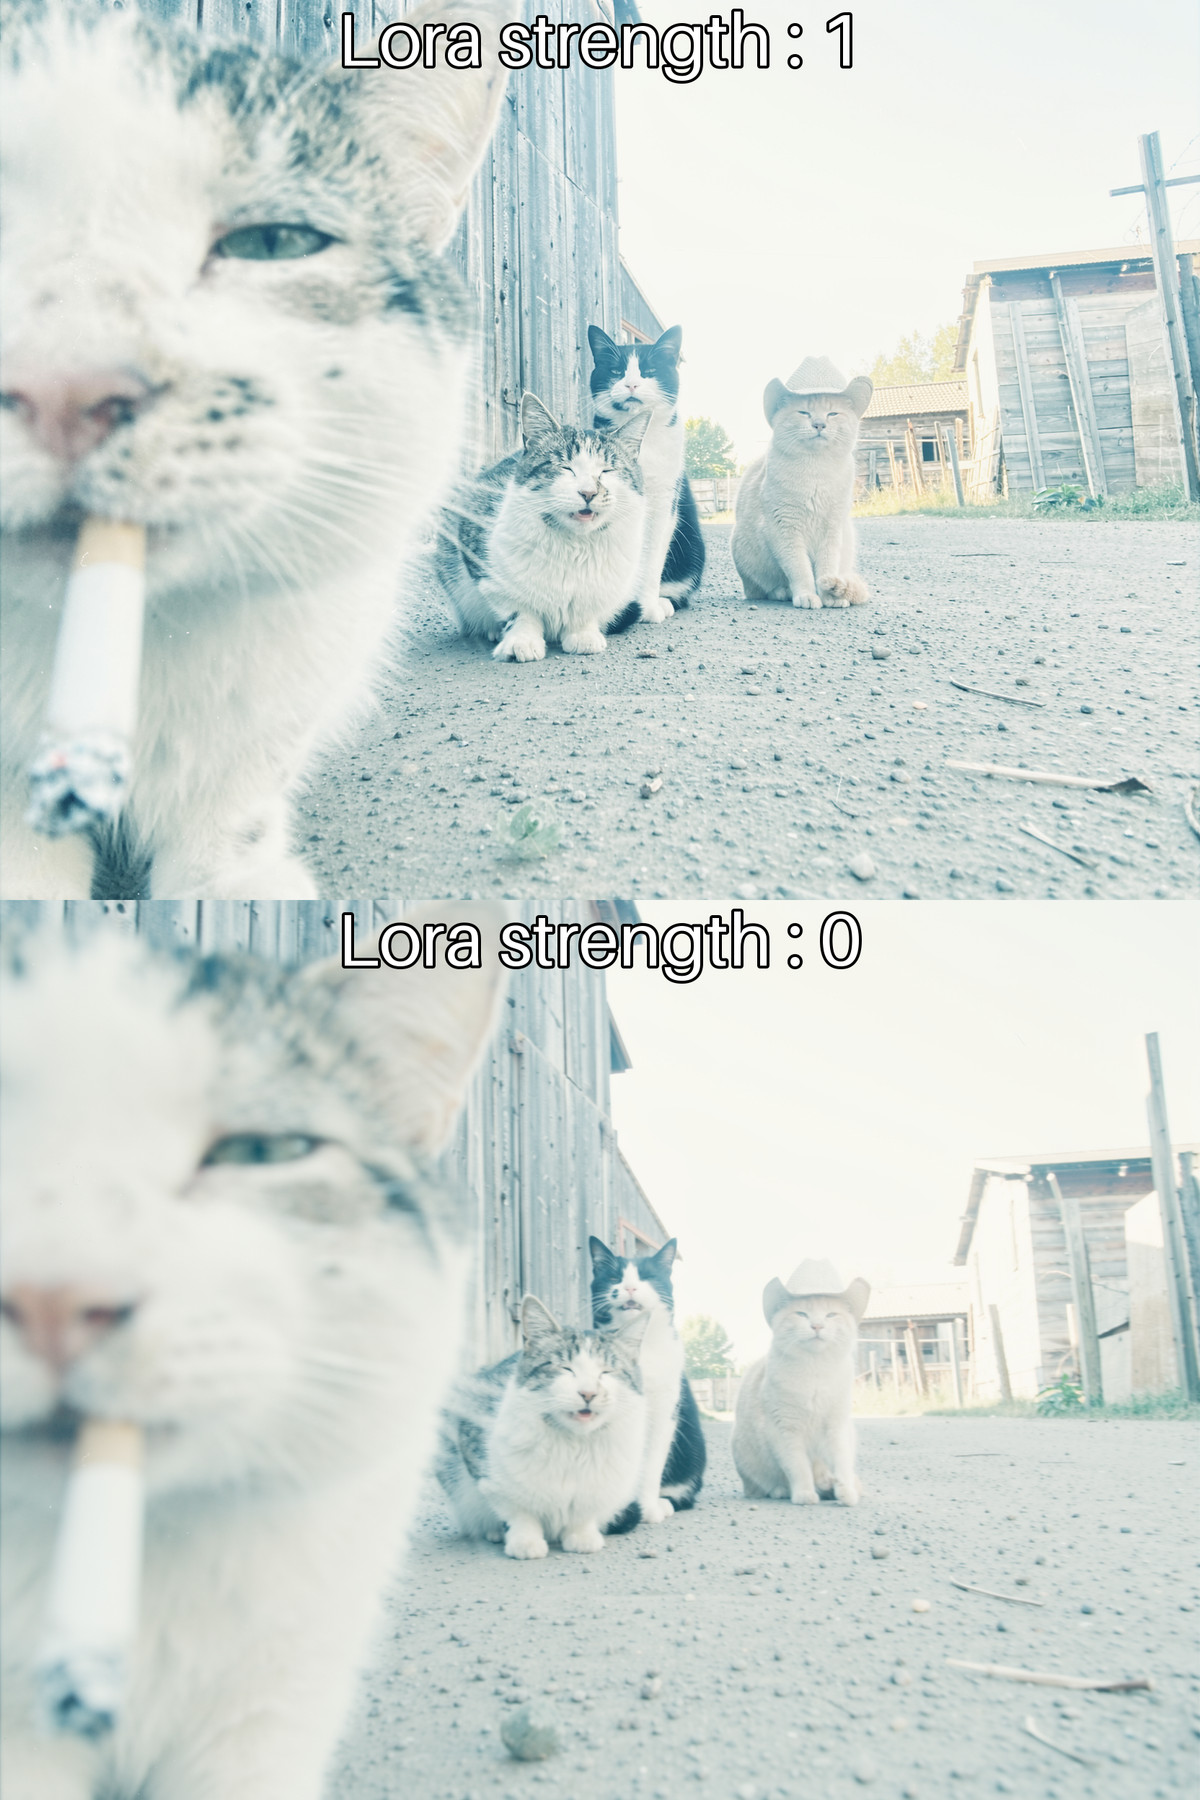
【B】釉光细绘 Glazeline style · moss-v1.0
LoRA · 新模型 · 作者 soda_Cookie · 发布 11-10 20:04 · 下载 12
名为“釉光细绘”(Glazeline)的插画风格 LoRA,作者给了触发词、一段完整示例提示词和负面提示词。
配图
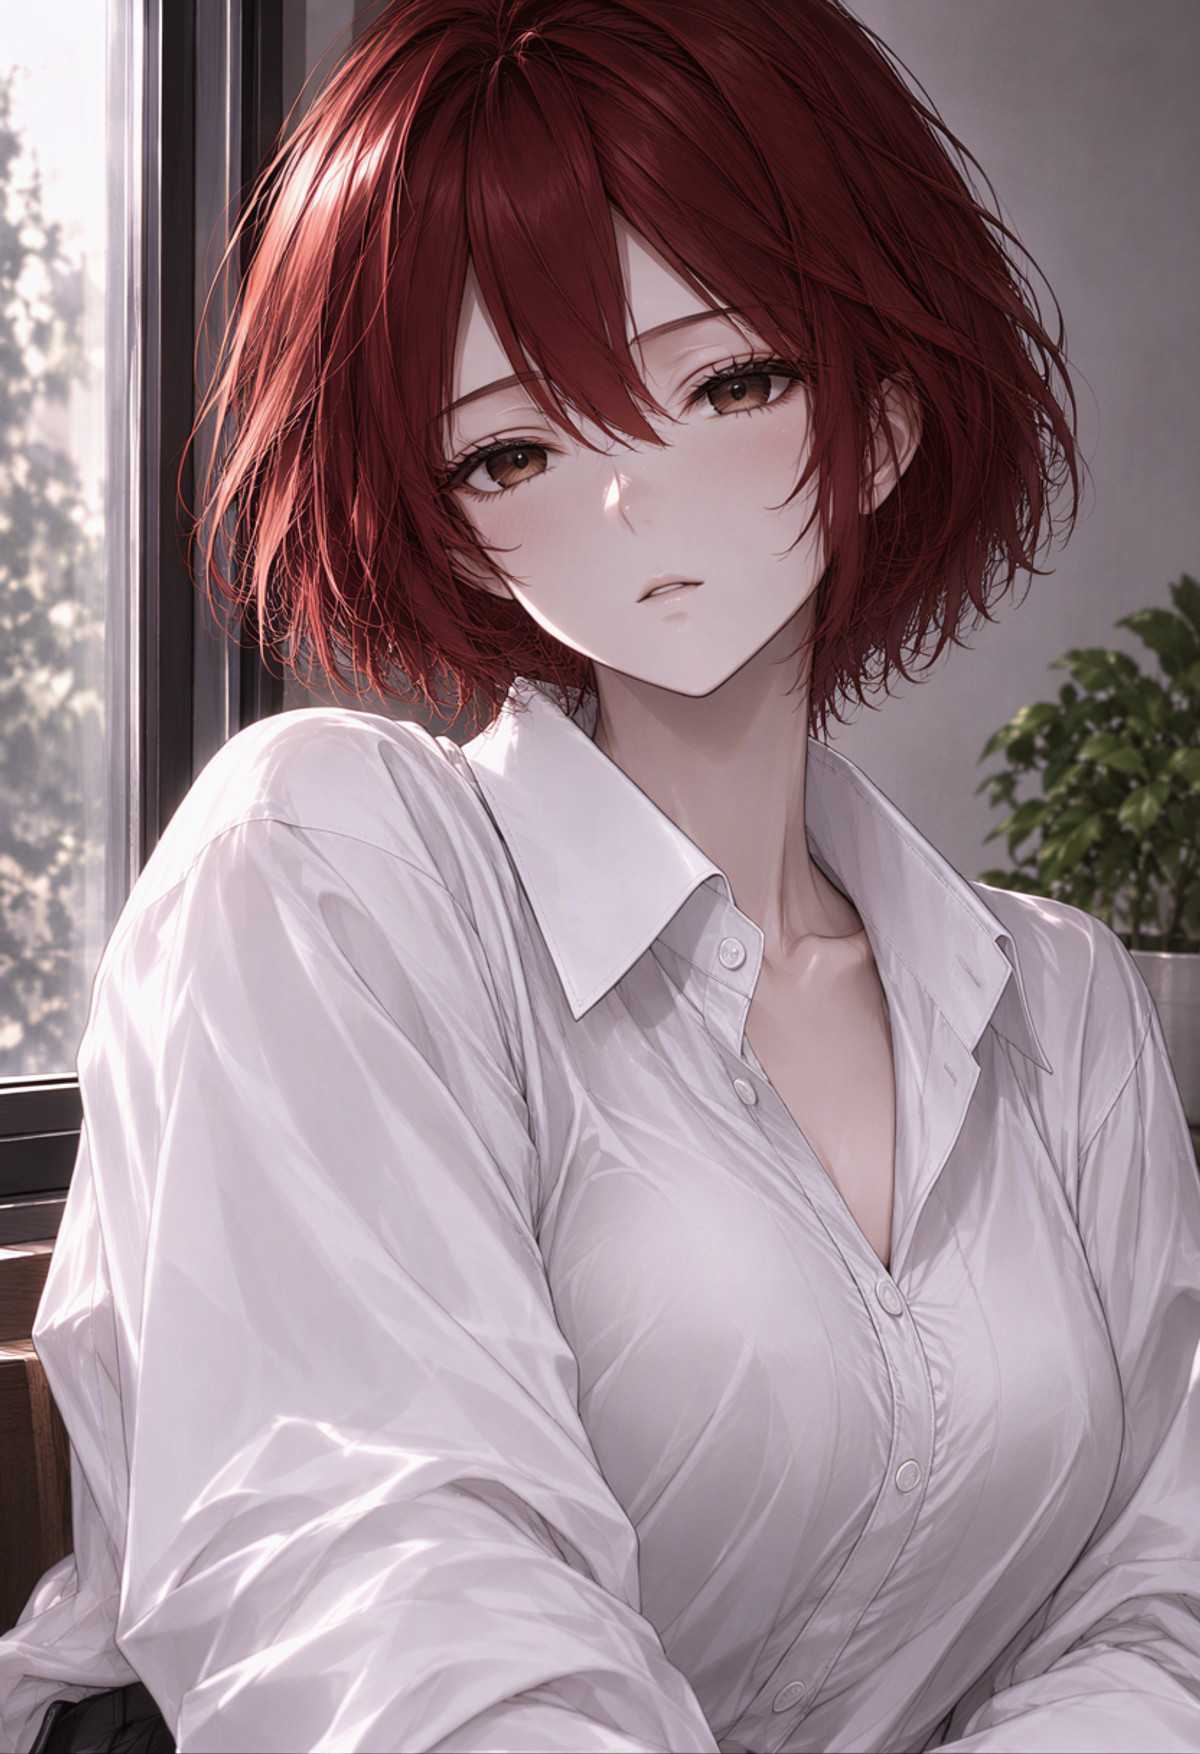
【B】纸雕/纸偶 · v1.0
LoRA · 移植 · 作者 YuChuXi · 发布 11-10 13:54 · 下载 47
纸雕 / 纸偶风格 LoRA 的 MOSS 版:把画面做成一层层叠起来的剪纸插画。
配图
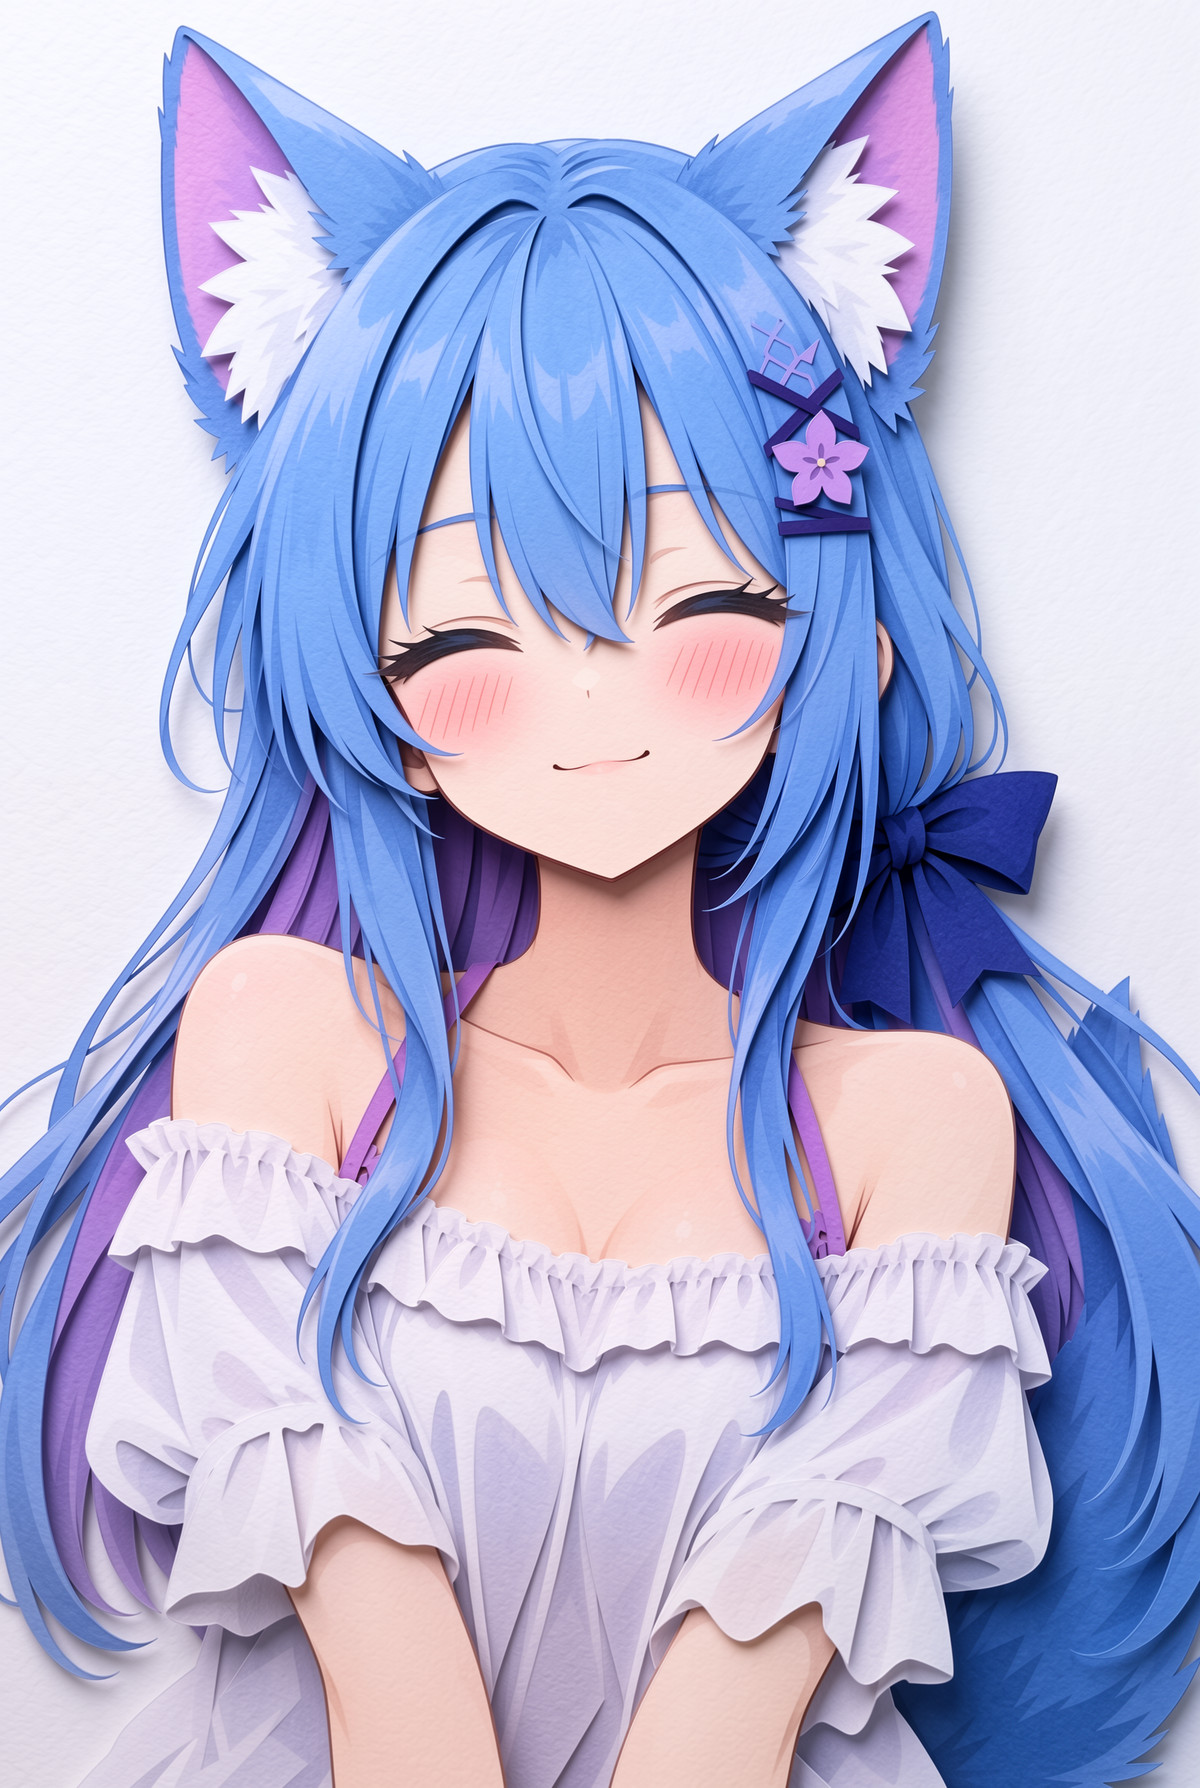
【B】18 in 1,《Bleach》/《死神》,Tite Kubo/久保带人 - Artist Style · MOSS_v1.0
LoRA · 移植 · 作者 flyx3 · 发布 11-10 12:10 · 下载 3 · 付费
《死神》作者久保带人的漫画画风 LoRA 的 MOSS 版,同一个文件里还能出该作的大多数角色。
配图
仅收录(14)
- MaleBot Style · Moss v1 — LoRA:模仿角色聊天机器人里常见男性角色封面画风(作者称类似 niji 那种)的风格 LoRA 的 MOSS 版。
- Mem (Honkai: Star Rail) [Illustrious/pony/moss] · MOSS — LoRA:《崩坏:星穹铁道》角色“迷迷”(Mem,粉色毛绒小生物)的角色 LoRA 的 MOSS 版。
- huashijw/画师JW | Style · MOSS(test) — LoRA:仿画师“画师JW”(huashijw)可爱系二次元女性画风的风格 LoRA 的 MOSS 测试版。
- Takorin Style | ILXL & Anima · Moss v0.1 — LoRA:画师 Takorin(namako8982)二次元画风 LoRA 的 MOSS 测试版 v0.1。
- Francesca · MossImage — LoRA:MisterMR 系列虚构人物 Francesca(托斯卡纳出身的“缪斯”设定)的人物 LoRA 的 MOSS 版。
- xKlara · MOSS Image — LoRA:AI 生成的原创女性人物 xKlara(深棕发、柔和五官)的人物 LoRA,MOSS 版与同页 Krea 2 版用同一数据集训练。
- Echidna - MOSS · Echidna — LoRA:《Re:从零开始的异世界生活》角色艾姬多娜(Echidna)的角色 LoRA,作者给了一整段逐件拆解的外貌和服装描述。
- Frankie NordhavenLove · MossImage — LoRA:一个虚构北欧女性角色的人物 LoRA,用来固定同一张脸出图。
- jun navigavi style · v1.0 — LoRA:模仿画师 jun navigavi 画风的二次元插画 LoRA。
- A style lora by Ryia | 2 · v1.1 — LoRA:作者用自己 NAI v5 出的图训练的二次元画风 LoRA,本版改在 Moss-heal 上重训。
- 凉屋/涼香/Ryohka/Suzuya · Runs_1_st9000 — LoRA:二次元角色「涼香 / Ryohka / Suzuya」的 MOSS-Image-SFT 角色 LoRA,这是同一次训练的最终第 9000 步存档;示例是紫色长卷发、绿眼、白色水手服的少女。
- ૮꒰ ˶• ༝ •˶꒱ა ♡ · v1 — LoRA:作者自称“2000 年代复古动画”画风的 LoRA,方形示例图。
- YD style · v1.1 — LoRA:一个名为 YD 的画风 LoRA 的第二版,模型卡只有触发词。
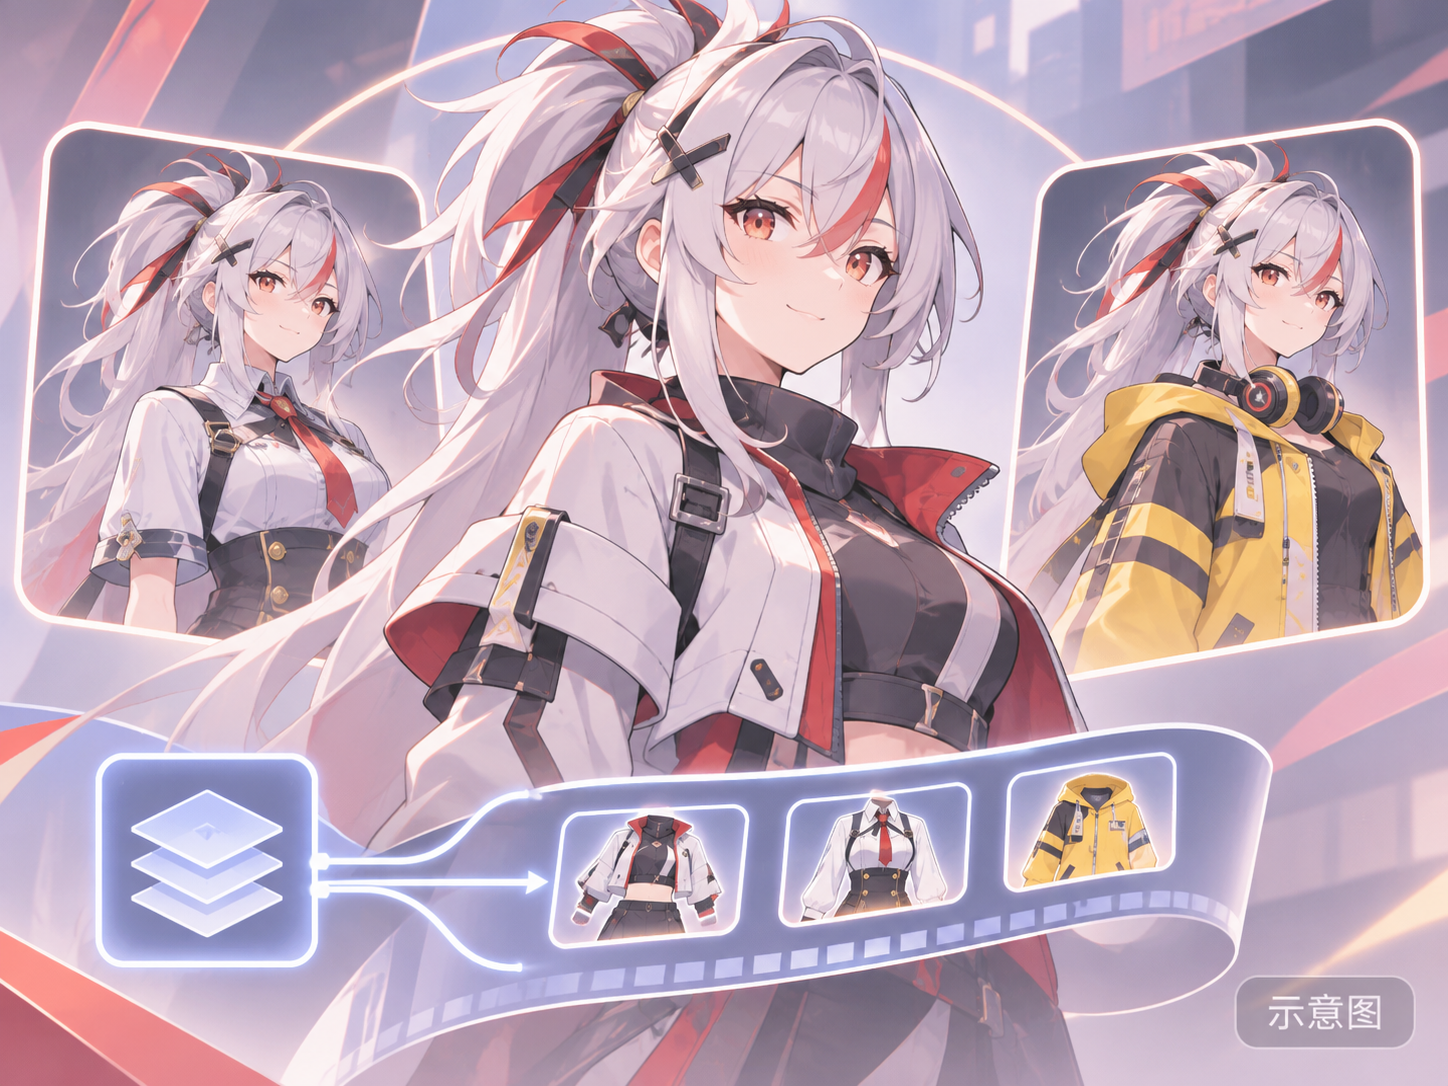
- Phoenix Reffaella フィオニー・レファエラ, 3 Outfits — Zenless Zone Zero ゼンレスゾーンゼロ [Anima+Illustrious+MOSS] · v1.0 MOSS Image — LoRA:《绝区零》第三季角色 Phoenix 的角色 LoRA 的 MOSS 版,一个文件含三套服装。
数据:Civitai 公开 API(基模 MOSS Image),收录窗口 11-10 08:31 → 11-10 21:01(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。