진진의 AI 레이더 · MOSS Image · 2026-11-10 저녁 브리핑
이번 호의 35개 신규 버전: 강력 추천 2 · 추천 9 · 주목할 만함 10 · 단순 수록 14
편집자 주 이번 호에서는 MOSS의 새로운 버전 44개를 검토했으며, S등급 2개, A등급 9개, B등급 10개, C등급 14개로 분류하고 9개는 제외했습니다. 가장 먼저 추천하는 것은 복고풍 전체 페이지 광고 스타일 LoRA인 Ad Infinitum의 MOSS 버전입니다: 화면을 옛날 상품 카드, 포스터 및 잡지 광고처럼 연출하며, 따옴표를 사용하여 시대감 있는 제목을 작성할 수 있고, 트리거 워드, 강도, 스텝 수, CFG 및 타이포그래피 설정까지 모두 제공됩니다. 같은 S등급으로 분류된 것은 thedeoxen의 포즈 제어 LoRA로, DWPose 골격 이미지를 입력하여 새로운 인물이 동일한 포즈를 취하도록 하며, 같은 저자의 Canny, 선화, 낙서, 깊이, 법선, 분할 제어 LoRA는 A등급입니다. 그 외 FGO 복도 장면 배경, 애니메이션 스크린샷 스타일 v2, 스마트폰 스냅 사진 리얼리즘 사진 등이 A등급으로 분류되었습니다; 설명이 한두 문장뿐인 인물/화풍 LoRA와 유료 선공개 체험용 캐릭터 LoRA는 C등급입니다. Liangwu(凉屋) 캐릭터 LoRA의 8개 중간 스텝 스냅샷은 최종 st9000 버전만 유지했으며, Ceiling Fisheye Cam의 Krea2 버전은 MOSS로 잘못 표기된 Krea 2 가중치이므로 모두 제외했습니다.
강력 추천 (2)
【S】Ad Infinitum - Krea 2 · Classic - MOSS
LoRA · 이식 · 저자 AriaMaiven · 공개일 11-10 10:48 · 다운로드 수 50
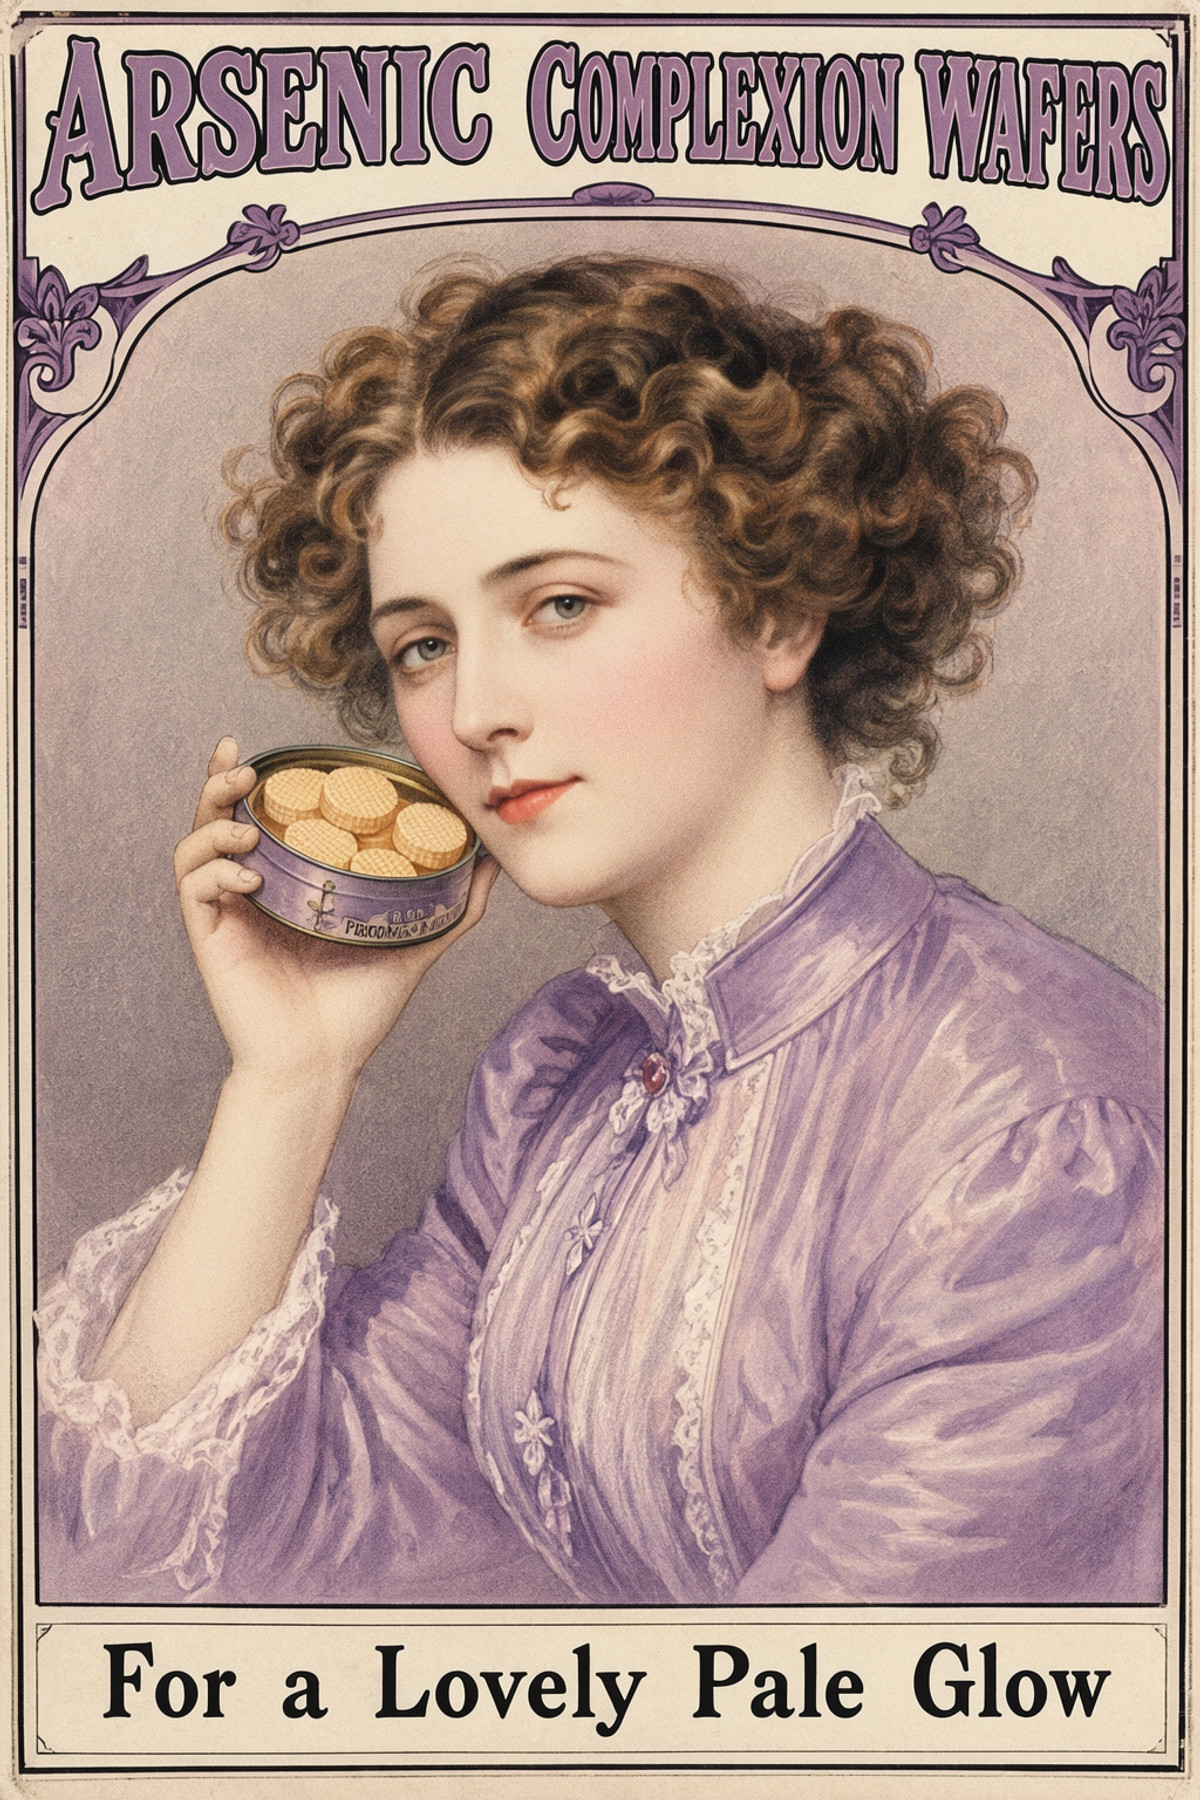
복고 광고 페이지 스타일 LoRA의 MOSS 버전(Classic): 화면을 1885–1948년도의 상품 카드, 포스터 및 잡지 광고에서 볼 수 있는 점묘법 채색, 잉크 라인 아웃라인, 크림색 종이 질감의 전체 페이지 광고로 연출하며, 프롬프트에 따라 옛날식 대문자 제목을 작성할 수 있습니다.
이번 그룹의 추천: 방향성이 독특합니다(단순한 복고 필터가 아닌 전체 페이지 광고). 트리거 워드, 강도, 스텝 수, CFG, 크기 및 타이포그래피 설정이 모두 제공되어 따라 하기 쉽습니다.
예시 이미지
추천 이유
- 이식: 같은 페이지에는 이미 Krea 2의 Classic 및 Future Vintage 두 버전이 있으며, 모델 페이지 누적 다운로드 수는 303회입니다. MOSS 버전은 MOSS Base에서 학습되었으며, 동일한 46장의 퍼블릭 도메인 상품 카드/포스터/잡지 광고(기존 텍스트 제거됨)를 사용했고, 트리거 워드는 adnclsk를 그대로 따랐습니다
- 복고 포스터, 옛날 광고, 브랜드 패러디 및 편집용 이미지 생성에 적합합니다. 저자는 타이포그래피 설정 방법을 제시했습니다: 프롬프트 끝에 각 문장을 따옴표로 감싸고 위치를 명시하면 MOSS가 시대감 있는 대문자 폰트로 작성합니다
- 파라미터 완비: 강도 0.7에서 1.0; MOSS Image (SFT), 30 스텝, CFG 3, euler / simple, 1024 x 1536; 저자에 따르면 LoRA를 적용하지 않으면 MOSS는 현대적인 디지털 일러스트레이션만 생성합니다
- 저자는 갤러리의 모든 이미지에 프롬프트와 파라미터가 포함되어 있다고 밝혔습니다. 무료이며, 라이선스는 이미지 출력 및 사이트 내 대여를 허용합니다. 공개 후 약 10시간 만에 다운로드 수 50회
사용 방법
- 프롬프트의 첫 번째 단어로 adnclsk를 작성한 후 광고의 주제와 화면을 기술합니다. 강도는 0.7에서 1.0 사이로 설정하며, 제목이 길 경우 0.7으로 설정하면 더 깔끔합니다
- 텍스트가 필요할 경우 끝에 다음과 같이 작성합니다: The only words on the page are the headline "…" at the top …, and the line "…" on a cream panel at the bottom. 각 문장을 따옴표로 감싸고 위치와 색상을 명시합니다
- MOSS Image (SFT), 30 스텝, CFG 3, euler / simple, 1024 x 1536; 나중에 직접 타이포그래피를 할 계획이라도 프롬프트에 제목과 하단 바를 포함해야 합니다. 그렇지 않으면 기차나 풍경 같은 화면이 유화처럼 변질될 수 있습니다
- poster, lithograph, vintage 또는 연도 관련 단어를 다시 작성하지 마세요. 저자는 LoRA가 이미 시대감을 내장하고 있다고 밝혔습니다
리스크 및 제한 사항
- 공개된 예시 이미지는 5장이며, 추가로 4장은 등급 분류로 인해 숨겨져 있습니다. LoRA 적용 전후의 동일 시드 비교가 없습니다
- 학습 데이터셋은 46장에 불과합니다. Krea 2 버전에 포함된 ComfyUI 워크플로우 압축 파일은 MOSS 버전에는 없으므로 직접 구성해야 합니다
- 라이선스는 출처 표기를 요구합니다. 저자는 재사용하거나 해당 출력 이미지로 다른 모델을 학습시키기 전에 허락을 받아야 한다고 명시했습니다
- 이 항목은 실행되지 않았습니다
트리거 워드: adnclsk
【S】MOSS-Image Pose Control · v1.0
LoRA · 신규 모델 · 저자 thedeoxen · 공개일 11-10 16:20 · 다운로드 수 29
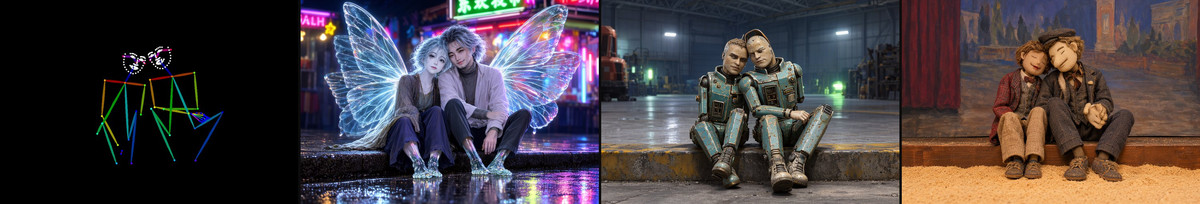
MOSS-Image-SFT용 포즈 제어 LoRA: 검은색 배경의 컬러 DWPose 골격 이미지를 입력하면 생성된 인물이 골격에 따라 동일한 신체, 손 및 얼굴 포즈를 취하며, 외모, 의상 및 배경은 프롬프트로 결정됩니다.
같은 저자가 같은 날 7개의 제어 LoRA를 공개했으며, 학습 방식과 샘플링 파라미터는 동일하고 입력하는 제어 이미지만 다릅니다. 그중 포즈 제어 기능이 가장 독립적이고 워크플로우가 완비되어 있어 이번 그룹의 대표로 선정했습니다.
예시 이미지
추천 이유
- 신규 기능: MOSS-Image-SFT에 골격 기반 포즈 제어 기능을 추가했습니다. 저자는 이것이 ControlNet 방식의 편집 LoRA이며 공식적인 color/depth 결합 어댑터가 아니라고 설명합니다. 일반 LoRA 로더로 로드하고 골격 이미지를 유일한 참조 이미지로 Text Encode MOSS-Image Edit에 입력하면 됩니다
- 의상 및 인물 교체, 사진 속 포즈를 다른 캐릭터로 이전, 스토리보드 및 키프레임에서 신체 동작 일관성이 필요한 상황에 적합합니다. 같은 저자의 Canny / Lineart 같은 윤곽 제어와 달리 관절 위치만 고정하며 의상 윤곽이나 배경은 고정하지 않습니다
- 저자가 제시한 골격 추출 방법: comfyui_controlnet_aux의 DWPose를 사용하며, 신체, 손, 얼굴 세 항목을 모두 활성화합니다. 검은색 배경의 컬러 뼈대는 학습용 제어 이미지와 일치합니다
- 파라미터 및 워크플로우 완비: ComfyUI 워크플로우 JSON(사진 읽기→골격 추출→인코딩→샘플링)이 첨부되어 있으며, 4500번째 스텝 체크포인트를 선택하고 강도 1.0, 30 스텝, CFG 4, euler + simple을 사용하며 트리거 워드는 없습니다
- 예시 이미지는 3장으로, 각각 '골격 + 세 가지 다른 프롬프트'로 구성된 콜라주이며 동일한 포즈로 세 가지 인물을 생성한 결과를 직접 확인할 수 있습니다. 공개 후 5시간 만에 다운로드 수 29회, 좋아요 3개를 기록했으며 이 그룹의 제어 LoRA 중 가장 높은 관심을 받았습니다. 무료이며 라이선스는 이미지 출력 및 판매를 허용합니다
사용 방법
- 기본 모델은 MOSS-Image-SFT 사용: UNet moss_image_sft_int8_convrot, 텍스트 인코더 qwen3.5_9b_w4a8_gptq(타입은 moss_image 선택), VAE flux2-vae_small; LoRA는 UNet에 연결하며 강도는 1.0
- DWPose(신체 + 손 + 얼굴)를 사용하여 참조 사진에서 골격을 추출하고, 검은색 배경의 컬러 뼈대 이미지를 유일한 참조 이미지로 Text Encode MOSS-Image Edit에 연결합니다. 긍정 및 부정 인코딩 노드의 edit format을 모두 ai-toolkit으로 설정합니다
- 30 스텝, CFG 4, euler + simple; 트리거 워드는 없으며 프롬프트에는 인물 정체성, 의상, 재질 및 배경을 작성하고 관절을 하나하나 설명할 필요는 없습니다
리스크 및 제한 사항
- 민감도 등급으로 숨겨진 예시가 4개로, 공개된 3장보다 많습니다
- 골격에서 누락된 사지에 대해 저자는 프롬프트로 해당 관절을 신뢰성 있게 보완할 수 없다고 밝혔습니다. 손가락 등 세부 사항이 얼마나 잘 반영되는지는 저자가 언급하지 않았습니다
- MOSS-Image-SFT(저자는 int8 양자화 UNet 사용)에만 학습되었습니다. MOSS-Image-Base 또는 다른 정밀도에서의 성능은 저자가 언급하지 않았으며, 기본 모델을 Other로 표기했습니다
- 전체 모델 카드에서 저자는 제어가 너무 경직될 경우 강도를 0.7으로 낮추라고 권장하며, 학습 값은 1.0입니다
- 예시 이미지에는 생성 파라미터가 첨부되지 않았습니다. 이 항목은 실행되지 않았습니다
추천 (9)
【A】Anime Screencap Style · v2.0
LoRA · 버전 업데이트 · 저자 kanakiy · 공개일 11-10 09:48 · 다운로드 수 57
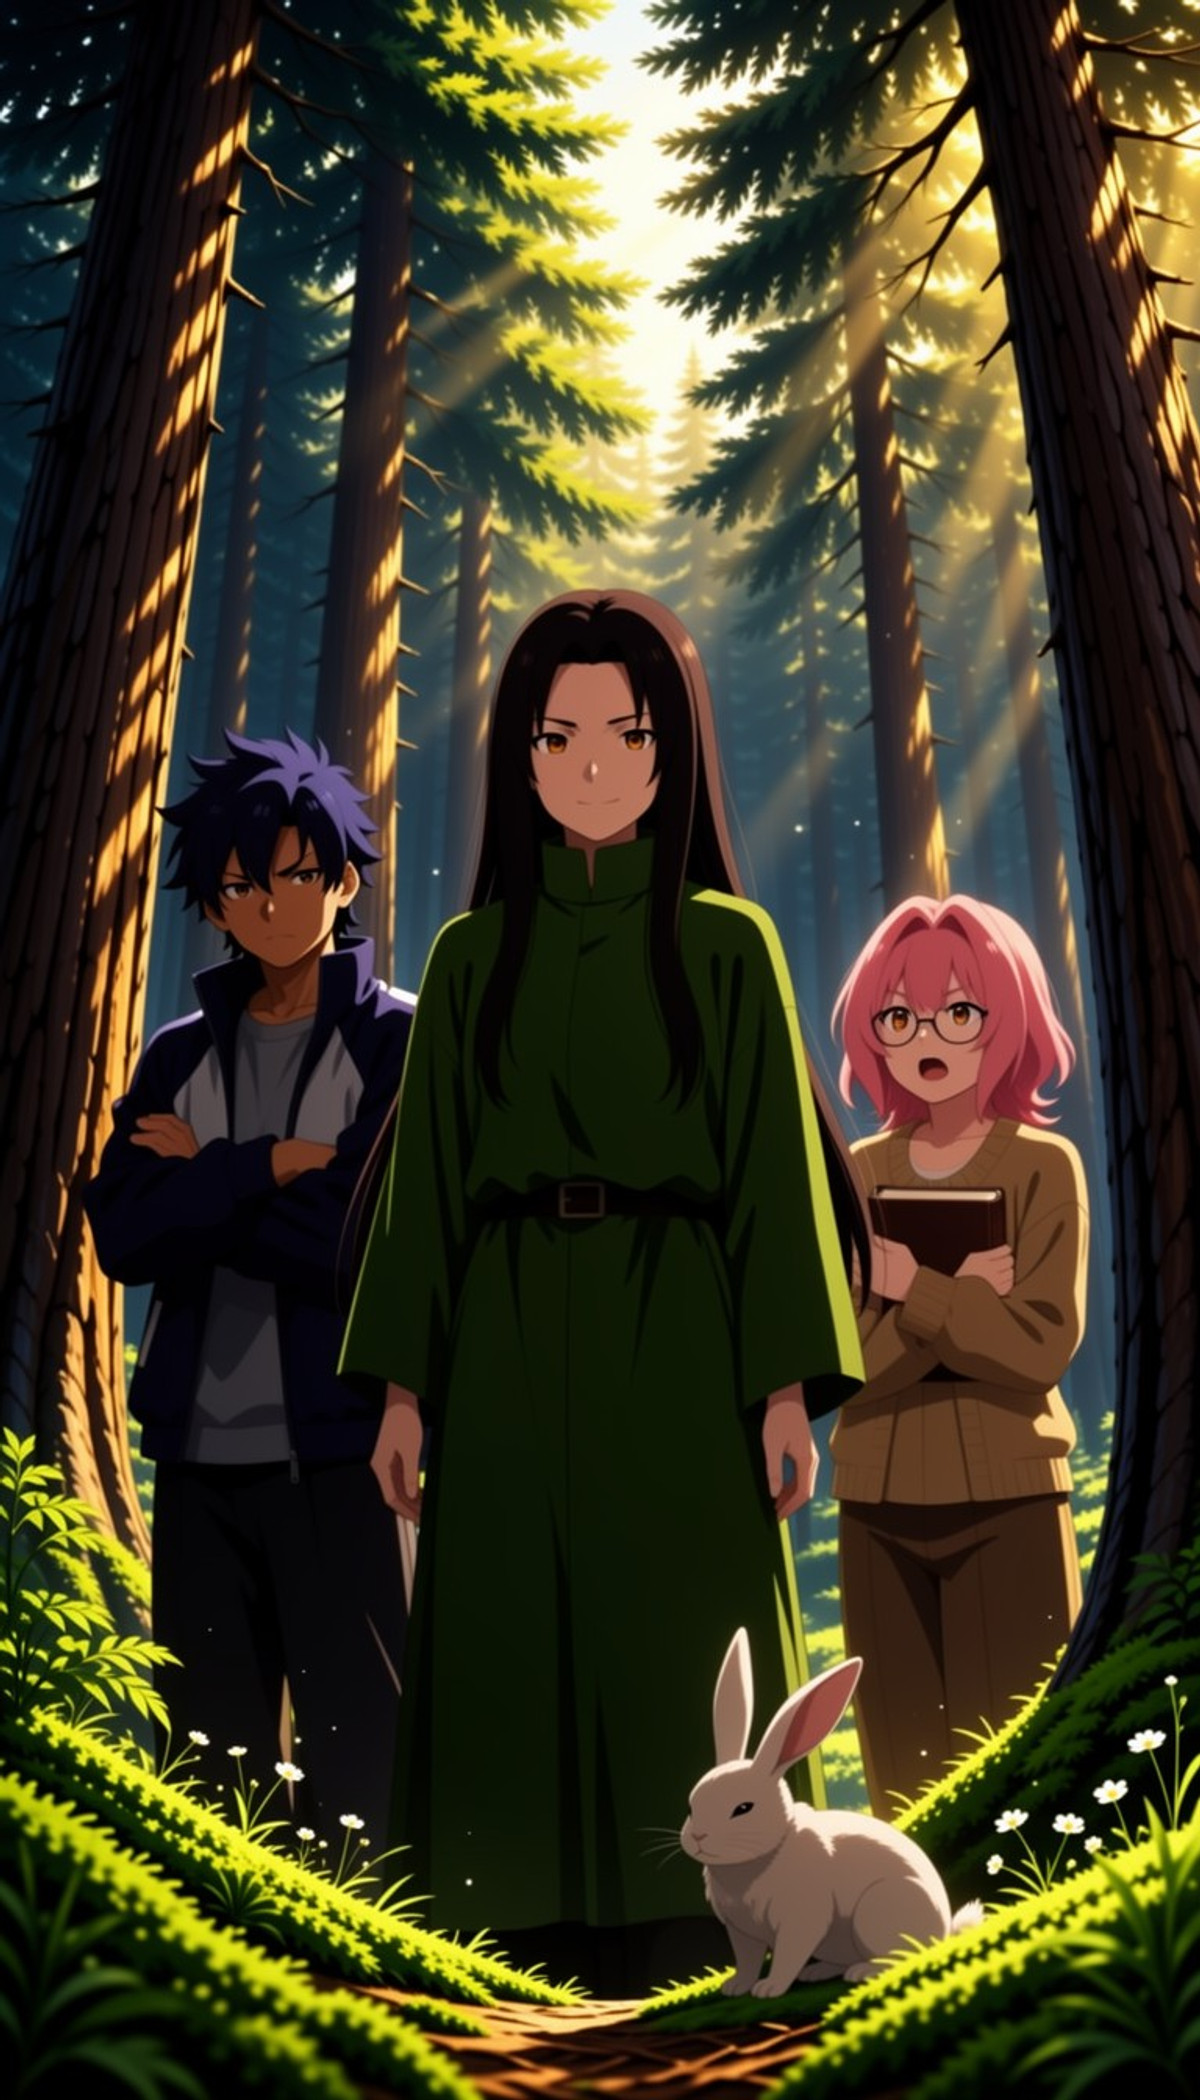
현대 애니메이션 스크린샷 스타일 LoRA의 v2.0: 평면 셀 채색, 거의 없는 부드러운 그림자, 굵고 깔끔한 선, 고채도 색상 및 와이드 스크린식 구도를 특징으로 합니다.
자동 A등급 유지: 스타일 목표가 구체적으로 기술되고 예시가 많지만, v2에는 강도와 샘플링 파라미터가 누락되었습니다.
예시 이미지
추천 이유
- 버전 업데이트: 저자는 v2.0에서 학습 데이터를 개선하여 v1.0 데이터에 있던 츠나데(纲手)와 아야세 세이코(绫濑星子, Seiko Ayase) 두 캐릭터를 제거했다고 밝혔습니다(이름으로 능동적으로 호출하는 것은 여전히 가능). v1.0에서는 이 두 캐릭터 때문에 강도 0.6–0.8을 권장했습니다
- 일반적인 부드러운 그라데이션 2D 스타일이 아닌 '애니메이션 스크린샷 느낌'을 원하는 텍스트-이미지 생성에 적합하며, 저자는 대부분의 애니메이션 모델보다 더 평면적이고 단단한 느낌을 준다고 밝혔습니다
- 예시 이미지 17장; 무료; 공개 후 약 11시간 만에 다운로드 수 57회
사용 방법
- LoRA를 로드하면 되며 트리거 워드는 없습니다. v1.0은 강도 0.6–0.8을 권장하며, v2.0의 강도는 저자가 제시하지 않았으므로 동일한 범위에서 시작해 볼 수 있습니다. 스텝 수와 CFG는 저자가 제시하지 않았습니다
리스크 및 제한 사항
- 저자는 업데이트 설명을 작성하지 않았습니다(버전 설명은 비어 있으며, 변경 사항은 모델 카드의 두 문장에서 유추됩니다). v1과 v2 간의 비교가 없습니다
- 라이선스는 이미지 출력의 상업적 사용을 포함하지 않으며 대여만 허용합니다. 예시 이미지 3장이 등급 분류로 인해 숨겨져 있습니다
- 이 항목은 실행되지 않았습니다
【A】Realistic Photo by Amateur Snapshot · MOSS
LoRA · 신규 모델 · 저자 858654128784 · 공개일 11-10 18:02 · 다운로드 수 73
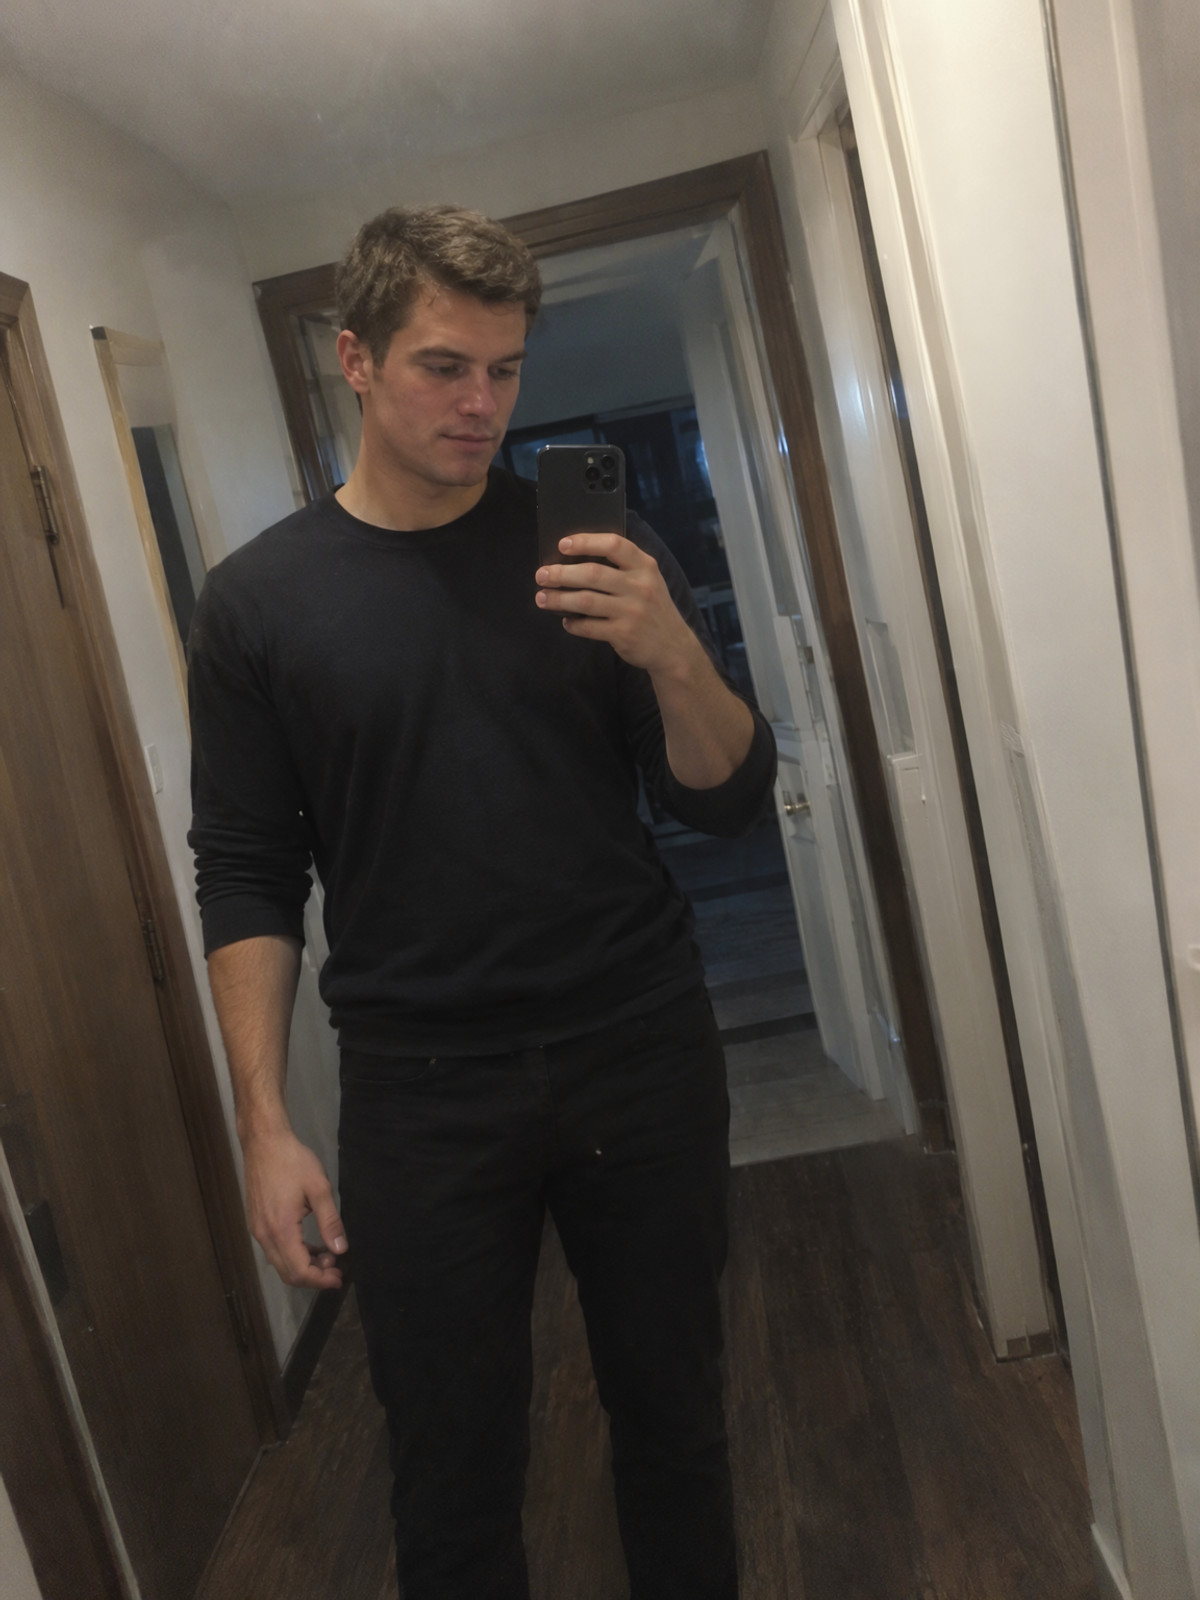
스마트폰 스냅 사진 스타일의 리얼리즘 사진 LoRA: 거울 셀카, 전면 카메라 셀카, 주방 테이블, 엘리베이터 내부, 위에서 내려다본 반려동물 등 기울어진 구도, 불균일한 조명, 어두운 부분의 입자감 및 실제 피부 질감을 재현하여 AI 이미지 특유의 지나치게 깨끗한 스튜디오 느낌을 제거합니다.
자동 A등급 유지: 용도가 명확하고 프롬프트 작성 방법을 그대로 따라 할 수 있지만, 강도와 샘플링 파라미터가 누락되었으며 공개된 예시가 적습니다.
예시 이미지
추천 이유
- 신규 모델: MOSS 버전만 존재하며, 정교하게 보정된 리얼리즘이 아닌 '일반인이 스마트폰으로 찍은 사진'을 목표로 합니다
- 저자는 프롬프트 작성 방법을 제시했습니다: amateur smartphone photo로 시작하여 장소, 누가 폰을 들고 있는지, 빛의 방향을 명시합니다. '폰이 얼굴 절반을 가림', '전경에서 잘려 나간 머그컵' 같은 세부 사항을 추가하면 더 자연스럽습니다
- 무료이며 라이선스는 이미지 출력, 대여 및 판매를 허용합니다. 공개 후 약 3시간 만에 다운로드 수 73회로 이번 그룹에서 가장 빠른 다운로드 속도를 기록했습니다
사용 방법
- 프롬프트는 amateur smartphone photo로 시작하여 장소, 폰을 든 사람 및 광원을 작성하고, 가림 현상, 전경 잘림 등 스냅 사진의 세부 사항을 추가합니다. 트리거 워드는 없습니다
- 강도, 스텝 수, CFG는 저자가 제시하지 않았습니다
리스크 및 제한 사항
- 예시 이미지 15장이 등급 분류로 인해 숨겨져 있어 공개된 것은 5장뿐입니다. 페이지는 혼합 콘텐츠입니다
- 파라미터가 없으며 LoRA 적용 전후의 비교도 없습니다. 학습 데이터 출처는 저자가 설명하지 않았습니다
- 실제 인물 생활 사진처럼 보이는 생성 결과이므로, 게시 시 AI 생성임을 명시해야 합니다. 이 항목은 실행되지 않았습니다
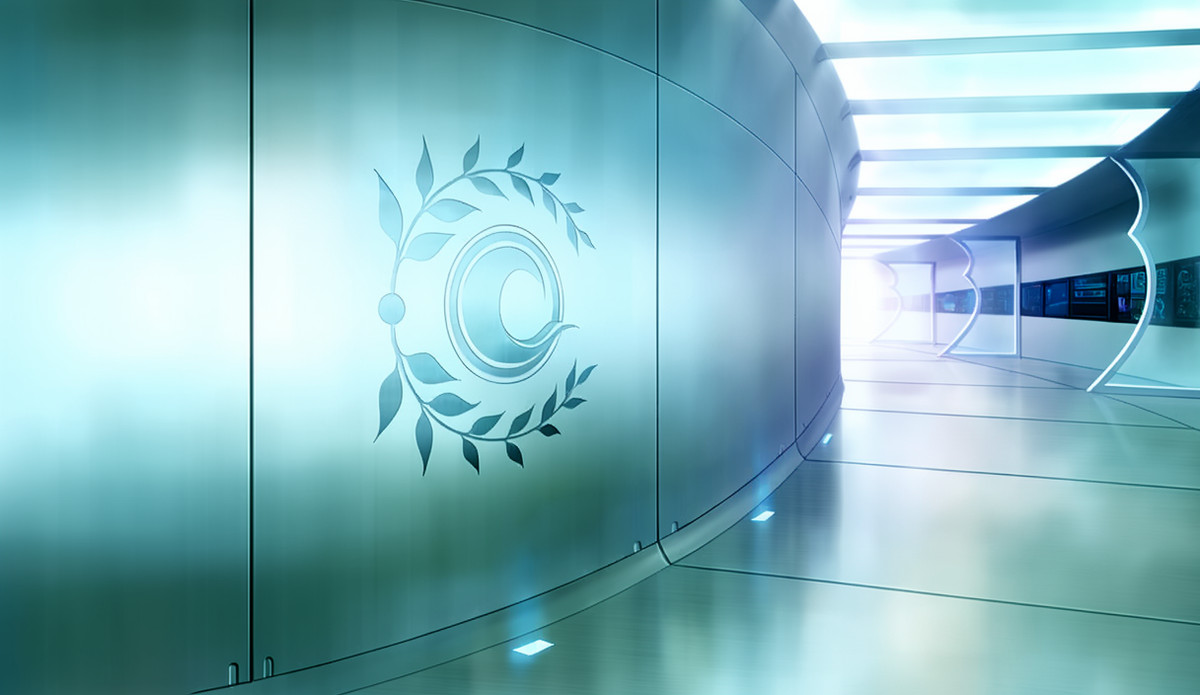
【A】Chaldea Corridor: Fate/Grand Order · MOSS-sft01
LoRA · 신규 모델 · 저자 RHU_AIstudio · 공개일 11-10 19:59 · 다운로드 수 10
《Fate/Grand Order》의 구 칼데아 복도 장면 배경 LoRA: 하나의 트리거 워드로 이 복도를 고정하고, 상태 단어를 사용하여 정상, 어두움, 파손, 얼음 등 다양한 모습을 전환합니다.
자동 A등급 유지: 장면 LoRA로서 사용법이 가장 명확하게 기술된 항목으로, 트리거 워드, 강도 및 상태 단어를 그대로 복사하여 사용할 수 있지만 하나의 장소만 커버하며 샘플링 파라미터가 누락되었습니다.
이미지
1216x704 예시 이미지(https://rh-images-switch.xiaoyaoyou.com/input/openapi/932b9f559656ce7438a077493b8f71d7cda41ff52fc9bcb72cfe40533d139755.jpg)
추천 이유
- 새로운 모델이며, 이번 호에서 보기 드문 배경/장소 관련 LoRA입니다: 인물에 관계없이 특정 장소를 재현하는 데 특화되어 있으며, 팬아트 일러스트, 캐릭터 입체 일러스트의 배경, 비주얼 노벨 스타일의 장면 이미지에 적합합니다
- 저자가 학습 출처를 명시했습니다: 게임 내 배경 소스 7장을 사용했으며, 정상/어두움/흐림/손상/얼음 결빙 상태와 두 가지 카메라 각도를 포함합니다
- 트리거 워드, 강도 및 상태 단어를 모두 제공했습니다: corridor_(chaldea)_(fate), 강도 1.0; bright lighting, dark, dim lighting, damaged, cracked wall, debris, frozen, ice, flooded, close-up은 문장이 있는 벽면의 카메라 각도에 해당합니다
- 3장의 공개 예시와 1장의 비공개 예시가 있습니다; 무료이며 라이선스가 유연하여 이미지 생성, 판매 및 파생 작업이 허용됩니다
사용 방법
- 프롬프트에 corridor_(chaldea)_(fate)를 입력하고 필요에 따라 상태 단어를 추가합니다: bright lighting / dark, dim lighting / damaged, cracked wall, debris / frozen, ice, flooded; 문장이 있는 벽면 각도를 원할 경우 close-up을 추가합니다; LoRA 강도는 1.0입니다
- 스텝 수, CFG, 샘플러는 저자가 제공하지 않았습니다; 버전명은 MOSS-sft01이며, 저자는 Base 모델인지 SFT 모델인지 명시하지 않았습니다
리스크 및 제한 사항
- 학습 데이터셋은 7장의 이미지로만 구성되어 있어, 기본적으로 이 복도의 몇 가지 상태와 두 가지 카메라 각도만 생성할 수 있으며, 다른 시점으로 변경했을 때 구조가 유지되는지는 불명확합니다
- 소스 이미지는 게임의 저작권이 있는 배경 이미지입니다. 라이선스가 유연하더라도 상업적 사용 전 원작의 저작권을 고려해야 합니다
- 모델 카드는 짧은 문단 하나로만 구성되어 있으며, 인물을 추가할 때의 작성법이나 중첩 사용에 대한 설명이 없습니다; 이 항목은 실행되지 않았습니다
트리거 워드: corridor_(chaldea)_(fate)
【A】MOSS-Image Scribble Control · v1.0
LoRA · 신규 모델 · 저자 thedeoxen · 공개일 11-10 16:53 · 다운로드 수 23
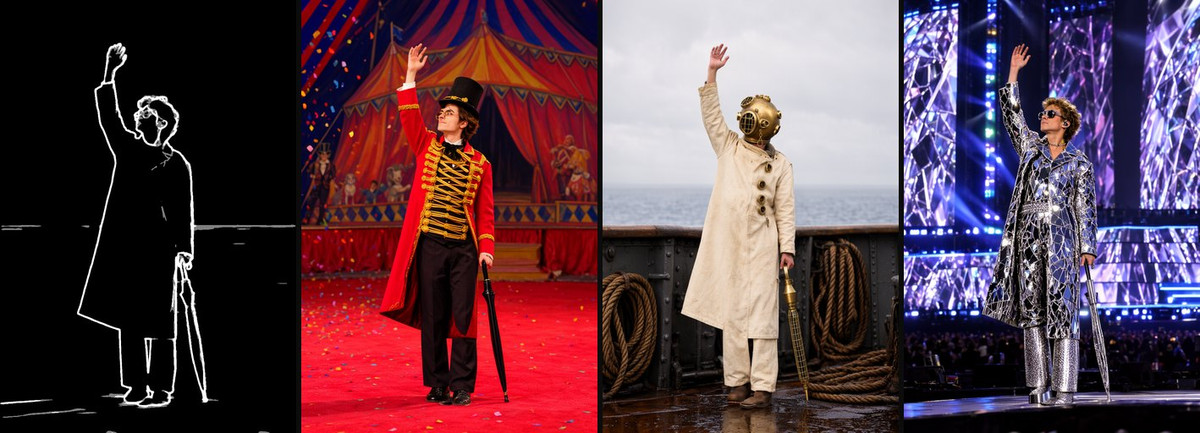
MOSS-Image-SFT용 스케치 제어 LoRA입니다: 검은색 배경 위에 굵고 부드러운 흰색 선 몇 개를 입력하면, 큰 붓의 흐름과 덩어리만 따르며 세부 사항, 질감 및 스타일은 프롬프트에 따라 자유롭게 생성됩니다.
이미지
1418x512 예시 이미지(https://rh-images-switch.xiaoyaoyou.com/input/openapi/770ae64db6bd38e2585538cafea6fb743f2b80c7ef8340fda77c1adcaf69b0d9.jpg)
추천 이유
- 새로운 기능: 같은 저자의 제어 시리즈 중 가장 느슨한 단계로, 주요 붓질과 큰 덩어리만 관리하며 모든 세부 윤곽을 따르지 않습니다; 저자는 Canny / Lineart 정밀 보정 전에 빠른 구도 테스트 용도로 사용할 것을 권장합니다
- 스케치 초안 작성, 스토리보드 붓질, 사진에서 큰 형태만 남기고 다시 그리는 작업에 적합합니다: 입력은 손으로 그린 몇 개의 선이거나 사진에서 추출한 부드러운 가장자리일 수 있습니다
- 전처리: 워크플로우는 HED Soft-Edge Lines를 사용하며 safe mode를 활성화합니다; 학습용 스케치는 Canny 및 라인아트보다 더 굵고 부드러우며, 저자는 HED의 부드러운 가장자리가 얇은 PiDiNet 스케치보다 학습 이미지와 더 유사하다고 언급했습니다
- ComfyUI 워크플로우 포함; 5000번째 스텝에서 저장, 강도 1.0, 30 스텝, CFG 4, euler + simple; 3장의 콜라주 예시
- 무료이며 라이선스가 이미지 생성 및 판매를 허용합니다; 공개 후 4시간 동안 23회 다운로드됨
사용 방법
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA를 UNet에 연결, 강도 1.0
- HED Soft-Edge Lines(safe mode) 또는 검은색 배경 위에 흰색 굵은 선으로 손으로 그린 몇 개를 유일한 참조 이미지로 사용하여 Text Encode MOSS-Image Edit에 연결하며, 긍정 및 부정 인코딩의 edit format을 모두 ai-toolkit으로 설정합니다
- 30 스텝, CFG 4, euler + simple; 트리거 워드 없음; 저자는 복잡하고 어지러운 가장자리 이미지보다 적고 확실한 붓질을 권장하며, 질감, 색상 및 세부 사항은 프롬프트에 맡깁니다
리스크 및 제한 사항
- 제어가 느슨하여 세부 위치가 고정되지 않으므로, 정확한 윤곽이 필요한 상황에서는 Canny 또는 Lineart로 변경해야 합니다
- MOSS-Image-SFT 전용으로 학습되었습니다; 기본 모델은 Other로 표기됨; 1개의 민감도 등급 예시가 비공개 상태입니다
- 전체 모델 카드에서는 제어가 너무 경직될 경우 강도를 0.7으로 낮출 것을 권장합니다
- 이 항목은 실행되지 않았습니다
【A】MOSS-Image Normal Control · v1.0
LoRA · 신규 모델 · 저자 thedeoxen · 공개일 11-10 16:51 · 다운로드 수 24
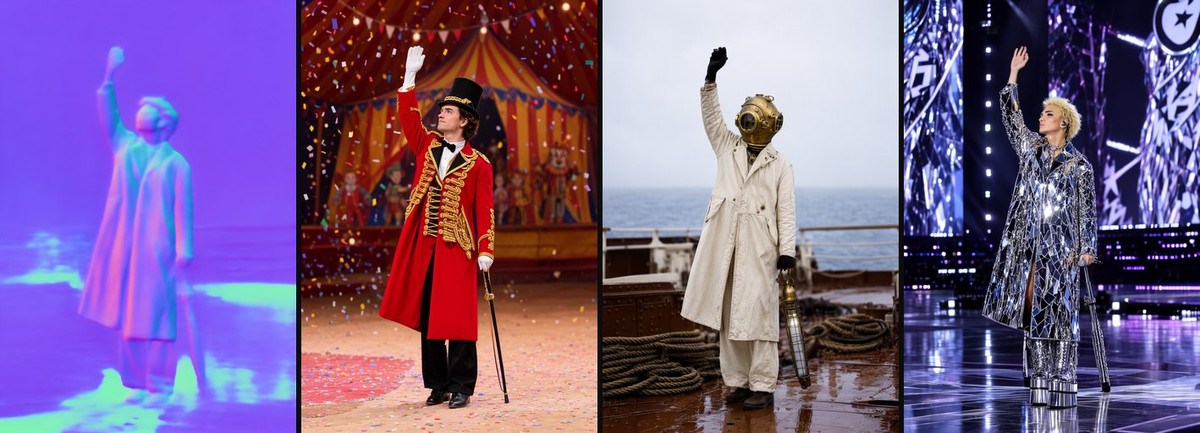
MOSS-Image-SFT용 노말 맵 제어 LoRA입니다: 컬러 노말 맵 이미지를 입력하면 물체의 부피와 표면 방향을 유지하면서 재질과 장면만 변경합니다.
이미지
1418x512 예시 이미지(https://rh-images-switch.xiaoyaoyou.com/input/openapi/5e37b8f356aea03ae9118e4a1c60ff78b4c84f1451a0bb2a3fa8da1c31c1fe59.jpg)
추천 이유
- 새로운 기능: 깊이 맵보다 '표면이 어느 방향을 향하는가'를 한 단계 더 관리하며, 부피와 방향은 고정하고 재질만 변경할 수 있습니다; 저자가 나열한 용도는 고정된 형태에 재질을 교체하거나 조명을 다시 설정하는 것, 그리고 제품 이미지에서 물체의 부피가 고정된 상황입니다
- 제품 이미지의 재질 교체, 조각품이나 소품의 텍스처 재부착, 깊이는 맞지만 표면 방향도 제어해야 하는 상황에 적합합니다; 입력은 사진 또는 3D 렌더링에서 내보낸 노말 맵입니다
- 전처리: 워크플로우는 BAE Normal Map을 사용하며, 학습 이미지는 일반적인 보라색/청록색/녹색의 카메라 공간 노말 맵입니다; 저자는 회색조 높이 맵이 아닌 카메라 공간 노말 맵을 사용해야 한다고 경고하며, 노말 맵이 매끄러울수록 부피가 깔끔해지고 노이즈가 많으면 불필요한 돌출부가 생긴다고 언급했습니다
- ComfyUI 워크플로우 포함; 5000번째 스텝에서 저장, 강도 1.0, 30 스텝, CFG 4, euler + simple; 3장의 콜라주 예시는 Canny / Lineart 버전과 동일한 테스트 사진 사용
- 무료이며 라이선스가 이미지 생성 및 판매를 허용합니다
사용 방법
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA를 UNet에 연결, 강도 1.0
- BAE Normal Map으로 컬러 카메라 공간 노말 맵 이미지를 생성하여 유일한 참조 이미지로 Text Encode MOSS-Image Edit에 연결하며, 긍정 및 부정 인코딩의 edit format을 모두 ai-toolkit으로 설정합니다
- 30 스텝, CFG 4, euler + simple; 트리거 워드 없음, 프롬프트에는 재질과 장면을 작성합니다
리스크 및 제한 사항
- 용도가 Canny / Depth보다 좁으며, 주로 재질 교체나 조명 변경 상황에서만 깊이 제어보다 더 큰 가치를 제공합니다
- 3D 소프트웨어에서 내보낸 노말 맵이 BAE의 색상 규칙과 일치하는지 직접 확인해야 하며 저자는 이에 대해 설명하지 않았습니다; MOSS-Image-SFT 전용으로 학습되었습니다; 기본 모델은 Other로 표기됨; 1개의 민감도 등급 예시가 비공개 상태입니다
- 전체 모델 카드에서는 제어가 너무 경직될 경우 강도를 0.7으로 낮출 것을 권장합니다
- 이 항목은 실행되지 않았습니다
【A】MOSS-Image Segmentation Control · v1.0
LoRA · 신규 모델 · 저자 thedeoxen · 공개일 11-10 16:54 · 다운로드 수 25
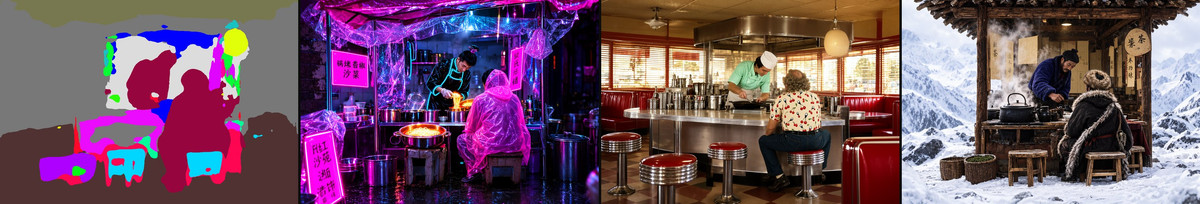
MOSS-Image-SFT용 시맨틱 세그멘테이션 제어 LoRA입니다: 단색으로 칠해진 영역 맵 이미지를 입력하면 각 영역의 경계와 큰 블록 레이아웃을 유지하며, 각 블록이 무엇이 될지는 프롬프트에 따라 결정됩니다.
이미지
3010x512 예시 이미지(https://rh-images-switch.xiaoyaoyou.com/input/openapi/1d671c5e96e589b8e6b0ace802eb1f4d85e921e145b8654217778c09fb763353.jpg)
추천 이유
- 새로운 기능: 선이나 깊이가 아닌 '영역 블록' 단위로 제어하므로, 화면을 인물, 가구, 배경 등 큰 블록으로 먼저 나눈 후 전체 렌더링 스타일을 변경하는 데 적합합니다; 저자는 경계와 큰 덩어리 볼륨이 유지된다고 언급했습니다
- 장면 분할 구도, 컬러 스크립트식 레이아웃, 인물과 가구의 위치를 유지한 채 전체 이미지를 다시 그리는 작업에 적합합니다
- 전처리: 워크플로우는 UniFormer 시맨틱 세그멘테이션을 사용; 학습 이미지는 검은색 미표기 영역 없이 화면 전체가 단색 블록으로 덮여 있습니다; 저자는 블록의 색상은 단지 영역 번호일 뿐 최종 이미지의 색상이 되지 않으며, 재질은 프롬프트에 작성해야 하고 그라데이션과 텍스처는 영역을 혼란스럽게 할 수 있다고 경고했습니다
- ComfyUI 워크플로우 포함; 4500번째 스텝에서 저장, 강도 1.0, 30 스텝, CFG 4, euler + simple
- 무료이며 라이선스가 이미지 생성 및 판매를 허용합니다; 공개 후 4시간 동안 25회 다운로드됨
사용 방법
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA를 UNet에 연결, 강도 1.0
- UniFormer로 화면 전체를 덮는 단색 영역 맵을 생성합니다(검은색 배경이 크게 남지 않도록 함). 이를 유일한 참조 이미지로 Text Encode MOSS-Image Edit에 연결하며, 긍정 및 부정 인코딩의 edit format을 모두 ai-toolkit으로 설정합니다
- 30 스텝, CFG 4, euler + simple; 트리거 워드 없음, 프롬프트에는 각 영역의 주체와 재질을 명확히 작성합니다
리스크 및 제한 사항
- 저자는 배경을 검은색으로 남기는 세그멘테이션 도구는 이 가중치와 잘 맞지 않을 수 있다고 언급하므로, 다른 세그멘테이션 모델로 변경할 때 주의해야 합니다
- 공개 예시 2장, 민감도 등급 예시 1개 비공개; MOSS-Image-SFT 전용으로 학습되었습니다; 기본 모델은 Other로 표기됨
- 전체 모델 카드에서는 제어가 너무 경직될 경우 강도를 0.7으로 낮출 것을 권장합니다
- 이 항목은 실행되지 않았습니다
【A】MOSS-Image Lineart Control · v1.0
LoRA · 신규 모델 · 저자 thedeoxen · 공개일 11-10 16:37 · 다운로드 수 21
MOSS-Image-SFT용 라인아트 제어 LoRA입니다: 검은색 배경 위의 흰색 얇은 선으로 된 라인아트를 입력하면 선의 구조에 따라 생성되며, 채색, 재질 및 스타일은 프롬프트에 따라 결정됩니다.
이미지
1418x512 예시 이미지(https://rh-images-switch.xiaoyaoyou.com/input/openapi/984b0e6b9c051965c08f39a0741c5ef76f24095085ba22e4afc3a068589dc43c.jpg)
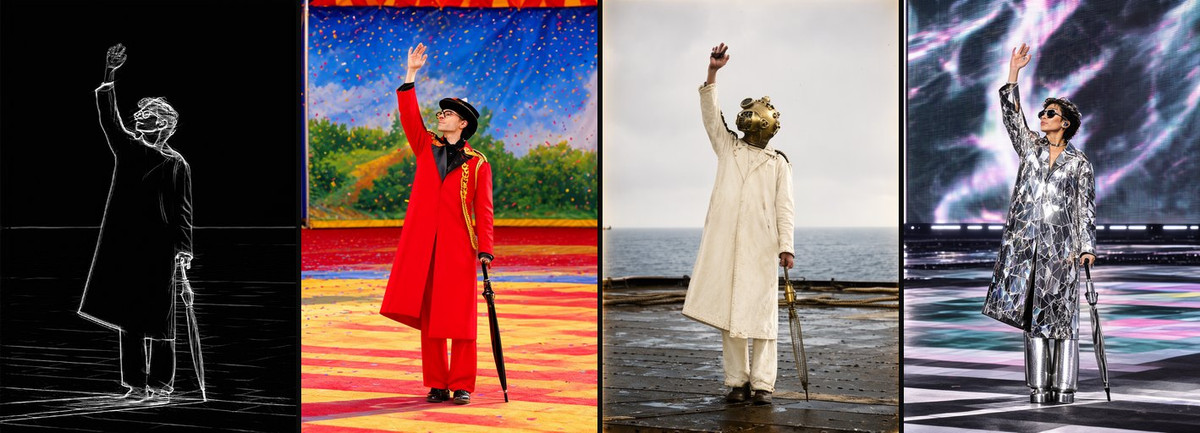
추천 이유
- 새로운 기능: Canny와 Scribble의 중간 단계로, 깨끗한 윤곽선을 따르지만 원본 Canny 이미지의 잡음 점은 포함하지 않습니다; 저자가 나열한 용도는 주로 라인아트 채색입니다
- 라인아트 채색, 디자인 스케치의 최종 이미지화, 사진에서 선 구조를 유지한 후 장면 변경에 적합합니다; 손으로 그린 라인아트와 사진에서 추출한 라인아트 모두 사용 가능하며, 단 선이 가볍고 희소해야 합니다
- 전처리에 주의가 필요합니다: 워크플로우는 Realistic Lineart를 사용하며 coarse 옵션을 활성화합니다. 저자는 이것이 정밀 라인아트 모드보다 학습 이미지와 더 유사하다고 언급했습니다; 흰색 선과 검은색 배경이어야 하며, 검은색 선과 흰색 배경의 라인아트를 가지고 있다면 먼저 반전해야 합니다
- ComfyUI 워크플로우 포함; 5000번째 스텝에서 저장, 강도 1.0, 30 스텝, CFG 4, euler + simple; 3장의 콜라주 예시는 Canny 버전과 동일한 테스트 사진 사용
- 무료이며 라이선스가 이미지 생성 및 판매를 허용합니다
사용 방법
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA를 UNet에 연결, 강도 1.0
- Realistic Lineart(coarse 활성화)로 검은색 배경의 흰색 선 이미지를 생성하여 유일한 참조 이미지로 Text Encode MOSS-Image Edit에 연결하며, 긍정 및 부정 인코딩의 edit format을 모두 ai-toolkit으로 설정합니다
- 30 스텝, CFG 4, euler + simple; 트리거 워드 없음, 프롬프트에는 색상, 재질 및 그림 스타일을 작성합니다
리스크 및 제한 사항
- 저자는 희소한 선이 밀도 높은 스케치보다 학습 데이터에 더 잘 맞다고 언급하며, 라인아트가 너무 밀집된 경우의 성능은 설명하지 않았습니다
- MOSS-Image-SFT 전용으로 학습되었습니다; 기본 모델은 Other로 표기됨; 1개의 민감도 등급 예시가 비공개 상태입니다; 이 그룹은 다운로드 수가 가장 적습니다(21회)
- 전체 모델 카드에서는 제어가 너무 경직될 경우 강도를 0.7으로 낮출 것을 권장합니다
- 이 항목은 실행되지 않았습니다
【A】MOSS-Image Canny Control · v1.0
LoRA · 신규 모델 · 저자 thedeoxen · 공개일 11-10 16:29 · 다운로드 수 23
MOSS-Image-SFT용 Canny 엣지 제어 LoRA입니다: 검은색 배경 위의 흰색 선으로 된 Canny 엣지 이미지를 입력하면 물체의 윤곽, 구도 및 세부 가장자리를 고정하며, 재질, 색상 팔레트 및 스타일은 프롬프트에 맡깁니다.
이미지
1418x512 예시 이미지(https://rh-images-switch.xiaoyaoyou.com/input/openapi/6cc51f430446b1742d834fa4b46fa9034a66e6c491afd6f79df1f1ef67ff6dce.jpg)
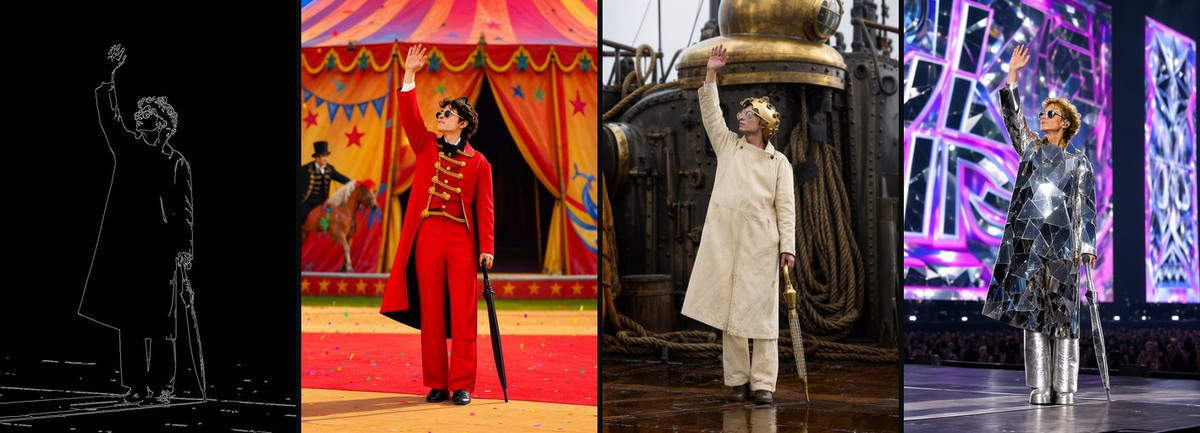
추천 이유
- 새로운 기능: 같은 저자의 LoRA 시리즈 중 가장 제약이 엄격한 모델로, 세밀한 가장자리까지도 추적합니다. 저자는 이를 '윤곽선은 유지하고 색상과 재질을 변경'하는 용도로 정의했으며, 윤곽선이 반드시 고정되어야 하는 레이아웃 연구에 적합합니다
- 사진의 스타일 변환, 동일한 구도로 재질 변경하여 다시 그리기, 레이아웃 초안 생성에 사용: 입력은 사진 또는 기존 이미지이며, 먼저 Canny 엣지를 추출한 후 생성합니다
- 전처리가 구체적으로 명시됨: comfyui_controlnet_aux의 Canny Edge 사용, 임계값 low 100 / high 200; 저자는 결과가 노이즈 하나하나까지 과도하게 따라간다면 임계값을 높여 엣지를 더 깔끔하게 만들라고 조언합니다
- ComfyUI 워크플로우 포함; 4500단계에서 저장, 강도 1.0, 30 스텝, CFG 4, euler + simple; 3장의 '컨트롤 이미지 + 3개의 프롬프트' 콜라주 예시 제공, 같은 저자의 Normal / Scribble / Lineart 모델과 동일한 서커스 단장 테스트 사진을 사용하여 비교 가능
- 무료이며, 라이선스상 이미지 생성 및 판매가 허용됨; 공개 후 4시간 동안 23회 다운로드
사용 방법
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq 텍스트 인코더, 유형 moss_image + flux2-vae_small), LoRA는 UNet에 연결, 강도 1.0
- Canny Edge 전처리 (low 100 / high 200)로 검은 배경에 흰색 선 그림을 생성하여 유일한 참조 이미지로 사용하며, Text Encode MOSS-Image Edit에 연결, 긍정 및 부정 인코딩의 edit format 모두 ai-toolkit으로 설정
- 30 스텝, CFG 4, euler + simple; 트리거 워드 없음, 프롬프트에는 새로운 재질, 색상 구성 및 장면을 작성
리스크 및 제한 사항
- Canny 이미지가 복잡할수록 원본 이미지의 디테일에 더 강하게 묶이며, 프롬프트로 변형할 수 있는 여지가 줄어듭니다. 큰 형태만 유지하려면 Scribble 또는 Lineart 계열을 사용해야 합니다
- MOSS-Image-SFT 전용으로 학습되었으며, 다른 기본 모델/정밀도에 대해서는 저자가 언급하지 않았습니다. 기본 모델은 Other로 표기됨; 1개의 민감도 등급 예시는 숨겨져 있음
- 전체 모델 카드에서는 제어가 너무 경직될 경우 강도를 0.7으로 낮추라고 권장합니다
- 이 항목은 실행되지 않았습니다
【A】MOSS-Image Depth Control · v1.0
LoRA · 신규 모델 · 저자 thedeoxen · 공개 11-10 16:25 · 다운로드 22
MOSS-Image-SFT용 깊이 제어 LoRA: 근경은 하얗고 원경은 검은 회색조 깊이 맵을 입력하여 전경과 배경의 거리 및 공간적 배치를 유지하고, 피사체와 스타일은 프롬프트에 맡깁니다.
예시 이미지
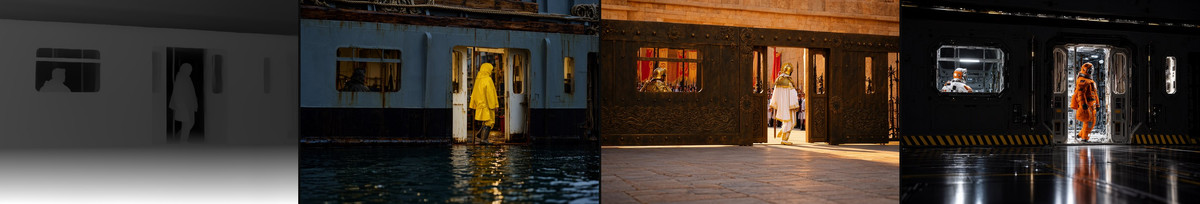
추천 이유
- 새로운 기능: '누가 가깝고 누가 먼지'와 카메라의 심도만 고정하며 모든 엣지를 고정하지는 않습니다. 저자는 '윤곽선보다 카메라의 심도가 더 중요한' 상황에 적합하다고 설명합니다. 이는 공식적인 MOSS color/depth 어댑터가 아니라 같은 저자의 편집형 LoRA임을 주의해야 합니다
- 같은 카메라 위치에서 스타일을 변경하여 장면을 재구성하거나, 전경 피사체와 배경을 분리한 후 재질을 변경하거나, 제품 및 실내처럼 명확한 근경 피사체가 있는 레이아웃에 사용
- 전처리: 워크플로우에서 Depth Anything V2 (depth_anything_v2_vitl)을 사용하며, 근경은 하얗고 배경은 검은색으로 처리됩니다. 저자는 반전된 깊이 맵을 사용하지 말라고 특별히 경고하며, 그렇지 않으면 LoRA와 충돌할 수 있다고 합니다
- ComfyUI 워크플로우 포함; 5000단계에서 저장, 강도 1.0, 30 스텝, CFG 4, euler + simple; 저자는 넓고 평평한 깊이 영역이 프롬프트에 더 많은 텍스처 공간을 제공한다고 설명합니다
- 무료이며, 라이선스상 이미지 생성 및 판매가 허용됨; 3개의 좋아요
사용 방법
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA는 UNet에 연결, 강도 1.0
- Depth Anything V2 vitl로 회색조 깊이 맵 생성 (근경은 하얗고 원경은 검게, 반전 금지), 유일한 참조 이미지로 사용하며 Text Encode MOSS-Image Edit에 연결, 긍정 및 부정 인코딩의 edit format 모두 ai-toolkit으로 설정
- 30 스텝, CFG 4, euler + simple; 트리거 워드 없음, 프롬프트에는 피사체, 재질 및 스타일을 작성
리스크 및 제한 사항
- 공개된 예시는 1장의 콜라주뿐이며, 추가로 4개의 민감도 등급 예시가 숨겨져 있어 이 그룹 내에서 공개된 증거가 가장 적습니다
- 공식 깊이 어댑터와 비교하여 우열이 어떠한지에 대해 저자는 언급하지 않았습니다. MOSS-Image-SFT 전용으로 학습되었으며, 기본 모델은 Other로 표기됨
- 전체 모델 카드에서는 제어가 너무 경직될 경우 강도를 0.7으로 낮추라고 권장합니다
- 이 항목은 실행되지 않았습니다
주목할 만한 항목 (10)
【B】AG: Naberius - Grumpy Niji Boys · MOSS-Image
LoRA · 포팅 · 저자 Azriaelis · 공개 11-10 09:10 · 다운로드 27
'Ars Goetia' 시리즈 중 Naberius 항목의 MOSS 버전: Niji 스타일의 반실사적이며 남성 캐릭터 중심의 화풍 LoRA (제목은 Grumpy Niji Boys).
예시 이미지
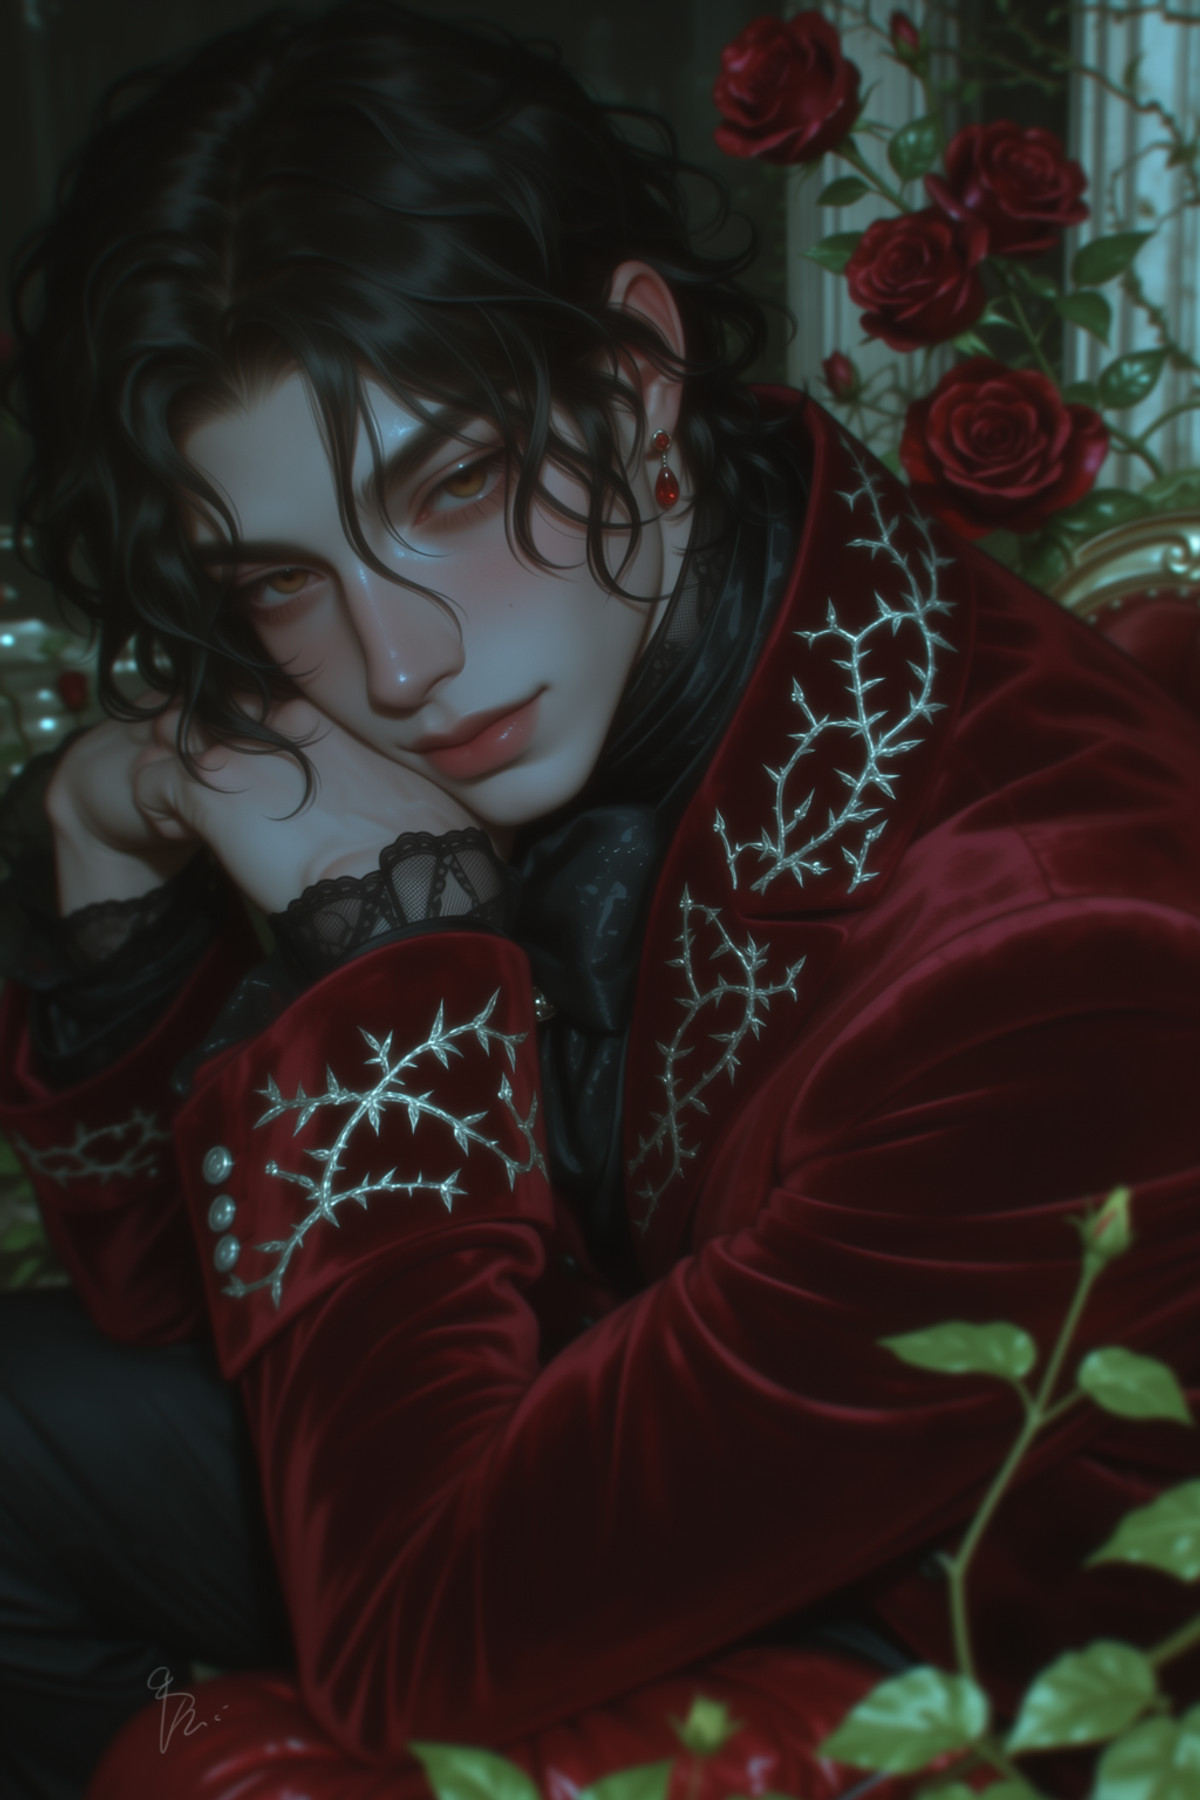
【B】HaDeS MOSS Suite Workflows · Turbo Image to Image v0.1
워크플로우 · 버전 업데이트 · 저자 _HaDeS_ · 공개 11-10 17:33 · 다운로드 24
HaDeS MOSS Suite 워크플로우 컬렉션의 새로운 항목: 프롬프트 강화 노드와 HaDeS 가속 LoRA가 포함된 MOSS 이미지 투 이미지 ComfyUI 워크플로우 (JSON 파일이며 새로운 가중치가 아님).
예시 이미지
【B】V67 Twins and Mirror · V1 MOSS
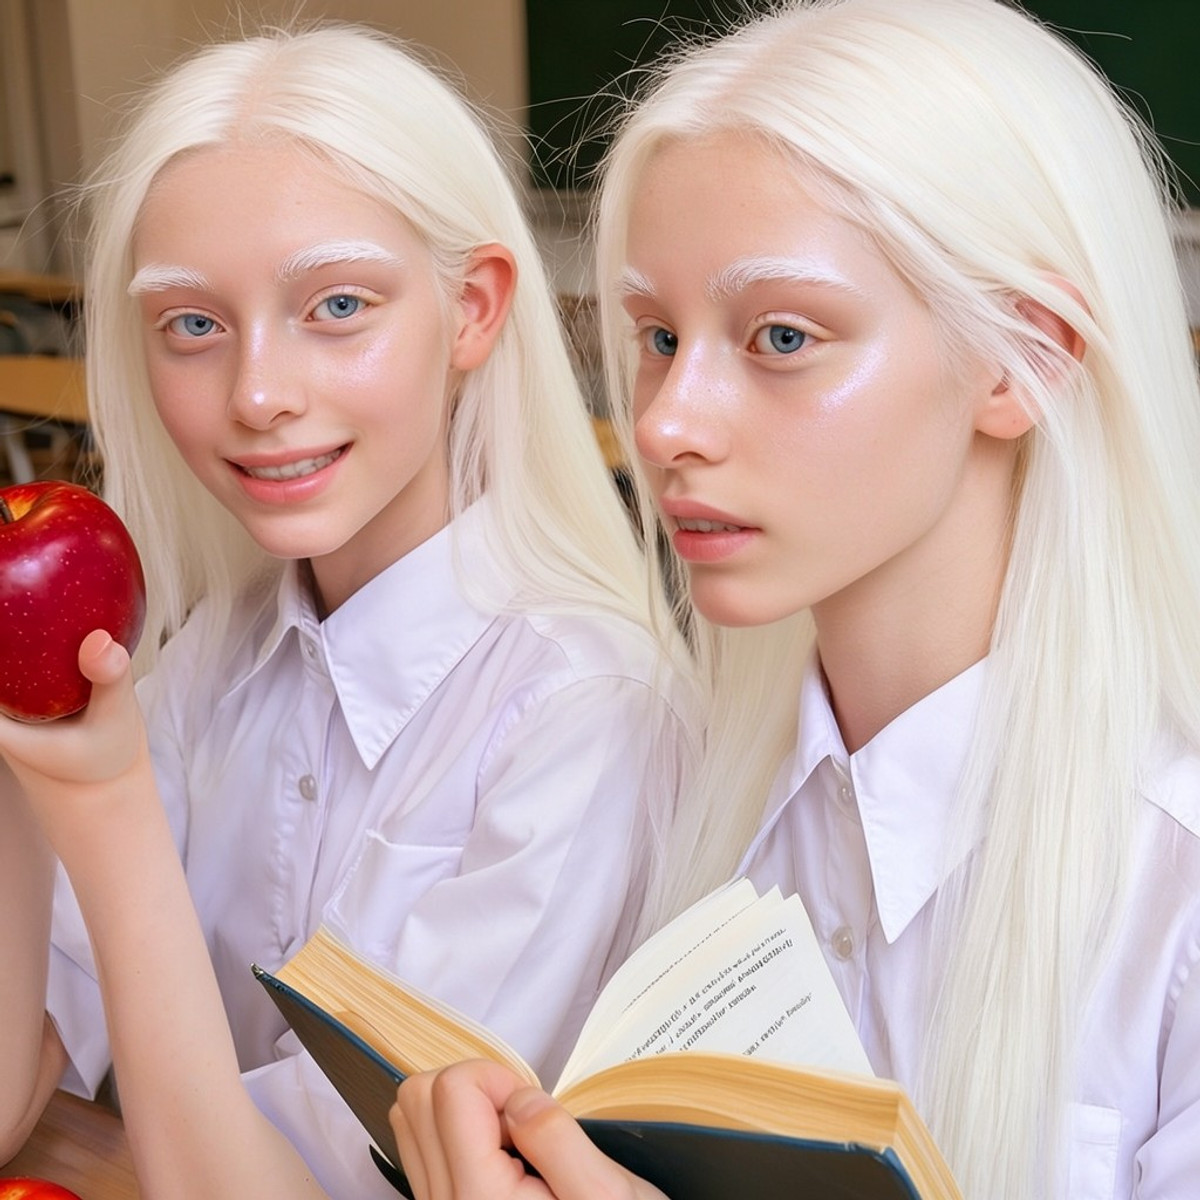
LoRA · 포팅 · 저자 angelomaiota · 공개 11-10 17:57 · 다운로드 23
쌍둥이 및 거울 LoRA의 MOSS 버전: 일란성/이란성 쌍둥이, 거울 속 반영, 물웅덩이 반영 등 '한 사람이 두 몸'이거나 대칭 구도의 이미지를 생성합니다.
예시 이미지
【B】One obsession_MOSS · SFT v1
기본 모델 / 체크포인트 · 버전 업데이트 · 저자 maxfeifei8 · 공개 11-10 19:20 · 다운로드 9 · 유료
MOSS 기본 모델의 One obsession 파인튜닝 두 번째 버전인 SFT v1: 전체 기본 모델 가중치 세트 (INT8 및 BF16 두 가지), 이름상으로는 SFT 시리즈이며 이전 버전은 BASE v1입니다.
예시 이미지
【B】V67 Italian Villages · V1 MOSS
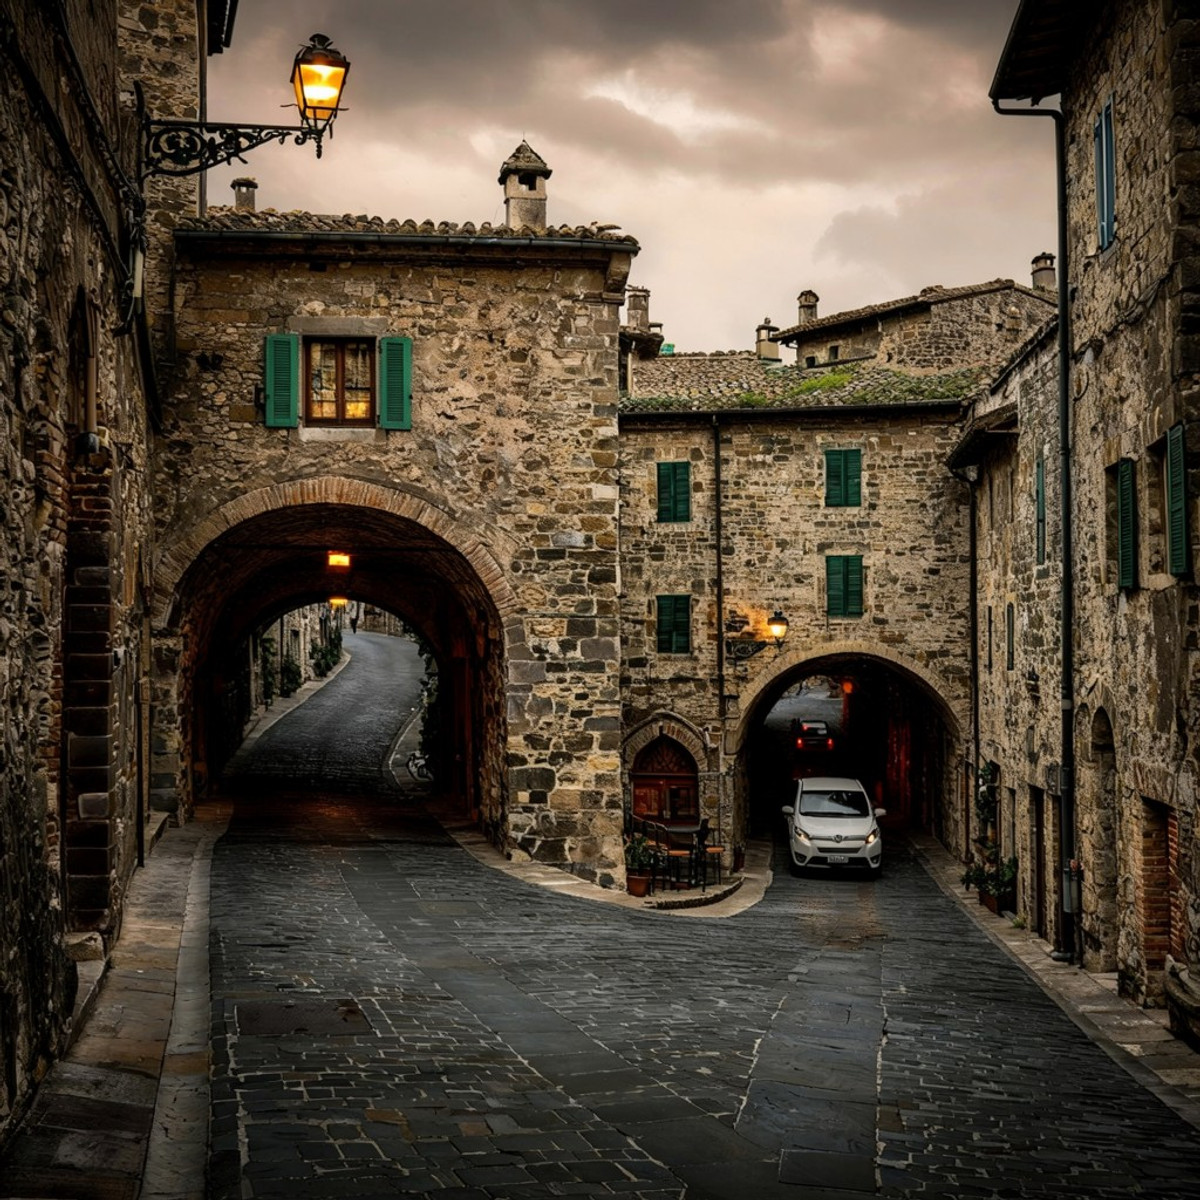
LoRA · 포팅 · 저자 angelomaiota · 공개 11-10 15:11 · 다운로드 21
이탈리아 마을 풍경 LoRA의 MOSS 버전: 돌집, 좁은 골목, 점토 지붕, 산 정상에서의 조망 및 황금빛 광선을 포함하며, 저자는 카날레토 스타일의 풍경화와 사실적인 건축 사진이 융합된 것이라고 설명합니다.
예시 이미지
【B】Chenbin (Beggarticks) Style | MOSS Image LoRA · v1.0
LoRA · 신규 모델 · 저자 NO83 · 공개 11-10 20:46 · 다운로드 7
화가 'Beggarticks(鬼针草)'의 화풍을 모방한 MOSS 전용 LoRA: 저자는 스타킹의 질감 표현이 매우 뛰어나며 머리카락은 보통이라고 설명합니다.
예시 이미지
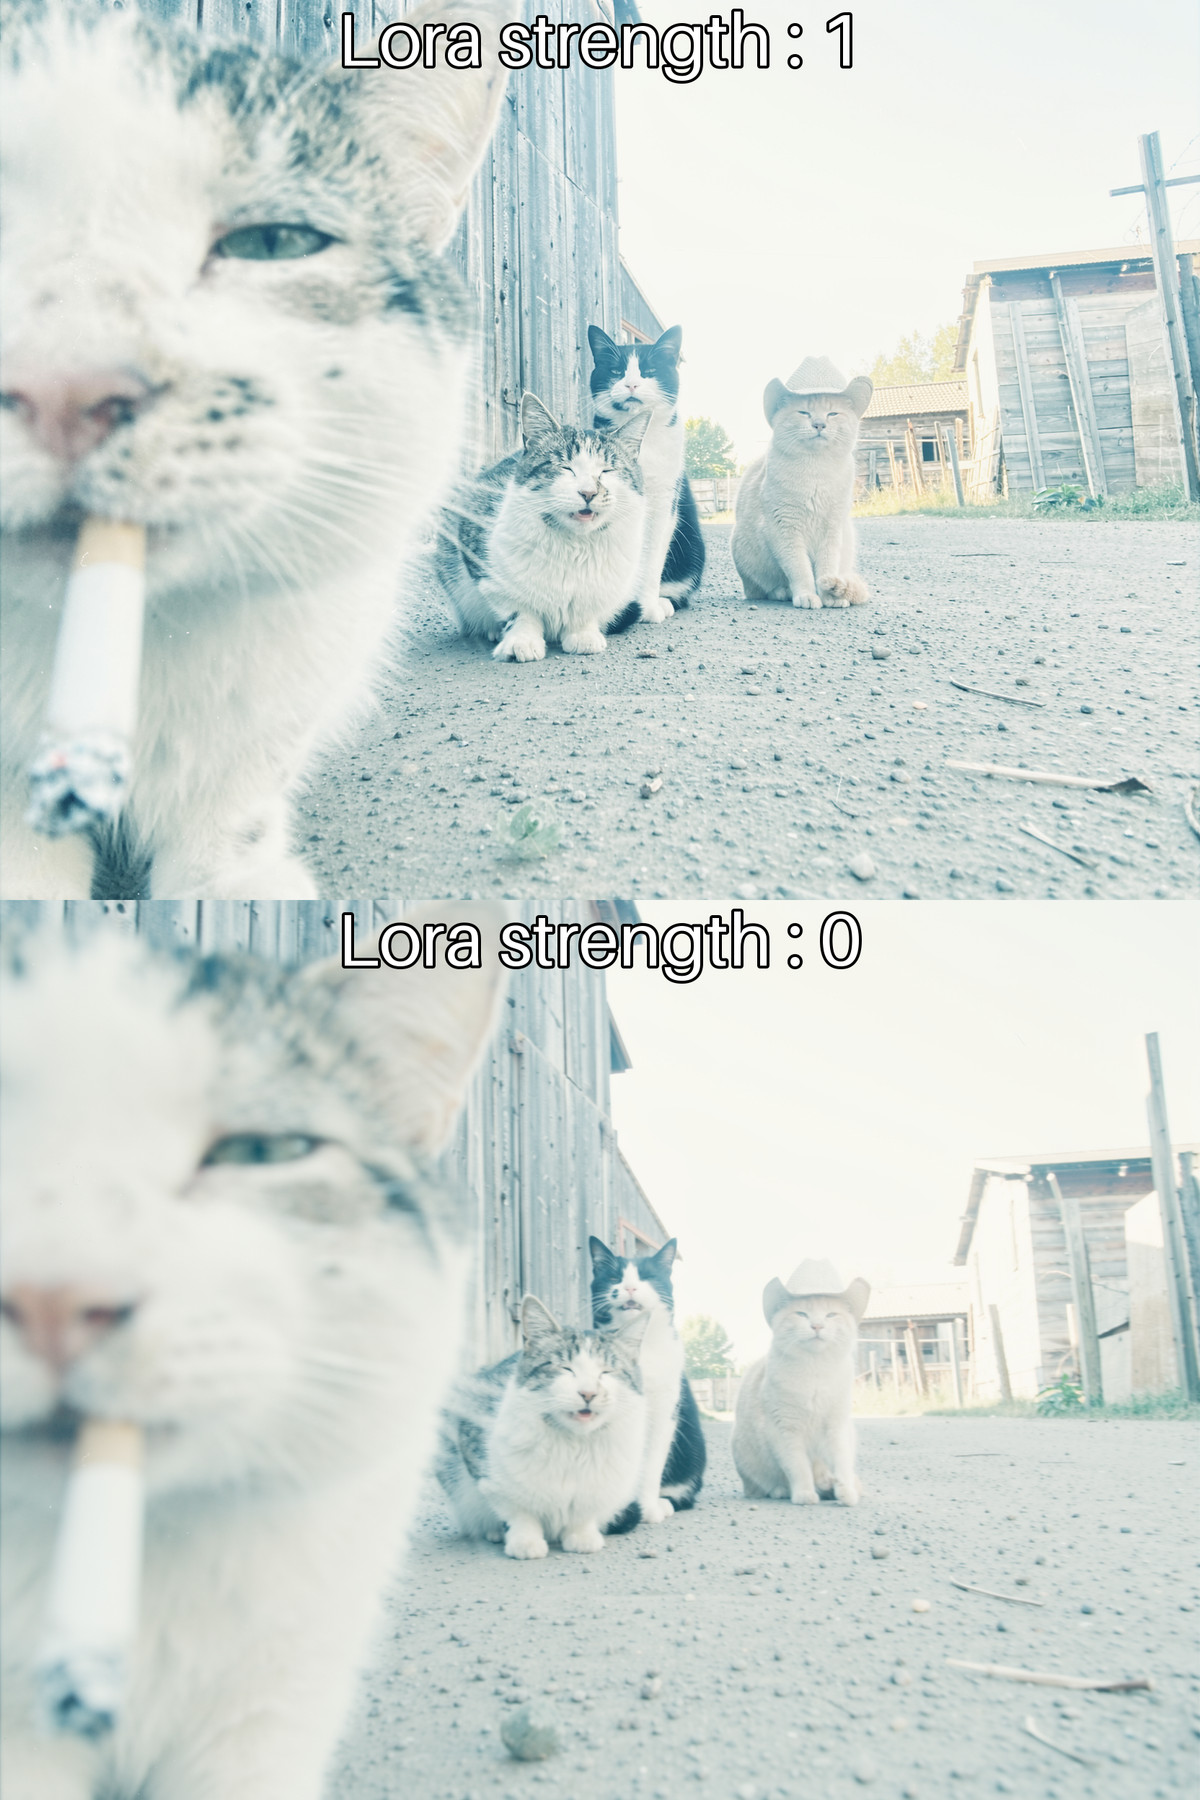
【B】Kromoss slider: blurry to sharp · v1
LoRA · 신규 모델 · 저자 Generated_Good · 공개 11-10 18:27 · 다운로드 61
선명도 슬라이더 LoRA: Kromoss (MOSS-Image-Base의 전체 파인튜닝)에서 학습되었으며, 긍정 및 부정 강도를 조절하여 전경과 배경의 흐림 정도를 제어합니다. Kromoss에서 자주 발생하는 이미지 흐림 문제를 해결하기 위한 목적입니다.
예시 이미지
【B】Glazeline Style (釉光细绘) · moss-v1.0
LoRA · 신규 모델 · 저자 soda_Cookie · 공개 11-10 20:04 · 다운로드 12
'글레이즈라인(Glazeline)'이라는 이름의 일러스트 스타일 LoRA에 대해, 저자는 트리거 워드, 전체 예시 프롬프트 및 네거티브 프롬프트를 제공했습니다.
예시 이미지
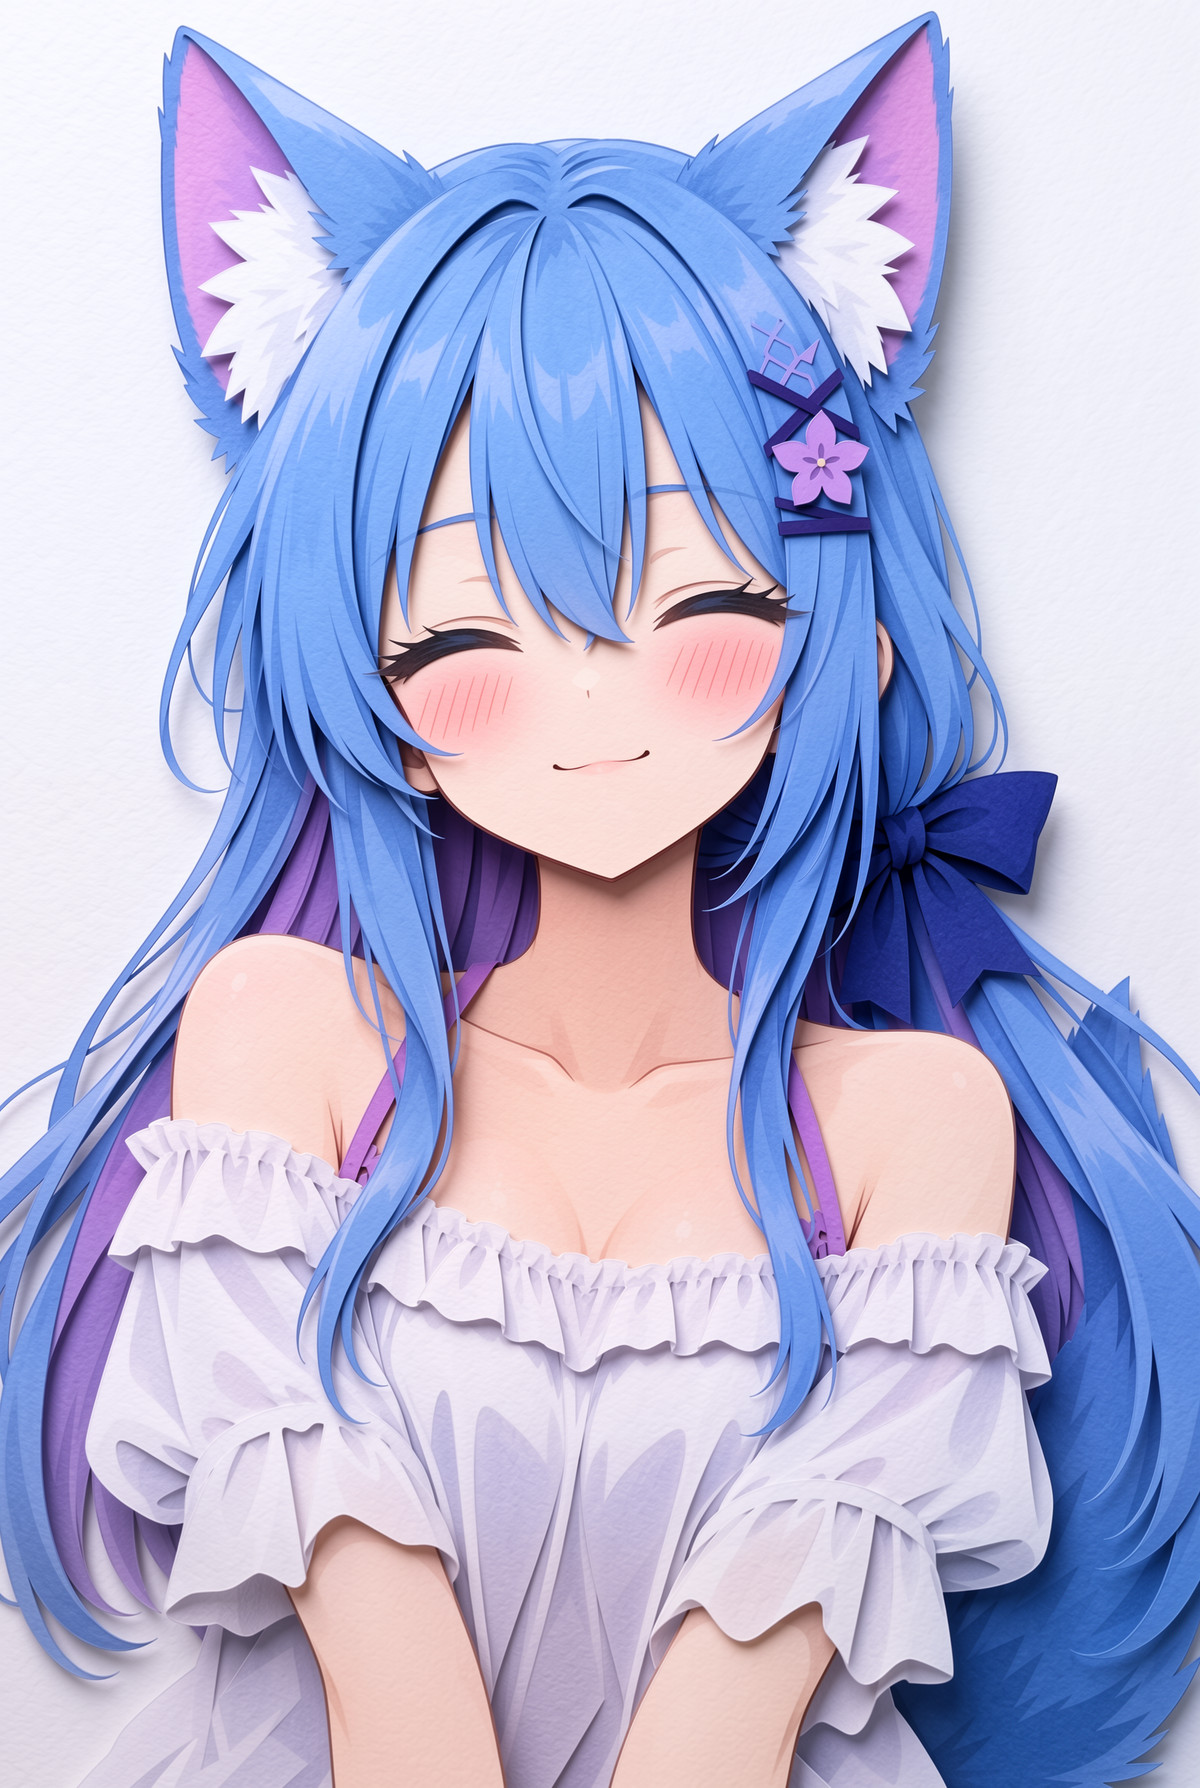
【B】종이 조각/종이 인형 · v1.0
LoRA · 포팅 · 저자 YuChuXi · 공개 11-10 13:54 · 다운로드 47
종이 조각/종이 인형 스타일 LoRA의 MOSS 버전: 이미지를 겹겹이 쌓아 올린 종이 조각 일러스트처럼 만듭니다.
예시 이미지
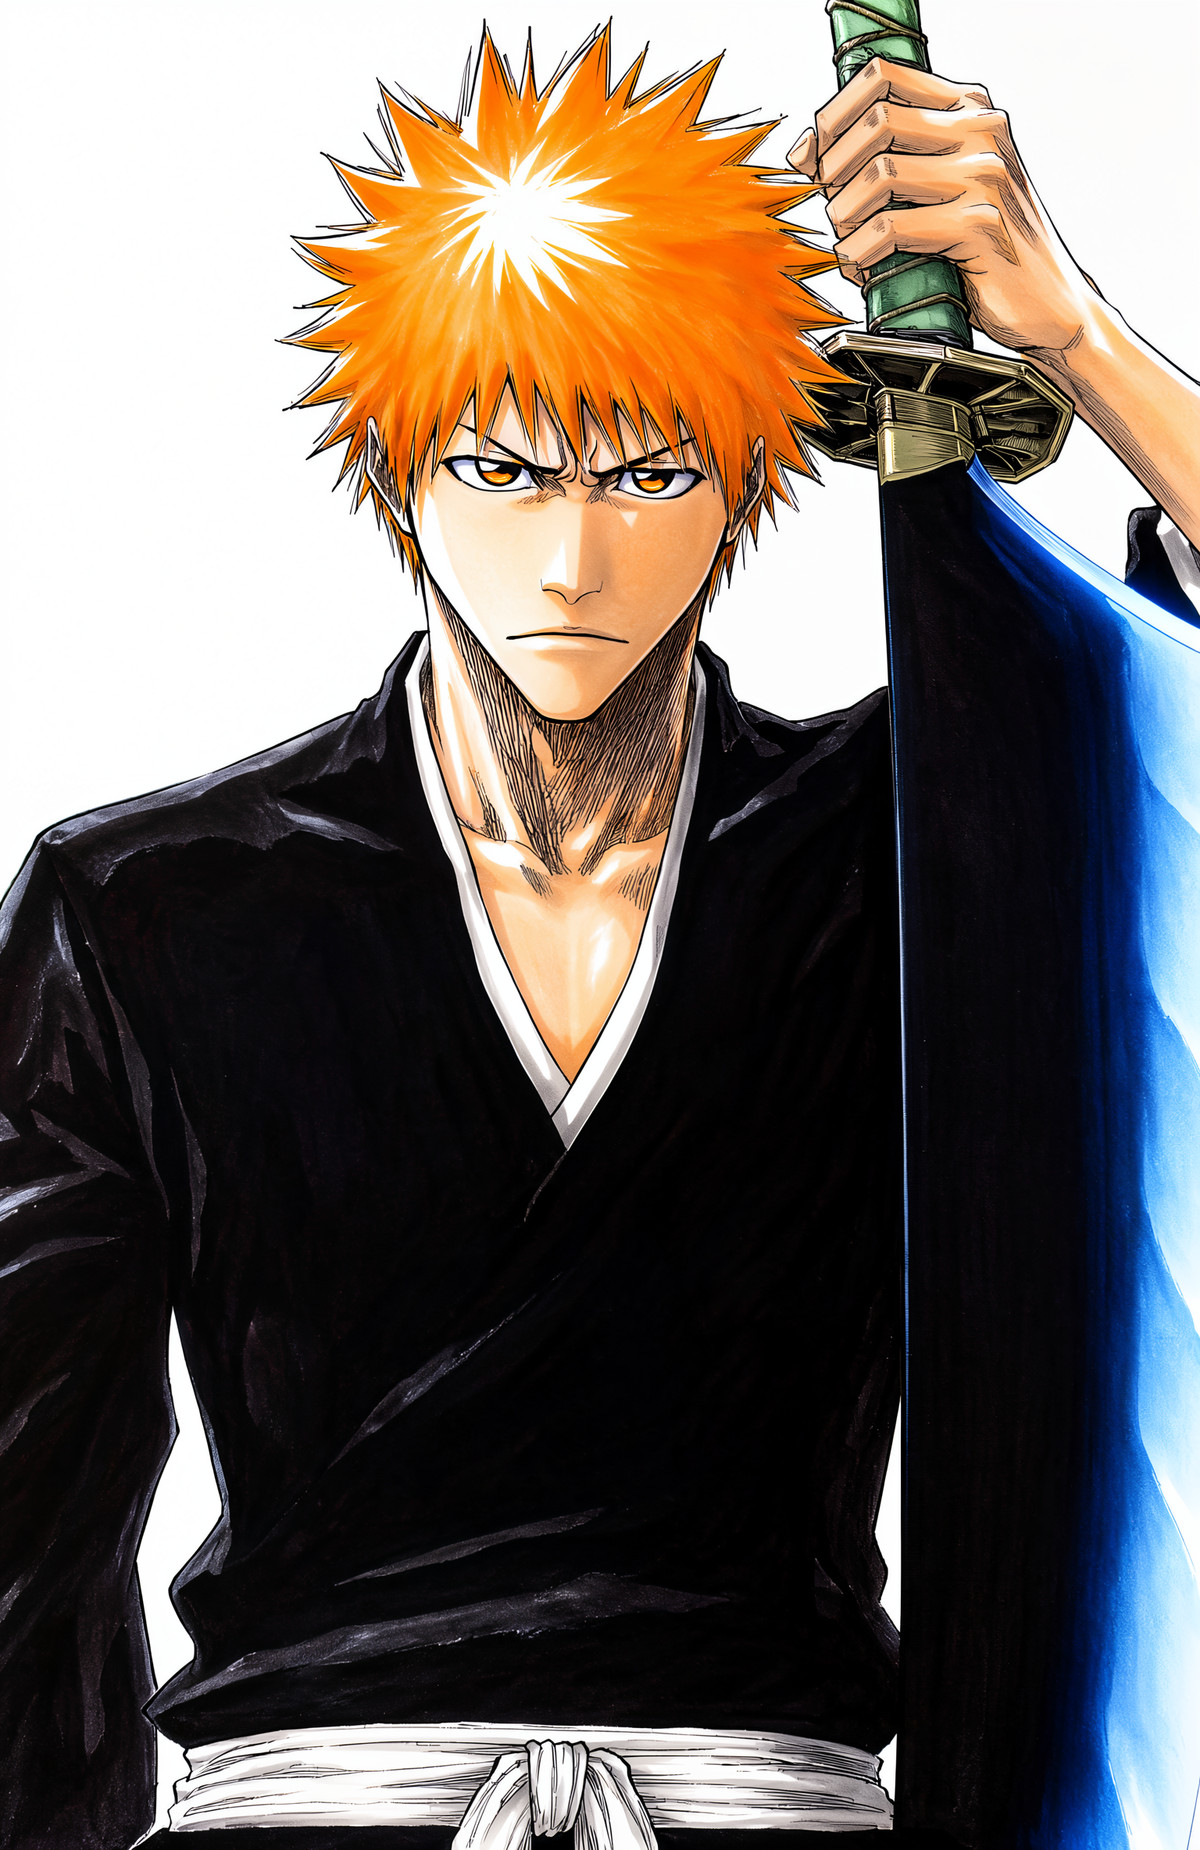
【B】18 in 1, 《Bleach》/《블리치》, Tite Kubo/구보 타이테 - Artist Style · MOSS_v1.0
LoRA · 포팅 · 저자 flyx3 · 공개 11-10 12:10 · 다운로드 3 · 유료
《블리치》의 작가 구보 타이테의 만화 화풍 LoRA의 MOSS 버전으로, 동일한 파일 내에서 해당 작품의 대부분의 캐릭터를 생성할 수 있습니다.
예시 이미지
참고용만 수록 (14)
- MaleBot Style · Moss v1 — LoRA: MOSS 버전의 스타일 LoRA로, 채팅봇의 남성 캐릭터 표지에서 흔히 볼 수 있는 그림체(저자는 niji와 유사하다고 언급)를 모방합니다.
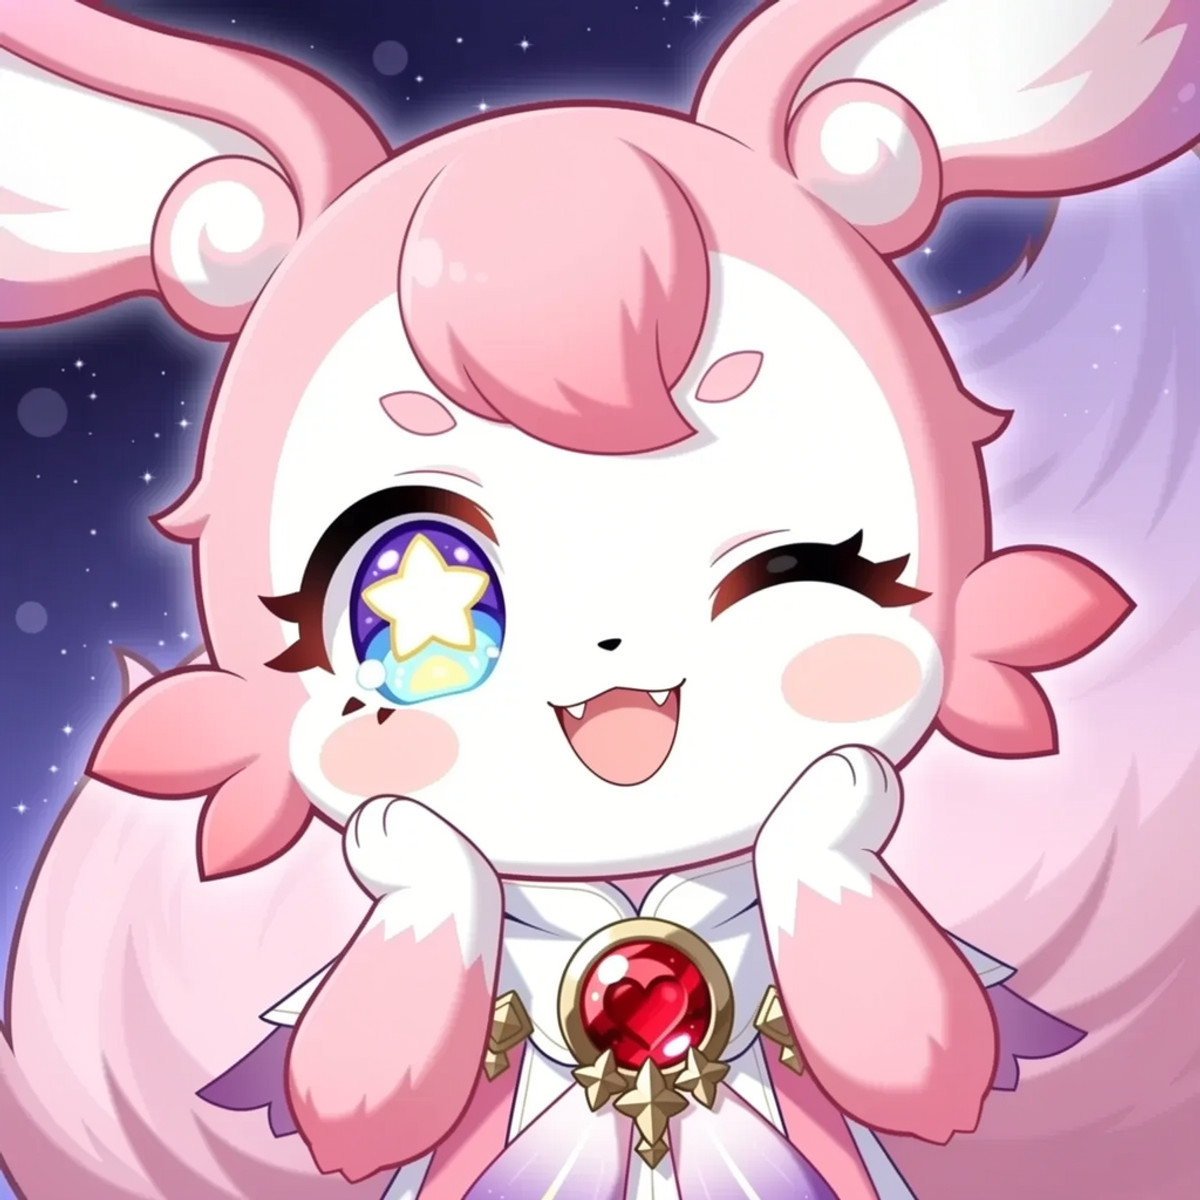
- Mem (Honkai: Star Rail) [Illustrious/pony/moss] · MOSS — LoRA: 《붕괴: 스타레일》의 캐릭터 '메무(Mem, 분홍색 털복숭이 작은 생물)'의 캐릭터 LoRA의 MOSS 버전입니다.
- huashijw/화사JW | Style · MOSS(test) — LoRA: 화가 '화사JW(huashijw)'의 귀여운 계열 2D 여성 그림체를 모방한 스타일 LoRA의 MOSS 테스트 버전입니다.
- Takorin Style | ILXL & Anima · Moss v0.1 — LoRA: 화가 Takorin(namako8982)의 2D 그림체 LoRA의 MOSS 테스트 버전 v0.1입니다.
- Francesca · MossImage — LoRA: MisterMR 시리즈의 가상 인물 Francesca(토스카나 출신 '뮤즈' 설정)의 인물 LoRA의 MOSS 버전입니다.
- xKlara · MOSS Image — LoRA: AI로 생성된 오리지널 여성 인물 xKlara(짙은 갈색 머리, 부드러운 이목구비)의 인물 LoRA로, MOSS 버전과 같은 페이지의 Krea 2 버전은 동일한 데이터셋으로 학습되었습니다.
- Echidna - MOSS · Echidna — LoRA: 《Re: 제로부터 시작하는 이세계 생활》의 캐릭터 에키드나(Echidna)의 캐릭터 LoRA로, 저자는 외모와 의상을 항목별로 세분화한 상세한 설명을 제공했습니다.
- Frankie NordhavenLove · MossImage — LoRA: 동일한 얼굴로 일관된 이미지를 생성하기 위해 사용된 가상 북유럽 여성 캐릭터의 인물 LoRA입니다.
- jun navigavi style · v1.0 — LoRA: 화가 jun navigavi의 그림체를 모방한 2D 일러스트 LoRA입니다.
- A style lora by Ryia | 2 · v1.1 — LoRA: 저자가 자신의 NAI v5로 생성한 이미지로 학습한 2D 그림체 LoRA로, 이 버전은 Moss-heal에서 재학습되었습니다.
- 량우/량향/Ryohka/Suzuya · Runs_1_st9000 — LoRA: 2D 캐릭터 '량향 / Ryohka / Suzuya'의 MOSS-Image-SFT 캐릭터 LoRA로, 이는 동일 학습 과정의 최종 9000단계 체크포인트입니다. 예시는 보라색 긴 곱슬머리, 초록색 눈, 흰색 세일러복을 입은 소녀입니다.
- ૮꒰ ˶• ༝ •˶꒱ა ♡ · v1 — LoRA: 저자가 스스로 '2000년대 레트로 애니메이션' 그림체라고 부르는 LoRA로, 정사각형 예시 이미지를 사용합니다.
- YD style · v1.1 — LoRA: YD라는 이름의 그림체 LoRA의 두 번째 버전으로, 모델 카드에는 트리거 워드만 포함되어 있습니다.
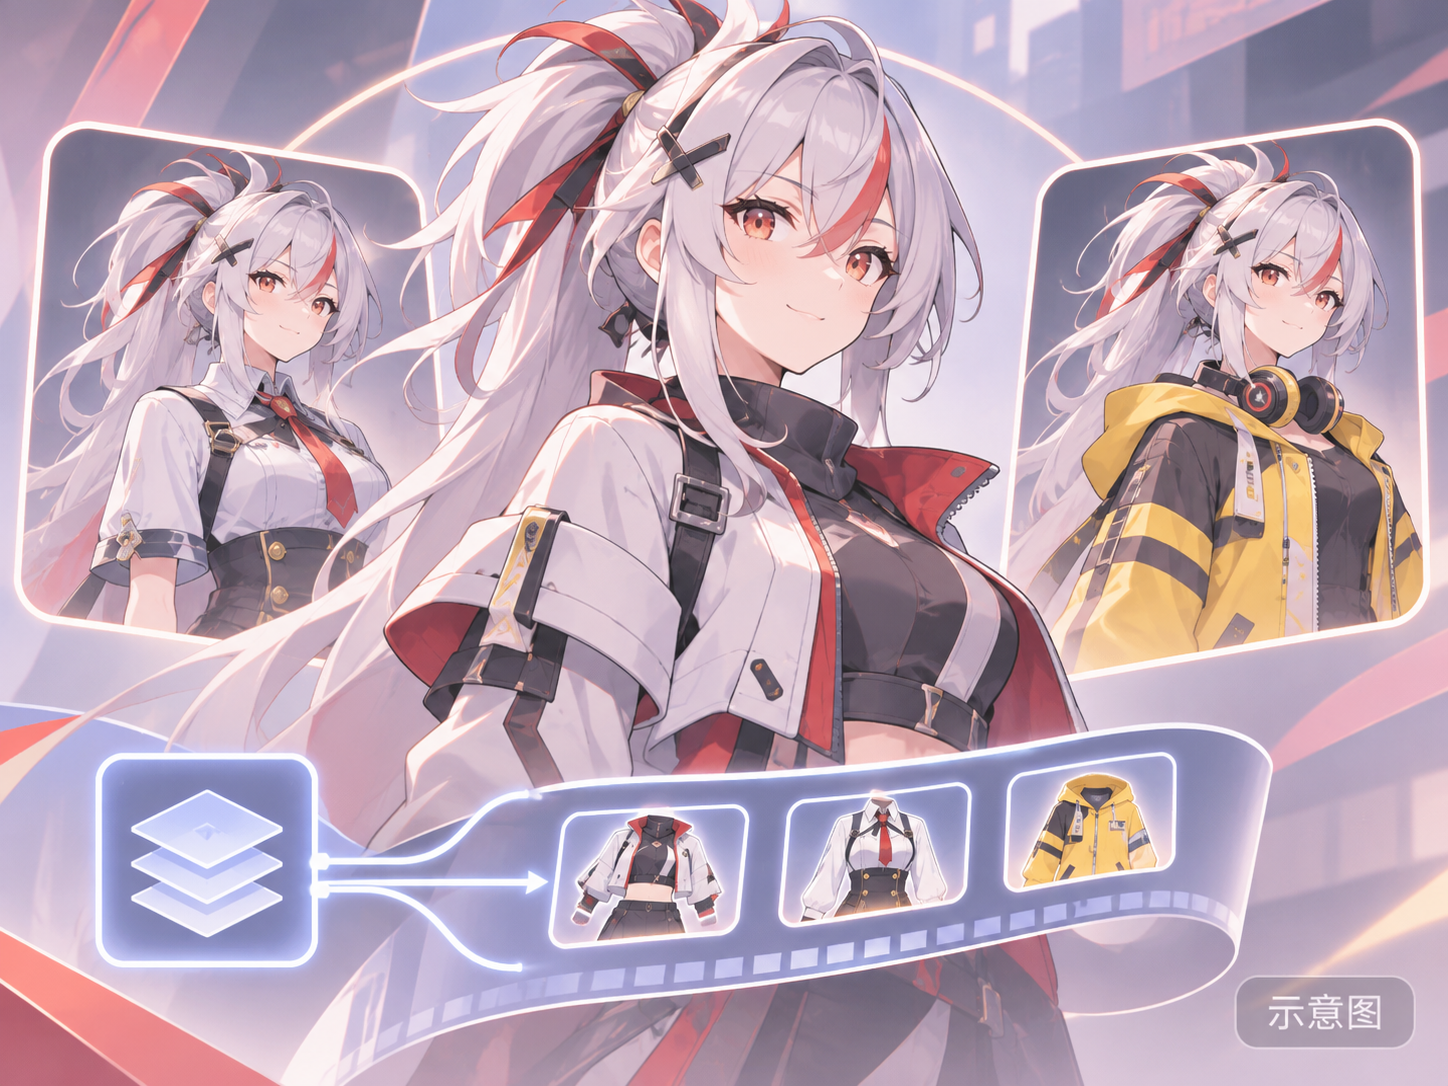
- Phoenix Reffaella 피오니 레파엘라, 3 Outfits — Zenless Zone Zero 젠레스 존 제로 [Anima+Illustrious+MOSS] · v1.0 MOSS Image — LoRA: 《젠레스 존 제로》 시즌 3 캐릭터 Phoenix의 캐릭터 LoRA의 MOSS 버전으로, 하나의 파일에 세 가지 의상이 포함되어 있습니다.
데이터: Civitai 공개 API(기본 모델 MOSS Image), 수집 기간 11-10 08:31 → 11-10 21:01(베이징 시간). 추천 이유는 편집자 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.