AI-радар Чжэньчжэнь · MOSS Image · Вечерний выпуск 2026-11-10
В этом выпуске 35 новых версий: настоятельно рекомендуется 2 · рекомендуется 9 · стоит обратить внимание 10 · включено только 14
Заметка редактора В этом выпуске рассмотрено 44 новых версий MOSS: 2 категории S, 9 категории A, 10 категории B, 14 категории C, исключено 9. Главная рекомендация — версия MOSS для LoRA Ad Infinitum в стиле ретро-рекламы на всю страницу: превращает изображение в старинные товарные карточки, плакаты и журнальную рекламу, умеет писать заголовки с налетом эпохи по кавычкам, указаны триггерные слова, сила, количество шагов, CFG и правила верстки; в ту же категорию S попала LoRA управления позами от thedeoxen, которая использует скелетные карты DWPose, чтобы заставить новых персонажей принимать те же позы, а LoRA управления Canny, контурными линиями, граффити, глубиной, нормалями и сегментацией от того же автора отнесены к категории A. Также в категорию A попали фоновые сцены коридора из FGO, стиль скриншотов аниме v2, реалистичные фото, снятые на телефон, и другие; множество LoRA персонажей / стилей с описанием в одну-две фразы и платные ранние версии LoRA персонажей отнесены к категории C. Из 8 промежуточных снимков шагов LoRA персонажей Liangwu сохранена только финальная версия st9000, а версия Ceiling Fisheye Cam для Krea2 — это веса Krea 2, ошибочно помеченные как MOSS, оба варианта исключены.
Настоятельно рекомендуется (2)
【S】Ad Infinitum - Krea 2 · Classic - MOSS
LoRA · Порт · Автор AriaMaiven · Выпущено 11-10 10:48 · Загрузок 50
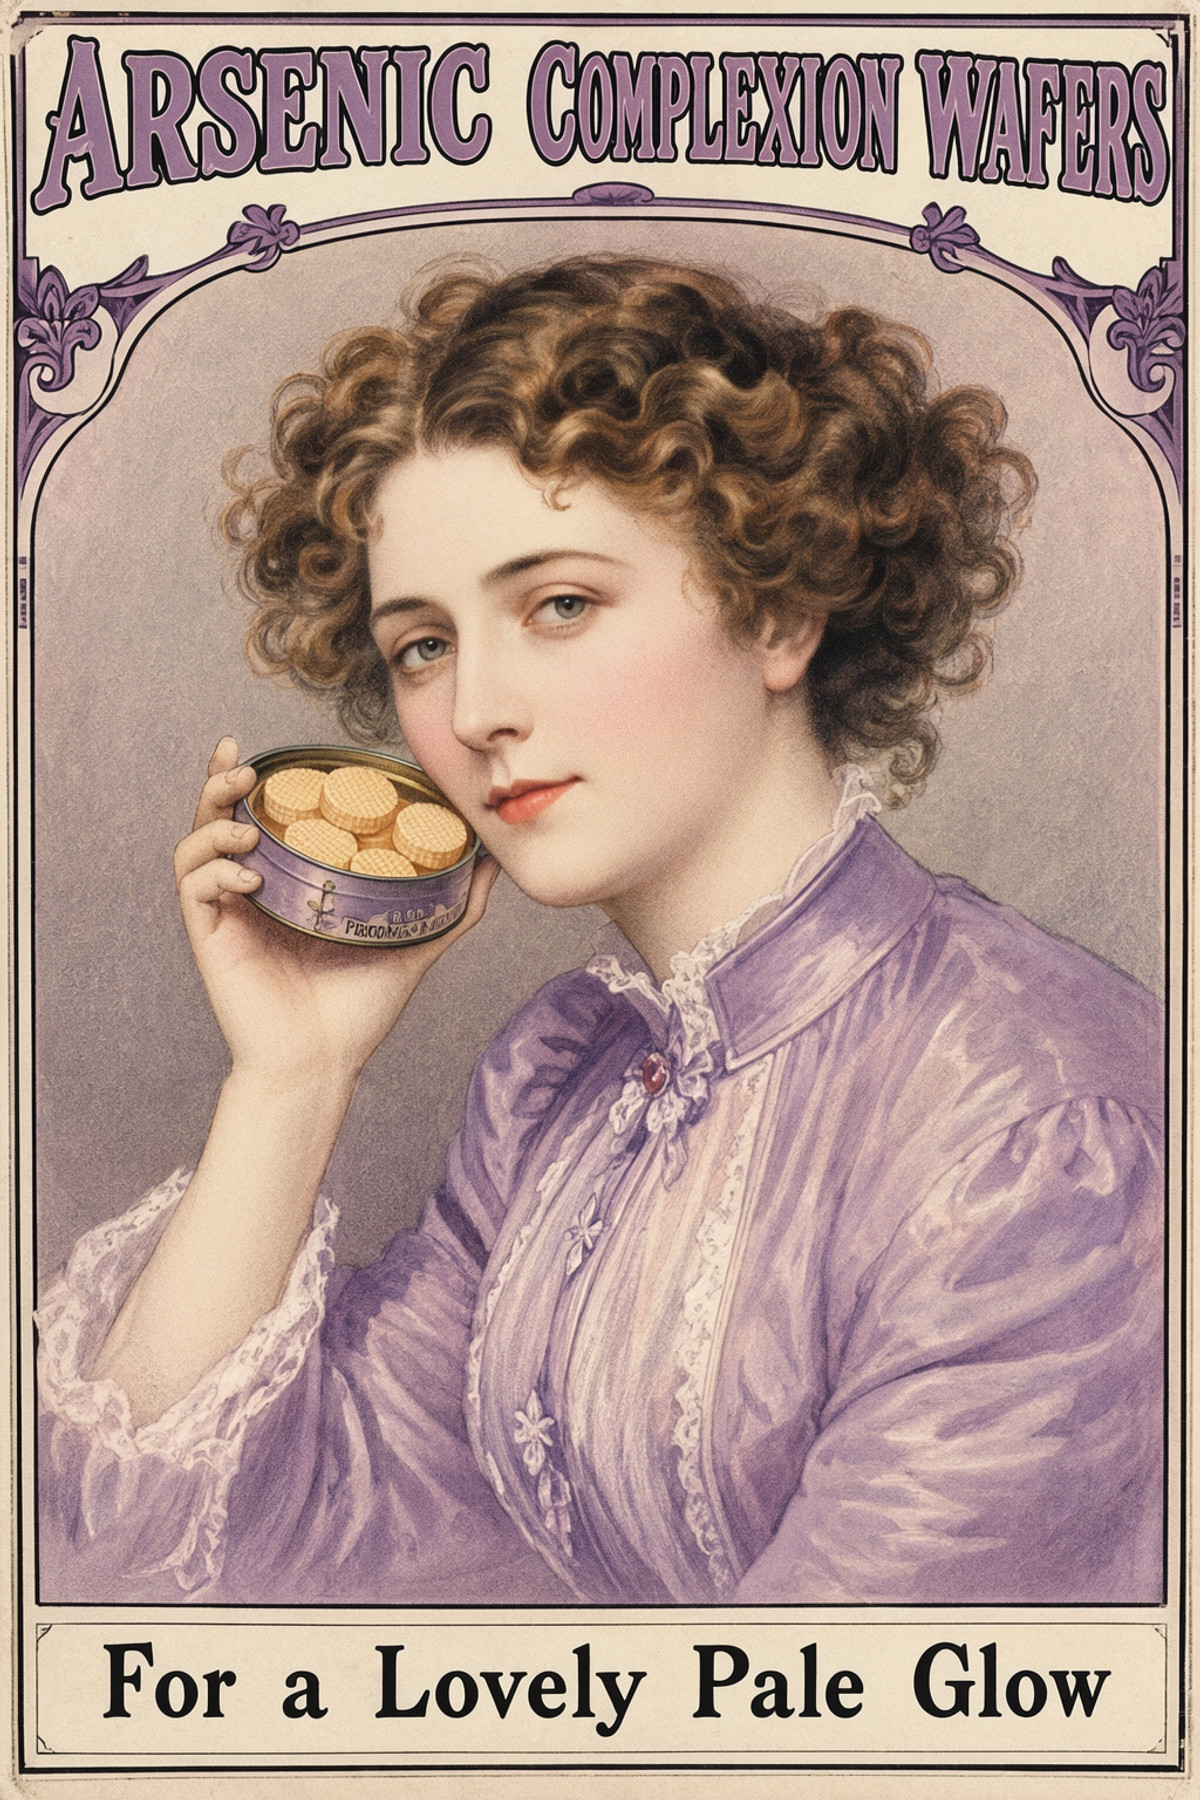
Версия MOSS (Classic) для LoRA в стиле ретро-рекламы на всю страницу: превращает изображение в рекламу на всю страницу в стиле товарных карточек, плакатов и журнальной рекламы 1885–1948 годов с пуантилистской раскраской, обводкой тушью и кремовой бумажной поверхностью, а также умеет писать старинные заглавные заголовки согласно промпту.
Главная рекомендация в этой группе: уникальное направление (реклама на всю страницу, а не просто ретро-фильтр), указаны все параметры: триггерные слова, сила, количество шагов, CFG, размер и правила верстки, порог входа низкий.
Иллюстрации
Причины рекомендации
- Порт: на той же странице уже есть версии Classic и Future Vintage для Krea 2, всего 303 загрузок на странице модели; версия MOSS обучена на базе MOSS Base с использованием того же набора из 46 изображений товарных карточек / плакатов / журнальной рекламы из общественного достояния (исходный текст удален), триггерное слово adnclsk сохранено
- Подходит для генерации изображений по тексту в стиле ретро-плакатов, старой рекламы, пародий на бренды и иллюстраций для статей; автор предоставил правила верстки: в конце промпта заключите каждую фразу текста в кавычки и укажите ее расположение, MOSS выведет ее старинным заглавным шрифтом
- Полный набор параметров: сила от 0.7 до 1.0; MOSS Image (SFT), 30 шагов, CFG 3, euler / simple, 1024 x 1536; автор утверждает, что без LoRA MOSS рисует только современные цифровые иллюстрации
- Автор утверждает, что каждое изображение в галерее сопровождается промптом и параметрами; бесплатно, лицензия разрешает использование сгенерированных изображений и сдачу в аренду на платформе; выпущено около 10 часов назад, 50 загрузок
Как использовать
- Первым словом в промпте укажите adnclsk, затем опишите объект рекламы и изображение; сила от 0.7 до 1.0, при длинных заголовках 0.7 дает более чистый результат
- Если нужен текст, добавьте в конце: The only words on the page are the headline "…" at the top …, and the line "…" on a cream panel at the bottom, заключите каждую фразу в кавычки и укажите расположение и цвет
- MOSS Image (SFT), 30 шагов, CFG 3, euler / simple, 1024 x 1536; даже если вы планируете верстку самостоятельно позже, обязательно укажите заголовок и нижнюю панель в промпте, иначе изображения поездов и пейзажей превратятся в масляную живопись
- Не добавляйте слова poster, lithograph, vintage или обозначения эпохи, автор утверждает, что LoRA уже содержит ощущение ретро
Риски и ограничения
- Доступно 5 примеров, еще 4 скрыты из-за рейтинга; нет сравнения с одним и тем же seed с LoRA и без LoRA
- Обучающий набор состоит всего из 46 изображений; архив рабочих процессов ComfyUI, прилагаемый к версии для Krea 2, отсутствует в версии MOSS, его нужно создавать самостоятельно
- Лицензия требует указания авторства; автор заявляет, что для републикации или использования сгенерированных изображений для обучения других моделей необходимо предварительное разрешение
- Этот пункт не был протестирован
Триггерное слово: adnclsk
【S】MOSS-Image Pose Control · v1.0
LoRA · Новая модель · Автор thedeoxen · Выпущено 11-10 16:20 · Загрузок 29
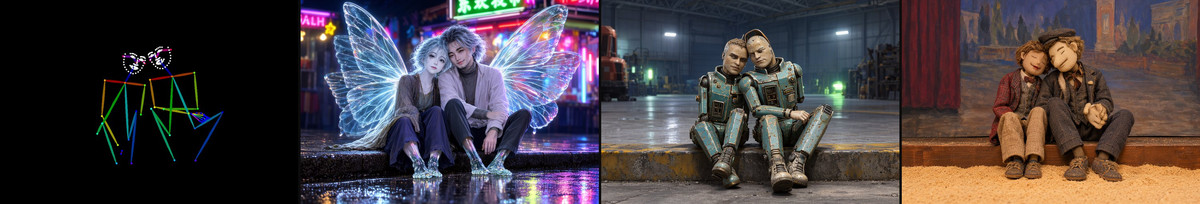
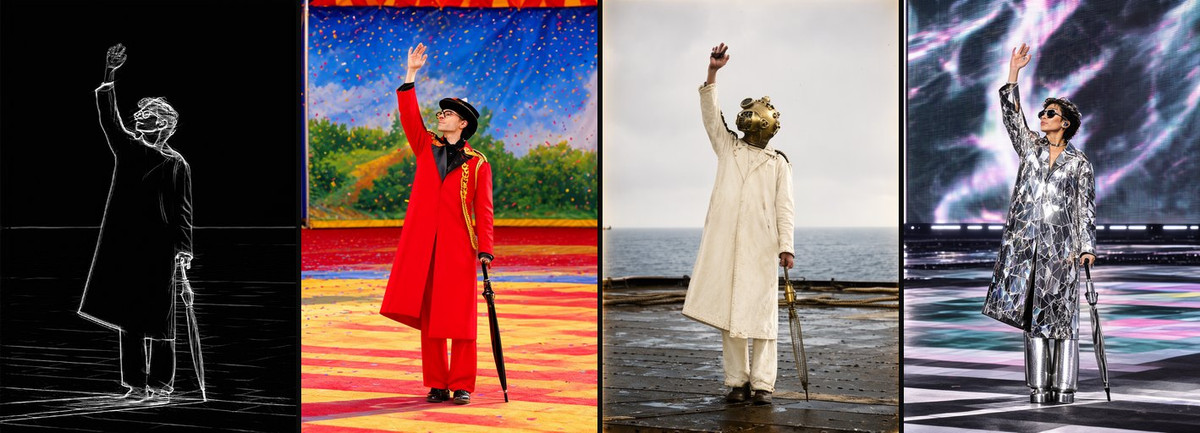
LoRA управления позами для MOSS-Image-SFT: при подаче цветной скелетной карты DWPose на черном фоне генерируемые персонажи принимают те же позы тела, рук и лица, что и на скелете, а внешность, одежда и сцена полностью определяются промптом.
Тот же автор в тот же день выпустил семь LoRA управления, метод обучения и параметры сэмплирования одинаковы, различие лишь в типе контрольного изображения; LoRA управления позами обладает наиболее независимой функциональностью и наиболее полным рабочим процессом, поэтому выбрана как представитель этой группы.
Иллюстрации
Причины рекомендации
- Новая возможность: добавляет MOSS-Image-SFT способность управлять позами по скелету; автор поясняет, что это редактирующая LoRA в стиле ControlNet, а не официальный адаптер склейки color/depth, она загружается через обычный загрузчик LoRA, а скелетная карта подается как единственное референсное изображение в Text Encode MOSS-Image Edit
- Подходит для смены одежды и персонажей, переноса поз с фотографий на других персонажей, а также для раскадровок и ключевых кадров, где требуется согласованность движений тела; в отличие от LoRA управления контурами, такими как Canny / Lineart от того же автора, эта LoRA фиксирует только положение суставов, не фиксируя контуры одежды и фон
- Метод извлечения скелета, предложенный автором: DWPose из comfyui_controlnet_aux с включенными опциями тела, рук и лица; цветные кости на черном фоне соответствуют контрольным изображениям, использованным при обучении
- Полный набор параметров и рабочий процесс: прилагается JSON рабочего процесса ComfyUI (чтение фото → извлечение скелета → кодирование → сэмплирование), выбран архив с 4500-го шага, сила 1.0, 30 шагов, CFG 4, euler + simple, триггерное слово отсутствует
- 3 примеров, каждый представляет собой коллаж «скелет + три разных промпта», что позволяет сразу увидеть, как одна поза меняет трех разных персонажей; выпущено 5 часов назад, 29 загрузок, 3 лайков, это самый популярный вариант среди этой группы LoRA управления; бесплатно, лицензия разрешает использование сгенерированных изображений и их продажу
Как использовать
- Базовая модель MOSS-Image-SFT: UNet moss_image_sft_int8_convrot, текстовый энкодер qwen3.5_9b_w4a8_gptq (тип выберите moss_image), VAE flux2-vae_small; LoRA подключается к UNet, сила 1.0
- Используйте DWPose (тело + руки + лицо) для извлечения скелета из референсного фото, цветная скелетная карта на черном фоне подается как единственное референсное изображение в Text Encode MOSS-Image Edit; в обоих узлах кодирования (позитивном и негативном) установите edit format в ai-toolkit
- 30 шагов, CFG 4, euler + simple; триггерное слово отсутствует, в промпте опишите личность персонажа, одежду, материалы и сцену, описывать каждый сустав по отдельности не нужно
Риски и ограничения
- 4 примеров с рейтингом sensitive скрыты, их больше, чем доступных 3
- Если конечности отсутствуют на скелете, автор утверждает, что промпт не может надежно восстановить соответствующие суставы; степень детализации, например пальцев, автор не уточнил
- Обучено только для MOSS-Image-SFT (автор использовал квантованный UNet int8); поведение с MOSS-Image-Base или другими точностями автор не уточнил; базовая модель помечена автором как Other
- В полной карточке модели автор рекомендует снижать силу к 0.7, если контроль слишком жесткий, значение при обучении было 1.0
- Примеры изображений не сопровождаются параметрами генерации; этот пункт не был протестирован
Рекомендуется (9)
【A】Anime Screencap Style · v2.0
LoRA · Обновление версии · Автор kanakiy · Выпущено 11-10 09:48 · Загрузок 57
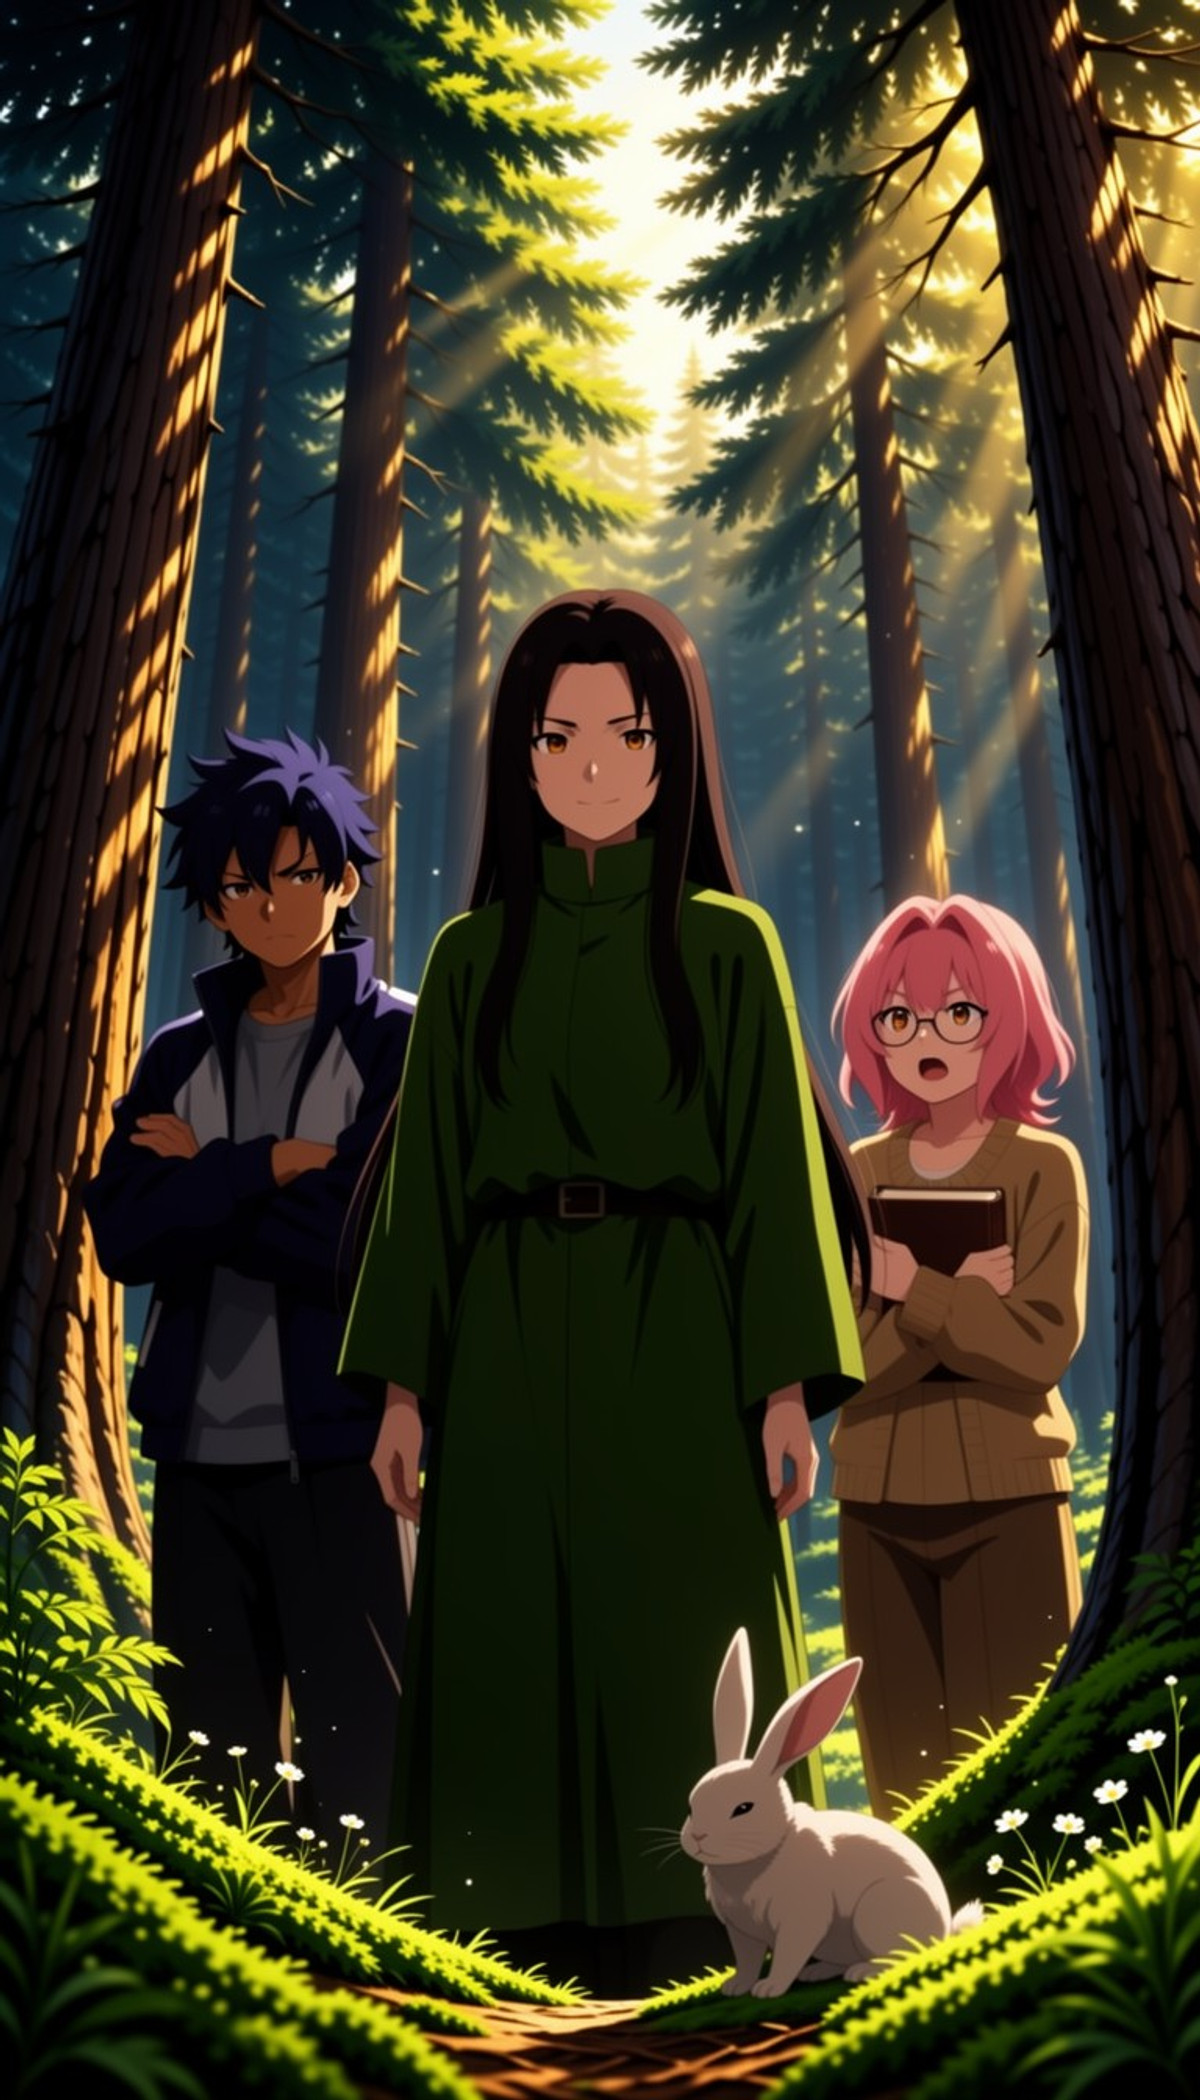
Версия v2.0 LoRA в стиле скриншотов современного аниме: плоская заливка в стиле сел-анимации, почти отсутствие мягких теней, толстые и чистые линии, высокая насыщенность цветов и широкоэкранные композиции.
Сохранена автоматическая категория A: цель стиля описана конкретно, много примеров, но в v2 отсутствуют параметры силы и сэмплирования.
Иллюстрации
Причины рекомендации
- Обновление версии: автор утверждает, что в v2.0 улучшены обучающие данные, удалены персонажи Цунаде и Сэйко Аясэ (Seiko Ayase), присутствовавшие в данных v1.0 (их по-прежнему можно вызывать по имени); для v1.0 из-за этих персонажей рекомендована сила 0.6–0.8
- Подходит для генерации изображений по тексту, где нужен «эффект скриншота аниме», а не обычный мягкий градиентный аниме-стиль, автор утверждает, что результат более плоский и жесткий, чем у большинства аниме-моделей
- 17 примеров; бесплатно; выпущено около 11 часов назад, 57 загрузок
Как использовать
- Просто загрузите LoRA, триггерное слово отсутствует; для v1.0 рекомендована сила 0.6–0.8, для v2.0 автор не указал силу, можно начать с того же диапазона; количество шагов и CFG автор не указал
Риски и ограничения
- Автор не написал примечания к обновлению (описание версии пустое, изменения следуют из двух фраз в карточке модели); нет сравнения между v1 и v2
- Лицензия не разрешает коммерческое использование сгенерированных изображений, разрешена только сдача в аренду; 3 примеров скрыты из-за рейтинга
- Этот пункт не был протестирован
【A】Realistic Photo by Amateur Snapshot · MOSS
LoRA · Новая модель · Автор 858654128784 · Выпущено 11-10 18:02 · Загрузок 73
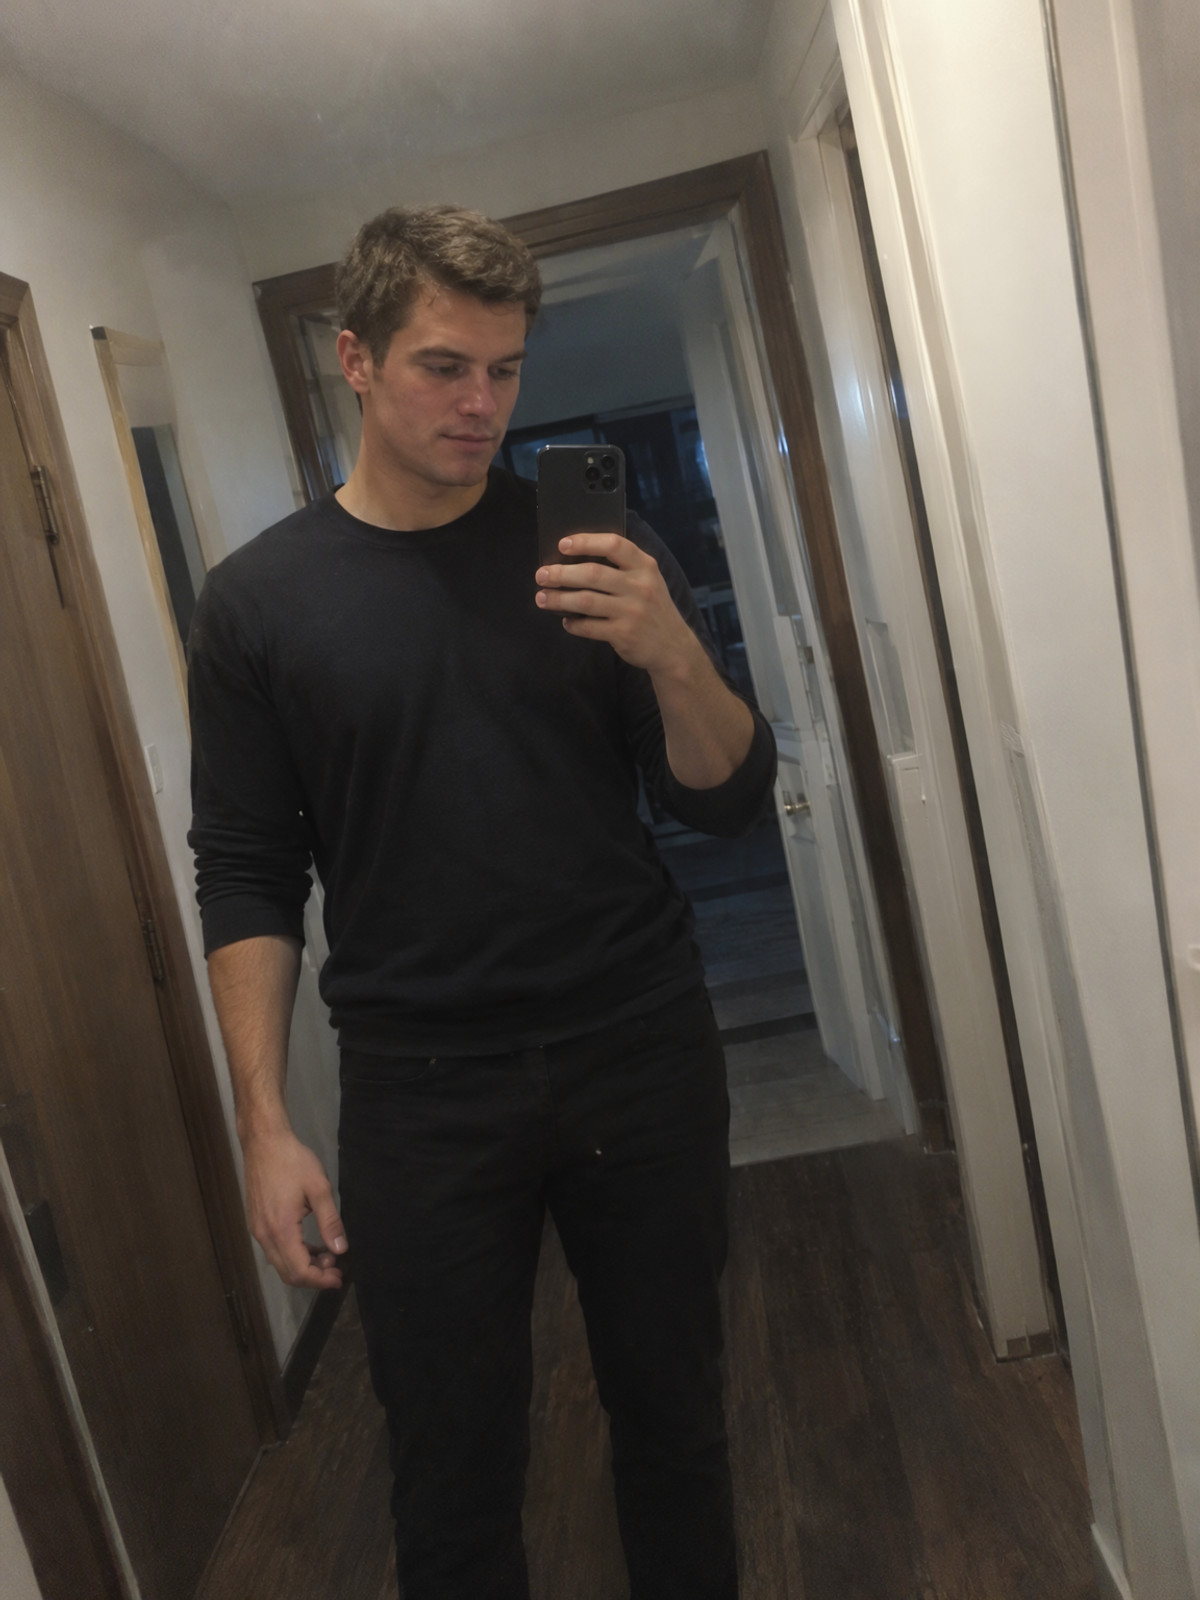
LoRA для реалистичных фото в стиле случайных снимков на телефон: селфи в зеркале, селфи на фронтальную камеру, кухонный стол, лифт, вид сверху на питомца, кривые композиции, неравномерное освещение, зернистость в тенях и реалистичная текстура кожи, устраняя излишне чистую студийную эстетику типичных AI-изображений.
Сохранена автоматическая категория A: назначение ясно, правила написания промптов можно копировать напрямую, но отсутствуют параметры силы и сэмплирования, доступно мало примеров.
Иллюстрации
Причины рекомендации
- Новая модель: существует только версия для MOSS, цель — «фото, снятые обычными людьми на телефон», а не отретушированная реалистичность
- Автор предоставил правила написания промптов: начинайте с amateur smartphone photo, укажите место, кто держит телефон, откуда идет свет; добавление деталей вроде «телефон закрывает половину лица» или «обрезанная наполовину кружка на переднем плане» делает результат более реалистичным
- Бесплатно, лицензия разрешает использование сгенерированных изображений, сдачу в аренду и продажу; выпущено около 3 часов назад, 73 загрузок, это самый быстрый рост загрузок в этой группе
Как использовать
- Начинайте промпт с amateur smartphone photo, укажите место, человека с телефоном и источник света, добавьте детали случайного снимка, такие как перекрытия и обрезка на переднем плане; триггерное слово отсутствует
- Силу, количество шагов и CFG автор не указал
Риски и ограничения
- 15 примеров скрыты из-за рейтинга, доступно только 5; страница содержит смешанный контент
- Нет параметров, нет сравнения с LoRA и без LoRA; источник обучающих данных автор не указал
- Генерация реалистичных бытовых фото людей, при публикации обращайте внимание на маркировку AI-генерации; этот пункт не был протестирован
【A】Chaldea Corridor: Fate/Grand Order · MOSS-sft01
LoRA · Новая модель · Автор RHU_AIstudio · Выпущено 11-10 19:59 · Загрузок 10
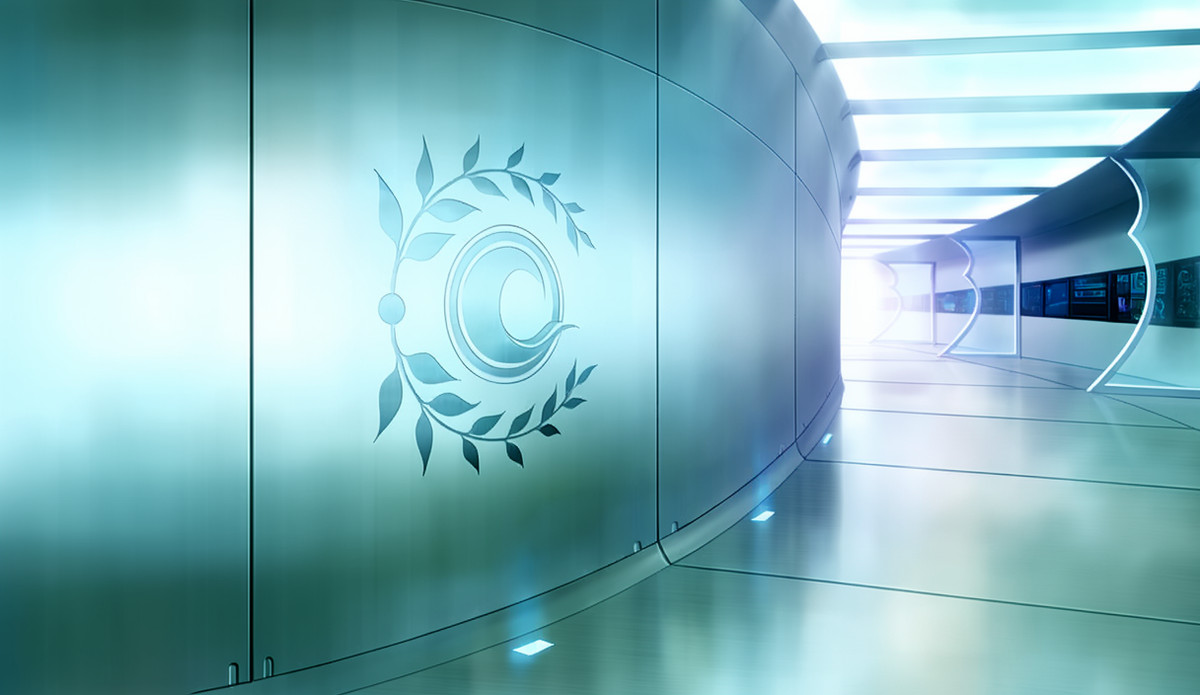
LoRA фонового сцены коридора Старой Калдеи из «Fate/Grand Order»: одно триггерное слово фиксирует этот коридор, а состояния переключают его вид на нормальный, темный, разрушенный, замерзший и т.д.
Сохранена автоматическая категория A: самая понятная инструкция по использованию среди LoRA сцен, триггерное слово, сила и состояния можно копировать напрямую, но охвачено только одно место, отсутствуют параметры сэмплирования.
Иллюстрация
Причины рекомендации
- Новая модель, и это редкий для этого выпуска LoRA для сцен / фонов: не занимается персонажами, а специализируется на воспроизведении фиксированного места, подходит для фан-арта, добавления фонов к иллюстрациям персонажей и создания сцен в стиле визуальных новелл
- Автор указал источник данных для обучения: 7 фоновых изображений из игры, охватывающих состояния «нормальное / тёмное / размытое / повреждённое / замёрзшее» и два ракурса камеры
- Указаны триггерные слова, сила воздействия и слова-состояния: corridor_(chaldea)_(fate), сила 1.0; bright lighting, dark, dim lighting, damaged, cracked wall, debris, frozen, ice, flooded, close-up соответствует ракурсу со стеной, украшенной гербом
- 3 видимых примеров, 1 скрыты; бесплатно, лицензия свободная, разрешено использование сгенерированных изображений, их продажа и создание производных работ
Как использовать
- В промпте укажите corridor_(chaldea)_(fate), при необходимости добавьте слова-состояния: bright lighting / dark, dim lighting / damaged, cracked wall, debris / frozen, ice, flooded; для ракурса со стеной, украшенной гербом, добавьте close-up; сила LoRA 1.0
- Количество шагов, CFG и сэмплер автором не указаны; название версии — MOSS-sft01, автор не уточнил, обучалась ли модель на Base или на SFT
Риски и ограничения
- Обучающая выборка состоит всего из 7 изображений, поэтому модель в основном воспроизводит коридор в указанных состояниях и с двух ракурсов; неизвестно, сохранит ли она структуру при смене ракурса
- Материалы взяты из защищённых авторским правом фонов игры; несмотря на свободную лицензию, перед коммерческим использованием необходимо учитывать авторские права оригинала
- Карточка модели содержит лишь один абзац, нет рекомендаций по добавлению персонажей и использованию нескольких LoRA одновременно; данная модель не тестировалась
Триггерное слово: corridor_(chaldea)_(fate)
【A】MOSS-Image Scribble Control · v1.0
LoRA · Новая модель · Автор thedeoxen · Выпущено 11-10 16:53 · Загрузок 23
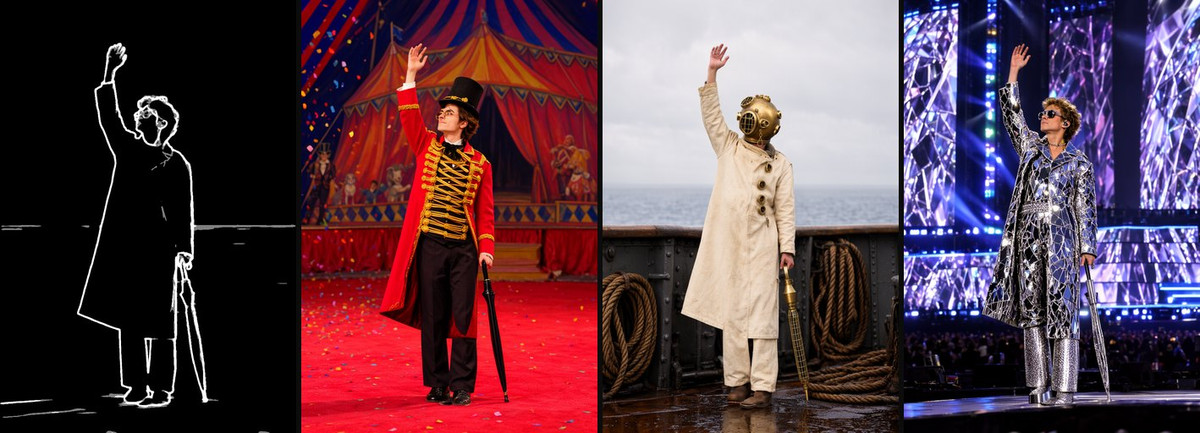
LoRA для управления набросками в MOSS-Image-SFT: принимает несколько грубых мягких белых штрихов на чёрном фоне, ориентируясь только на общий жест и объёмные формы, тогда как детали, текстура и стиль определяются промптом.
Иллюстрация
Причины рекомендации
- Новая возможность: самая свободная из серии контрольных LoRA этого автора, учитывает только основные штрихи и крупные формы, не следуя за каждой мелкой линией; автор рекомендует использовать её перед доработкой с Canny / Lineart для быстрых тестов композиции
- Подходит для начальных набросков, раскадровки и перерисовки фото с сохранением только общей формы: входными данными могут быть как несколько ручных штрихов, так и мягкие контуры, извлечённые из фотографии
- Предобработка: в рабочем процессе используется HED Soft-Edge Lines с включённым режимом safe mode; обучающие наброски более грубые и мягкие, чем Canny и линейные рисунки, автор утверждает, что мягкие контуры HED ближе к обучающим изображениям, чем тонкие эскизы PiDiNet
- Прилагается рабочий процесс ComfyUI; сохранение на 5000-м шаге, сила 1.0, 30 шагов, CFG 4, euler + simple; 3 примеров в виде коллажей
- Бесплатно, лицензия разрешает использование и продажу сгенерированных изображений; за 4 часов после выпуска — 23 загрузок
Как использовать
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA подключается к UNet, сила 1.0
- HED Soft-Edge Lines (safe mode) или несколько грубых белых штрихов на чёрном фоне, нарисованных от руки, используются как единственное референсное изображение, подаваемое в Text Encode MOSS-Image Edit, для положительного и отрицательного кодирования edit format устанавливается ai-toolkit
- 30 шагов, CFG 4, euler + simple; триггерных слов нет; автор рекомендует использовать меньше, но более уверенных штрихов вместо зашумлённых контуров, оставляя текстуру, цвет и мелкие детали на усмотрение промпта
Риски и ограничения
- Контроль слабый, точное положение деталей не фиксируется; для сцен, требующих точных контуров, следует использовать Canny или Lineart
- Обучена только для MOSS-Image-SFT; базовая модель помечена как Other; 1 примеров с чувствительным контентом скрыты
- В полной карточке модели рекомендуется снижать силу к 0.7, если контроль слишком жёсткий
- Данная модель не тестировалась
【A】MOSS-Image Normal Control · v1.0
LoRA · Новая модель · Автор thedeoxen · Выпущено 11-10 16:51 · Загрузок 24
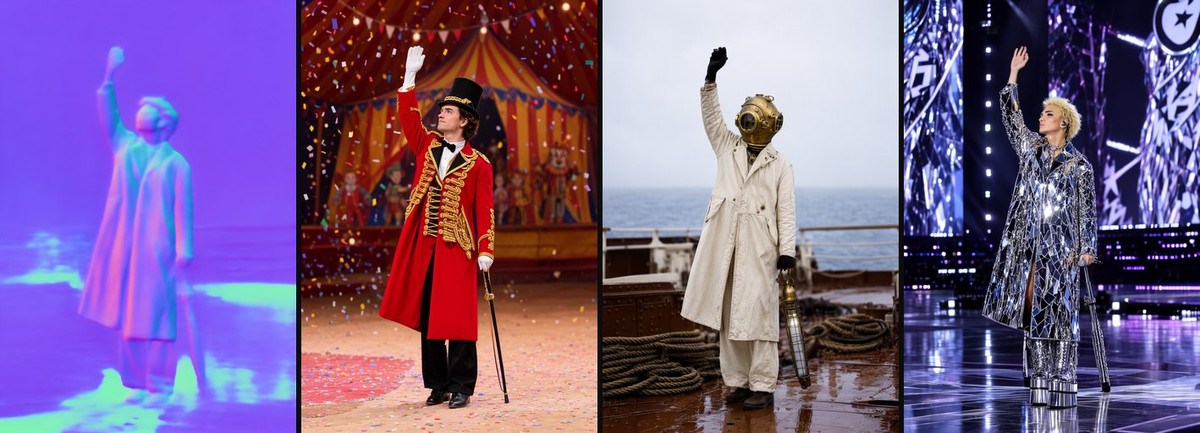
LoRA для управления нормалями в MOSS-Image-SFT: принимает цветную карту нормалей, сохраняя объём объектов и ориентацию поверхностей, меняя только материалы и окружение.
Иллюстрация
Причины рекомендации
- Новая возможность: контролирует на один уровень больше, чем карта глубины, а именно «направление поверхности», сохраняя объём и ориентацию неизменными, но позволяя менять материалы; автор перечисляет такие применения, как замена материалов / пересветка для фиксированных форм и сцены с фиксированным объёмом объектов в продуктовых фото
- Подходит для замены материалов в продуктовых фото, перетекстурирования скульптур или реквизита, а также для сцен, где глубина верна, но требуется контроль ориентации поверхности; входными данными являются карты нормалей, полученные из фото или 3D-рендеров
- Предобработка: в рабочем процессе используется BAE Normal Map, обучающие изображения — обычные карты нормалей в пространстве камеры в фиолетовых / голубых / зелёных тонах; автор напоминает, что необходимо использовать карты нормалей в пространстве камеры, а не карты высот в градациях серого; чем глаже нормали, тем чище объём, а шум приводит к появлению лишних выпуклостей
- Прилагается рабочий процесс ComfyUI; сохранение на 5000-м шаге, сила 1.0, 30 шагов, CFG 4, euler + simple; 3 примеров в виде коллажей, выполненных на том же тестовом фото, что и версии с Canny / Lineart
- Бесплатно, лицензия разрешает использование и продажу сгенерированных изображений
Как использовать
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA подключается к UNet, сила 1.0
- BAE Normal Map создаёт цветную карту нормалей в пространстве камеры, которая используется как единственное референсное изображение, подаваемое в Text Encode MOSS-Image Edit, для положительного и отрицательного кодирования edit format устанавливается ai-toolkit
- 30 шагов, CFG 4, euler + simple; триггерных слов нет, в промпте описываются материалы и окружение
Риски и ограничения
- Область применения уже, чем у Canny / Depth; преимущество над управлением по глубине проявляется в основном при смене материалов и освещения
- Необходимо самостоятельно проверить, соответствуют ли нормали, экспортируемые из 3D-программ, цветовым соглашениям BAE; автор не уточняет этот момент; обучение проводилось только для MOSS-Image-SFT; базовая модель обозначена как Other; 1 примеров с чувствительным контентом скрыты
- В полной карточке модели рекомендуется снижать силу воздействия до 0.7, если контроль становится слишком жестким
- Данный пункт не выполнялся
【A】MOSS-Image Segmentation Control · v1.0
LoRA · Новая модель · Автор thedeoxen · Опубликовано 11-10 16:54 · Загрузок 25
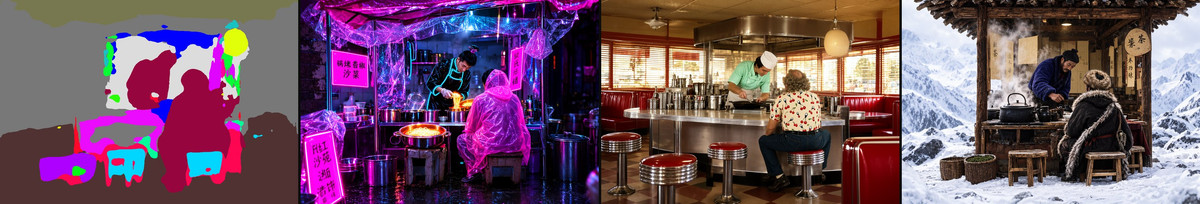
LoRA для управления семантической сегментацией MOSS-Image-SFT: подается карта областей с плоскими цветовыми блоками, сохраняющая границы зон и общую компоновку, при этом содержимое каждой области определяется промптом.
Иллюстрации
Причины рекомендации
- Новая возможность: управление по «областям», а не по линиям или глубине; подходит для предварительного разделения изображения на крупные блоки (люди, мебель, фон) с последующей общей сменой стиля рендеринга; автор утверждает, что границы и общий объем блоков сохраняются
- Подходит для композиций с разделением на сцены, цветовых скриптов и перерисовки всего изображения с сохранением положения людей и мебели
- Предобработка: в рабочем процессе используется семантическая сегментация UniFormer; обучающие изображения представляют собой полностью заполненные плоские цветовые блоки без больших черных неаннотированных областей; автор предупреждает, что цвета блоков — это просто идентификаторы областей, они не переносятся в цвета итогового изображения, материалы следует указывать в промпте, а градиенты и текстуры могут нарушить целостность областей
- Прилагается рабочий процесс ComfyUI; сохранение на шаге 4500, сила 1.0, 30 шагов, CFG 4, euler + simple
- Бесплатно, лицензия разрешает генерацию изображений и их продажу; за 4 часов после публикации — 25 загрузок
Как использовать
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA подключается к UNet, сила 1.0
- С помощью UniFormer создается карта областей с плоскими цветами, заполняющая весь кадр (не оставляйте большие черные области), которая подается как единственное референсное изображение в Text Encode MOSS-Image Edit; для положительного и отрицательного кодирования edit format устанавливается в ai-toolkit
- 30 шагов, CFG 4, euler + simple; триггерных слов нет, в промпте четко опишите объекты и материалы для каждой области
Риски и ограничения
- По словам автора, сегментаторы, оставляющие фон черным, плохо сочетаются с этими весами; при использовании других моделей сегментации следует быть осторожным
- Доступно 2 видимых примеров, 1 примеров с чувствительным контентом скрыты; обучение проводилось только для MOSS-Image-SFT; базовая модель обозначена как Other
- В полной карточке модели рекомендуется снижать силу воздействия до 0.7, если контроль становится слишком жестким
- Данный пункт не выполнялся
【A】MOSS-Image Lineart Control · v1.0
LoRA · Новая модель · Автор thedeoxen · Опубликовано 11-10 16:37 · Загрузок 21
LoRA для управления по контурным рисункам MOSS-Image-SFT: подается тонкий белый контурный рисунок на черном фоне, генерация следует структуре линий, а цвета, материалы и стиль определяются промптом.
Иллюстрации
Причины рекомендации
- Новая возможность: занимает промежуточное положение между Canny и Scribble — следует чистым контурным линиям, но без шумовых точек, характерных для исходных изображений Canny; автор указывает, что основное применение — раскрашивание контурных рисунков
- Подходит для раскрашивания контурных рисунков, превращения эскизов в готовые изображения и смены сцены с сохранением линейной структуры фотографии; по словам автора, можно использовать как рисованные от руки контуры, так и контуры, извлеченные из фотографий, при условии, что линии легкие и разреженные
- Важные нюансы предобработки: в рабочем процессе используется Realistic Lineart с включенным режимом coarse; автор утверждает, что это ближе к обучающим данным, чем режим детализированных контуров; белые линии на черном фоне, если у вас контурный рисунок с черными линиями на белом фоне, его нужно предварительно инвертировать
- Прилагается рабочий процесс ComfyUI; сохранение на шаге 5000, сила 1.0, 30 шагов, CFG 4, euler + simple; 3 примеров в виде коллажей используют те же тестовые фото, что и версия Canny
- Бесплатно, лицензия разрешает генерацию изображений и их продажу
Как использовать
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA подключается к UNet, сила 1.0
- С помощью Realistic Lineart (с включенным coarse) создается изображение с белыми линиями на черном фоне, которое подается как единственное референсное изображение в Text Encode MOSS-Image Edit; для положительного и отрицательного кодирования edit format устанавливается в ai-toolkit
- 30 шагов, CFG 4, euler + simple; триггерных слов нет, в промпте укажите цвета, материалы и стиль рисования
Риски и ограничения
- По словам автора, разреженные линии лучше соответствуют обучающим данным, чем плотные наброски; поведение при очень плотных контурных рисунках не описано
- Обучение проводилось только для MOSS-Image-SFT; базовая модель обозначена как Other; 1 примеров с чувствительным контентом скрыты; в этой группе меньше всего загрузок (21)
- В полной карточке модели рекомендуется снижать силу воздействия до 0.7, если контроль становится слишком жестким
- Данный пункт не выполнялся
【A】MOSS-Image Canny Control · v1.0
LoRA · Новая модель · Автор thedeoxen · Опубликовано 11-10 16:29 · Загрузок 23
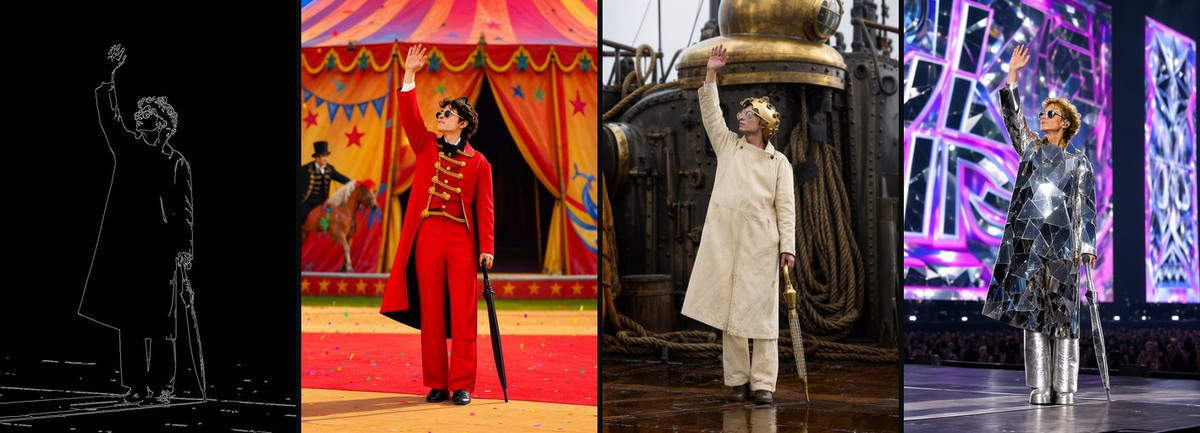
LoRA для управления по краям Canny MOSS-Image-SFT: подается изображение краев Canny с белыми линиями на черном фоне, которое фиксирует контуры объектов, композицию и мелкие детали, оставляя материалы, цветовую гамму и стиль на усмотрение промпта.
Иллюстрации
Причины рекомендации
- Новая возможность: самый строгий в серии LoRA от того же автора, следует даже за мелкими краями; автор позиционирует его как «сохранение контура, замена цвета и материала», подходит для макетных исследований, где контур должен оставаться неизменным
- Служит для преобразования фото в стиль, перерисовки с той же композицией и заменой материала, черновиков макетов: входные данные — это фотография или существующее изображение, сначала извлекается Canny, затем генерируется результат
- Предобработка описана конкретно: Canny Edge из comfyui_controlnet_aux, пороги low 100 / high 200; автор подсказывает, что если результат слишком точно повторяет каждый шум, следует увеличить пороги, чтобы сделать края чище
- Прилагается рабочий процесс ComfyUI; сохранение на шаге 4500, сила 1.0, 30 шагов, CFG 4, euler + simple; 3 примеров коллажей «контрольное изображение + три промпта», использующих ту же тестовую фотографию циркового артиста, что и в работах того же автора с Normal / Scribble / Lineart, что позволяет проводить сравнение
- Бесплатно, лицензия разрешает генерацию изображений и их продажу; за 4 часов после публикации было 23 скачиваний
Как использовать
- MOSS-Image-SFT (int8 convrot UNet + текстовый энкодер qwen3.5_9b_w4a8_gptq, тип moss_image + flux2-vae_small), LoRA подключается к UNet, сила 1.0
- Предобработка Canny Edge (low 100 / high 200) создает черно-белую линейную графику, которая подается как единственное референсное изображение в Text Encode MOSS-Image Edit, формат редактирования для позитивного и негативного кодирования устанавливается как ai-toolkit
- 30 шагов, CFG 4, euler + simple; без триггерных слов, в промпте описываются новые материалы, цветовая гамма и сцена
Риски и ограничения
- Чем плотнее изображение Canny, тем сильнее результат привязан к деталям оригинала, оставляя меньше пространства для изменений через промпт; если нужно сохранить только общую форму, следует использовать варианты Scribble или Lineart
- Обучено только для MOSS-Image-SFT, другие базовые модели / точности автором не указаны; базовая модель помечена как Other; 1 примеров с чувствительным контентом скрыты
- В полной карточке модели рекомендуется снижать силу до 0.7, если контроль слишком жесткий
- Этот пункт не был протестирован
【A】MOSS-Image Depth Control · v1.0
LoRA · Новая модель · Автор thedeoxen · Опубликовано 11-10 16:25 · Скачиваний 22
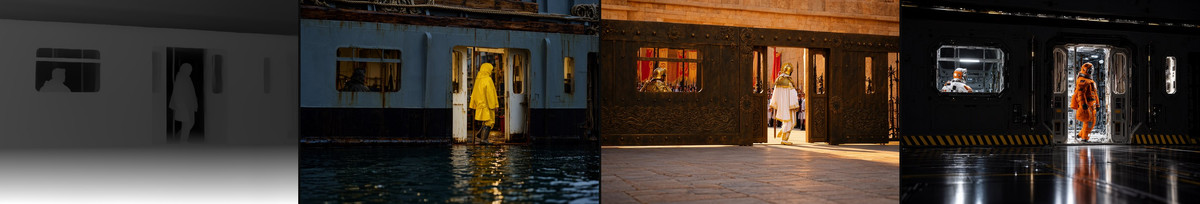
LoRA для контроля глубины MOSS-Image-SFT: подается grayscale карта глубины (белый для ближнего плана, черный для дальнего), сохраняющая расстояние между передним и задним планами и пространственную компоновку, при этом объекты и стиль определяются промптом.
Иллюстрации
Причины рекомендации
- Новая возможность: фиксирует только «что ближе, что дальше» и глубину камеры, не фиксируя каждый край; автор утверждает, что это подходит для случаев, когда «глубина кадра важнее контура»; обратите внимание, что это не официальный адаптер MOSS color/depth, а редакторская LoRA того же автора
- Служит для перестройки сцен в другом стиле с той же камерой, замены материала после разделения объекта переднего плана и фона, а также для макетов с четким объектом переднего плана, таких как продукты и интерьеры
- Предобработка: в рабочем процессе используется Depth Anything V2 (depth_anything_v2_vitl), где ближний план белый, а фон уходит в черный; автор особо предупреждает не использовать инвертированную карту глубины, иначе она будет конфликтовать с LoRA
- Прилагается рабочий процесс ComfyUI; сохранение на шаге 5000, сила 1.0, 30 шагов, CFG 4, euler + simple; автор утверждает, что большие плоские области глубины оставляют больше пространства для текстур в промпте
- Бесплатно, лицензия разрешает генерацию изображений и их продажу; 3 лайков
Как использовать
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), LoRA подключается к UNet, сила 1.0
- Depth Anything V2 vitl создает grayscale карту глубины (белый для ближнего плана, черный для дальнего, не инвертировать), которая подается как единственное референсное изображение в Text Encode MOSS-Image Edit, формат редактирования для позитивного и негативного кодирования устанавливается как ai-toolkit
- 30 шагов, CFG 4, euler + simple; без триггерных слов, в промпте описываются объекты, материалы и стиль
Риски и ограничения
- В видимых примерах только 1 коллажей, еще 4 примеров с чувствительным контентом скрыты, что делает это наименее документированным вариантом в группе
- Автор не указал, что лучше: этот вариант или официальный адаптер depth; обучено только для MOSS-Image-SFT; базовая модель помечена как Other
- В полной карточке модели рекомендуется снижать силу до 0.7, если контроль слишком жесткий
- Этот пункт не был протестирован
Заслуживают внимания (10)
【B】AG: Naberius - Grumpy Niji Boys · MOSS-Image
LoRA · Порт · Автор Azriaelis · Опубликовано 11-10 09:10 · Скачиваний 27
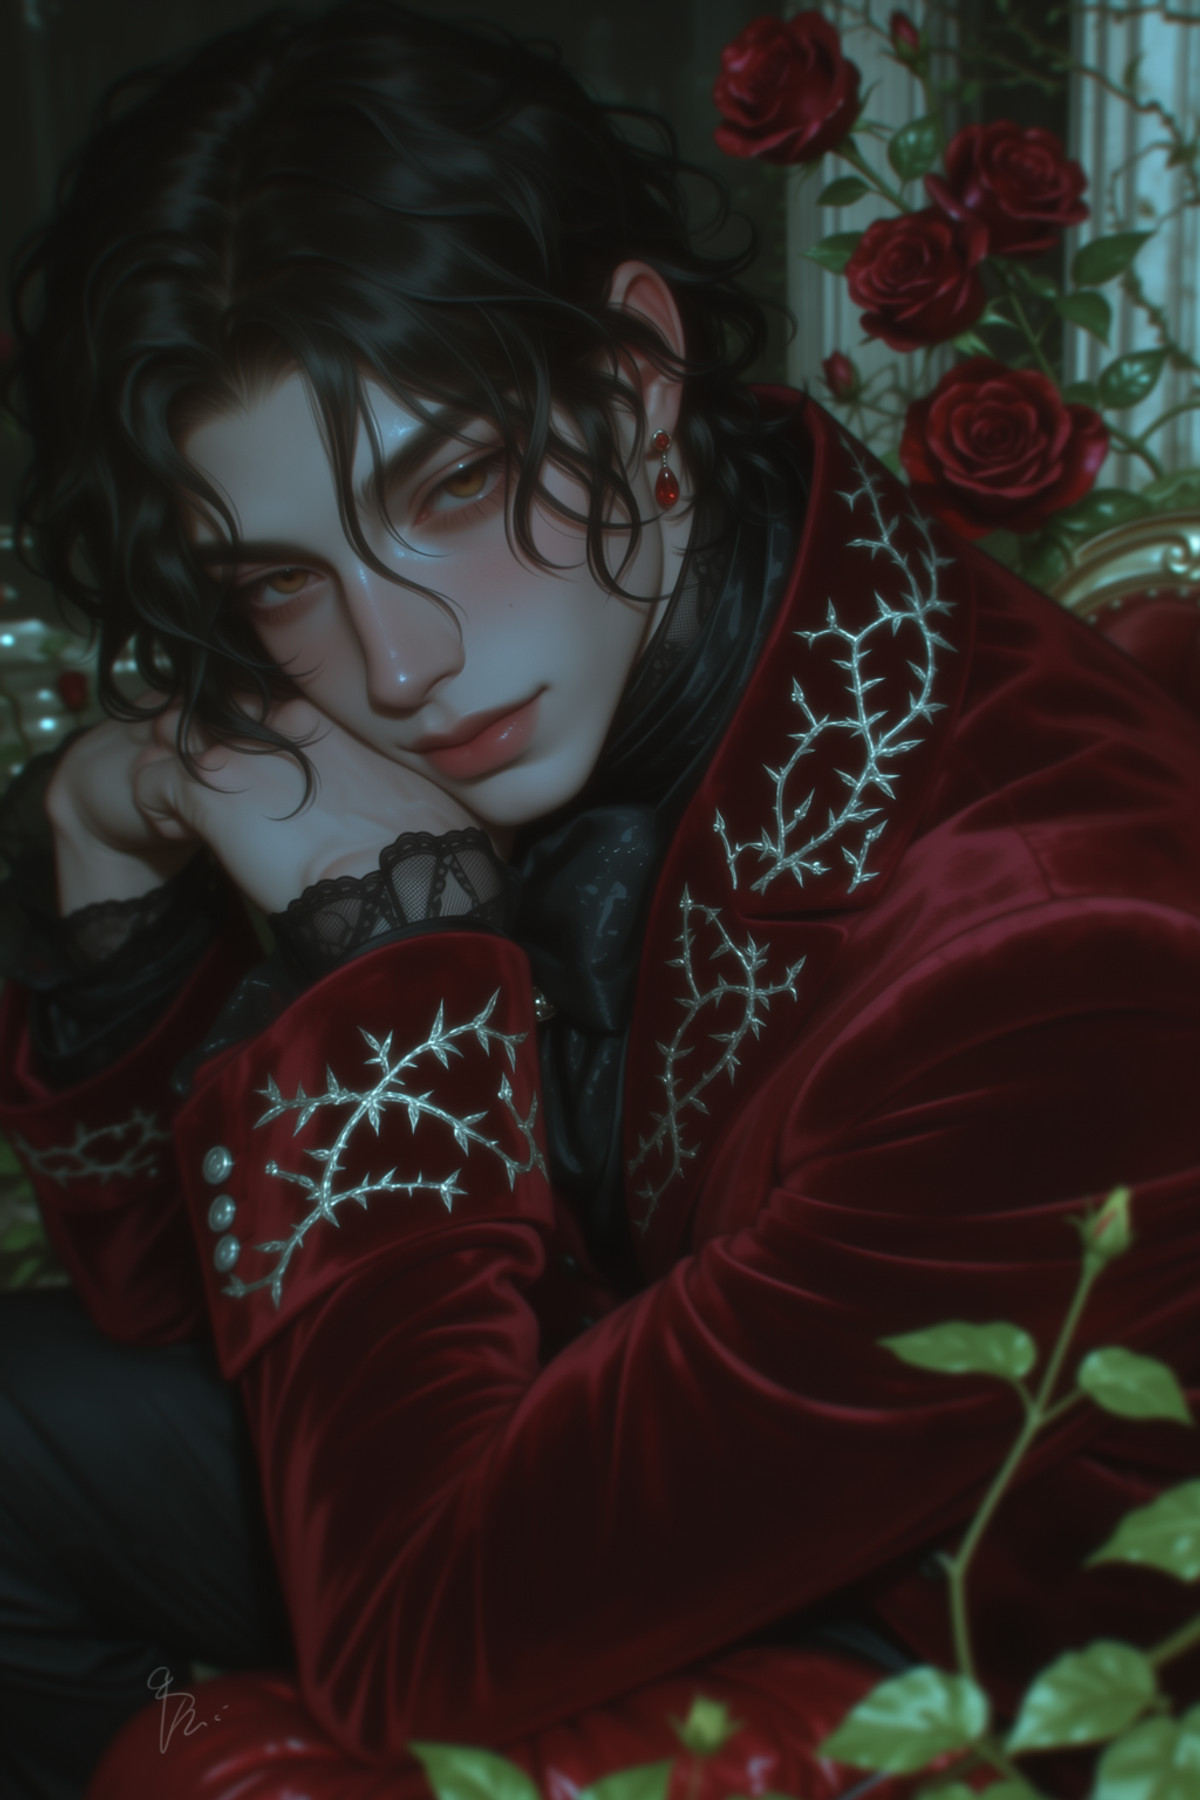
Версия для MOSS элемента Naberius из серии «Ars Goetia»: LoRA в стиле полу-реалистичного Niji с преобладанием мужских персонажей (название Grumpy Niji Boys).
Иллюстрации
【B】HaDeS MOSS Suite Workflows · Turbo Image to Image v0.1
Рабочий процесс · Обновление версии · Автор _HaDeS_ · Опубликовано 11-10 17:33 · Скачиваний 24
Новый элемент в коллекции рабочих процессов HaDeS MOSS Suite: рабочий процесс ComfyUI для image-to-image в MOSS с узлом усиления промпта и ускоряющей LoRA HaDeS (JSON, не новые веса).
Иллюстрации
【B】V67 Twins and Mirror · V1 MOSS
LoRA · Порт · Автор angelomaiota · Опубликовано 11-10 17:57 · Скачиваний 23
Версия для MOSS LoRA «Близнецы и зеркало»: генерирует изображения однояйцевых / разнояйцевых близнецов, отражений в зеркале, отражений в лужах и другие композиции с «одним человеком в двух телах» или симметрией.
Иллюстрации
【B】One obsession_MOSS · SFT v1
Базовая модель / Checkpoint · Обновление версии · Автор maxfeifei8 · Опубликовано 11-10 19:20 · Скачиваний 9 · Платно
Вторая версия SFT v1 для дообучения базовой модели MOSS One obsession: полный набор весов базовой модели (в форматах INT8 и BF16), согласно названию относится к серии SFT, предыдущая версия была BASE v1.
Иллюстрации
【B】V67 Italian Villages · V1 MOSS
LoRA · Порт · Автор angelomaiota · Опубликовано 11-10 15:11 · Скачиваний 21
Версия для MOSS LoRA «Итальянские деревни»: каменные дома, узкие улочки, черепичные крыши, вид с вершины холма и золотистый свет; автор утверждает, что это сочетание пейзажной живописи в стиле Каналетто и реалистичной архитектурной фотографии.
Иллюстрации
【B】Chenbin (鬼针草) Style | MOSS Image LoRA · v1.0
LoRA · Новая модель · Автор NO83 · Опубликовано 11-10 20:46 · Скачиваний 7
LoRA для MOSS, имитирующая стиль художника «鬼针草» (Chenbin): автор утверждает, что текстура чулок получается очень хорошо, а волосы — обычно.
Иллюстрации
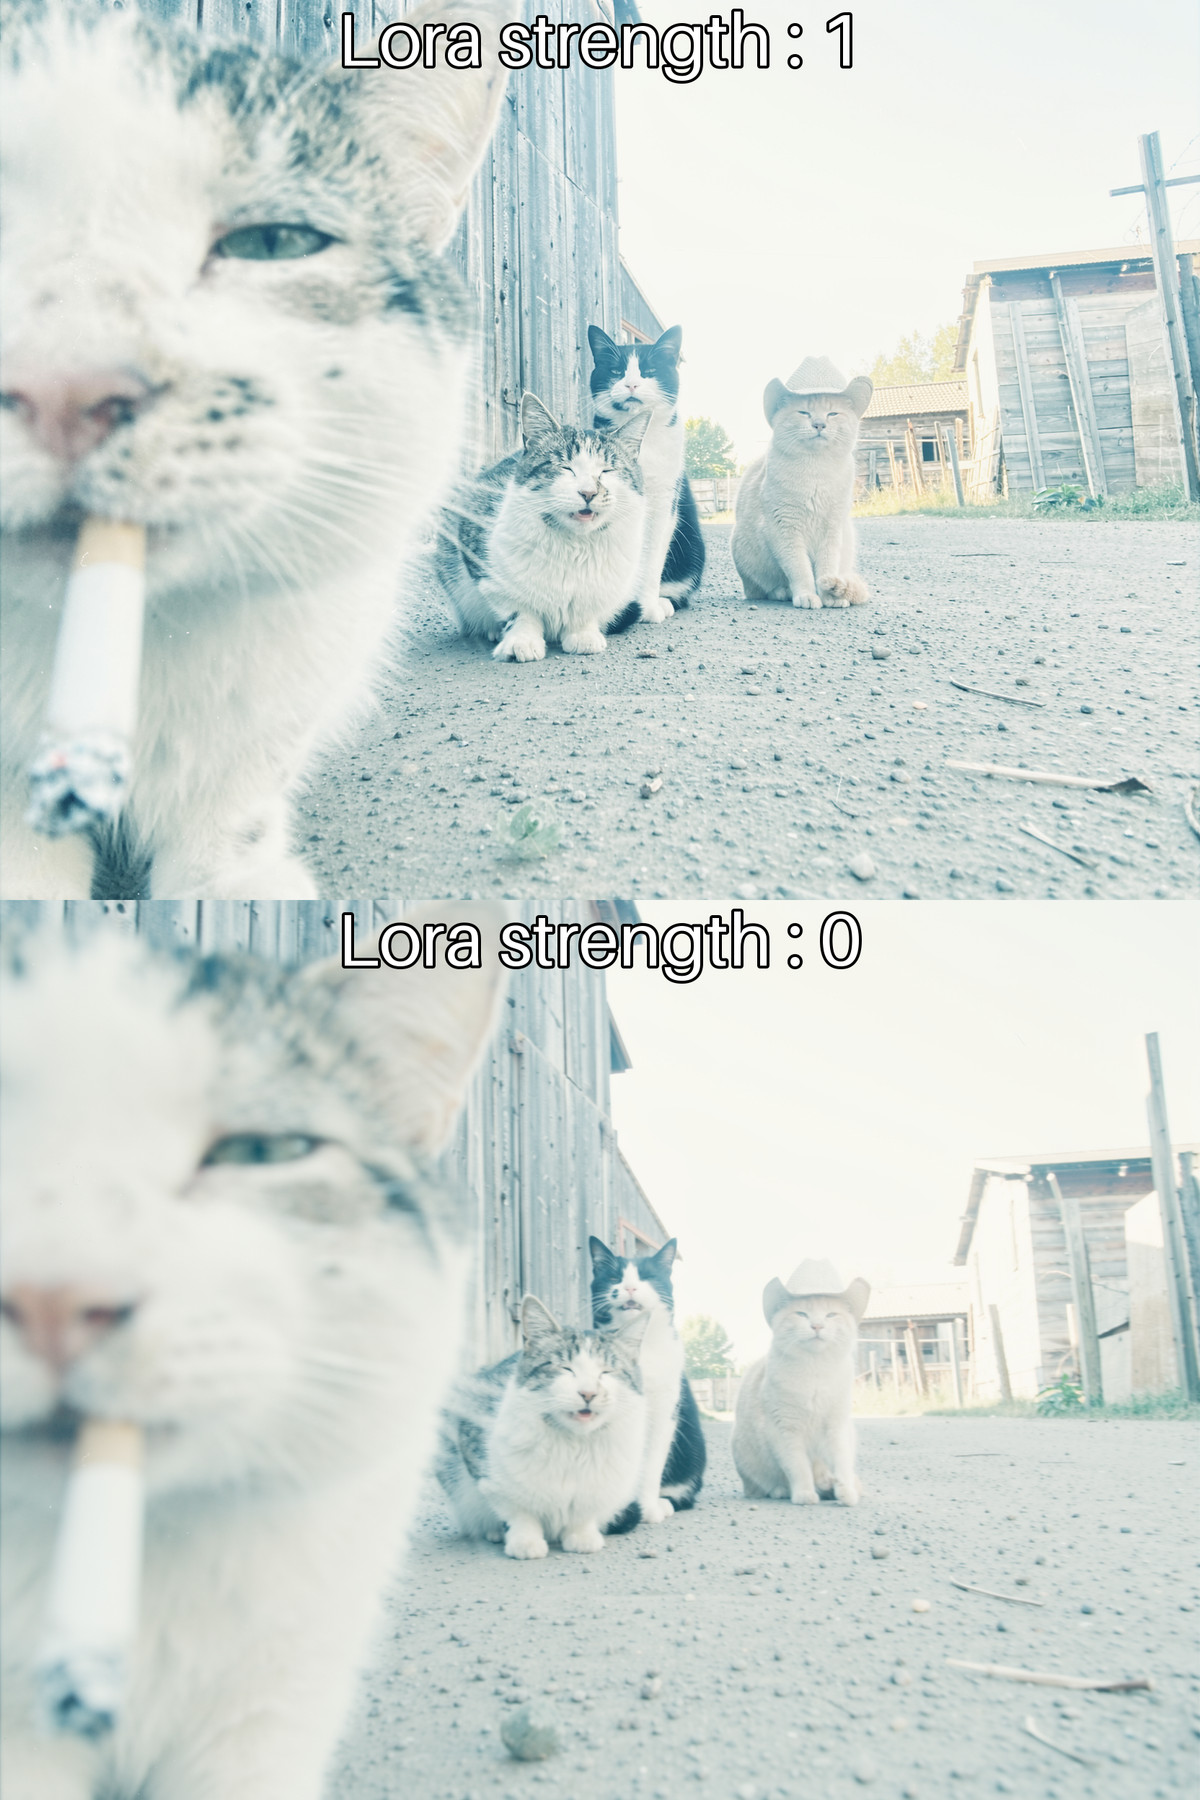
【B】Kromoss slider: blurry to sharp · v1
LoRA · Новая модель · Автор Generated_Good · Опубликовано 11-10 18:27 · Скачиваний 61
LoRA-ползунок четкости: обучена на Kromoss (полное дообучение MOSS-Image-Base), регулирует степень размытия переднего и заднего планов с помощью позитивной и негативной силы, решая проблему частого размытия в Kromoss.
Иллюстрации
【B】釉光细绘 Glazeline style · moss-v1.0
LoRA · Новая модель · Автор soda_Cookie · Опубликовано 11-10 20:04 · Скачиваний 12
Иллюстративный LoRA под названием «Glazeline» (в переводе — «глазурная тонкая прорисовка»), автор которого предоставил триггерное слово, полный пример промпта и негативный промпт.
Иллюстрации
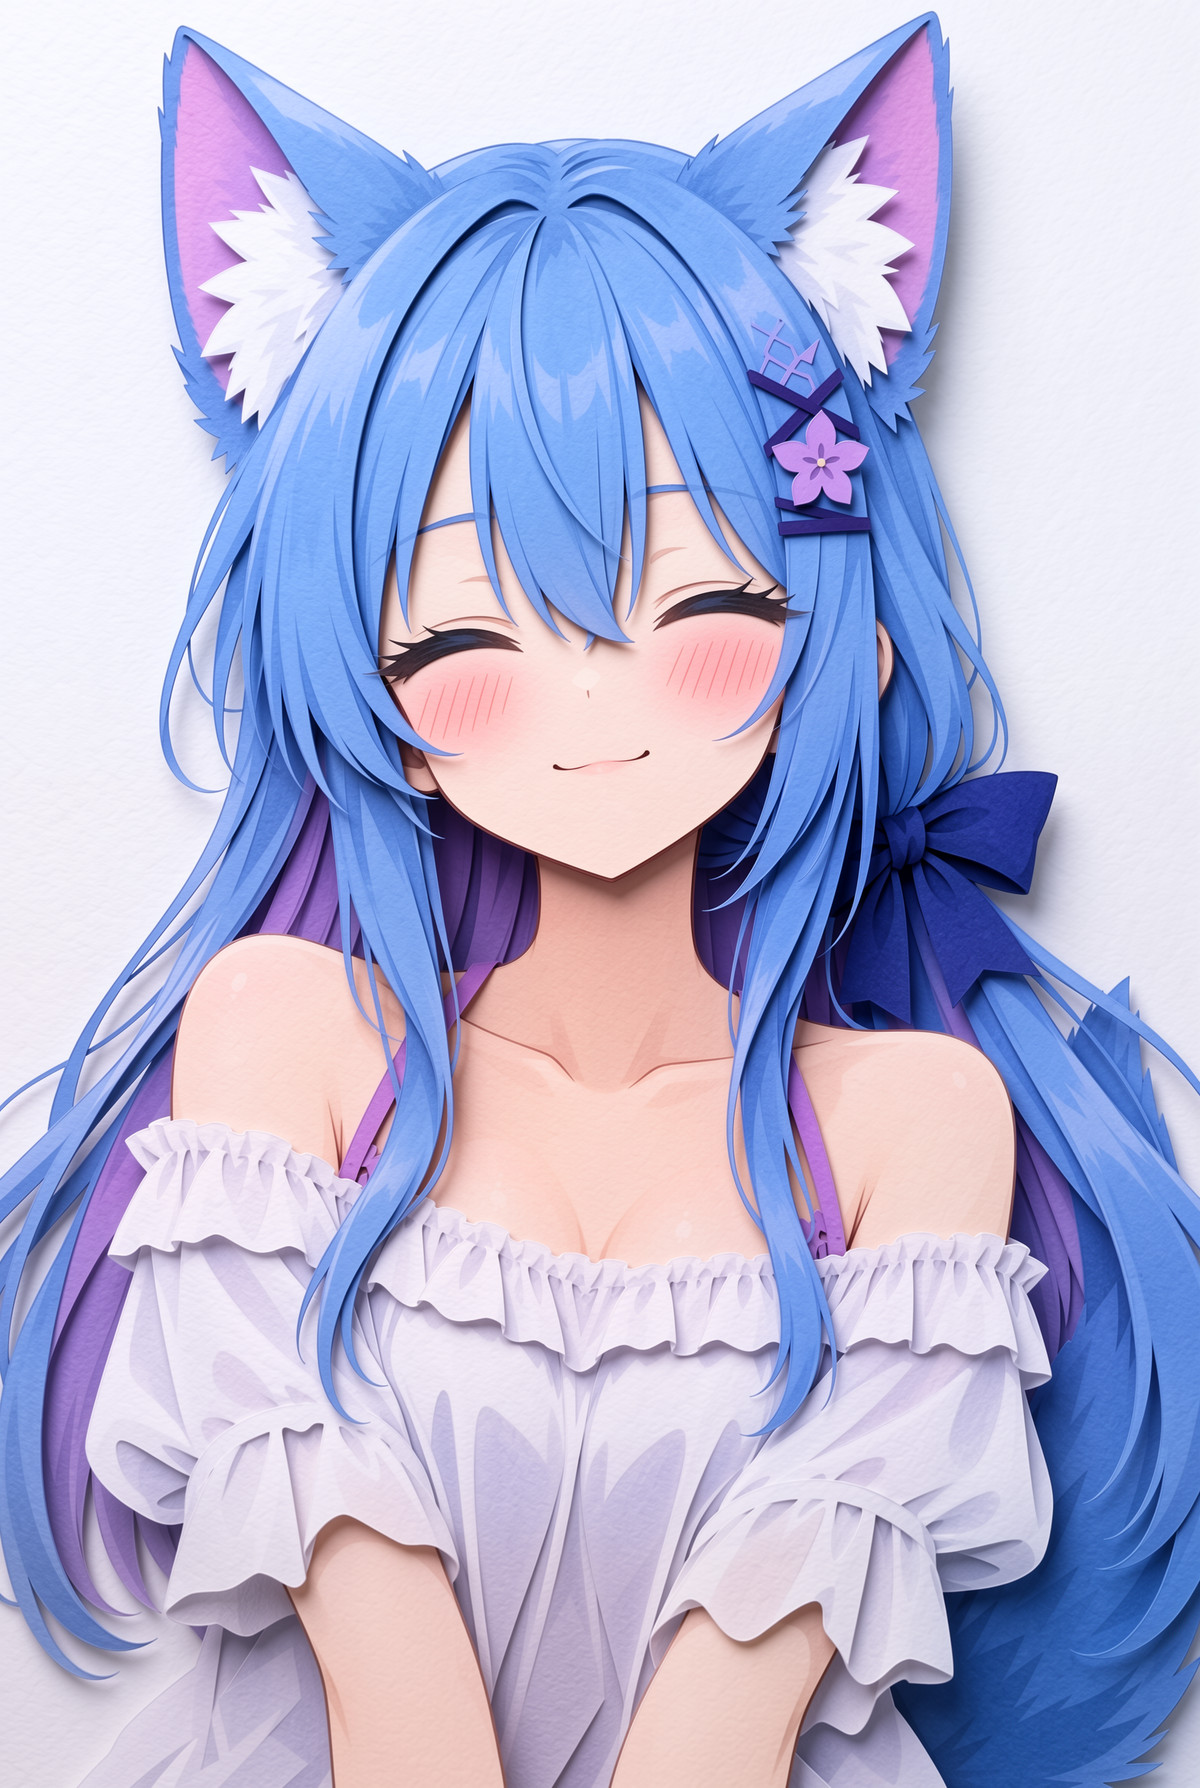
【B】纸雕/纸偶 · v1.0
LoRA · Порт · Автор YuChuXi · Опубликовано 11-10 13:54 · Скачиваний 47
Версия для MOSS LoRA в стиле бумажной скульптуры / бумажных кукол: превращает изображение в многослойную бумажную аппликацию.
Иллюстрации
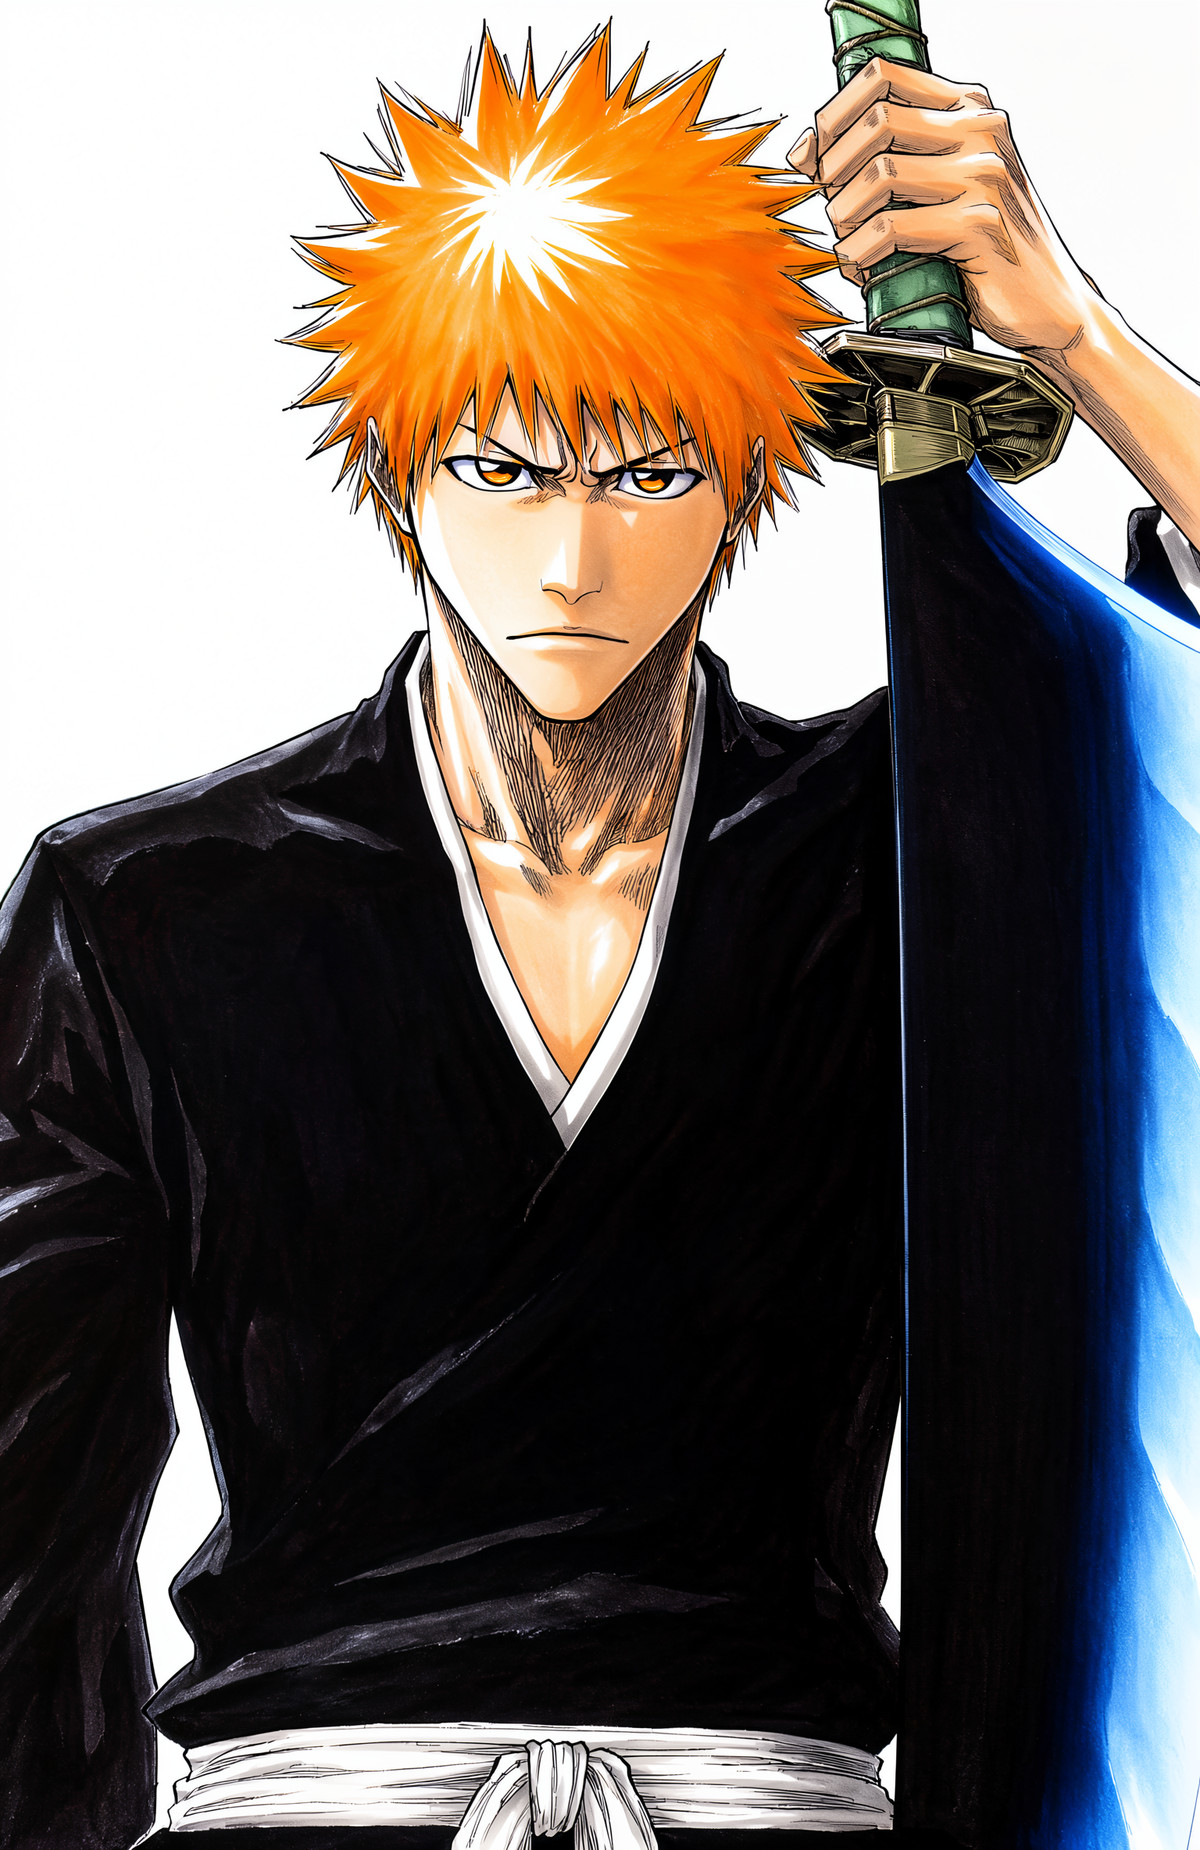
【B】18 in 1,《Bleach》/《Блич》, Tite Kubo/Кубо Тайт - Artist Style · MOSS_v1.0
LoRA · Порт · Автор flyx3 · Опубликовано 11-10 12:10 · Скачиваний 3 · Платно
Версия для MOSS LoRA в стиле манги автора «Блич» Кубо Тайта, в одном файле также можно генерировать большинство персонажей из этого произведения.
Иллюстрации
Только для справки (14)
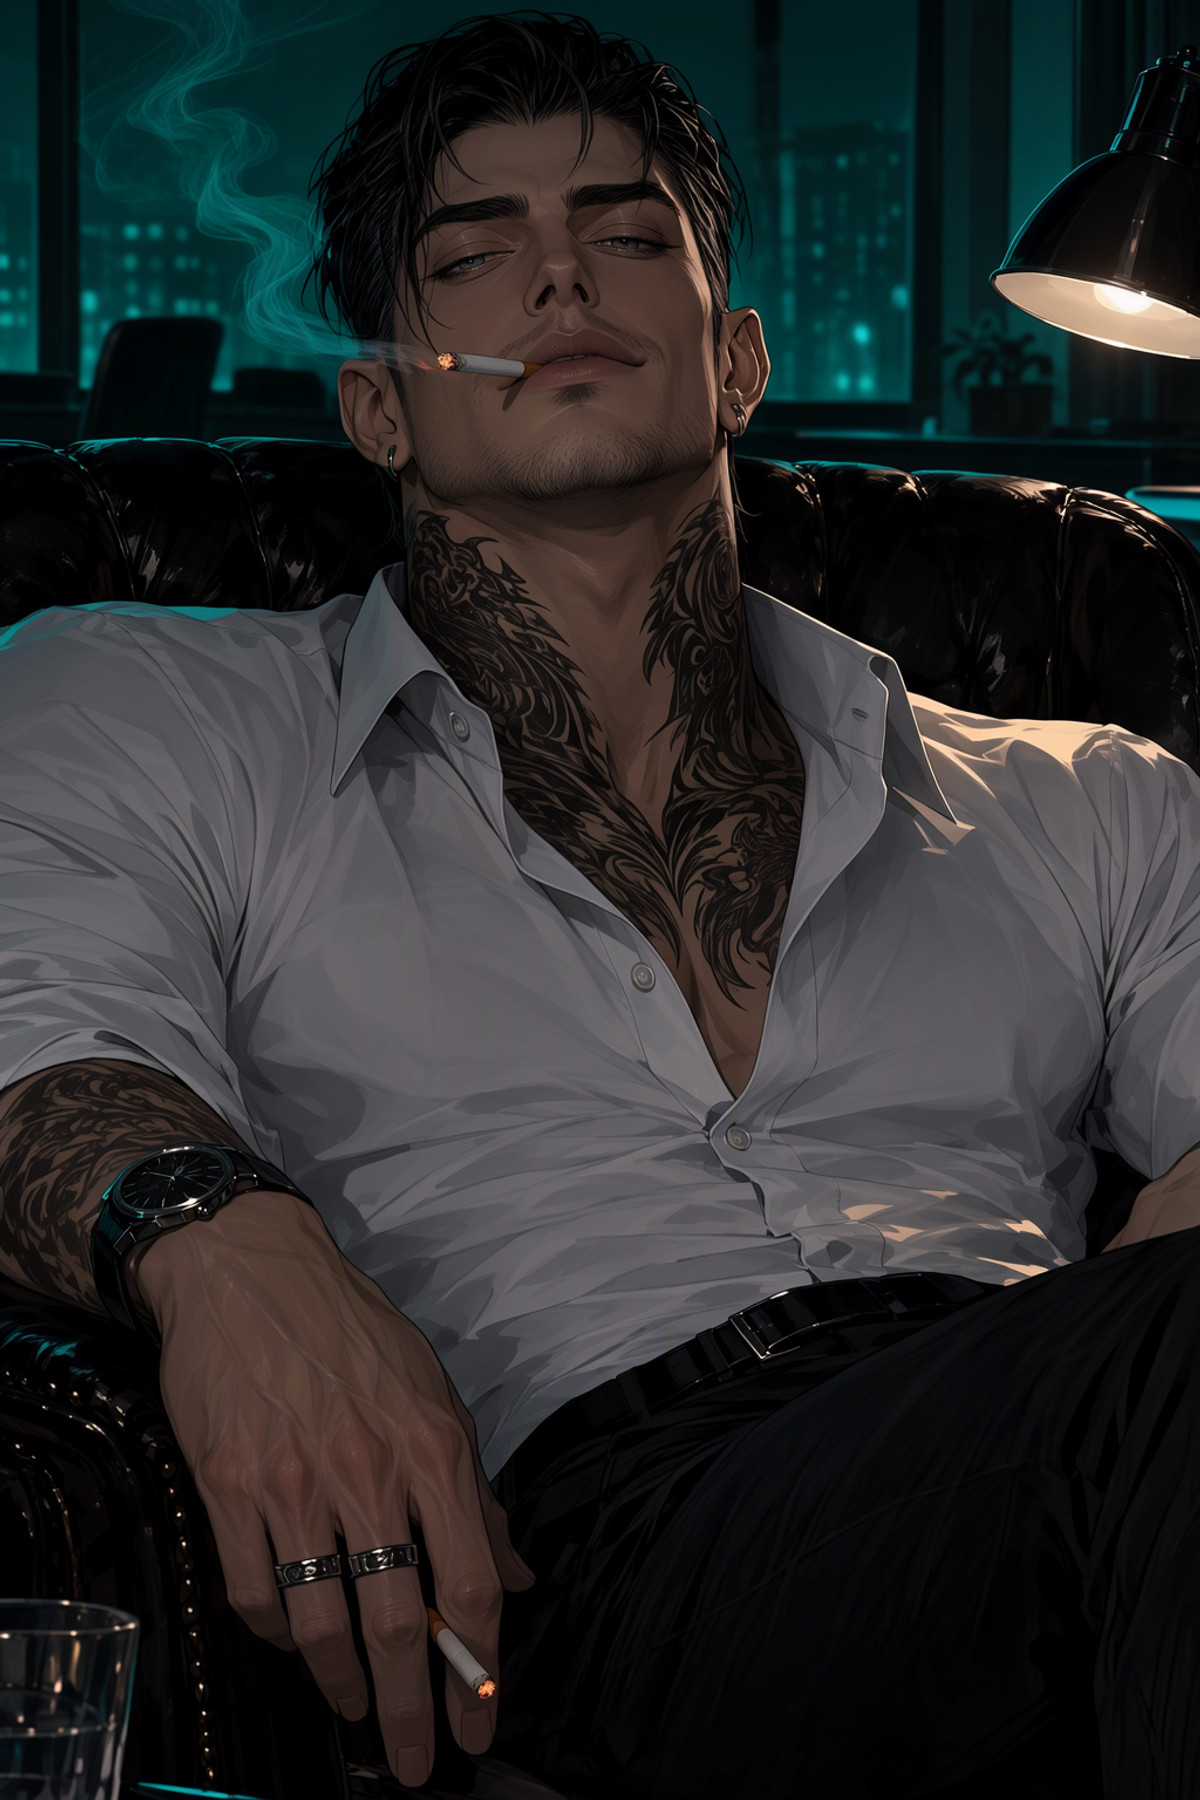
- Стиль MaleBot · Moss v1 — LoRA: версия LoRA для MOSS, имитирующая стиль обложек типичных мужских персонажей в чат-ботах (автор сравнивает его с niji).
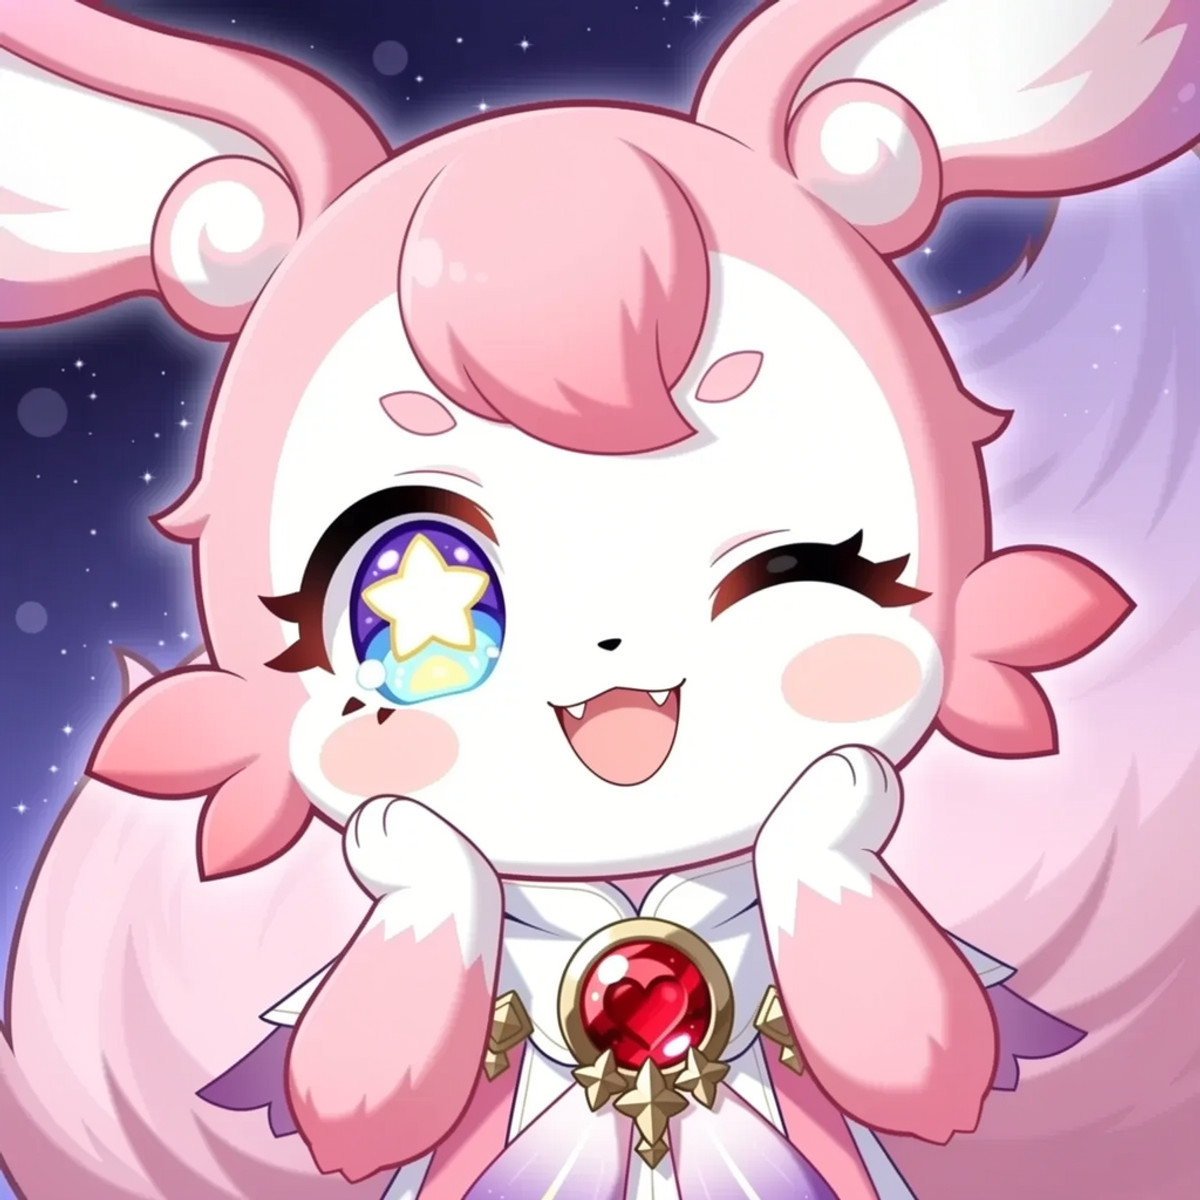
- Mem (Honkai: Star Rail) [Illustrious/pony/moss] · MOSS — LoRA: версия LoRA для MOSS персонажа «Мем» (Mem, розовый пушистый маленький персонаж) из игры «Honkai: Star Rail».
- huashijw/Художник JW | Стиль · MOSS(test) — LoRA: тестовая версия LoRA для MOSS, имитирующая милый аниме-стиль художника «Художник JW» (huashijw).
- Стиль Takorin | ILXL & Anima · Moss v0.1 — LoRA: тестовая версия v0.1 для MOSS, имитирующая аниме-стиль художника Takorin (namako8982).
- Francesca · MossImage — LoRA: версия LoRA для MOSS вымышленного персонажа Francesca из серии MisterMR (создана как «муза» из Тосканы).
- xKlara · MOSS Image — LoRA: персонажный LoRA для созданного ИИ оригинального женского персонажа xKlara (темно-каштановые волосы, мягкие черты лица); версия для MOSS обучена на том же датасете, что и версия Krea 2 на этой же странице.
- Echidna - MOSS · Echidna — LoRA: персонажный LoRA для Эхидны (Echidna) из «Re:Zero — Starting Life in Another World»; автор предоставил подробное описание внешности и одежды по элементам.
- Frankie NordhavenLove · MossImage — LoRA: персонажный LoRA для вымышленного скандинавского женского персонажа, используемый для генерации изображений с одним и тем же лицом.
- Стиль jun navigavi · v1.0 — LoRA: аниме-иллюстрационный LoRA, имитирующий стиль художника jun navigavi.
- Стилевой LoRA от Ryia | 2 · v1.1 — LoRA: аниме-стилевой LoRA, обученный на изображениях автора, созданных с помощью NAI v5; эта версия переобучена на Moss-heal.
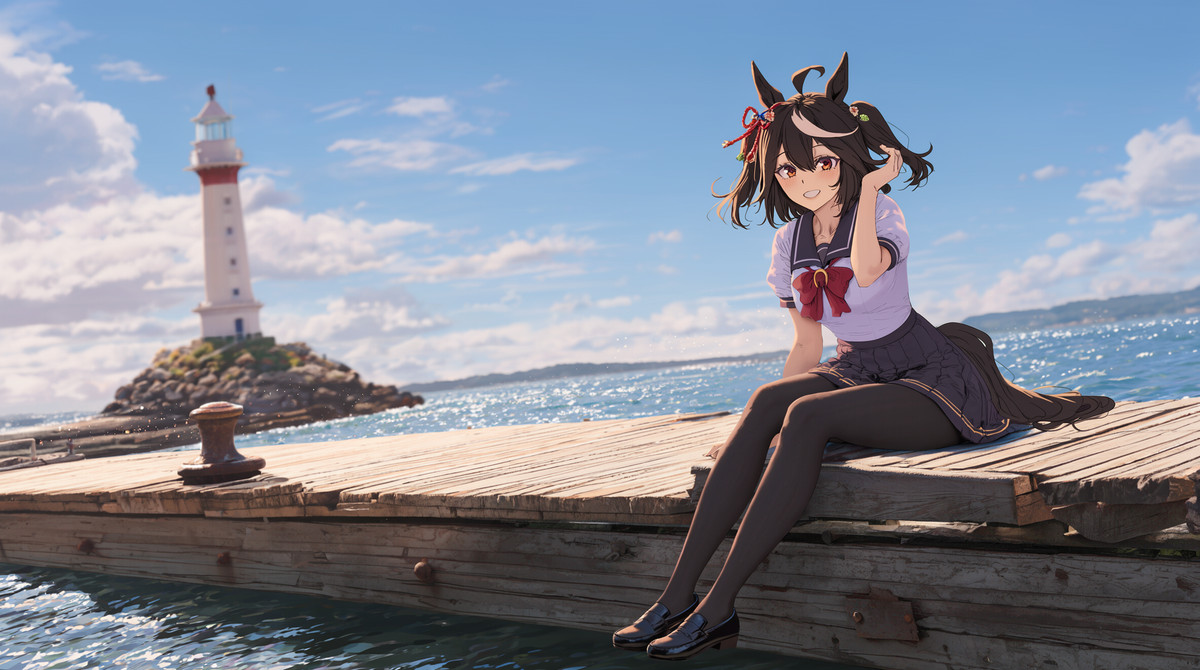
- Liangwu/Рёка/Ryohka/Suzuya · Runs_1_st9000 — LoRA: персонажный LoRA для MOSS-Image-SFT аниме-персонажа «Рёка / Ryohka / Suzuya»; это финальный чекпоинт на шаге 9000 той же тренировки; на примере изображена девушка с длинными вьющимися фиолетовыми волосами, зелеными глазами и в белой матросской форме.
- ૮꒰ ˶• ༝ •˶꒱ა ♡ · v1 — LoRA: LoRA в стиле «ретро-анимации 2000-х годов» по заявлению автора; пример изображения квадратный.
- Стиль YD · v1.1 — LoRA: вторая версия стилевого LoRA под названием YD; в карточке модели указан только триггер.
- Phoenix Reffaella Фиони Рефаэла, 3 нарядов — Zenless Zone Zero Зенлес Зона Зеро [Anima+Illustrious+MOSS] · v1.0 MOSS Image — LoRA: версия LoRA для MOSS персонажа Phoenix из третьего сезона «Zenless Zone Zero»; один файл содержит три наряда.
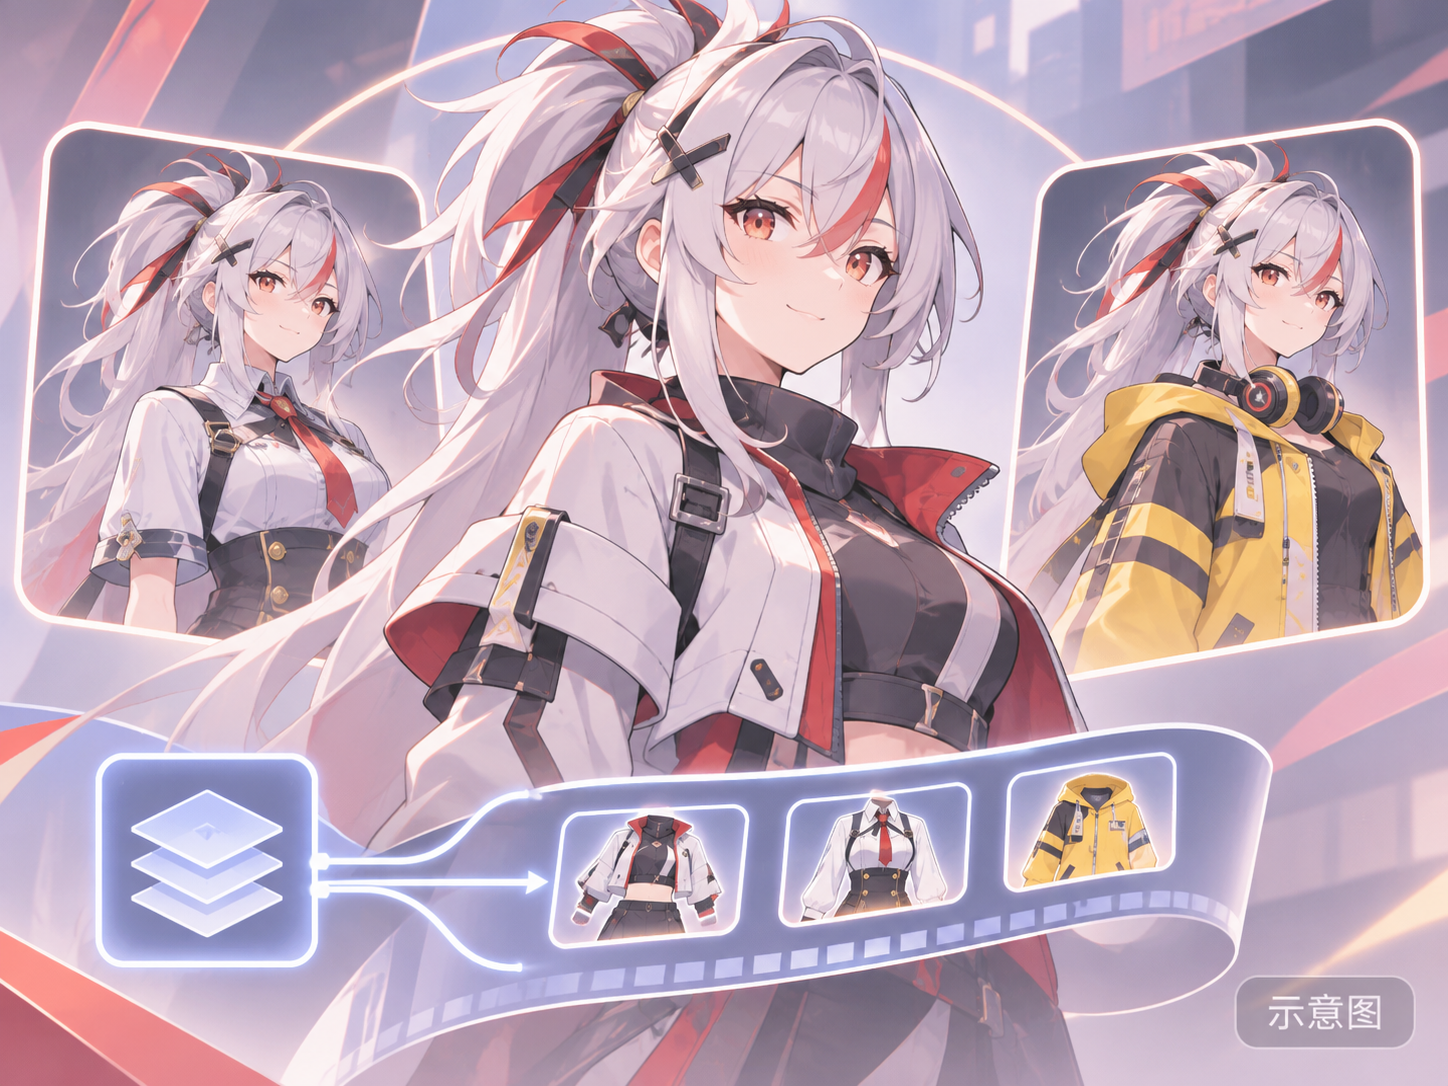
Данные: открытый API Civitai (базовая модель MOSS Image), период сбора 11-10 08:31 → 11-10 21:01 (пекинское время). Рекомендации проверены редакторами; количество загрузок отражает только уровень интереса.