貞貞のAIレーダー · MOSS Image · 2026-11-10 夕刊
今号の 35 個の新バージョン:強くおすすめ 2 · おすすめ 9 · 注目すべき 10 · 収録のみ 14
編集後記 今号では 44 個の MOSS 新バージョンをレビューし、S評価が 2 個、A評価が 9 個、B評価が 10 個、C評価が 14 個で、9 個は除外しました。おすすめは、レトロなフルページ広告スタイルの LoRA「Ad Infinitum」の MOSS 版です。画面を古い商品カード、ポスター、雑誌広告のように仕上げ、引用符で時代感のあるタイトルを書き出すことができます。トリガーワード、強度、ステップ数、CFG、タイポグラフィの方法まで全て記載されています。同じく S評価なのは thedeoxen のポーズ制御 LoRA で、DWPose のスケルトン画像を入力すると新しいキャラクターが同じポーズを取ります。同作者の Canny、線画、落書き、深度、法線、セグメンテーション制御 LoRA は A評価です。他に FGO の廊下シーン背景、アニメスクリーンショット風 v2、スマホのスナップ写真風のリアルな写真などが A評価です。説明が一・二文しかない人物/画風 LoRA や有料先行体験版のキャラクター LoRA は C評価です。涼屋(Liangwu)キャラクター LoRA の 8 個の中間ステップスナップショットは最終 st9000 版のみを残し、Ceiling Fisheye Cam の Krea2 版は誤って MOSS とラベル付けされた Krea 2 ウェイトであるため、いずれも除外しました。
強くおすすめ(2)
【S】Ad Infinitum - Krea 2 · Classic - MOSS
LoRA · ポート · 作者 AriaMaiven · 公開 11-10 10:48 · ダウンロード 50
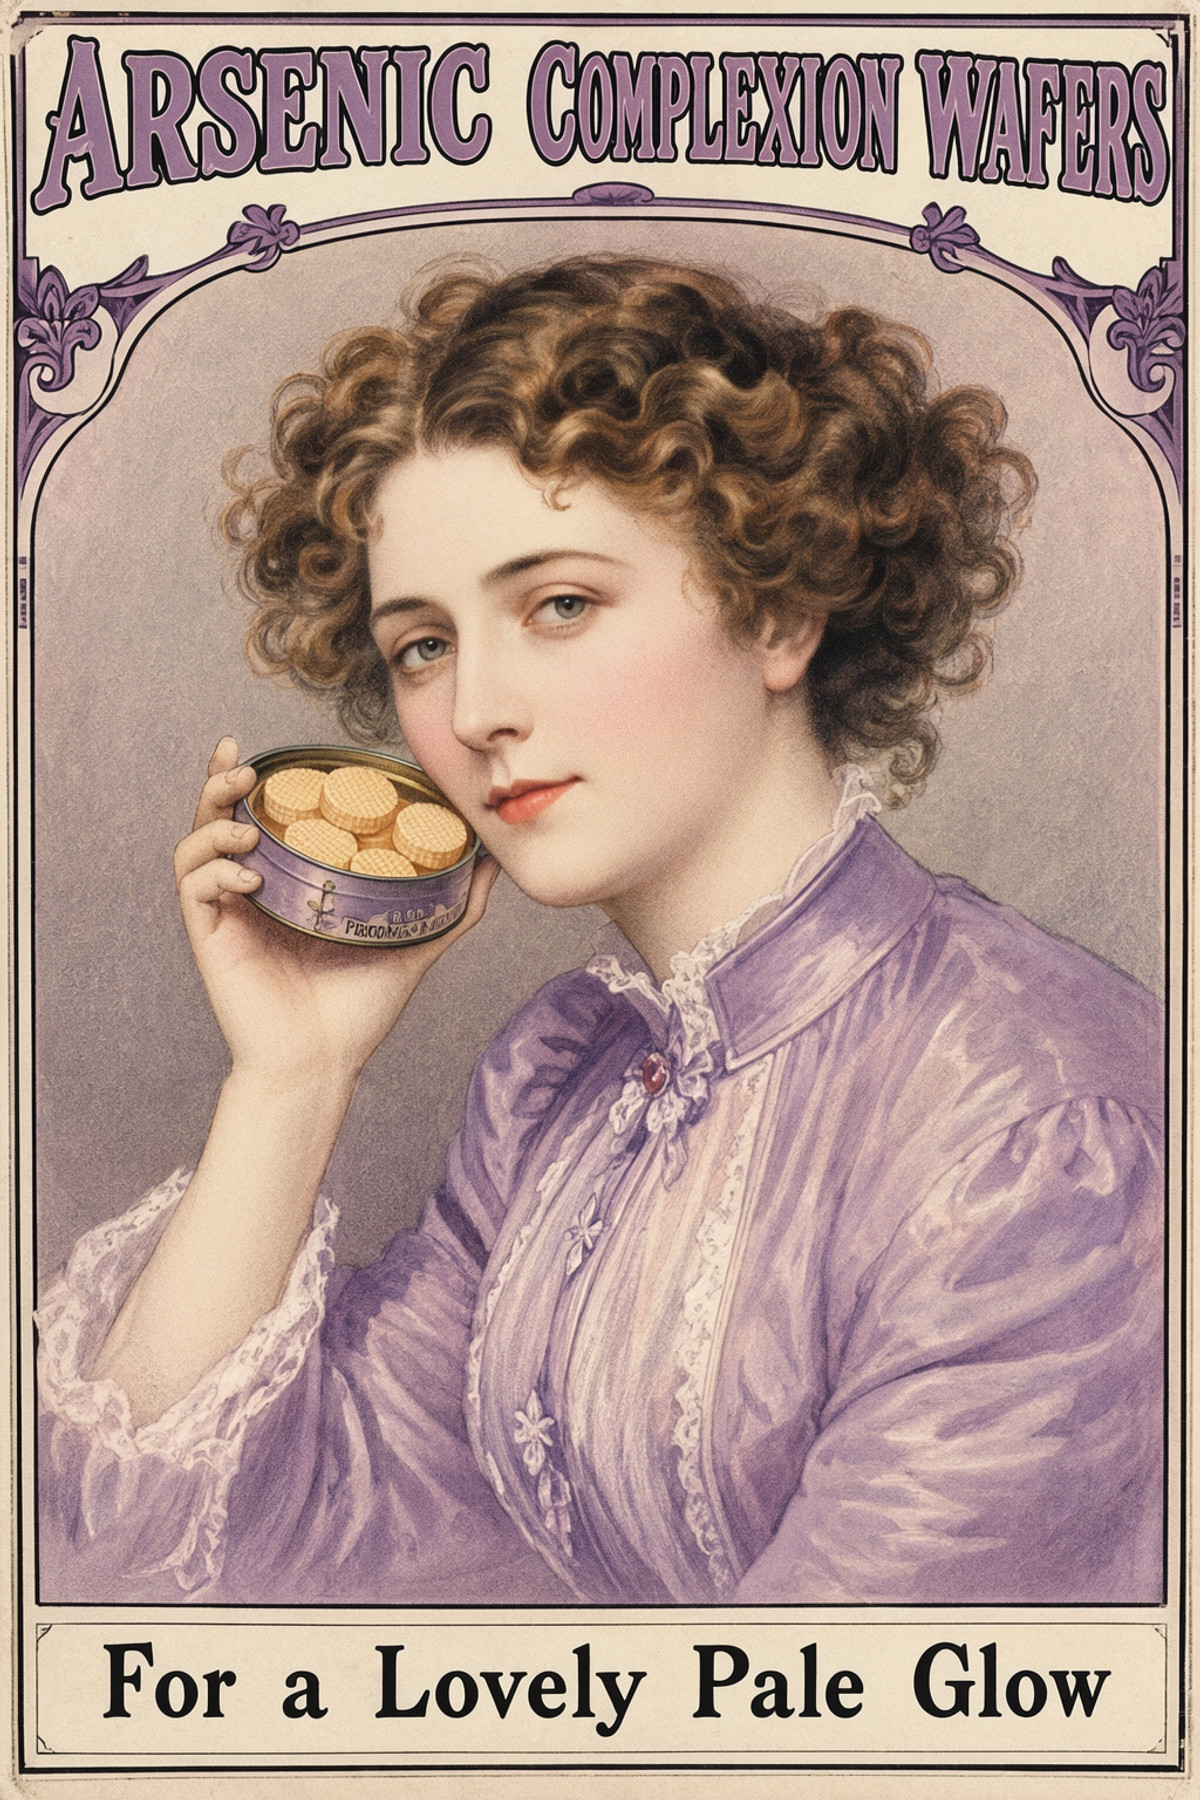
レトロ広告ページスタイル LoRA の MOSS 版(Classic):画面を 1885–1948 年の商品カード、ポスター、雑誌広告のような点描彩色、インクラインの縁取り、クリーム色の紙面のフルページ広告に仕上げ、プロンプトに従って古い大文字タイトルを書き出すことができます。
このグループのおすすめ:方向性が独特(単なるレトロフィルターではなくフルページの古い広告)、トリガーワード、強度、ステップ数、CFG、サイズ、タイポグラフィの方法が全て記載されており、再現のハードルが低いです。
画像
おすすめ理由
- ポート:同じページには Krea 2 の Classic と Future Vintage の2バージョンがあり、モデルページの累計ダウンロード数は 303 回です。MOSS 版は MOSS Base で訓練され、既存のテキストを除去した同一の 46 枚のパブリックドメイン商品カード/ポスター/雑誌広告を使用しています。トリガーワードは adnclsk を引き継いでいます
- レトロポスター、古い広告、ブランドパロディ、編集用画像などのテキスト生成に対応します。作者はタイポグラフィの方法を提供しており、プロンプトの末尾で各文を引用符で囲み位置を指定すると、MOSS が時代感のある大文字フォントで書き出します
- パラメータが揃っています:強度 0.7 から 1.0;MOSS Image (SFT)、30 ステップ、CFG 3、euler / simple、1024 x 1536。作者によると、LoRA なしでは MOSS は現代のデジタルイラストしか描けないとのことです
- 作者はギャラリーの各画像にプロンプトとパラメータが付いていると述べています。無料であり、ライセンスは出力画像の使用とサイト内レンタルを許可しています。公開後約 10 時間で 50 回のダウンロードがありました
使い方
- プロンプトの最初の単語に adnclsk を書き、その後ろに広告の主題と画面を記述します。強度は 0.7 から 1.0 で、タイトルが長い場合は 0.7 の方がクリーンです
- テキストを入れる場合は末尾に以下のように書きます:The only words on the page are the headline "…" at the top …, and the line "…" on a cream panel at the bottom。各文を引用符で囲み、位置と色を指定します
- MOSS Image (SFT)、30 ステップ、CFG 3、euler / simple、1024 x 1536。後で自分でタイポグラフィを行う予定でも、プロンプトにタイトルとフッターを指定してください。そうしないと、電車や風景の画像が油絵風にブレてしまいます
- poster、lithograph、vintage や年代を示す単語は再度書かないでください。作者によると LoRA 自体に時代感が備わっているためです
リスクと制限
- 表示可能なサンプルは 5 枚で、他に 4 枚がレーティングにより非表示です。LoRA の有無を比較した同一シードの対照実験はありません
- 訓練セットはわずか 46 枚です。Krea 2 版に付属していた ComfyUI ワークフローの圧縮ファイルは MOSS 版には含まれていないため、自分で構築する必要があります
- ライセンスにはクレジット表記が要求されます。作者は転載や出力画像を用いた他モデルの訓練には事前の許可が必要だと声明しています
- この項目は実行されていません
トリガーワード:adnclsk
【S】MOSS-Image Pose Control · v1.0
LoRA · 新モデル · 作者 thedeoxen · 公開 11-10 16:20 · ダウンロード 29
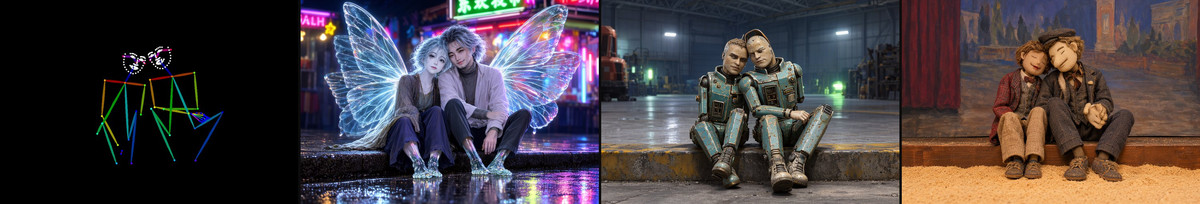
MOSS-Image-SFT のポーズ制御 LoRA:黒背景のカラー DWPose スケルトン画像を入力すると、生成されるキャラクターがスケルトンと同じ身体、手、顔のポーズを取ります。外見、服装、シーンは全てプロンプトで決定されます。
同作者は同日に7つの制御 LoRA を公開しており、訓練方法とサンプリングパラメータは同じで、入力する制御画像の種類のみが異なります。ポーズ制御は能力として最も独立しておりワークフローも完全なため、このグループの代表として採用しました。
画像
おすすめ理由
- 新機能:MOSS-Image-SFT にスケルトンによるポーズ制御機能を追加します。作者の説明によると、これは ControlNet 型の編集 LoRA であり、公式の color/depth 結合アダプターではありません。通常の LoRA ローダーで読み込み、スケルトン画像を唯一の参照画像として Text Encode MOSS-Image Edit に送ります
- 着せ替えやキャラクター変更、写真内のポーズを別のキャラクターへ転写する用途、絵コンテやキーフレームで身体動作の一貫性を求めるシーンに対応します。同作者の Canny / Lineart などの輪郭制御とは異なり、関節位置のみを固定し、衣服の輪郭や背景は固定しません
- 作者が示したスケルトン抽出方法:comfyui_controlnet_aux の DWPose で、身体、手、顔の3項目を有効にします。黒背景のカラー骨格画像は訓練時の制御画像と一致しています
- パラメータとワークフローが揃っています:ComfyUI ワークフロー JSON(写真読み込み→スケルトン抽出→エンコード→サンプリング)が付属しており、第 4500 ステップのアーカイブを選択、強度 1.0、30 ステップ、CFG 4、euler + simple、トリガーワードなし
- サンプルは 3 枚で、それぞれ「スケルトン+異なるプロンプト3つ」のコラージュ画像となっており、同じポーズで3種類のキャラクターへの変更を直接確認できます。公開 5 時間で 29 回のダウンロード、3 のいいねがあり、このグループの制御 LoRA 中で最も注目度が高いです。無料であり、ライセンスは出力画像の使用と販売を許可しています
使い方
- ベースモデルには MOSS-Image-SFT を使用します:UNet moss_image_sft_int8_convrot、テキストエンコーダー qwen3.5_9b_w4a8_gptq(タイプは moss_image を選択)、VAE flux2-vae_small。LoRA は UNet に接続し、強度は 1.0 です
- DWPose(身体+手+顔)を用いて参照写真からスケルトンを抽出し、黒背景のカラー骨格画像を唯一の参照画像として Text Encode MOSS-Image Edit に接続します。正負両方のエンコードノードの edit format を ai-toolkit に設定します
- 30 ステップ、CFG 4、euler + simple。トリガーワードはなく、プロンプトにはキャラクターのアイデンティティ、服装、素材、シーンを記述し、関節を一つずつ説明する必要はありません
リスクと制限
- 敏感レベルのサンプル 4 個が非表示であり、表示されている 3 枚よりも多いです
- スケルトンに欠落している肢体について、作者はプロンプトで対応する関節を確実に補完できないと述べています。指などの細部がどの程度追従するかについては言及されていません
- MOSS-Image-SFT(作者は int8 量子化 UNet を使用)向けにのみ訓練されています。MOSS-Image-Base や他の精度との組み合わせでのパフォーマンスについては作者は述べておらず、ベースモデルを Other とラベル付けしています
- 完全なモデルカードでは、制御が硬すぎる場合に強度を 0.7 へ下げることを推奨していますが、訓練値は 1.0 です
- サンプル画像に生成パラメータが付いていません。この項目は実行されていません
おすすめ(9)
【A】Anime Screencap Style · v2.0
LoRA · バージョン更新 · 作者 kanakiy · 公開 11-10 09:48 · ダウンロード 57
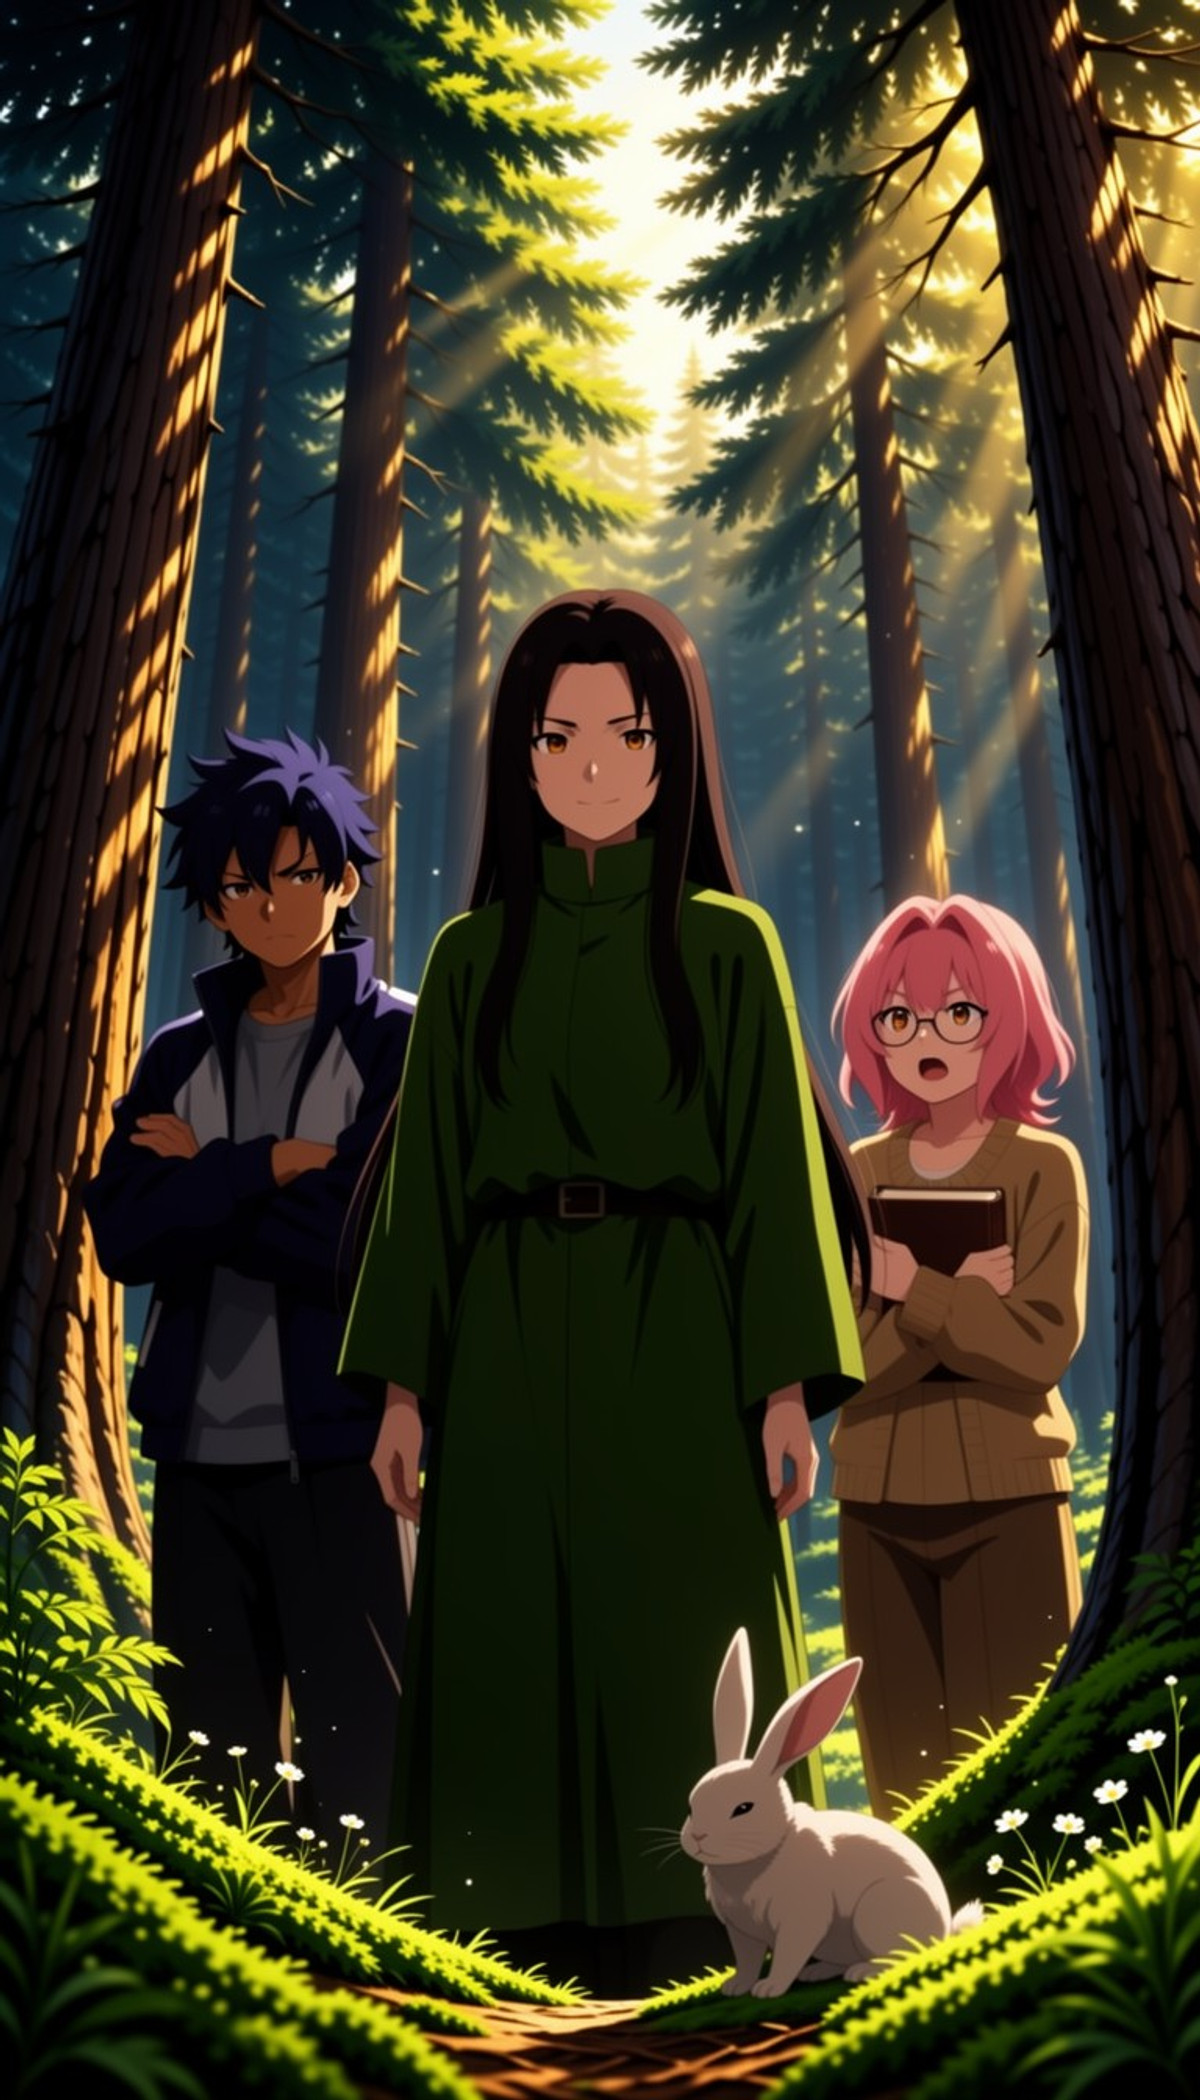
現代アニメスクリーンショットスタイル LoRA の v2.0:フラットなセルルック着色、ほぼないソフトシャドウ、太くクリーンなライン、高彩度カラー、ワイドスクリーン風の構図。
自動 A評価を維持:スタイルの目標が具体的に記述されサンプルも多いですが、v2 では強度とサンプリングパラメータが欠けています。
画像
おすすめ理由
- バージョン更新:作者は v2.0 で訓練データを改善し、v1.0 のデータに含まれていたツナデと綾瀬星子(Seiko Ayase)の2キャラクターを削除したと述べています(名前で能動的に呼び出すことは可能です)。v1.0 ではこれら2キャラクターの影響で強度 0.6–0.8 が推奨されていました
- 一般的なソフトなグラデーションの二次元ではなく「アニメスクリーンショット感」を求めるテキスト生成に対応します。作者によると、多くのアニメモデルよりもフラットでハードな仕上がりになるとのことです
- サンプルは 17 枚。無料。公開後約 11 時間で 57 回のダウンロードがありました
使い方
- LoRA を読み込むだけで使用可能で、トリガーワードはありません。v1.0 では強度 0.6–0.8 が推奨されていますが、v2.0 の強度は作者から提供されていないため、同じ範囲から試行開始してください。ステップ数と CFG は作者から提供されていません
リスクと制限
- 作者は更新説明を書いていません(バージョン説明は空欄で、変更点はモデルカードの2文から推測されます)。v1 と v2 の対照はありません
- ライセンスには出力画像の商用利用が含まれず、レンタルのみ許可されています。サンプル 3 枚がレーティングにより非表示です
- この項目は実行されていません
【A】Realistic Photo by Amateur Snapshot · MOSS
LoRA · 新モデル · 作者 858654128784 · 公開 11-10 18:02 · ダウンロード 73
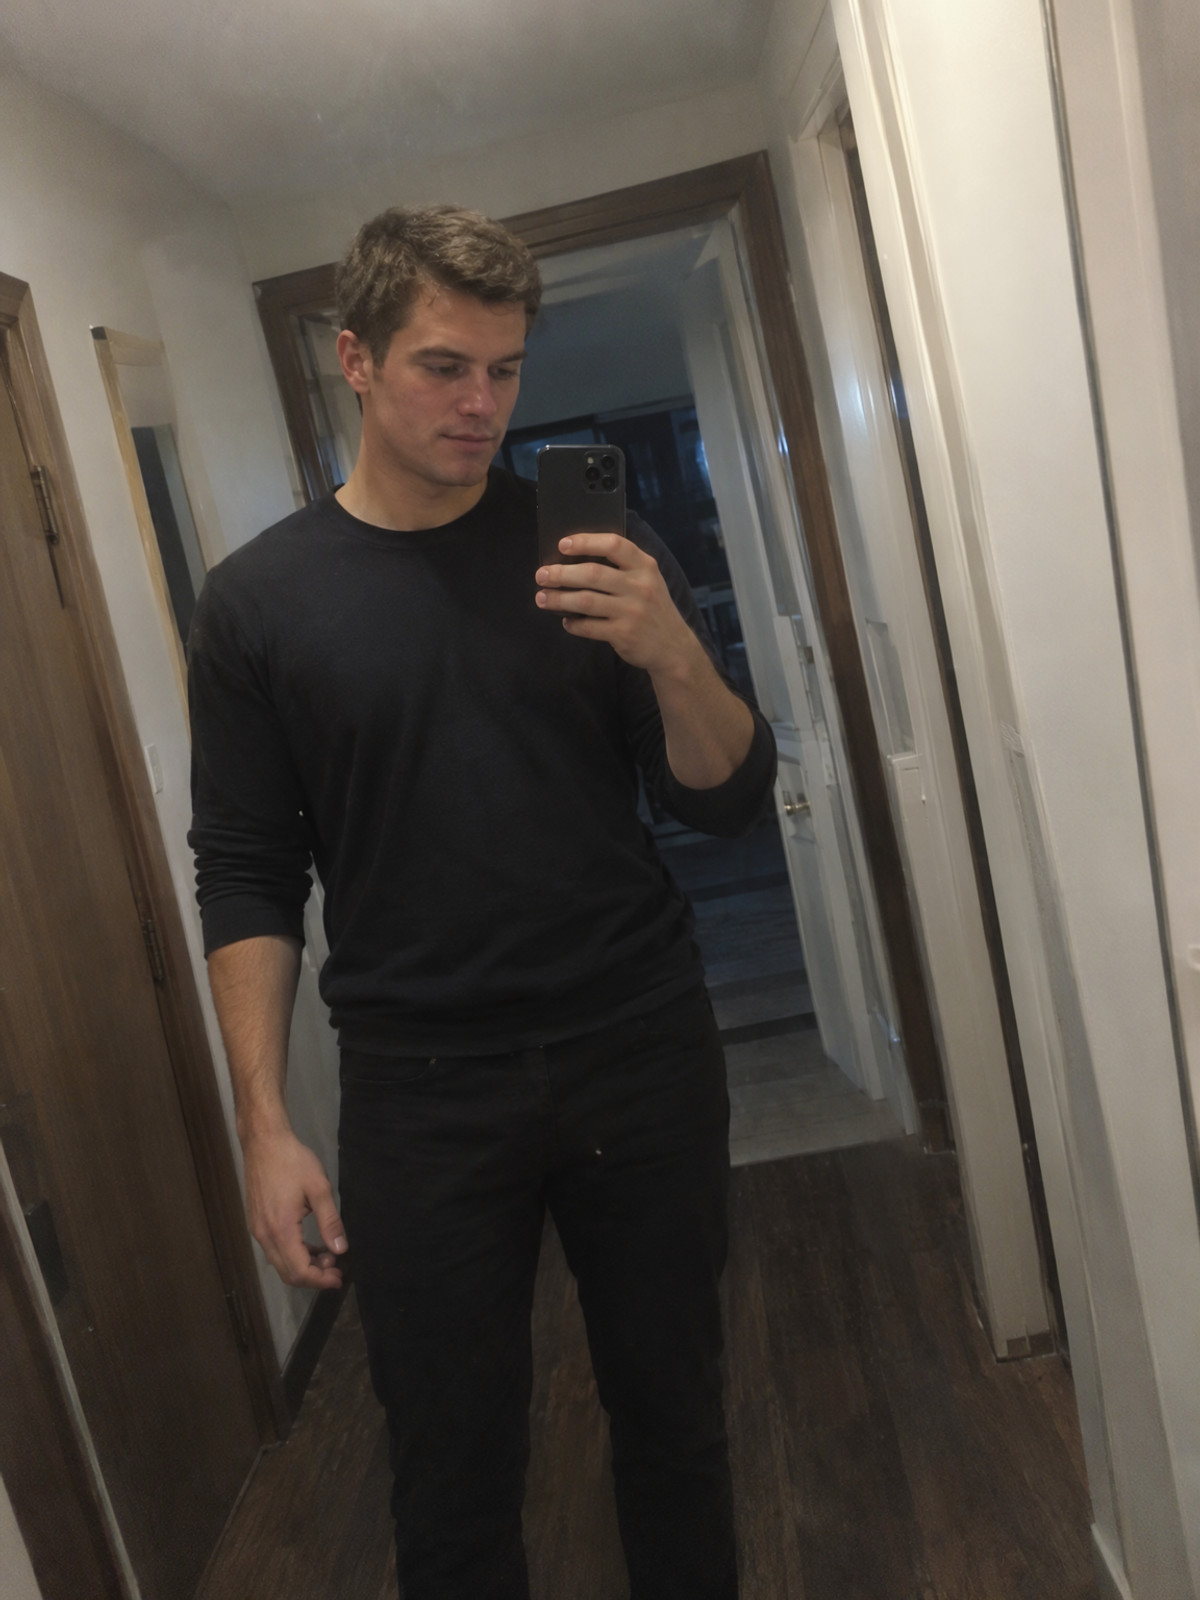
スマホのスナップ写真スタイルのリアルな写真 LoRA:鏡越しセルフィー、フロントカメラセルフィー、キッチンテーブル、エレベーター内、ペットの上からの撮影など。歪んだ構図、不均一な光、暗部のノイズ、リアルな肌の質感を再現し、AI画像特有の過度にクリーンなスタジオ感を排除します。
自動 A評価を維持:用途が明確でプロンプトの書き方をそのまま真似できますが、強度とサンプリングパラメータが欠けており、表示可能なサンプルが少ないです。
画像
おすすめ理由
- 新モデル:MOSS 版のみで、目標は「一般人がスマホで撮った写真」であり、リタッチされたリアルな写真ではありません
- 作者はプロンプトの書き方を提供しています:amateur smartphone photo で始まり、場所、誰がスマホを持っているか、光の方向を記述します。「スマホが顔の半分を隠している」「前景で半分切れたマグカップ」などの詳細を加えるとよりリアルになります
- 無料であり、ライセンスは出力画像の使用、レンタル、販売を許可しています。公開後約 3 時間で 73 回のダウンロードがあり、このグループで最もダウンロード速度が速いです
使い方
- プロンプトを amateur smartphone photo で始め、場所、撮影者、光源を記述し、遮蔽物や前景のトリミングなどのスナップ写真の詳細を加えます。トリガーワードはありません
- 強度、ステップ数、CFG は作者から提供されていません
リスクと制限
- サンプル 15 枚がレーティングにより非表示で、表示されているのは 5 枚のみです。ページは混合コンテンツです
- パラメータがなく、LoRA の有無を比較した対照実験もありません。訓練データのソースについては作者から説明がありません
- 本物と見紛うような人物の生活写真が生成されるため、公開時には AI 生成であることを明記してください。この項目は実行されていません
【A】Chaldea Corridor: Fate/Grand Order · MOSS-sft01
LoRA · 新モデル · 作者 RHU_AIstudio · 公開 11-10 19:59 · ダウンロード 10
『Fate/Grand Order』の旧カルデア廊下のシーン背景 LoRA:一つのトリガーワードでこの廊下を固定し、状態語で通常、暗い、破損、凍結などの外観を切り替えます。
自動 A評価を維持:シーン LoRA の使い方が最も明確に記述されており、トリガーワード、強度、状態語をそのままコピーできますが、カバーする場所は一つのみでサンプリングパラメータが欠けています。
画像
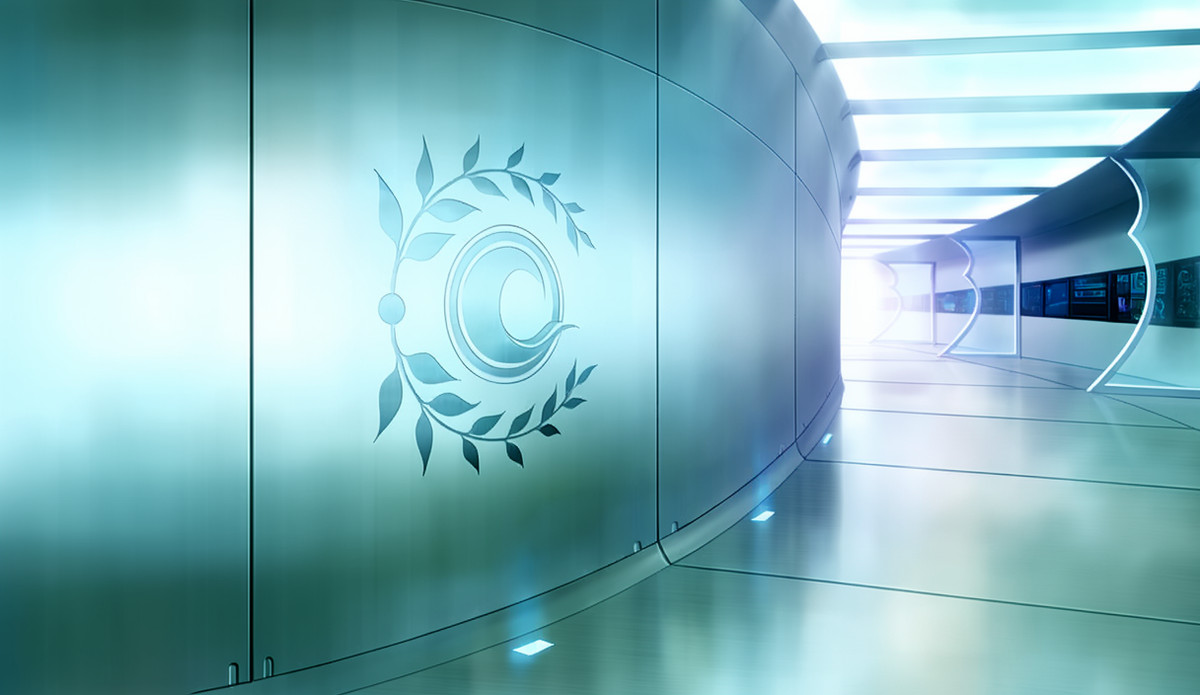
推奨理由
- 新モデルであり、今期では珍しいシーン/背景系LoRA:人物には関与せず、特定の場所を再現することに特化しており、二次創作イラスト、キャラクター立ち絵の背景、ビジュアルノベル風シーン画像などに最適
- 作者が学習ソースを明記:7枚のゲーム内背景素材を使用し、通常/暗い/ぼやけた/破損/凍結の各状態と2つのカメラアングルをカバー
- トリガーワード、強度、状態ワードがすべて提供:corridor_(chaldea)_(fate)、強度 1.0;bright lighting、dark, dim lighting、damaged, cracked wall, debris、frozen, ice, flooded、close-up は紋章付き壁面のカメラアングルに対応
- 表示可能なサンプルは 3枚、1枚は非表示;無料、ライセンスは緩く、画像出力、販売、派生作品の作成が許可されている
使い方
- プロンプトに corridor_(chaldea)_(fate) を記述し、必要に応じて状態ワードを追加:bright lighting / dark, dim lighting / damaged, cracked wall, debris / frozen, ice, flooded;紋章付き壁面の角度が必要な場合は close-up を追加;LoRA強度は 1.0
- ステップ数、CFG、サンプラーは作者が未提供;バージョン名は MOSS-sft01 だが、BaseモデルとSFTモデルのどちらで学習されたかは作者が明記していない
リスクと制限
- 学習データはわずか 7枚のため、出力できるのは基本的にこの廊下のこれらの状態と2つのカメラアングルに限られ、他の視点で構造が維持されるかは不明
- 素材はゲームの著作権付き背景画像であり、ライセンスは緩いものの、商用利用前には原作の著作権を考慮する必要がある
- モデルカードは短い段落のみで、人物を追加する場合の書き方や複数LoRA併用に関する説明がない;本項目は動作確認未実施
トリガーワード:corridor_(chaldea)_(fate)
【A】MOSS-Image Scribble Control · v1.0
LoRA · 新モデル · 作者 thedeoxen · 公開 11-10 16:53 · ダウンロード数 23
MOSS-Image-SFT用のスケッチ制御LoRA:黒背景上の太く柔らかい白い線画を数本入力すると、大きな筆勢と塊のみを反映し、ディテール、質感、スタイルはプロンプトで自由に決定できる。
画像
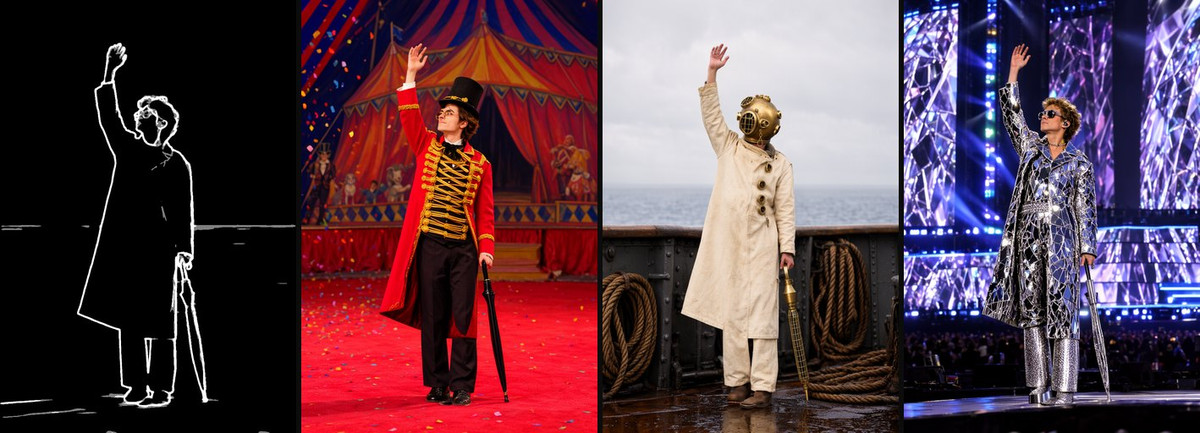
推奨理由
- 新機能:同作者の制御シリーズの中で最も緩い設定で、主要な線画と大きな形体のみを扱い、細部の輪郭は追わない;作者はCanny / Lineartによる精修前の迅速な構図テストに使用することを推奨
- スケッチからの起稿、絵コンテの線画、写真から大きな形体のみを残して再描画する場合に有用:入力は手描きの数本の線でも、写真から抽出したソフトエッジでも可能
- 前処理:ワークフローではHED Soft-Edge Linesを使用し、safe modeを有効化;学習用スケッチはCannyや線画よりも太く柔らかく、作者はHEDのソフトエッジが細いPiDiNetスケッチよりも学習画像に近いと述べている
- ComfyUIワークフロー添付;第 5000 ステップで保存、強度 1.0、30 ステップ、CFG 4、euler + simple;3枚のコラージュサンプル
- 無料、ライセンスは画像出力と販売を許可;公開 4 時間で 23 回ダウンロード
使い方
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small)、LoRAをUNetに適用、強度 1.0
- HED Soft-Edge Lines(safe mode)または黒背景に手描きした太い白い線画を唯一の参考画像としてText Encode MOSS-Image Editに接続、ポジティブ/ネガティブエンコードのedit formatをai-toolkitに設定
- 30 ステップ、CFG 4、euler + simple;トリガーワードなし;作者は雑多なエッジ画像よりも、少なく明確な線画を推奨し、質感、色、細かいディテールはプロンプトに任せることを推奨
リスクと制限
- 制御が緩いため、細部の位置は固定されず、正確な輪郭が必要なシナリオではCannyまたはLineartに切り替えるべき
- MOSS-Image-SFT専用で学習;ベースモデルはOtherと表記;1件のセンシティブレベルのサンプルは非表示
- 完全なモデルカードでは、制御が硬すぎる場合は強度を 0.7 に下げることを推奨
- 本項目は動作確認未実施
【A】MOSS-Image Normal Control · v1.0
LoRA · 新モデル · 作者 thedeoxen · 公開 11-10 16:51 · ダウンロード数 24
MOSS-Image-SFT用のノーマルマップ制御LoRA:カラーノーマルマップ画像を入力すると、物体の体積と表面の向きを保持し、マテリアルとシーンのみを変更できる。
画像
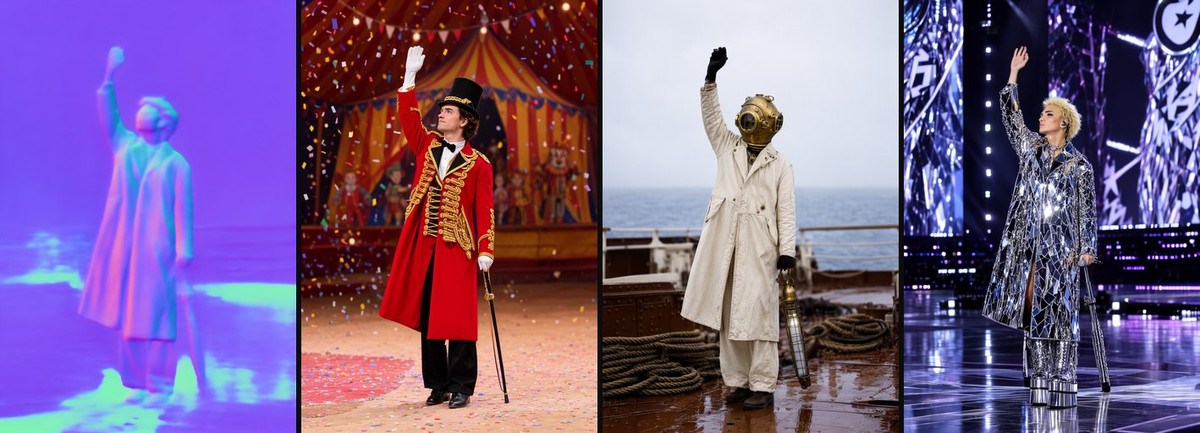
推奨理由
- 新機能:デプスマップよりも「表面がどの方向を向いているか」をさらに制御し、体積と向きを固定したままマテリアルを変更可能;作者が挙げる用途は、固定形体のマテリアル変更/ライティング再設定、製品画像で物体の体積を固定したいシナリオ
- 製品画像のマテリアル変更、彫刻や小道具のテクスチャ再適用、デプスは正しいが表面の向きも制御したいシナリオに有用;入力は写真または3Dレンダリングから出力したノーマルマップ
- 前処理:ワークフローではBAE Normal Mapを使用、学習画像は一般的な紫/青/緑のカメラ空間ノーマルマップ;作者はカメラ空間ノーマルマップを使用すべきで、グレースケール高度マップは不可であり、ノーマルマップが滑らかほど体積がクリーンになり、ノイズが多いと余計な突起が発生すると注意喚起
- ComfyUIワークフロー添付;第 5000 ステップで保存、強度 1.0、30 ステップ、CFG 4、euler + simple;3枚のコラージュサンプルはCanny / Lineart版と同じテスト写真を使用
- 無料、ライセンスは画像出力と販売を許可
使い方
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small)、LoRAをUNetに適用、強度 1.0
- BAE Normal Mapでカラーカメラ空間ノーマルマップ画像を出力し、唯一の参考画像としてText Encode MOSS-Image Editに接続、ポジティブ/ネガティブエンコードのedit formatをai-toolkitに設定
- 30 ステップ、CFG 4、euler + simple;トリガーワードなし、プロンプトにはマテリアルとシーンを記述
リスクと制限
- 用途はCanny / Depthより狭く、主にマテリアル変更やライティング変更の場面で深度制御より価値が高い
- 3Dソフトから出力したノーマルマップがBAEの色規則と一致するかは自己確認が必要で、作者は説明していない;MOSS-Image-SFT専用で学習;ベースモデルはOtherと表記;1件のセンシティブレベルのサンプルは非表示
- 完全なモデルカードでは、制御が硬すぎる場合は強度を 0.7 に下げることを推奨
- 本項目は動作確認未実施
【A】MOSS-Image Segmentation Control · v1.0
LoRA · 新モデル · 作者 thedeoxen · 公開 11-10 16:54 · ダウンロード数 25
MOSS-Image-SFT用のセマンティックセグメンテーション制御LoRA:フラットな色ブロックで構成された領域マップを入力すると、各領域の境界と大きなレイアウトを保持し、各ブロックが何になるかはプロンプトで決定できる。
画像
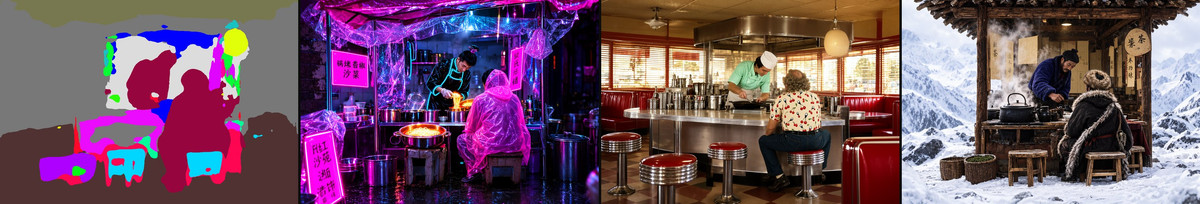
推奨理由
- 新機能:線画や深度ではなく「領域ブロック」で制御するため、画面を人物、家具、背景などの大きなブロックに分割してから、全体のレンダリングスタイルを変更するのに適している;作者は境界と大きな体積が保持されると述べている
- シーンのブロック化構図、カラースクリプト風レイアウト、人物と家具の位置を保持したまま全体を再描画する場合に有用
- 前処理:ワークフローではUniFormerセマンティックセグメンテーションを使用;学習画像はフラットな色ブロックで全面を覆い、大きな黒い未ラベル領域はない;作者は色ブロックの色は単なる領域番号であり、出力画像の色にはならず、マテリアルはプロンプトに記述すべきであり、グラデーションやテクスチャは領域を乱すと注意喚起
- ComfyUIワークフロー添付;第 4500 ステップで保存、強度 1.0、30 ステップ、CFG 4、euler + simple
- 無料、ライセンスは画像出力と販売を許可;公開 4 時間で 25 回ダウンロード
使い方
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small)、LoRAをUNetに適用、強度 1.0
- UniFormerで画面全体を覆うフラットな領域マップを出力(大きな黒背景を残さない)、唯一の参考画像としてText Encode MOSS-Image Editに接続、ポジティブ/ネガティブエンコードのedit formatをai-toolkitに設定
- 30 ステップ、CFG 4、euler + simple;トリガーワードなし、プロンプトには各領域の主体とマテリアルを明確に記述
リスクと制限
- 作者は背景を黒く残すセグメンターはこの重みと相性が悪く、他のセグメンテーションモデルに変更する際は注意が必要と述べている
- 表示可能なサンプルは 2枚、1件のセンシティブレベルのサンプルは非表示;MOSS-Image-SFT専用で学習;ベースモデルはOtherと表記
- 完全なモデルカードでは、制御が硬すぎる場合は強度を 0.7 に下げることを推奨
- 本項目は動作確認未実施
【A】MOSS-Image Lineart Control · v1.0
LoRA · 新モデル · 作者 thedeoxen · 公開 11-10 16:37 · ダウンロード数 21
MOSS-Image-SFT用の線画制御LoRA:黒背景上の白い細い線画を入力すると、線画構造に従って生成し、着色、マテリアル、スタイルはプロンプトで決定できる。
画像
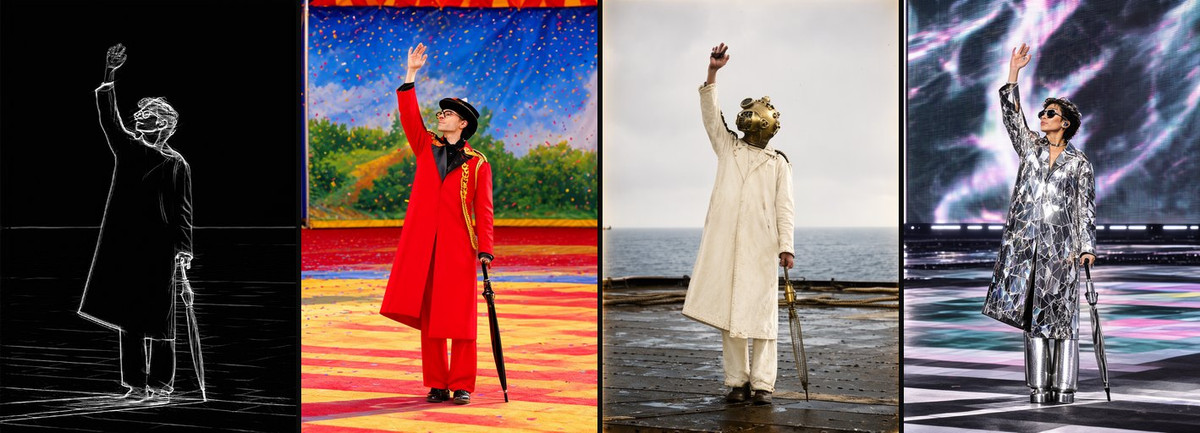
推奨理由
- 新機能:CannyとScribbleの中間——クリーンな輪郭線に従うが、元のCanny画像に見られるノイズや斑点は含まない;作者が挙げる主な用途は線画への着色
- 線画への着色、デザインスケッチからの完成画像生成、写真から線画構造を保持したままシーン変更する場合に有用;作者は手描き線画と写真から抽出した線画の両方が使用可能だが、線は軽く、疎であることが前提と述べている
- 前処理に注意:ワークフローではRealistic Lineartを使用し、coarseを有効化;作者はこれが精密線画モードよりも学習画像に近いと述べている;白線黒背景であり、手元に黒線白背景の線画がある場合は事前に反転が必要
- ComfyUIワークフロー添付;第 5000 ステップで保存、強度 1.0、30 ステップ、CFG 4、euler + simple;3枚のコラージュサンプルはCanny版と同じテスト写真を使用
- 無料、ライセンスは画像出力と販売を許可
使い方
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small)、LoRAをUNetに適用、強度 1.0
- Realistic Lineart(coarse有効)で黒背景白線画を出力し、唯一の参考画像としてText Encode MOSS-Image Editに接続、ポジティブ/ネガティブエンコードのedit formatをai-toolkitに設定
- 30 ステップ、CFG 4、euler + simple;トリガーワードなし、プロンプトには色、マテリアル、画風を記述
リスクと制限
- 作者は疎な線画が密な素描よりも学習データに適合すると述べており、線画が過密な場合の挙動は説明されていない
- MOSS-Image-SFT専用で学習;ベースモデルはOtherと表記;1件のセンシティブレベルのサンプルは非表示;本グループはダウンロード数が最少(21回)
- 完全なモデルカードでは、制御が硬すぎる場合は強度を 0.7 に下げることを推奨
- 本項目は動作確認未実施
【A】MOSS-Image Canny Control · v1.0
LoRA · 新モデル · 作者 thedeoxen · 公開 11-10 16:29 · ダウンロード数 23
MOSS-Image-SFT用のCannyエッジ制御LoRA:黒背景上の白いCannyエッジ画像を入力すると、物体の輪郭、構図、細部エッジを固定し、マテリアル、配色、スタイルはプロンプトに委ねる。
画像
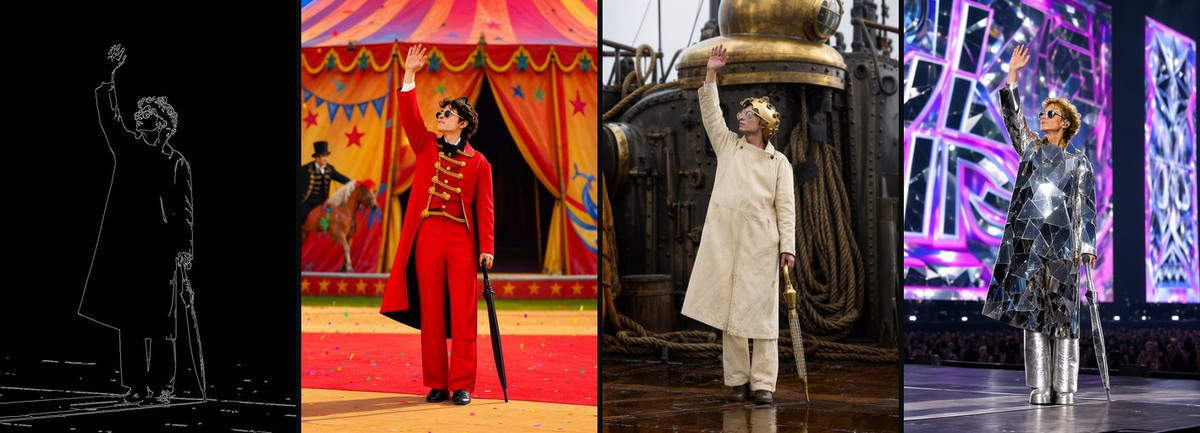
推奨理由
- 新機能:同一作者によるLoRAシリーズの中で最も制約が厳しいもので、細かな輪郭まで追従します。作者は「輪郭を保持し、色と素材を変更する」ことを目的としており、輪郭を動かしたくないレイアウト研究に適しています
- 写真のスタイル変換、同一構図での素材変更による再描画、レイアウト草案にサービスを提供:入力として写真または既存の画像を使用し、まずCannyエッジ抽出を行ってから生成します
- 前処理が具体的に記載されています:comfyui_controlnet_aux の Canny Edge、閾値 low 100 / high 200;作者は、結果がノイズまで厳密に追従しすぎる場合は、閾値を上げてエッジをクリーンにするよう推奨しています
- ComfyUI ワークフローを添付;第 4500 ステップで保存、強度 1.0、30 ステップ、CFG 4、euler + simple;3 枚の「制御画像 + 3つのプロンプト」の組み合わせ例を提供。同一作者の Normal / Scribble / Lineart と同じサーカス団長のテスト写真を使用しており、横断的な比較が可能です
- 無料、ライセンスは画像生成と販売を許可;公開 4 時間で 23 回のダウンロード
使い方
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq テキストエンコーダー、タイプ moss_image + flux2-vae_small)、LoRA を UNet に適用、強度 1.0
- Canny Edge 前処理(low 100 / high 200)で黒背景に白線画を作成し、唯一の参照画像として Text Encode MOSS-Image Edit に接続。正負のエンコードともに edit format を ai-toolkit に設定
- 30 ステップ、CFG 4、euler + simple;トリガーワードなし、プロンプトには新しい素材、配色、シーンを書き込みます
リスクと制限
- Canny 画像が密になるほど、画像は元の細部に縛られ、プロンプトによる変更の余地が小さくなります。大きな形状のみを保持したい場合は、Scribble または Lineart のワークフローに切り替えてください
- MOSS-Image-SFT のみで訓練されており、他のベースモデルや精度については作者から言及がありません。ベースモデルは Other と表記されています。1 件のセンシティブな例は非表示です
- 完全なモデルカードでは、制御が硬すぎる場合は強度を 0.7 に下げることを推奨しています
- 本項目は実行されていません
【A】MOSS-Image Depth Control · v1.0
LoRA · 新モデル · 作者 thedeoxen · 公開 11-10 16:25 · ダウンロード 22
MOSS-Image-SFT の深度制御 LoRA:手前が白く奥が黒いグレースケールの深度マップを入力し、前後景の距離と空間レイアウトを保持します。被写体とスタイルはプロンプトに委ねます。
画像
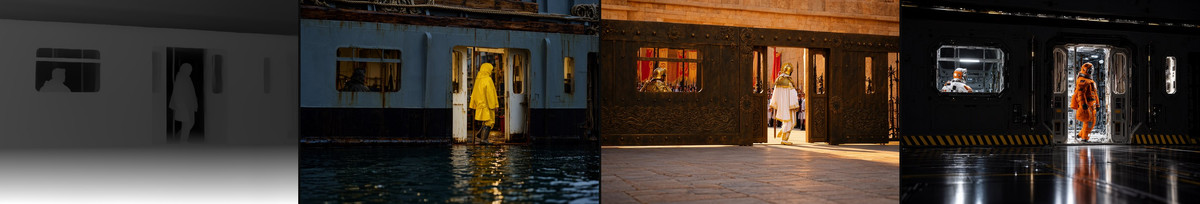
推奨理由
- 新機能:「誰が近くて誰が遠いか」とカメラの奥行きのみを固定し、すべてのエッジは固定しません。作者は「輪郭よりもカメラの奥行きが重要」な場面に適していると述べています。これは公式の MOSS color/depth 結合アダプターではなく、同一作者による編集型 LoRA である点に注意してください
- 同一カメラ位置でのスタイル変更によるシーン再構築、前景被写体と背景の分離後の素材変更、明確な前景被写体を持つ製品や室内のレイアウトにサービスを提供
- 前処理:ワークフローでは Depth Anything V2(depth_anything_v2_vitl)を使用し、手前は白、背景は黒になるようにします。作者は、反転した深度マップを使用しないよう特に注意を促しています。使用すると LoRA と競合するためです
- ComfyUI ワークフローを添付;第 5000 ステップで保存、強度 1.0、30 ステップ、CFG 4、euler + simple;作者は、広範な平坦な深度領域がプロンプトにテクスチャの余地を残すと述べています
- 無料、ライセンスは画像生成と販売を許可;3 件の「いいね」
使い方
- MOSS-Image-SFT(int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small)、LoRA を UNet に適用、強度 1.0
- Depth Anything V2 vitl でグレースケール深度マップを作成(手前が白、奥が黒、反転不可)、唯一の参照画像として Text Encode MOSS-Image Edit に接続。正負のエンコードともに edit format を ai-toolkit に設定
- 30 ステップ、CFG 4、euler + simple;トリガーワードなし、プロンプトには被写体、素材、スタイルを書き込みます
リスクと制限
- 公開されている例は 1 枚の組み合わせ画像のみで、さらに 4 件のセンシティブな例が非表示です。このグループでは公開されている証拠が最も少ないです
- 公式の depth 結合アダプターとの優劣については作者から言及がありません。MOSS-Image-SFT のみで訓練されています。ベースモデルは Other と表記されています
- 完全なモデルカードでは、制御が硬すぎる場合は強度を 0.7 に下げることを推奨しています
- 本項目は実行されていません
注目すべき項目(10)
【B】AG: Naberius - Grumpy Niji Boys · MOSS-Image
LoRA · ポート · 作者 Azriaelis · 公開 11-10 09:10 · ダウンロード 27
「Ars Goetia」シリーズの Naberius の MOSS バージョン:Niji 風の半写実的で男性キャラクター中心の画風 LoRA(タイトルは Grumpy Niji Boys)。
画像
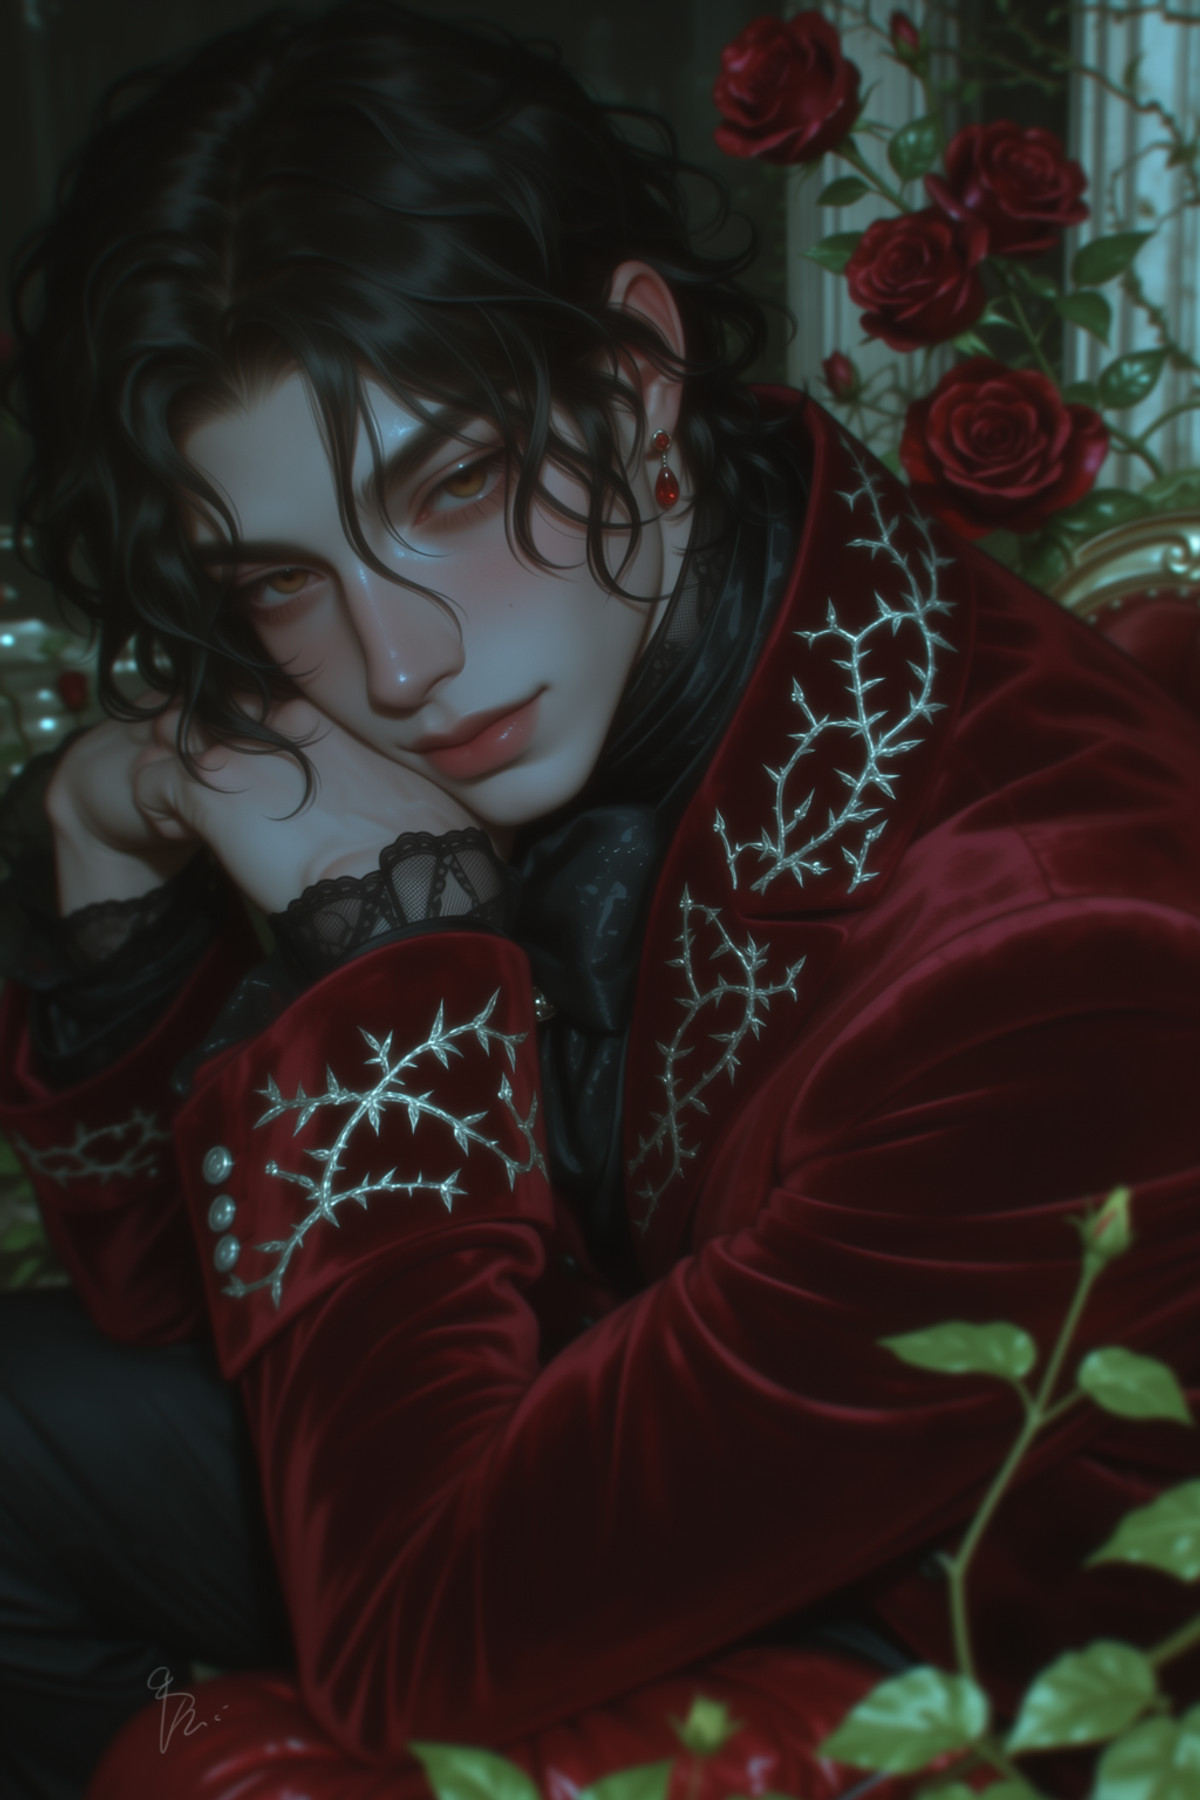
【B】HaDeS MOSS Suite Workflows · Turbo Image to Image v0.1
ワークフロー · バージョン更新 · 作者 _HaDeS_ · 公開 11-10 17:33 · ダウンロード 24
HaDeS MOSS Suite ワークフローコレクションの新バージョン:プロンプト強化ノードと HaDeS 高速化 LoRA を備えた MOSS 画像から画像への ComfyUI ワークフロー(JSON ファイルであり、新しい重みではありません)。
画像
【B】V67 Twins and Mirror · V1 MOSS
LoRA · ポート · 作者 angelomaiota · 公開 11-10 17:57 · ダウンロード 23
双子と鏡像 LoRA の MOSS バージョン:一卵性/二卵性双子、鏡の中の反射、水たまりの反射など、「一人二体」または対称的な構図の画像を生成します。
画像
【B】One obsession_MOSS · SFT v1
ベースモデル / Checkpoint · バージョン更新 · 作者 maxfeifei8 · 公開 11-10 19:20 · ダウンロード 9 · 有料
MOSS ベースモデルの One obsession の第2版 SFT v1:完全なベースモデルの重みセット(INT8 と BF16 の2種類)。名称から SFT シリーズであり、前バージョンは BASE v1 です。
画像
【B】V67 Italian Villages · V1 MOSS
LoRA · ポート · 作者 angelomaiota · 公開 11-10 15:11 · ダウンロード 21
イタリアの村の風景 LoRA の MOSS バージョン:石造りの家、狭い路地、テラコッタの屋根、山頂からの眺め、金色の光。作者は、カナルエット風の風景画と写実的な建築写真を融合させたと述べています。
画像
【B】Chenbin(鬼針草)Style | MOSS Image LoRA · v1.0
LoRA · 新モデル · 作者 NO83 · 公開 11-10 20:46 · ダウンロード 7
画家「鬼針草」の画風を模倣した MOSS 専用 LoRA:作者は、ストッキングの質感の表現が非常に優れており、髪は一般的であると述べています。
画像
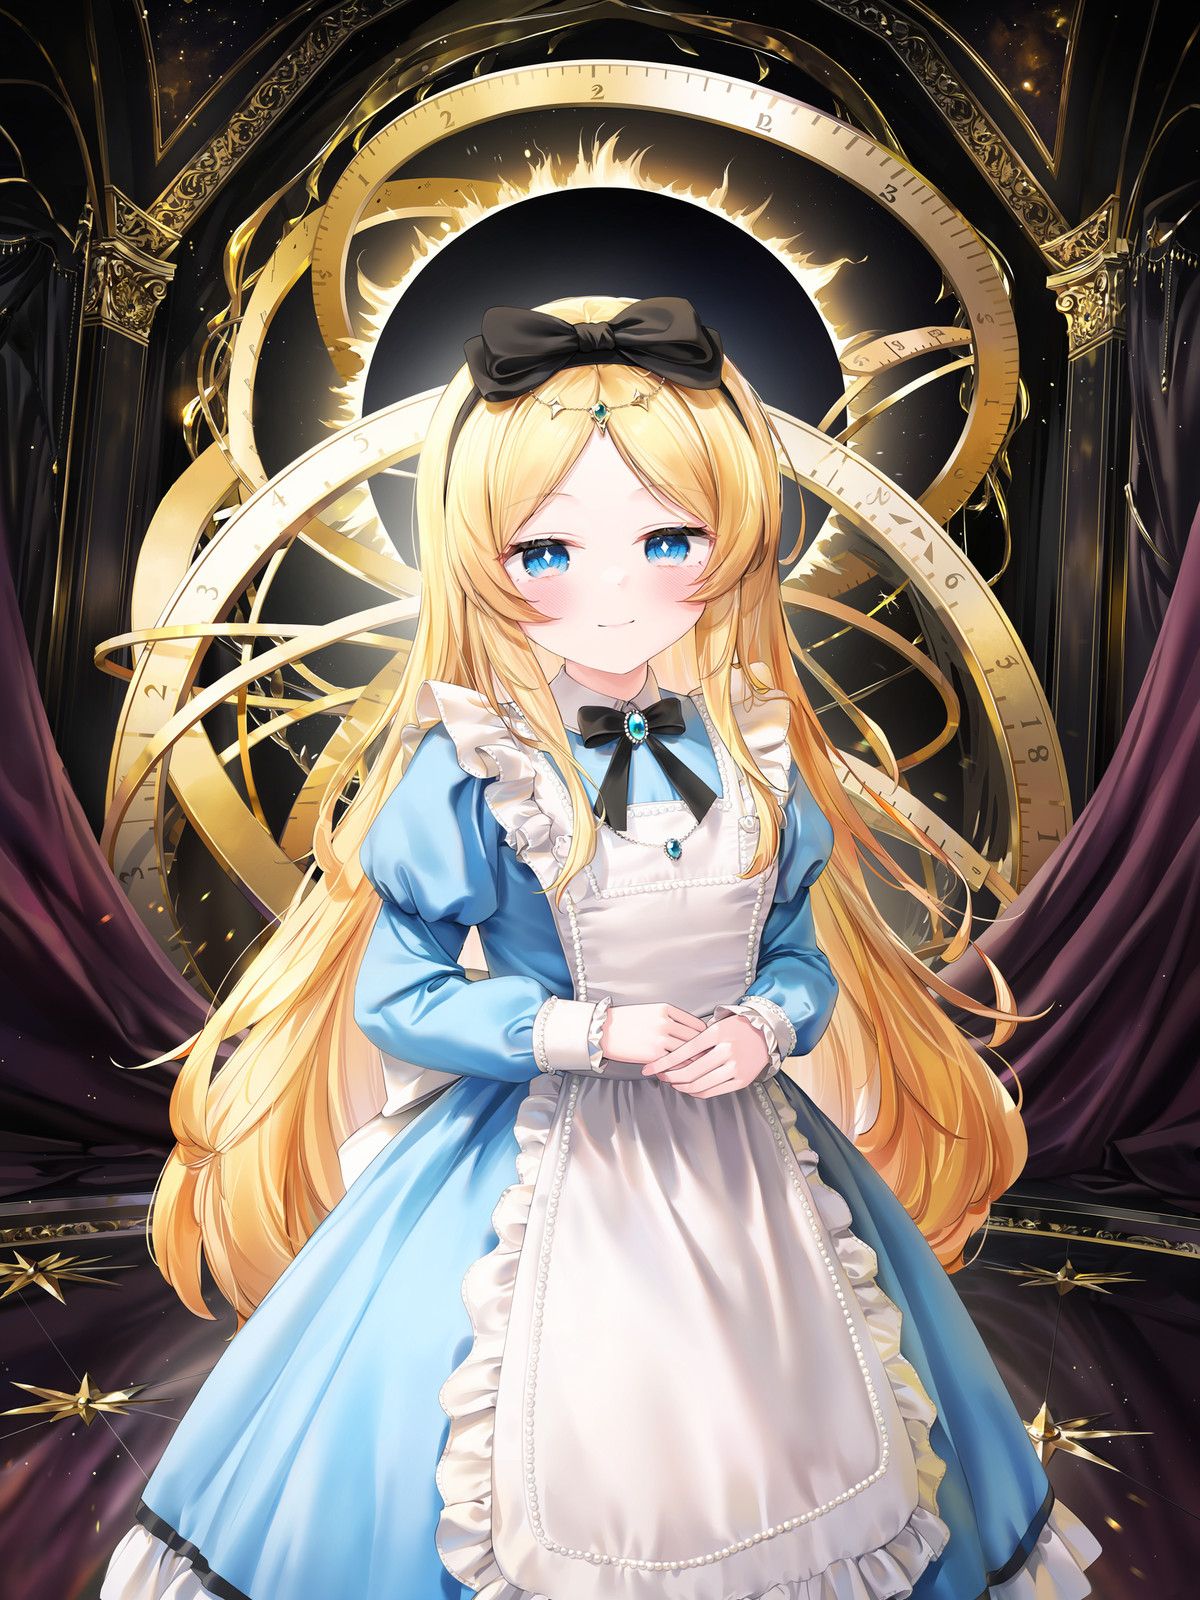
【B】Kromoss slider: blurry to sharp · v1
LoRA · 新モデル · 作者 Generated_Good · 公開 11-10 18:27 · ダウンロード 61
鮮明度スライダー LoRA:Kromoss(MOSS-Image-Base のフルファインチューニング)上で訓練され、正負の強度で前景と背景のぼかし具合を調整します。Kromoss でよく発生する画像のぼやけ問題に対処しています。
画像
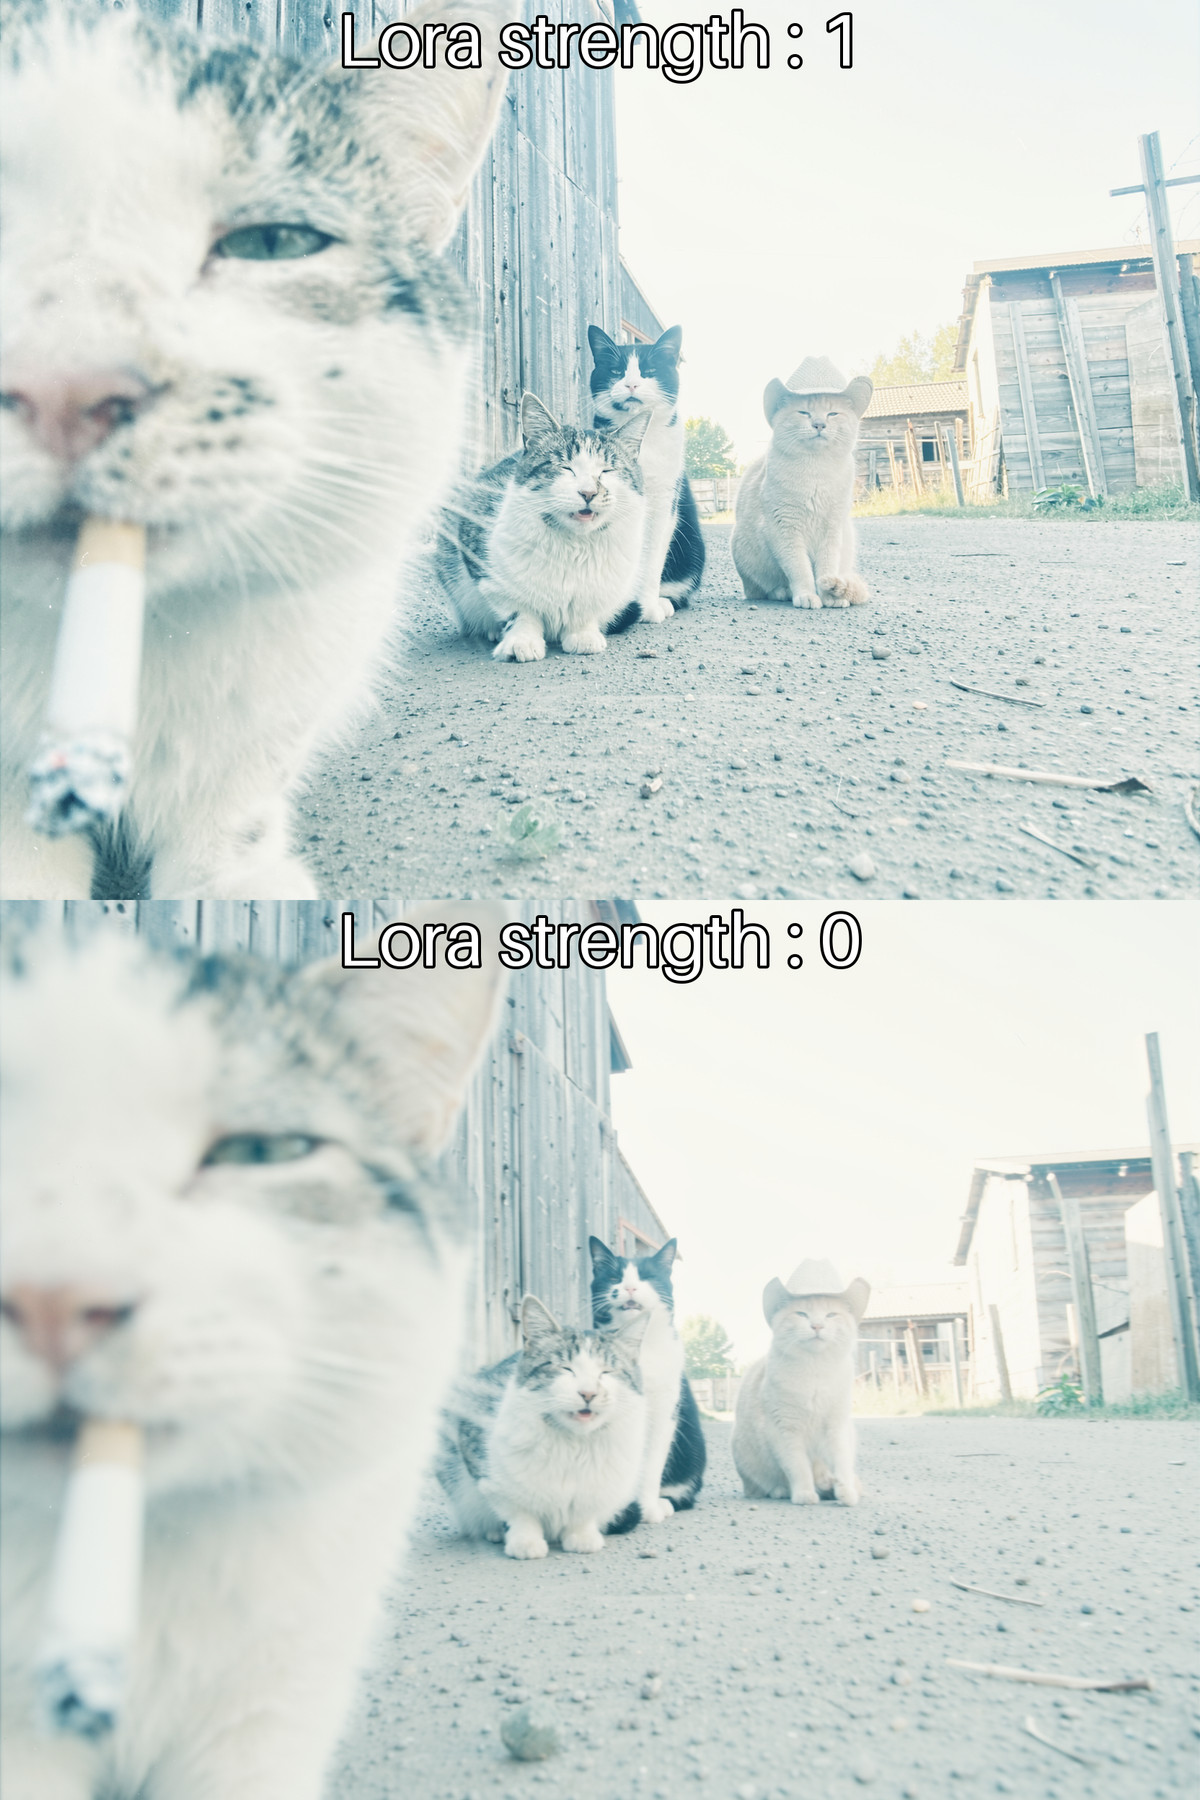
【B】釉光細絵 Glazeline style · moss-v1.0
LoRA · 新モデル · 作者 soda_Cookie · 公開 11-10 20:04 · ダウンロード 12
「釉光細絵」(Glazeline)という名前のイラストスタイル LoRA。作者はトリガーワード、完全なサンプルプロンプト、およびネガティブプロンプトを提供しています。
画像
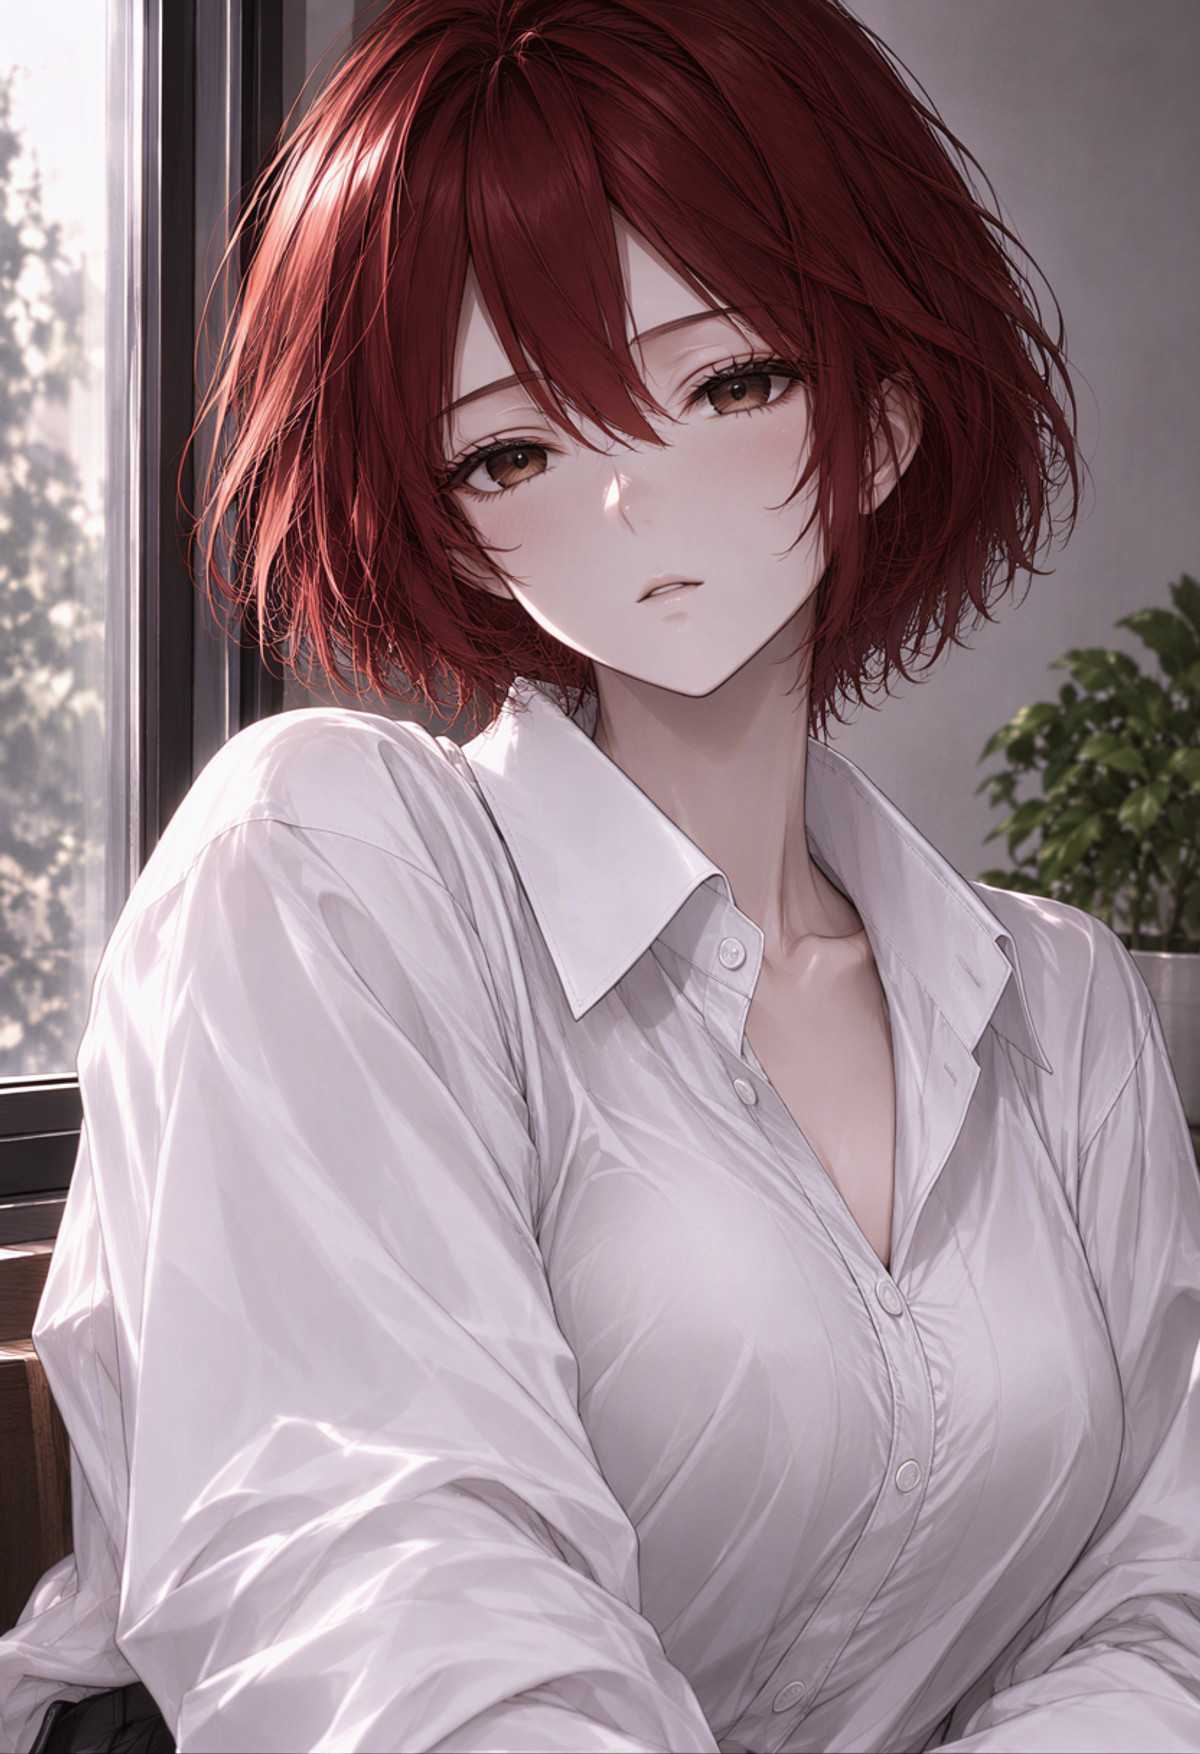
【B】紙彫り/紙人形 · v1.0
LoRA · ポート · 作者 YuChuXi · 公開 11-10 13:54 · ダウンロード 47
紙彫り / 紙人形スタイル LoRA の MOSS バージョン:画像を層状に重ねた切り紙イラストのように仕上げます。
画像
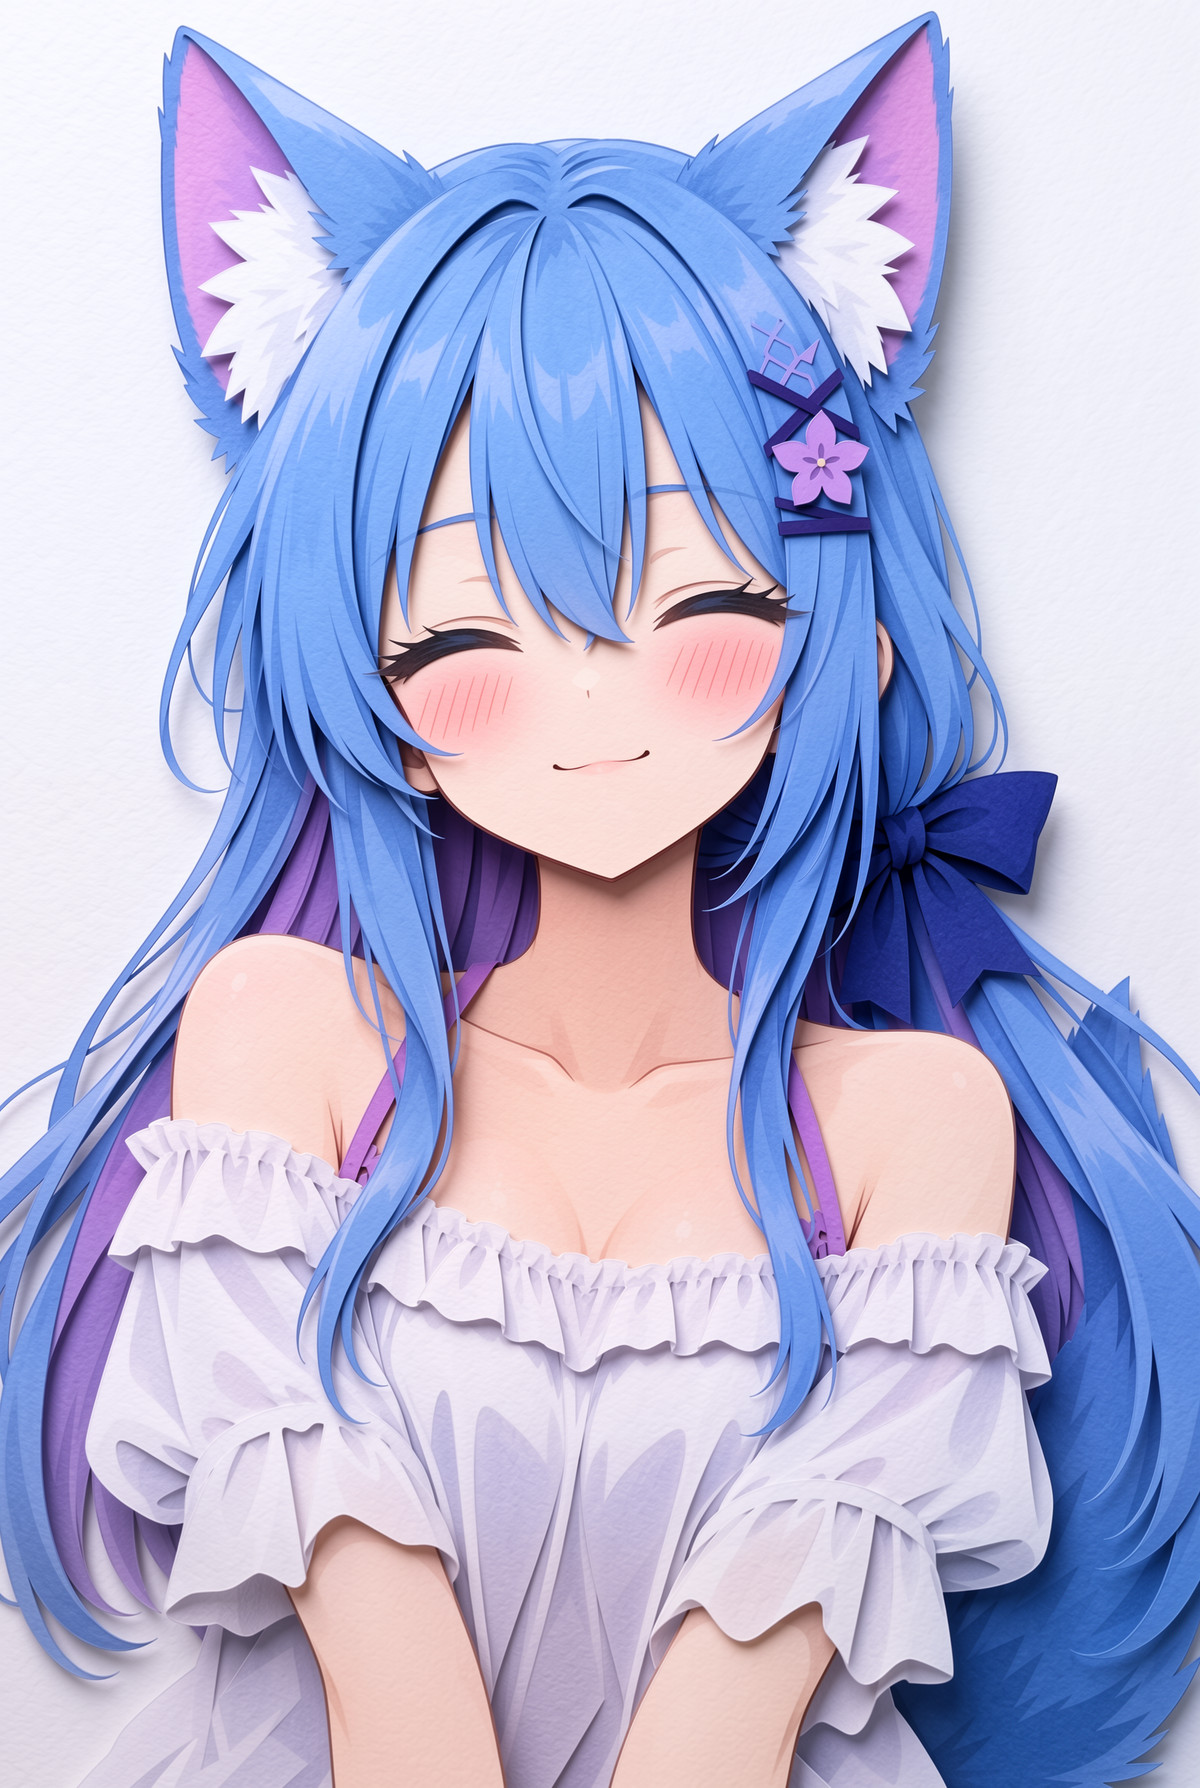
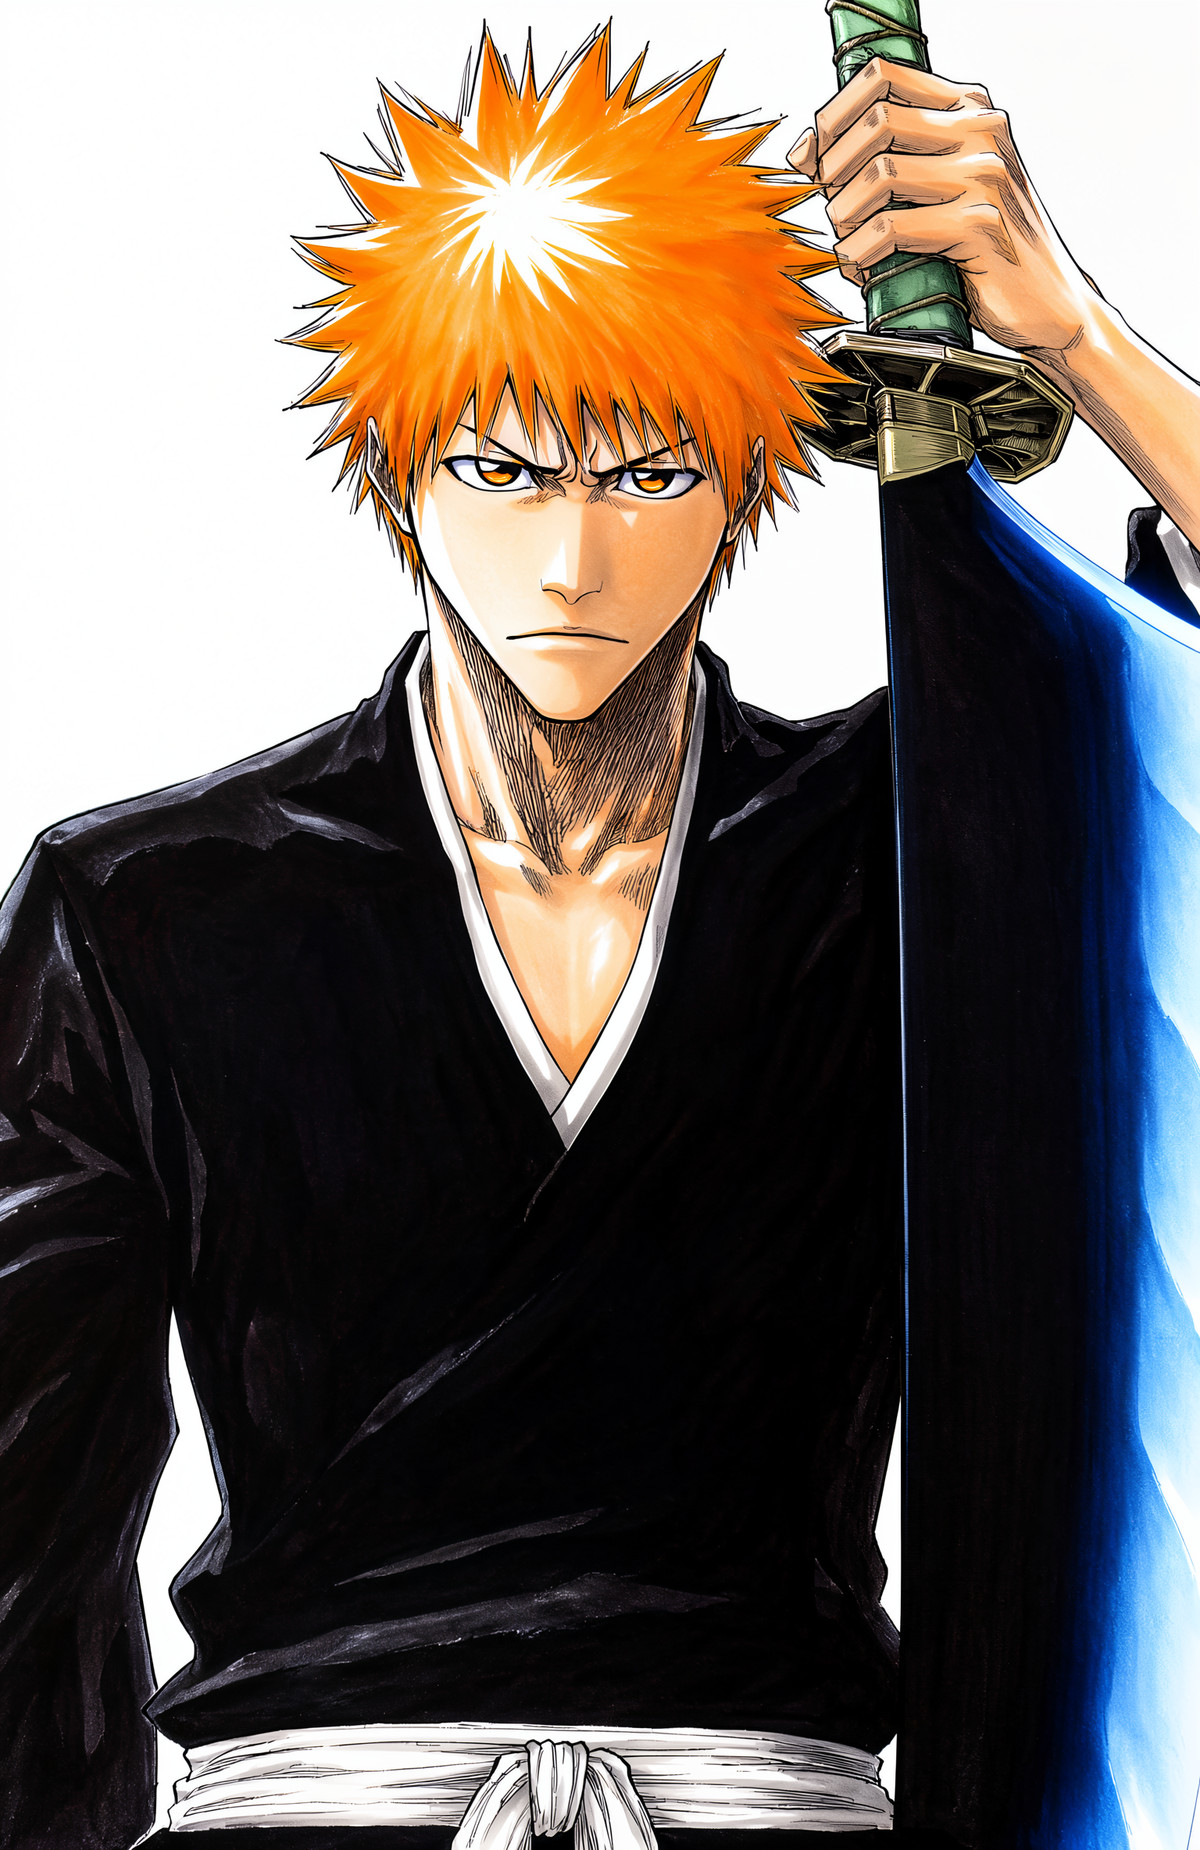
【B】18 in 1,《Bleach》/《ブリーチ》,Tite Kubo/久保帯人 - Artist Style · MOSS_v1.0
LoRA · ポート · 作者 flyx3 · 公開 11-10 12:10 · ダウンロード 3 · 有料
『ブリーチ』の作者である久保帯人の漫画画風 LoRA の MOSS バージョン。同じファイルで同作のほとんどのキャラクターも生成可能です。
画像
収録のみ(14)
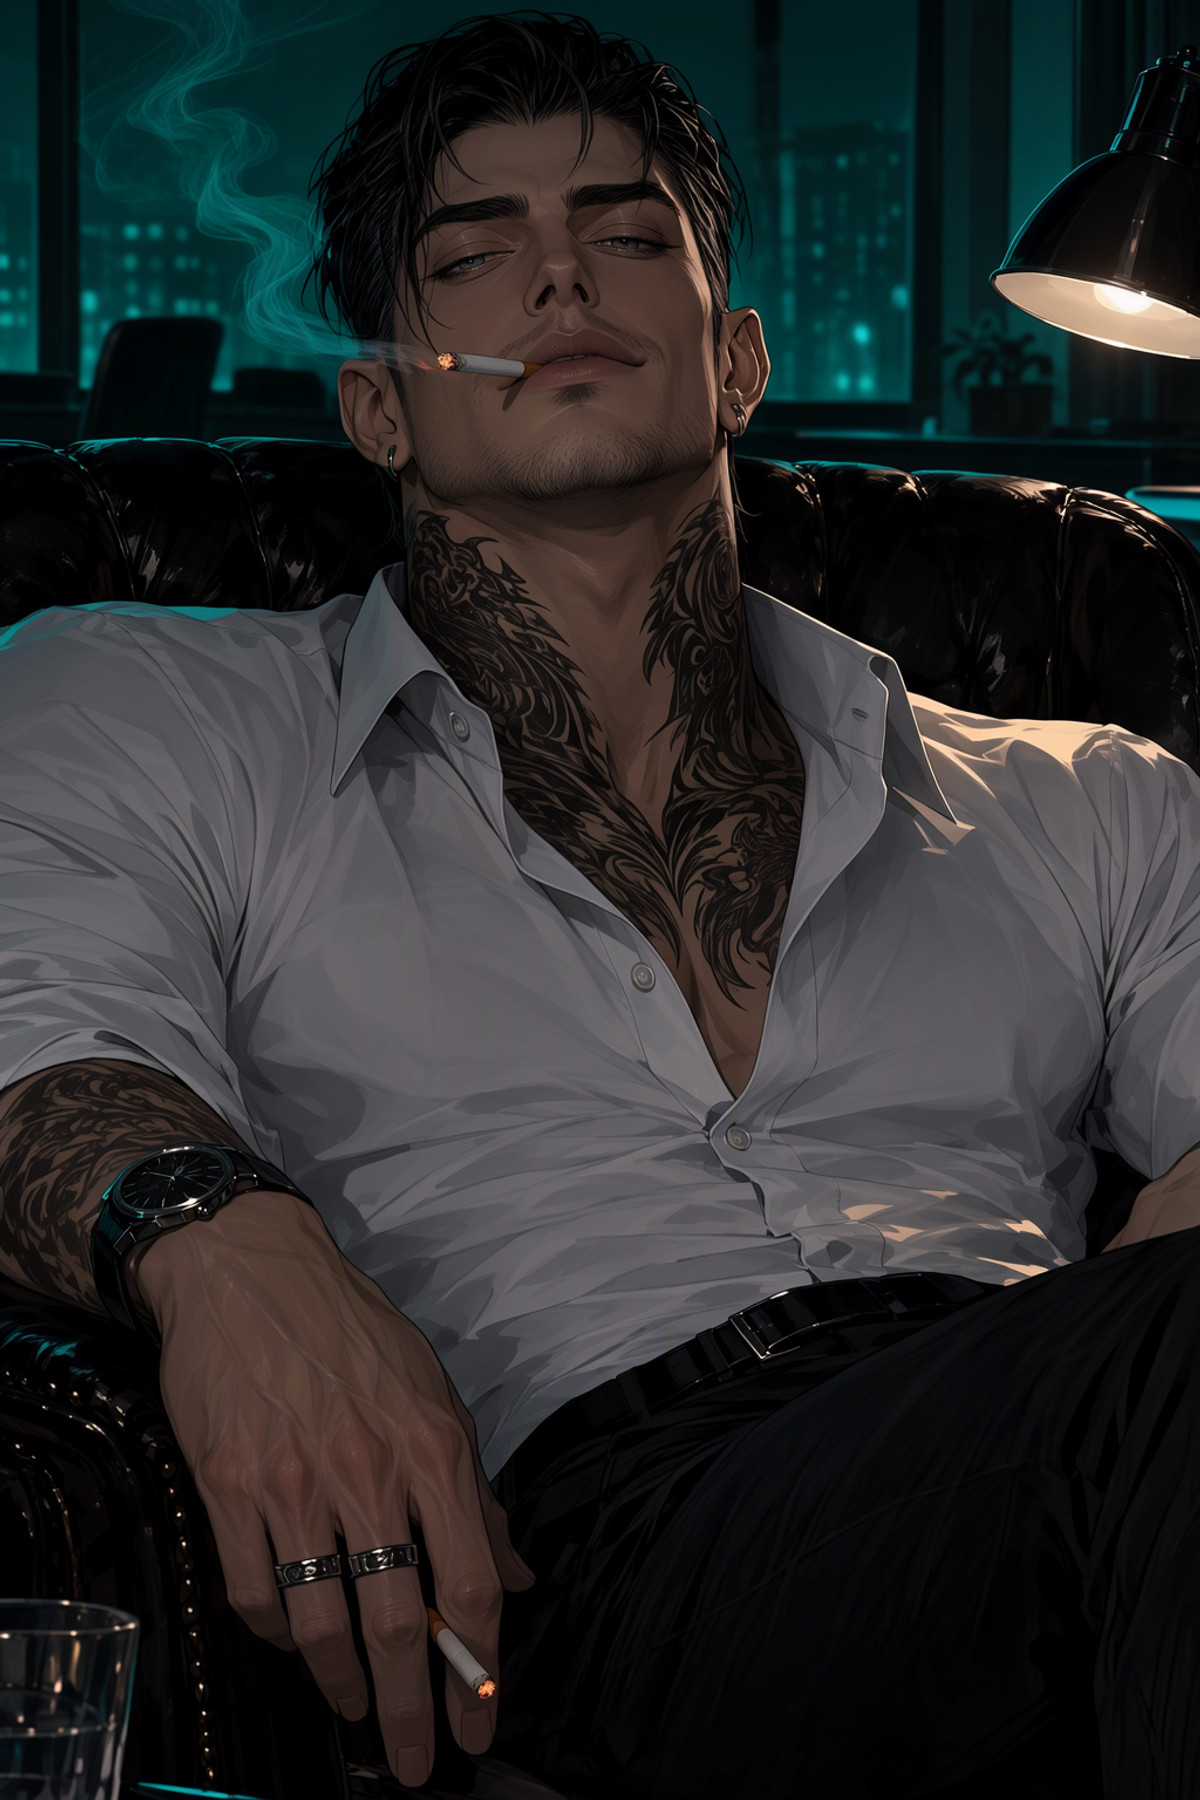
- MaleBot Style · Moss v1 — LoRA:チャットボット内の男性キャラクターの表紙イラスト風(作者曰くnijiに類似)を模倣するスタイルLoRAのMOSS版。
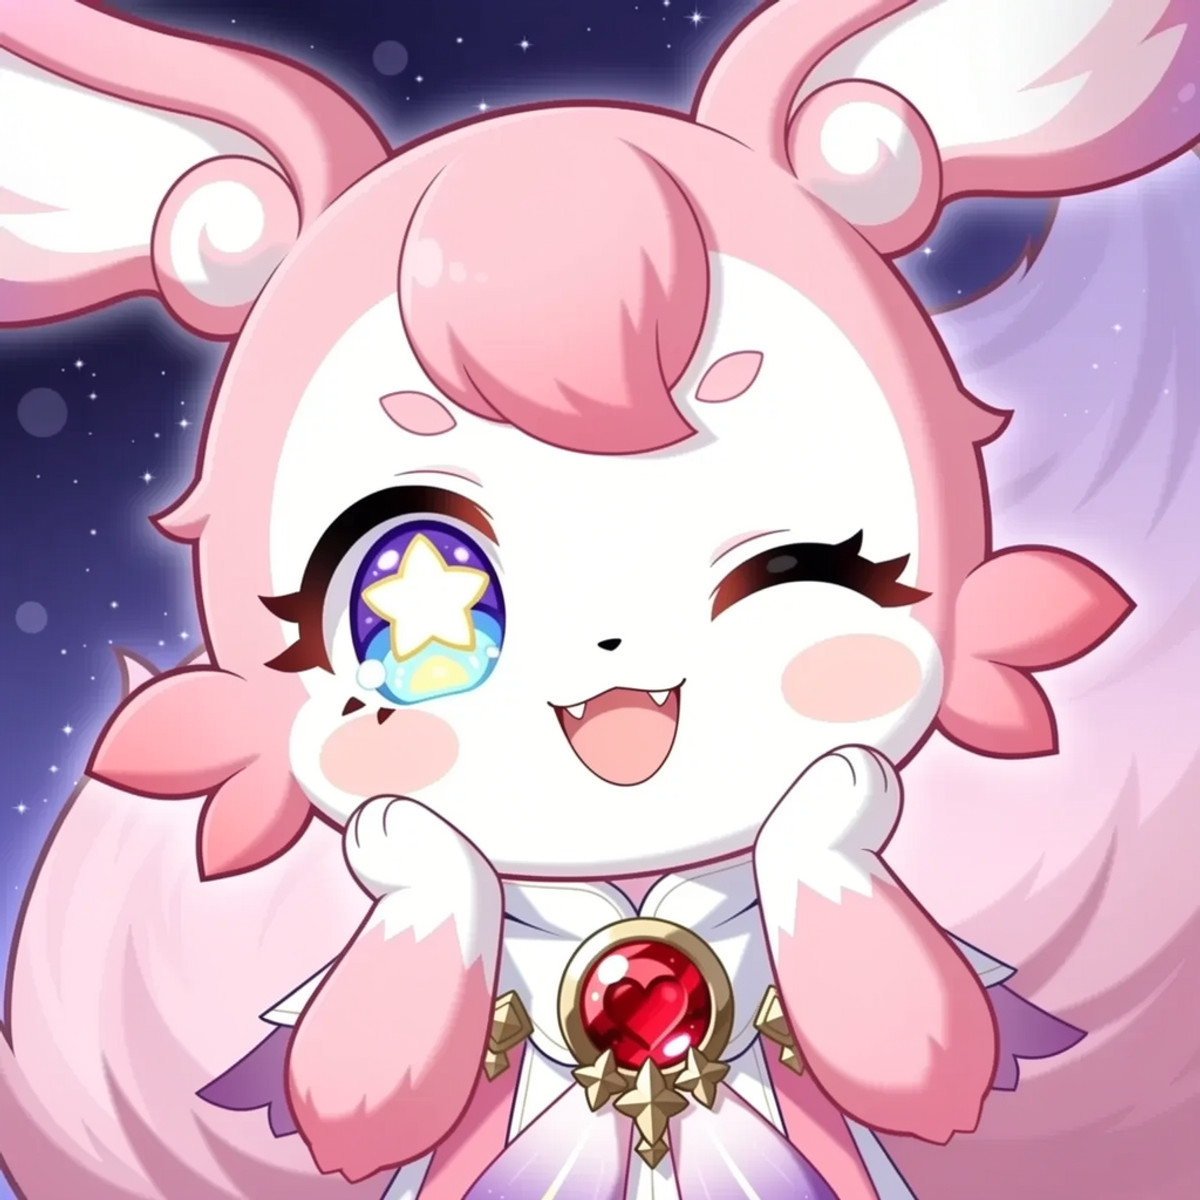
- Mem (Honkai: Star Rail) [Illustrious/pony/moss] · MOSS — LoRA:『崩壊:スターレイル』のキャラクター「迷迷」(Mem、ピンク色のふわふわした小さな生物)のキャラクターLoRAのMOSS版。
- huashijw/画師JW | Style · MOSS(test) — LoRA:イラストレーター「画師JW」(huashijw)のかわいい系二次元女性イラスト風を模倣するスタイルLoRAのMOSSテスト版。
- Takorin Style | ILXL & Anima · Moss v0.1 — LoRA:イラストレーターTakorin(namako8982)の二次元イラスト風LoRAのMOSSテスト版v0.1。
- Francesca · MossImage — LoRA:MisterMRシリーズの架空人物Francesca(トスカーナ出身の「ミューズ」設定)のキャラクターLoRAのMOSS版。
- xKlara · MOSS Image — LoRA:AI生成のオリジナル女性キャラクターxKlara(ダークブラウンの髪、柔らかな顔立ち)のキャラクターLoRA。MOSS版と同一ページのKrea 2 版は同じデータセットで学習されている。
- Echidna - MOSS · Echidna — LoRA:『Re:ゼロから始める異世界生活』のキャラクターエミリア(Echidna)のキャラクターLoRA。作者は外見と衣装の詳細を一つずつ解説した文章を提供している。
- Frankie NordhavenLove · MossImage — LoRA:架空の北欧系女性キャラクターのキャラクターLoRA。同じ顔で画像を生成するために使用される。
- jun navigavi style · v1.0 — LoRA:イラストレーターjun navigaviの画風を模倣する二次元イラストLoRA。
- A style lora by Ryia | 2 · v1.1 — LoRA:作者が自身のNAI v5 で生成した画像で学習した二次元画風LoRA。本バージョンはMoss-healで再学習された。
- 凉屋/涼香/Ryohka/Suzuya · Runs_1_st9000 — LoRA:二次元キャラクター「涼香 / Ryohka / Suzuya」のMOSS-Image-SFTキャラクターLoRA。これは同一学習の最終ステップ9000のチェックポイント。サンプルは紫色のロングカールヘア、緑の目、白いセーラー服を着た少女。
- ૮꒰ ˶• ༝ •˶꒱ა ♡ · v1 — LoRA:作者が「2000年代レトロアニメ」画風と称するLoRA。正方形のサンプル画像。
- YD style · v1.1 — LoRA:YDという名前の画風LoRAの第2版。モデルカードにはトリガーワードのみ記載されている。
- Phoenix Reffaella フィオニー・レファエラ, 3 Outfits — Zenless Zone Zero ゼンレスゾーンゼロ [Anima+Illustrious+MOSS] · v1.0 MOSS Image — LoRA:『ゼンレスゾーンゼロ』第3シーズンキャラクターPhoenixのキャラクターLoRAのMOSS版。1つのファイルに3種類の衣装が含まれている。
データ:Civitai公開API(基盤モデルMOSS Image)、収録期間 11-10 08:31 → 11-10 21:01(北京時間)。推薦理由は編集者による審査済み。ダウンロード数は注目度を表すに過ぎない。