Radar AI của Trinh Trinh · MOSS Image · Bản tin tối 2026-11-10
Kỳ này có 35 phiên bản mới: Đề xuất mạnh mẽ 2 · Đề xuất 9 · Có thể theo dõi 10 · Chỉ ghi nhận 14
Lời bình của biên tập viên Kỳ này đã xem xét 44 phiên bản mới của MOSS, gồm 2 loại S, 9 loại A, 10 loại B, 14 loại C, loại trừ 9 mục. Đề xuất đầu tiên là phiên bản MOSS của LoRA phong cách quảng cáo nguyên trang cổ điển Ad Infinitum: biến hình ảnh thành thẻ sản phẩm, áp phích và quảng cáo tạp chí kiểu cũ, có thể viết tiêu đề mang hơi hướng thời đại theo dấu ngoặc kép, cung cấp đầy đủ từ khóa kích hoạt, cường độ, số bước, CFG và cách bố trí chữ; cùng xếp loại S là LoRA kiểm soát tư thế của thedeoxen, cung cấp hình ảnh khung xương DWPose để nhân vật mới tạo ra tư thế tương tự, các LoRA kiểm soát Canny, nét vẽ, vẽ nguệch ngoạc, độ sâu, pháp tuyến và phân đoạn của cùng tác giả được xếp loại A. Ngoài ra, bối cảnh hành lang FGO, phong cách ảnh chụp màn hình anime v2, ảnh chụp thực tế bằng điện thoại di động... được xếp loại A; nhiều LoRA nhân vật / phong cách vẽ chỉ có một hoặc hai câu mô tả và LoRA nhân vật trải nghiệm sớm trả phí được xếp loại C. 8 ảnh chụp nhanh các bước trung gian của LoRA nhân vật Liangwu chỉ giữ lại phiên bản st9000 cuối cùng, phiên bản Krea2 của Ceiling Fisheye Cam là trọng số Krea 2 bị gắn nhãn nhầm thành MOSS, cả hai đều đã bị loại trừ.
Đề xuất mạnh mẽ (2)
【S】Ad Infinitum - Krea 2 · Classic - MOSS
LoRA · Chuyển đổi · Tác giả AriaMaiven · Phát hành 11-10 10:48 · Tải xuống 50
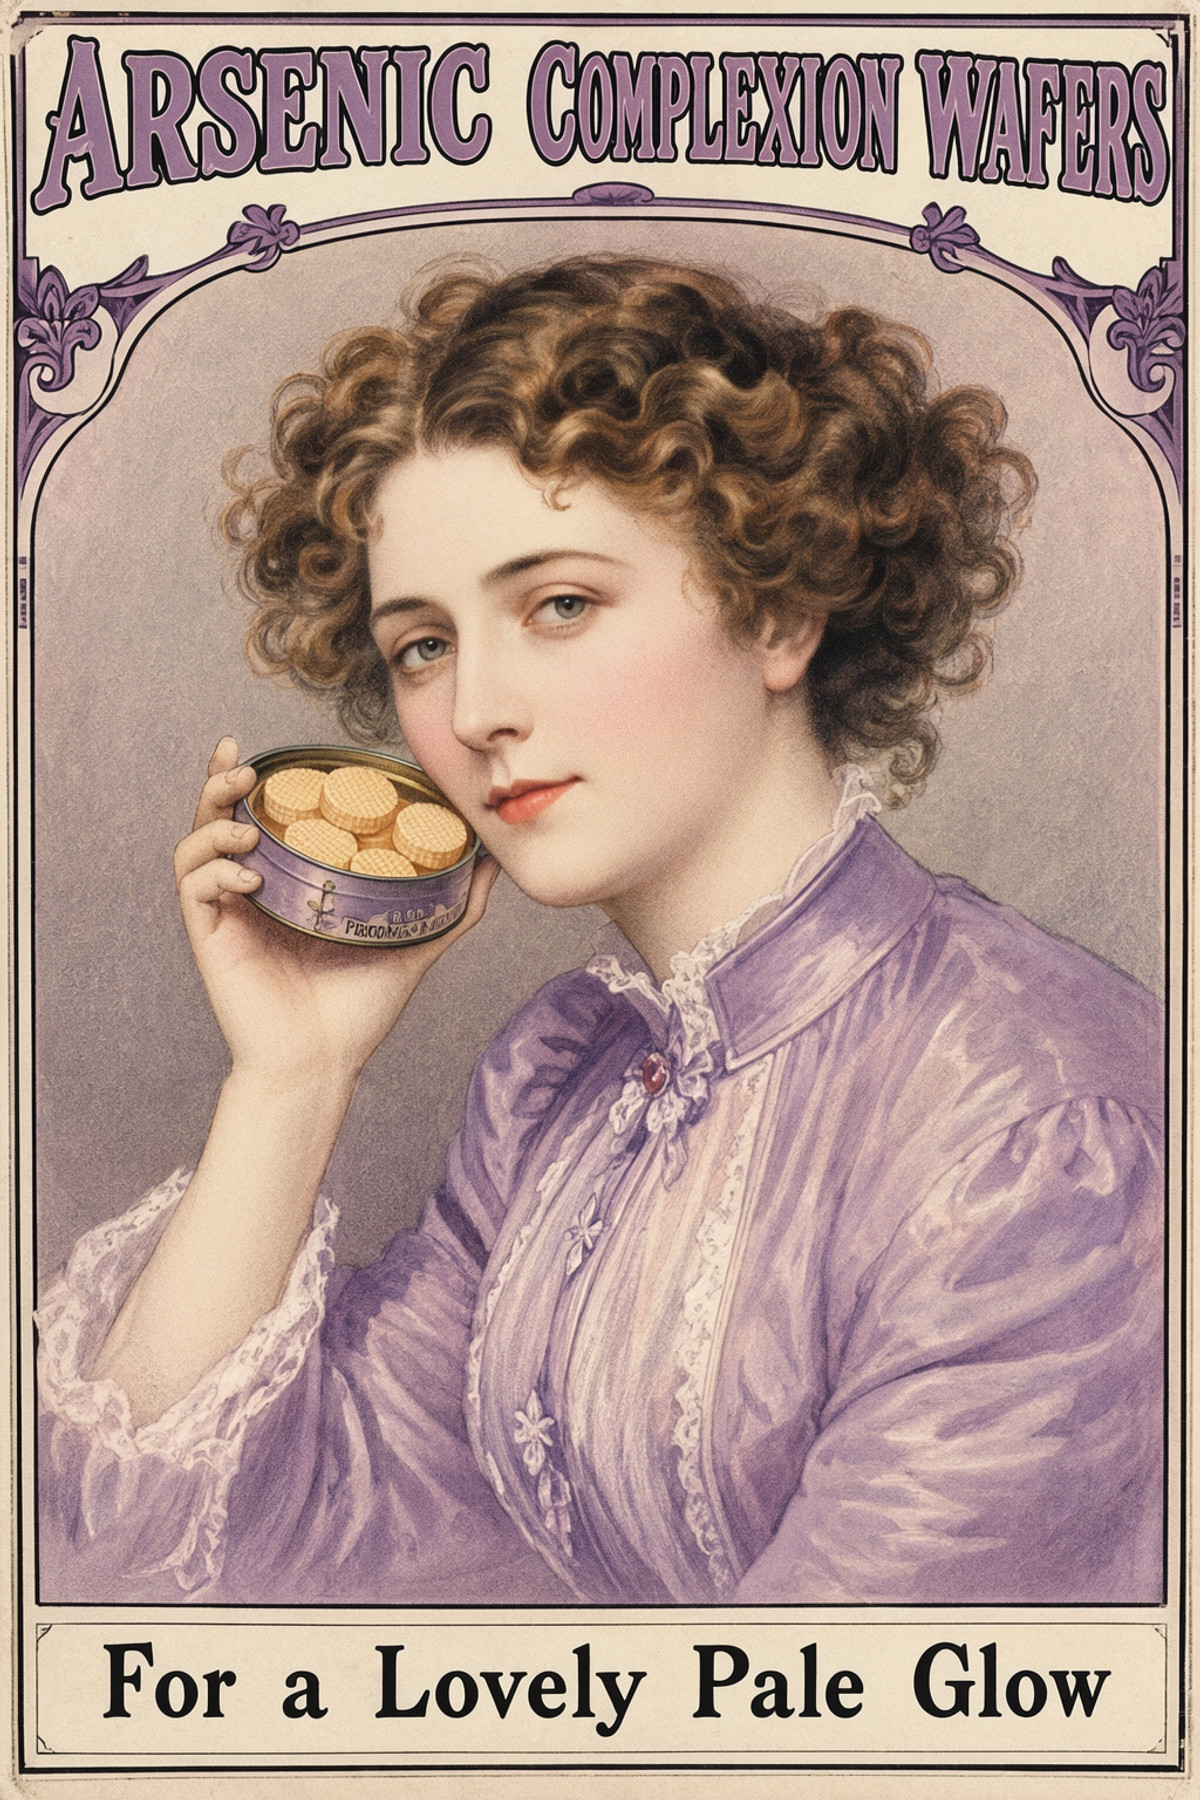
Phiên bản MOSS (Classic) của LoRA phong cách trang quảng cáo cổ điển: biến hình ảnh thành quảng cáo nguyên trang với màu chấm điểm, viền mực và mặt giấy màu kem kiểu thẻ sản phẩm, áp phích và quảng cáo tạp chí từ những năm 1885–1948, đồng thời có thể viết tiêu đề in hoa kiểu cũ theo lời nhắc.
Đề xuất hàng đầu của nhóm này: hướng đi độc đáo (quảng cáo nguyên trang kiểu cũ chứ không chỉ là bộ lọc cổ điển), cung cấp đầy đủ từ khóa kích hoạt, cường độ, số bước, CFG, kích thước và cách bố trí chữ, dễ dàng thực hiện theo.
Hình ảnh minh họa
Lý do đề xuất
- Chuyển đổi: Trang này đã có hai phiên bản Classic và Future Vintage của Krea 2, trang mô hình tích lũy 303 lượt tải xuống; phiên bản MOSS được huấn luyện trên MOSS Base, sử dụng cùng bộ 46 thẻ sản phẩm / áp phích / quảng cáo tạp chí thuộc phạm vi công cộng (đã loại bỏ văn bản gốc), từ khóa kích hoạt vẫn là adnclsk
- Phục vụ cho việc tạo ảnh từ văn bản thuộc các loại áp phích cổ điển, quảng cáo cũ, chế giễu thương hiệu và hình ảnh minh họa cho bài viết; tác giả đã cung cấp cách bố trí chữ: ở cuối lời nhắc, đặt mỗi câu văn vào trong dấu ngoặc kép và ghi rõ vị trí, MOSS sẽ viết ra bằng phông chữ in hoa mang hơi hướng thời đại
- Đầy đủ tham số: cường độ từ 0.7 đến 1.0; MOSS Image (SFT), 30 bước, CFG 3, euler / simple, 1024 x 1536; tác giả cho biết nếu không thêm LoRA, MOSS chỉ vẽ thành minh họa kỹ thuật số hiện đại
- Tác giả cho biết mỗi hình ảnh trong thư viện đều kèm theo lời nhắc và tham số; miễn phí, giấy phép cho phép xuất ảnh và cho thuê trong trang web; phát hành khoảng 10 giờ với 50 lượt tải xuống
Cách sử dụng
- Viết adnclsk làm từ đầu tiên trong lời nhắc, sau đó viết chủ thể và hình ảnh của quảng cáo; cường độ từ 0.7 đến 1.0, nếu tiêu đề dài thì dùng 0.7 sẽ sạch hơn
- Nếu cần văn bản, hãy viết ở cuối: The only words on the page are the headline "…" at the top …, and the line "…" on a cream panel at the bottom, đặt mỗi câu vào trong dấu ngoặc kép và ghi rõ vị trí và màu sắc
- MOSS Image (SFT), 30 bước, CFG 3, euler / simple, 1024 x 1536; ngay cả khi bạn định tự bố trí chữ sau này, vẫn phải cung cấp tiêu đề và thanh dưới cùng trong lời nhắc, nếu không các cảnh như tàu hỏa, phong cảnh sẽ bị lệch sang phong cách sơn dầu
- Không viết thêm poster, lithograph, vintage hoặc các từ chỉ thời đại, tác giả cho biết LoRA đã tự động có cảm giác thời đại
Rủi ro và hạn chế
- Có 5 ví dụ hiển thị được, 4 hình khác bị ẩn do phân loại; không có so sánh cùng seed với và không có LoRA
- Bộ dữ liệu huấn luyện chỉ có 46 hình; gói nén quy trình làm việc ComfyUI đi kèm phiên bản Krea 2 không có trong phiên bản MOSS, bạn phải tự thiết lập
- Giấy phép yêu cầu ghi công; tác giả tuyên bố rằng việc sao chép hoặc sử dụng ảnh xuất ra của nó để huấn luyện các mô hình khác phải được cấp phép trước
- Mục này chưa được chạy thử
Từ khóa kích hoạt: adnclsk
【S】MOSS-Image Pose Control · v1.0
LoRA · Mô hình mới · Tác giả thedeoxen · Phát hành 11-10 16:20 · Tải xuống 29
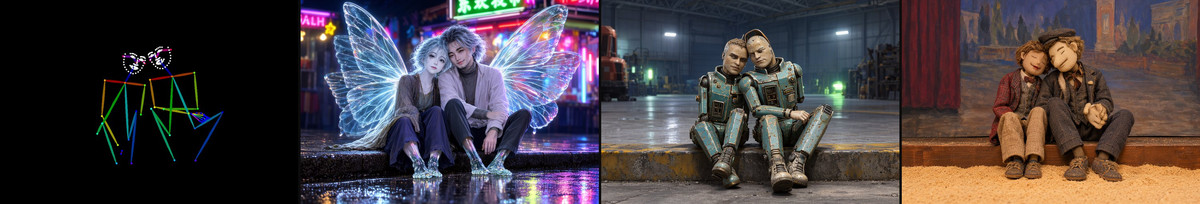
LoRA kiểm soát tư thế cho MOSS-Image-SFT: cung cấp một hình ảnh khung xương DWPose màu sắc trên nền đen, nhân vật được tạo ra sẽ tạo ra tư thế cơ thể, tay và khuôn mặt giống hệt khung xương, ngoại hình, trang phục và bối cảnh hoàn toàn do lời nhắc quyết định.
Cùng tác giả đã phát hành bảy LoRA kiểm soát vào cùng ngày, phương pháp huấn luyện và tham số lấy mẫu giống nhau, chỉ khác nhau ở loại hình ảnh kiểm soát được cung cấp; LoRA tư thế này có khả năng độc lập nhất và quy trình làm việc hoàn chỉnh nhất, được chọn làm đại diện cho nhóm này.
Hình ảnh minh họa
Lý do đề xuất
- Khả năng mới: Bổ sung khả năng kiểm soát tư thế theo khung xương cho MOSS-Image-SFT; tác giả giải thích rằng đây là LoRA chỉnh sửa kiểu ControlNet, không phải bộ ghép nối color/depth chính thức, sử dụng trình tải LoRA thông thường và đưa hình ảnh khung xương vào làm hình tham chiếu duy nhất trong Text Encode MOSS-Image Edit
- Phục vụ cho việc thay đổi trang phục/nhân vật, chuyển tư thế từ ảnh sang nhân vật khác, và các cảnh yêu cầu hành động cơ thể nhất quán trong storyboard và keyframe; khác với các LoRA kiểm soát đường viền như Canny / Lineart của cùng tác giả, nó chỉ khóa vị trí khớp, không khóa đường viền quần áo và nền
- Cách trích xuất khung xương do tác giả cung cấp: DWPose của comfyui_controlnet_aux, bật cả ba mục cơ thể, tay và mặt; xương màu sắc trên nền đen khớp với hình ảnh kiểm soát dùng để huấn luyện
- Đầy đủ tham số và quy trình làm việc: kèm theo JSON quy trình làm việc ComfyUI (đọc ảnh → xuất khung xương → mã hóa → lấy mẫu), chọn lưu trữ ở bước thứ 4500, cường độ 1.0, 30 bước, CFG 4, euler + simple, không có từ khóa kích hoạt
- 3 ví dụ, mỗi ví dụ là một hình ghép gồm “khung xương + ba lời nhắc khác nhau”, có thể trực tiếp xem cùng một tư thế với ba nhân vật khác nhau; phát hành 5 giờ với 29 lượt tải xuống, 3 lượt thích, là mục được quan tâm nhất trong nhóm LoRA kiểm soát này; miễn phí, giấy phép cho phép xuất ảnh và bán
Cách sử dụng
- Mô hình cơ sở sử dụng MOSS-Image-SFT: UNet moss_image_sft_int8_convrot, bộ mã hóa văn bản qwen3.5_9b_w4a8_gptq (chọn loại moss_image), VAE flux2-vae_small; LoRA được gắn vào UNet, cường độ 1.0
- Sử dụng DWPose (cơ thể + tay + mặt) để trích xuất khung xương từ ảnh tham chiếu, hình ảnh xương màu sắc trên nền đen được đưa vào làm hình tham chiếu duy nhất trong Text Encode MOSS-Image Edit; đặt định dạng chỉnh sửa của cả hai nút mã hóa dương và âm thành ai-toolkit
- 30 bước, CFG 4, euler + simple; không có từ khóa kích hoạt, lời nhắc viết về danh tính nhân vật, trang phục, chất liệu và bối cảnh, không cần mô tả từng khớp
Rủi ro và hạn chế
- 4 ví dụ cấp độ nhạy cảm bị ẩn, nhiều hơn 3 hình hiển thị được
- Các chi bị thiếu trong khung xương, tác giả cho biết lời nhắc không thể bổ sung đáng kể các khớp tương ứng; mức độ chi tiết như ngón tay có thể theo được hay không tác giả không nói rõ
- Chỉ được huấn luyện cho MOSS-Image-SFT (tác giả sử dụng UNet lượng tử hóa int8); hiệu suất khi kết hợp với MOSS-Image-Base hoặc các độ chính xác khác tác giả không nói rõ; tác giả đánh dấu mô hình cơ sở là Other
- Trong thẻ mô hình đầy đủ, tác giả đề xuất giảm cường độ xuống 0.7 nếu kiểm soát quá cứng nhắc, giá trị huấn luyện là 1.0
- Hình ảnh ví dụ không kèm theo tham số tạo; mục này chưa được chạy thử
Đề xuất (9)
【A】Anime Screencap Style · v2.0
LoRA · Cập nhật phiên bản · Tác giả kanakiy · Phát hành 11-10 09:48 · Tải xuống 57
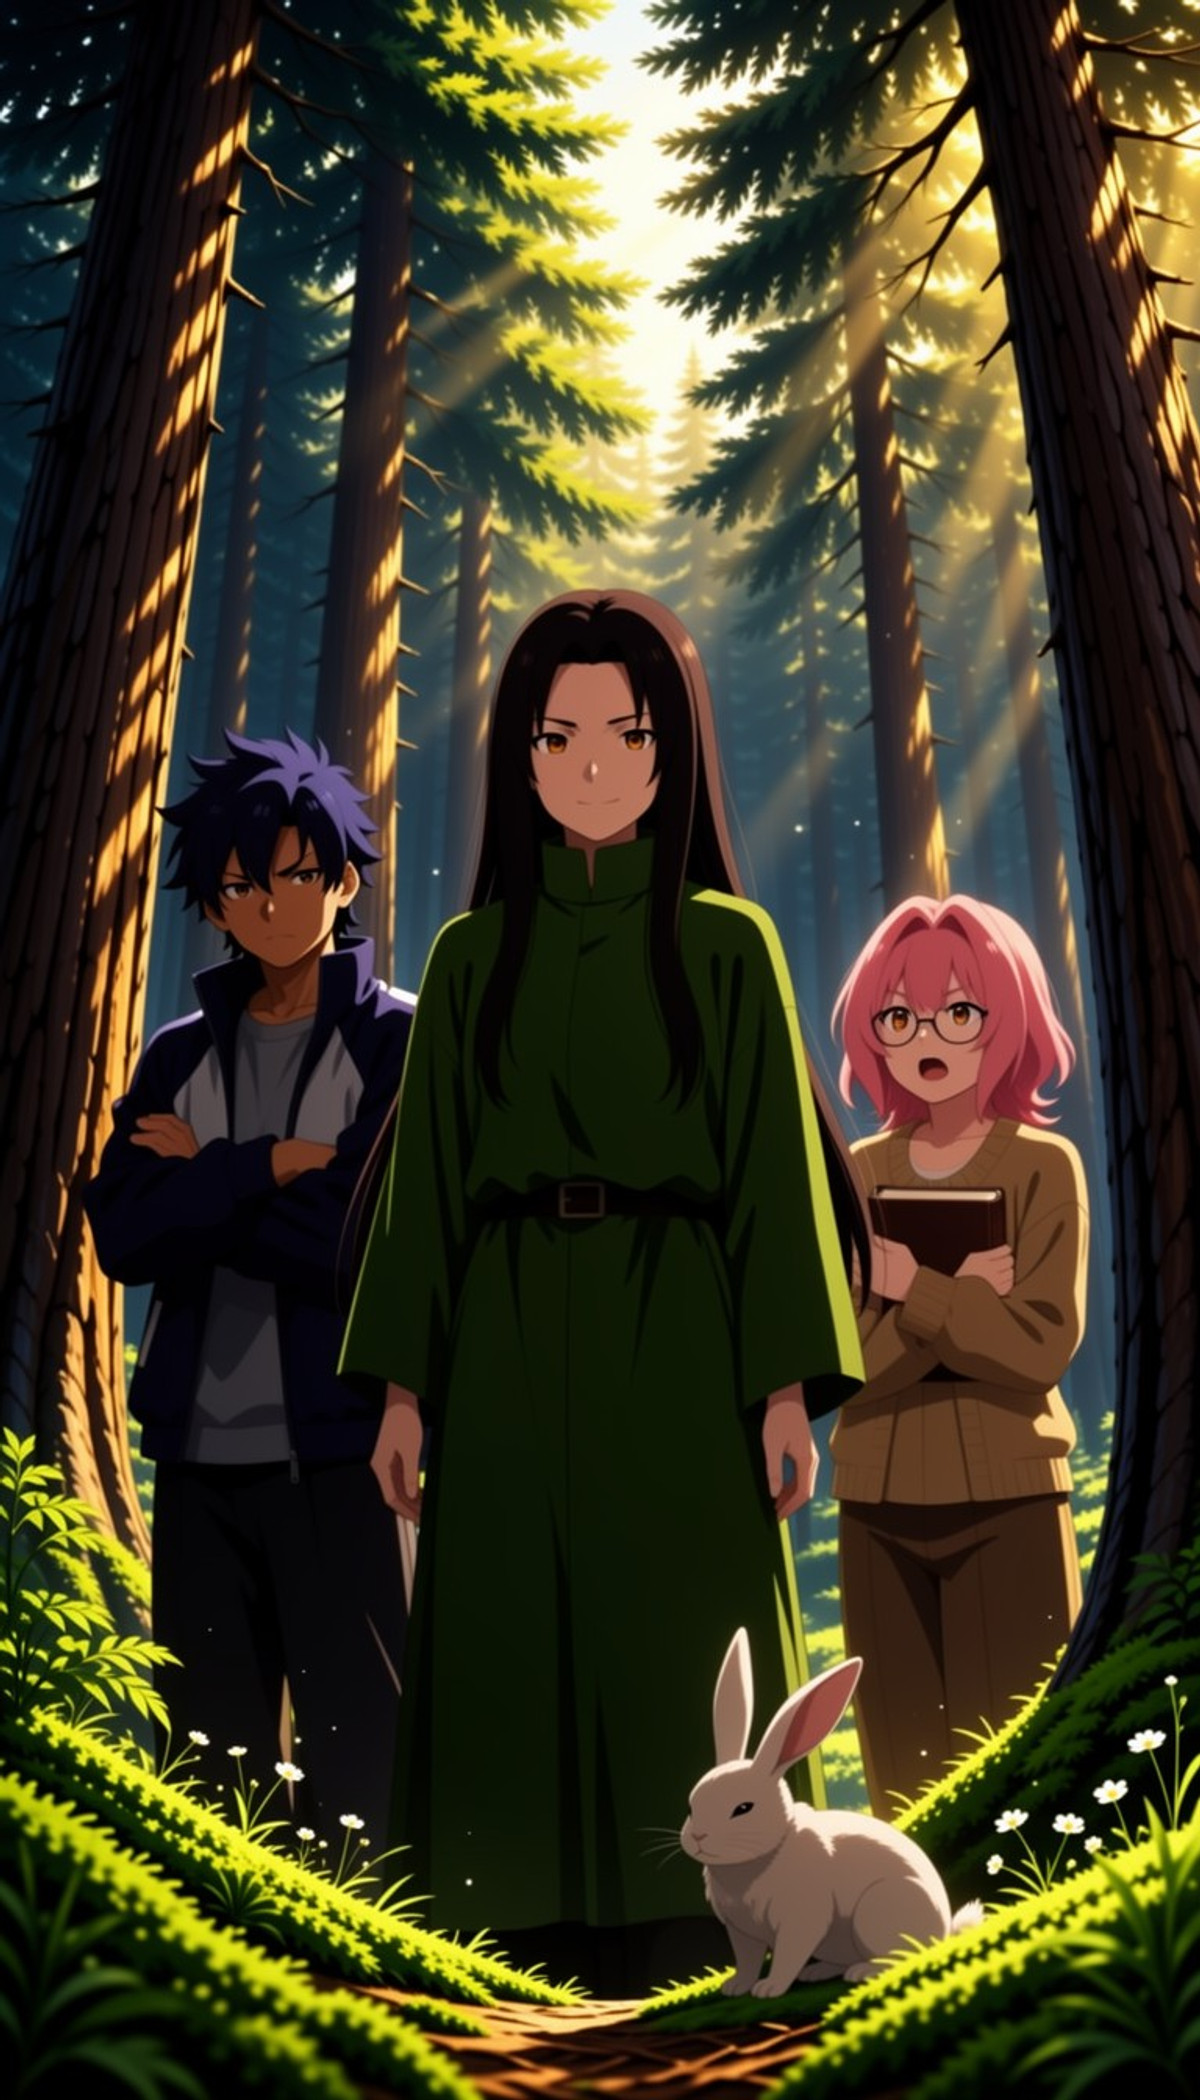
Phiên bản v2.0 của LoRA phong cách ảnh chụp màn hình anime hiện đại: màu phẳng kiểu cel, hầu như không có bóng đổ mềm mại, đường nét dày và sạch sẽ, màu sắc bão hòa cao và bố cục kiểu màn ảnh rộng.
Giữ nguyên đánh giá tự động A: mô tả mục tiêu phong cách cụ thể, nhiều ví dụ, nhưng v2 thiếu tham số cường độ và lấy mẫu.
Hình ảnh minh họa
Lý do đề xuất
- Cập nhật phiên bản: Tác giả cho biết v2.0 đã cải thiện dữ liệu huấn luyện, loại bỏ hai nhân vật Tsunade và Seiko Ayase khỏi dữ liệu v1.0 (vẫn có thể gọi ra chủ động bằng tên); v1.0 đề xuất cường độ 0.6–0.8 do hai nhân vật này
- Phục vụ cho việc tạo ảnh từ văn bản muốn có “cảm giác ảnh chụp màn hình anime” thay vì phong cách anime 2D chuyển sắc mềm mại phổ biến, tác giả cho biết nó phẳng và cứng cỏi hơn hầu hết các mô hình anime
- 17 ví dụ; miễn phí; phát hành khoảng 11 giờ với 57 lượt tải xuống
Cách sử dụng
- Chỉ cần tải LoRA, không có từ khóa kích hoạt; v1.0 đề xuất cường độ 0.6–0.8, tác giả không cung cấp cường độ cho v2.0, có thể thử bắt đầu từ cùng khoảng đó; tác giả không cung cấp số bước và CFG
Rủi ro và hạn chế
- Tác giả không viết ghi chú cập nhật (mô tả phiên bản trống, thay đổi chỉ từ hai câu trong thẻ mô hình); không có so sánh giữa v1 và v2
- Giấy phép không bao gồm việc sử dụng thương mại cho ảnh xuất ra, chỉ cho phép cho thuê; 3 ví dụ bị ẩn do phân loại
- Mục này chưa được chạy thử
【A】Realistic Photo by Amateur Snapshot · MOSS
LoRA · Mô hình mới · Tác giả 858654128784 · Phát hành 11-10 18:02 · Tải xuống 73
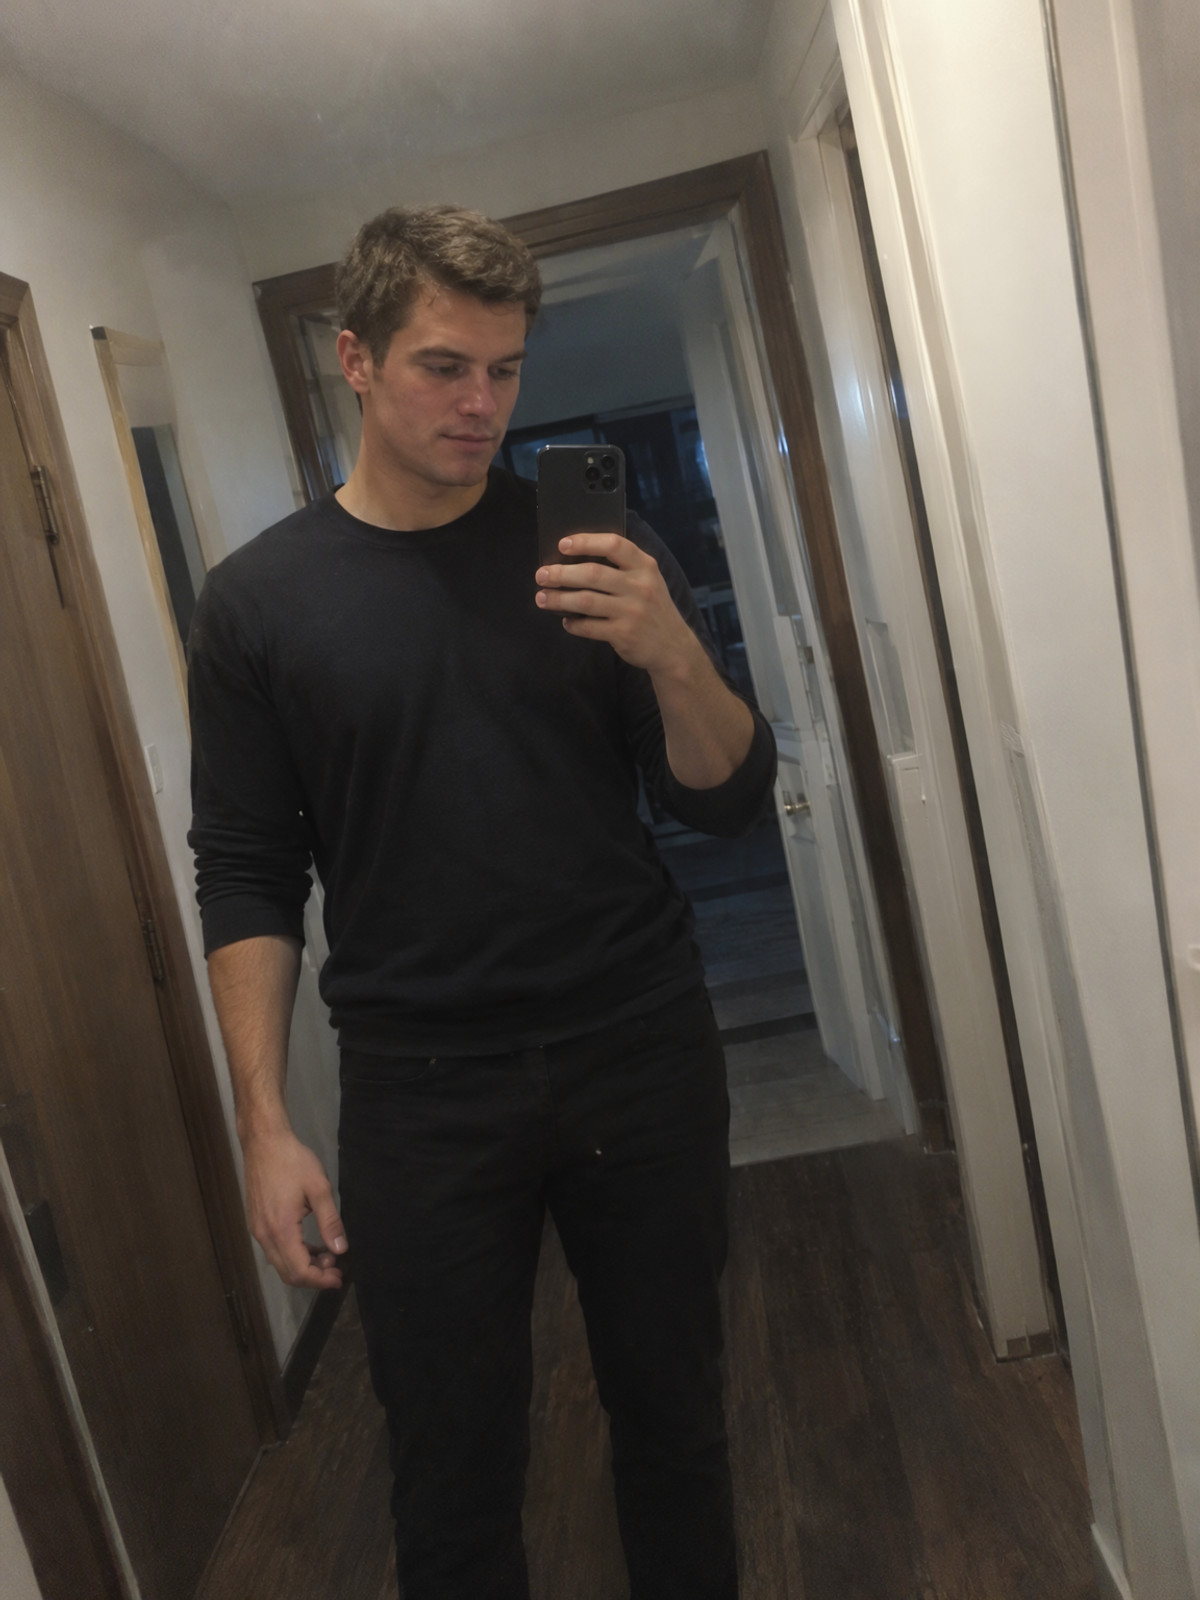
LoRA ảnh chụp thực tế phong cách chụp nhanh bằng điện thoại di động: selfie trước gương, selfie bằng camera trước, bàn bếp, trong thang máy, chụp từ trên xuống thú cưng, bố cục nghiêng, ánh sáng không đều, hạt ở vùng tối và kết cấu da thực tế, loại bỏ cảm giác studio quá sạch sẽ của ảnh AI.
Giữ nguyên đánh giá tự động A: mục đích rõ ràng, cách viết lời nhắc có thể thực hiện trực tiếp, thiếu tham số cường độ và lấy mẫu, số lượng ví dụ hiển thị được ít.
Hình ảnh minh họa
Lý do đề xuất
- Mô hình mới: Chỉ có phiên bản MOSS, mục tiêu là “ảnh chụp bằng điện thoại của người bình thường” chứ không phải ảnh thực tế được chỉnh sửa kỹ lưỡng
- Tác giả đã cung cấp cách viết lời nhắc: bắt đầu bằng amateur smartphone photo, ghi rõ địa điểm, ai cầm điện thoại, ánh sáng đến từ đâu; thêm các chi tiết như “điện thoại che nửa mặt”, “cốc bị cắt một nửa ở tiền cảnh” sẽ trông giống hơn
- Miễn phí, giấy phép cho phép xuất ảnh, cho thuê và bán; phát hành khoảng 3 giờ với 73 lượt tải xuống, là mục có tốc độ tải xuống nhanh nhất trong nhóm này
Cách sử dụng
- Lời nhắc bắt đầu bằng amateur smartphone photo, viết địa điểm, người cầm máy và nguồn sáng, sau đó thêm các chi tiết chụp nhanh như che khuất, cắt xén tiền cảnh; không có từ khóa kích hoạt
- Tác giả không cung cấp cường độ, số bước, CFG
Rủi ro và hạn chế
- 15 ví dụ bị ẩn do phân loại, chỉ có 5 hình hiển thị được; trang là nội dung hỗn hợp
- Không có tham số, cũng không có so sánh với và không có LoRA; nguồn dữ liệu huấn luyện tác giả không giải thích
- Tạo ra ảnh đời sống nhân vật giống thật, khi phát hành cần chú ý ghi rõ là do AI tạo; mục này chưa được chạy thử
【A】Chaldea Corridor: Fate/Grand Order · MOSS-sft01
LoRA · Mô hình mới · Tác giả RHU_AIstudio · Phát hành 11-10 19:59 · Tải xuống 10
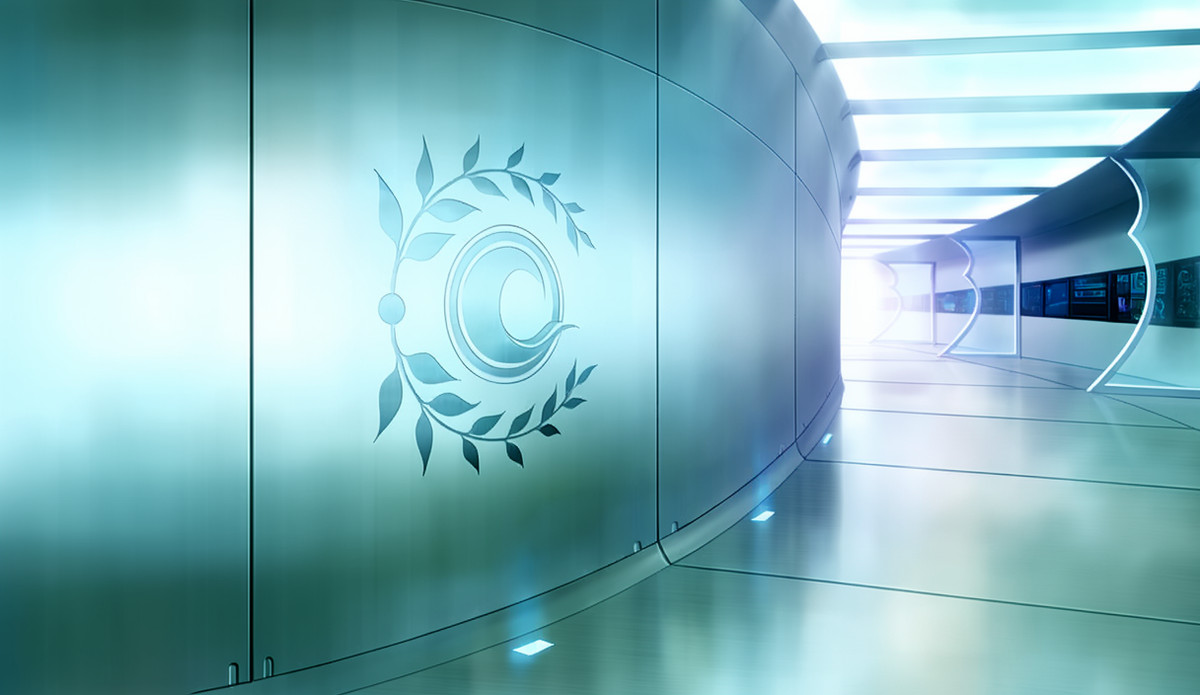
LoRA bối cảnh hành lang Chaldea cũ của 《Fate/Grand Order》: sử dụng một từ khóa kích hoạt để cố định hành lang này, sau đó sử dụng các từ trạng thái để chuyển đổi giữa các trạng thái bình thường, tối, hư hỏng, đóng băng, v.v.
Giữ nguyên đánh giá tự động A: LoRA bối cảnh này có cách sử dụng được viết rõ ràng nhất, từ khóa kích hoạt, cường độ và từ trạng thái có thể sao chép trực tiếp, nhưng chỉ bao phủ một địa điểm, thiếu tham số lấy mẫu.
Hình minh họa
Lý do đề xuất
- Mô hình mới, và là loại LoRA theo bối cảnh / địa điểm hiếm gặp trong đợt này: không tập trung vào nhân vật, chuyên tái hiện một địa điểm cố định, phục vụ minh họa fan-art, ghép nền cho ảnh nhân vật, và hình ảnh bối cảnh kiểu visual novel
- Tác giả đã giải thích nguồn dữ liệu huấn luyện: 7 hình nền trong game, bao phủ các trạng thái bình thường / tối / mờ / hư hỏng / đóng băng và hai góc máy
- Đã cung cấp từ khóa kích hoạt, cường độ và các từ khóa trạng thái: corridor_(chaldea)_(fate), cường độ 1.0; bright lighting, dark, dim lighting, damaged, cracked wall, debris, frozen, ice, flooded, close-up tương ứng với góc máy có tường khắc huy hiệu
- 3 hình mẫu có thể xem, 1 hình bị ẩn; miễn phí, giấy phép rộng rãi, cho phép xuất ảnh, bán và tạo tác phẩm phái sinh
Cách sử dụng
- Viết prompt là corridor_(chaldea)_(fate), thêm các từ khóa trạng thái khi cần: bright lighting / dark, dim lighting / damaged, cracked wall, debris / frozen, ice, flooded; thêm close-up nếu muốn góc tường có huy hiệu; cường độ LoRA 1.0
- Tác giả không cung cấp số bước, CFG, hay bộ lấy mẫu; tên phiên bản là MOSS-sft01, tác giả không ghi rõ là được huấn luyện trên Base hay SFT
Rủi ro và hạn chế
- Bộ dữ liệu huấn luyện chỉ có 7 hình, những gì có thể tạo ra cơ bản chỉ là các trạng thái này của hành lang và hai góc máy, chưa rõ liệu có giữ được cấu trúc khi đổi sang góc nhìn khác hay không
- Tài liệu nguồn là hình nền có bản quyền từ game, mặc dù giấy phép rộng rãi, vẫn cần cân nhắc bản quyền của tác phẩm gốc trước khi sử dụng thương mại
- Thẻ mô hình chỉ có một đoạn văn, không có hướng dẫn về cách viết khi thêm nhân vật hay cách kết hợp nhiều LoRA; mục này chưa được chạy thử
Từ khóa kích hoạt: corridor_(chaldea)_(fate)
【A】MOSS-Image Scribble Control · v1.0
LoRA · Mô hình mới · Tác giả thedeoxen · Phát hành 11-10 16:53 · Tải xuống 23
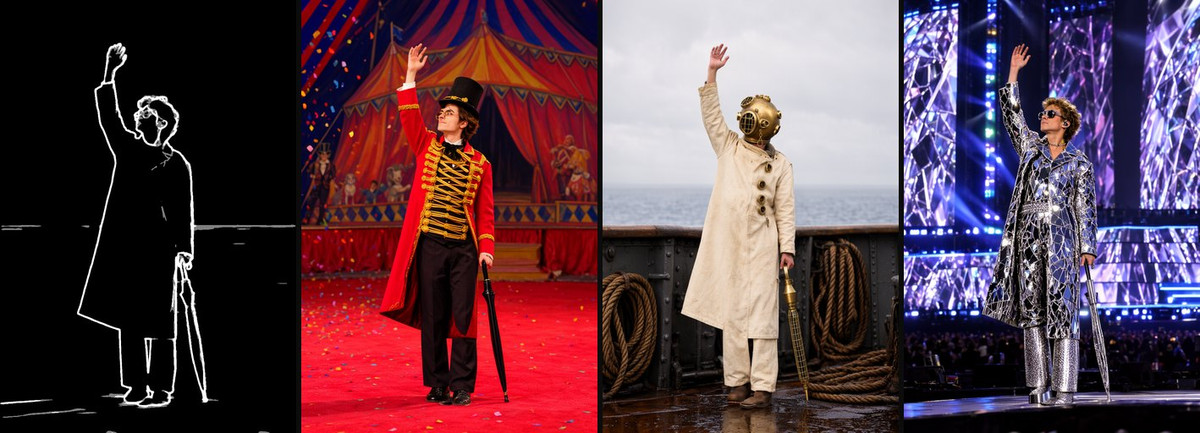
LoRA điều khiển nét vẽ nguệch ngoạc cho MOSS-Image-SFT: cung cấp vài nét vẽ trắng thô, mềm trên nền đen, chỉ theo dõi các nét chính và khối lớn, còn chi tiết, kết cấu và phong cách sẽ được tự do thể hiện qua prompt.
Hình minh họa
Lý do đề xuất
- Tính năng mới: mức điều khiển lỏng lẻo nhất trong loạt điều khiển của cùng tác giả, chỉ quản lý các nét chính và khối hình lớn, không bám sát từng đường viền nhỏ; tác giả đề xuất sử dụng nó trước khi tinh chỉnh bằng Canny / Lineart để thử nghiệm bố cục nhanh
- Phục vụ phác thảo ý tưởng, nét vẽ storyboard, giữ lại hình dạng lớn từ ảnh rồi vẽ lại: đầu vào có thể là vài nét vẽ tay, hoặc các đường viền mềm được trích xuất từ ảnh
- Tiền xử lý: quy trình làm việc sử dụng HED Soft-Edge Lines và bật chế độ safe mode; các nét vẽ nguệch ngoạc dùng để huấn luyện thô và mềm hơn so với Canny và lineart, tác giả cho rằng đường viền mềm HED gần với hình huấn luyện hơn so với phác thảo PiDiNet mảnh
- Kèm theo quy trình làm việc ComfyUI; lưu ở bước 5000, cường độ 1.0, 30 bước, CFG 4, euler + simple; 3 hình mẫu ghép
- Miễn phí, giấy phép cho phép xuất ảnh và bán; phát hành 4 giờ với 23 lượt tải xuống
Cách sử dụng
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), gắn LoRA vào UNet, cường độ 1.0
- HED Soft-Edge Lines (safe mode) hoặc vài nét vẽ tay màu trắng thô trên nền đen, làm hình tham chiếu duy nhất nối vào Text Encode MOSS-Image Edit, đặt edit format cho cả mã hóa dương và âm là ai-toolkit
- 30 bước, CFG 4, euler + simple; không có từ khóa kích hoạt; tác giả khuyên nên dùng ít nét vẽ khẳng định thay vì hình viền lộn xộn, để lại kết cấu, màu sắc và chi tiết nhỏ cho prompt
Rủi ro và hạn chế
- Điều khiển lỏng, vị trí chi tiết sẽ không bị khóa, các cảnh cần đường viền chính xác nên chuyển sang Canny hoặc Lineart
- Chỉ được huấn luyện cho MOSS-Image-SFT; mô hình cơ sở được đánh dấu là Other; 1 hình mẫu cấp độ nhạy cảm bị ẩn
- Thẻ mô hình đầy đủ đề xuất giảm cường độ xuống 0.7 nếu điều khiển quá cứng nhắc
- Mục này chưa được chạy thử
【A】MOSS-Image Normal Control · v1.0
LoRA · Mô hình mới · Tác giả thedeoxen · Phát hành 11-10 16:51 · Tải xuống 24
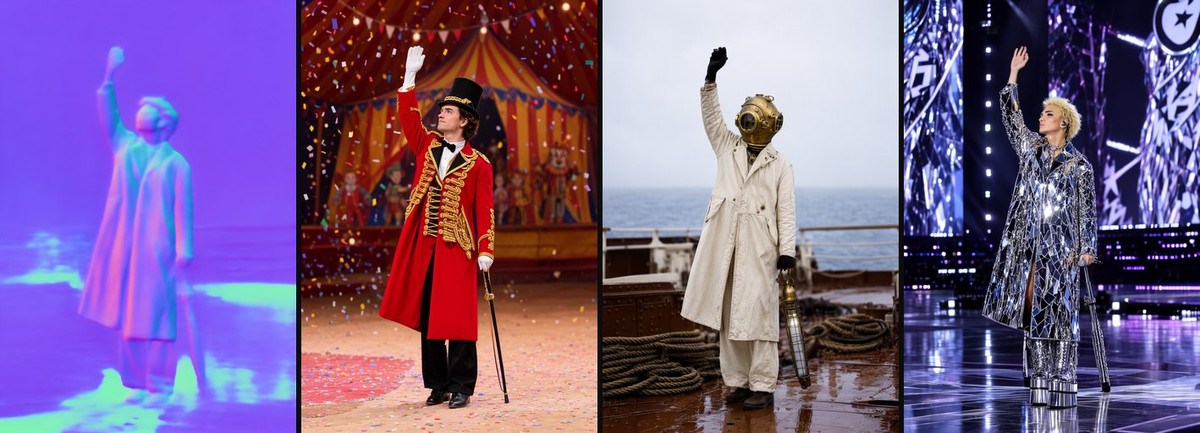
LoRA điều khiển pháp tuyến cho MOSS-Image-SFT: cung cấp một bản đồ pháp tuyến màu, giữ nguyên thể tích và hướng bề mặt của vật thể, chỉ thay đổi vật liệu và bối cảnh.
Hình minh họa
Lý do đề xuất
- Tính năng mới: quản lý thêm một lớp "bề mặt hướng về đâu" so với bản đồ độ sâu, giữ nguyên thể tích và hướng nhưng có thể thay đổi vật liệu; các mục đích sử dụng được tác giả liệt kê bao gồm thay đổi vật liệu / chiếu sáng lại cho hình dạng cố định, và các cảnh trong ảnh sản phẩm nơi thể tích vật thể được cố định
- Phục vụ thay đổi vật liệu trong ảnh sản phẩm, kết cấu lại tượng hoặc đạo cụ, các cảnh mà độ sâu đã đúng nhưng vẫn cần kiểm soát hướng bề mặt; đầu vào là pháp tuyến xuất từ ảnh hoặc kết xuất 3D
- Tiền xử lý: quy trình làm việc sử dụng BAE Normal Map, hình huấn luyện là pháp tuyến không gian máy ảnh màu tím / xanh lục / xanh lam phổ biến; tác giả nhắc nhở phải sử dụng pháp tuyến không gian máy ảnh, không được dùng bản đồ độ cao thang xám, pháp tuyến càng mượt thì thể tích càng sạch, nhiều nhiễu sẽ tạo ra các chỗ lồi thừa
- Kèm theo quy trình làm việc ComfyUI; lưu ở bước 5000, cường độ 1.0, 30 bước, CFG 4, euler + simple; 3 hình mẫu ghép với cùng một ảnh thử nghiệm như phiên bản Canny / Lineart
- Miễn phí, giấy phép cho phép xuất ảnh và bán
Cách sử dụng
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), gắn LoRA vào UNet, cường độ 1.0
- BAE Normal Map tạo ra bản đồ pháp tuyến không gian máy ảnh màu, làm hình tham chiếu duy nhất nối vào Text Encode MOSS-Image Edit, đặt edit format cho cả mã hóa dương và âm là ai-toolkit
- 30 bước, CFG 4, euler + simple; không có từ khóa kích hoạt, viết vật liệu và bối cảnh trong prompt
Rủi ro và hạn chế
- Phạm vi sử dụng hẹp hơn Canny / Depth, chủ yếu chỉ tạo thêm giá trị so với điều khiển độ sâu trong các trường hợp thay đổi vật liệu, chiếu sáng
- Cần tự xác nhận xem pháp tuyến xuất từ phần mềm 3D có khớp với quy ước màu của BAE hay không, tác giả không giải thích; chỉ được huấn luyện cho MOSS-Image-SFT; mô hình cơ sở được đánh dấu là Other; 1 hình mẫu cấp độ nhạy cảm bị ẩn
- Thẻ mô hình đầy đủ đề xuất giảm cường độ xuống 0.7 nếu điều khiển quá cứng nhắc
- Mục này chưa được chạy thử
【A】MOSS-Image Segmentation Control · v1.0
LoRA · Mô hình mới · Tác giả thedeoxen · Phát hành 11-10 16:54 · Tải xuống 25
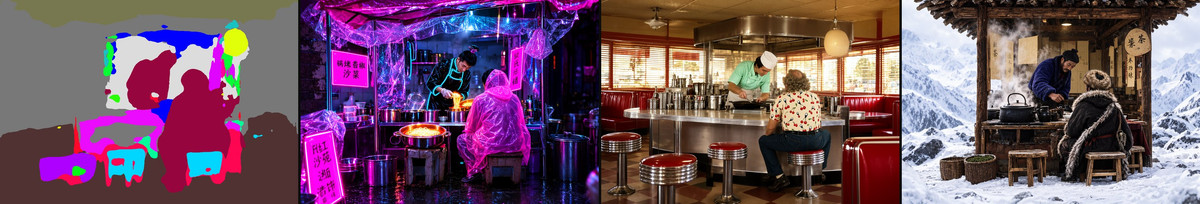
LoRA điều khiển phân đoạn ngữ nghĩa cho MOSS-Image-SFT: cung cấp một bản đồ khu vực với các khối màu phẳng, giữ nguyên ranh giới và bố cục khối lớn của từng khu vực, mỗi khối sẽ trở thành gì do prompt quyết định.
Hình minh họa
Lý do đề xuất
- Tính năng mới: điều khiển theo "khối khu vực" thay vì đường nét hoặc độ sâu, phù hợp để chia khung hình thành các khối lớn như người, nội thất, nền trước, sau đó thay đổi phong cách kết xuất tổng thể; tác giả cho biết ranh giới và khối lượng lớn sẽ được giữ lại
- Phục vụ bố cục phân khối cảnh, bố cục kiểu kịch bản màu sắc, vẽ lại toàn bộ hình ảnh trong khi giữ nguyên vị trí của người và nội thất
- Tiền xử lý: quy trình làm việc sử dụng phân đoạn ngữ nghĩa UniFormer; hình huấn luyện là các khối màu phẳng phủ kín, không có vùng đen lớn chưa được đánh dấu; tác giả nhắc nhở rằng màu của các khối chỉ là số hiệu khu vực, chúng sẽ không trở thành màu trong ảnh kết quả, vật liệu cần được viết trong prompt, gradient và kết cấu sẽ làm rối loạn các khu vực
- Kèm theo quy trình làm việc ComfyUI; lưu ở bước 4500, cường độ 1.0, 30 bước, CFG 4, euler + simple
- Miễn phí, giấy phép cho phép xuất ảnh và bán; phát hành 4 giờ với 25 lượt tải xuống
Cách sử dụng
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), gắn LoRA vào UNet, cường độ 1.0
- UniFormer tạo ra bản đồ khu vực màu phẳng phủ kín khung hình (không để lại nền đen lớn), làm hình tham chiếu duy nhất nối vào Text Encode MOSS-Image Edit, đặt edit format cho cả mã hóa dương và âm là ai-toolkit
- 30 bước, CFG 4, euler + simple; không có từ khóa kích hoạt, viết rõ chủ thể và vật liệu của từng khu vực trong prompt
Rủi ro và hạn chế
- Tác giả cho biết các bộ phân đoạn để lại nền đen không phù hợp lắm với trọng số này, cần lưu ý khi đổi sang mô hình phân đoạn khác
- 2 hình mẫu có thể xem, 1 hình mẫu cấp độ nhạy cảm bị ẩn; chỉ được huấn luyện cho MOSS-Image-SFT; mô hình cơ sở được đánh dấu là Other
- Thẻ mô hình đầy đủ đề xuất giảm cường độ xuống 0.7 nếu điều khiển quá cứng nhắc
- Mục này chưa được chạy thử
【A】MOSS-Image Lineart Control · v1.0
LoRA · Mô hình mới · Tác giả thedeoxen · Phát hành 11-10 16:37 · Tải xuống 21
LoRA điều khiển lineart cho MOSS-Image-SFT: cung cấp bản vẽ lineart nét mảnh màu trắng trên nền đen, tạo hình theo cấu trúc đường nét, còn tô màu, vật liệu và phong cách do prompt quyết định.
Hình minh họa
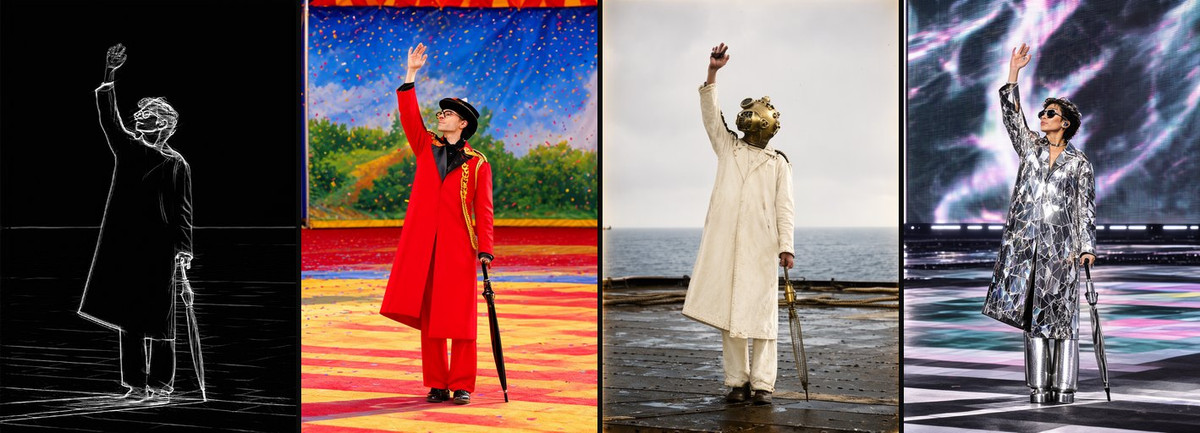
Lý do đề xuất
- Tính năng mới: nằm giữa Canny và Scribble—theo dõi các đường viền sạch sẽ, nhưng không kèm theo nhiễu điểm lộn xộn trong hình Canny gốc; mục đích sử dụng đầu tiên được tác giả liệt kê là tô màu cho lineart
- Phục vụ tô màu lineart, tạo ảnh hoàn chỉnh từ phác thảo thiết kế, giữ lại cấu trúc đường nét từ ảnh rồi thay đổi bối cảnh; tác giả cho biết cả lineart vẽ tay và lineart trích xuất từ ảnh đều có thể sử dụng, với điều kiện đường nét phải nhẹ và thưa
- Tiền xử lý có lưu ý: quy trình làm việc sử dụng Realistic Lineart và bật coarse, tác giả cho rằng điều này gần với hình huấn luyện hơn so với chế độ lineart tinh tế; đường trắng nền đen, nếu bạn có lineart đường đen nền trắng thì cần đảo ngược màu trước
- Kèm theo quy trình làm việc ComfyUI; lưu ở bước 5000, cường độ 1.0, 30 bước, CFG 4, euler + simple; 3 hình mẫu ghép với cùng một ảnh thử nghiệm như phiên bản Canny
- Miễn phí, giấy phép cho phép xuất ảnh và bán
Cách sử dụng
- MOSS-Image-SFT (int8 convrot UNet + qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), gắn LoRA vào UNet, cường độ 1.0
- Realistic Lineart (bật coarse) tạo ra hình đường trắng nền đen, làm hình tham chiếu duy nhất nối vào Text Encode MOSS-Image Edit, đặt edit format cho cả mã hóa dương và âm là ai-toolkit
- 30 bước, CFG 4, euler + simple; không có từ khóa kích hoạt, viết màu sắc, vật liệu và phong cách vẽ trong prompt
Rủi ro và hạn chế
- Tác giả cho biết đường nét thưa phù hợp với dữ liệu huấn luyện hơn so với vẽ ký họa dày đặc, hiệu suất khi lineart quá dày đặc không được giải thích
- Chỉ được huấn luyện cho MOSS-Image-SFT; mô hình cơ sở được đánh dấu là Other; 1 hình mẫu cấp độ nhạy cảm bị ẩn; nhóm này có lượt tải xuống ít nhất (21 lượt)
- Thẻ mô hình đầy đủ đề xuất giảm cường độ xuống 0.7 nếu điều khiển quá cứng nhắc
- Mục này chưa được chạy thử
【A】MOSS-Image Canny Control · v1.0
LoRA · Mô hình mới · Tác giả thedeoxen · Phát hành 11-10 16:29 · Tải xuống 23
LoRA điều khiển cạnh Canny cho MOSS-Image-SFT: cung cấp bản đồ cạnh Canny đường trắng trên nền đen, khóa đường viền vật thể, bố cục và các cạnh chi tiết, còn vật liệu, phối màu và phong cách được giao cho prompt.
Hình minh họa
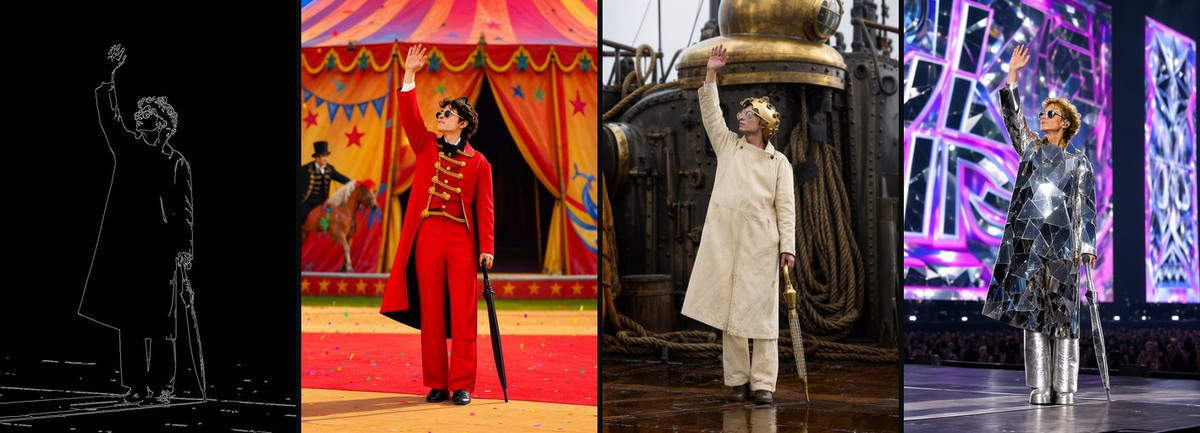
Lý do đề xuất
- Tính năng mới: Trong loạt LoRA do cùng tác giả phát hành, đây là phiên bản có ràng buộc chặt chẽ nhất, bám sát cả những chi tiết nhỏ ở rìa; tác giả định vị nó là “giữ nguyên đường viền, thay đổi màu sắc và chất liệu”, phù hợp cho các nghiên cứu bố cục yêu cầu đường viền không được thay đổi
- Phục vụ chuyển ảnh thành phong cách, vẽ lại cùng bố cục với chất liệu khác, bản nháp bố cục: đầu vào là một bức ảnh hoặc hình ảnh có sẵn, trước tiên trích xuất Canny rồi mới tạo sinh
- Tiền xử lý được mô tả cụ thể: sử dụng Canny Edge từ comfyui_controlnet_aux, ngưỡng low 100 / high 200; tác giả lưu ý nếu kết quả bám quá sát từng điểm nhiễu, hãy tăng ngưỡng để đường viền sạch hơn
- Kèm theo workflow ComfyUI; lưu ở bước thứ 4500, cường độ 1.0, 30 bước, CFG 4, euler + simple; ví dụ minh họa gồm 3 hình ghép “bản đồ kiểm soát + ba prompt”, sử dụng cùng một bức ảnh thử nghiệm về trưởng đoàn xiếc như các bản Normal / Scribble / Lineart của cùng tác giả, có thể so sánh ngang
- Miễn phí, giấy phép cho phép xuất ảnh và bán; đã tải xuống 23 lần trong vòng 4 giờ kể từ khi phát hành
Cách sử dụng
- MOSS-Image-SFT (UNet int8 convrot + bộ mã hóa văn bản qwen3.5_9b_w4a8_gptq, loại moss_image + flux2-vae_small), gắn LoRA vào UNet, cường độ 1.0
- Tiền xử lý Canny Edge (low 100 / high 200) tạo ra bản vẽ đường nét màu trắng trên nền đen, dùng làm hình ảnh tham chiếu duy nhất nối vào Text Encode MOSS-Image Edit, cả mã hóa dương và âm đều đặt edit format là ai-toolkit
- 30 bước, CFG 4, euler + simple; không có từ kích hoạt (trigger word), prompt mô tả chất liệu, phối màu và bối cảnh mới
Rủi ro và hạn chế
- Bản đồ Canny càng dày đặc, hình ảnh càng bị ràng buộc bởi chi tiết của ảnh gốc, không gian để prompt biến đổi càng nhỏ; nếu chỉ muốn giữ hình dạng tổng thể, nên chuyển sang hai bản Scribble hoặc Lineart
- Chỉ được huấn luyện cho MOSS-Image-SFT, tác giả chưa đề cập đến các mô hình cơ sở / độ chính xác khác; mô hình cơ sở được đánh dấu là Other; 1 ví dụ ở mức nhạy cảm đã bị ẩn
- Thẻ mô hình đầy đủ khuyến nghị giảm cường độ xuống 0.7 nếu kiểm soát quá cứng nhắc
- Mục này chưa được chạy thử
【A】MOSS-Image Depth Control · v1.0
LoRA · Mô hình mới · Tác giả thedeoxen · Phát hành 11-10 16:25 · Tải xuống 22
LoRA kiểm soát độ sâu cho MOSS-Image-SFT: cung cấp một bản đồ độ sâu grayscale (gần trắng, xa đen), giữ nguyên khoảng cách trước-sau và bố cục không gian, phần chủ thể và phong cách sẽ do prompt quyết định.
Hình minh họa
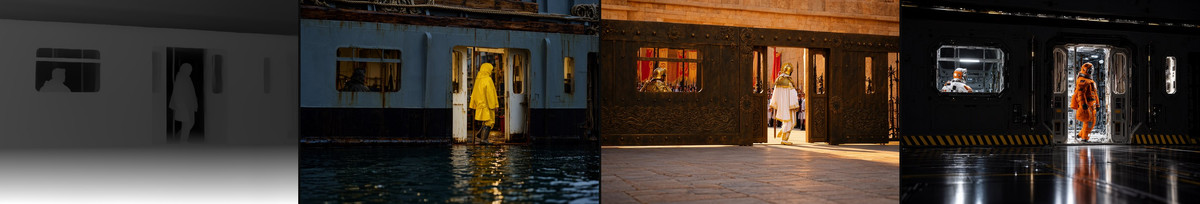
Lý do đề xuất
- Tính năng mới: Chỉ khóa “ai gần, ai xa” và độ sâu trường máy quay, không khóa từng đường viền; tác giả cho biết nó phù hợp với những trường hợp mà “độ sâu trường máy quay quan trọng hơn đường viền”; lưu ý đây không phải là bộ thích ứng ghép màu/độ sâu chính thức của MOSS, mà là LoRA dạng chỉnh sửa của cùng tác giả
- Phục vụ tái tạo bối cảnh với phong cách khác ở cùng vị trí máy quay, tách chủ thể tiền cảnh khỏi hậu cảnh để thay đổi chất liệu, và các bố cục có chủ thể cận cảnh rõ ràng như sản phẩm hoặc nội thất
- Tiền xử lý: workflow sử dụng Depth Anything V2 (depth_anything_v2_vitl), phần gần màu trắng, nền chuyển sang đen; tác giả đặc biệt nhắc nhở không dùng bản đồ độ sâu bị đảo ngược, nếu không sẽ xung đột với LoRA
- Kèm theo workflow ComfyUI; lưu ở bước thứ 5000, cường độ 1.0, 30 bước, CFG 4, euler + simple; tác giả cho biết các vùng độ sâu phẳng và lớn sẽ để lại nhiều không gian hơn cho prompt tạo kết cấu
- Miễn phí, giấy phép cho phép xuất ảnh và bán; 3 lượt thích
Cách sử dụng
- MOSS-Image-SFT (UNet int8 convrot + bộ mã hóa văn bản qwen3.5_9b_w4a8_gptq / moss_image + flux2-vae_small), gắn LoRA vào UNet, cường độ 1.0
- Depth Anything V2 vitl tạo ra bản đồ độ sâu grayscale (gần trắng, xa đen, không đảo ngược), dùng làm hình ảnh tham chiếu duy nhất nối vào Text Encode MOSS-Image Edit, cả mã hóa dương và âm đều đặt edit format là ai-toolkit
- 30 bước, CFG 4, euler + simple; không có từ kích hoạt, prompt mô tả chủ thể, chất liệu và phong cách
Rủi ro và hạn chế
- Chỉ có 1 hình ghép trong các ví dụ hiển thị công khai, ngoài ra còn 4 ví dụ ở mức nhạy cảm bị ẩn, đây là mục có ít bằng chứng công khai nhất trong nhóm này
- Tác giả chưa so sánh ưu nhược điểm với bộ thích ứng ghép độ sâu chính thức; chỉ được huấn luyện cho MOSS-Image-SFT; mô hình cơ sở được đánh dấu là Other
- Thẻ mô hình đầy đủ khuyến nghị giảm cường độ xuống 0.7 nếu kiểm soát quá cứng nhắc
- Mục này chưa được chạy thử
Có thể quan tâm (10)
【B】AG: Naberius - Grumpy Niji Boys · MOSS-Image
LoRA · Chuyển đổi · Tác giả Azriaelis · Phát hành 11-10 09:10 · Tải xuống 27
Phiên bản MOSS của nhân vật Naberius trong loạt “Ars Goetia”: LoRA phong cách thiên về bán thực tế kiểu Niji, chủ yếu là nhân vật nam (tiêu đề là Grumpy Niji Boys).
Hình minh họa
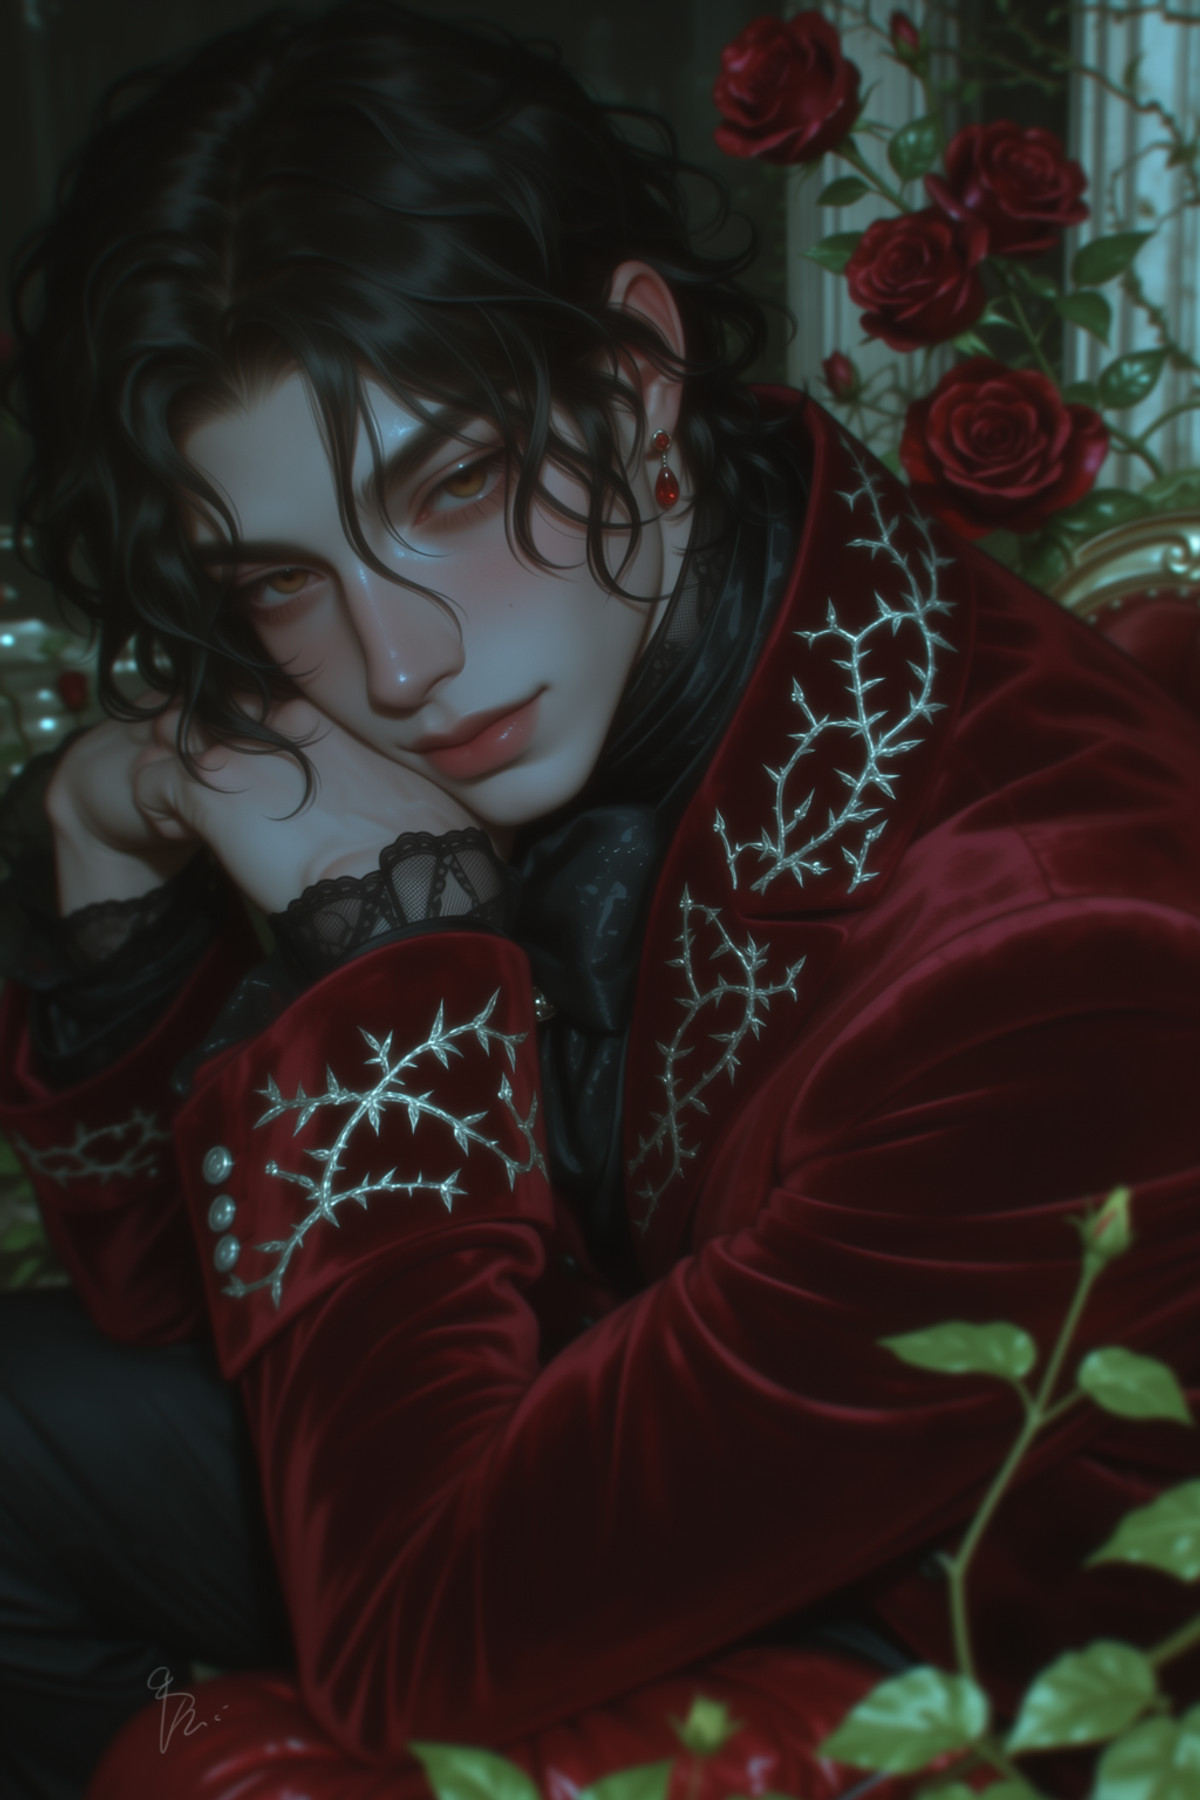
【B】HaDeS MOSS Suite Workflows · Turbo Image to Image v0.1
Workflow · Cập nhật phiên bản · Tác giả _HaDeS_ · Phát hành 11-10 17:33 · Tải xuống 24
Một mục mới trong bộ sưu tập workflow HaDeS MOSS Suite: workflow ComfyUI cho phép chuyển ảnh sang ảnh (image-to-image) của MOSS, có kèm nút tăng cường prompt và LoRA tăng tốc HaDeS (dạng JSON, không phải trọng số mới).
Hình minh họa
【B】V67 Twins and Mirror · V1 MOSS
LoRA · Chuyển đổi · Tác giả angelomaiota · Phát hành 11-10 17:57 · Tải xuống 23
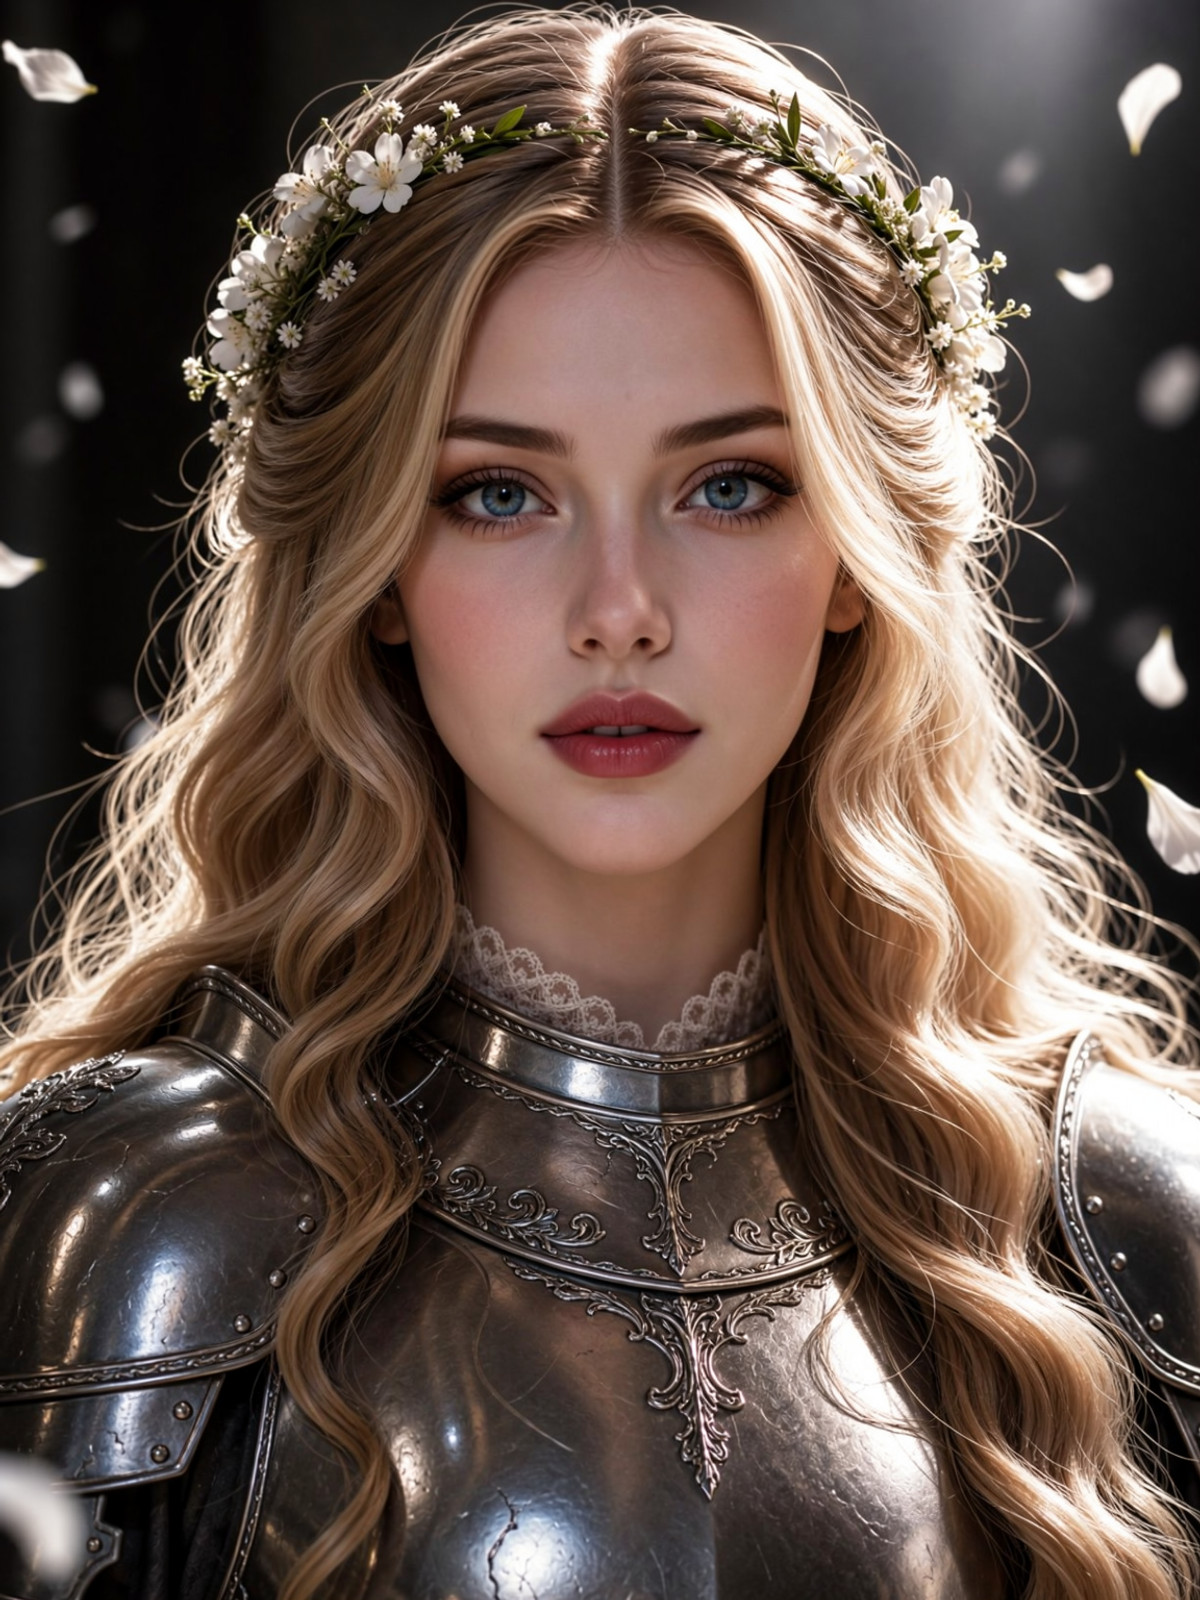
Phiên bản MOSS của LoRA sinh đôi và gương: tạo ra các hình ảnh kiểu “một người hai thân” hoặc bố cục đối xứng như sinh đôi cùng trứng/khác trứng, phản chiếu trong gương, phản chiếu trên vũng nước.
Hình minh họa
【B】One obsession_MOSS · SFT v1
Mô hình cơ sở / Checkpoint · Cập nhật phiên bản · Tác giả maxfeifei8 · Phát hành 11-10 19:20 · Tải xuống 9 · Trả phí
Phiên bản thứ hai SFT v1 của mô hình cơ sở MOSS được tinh chỉnh One obsession: toàn bộ trọng số mô hình cơ sở (hai loại INT8 và BF16), theo tên gọi thuộc loạt SFT, phiên bản trước đó là BASE v1.
Hình minh họa
【B】V67 Italian Villages · V1 MOSS
LoRA · Chuyển đổi · Tác giả angelomaiota · Phát hành 11-10 15:11 · Tải xuống 21
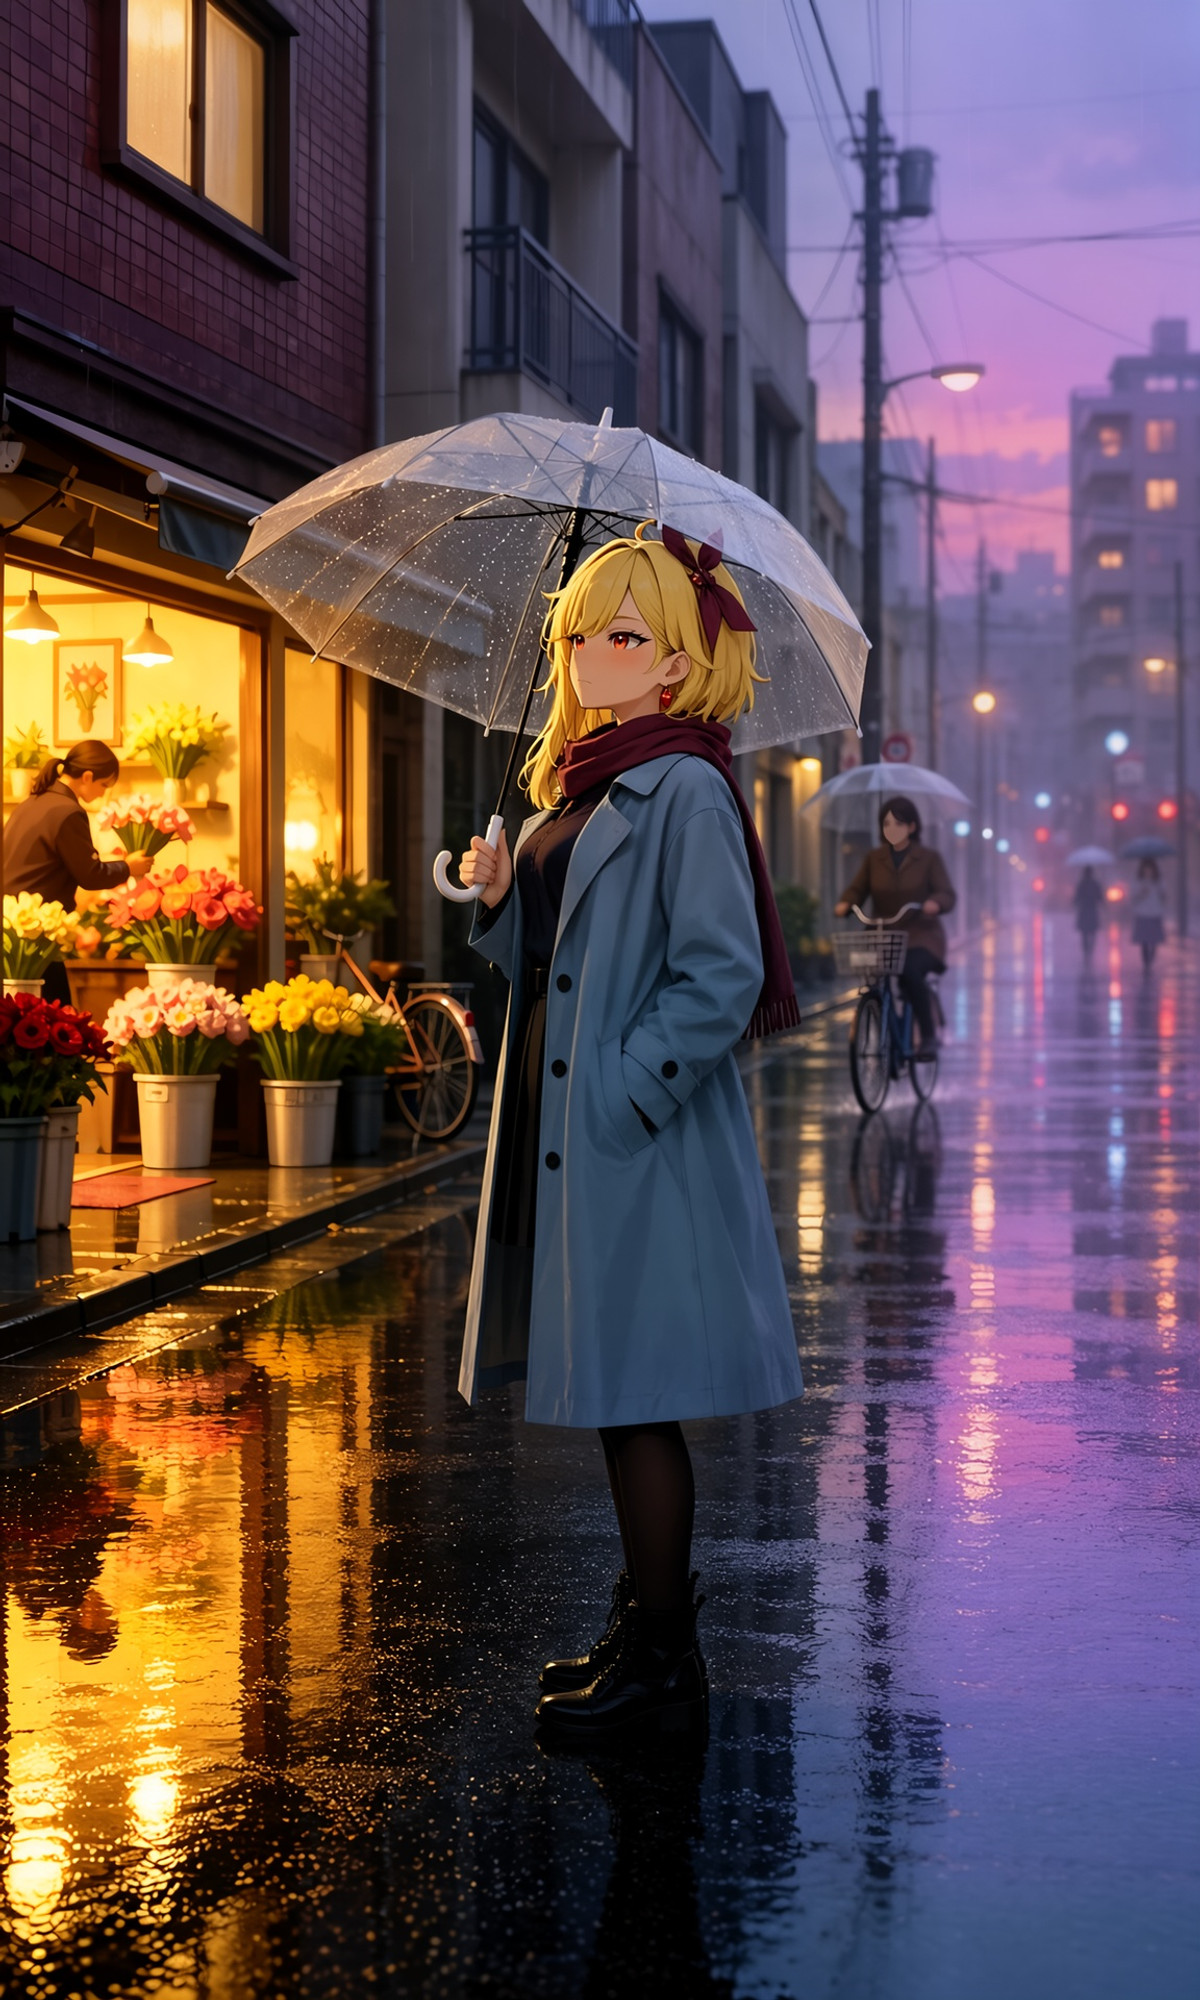
Phiên bản MOSS của LoRA phong cảnh làng quê Ý: nhà đá, hẻm nhỏ, mái ngói đất nung, góc nhìn từ đỉnh núi và ánh sáng vàng; tác giả cho biết nó kết hợp tranh phong cảnh kiểu Canaletto và nhiếp ảnh kiến trúc thực tế.
Hình minh họa
【B】Chenbin(鬼针草)Style | MOSS Image LoRA · v1.0
LoRA · Mô hình mới · Tác giả NO83 · Phát hành 11-10 20:46 · Tải xuống 7
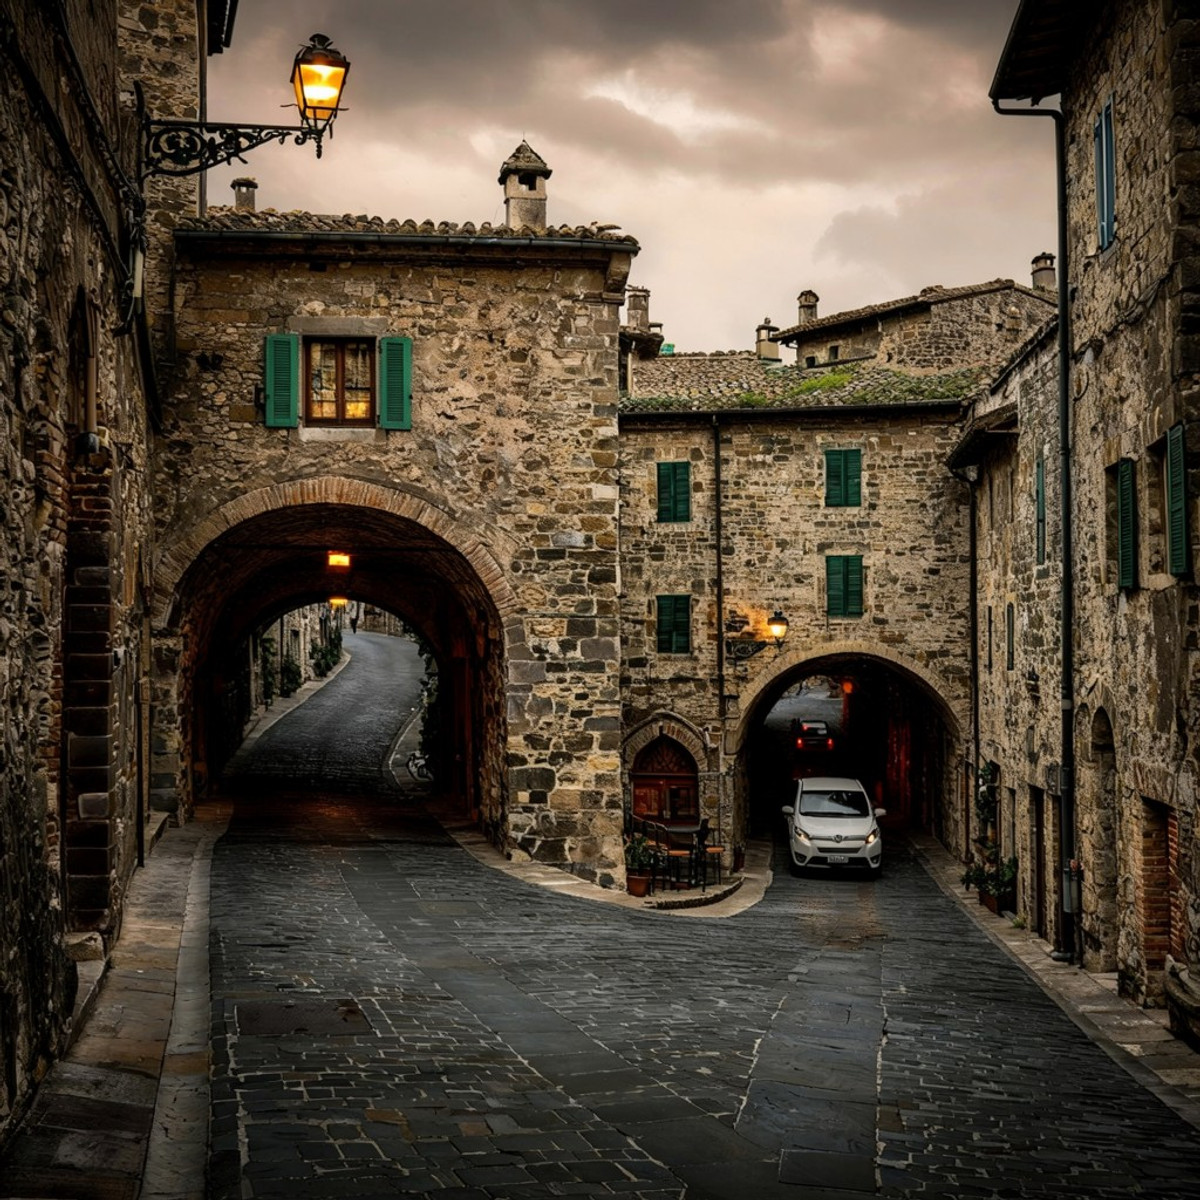
LoRA chuyên dụng cho MOSS mô phỏng phong cách của họa sĩ “鬼针草” (Chenbin): tác giả cho biết kết cấu tất da chân được thể hiện rất tốt, còn tóc thì bình thường.
Hình minh họa
【B】Kromoss slider: blurry to sharp · v1
LoRA · Mô hình mới · Tác giả Generated_Good · Phát hành 11-10 18:27 · Tải xuống 61
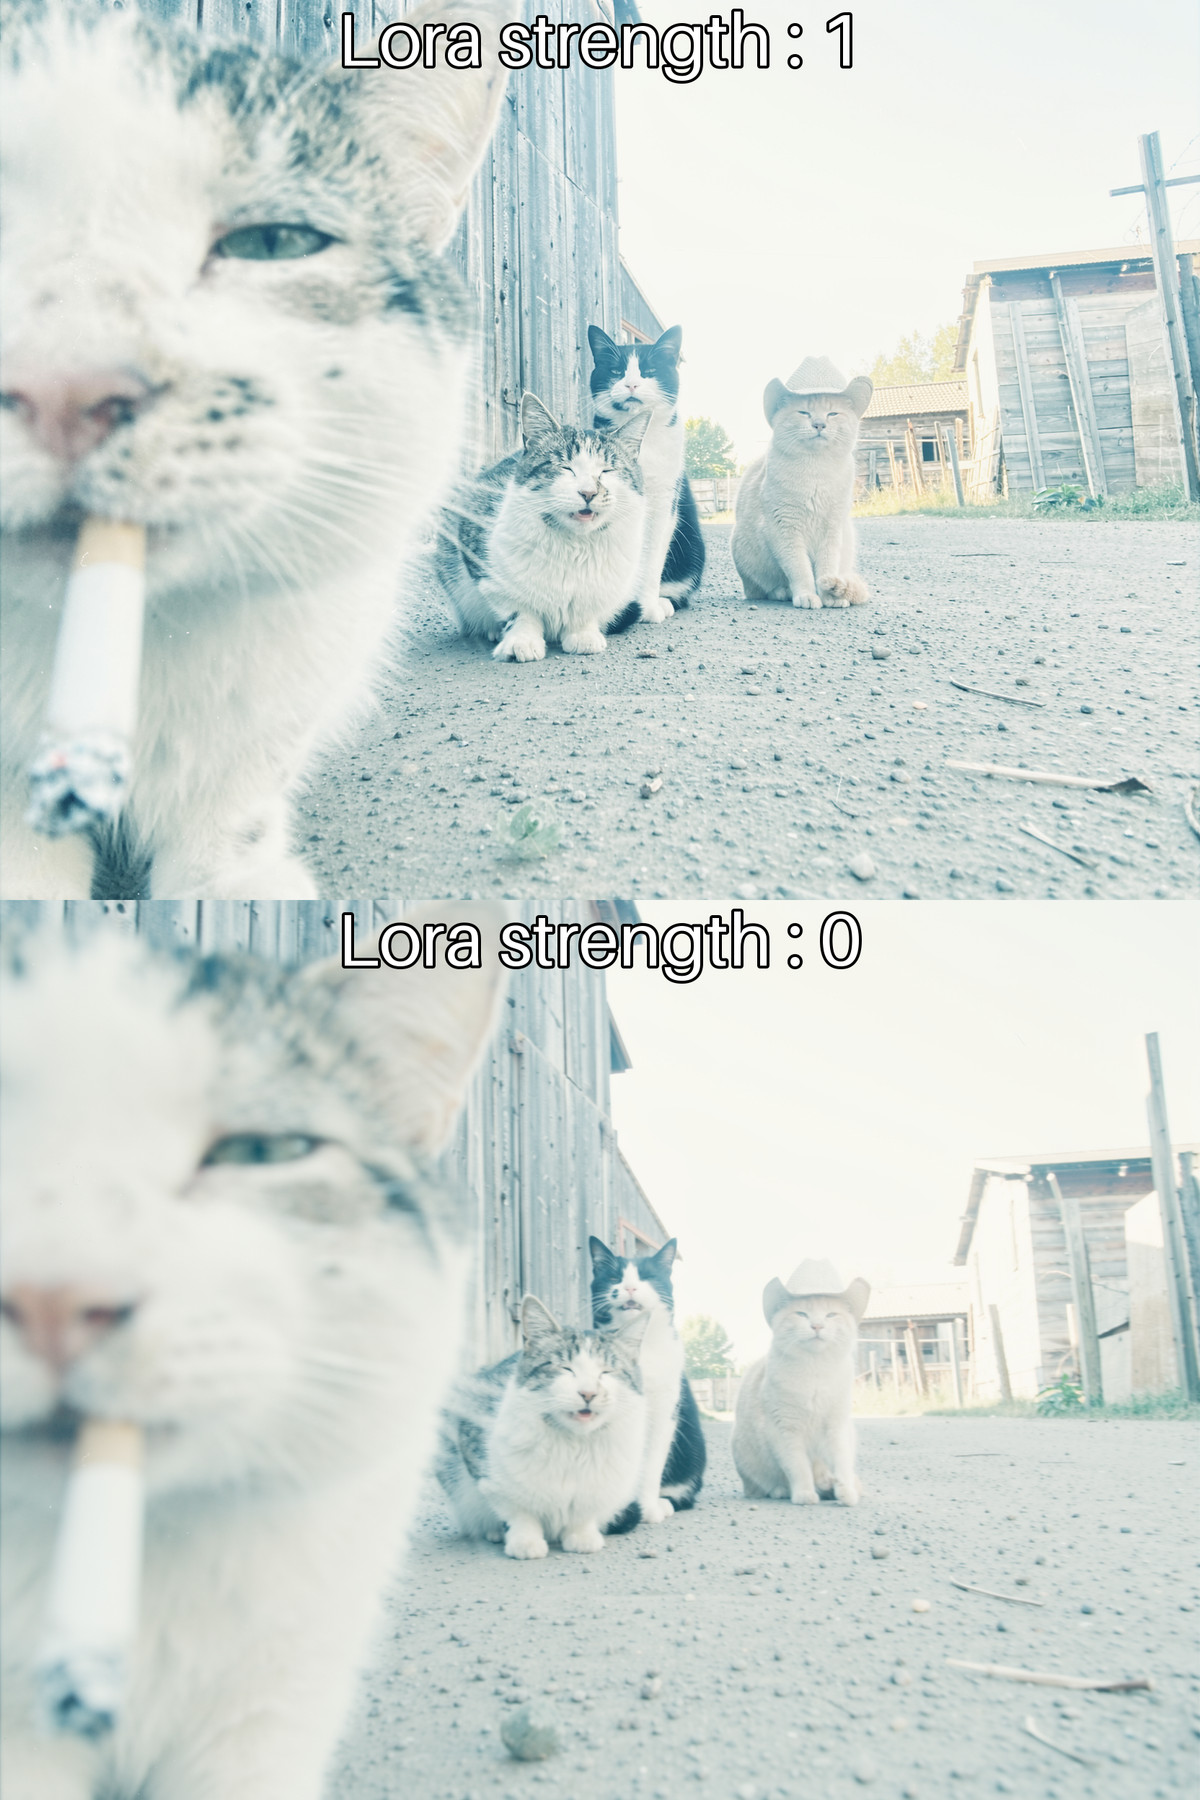
LoRA thanh trượt độ nét: được huấn luyện trên Kromoss (bản tinh chỉnh toàn bộ của MOSS-Image-Base), sử dụng cường độ dương/âm để điều chỉnh mức độ mờ của tiền cảnh và hậu cảnh, nhằm giải quyết vấn đề Kromoss thường tạo ra ảnh bị nhòe.
Hình minh họa
【B】釉光细绘 Glazeline style · moss-v1.0
LoRA · Mô hình mới · Tác giả soda_Cookie · Phát hành 11-10 20:04 · Tải xuống 12
LoRA phong cách minh họa có tên là “Gương Mịn Màng” (Glazeline), tác giả đã cung cấp từ khóa kích hoạt, một câu lệnh mẫu hoàn chỉnh và câu lệnh phủ định.
Hình minh họa
【B】纸雕/纸偶 · v1.0
LoRA · Chuyển đổi · Tác giả YuChuXi · Phát hành 11-10 13:54 · Tải xuống 47
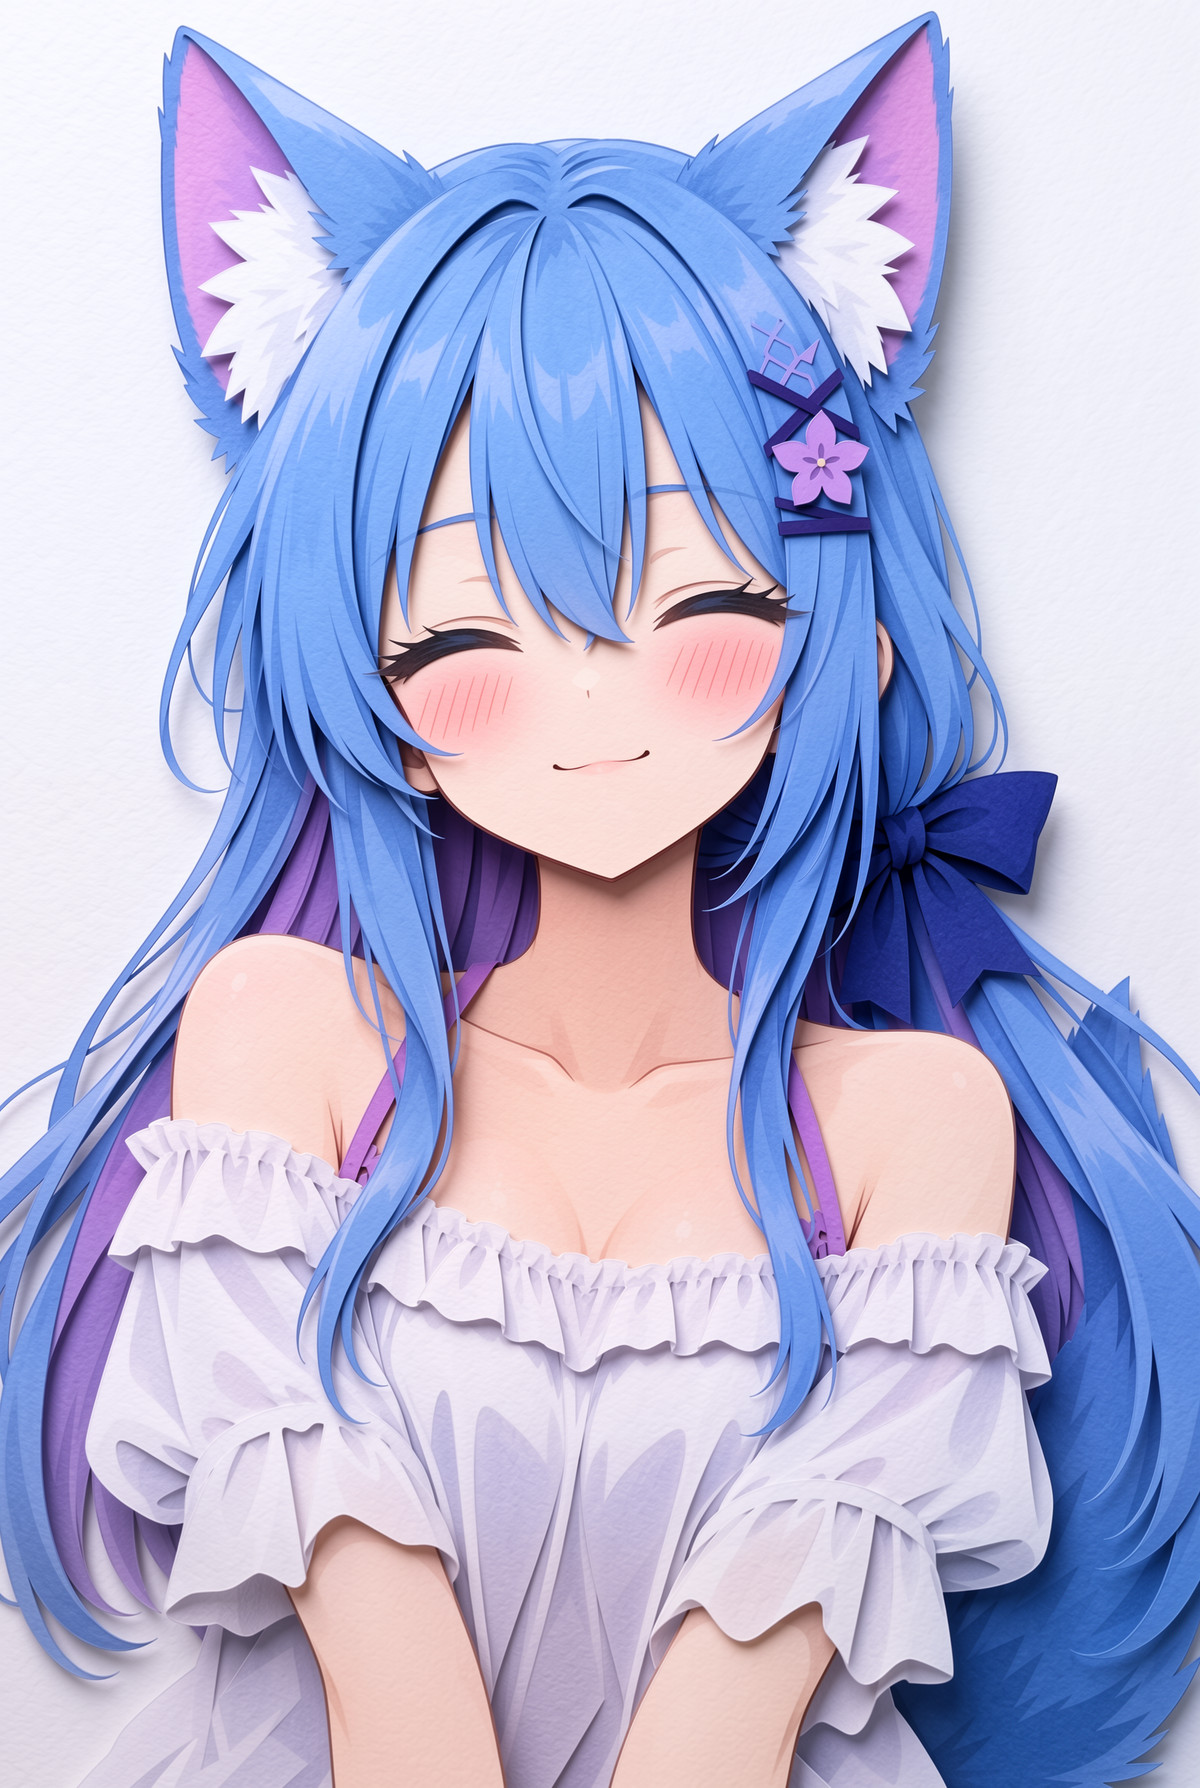
Phiên bản MOSS của LoRA phong cách giấy cắt/giấy rối: biến hình ảnh thành các lớp tranh cắt giấy xếp chồng lên nhau.
Hình minh họa
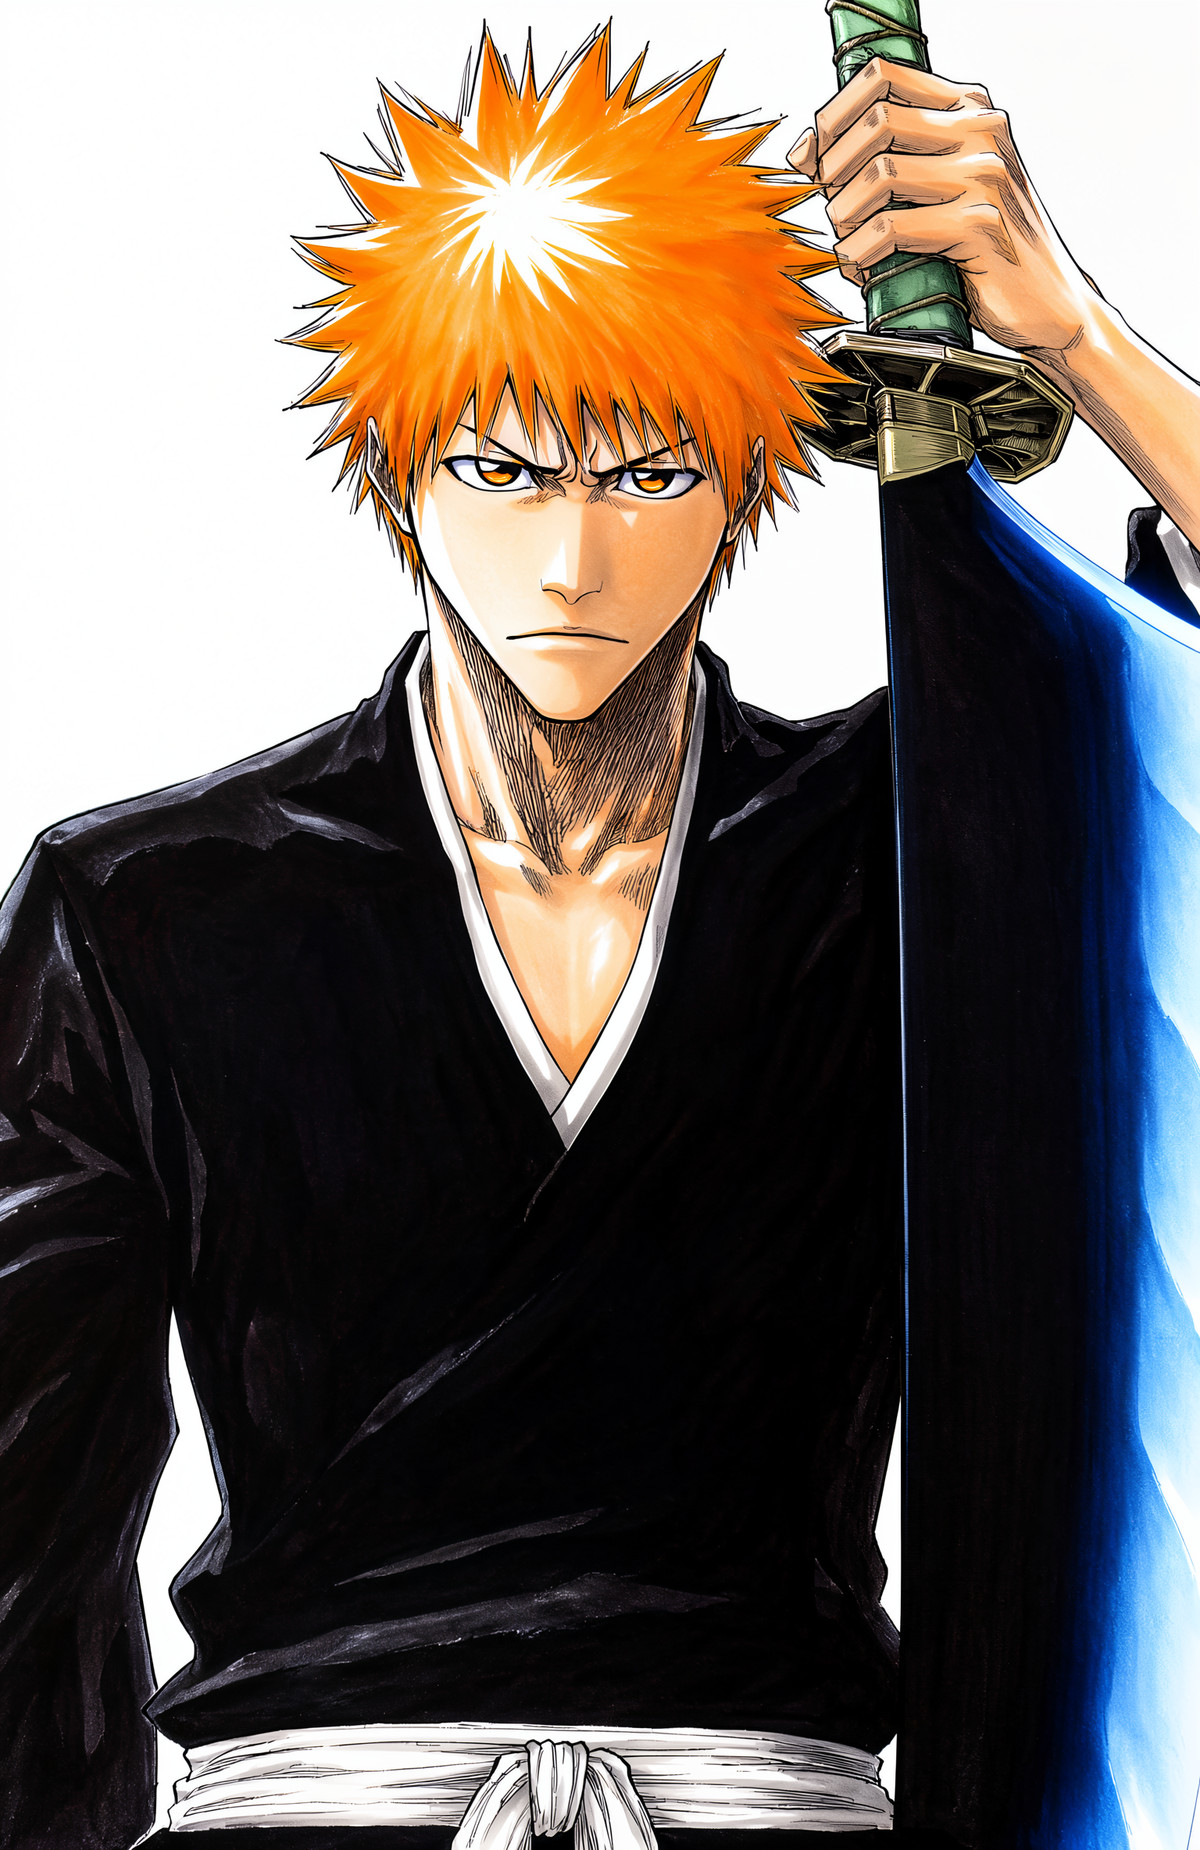
【B】18 in 1,《Bleach》/《死神》,Tite Kubo/久保带人 - Artist Style · MOSS_v1.0
LoRA · Chuyển đổi · Tác giả flyx3 · Phát hành 11-10 12:10 · Tải xuống 3 · Trả phí
Phiên bản MOSS của LoRA phong cách vẽ truyện tranh của Tite Kubo (tác giả bộ Bleach/死神), cùng một tệp có thể tạo ra hầu hết các nhân vật trong tác phẩm này.
Hình minh họa
Chỉ liệt kê (14)
- Phong cách MaleBot · Moss v1 — LoRA: Phiên bản MOSS của LoRA phong cách bắt chước phong cách vẽ bìa các nhân vật nam phổ biến trong chatbot (tác giả cho biết tương tự kiểu niji).
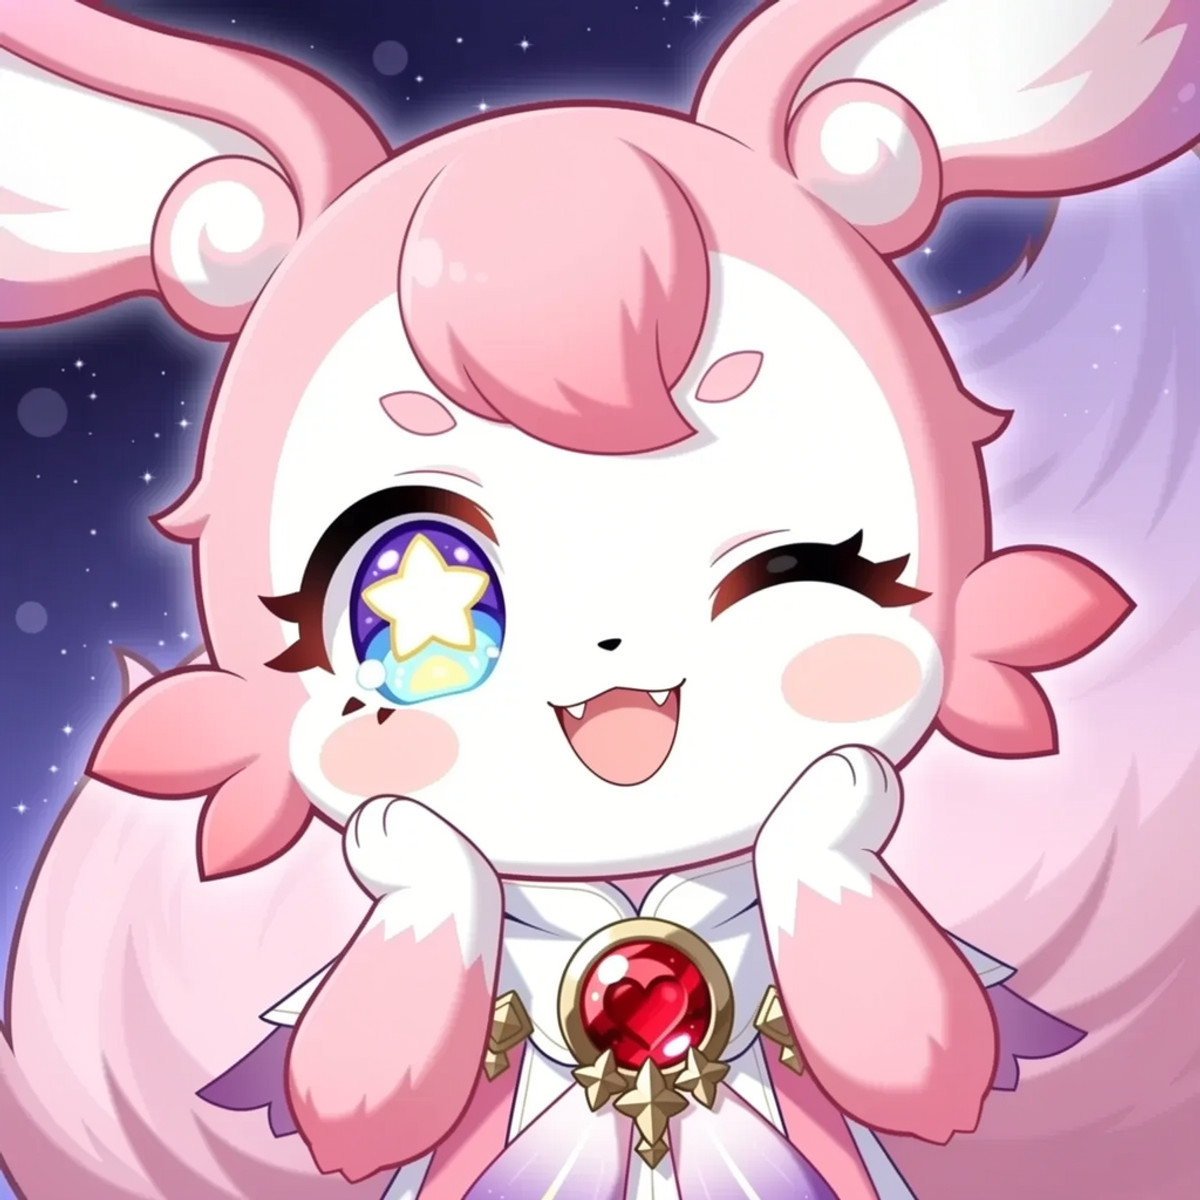
- Mem (Honkai: Star Rail) [Illustrious/pony/moss] · MOSS — LoRA: Phiên bản MOSS của LoRA nhân vật “Mem” (sinh vật nhỏ màu hồng lông xù) từ game 《Honkai: Star Rail》.
- huashijw/Họa sĩ JW | Phong cách · MOSS(test) — LoRA: Phiên bản thử nghiệm MOSS của LoRA phong cách bắt chước phong cách vẽ nữ anime dễ thương của họa sĩ “Họa sĩ JW” (huashijw).
- Phong cách Takorin | ILXL & Anima · Moss v0.1 — LoRA: Phiên bản thử nghiệm v0.1 của LoRA phong cách anime của họa sĩ Takorin (namako8982).
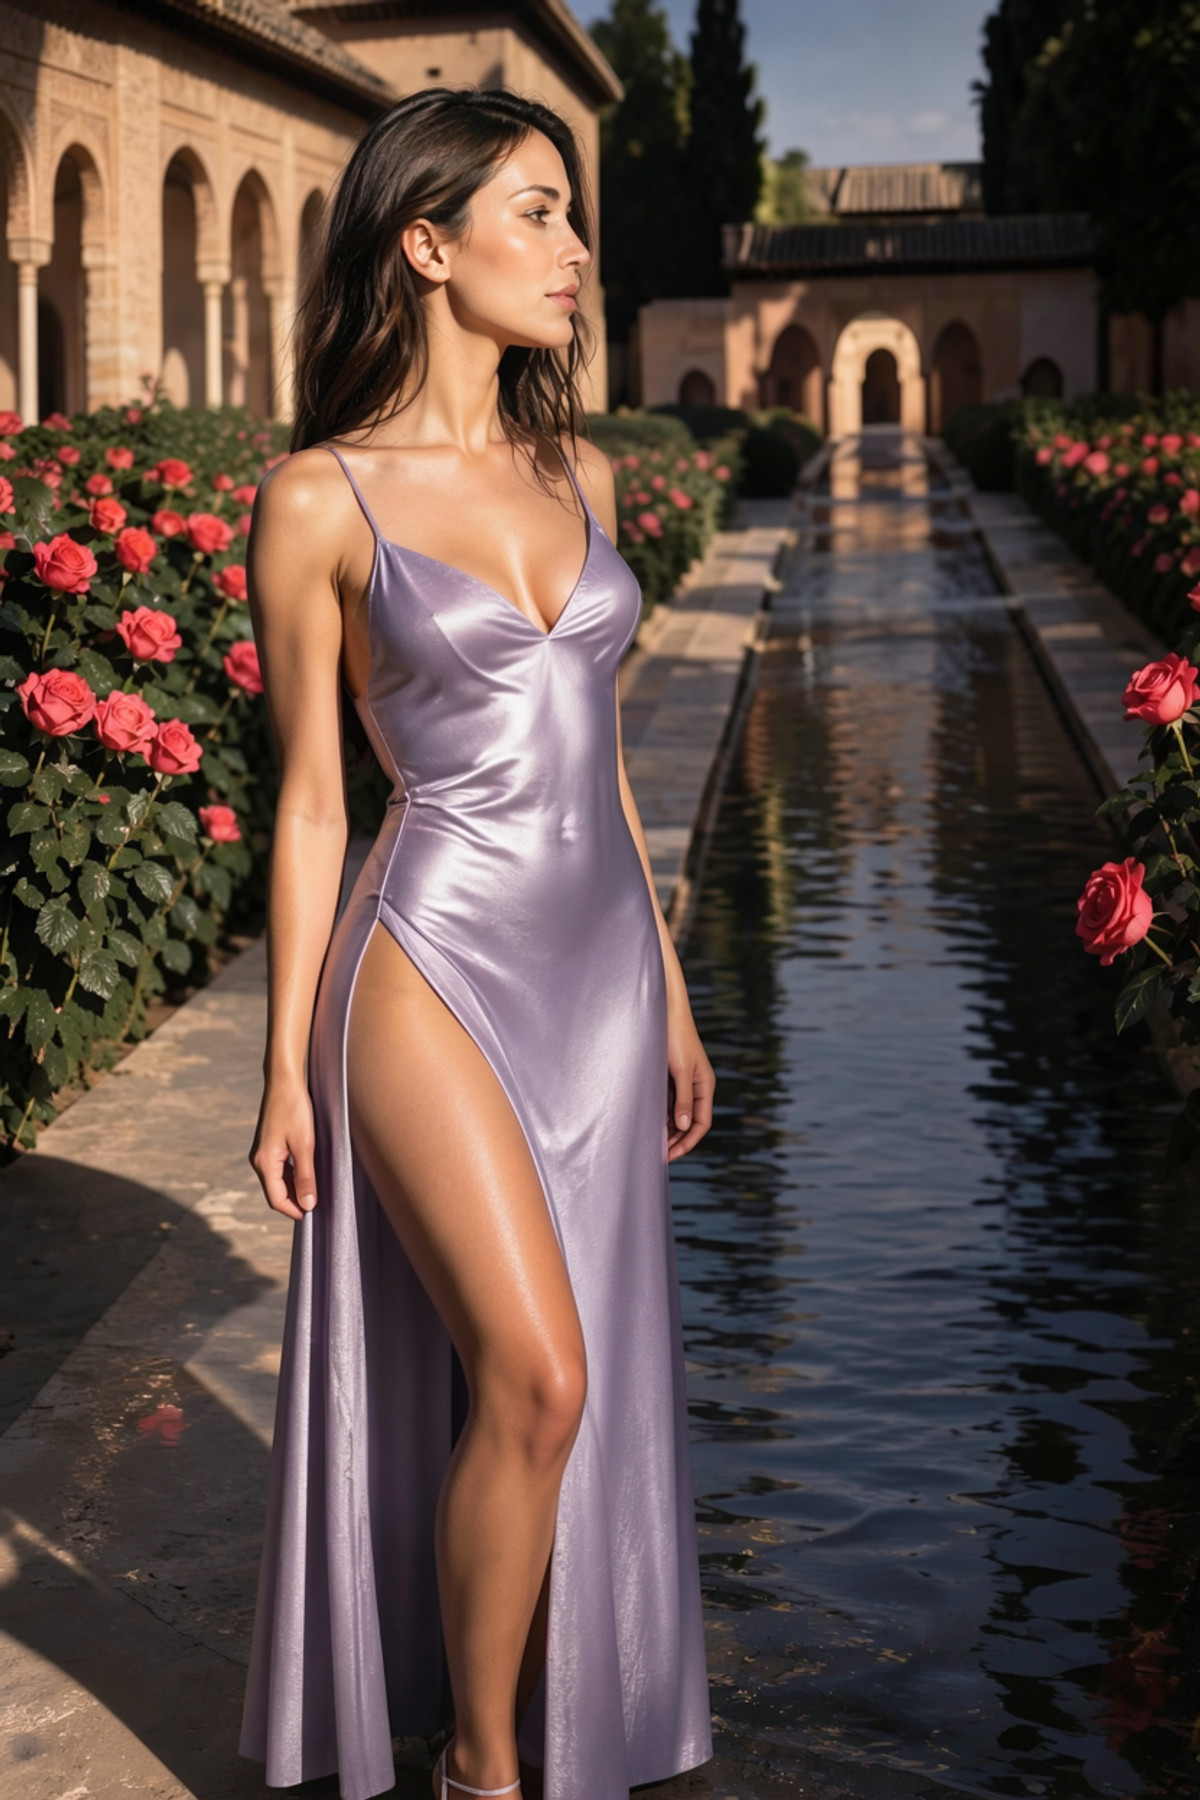
- Francesca · MossImage — LoRA: Phiên bản MOSS của LoRA nhân vật Francesca (nhân vật hư cấu thuộc series MisterMR, với thiết lập là “nàng thơ” xuất thân từ Tuscany).
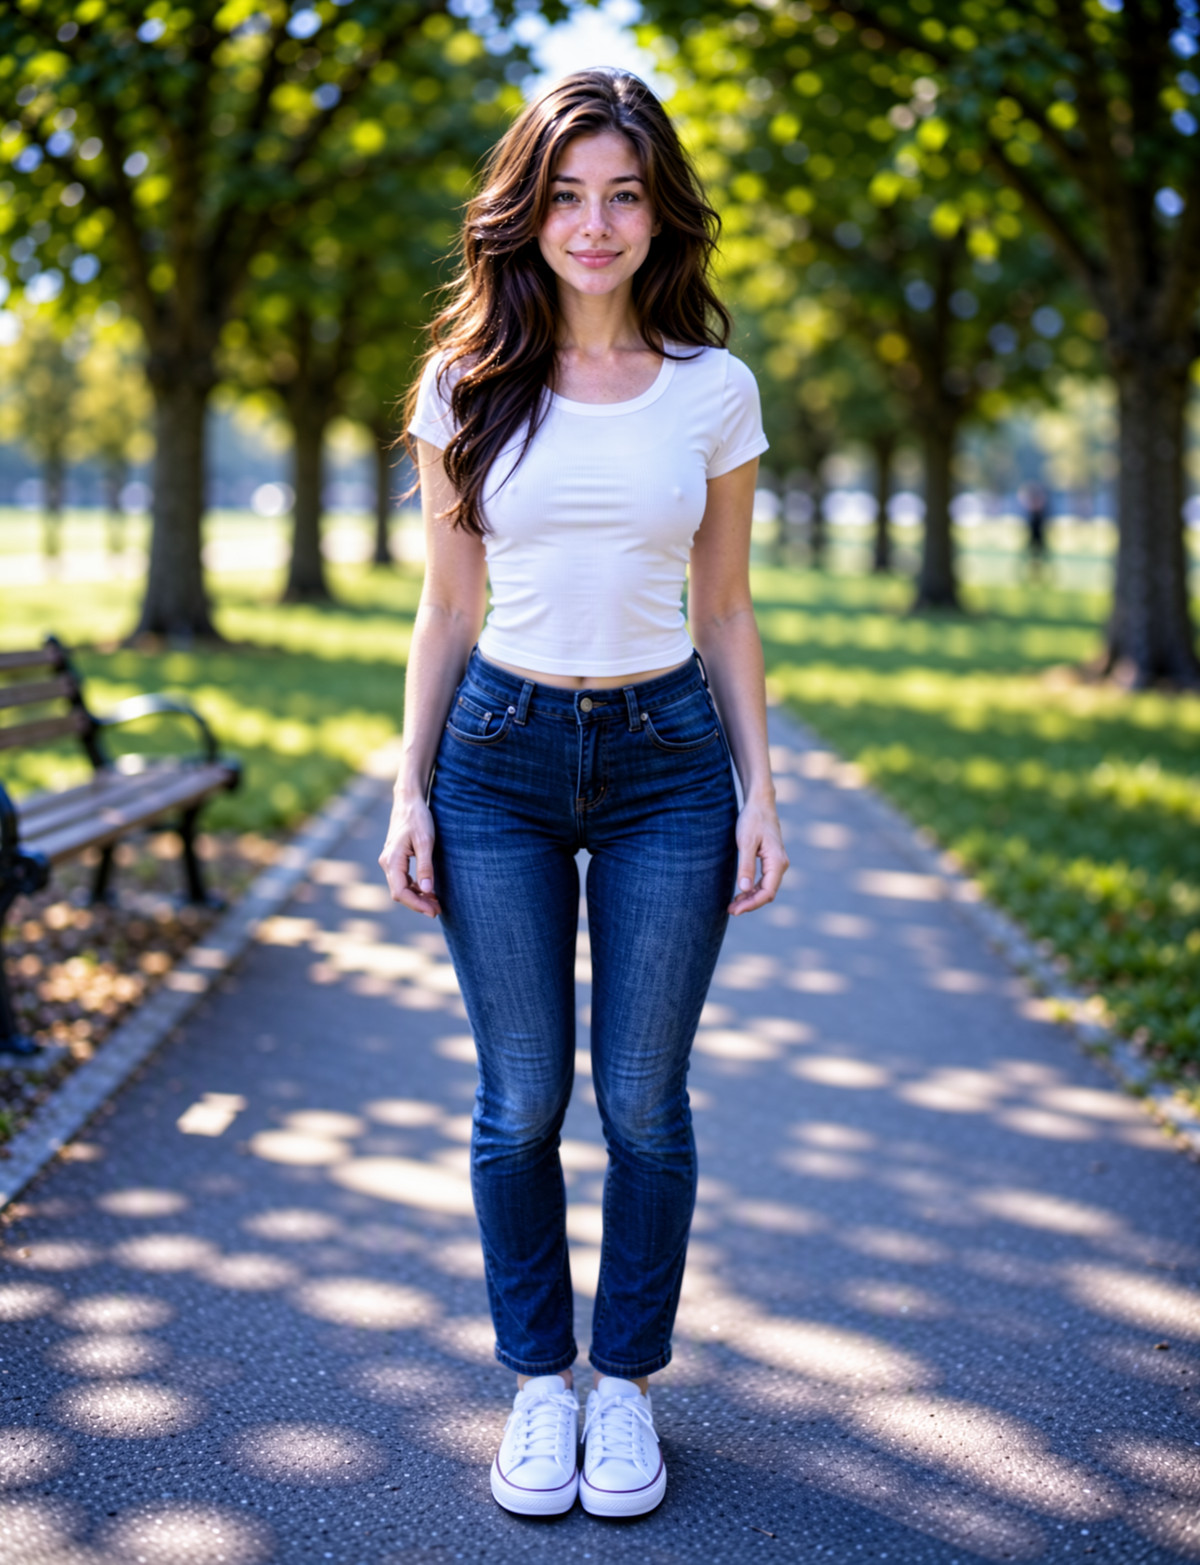
- xKlara · MOSS Image — LoRA: LoRA nhân vật xKlara (nữ giới do AI tạo ra, tóc nâu sẫm, đường nét khuôn mặt dịu dàng), phiên bản MOSS được huấn luyện trên cùng một bộ dữ liệu với phiên bản Krea 2 trên cùng trang.
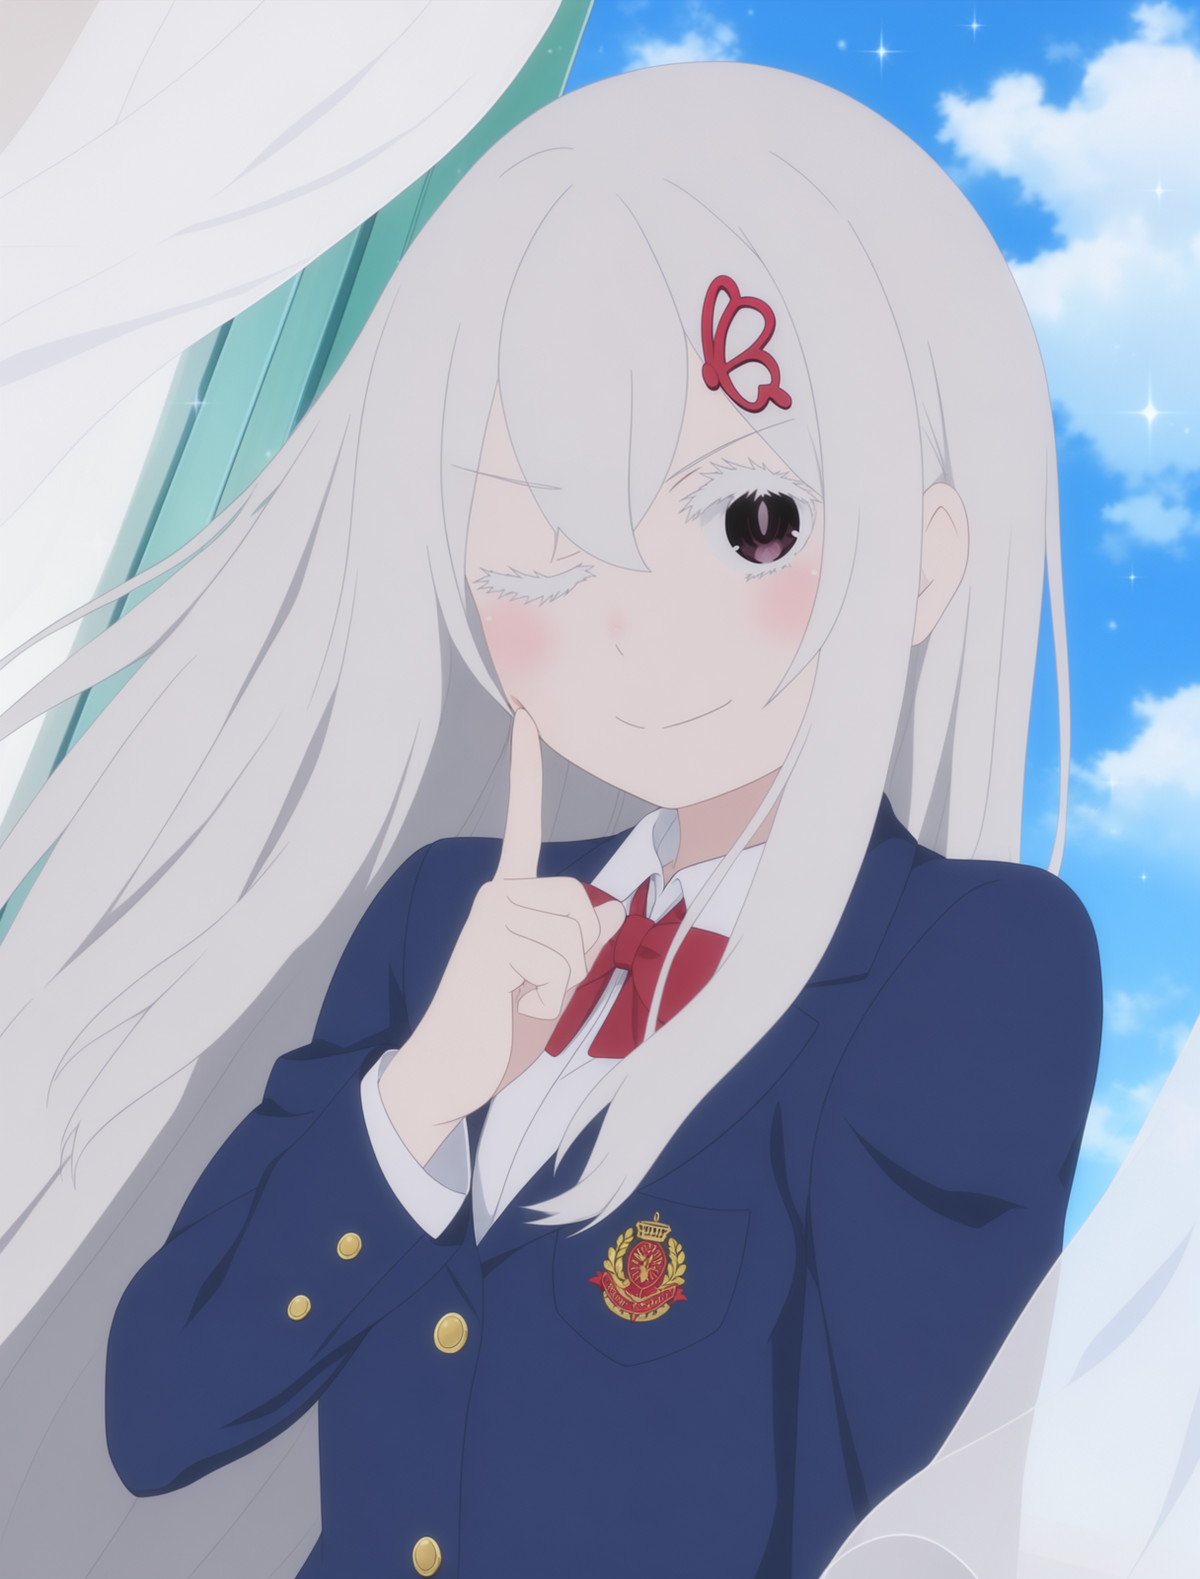
- Echidna - MOSS · Echidna — LoRA: LoRA nhân vật Echidna từ 《Re:Zero - Starting Life in Another World》, tác giả đã cung cấp một đoạn mô tả chi tiết về ngoại hình và trang phục từng món.
- Frankie NordhavenLove · MossImage — LoRA: LoRA nhân vật nữ Bắc Âu hư cấu, dùng để cố định một khuôn mặt duy nhất khi tạo ảnh.
- Phong cách jun navigavi · v1.0 — LoRA: LoRA minh họa anime bắt chước phong cách vẽ của họa sĩ jun navigavi.
- LoRA phong cách bởi Ryia | 2 · v1.1 — LoRA: LoRA phong cách anime được huấn luyện trên các hình ảnh do tác giả tạo ra bằng NAI v5, phiên bản này được huấn luyện lại trên Moss-heal.
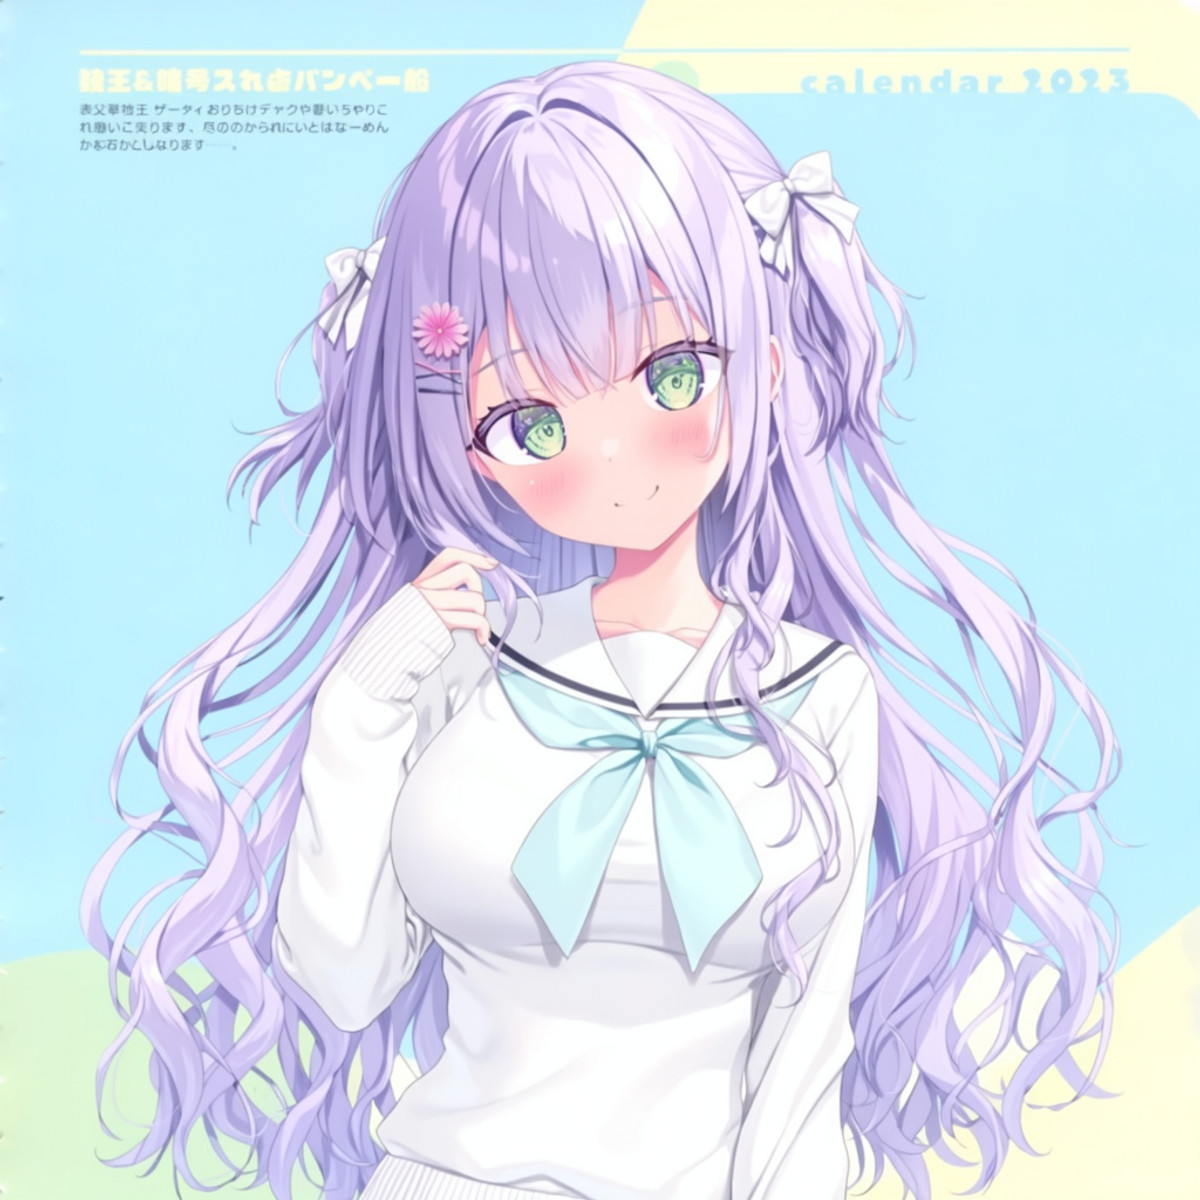
- Liangwu/Ryohka/Suzuya · Runs_1_st9000 — LoRA: LoRA nhân vật MOSS-Image-SFT cho nhân vật anime “Ryohka / Suzuya”, đây là bản lưu cuối cùng ở bước thứ 9000 của cùng một quá trình huấn luyện; ví dụ là một thiếu nữ tóc dài xoăn màu tím, mắt xanh lá, mặc đồng phục thủy thủ màu trắng.
- ૮꒰ ˶• ༝ •˶꒱ა ♡ · v1 — LoRA: LoRA phong cách mà tác giả tự gọi là “hoạt hình cổ điển thập niên 2000”, hình ví dụ vuông.
- Phong cách YD · v1.1 — LoRA: Phiên bản thứ hai của LoRA phong cách có tên YD, thẻ mô hình chỉ chứa từ khóa kích hoạt.
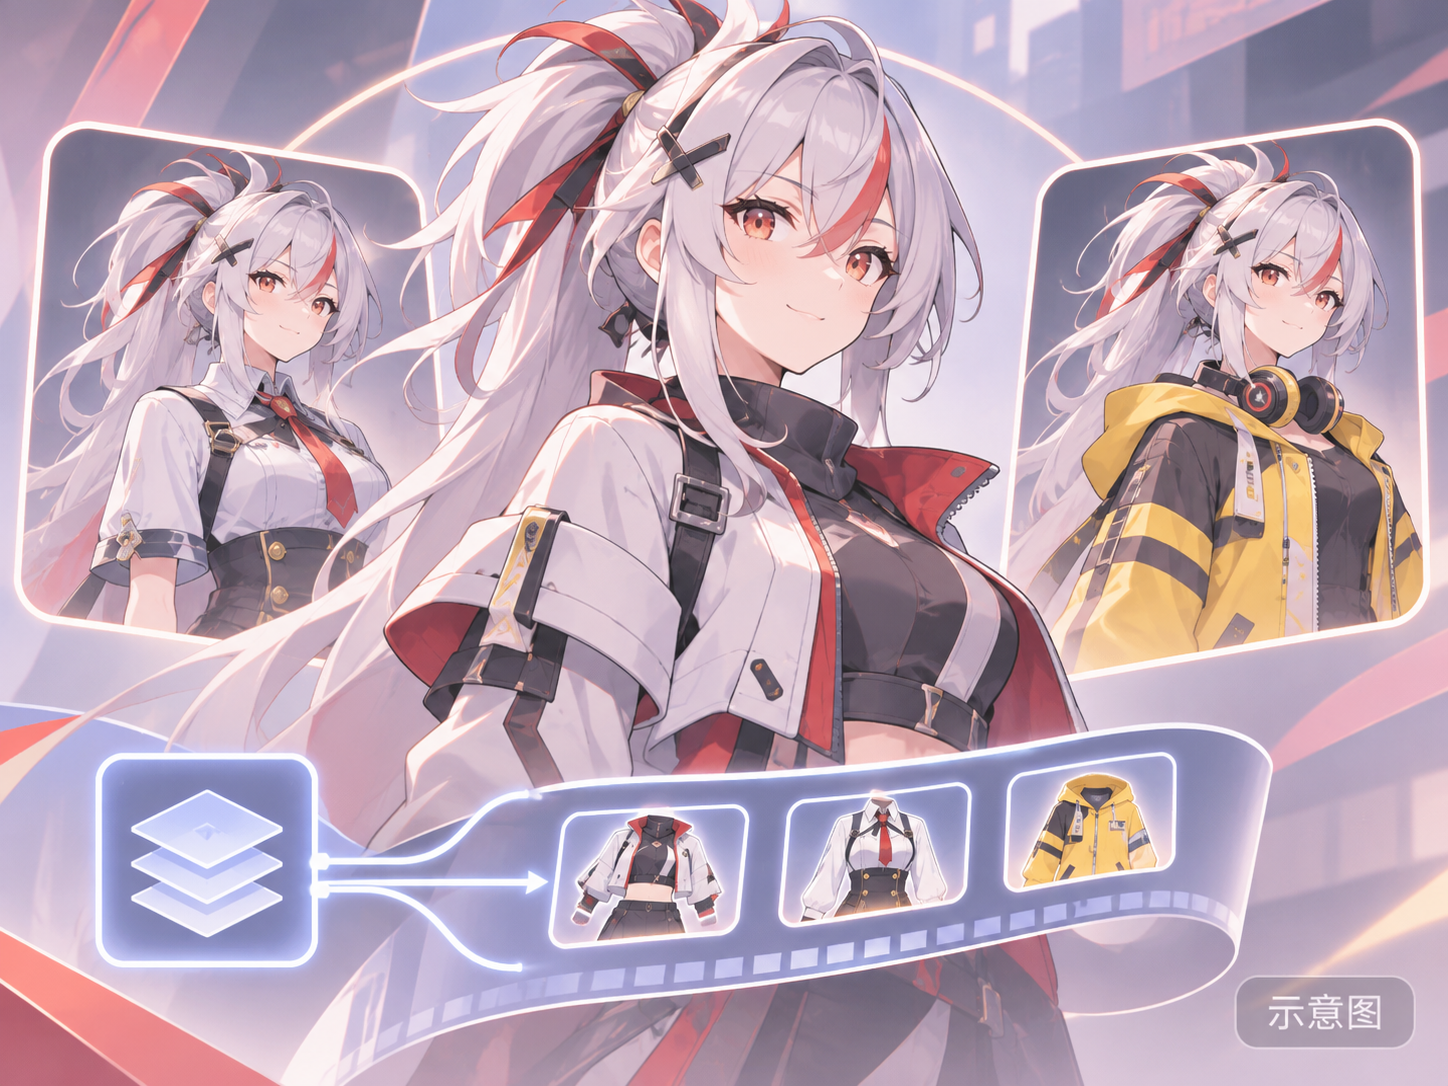
- Phoenix Reffaella フィオニー・レファエラ, 3 Trang phục — Zenless Zone Zero ゼンレスゾーンゼロ [Anima+Illustrious+MOSS] · v1.0 MOSS Image — LoRA: Phiên bản MOSS của LoRA nhân vật Phoenix từ mùa 3 của game 《Zenless Zone Zero》, một tệp chứa ba bộ trang phục.
Dữ liệu: API công khai của Civitai (mô hình cơ sở MOSS Image), cửa sổ thu thập từ 11-10 08:31 đến 11-10 21:01 (giờ Bắc Kinh). Lý do đề xuất đã được biên tập viên xem xét; số lượt tải xuống chỉ phản ánh mức độ quan tâm.