貞貞のAIレーダー · MiniMax H3 · 2026-11-02 朝刊
今号の 22 件の新バージョン:強くおすすめ 0 · おすすめ 1 · 注目すべき 9 · 収録のみ 12
編集者によるコメント 今号では 22 件の H3 新バージョンをレビューしました。おすすめは H3 キャラクターシートデザイナー v1.3:1枚のキャラクター画像から H3 の参照画像条件を用いて最大 13 ビューの静的設定画を生成するオープンソースの ComfyUI ノードで、このバージョンではテンプレートが Pika Ref2VA LoRA に変更され、手足を右側に配置する 7 ビュープリセットが追加され、評価が B から A に引き上げられました。キャラクター入れ替えワークフロー v2.0 は、二次リファイン、水彩風 LoRA トリガーワード、強度調整が追加されましたが有料であり、評価は B のままです。AIKSK は一度に 15 個のワークフローを公開しましたが、カードには構造の説明のみがあり、作者は推論検証を行っていないと述べており、目に見えるサンプルはほぼありません。Sigma / OpenVDN / SelfLift の3セットの 4K 生成、音声駆動デジタルヒューマンと写真からの音声付き人物、動画キャラクター入れ替え標準版、動画部分再描画は B と判定され、768P 重複版、タイトルとフローが一致しない「顔修正・テカリ除去」、汎用 SeedVR2 アップスケール、説明が前バージョンをそのまま写した Hero Shot v2 などは C に格下げされました。Anima 統合ワークフローの「MiniMax 版」カードには H3 に関する説明が一切なく、評価は A から C に格下げされました。
おすすめ(1)
【A】H3 Character Sheet Designer for ComfyUI -Image Generation · v1.3
ワークフロー · バージョン更新 · 作者 ukr8b3g201 · 公開 11-01 22:18 · ダウンロード 160
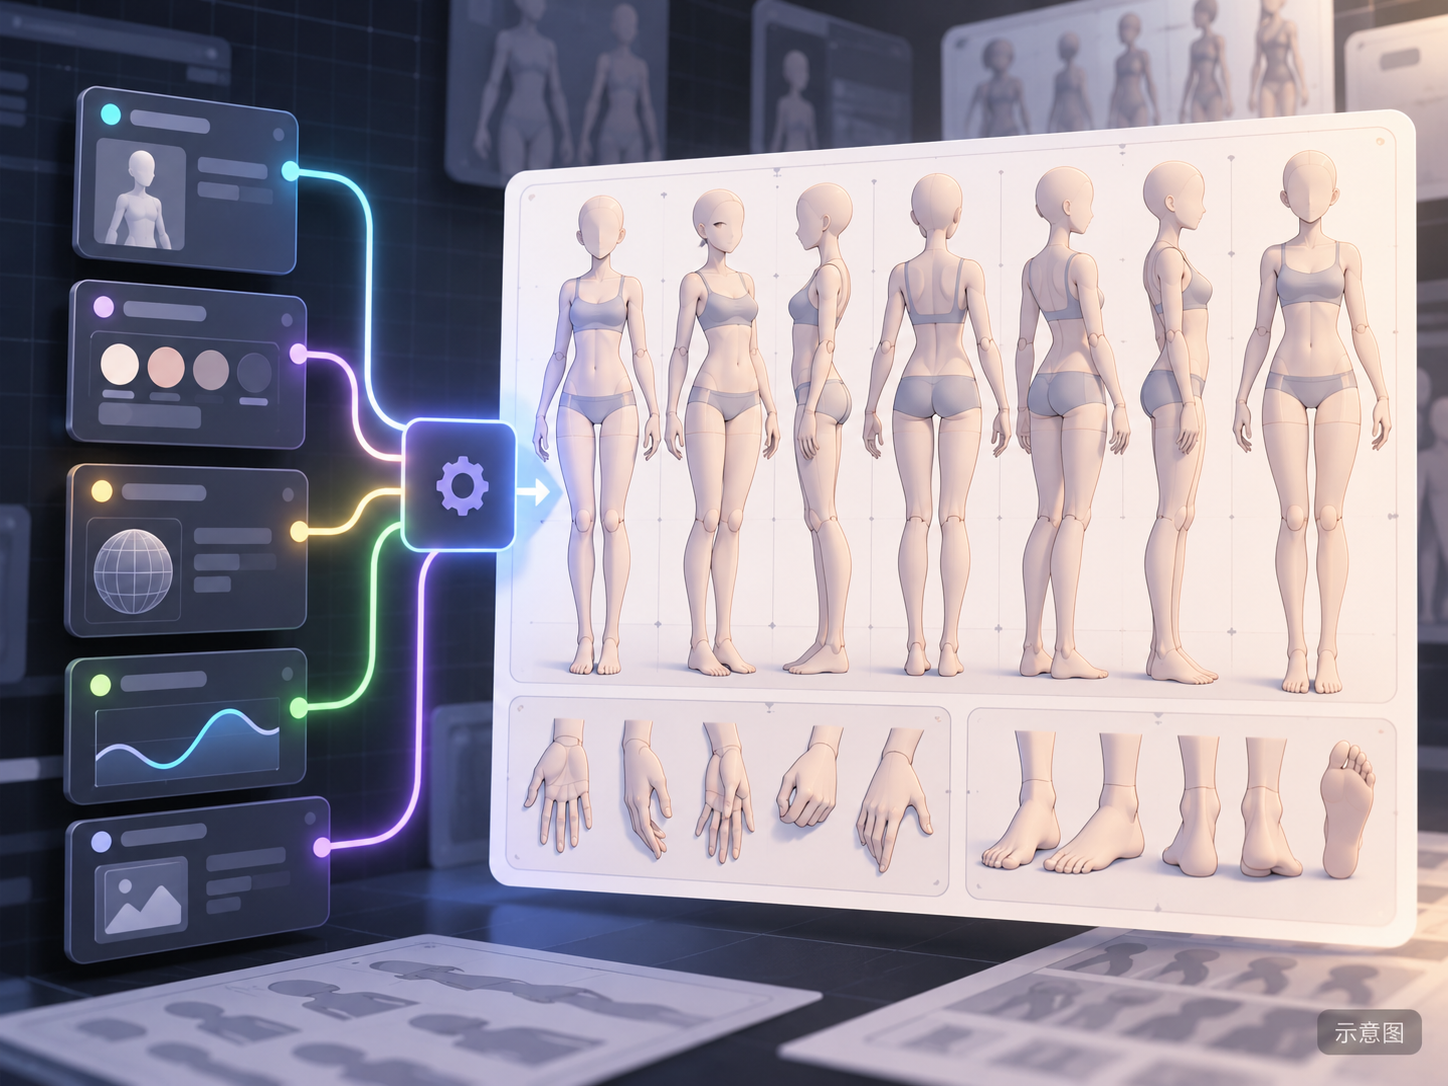
ComfyUI カスタムノードとワークフローの組み合わせ:1枚のキャラクター画像(同じキャラクターの参照画像をさらに3枚追加可能)を入力し、H3 標準の参照画像条件を用いて多視点キャラクター設定画(頭部、全身、前後の服装、手、靴、最大 13 ビュー)を生成します。専用の設定画 LoRA は不要です。
B から A に引き上げ:ノードはオープンソースで、インストール手順とモデルリストが完全に記載されており、v1.3 の変更点は具体的で、制限事項も率直に記述されています。減点理由は、このバージョンに目に見えるサンプルがないことです。
画像
おすすめ理由
- バージョン更新:更新説明欄は空ですが、モデルカードには v1.3 の変更点が記載されています。テンプレートが Pika H3 Flex Ref2VA LoRA に変更されました。MOSS 風プリセットが追加され、その中の 7 ビュー版では手と足を右側に配置します。ガイドラインのレイアウトはオンとオフで共通し、余白が小さく、全身フレームが大きくなりました。インターフェースがよりシンプルになり、服装と 13 ビューのプロンプトが小幅に調整されました
- キャラクター設定画を作成し、それを H3 の参照画像から動画生成に利用してキャラクターの一貫性を保つニーズに対応しています。作者はモデルカードと GitHub README で、v1.3 は小規模な変更であり、服装と全 13 ビューで大幅な改善は証明されておらず、人体の欠陥やビューの欠落が残る可能性があることを率直に明記しています
- 無料で、コードは GitHub でオープンソース化されており、ライセンスは販売を許可しています。このバージョンのダウンロード数は 160 回、モデル全体の累計ダウンロード数は 2707 回、いいね数は 111 件です(注目度を示すのみ)
使い方
- ComfyUI/custom_nodes 目录下で作者の H3-Character-Sheet-Designer リポジトリを git clone し、再起動後に h3CharacterSheetDesigner_v13.zip 内の v1.3 ワークフローを読み込みます(パッケージには v1.2.2 ワークフローも含まれています)。テンプレートには rgthree-comfy も必要です
- モデルはカードの表に従って配置します。拡散モデルには DaSiWa Hybrid V4 INT8 または公式 H3 Ref2VA INT8 を使用し、テキストエンコーダーには H3 Qwen3-VL INT8(または NVFP4 AWQ)を使用し、動画 VAE には INT8 または FP16 を使用します。Pika Ref2VA LoRA はオン、FL2VA LoRA はオフにします。CLIP ローダーのタイプは minimax を選択します
- 必要なビューにチェックを入れ、出力サイズを調整し、服装などの詳細を記述するために英語の部位プロンプトを追加できます。作者はまず Use Layout Image をオフにし、構図のガイドが必要になった場合にオンにするよう推奨しています。サンプリングパラメータはテンプレート標準の設定を使用し、カードには個別に指定されていません
リスクと制限
- 作者は更新説明を書いておらず、v1.3 の変更点はモデルカードの本文に記載されています
- このバージョンには目に見えるサンプルがありません(2 件のセンシティブレベルは非表示)。GitHub README にはインターフェースのスクリーンショットのみがあり、本レビューでは完成した設定画を確認できませんでした
- 作者は自動サイズ調整によりレンダリング時間と VRAM 使用量が増加すると述べています。出力は静的な設定画であり、動画ではありません。本レビューでは実行していません
- カードの画像は AI 生成の概念図であり、モデルの実際の効果ではありません。作者は公開されたノーマルレベルのサンプルを持っていません
注目すべき(9)
【B】Minimax H3 IMG2IMG Character Swap Workflow · v2.0
ワークフロー · バージョン更新 · 作者 MrAzor · 公開 11-02 01:18 · ダウンロード 92
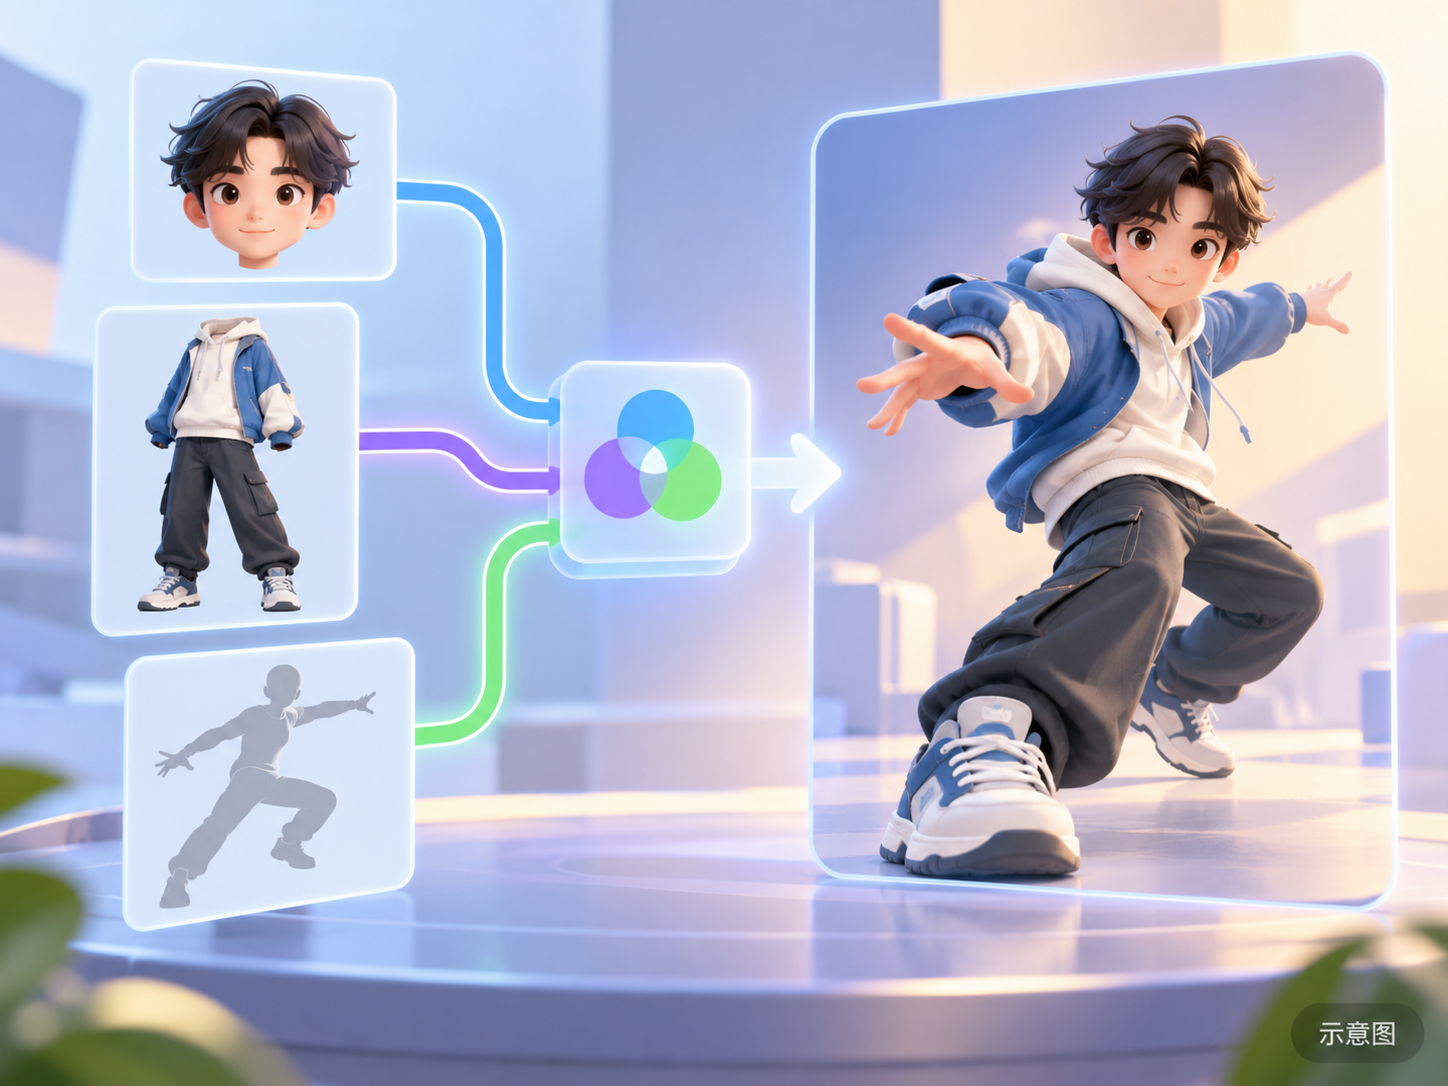
H3 と NRDX Character Swap LoRA を使用して「キャラクター入れ替え」を行う ComfyUI ワークフロー:頭部と身体の参照画像を合成してキャラクター参照を作成し、別のポーズ画像に基づいて静的画像を生成します。v2.0 では任意の二次リファインが追加されました。
画像
【B】Watercolor [Minimax / MOSS / Krea2 / SD]🎨 🖌️ 🖼️ · Minimax v1.0
LoRA · ポート · 作者 TeraWatt · 公開 11-02 06:36 · ダウンロード 2 · 有料
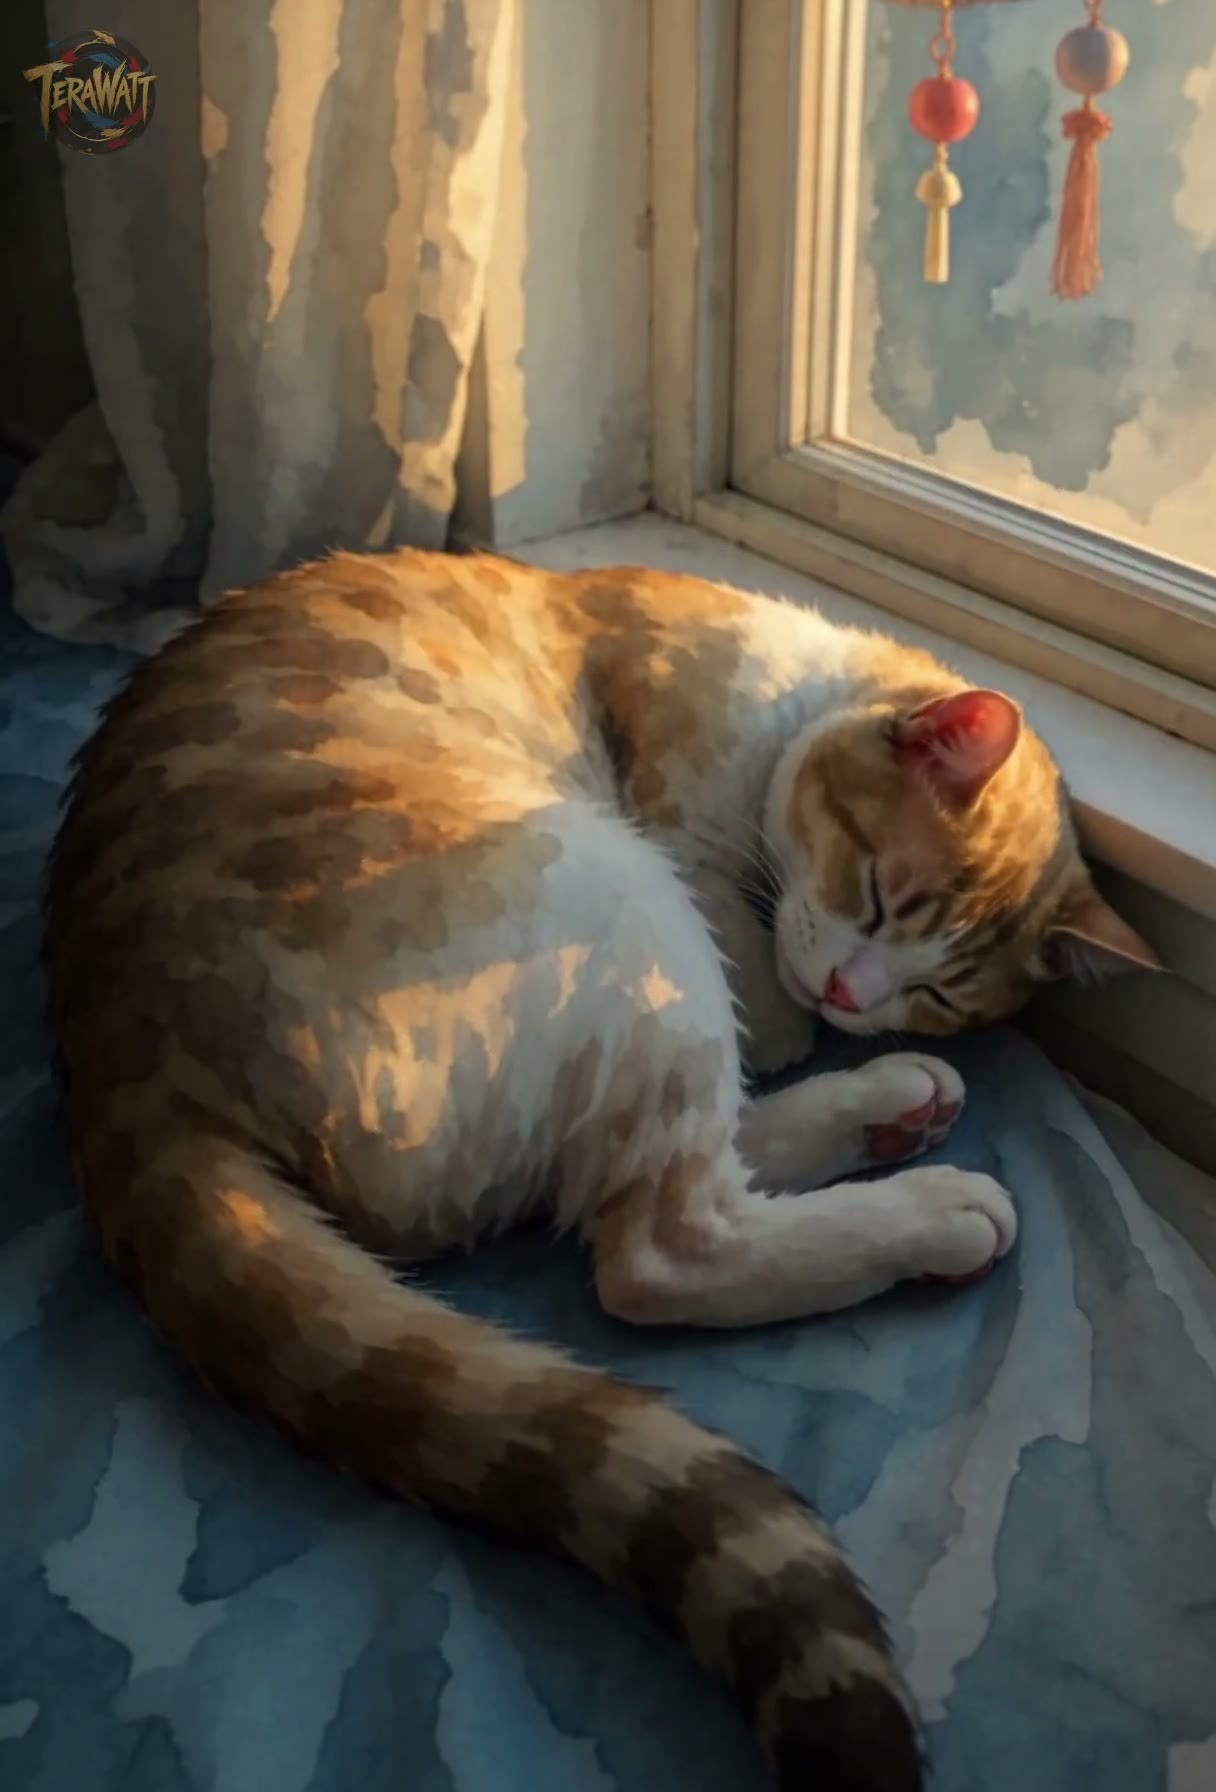
水彩画風 LoRA の H3 版:テキストから動画生成した映像を水彩画の質感に変換します。作者は、人物、風景、ペットなどの映像を同一シリーズに統一するために使用できると述べています。
画像
【B】MiniMax H3 Sigma Enhanced Dual-Pass Universal Video Generation 4K · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 04:39 · ダウンロード 33
AIKSK の H3 汎用動画生成ワークフロー(Sigma 強化デュアルパス · 4K 目標):1枚の参照画像から動画を生成し、まず低解像度でサンプリングし、学習型潜在空間で 2 倍にアップスケールしてリファインします。デコード後、SeedVR2 で 2160 にアップスケールし、さらに 2 倍のフレーム補間を行います。
画像
【B】MiniMax H3 OpenVDN DMD8 Universal Video Generation 4K · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 04:38 · ダウンロード 19
AIKSK の H3 汎用動画ワークフロー(OpenVDN DMD8 · 4K 目標):最初のフレームと最後のフレームを使用して動画を生成し、サンプリングは OpenVDN の vdn-minimax-h3 蒸留ソリューション(stage_dmd_8nfe)に任されます。デコード後、SeedVR2 で 2160 にアップスケールし、さらに 3840×2160 にスケールダウンして 2 倍のフレーム補間を行います。
画像
【B】MiniMax H3 SelfLift Universal Video Generation 4K · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 04:39 · ダウンロード 22
AIKSK の H3 汎用動画ワークフロー(SelfLift · 4K 目標):1枚の参照画像から動画を生成し、SelfLift ノード内部でまず低解像度で生成し、学習型潜在空間でアップスケールしてリファインします。その後、SeedVR2 で 2160 にアップスケールし、3840×2160 にスケールダウンして 2 倍のフレーム補間を行います。
画像
【B】10Eros Beta5 SelfLift Audio Digital Human Fine-tuning Workflow · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 04:23 · ダウンロード 21
ユーザーが提供した音声で H3 デジタルヒューマン動画を駆動するワークフロー:2枚の画像でそれぞれキャラクターと環境/構図を指定し、ソース音声の一部を切り出してエンコードし、参照条件に組み込み、SelfLift デュアルパスサンプリングで生成します。完成動画には元の音声が直接付けられます。
画像
【B】MiniMax H3 ControlNet Union Local Repaint Workflow · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 01:03 · ダウンロード 28
AIKSK の H3 動画部分再描画ワークフロー:SeC を使用してソース動画内の修正対象領域を分割し、拡張されたマスクとソース動画を一緒に Fun ControlNet Union に送り込み、マスク領域のみを再描画します。
画像
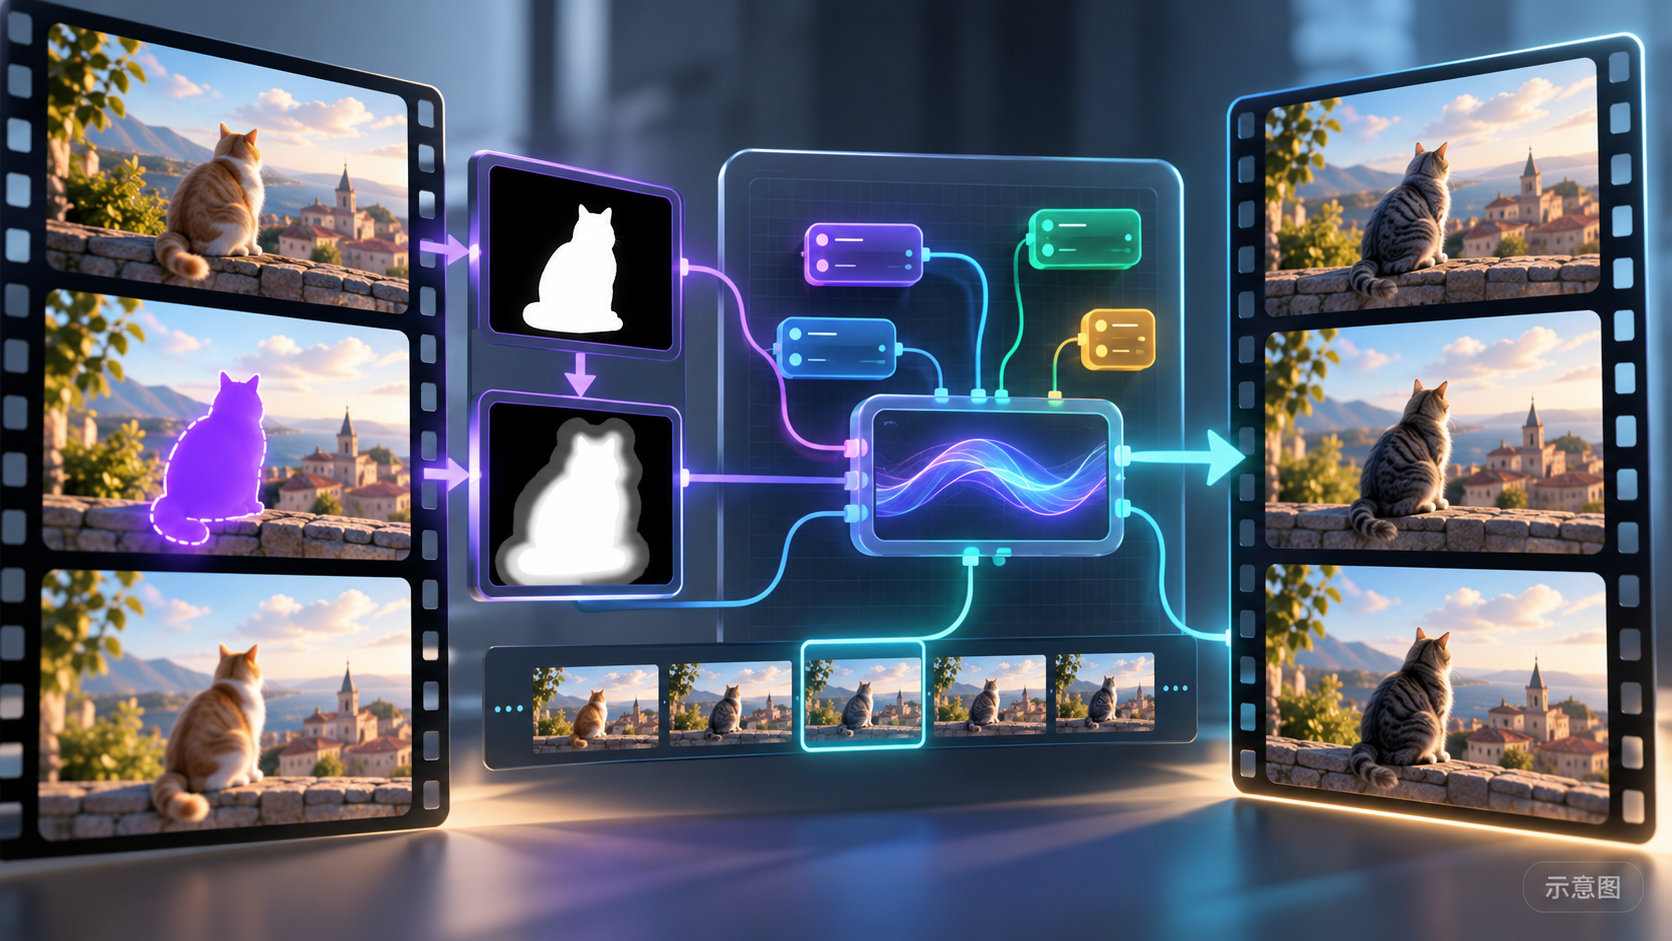
【B】MiniMax H3 Role Swap Reference Edit — Standard Version · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 01:57 · ダウンロード 33
AIKSK の H3 動画キャラクター入れ替えワークフロー「標準版」:SeC でソース動画の人物を分割し、RGB と深度を混合して参照を作成し、外見参照画像に基づいてキャラクターを再描画します。同時にソース動画の音声をエンコードして注入し、元の音声を保持します。
画像
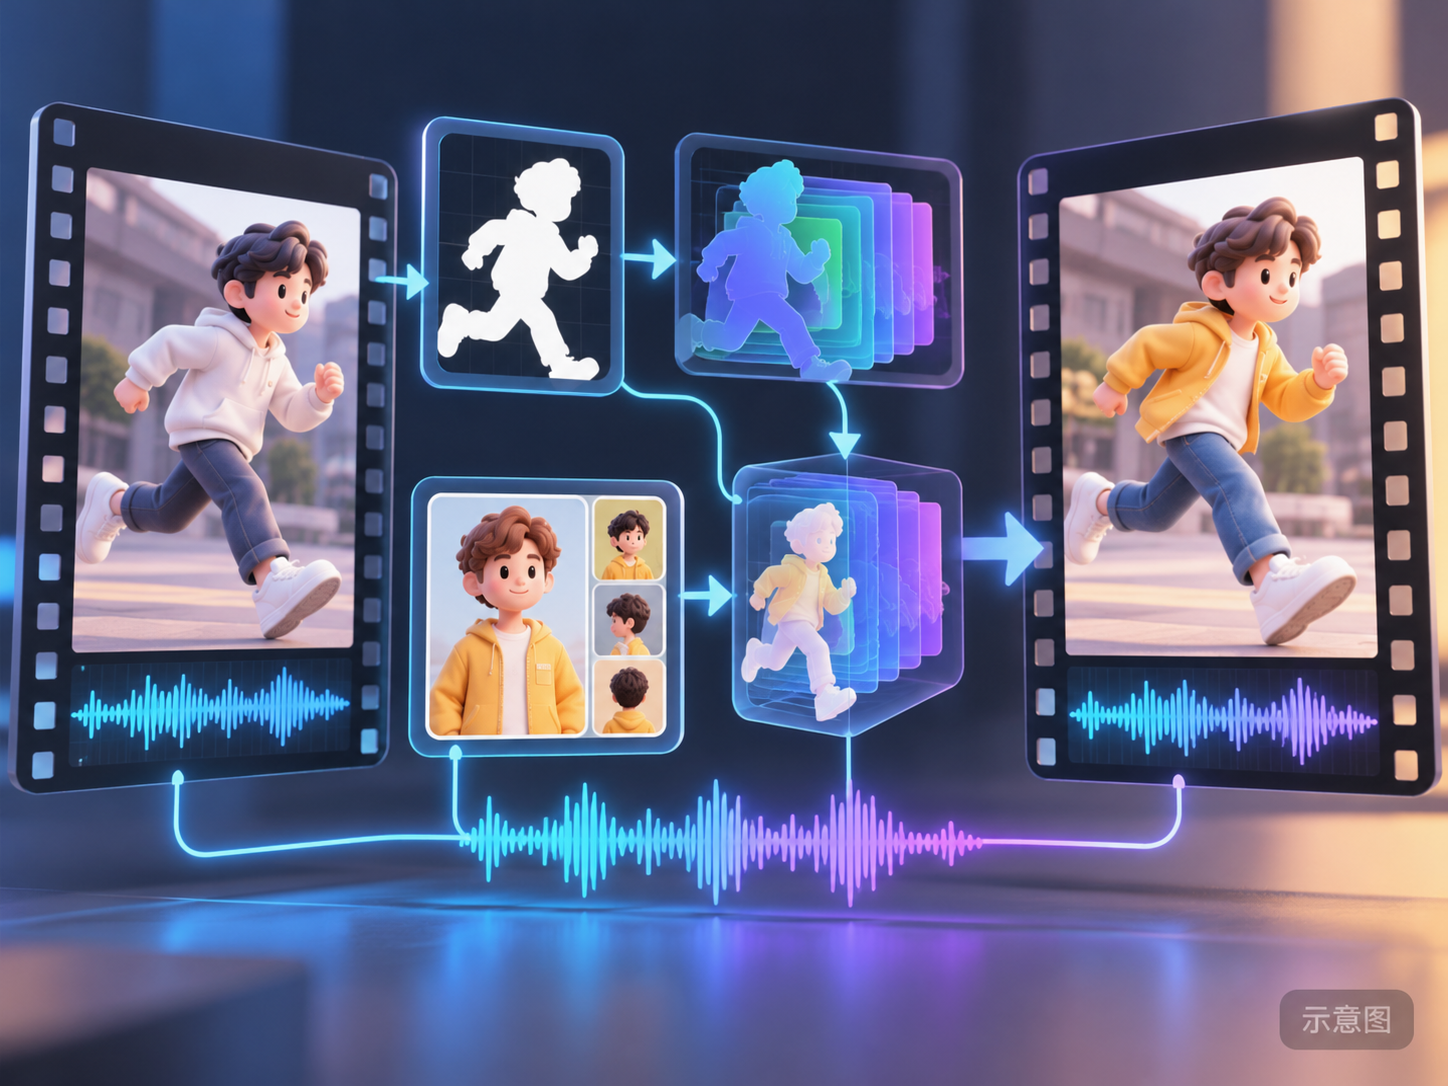
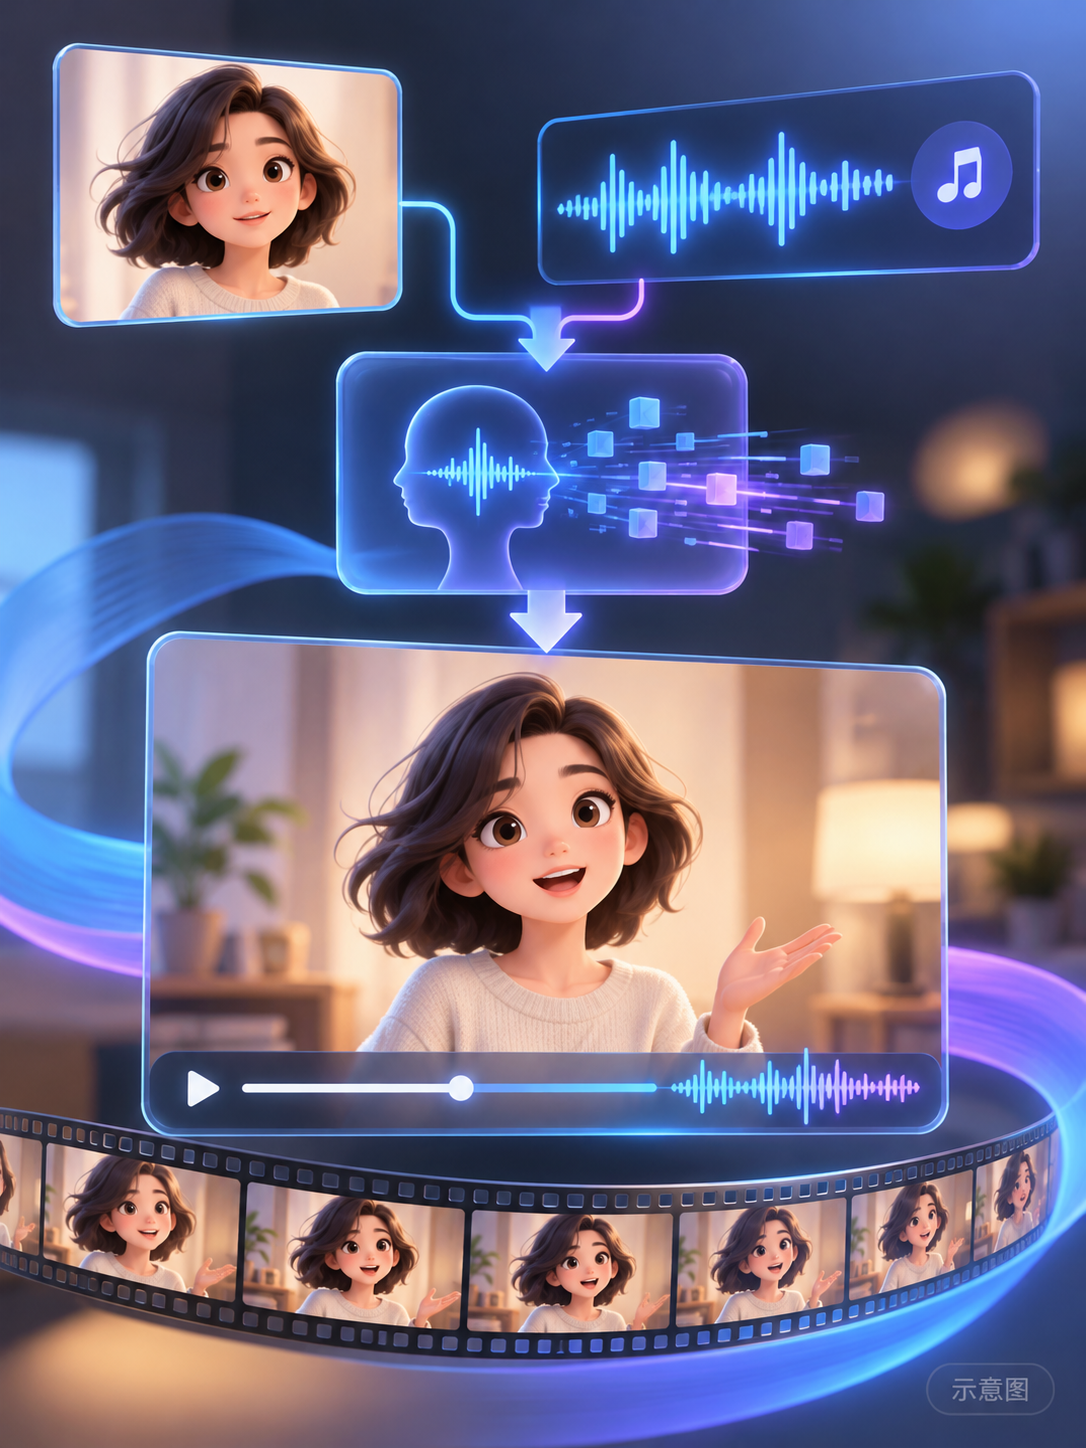
【B】MiniMax H3 General Video Generation with Audio-Driven Avatar (VDN 12-Step) · v1.0
ワークフロー · 新モデル · 作者 AIKSK · 公開 11-02 01:02 · ダウンロード 27
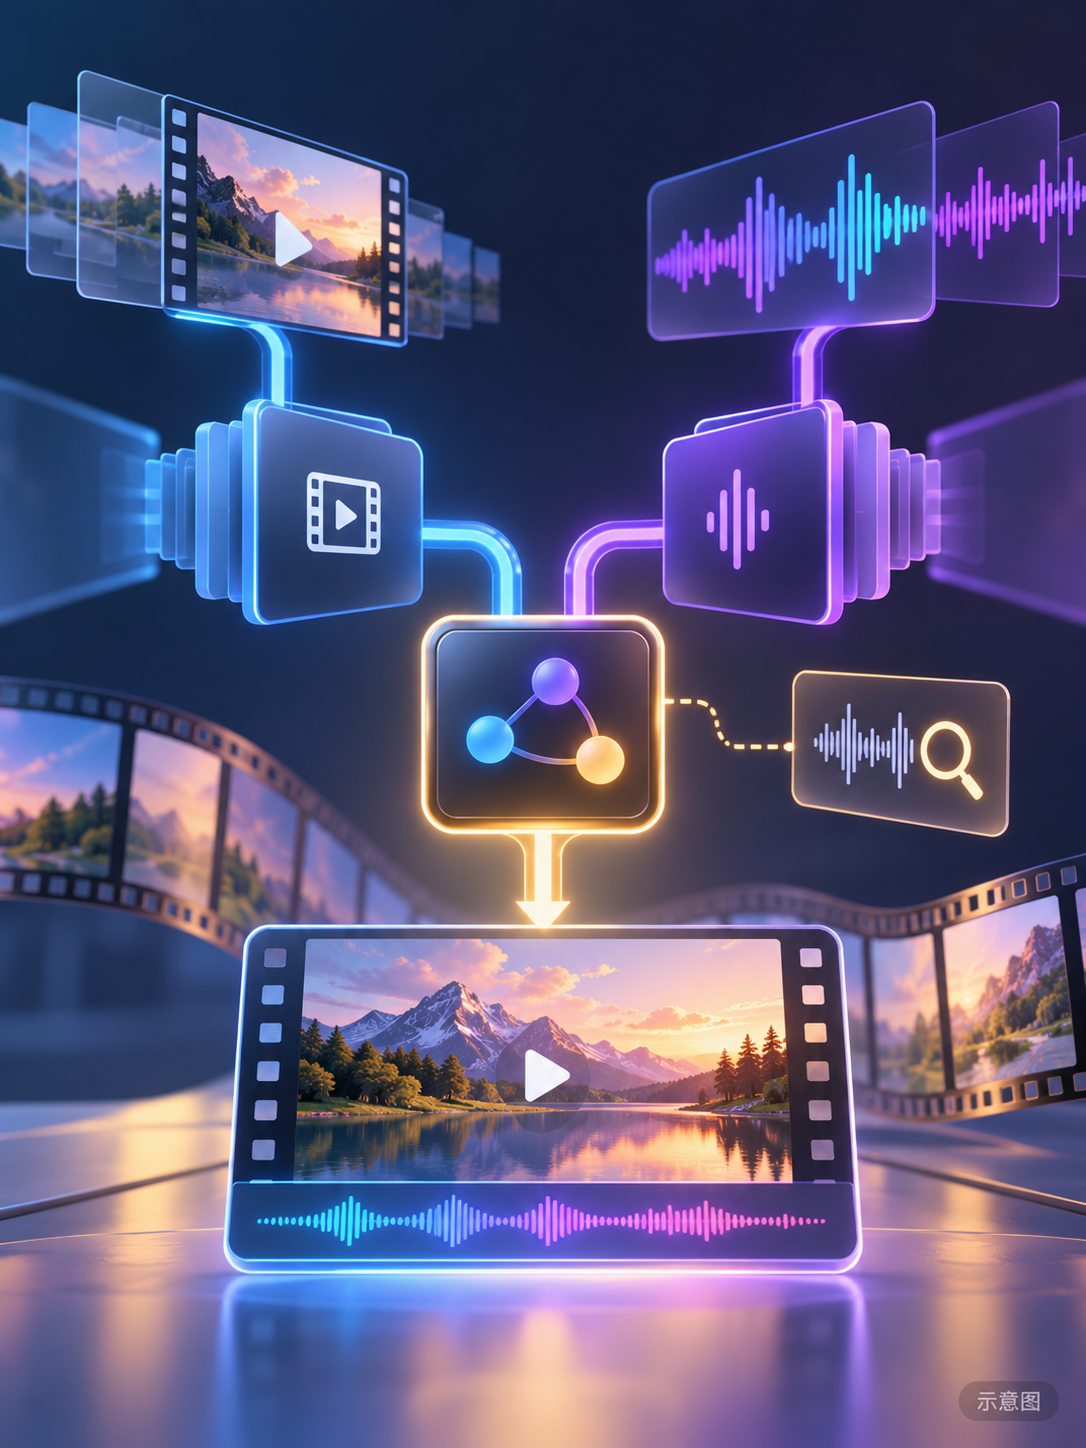
AIKSK の H3 音声駆動キャラクターワークフロー:参考画像1枚とアップロードした音声1本を使用し、音声からボーカルを分離して音声潜在変数としてエンコードし、生成に注入します。出力時には選択した元の音声を再適用します。
図版
収録のみ(12)
- All in one Anima Made Easy Brain Edition: Complete ComfyUI Workflow with Wan Video or Minimax H3. Or Both! · v4.0 MiniMax edition — ワークフロー:Anima による画像生成を主軸とした ComfyUI の統合ワークフロー(スケッチから高解像度化、顔・手の修正、アップスケール、部分再描画、4人分のプロンプト分割、Wan 2.2 画像から動画へ)。このバージョンは「MiniMax edition」と名付けられていますが、モデルカードには H3 部分の接続方法が記載されていません。
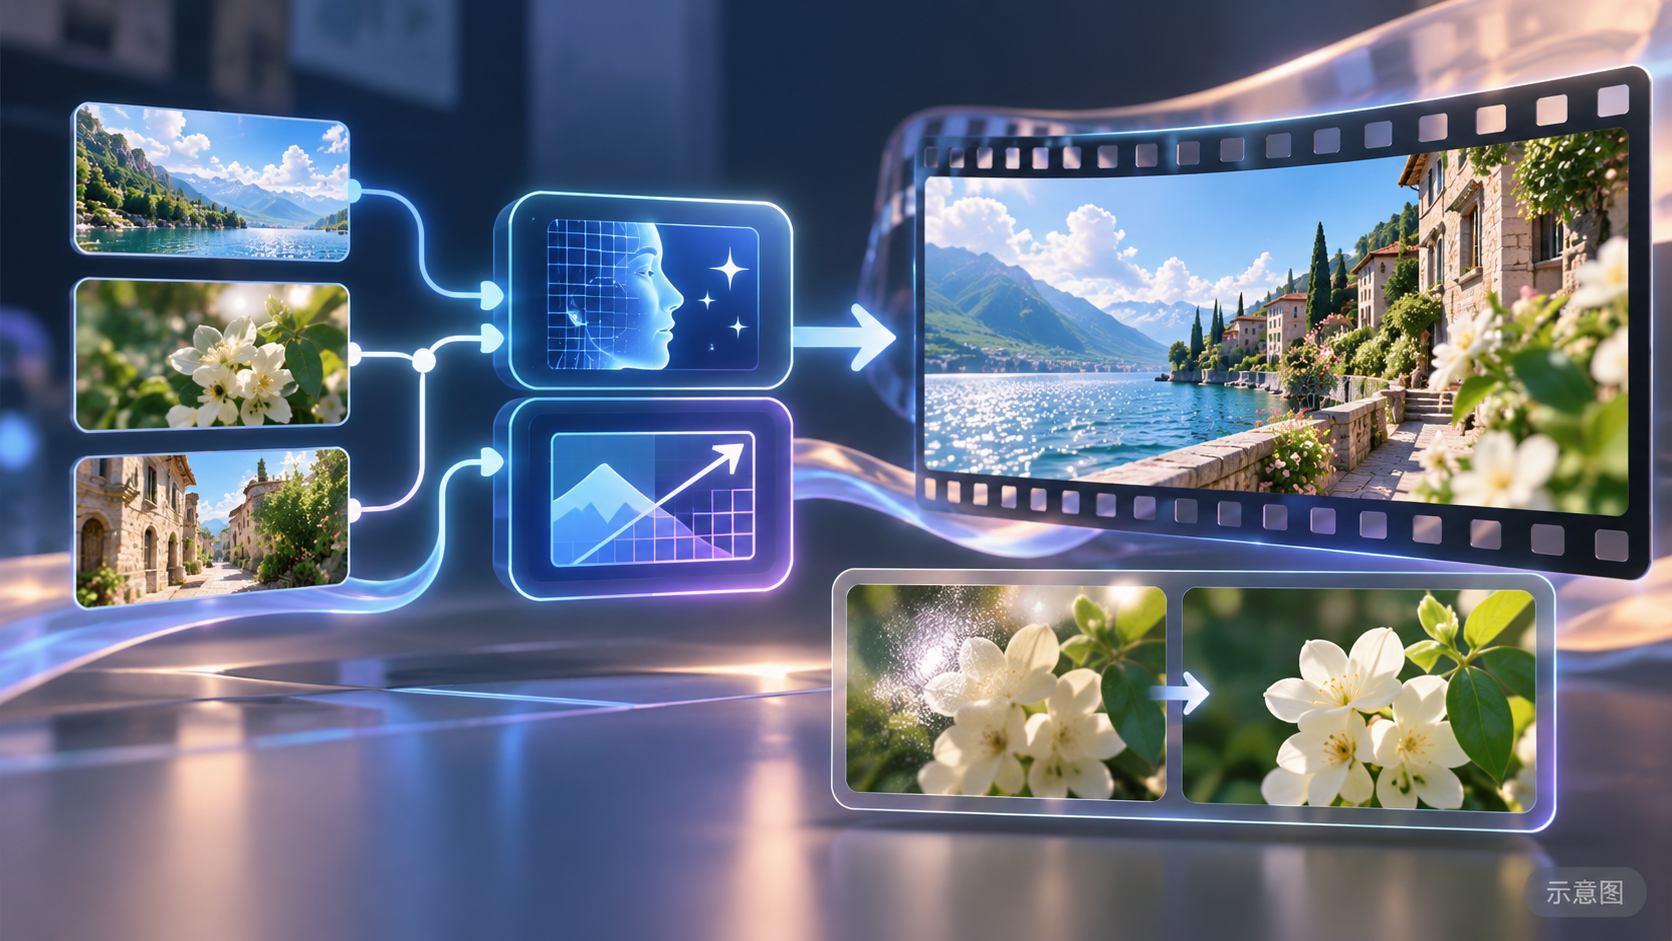
- 10Eros Beta5 + FL2VA/Ref2VA Face Touch-up and Oil Removal Second-Pass Workflow · v1.0 — ワークフロー:タイトルは「顔の修正、テカリ除去の二次精修」となっている 10Eros + H3 ワークフローですが、カード上の構造説明では、3枚の参考画像から動画を生成し、1.5 倍の学習型アップスケールを行う2段階の精修プロセスを示しており、専用の顔切り抜き貼り戻しフローはありません。
- Universal Video Upscaling SeedVR2 with DLSS Frame Interpolation · v1.0 — ワークフロー:ポストプロセッシングのみを行う動画ワークフロー:既存の動画を読み込み、SeedVR2(3B FP8)で 2160 にアップスケールし、さらに 2 倍のフレーム補間を行います。元の音声とフレームレートは保持されます。H3 による生成は含まれません。
- MiniMax H3 OpenVDN DMD8 Universal Video Generation 768P · v1.0 — ワークフロー:OpenVDN DMD8 の最初と最後のフレームワークフローの「768P」版:同じ VDN 蒸留サンプリングと 2 倍のフレーム補間を使用しますが、SeedVR2 によるアップスケールと 4K スケーリングの後処理セクションはありません。
- MiniMax H3 SelfLift Universal Video Generation 768P · v1.0 — ワークフロー:SelfLift 汎用動画ワークフローの「768P」版:同じ SelfLift 2段階サンプリング、4 ステップ高速化 LoRA、2 倍のフレーム補間を使用しますが、SeedVR2 と 4K スケーリングの後処理セクションはありません。
- MiniMax H3 Role Swap Reference Edit — Silent Version · v1.0 — ワークフロー:AIKSK の H3 動画キャラクター置き換えワークフローの「サイレント版」:SeC を使用してソース動画内の人物をセグメンテーションし、RGB と深度マップを混合して参考資料を作成、1枚の外観参考画像に基づいてキャラクターを再描画します。このバージョンでは、手動で音声を注入するノードがバイパスされています。
- MiniMax H3 VDN Hero Shot · v2 — 12NFE 40-node export — ワークフロー:製品展示のヒーローショットを作成するための H3 VDN 二次精修ワークフロー:ソース動画と参考画像を読み込み、まず 8-NFE の低解像度 VDN、学習型潜在空間アップスケール 2 倍、その後 4-NFE の精修を行い、約 1920×1088、24 fps の音声付き最終動画を出力します。
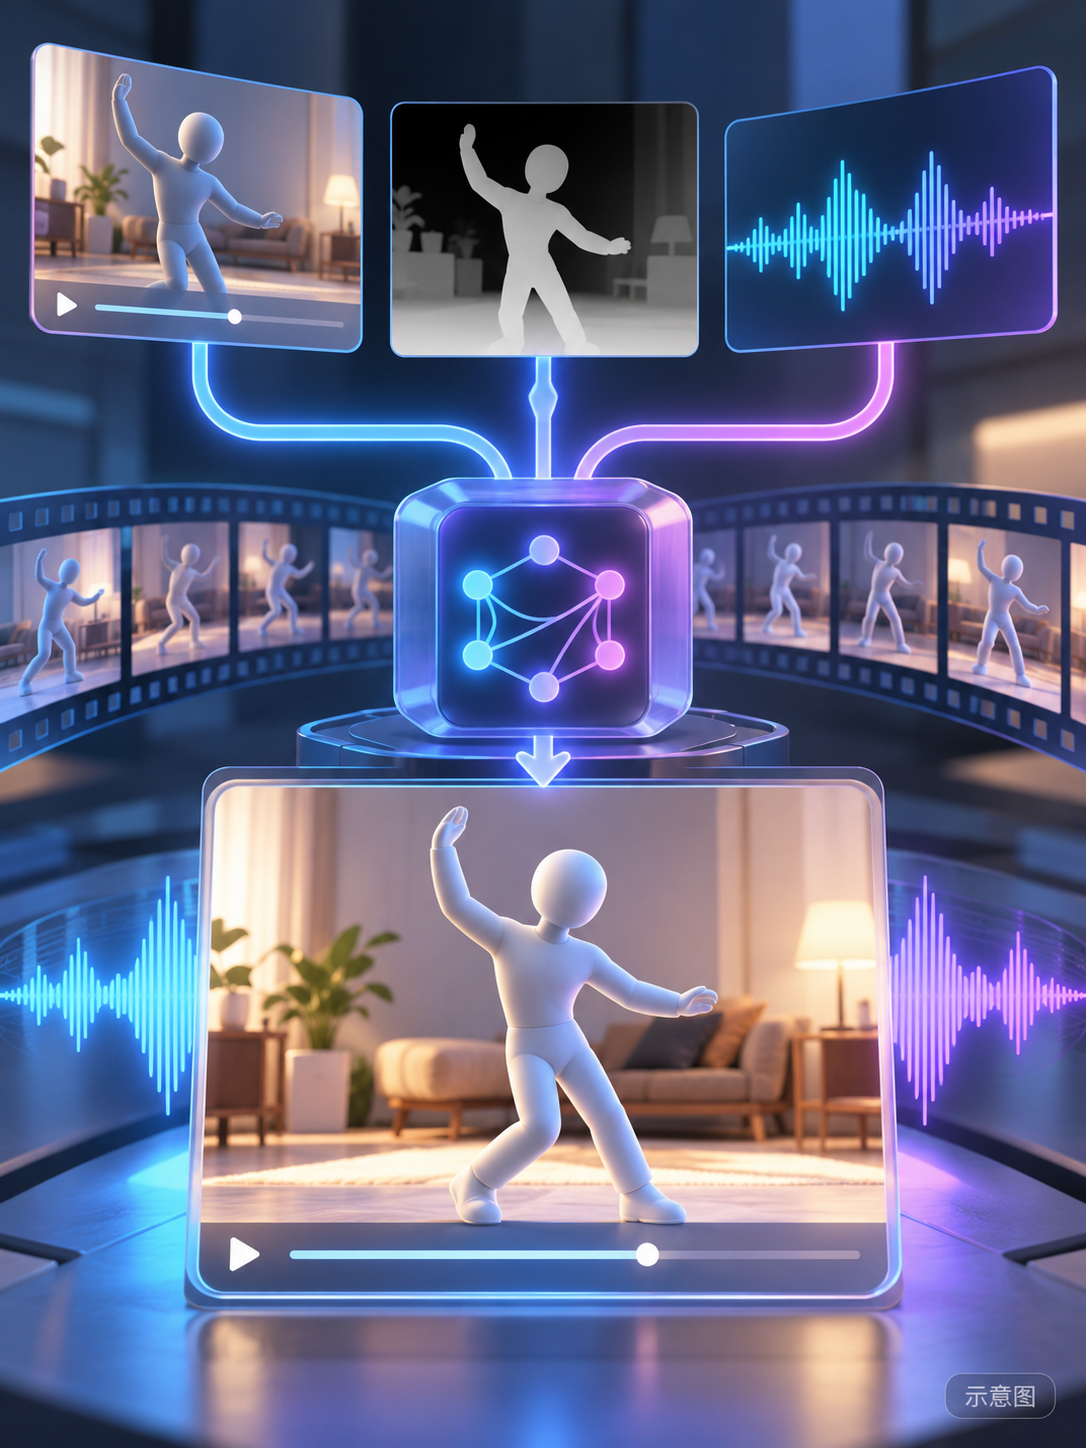
- MiniMax H3 ControlNet Union 2.0 Video Control with Audio Avatar (VDN 12-Step) · v1.0 — ワークフロー:AIKSK の H3 ワークフロー:ソース動画の深度マップ(DepthAnythingV2)で構造制御を行い、同時にボーカルを音声潜在変数としてエンコードして注入し、動きと音声に同期した動画を生成します。
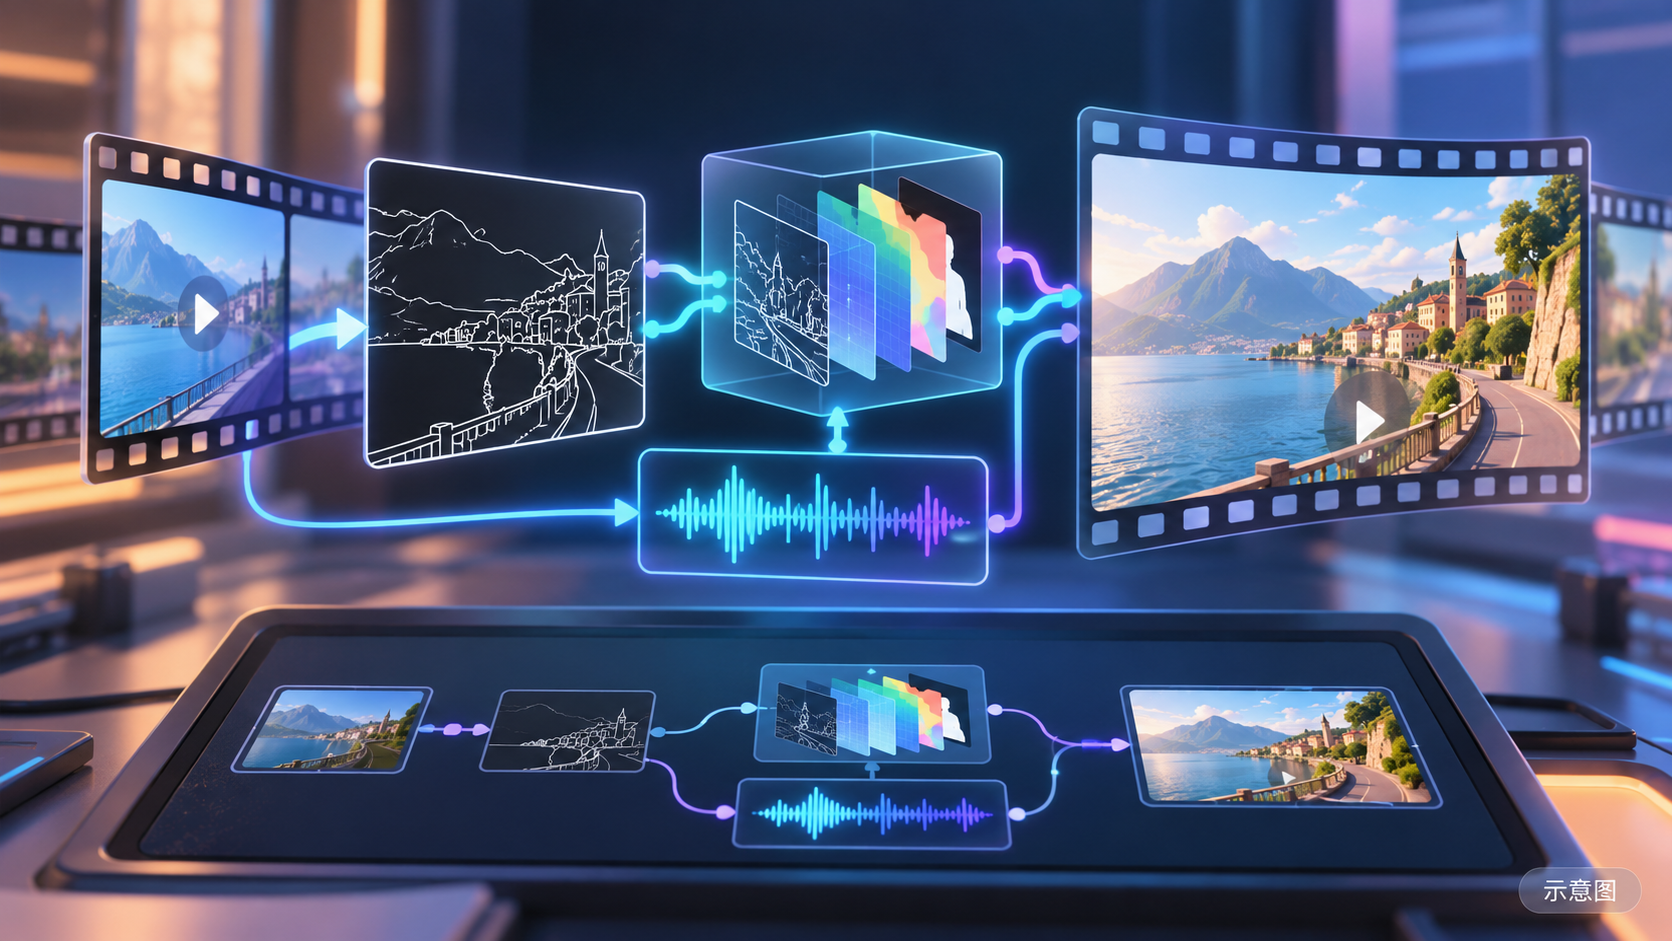
- MiniMax H3 ControlNet Union 2.0 Video Control and Inpaint (VDN 12-Step) · v1.0 — ワークフロー:AIKSK の H3 構造制御ワークフロー:ソース動画を Scribble 線画前処理した後、Fun ControlNet Union に送って画面構造を制御し、音声は H3 のネイティブ機能で生成します。
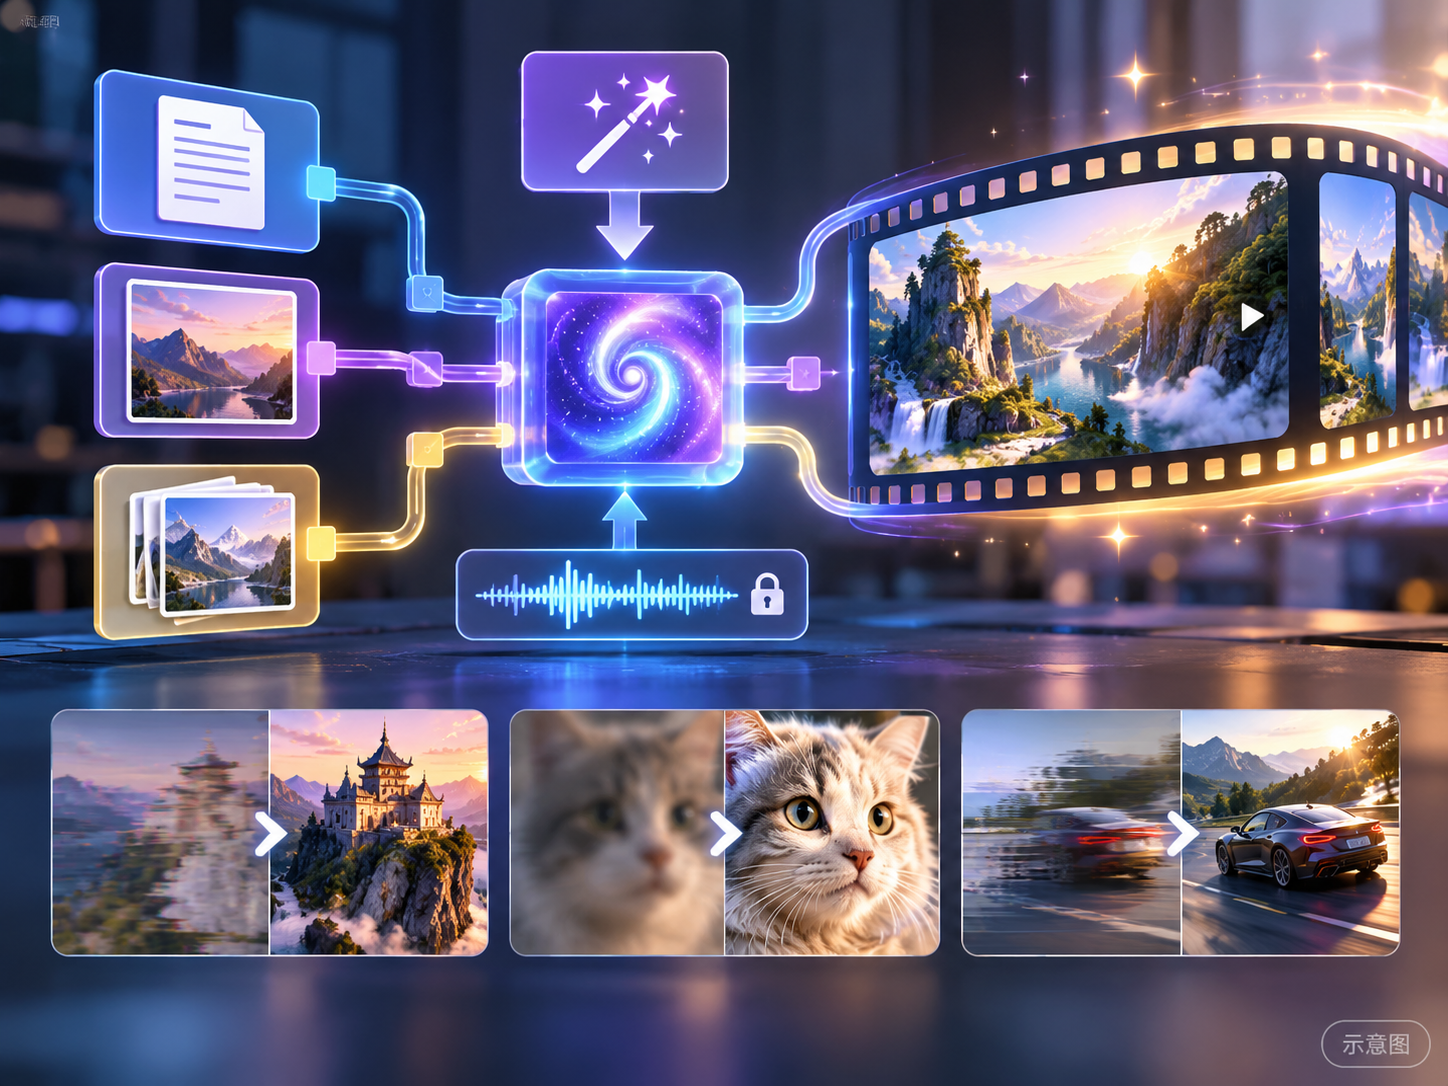
- MiniMax-H3 All-in-One Video Workflow V5 - Latent Chunked Second-Sampling Edition · v1.0 — ワークフロー:Astral星芒 の H3 汎用動画生成ワークフロー V5「latent 分割二次サンプリング版」:テキストから動画、画像から動画、参考画像から動画の3機能を統合、プロンプトの自動作成、音声の固定、作者によると遠景での顔の崩れ、顔のテカリ、高ダイナミックな残像の修正を主張しています。
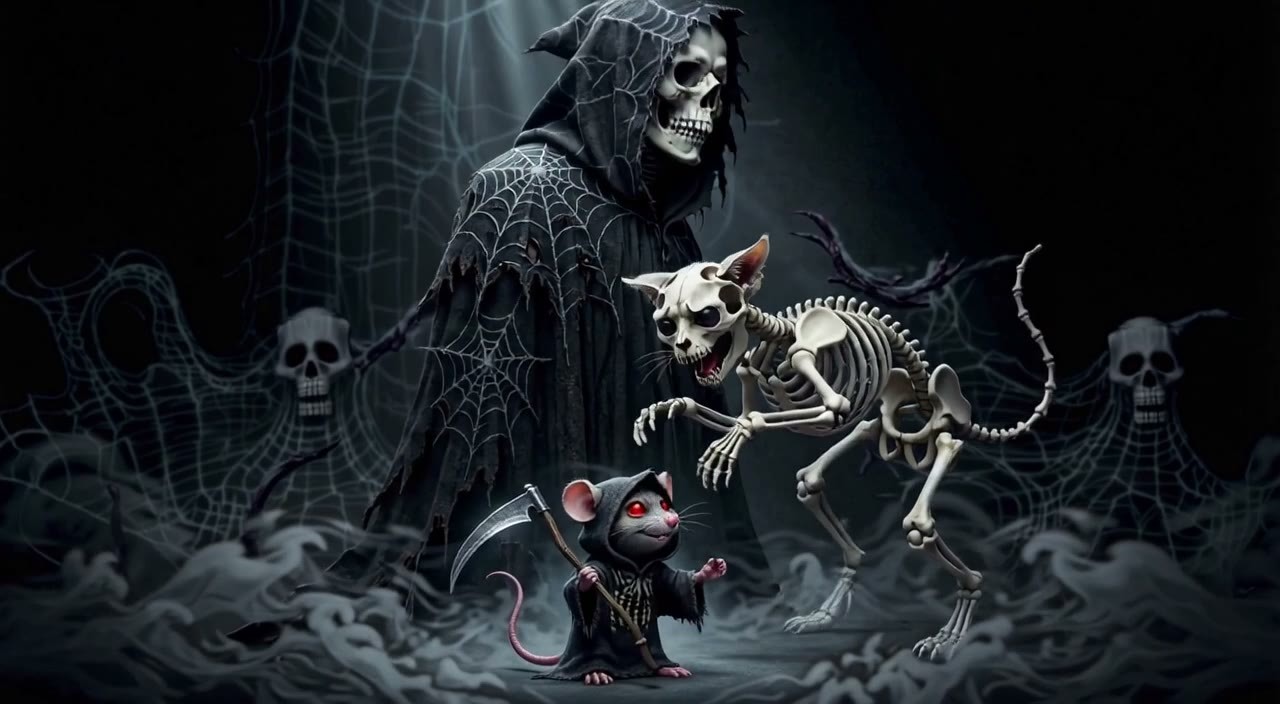
- LORU & RIBS: SALT FLAT SYMPHONY · v1 — LoRA:架空のスケルトンキャラクターペアの H3 LoRA:ボロボロのハイファッションマントとカーゴパンツを着た死神 Loru、パーカーとスニーカーを着たスケルトン猫 Ribs;作者は骨と布地の質感の対比、塩湖、ネオンなどのシーンライティングに優れていると主張しています。
- MiniMax-H3 V5 All-in-One Video Workflow - SelfLift Two-Pass Edition · v1.0 — ワークフロー:Astral星芒 の H3 汎用動画生成ワークフロー V5「SelfLift 二次サンプリング版」:テキストから動画、画像から動画、参考画像から動画の3機能を統合、公式スキルによるプロンプトの自動作成、音声の固定、低VRAMでの二次サンプリング、作者は遠景での顔の崩れの改善を主張しています。
データ:Civitai 公開 API(基盤モデル MiniMax H3)、収録期間 11-01 20:31 → 11-02 10:45(北京時間)。推奨理由は編集者による審査済み;ダウンロード数は注目度を表すに過ぎません。