진정의 AI 레이더 · MiniMax H3 · 2026-11-02 모닝 브리프
이번 호 22개 신규 버전: 강력 추천 0 · 추천 1 · 주목할 만함 9 · 단순 수록 12
편집자 주 이번 호에서는 22개의 H3 신규 버전을 검토했습니다. 최우선 추천은 H3 캐릭터 시트 디자이너 v1.3입니다: 오픈소스 ComfyUI 노드로, 캐릭터 이미지 한 장을 H3의 참조 이미지 조건으로 활용하여 최대 13개 뷰의 정적 시트 이미지를 생성합니다. 이번 버전에서는 템플릿을 Pika Ref2VA LoRA로 변경하고, 손과 발을 오른쪽에 배치한 7 뷰 프리셋을 추가하여 B에서 A로 등급이 상향되었습니다. 캐릭터 스왑 워크플로우 v2.0은 2차 정제, 수채화 스타일 LoRA 트리거 워드 및 강도 조정을 추가했으나 유료이며, 모두 B 등급을 유지했습니다. AIKSK는 한 번에 15개의 워크플로우를 공개했는데, 카드에는 구조 설명만 있고 저자는 추론 검증을 하지 않았다고 밝히며 가시적인 예시가 거의 없습니다: Sigma / OpenVDN / SelfLift 3종류의 4K 생성, 오디오 기반 디지털 휴먼 및 사진 더빙 캐릭터, 비디오 캐릭터 스왑 표준 버전, 비디오 부분 리페인트는 B로 지정되었으며, 768P 중복 버전, 제목과 프로세스가 불일치하는 '얼굴 보정 및 유분 제거', 범용 SeedVR2 업스케일링, 이전 버전의 설명을 그대로 복사한 Hero Shot v2 등은 C로 하향되었습니다. Anima 올인원 워크플로우의 'MiniMax 버전' 카드에는 H3 관련 설명이 전혀 없어 A에서 C로 하향되었습니다.
추천 (1)
【A】ComfyUI용 H3 캐릭터 시트 디자이너 - 이미지 생성 · v1.3
워크플로우 · 버전 업데이트 · 저자 ukr8b3g201 · 게시일 11-01 22:18 · 다운로드 수 160
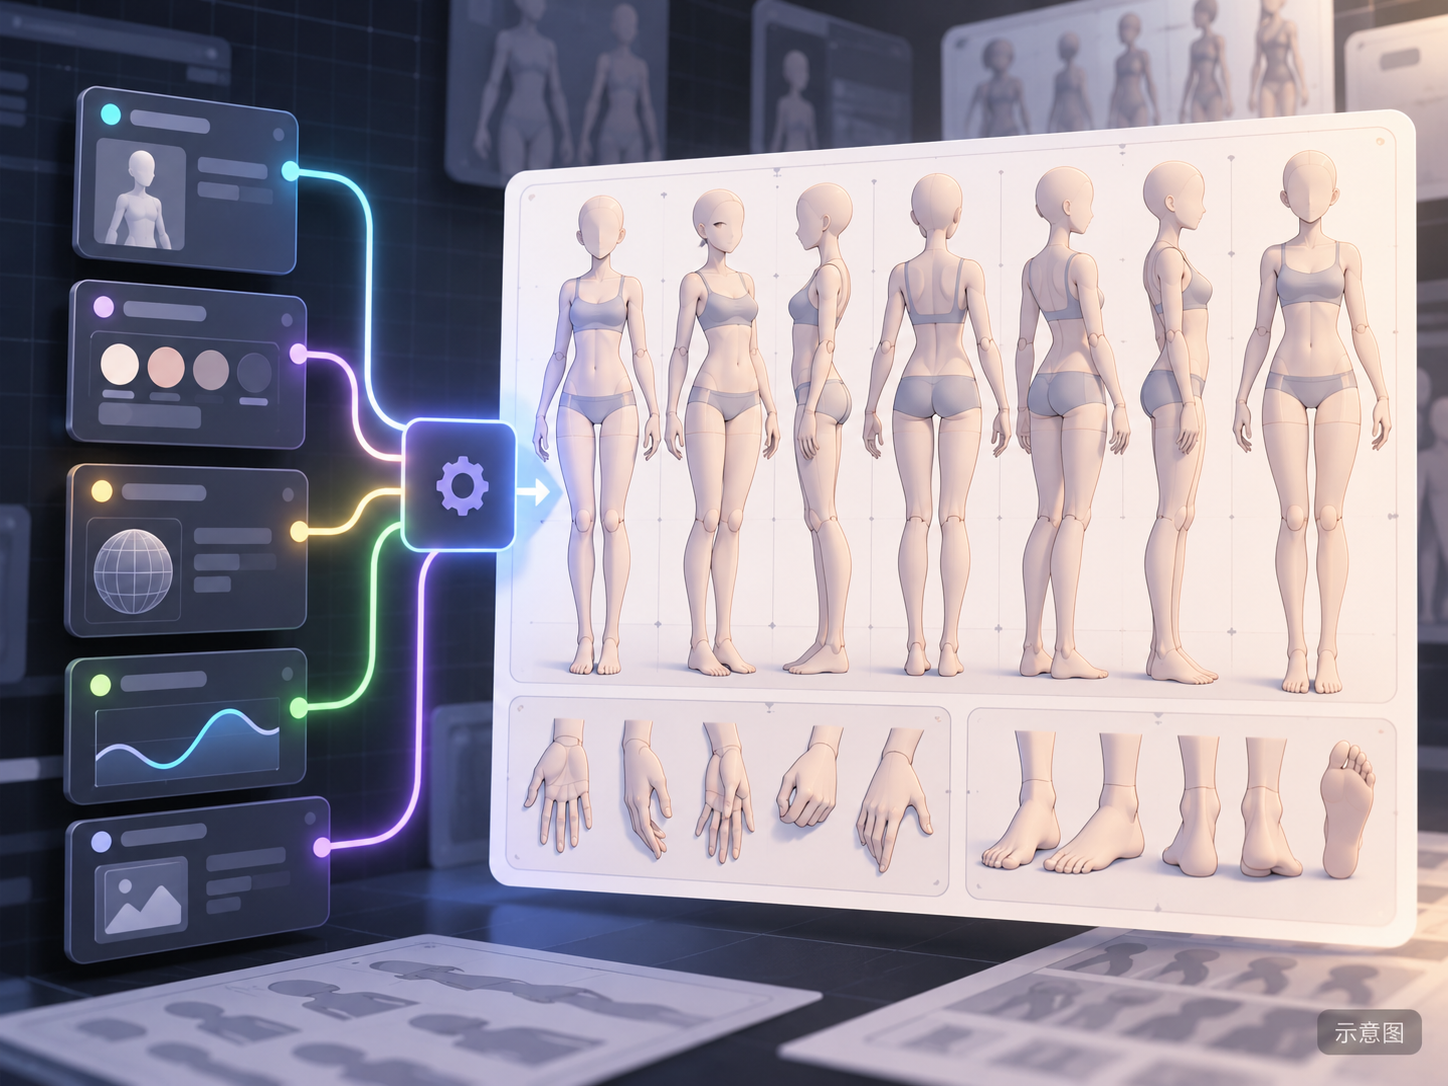
ComfyUI 커스텀 노드 및 워크플로우: 캐릭터 이미지 한 장(동일 캐릭터의 참조 이미지 3장 추가 가능)을 입력하면 H3의 내장 참조 이미지 조건을 활용하여 다중 뷰 캐릭터 시트 이미지(머리, 전신, 의류 앞뒤, 손, 신발, 최대 13개 뷰)를 생성하며, 전용 시트 이미지 LoRA가 필요하지 않습니다.
B에서 A로 상향: 노드가 오픈소스이며, 설치 단계와 모델 목록이 완벽하게 작성되어 있고, v1.3의 변경 사항이 구체적이며 제한 사항을 솔직하게 기재했습니다. 감점 요인은 이번 버전에 가시적인 예시가 없다는 점입니다.
이미지
추천 이유
- 버전 업데이트: 업데이트 노트는 비어 있지만 모델 카드에 v1.3의 변경 사항이 기재되어 있습니다. 템플릿을 Pika H3 Flex Ref2VA LoRA로 변경했습니다. MOSS 스타일 프리셋을 추가했으며, 그중 7 뷰 버전은 손과 발을 오른쪽에 배치합니다. 참조선 레이아웃의 켜짐/꺼짐이 하나의 세트를 공유하고, 여백이 더 작아지며, 전신 프레임이 더 커집니다. 인터페이스가 더 깔끔해졌으며, 의류 및 13 뷰 프롬프트가 소폭 조정되었습니다.
- 캐릭터 시트 이미지 생성을 지원하며, 이를 H3 참조 이미지 기반 비디오 생성에 활용하여 캐릭터 일관성을 유지하는 요구 사항에 부합합니다. 저자는 모델 카드와 GitHub README에서 v1.3가 사소한 변경 사항임을 솔직하게 명시했으며, 의류 및 전체 13 뷰에서 큰 개선이 입증되지 않았고 여전히 인체 잔여물이나 뷰 누락이 발생할 수 있다고 밝혔습니다.
- 무료이며 코드는 GitHub에서 오픈소스로 공개되어 있고, 라이선스상 판매가 허용됩니다. 이번 버전은 160회 다운로드되었으며, 전체 모델 누적 다운로드 수는 2707회, 좋아요 수는 111개입니다(관심도만 나타냄).
사용 방법
- ComfyUI/custom_nodes目录下에서 저자의 H3-Character-Sheet-Designer 저장소를 git clone으로 복제하고, 재시작 후 h3CharacterSheetDesigner_v13.zip 파일 내의 v1.3 워크플로우를 로드합니다(패키지에는 v1.2.2 워크플로우도 포함되어 있습니다). 템플릿에는 rgthree-comfy가 추가로 필요합니다.
- 모델은 카드의 표에 따라 배치합니다. 확산 모델은 DaSiWa Hybrid V4 INT8 또는 공식 H3 Ref2VA INT8를 사용하고, 텍스트 인코더는 H3 Qwen3-VL INT8(또는 NVFP4 AWQ)를 사용하며, 비디오 VAE는 INT8 또는 FP16를 사용합니다. Pika Ref2VA LoRA는 켜고, FL2VA LoRA는 끕니다. CLIP 로더 유형은 minimax로 선택합니다.
- 필요한 뷰를 체크하고 출력 크기를 조정하며, 의류 등 세부 사항을 설명하기 위해 영어 부위 프롬프트를 추가할 수 있습니다. 저자는 먼저 Use Layout Image를 끄고, 구도 가이드가 필요할 때 다시 켜는 것을 권장합니다. 샘플링 매개변수는 템플릿 기본 설정을 사용하며, 카드에는 별도로 명시되지 않았습니다.
리스크 및 제한 사항
- 저자가 업데이트 노트를 작성하지 않았으며, v1.3의 변경 사항은 모델 카드 본문에 기재되어 있습니다.
- 이번 버전에는 가시적인 예시가 없습니다(2개의 민감도 등급이 숨겨져 있음). GitHub README에는 인터페이스 스크린샷만 있으며, 이 항목에서는 완성된 시트 이미지를 확인할 수 없습니다.
- 저자는 자동 크기 조정이 렌더링 시간과 VRAM 사용량을 증가시킬 수 있다고 언급했습니다. 출력은 정적 시트 이미지이며 비디오가 아닙니다. 이 항목은 실행되지 않았습니다.
- 카드의 이미지는 AI로 생성된 개요도이며 모델의 실제 효과가 아닙니다. 저자는 공개된 일반 등급의 예시를 제공하지 않았습니다.
주목할 만함 (9)
【B】Minimax H3 IMG2IMG 캐릭터 스왑 워크플로우 · v2.0
워크플로우 · 버전 업데이트 · 저자 MrAzor · 게시일 11-02 01:18 · 다운로드 수 92
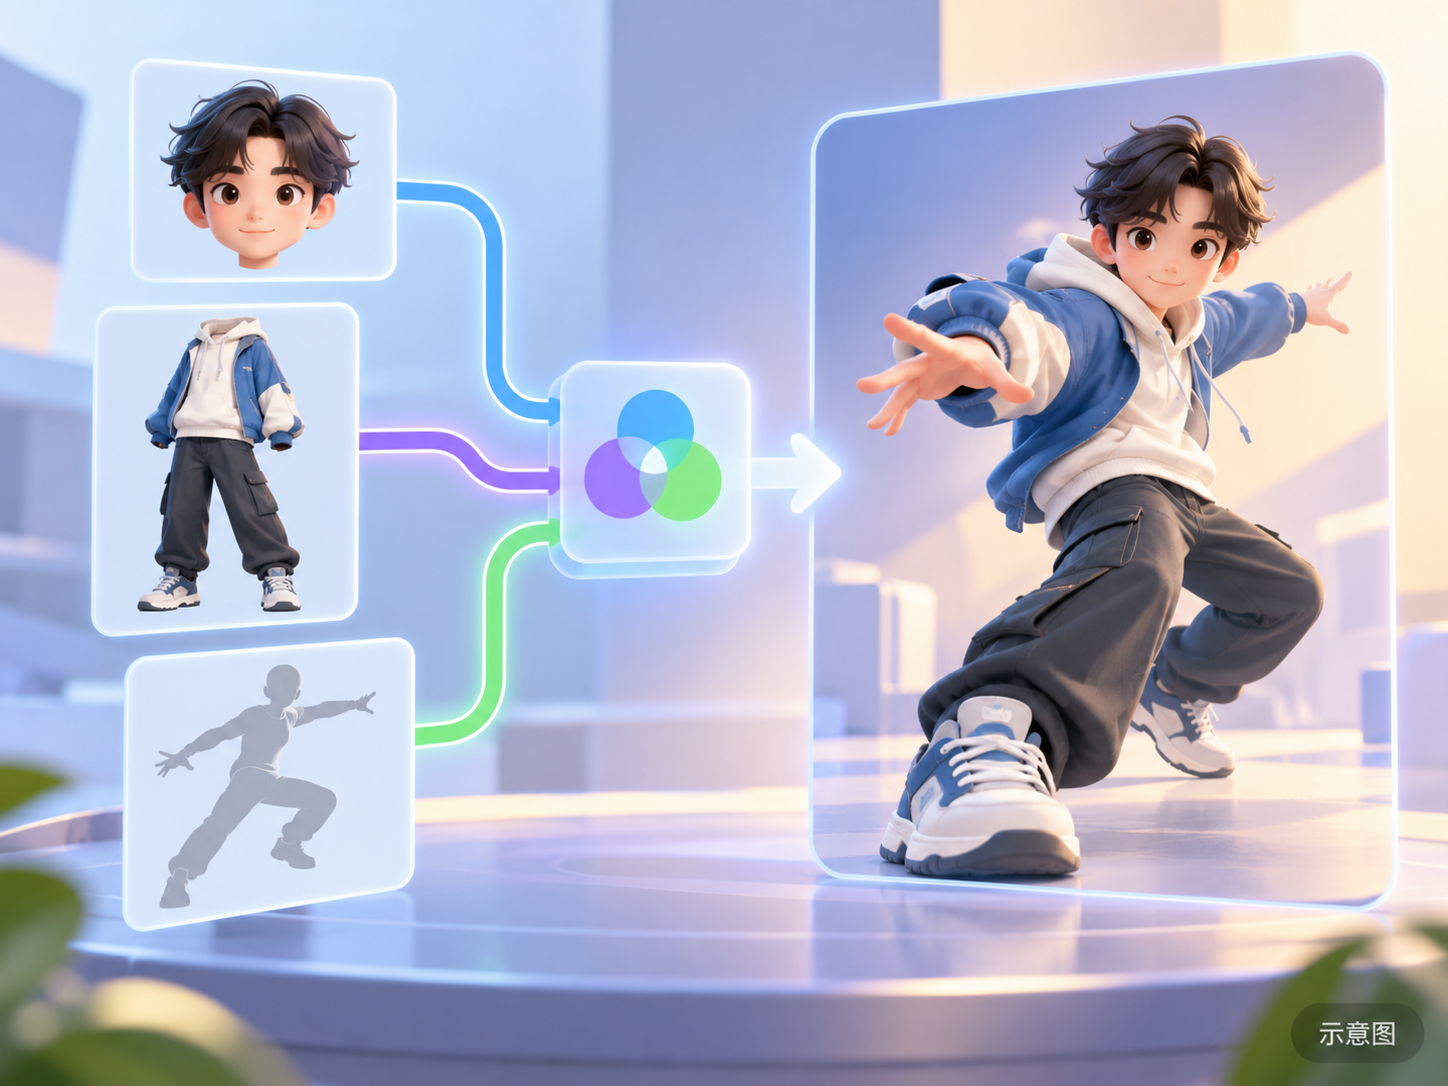
H3과 NRDX Character Swap LoRA를 사용하여 '캐릭터 스왑'을 수행하는 ComfyUI 워크플로우: 머리 및 신체 참조 이미지를 캐릭터 참조로 합성하고, 다른 포즈 이미지에 따라 정적 이미지를 생성합니다. v2.0에서는 선택적 2차 정제가 추가되었습니다.
이미지
【B】수채화 [Minimax / MOSS / Krea2 / SD]🎨 🖌️ 🖼️ · Minimax v1.0
LoRA · 이식 · 저자 TeraWatt · 게시일 11-02 06:36 · 다운로드 수 2 · 유료
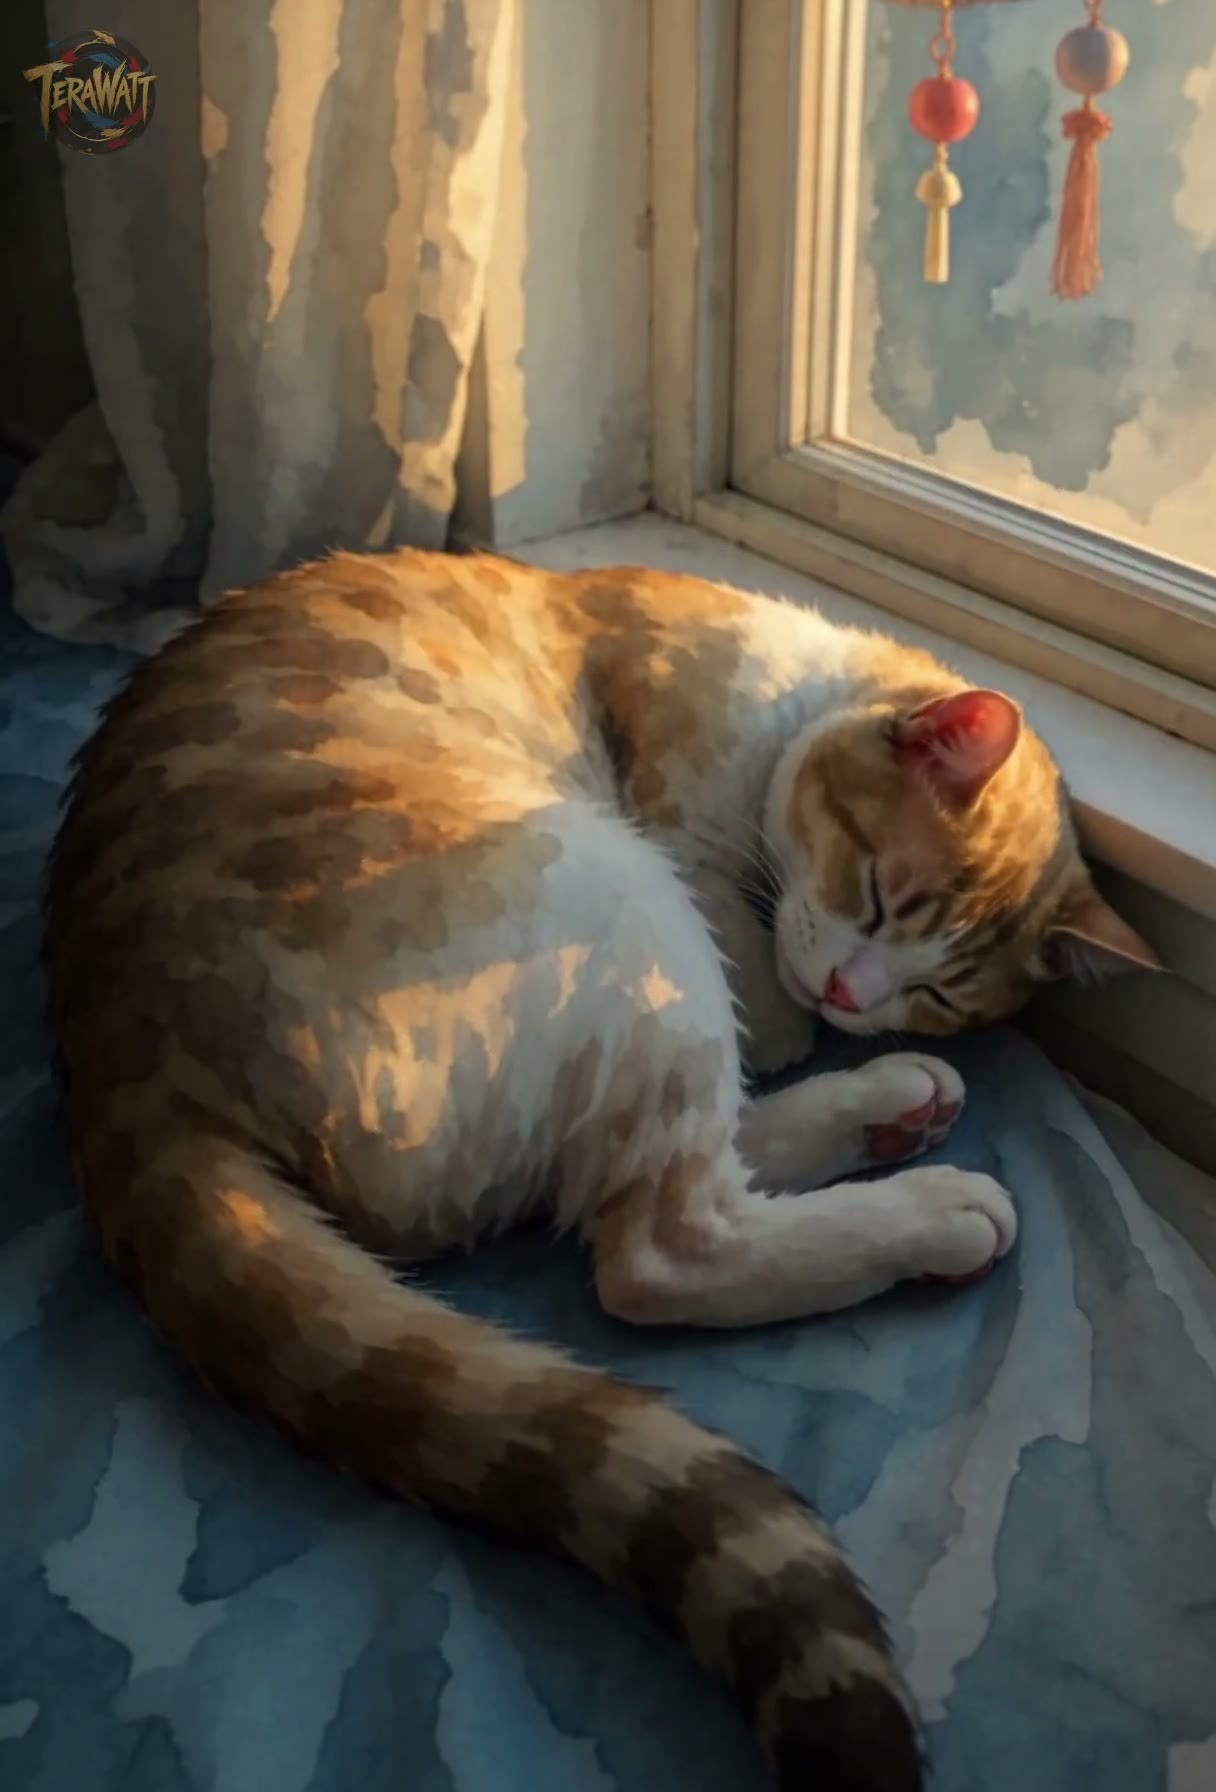
수채화 스타일 LoRA의 H3 버전: 텍스트-비디오 생성 화면을 수채화 질감으로 변환하며, 저자는 인물, 풍경, 애완동물 등의 화면을 동일한 시리즈로 통일하는 데 사용할 수 있다고 주장합니다.
이미지
【B】MiniMax H3 Sigma Enhanced Dual-Pass 범용 비디오 생성 4K · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 04:39 · 다운로드 수 33
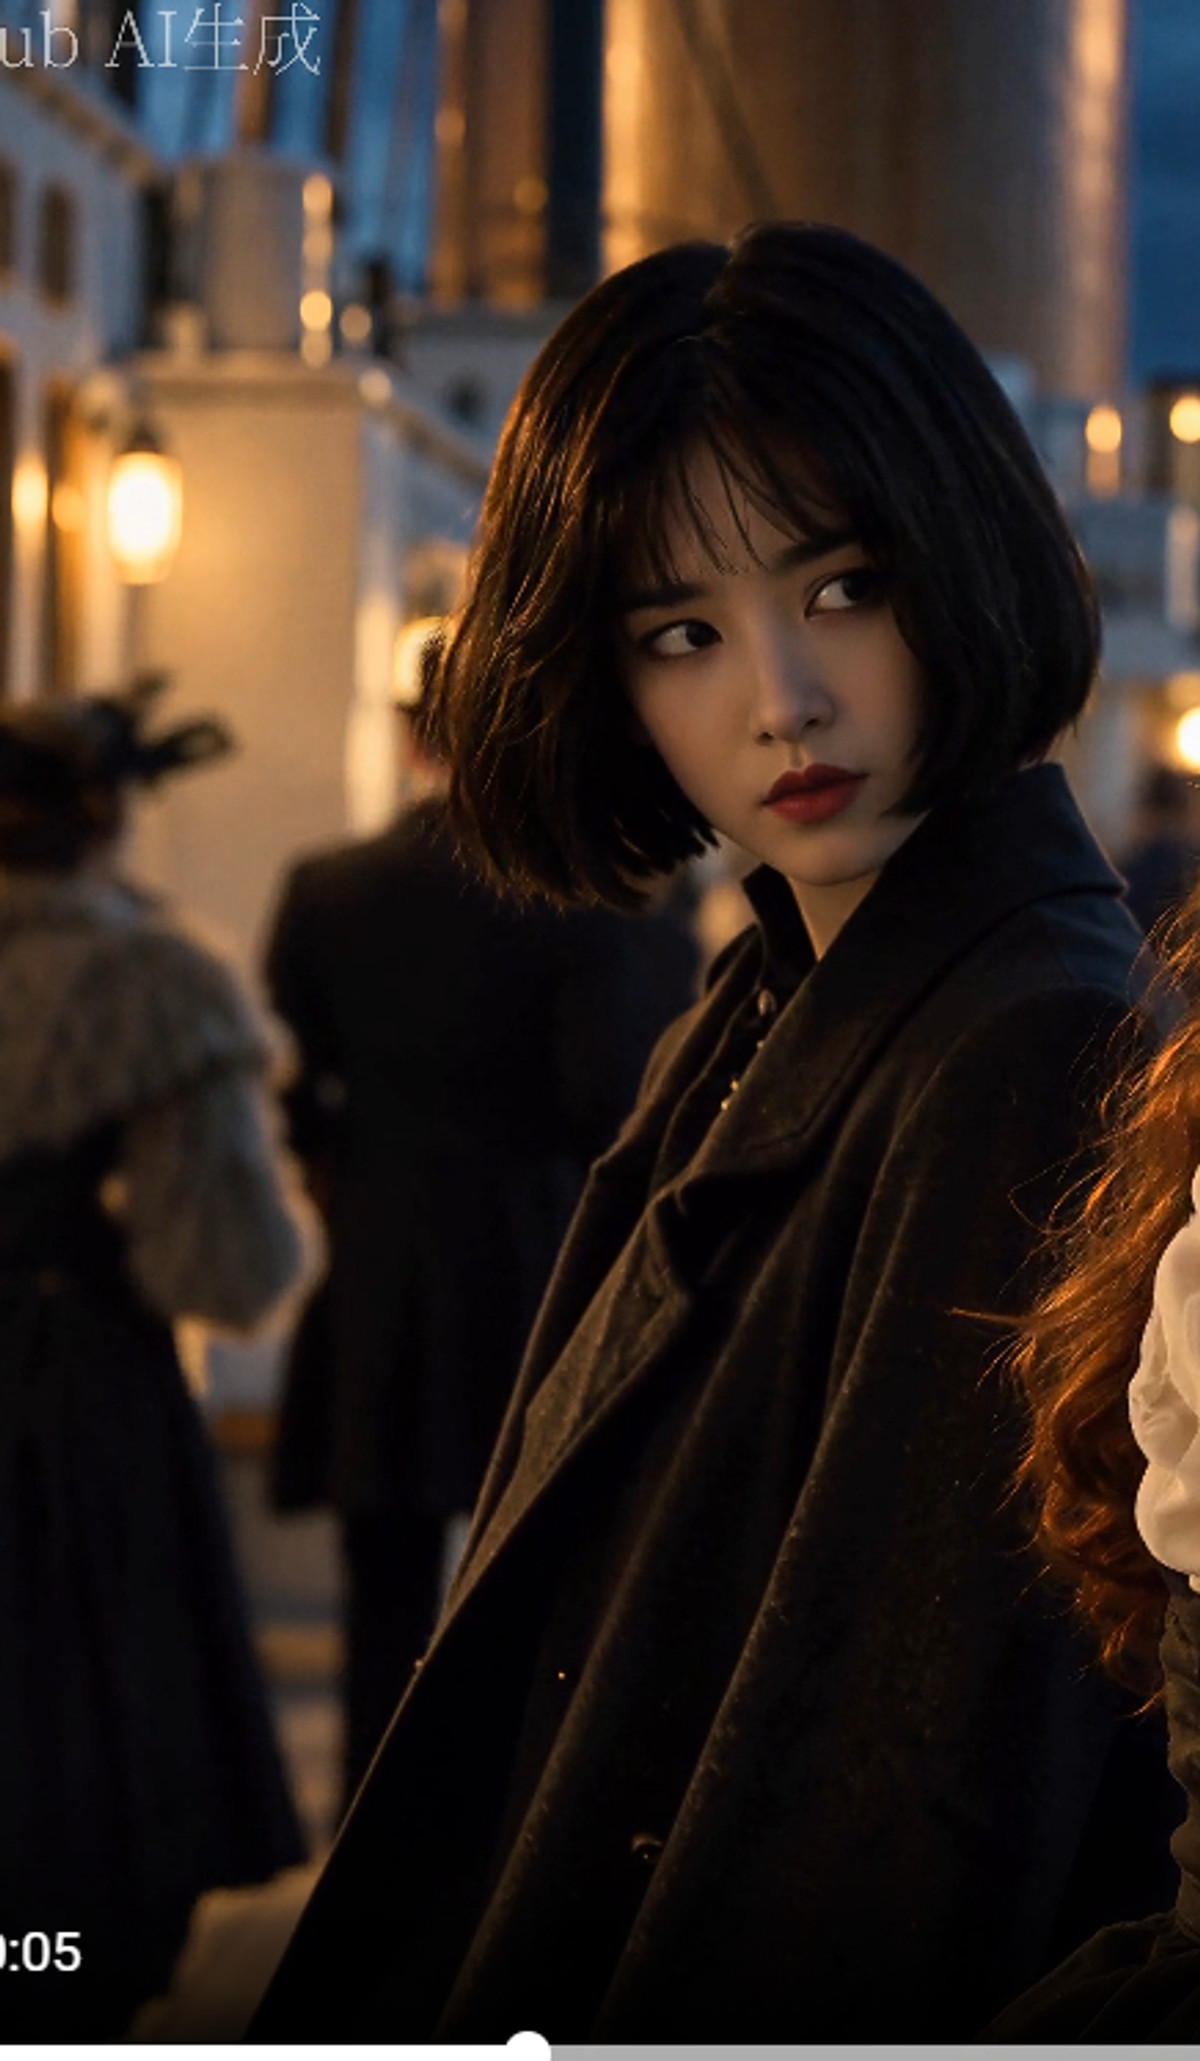
AIKSK의 H3 범용 비디오 생성 워크플로우(Sigma Enhanced Dual-Pass · 4K 목표): 참조 이미지 한 장으로 비디오를 생성하며, 먼저 저해상도 샘플링을 수행하고 학습형 잠재 공간에서 2배 업스케일링 후 정제합니다. 디코딩 후 SeedVR2로 2160까지 업스케일링하고 2배 프레임 보간을 수행합니다.
이미지
【B】MiniMax H3 OpenVDN DMD8 범용 비디오 생성 4K · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 04:38 · 다운로드 수 19
AIKSK의 H3 범용 비디오 워크플로우(OpenVDN DMD8 · 4K 목표): 첫 번째 프레임과 마지막 프레임을 사용하여 비디오를 생성하며, 샘플링은 OpenVDN의 vdn-minimax-h3 증류 방식(stage_dmd_8nfe)에 맡깁니다. 디코딩 후 SeedVR2로 2160까지 업스케일링하고, 3840×2160로 축소한 뒤 2배 프레임 보간을 수행합니다.
이미지
【B】MiniMax H3 SelfLift 범용 비디오 생성 4K · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 04:39 · 다운로드 수 22
AIKSK의 H3 범용 비디오 워크플로우(SelfLift · 4K 목표): 참조 이미지 한 장으로 비디오를 생성하며, SelfLift 노드 내부에서 먼저 저해상도로 생성한 후 학습형 잠재 공간에서 업스케일링 및 정제를 수행합니다. 이후 SeedVR2로 2160까지 업스케일링하고, 3840×2160로 축소한 뒤 2배 프레임 보간을 수행합니다.
이미지
【B】10Eros Beta5 SelfLift 오디오 디지털 휴먼 파인튜닝 워크플로우 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 04:23 · 다운로드 수 21
사용자가 제공한 오디오로 H3 디지털 휴먼 비디오를 구동하는 워크플로우: 두 장의 이미지로 각각 캐릭터와 환경/구도를 제공하며, 원본 오디오의 일부를 잘라 인코딩한 후 참조 조건에 결합하고, SelfLift 2단계 샘플링으로 생성하여 최종 영상에 원본 오디오를 직접 결합합니다.
이미지
【B】MiniMax H3 ControlNet Union 부분 리페인트 워크플로우 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 01:03 · 다운로드 수 28
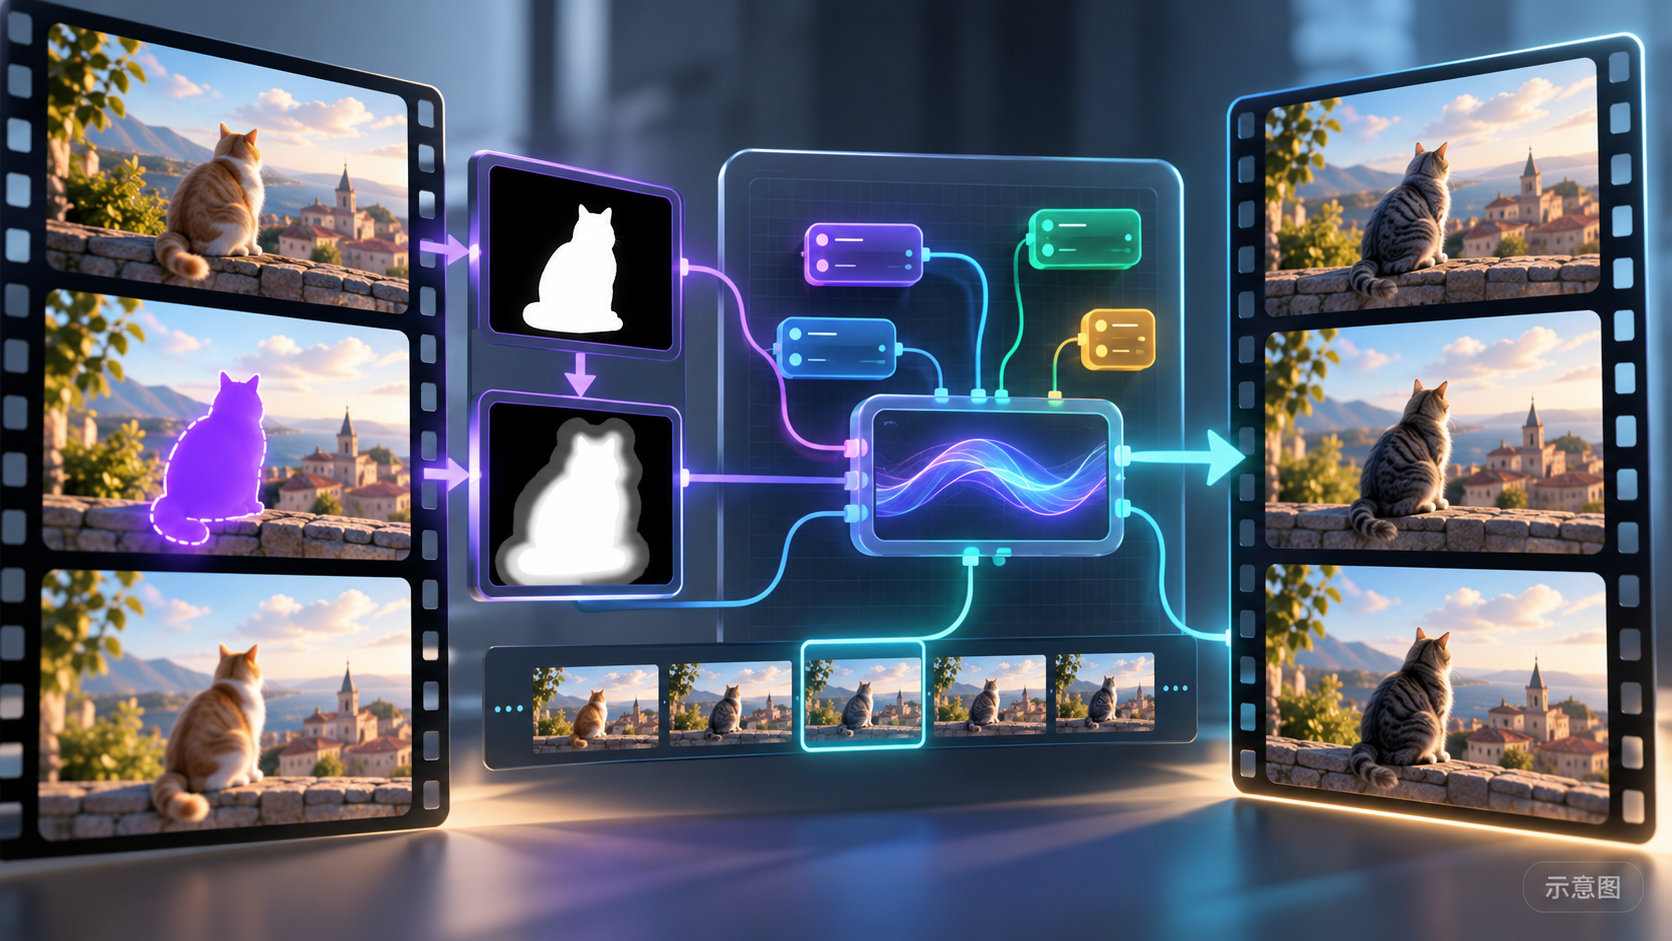
AIKSK의 H3 비디오 부분 리페인트 워크플로우: SeC를 사용하여 원본 비디오에서 수정할 영역을 분할하고, 확장된 마스크와 원본 비디오를 함께 Fun ControlNet Union에 입력하여 마스크 영역만 리페인트합니다.
이미지
【B】MiniMax H3 캐릭터 스왑 참조 편집 — 표준 버전 · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 01:57 · 다운로드 수 33
AIKSK의 H3 비디오 캐릭터 스왑 워크플로우 '표준 버전': SeC로 원본 비디오의 인물을 분할하고, RGB와 깊이를 혼합하여 참조로 만든 후, 외형 참조 이미지에 따라 캐릭터를 리페인트하며, 동시에 원본 비디오의 오디오를 인코딩하여 주입하여 원본 음성을 유지합니다.
이미지
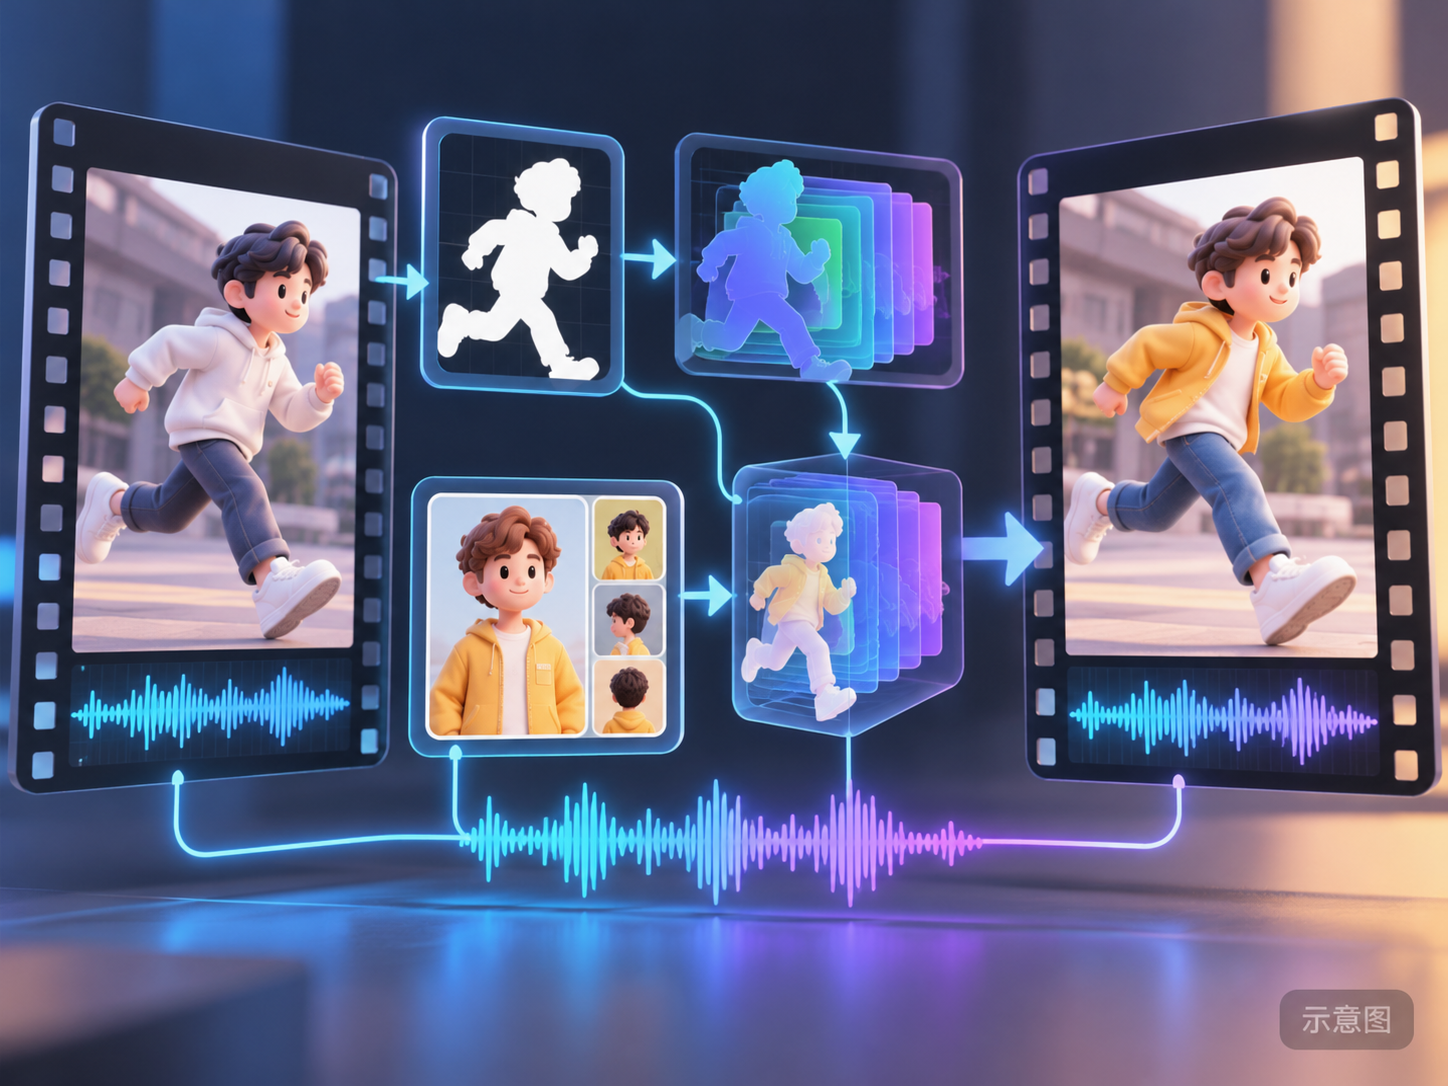
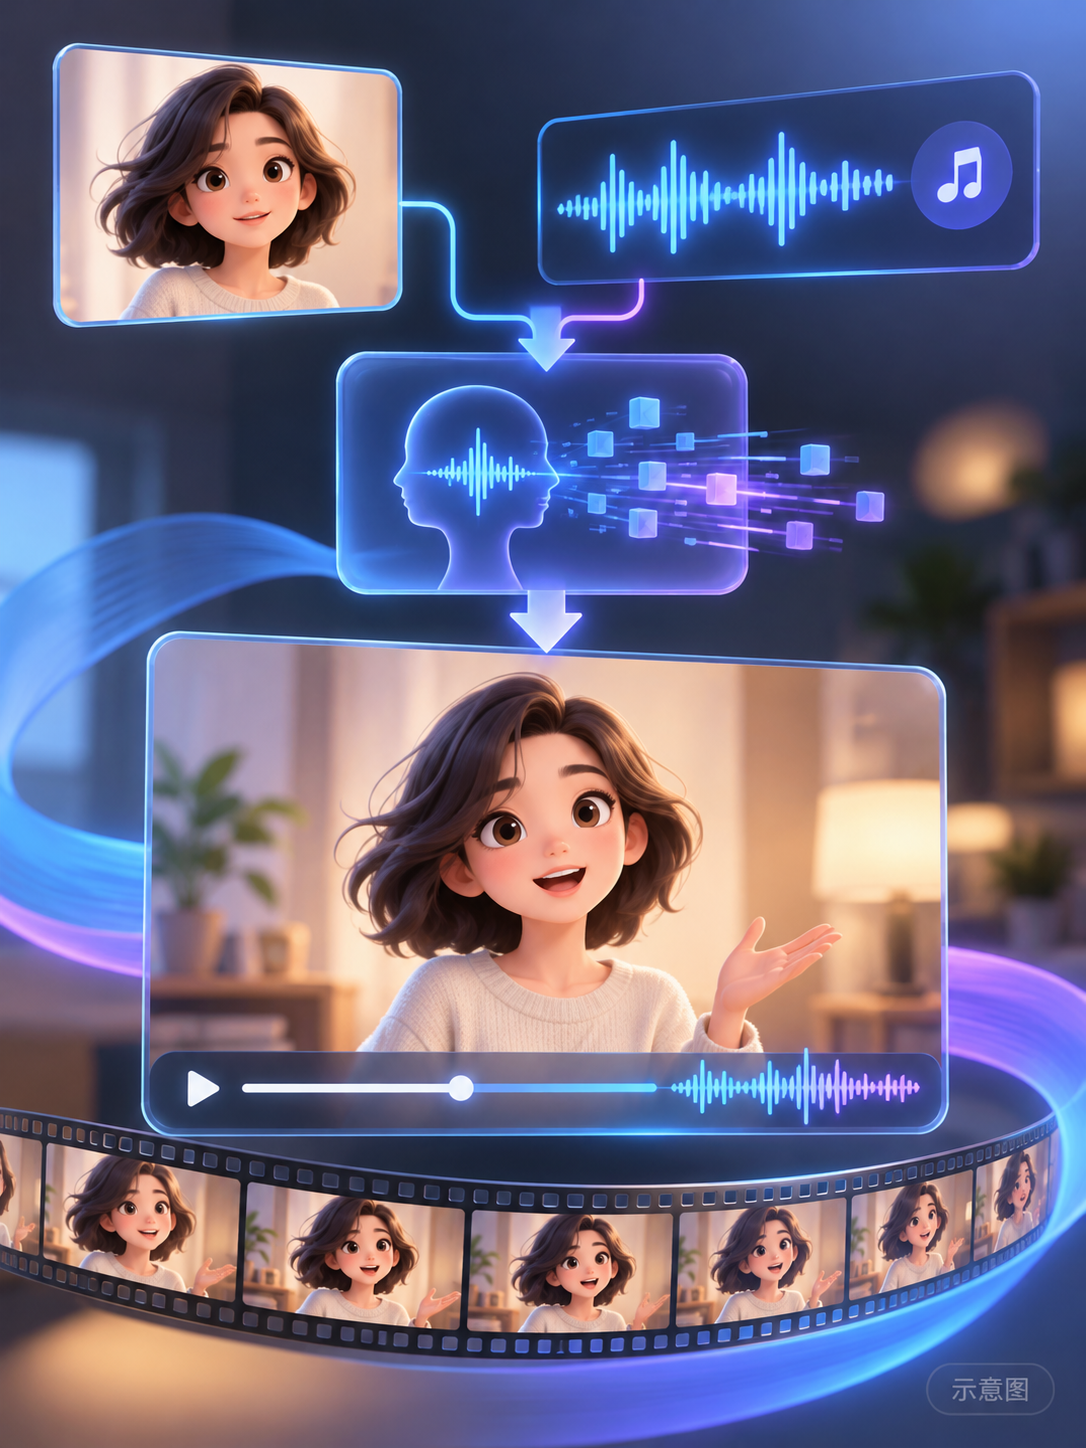
【B】오디오 기반 아바타를 포함한 MiniMax H3 범용 비디오 생성(VDN 12-Step) · v1.0
워크플로우 · 신규 모델 · 저자 AIKSK · 게시일 11-02 01:02 · 다운로드 수 27
AIKSK의 H3 오디오 기반 캐릭터 워크플로우: 참고 이미지 한 장과 업로드한 오디오 한 개를 사용하여 보컬을 분리하고 오디오 잠재 변수로 인코딩하여 생성에 주입하며, 출력 시 선택한 원본 오디오를 다시 연결합니다.
참고 이미지
포함 항목만 (12)
- All in one Anima Made Easy Brain Edition: Complete ComfyUI Workflow with Wan Video or Minimax H3. Or Both! · v4.0 MiniMax edition — 워크플로우: Anima 이미지 생성을 중심으로 한 ComfyUI 통합 워크플로우(스케치에서 고해상도로 변환, 얼굴 및 손 수정, 업스케일링, 부분 리페인트, 4인 영역별 프롬프트, Wan 2.2 이미지에서 영상으로 생성)로, 이 버전은 'MiniMax edition'으로 명명되었으나 모델 카드에는 H3 부분의 연결 방법이 명시되어 있지 않습니다.
- 10Eros Beta5 + FL2VA/Ref2VA Face Touch-up and Oil Removal Second-Pass Workflow · v1.0 — 워크플로우: 제목은 '얼굴 수정 및 유분 제거 2차 정밀 보정'으로 되어 있는 10Eros + H3 워크플로우이지만, 카드의 구조 설명에 따르면 이는 3장의 참고 이미지에서 영상 생성 후 1.5배 학습 기반 업스케일링을 수행하는 2단계 정밀 보정 프로세스이며, 전용 얼굴 크롭 및 재부착 프로세스는 없습니다.
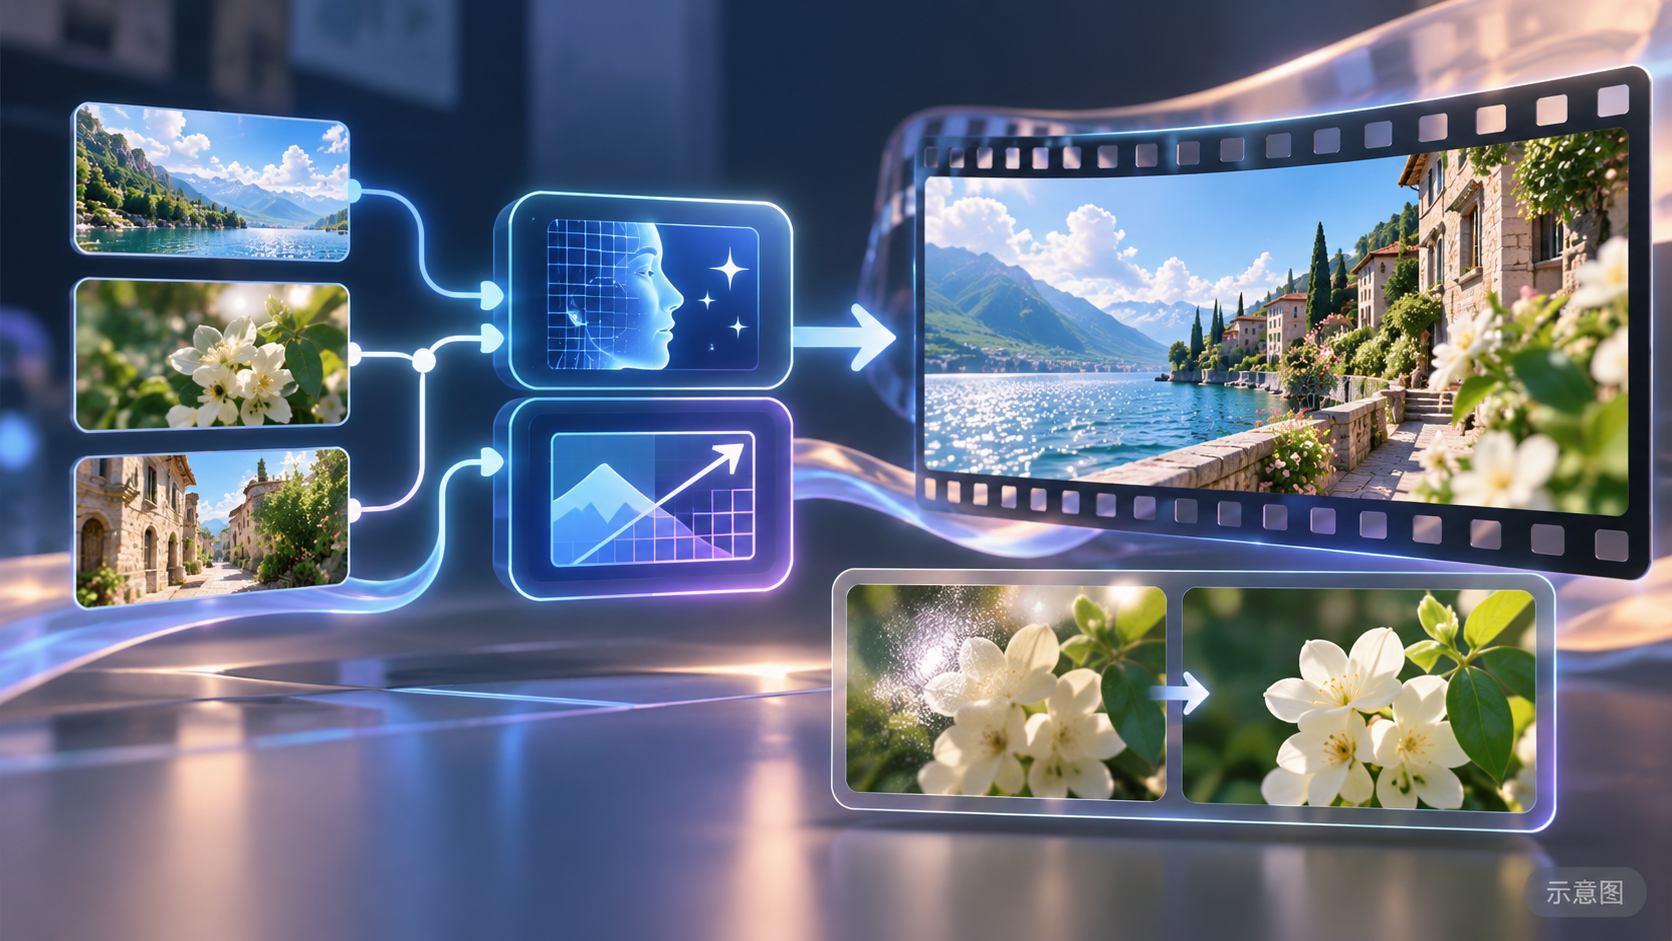
- Universal Video Upscaling SeedVR2 with DLSS Frame Interpolation · v1.0 — 워크플로우: 후처리 전용 영상 워크플로우로, 기존 영상을 읽어 SeedVR2(3B FP8)를 사용하여 2160로 업스케일링한 후 2배 프레임 보간을 수행하며, 원본 오디오와 원본 프레임 레이트를 유지합니다. H3 생성은 포함되지 않습니다.
- MiniMax H3 OpenVDN DMD8 Universal Video Generation 768P · v1.0 — 워크플로우: OpenVDN DMD8 첫 프레임 및 마지막 프레임 워크플로우의 '768P' 버전으로, 동일한 VDN 증류 샘플링과 2배 프레임 보간을 사용하지만 SeedVR2 업스케일링 및 4K 스케일링 후처리 단계는 없습니다.
- MiniMax H3 SelfLift Universal Video Generation 768P · v1.0 — 워크플로우: SelfLift 범용 영상 워크플로우의 '768P' 버전으로, 동일한 SelfLift 2단계 샘플링, 4단계 가속 LoRA 및 2배 프레임 보간을 사용하지만 SeedVR2 및 4K 스케일링 후처리 단계는 없습니다.
- MiniMax H3 Role Swap Reference Edit — Silent Version · v1.0 — 워크플로우: AIKSK의 H3 영상 캐릭터 교체 워크플로우 '무음 버전'으로, SeC를 사용하여 소스 영상 내 캐릭터를 분할하고 RGB 및 깊이 맵을 혼합하여 참고 자료로 만든 후, 하나의 외형 참고 이미지를 기반으로 캐릭터를 리페인트합니다. 이 버전은 수동 오디오 주입 노드를 우회합니다.
- MiniMax H3 VDN Hero Shot · v2 — 12NFE 40-노드 내보내기 — 워크플로우: 제품 전시용 히어로 샷을 제작하는 H3 VDN 2차 정밀 보정 워크플로우로, 소스 영상과 참고 이미지를 읽어들이고 먼저 8-NFE 저해상도 VDN을 수행한 후 학습 기반 잠재 공간에서 2배 업스케일링을 적용하며, 다시 4-NFE 정밀 보정을 거쳐 약 1920×1088, 24 fps의 오디오 포함 최종 영상을 출력합니다.
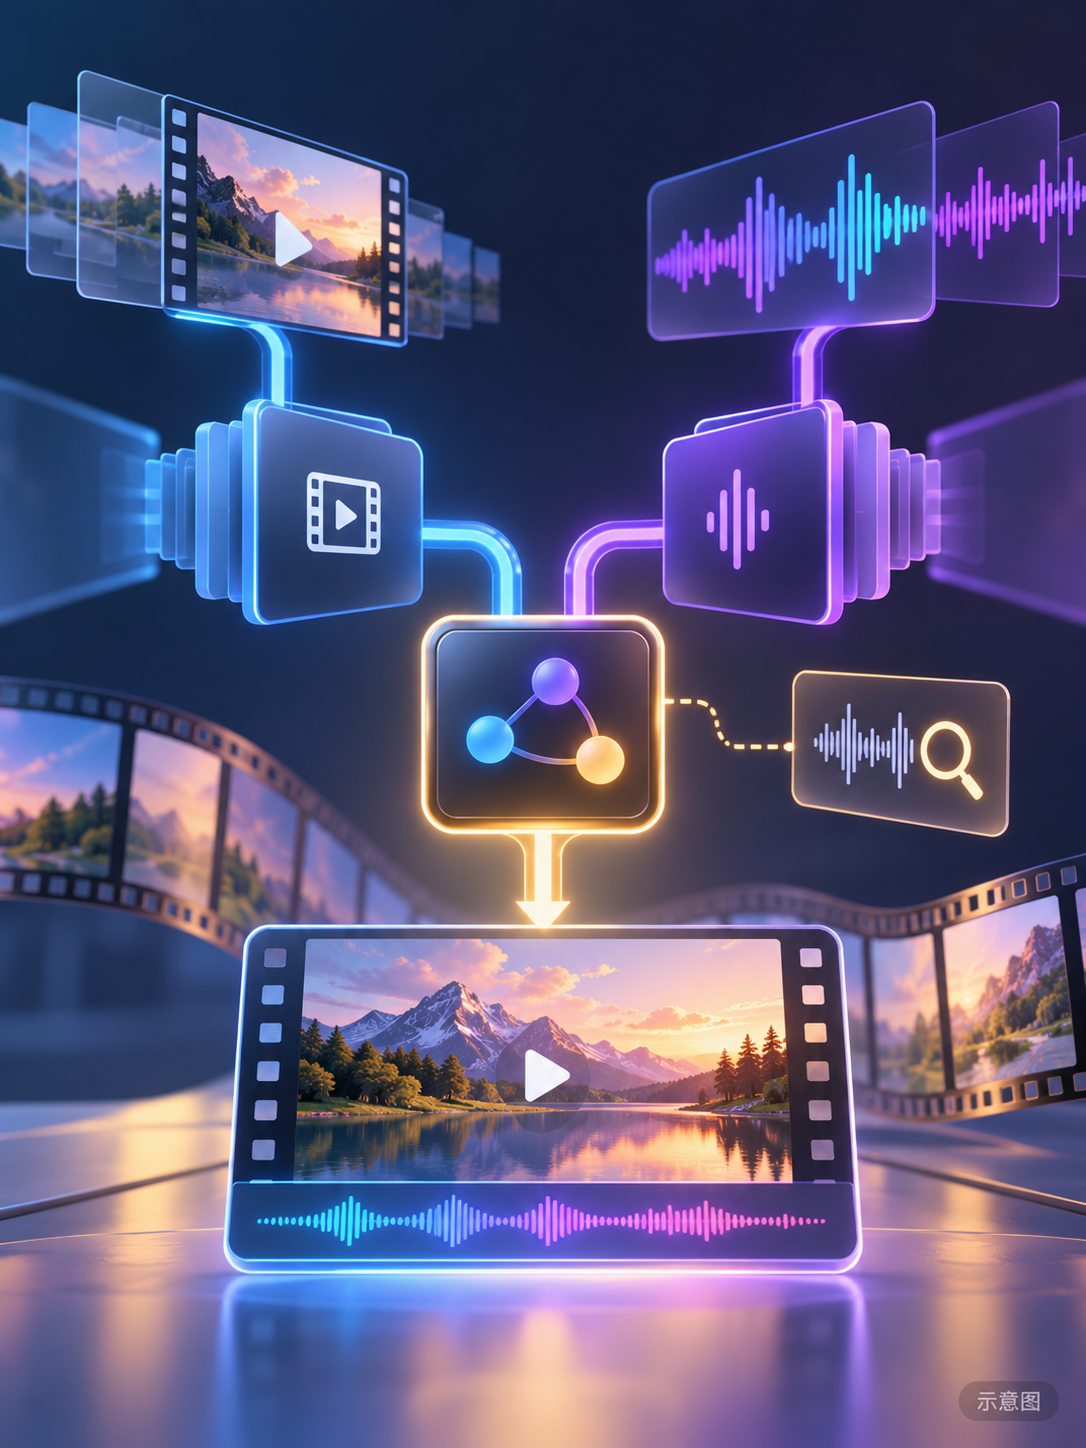
- MiniMax H3 ControlNet Union 2.0 Video Control with Audio Avatar (VDN 12-Step) · v1.0 — 워크플로우: AIKSK의 H3 워크플로우로, 소스 영상의 깊이 맵(DepthAnythingV2)을 사용하여 구조 제어를 수행하는 동시에 보컬을 오디오 잠재 변수로 인코딩하여 주입함으로써 동작과 소리에 동기화된 영상을 생성합니다.
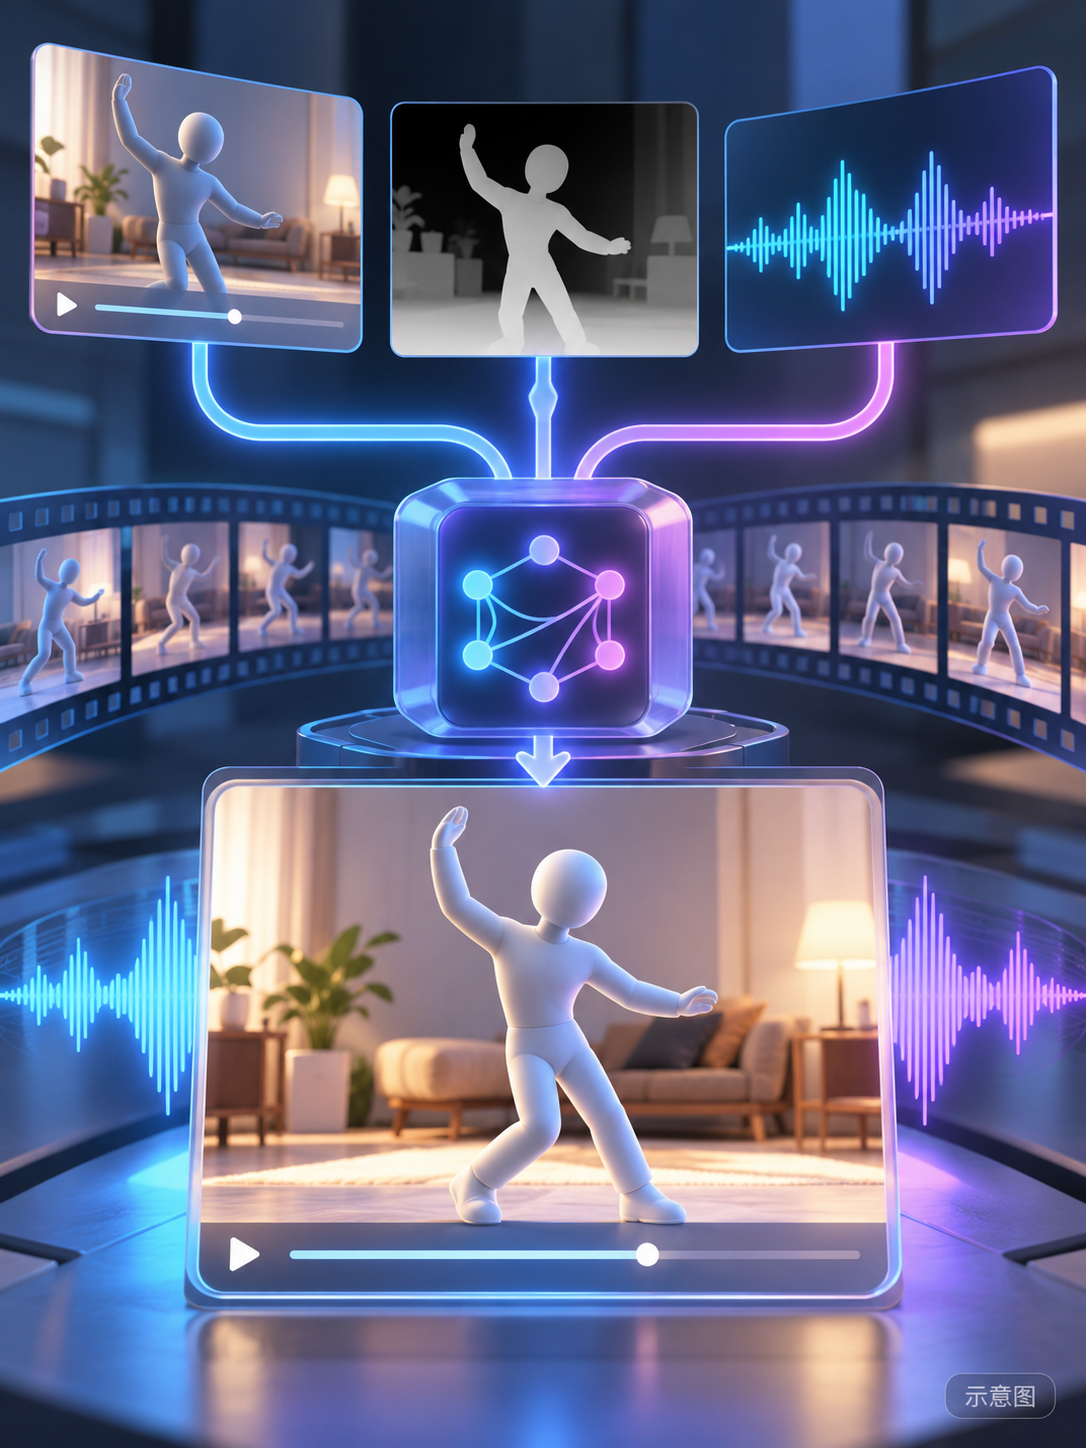
- MiniMax H3 ControlNet Union 2.0 Video Control and Inpaint (VDN 12-Step) · v1.0 — 워크플로우: AIKSK의 H3 구조 제어 워크플로우로, 소스 영상을 Scribble 선화 전처리 후 Fun ControlNet Union에 입력하여 화면 구조를 제어하며, 오디오는 H3에서 네이티브로 생성됩니다.
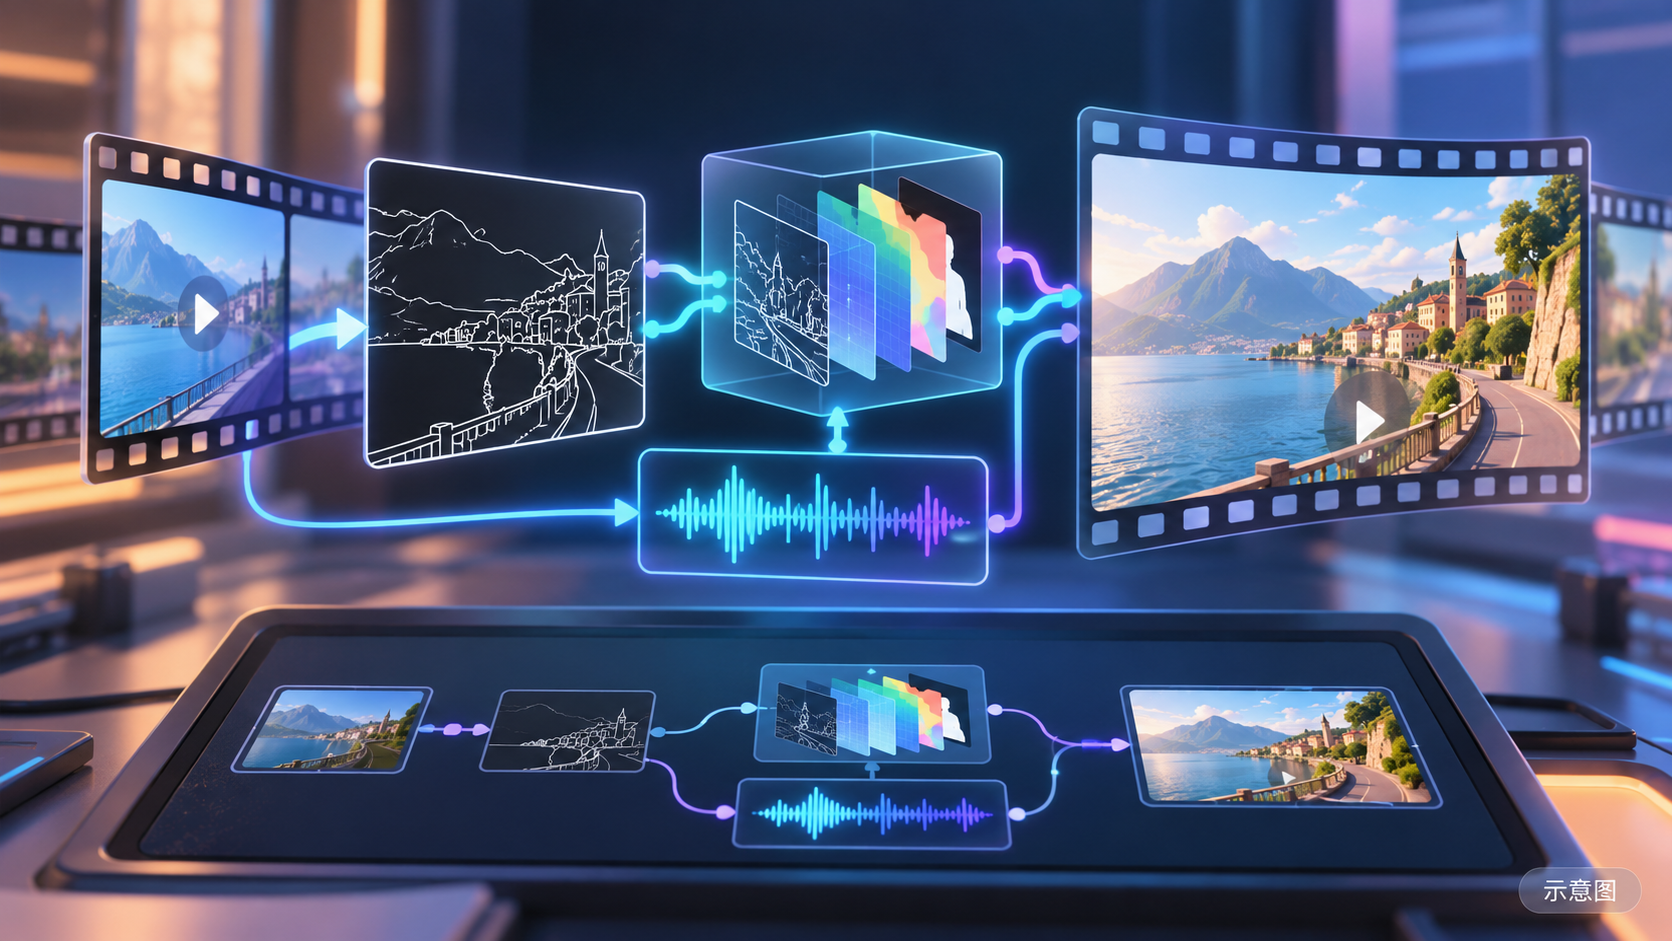
- MiniMax-H3 All-in-One Video Workflow V5 - Latent Chunked Second-Sampling Edition · v1.0 — 워크플로우: Astral성광의 H3 올인원 영상 생성 워크플로우 V5 '잠재 변수 청킹 2차 샘플링 버전'으로, 텍스트에서 영상, 이미지에서 영상, 참고에서 영상 생성의 3가지 기능을 통합하며 자동 프롬프트 작성 및 오디오 잠금을 지원하고, 저자는 원거리 얼굴 붕괴, 얼굴 유분 및 고동적 잔상 문제를 수정했다고 주장합니다.
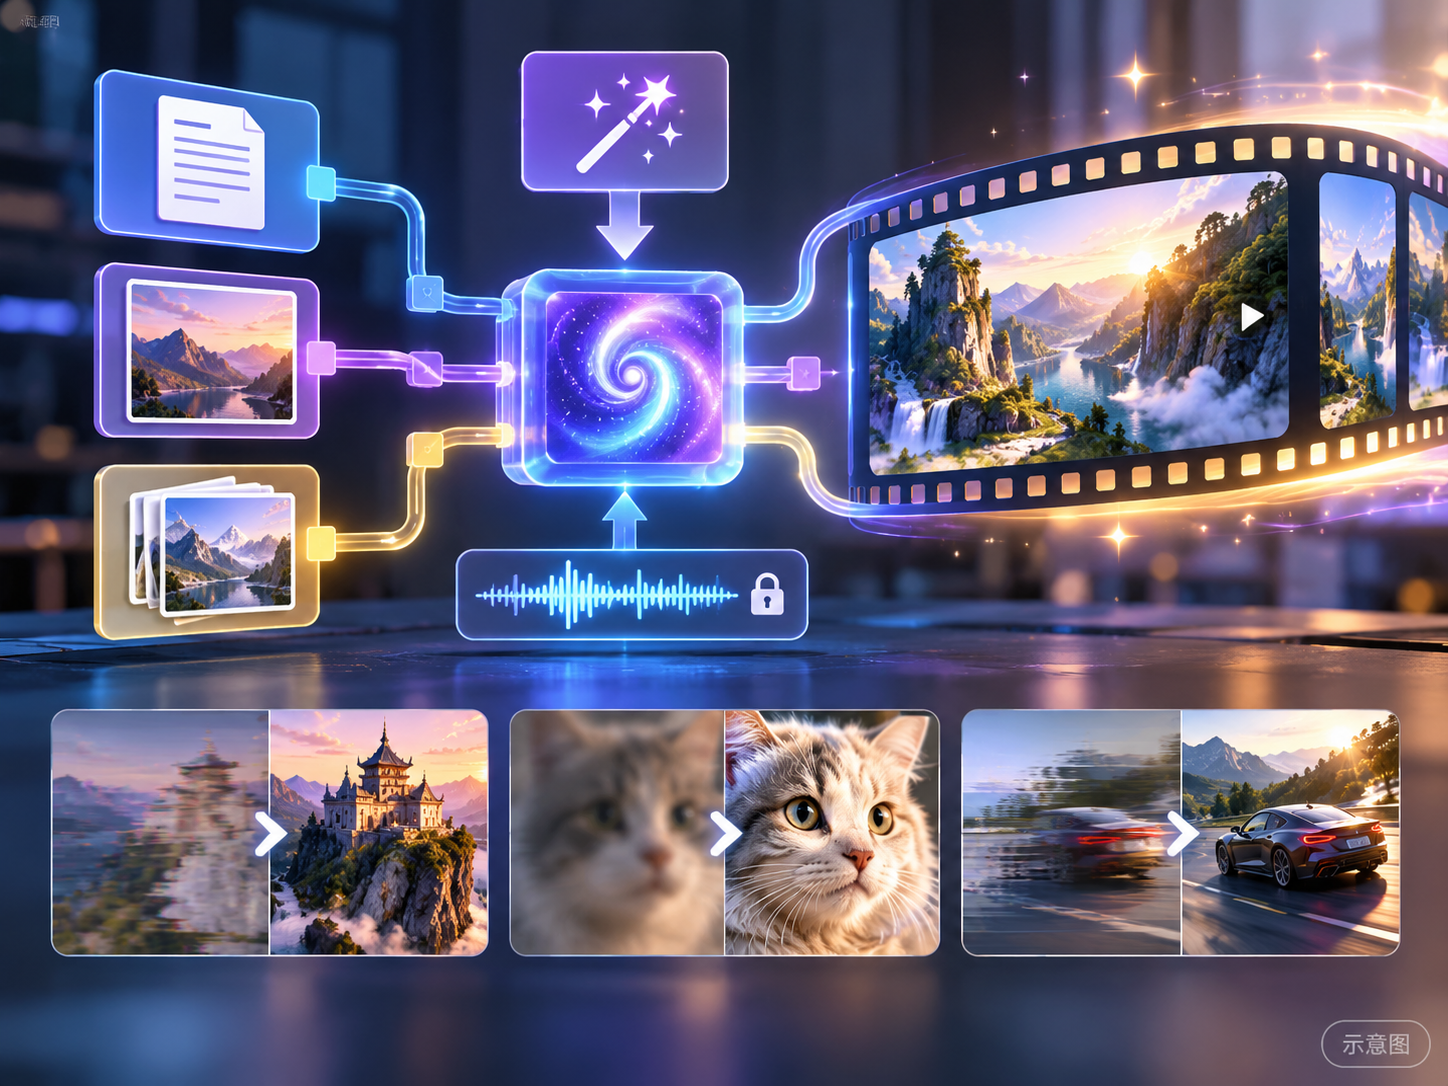
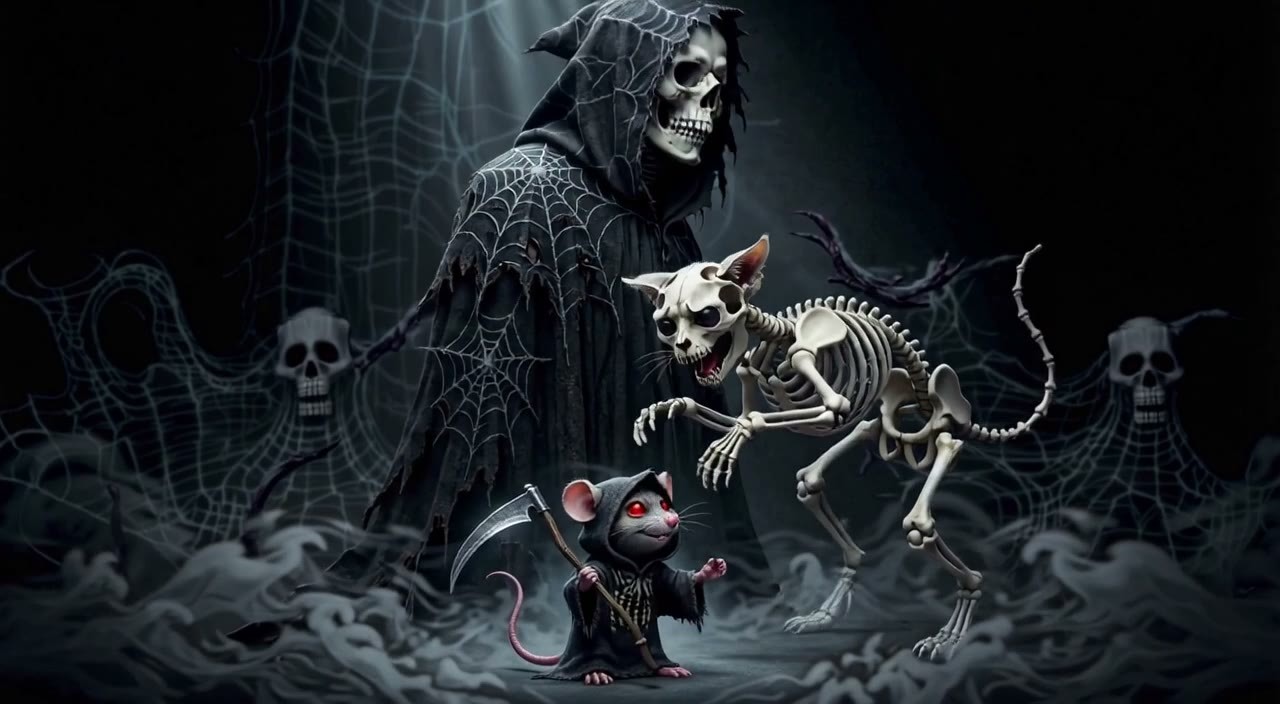
- LORU & RIBS: SALT FLAT SYMPHONY · v1 — LoRA: 가상의 해골 캐릭터 한 쌍을 위한 H3 LoRA로, 낡은 오트쿠튀르 망토와 작업복 바지를 입은死神 Loru와 후드티와 운동화를 신은 해골 고양이 Ribs를 포함합니다. 저자는 뼈와 천의 질감 대비 및 소금 평원, 네온 등의 장면 조명을 잘 표현한다고 주장합니다.
- MiniMax-H3 V5 All-in-One Video Workflow - SelfLift Two-Pass Edition · v1.0 — 워크플로우: Astral성광의 H3 올인원 영상 생성 워크플로우 V5 'SelfLift 2차 샘플링 버전'으로, 텍스트에서 영상, 이미지에서 영상, 참고에서 영상 생성의 3가지 기능을 통합하며 공식 스킬을 사용하여 자동 프롬프트 작성 및 오디오 잠금을 지원하고, 저메모리 2차 샘플링을 통해 저자는 원거리 얼굴 붕괴가 개선되었다고 주장합니다.
데이터: Civitai 공개 API(기본 모델 MiniMax H3), 수집 기간 11-01 20:31 → 11-02 10:45(베이징 시간). 추천 이유는 편집자 검수를 거쳤으며, 다운로드 수는 관심도를 나타냅니다.