贞贞的AI雷达 · MiniMax H3 · 2026-11-02 晨报
本期 22 个新版本:强烈推荐 0 · 推荐 1 · 可关注 9 · 仅收录 12
编辑按语 本期审阅 22 个 H3 新版本。首推 H3 角色设定图设计器 v1.3:一个开源 ComfyUI 节点,用一张角色图借 H3 的参考图条件出最多 13 个视图的静态设定图,这一版模板换用 Pika Ref2VA LoRA、新增手脚放右侧的 7 视图预设,由 B 升为 A;角色互换工作流 v2.0 加了二次精修、水彩风格 LoRA 触发词和强度齐但付费,均维持 B。AIKSK 一次发了 15 个工作流,卡上是结构说明、作者自称未做推理验证且基本没有可见示例:Sigma / OpenVDN / SelfLift 三套 4K 生成、音频驱动数字人和照片配音人物、视频换角色标准版、视频局部重绘定为 B,768P 重复版、标题与流程不符的“修脸去油”、通用 SeedVR2 放大、说明照抄上一版的 Hero Shot v2 等降为 C。Anima 一体工作流的“MiniMax 版”卡上没有任何 H3 说明,由 A 降为 C。
推荐(1)
【A】H3 Character Sheet Designer for ComfyUI -Image Generation · v1.3
工作流 · 版本更新 · 作者 ukr8b3g201 · 发布 11-01 22:18 · 下载 160
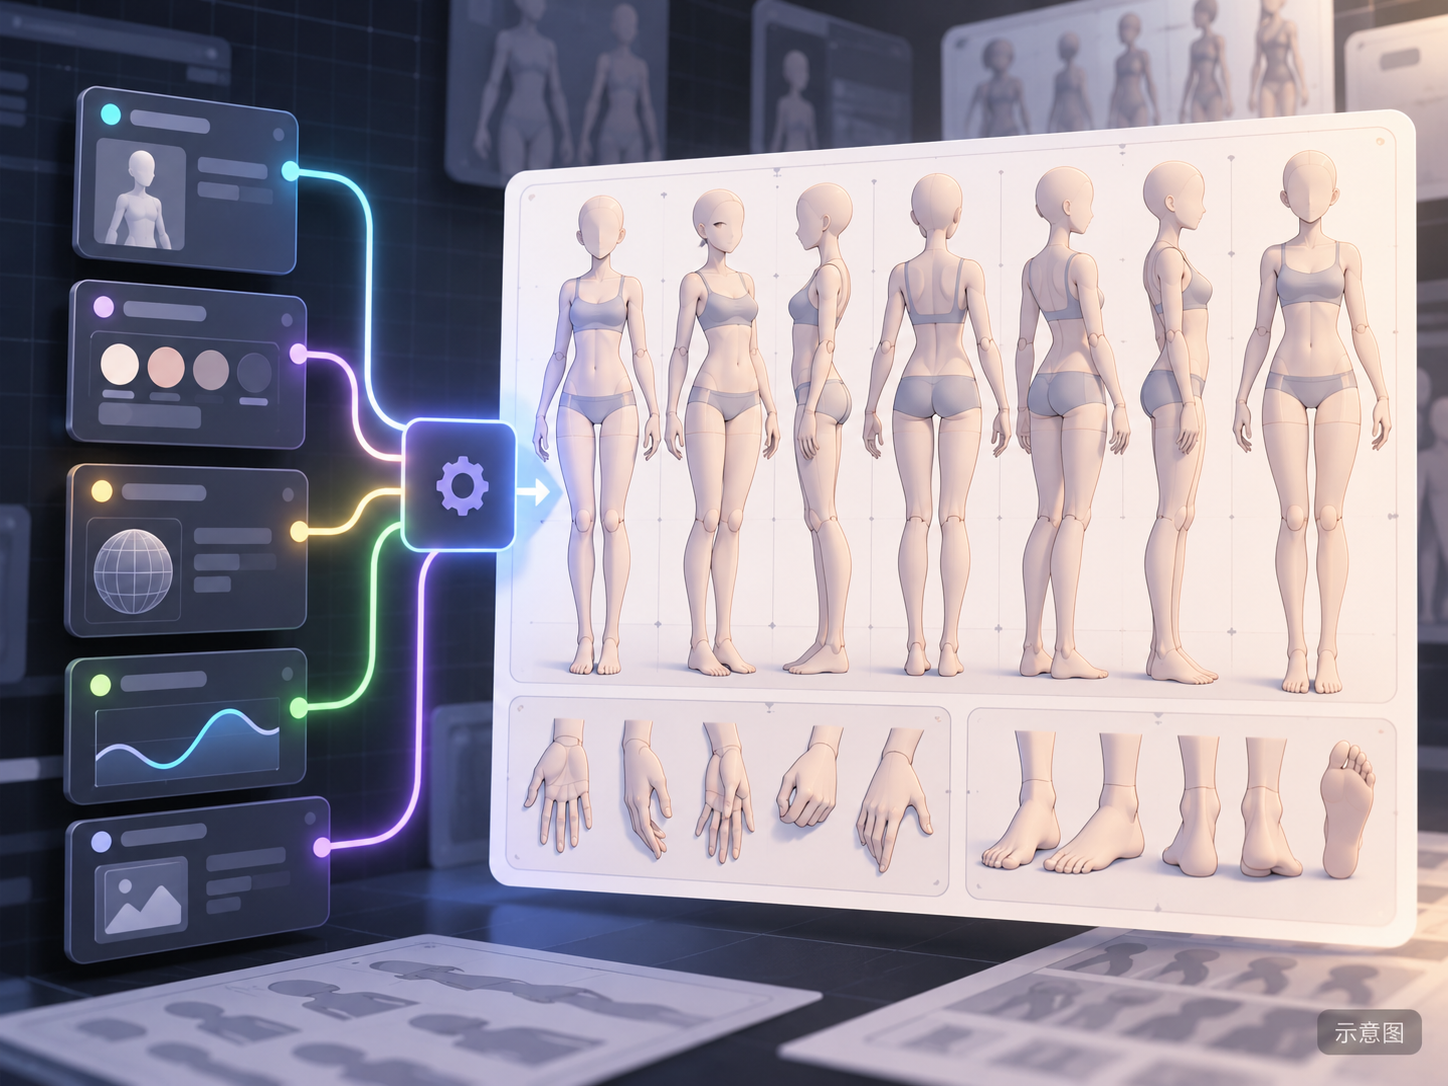
一个 ComfyUI 自定义节点加工作流:输入一张角色图(可再加三张同角色参考),借 H3 自带的参考图条件生成多视角角色设定图(头部、全身、正反面服装、手、鞋,最多 13 个视图),不需要专门的设定图 LoRA。
由 B 升为 A:节点开源,安装步骤和模型清单写得完整,v1.3 改动具体、限制写得坦白;扣分在本版没有可见示例。
配图
推荐理由
- 版本更新:更新说明栏为空,但模型卡写了 v1.3 的改动——模板改用 Pika H3 Flex Ref2VA LoRA;新增 MOSS 风格预设,其中 7 视图版把手和脚放在右侧;参考线布局开与关共用一套、边距更小、全身框更大;界面更简洁,服装和 13 视图提示词小幅调整
- 服务给角色做设定图,再拿去做 H3 参考图生视频、保持角色一致的需求;作者在模型卡和 GitHub README 里坦白写明 v1.3 只是小改,服装和全 13 视图没有证明大幅改善,仍可能残留人体或缺视图
- 免费、代码在 GitHub 开源,许可允许售卖;本版 160 次下载,整个模型累计 2707 次、111 个赞(只代表关注度)
怎么用
- 在 ComfyUI/custom_nodes 下 git clone 作者的 H3-Character-Sheet-Designer 仓库,重启后加载 h3CharacterSheetDesigner_v13.zip 里的 v1.3 工作流(包里也保留 v1.2.2 工作流);模板还需要 rgthree-comfy
- 模型按卡上的表放:扩散模型用 DaSiWa Hybrid V4 INT8 或官方 H3 Ref2VA INT8,文本编码器用 H3 Qwen3-VL INT8(或 NVFP4 AWQ),视频 VAE 用 INT8 或 FP16,Pika Ref2VA LoRA 开、FL2VA LoRA 关;CLIP 加载器类型选 minimax
- 勾选需要的视图、调输出尺寸,可加英文部位提示词描述服装等细节;作者建议先关掉 Use Layout Image,需要构图引导时再打开;采样参数用模板自带设置,卡上未单独给出
风险与限制
- 作者未写更新说明,v1.3 改动写在模型卡正文里
- 本版没有可见示例(2 个敏感级已隐藏);GitHub README 只有界面截图,本条未看到成片设定图
- 作者称自动尺寸会增加渲染时间和显存;输出是静态设定图,不是视频;本条未运行
- 卡片配图是 AI 生成的示意图,不是模型的实际效果;作者没有公开的普通级示例
可关注(9)
【B】Minimax H3 IMG2IMG Character Swap Workflow · v2.0
工作流 · 版本更新 · 作者 MrAzor · 发布 11-02 01:18 · 下载 92
用 H3 和 NRDX Character Swap LoRA 做“换角色”的 ComfyUI 工作流:把头部、身体参考图合成角色参考,再按另一张姿势图生成静态图;v2.0 加了可选的二次精修。
配图
【B】Watercolor [Minimax / MOSS / Krea2 / SD]🎨 🖌️ 🖼️ · Minimax v1.0
LoRA · 移植 · 作者 TeraWatt · 发布 11-02 06:36 · 下载 2 · 付费
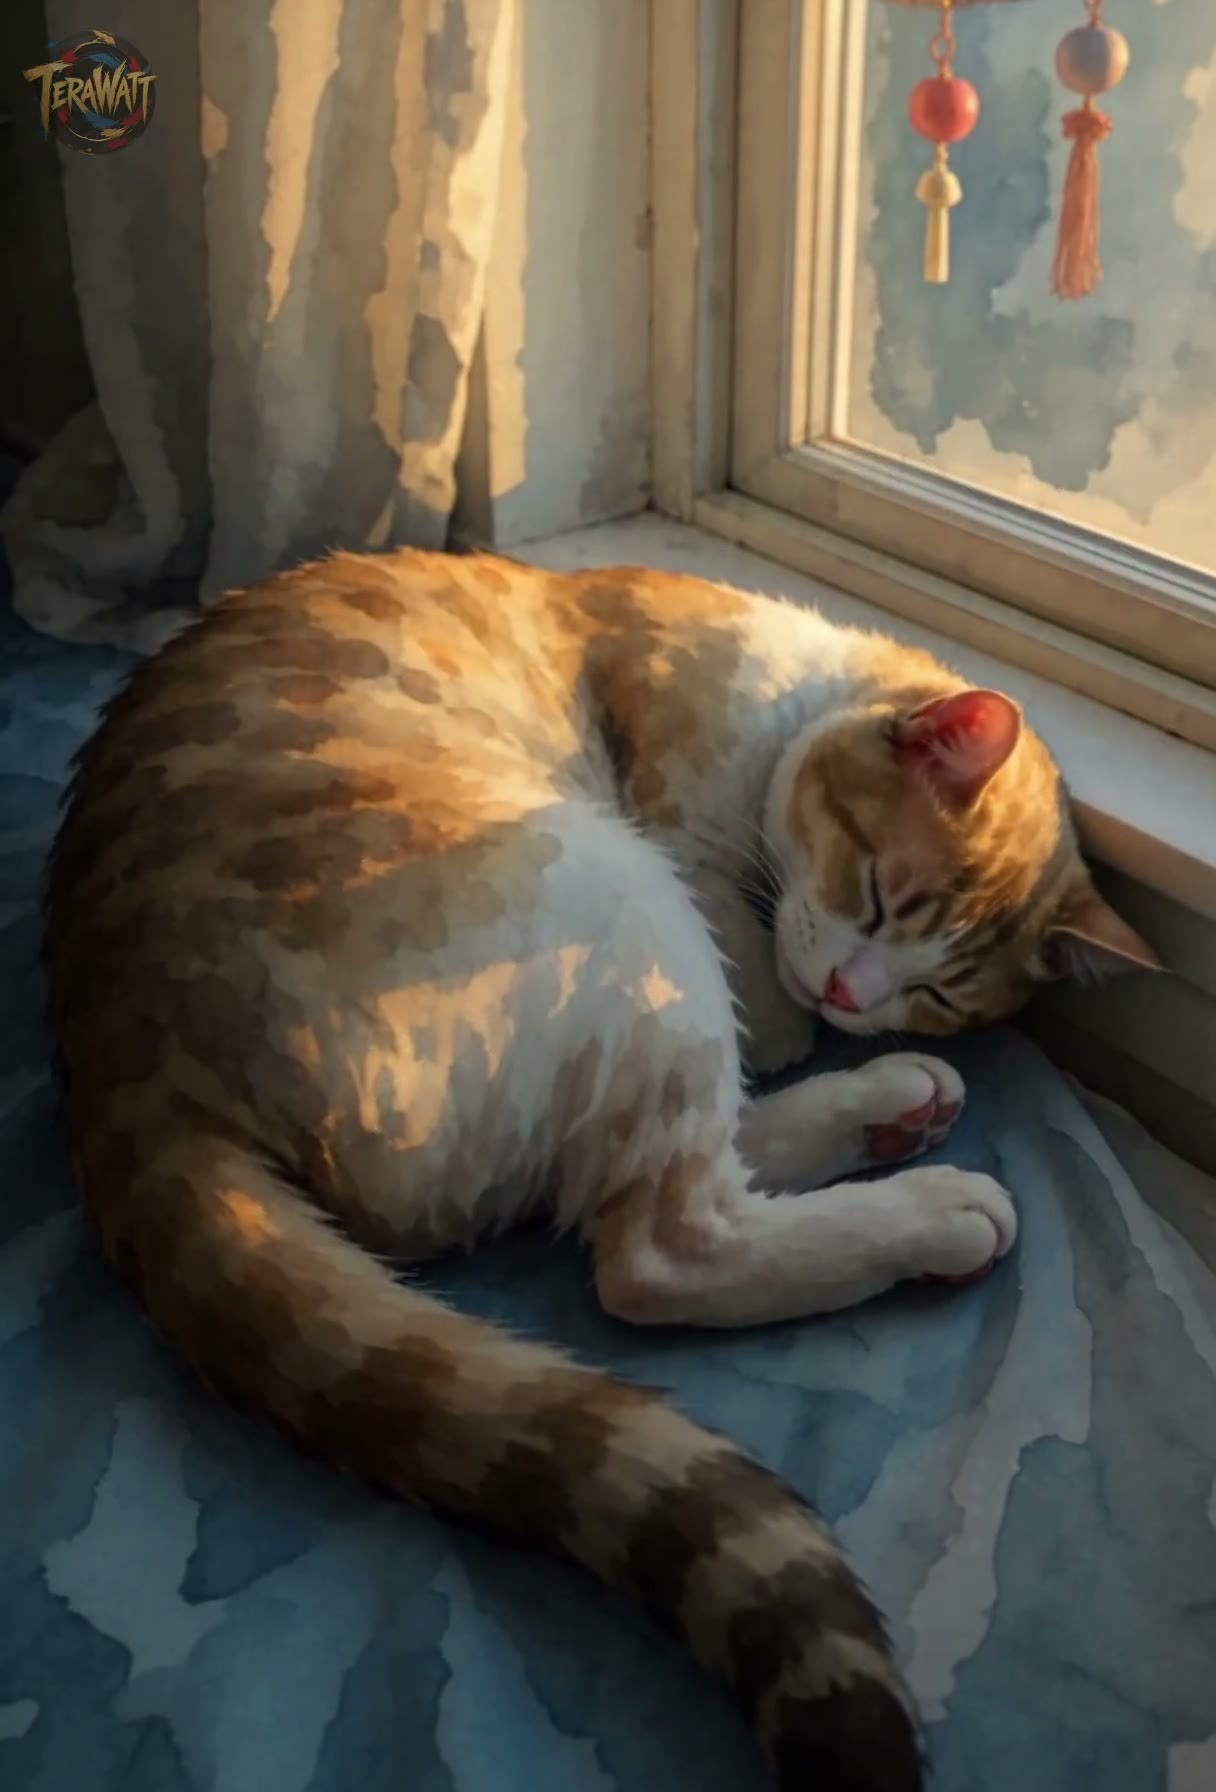
水彩画风格 LoRA 的 H3 版:把文生视频的画面做成水彩画质感,作者称可用来让人像、风景、宠物等画面统一成同一系列。
配图
【B】MiniMax H3 Sigma Enhanced Dual-Pass Universal Video Generation 4K · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 04:39 · 下载 33
AIKSK 的 H3 通用视频生成工作流(Sigma 增强双采样 · 4K 目标):一张参考图出视频,先低分辨率采样、学习型潜空间放大 2 倍再精修,解码后用 SeedVR2 放大到 2160 并 2 倍补帧。
配图
【B】MiniMax H3 OpenVDN DMD8 Universal Video Generation 4K · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 04:38 · 下载 19
AIKSK 的 H3 通用视频工作流(OpenVDN DMD8 · 4K 目标):用首帧加尾帧生成视频,采样交给 OpenVDN 的 vdn-minimax-h3 蒸馏方案(stage_dmd_8nfe),解码后 SeedVR2 放大到 2160、再缩放到 3840×2160 并 2 倍补帧。
配图
【B】MiniMax H3 SelfLift Universal Video Generation 4K · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 04:39 · 下载 22
AIKSK 的 H3 通用视频工作流(SelfLift · 4K 目标):单张参考图生视频,SelfLift 节点内部先低分辨率生成、再用学习型潜空间放大精修,之后 SeedVR2 放大到 2160、缩放到 3840×2160 并 2 倍补帧。
配图
【B】10Eros Beta5 SelfLift Audio Digital Human Fine-tuning Workflow · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 04:23 · 下载 21
用自己提供的音频驱动 H3 数字人视频的工作流:两张图分别给角色和环境/构图,裁出一段源音频编码后拼进参考条件,再用 SelfLift 两段采样生成,成片直接配原音频。
配图
【B】MiniMax H3 ControlNet Union Local Repaint Workflow · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 01:03 · 下载 28
AIKSK 的 H3 视频局部重绘工作流:用 SeC 分割源视频里要改的区域,扩展后的遮罩和源视频一起送进 Fun ControlNet Union,只重绘遮罩区域。
配图
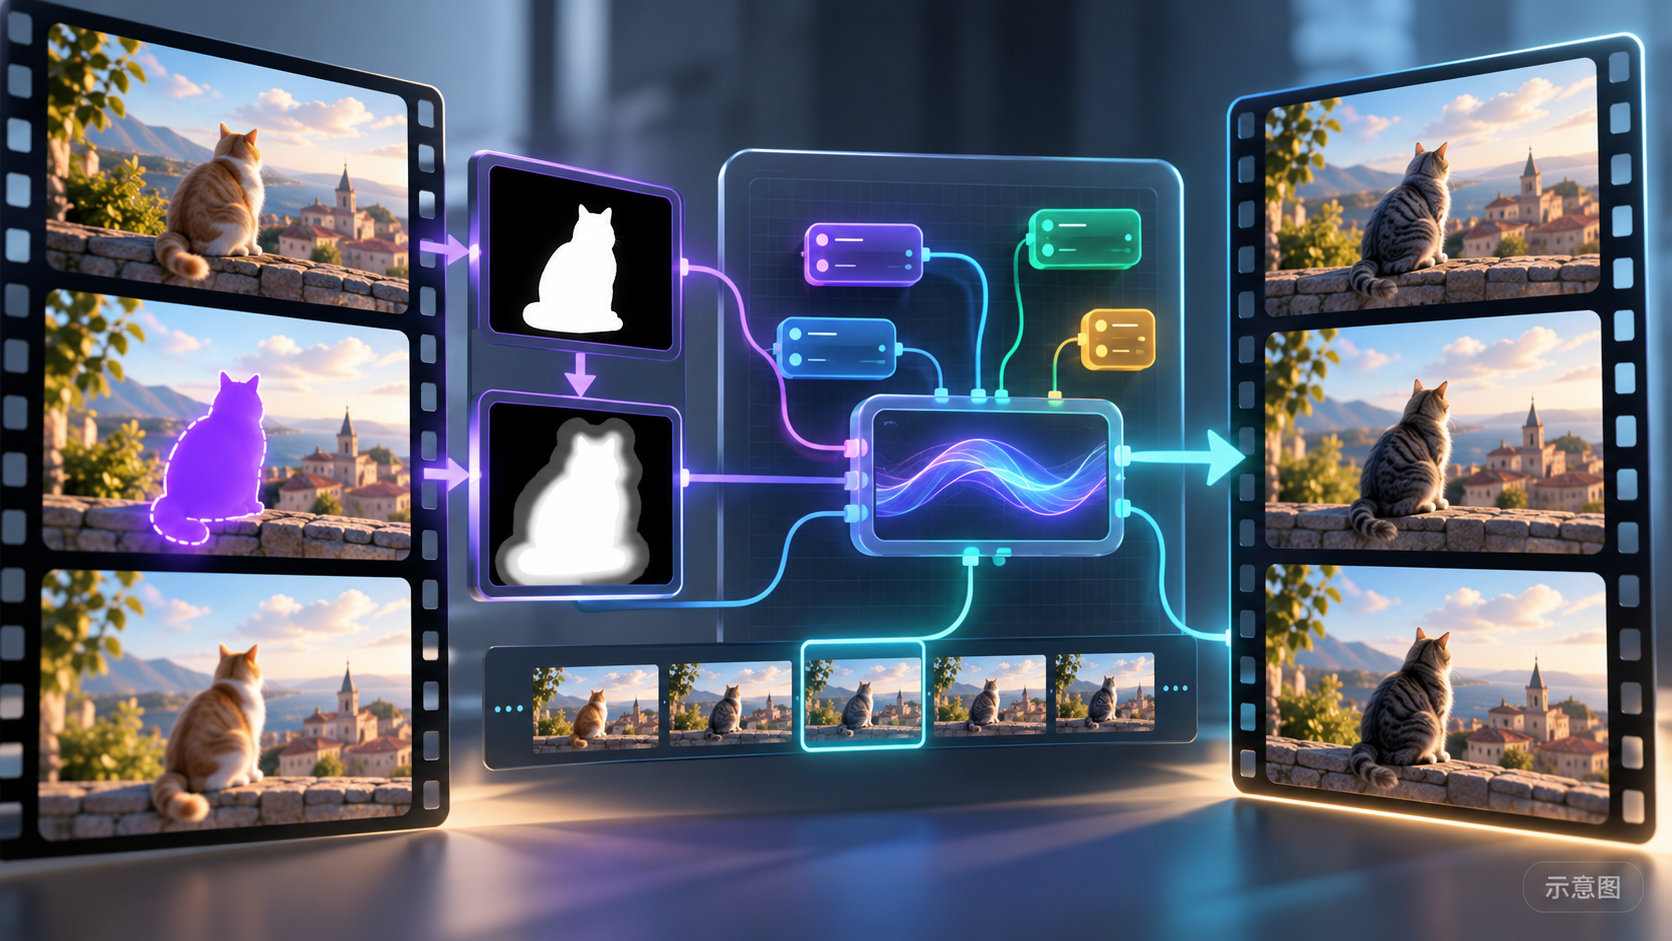
【B】MiniMax H3 Role Swap Reference Edit — Standard Version · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 01:57 · 下载 33
AIKSK 的 H3 视频换角色工作流“标准版”:SeC 分割源视频人物、RGB 加深度混合成参考,再按外观参考图重绘角色,同时把源视频音频编码注入,保留原声。
配图
【B】MiniMax H3 General Video Generation with Audio-Driven Avatar (VDN 12-Step) · v1.0
工作流 · 新模型 · 作者 AIKSK · 发布 11-02 01:02 · 下载 27
AIKSK 的 H3 音频驱动人物工作流:一张参考图加一段上传音频,分离出人声编码成音频潜变量注入生成,输出时配回所选原音频。
配图
仅收录(12)
- All in one Anima Made Easy Brain Edition: Complete ComfyUI Workflow with Wan Video or Minimax H3. Or Both! · v4.0 MiniMax edition — 工作流:一套以 Anima 出图为主的 ComfyUI 一体工作流(草图转高清、修脸手、放大、局部重绘、四人分区提示词、Wan 2.2 图生视频),这一版名为“MiniMax edition”,但模型卡没写 H3 部分怎么接。
- 10Eros Beta5 + FL2VA/Ref2VA Face Touch-up and Oil Removal Second-Pass Workflow · v1.0 — 工作流:标题写“修脸、去油光二次精修”的 10Eros + H3 工作流,但卡上的结构说明显示它是三张参考图生视频加 1.5 倍学习型放大的两段精修,没有专门的人脸裁切贴回流程。
- Universal Video Upscaling SeedVR2 with DLSS Frame Interpolation · v1.0 — 工作流:一个只做后期的视频工作流:读入已有视频,用 SeedVR2(3B FP8)放大到 2160,再 2 倍补帧,保留原音频和原帧率;不涉及 H3 生成。
- MiniMax H3 OpenVDN DMD8 Universal Video Generation 768P · v1.0 — 工作流:OpenVDN DMD8 首尾帧工作流的“768P”版:同样的 VDN 蒸馏采样和 2 倍补帧,但没有 SeedVR2 放大和 4K 缩放尾段。
- MiniMax H3 SelfLift Universal Video Generation 768P · v1.0 — 工作流:SelfLift 通用视频工作流的“768P”版:同样的 SelfLift 两段采样、4 步加速 LoRA 和 2 倍补帧,没有 SeedVR2 和 4K 缩放尾段。
- MiniMax H3 Role Swap Reference Edit — Silent Version · v1.0 — 工作流:AIKSK 的 H3 视频换角色工作流“静音版”:用 SeC 分割源视频里的人物,把 RGB 和深度图混合成参考,再按一张外观参考图重绘角色;这一版旁路了手动注入音频的节点。
- MiniMax H3 VDN Hero Shot · v2 — 12NFE 40-node export — 工作流:做产品展示主镜头的 H3 VDN 二次精修工作流:读入源视频和参考图,先 8-NFE 低分辨率 VDN、学习型潜空间放大 2 倍,再 4-NFE 精修,输出约 1920×1088、24 fps 带声音成片。
- MiniMax H3 ControlNet Union 2.0 Video Control with Audio Avatar (VDN 12-Step) · v1.0 — 工作流:AIKSK 的 H3 工作流:用源视频的深度图(DepthAnythingV2)做结构控制,同时把人声编码成音频潜变量注入,生成跟着动作和声音走的视频。
- MiniMax H3 ControlNet Union 2.0 Video Control and Inpaint (VDN 12-Step) · v1.0 — 工作流:AIKSK 的 H3 结构控制工作流:源视频经 Scribble 线稿预处理后送进 Fun ControlNet Union 控制画面结构,音频由 H3 原生生成。
- MiniMax-H3 All-in-One Video Workflow V5 - Latent Chunked Second-Sampling Edition · v1.0 — 工作流:Astral星芒的 H3 全能生视频工作流 V5“latent 分块二采版”:文生、图生、参考生三合一,自动写提示词、锁定音频,作者称修复远景崩脸、脸部油腻和高动态拖影。
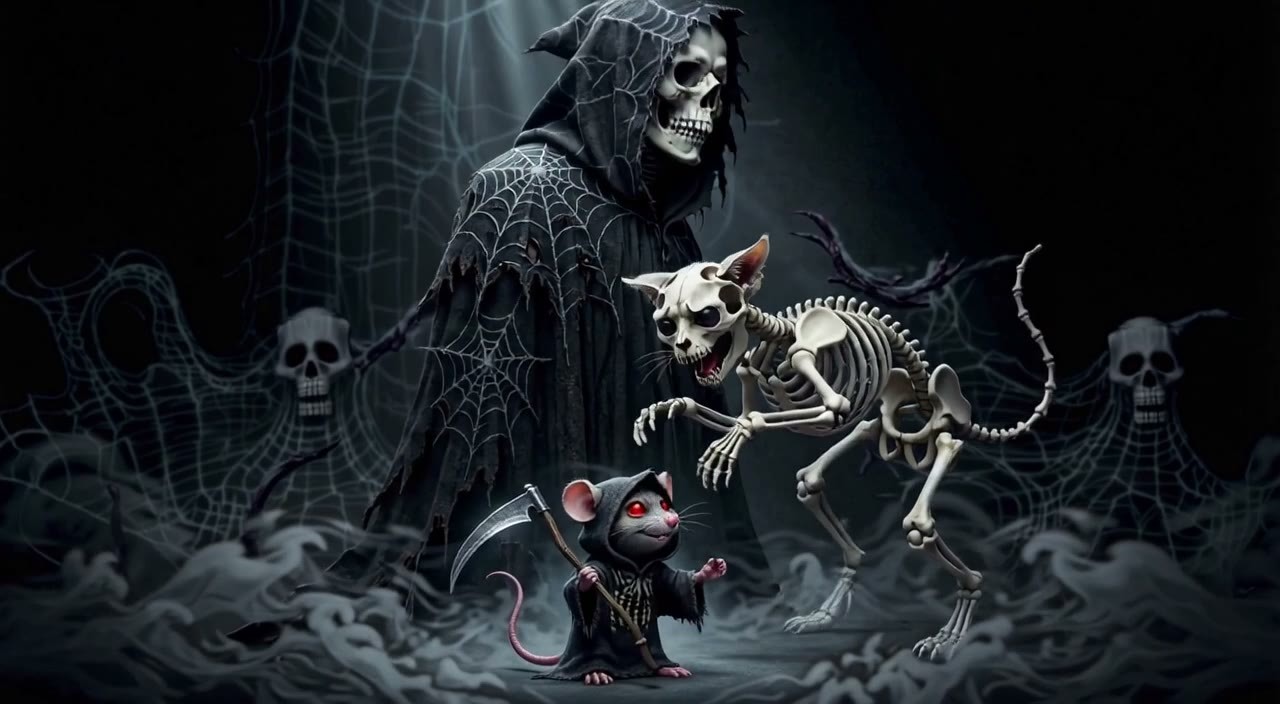
- LORU & RIBS: SALT FLAT SYMPHONY · v1 — LoRA:一对虚构骷髅角色的 H3 LoRA:穿破烂高定斗篷和工装裤的死神 Loru,和穿卫衣、运动鞋的骷髅猫 Ribs;作者称擅长骨头与布料的质感对比和盐滩、霓虹等场景光。
- MiniMax-H3 V5 All-in-One Video Workflow - SelfLift Two-Pass Edition · v1.0 — 工作流:Astral星芒的 H3 全能生视频工作流 V5“SelfLift 二采版”:文生、图生、参考生三合一,用官方 skill 自动写提示词、锁定音频,低显存二次采样,作者称改善远景崩脸。
数据:Civitai 公开 API(基模 MiniMax H3),收录窗口 11-01 20:31 → 11-02 10:45(北京时间)。推荐理由经编辑审阅;下载量只代表关注度。